valuation et Traitement Automatique des Langues mardi 21
- Slides: 99
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Évaluation et Traitement Automatique des Langues Patrick Paroubek Laboratoire pour la Mécanique et les Sciences de l’Ingénieur Centre National de la Recherche Scientifique Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 1. Le paradigme d’évaluation 2. Contrastes Historiques Europe / États-Unis 3. Le traitement de l’écrit 1. Annoter (Kappa) & Aligner (Prog. Dyn. ) & Évaluer (Précision/Rappel) 2. Morphosyntaxe 3. Syntaxe 4. Remarque sur l’évaluation des systèmes de dialogue Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues 1. Le paradigme d’évaluation Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Évaluation : subst fém. Action d’évaluer, d’apprécier la valeur (d’un chose); technique, méthode d’estimation. [TLFI] L’évaluation est "une formalisation" d’un processus de sélection naturelle. L’évaluation est inhérente au processus scientifique. Trouver une réponse (optimale) à un problème. Comment comparer les réponses ? L’évaluation nécessite l’adoption d’un système de valeurs. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 1) Qu’évalue t’on ? (identifier la frontière du système et la tâche effectuée par le système) 2) Évalue t’on un système ou un couple système-utilisateur ? 3) Par rapport à quel système de valeurs ? 4) Par rapport à quel objectif ? (réponse apportée par l’évaluation). Rem. L’évaluation n’est pas une compétition (compétition = qui ? , évalution = comment ? ) Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 L’évaluation fait peur (sélection/compétition). Le rapport ALPAC 1966 a engendré un arrêt des financements aux USA pour la Traduction Automatique pendant 20 ans. Mais ce qui est dangereux n’est pas l’évaluation, mais la manière dont on utilise ses résultats. Par ex. une lecture abusive du livre de Minsky & Papert (Perceptrons) a retardé l’avènement des réseaux de neurones multi-couches d’une dizaine d’années. Maghi King, « When is the next ALPAC report due? » , 10 th International Conference on Computational Linguistics, Proceedings of Coling 84, July 1984, Stanford University, Ca (ACL 1984); p 352 -353. http: //ourworld. compuserve. com/homepages/WJHutchins/Alpac. htm Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Les campagnes d’évaluations sont un accélérateur du processus scientifique: ressources, outils, standards, infrastructure, synergie. LDC (http : //www. ldc. upenn. edu) aux USA et ELRA/ELDA en Europe (http : //www. elra. org ou www. elda. i Objectif : créer, maintenir, distribuer, partager des ressources linguistiques. LDC = Linguistic Data Consortium, consortium ouvert de laboartoires de recherche, univsertités, industriels et agences gouvernementales, fondé en 1992 (ARPA et NSF), hébergé à l’Université Pennsylvania. Patrick Paroubek / Limsi-CNRS
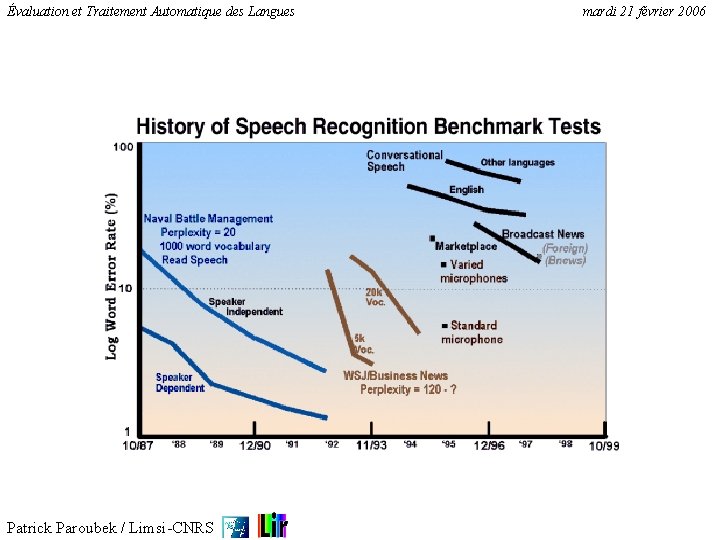
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 ELRA association à buts non lucratifs (loi 1901), basée au Luxembourg, fondée en février 1995. ELDA, S. A. fondée en février 1995, instrument exécutif d’EL Financement Européen initial, puis auto-financement. Objectif: pérenniser/partager les ressources produites par les projets Européens, ainsi que produire de nouvelles ressources. Impact de l’évaluation : Ex. Progrès en reconnaissance de Parole grace aux évaluation DARPA aux USA qui ont amené la technologie sur le marché Patrick Paroubek / Limsi-CNRS
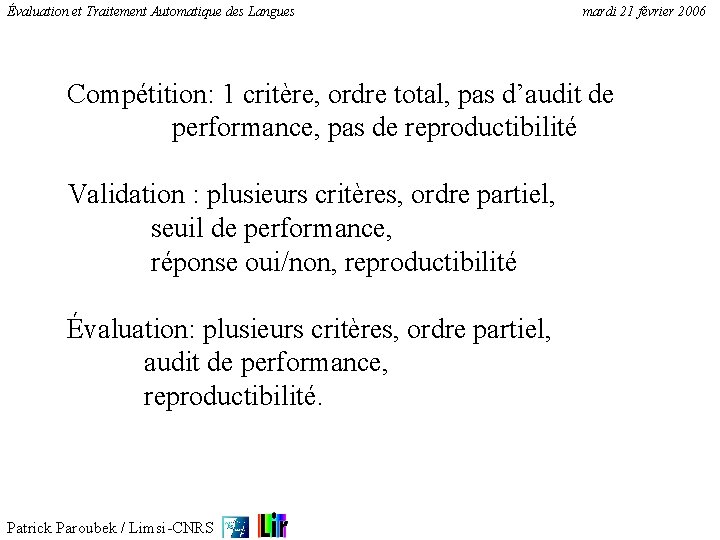
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Compétition: 1 critère, ordre total, pas d’audit de performance, pas de reproductibilité Validation : plusieurs critères, ordre partiel, seuil de performance, réponse oui/non, reproductibilité Évaluation: plusieurs critères, ordre partiel, audit de performance, reproductibilité. Patrick Paroubek / Limsi-CNRS
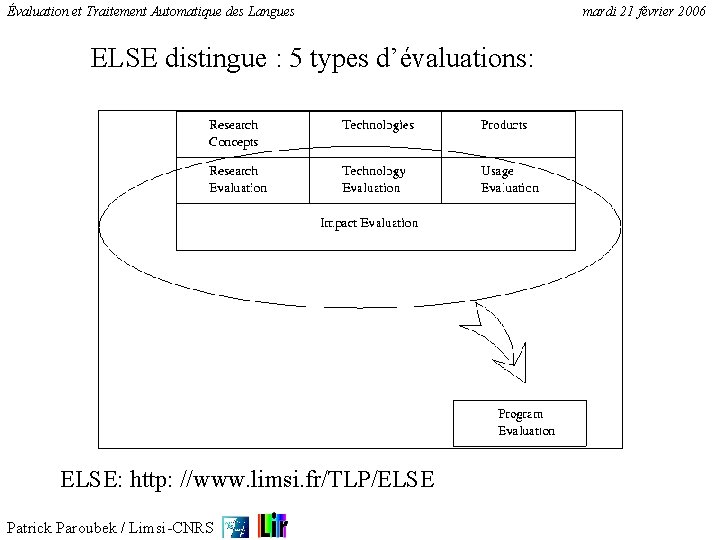
Évaluation et Traitement Automatique des Langues ELSE distingue : 5 types d’évaluations: ELSE: http: //www. limsi. fr/TLP/ELSE Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
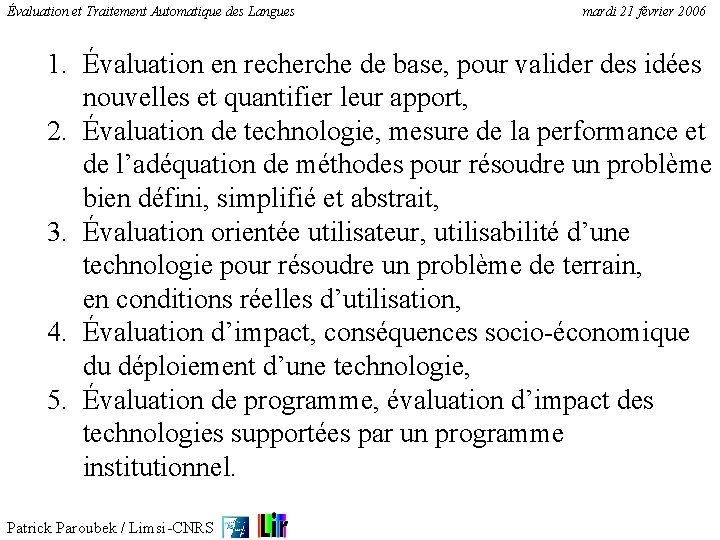
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 1. Évaluation en recherche de base, pour valider des idées nouvelles et quantifier leur apport, 2. Évaluation de technologie, mesure de la performance et de l’adéquation de méthodes pour résoudre un problème bien défini, simplifié et abstrait, 3. Évaluation orientée utilisateur, utilisabilité d’une technologie pour résoudre un problème de terrain, en conditions réelles d’utilisation, 4. Évaluation d’impact, conséquences socio-économique du déploiement d’une technologie, 5. Évaluation de programme, évaluation d’impact des technologies supportées par un programme institutionnel. Patrick Paroubek / Limsi-CNRS
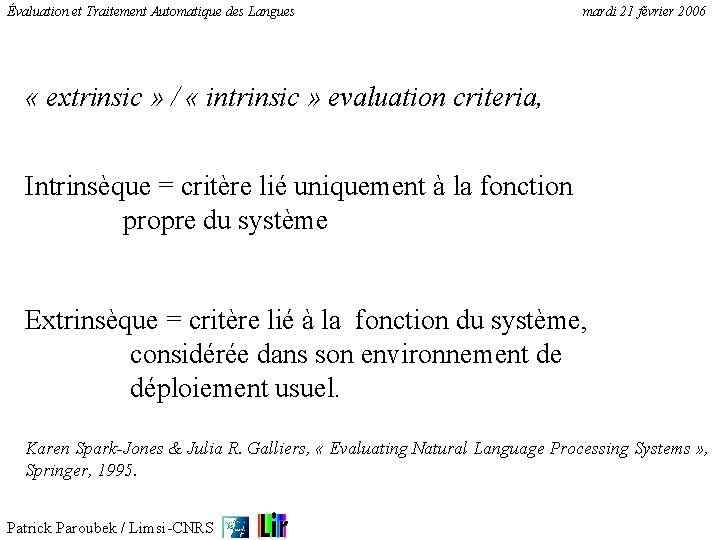
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 « extrinsic » / « intrinsic » evaluation criteria, Intrinsèque = critère lié uniquement à la fonction propre du système Extrinsèque = critère lié à la fonction du système, considérée dans son environnement de déploiement usuel. Karen Spark-Jones & Julia R. Galliers, « Evaluating Natural Language Processing Systems » , Springer, 1995. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 EAGLES distingue 3 types d’évaluation: 1. « adequacy » evaluation, adéquation d’un système pour une fonction donnée 2. « diagnostic » evaluation, identification des raisons de dysfonctionnement 3. « progress » evaluation, mesure des progrès en performance EAGLES : http: //www. issco. unige. ch/projects/ewg 96. html (evalutation of NLP systems : final report, ) Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Qualitative (morpholympics) Quantitative (NIST/DARPA, Technolangue-EVALDA) Comparative (NIST/DARPA, Technolangue-EVALDA) Boîte « noire » (NIST/DARPA, Technolangue-EVALDA) Boîte « blanche » (DISC) Subjective (morpholympics) Objective (NIST/DARPA, Technolangue-EVALDA) Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Le paradigme d’évaluation (Joseph Mariani) 1. Assembler des acteurs (évaluateurs, participants, producteurs de ressources) 2. Organiser une campagne d’évaluation sur de données communes 3. Définir une mesure de performance commune Joseph Mariani, Patrick Paroubek, "Human Language Technologies Evaluation in the European Framework", actes de l'atelier DARPA Broadcast News Workshop, Whashington, February 1999, Morgan Kaufman Publishers, ISBN-1 -55860 -638 -6, pp 237 -242 Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Une infrastructure pour l ’évaluation en ingéniérie linguistique : 1. 2. 3. 4. 5. 6. 7. Comparative & Collaborative Tâche/Application Indépendente Semi-Automatique & Reproduisible Boîte Noire + Conférence Quantitative Multilingue Oral & écrit Patrick Paroubek / Limsi-CNRS
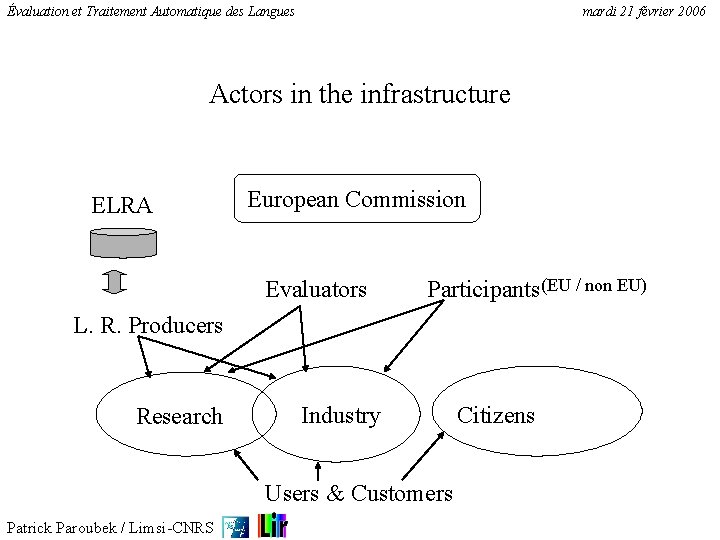
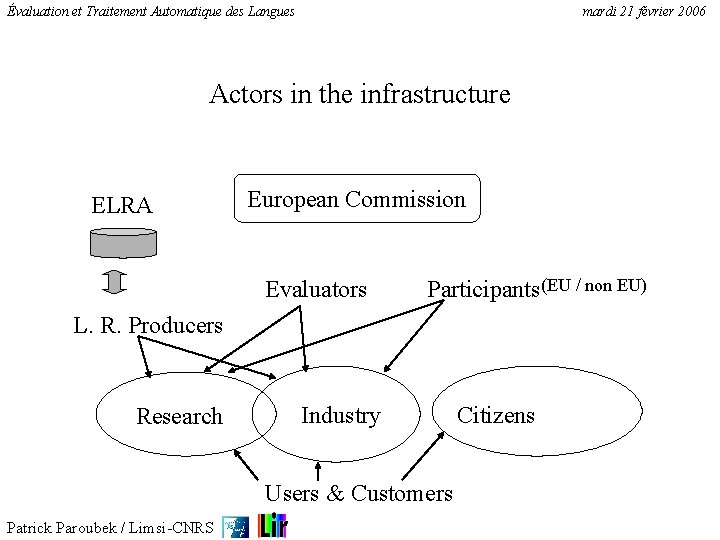
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Actors in the infrastructure ELRA European Commission Evaluators Participants (EU / non EU) L. R. Producers Research Industry Citizens Users & Customers Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Attentes: 1. Renforcement de l’utilisation des standards 2. Des informations et des connaissances sur les applications et les technologies disponibles de meilleur qualité et plus abondantes 3. Des produits et des ressources de meilleurs qualité 4. Un accroissement de la quantité de ressources linguistiques annotées et validées Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Structure d’une campagne 1. 2. 3. 4. 5. Phase 1 - Développement (distribution calibrage / données d’entrainement) Phase 2 - Essais + première Adjudication (+ Conférence/Atelier) Phase 3 - Tests + seconde Adjudication + Conférence/Atelier Phase 4 - Valorisation (distribution des données produites et des résultats) Phase 4 - Étude d ’Impact Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 La tâche de contrôle 1. La fonction de traitement du language doit être facile a comprendre 2. Elle peut être réalisée manuellement 3. Il peut s’agir d’une tâche « artificielle » 4. Il existe un formalisme commun, facilement accessible (projection/transcodage aisé) 5. Il est « facile » de définir une mesure de performance Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 2. Contrastes Historiques Europe / États-Unis Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues Contexte international 1. États-Unis 1. Campagnes d ’évaluation NIST - DARPA 1. 2. 3. 4. Depuis 1987, ouvertes en 1992 Ecrit / Oral Production / distribution des ressources (LDC) Organisation des campagnes (NIST) 2. Traitement du Langage Parlé 1. 2. 3. 4. 5. 6. Dictée Vocale (RM, WSJ, NAB) Compréhension de la langue parlée (ATIS) Transcription infos radio/télédiffusées (BN) Reconnaissance de conversations (switchboard) Reconnaissance du locuteur Reconnaissance de la langue parlée Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Contexte international 1. États-Unis 1. Traitement du Langage Écrit 1. Recherche d’Informations Textuelles (TREC) 2. Compréhension de Messages (MUC) 3. Traduction Automatique 2. Traitement du Langage Écrit + Parlé 1. Extraction d’Entités Nommées (dans BN) 2. Détection et Suivi de Thèmes (TDT) (dans BN) 3. Reconnaissance de caractères etc. . . Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Évaluation aux USA (Parole) 1. 2. 3. 4. CSR (DARPA) read & found english, 89 -97 LVCSR conversationel, multilingue ATIS (DARPA) DARPA/NSF en 1998 (multilingue): 1. Extraction d ’entité nommées 2. Détection et suivit de thèmes 3. Transcription de nouvelles 4. COMMUNICATOR Patrick Paroubek / Limsi-CNRS
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue Évaluation (USA) COMMUNICATOR dialogue oral pour la réservation de transport, l’hébergement et planification d’itinéraire TIDES extraction d’information interlingue, traduction et résumé automatique Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue mardi 21 février 2006 Évaluation (USA) AQUAINT (Defense Ministry) programme de l’ ARDA, extraction d'information étendue en amont et en aval sur des données multimodales, pour incorporer des connaissances à des données factuelles du types de celles manipulées dans les évaluations TREC ITR (NSF) recherche en technologie de l'information) Patrick Paroubek / Limsi-CNRS
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue mardi 21 février 2006 Évaluation (USA) SYMPHONY (DARPA) suite de COMMUNICATOR et dont les objectifs sont : la reconnaissance de la parole robuste en milieu bruité, le compte rendu automatique de réunion, la fusion de données multimodales, l'interprète automatique, les interfaces homme-machine dialogiques, la traduction automatique (déjà présente dans le programme TIDES), et l'exploitation rapide et automatique de langues nouvelles Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues Évaluation aux USA (écrit) 1. 2. 3. 4. 5. 6. Tipster program (DARPA & NIST) MUC-1 (1987) to MUC-7 (1998) MET-1 (1995) and MET-2 (1998) TREC-1 (1992) to TREC-7 (1998) SUMMAC MT Evaluation (1992, 1993, 1994) Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue mardi 21 février 2006 Évaluation (USA) Les directions de recherche favorisées par le DARPA: les technologies robustes à large couverture, les technologie de base largement réutilisables, la multilingualité, le partage des données ( LDC) les corpus arborés (U. Penn) les évaluation comparatives supportées par des métriques quantitatives, les expériences d'intégration et de faisabilité L’objectif à plus long terme étant la compréhension du langage Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Contexte international 1. Japon, National Institute of Informatics (http : //www. nii. ac. jp) 1. Research Center for Information Ressources (test collection for IR systems) 2. Research Center for Testbeds and Prototyping (scholarly information retrieval) 2. Cocosda / Oriental Cocosda (International Committee for the Coordination and Standardisation of Speech Databases and Assesment Techniques) 3. Conférences : 1. HLT workshop 02, 03, 04, 06 2. LREC conference 98, 00, 02, 04, 06 3. Lang. Tech conference 02, 03, Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Évaluation en Europe EAGLES TSNLP DIET TEMAA SQALE SPARKLE DISC MATE Patrick Paroubek / Limsi-CNRS COCOSDA SAM & SAM-A Morpholympics Actions de recherche concerté de l’AUPELF GRACE (CNRS) Verb. Mobil
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Pilot Senseval / Romanseval § § § § § Task: Word Sense Disambiguating (Senseval/English) 20 nouns, 20 adjectives and 20 verbs Romanseval, same task in French & Italian. 8 month (December 1997 - September 1998) 35 teams interested / 21 systems evaluated Senseval: FR, USA, IT, UK, CH, KO, MA, CA, SP, NL Romanseval: FR, IT, CH Budget : 61 KEuros(English) Data, hardware and computing for free. Evaluatees not funded. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 SQALE Project § § Duration 1993 to 1995. Evaluation of 3 different ASR 3 languages + 1 common (Fr. , Germ. , UK Eng. + US Eng. ) TNO-IZF (NL), Philips (D), U. Cambridge (UK), Limsi. CNRS (F) § Task: dictation of newspaper texts § Result: If a system is better on the common language than another system, it will also be better on its own language. § Comparison with human performance was studied. Patrick Paroubek / Limsi-CNRS
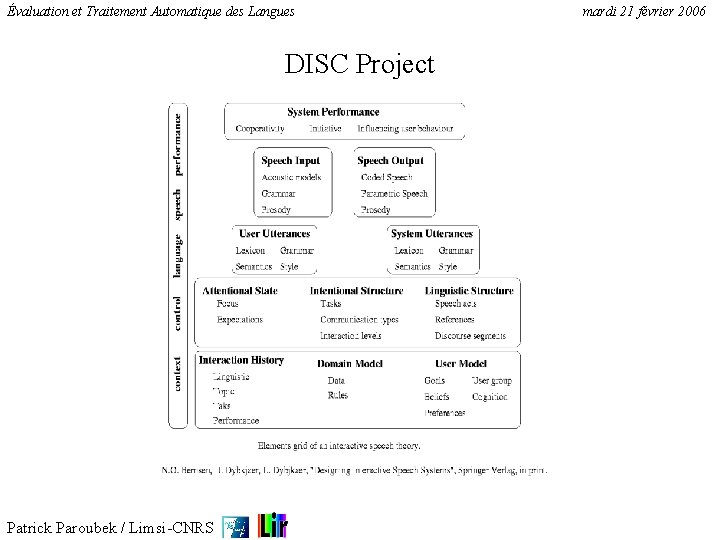
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 DISC Project § Reference methodology for SLDS development. § Best practice development and evaluation (existing components & procedures) § Results: Guidelines and Heuristics § 2 Guiding principles: Grid Aspects of SLDS components and Development Lifecycle of SLDS § 7 Participants: NIS (DK), LIMSI (F), IMS (D), KTH (S), Vocalis (UK), D-Benz (D), ELSNET (NL) § Duration: 1 year (1998) § Follow-up: DISC-2 (January 1999) information update, packaging, access and usability Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues DISC Project Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 EAGLES Evaluation WG § § § EAGLES was launched in 1993 Aim: standards for NLP technology (including evaluation) Eval. working group started from ISO 9126 (software) User-oriented methodology (consumer report paradigm) for adequacy evaluation or progress evaluation Formalism (based on feature structures) for classifying products and users. § Case studies on: spelling checkers (LRE-TEMAA), grammar checkers and translators’ aids. § Follow-up: EAGLES-II (1995 -1998), consolidate, extend and disseminate EAGLES results. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 ELSE Project § Evaluation in Language and Speech. Engineering § 8 partners: MIP (DK), LIMSI (FR), DFKI (D), U. Pisa (I), EPFL (CH), XRCE (FR), U. Sheffiel (UK), CECOJI (FR) + ELSNET & ELRA § Duration: January 1998 - April 1999. Budget: 414 KECU § Draw a blueprint for an evaluation infrastructure (IST Key Actions of FP 5 ? ) § Evaluation Paradigm: contrastive quantitative Technology Evaluation. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Actors in the infrastructure ELRA European Commission Evaluators Participants (EU / non EU) L. R. Producers Research Industry Citizens Users & Customers Patrick Paroubek / Limsi-CNRS
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue mardi 21 février 2006 Évaluation (Europe) § § § § EAGLES TSNLP DIET TEMAA SQALE SPARKLE DISC MATE Patrick Paroubek / Limsi-CNRS § § COCOSDA SAM & SAM-A Morpholympics Actions de recherche concerté de l ’AUPELF § GRACE (CNRS) § Verb. Mobil § ELSE
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue mardi 21 février 2006 Évaluation (Europe) CLASS Evaluation URL: http: //www. limsi. fr/TLP/CLASS Disponibles sur le site : Actes de LREC 2000 CLASS atelier satellite sur l’évaluation. 1. Actes de EACL 2 OO 1, Toulouse, atelier « Evaluation for Language & Dialog Systems » 2. Présentations du Bullet Course on the paradigm of Evaluation in Speech and Language, Juillet, Paris 02 et 03 2001. Patrick Paroubek / Limsi-CNRS
Traitement Automatique des Langues Évaluation et Traitement Automatique des Langues et Industrie de la Langue Évaluation (Europe) CLEF: recherche d’information interlingue SENSEVAL: désambiguïsation sémantique SMARTKOM: nouveau projet allemand. TCSTAR technologie pour interprète automatique ECOM (ELRA) évaluation Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues FRANCIL Program Created : June 1994 Coordinator: J. Mariani, F. Néel Networking (70 laboratories, 9 countries) Training Collaborative Research Actions (ARP) Strategic Research Actions (ARC) Budget: 4 Meuro / 4 years - 2 Meuro ARC Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 ARC Use of the evaluation paradigm for accompanying research : Infrastructure for evaluation (protocols, metrics, organization. . . ) Language Resources for systems development and evaluation Discussion of the advantages and disadvantages of different approaches based on objective evaluation conducted on common data Written and spoken language Patrick Paroubek / Limsi-CNRS
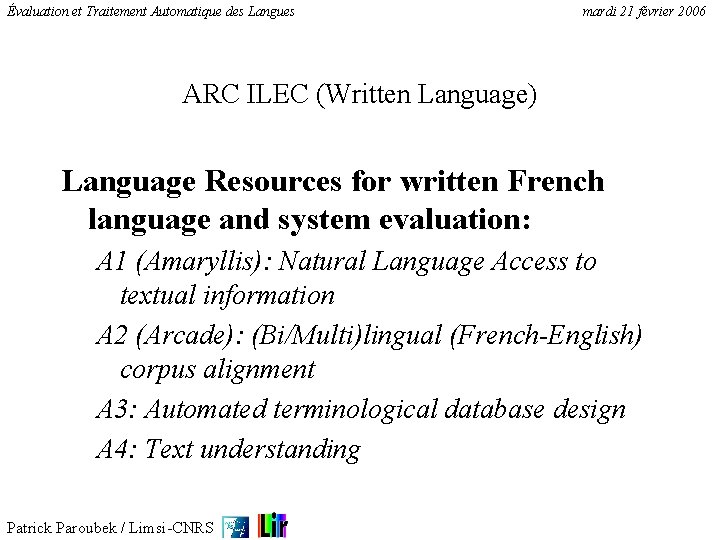
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 ARC ILEC (Written Language) Language Resources for written French language and system evaluation: A 1 (Amaryllis): Natural Language Access to textual information A 2 (Arcade): (Bi/Multi)lingual (French-English) corpus alignment A 3: Automated terminological database design A 4: Text understanding Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 ARC ILOR (Spoken language) • Language Resources for spoken French language and system evaluation B 1: Voice Dictation (large vocabulary recognition) B 2: Vocal Dialog B 3: Text-to-Speech synthesis Patrick Paroubek / Limsi-CNRS
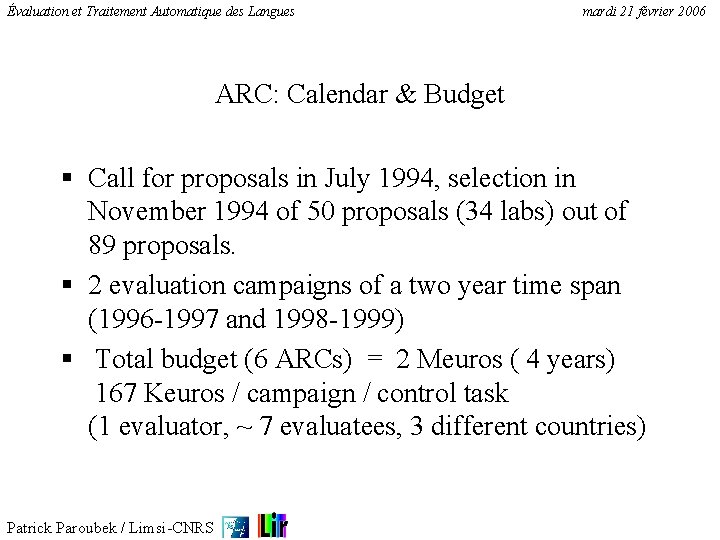
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 ARC: Calendar & Budget § Call for proposals in July 1994, selection in November 1994 of 50 proposals (34 labs) out of 89 proposals. § 2 evaluation campaigns of a two year time span (1996 -1997 and 1998 -1999) § Total budget (6 ARCs) = 2 Meuros ( 4 years) 167 Keuros / campaign / control task (1 evaluator, ~ 7 evaluatees, 3 different countries) Patrick Paroubek / Limsi-CNRS
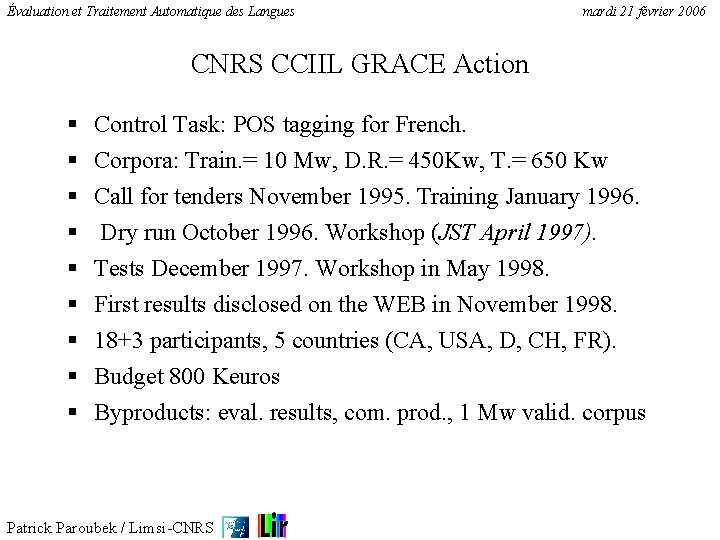
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 CNRS CCIIL GRACE Action § § § § § Control Task: POS tagging for French. Corpora: Train. = 10 Mw, D. R. = 450 Kw, T. = 650 Kw Call for tenders November 1995. Training January 1996. Dry run October 1996. Workshop (JST April 1997). Tests December 1997. Workshop in May 1998. First results disclosed on the WEB in November 1998. 18+3 participants, 5 countries (CA, USA, D, CH, FR). Budget 800 Keuros Byproducts: eval. results, com. prod. , 1 Mw valid. corpus Patrick Paroubek / Limsi-CNRS
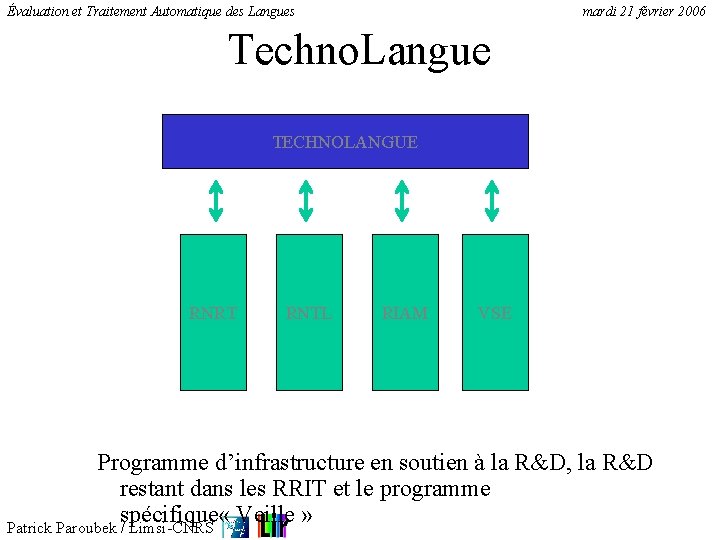
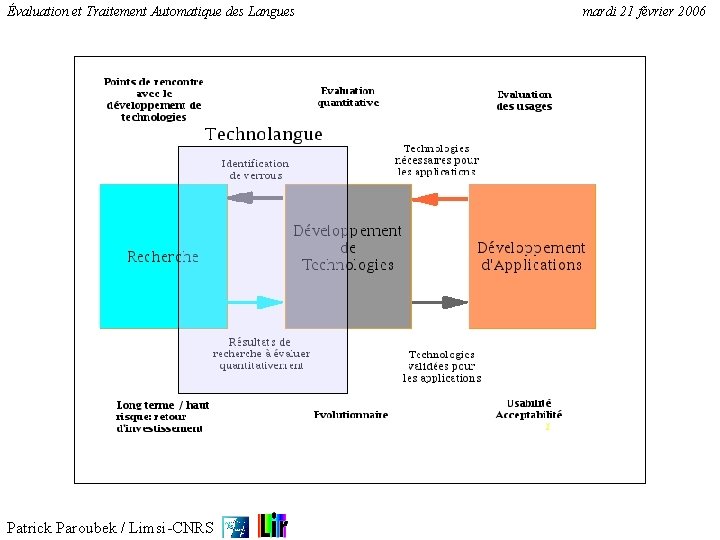
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Techno. Langue TECHNOLANGUE RNRT RNTL RIAM VSE Programme d’infrastructure en soutien à la R&D, la R&D restant dans les RRIT et le programme spécifique « Veille » Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
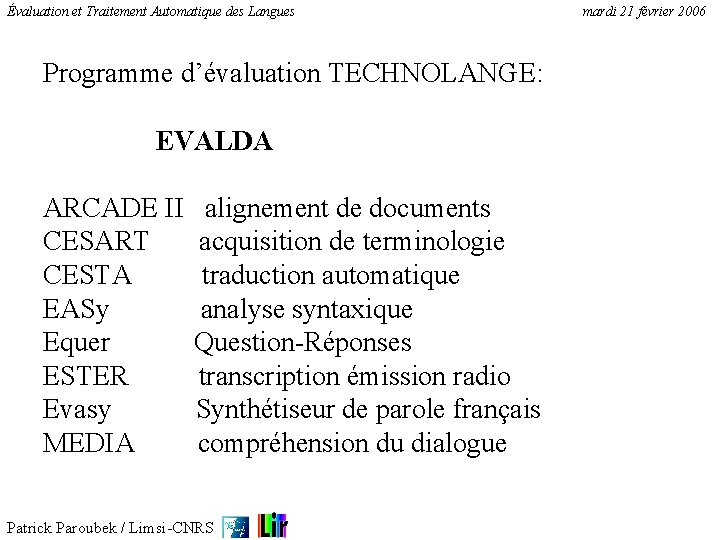
Évaluation et Traitement Automatique des Langues Programme d’évaluation TECHNOLANGE: EVALDA ARCADE II alignement de documents CESART acquisition de terminologie CESTA traduction automatique EASy analyse syntaxique Equer Question-Réponses ESTER transcription émission radio Evasy Synthétiseur de parole français MEDIA compréhension du dialogue Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
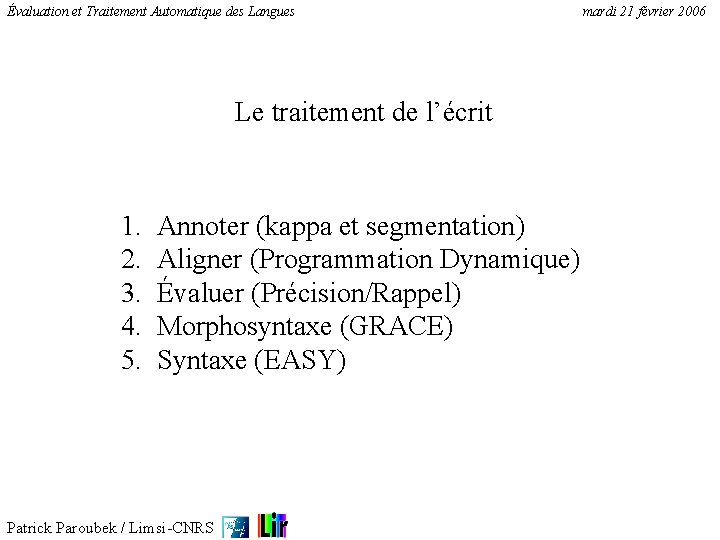
Évaluation et Traitement Automatique des Langues Le traitement de l’écrit 1. 2. 3. 4. 5. Annoter (kappa et segmentation) Aligner (Programmation Dynamique) Évaluer (Précision/Rappel) Morphosyntaxe (GRACE) Syntaxe (EASY) Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Le (coefficient) Kappa est une mesure permettant de quantifier la plus ou moins grande similarité entre deux systèmes d’annotation (accord inter-annotateur). Le kappa est fréquemment utilisée en TALN. Il a été défini par [Cohen 1960]. Le principe est de relativiser la valeur effectivement observée pour le taux d’accord en la rapportant à celle qui aurait été obtenue en comparant deux systèmes affectant les étiquettes de façon aléatoire dans les mêmes proportions que les systèmes effectivement comparés. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Barbara Di Eugenio and Michael Glass (2004). The kappa statistic: A second look. Computational Linguistics, 30(1): 95 -101. Véronis, J. (1998 a). A study of polysemy judgements and inter-annotator agreement. Senseval workshop, 2 -4 Sept. 1998. Herstmonceux Castle, England. Bruce, R. , Wiebe, J. (1998). Word sense distinguishability and inter-coder agreement. Proceedings of the 3 rd Conference on Empirical Methods in Natural Language Processing (EMNLP-98). ACL SIGDAT, Granada, Spain, June 1998. Carletta, J. (1996). Assessing agreement on classification tasks: the kappa statistics. Computational Linguistics, 22(2), 249 -254. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Jones, A. P. , Johnson, L. A. , Butler, M. C. , & Main, D. S. 1983. Apples and oranges: An empirical comparison of commonlyused indices of interrater agreement. Academy of Management Journal, 26(3): 507 -519. Davies, M. , Fleis, J. L. (1982). measuring agreement for multinomial data. Biometrics, 38, 1047 -1051. Brenann, R. L. & Prediger, D. J. (1981). Coefficient Kappa : Some uses, misuses and alternatives. Educational and Psychological Measurement, 4, 687 -699. Hubert, L. 1977. Kappa revisited. Psychological Bulletin, 84(2): 289 -297. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Landis J. R. ; Koch G. G. (1977) The measurement of observer agreement for categorial data. Biometrics 45: 255 -268 Fleiss, J. L. ; Cohen, J. ; and Everitt, B. S. Largesample standard errors of kappa and weighted kappa. Psychological Bulletin 72 (1969): 323 -327. Cohen, J. (1960) A coefficient of agreement for nominal scales. Educational and Psychological Measurements 20(1): 37 -46. Patrick Paroubek / Limsi-CNRS
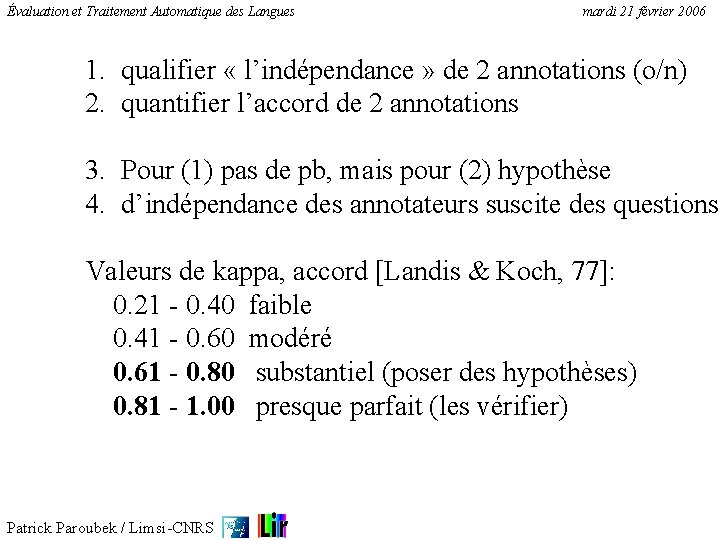
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 1. qualifier « l’indépendance » de 2 annotations (o/n) 2. quantifier l’accord de 2 annotations 3. Pour (1) pas de pb, mais pour (2) hypothèse 4. d’indépendance des annotateurs suscite des questions Valeurs de kappa, accord [Landis & Koch, 77]: 0. 21 - 0. 40 faible 0. 41 - 0. 60 modéré 0. 61 - 0. 80 substantiel (poser des hypothèses) 0. 81 - 1. 00 presque parfait (les vérifier) Patrick Paroubek / Limsi-CNRS
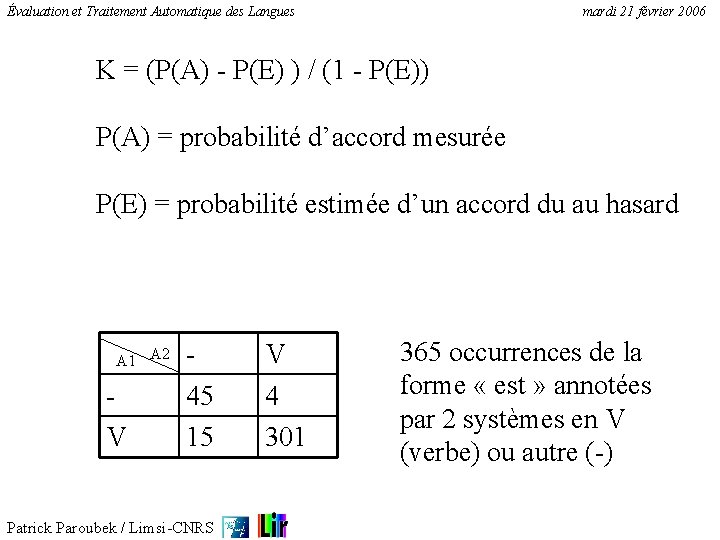
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 K = (P(A) - P(E) ) / (1 - P(E)) P(A) = probabilité d’accord mesurée P(E) = probabilité estimée d’un accord du au hasard A 1 A 2 V 45 15 Patrick Paroubek / Limsi-CNRS V 4 301 365 occurrences de la forme « est » annotées par 2 systèmes en V (verbe) ou autre (-)
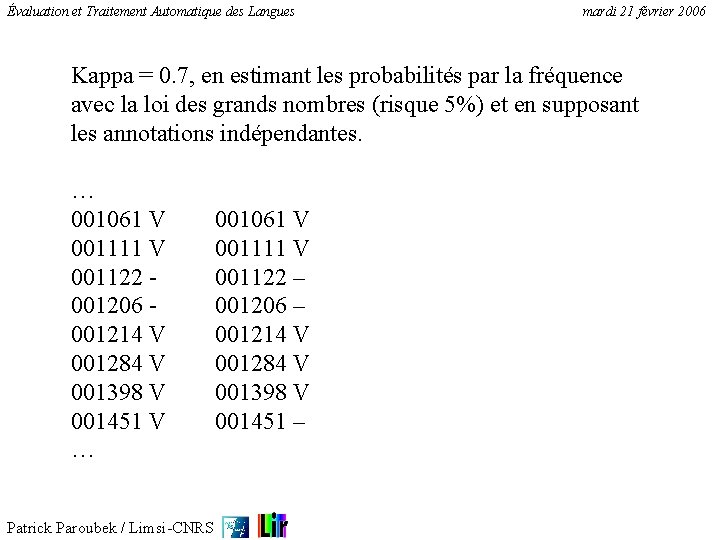
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Kappa = 0. 7, en estimant les probabilités par la fréquence avec la loi des grands nombres (risque 5%) et en supposant les annotations indépendantes. … 001061 V 001111 V 001122 001206 001214 V 001284 V 001398 V 001451 V … Patrick Paroubek / Limsi-CNRS 001061 V 001111 V 001122 – 001206 – 001214 V 001284 V 001398 V 001451 –
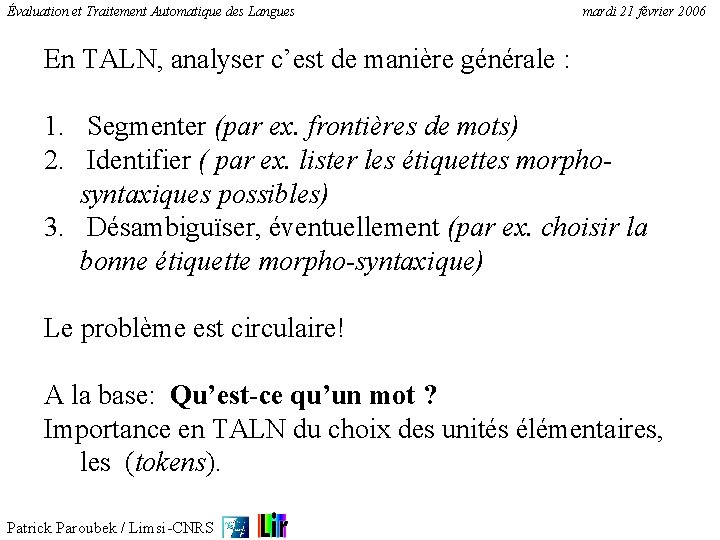
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 En TALN, analyser c’est de manière générale : 1. Segmenter (par ex. frontières de mots) 2. Identifier ( par ex. lister les étiquettes morphosyntaxiques possibles) 3. Désambiguïser, éventuellement (par ex. choisir la bonne étiquette morpho-syntaxique) Le problème est circulaire! A la base: Qu’est-ce qu’un mot ? Importance en TALN du choix des unités élémentaires, les (tokens). Patrick Paroubek / Limsi-CNRS
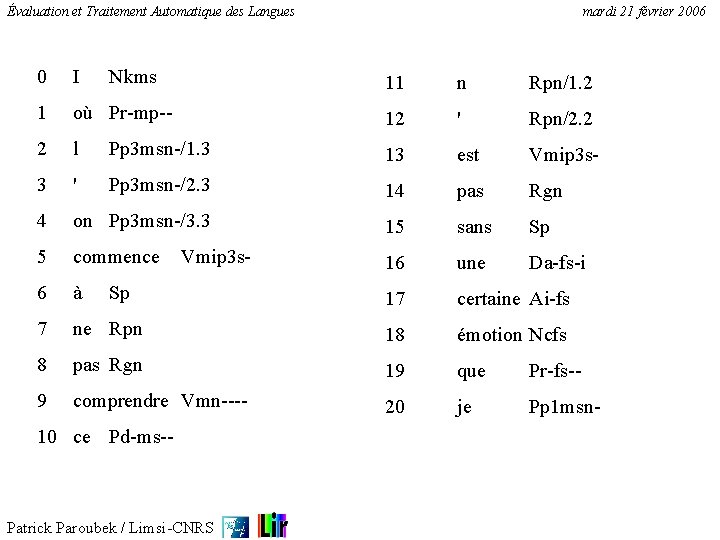
Évaluation et Traitement Automatique des Langues 0 I 1 Nkms mardi 21 février 2006 11 n Rpn/1. 2 où Pr-mp-- 12 ' Rpn/2. 2 2 l Pp 3 msn-/1. 3 13 est Vmip 3 s- 3 ' Pp 3 msn-/2. 3 14 pas Rgn 4 on Pp 3 msn-/3. 3 15 sans Sp 5 commence 16 une Da-fs-i 6 à 17 certaine Ai-fs 7 ne Rpn 18 émotion Ncfs 8 pas Rgn 19 que Pr-fs-- 9 comprendre Vmn---- 20 je Pp 1 msn- Vmip 3 s- Sp 10 ce Pd-ms-- Patrick Paroubek / Limsi-CNRS
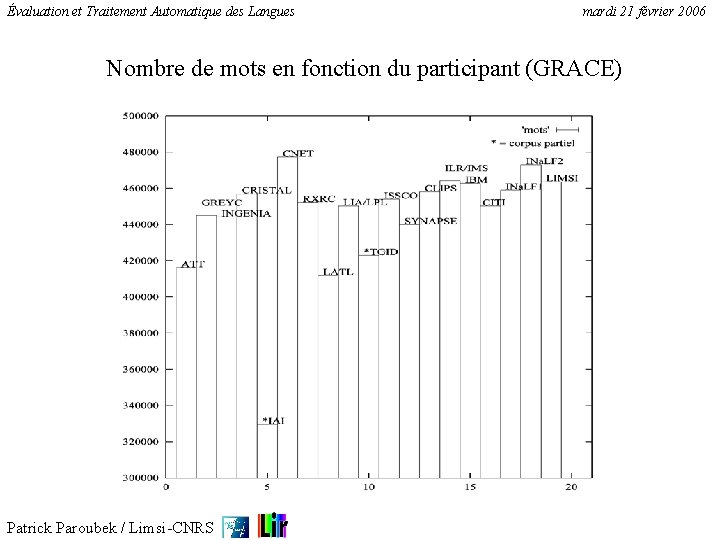
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Nombre de mots en fonction du participant (GRACE) Patrick Paroubek / Limsi-CNRS
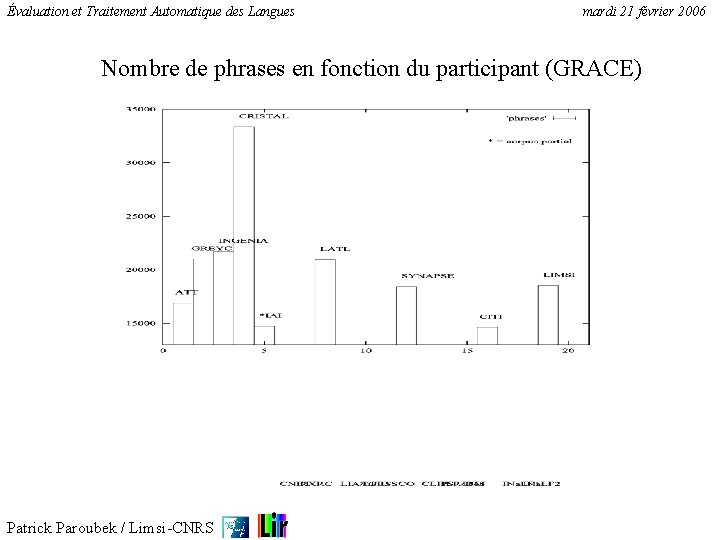
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Nombre de phrases en fonction du participant (GRACE) Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Outil d’alignement acquis de l’évaluation de l’oral pour lequel beaucoup de travail a été fait sur la mesure fondamentale en transcription de parole, le taux d’erreur de transcription (Word Error Rate). La meilleur mesure (fidélité) : mesure du nombre d’insertions, de suppressions et de substitutions. [J. Makhoul and F. Kubala and R. Schwartz and R. Weischedel, Performance measures for information extraction, Proceedings of DARPA Broadcast News Workshop, 1999, Herndon, VA, February, http : //citeseer. ist. psu. edu/makhoul 99 performance. html] Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Cette mesure repose sur le réalignement des données produites par un système avec la transcription de référence au moyen de l’algorithme de Programmation Dynamique (réalignement optimal, minimum de distortions introduites) DP utilise une métrique de Levenshtein (ou distance d'édition de Seller) [allison 90] L. Allison and C. S. Wallace and C. N. Yee, When is a String Like a String? , Proceedings of International Symposium on Artificial Intelligence in Mathematics (AIM)}, 1990, Ft. Lauderdale, Florida, January, http : //www. csse. monash. edu. au/~lloyd/tilde. Strings/Alignment/90. AIM. html Patrick Paroubek / Limsi-CNRS
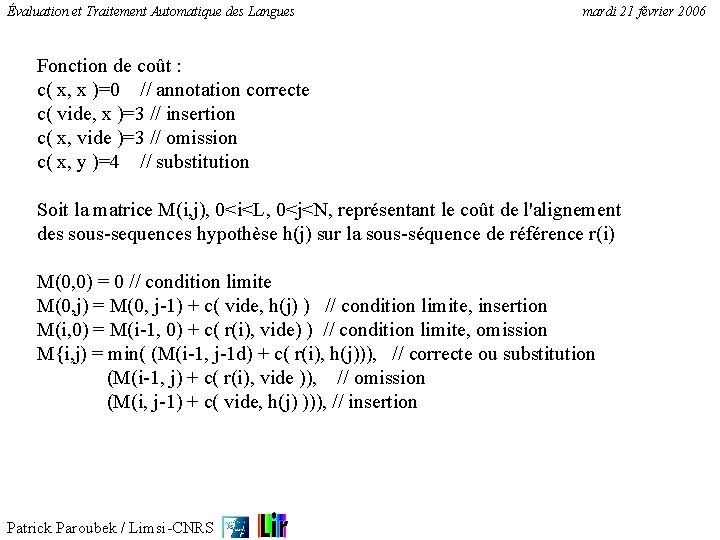
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Fonction de coût : c( x, x )=0 // annotation correcte c( vide, x )=3 // insertion c( x, vide )=3 // omission c( x, y )=4 // substitution Soit la matrice M(i, j), 0<i<L, 0<j<N, représentant le coût de l'alignement des sous-sequences hypothèse h(j) sur la sous-séquence de référence r(i) M(0, 0) = 0 // condition limite M(0, j) = M(0, j-1) + c( vide, h(j) ) // condition limite, insertion M(i, 0) = M(i-1, 0) + c( r(i), vide) ) // condition limite, omission M{i, j) = min( (M(i-1, j-1 d) + c( r(i), h(j))), // correcte ou substitution (M(i-1, j) + c( r(i), vide )), // omission (M(i, j-1) + c( vide, h(j) ))), // insertion Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 La somme des coûts d'une insertion (3) et d'une délétion (3) est supérieur au coût d'une substitution (4), on utilisera donc de préférence des substitution à la place de paires insertion-omission, qui seront présentes uniquement pour réaligner les deux flux de données. L'alignement est obtenu en identifiant dans la matrice M(i, j) le chemin de coût minimal, allant de M(L, N) à M(0, 0). Pour l'oral, le résultat de l'évaluation pour un tour de parole est donné par le décompte des nombres d'insertion, d'omission et de substitution, pondéré par le nombre de mots présents dans la référence. [Makhoul et al. 99] Patrick Paroubek / Limsi-CNRS
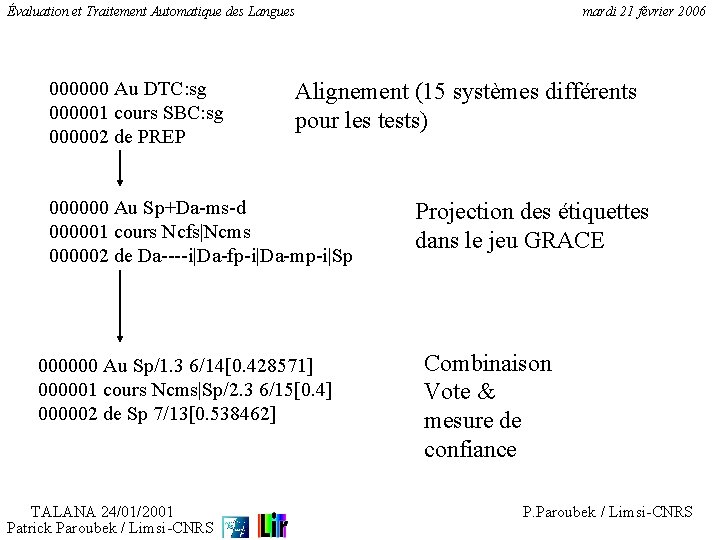
Évaluation et Traitement Automatique des Langues 000000 Au DTC: sg 000001 cours SBC: sg 000002 de PREP Alignement (15 systèmes différents pour les tests) 000000 Au Sp+Da-ms-d 000001 cours Ncfs|Ncms 000002 de Da----i|Da-fp-i|Da-mp-i|Sp 000000 Au Sp/1. 3 6/14[0. 428571] 000001 cours Ncms|Sp/2. 3 6/15[0. 4] 000002 de Sp 7/13[0. 538462] TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS mardi 21 février 2006 Projection des étiquettes dans le jeu GRACE Combinaison Vote & mesure de confiance P. Paroubek / Limsi-CNRS
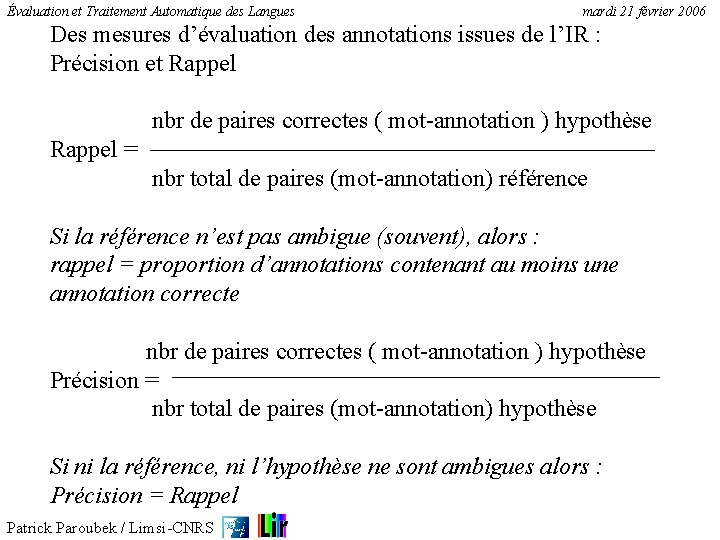
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Des mesures d’évaluation des annotations issues de l’IR : Précision et Rappel nbr de paires correctes ( mot-annotation ) hypothèse Rappel = nbr total de paires (mot-annotation) référence Si la référence n’est pas ambigue (souvent), alors : rappel = proportion d’annotations contenant au moins une annotation correcte nbr de paires correctes ( mot-annotation ) hypothèse Précision = nbr total de paires (mot-annotation) hypothèse Si ni la référence, ni l’hypothèse ne sont ambigues alors : Précision = Rappel Patrick Paroubek / Limsi-CNRS
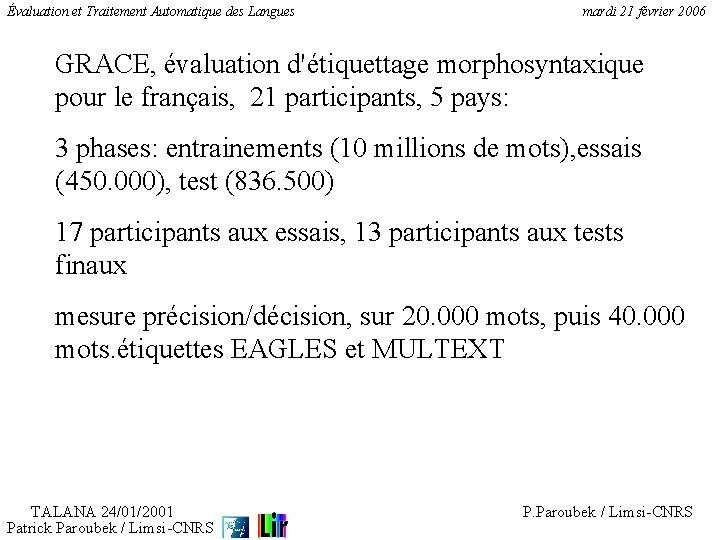
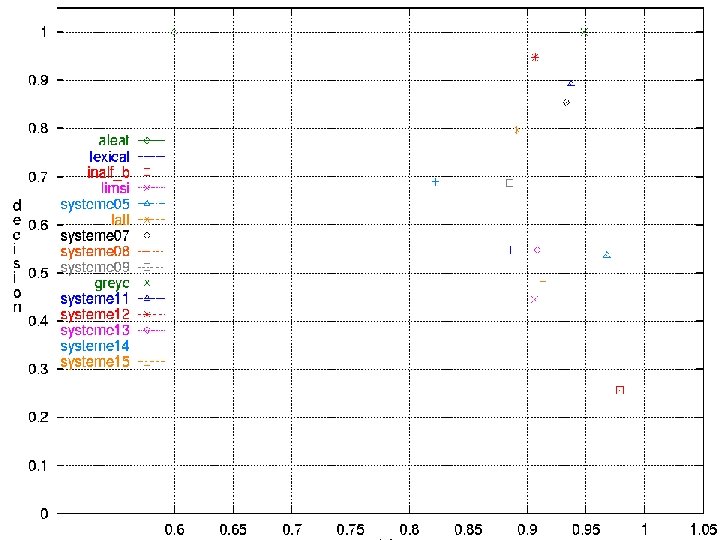
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 GRACE, évaluation d'étiquettage morphosyntaxique pour le français, 21 participants, 5 pays: 3 phases: entrainements (10 millions de mots), essais (450. 000), test (836. 500) 17 participants aux essais, 13 participants aux tests finaux mesure précision/décision, sur 20. 000 mots, puis 40. 000 mots. étiquettes EAGLES et MULTEXT TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS P. Paroubek / Limsi-CNRS
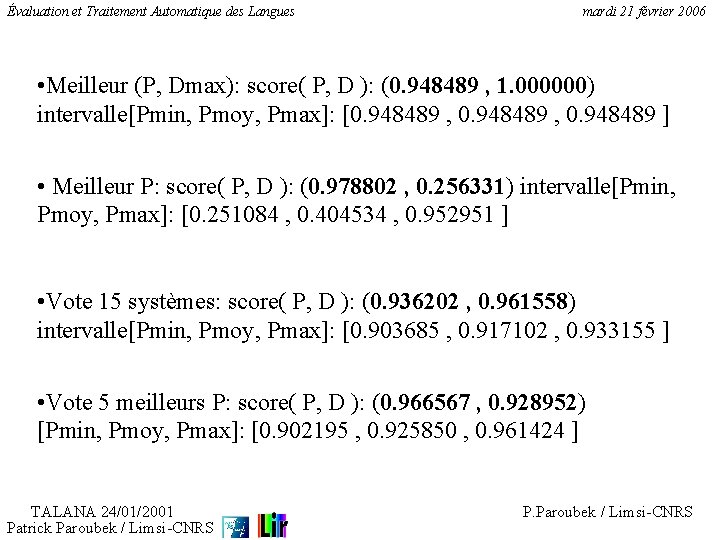
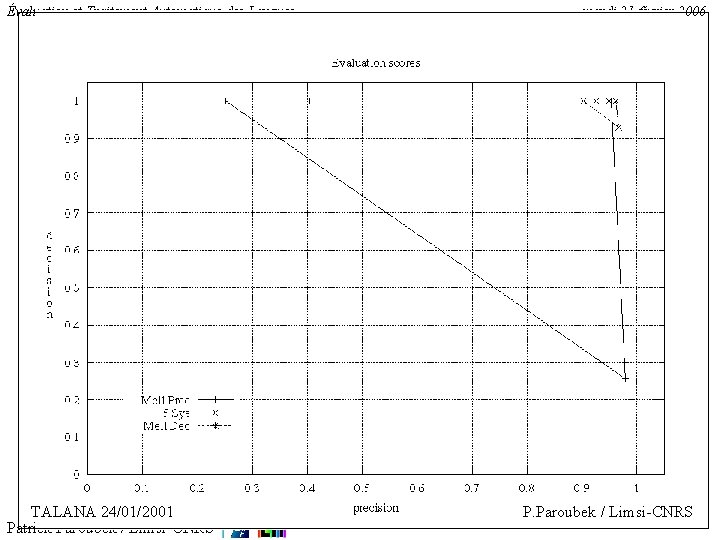
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 • Meilleur (P, Dmax): score( P, D ): (0. 948489 , 1. 000000) intervalle[Pmin, Pmoy, Pmax]: [0. 948489 , 0. 948489 ] • Meilleur P: score( P, D ): (0. 978802 , 0. 256331) intervalle[Pmin, Pmoy, Pmax]: [0. 251084 , 0. 404534 , 0. 952951 ] • Vote 15 systèmes: score( P, D ): (0. 936202 , 0. 961558) intervalle[Pmin, Pmoy, Pmax]: [0. 903685 , 0. 917102 , 0. 933155 ] • Vote 5 meilleurs P: score( P, D ): (0. 966567 , 0. 928952) [Pmin, Pmoy, Pmax]: [0. 902195 , 0. 925850 , 0. 961424 ] TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS P. Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS mardi 21 février 2006 P. Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues Annotation Morpho-syntaxique P. Paroubek / Limsi-CNRS Patrick Paroubek / Limsi-CNRS mardi 21 février 2006 27 / 03 / 01
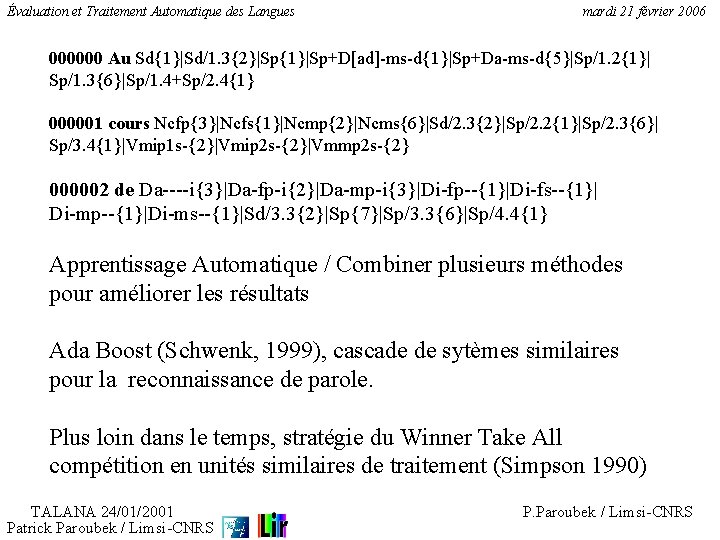
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 000000 Au Sd{1}|Sd/1. 3{2}|Sp{1}|Sp+D[ad]-ms-d{1}|Sp+Da-ms-d{5}|Sp/1. 2{1}| Sp/1. 3{6}|Sp/1. 4+Sp/2. 4{1} 000001 cours Ncfp{3}|Ncfs{1}|Ncmp{2}|Ncms{6}|Sd/2. 3{2}|Sp/2. 2{1}|Sp/2. 3{6}| Sp/3. 4{1}|Vmip 1 s-{2}|Vmip 2 s-{2}|Vmmp 2 s-{2} 000002 de Da----i{3}|Da-fp-i{2}|Da-mp-i{3}|Di-fp--{1}|Di-fs--{1}| Di-mp--{1}|Di-ms--{1}|Sd/3. 3{2}|Sp{7}|Sp/3. 3{6}|Sp/4. 4{1} Apprentissage Automatique / Combiner plusieurs méthodes pour améliorer les résultats Ada Boost (Schwenk, 1999), cascade de sytèmes similaires pour la reconnaissance de parole. Plus loin dans le temps, stratégie du Winner Take All compétition en unités similaires de traitement (Simpson 1990) TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS P. Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Combiner pour améliorer NIST, reconnaissance de la parole ROVER - Recognizer Output Voting Error Reduction (Fiscus 1997) Sytème composite, meilleur performance que le meilleur des systèmes. Graphe de mot (alignement), vote à majorité (pondéré par la fréquence maximale d'occurence et un score de confiance). Réduction d'erreur mesurée par Fiscus: 5, 6 % en absolu (et 12, 5% en relatif). Principe de combinaison de systèmes utilisé par Marquez & Prado 1998 (combinaison de 2 étiquetteurs pour marquer un corpus) Tufis 1999 (plusieurs versions du même système entraîné sur des données différentes) TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS P. Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Phase 1: 38643 formes (4 % des 836500 formes) relues pour la catégorie et la sous-catégorie Phase 2: 64061 formes (8 % des 836500 formes) relues pour les indications de genre, nombre et personne Validation: selection aléatoire de 511 formes, 53 formes identifiées commes douteuses (pas de décision de vote); 27 d'entres elles n'étaient pas correctement étiquettées (erreur de relecture, ou erreur ou ambiguité résiduelle; traits autres que G, N, P), c. a. d. env. 50 % (+-13% avec risque 95%) Inversement sur 458 formes qui n'étaient pas à relire, seules 10 étaient mal étiquettées, ce qui représente un taux d'erreur résiduelle de 2, 18% (+-1. 34% avec risque 95%) TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS P. Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 CONCLUSION La campagne GRACE et l'expérience MULTITAG ont prouvé que le paradigme d'évaluation peut servir à produire de manière économique des ressources linguistiques validées de qualité. La généralisation à d'autre tâches de contrôle permet d'augmenter rapidement la quantité de données annotées et validées tout en permettant de déployer le paradigme d'évaluation plus avant. TALANA 24/01/2001 Patrick Paroubek / Limsi-CNRS P. Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues 1. La campagne EASY 2. Annotations pour l’analyse syntaxique 3. Les données 4. Les résultats préliminiaires Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Objectif: évaluation d’analyse syntaxique 5 fournis. corpus, 13 participants, 16 systèmes évalués • France Telcom R&D • XEROX • GREYC • LPL (1, 2 & 3) • INRIA (ATOLL 1, 2) • PERTIMM • LATL • SYNAPSE • LIC 2 M • ERSS • LIRMM • TAGMATICA • LORIA Patrick Paroubek / Limsi-CNRS
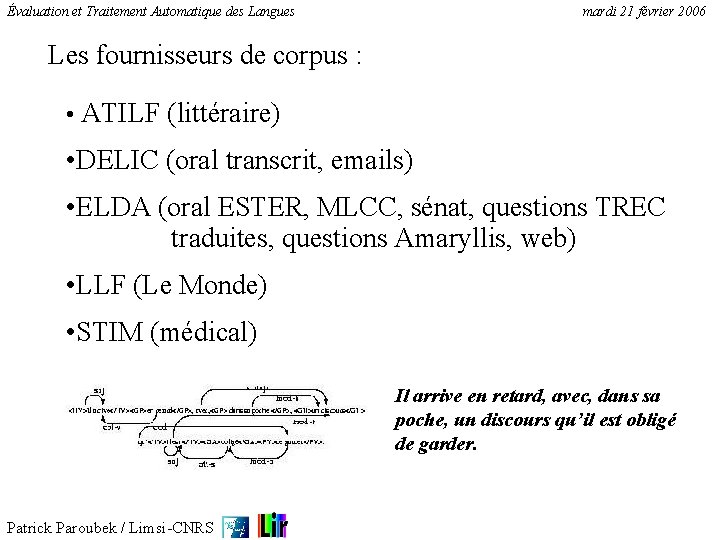
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Les fournisseurs de corpus : • ATILF (littéraire) • DELIC (oral transcrit, emails) • ELDA (oral ESTER, MLCC, sénat, questions TREC traduites, questions Amaryllis, web) • LLF (Le Monde) • STIM (médical) Il arrive en retard, avec, dans sa poche, un discours qu’il est obligé de garder. Patrick Paroubek / Limsi-CNRS
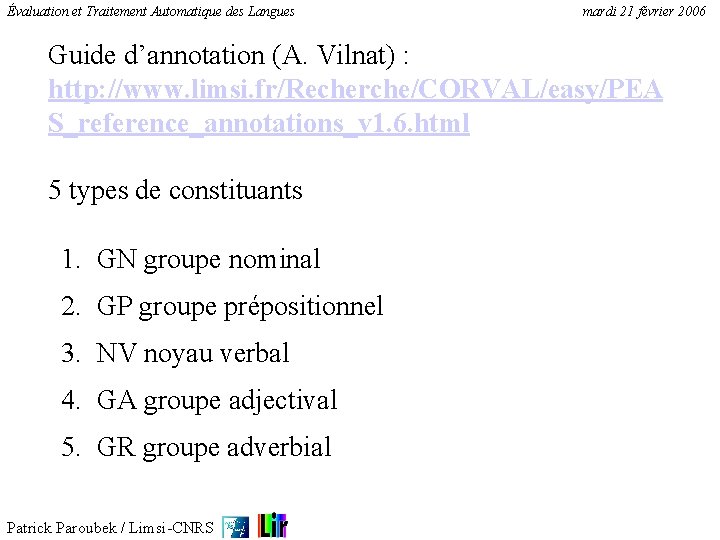
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Guide d’annotation (A. Vilnat) : http: //www. limsi. fr/Recherche/CORVAL/easy/PEA S_reference_annotations_v 1. 6. html 5 types de constituants 1. GN groupe nominal 2. GP groupe prépositionnel 3. NV noyau verbal 4. GA groupe adjectival 5. GR groupe adverbial Patrick Paroubek / Limsi-CNRS
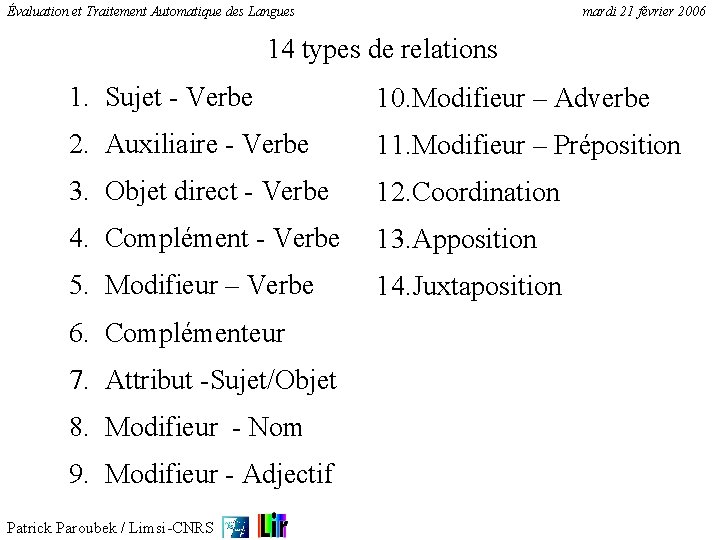
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 14 types de relations 1. Sujet - Verbe 10. Modifieur – Adverbe 2. Auxiliaire - Verbe 11. Modifieur – Préposition 3. Objet direct - Verbe 12. Coordination 4. Complément - Verbe 13. Apposition 5. Modifieur – Verbe 14. Juxtaposition 6. Complémenteur 7. Attribut -Sujet/Objet 8. Modifieur - Nom 9. Modifieur - Adjectif Patrick Paroubek / Limsi-CNRS
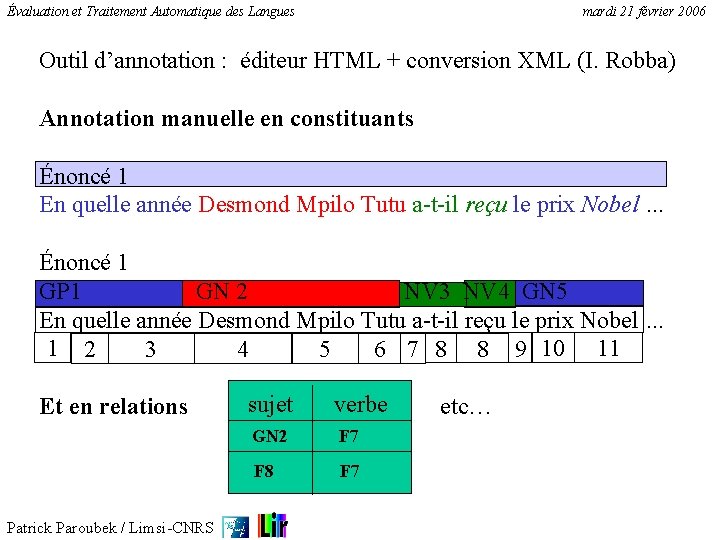
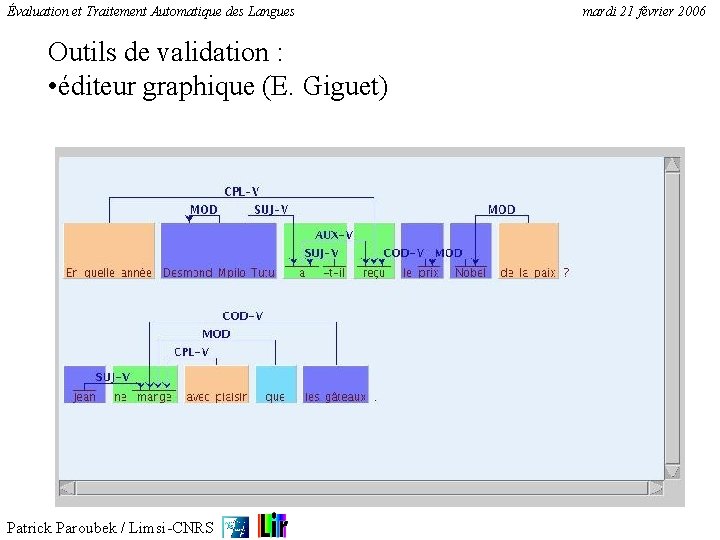
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Outil d’annotation : éditeur HTML + conversion XML (I. Robba) Annotation manuelle en constituants Énoncé 1 En quelle année Desmond Mpilo Tutu a-t-il reçu le prix Nobel … Énoncé 1 GP 1 GN 2 NV 3 NV 4 GN 5 En quelle année Desmond Mpilo Tutu a-t-il reçu le prix Nobel … 1 2 4 6 7 8 8 9 10 11 3 5 sujet verbe Et en relations etc… Patrick Paroubek / Limsi-CNRS GN 2 F 7 F 8 F 7
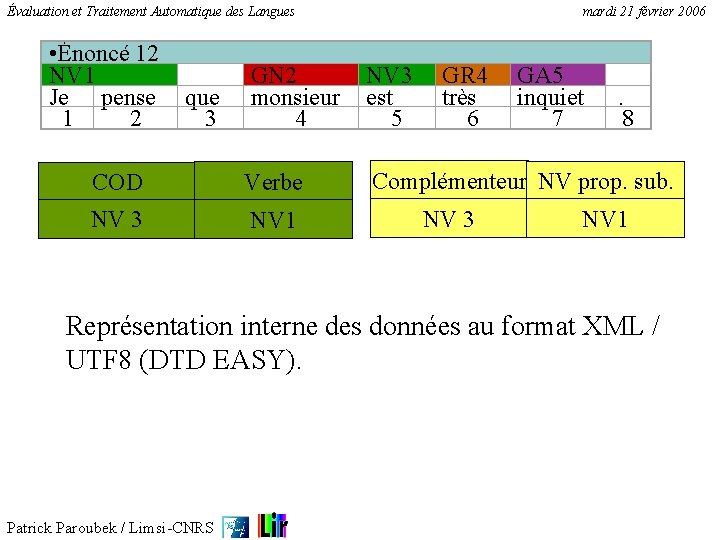
Évaluation et Traitement Automatique des Langues • Énoncé 12 NV 1 Je pense 1 2 mardi 21 février 2006 GN 2 monsieur 4 NV 3 est 5 COD Verbe Complémenteur NV prop. sub. NV 3 NV 1 que 3 GR 4 très 6 NV 3 GA 5 inquiet 7 . 8 NV 1 Représentation interne des données au format XML / UTF 8 (DTD EASY). Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues Outils de validation : • éditeur graphique (E. Giguet) Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
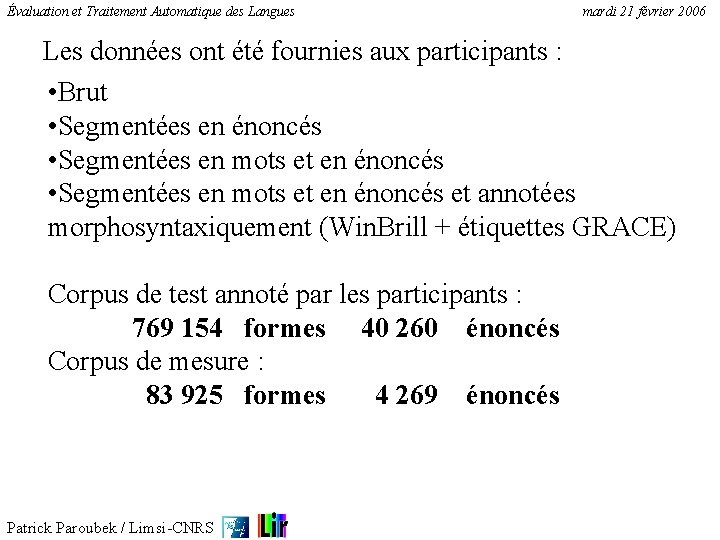
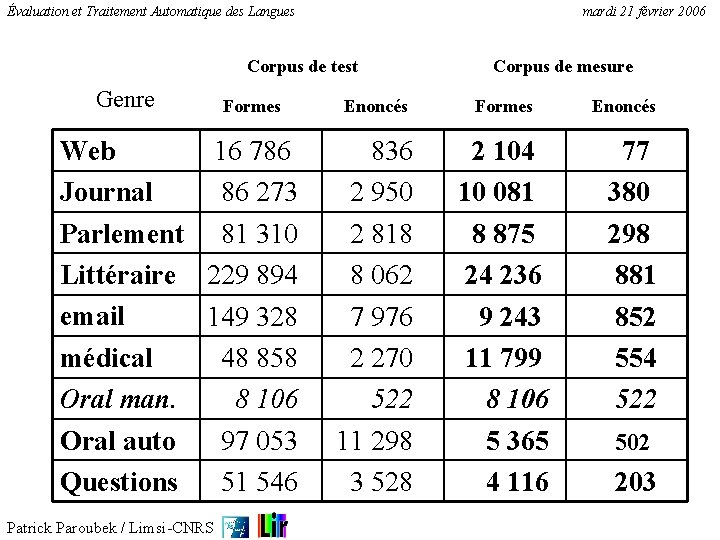
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Les données ont été fournies aux participants : • Brut • Segmentées en énoncés • Segmentées en mots et en énoncés et annotées morphosyntaxiquement (Win. Brill + étiquettes GRACE) Corpus de test annoté par les participants : 769 154 formes 40 260 énoncés Corpus de mesure : 83 925 formes 4 269 énoncés Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Corpus de test Corpus de mesure Genre Web Journal Parlement Littéraire email médical Oral man. Oral auto Questions Formes Enoncés 16 786 86 273 81 310 229 894 149 328 48 858 8 106 97 053 51 546 Patrick Paroubek / Limsi-CNRS 836 2 950 2 818 8 062 7 976 2 270 522 11 298 3 528 2 104 10 081 8 875 24 236 9 243 11 799 8 106 5 365 4 116 77 380 298 881 852 554 522 502 203
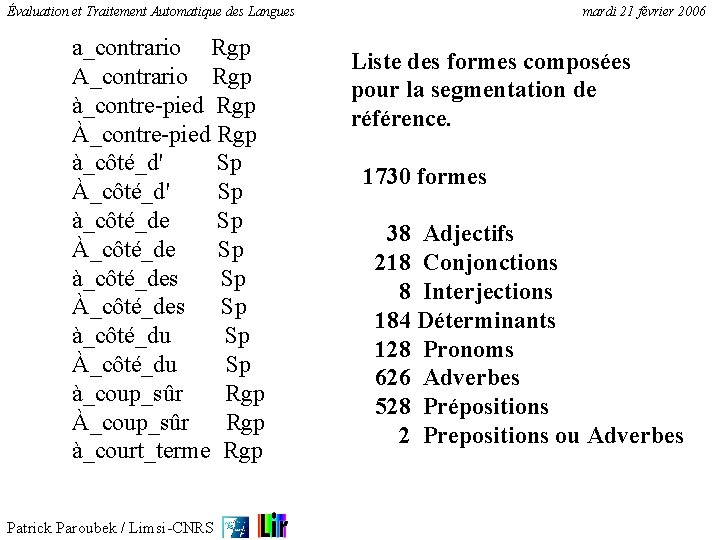
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Les énoncés sont définis à partir de la typographie au moyen d’expressions régulières. Les formes sont définies avec ces mêmes expressions et avec une liste pour les formes composées (non nominales). Les données DELIC ont été segmentées en énoncé manuellement (manque de ponctuation). Toutes les autres données ont été segmentées automatiquement avec les outils EASY Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues a_contrario Rgp A_contrario Rgp à_contre-pied Rgp À_contre-pied Rgp à_côté_d' Sp À_côté_d' Sp à_côté_de Sp À_côté_de Sp à_côté_des Sp À_côté_des Sp à_côté_du Sp À_côté_du Sp à_coup_sûr Rgp À_coup_sûr Rgp à_court_terme Rgp Patrick Paroubek / Limsi-CNRS mardi 21 février 2006 Liste des formes composées pour la segmentation de référence. 1730 formes 38 Adjectifs 218 Conjonctions 8 Interjections 184 Déterminants 128 Pronoms 626 Adverbes 528 Prépositions 2 Prepositions ou Adverbes
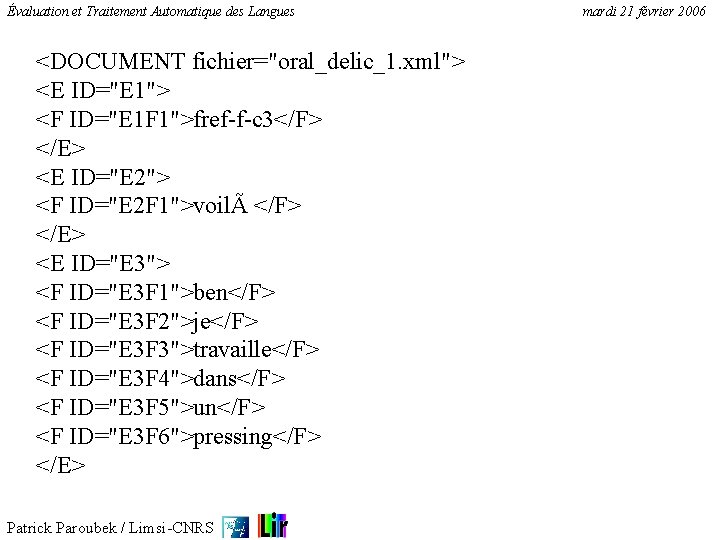
Évaluation et Traitement Automatique des Langues <DOCUMENT fichier="oral_delic_1. xml"> <E ID="E 1"> <F ID="E 1 F 1">fref-f-c 3</F> </E> <E ID="E 2"> <F ID="E 2 F 1">voilà </F> </E> <E ID="E 3"> <F ID="E 3 F 1">ben</F> <F ID="E 3 F 2">je</F> <F ID="E 3 F 3">travaille</F> <F ID="E 3 F 4">dans</F> <F ID="E 3 F 5">un</F> <F ID="E 3 F 6">pressing</F> </E> Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
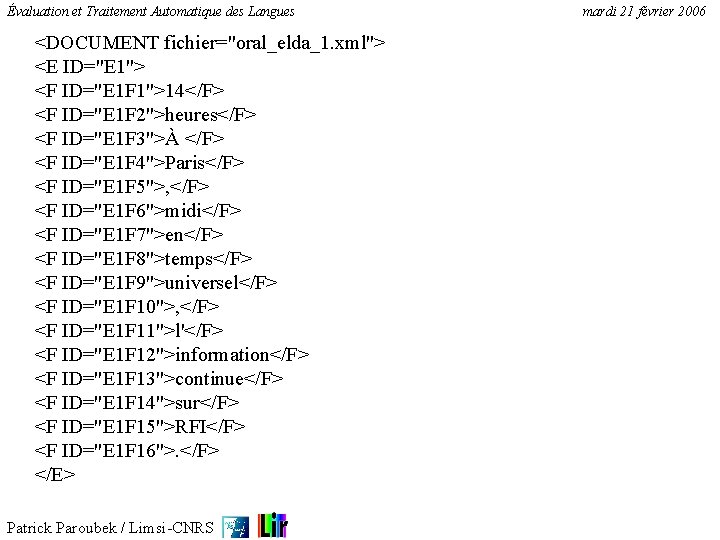
Évaluation et Traitement Automatique des Langues <DOCUMENT fichier="oral_elda_1. xml"> <E ID="E 1"> <F ID="E 1 F 1">14</F> <F ID="E 1 F 2">heures</F> <F ID="E 1 F 3">À </F> <F ID="E 1 F 4">Paris</F> <F ID="E 1 F 5">, </F> <F ID="E 1 F 6">midi</F> <F ID="E 1 F 7">en</F> <F ID="E 1 F 8">temps</F> <F ID="E 1 F 9">universel</F> <F ID="E 1 F 10">, </F> <F ID="E 1 F 11">l'</F> <F ID="E 1 F 12">information</F> <F ID="E 1 F 13">continue</F> <F ID="E 1 F 14">sur</F> <F ID="E 1 F 15">RFI</F> <F ID="E 1 F 16">. </F> </E> Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
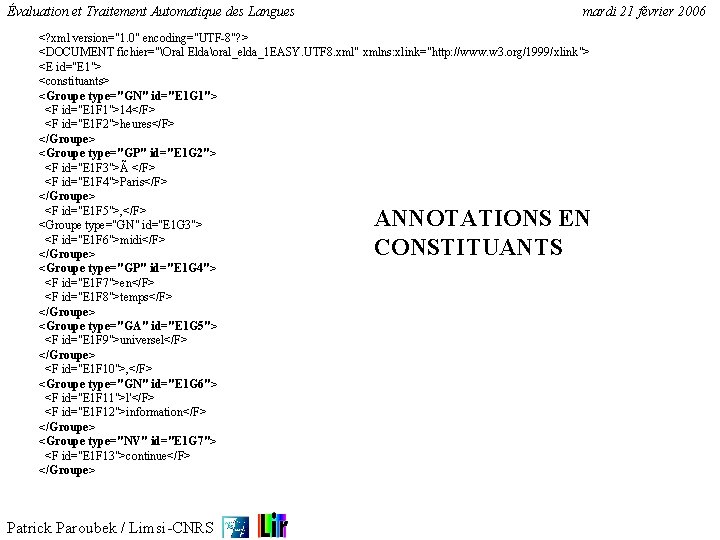
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 <? xml version="1. 0" encoding="UTF-8"? > <DOCUMENT fichier="Oral Eldaoral_elda_1 EASY. UTF 8. xml" xmlns: xlink="http: //www. w 3. org/1999/xlink"> <E id="E 1"> <constituants> <Groupe type="GN" id="E 1 G 1"> <F id="E 1 F 1">14</F> <F id="E 1 F 2">heures</F> </Groupe> <Groupe type="GP" id="E 1 G 2"> <F id="E 1 F 3">Ã </F> <F id="E 1 F 4">Paris</F> </Groupe> <F id="E 1 F 5">, </F> <Groupe type="GN" id="E 1 G 3"> <F id="E 1 F 6">midi</F> </Groupe> <Groupe type="GP" id="E 1 G 4"> <F id="E 1 F 7">en</F> <F id="E 1 F 8">temps</F> </Groupe> <Groupe type="GA" id="E 1 G 5"> <F id="E 1 F 9">universel</F> </Groupe> <F id="E 1 F 10">, </F> <Groupe type="GN" id="E 1 G 6"> <F id="E 1 F 11">l'</F> <F id="E 1 F 12">information</F> </Groupe> <Groupe type="NV" id="E 1 G 7"> <F id="E 1 F 13">continue</F> </Groupe> ANNOTATIONS EN CONSTITUANTS Patrick Paroubek / Limsi-CNRS
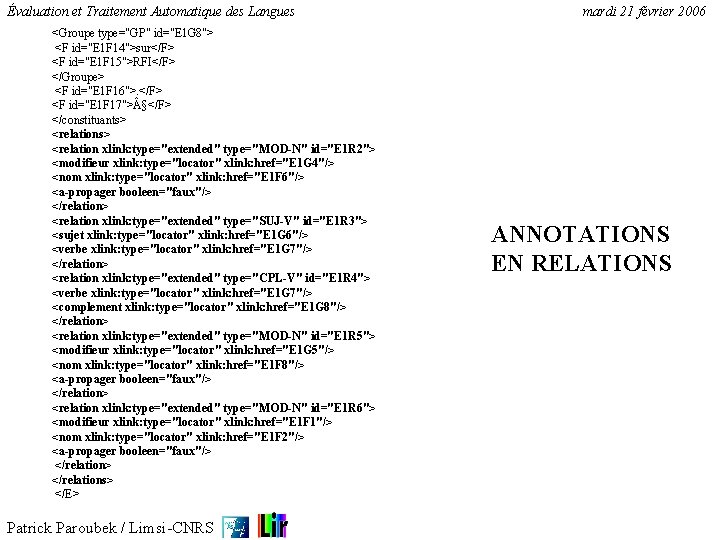
Évaluation et Traitement Automatique des Langues <Groupe type="GP" id="E 1 G 8"> <F id="E 1 F 14">sur</F> <F id="E 1 F 15">RFI</F> </Groupe> <F id="E 1 F 16">. </F> <F id="E 1 F 17"> §</F> </constituants> <relation xlink: type="extended" type="MOD-N" id="E 1 R 2"> <modifieur xlink: type="locator" xlink: href="E 1 G 4"/> <nom xlink: type="locator" xlink: href="E 1 F 6"/> <a-propager booleen="faux"/> </relation> <relation xlink: type="extended" type="SUJ-V" id="E 1 R 3"> <sujet xlink: type="locator" xlink: href="E 1 G 6"/> <verbe xlink: type="locator" xlink: href="E 1 G 7"/> </relation> <relation xlink: type="extended" type="CPL-V" id="E 1 R 4"> <verbe xlink: type="locator" xlink: href="E 1 G 7"/> <complement xlink: type="locator" xlink: href="E 1 G 8"/> </relation> <relation xlink: type="extended" type="MOD-N" id="E 1 R 5"> <modifieur xlink: type="locator" xlink: href="E 1 G 5"/> <nom xlink: type="locator" xlink: href="E 1 F 8"/> <a-propager booleen="faux"/> </relation> <relation xlink: type="extended" type="MOD-N" id="E 1 R 6"> <modifieur xlink: type="locator" xlink: href="E 1 F 1"/> <nom xlink: type="locator" xlink: href="E 1 F 2"/> <a-propager booleen="faux"/> </relations> </E> Patrick Paroubek / Limsi-CNRS mardi 21 février 2006 ANNOTATIONS EN RELATIONS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Mesures de précision et rappel : • participant, • type de constituant, • par type de corpus. Mesures strictes (égalité stricte des adresses) et relachement de contrainte sur les adresses de début et de fin de groupes (+/-1). Pour les relations, sugérnération pour certaines relation de la référence (modifieur nom-adjectif intra groupe). Patrick Paroubek / Limsi-CNRS
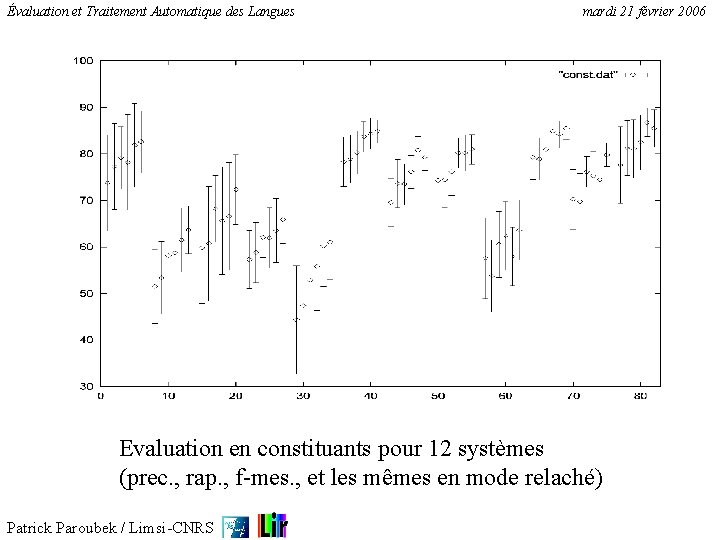
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Evaluation en constituants pour 12 systèmes (prec. , rap. , f-mes. , et les mêmes en mode relaché) Patrick Paroubek / Limsi-CNRS
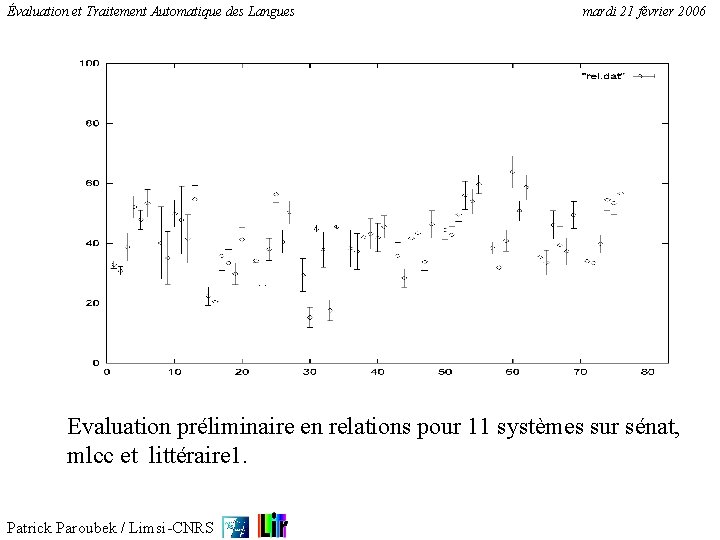
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Evaluation préliminaire en relations pour 11 systèmes sur sénat, mlcc et littéraire 1. Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues 5. Les systèmes de dialogue Patrick Paroubek / Limsi-CNRS mardi 21 février 2006
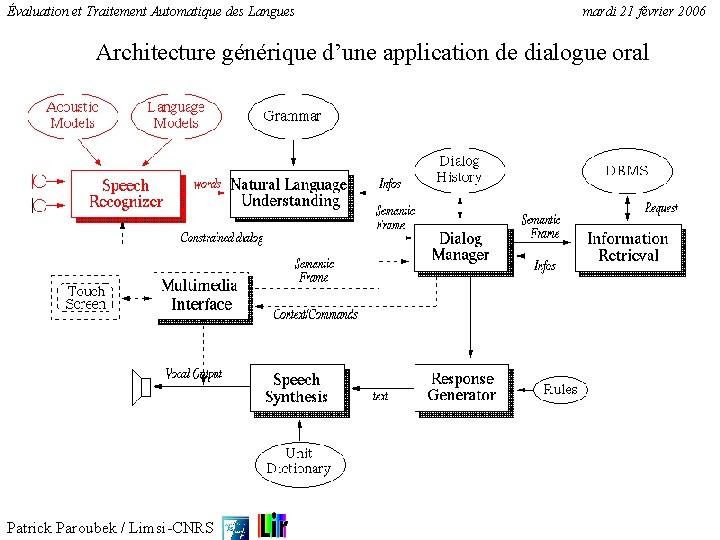
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Pour les systèmes de dialogue oral (SLDS), 2 points essentiels: -évaluation de possible sous de nombreux aspects ( variété des fonctionalités/module, cf figure suivante) - problème : comment décorréler les facteurs humains (ergonomie) et les aspects propres à l’application réalisée (ex. réservation) de ceux liés au traitement du dialogue proprement dit Patrick Paroubek / Limsi-CNRS
Évaluation et Traitement Automatique des Langues mardi 21 février 2006 Architecture générique d’une application de dialogue oral Patrick Paroubek / Limsi-CNRS