ARQUIVOS INDEXADOS POR CHAVES SECUNDRIAS 1 CONCEITO Na
- Slides: 68
ARQUIVOS INDEXADOS POR CHAVES SECUNDÁRIAS 1
CONCEITO Na maioria das organizações de arquivos, dada uma chave primária, recupera-se um registro. No processamento com chaves múltiplas, procura-se recuperar todos os registros, que possuam uma particular combinação de valores de atributos. Podem ocorrer vários registros com o mesmo valor de atributo (chave secundária). Um índice secundário indica uma lista de registros que possuem um dado valor de chave secundária. Estes índices permitem a consulta combinada utilizando interseção e união de conjuntos de listas. 2
CONCEITO (cont) Índices secundários permitem rápida recuperação de registros com certo valor de atributo. Contudo, índices ocupam espaços e exigem grande esforço de atualização. Deve-se estudar, caso a caso, a conveniência de adoção de índices secundários. 3
Arquivos com Listas Considere-se a associação de um ponteiro a cada chave secundária indexada. O ponteiro indica o próximo registro com o mesmo valor de chave secundária. O arquivo é "atravessado" por um grande número de listas, teias ou costuras. 4
Arquivos com Listas (cont. ) O índice para um atributo contém uma entrada para cada valor desse atributo que ocorre no arquivo. Cada entrada do índice funciona como cabeça da lista, apontando um registro com esse valor de atributo 5
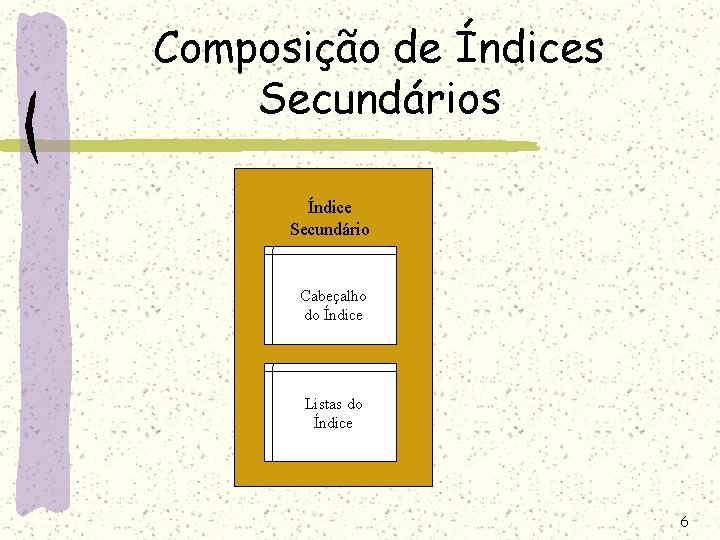
Composição de Índices Secundários Índice Secundário Cabeçalho do Índice Listas do Índice 6
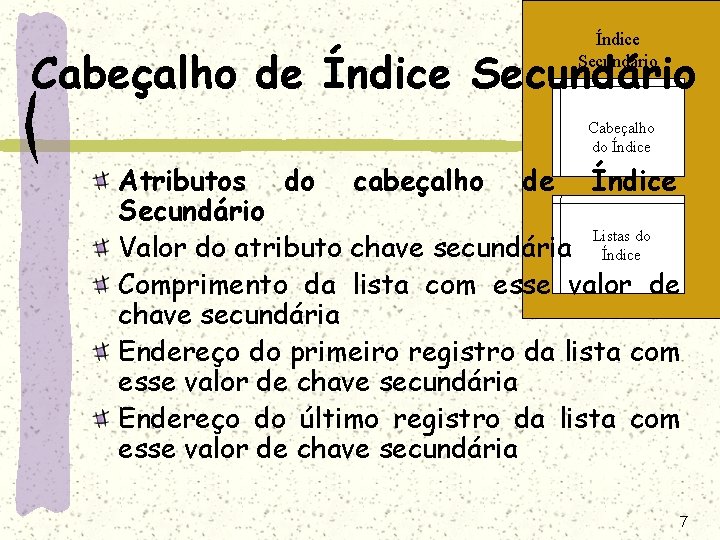
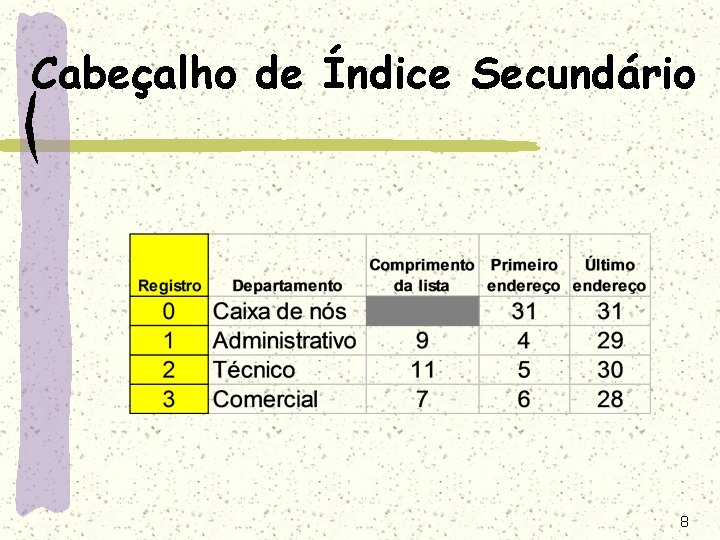
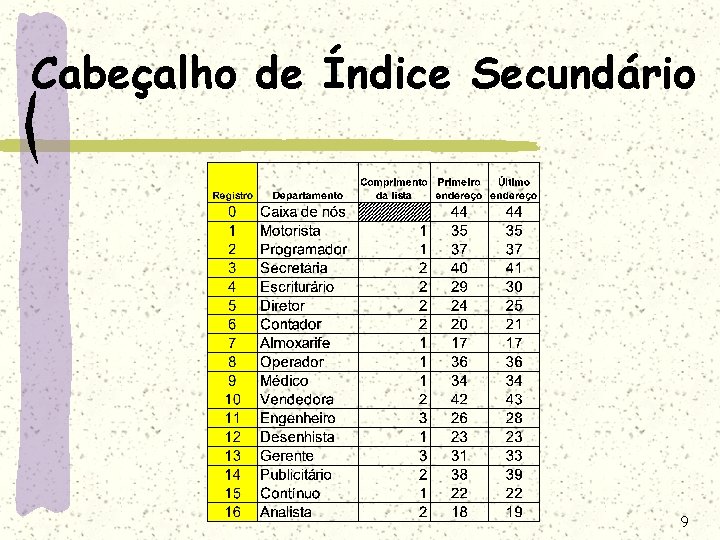
Índice Secundário Cabeçalho de Índice Secundário Cabeçalho do Índice Atributos do cabeçalho de Índice Secundário Listas do Valor do atributo chave secundária Índice Comprimento da lista com esse valor de chave secundária Endereço do primeiro registro da lista com esse valor de chave secundária Endereço do último registro da lista com esse valor de chave secundária 7
Cabeçalho de Índice Secundário 8
Cabeçalho de Índice Secundário 9
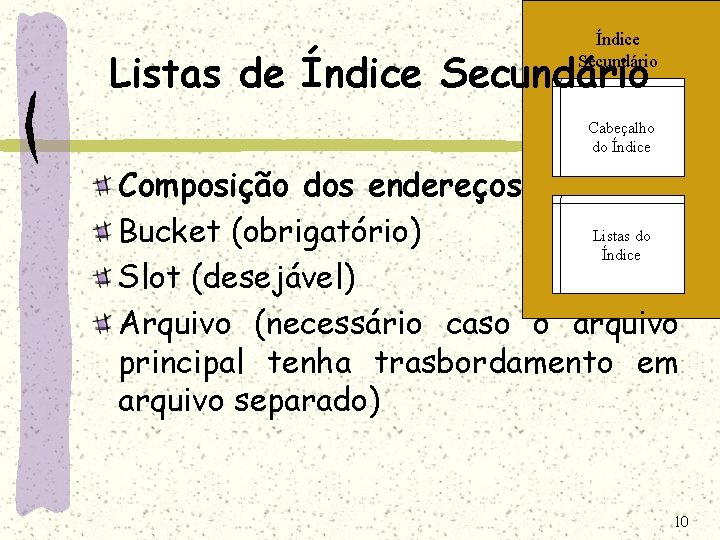
Índice Secundário Listas de Índice Secundário Cabeçalho do Índice Composição dos endereços Listas do Bucket (obrigatório) Índice Slot (desejável) Arquivo (necessário caso o arquivo principal tenha trasbordamento em arquivo separado) 10
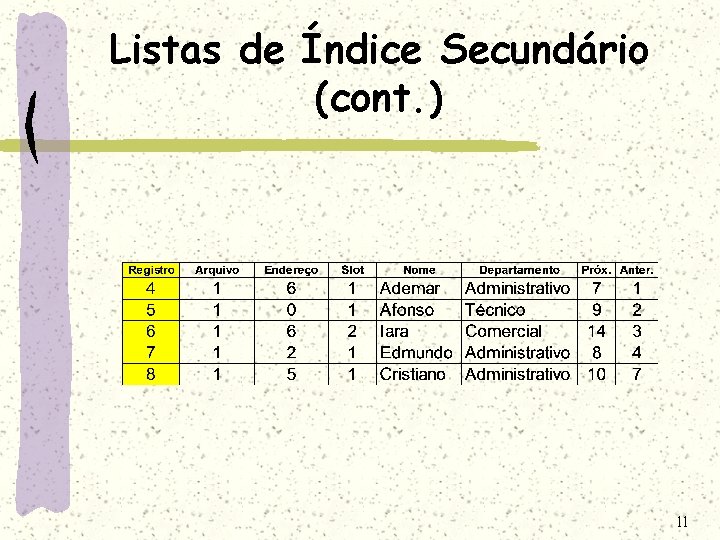
Listas de Índice Secundário (cont. ) 11
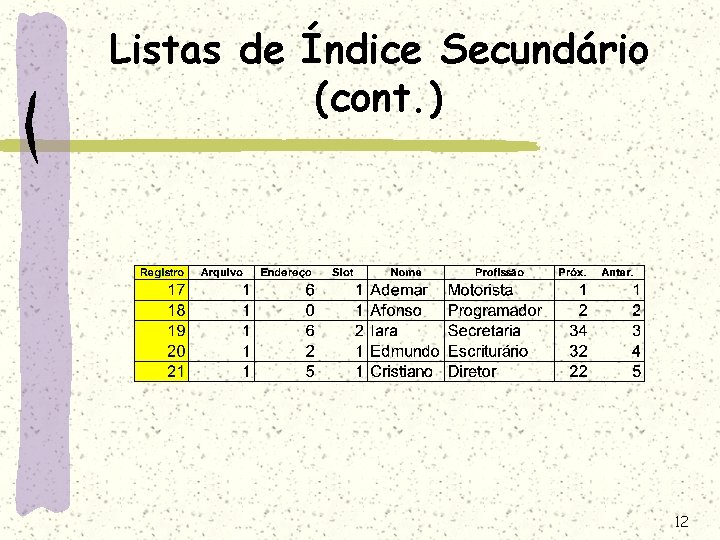
Listas de Índice Secundário (cont. ) 12
Exemplo Um arquivo de produtos de "software" contendo os atributos fornecedor, nome do produto, tipo, plataforma de utilização cuja chave primária é nome do produto, deve ser indexado pela chave secundária fornecedor. Solicitase exibir a configuração do arquivo e do respectivo índice. 13
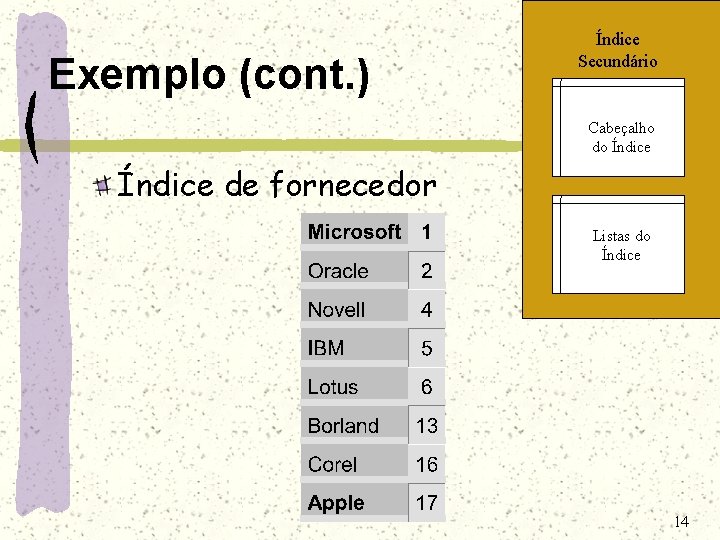
Exemplo (cont. ) Índice Secundário Cabeçalho do Índice de fornecedor Listas do Índice 14
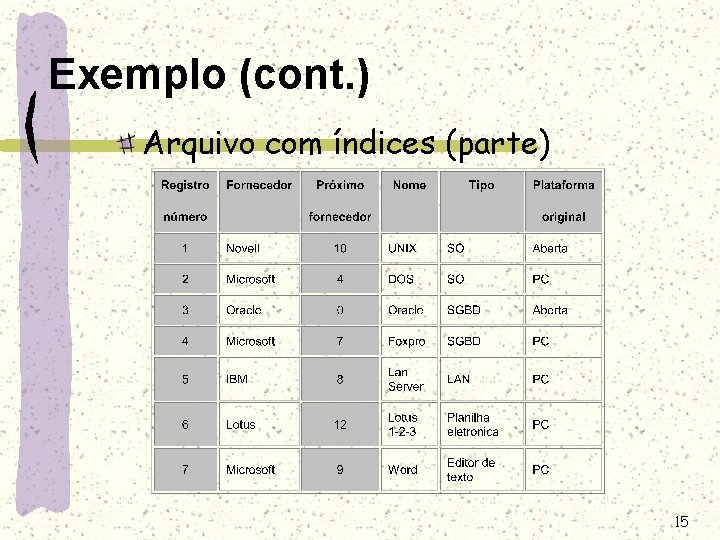
Exemplo (cont. ) Arquivo com índices (parte) 15
Tipos de Arquivos com Índices Secundários Arquivos Multilistas Arquivos Invertidos 16
Arquivos Multilistas 17
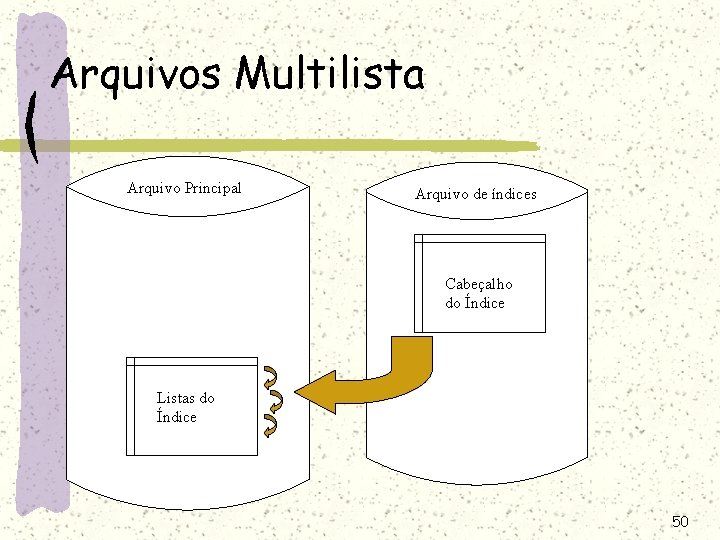
Arquivos Multilistas Nos arquivos com índice secundário a estrutura de índices possui uma entrada para o índice de uma lista no arquivo principal Pode-se considerar uma organização na qual a estrutura de índices contenha uma entrada para cada í-ésimo registro da lista com o mesmo valor de atributo. Diz-se que esta organização é uma organização multilista de tamanho controlado, i, de lista. 18
Arquivos Multilista (cont. ) Os arquivos nos quais i = infinito são chamados simplesmente de "multilistas". Arquivos para os quais i = 1 são chamados invertidos. Os arquivos multilistas apresentam como vantagem a extrema simplicidade da estrutura de índices e como desvantagem o processamento lento e a inadequação para a aceitação de consultas complexas. 19
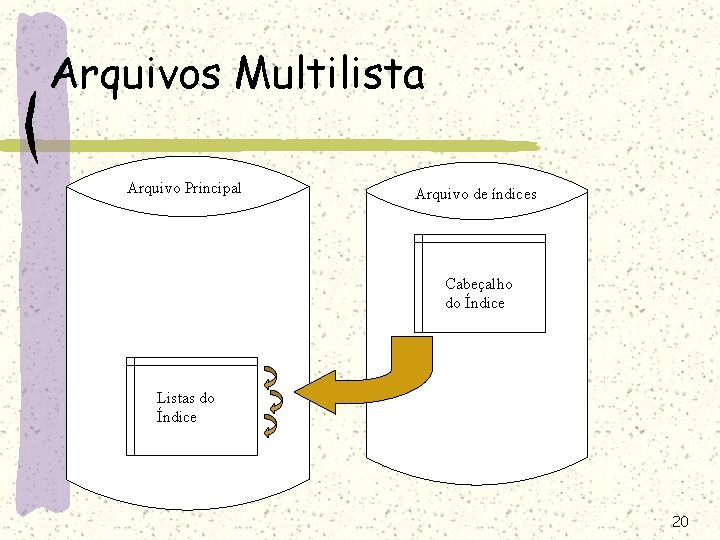
Arquivos Multilista Arquivo Principal Arquivo de índices Cabeçalho do Índice Listas do Índice 20
Listas de Índice Secundário Atributos do registro de Listas de Índice Secundário para Arquivos Multilista Endereço do próximo registro da lista com esse valor de chave secundária (no arquivo principal) Endereço do registro anterior da lista com esse valor de chave secundária (no arquivo principal) 21
Geração de Arquivo Multilista Arquivos multilistas são criados a partir de arquivos seqüenciais em um procedimento de seis passos O algoritmo a ser mostrado é creditado a Lefkowitz e utiliza a seguinte notação : ED = endereço de disco. Numeração dos registros em relação ao início do arquivo CP = chave primária dos registros do arquivo. CA = chave de acesso. Atributo chave secundária que criou o multilista. CL = comprimento de lista. Número de registros com o mesmo valor de chave de acesso. EC = endereço de cabeça. ED do primeiro registro com um dado valor de chave de acesso. INC = itens não chave. Atributos de registro que não influem no processamento de multilista. P = ponteiro para o sucessor na multilista da respectiva chave de acesso 22
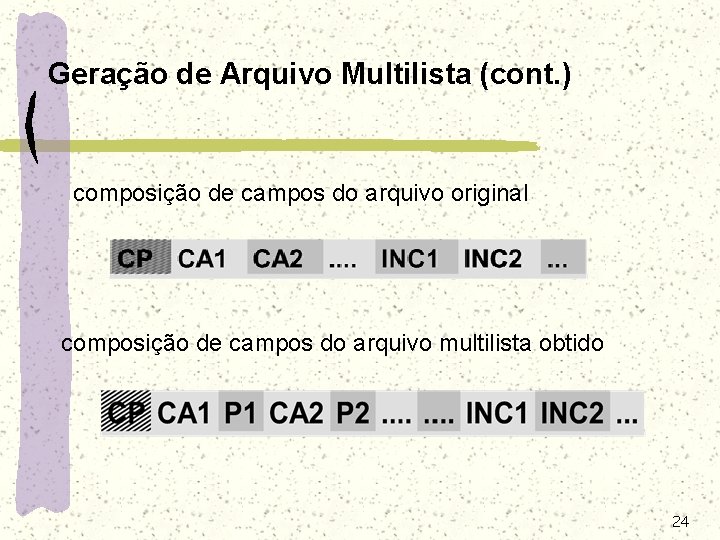
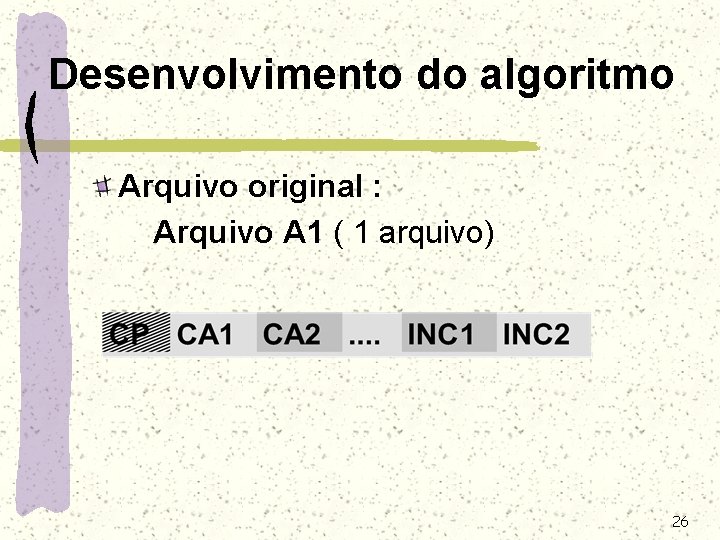
Geração de Arquivo Multilista (cont. ) Na hipótese de ocorrência de n atributos para os quais se quer multilistas são criados 4*n+1 arquivos temporários de trabalho, n arquivos de índices e um arquivo de saída. A composição de campos do arquivo original é a seguinte, lembrando que os campos sombreados são aqueles pelos quais o arquivo está classificado: 23
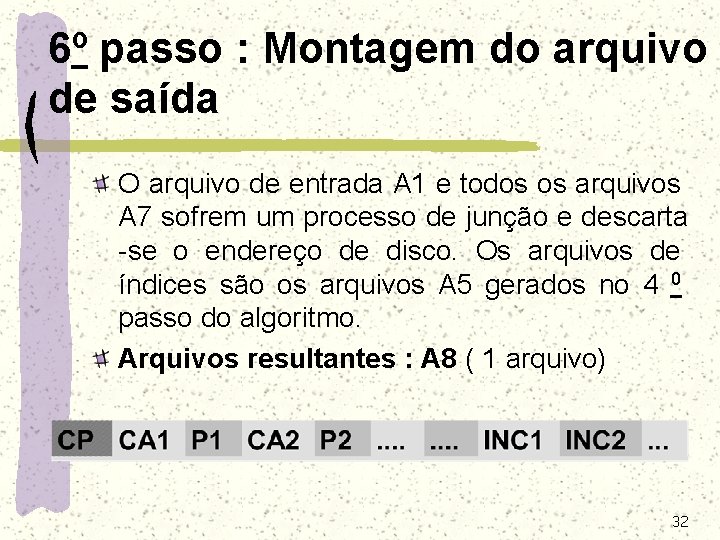
Geração de Arquivo Multilista (cont. ) composição de campos do arquivo original composição de campos do arquivo multilista obtido 24
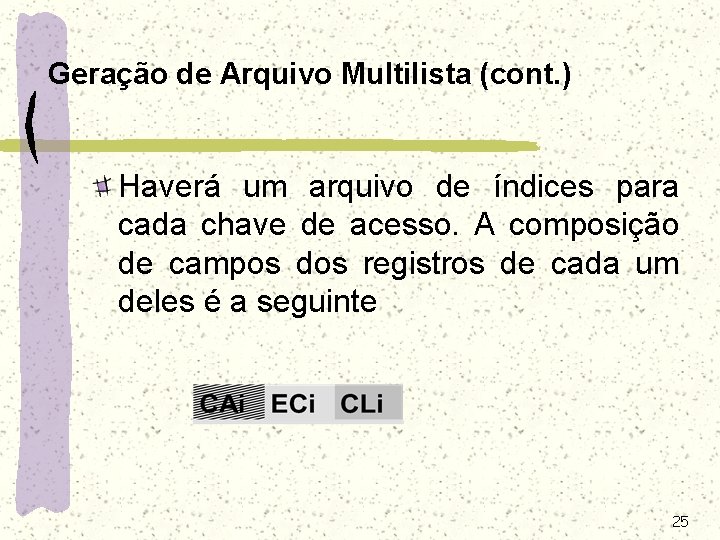
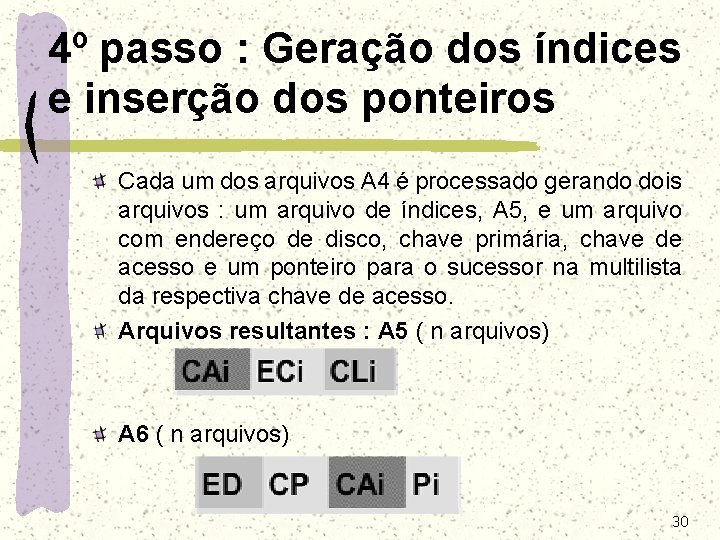
Geração de Arquivo Multilista (cont. ) Haverá um arquivo de índices para cada chave de acesso. A composição de campos dos registros de cada um deles é a seguinte 25
Desenvolvimento do algoritmo Arquivo original : Arquivo A 1 ( 1 arquivo) 26
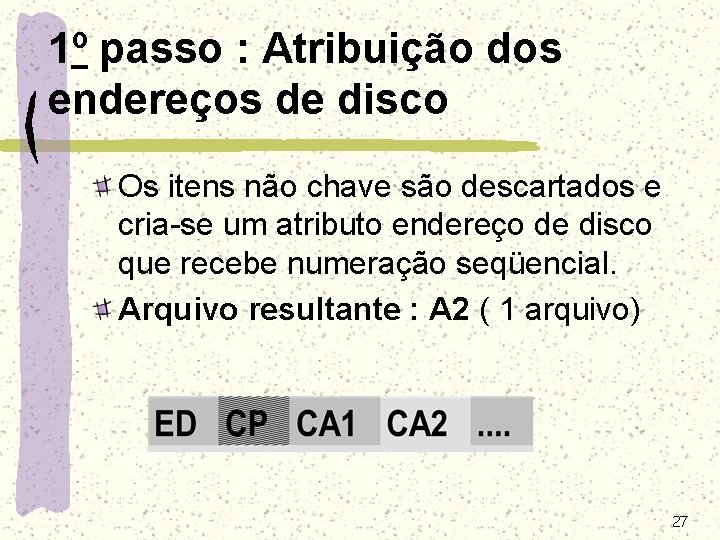
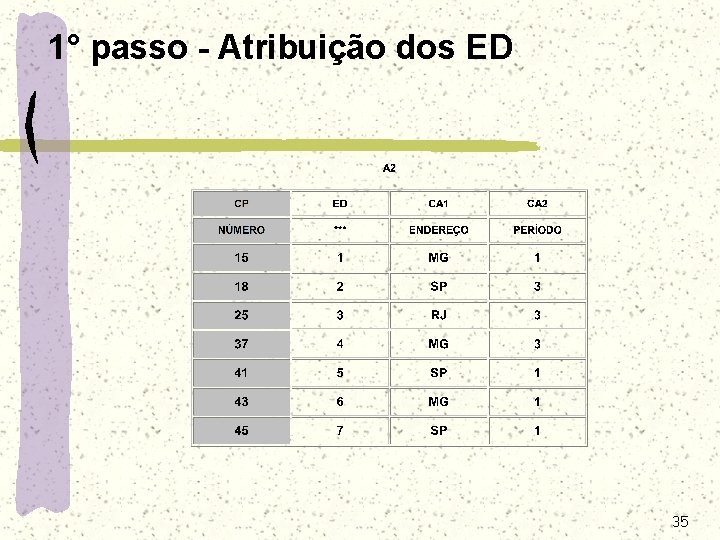
1º passo : Atribuição dos endereços de disco Os itens não chave são descartados e cria-se um atributo endereço de disco que recebe numeração seqüencial. Arquivo resultante : A 2 ( 1 arquivo) 27
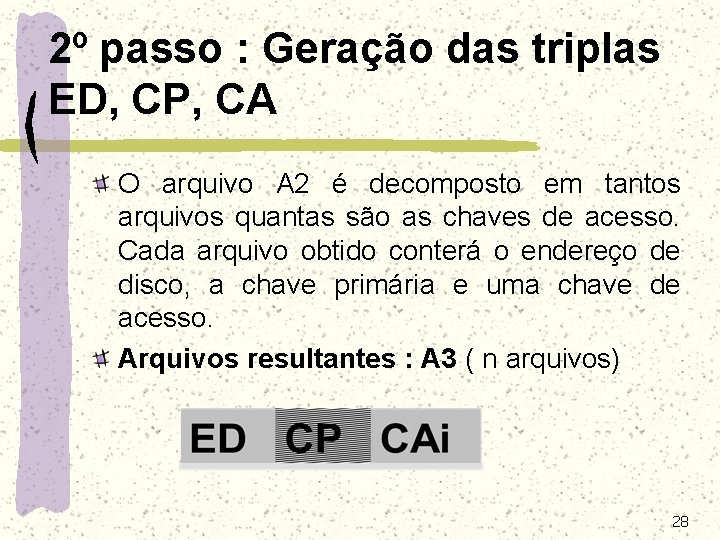
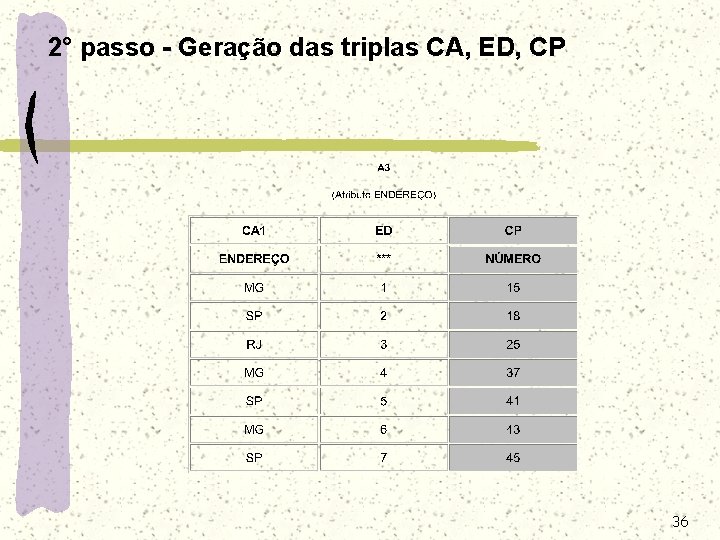
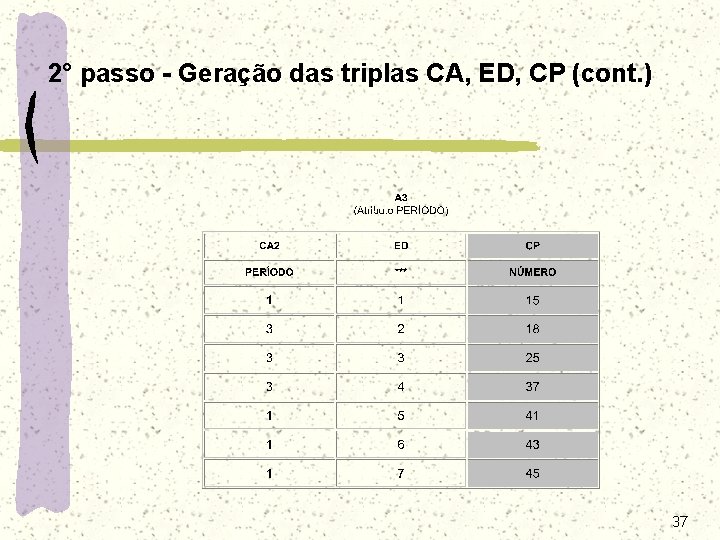
2º passo : Geração das triplas ED, CP, CA O arquivo A 2 é decomposto em tantos arquivos quantas são as chaves de acesso. Cada arquivo obtido conterá o endereço de disco, a chave primária e uma chave de acesso. Arquivos resultantes : A 3 ( n arquivos) 28
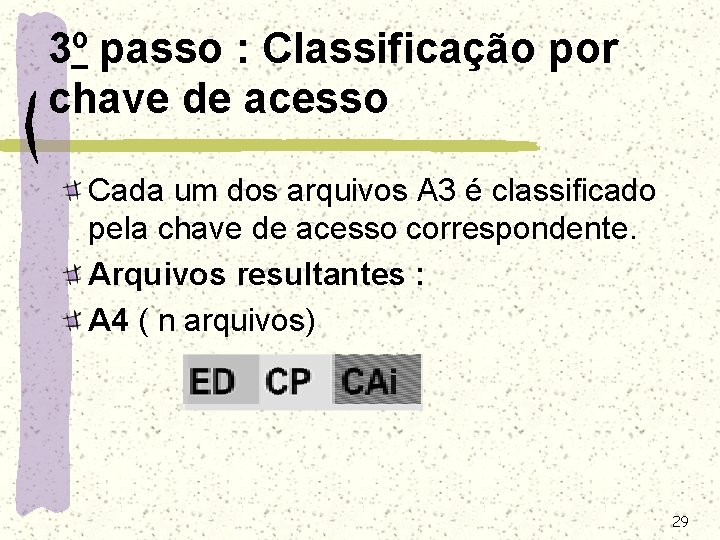
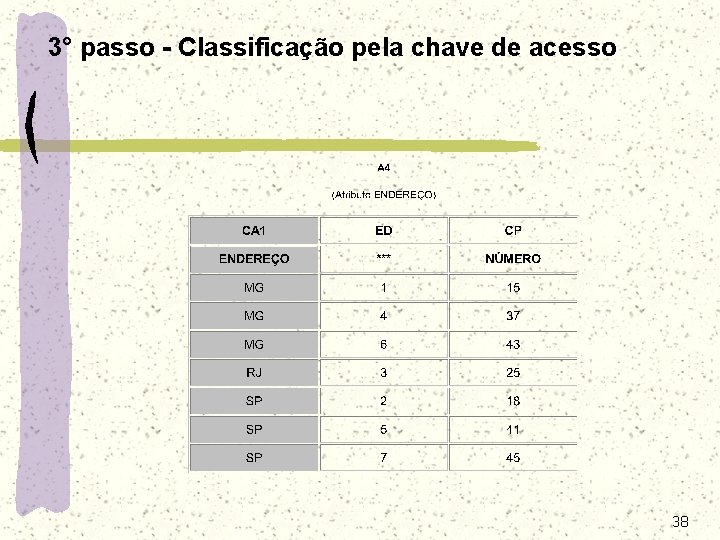
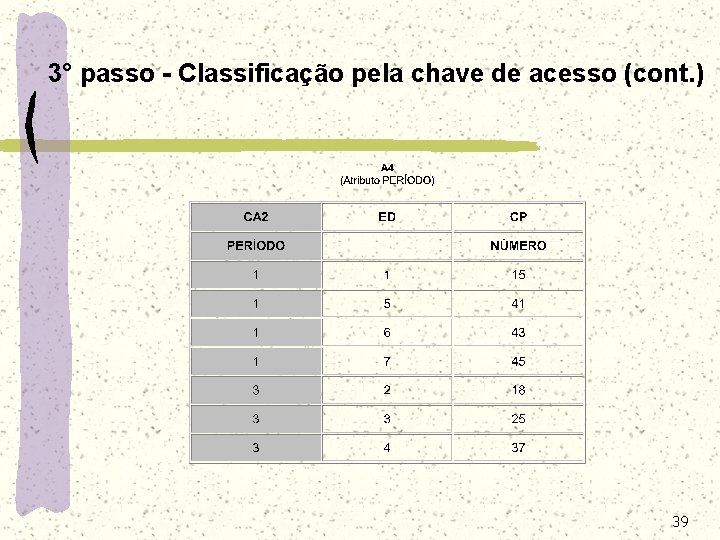
3º passo : Classificação por chave de acesso Cada um dos arquivos A 3 é classificado pela chave de acesso correspondente. Arquivos resultantes : A 4 ( n arquivos) 29
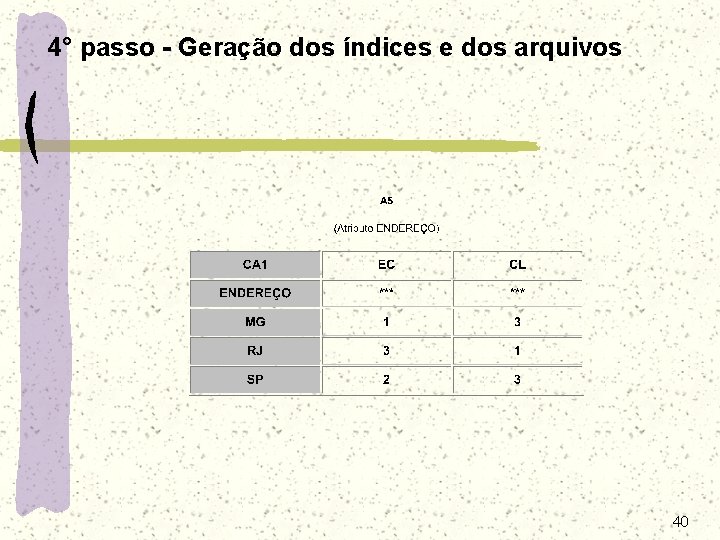
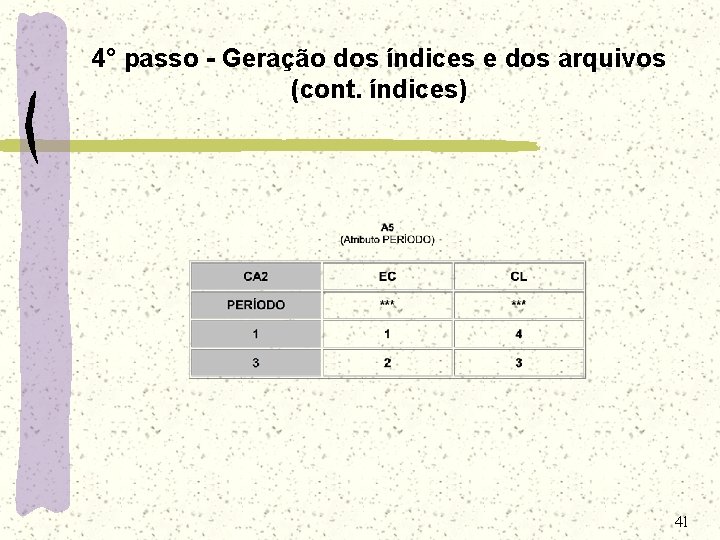
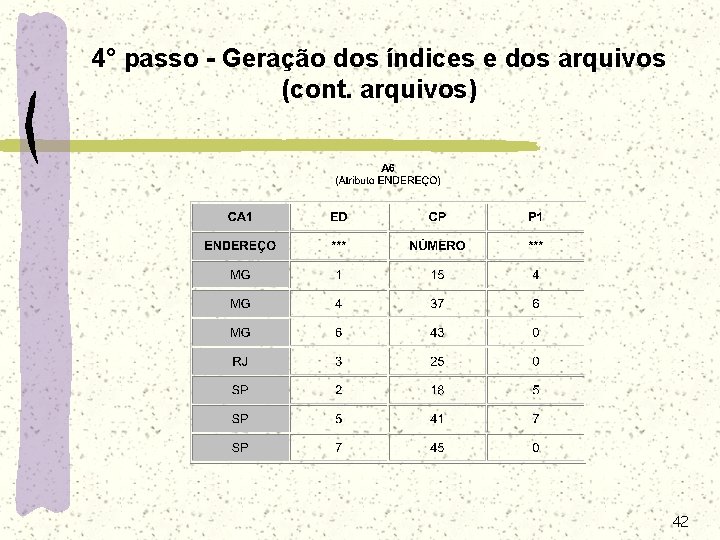
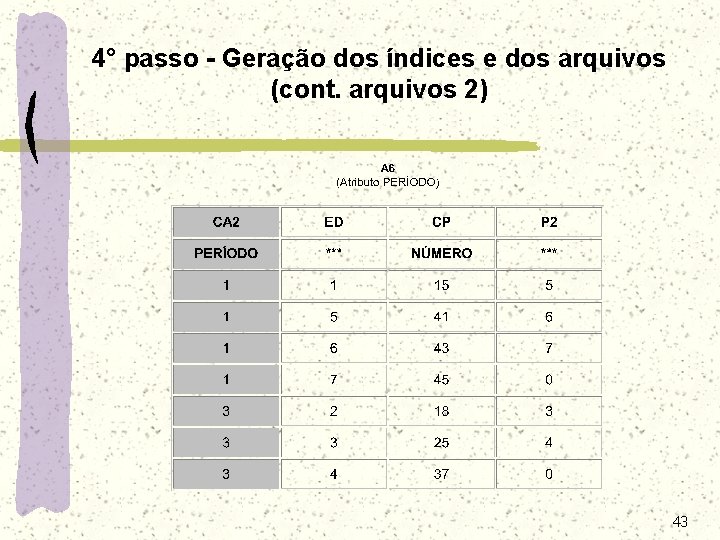
4º passo : Geração dos índices e inserção dos ponteiros Cada um dos arquivos A 4 é processado gerando dois arquivos : um arquivo de índices, A 5, e um arquivo com endereço de disco, chave primária, chave de acesso e um ponteiro para o sucessor na multilista da respectiva chave de acesso. Arquivos resultantes : A 5 ( n arquivos) A 6 ( n arquivos) 30
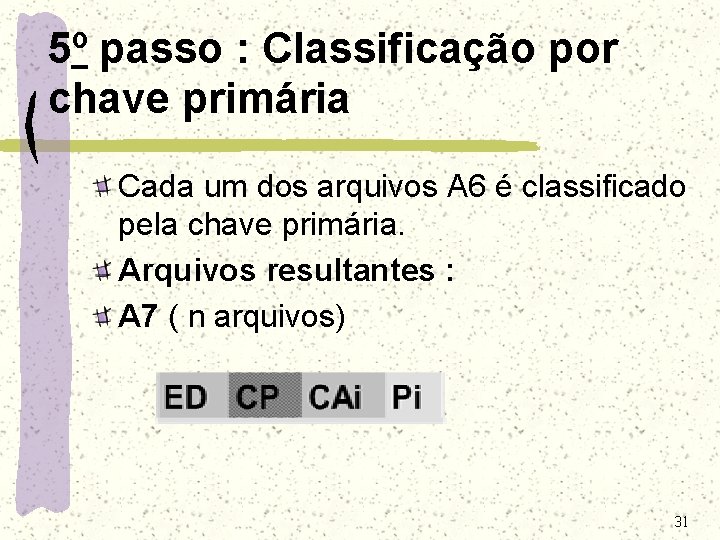
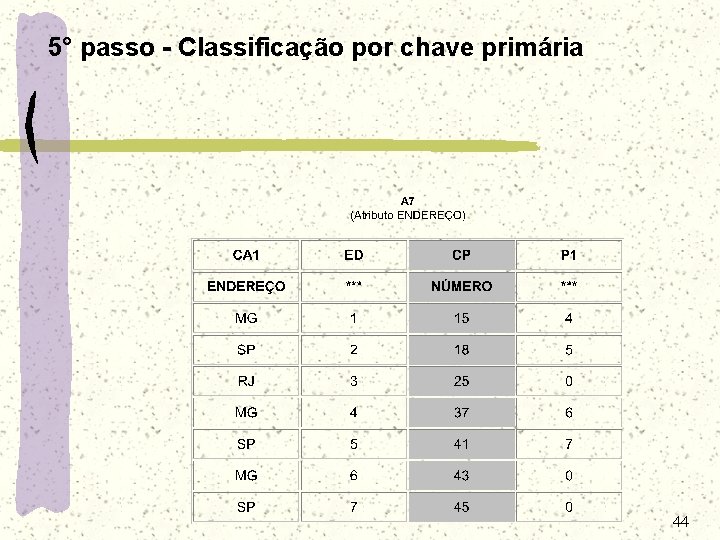
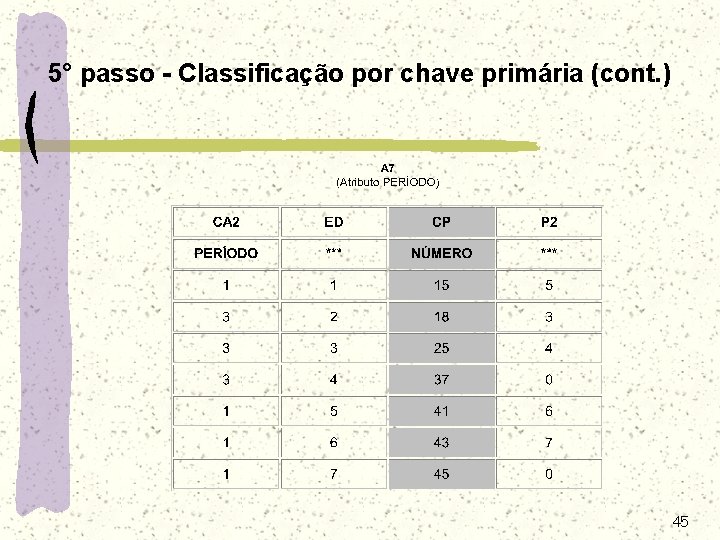
5º passo : Classificação por chave primária Cada um dos arquivos A 6 é classificado pela chave primária. Arquivos resultantes : A 7 ( n arquivos) 31
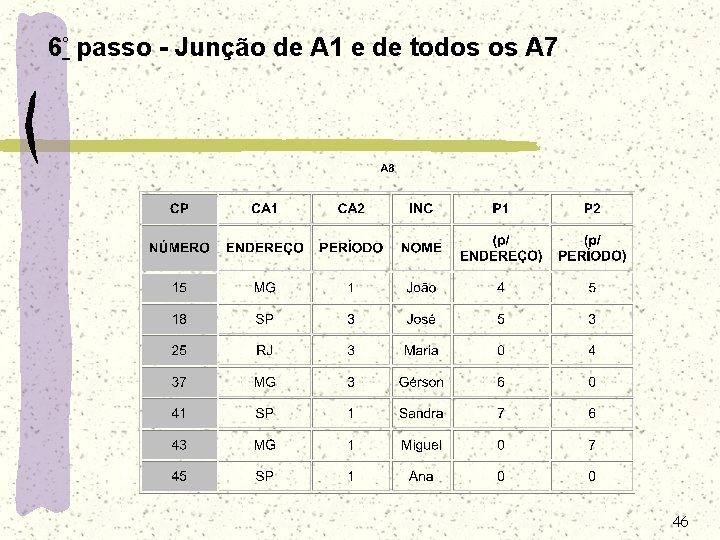
6º passo : Montagem do arquivo de saída O arquivo de entrada A 1 e todos os arquivos A 7 sofrem um processo de junção e descarta -se o endereço de disco. Os arquivos de índices são os arquivos A 5 gerados no 4 0 passo do algoritmo. Arquivos resultantes : A 8 ( 1 arquivo) 32
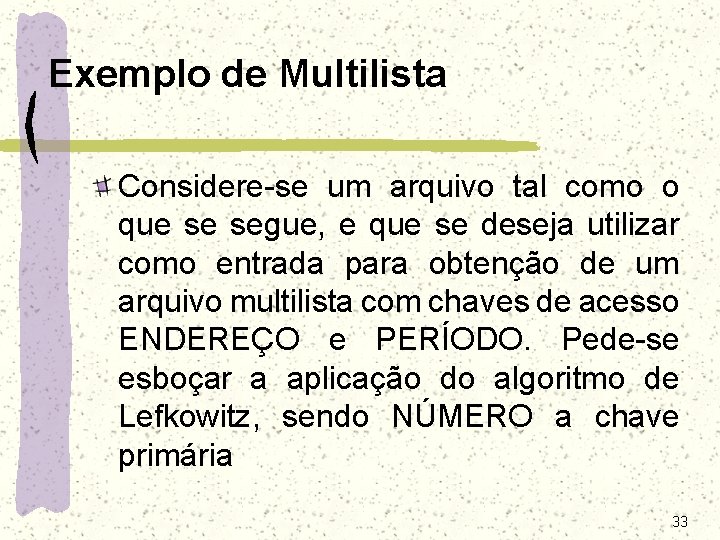
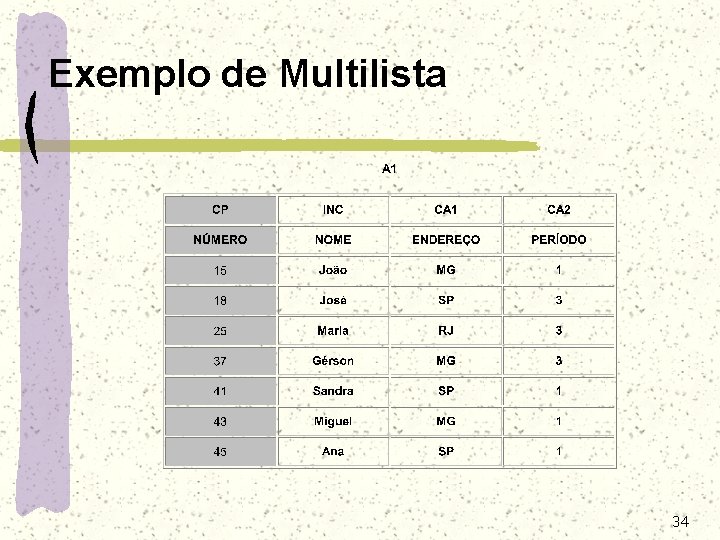
Exemplo de Multilista Considere-se um arquivo tal como o que se segue, e que se deseja utilizar como entrada para obtenção de um arquivo multilista com chaves de acesso ENDEREÇO e PERÍODO. Pede-se esboçar a aplicação do algoritmo de Lefkowitz, sendo NÚMERO a chave primária 33
Exemplo de Multilista 34
1° passo - Atribuição dos ED 35
2° passo - Geração das triplas CA, ED, CP 36
2° passo - Geração das triplas CA, ED, CP (cont. ) 37
3° passo - Classificação pela chave de acesso 38
3° passo - Classificação pela chave de acesso (cont. ) 39
4° passo - Geração dos índices e dos arquivos 40
4° passo - Geração dos índices e dos arquivos (cont. índices) 41
4° passo - Geração dos índices e dos arquivos (cont. arquivos) 42
4° passo - Geração dos índices e dos arquivos (cont. arquivos 2) 43
5° passo - Classificação por chave primária 44
5° passo - Classificação por chave primária (cont. ) 45
6° passo - Junção de A 1 e de todos os A 7 46
Arquivos Invertidos 47
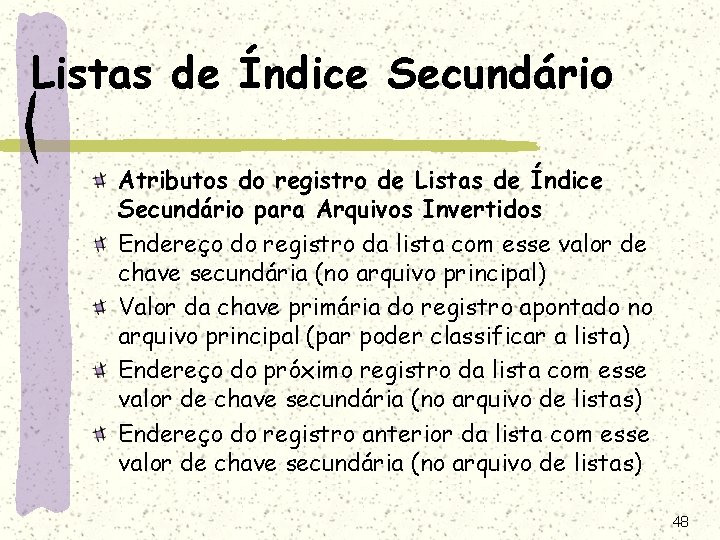
Listas de Índice Secundário Atributos do registro de Listas de Índice Secundário para Arquivos Invertidos Endereço do registro da lista com esse valor de chave secundária (no arquivo principal) Valor da chave primária do registro apontado no arquivo principal (par poder classificar a lista) Endereço do próximo registro da lista com esse valor de chave secundária (no arquivo de listas) Endereço do registro anterior da lista com esse valor de chave secundária (no arquivo de listas) 48
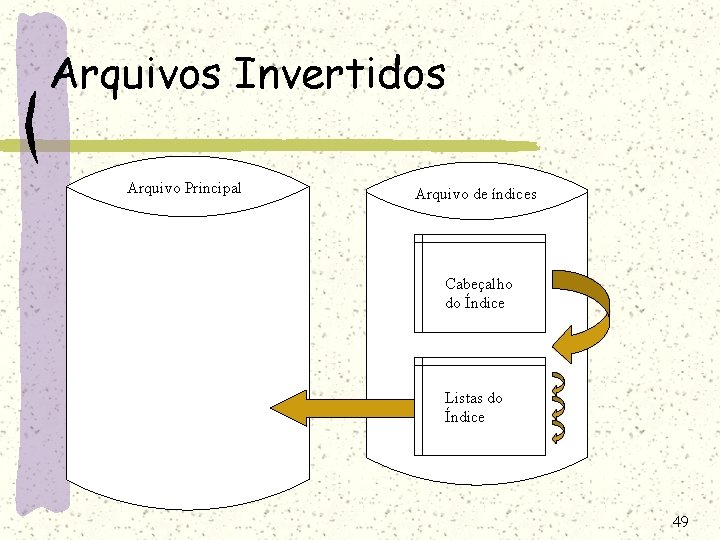
Arquivos Invertidos Arquivo Principal Arquivo de índices Cabeçalho do Índice Listas do Índice 49
Arquivos Multilista Arquivo Principal Arquivo de índices Cabeçalho do Índice Listas do Índice 50
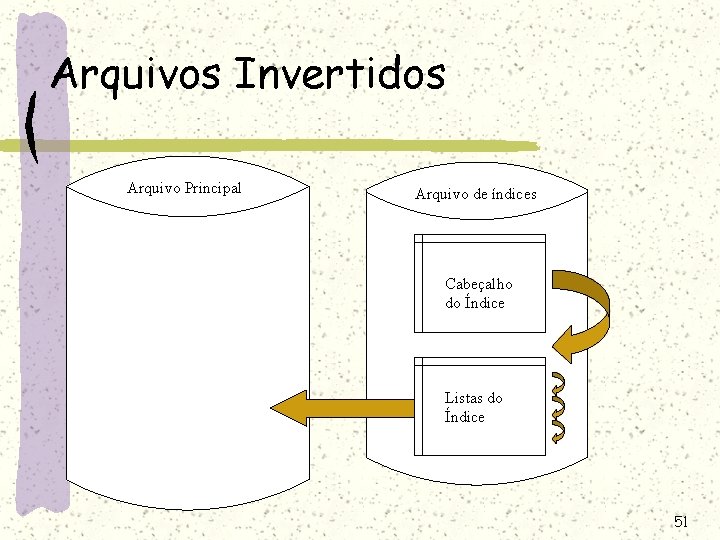
Arquivos Invertidos Arquivo Principal Arquivo de índices Cabeçalho do Índice Listas do Índice 51
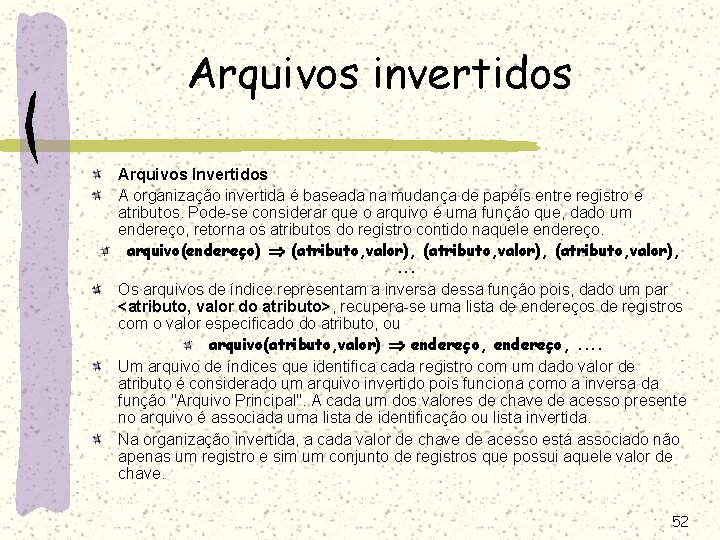
Arquivos invertidos Arquivos Invertidos A organização invertida é baseada na mudança de papéis entre registro e atributos. Pode-se considerar que o arquivo é uma função que, dado um endereço, retorna os atributos do registro contido naquele endereço. arquivo(endereço) Þ (atributo, valor), . . . Os arquivos de índice representam a inversa dessa função pois, dado um par <atributo, valor do atributo>, recupera-se uma lista de endereços de registros com o valor especificado do atributo, ou arquivo(atributo, valor) Þ endereço, . . Um arquivo de índices que identifica cada registro com um dado valor de atributo é considerado um arquivo invertido pois funciona como a inversa da função "Arquivo Principal". A cada um dos valores de chave de acesso presente no arquivo é associada uma lista de identificação ou lista invertida. Na organização invertida, a cada valor de chave de acesso está associado não apenas um registro e sim um conjunto de registros que possui aquele valor de chave. 52
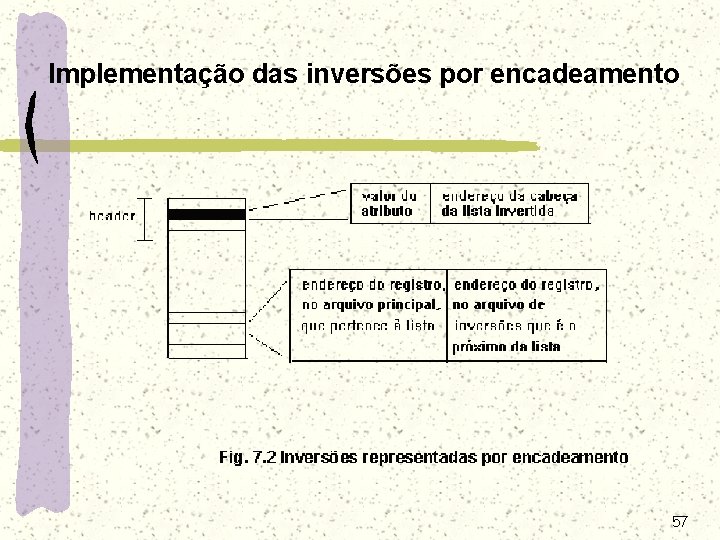
Inversões e Listas Invertidas O conjunto de listas invertidas associadas a um determinado atributo é chamado de inversão por aquele atributo. Um arquivo pode ter uma ou mais inversões. O número de listas invertidas em cada inversão é igual ao número de diferentes valores daquele atributo existente no arquivo. O arquivo de índices contém inversões, cada inversão contém diversas listas invertidas, cada lista invertida contém um "header" (que identifica o valor do atributo correspondente a esta lista e o comprimento da lista) e a lista dos endereços de registros que contém este valor de atributo 53
Grau de Inversão Chama-se grau de inversão de um arquivo a porcentagem de atributos indexados por inversão. Um arquivo com todos os atributos indexados tem 100% de grau de inversão. Os sistema de informação comerciais são sistemas de recuperação de referências (ou documentos). As referências são armazenadas junto com palavras chave indicadoras de seu conteúdo. Os usuários solicitam informações sob a forma de expressões "booleanas", do tipo : quais as referências existente sobre "tendinite" and ("teclado" or "terminal"). Praticamente todos esses sistemas utilizam arquivos invertidos. 54
Implementação das inversões As representações das listas invertidas são feitas pelos processos convencionais de representação de listas, ou seja, por contigüidade, por encadeamento e por mapa de bits. 55
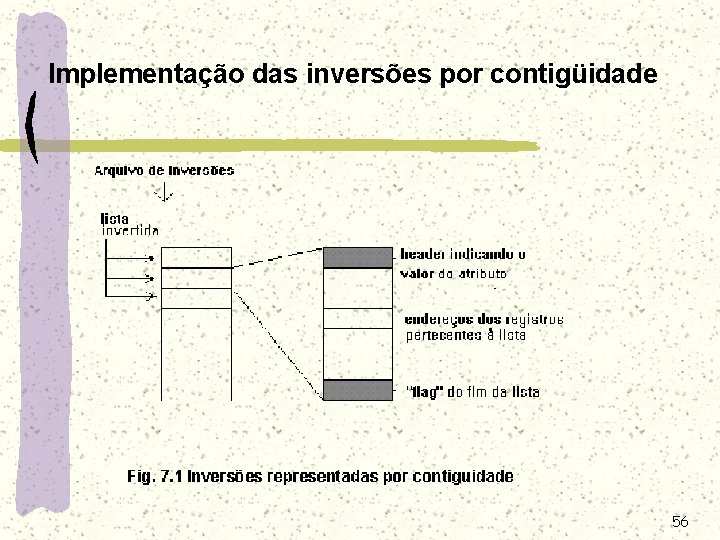
Implementação das inversões por contigüidade 56
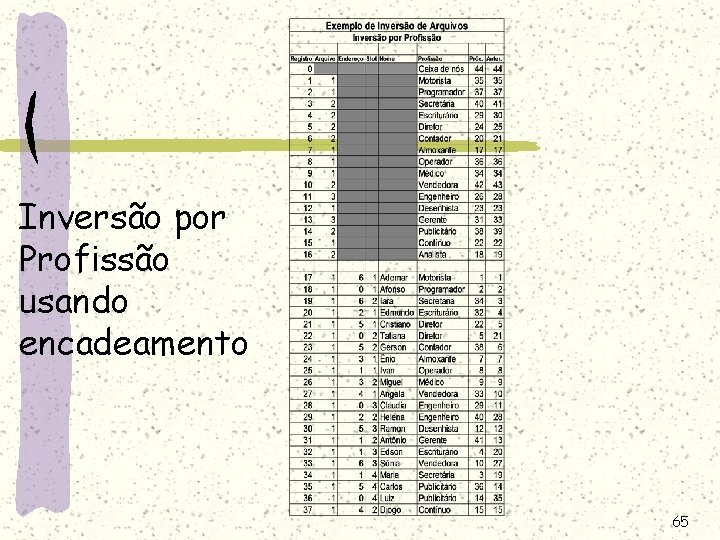
Implementação das inversões por encadeamento 57
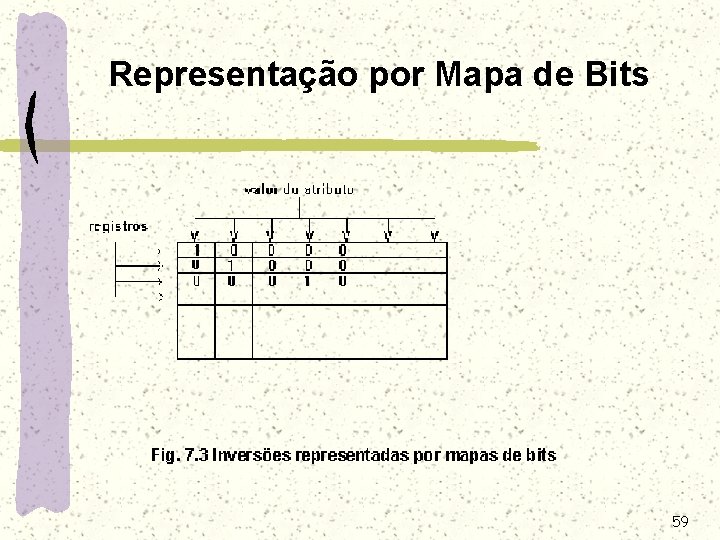
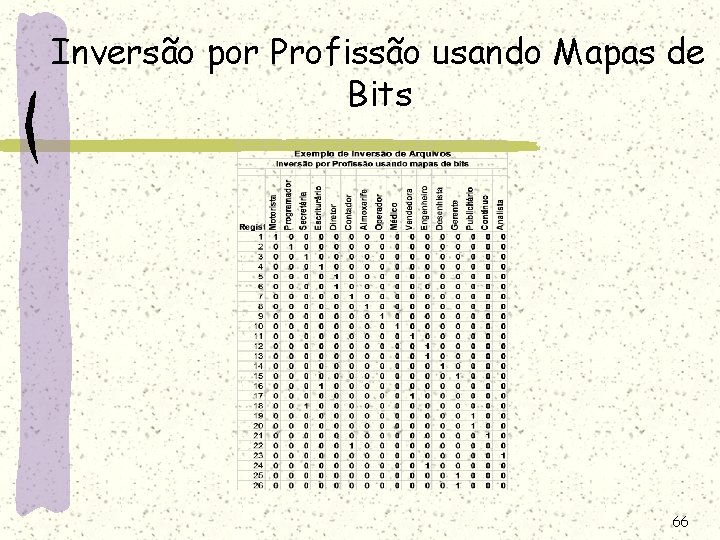
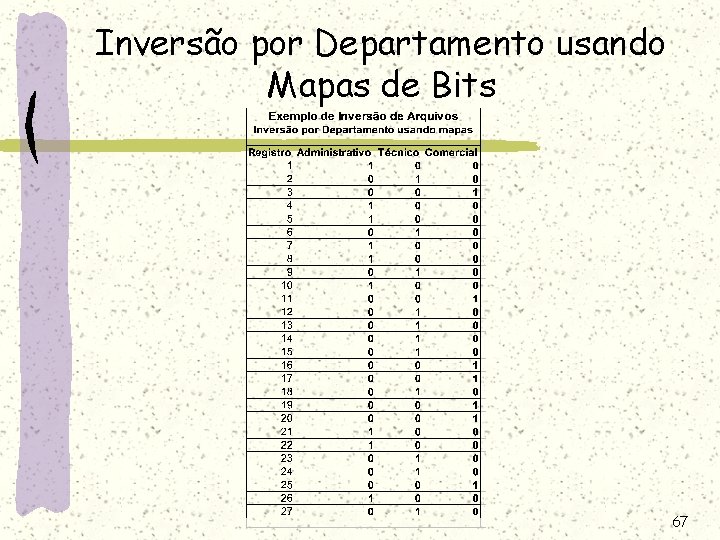
Representação por Mapa de Bits Mapas de bits são arrays bidimensionais nos quais cada linha corresponde a um registro do arquivo principal e cada coluna corresponde a um dos valores do atributo que ocorrem no arquivo principal. Cada mapa de bits corresponde a um atributo, cada bit 1 indica que o registro correspondente pertence à lista de registro com o valor de atributo correspondente à coluna onde se encontra o bit 1. 58
Representação por Mapa de Bits 59
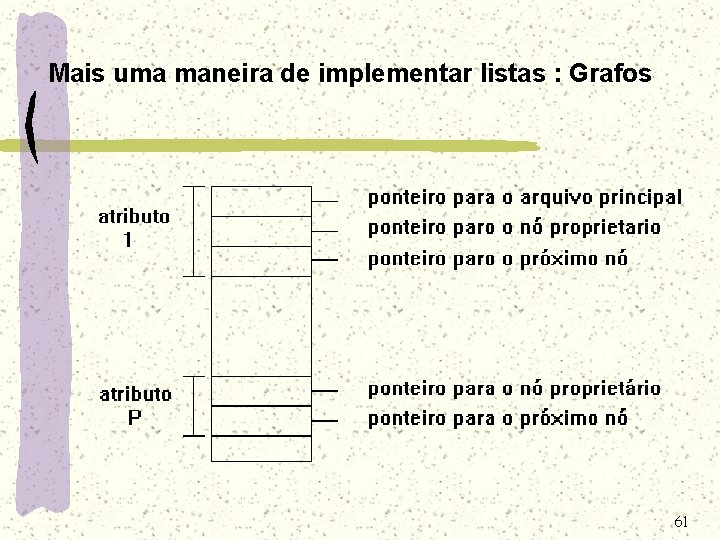
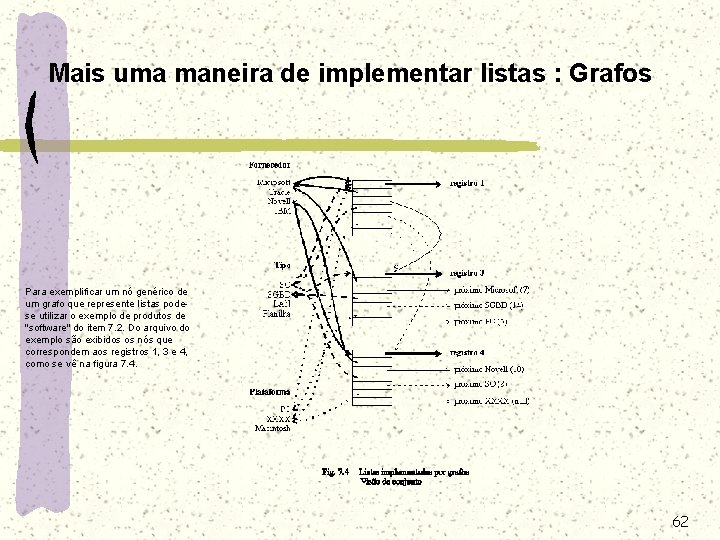
Mais uma maneira de implementar listas : Grafos Pode-se economizar espaço em estruturas encadeadas de índices combinados os elementos da lista que apontam para um mesmo registro do arquivo principal. Cada registro do arquivo principal é representado em uma inversão por um simples nó, que pode pertencer a tantas lista quantos são os atributos indexados, formando-se assim uma estrutura de grafo. Cada nó destes grafos conterá : - um ponteiro para o arquivo principal - para cada atributo indexado : um ponteiro para o nó proprietário da lista um ponteiro para o próximo nó com o mesmo valor de atributo 60
Mais uma maneira de implementar listas : Grafos 61
Mais uma maneira de implementar listas : Grafos Para exemplificar um nó genérico de um grafo que represente listas podese utilizar o exemplo de produtos de "software" do item 7. 2. Do arquivo do exemplo são exibidos os nós que correspondem aos registros 1, 3 e 4, como se vê na figura 7. 4. 62
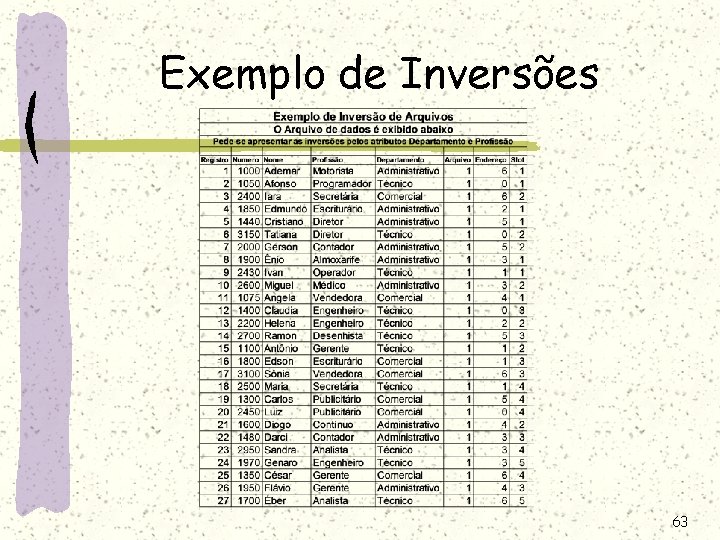
Exemplo de Inversões 63
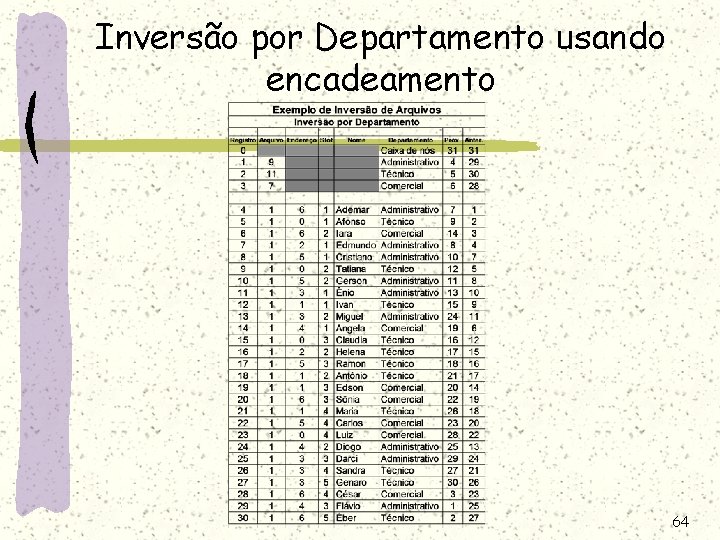
Inversão por Departamento usando encadeamento 64
Inversão por Profissão usando encadeamento 65
Inversão por Profissão usando Mapas de Bits 66
Inversão por Departamento usando Mapas de Bits 67
Algoritmo de implementação de Listas Invertidas O algoritmo do Livro mostra uma implementação de inversão de arquivos na qual se considera a inversão de um arquivo de acesso direto implementada por encadeamento, com as seguintes hipóteses: O arquivo de acesso direto possui área de transbordamento separada; O número de "buckets" na área primária do arquivo de acesso direto é igual a n_buckets; O número de "slots" de cada "bucket" na área primária é igual a n_slots; O tratamento de transbordamento é feito por encadeamento em área secundária; Os buckets da área secundária só possuem um "slot" cada; O registro a ser inserido na lista invertida está gravado no "slot" de posição slot_corrente do bucket de endereço bucket_corrente; O arquivo de inversões será implementado por listas duplamente encadeadas; O número de registros do arquivo de inversões é igual a n_regs_inversão; O número máximo previsto de distintos valores para a chave secundária é tamanho_header; O algoritmo de alocação de registros do arquivo de inversões utiliza preferencialmente registros reaproveitados de exclusões anteriores (mantidos em uma pilha). Não havendo possibilidade de utilização de registros reaproveitados, são alocados registros ainda não utilizados mantidos em uma fila. 68