Translace a genetick kd Srpkovit tvar ervench krvinek
- Slides: 61
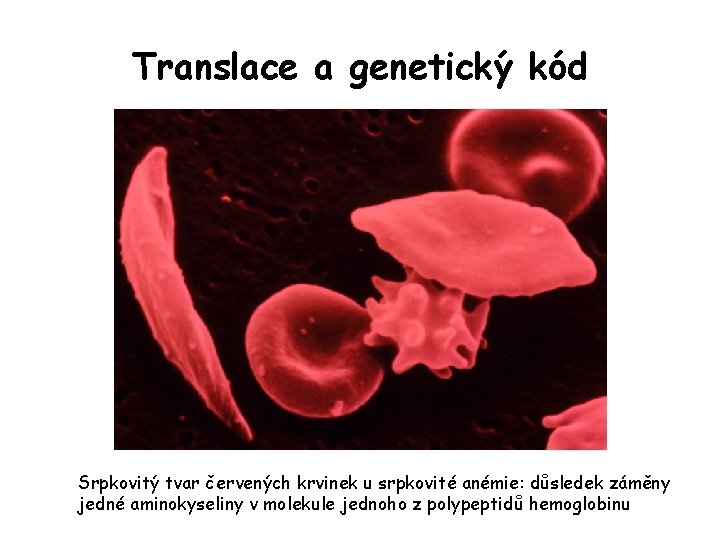
Translace a genetický kód Srpkovitý tvar červených krvinek u srpkovité anémie: důsledek záměny jedné aminokyseliny v molekule jednoho z polypeptidů hemoglobinu
Osnova přednášky • • • struktura proteinů syntéza proteinů: translace genetický kód interakce kodon-t. RNA potvrzení povahy genetického kódu in vivo
Struktura proteinů • proteiny jsou složité makromolekuly složené z 20 různých aminokyselin • tvoří 15% nativní hmotnosti buněk • s výjimkou vody představují převládající složku živých organizmů • podílejí se na výstavbě jejich těl jako strukturní prvky i na jejich funkci
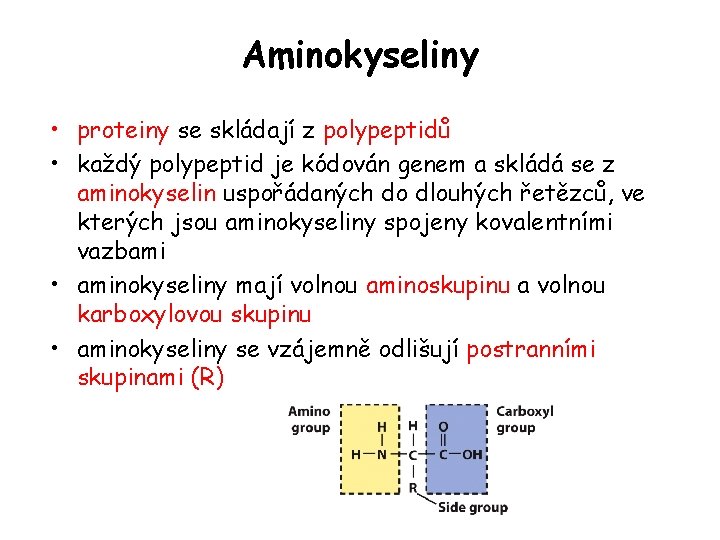
Aminokyseliny • proteiny se skládají z polypeptidů • každý polypeptid je kódován genem a skládá se z aminokyselin uspořádaných do dlouhých řetězců, ve kterých jsou aminokyseliny spojeny kovalentními vazbami • aminokyseliny mají volnou aminoskupinu a volnou karboxylovou skupinu • aminokyseliny se vzájemně odlišují postranními skupinami (R)
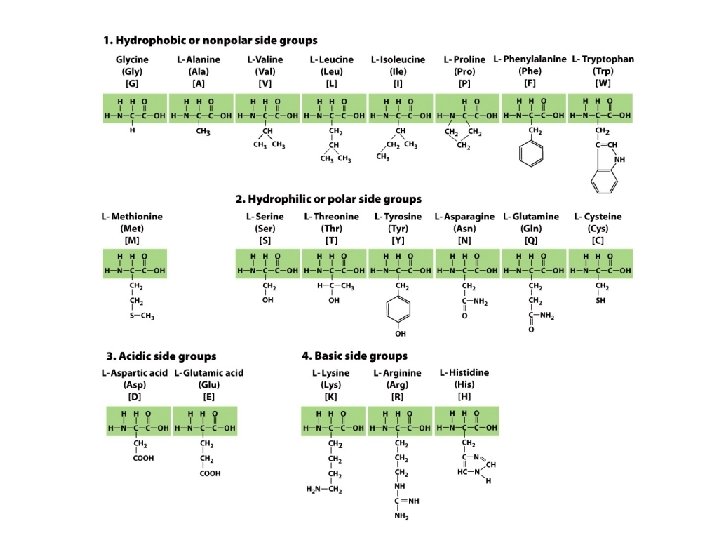
Postranní skupiny aminokyselin • zdroj jejich strukturní (a funkční) diverzity 4 typy: • hydrofóbní (nepolární) • hydrofilní (polární) • kyselé (negativně nabité) • bazické (pozitivně nabité)
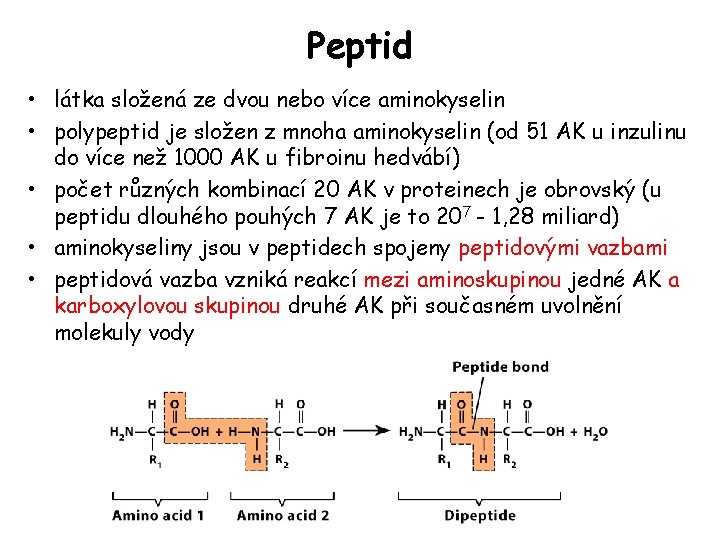
Peptid • látka složená ze dvou nebo více aminokyselin • polypeptid je složen z mnoha aminokyselin (od 51 AK u inzulinu do více než 1000 AK u fibroinu hedvábí) • počet různých kombinací 20 AK v proteinech je obrovský (u peptidu dlouhého pouhých 7 AK je to 207 - 1, 28 miliard) • aminokyseliny jsou v peptidech spojeny peptidovými vazbami • peptidová vazba vzniká reakcí mezi aminoskupinou jedné AK a karboxylovou skupinou druhé AK při současném uvolnění molekuly vody
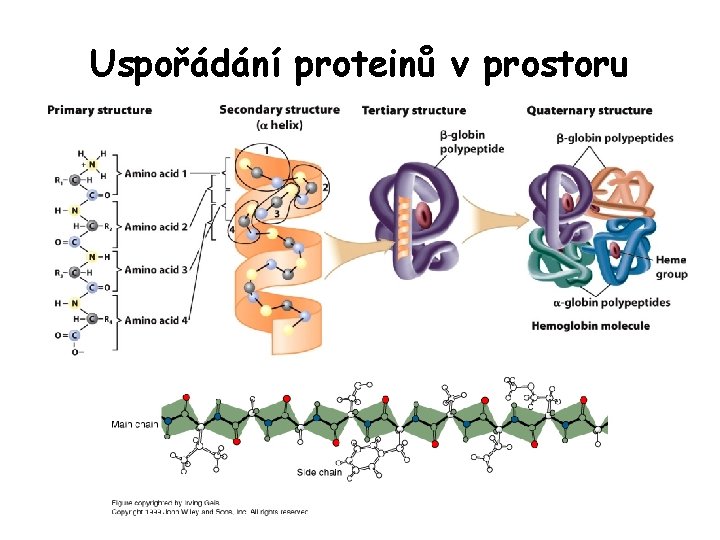
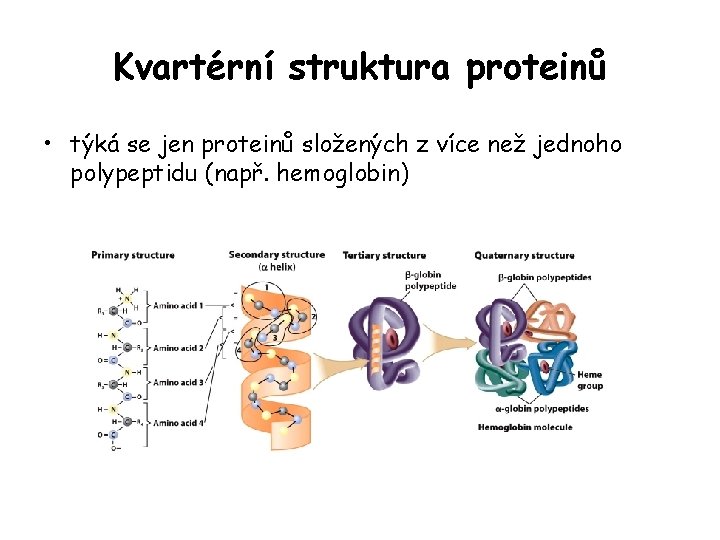
Uspořádání proteinů v prostoru 4 úrovně organizace struktury proteinů: • primární struktura: určena sekvencí aminokyselin (kódována genem) • sekundární struktura: určena prostorovými vztahy aminokyselin v částech polypeptidu • terciární struktura: celkové složení polypeptidu v trojrozměrném prostoru • kvartérní struktura: vyplývá ze spojení dvou nebo více polypeptidů v proteinu s více podjednotkami
Uspořádání proteinů v prostoru
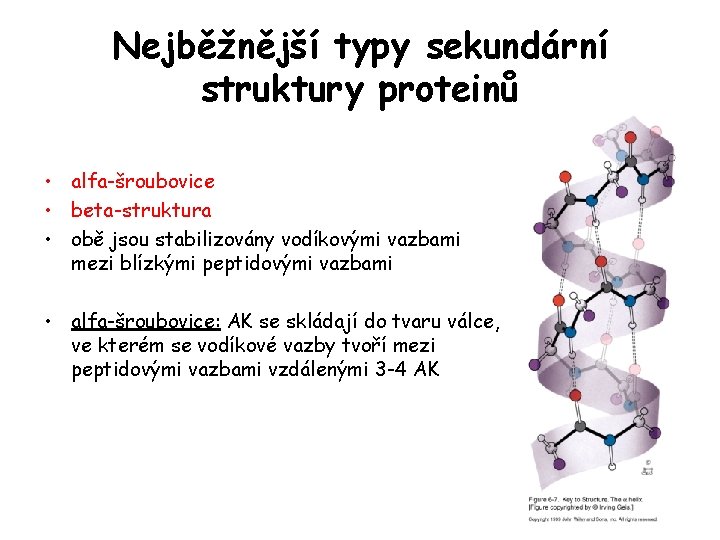
Nejběžnější typy sekundární struktury proteinů • alfa-šroubovice • beta-struktura • obě jsou stabilizovány vodíkovými vazbami mezi blízkými peptidovými vazbami • alfa-šroubovice: AK se skládají do tvaru válce, ve kterém se vodíkové vazby tvoří mezi peptidovými vazbami vzdálenými 3 -4 AK
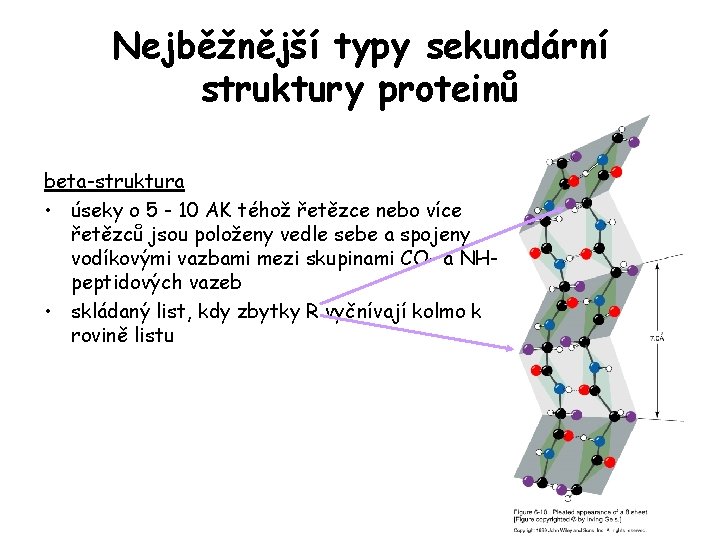
Nejběžnější typy sekundární struktury proteinů beta-struktura • úseky o 5 - 10 AK téhož řetězce nebo více řetězců jsou položeny vedle sebe a spojeny vodíkovými vazbami mezi skupinami CO- a NHpeptidových vazeb • skládaný list, kdy zbytky R vyčnívají kolmo k rovině listu
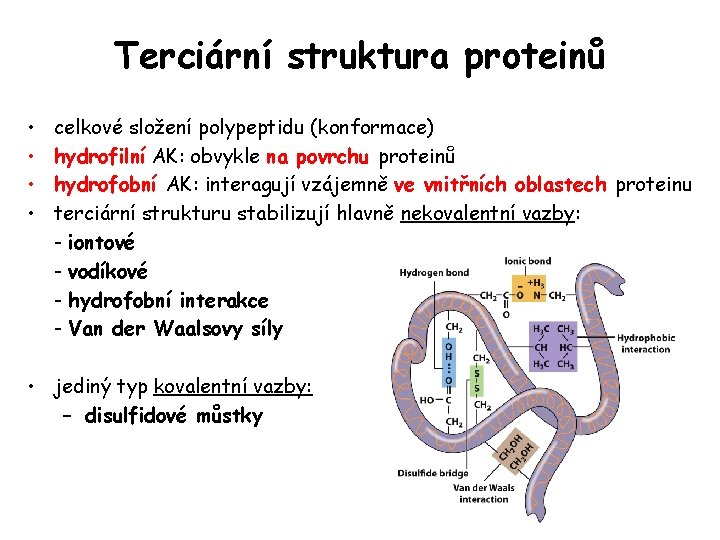
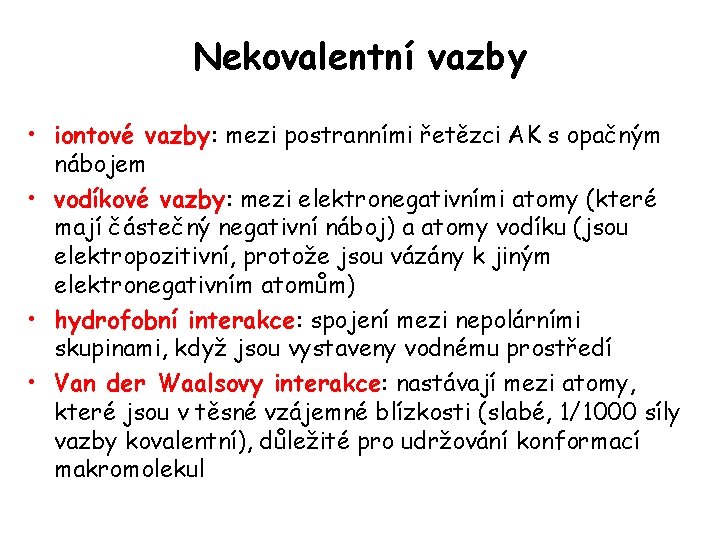
Terciární struktura proteinů • • celkové složení polypeptidu (konformace) hydrofilní AK: obvykle na povrchu proteinů hydrofobní AK: interagují vzájemně ve vnitřních oblastech proteinu terciární strukturu stabilizují hlavně nekovalentní vazby: - iontové - vodíkové - hydrofobní interakce - Van der Waalsovy síly • jediný typ kovalentní vazby: – disulfidové můstky
Nekovalentní vazby • iontové vazby: mezi postranními řetězci AK s opačným nábojem • vodíkové vazby: mezi elektronegativními atomy (které mají částečný negativní náboj) a atomy vodíku (jsou elektropozitivní, protože jsou vázány k jiným elektronegativním atomům) • hydrofobní interakce: spojení mezi nepolárními skupinami, když jsou vystaveny vodnému prostředí • Van der Waalsovy interakce: nastávají mezi atomy, které jsou v těsné vzájemné blízkosti (slabé, 1/1000 síly vazby kovalentní), důležité pro udržování konformací makromolekul
Kvartérní struktura proteinů • týká se jen proteinů složených z více než jednoho polypeptidu (např. hemoglobin)
Take home message • většina genů realizuje svou funkci (vliv na fenotyp organizmu) prostřednictvím proteinů • proteiny jsou makromolekuly složené z polypeptidů • každý polypeptid je polymer složený z různých aminokyselin • aminokyselinová sekvence každého polypeptidu je určena nukleotidovou sekvencí genu • funkční diverzita proteinů je z velké míry důsledkem je složitých trojrozměrných struktur, které proteiny zaujímají
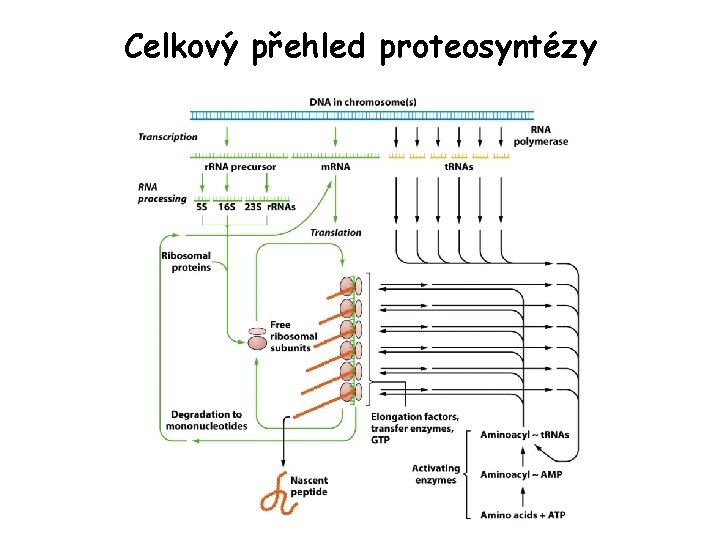
Principy translace • genetická informace se z m. RNA překládá do sekvence aminokyselin v polypeptidu pomocí genetického kódu • do procesu translace je zapojeno: - více než 50 proteinů - m. RNA - 3 až 5 typů r. RNA v ribozomu - alespoň 20 enzymů pro aktivaci aminokyselin (aminoacyl-t. RNA syntetázy) - 40 až 60 různých t. RNA - řada rozpustných proteinů zapojených do iniciace, elongace a terminace translace • translační systém představuje dominantní část metabolického aparátu každé buňky
Celkový přehled proteosyntézy
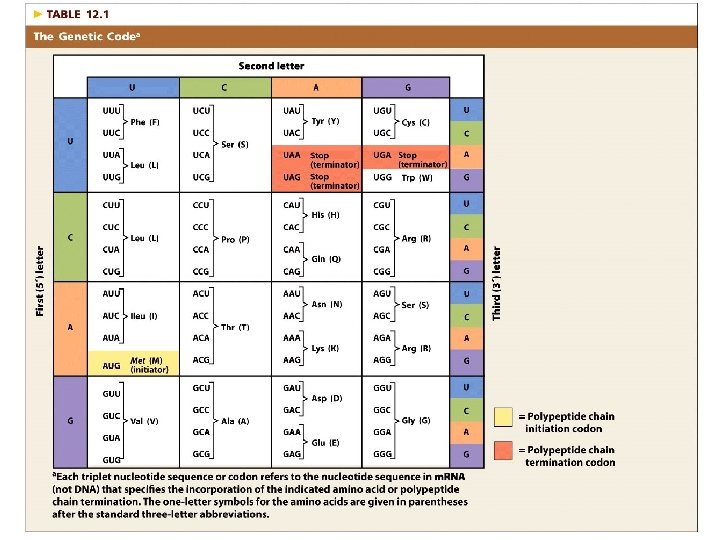
Genetický kód • systém, podle kterého se určuje přiřazení specifické AK do polypeptidového řetězce podle nukleotidové sekvence m. RNA • každá AK je určena jedním nebo několika kodony v m. RNA • každý kodon obsahuje tři nukleotidy (triplety) • ze 64 možných tripletů: 61 určuje aminokyseliny + 3 určují terminaci translace • kodony v m. RNA jsou rozeznávány (a dočasně vázány na základě párování bází) komplementárními sekvencemi v t. RNA (antikodony), které nesou specifické aminokyseliny
Ribozomy • místa syntézy proteinů, kde jsou soustředěny potřebné nástroje pro tuto funkci • nespecifické (dokážou syntetizovat jakýkoliv peptid kódovaný příslušnou m. RNA, i z jiných buněk či organizmů) • molekula m. RNA může být současně překládána několika ribozomy: tvorba polyribozomů (polyzomů) • v buňce E. coli je cca 200 000 ribozomů (tj. 25% sušiny buňky) • všechny molekuly zapojené do proteosyntézy dohromady tvoří 1/3 sušiny buněk, vysoká energetická náročnost, význam pro život
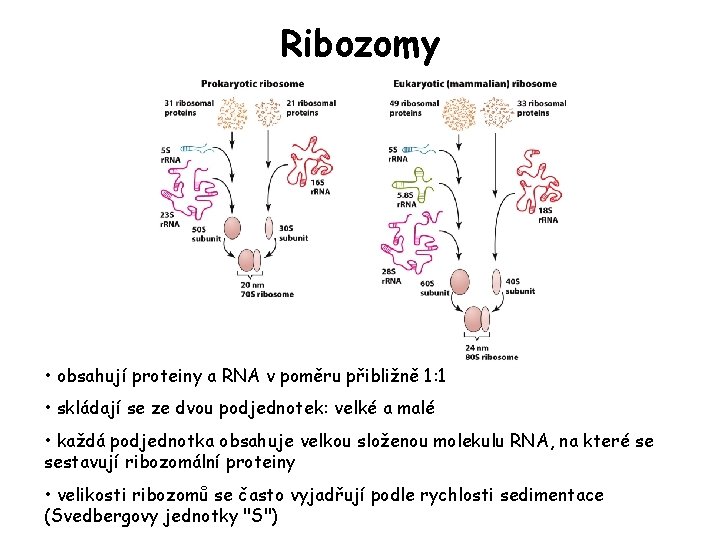
Ribozomy • obsahují proteiny a RNA v poměru přibližně 1: 1 • skládají se ze dvou podjednotek: velké a malé • každá podjednotka obsahuje velkou složenou molekulu RNA, na které se sestavují ribozomální proteiny • velikosti ribozomů se často vyjadřují podle rychlosti sedimentace (Svedbergovy jednotky "S")
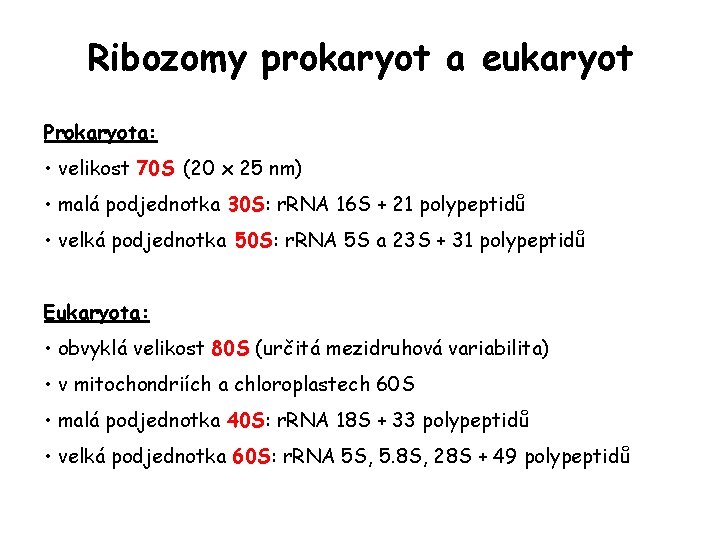
Ribozomy prokaryot a eukaryot Prokaryota: • velikost 70 S (20 x 25 nm) • malá podjednotka 30 S: r. RNA 16 S + 21 polypeptidů • velká podjednotka 50 S: r. RNA 5 S a 23 S + 31 polypeptidů Eukaryota: • obvyklá velikost 80 S (určitá mezidruhová variabilita) • v mitochondriích a chloroplastech 60 S • malá podjednotka 40 S: r. RNA 18 S + 33 polypeptidů • velká podjednotka 60 S: r. RNA 5 S, 5. 8 S, 28 S + 49 polypeptidů
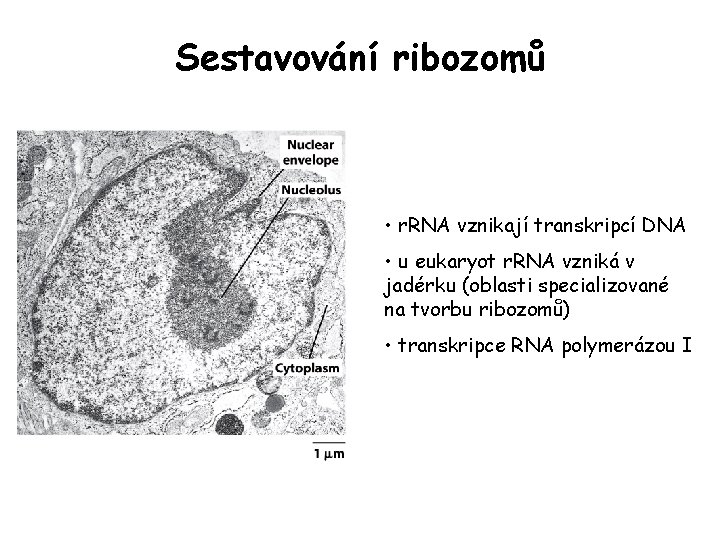
Sestavování ribozomů • r. RNA vznikají transkripcí DNA • u eukaryot r. RNA vzniká v jadérku (oblasti specializované na tvorbu ribozomů) • transkripce RNA polymerázou I
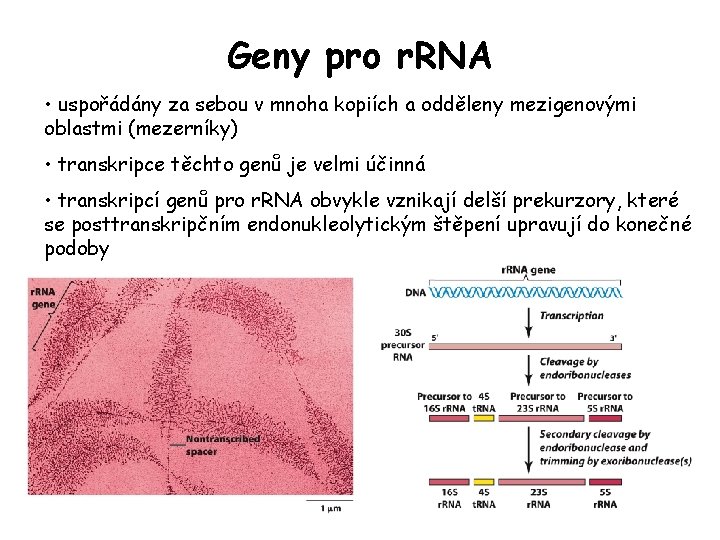
Geny pro r. RNA • uspořádány za sebou v mnoha kopiích a odděleny mezigenovými oblastmi (mezerníky) • transkripce těchto genů je velmi účinná • transkripcí genů pro r. RNA obvykle vznikají delší prekurzory, které se posttranskripčním endonukleolytickým štěpení upravují do konečné podoby
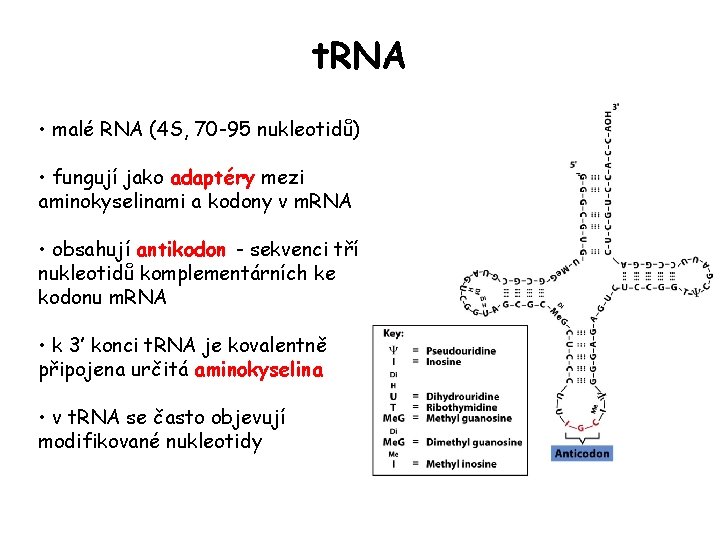
t. RNA • malé RNA (4 S, 70 -95 nukleotidů) • fungují jako adaptéry mezi aminokyselinami a kodony v m. RNA • obsahují antikodon - sekvenci tří nukleotidů komplementárních ke kodonu m. RNA • k 3’ konci t. RNA je kovalentně připojena určitá aminokyselina • v t. RNA se často objevují modifikované nukleotidy
Vazba mezi aminokyselinou a t. RNA • vysokoonergetická vazba (velmi reaktivní) mezi karboxylovou skupinou aminokyseliny a 3´hydroxylovým koncem t. RNA • vazba AK (=aktivace, nabití t. RNA) probíhá ve dvou krocích, které oba katalyzuje enzym aminoacyl-t. RNA syntetáza: 1. aktivace AK energií z ATP: AK + ATP —› AK-AMP + P-P 2. reakce s t. RNA: AK-AMP + t. RNA —› AK-t. RNA + AMP • existuje alespoň jedna aminoacyl-t. RNA syntetáza pro každou z 20 AK • aminoacyl-t. RNA jsou vlastními substráty proteosyntézy na ribozomech (správná kombinace AK a kodonu, přístupnost antikodonu pro reakci s kodonem, prezentace AK v takové prostorové konformaci, která umožňuje tvorbu peptidových vazeb)
Geny pro t. RNA • transkribovány ve formě větších prekurzorů (podobně jako r. RNA) • běžné jsou posttranskripční úpravy (štěpení, metylace, apod. ) • v t. RNA se běžně vyskytují neobvyklé nukleotidy (inozin, pseudouridin, dihydrouridin, metylguanosin, apod. ) vznikají posttranskripčními úpravami čtyř běžných nukleotidů, katalyzováno enzymaticky
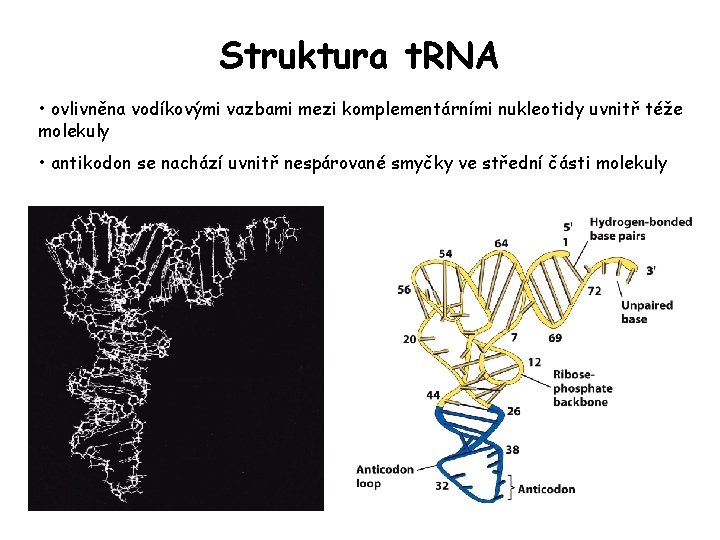
Struktura t. RNA • ovlivněna vodíkovými vazbami mezi komplementárními nukleotidy uvnitř téže molekuly • antikodon se nachází uvnitř nespárované smyčky ve střední části molekuly
Specifita t. RNA • musí mít správnou sekvenci antikodonu (aby reagovala na správný kodon) • musí být rozeznána správnou aminoacyl-t. RNA syntetázou (aby nesla správnou AK) • musí se vázat na správná místa v ribozomech (aby mohla realizovat svou adaptérovou funkci)
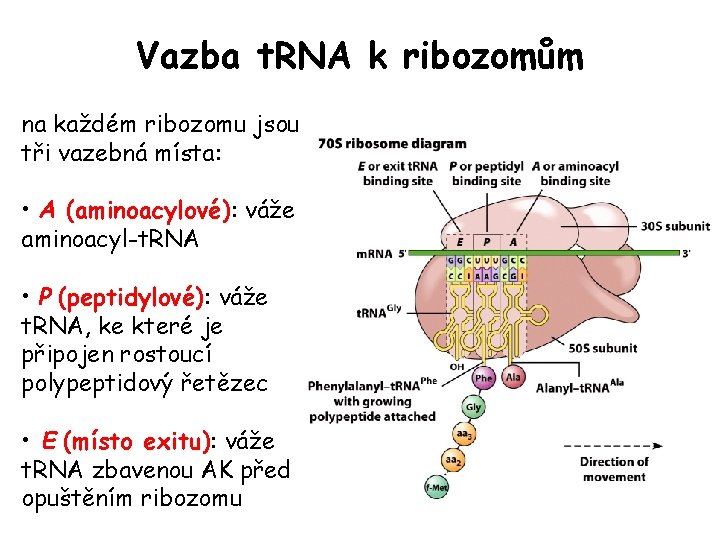
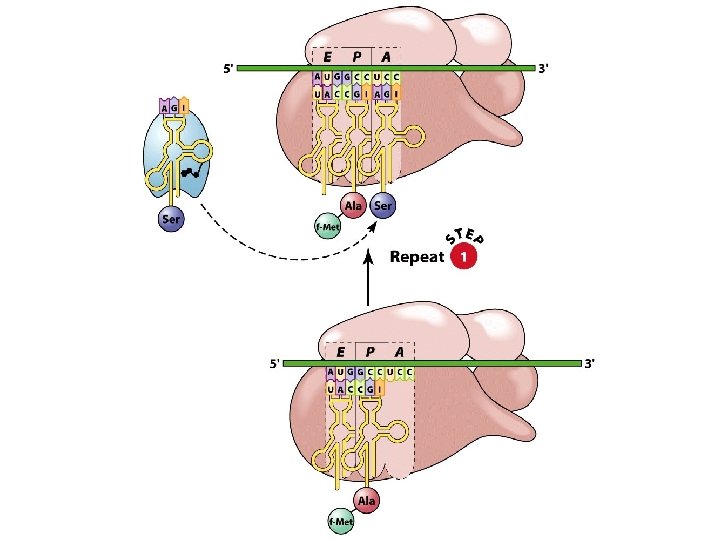
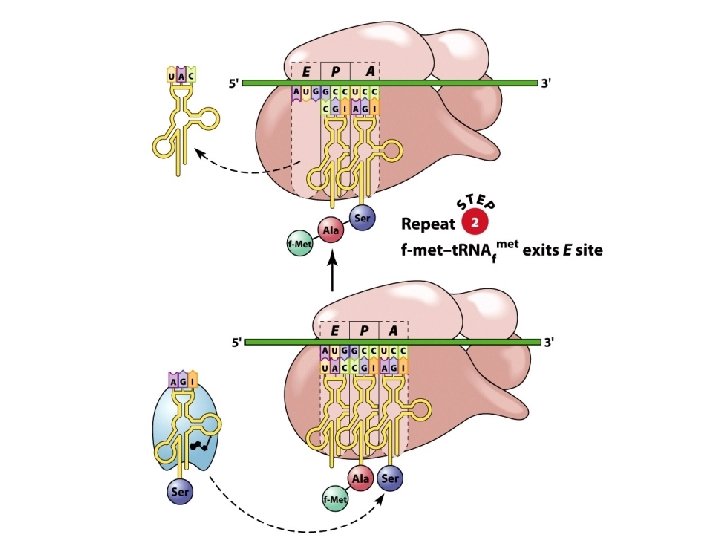
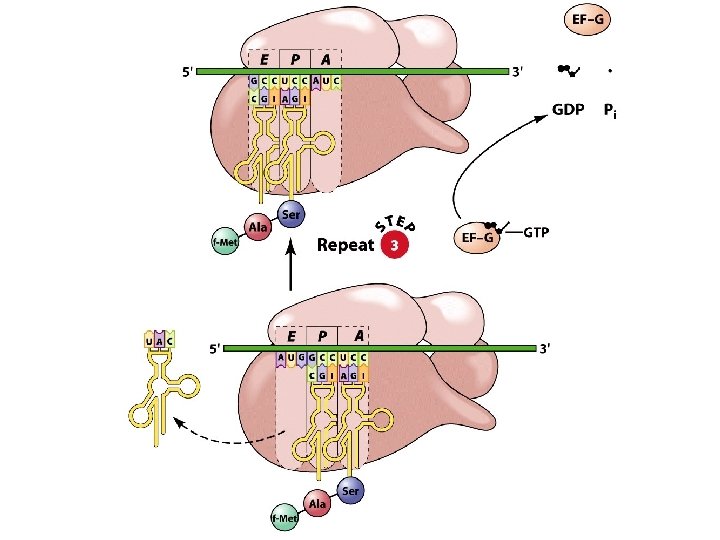
Vazba t. RNA k ribozomům na každém ribozomu jsou tři vazebná místa: • A (aminoacylové): váže aminoacyl-t. RNA • P (peptidylové): váže t. RNA, ke které je připojen rostoucí polypeptidový řetězec • E (místo exitu): váže t. RNA zbavenou AK před opuštěním ribozomu
Vazba t. RNA k ribozomům • při pohybu ribozomu podél m. RNA se ve vazebných místech objevují nové kodony, které určují specifitu vazby t. RNA • samotná vazebná místa na ribozomu (za nepřítomnosti m. RNA) mohou vázat jakoukoliv aminoacyl-t. RNA
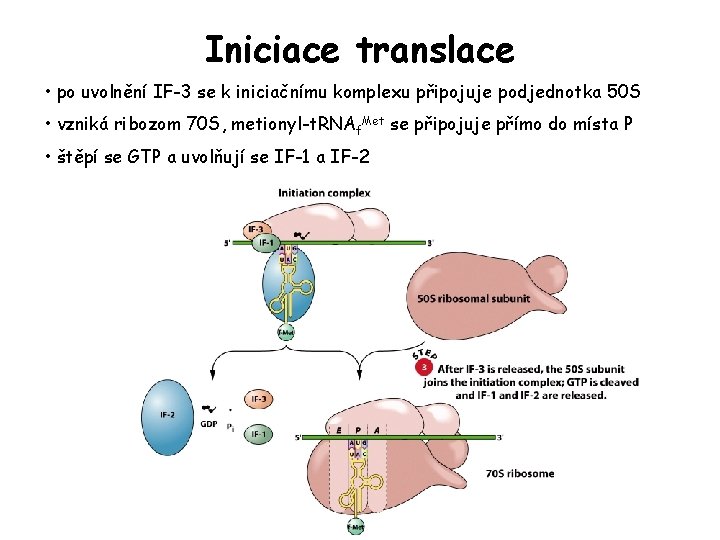
Průběh translace 3 fáze: iniciace, elongace, terminace 1. Iniciace translace zahrnuje všechny děje, které předcházejí tvorbě peptidové vazby mezi prvními dvěma AK nového polypeptidu Zapojené molekuly u prokaryot: • podjednotka 30 S ribozomu • iniciátorová t. RNA • m. RNA • tři rozpustné iniciační faktory: IF-1, IF-2, IF-3 • jedna molekula GTP
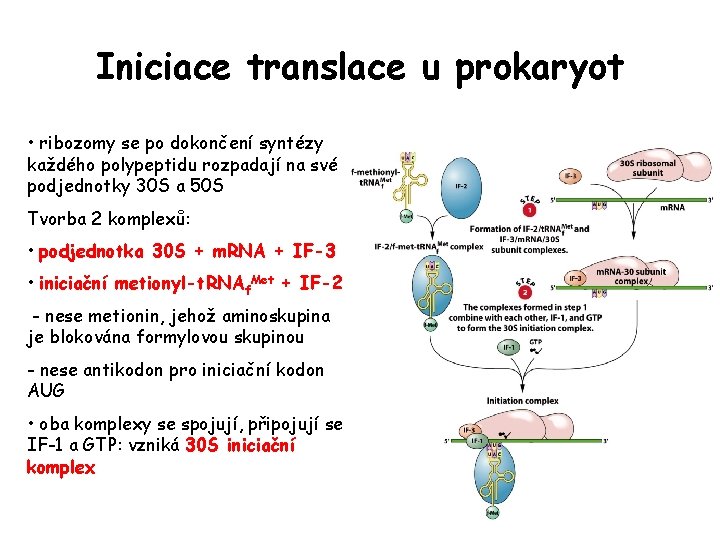
Iniciace translace u prokaryot • ribozomy se po dokončení syntézy každého polypeptidu rozpadají na své podjednotky 30 S a 50 S Tvorba 2 komplexů: • podjednotka 30 S + m. RNA + IF-3 • iniciační metionyl-t. RNAf. Met + IF-2 - nese metionin, jehož aminoskupina je blokována formylovou skupinou - nese antikodon pro iniciační kodon AUG • oba komplexy se spojují, připojují se IF-1 a GTP: vzniká 30 S iniciační komplex
Iniciace translace • po uvolnění IF-3 se k iniciačnímu komplexu připojuje podjednotka 50 S • vzniká ribozom 70 S, metionyl-t. RNAf. Met se připojuje přímo do místa P • štěpí se GTP a uvolňují se IF-1 a IF-2
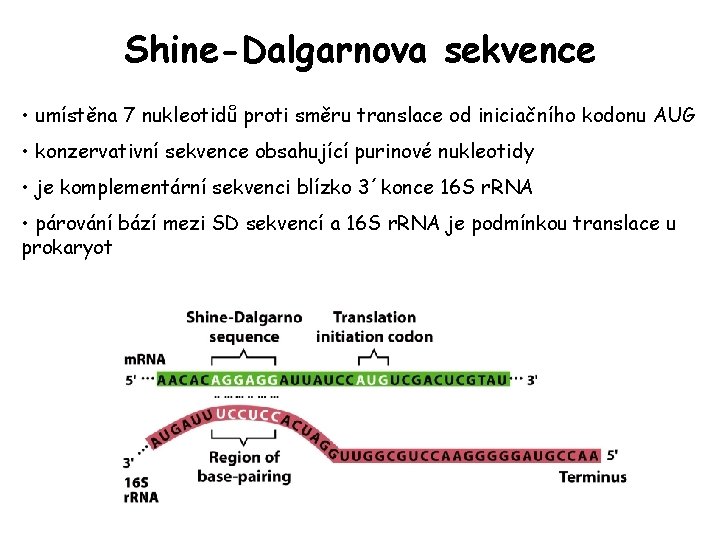
Shine-Dalgarnova sekvence • umístěna 7 nukleotidů proti směru translace od iniciačního kodonu AUG • konzervativní sekvence obsahující purinové nukleotidy • je komplementární sekvenci blízko 3´konce 16 S r. RNA • párování bází mezi SD sekvencí a 16 S r. RNA je podmínkou translace u prokaryot
Iniciace translace u eukaryot • složitější než u prokaryot • zapojeno několik rozpustných iniciačních faktorů • aminoskupina metioninu na iniciátorové t. RNA není formylována • iniciační komplex se tvoří na 5’ konci m. RNA (ne v oblasti Shine -Dalgarno/AUG) • iniciační komplex zkoumá m. RNA od 5´konce a hledá iniciační kodon AUG • translace začíná na prvním AUG od 5´konce
Iniciace translace u eukaryot • protein CBP (cap-binding protein) se váže 7 -metylguanozinovou čepičku na 5´konci m. RNA • ke komplexu CBP-m. RNA se vážou iniciační faktory • následuje vazba malé podjednotky 40 S ribozomu • iniciační komplex se pohybuje ve směru 5´- 3´ po m. RNA dokud a hledá AUG • v místě AUG: iniciační faktory opouštějí iniciační komplex, připojuje se velká podjednotka 60 S • metionyl-t. RNAi. Met se váže přímo do místa P
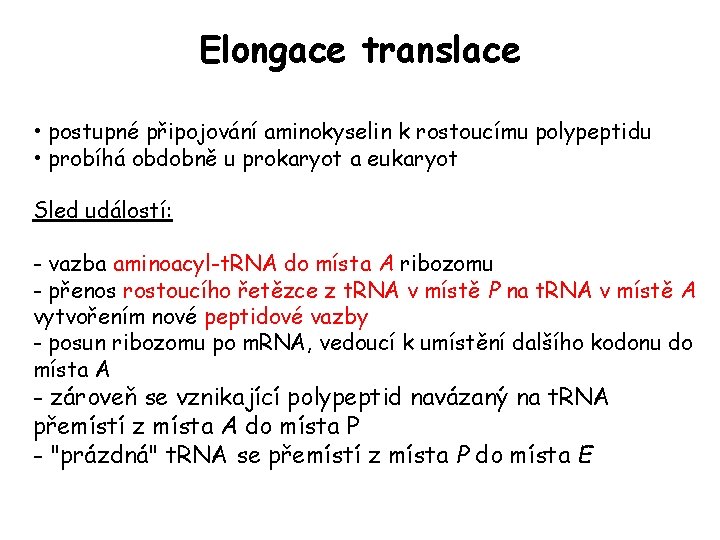
Elongace translace • postupné připojování aminokyselin k rostoucímu polypeptidu • probíhá obdobně u prokaryot a eukaryot Sled událostí: - vazba aminoacyl-t. RNA do místa A ribozomu - přenos rostoucího řetězce z t. RNA v místě P na t. RNA v místě A vytvořením nové peptidové vazby - posun ribozomu po m. RNA, vedoucí k umístění dalšího kodonu do místa A - zároveň se vznikající polypeptid navázaný na t. RNA přemístí z místa A do místa P - "prázdná" t. RNA se přemístí z místa P do místa E
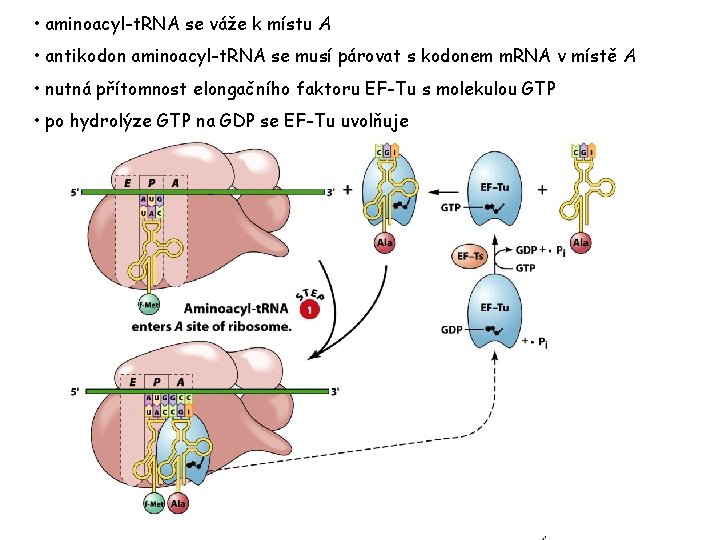
• aminoacyl-t. RNA se váže k místu A • antikodon aminoacyl-t. RNA se musí párovat s kodonem m. RNA v místě A • nutná přítomnost elongačního faktoru EF-Tu s molekulou GTP • po hydrolýze GTP na GDP se EF-Tu uvolňuje
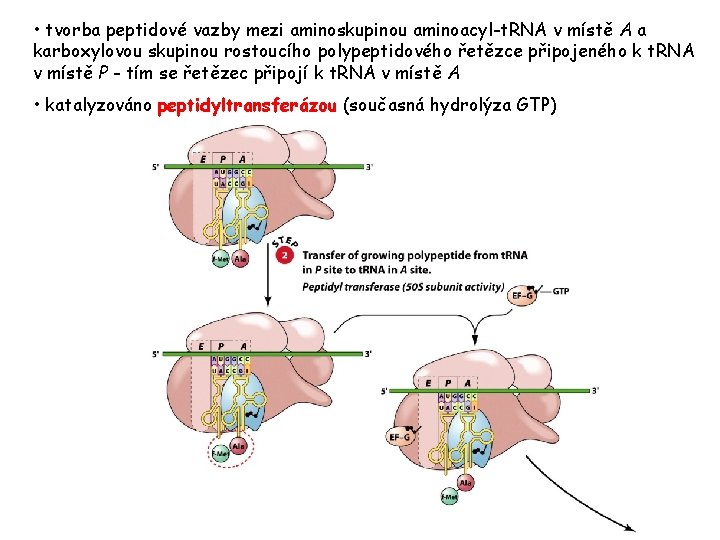
• tvorba peptidové vazby mezi aminoskupinou aminoacyl-t. RNA v místě A a karboxylovou skupinou rostoucího polypeptidového řetězce připojeného k t. RNA v místě P - tím se řetězec připojí k t. RNA v místě A • katalyzováno peptidyltransferázou (současná hydrolýza GTP)
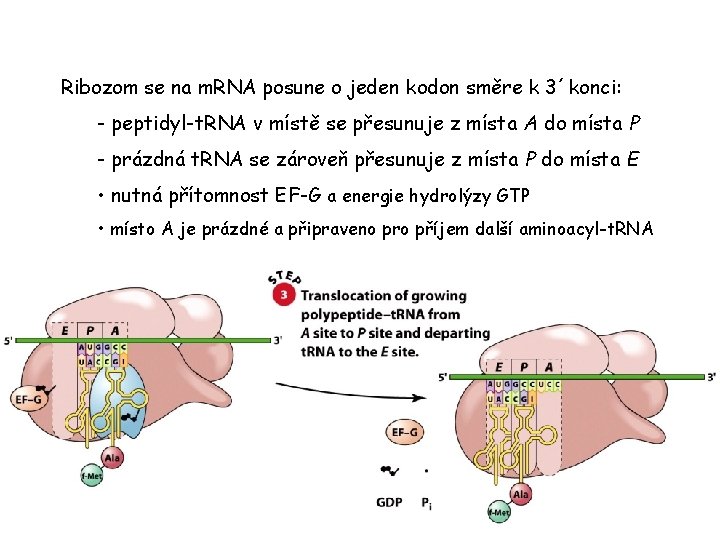
Ribozom se na m. RNA posune o jeden kodon směre k 3´konci: - peptidyl-t. RNA v místě se přesunuje z místa A do místa P - prázdná t. RNA se zároveň přesunuje z místa P do místa E • nutná přítomnost EF-G a energie hydrolýzy GTP • místo A je prázdné a připraveno pro příjem další aminoacyl-t. RNA
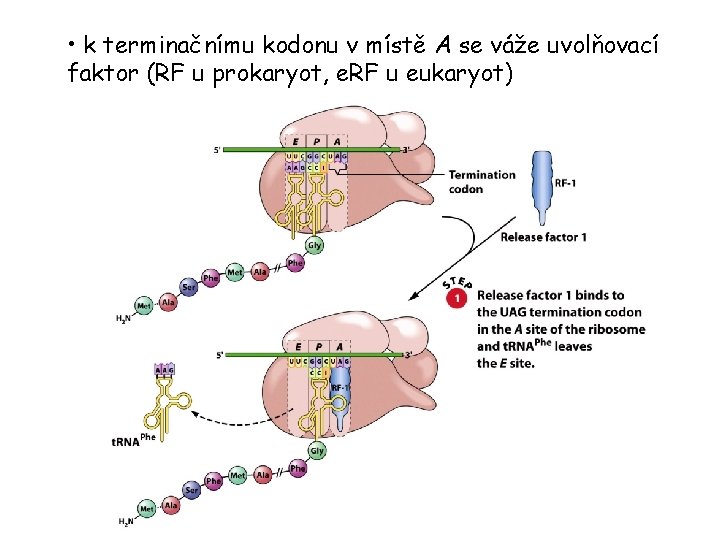
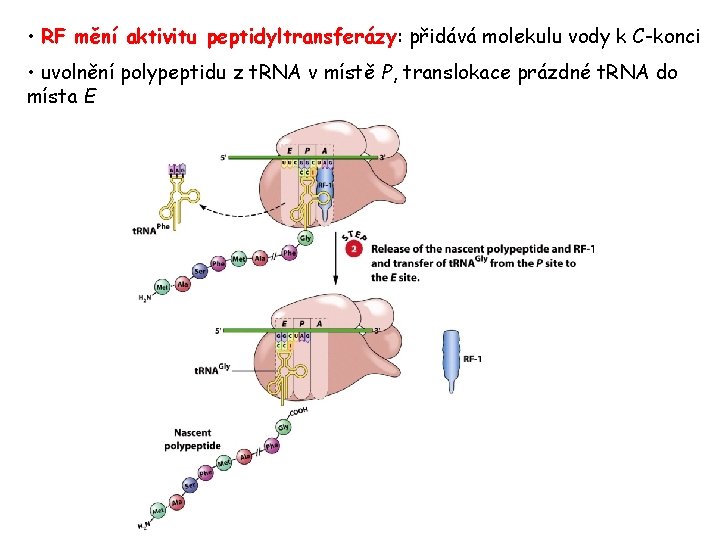
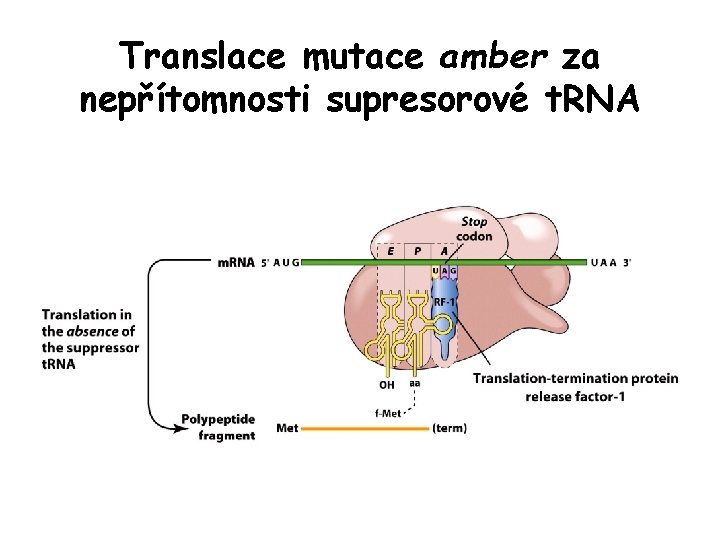
Terminace translace • nastává v okamžiku, kdy do místa A vstoupí terminační kodon (stop kodon): UAA, UAG nebo UGA • zároveň se do místa A váže uvolňovací faktor • ke karboxylovému konci vzniklého polypeptidu se naváže molekula vody, což vede k terminaci translace
• k terminačnímu kodonu v místě A se váže uvolňovací faktor (RF u prokaryot, e. RF u eukaryot)
• RF mění aktivitu peptidyltransferázy: přidává molekulu vody k C-konci • uvolnění polypeptidu z t. RNA v místě P, translokace prázdné t. RNA do místa E
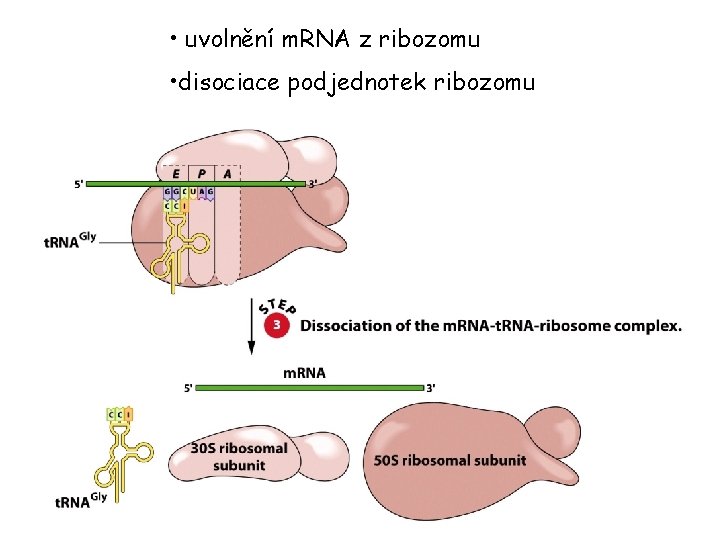
• uvolnění m. RNA z ribozomu • disociace podjednotek ribozomu
Take home message • genetická informace uložená v sekvencích nukleotidů m. RNA se překládá do sekvencí aminokyselin v polypeptidech pomocí ribozomů a složitého aparátu • translační proces je složitý a vyžaduje účast mnoha různých RNA a proteinů • t. RNA slouží jako adaptéry zprostředkující interakce mezi aminokyselinami a kodony v m. RNA • translace probíhá ve fázích iniciace, elongace, terminace podle genetického kódu
Genetický kód • nepřekrývající se kód, který určuje typ aminokyseliny, iniciaci a terminaci translace
Vlastnosti genetického kódu • • • složen z tripletů nukleotidů triplety se nepřekrývají neobsahuje interpunkční znaménka je degenerovaný obsahuje kodony pro začátek a konec translace je téměř univerzální
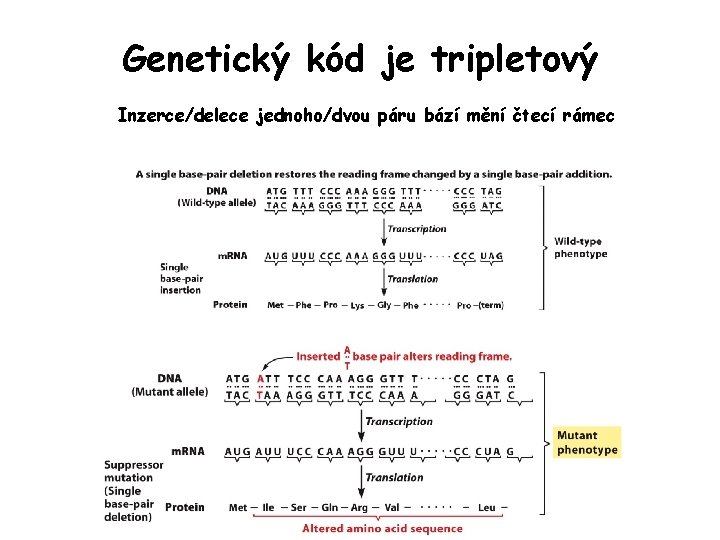
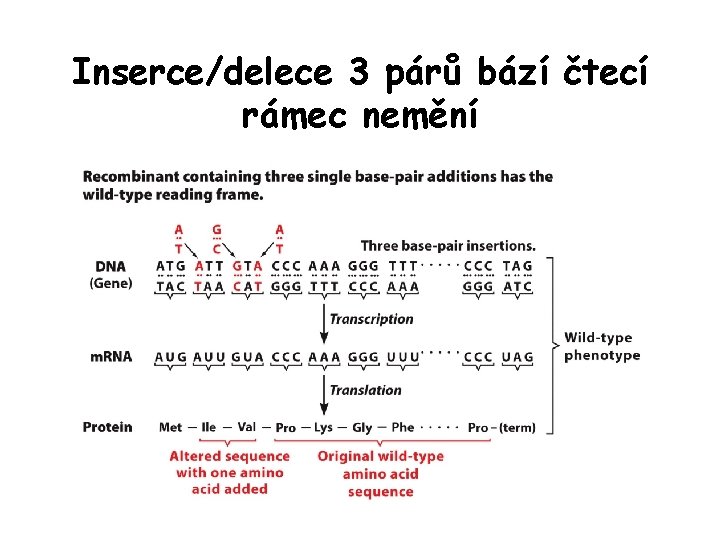
Genetický kód je tripletový Inzerce/delece jednoho/dvou páru bází mění čtecí rámec
Inserce/delece 3 párů bází čtecí rámec nemění
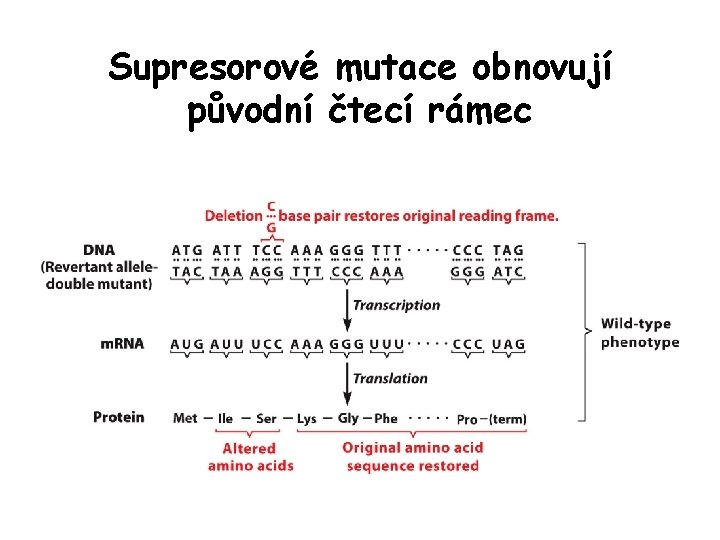
Supresorové mutace obnovují původní čtecí rámec
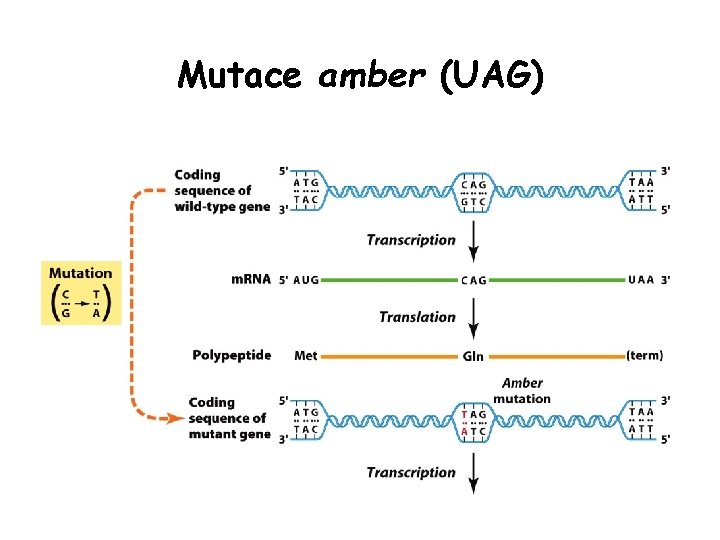
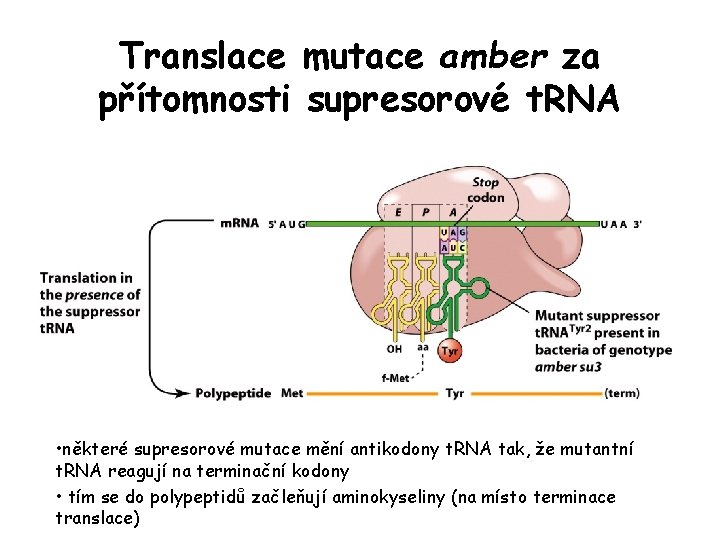
Supresorové mutace • některé mutace v genech pro t. RNA mění strukturu antikodonů a proto vedou k chybné interpretaci kodonů v m. RNA • tyto mutace byly původně nalezeny jako supresorové mutace, které potlačovaly účinek jiných mutací • příklad: mutace t. RNA, které suprimují mutace amber (mutace způsobující terminaci řetězce UAG) v kódující sekvenci genu
Mutace amber (UAG)
Translace mutace amber za nepřítomnosti supresorové t. RNA
Translace mutace amber za přítomnosti supresorové t. RNA • některé supresorové mutace mění antikodony t. RNA tak, že mutantní t. RNA reagují na terminační kodony • tím se do polypeptidů začleňují aminokyseliny (na místo terminace translace)
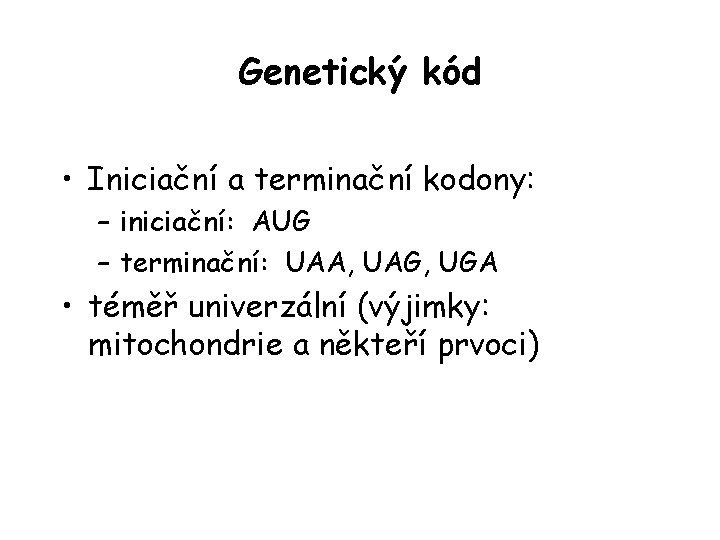
Genetický kód • Iniciační a terminační kodony: – iniciační: AUG – terminační: UAA, UAG, UGA • téměř univerzální (výjimky: mitochondrie a někteří prvoci)
Take home message • každá z 20 aminokyselin v proteinech je určena jedním nebo několika nukleotidovými triplety v m. RNA • z 64 možných tripletů vytvořených ze 4 bází v m. RNA, 61 určuje aminokyseliny a 3 signalizují terminaci řetězce • kód je nepřekrývající (každý nukleotid patří k jedinému kodonu), degenerovaný (většina AK je určena 2 -4 kodony) • kód je téměř univerzální; s minimálními výjimkami má 64 tripletů stejný význam u všech organizmů
Potvrzení povahy genetického kódu in vivo • srovnání nukleotidových sekvencí genů se sekvencemi aminokyselin jejich polypeptidových produktů prokázalo, že kódující smysl kodonů vyvozený ze studií in vitro plně odpovídá jejich využití při proteosyntéze v živých buňkách • srpkovitá anémie: srovnání nukleotidové sekvence normální a "nemocné" alely a jejich proteinových produktů