El Algoritmo de Floyd Captulo 6 Grafos con
- Slides: 43
El Algoritmo de Floyd Capítulo 6
Grafos con Pesos • Un grafo dirigido en la cual hay asociado con cada arista un número positivo (el “peso”) se llama un grafo dirigido con pesos. • El largo de una trayectoria de un vértice u a otro vértice v es la suma de los pesos de las aristas que componen la trayectoria.
El Problema de Todos Pares Distancias mas Cortas • Dado un grafo dirigido con pesos, ¿cuales son las trayectorias de largos mínimos (es decir “distancias mas cortas”) entre todos los pares de vértices?
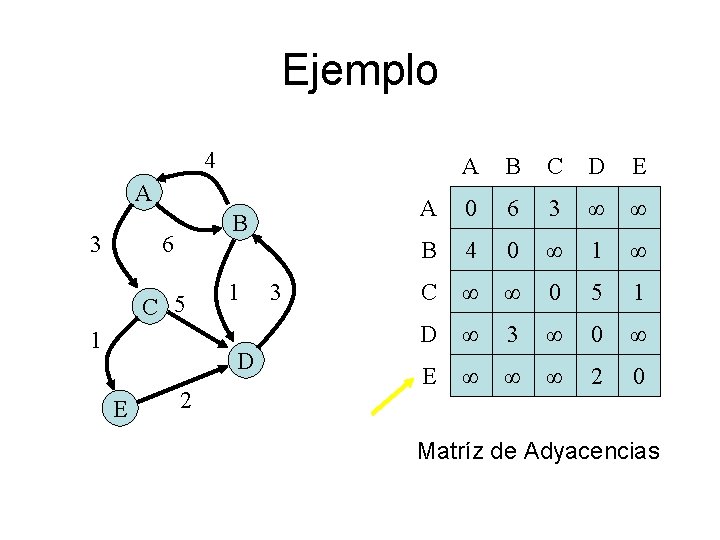
La Matríz de Adyacencias • Representar un grafo dirigido con pesos G con n vértices por una matríz MG como sigue: • Si 1, 2, … , n son los vértices, entonces el elemento en la fila #i y la columna #j es 0 si i=j, es ∞ (un número mas grande que cualquier peso) si no hay arista de I a j, y es el peso de la arista de i a j si tal arista existe. Lamemos MG la matríz de adyacencias.
Ejemplo 4 A 3 B 6 C 5 1 1 D E 2 3 A B C D E A 0 6 3 ∞ ∞ B 4 0 ∞ 1 ∞ C ∞ ∞ 0 5 1 D ∞ 3 ∞ 0 ∞ E ∞ ∞ ∞ 2 0 Matríz de Adyacencias
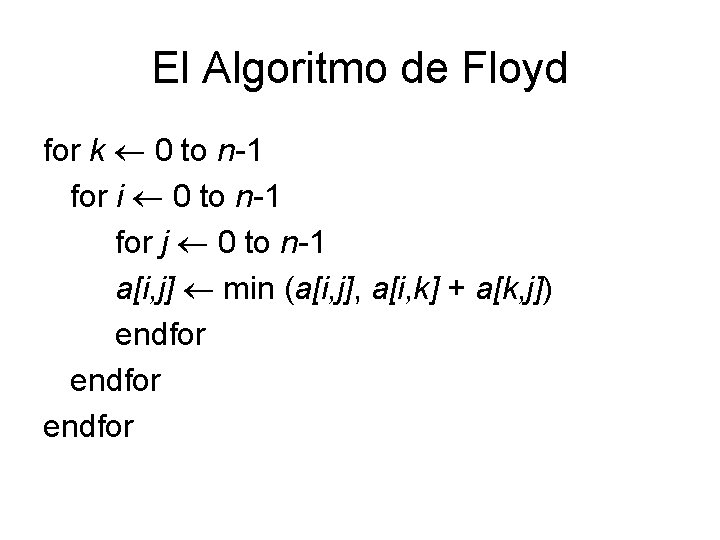
El Algoritmo de Floyd for k 0 to n-1 for i 0 to n-1 for j 0 to n-1 a[i, j] min (a[i, j], a[i, k] + a[k, j]) endfor
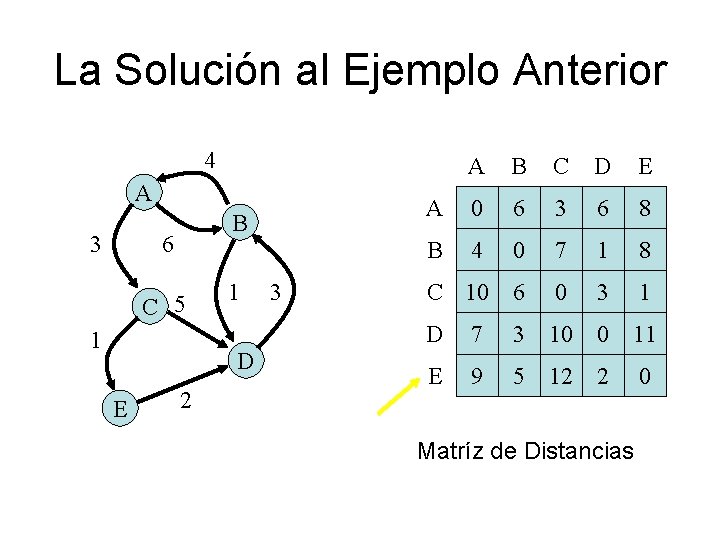
La Solución al Ejemplo Anterior 4 A 3 B 6 C 5 1 1 D E 2 3 A B C D E A 0 6 3 6 8 B 4 0 7 1 8 C 10 6 0 3 1 D 7 3 10 0 11 E 9 5 12 2 0 Matríz de Distancias
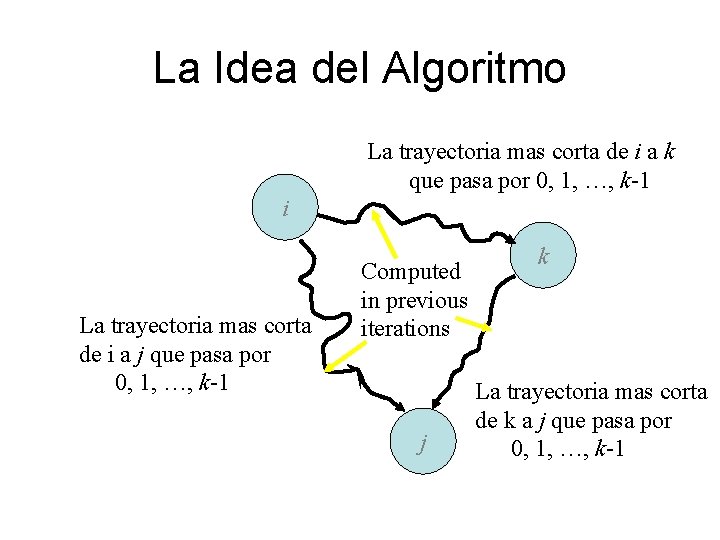
La Idea del Algoritmo La trayectoria mas corta de i a k que pasa por 0, 1, …, k-1 i La trayectoria mas corta de i a j que pasa por 0, 1, …, k-1 Computed in previous iterations j k La trayectoria mas corta de k a j que pasa por 0, 1, …, k-1
El Diseño del Algoritmo Paralelo • Particionar • Patronos de Comunicaciones • Aglomeración y Asignación
Particionar • En el seudo código la misma asignación se ejecuta n 3 veces. • No hay paralelismo funcional. • Usemos descomposición de dominio: particionar la matriz A en sus n 2 elementos.
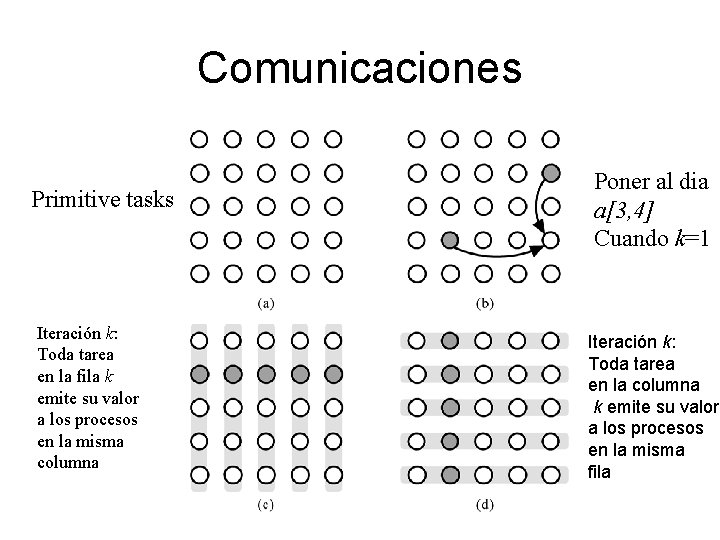
Comunicaciones • Para todo valor de k, a[k, m] se necesita por toda tarea asociada con elementos en la columna m y a[m, k] se necesita por toda tarea asociada con elements de la fila m. • Durante de la iteración k, todo element en la fila k se emit a las tareas de la misma columna y todo elemento de la columna a se emite a la tarea en la misma fila
Comunicaciones Primitive tasks Iteración k: Toda tarea en la fila k emite su valor a los procesos en la misma columna Poner al dia a[3, 4] Cuando k=1 Iteración k: Toda tarea en la columna k emite su valor a los procesos en la misma fila
Aglomeración y Asignación • El número de taréas es estático • Las comunicaciones entre las tareas son regulares • El tiempo de computación por tarea es constante • Un buena estrategia en este caso es – Aglomerar tareas pare minimizar las comunicaciones – Crear una tarea por proceso MPI
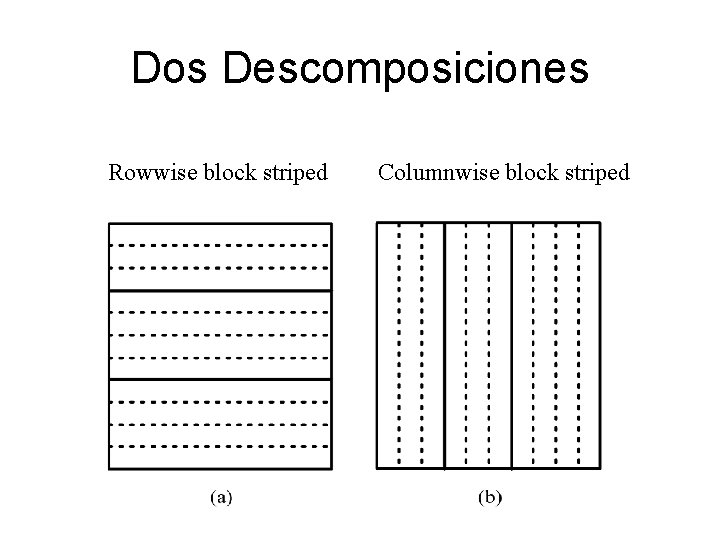
Dos Descomposiciones Rowwise block striped Columnwise block striped
Comparación de Descomposiciones • Columnwise block striped – Se eliminan las emisiones dentro de las columnas • Rowwise block striped – Se eliminan las emisiones dentro de las columnas – Escribir la salida es mas simple • Escoja rowwise
La Entrada de la Matríz de Adyacencias • La matríz se guarda en el orden “row major” en un archivo”. • Si hay p procesos, entonces para cada i=0, 1, …, p-2, el proceso p-1 lee la fila in/p hasta la fila (i+1)n/p -1 y las envia al proceso i. Después, lee las últimas filas para le mismo. • La razón por la cual p-1 hace este trabajo es que no hay ningun proceso que va a ser responsible por mas filas que el p-1 (Ejercicio 6. 1)
Comunicación Punto-Punto • Envolve dos procesos • Un proceso envia un mensaje • El otro proceso receive el mensaje
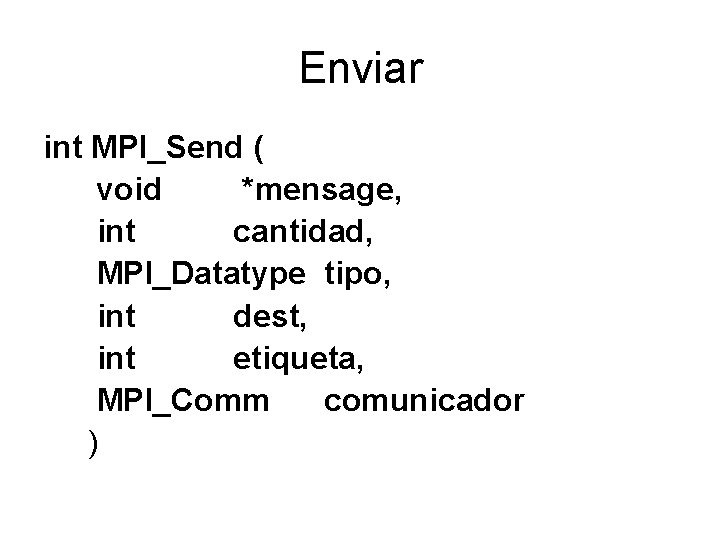
Enviar int MPI_Send ( void *mensage, int cantidad, MPI_Datatype tipo, int dest, int etiqueta, MPI_Comm comunicador )
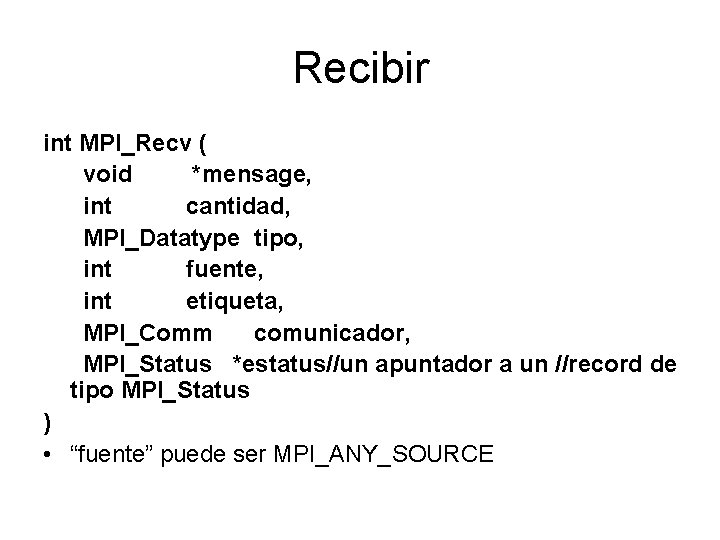
Recibir int MPI_Recv ( void *mensage, int cantidad, MPI_Datatype tipo, int fuente, int etiqueta, MPI_Comm comunicador, MPI_Status *estatus//un apuntador a un //record de tipo MPI_Status ) • “fuente” puede ser MPI_ANY_SOURCE
El Argumento estatus de MPI_Recv • Antes de usar MPI_Recv, hay que declarar un record de tipo MPI_Status • Este record contiene tres campos: - MPI_source: el rango del proceso que envió el mensaje - MPI_tag: la etiqueta del mensaje - MPI_ERROR: la condición de error
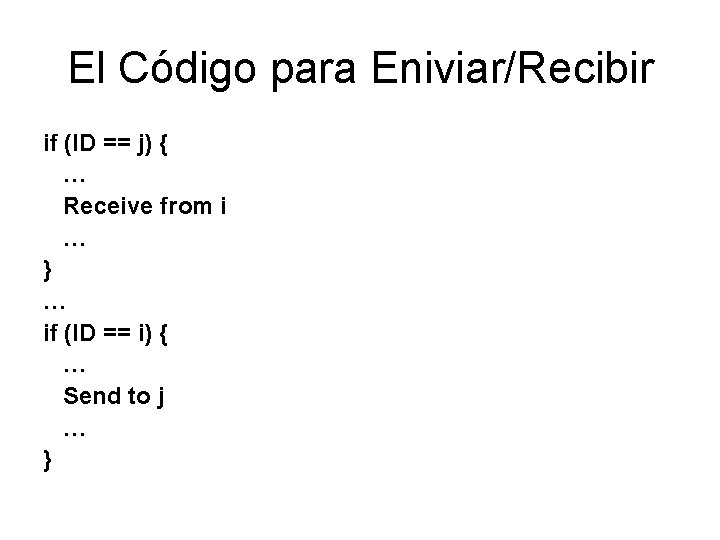
El Código para Eniviar/Recibir if (ID == j) { … Receive from i … } … if (ID == i) { … Send to j … }
MPI_Send • La función bloquea hasta que el buffer este libre • Tipicamente el mensaje se envia a un buffer de mensaje que permite la devolución de control al proceso que llamó
MPI_Recv • La función bloquea hasta que el mensaje se haya recibido o hasta que un error se haya detectado • Cuando occure un error, el record dado como el último argumentocontiene información acerca del proceso que envió el mensaje, el valor de la etiqueta, y la condición de error.
Punto Muerto (“Deadlock”) • Ocurre cuando un proceso espera una condición que nunca occura. • Ejemplos en los cuales punto muerto ocurre: – Dos procesos reciben antes de enviar. – La etiqueta de enviar no es la misma como la etiqueta de recibir. – Un proceso envia un mensaje a una destinación incorrecta.
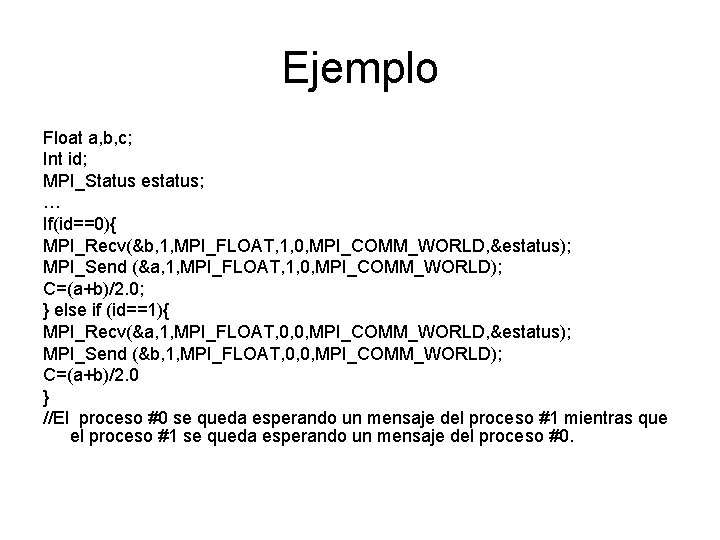
Ejemplo Float a, b, c; Int id; MPI_Status estatus; … If(id==0){ MPI_Recv(&b, 1, MPI_FLOAT, 1, 0, MPI_COMM_WORLD, &estatus); MPI_Send (&a, 1, MPI_FLOAT, 1, 0, MPI_COMM_WORLD); C=(a+b)/2. 0; } else if (id==1){ MPI_Recv(&a, 1, MPI_FLOAT, 0, 0, MPI_COMM_WORLD, &estatus); MPI_Send (&b, 1, MPI_FLOAT, 0, 0, MPI_COMM_WORLD); C=(a+b)/2. 0 } //El proceso #0 se queda esperando un mensaje del proceso #1 mientras que el proceso #1 se queda esperando un mensaje del proceso #0.
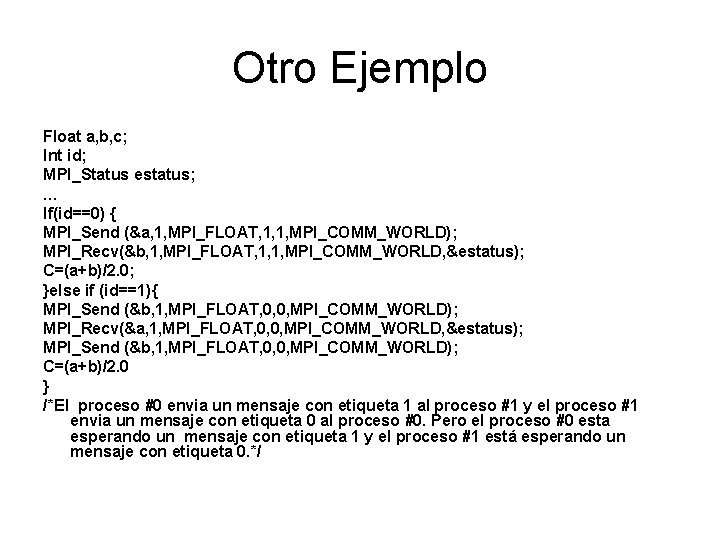
Otro Ejemplo Float a, b, c; Int id; MPI_Status estatus; … If(id==0) { MPI_Send (&a, 1, MPI_FLOAT, 1, 1, MPI_COMM_WORLD); MPI_Recv(&b, 1, MPI_FLOAT, 1, 1, MPI_COMM_WORLD, &estatus); C=(a+b)/2. 0; }else if (id==1){ MPI_Send (&b, 1, MPI_FLOAT, 0, 0, MPI_COMM_WORLD); MPI_Recv(&a, 1, MPI_FLOAT, 0, 0, MPI_COMM_WORLD, &estatus); MPI_Send (&b, 1, MPI_FLOAT, 0, 0, MPI_COMM_WORLD); C=(a+b)/2. 0 } /*El proceso #0 envia un mensaje con etiqueta 1 al proceso #1 y el proceso #1 envia un mensaje con etiqueta 0 al proceso #0. Pero el proceso #0 esta esperando un mensaje con etiqueta 1 y el proceso #1 está esperando un mensaje con etiqueta 0. */
Una Versión Paralela en MPI del Algoritmo de Floyd • La entrada consiste de un archivo que contiene una matríz n X n de enteros. • Esta matriz se puede leer haciendo uso de una función read_row_striped_matrix
read_row_striped_matrix • Esta función pone las filas de la matríz de entrada en los p procesadores de acuerdo con el Método 2, es decir que el procesador i, i=0, 1, …, p-1, irecibirá las filas i n/p hasta la (i + 1) n/p -1 • Dado el nombre del archivo de entrada, el tipo de dato de los elementos de la matriz, y un comunicador, (1) devuelve un apuntador a un arreglo de apuntadores y (2) un apuntador a la localización que contiene la matrix, y (3) las dimensiones de la matriz
Funciones Disponibles • read_row_striped_matrix además de otras funciones útiles se encuentran en el archivo My. MPI. h • Este archivo además del código de fuente de los otros programas del texto se encuentran en la página de Michael J. Quinn: http: //ac-staff. seattleu. edu/quinnm/web. /education/Parallel. Programming
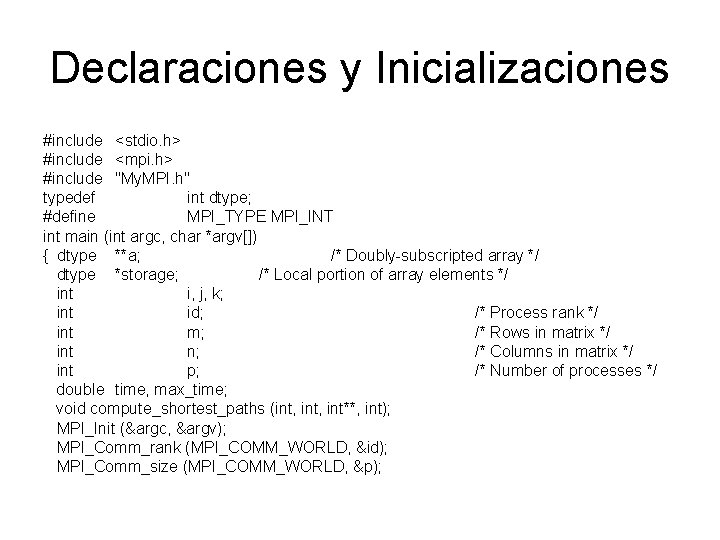
Declaraciones y Inicializaciones #include <stdio. h> #include <mpi. h> #include "My. MPI. h" typedef int dtype; #define MPI_TYPE MPI_INT int main (int argc, char *argv[]) { dtype **a; /* Doubly-subscripted array */ dtype *storage; /* Local portion of array elements */ int i, j, k; int id; /* Process rank */ int m; /* Rows in matrix */ int n; /* Columns in matrix */ int p; /* Number of processes */ double time, max_time; void compute_shortest_paths (int, int**, int); MPI_Init (&argc, &argv); MPI_Comm_rank (MPI_COMM_WORLD, &id); MPI_Comm_size (MPI_COMM_WORLD, &p);
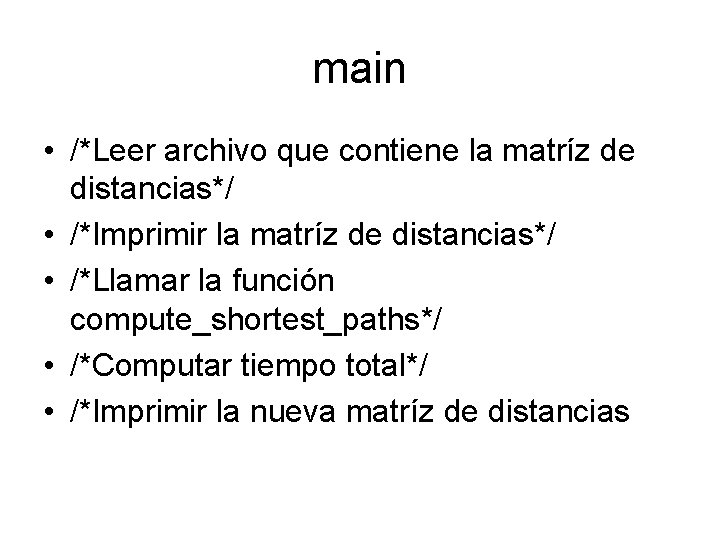
main • /*Leer archivo que contiene la matríz de distancias*/ • /*Imprimir la matríz de distancias*/ • /*Llamar la función compute_shortest_paths*/ • /*Computar tiempo total*/ • /*Imprimir la nueva matríz de distancias
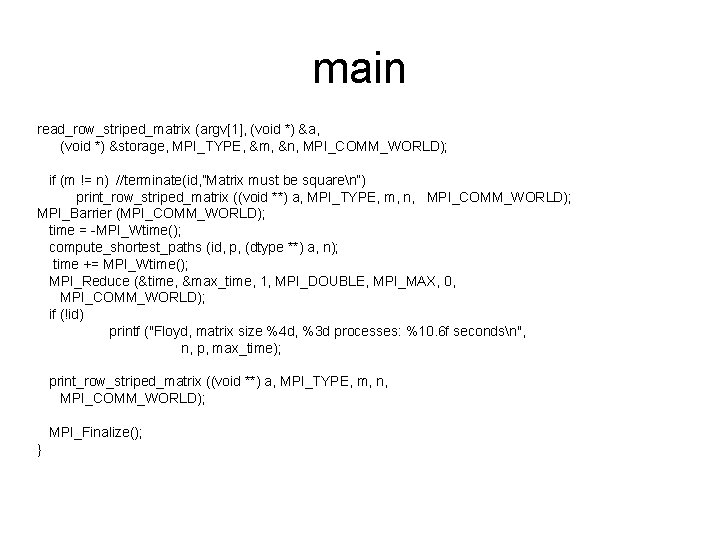
main read_row_striped_matrix (argv[1], (void *) &a, (void *) &storage, MPI_TYPE, &m, &n, MPI_COMM_WORLD); if (m != n) //terminate(id, ”Matrix must be squaren”) print_row_striped_matrix ((void **) a, MPI_TYPE, m, n, MPI_COMM_WORLD); MPI_Barrier (MPI_COMM_WORLD); time = -MPI_Wtime(); compute_shortest_paths (id, p, (dtype **) a, n); time += MPI_Wtime(); MPI_Reduce (&time, &max_time, 1, MPI_DOUBLE, MPI_MAX, 0, MPI_COMM_WORLD); if (!id) printf ("Floyd, matrix size %4 d, %3 d processes: %10. 6 f secondsn", n, p, max_time); print_row_striped_matrix ((void **) a, MPI_TYPE, m, n, MPI_COMM_WORLD); MPI_Finalize(); }
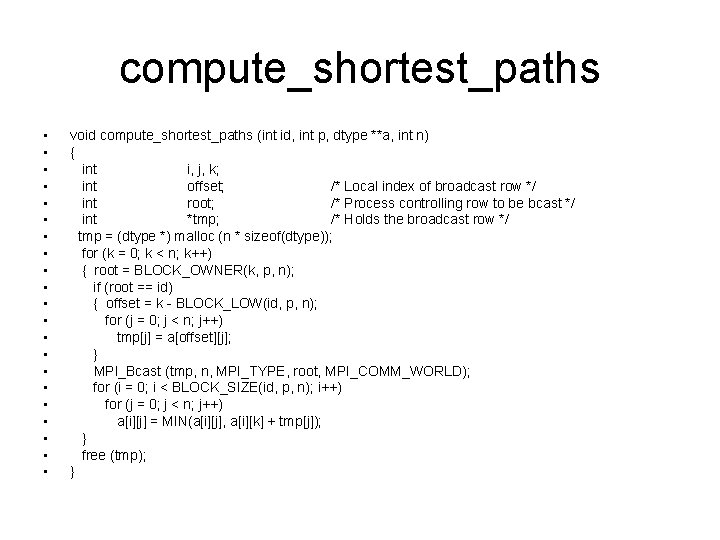
compute_shortest_paths • • • • • • void compute_shortest_paths (int id, int p, dtype **a, int n) { int i, j, k; int offset; /* Local index of broadcast row */ int root; /* Process controlling row to be bcast */ int *tmp; /* Holds the broadcast row */ tmp = (dtype *) malloc (n * sizeof(dtype)); for (k = 0; k < n; k++) { root = BLOCK_OWNER(k, p, n); if (root == id) { offset = k - BLOCK_LOW(id, p, n); for (j = 0; j < n; j++) tmp[j] = a[offset][j]; } MPI_Bcast (tmp, n, MPI_TYPE, root, MPI_COMM_WORLD); for (i = 0; i < BLOCK_SIZE(id, p, n); i++) for (j = 0; j < n; j++) a[i][j] = MIN(a[i][j], a[i][k] + tmp[j]); } free (tmp); }
Un Program para Generar una Matríz de Distancias Aleatorias • gen. Mat 4 floyd escrito por Andrea di Blas • Hay 4 entradas en la linea de comando: n (el número de vértices) r (la “densidad”, es decir el porciento de números no cero en la matríz de distancias) salida (el nombre del archivo de salida) seed (la “semilla” del generador de números aleatorios.
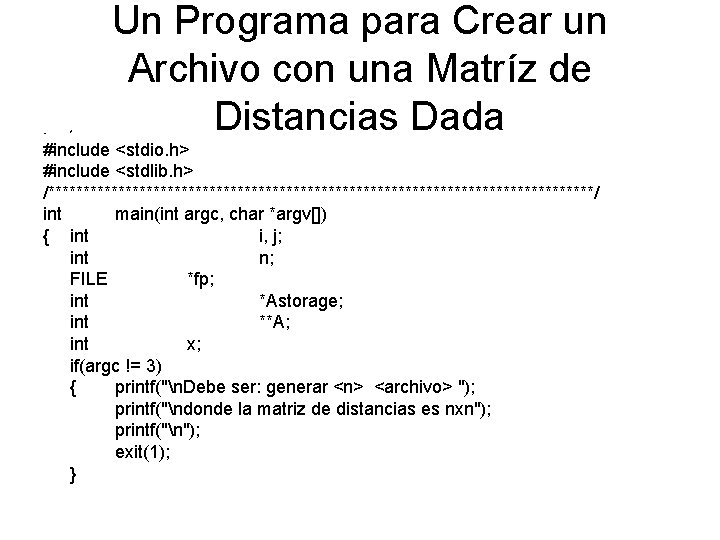
• * Un Programa para Crear un Archivo con una Matríz de Distancias Dada #include <stdio. h> #include <stdlib. h> /***************************************/ int main(int argc, char *argv[]) { int i, j; int n; FILE *fp; int *Astorage; int **A; int x; if(argc != 3) { printf("n. Debe ser: generar <n> <archivo> "); printf("ndonde la matriz de distancias es nxn"); printf("n"); exit(1); }
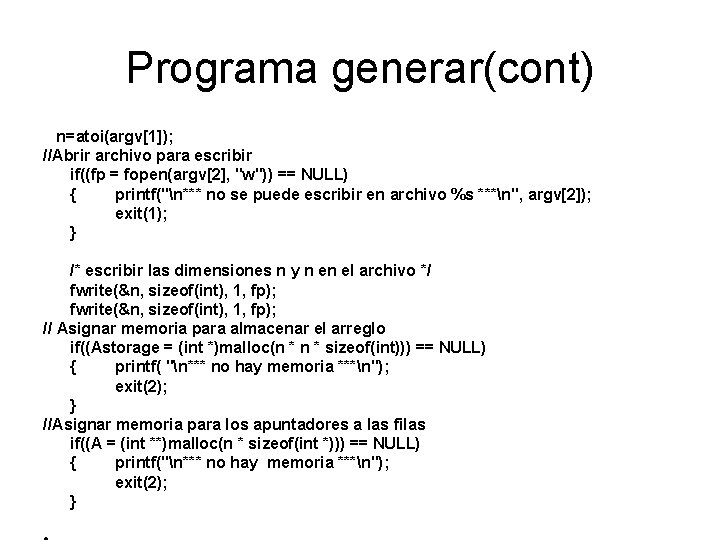
Programa generar(cont) n=atoi(argv[1]); //Abrir archivo para escribir if((fp = fopen(argv[2], "w")) == NULL) { printf("n*** no se puede escribir en archivo %s ***n", argv[2]); exit(1); } /* escribir las dimensiones n y n en el archivo */ fwrite(&n, sizeof(int), 1, fp); // Asignar memoria para almacenar el arreglo if((Astorage = (int *)malloc(n * sizeof(int))) == NULL) { printf( "n*** no hay memoria ***n"); exit(2); } //Asignar memoria para los apuntadores a las filas if((A = (int **)malloc(n * sizeof(int *))) == NULL) { printf("n*** no hay memoria ***n"); exit(2); }
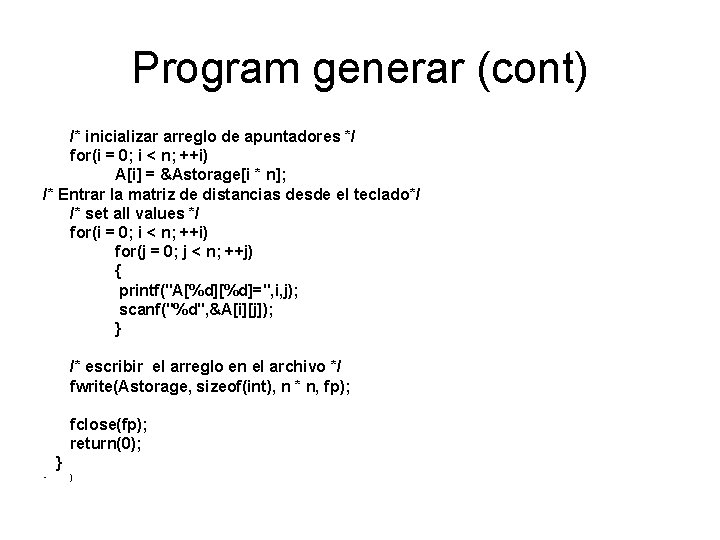
Program generar (cont) /* inicializar arreglo de apuntadores */ for(i = 0; i < n; ++i) A[i] = &Astorage[i * n]; /* Entrar la matriz de distancias desde el teclado*/ /* set all values */ for(i = 0; i < n; ++i) for(j = 0; j < n; ++j) { printf("A[%d]=", i, j); scanf("%d", &A[i][j]); } /* escribir el arreglo en el archivo */ fwrite(Astorage, sizeof(int), n * n, fp); fclose(fp); return(0); • } }
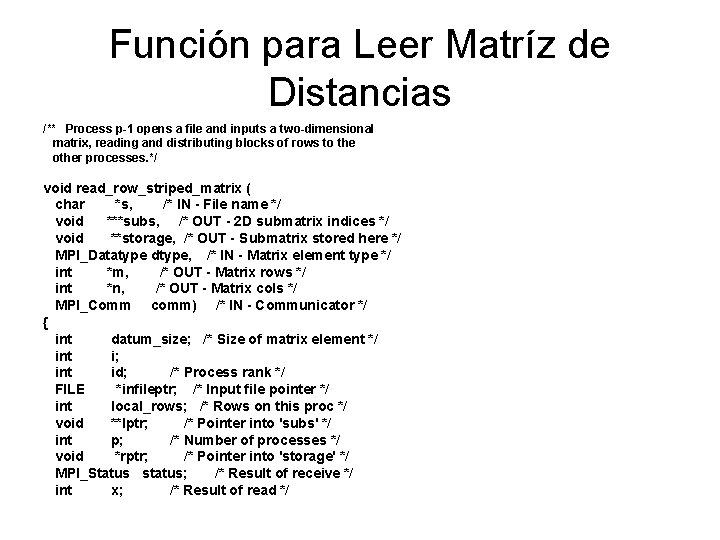
Función para Leer Matríz de Distancias /** Process p-1 opens a file and inputs a two-dimensional matrix, reading and distributing blocks of rows to the other processes. */ void read_row_striped_matrix ( char *s, /* IN - File name */ void ***subs, /* OUT - 2 D submatrix indices */ void **storage, /* OUT - Submatrix stored here */ MPI_Datatype dtype, /* IN - Matrix element type */ int *m, /* OUT - Matrix rows */ int *n, /* OUT - Matrix cols */ MPI_Comm comm) /* IN - Communicator */ { int datum_size; /* Size of matrix element */ int i; int id; /* Process rank */ FILE *infileptr; /* Input file pointer */ int local_rows; /* Rows on this proc */ void **lptr; /* Pointer into 'subs' */ int p; /* Number of processes */ void *rptr; /* Pointer into 'storage' */ MPI_Status status; /* Result of receive */ int x; /* Result of read */
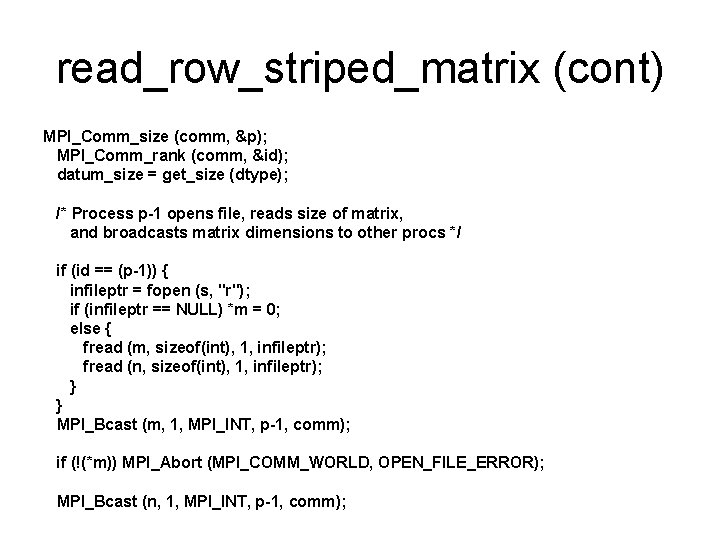
read_row_striped_matrix (cont) MPI_Comm_size (comm, &p); MPI_Comm_rank (comm, &id); datum_size = get_size (dtype); /* Process p-1 opens file, reads size of matrix, and broadcasts matrix dimensions to other procs */ if (id == (p-1)) { infileptr = fopen (s, "r"); if (infileptr == NULL) *m = 0; else { fread (m, sizeof(int), 1, infileptr); fread (n, sizeof(int), 1, infileptr); } } MPI_Bcast (m, 1, MPI_INT, p-1, comm); if (!(*m)) MPI_Abort (MPI_COMM_WORLD, OPEN_FILE_ERROR); MPI_Bcast (n, 1, MPI_INT, p-1, comm);
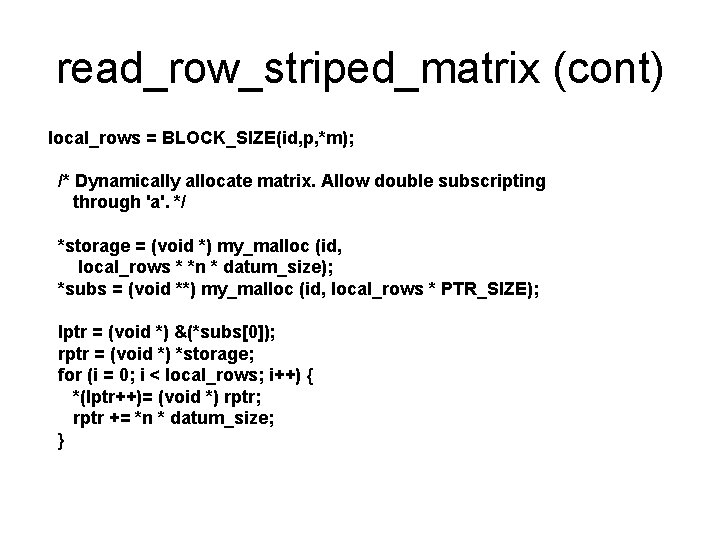
read_row_striped_matrix (cont) local_rows = BLOCK_SIZE(id, p, *m); /* Dynamically allocate matrix. Allow double subscripting through 'a'. */ *storage = (void *) my_malloc (id, local_rows * *n * datum_size); *subs = (void **) my_malloc (id, local_rows * PTR_SIZE); lptr = (void *) &(*subs[0]); rptr = (void *) *storage; for (i = 0; i < local_rows; i++) { *(lptr++)= (void *) rptr; rptr += *n * datum_size; }
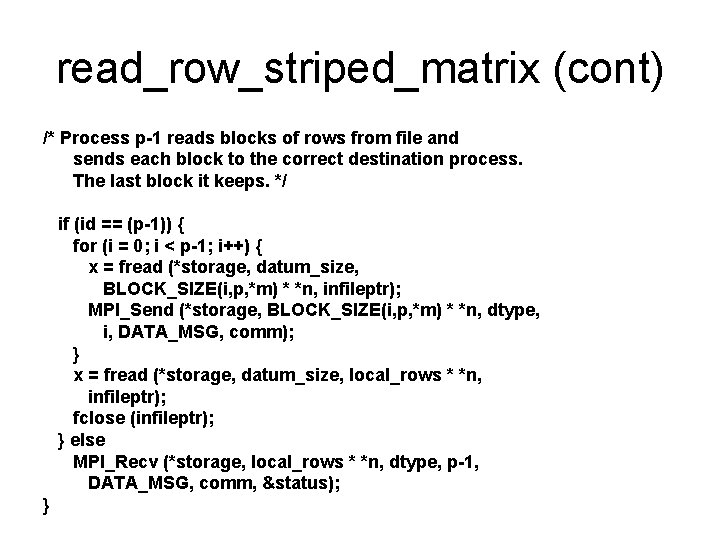
read_row_striped_matrix (cont) /* Process p-1 reads blocks of rows from file and sends each block to the correct destination process. The last block it keeps. */ if (id == (p-1)) { for (i = 0; i < p-1; i++) { x = fread (*storage, datum_size, BLOCK_SIZE(i, p, *m) * *n, infileptr); MPI_Send (*storage, BLOCK_SIZE(i, p, *m) * *n, dtype, i, DATA_MSG, comm); } x = fread (*storage, datum_size, local_rows * *n, infileptr); fclose (infileptr); } else MPI_Recv (*storage, local_rows * *n, dtype, p-1, DATA_MSG, comm, &status); }
Como Usar el Programa Paralelo de Floyd • Crear un archivo que contiene la matríz de distancias utilizando o generar. c (para un grafo especifico) o gen. Mat 4 floyd. c (para un grafo a la azar) • Si el archivo de objeto está en generar o gen. Mat 4 floyd, respectivamente, entonces se ejecutan por • . /generar n archivo • o. /gen. Mat 4 floyd n r archivo semilla
Compilar y Ejecutar • Compilar My. MPI. c y floyd. c separadamente para crear archivos o mpicc –c My. MPI. c mpicc –c floyd. c • Link: mpicc My. MPI. o floyd. o -o floyd • Ejecutar: . /floyd archivo