EKONOMETRIKA PERTEMUAN 3 REGRESI LINIER SEDERHANA lanjutan Pemeriksaan



- Slides: 29
EKONOMETRIKA PERTEMUAN 3 REGRESI LINIER SEDERHANA (lanjutan)
Pemeriksaan Persamaan Regresi ( standard Error ) Harus diingat bahwa metode yang digunakan untuk menduga model dilandasi pada prinsip meminimalkan error n Hubungan error yang minimal akan mengakibatkan standard error koefisien minimal pula n
Interval Kepercayaan untuk bj n Dalam ilmu statistik, ada dua teknik dalam melakukan pendugaan parameter Pendugaan tunggal(point estimate) l Pendugaan Interval (interval estimate) l
Interval Kepercayaan untuk bj Pendugaan tunggal yaitu menaksir nilai-nilai koefisien regresi diatas, yaitu menduga nilai Bj dengan bj (ini yang sering digunakan) n Pendugaan interval yaitu menaksir nilai Bj dalam suatu selang nilai n
Interval Kepercayaan untuk bj n n t α/2 diperoleh dari tabel distribusi t dengan keyakinan (1 -α) x 100%. Maksudnya, jika α = 5%, apabila dalam populasi yang sama percobaan dilakukan sebanyak 100 kali, maka bj akan berada pada interval tersebut sebanyak 95 kali Nilai α juga dapat dinyatakan sebagai besarnya tingkat kesalahan yang dapat ditolerir Umumnya untuk ilmu sosial termasuk ekonomi dan keuangan besarnya α adalah 5 %
Interval Kepercayaan untuk bj Jadi Semakin sempit interval yang dibuat, maka dapat dinyatakan bahwa koefisien regresi yang didapat semakin tepat n Semakin besar Standard error koefisien, maka koefisien regresi yang didapat semakin kurang akurat n
Interval Kepercayaan untuk bj n n Dalam distribusi t sebagai fungsi sebaran yang digunakan dalam membuat interval, dikenal suatu besaran yang disebut derajat bebas (degrees of freedom) df. Secara formulasi derajat bebas ini merupakan pengurangan antara banyaknya observasi (n) dengan banyaknya parameter yang diestimasi (k)
Ilustrasi interval kepercayaan n Misalnya, diketahui: b 1 = 0. 1022 dan s. e(b 1) = 0. 0092 l Banyaknya observasi(n) = 10 l Banyaknya parameter yang diestimasi (k) = 2 l Df = n-k, maka df = 10 – 2 = 8 n Tingkat signifikansi 1 – α = 95 % n
Ilustrasi interval kepercayaan Dari tabel t 0. 025 dengan df = 8, diperoleh nilai t = 2. 306 n Maka interval kepercayaan B 1 adalah (0. 1022 ± 2. 306 (0. 0092)) atau (0. 0810; 0. 1234) n Artinya Nilai B 1 terletak antara 0. 0810 dan 0. 1234 dengan peluang sebesar 95%
Uji Hipotesis n n n Uji Hipotesis berguna untuk memeriksa atau menguji apakah koefisien regresi yang didapat signifikan (berbeda nyata). Maksud signifikan ini adalah suatu nilai koefisien regresi yang secara statistik tidak sama dengan Nol Jika koefisien slope sama dengan nol, berarti dapat dikatakan bahwa tidak cukup bukti untuk menyatakan variabel bebas mempunyai pengaruh terhadap vairabel terikat
Uji Hipotesis n Ada dua jenis pengujian terhadap koefisien regresi yang dapat dilakukan yaitu: Uji F digunakan untuk menguji koefisien (slope) regresi secara bersama-sama l Uji t untuk menguji koefisien regresi, termasuk intercept secara individu l
Uji Hipotesis ( Uji F) n Secara Umum hipotesis dituliskan sebagai berikut: l l n Ho = B 1=B 2=B 3=B 4=…=Bk = 0 H 1 Tidak demikian ( Paling tidak ada satu slope yang ≠ 0 ) Oleh karena dalam regresi sederhana jumlah variabel bebas hanya satu (k=1), maka hipotesisnya menjadi: l l Ho = B 1 = 0 H 1 = B 1 ≠ 0
Uji Hipotesis ( Uji F) Adapun cara pengujian baik dalam regresi sederhana mapun regresi majemuk sama, yaitu dengan menggunakan suatu tabel Anova (Analysis of Variance) n Perhatikan berikut ini: n Observasi = Yi = β 0 + β 1 Xi + ei l Regresi = Ŷi = b 1 + b 2 Xi (catatan: Ŷ merupakan estimasi dari Yi) l
Uji Hipotesis ( Uji F) n n n Dimana df adalah degree of freedom, k adalah jumlah variabel bebas(koefisien slope), dan n jumlah obeservasi (sampel) Setelah didapatkan F Hitung, maka langkah selanjutnya adalah membandingkannya dengan Tabel F dengan df sebesar k dan n-k-1 Jika F hitung > Fα(k, n-k-1) maka tolak Ho atau dengan kata lain bahwa paling tidak ada satu slope regresi yang signifikan secara statistik
Uji Hipotesis ( Uji t) n Secara umum hipotesis dalam uji adalah sbb: Ho = Bj = 0 l H 1 = Bj ≠ 0; j = 0, 1, 2, …, k k adalah koefisien slope l n n n Dari hipotesis tersebut dapat terlihat arti dari pengujian yang dilakukan yaitu berdasarkan data yang tersedia, akan dilakukan pengujian terhadap Bj (koefisien regresi populasi), Jika = 0 berarti variabel bebas tidak mempunyai pengaruh signifikan terhadap variabel terikat, atau Jika ≠ 0 berarti variabel bebas mempunyai pengaruh signifikan terhadap variabel terikat
Uji Hipotesis ( Uji t) n Untuk Regresi sederhana, yang mempunyai dua koefisien regresi (intercept dan sebuah slope), tentu hipotesis yang dibuat akan sebanyak dua buah, yaitu: 1. 2. Ho: β 0 = 0 H 1: β 0 ≠ 0 Ho: β 1 = 0 H 1: β 1 ≠ 0
Uji Hipotesis ( Uji t) n n Jelas bahwa uji hipotesis terhadap slope (β 1) baik secara individua (uji t) maupun bersama-sama (uji f) mempunyai bentuk hipotesis yang sama Nilai t dibandingkan dengan nilai t tabel
Uji Hipotesis ( Uji t) n Jika t hitung > t α(k, n-k-1) maka tolak Ho atau dengan kata lain bahwa Bj statistically significance
Koefisien Determinasi n n Koefisien Determinasi (Good of Fit), yang dinotasikan dengan R 2 , merupakan suatu ukuran yang penting dalam regresi, karena dapat menginformasikan baik atau tidaknya model regresi yang terestimasi Dengan kata lain angka tersebut dapat mengukur seberapa dekatkah garis regresi yang terestimasi dengan data sesungguhnya.
Koefisien Determinasi n n Nilai R 2 ini mencerminkan seberapa besar variasi dari variabel terikat Y dapat diterangkan oleh variabel bebas X Nilai R 2 antara 0 – 1 ( 0 < R 2 < 1) l l Bila R 2 =0, artinya variasi dari Y tidak dapat diterangkan oleh X sama sekali Bila R 2 = 1, artinya variasi dari Y secara keseluruhan dapat diterangkan oleh X i
Analisis Residual n n Analisis Residual adalah upaya pemeriksaan, teknik yang paling praktis adalah dengan membuat plot Ada beberapa plot yang biasanya dibuat, antara lain: 1. 2. 3. Membuat plot antara residual dengan variabel bebas atau Ŷi Membuat plot antara residual dan waktu Residual mengikuti distribusi normal
Analisis Residual 1. Membuat plot antara residual dengan variabel bebas atau Ŷi n 2. Berdasarkan pola plot ini, kita akan dapat melihat, apakah varian error konstan (homoskedastis) Membuat plot antara residual dan waktu n Polanya akan menunjukkan apakah satu residual independen dengan residual lainnya
Analisis Residual 3. Residual mengikuti distribusi normal (dgn menggunakan histogram dari residual) n Jika residual mengikuti distribusi normal, maka histogram akan berbentuk kurva yang menyerupai bell (bell-shaped)
Residual Standard n Residual standar akan memiliki nilai tengah nol, dan varian satu, serta mengikuti distribusi Normal
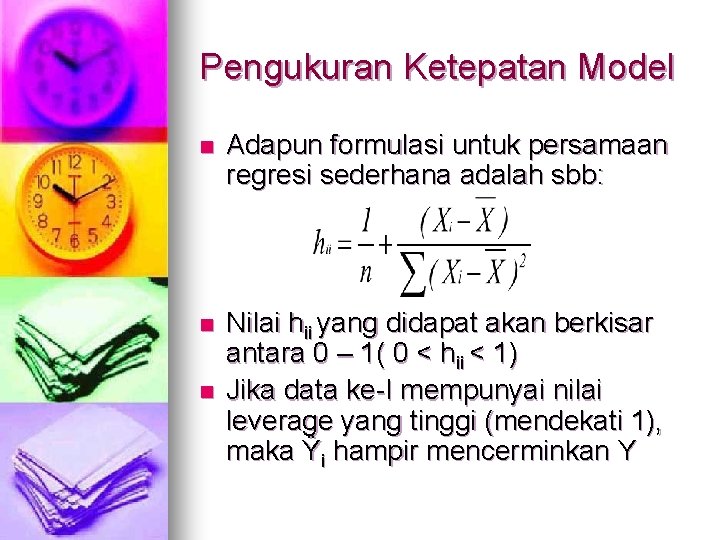
Pengukuran Ketepatan Model n n Ketepatan Model dapat diukur berdasarkan besar atau kecilnya residual Untuk mengukur jarak(standar) antara data ke-I dengan prediksi pada fungsi regresi, dapat digunakan ‘leverage’ atau disebut juga standardized Squared Distance Measure, yang dinotasikan dengan hii
Pengukuran Ketepatan Model n Adapun formulasi untuk persamaan regresi sederhana adalah sbb: n Nilai hii yang didapat akan berkisar antara 0 – 1( 0 < hii < 1) Jika data ke-I mempunyai nilai leverage yang tinggi (mendekati 1), maka Ŷi hampir mencerminkan Y n
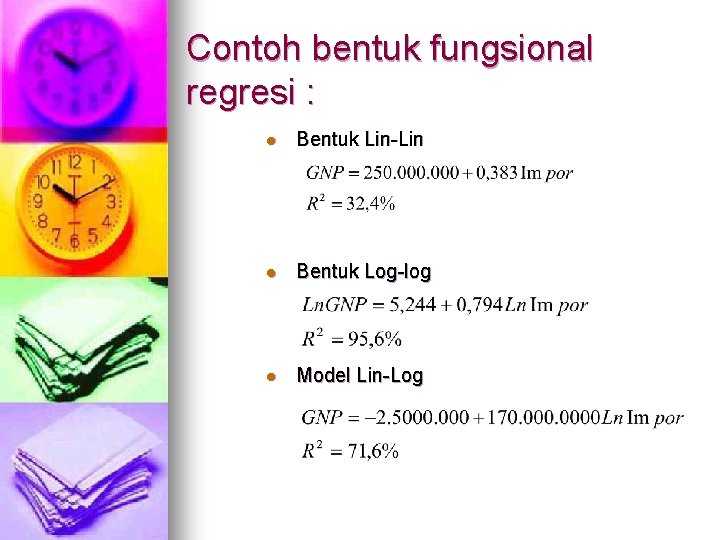
BENTUK FUNGSIONAL DALAM MODEL REGRESI 1. The Log linear model atau disebut sebagai model Log-Log Model Log Linear dituliskan sebagai berikut : Atau Sifat dari model log-log adalah koefisien beta merupakan ukuran elastisitas Y terhadap X. Diasumsikan bahwa koefisien elastisitas antara Y dan x adalah 1 (konstan), yaitu:
Semilog Model, terdiri dari dua model : n l Model Log-Lin l Model Lin- Log
Contoh bentuk fungsional regresi : l Bentuk Lin-Lin l Bentuk Log-log l Model Lin-Log