Introduccin a No SQL Angel Java Lopez http
- Slides: 74
Introducción a No. SQL Angel “Java” Lopez http: //www. ajlopez. com http: //www. msmvps. com/lopez
Agenda • • Qué es No. SQL Bases de Datos ACID, CAP, BASE Oferta No. SQL Varias implementaciones Caso Twitter/Cassandra Usando Mongo. DB
¿Qué es No. SQL? • Not Only SQL • Alternativa a persistir en bases de datos relacionales – Libre de esquema – Libre estructura – En general • Distribuidas • Alta disponibilidad • Escalables
Bases de Datos • Jerárquicas y en Red – Anteriores a las relacionales • Hoy, relacionales en todos lados • Brillan: – Manejo de conjuntos – Transacciones – Seguridad – ACID
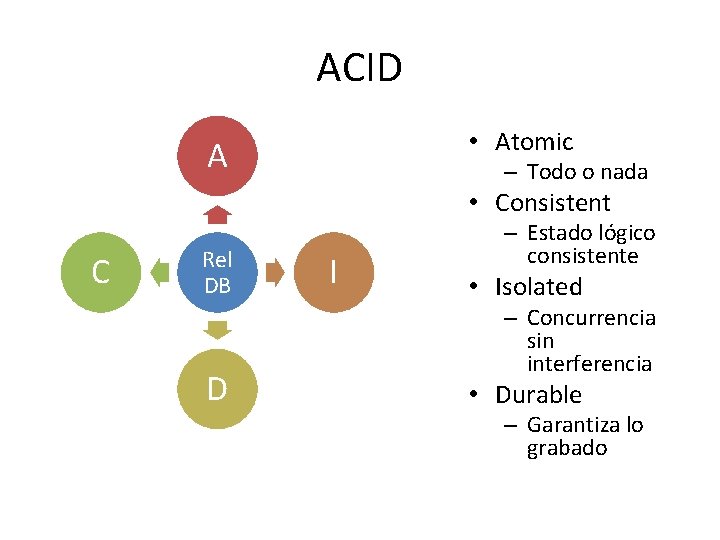
ACID • Atomic A – Todo o nada • Consistent C Rel DB D I – Estado lógico consistente • Isolated – Concurrencia sin interferencia • Durable – Garantiza lo grabado
Más allá de una base • Necesitamos escalabilidad • Necesitamos disponibilidad • Replicación – La misma base en varias bases en distintos servidores • Partición – Una tabla repartida en varias bases en distintos servidores
ACID Distribuido Implementado mediante 2 PC Two Phase Commit Hay un Coordinador de la transacción Avisa a cada base de datos: precommit Si todas las instancias están de acuerdo, avisa commit • Si alguna base que rehúsa, avisa rollback • ACID da Consistencia a las bases distribuidas • • •
Consistencia • Cuando hay una actualización, todos los observadores ven esa actualización (en caso de ir a leer) – No acepción de C de ACID • Con la llegada de Internet, surgió la importancia de la disponibilidad (availability) • Con la llegada de Internet, llegaron miles o millones de usuarios, surgió la importancia de la escalabilidad • Eric Brewer presenta el teorema CAP en 2000
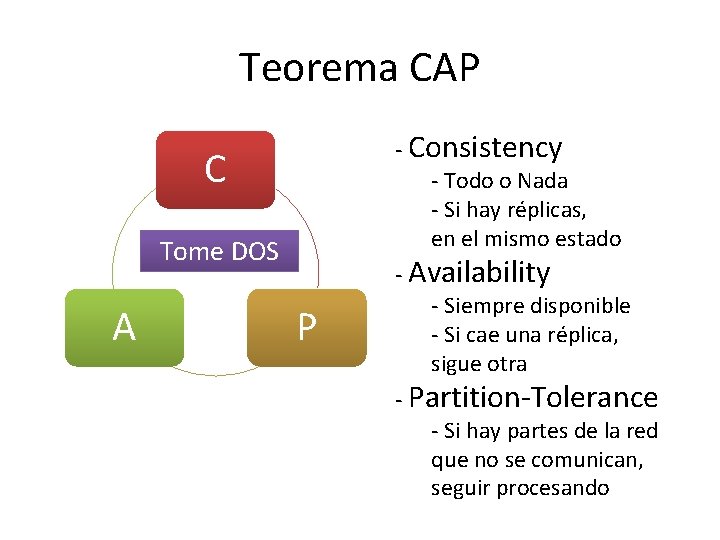
Teorema CAP C Tome DOS A P - Consistency - Todo o Nada - Si hay réplicas, en el mismo estado - Availability - Siempre disponible - Si cae una réplica, sigue otra - Partition-Tolerance - Si hay partes de la red que no se comunican, seguir procesando
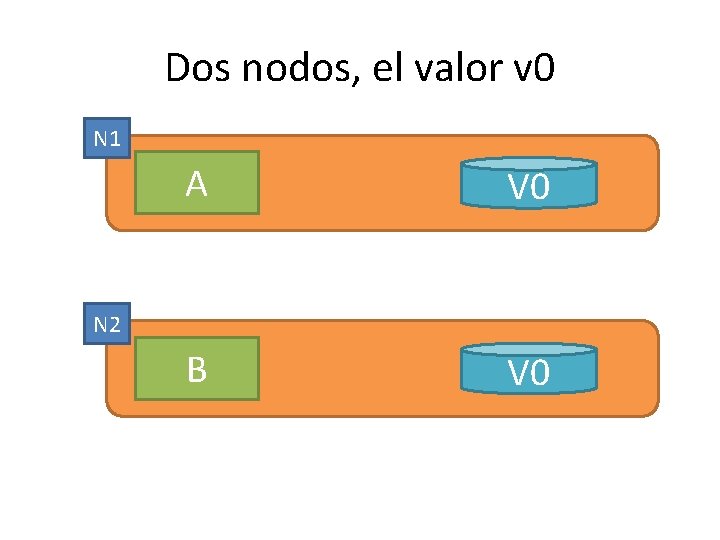
Dos nodos, el valor v 0 N 1 A V 0 B V 0 N 2
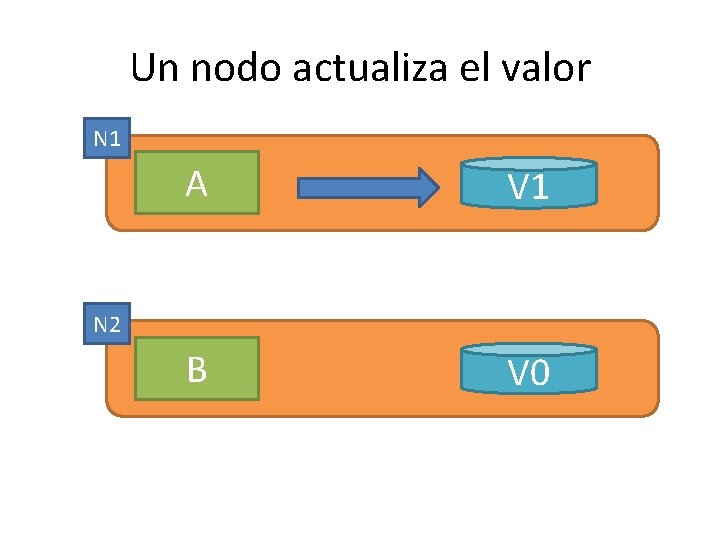
Un nodo actualiza el valor N 1 A V 1 B V 0 N 2
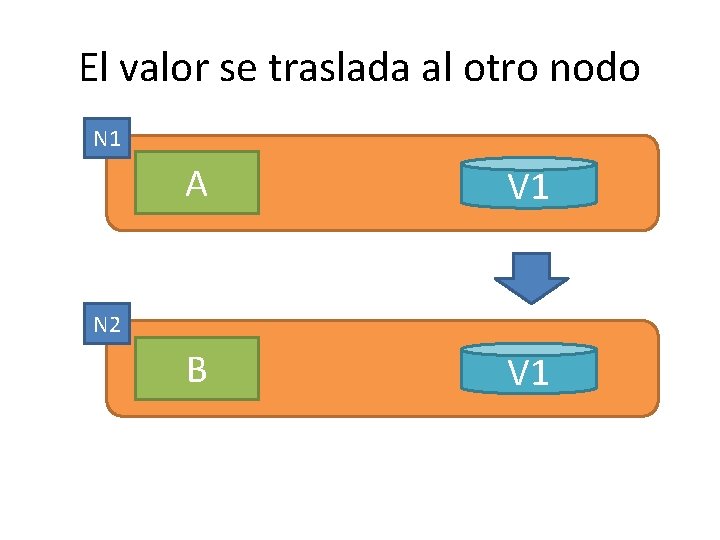
El valor se traslada al otro nodo N 1 A V 1 B V 1 N 2
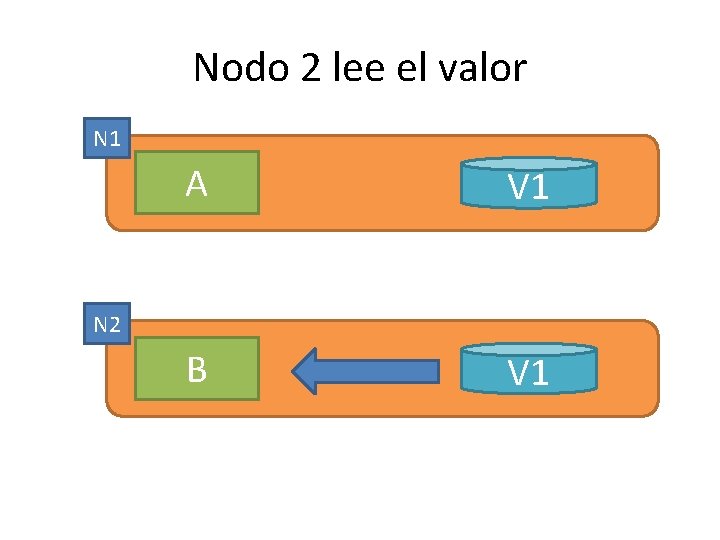
Nodo 2 lee el valor N 1 A V 1 B V 1 N 2
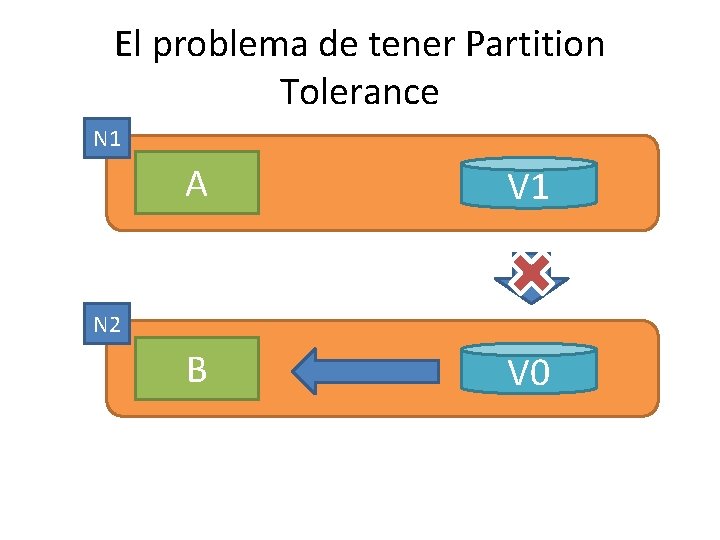
El problema de tener Partition Tolerance N 1 A V 1 B V 0 N 2
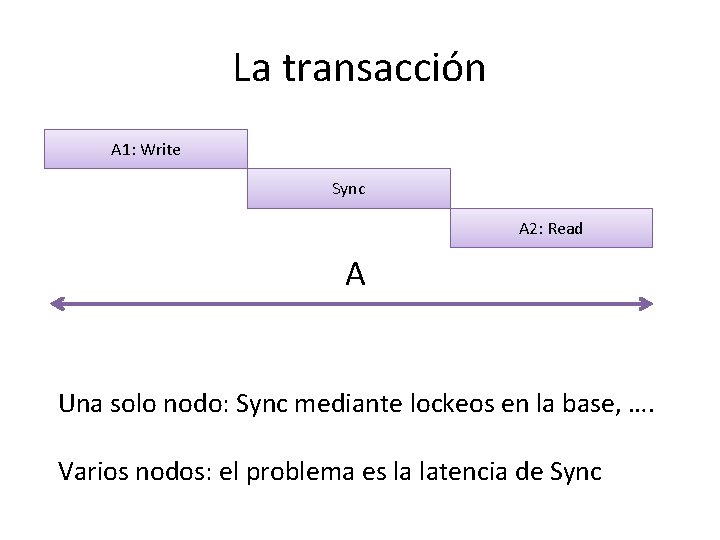
La transacción A 1: Write Sync A 2: Read A Una solo nodo: Sync mediante lockeos en la base, …. Varios nodos: el problema es la latencia de Sync
Manejando el problema CAP • Abandonamos P (Partition Tolerance) – Ponemos todo en una caja – Problemas de escalabilidad • Abandonamos A (Availability) – Ej: Al grabar/leer esperamos que todo se estabilice. Si hay falla de red, el dato no está disponible hasta reparar el fallo • Abandonamos C (Consistency) – Eventual Consistency: N 1 tiene V 1, y por un tiempo, N 2 tiene V 2
Tipos de Consistencia • Proceso A graba y lee, Procesos B, C leen y graban independientemente de A • Strong (Fuerte): Cuando alguien graba, todos (A, B, C) leen el mismo dato • Weak (Débil): Cuando alguien graba, no se asegura que todos lean lo mismo. Dependiendo de unas condiciones, hay una ventana de inconsistencia • Eventual: Si no hay más actualizaciones, al tiempo todos leen lo mismo. Ej. DNS (Domain Name System)
En el negocio • Amazon – Una décima de segundo más, cuesta 1% de las ventas http: //highscalability. com/latency-everywhere-andit-costs-you-sales-how-crush-it • Google – Medio segundo de latencia, baja el tráfico en un quinto http: //glinden. blogspot. com/2006/11/marissamayer-at-web-20. html
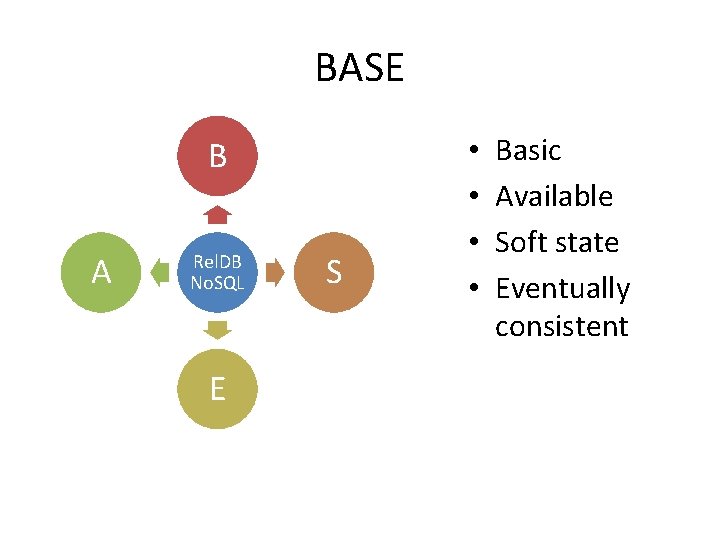
BASE B A Rel. DB No. SQL E S • • Basic Available Soft state Eventually consistent
BASE • Es diametralmente opuesto a ACID • ACID es pesimista, fuerza la consistencia al final de cada operación • BASE es optimista, acepta que el estado de la base esté en cambio • Provee availability soportando fallas parciales: – Ej. Tener la base de usuarios particionada en 5 servidores – Si falla uno, sólo afecta al 20% de los usuarios
Aparece No. SQL • Ya que ACID no es posible siempre • Hay otras fuerzas: disponibilidad, escalabilidad, que hay nacido en gran parte por Internet • CAP muestra que no podemos tenerlo todo • BASE es aceptable en algunos sistemas (notablemente, grandes aplicaciones en Internet) Entonces: • Se puede encarar la persistencia en algo que no es base de datos relacional • Pasan de Consistency a Eventual Consistency, en general • Harán hincapié en A o P de CAP.
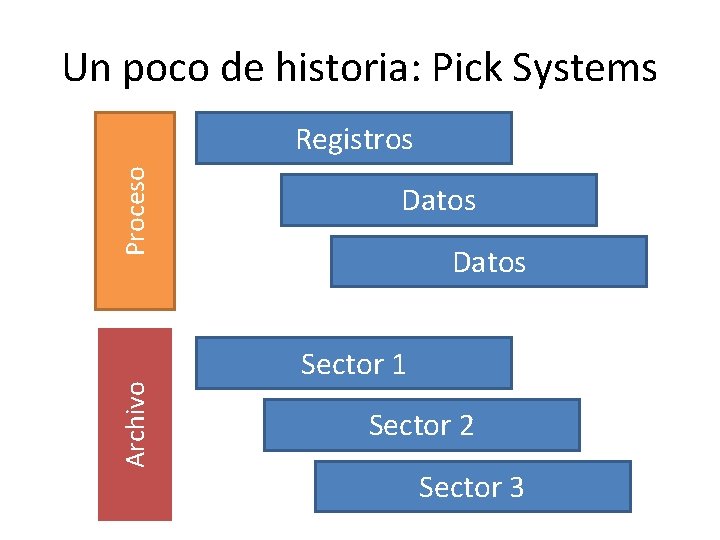
Un poco de historia: Pick Systems Archivo Proceso Registros Datos Sector 1 Sector 2 Sector 3
Implementaciones • Distribuidas – Toman la responsabilidad de: • Partition, para escalabilidad • Replication, para disponibilidad – Amazon Dynamo, Voldemort, Couch. DB (via Lounge), Riak, Mongo. DB (en desarrollo), Big. Table, Cassandra, Hyper. Table, Hbase • No Distribuidas – Responsabilidad en el cliente
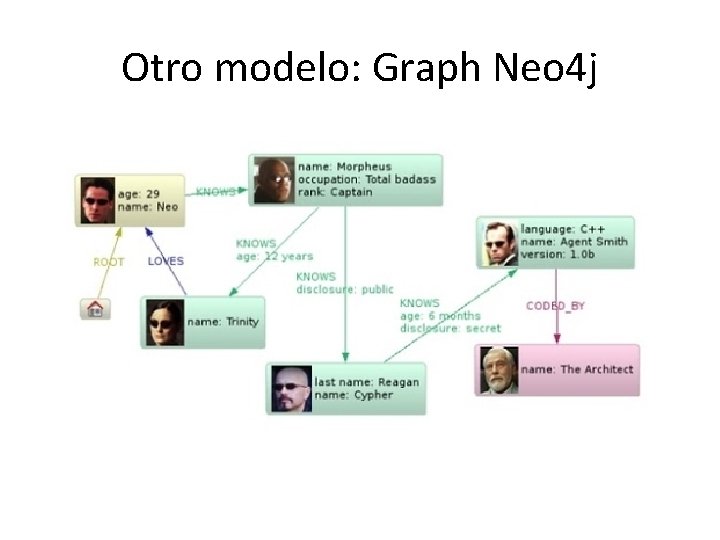
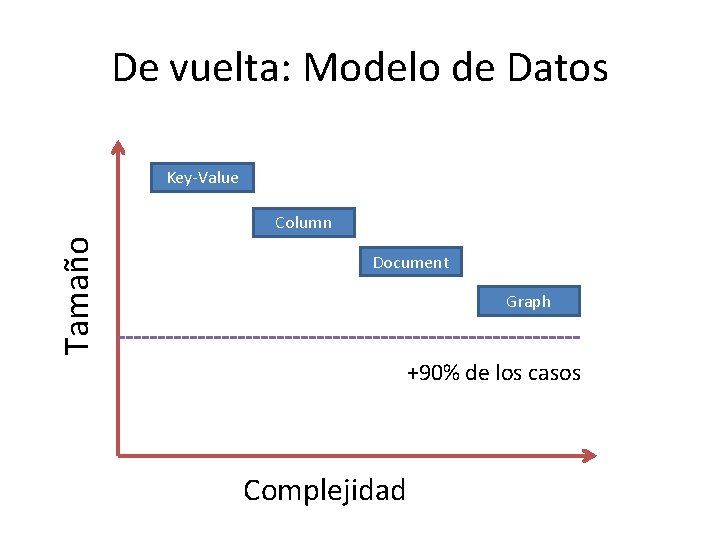
Modelos de Datos • Key-Value store – Ej: Amazon Dynamic, Voldemort, Tokyo Cabinet • Column store – Ej: Google Big. Table, Cassandra, HBase • Document store – Ej: Apache Couch. DB, Mongo. DB • Graph databases – Ej: Neo 4 j
Disco o Memoria • En Memoria – Redis (async write to disk), Scalaris • En Disco – Couch. DB, Mongo. DB, Riak (archivos) – Voldemort (BDB o My. SQL) • Configurable – Big. Table, Cassandra, Hbase, Hyper. Table
Dynamo Producto interno de Amazon Orientado a AP (Availability, Partition Tolerance) Sacrifica Consistency Adopta Eventual Consistency Muchos servicios internos de Amazon necesitan acceder por Clave a un Valor • Los Datos son Particionados • Los Datos son Replicados • • •
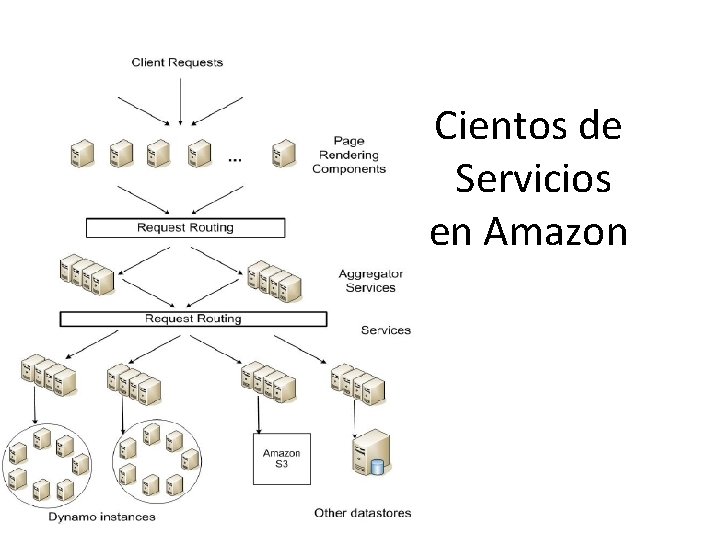
Cientos de Servicios en Amazon
Operaciones • Cada clave tiene un nodo coordinador asignado • La clave-valor se replica en otros servidores • Put(key, value, context) – – Clave y valor Siempre toma el “write” Contexto tiene información como la versión Puede pedir que se escriba en W nodos • Get(key) – – Dado la clave, recupera el valor Y el contexto Puede dar un valor, o una lista de valores en conflicto La aplicación decide qué hacer con los conflictos Puede pedir valores de R nodo
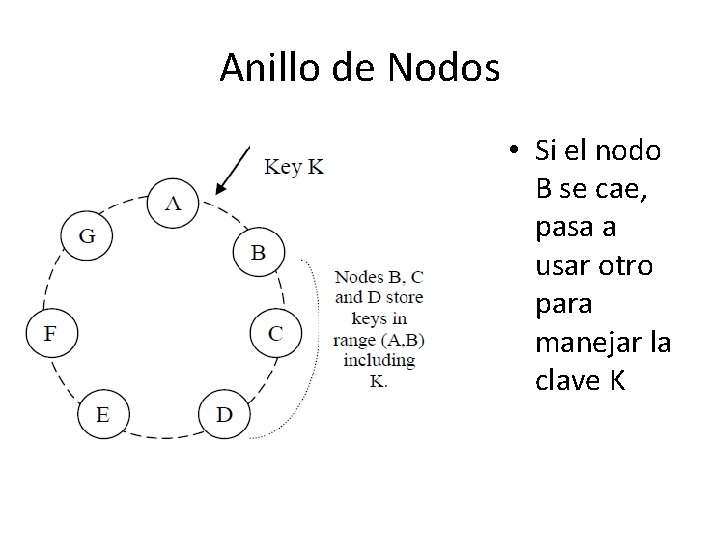
Anillo de Nodos • Si el nodo B se cae, pasa a usar otro para manejar la clave K
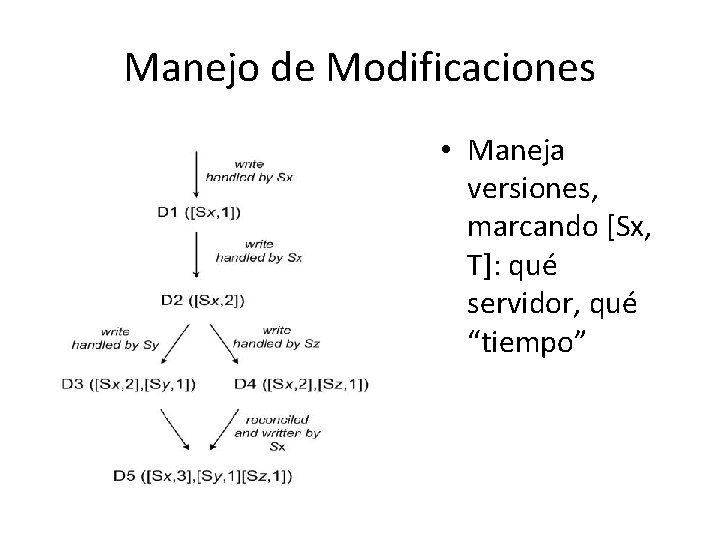
Manejo de Modificaciones • Maneja versiones, marcando [Sx, T]: qué servidor, qué “tiempo”
Big. Table • Nace en Google • Orientado a CA: – Strong Consistency – High Availability – Pero no resuelve Network Partitions • No tiene replicación a nivel de una base de datos: – La replicación la hace el Google File System • Usado en Web indexing, Google Earth, Google Finance, Google Analytics, etc. • Estas aplicaciones manejan datos desde simples URLs a fotos satelitales, desde batch hasta datos para usuarios finales en el momento
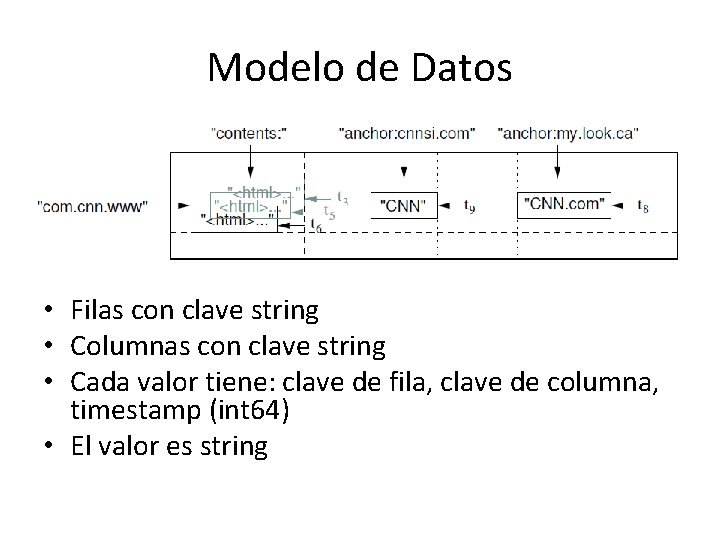
Modelo de Datos • Filas con clave string • Columnas con clave string • Cada valor tiene: clave de fila, clave de columna, timestamp (int 64) • El valor es string
Filas • Big. Table las mantiene ordenadas por clave • Cada tabla es particionada – El rango se llama tablet • El programa cliente decide la clave – Puede aprovechar que datos relacionados vayan al mismo tablet – Ejemplo: clave com. google. maps queda “cerca” de otro com. google
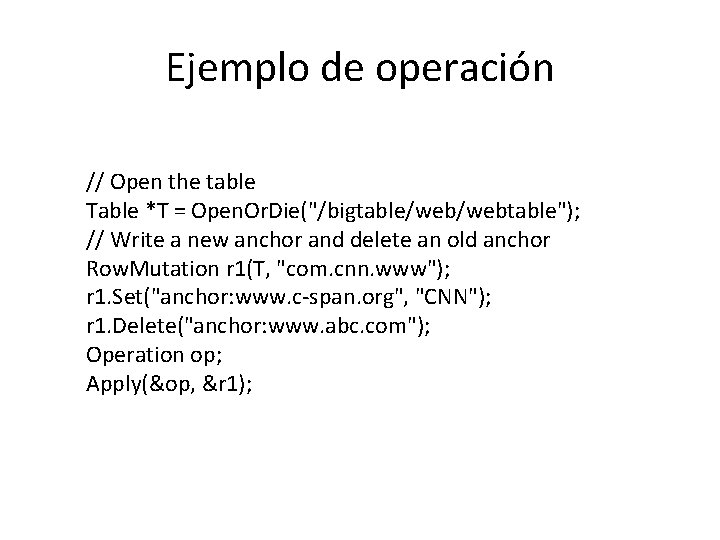
Ejemplo de operación // Open the table Table *T = Open. Or. Die("/bigtable/webtable"); // Write a new anchor and delete an old anchor Row. Mutation r 1(T, "com. cnn. www"); r 1. Set("anchor: www. c-span. org", "CNN"); r 1. Delete("anchor: www. abc. com"); Operation op; Apply(&op, &r 1);
Voldemort Open Source Key-Value Usado en Linked. In Datos replicados automáticamente en múltiples servidores Datos automáticamente particionados La caída de un servidor es manejada transparentemente Cada nodo es independiente de los demás, no hay un punto central de coordinación • Versionamiento de los datos • Capa de storage: mockeable! • •
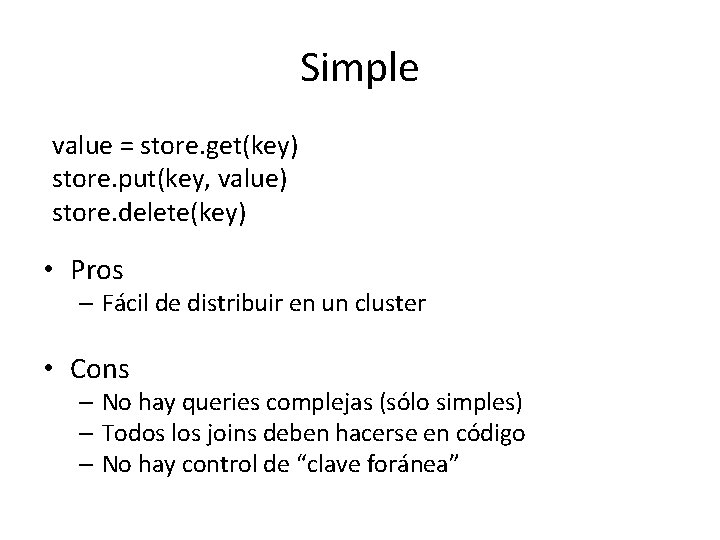
Simple value = store. get(key) store. put(key, value) store. delete(key) • Pros – Fácil de distribuir en un cluster • Cons – No hay queries complejas (sólo simples) – Todos los joins deben hacerse en código – No hay control de “clave foránea”
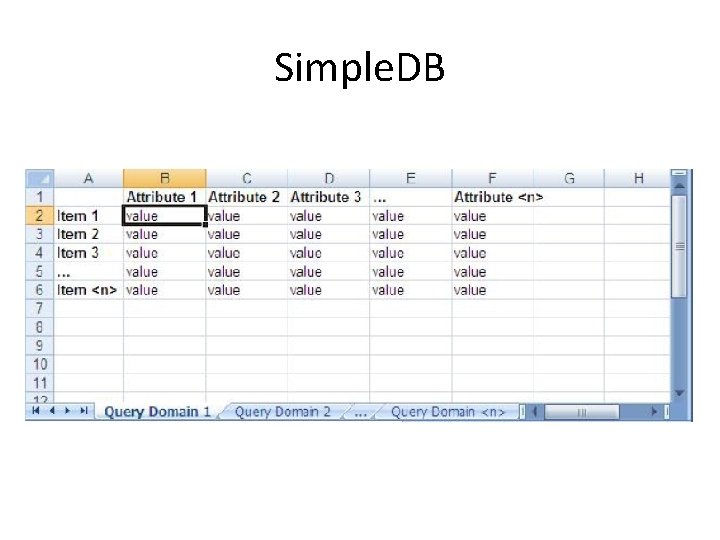
Simple. DB • • • Acceso por servicios web Ofrecido por Amazon cargo Replicación en data centers Eventual consistency en read Consistency en read
Simple. DB
Conceptos • Cuenta del cliente: la planilla completa • Dominio: cada hoja – Particionar dominio: en vez de Products: Books, DVDs, CDs • Items: cada fila • Atributo: cada columna • Valores: en la celda, pueden ser multivaluadas
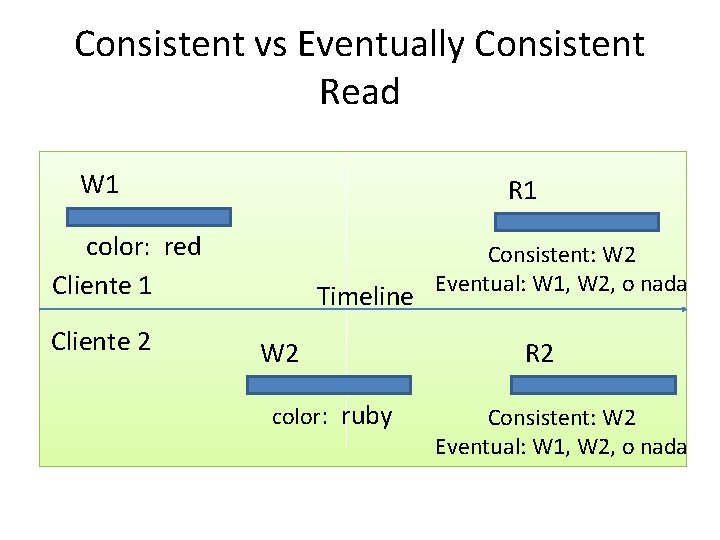
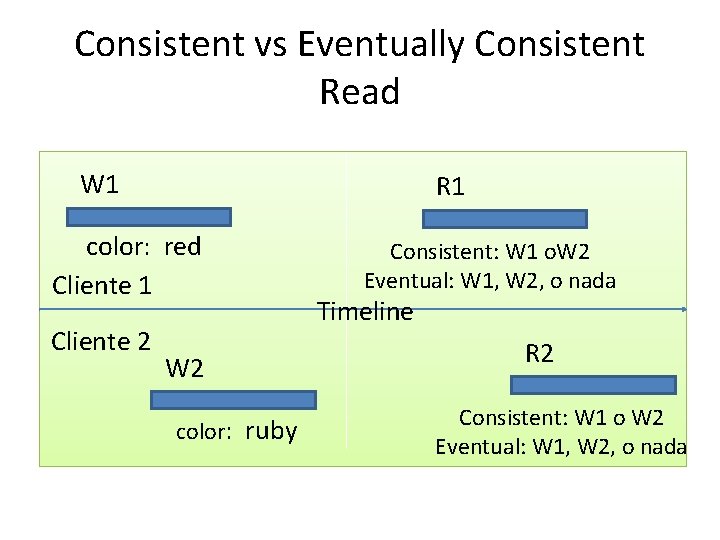
Consistent vs Eventually Consistent Read W 1 R 1 color: red Cliente 1 Cliente 2 Timeline W 2 color: ruby Consistent: W 2 Eventual: W 1, W 2, o nada R 2 Consistent: W 2 Eventual: W 1, W 2, o nada
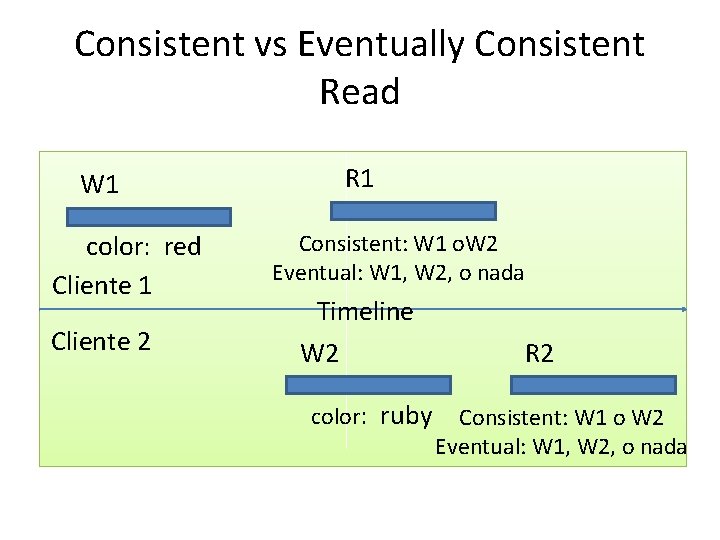
Consistent vs Eventually Consistent Read W 1 color: red Cliente 1 Cliente 2 R 1 Consistent: W 1 o. W 2 Eventual: W 1, W 2, o nada Timeline W 2 color: ruby R 2 Consistent: W 1 o W 2 Eventual: W 1, W 2, o nada
Consistent vs Eventually Consistent Read W 1 R 1 color: red Cliente 1 Cliente 2 W 2 color: ruby Consistent: W 1 o. W 2 Eventual: W 1, W 2, o nada Timeline R 2 Consistent: W 1 o W 2 Eventual: W 1, W 2, o nada
Apache Cassandra • • • Proyecto Apache de código abierto, escrito en Java Originalmente desarrollado en Facebook Rackspace, Digg, Simple. Geo, Twitter, etc. . Alta disponibilidad: desde “write nunca falla” hasta “esperar a que todas las réplicas se puedan leer” Eventualmente consistente Decentralizado: todos los nodos en el cluster son iguales Tolerante a fallas: los datos son replicados automáticamente en múltiples nodos Flexible: agregado de nuevos nodos sin bajar el servicio Es base de datos distribuida, usando el modelo de datos de Big. Table, y la infraestructura de Dynamo
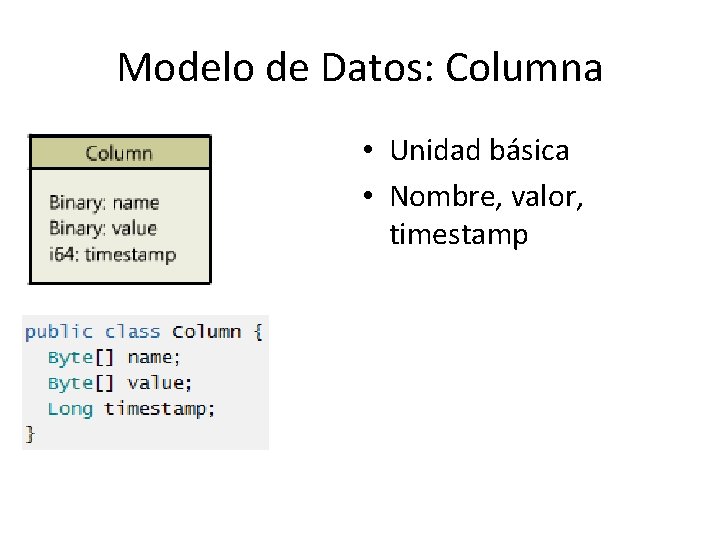
Modelo de Datos: Columna • Unidad básica • Nombre, valor, timestamp
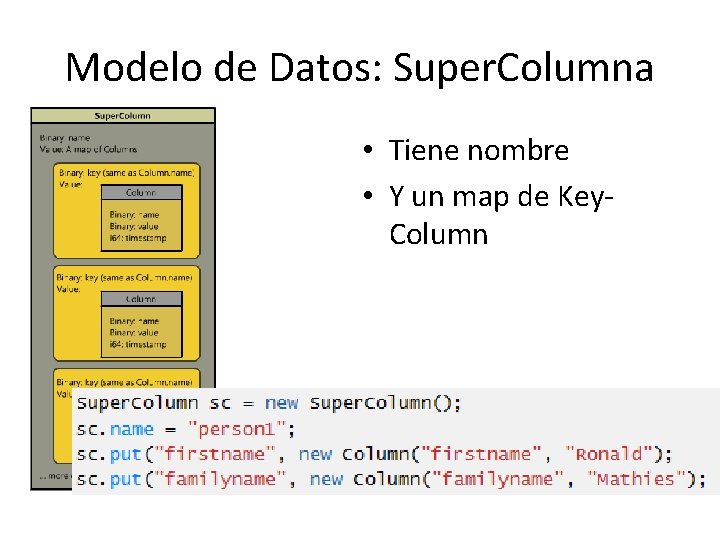
Modelo de Datos: Super. Columna • Tiene nombre • Y un map de Key. Column
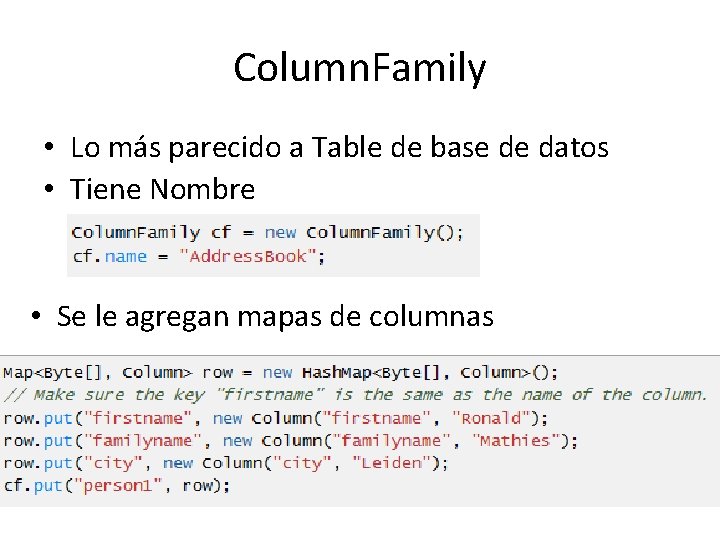
Column. Family • Lo más parecido a Table de base de datos • Tiene Nombre • Se le agregan mapas de columnas
Modelo de Datos • Super. Column. Family – Como Column. Family pero contiene Super. Columns • Key. Space – Contiene varias familias (tablas) – Generalmente uno por aplicación
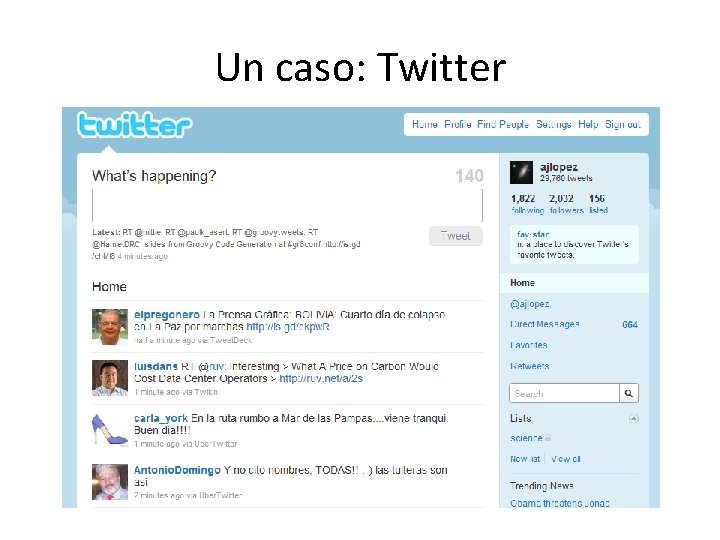
Un caso: Twitter
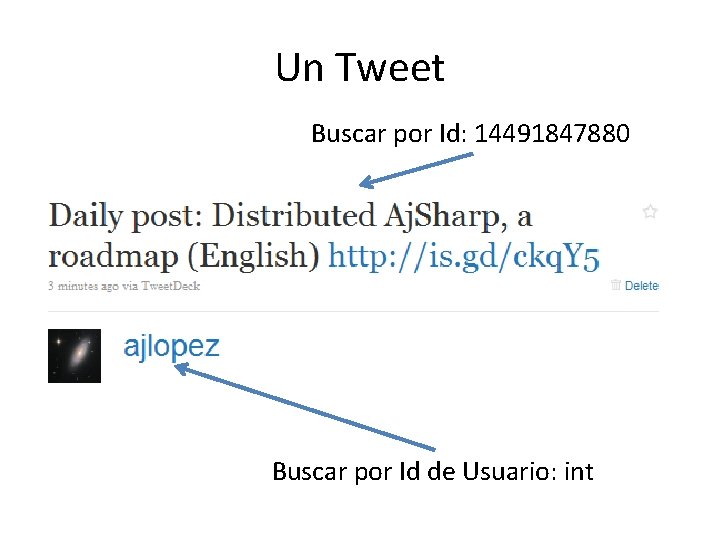
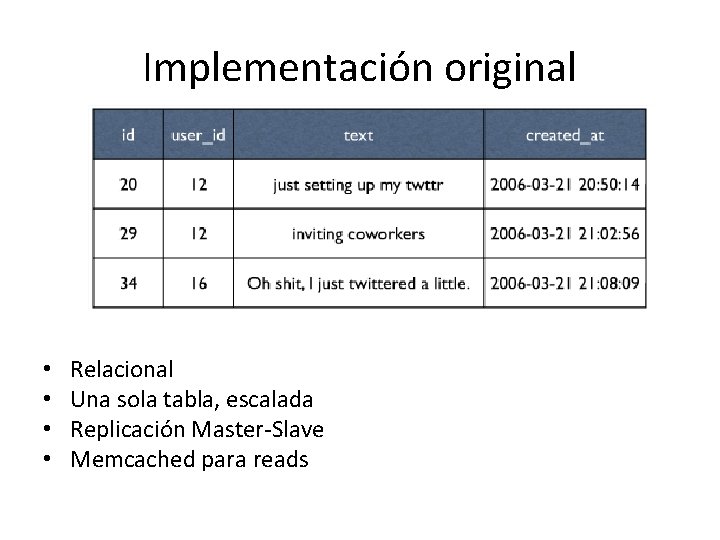
Un Tweet Buscar por Id: 14491847880 Buscar por Id de Usuario: int
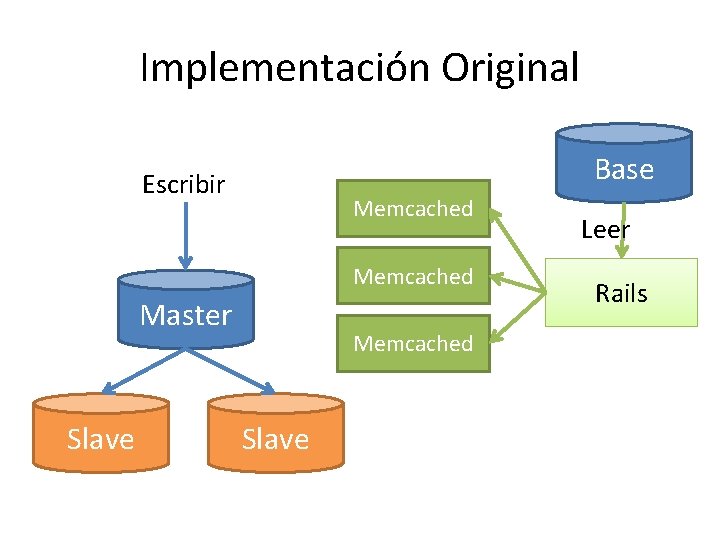
Implementación original • • Relacional Una sola tabla, escalada Replicación Master-Slave Memcached para reads
Implementación Original Base Escribir Memcached Master Slave Memcached Slave Leer Rails
Problema • Los disk arrays no pasan de 800 GB • Con 2, 954, 291, 678 tweets, el 90% del espacio está utilizado • Solución: Partition
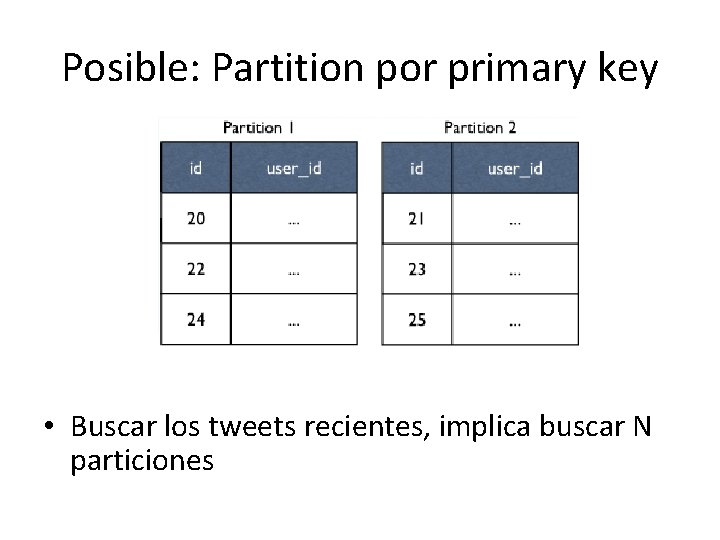
Posible: Partition por primary key • Buscar los tweets recientes, implica buscar N particiones
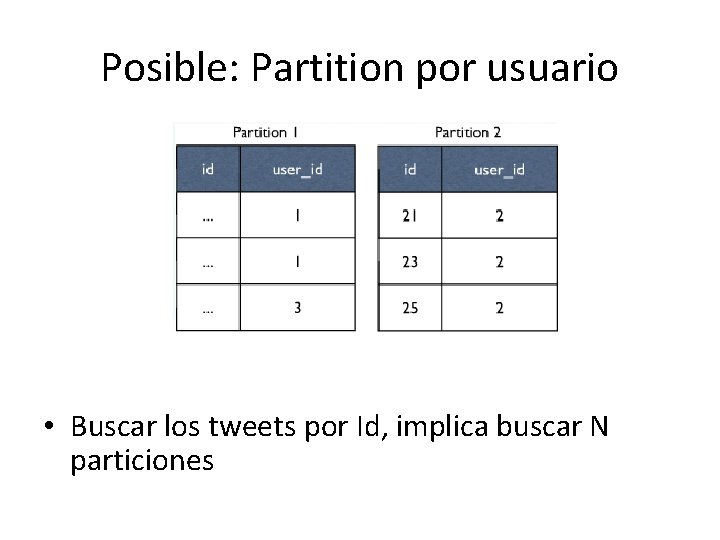
Posible: Partition por usuario • Buscar los tweets por Id, implica buscar N particiones
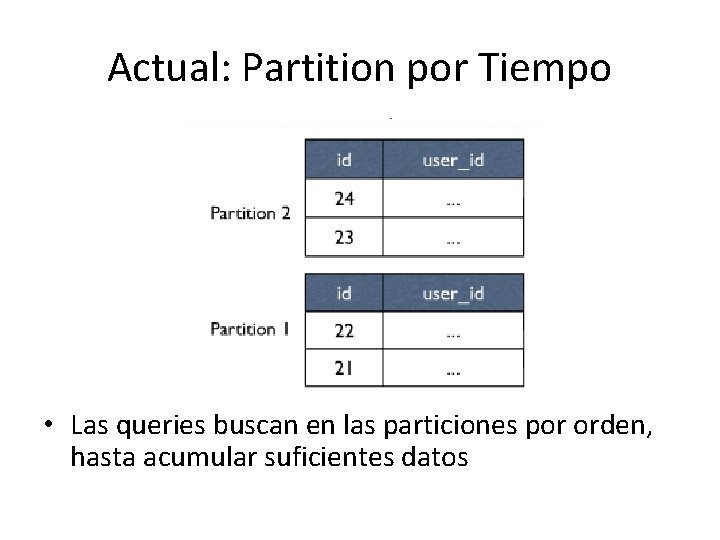
Actual: Partition por Tiempo • Las queries buscan en las particiones por orden, hasta acumular suficientes datos
Situación • Baja latencia, PK lookup: – Memcached 1 ms – My. SQL <10 ms (dependiendo de las particiones a consultar) • Principios – Particionar e indexar – Explotar localidad (lo local, localidad temporal) – Los nuevos tweets son los más frecuentes consultados, en general en la primera partición
Problemas • Capacidad de Write • A grandes velocidades de Tweets, My. SQL deadlocks • Crear un shard temporal – Mucho trabajo de DBA
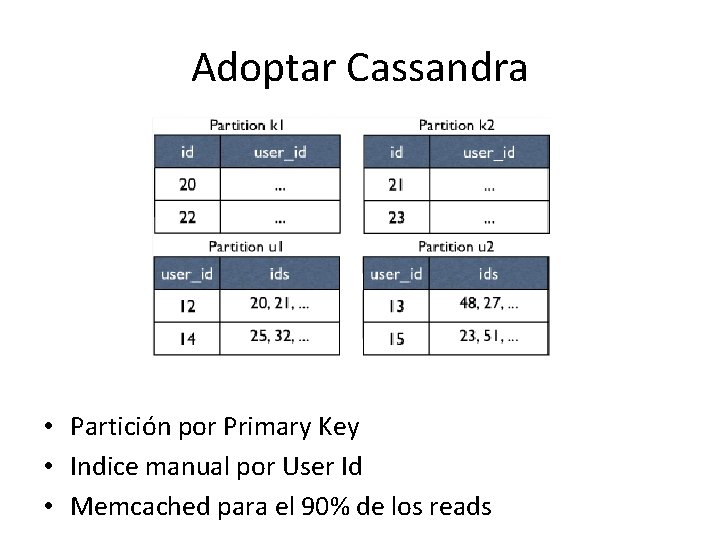
Adoptar Cassandra • Partición por Primary Key • Indice manual por User Id • Memcached para el 90% de los reads
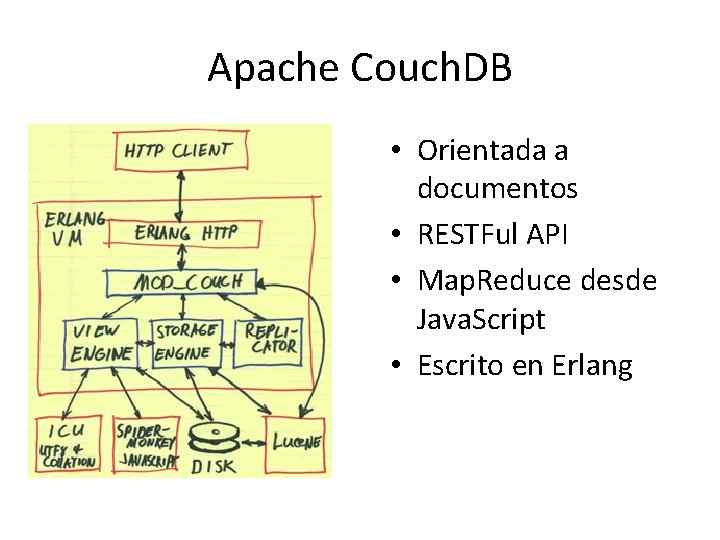
Apache Couch. DB • Orientada a documentos • RESTFul API • Map. Reduce desde Java. Script • Escrito en Erlang
Documentos • Compuesto de campos • Strings, números, fechas, listas ordenadas, mapas asociativos. • Cada documento se identifica con un Id "Subject": "I like Plankton" "Author": "Rusty" "Posted. Date": "5/23/2006" "Tags": ["plankton", "baseball", "decisions"] "Body": "I decided today that I don't like baseball. I like plankton. "
Propiedades • Provee ACID • Las actualizaciones son serializadas (ejecutadas en serie) • Las lecturas pueden ser concurrentes: cada lector obtiene un “snapshot” consistente de la base
Distribuida • La base de datos se distribuye entre pares • Servidores y clientes offline • Si vuelve a online, una instancia replica los cambios bidireccionalmente • Resuelve los conflictos, los trata no como excepciones, sino el estado normal • Los conflictos pueden resolverse manualmente o mediante agentes distribuidos
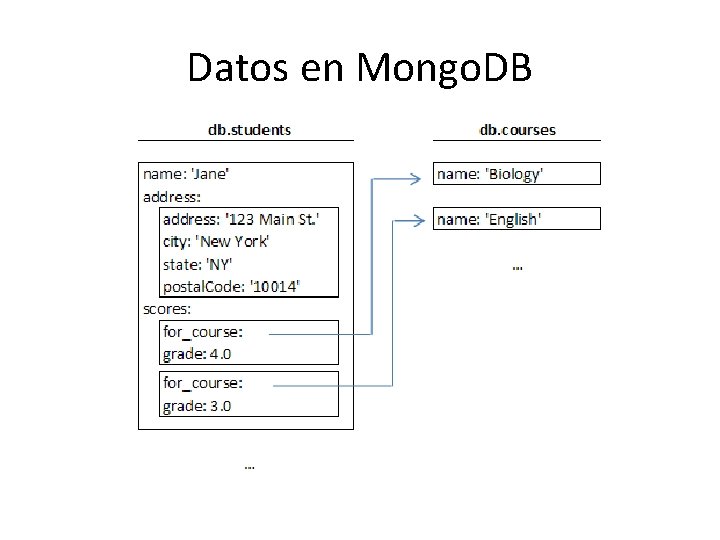
Mongo. DB • • • Open Source Orientada a Documentos estilo JSON Replicación y Disponibilidad Auto-Sharding Rico modelo de queries Documentos con documentos embebidos o referenciados
Datos en Mongo. DB
Probar en linea • http: //www. mongodb. org
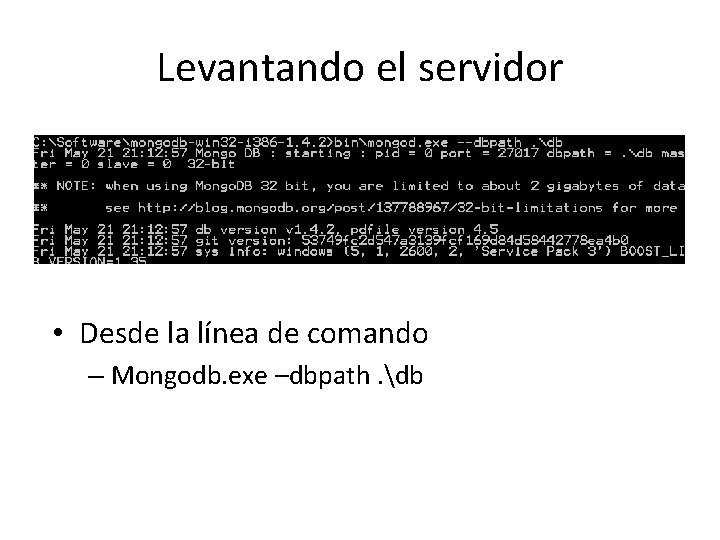
Levantando el servidor • Desde la línea de comando – Mongodb. exe –dbpath. db
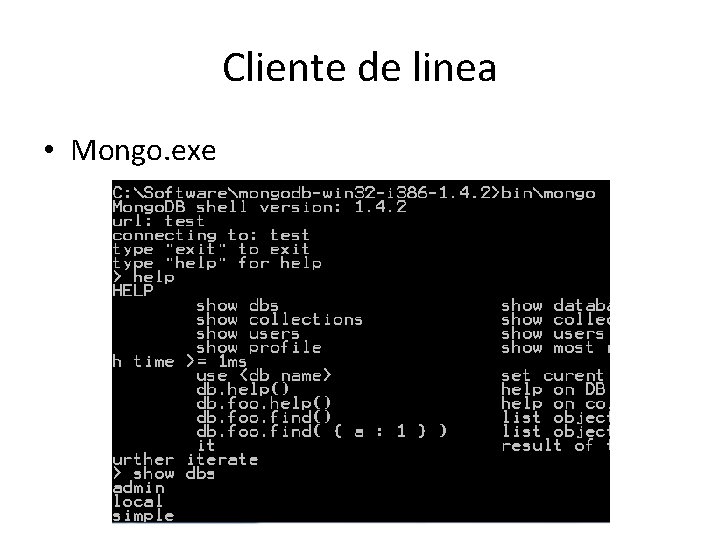
Cliente de linea • Mongo. exe
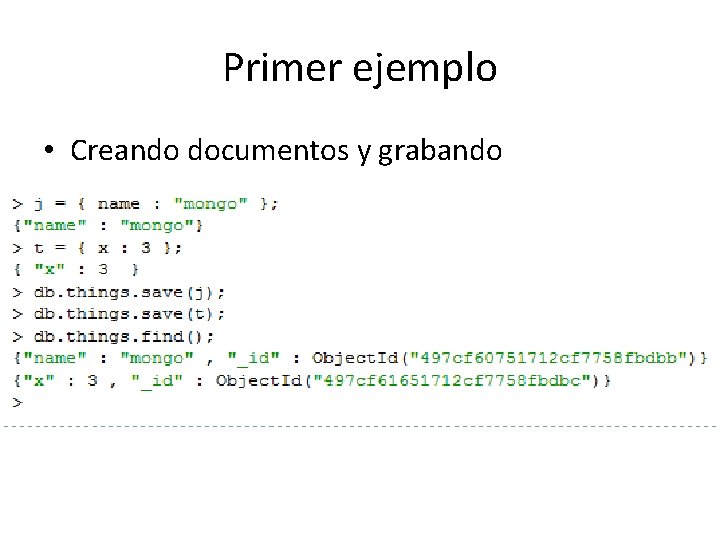
Primer ejemplo • Creando documentos y grabando
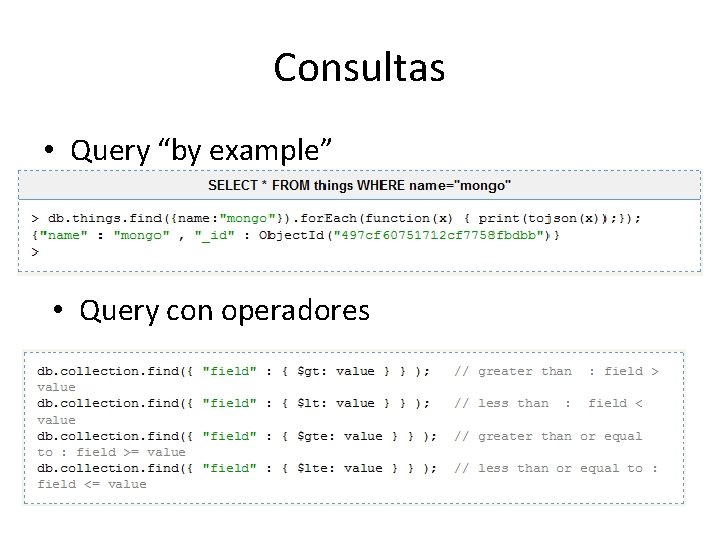
Consultas • Query “by example” • Query con operadores
Ejemplo en C#
Otro modelo: Graph Neo 4 j
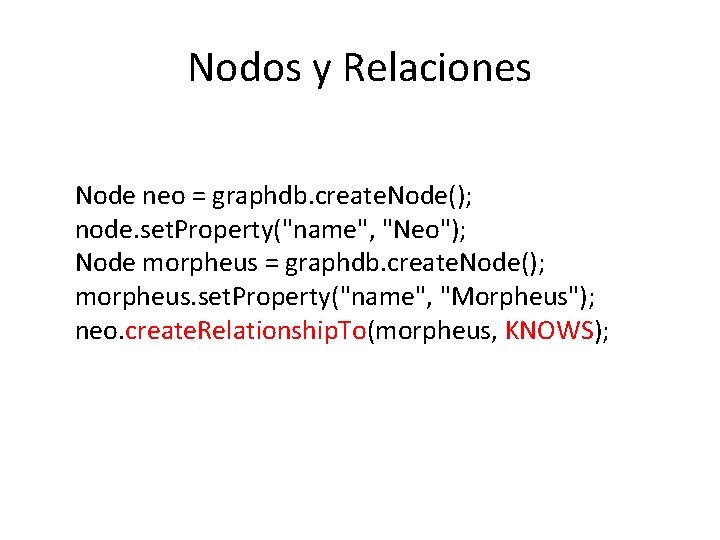
Nodos y Relaciones Node neo = graphdb. create. Node(); node. set. Property("name", "Neo"); Node morpheus = graphdb. create. Node(); morpheus. set. Property("name", "Morpheus"); neo. create. Relationship. To(morpheus, KNOWS);
De vuelta: Modelo de Datos Key-Value Tamaño Column Document Graph +90% de los casos Complejidad
El tema a seguir • Ir más allá de escalabilidad o disponibilidad ¿Podrá No. SQL ofrecer un mejor soporte para modelar modelos de dominio ricos?