Hoofdstuk 6 Inleiding tot inferentie Statistische inferentie op
- Slides: 44
Hoofdstuk 6 Inleiding tot inferentie
• Statistische inferentie : = op basis van steekproef uitspraken over populatie + mate van vertrouwen die men aan die conclusies mag hechten • Bij gebruik van statistische inferentie : data komen van een aselecte steekproef of van een gerandomiseerd experiment
6. 1. Schatten met betrouwbaarheid • Steekproefgemiddelde x is een schatter van de populatieverwachting µ – als de waarde = 36 : hoe betrouwbaar is deze schatting ? – Grotere steekproeven steeds betere schatting – steeds naast gemiddelde een indicatie van de variabiliteit nodig
A. Statistische betrouwbaarheid • 68 - 95 - 99. 7 regel : kans dat gemiddelde binnen een afstand van 2 standaardafwijkingen van de verwachte score van de populatie (µ) ligt is 95% • µ binnen een afstand van 2 standaardafwijkingen van x • in 95% van alle steekproeven zal het interval x - 2 keer stand. afw. tot x + 2 keer stand. afw. de werkelijke µ bevatten
• Op die manier wordt het vertrouwen uitgedrukt in de resultaten van een enkelvoudige steekproef • Voorbeeld : – gemiddelde van steekproef is 461 en standaardafwijking is 4, 5 – met 95% betrouwbaarheid ligt de onbekende verwachte score van de populatie tussen • 461 - 9 = 452 • 461 + 9 = 470 – slechts 5% van de steekproeven liggen hierbuiten
• We weten echter niet of onze steekproef tot die 95% of tot die 5% zal behoren • DUS : – “populatiegemiddelde ligt met 95% betrouwbaarheid tussen x en y” • wil eigenlijk zeggen – “we hebben x en y gevonden volgens een methode die in 95% van de gevallen correcte resultaten geeft”
B. Betrouwbaarheidsintervallen • Interval van getallen tussen x en y is het betrouwbaarheidsinterval voor µ • Betrouwbaarheidsinterval = schatting foutmarge • foutmarge toont iets van de accuraatheid die we onze schatting toekennen, gebaseerd op de variabiliteit van de schatting
• betrouwbaarheidsniveau = 95% niveau : laat zien hoeveel vertrouwen we hebben dat we met de methode µ zullen bevatten • Elk betrouwbaarheidsinterval : – interval (uit de data) – betrouwbaarheidsniveau (kiezen, meestal > 90%) • Betrouwbaarheidsniveau 95% is C=0. 95 • Onbekende parameter wordt (Griekse letter theta) genoemd
• Een betrouwbaarheidsinterval van niveau C voor een parameter , is een interval berekend uit de steekproefdata, volgens een methode die kans C heeft om een interval op te leveren dat de werkelijke waarde van bevat.
C. Betrouwbaarheidsinterval voor een populatieverwachting • Constructie van een betrouwbaarheidsinterval van niveau C voor de populatieverwachting µ • Populatie : N (µ, ) dan heeft de steekproefverdeling van het steekproefgemiddelde x een verdeling : steekpoef : N (µ, / n)
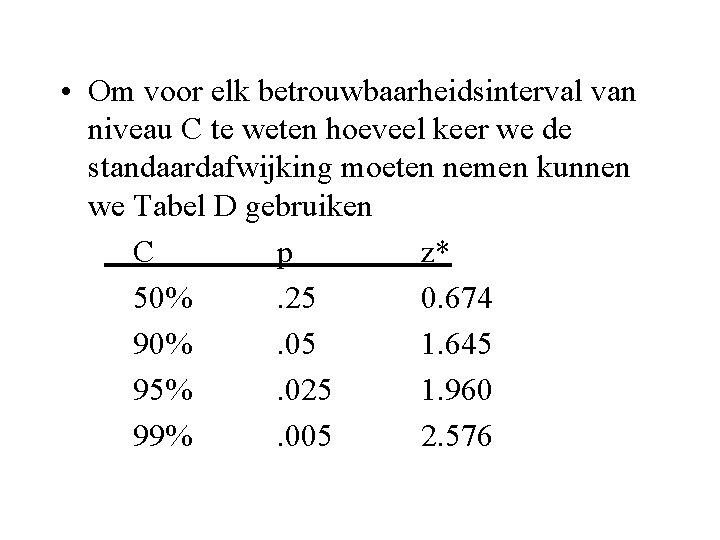
• Om voor elk betrouwbaarheidsinterval van niveau C te weten hoeveel keer we de standaardafwijking moeten nemen kunnen we Tabel D gebruiken C p z* 50%. 25 0. 674 90%. 05 1. 645 95%. 025 1. 960 99%. 005 2. 576
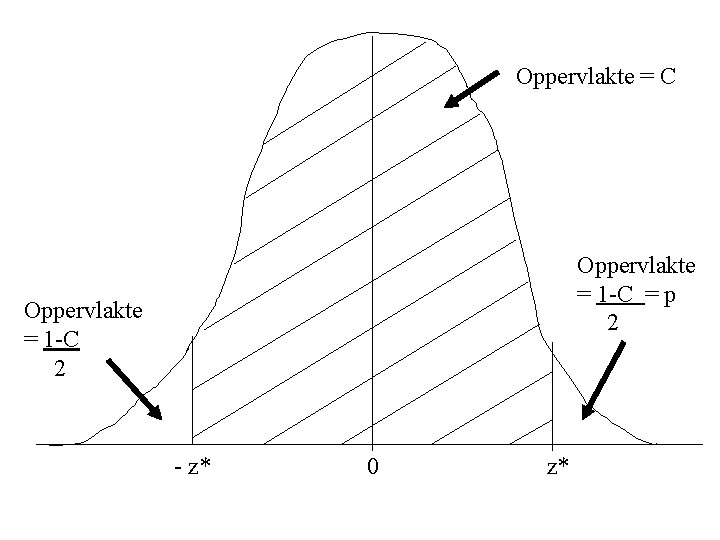
Oppervlakte = C Oppervlakte = 1 -C = p 2 Oppervlakte = 1 -C 2 - z* 0 z*
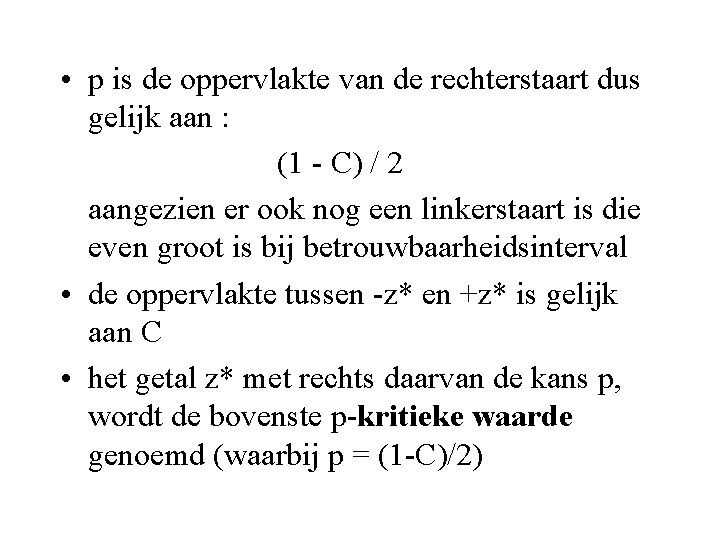
• p is de oppervlakte van de rechterstaart dus gelijk aan : (1 - C) / 2 aangezien er ook nog een linkerstaart is die even groot is bij betrouwbaarheidsinterval • de oppervlakte tussen -z* en +z* is gelijk aan C • het getal z* met rechts daarvan de kans p, wordt de bovenste p-kritieke waarde genoemd (waarbij p = (1 -C)/2)
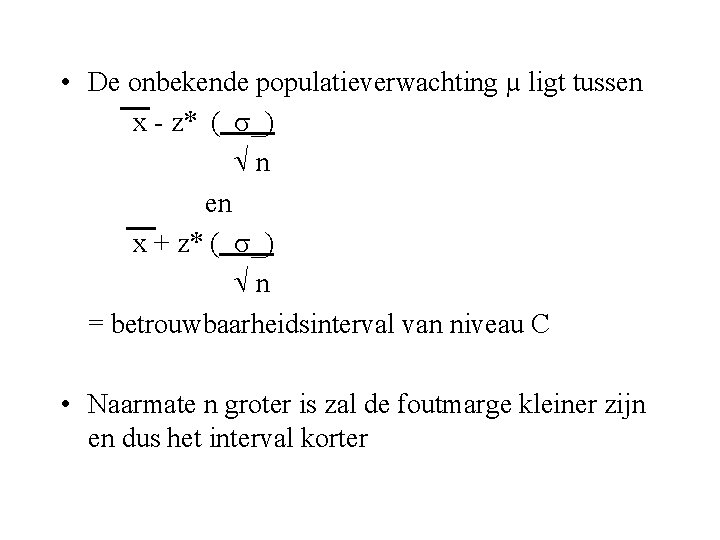
• De onbekende populatieverwachting µ ligt tussen x - z* ( _) n en x + z* ( _) n = betrouwbaarheidsinterval van niveau C • Naarmate n groter is zal de foutmarge kleiner zijn en dus het interval korter
D. Het gedrag van betrouwbaarheidsintervallen • Betrouwbaarheidsniveau kiest de gebruiker • Best : grote betrouwbaarheid en kleine foutmarge • Grote betrouwbaarheid = bijna altijd correcte antwoorden • Kleine foutmarge = parameter is heel nauwkeurig gelokaliseerd
• Voor dezelfde data : – grotere betrouwbaarheid impliceert bereidheid om grotere foutmarge te aanvaarden – want : voor grotere betrouwbaarheid : grotere waarde voor z* • Maar voor andere data : – bij stijging van n zal de foutmarge dalen – door wortel in de formule, moeten we n met 4 vermenigvuldigen om de foutmarge door 2 te laten delen (=halveren)
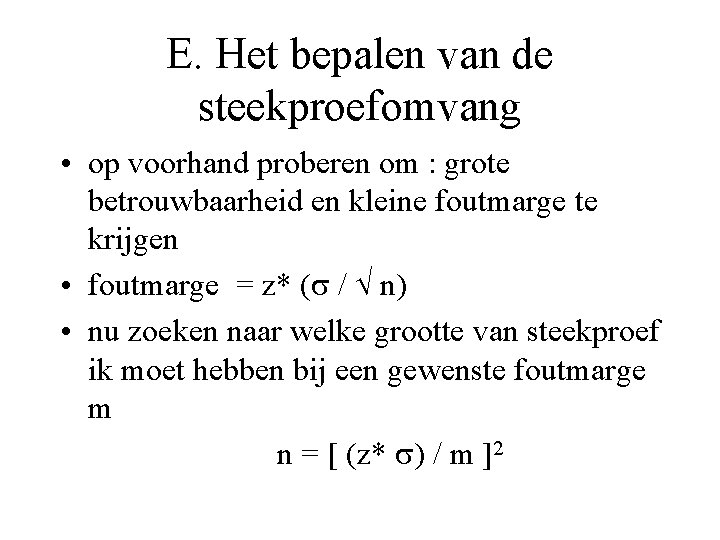
E. Het bepalen van de steekproefomvang • op voorhand proberen om : grote betrouwbaarheid en kleine foutmarge te krijgen • foutmarge = z* ( / n) • nu zoeken naar welke grootte van steekproef ik moet hebben bij een gewenste foutmarge m n = [ (z* ) / m ]2
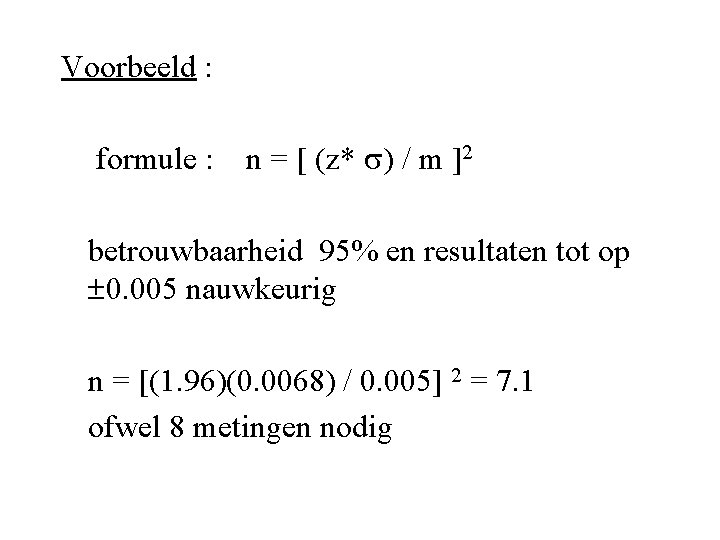
Voorbeeld : formule : n = [ (z* ) / m ]2 betrouwbaarheid 95% en resultaten tot op 0. 005 nauwkeurig n = [(1. 96)(0. 0068) / 0. 005] 2 = 7. 1 ofwel 8 metingen nodig
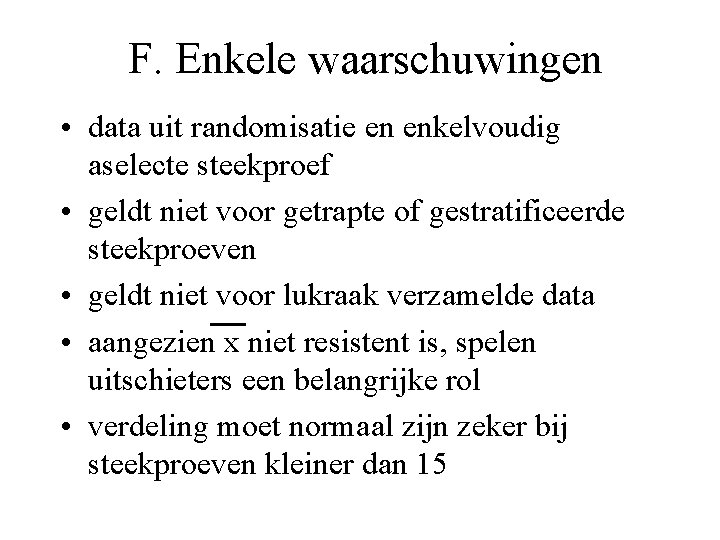
F. Enkele waarschuwingen • data uit randomisatie en enkelvoudig aselecte steekproef • geldt niet voor getrapte of gestratificeerde steekproeven • geldt niet voor lukraak verzamelde data • aangezien x niet resistent is, spelen uitschieters een belangrijke rol • verdeling moet normaal zijn zeker bij steekproeven kleiner dan 15
• De standaardafwijking van de populatie moet gekend zijn, wat irrealistisch is, als n voldoende groot is kan s, de standaardafwijking van de steekproef gebruikt worden • De gebruikte foutmarge geldt enkel voor aselecte steekproeven, drop-out, nonrespons, enz… zorgen voor extra fouten • 95% interval wil zeggen : volgens een methode die voor 95% correcte resultaten geeft
6. 2. Significantietoetsen • Doel : beoordelen van data ten gunste van de een of andere bewering omtrent de populatie • Voorbeeld : Kan het dat iemand die niet getraind is toch 6 m 25 ver springt ? – Kans dat iemand dat zonder training kan is 0. 001 – Dus : het is heel waarschijnlijk dat die persoon wel getraind was – Maar : het zou kunnen dat die persoon niet getraind is, maar die kans is zo klein dat het niet waarschijnlijk is
A. De redenering bij significantietoesten • Significantietoets = procedure om data te vergelijken met hypothese • Hypothese = bewering over parameters in een populatie • Uitkomst van een significantietoets : uitgedrukt in termven van een kans die aangeeft hoe goed data en hypothese met elkaar overeenkomen
B. Formuleren van hypothesen • Vraag : is een effect aanwezig ? • Hypothese : het effect is niet aanwezig = de NULHYPOTHESE (geen effect, geen verschil, …) • Significantietoets om de sterkte van het bewijs tegen de nulhypothese vast te stellen
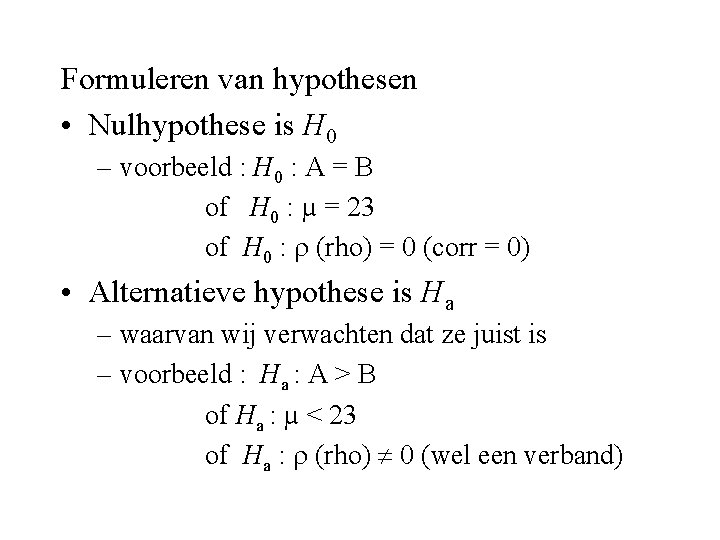
Formuleren van hypothesen • Nulhypothese is H 0 – voorbeeld : H 0 : A = B of H 0 : µ = 23 of H 0 : (rho) = 0 (corr = 0) • Alternatieve hypothese is Ha – waarvan wij verwachten dat ze juist is – voorbeeld : Ha : A > B of Ha : µ < 23 of Ha : (rho) 0 (wel een verband)
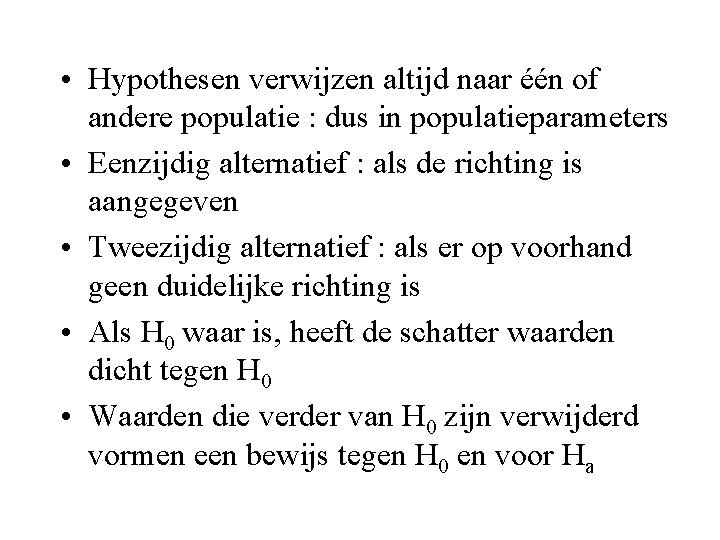
• Hypothesen verwijzen altijd naar één of andere populatie : dus in populatieparameters • Eenzijdig alternatief : als de richting is aangegeven • Tweezijdig alternatief : als er op voorhand geen duidelijke richting is • Als H 0 waar is, heeft de schatter waarden dicht tegen H 0 • Waarden die verder van H 0 zijn verwijderd vormen een bewijs tegen H 0 en voor Ha
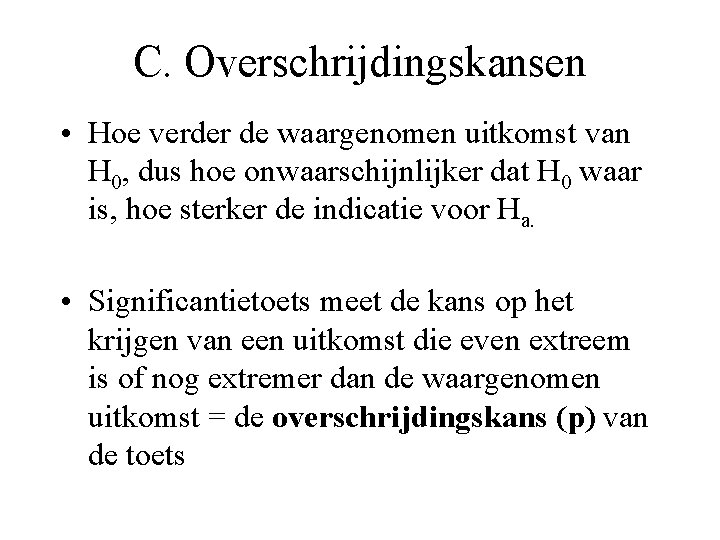
C. Overschrijdingskansen • Hoe verder de waargenomen uitkomst van H 0, dus hoe onwaarschijnlijker dat H 0 waar is, hoe sterker de indicatie voor Ha. • Significantietoets meet de kans op het krijgen van een uitkomst die even extreem is of nog extremer dan de waargenomen uitkomst = de overschrijdingskans (p) van de toets
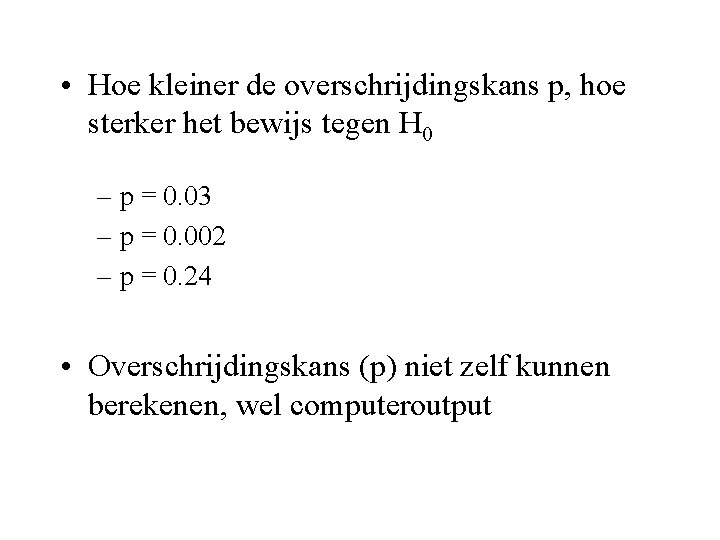
• Hoe kleiner de overschrijdingskans p, hoe sterker het bewijs tegen H 0 – p = 0. 03 – p = 0. 002 – p = 0. 24 • Overschrijdingskans (p) niet zelf kunnen berekenen, wel computeroutput
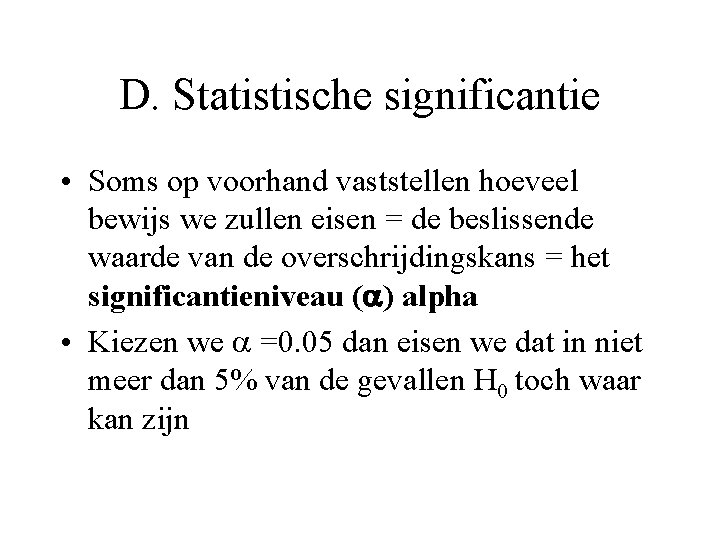
D. Statistische significantie • Soms op voorhand vaststellen hoeveel bewijs we zullen eisen = de beslissende waarde van de overschrijdingskans = het significantieniveau ( ) alpha • Kiezen we =0. 05 dan eisen we dat in niet meer dan 5% van de gevallen H 0 toch waar kan zijn
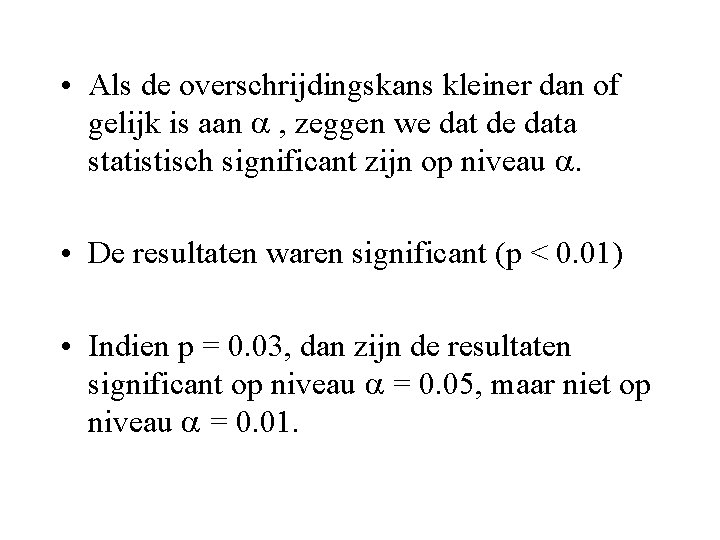
• Als de overschrijdingskans kleiner dan of gelijk is aan , zeggen we dat de data statistisch significant zijn op niveau . • De resultaten waren significant (p < 0. 01) • Indien p = 0. 03, dan zijn de resultaten significant op niveau = 0. 05, maar niet op niveau = 0. 01.
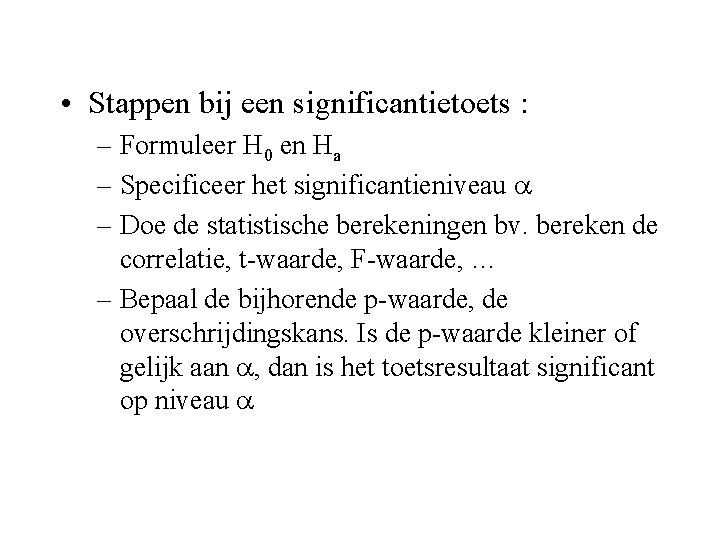
• Stappen bij een significantietoets : – Formuleer H 0 en Ha – Specificeer het significantieniveau – Doe de statistische berekeningen bv. bereken de correlatie, t-waarde, F-waarde, … – Bepaal de bijhorende p-waarde, de overschrijdingskans. Is de p-waarde kleiner of gelijk aan , dan is het toetsresultaat significant op niveau
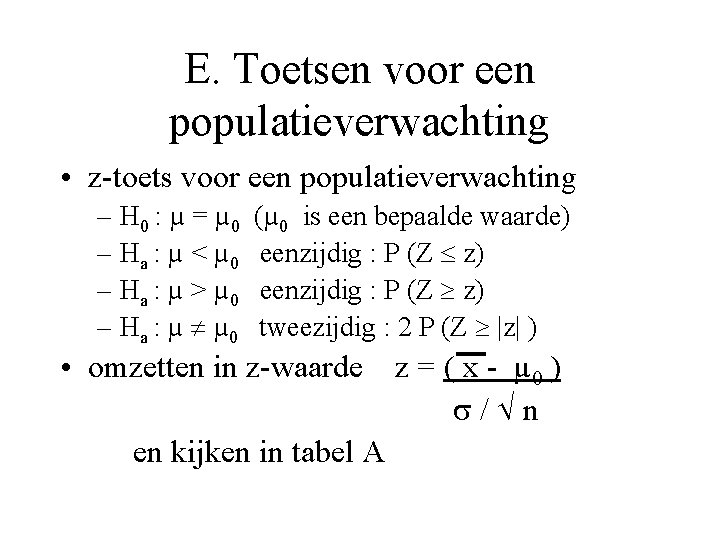
E. Toetsen voor een populatieverwachting • z-toets voor een populatieverwachting – H 0 : µ = µ 0 – Ha : µ < µ 0 – Ha : µ > µ 0 – Ha : µ µ 0 (µ 0 is een bepaalde waarde) eenzijdig : P (Z z) tweezijdig : 2 P (Z |z| ) • omzetten in z-waarde z = ( x - µ 0 ) / n en kijken in tabel A
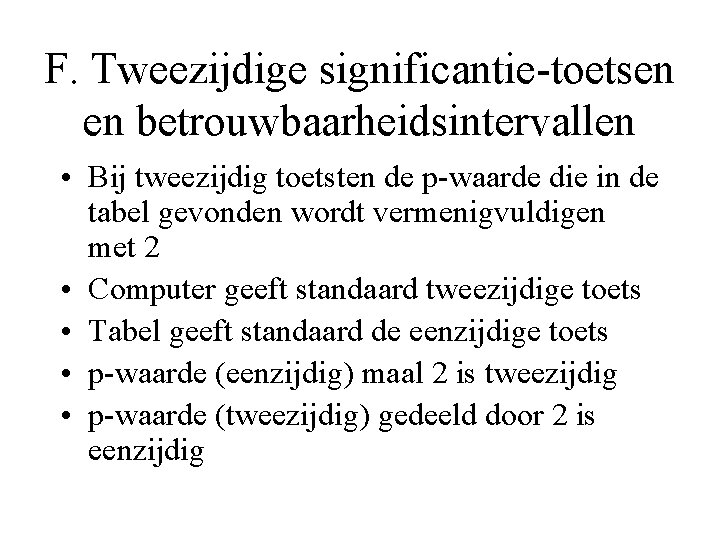
F. Tweezijdige significantie-toetsen en betrouwbaarheidsintervallen • Bij tweezijdig toetsten de p-waarde die in de tabel gevonden wordt vermenigvuldigen met 2 • Computer geeft standaard tweezijdige toets • Tabel geeft standaard de eenzijdige toets • p-waarde (eenzijdig) maal 2 is tweezijdig • p-waarde (tweezijdig) gedeeld door 2 is eenzijdig
G. Overschrijdingskansen versus vast niveau • De overschrijdingskans p is het kleinste niveau waarbij de data significant zijn. • Deze p-waarde wordt door de computer gegeven of opzoeken in Tabel • Bij vast niveau enkel beslissen : onder of boven : gemakkelijker maar je hebt minder informatie
6. 3. Gebruik en misbruik van toetsen • Uitvoeren van een significantietoets is zeer eenvoudig, zeker met computer • Toetsen moeten wel verstandig gebruikt worden • Onderzoekers doen soms te gemakkelijk toetsen zonder eerst stil te staan bij wat ze doen
A. Kiezen van een significantieniveau • Ha is meestal de onderzoekshypothese die bij een lage overschrijdingskans wordt bevestigd • Als H 0 een jarenlang aanvaarde waarheid is (plausibiliteit), of als verwerping vergaande consequenties heeft (consequenties), zal klein moeten zijn
• Meest gangbaar 10%, 5%, en 1% • Afhankelijk van inhoud van onderzoek deze kiezen • Meestal wordt 5% gebruikt, dit is eigenlijk een artificiële grens, er is geen breuk tussen wel en niet significant, enkel een bewijs die in sterkte toeneemt • Dus niet zomaar altijd 5% nemen en dit als een definitief BEWIJS zien, steeds als een kans
B. Wat statistische significantie niet betekent • “Statistische significantie is niet hetzelfde als praktische significantie” want bij grote steekproeven vinden we vlug significantie • Bv. correlatie van 0. 09 kan bij een steekproef van 1000 pp. een p =0. 03 geven • Gewoonlijk is het verstandig ook grafisch te kijken • Geef beter ook een betrouwbaarheidsinterval, geeft meer info dan enkel significantie
C. Negeer het ontbreken van significantie niet • Het NIET significant zijn kan even belangrijke informatie geven, maar wordt zelden gepubliceerd • Door deze niet te rapporteren gaan andere onderzoekers opnieuw op zoek, zonder effect. • Kan ook niet significant zijn omdat het onderscheidingsvermogen van de toets te zwak was (zie later)
D. Statistische inferentie is niet voor alle data geldig • Enkel op correct verzamelde gegevens betekenen significantietoetsen iets – Experimenten – Aselecte steekproef • Dikwijls dit niet voorhanden : telkens op voorhand goed nagaan hoe data verkregen zijn (zie hoofdstuk 3)
E. Ga niet zoeken naar significantie • Op voorhand hypothese stellen en dan toetsen, niet op zoek gaan naar alle mogelijke significanties : op 100 toetsen automatisch 5% significant door toeval • Computer is hier probleem : op enkele minuten honderden toetsen uitvoeren : steeds blijven nadenken • Beter : eerst exploratief en op ANDERE data deze hypothese toetsen
6. 4. Onderscheidingsvermogen en inferentie bij beslissingsproblemen • Onderscheidingsvermogen van een toets of de power van de toets : is de toets sterk genoeg om de nulhypothese te kunnen verwerpen • Sterke link tussen onderscheidingsvermogen en aantal subjecten : hoe meer subjecten, hoe groter het onderscheidingsvermogen
• 80% onderscheidingsvermogen is standaard aan het worden, of power van. 80 • Als het onderscheidingsvermogen te klein is zal de nulhypothese niet kunnen worden verworpen, zelfs indien de werkelijke waarde ver weg ligt van de nulhypothese • Berekenigen van onderscheidingsvermogen of power enkel met computer
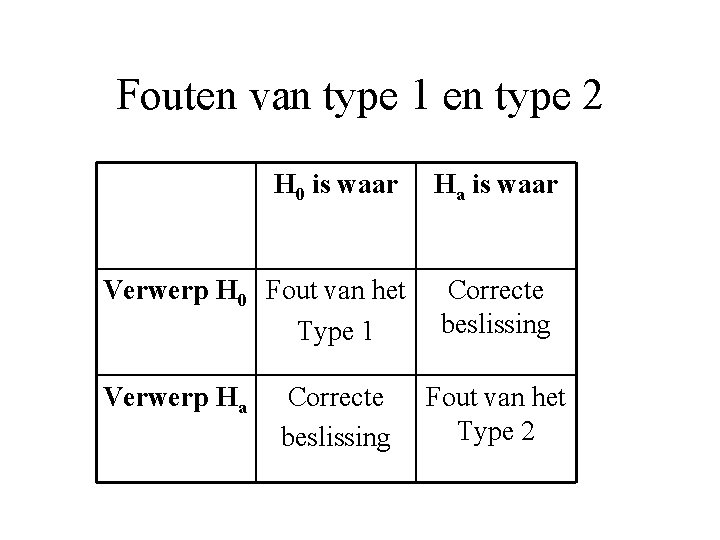
Fouten van type 1 en type 2 H 0 is waar Ha is waar Verwerp H 0 Fout van het Type 1 Correcte beslissing Verwerp Ha Correcte beslissing Fout van het Type 2
• Het significantieniveau is de kans op een fout van het type 1, of is kans dat de toets de nulhypothese zal verwerpen terwijl die in feite juist is • Het onderscheidingsvermogen van een significantietoets is 1 - de kans op een fout van de tweede soort : de toets is niet gevoelig genoeg om de nulhypothese te kunnen verwerpen