
HK 07 Les 4 Inleiding tot de Bayesiaanse
HK 07 – Les 4 Inleiding tot de Bayesiaanse statistiek Yves Moreau 3 de jr. Burg. Ir. Elektrotechniek Dataverwerking & Automatisatie 2001 -2002
Overzicht n n n De Cox-Jaynes axiomas De regel van Bayes Probabilistische modellen n n Maximum aannemelijkheid Maximum a posteriori Bayesiaanse inferentie Multinomiale en Dirichletverdelingen Schatting van frequentiematrices n n Pseudocounts Dirichletmengeling
De Cox-Jaynes axiomas en de regel van Bayes
Waarschijnlijkheid vs. overtuiging n Wat is een waarschijnlijkheid? n Frequentistisch standpunt n n n Waarschijnlijkheden zijn wat frequentietellingen (muntstuk, dobbelsteen) en histogrammen (lengte van mensen) naar convergeren Zulke definitie trekt op een cirkelredenering omwille van de afhankelijkheid op de Centrale Limiete Stelling Maattheoriestandpunt n n n Waarschijnlijkheden voldoen aan de s-algebra axiomas van Kolmogorov Rigoureuze definitie die goed past binnen het kader van integratieleer en maattheorie Maar definitie is ad hoc opgebouwd om binnen dit kader te passen
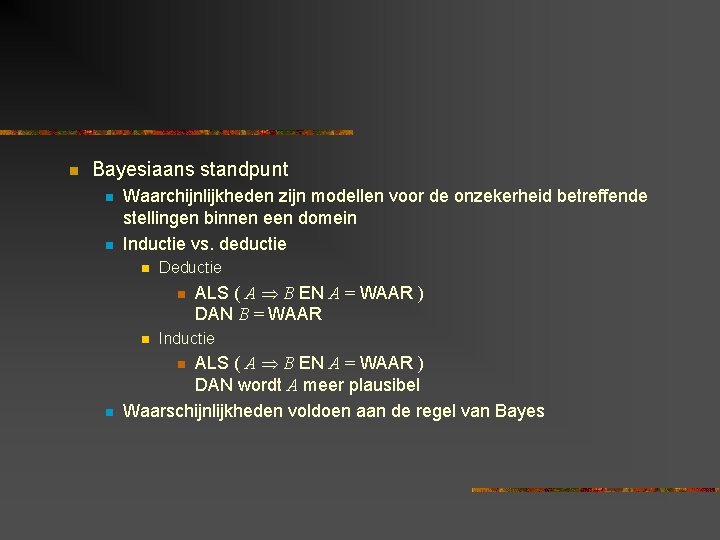
n Bayesiaans standpunt n n Waarchijnlijkheden zijn modellen voor de onzekerheid betreffende stellingen binnen een domein Inductie vs. deductie n Deductie n n Inductie ALS ( A B EN A = WAAR ) DAN wordt A meer plausibel Waarschijnlijkheden voldoen aan de regel van Bayes n n ALS ( A B EN A = WAAR ) DAN B = WAAR
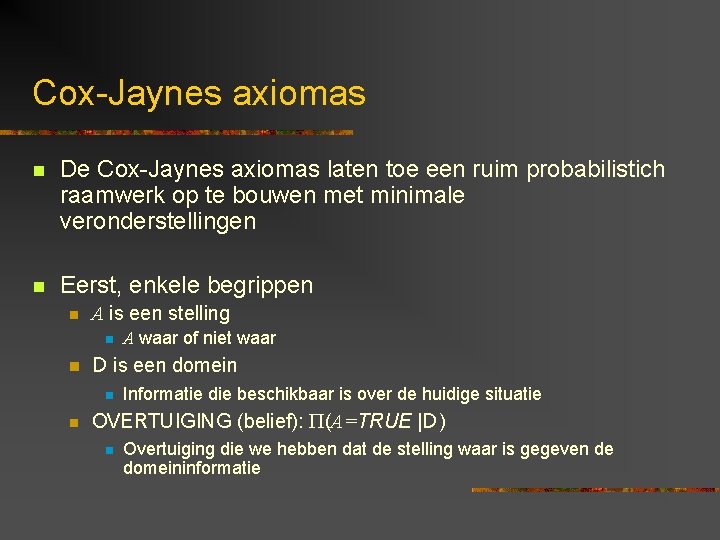
Cox-Jaynes axiomas n De Cox-Jaynes axiomas laten toe een ruim probabilistich raamwerk op te bouwen met minimale veronderstellingen n Eerst, enkele begrippen n A is een stelling n n D is een domein n n A waar of niet waar Informatie die beschikbaar is over de huidige situatie OVERTUIGING (belief): P(A=TRUE |D) n Overtuiging die we hebben dat de stelling waar is gegeven de domeininformatie
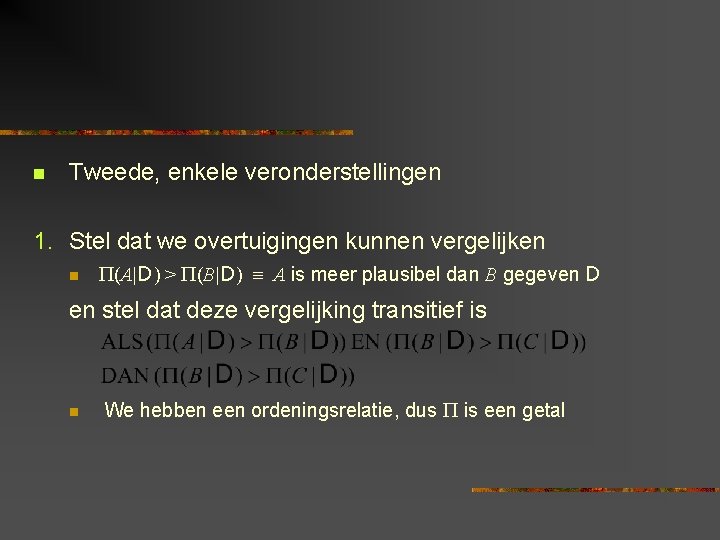
n Tweede, enkele veronderstellingen 1. Stel dat we overtuigingen kunnen vergelijken n P(A|D) > P(B|D) A is meer plausibel dan B gegeven D en stel dat deze vergelijking transitief is n We hebben een ordeningsrelatie, dus P is een getal
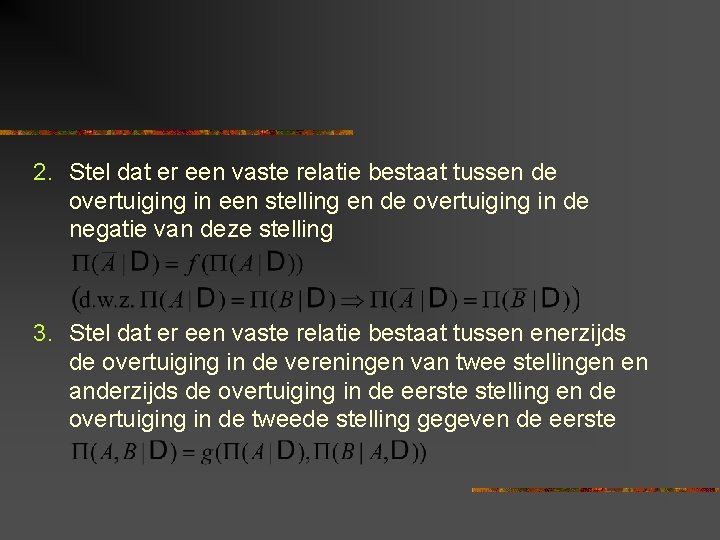
2. Stel dat er een vaste relatie bestaat tussen de overtuiging in een stelling en de overtuiging in de negatie van deze stelling 3. Stel dat er een vaste relatie bestaat tussen enerzijds de overtuiging in de vereningen van twee stellingen en anderzijds de overtuiging in de eerste stelling en de overtuiging in de tweede stelling gegeven de eerste
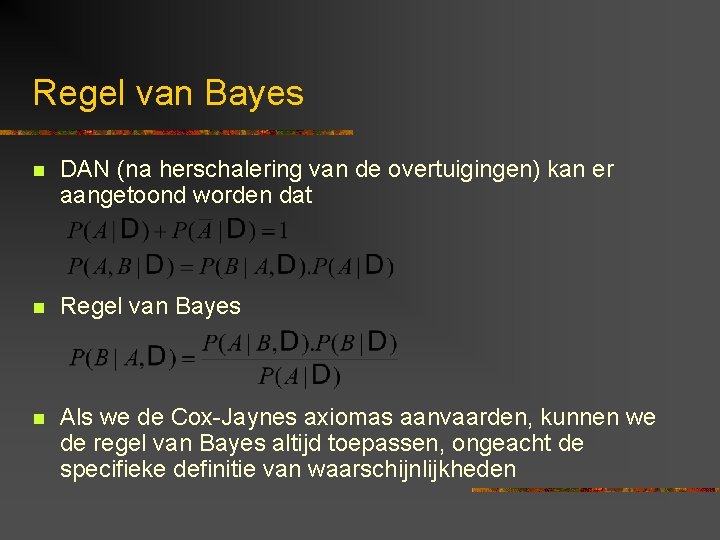
Regel van Bayes n DAN (na herschalering van de overtuigingen) kan er aangetoond worden dat n Regel van Bayes n Als we de Cox-Jaynes axiomas aanvaarden, kunnen we de regel van Bayes altijd toepassen, ongeacht de specifieke definitie van waarschijnlijkheden
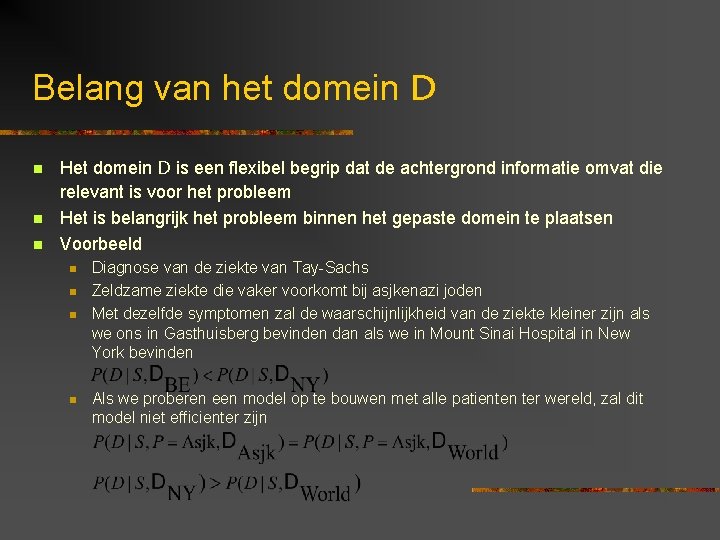
Belang van het domein D n n n Het domein D is een flexibel begrip dat de achtergrond informatie omvat die relevant is voor het probleem Het is belangrijk het probleem binnen het gepaste domein te plaatsen Voorbeeld n n Diagnose van de ziekte van Tay-Sachs Zeldzame ziekte die vaker voorkomt bij asjkenazi joden Met dezelfde symptomen zal de waarschijnlijkheid van de ziekte kleiner zijn als we ons in Gasthuisberg bevinden dan als we in Mount Sinai Hospital in New York bevinden Als we proberen een model op te bouwen met alle patienten ter wereld, zal dit model niet efficienter zijn
Probabilistische modellen en inferentie
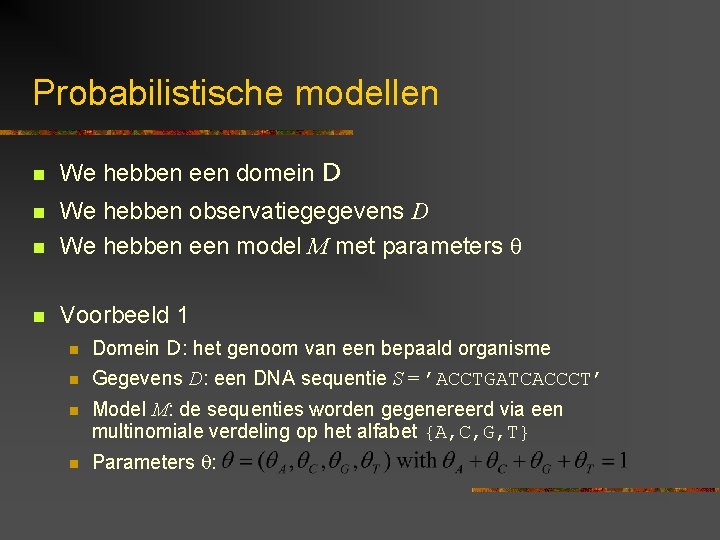
Probabilistische modellen n We hebben een domein D n We hebben observatiegegevens D We hebben een model M met parameters q n n Voorbeeld 1 n Domein D: het genoom van een bepaald organisme n Gegevens D: een DNA sequentie S = ’ACCTGATCACCCT’ n Model M: de sequenties worden gegenereerd via een multinomiale verdeling op het alfabet {A, C, G, T} n Parameters q:
n Voorbeeld 2 n Domein D: alle mensen in Europa n n n Gegevens D: de lengte van mensen uit een groep Model M: de lengte is normaal verdeeld N(m, s) Parameters q: de gemiddelde m en de variantie s
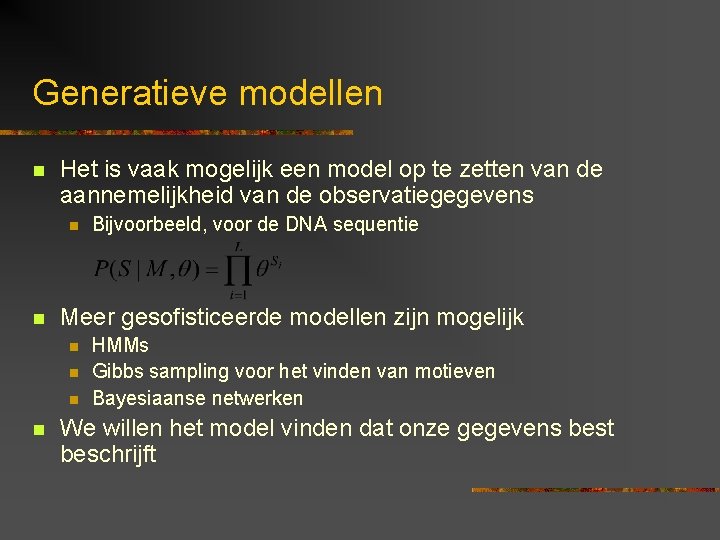
Generatieve modellen n Het is vaak mogelijk een model op te zetten van de aannemelijkheid van de observatiegegevens n n Meer gesofisticeerde modellen zijn mogelijk n n Bijvoorbeeld, voor de DNA sequentie HMMs Gibbs sampling voor het vinden van motieven Bayesiaanse netwerken We willen het model vinden dat onze gegevens best beschrijft
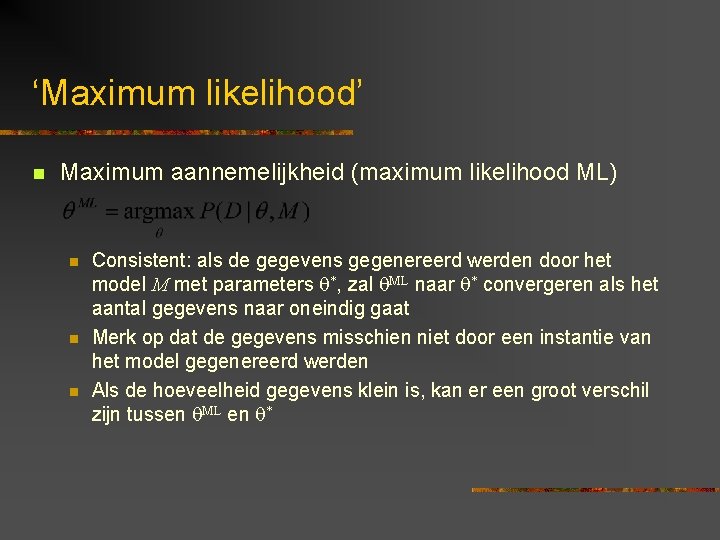
‘Maximum likelihood’ n Maximum aannemelijkheid (maximum likelihood ML) n n n Consistent: als de gegevens gegenereerd werden door het model M met parameters q*, zal q. ML naar q* convergeren als het aantal gegevens naar oneindig gaat Merk op dat de gegevens misschien niet door een instantie van het model gegenereerd werden Als de hoeveelheid gegevens klein is, kan er een groot verschil zijn tussen q. ML en q*
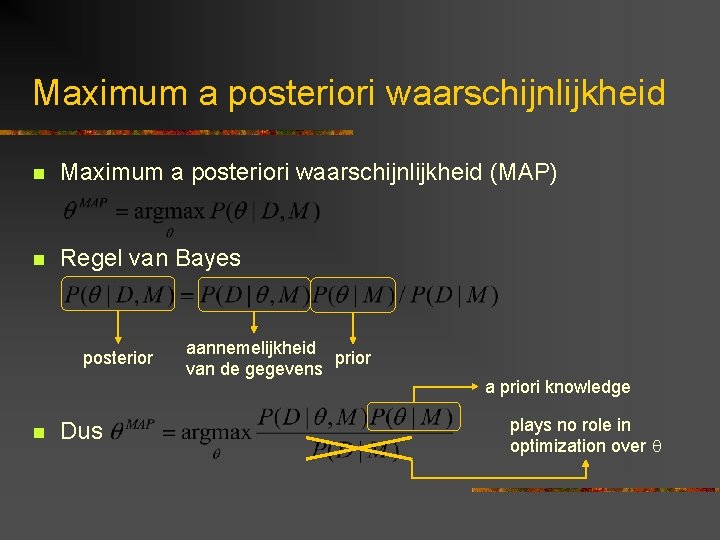
Maximum a posteriori waarschijnlijkheid n Maximum a posteriori waarschijnlijkheid (MAP) n Regel van Bayes posterior n Dus aannemelijkheid prior van de gegevens a priori knowledge plays no role in optimization over q
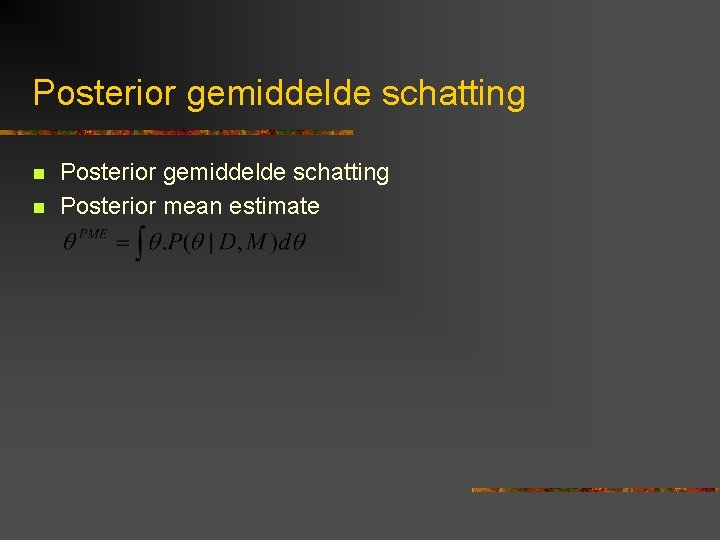
Posterior gemiddelde schatting n n Posterior gemiddelde schatting Posterior mean estimate
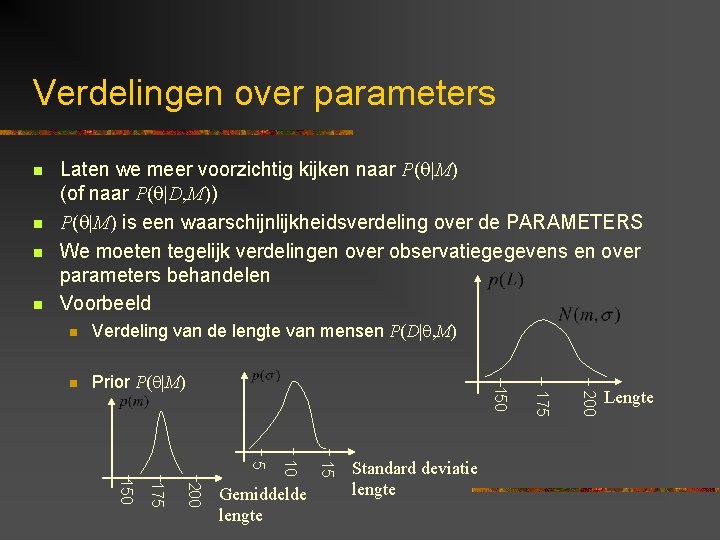
Verdelingen over parameters n n Laten we meer voorzichtig kijken naar P(q|M) (of naar P(q|D, M)) P(q|M) is een waarschijnlijkheidsverdeling over de PARAMETERS We moeten tegelijk verdelingen over observatiegegevens en over parameters behandelen Voorbeeld Prior P(q|M) 15 10 5 200 175 150 Gemiddelde lengte Standard deviatie lengte 200 n 175 Verdeling van de lengte van mensen P(D|q, M) 150 n Lengte
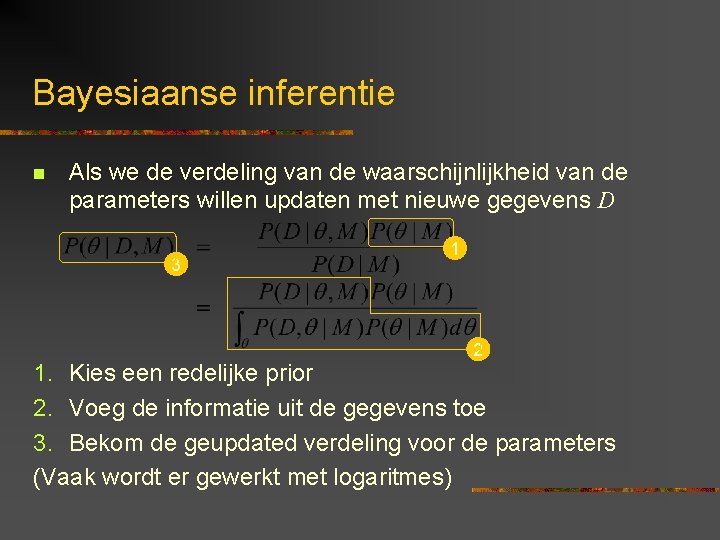
Bayesiaanse inferentie n Als we de verdeling van de waarschijnlijkheid van de parameters willen updaten met nieuwe gegevens D 3 1 2 1. Kies een redelijke prior 2. Voeg de informatie uit de gegevens toe 3. Bekom de geupdated verdeling voor de parameters (Vaak wordt er gewerkt met logaritmes)
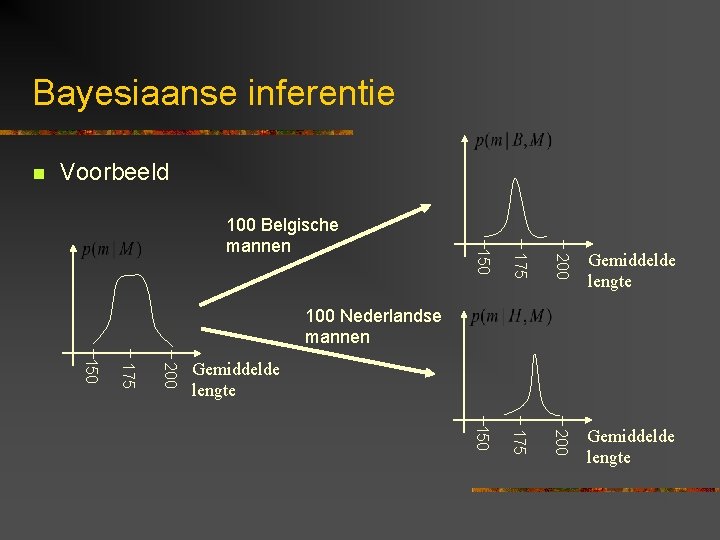
Bayesiaanse inferentie n Voorbeeld 200 Gemiddelde lengte 200 175 150 100 Belgische mannen Gemiddelde lengte 100 Nederlandse mannen 200 175 150 Gemiddelde lengte 175 150
Multinomiale en Dirichletverdelingen
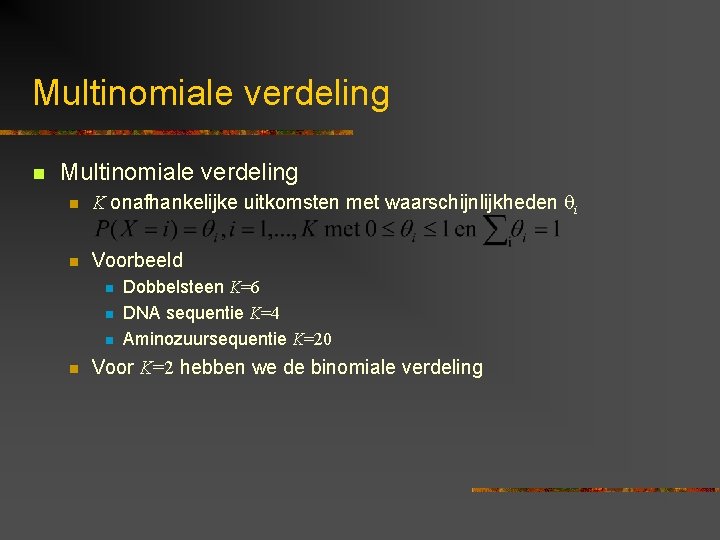
Multinomiale verdeling n K onafhankelijke uitkomsten met waarschijnlijkheden qi n Voorbeeld n n Dobbelsteen K=6 DNA sequentie K=4 Aminozuursequentie K=20 Voor K=2 hebben we de binomiale verdeling
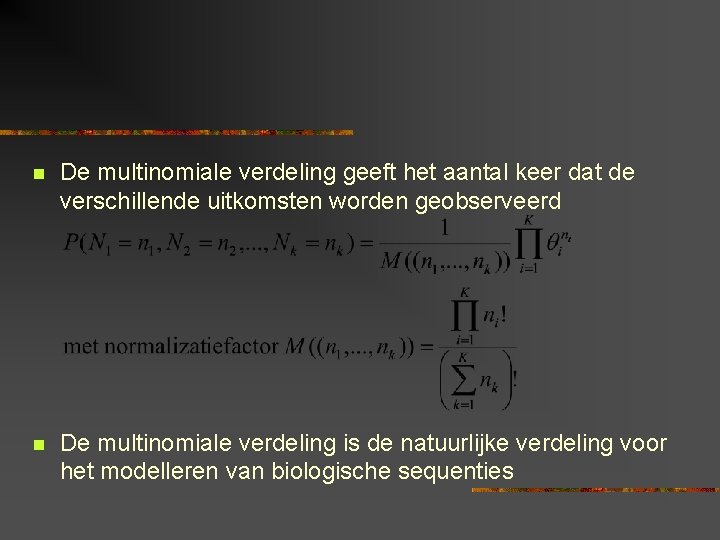
n De multinomiale verdeling geeft het aantal keer dat de verschillende uitkomsten worden geobserveerd n De multinomiale verdeling is de natuurlijke verdeling voor het modelleren van biologische sequenties
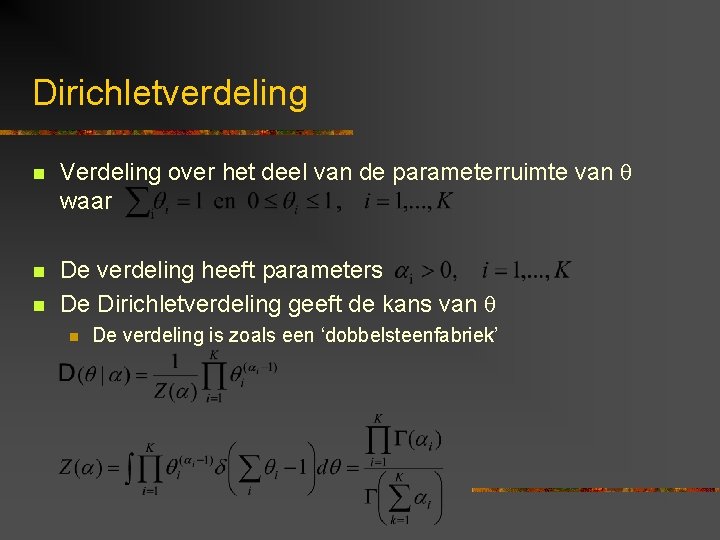
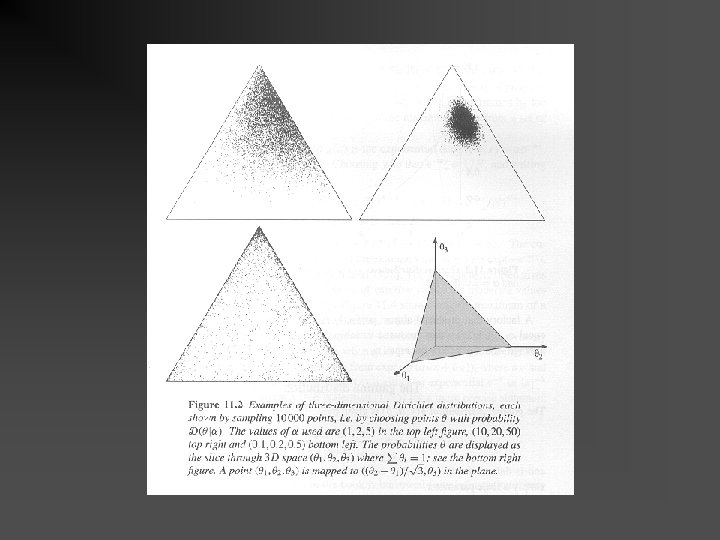
Dirichletverdeling n Verdeling over het deel van de parameterruimte van q waar n De verdeling heeft parameters De Dirichletverdeling geeft de kans van q n n De verdeling is zoals een ‘dobbelsteenfabriek’
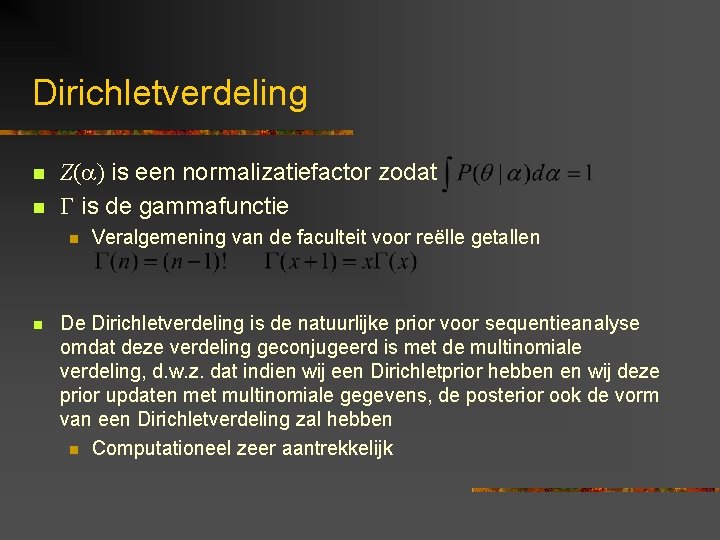
Dirichletverdeling n n Z(a) is een normalizatiefactor zodat G is de gammafunctie n n Veralgemening van de faculteit voor reëlle getallen De Dirichletverdeling is de natuurlijke prior voor sequentieanalyse omdat deze verdeling geconjugeerd is met de multinomiale verdeling, d. w. z. dat indien wij een Dirichletprior hebben en wij deze prior updaten met multinomiale gegevens, de posterior ook de vorm van een Dirichletverdeling zal hebben n Computationeel zeer aantrekkelijk
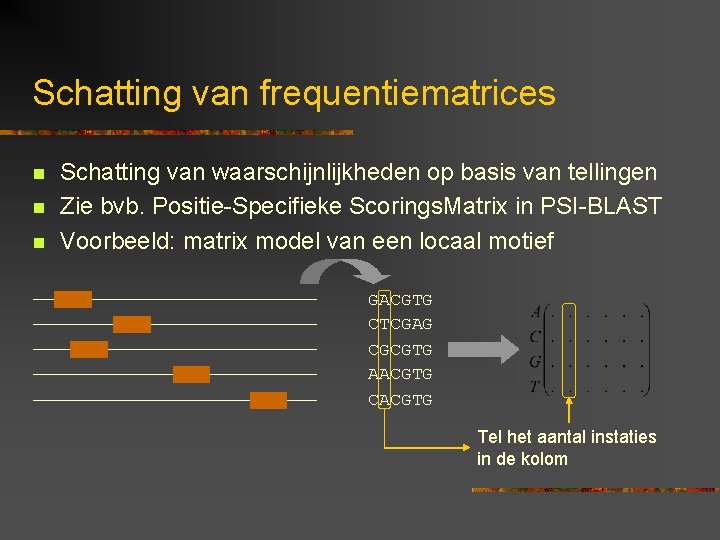
Schatting van frequentiematrices n n n Schatting van waarschijnlijkheden op basis van tellingen Zie bvb. Positie-Specifieke Scorings. Matrix in PSI-BLAST Voorbeeld: matrix model van een locaal motief GACGTG CTCGAG CGCGTG AACGTG CACGTG Tel het aantal instaties in de kolom
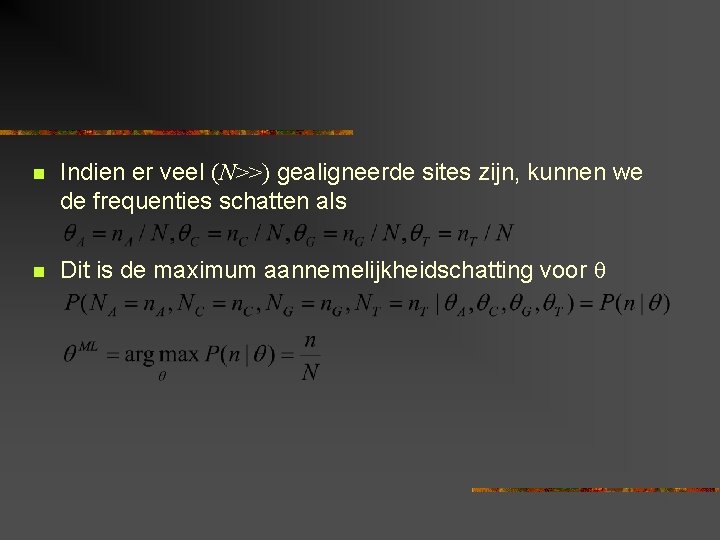
n Indien er veel (N>>) gealigneerde sites zijn, kunnen we de frequenties schatten als n Dit is de maximum aannemelijkheidschatting voor q
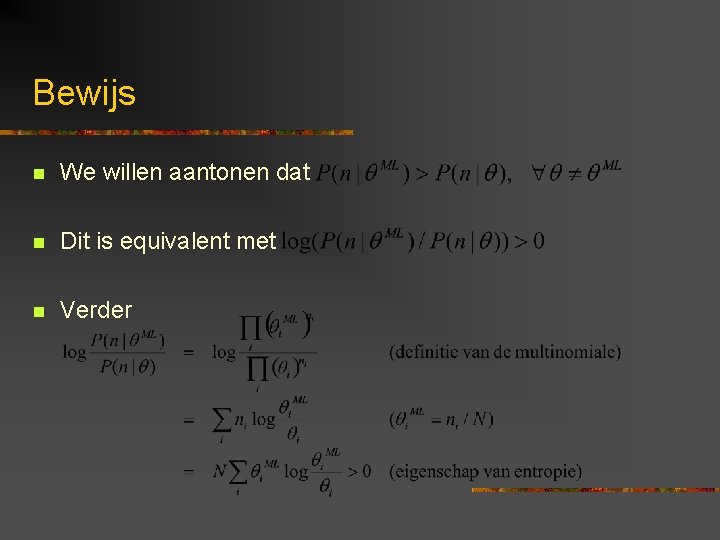
Bewijs n We willen aantonen dat n Dit is equivalent met n Verder
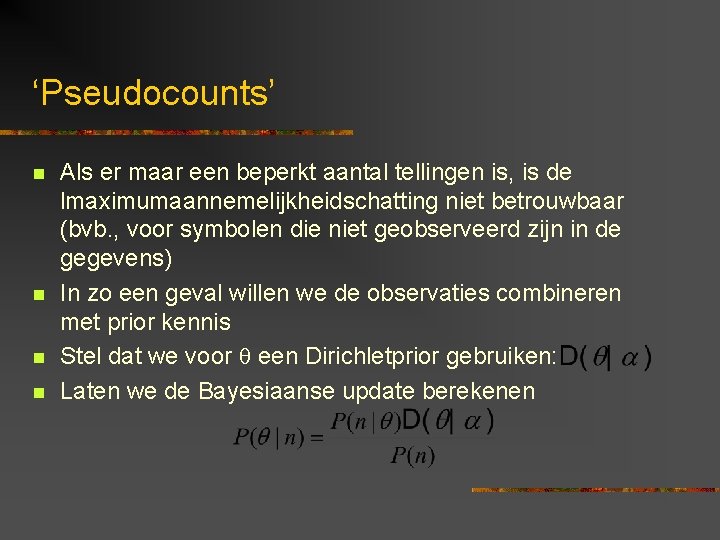
‘Pseudocounts’ n n Als er maar een beperkt aantal tellingen is, is de lmaximumaannemelijkheidschatting niet betrouwbaar (bvb. , voor symbolen die niet geobserveerd zijn in de gegevens) In zo een geval willen we de observaties combineren met prior kennis Stel dat we voor q een Dirichletprior gebruiken: Laten we de Bayesiaanse update berekenen
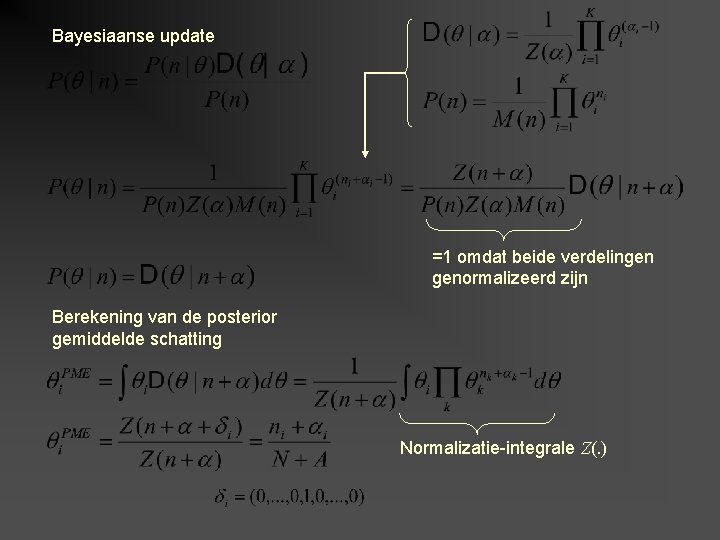
Bayesiaanse update =1 omdat beide verdelingen genormalizeerd zijn Berekening van de posterior gemiddelde schatting Normalizatie-integrale Z(. )
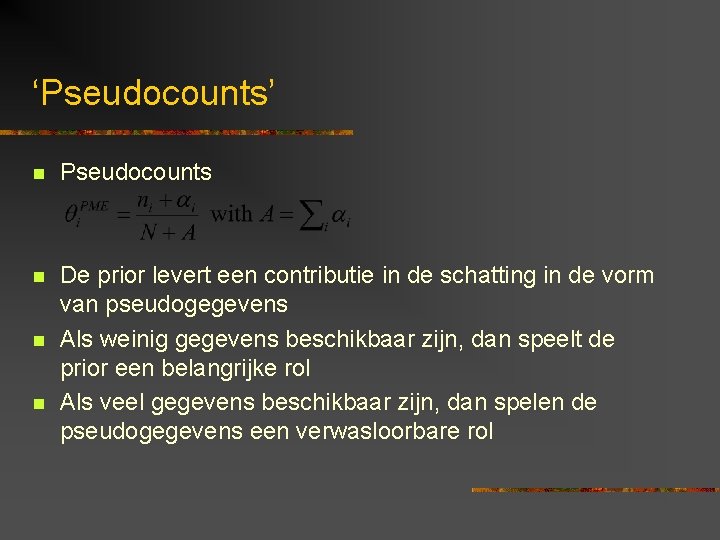
‘Pseudocounts’ n Pseudocounts n De prior levert een contributie in de schatting in de vorm van pseudogegevens Als weinig gegevens beschikbaar zijn, dan speelt de prior een belangrijke rol Als veel gegevens beschikbaar zijn, dan spelen de pseudogegevens een verwasloorbare rol n n
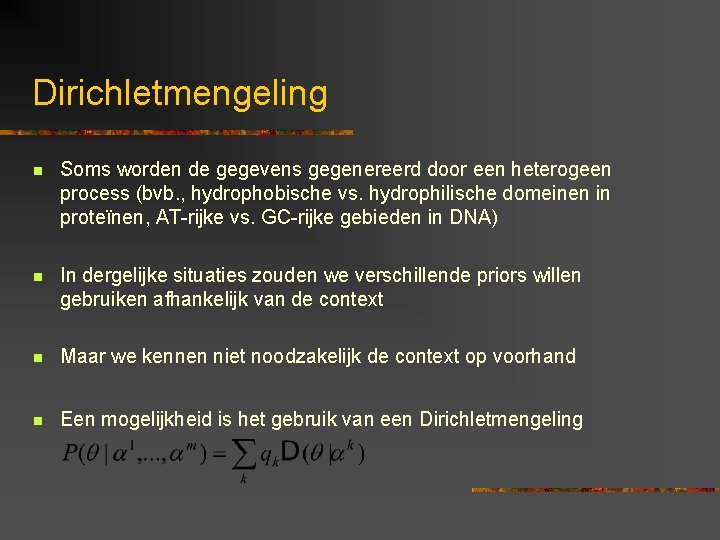
Dirichletmengeling n Soms worden de gegevens gegenereerd door een heterogeen process (bvb. , hydrophobische vs. hydrophilische domeinen in proteïnen, AT-rijke vs. GC-rijke gebieden in DNA) n In dergelijke situaties zouden we verschillende priors willen gebruiken afhankelijk van de context n Maar we kennen niet noodzakelijk de context op voorhand n Een mogelijkheid is het gebruik van een Dirichletmengeling
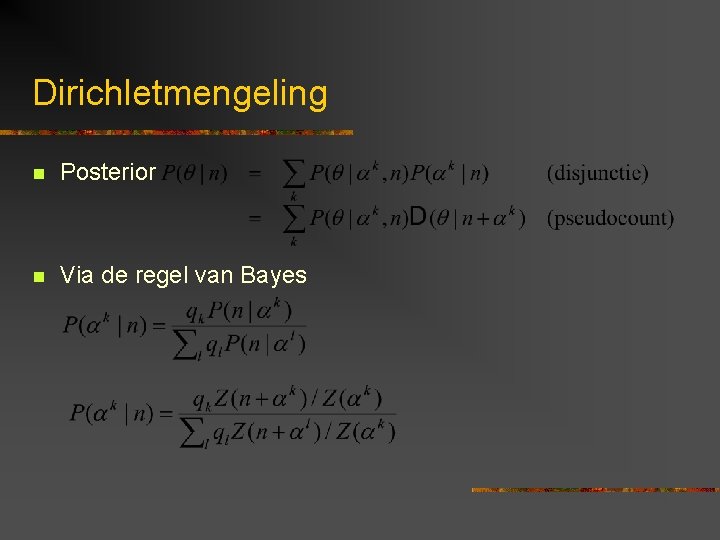
Dirichletmengeling n Posterior n Via de regel van Bayes
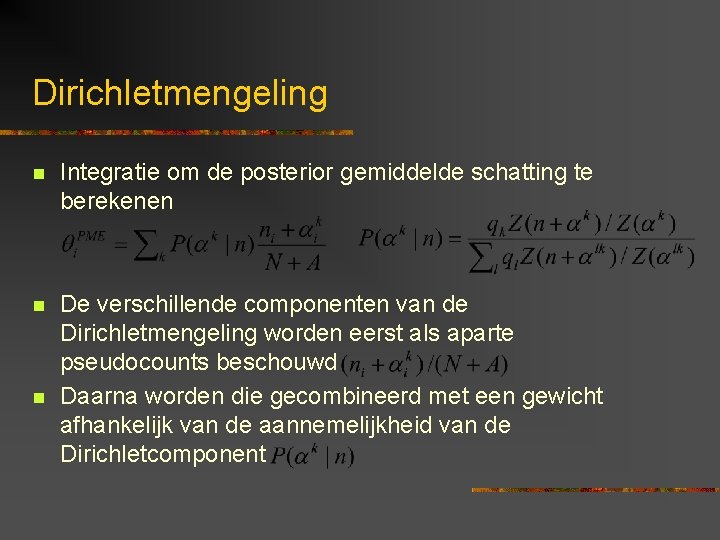
Dirichletmengeling n Integratie om de posterior gemiddelde schatting te berekenen n De verschillende componenten van de Dirichletmengeling worden eerst als aparte pseudocounts beschouwd Daarna worden die gecombineerd met een gewicht afhankelijk van de aannemelijkheid van de Dirichletcomponent n
Samenvatting n n n De Cox-Jaynes axiomas De regel van Bayes Probabilistische modellen n n Maximum aannemelijkheid Maximum a posteriori Bayesiaanse inferentie Multinomiale en Dirichletverdelingen Schatting van frequentiematrices n n Pseudocounts Dirichletmengeling
- Slides: 36