METADADA ZENG Marcia Lei e QIN Jian Metadata
- Slides: 29
METADADA • ZENG, Marcia Lei e QIN, Jian. Metadata Standards. In: ___. Metadata. 2ª Edição. 555 p. Chicago: Neal. Schuman/American Library Association. 2016. Capítulo 5, p. 219 -248.
CONTEXTO • Esquema: "an internal representation of the world; an organization of concepts and action that can be revised by new information about the world" (Word. Net) • Esquema: definições semânticas e estruturais de elementos de metadados, incluindo as relações entre esses elementos, representadas em um formato padronizado de sintaxe • As representações semânticas e estruturais dos esquemas de metadados não definem apenas o que os elementos significam, mas também como serão codificados em um formato processável por máquina
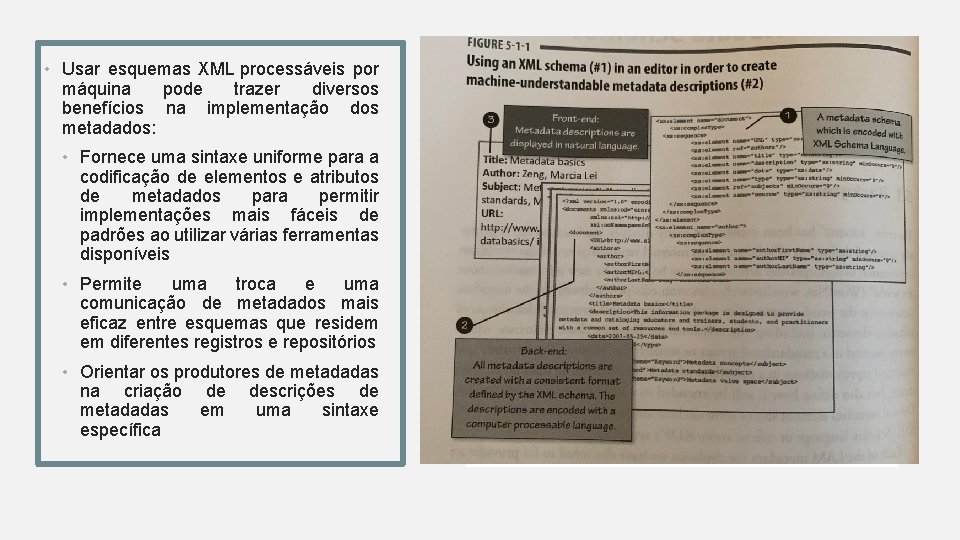
• Usar esquemas XML processáveis por máquina pode trazer diversos benefícios na implementação dos metadados: • Fornece uma sintaxe uniforme para a codificação de elementos e atributos de metadados para permitir implementações mais fáceis de padrões ao utilizar várias ferramentas disponíveis • Permite uma troca e uma comunicação de metadados mais eficaz entre esquemas que residem em diferentes registros e repositórios • Orientar os produtores de metadadas na criação de descrições de metadadas em uma sintaxe específica
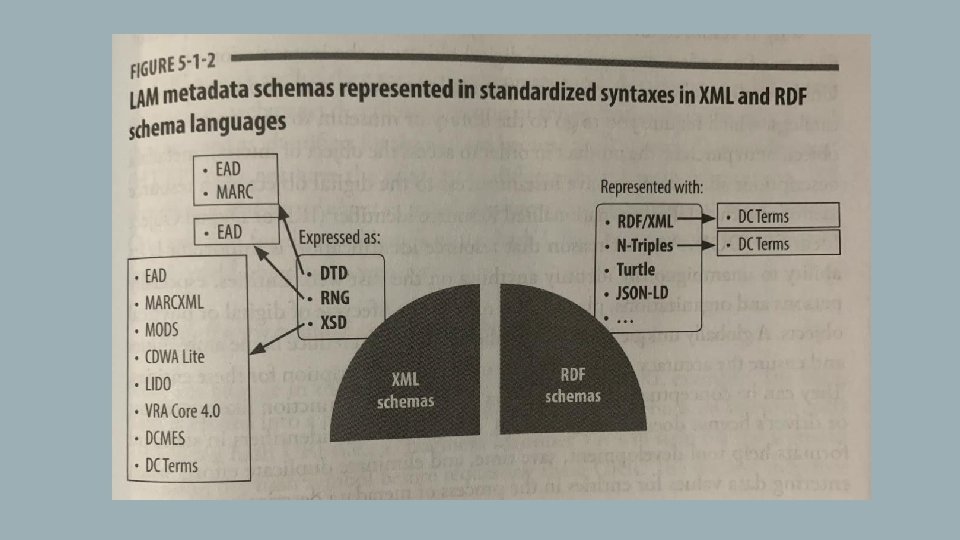
• Foi pioneiro dos esquemas de metadados desenvolvidos para a comunidade LAM • A semântica/estrutura e a sintaxe são integradas como uma unidade • Foi desenvolvido primeiramente como um Document Type Definition (DTD) ENCODED ARCHIVAL DESCRIPTIO N (EAD) • A versão Beta é de 1996 e se tornou compatível com XML durante a última etapa da versão 1. 0 do EAD, em 1998 • Todo o conjunto do DTD e de arquivos de referência de entidade foi redesenhado para atender às necessidades do XML na DTD da EAD 2002 • A W 3 C XML Schema 1. 0 foi aprovada como uma W 3 C recommendation (2001) • Duas sintaxes XML estão disponíveis para EAD: the Relax NG Schema (RNG, REgular LAnguage for XML Next Generation) e a W 3 C XML Schema (XSD) publicada pela Library of Congress • Resumo: [EAD] SGML DTD → XML Schema (Relax NG e XSD)
• Semelhante ao EAD, o MARC também emitiu DTDs, SGML e XML nos anos 90 • Na família MARC, MARCXML e o MODS (Metadada Object Description Schema) foram baseados no MARC 21 MARC • MARCXML: suporta marcação XML dos registros MARC 21, conforme especificado na documentação do MARC • MODS: esquema para elementos bibliográficos que é mais simples e mais amigável que o esquema MARCXML completo • Ambos os esquemas (MODS e MARCXML) permitem a conversão de registros MARC 21 em registros XML
CDWA LITE E LIDO • Embora os elementos em um padrão de metadados possam ser publicados sem um esquema de codificação correspondente, é comum hoje publicar padrões que incluam ambos os esquemas semântico/estrutural e codificador, como é o caso do CDWA Lite • CDWA Lite (Categories for the Description of Works of Art) : foi baseado nas semânticas definidas pela CDWA completa • A CDWA Lite providencia dois documentos em seu site: • Definições das semânticas (lista de elementos, tags, descrições e exemplos) • Sintaxe de codificação • A CDWA Lite foi expandida e integrada no esquema Lightweight Information Describing Objects (LIDO)
• Os termos DCMI, publicados na Web como um documento HTML, na verdade incorporam a marcação RDFa em todo o documento desde 2012 • DCMI fornece tanto esquemas XML quanto RDF para dar suporte aos termos de metadados do DCMES e DCMI DUBLIN CORE • O esquema DC XML simples definiu 15 elementos centrais • Um conjunto completo de esquemas XML foi desenvolvido, incluindo três esquemas "base" que declaram elementos XML para representar elementos DC e refinamentos de elementos, além de tipos complexos de DCMI • Resumo: os esquemas DC atualmente incluem: • Esquemas XML para DCMES 1. 1, Termos DC e DCMI Type Vocabulary • Esquemas RDF para termos DC
RESOURCE IDENTIFICATION • Identificação de recurso: processo no qual uma notação ou protocolo de identificação padrão é usado para identificar globalmente uma entidade exclusivamente • Todos os padrões de metadados contêm especificações para pelo menos uma entidade, seja a parte responsável pela criação, publicação, curadoria ou distribuição do objeto descrito • As descrições de metadados permitem que os usuários tenham acesso instantâneo ao objeto digital por meio de um identificador de recurso (IRI e DOI) • Tem a capacidade de identificar sem ambiguidade qualquer coisa na vastidão da Web • Um identificador único universal para entidades como organizações e pessoas (passaportes ou carteiras de motorista) pode reduzir ambiguidades de nome e garantir a precisão e consistência das descrições de metadados
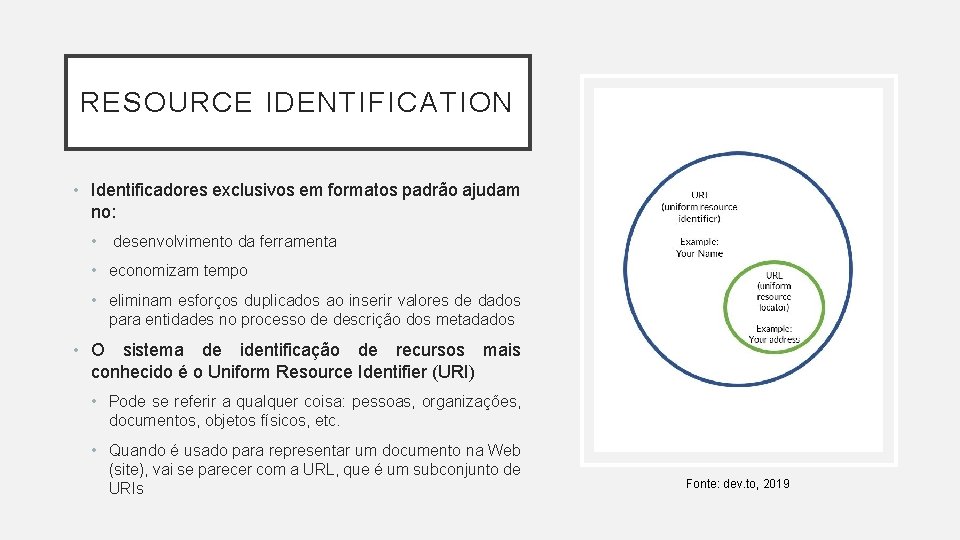
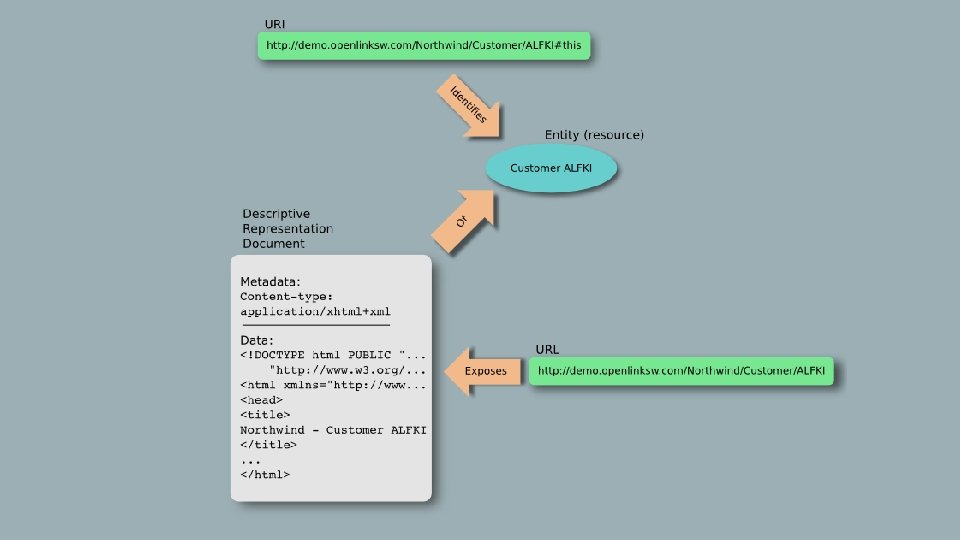
RESOURCE IDENTIFICATION • Identificadores exclusivos em formatos padrão ajudam no: • desenvolvimento da ferramenta • economizam tempo • eliminam esforços duplicados ao inserir valores de dados para entidades no processo de descrição dos metadados • O sistema de identificação de recursos mais conhecido é o Uniform Resource Identifier (URI) • Pode se referir a qualquer coisa: pessoas, organizações, documentos, objetos físicos, etc. • Quando é usado para representar um documento na Web (site), vai se parecer com a URL, que é um subconjunto de URIs Fonte: dev. to, 2019
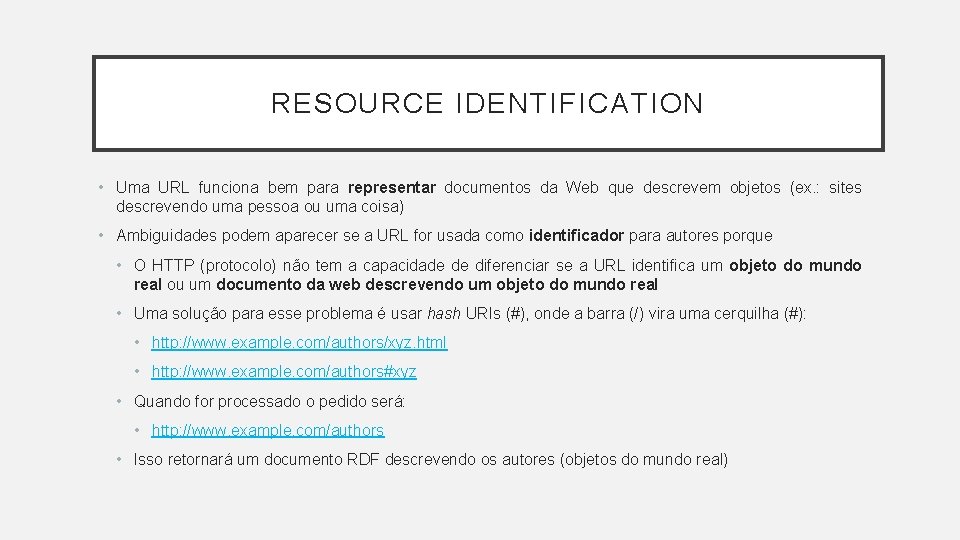
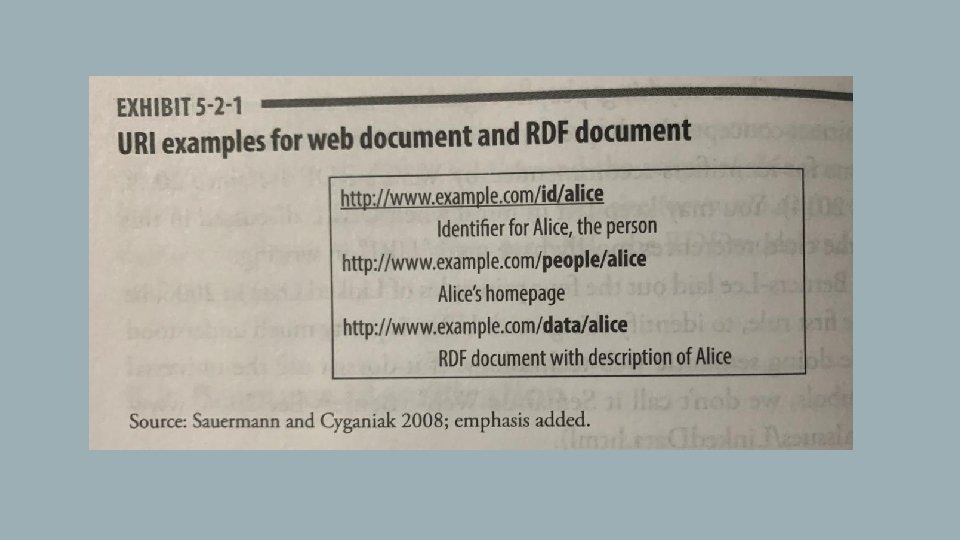
RESOURCE IDENTIFICATION • Uma URL funciona bem para representar documentos da Web que descrevem objetos (ex. : sites descrevendo uma pessoa ou uma coisa) • Ambiguidades podem aparecer se a URL for usada como identificador para autores porque • O HTTP (protocolo) não tem a capacidade de diferenciar se a URL identifica um objeto do mundo real ou um documento da web descrevendo um objeto do mundo real • Uma solução para esse problema é usar hash URIs (#), onde a barra (/) vira uma cerquilha (#): • http: //www. example. com/authors/xyz. html • http: //www. example. com/authors#xyz • Quando for processado o pedido será: • http: //www. example. com/authors • Isso retornará um documento RDF descrevendo os autores (objetos do mundo real)
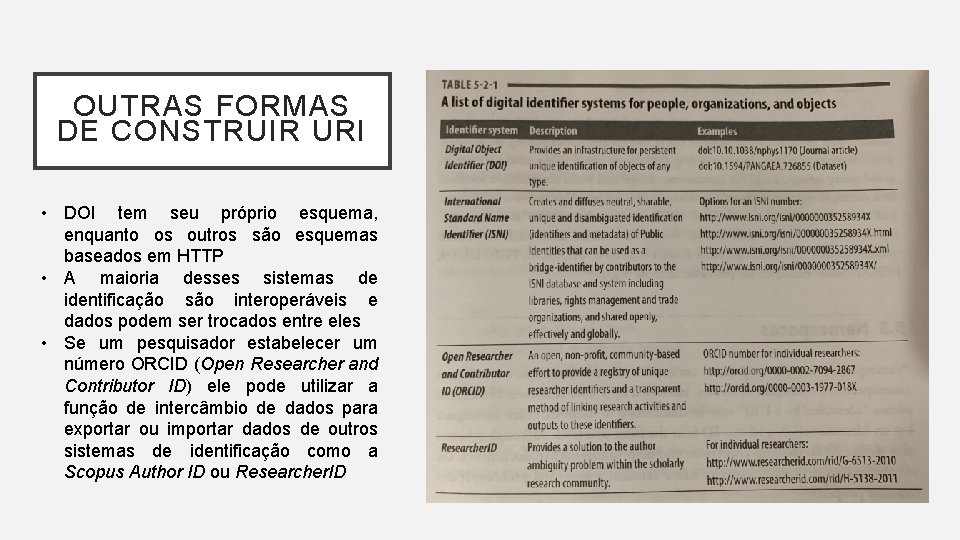
OUTRAS FORMAS DE CONSTRUIR URI • DOI tem seu próprio esquema, enquanto os outros são esquemas baseados em HTTP • A maioria desses sistemas de identificação são interoperáveis e dados podem ser trocados entre eles • Se um pesquisador estabelecer um número ORCID (Open Researcher and Contributor ID) ele pode utilizar a função de intercâmbio de dados para exportar ou importar dados de outros sistemas de identificação como a Scopus Author ID ou Researcher. ID
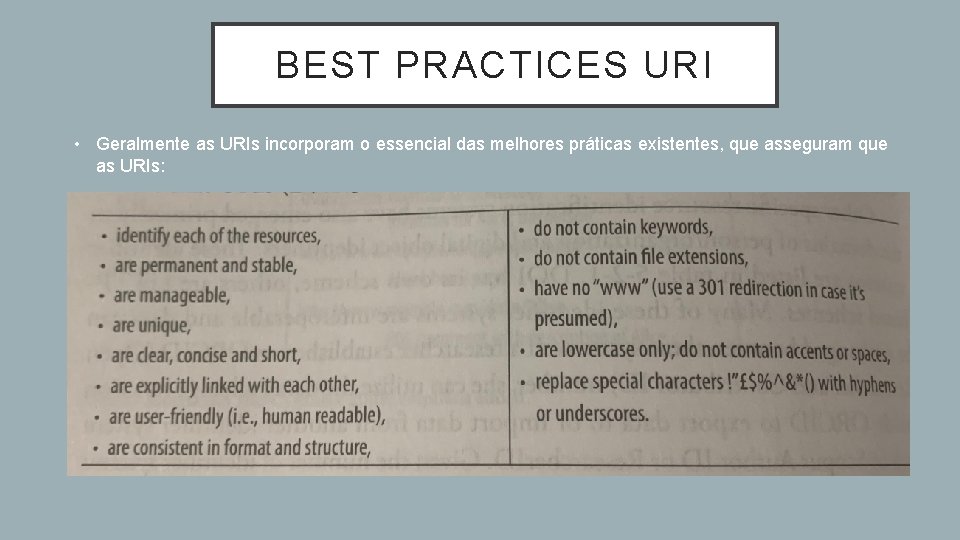
BEST PRACTICES URI • Geralmente as URIs incorporam o essencial das melhores práticas existentes, que asseguram que as URIs:
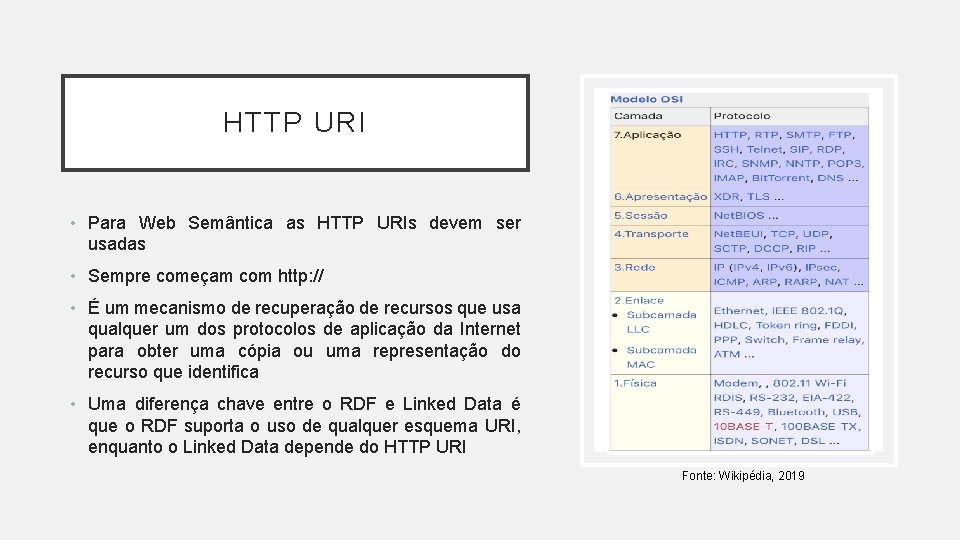
HTTP URI • Para Web Semântica as HTTP URIs devem ser usadas • Sempre começam com http: // • É um mecanismo de recuperação de recursos que usa qualquer um dos protocolos de aplicação da Internet para obter uma cópia ou uma representação do recurso que identifica • Uma diferença chave entre o RDF e Linked Data é que o RDF suporta o uso de qualquer esquema URI, enquanto o Linked Data depende do HTTP URI Fonte: Wikipédia, 2019
NAMESPACES • Coleção de nomes identificados por uma referência URI, ou seja, cada namespace tem um identificador (ID) e esse ID é em forma de URI • O vocabulário usado nos nomes dos elementos é um problema potencial: • Inconsistência dos nomes dos elementos para as mesmas relações semânticas em diferentes esquemas de metadados: “Order. Quantity” e “Order. Qty” / “floor. Rate” e “rate. Floor” • O mesmo nome de elemento com diferentes significados em domínios diferentes: • Catalog. xsd > título do livro (universo bibliográfico) • Journal. Index. xsd > título da revista (universo bibliográfico) • Employee. xsd > título de uma posição (sistema de recursos humanos) • Auto. Insurance. xsd > certificado de propriedade (indústria de seguros) • Se o esquema não tiver contexto causa colisões quando um sistema tenta fazer intercâmbio de dados com outro diferente
NAMESPACES • Convenções de nomenclaturas: conjunto de regras a serem seguidas por designers e programadores para que os tipos de objetos nas aplicações possam ser facilmente reconhecidos e organizados • O XML é o meta-formato predominante para dados e torna inevitável que um esquema frequentemente precise incorporar elementos de outros esquemas • Exemplo: um registro de um paciente médico: sintomas reportados, sinais físicos, diagnósticos, resultados de testes. . . • Cada uma dessas categorias é gerada e, provavelmente, gerenciada por diferentes departamentos e possivelmente contém um conjunto de vocabulários misturados que usam diferentes convenções de nomenclaturas • Namespaces é um mecanismo projetado para resolver problemas como esses
NAMESPACES • Um namespace define o uso dos elementos, bem como um alias que identifica de qual namespace um elemento é retirado • Exemplo: • Um namespace Dublin Core Metadada Elements Set (DCMES) • Identificado por uma URI: "http: //purl. org/dc/elements/1. 1" (os originais 15 elementos) • Alias: “dc” • O “dc” é usado como prefixo de um nome qualificado (XML) quando elementos do DCMES aparecem fora do namespace original do DCMES
NAMESPACES • O namespace funciona como um referente contextual, sendo decisivo para acabar com ambiguidades em vocabulários XML • Adiciona contexto às etiquetas dos elementos: máquinas e humanos podem entender o significado dos elementos • Exemplo: • bk: title para o título do livro • jn: title para o título da revista • hr: title para a posição do funcionário • Para usar o namespace, primeiro precisa-se declará-lo no esquema: • Começa com “xmlns” e é seguido por dois pontos (: ) e o alias • xmlns: bk=“http: //na. books. com/book” • xmlns: order=“http: //ns. books. com/order”
CODIFICAÇÃO DE ESQUEMA A conversão de uma especificação de conjunto de elementos de metadados em um esquema ou esquemas é um processo de estruturação e definição de elementos em um formato processável por máquina
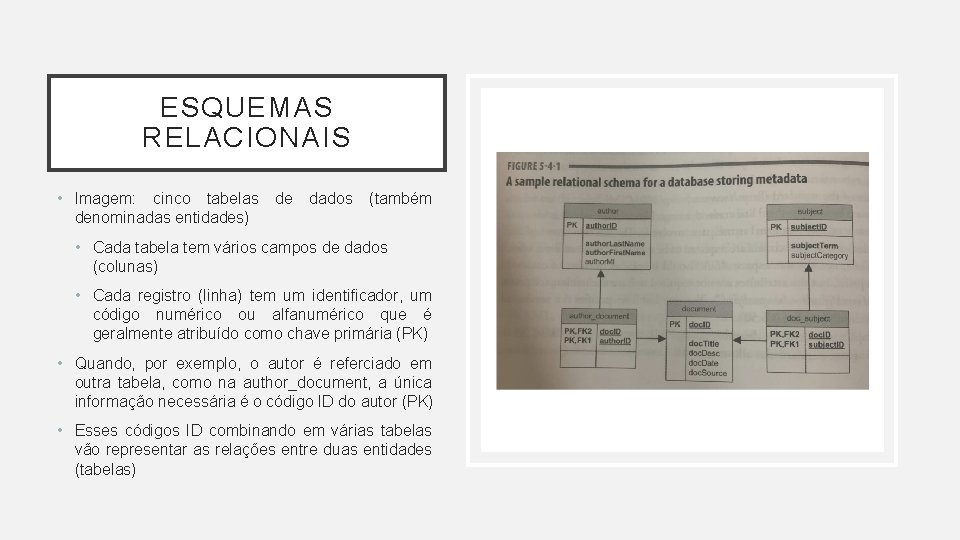
ESQUEMAS RELACIONAIS • Imagem: cinco tabelas de dados (também denominadas entidades) • Cada tabela tem vários campos de dados (colunas) • Cada registro (linha) tem um identificador, um código numérico ou alfanumérico que é geralmente atribuído como chave primária (PK) • Quando, por exemplo, o autor é referciado em outra tabela, como na author_document, a única informação necessária é o código ID do autor (PK) • Esses códigos ID combinando em várias tabelas vão representar as relações entre duas entidades (tabelas)
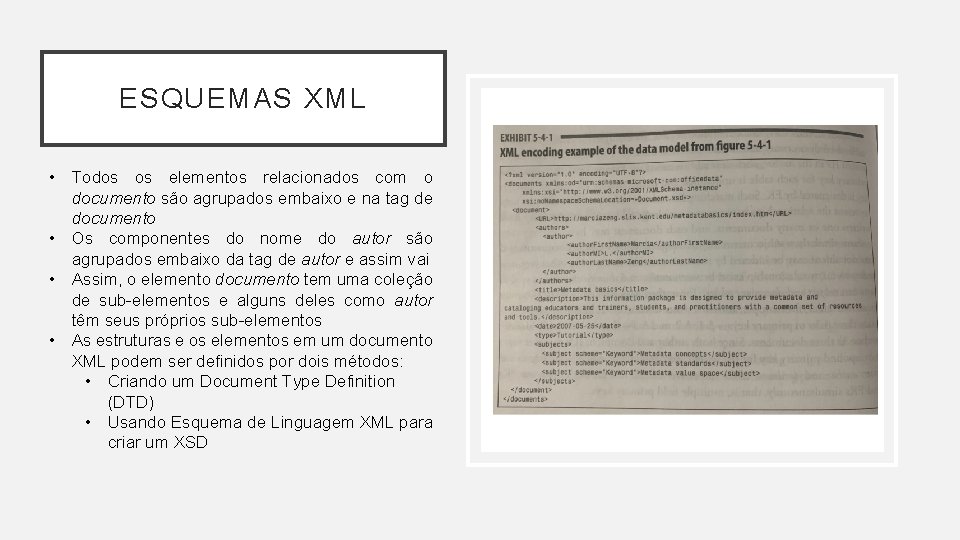
ESQUEMAS XML • Todos os elementos relacionados com o documento são agrupados embaixo e na tag de documento • Os componentes do nome do autor são agrupados embaixo da tag de autor e assim vai • Assim, o elemento documento tem uma coleção de sub-elementos e alguns deles como autor têm seus próprios sub-elementos • As estruturas e os elementos em um documento XML podem ser definidos por dois métodos: • Criando um Document Type Definition (DTD) • Usando Esquema de Linguagem XML para criar um XSD
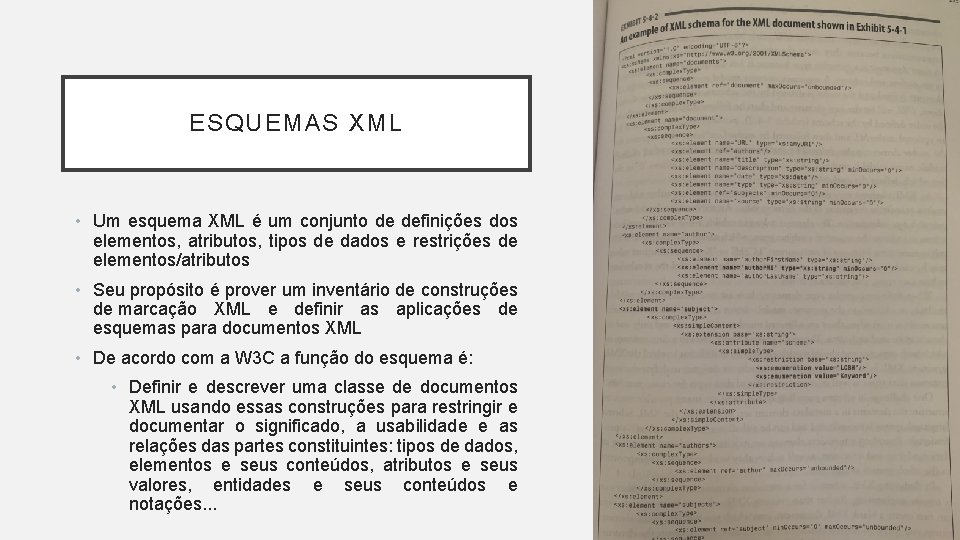
ESQUEMAS XML • Um esquema XML é um conjunto de definições dos elementos, atributos, tipos de dados e restrições de elementos/atributos • Seu propósito é prover um inventário de construções de marcação XML e definir as aplicações de esquemas para documentos XML • De acordo com a W 3 C a função do esquema é: • Definir e descrever uma classe de documentos XML usando essas construções para restringir e documentar o significado, a usabilidade e as relações das partes constituintes: tipos de dados, elementos e seus conteúdos, atributos e seus valores, entidades e seus conteúdos e notações. . .
ESQUEMAS XML • O Esquema XML faz distinção entre elementos do tipo simples e complexos: • Simples: não têm sub-elementos ou atributos. Pode ter apenas um valor de qualquer tipo: elementos URL, título, descrição, data e fonte • Complexo: têm uma sequência de sub-elementos e atributos. Exemplo: documento • Um modelo de sequência de conteúdo significa que a ordem dos elementos é fixa e a ordem é definida pelo esquema • Um Esquema XML pode conter um ou mais atributos que adicionam restrições ou indicam a natureza do valor do elemento • Um atributo é um par “nome-valor” • Permite que o designer do esquema defina os tipos de dados mais comuns e crie tipos de dados definidos pelo usuário para fins de reuso
ESQUEMAS XML • Um desafio na codificação de esquema é que existem muitas maneiras possíveis de se estruturar os elementos em um conjunto de elementos de metadados • Além disso, a sintaxe da linguagem XML é complicada e pode ser um desafio até mesmo para profissionais com experiência • Codificar um conjunto de elementos de metadados requer uma boa compreensão de modelagem de dados, além de como eles funcionam com outros componentes em toda a arquitetura do sistema • Ao projetar esquemas XML para um conjunto de elementos de metadados, uma forma de cortar caminho é a engenharia reversa: • Em vez de criar esquemas XML do zero, você pode primeiro criar um documento XML em branco, no qual você irá inserir a especificação do elemento e irá estruturar os nomes dos elementos que você especificou • Quando terminar, você pode usar um software de edição XML, como o o. Xygen XML Editor para gerar automaticamente o esquema • O conjunto de elementos também pode ser expresso em uma ontologia usando Web Ontology Language (OWL) • Outra alternativa é expressar usando RDF
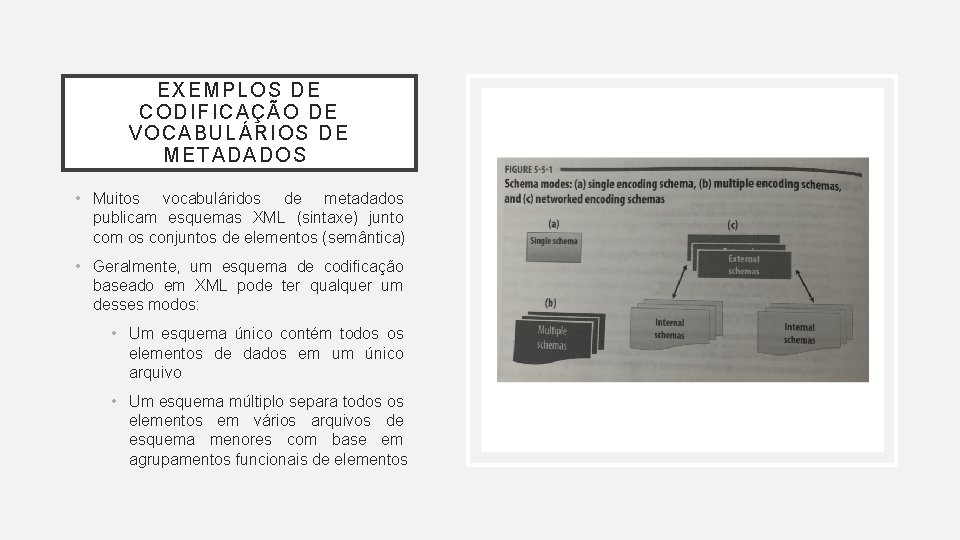
EXEM PLOS DE CO DIF ICAÇÃO DE VO CABULÁRIOS DE M ETADADOS • Muitos vocabuláridos de metadados publicam esquemas XML (sintaxe) junto com os conjuntos de elementos (semântica) • Geralmente, um esquema de codificação baseado em XML pode ter qualquer um desses modos: • Um esquema único contém todos os elementos de dados em um único arquivo • Um esquema múltiplo separa todos os elementos em vários arquivos de esquema menores com base em agrupamentos funcionais de elementos
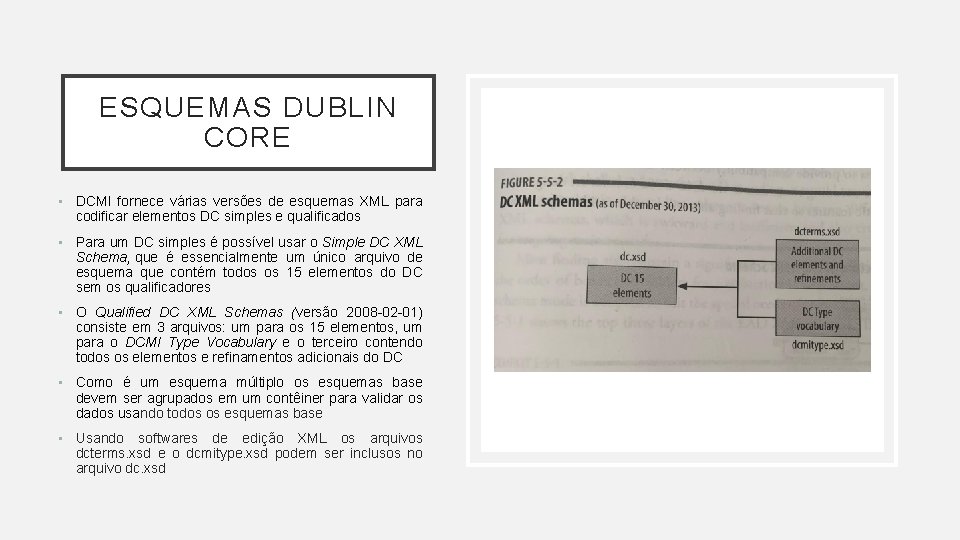
ESQUEMAS DUBLIN CORE • DCMI fornece várias versões de esquemas XML para codificar elementos DC simples e qualificados • Para um DC simples é possível usar o Simple DC XML Schema, que é essencialmente um único arquivo de esquema que contém todos os 15 elementos do DC sem os qualificadores • O Qualified DC XML Schemas (versão 2008 -02 -01) consiste em 3 arquivos: um para os 15 elementos, um para o DCMI Type Vocabulary e o terceiro contendo todos os elementos e refinamentos adicionais do DC • Como é um esquema múltiplo os esquemas base devem ser agrupados em um contêiner para validar os dados usando todos os esquemas base • Usando softwares de edição XML os arquivos dcterms. xsd e o dcmitype. xsd podem ser inclusos no arquivo dc. xsd
CONCLUSÕES • Sintaxe de codificação é uma área fluída nos esquemas de metadados • Há mais de uma forma de codificar um conjunto de elementos de metadados • Mesmo que uma autoridade do padrão de metadados recomende um ou mais esquemas para a codificação, na prática eles são raramente utilizados exatamente como definidos, porque raramente são aplicados sem modificações • Qualquer modificação local resulta em mudanças no padrão e isso modifica o esquema de codificação recomendado pela autoridade do padrão • Problemas de sintaxe na codificação podem comprometer a qualidade dos serviços de metadados • Outro problema na sintaxe é qual modo de esquema de codificação XML é melhor para um formato (não existe um perfeito para aplicar em todas as situações) • Geralmente esquemas de codificação modular (DSLESE) que mantém os elementos em um esquema e os valores de vocabulário em outro são mais flexíveis para reuso e expansão já que adicionar esquemas externos não afeta a estrutura de codificação de metadados ou outras partes da sintaxe • A codificação de esquema de metadados cria as construções para o conteúdo de metadados processável por computador para garantir a consistência, precisão e integridade na criação da descrição de metadados