1 La recherche centre utilisateur IHM 2 valuation
- Slides: 38
1 La recherche ‘centrée utilisateur’ – IHM 2 Évaluation du cours : contrôle finale et TP RV (rapport). Vous trouverez les supports du cours à : http: //peter. banton. perso. esil. univmed. fr/Intranet. Esil/ 1
1 La recherche ‘centrée utilisateur’ – IHM 2 Cours IHM 1 • des aspects accessibles de l’IHM basés sur l’expérimentation - bonnes pratiques pour les pages Web - le testing centré utilisateur Cours IHM 2 • fil directeur – l’expérimentation appliquée à l’IHM • cours en deux volets : -1. la démarche scientifique -2. la loi de Fitts et RV 4
1 La recherche ‘centrée utilisateur’ – IHM 2 Nous avons vu l’an dernier que le processus du design ‘centrée utilisateur’ nécessite des retours des utilisateurs pendant ce même processus : 1. l’identification des besoins et des critères des utilisateurs, 2. le développement des produits différents qui remplissent ces besoins/critères, 3. la fabrication/création des versions interactives pour les tester, 4. l’évaluation de ce qui a été créé pendant ce processus. Nous avons vu une première étape : le prototypage papier et/ou le card sorting. With a paper prototype, you can user test early design ideas at an extremely low cost. Doing so lets you fix usability problems before you waste money implementing something that doesn't work (Jakob Nielsen's Alertbox, April 14, 2003). http: //www. useit. com/alertbox/20030414. html Cette année on va aller un peu plus loin. 5
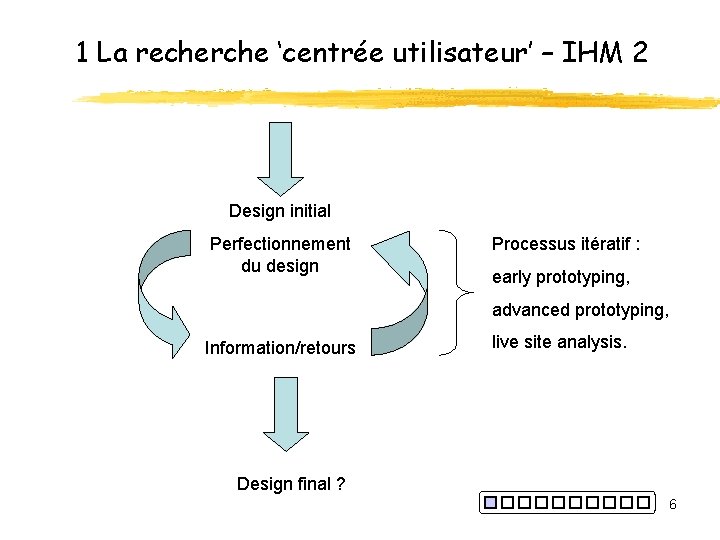
1 La recherche ‘centrée utilisateur’ – IHM 2 Design initial Perfectionnement du design Processus itératif : early prototyping, advanced prototyping, Information/retours live site analysis. Design final ? 6
1 La recherche ‘centrée utilisateur’ – IHM 2 A quoi sert l’information? – prendre les décisions (qu’elles soient ‘data-driven’ et non pas prises au feeling). Où/comment trouver de l’information? - Internet, expériences scientifiques, user testing, sondages, questionnaires… Question pertinente Comment savoir si ces informations sont de bonnes qualités? 7
1 La recherche ‘centrée utilisateur’ – IHM 2 Vous allez apprendre davantage sur le user testing et comment mieux évaluer d’autres informations comme les sondages, les études, etc. Exemple : sondage sur l’utilisation des scanners à l’école en Angleterre suite au cas d’un élève poignardé. Sondage : Pensez-vous que les scanners devraient être introduits aux écoles Anglaises? Résultats: oui – 85%; non – 15% Qu’est-ce qu’on peut tirer des ces résultats? 8
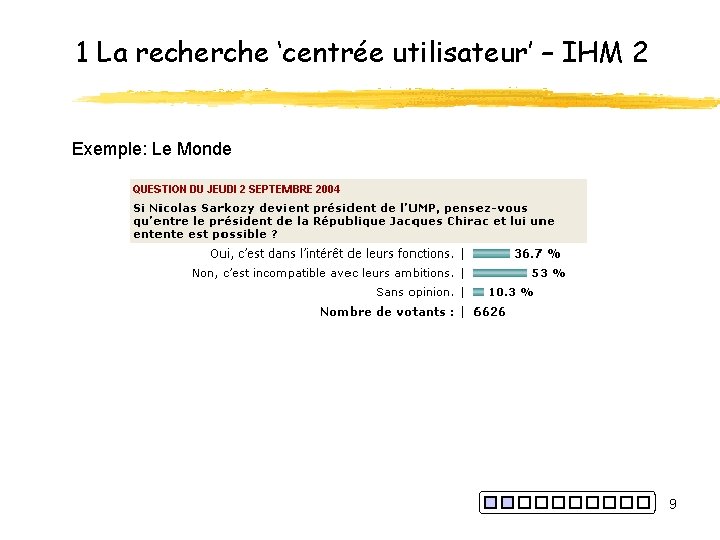
1 La recherche ‘centrée utilisateur’ – IHM 2 Exemple: Le Monde 9
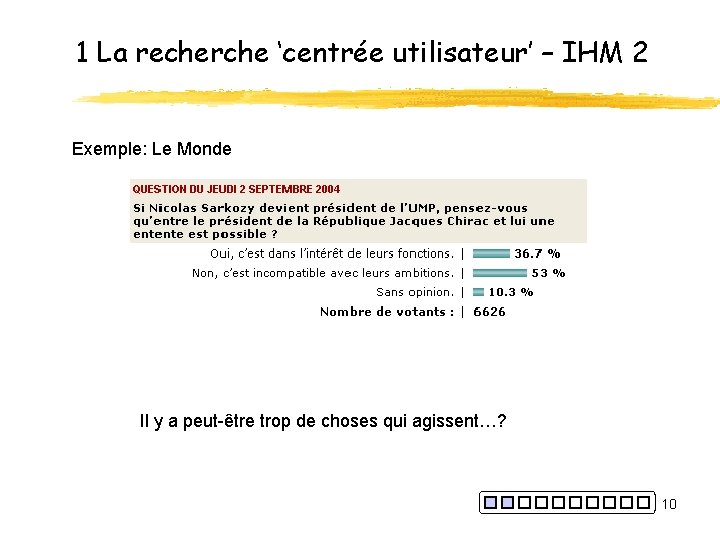
1 La recherche ‘centrée utilisateur’ – IHM 2 Exemple: Le Monde Il y a peut-être trop de choses qui agissent…? 10
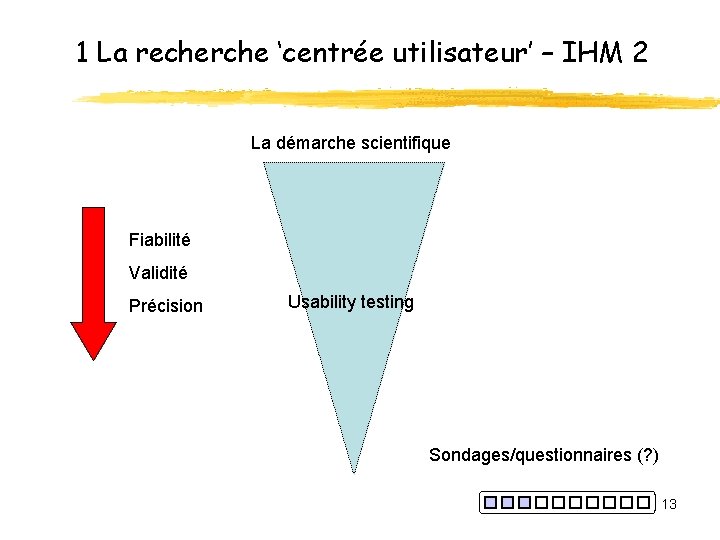
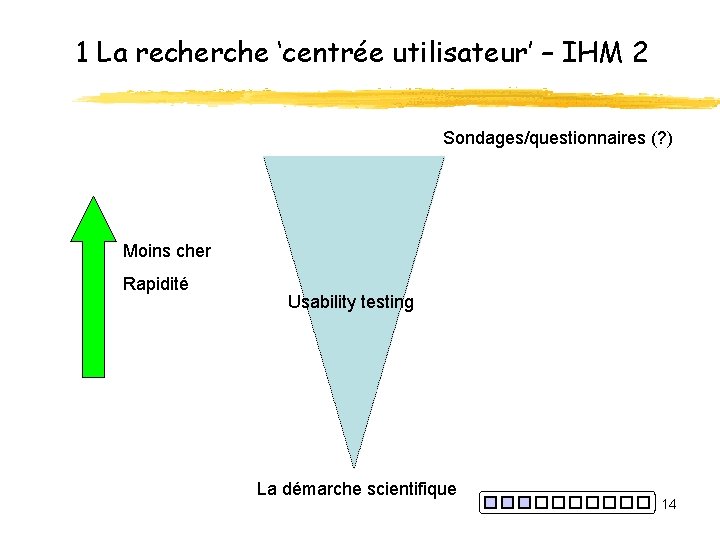
1 La recherche ‘centrée utilisateur’ – IHM 2 Généralement, les sondages/questionnaires sont très difficiles de construire de façon correcte; nous allons voir plus tard davantage làdessus. Y a-t-il des moyens plus facile pour acquérir de l’information? Réponse : oui, mais on n’a rien pour rien. Réfléchissons un peu sur ce que l’on veut en termes d’information. - fiable - valide - précise (correcte, exacte) - utile - rapide ? - pas cher ? Est-ce que tous ces souhaits sont compatibles? 11
1 La recherche ‘centrée utilisateur’ – IHM 2 Dans ce cours, nous allons considérer deux moyens d’acquérir de l’information : - la démarche scientifique (la méthodologie de la recherche), - les sondages/questionnaires (si nous aurons le temps). 12
1 La recherche ‘centrée utilisateur’ – IHM 2 La démarche scientifique Fiabilité Validité Précision Usability testing Sondages/questionnaires (? ) 13
1 La recherche ‘centrée utilisateur’ – IHM 2 Sondages/questionnaires (? ) Moins cher Rapidité Usability testing La démarche scientifique 14
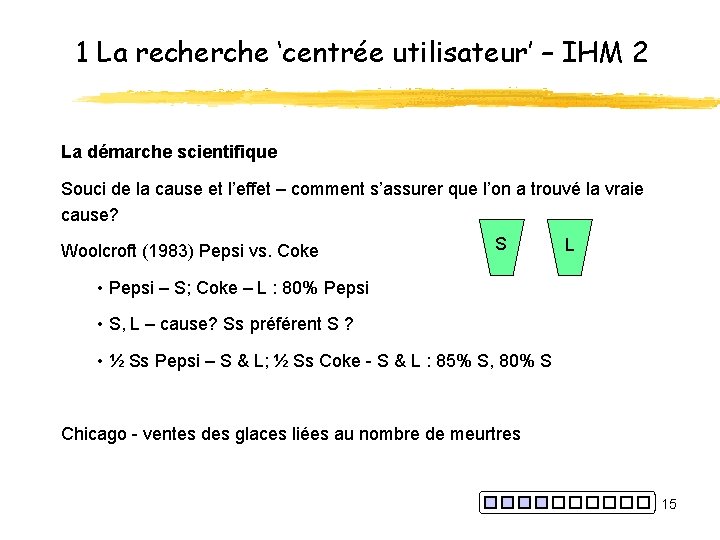
1 La recherche ‘centrée utilisateur’ – IHM 2 La démarche scientifique Souci de la cause et l’effet – comment s’assurer que l’on a trouvé la vraie cause? Woolcroft (1983) Pepsi vs. Coke S L • Pepsi – S; Coke – L : 80% Pepsi • S, L – cause? Ss préférent S ? • ½ Ss Pepsi – S & L; ½ Ss Coke - S & L : 85% S, 80% S Chicago - ventes des glaces liées au nombre de meurtres 15
1 La recherche ‘centrée utilisateur’ – IHM 2 Rappel des points clés Fiabilité Validité Cause et effet 16
2 La méthodologie de la recherche 2. 1 Les concepts de base 2. 2 Les statistiques descriptives 2. 3 La distribution normale 2. 4 L’inférence statistique 17
2. 1 Les concepts de base Pour mieux comprendre les failles, réelles et potentielles, d’une méthode de recherche quelconque, il faut des connaissances sur la démarche scientifique, d’où viennent les autres méthodes (user testing, sondages/questionnaires). La méthodologie de la recherche tourne autour de l’expérimentation. C’est une méthodologie qui nous permet de acquérir de l’information (les données) par rapport à une question (la question expérimentale). De plus, elle nous permet de nous assurer, avec une marge d’erreur précise, de la bonne qualité des ces informations. Avantages : - logique, fiable, valide. Inconvénients : - difficile (statistiques), longue, coûteuse. 18
2. 1 Les concepts de base Un peu d’histoire - Clever Hans (le début de la démarche scientifique) Cheval connu comme ‘Clever Hans’ - William von Osten Montré au publique entre 1891 et 1904 - plus qu’une dizaine de scientifiques l’ont vu et en étaient convaincu. Oskar Pfungst, en 1904, découvrit : Hans was responding to a simple, involuntary postural adjustment by the questioner, which was his cue to start tapping, and an unconscious, almost imperceptible head movement, which was his cue to stop" (Hyman 1989: 425) 19
2. 1 Les concepts de base Logique : processus du testing d’hypothèses Tous les cygnes sont blancs… Fiable : les résultats sont reproductibles et constants (avec une marge d’erreur précise) Valide : l’expérience fait ce que l’on suppose qu’elle fait; les résultats montrent ce que l’on suppose qu’ils montrent; donc généralisable 20
2. 1 Les concepts de base Considérons l’exemple d’une expérience ou l’on compare deux choses: pages Web avant et après amélioration, voiture de préférence, Pepsi vs. Coke, etc. D’abord, il nous faut une question à laquelle répondre… Question expérimentale : est-ce que la version 1 d’un site Web est mieux que la version 2 ? • formulation précise • celle-ci, est-elle bonne ? Population/échantillon ? 21
2. 1 Les concepts de base Quelques définitions Population: population mère; la collection entière des sujets/événements dont on s’intéresse et à laquelle on veut généraliser les résultats (les notes des étudiants, les salaires des gens, les opinions des opérateurs, etc. ). Peut être soit petite, soit grande, soit infinie. Il est rarement possible d’évaluer toute une population, alors nous prenons un échantillon. Echantillon: une partie d’une population sélectionnée pour l’expérience. Les tests statistiques d’inférence vont nous permettre de généraliser de nos résultats de l’échantillon à la population mère. 22
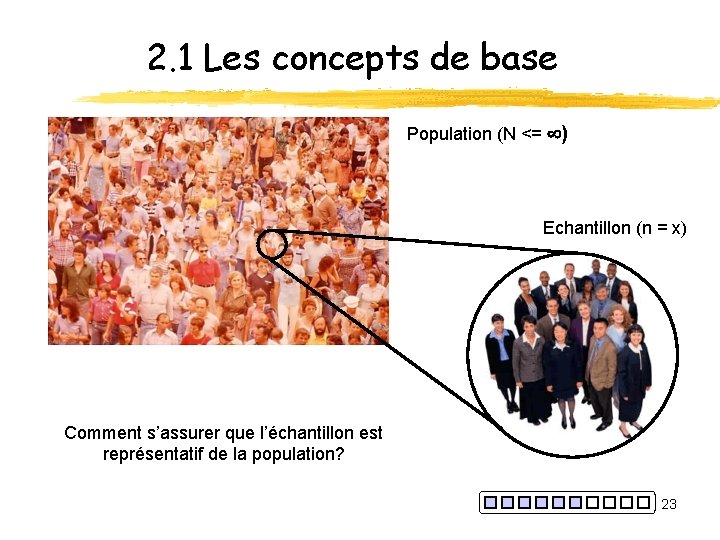
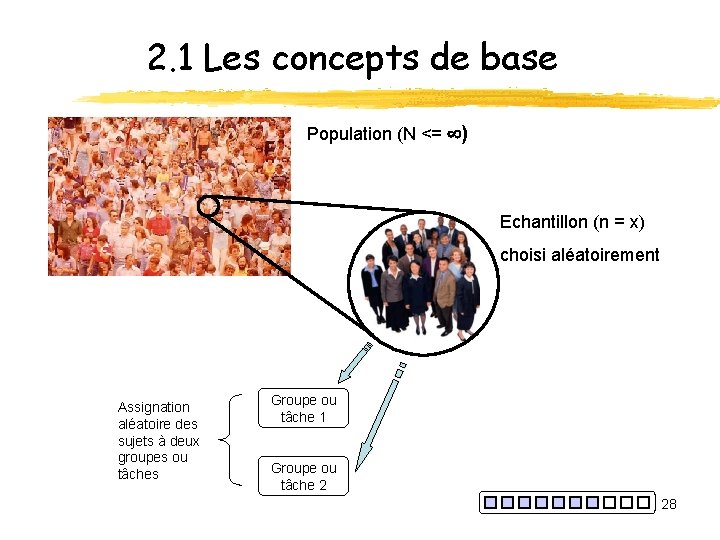
2. 1 Les concepts de base Population (N <= ) Echantillon (n = x) Comment s’assurer que l’échantillon est représentatif de la population? 23
2. 1 Les concepts de base Effet de la taille de l’échantillon Quel pourcentage de filles y a-t-il dans l’ESIL ? Si nous prenions comme échantillon : - une promo Info ? - une promo Biotech ? - les deux ? Plus généralement… 24
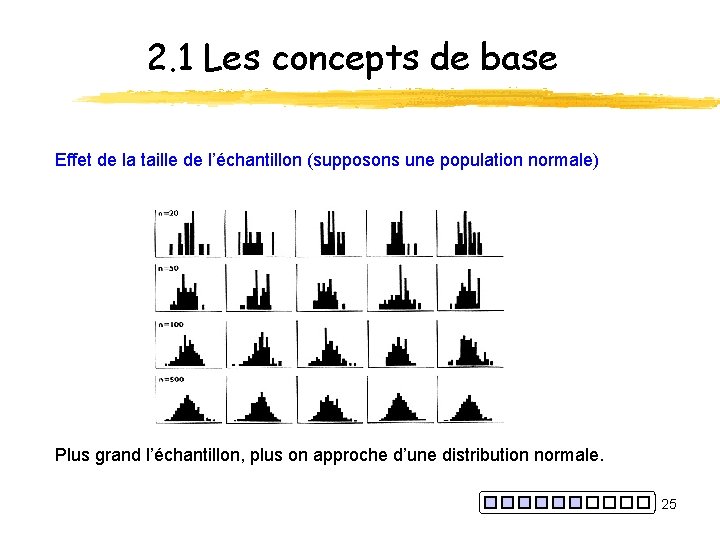
2. 1 Les concepts de base Effet de la taille de l’échantillon (supposons une population normale) Plus grand l’échantillon, plus on approche d’une distribution normale. 25
2. 1 Les concepts de base Plus grand l’échantillon, plus il représente la population mère. Mais nous sommes (déjà) contraints au niveau de la taille de l’échantillon et il y a toujours de la variation (variance) entre des échantillons différents. Les statistiques viennent au secours; elles prennent en compte ces deux contraintes (tout en gardant une marge d’erreur précise) sous condition que la sélection de l’échantillon soit faite de façon aléatoire. 26
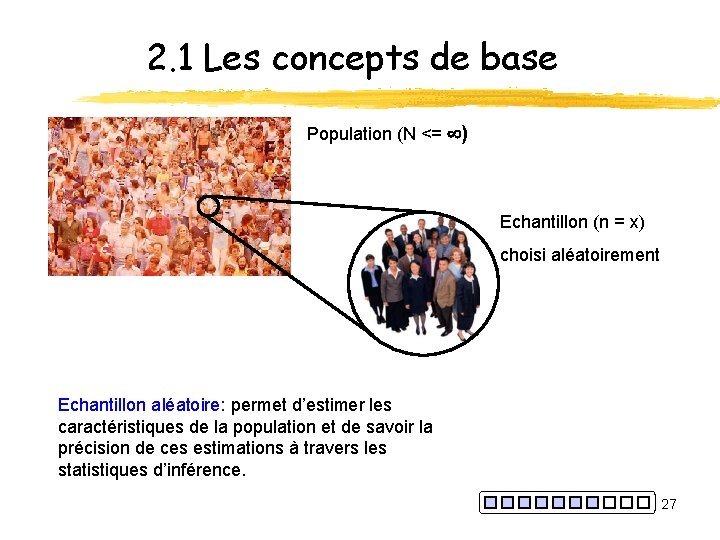
2. 1 Les concepts de base Population (N <= ) Echantillon (n = x) choisi aléatoirement Echantillon aléatoire: permet d’estimer les caractéristiques de la population et de savoir la précision de ces estimations à travers les statistiques d’inférence. 27
2. 1 Les concepts de base Population (N <= ) Echantillon (n = x) choisi aléatoirement Assignation aléatoire des sujets à deux groupes ou tâches Groupe ou tâche 1 Groupe ou tâche 2 28
2. 1 Les concepts de base L’assignation aléatoire: ex: on assigne la moitié des sujets au premier groupe et l’autre moitié au deuxième groupe (les deux moitiés choisis de façon aléatoire). Revenons au sujet de la validité de l’expérience. La validité externe: dépend en partie de si notre échantillon a vraiment été sélectionné aléatoirement. Est-ce que cet échantillon est vraiment représentatif de la population mère? Est-ce que nos résultats peuvent être généralisés à la population? La validité interne: alors que la sélection aléatoire de nos sujets porte sur la généralisation de nos résultats, l’assignation aléatoire des sujets aux groupes expérimentaux porte sur l’intégrité, ou validité interne, de notre étude. Est-ce que l'étude teste/mesure/étudie vraiment ce qu'elle était censée étudier/tester/mesurer? 29
2. 1 Les concepts de base Les conditions expérimentales : (définition temporaire) ce que l’on demande aux sujets de faire. A noter : les conditions expérimentales ne sont pas les conditions environnementales (la température, le niveau de bruit, etc. dans la pièce, le temps, etc. ). Exemple : notre expérience pour comparaître l’ancienne et la nouvelle version d’un site Web. Condition expérimentale 1 : une tâche quelconque sur l’ancienne version. Condition expérimentale 2 : la même tâche sur la nouvelle version. 30
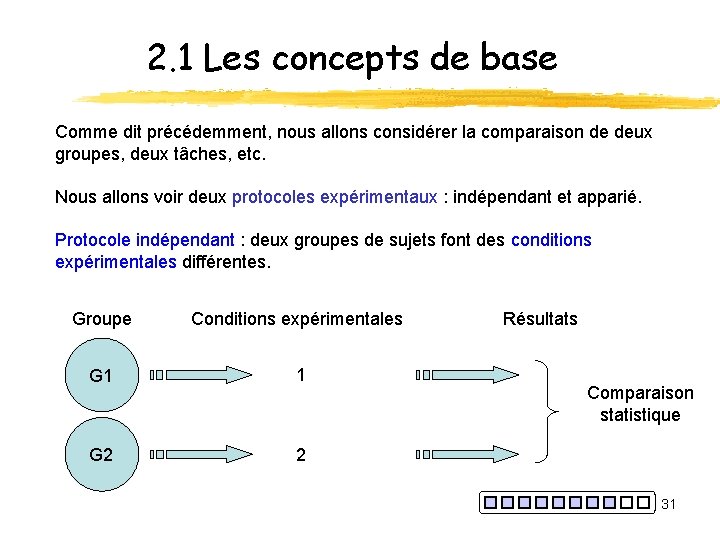
2. 1 Les concepts de base Comme dit précédemment, nous allons considérer la comparaison de deux groupes, deux tâches, etc. Nous allons voir deux protocoles expérimentaux : indépendant et apparié. Protocole indépendant : deux groupes de sujets font des conditions expérimentales différentes. Groupe Conditions expérimentales G 1 1 G 2 2 Résultats Comparaison statistique 31
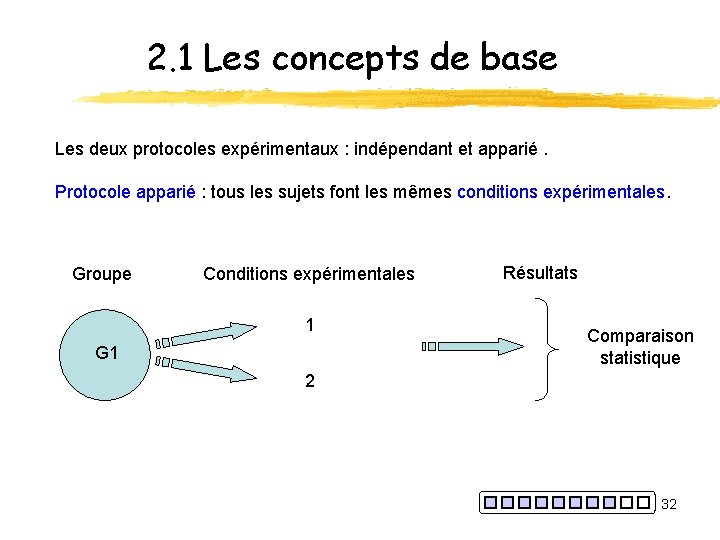
2. 1 Les concepts de base Les deux protocoles expérimentaux : indépendant et apparié. Protocole apparié : tous les sujets font les mêmes conditions expérimentales. Groupe Conditions expérimentales 1 G 1 Résultats Comparaison statistique 2 32
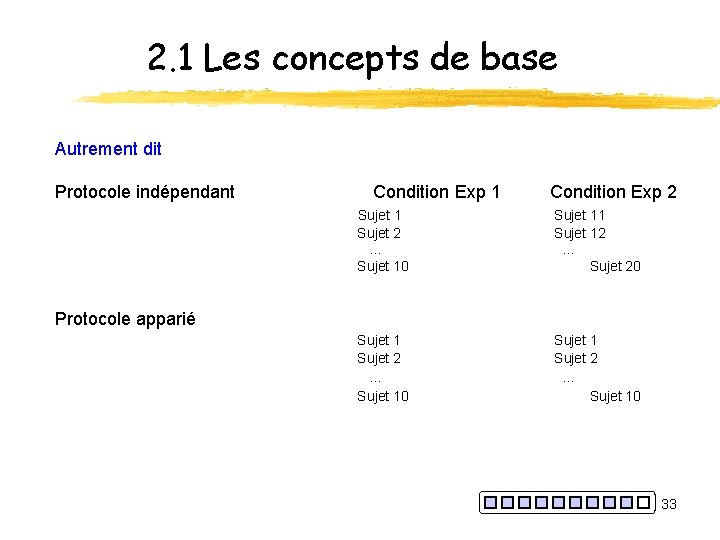
2. 1 Les concepts de base Autrement dit Protocole indépendant Condition Exp 1 Condition Exp 2 Sujet 1 Sujet 2 … Sujet 10 Sujet 11 Sujet 12 … Sujet 20 Sujet 1 Sujet 2 … Sujet 10 Protocole apparié 33
2. 1 Les concepts de base Avantages et inconvénients Protocole indépendant Avantages : aucun effet d’ordre des conditions expérimentales. Inconvénients : il nous faut deux fois le nombre de sujets. Solution : trouver davantage de sujets 34
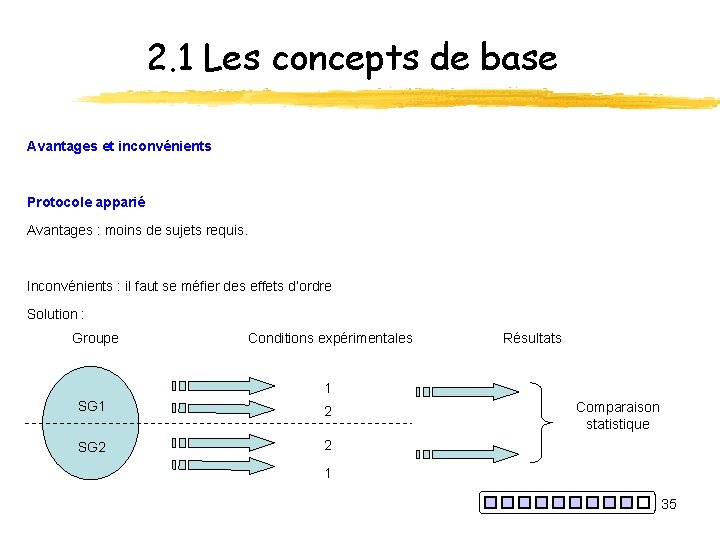
2. 1 Les concepts de base Avantages et inconvénients Protocole apparié Avantages : moins de sujets requis. Inconvénients : il faut se méfier des effets d’ordre Solution : Groupe Conditions expérimentales Résultats 1 SG 1 2 SG 2 2 Comparaison statistique 1 35
2. 1 Les concepts de base Pour être sûr que notre expérience est valide, fiable, etc. nous allons essayer de manipuler qu’une variable, en tenant toute autre variable constante, pour voir son effet. Une variable: c’est une propriété d’un objet ou d’un événement qui peut prendre des valeurs différentes. Ex: couleur des cheveux: rouge, noir, blonde… Ici, peut-être, performance sur la tâche 1 et/ou la tâche 2… Variables discrètes ou continues: une variable discrète ne peut prendre que certaines valeurs, une variable continue peut prendre toute valeur dans l’échelle utilisée (les chiffres entiers versus les chiffres réels). La variable indépendante: celle manipulée par l’expérimentateur. Ex : groupe de traitement (condition expérimentale). La/les variable(s) dépendante(s): les données. Score sur un test de précision, taux de réussite, temps pour compléter une tâche… Les variables parasites: les choses non contrôlées qui peuvent avoir un effet sur la/les variables dépendantes : température ambiante, bruit, humeur du sujet, etc. 36
2. 1 Les concepts de base On peut désormais définir les conditions expérimentales plus précisément : Les conditions expérimentales sont les niveaux de la variable indépendante. Exemple : pour notre expérience de site Web, si nous décidons de comparer les deux versions du site en mesurant la vitesse d’accomplir une tâche (trouver un lien, commander un article, etc. ), la variable indépendante serait la version du site et les conditions expérimentales seraient au nombre de deux : ancienne et nouvelle. 37
2. 1 Les concepts de base Données quantitatives: des mesures. Scores sur un test, les poids des sujets, etc. Données qualitatives ou catégoriques: « 15 sujets était grand, 10 moyen et 12 était petit. » « 14 sujets était classifiés comme ‘très anxieux’, 33 comme ‘moyenne’ et 12 comme ‘peu anxieux’. » Ici on catégorise les traits et les données sont les fréquences pour chaque catégorie. Nous pourrions avoir plusieurs centaines de sujets mais les données ne seraient que trois numéros. En revanche, si on avait testé chaque sujet sur une échelle (plus ou moins continue) d’anxiété, les données seraient les scores pour chaque sujet et donc les données quantitatives. 38