Structures physiques Witold Litwin http ceria dauphine frwitold
- Slides: 40
Structures physiques Witold Litwin http: //ceria. dauphine. fr/witold. html 1
Schéma interne Définit les chemins d'accès aux données n En général dans l'hypothèse que la BD est n – grande – sur le disque n Problèmes – Allocation d'espace disque – Accès direct aux enregistrement – Tampons RAM 2
Livres de Support n n Voir le cours introductif (Cours 1) De plus – Garcia-Molina, H. Ullman, J. Widom J. Database System Implementation. Prentice Hall, 1999 » Description de LH » Jointure bi-passes et multi-passes » Optimisation de requêtes à base de coût 3
Principes typiques n Espace disque est paginé en pages de 4 -8 KO – Appelés aussi blocs n n Une page est une unité de transfert entre disque et RAM Les pages sont structurées en fichiers – – 4 séquentiels ou directs ou non-ordonnés hachés Arbres B autres
n Les indexes sont des fichiers qui contiennent les paires attribut(s) d'accès -> numéro de page n les indexes peuvent être – séquentiels ou directs ou non-ordonnés – hachés – arbres B – autres 5
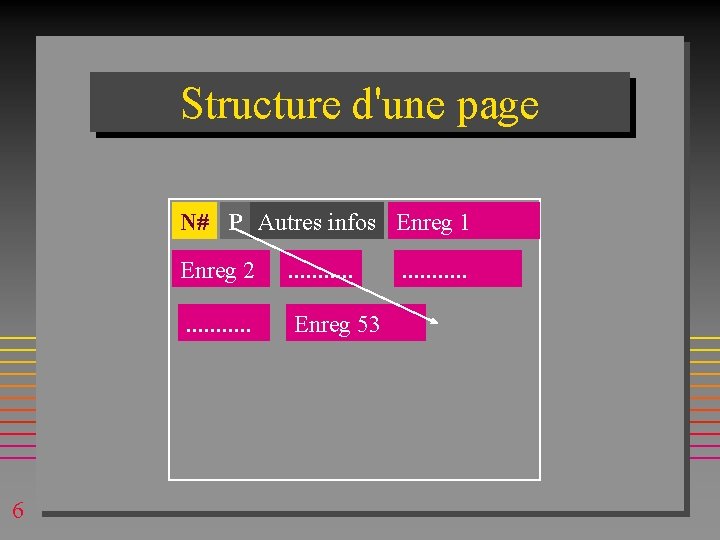
Structure d'une page N# P Autres infos Enreg 1 6 Enreg 2 . . Enreg 53 . . .
Utilisation d'indexes n n n 7 S’il n'y a pas de chemin d'accès au fichier par la valeur d'attribut, alors il faut faire une longue recherche séquentielle Un index crée le chemin d'accès aux pages pertinentes On peut en avoir autant d'indexes que l'on veut Avantage pour les recherches Désavantage pour les MAJ, car il faut aussi mettre à jour les indexes
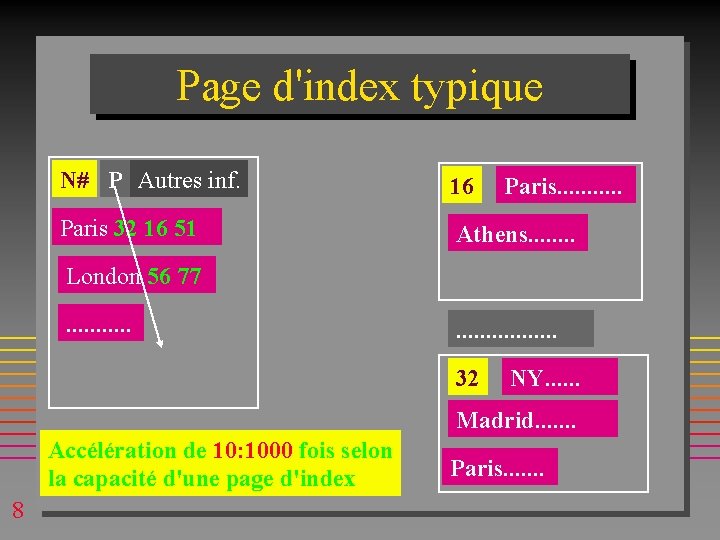
Page d'index typique N# P Autres inf. 16 Paris 32 16 51 Athens. . . . Paris. . . London 56 77. . . . 32 NY. . . Madrid. . . . Accélération de 10: 1000 fois selon la capacité d'une page d'index 8 Paris. . . .
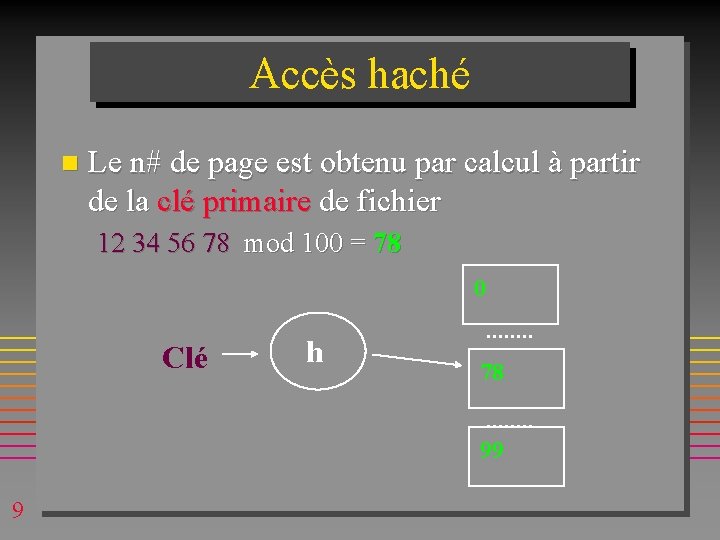
Accès haché n Le n# de page est obtenu par calcul à partir de la clé primaire de fichier 12 34 56 78 mod 100 = 78 0 Clé h . . . . 78. . . . 99 9
Hachage n n Il existe de nombreuses fonctions de hachage Il existe deux types de hachage – statique (classique) – virtuel (espace d'adressage peut grandir avec les insertions) » hachage dynamique (Larson) » hachage extensible (Fagin & al) » hachage linéaire (Litwin) – Implémenté dans nombreux produits – IIS, Frontpage, Ms. Exchange, Netscape, Unify, LH Server… n Le fichier haché n'est pas ordonné – pas de requêtes à intervalle 10
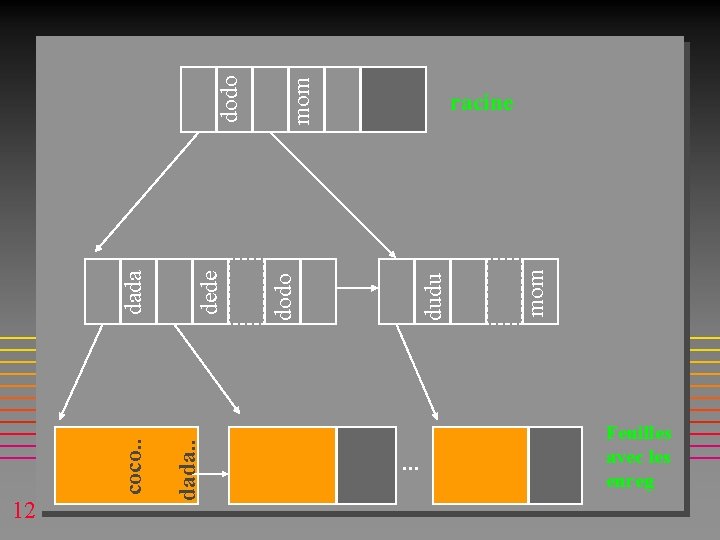
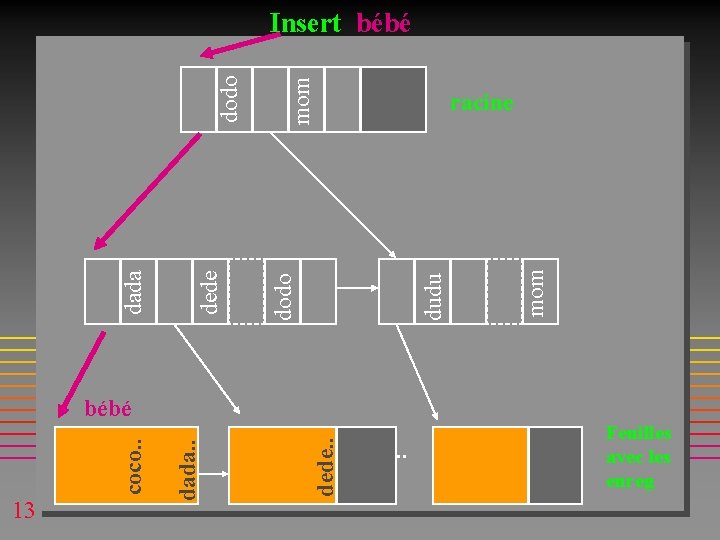
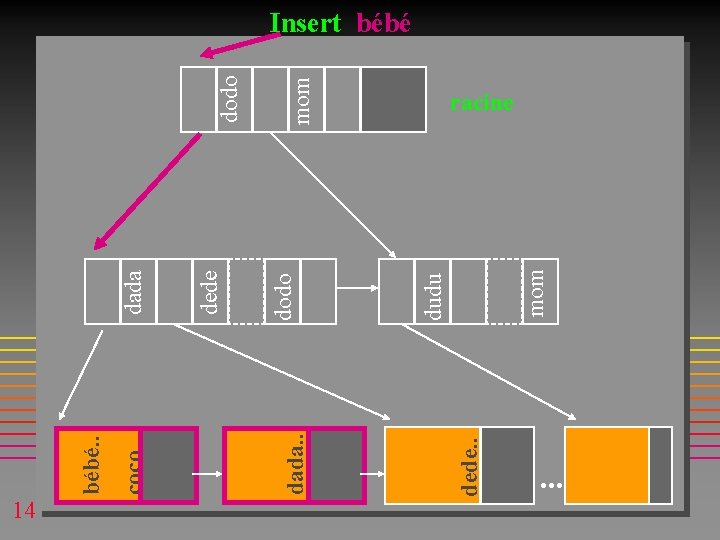
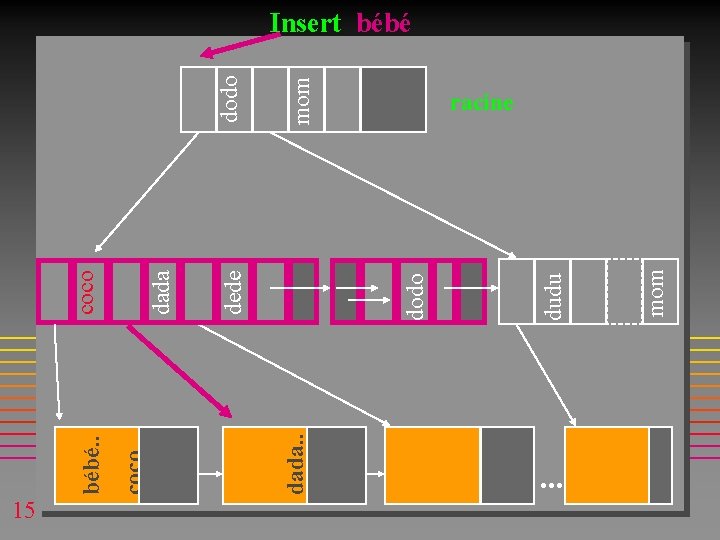
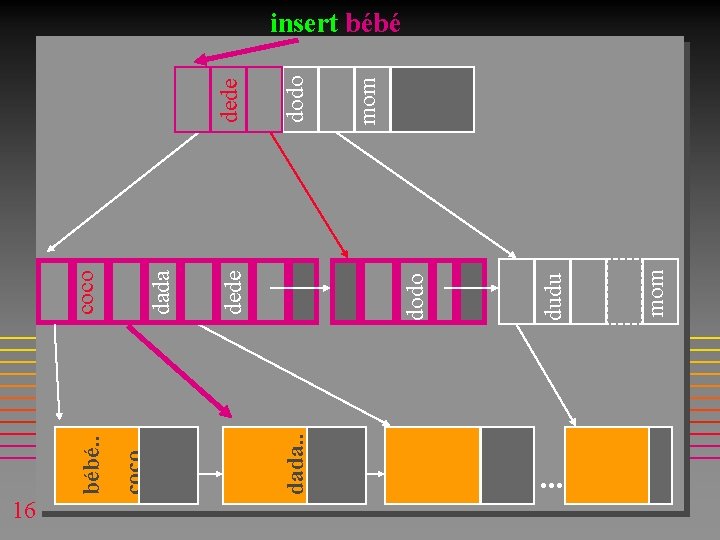
Fichiers ordonnés n Arbre-B est le plus populaire (tout SGBD) – En fait l’arbre B+ lié (linked B+ - tree de Lehma & Yao) » Pour le parcours séquentiel et l’accès concurrent + efficace – Loquets individuels sur chaque page parcourue n Une page contient d>>1 paires en ordre lexicographique de clés – clé - enreg. – ou clé-pointeur de page avec l'enreg. n n 11 Une page qui devient pleine éclate en deux pages semipleines La clé d'éclatement est dupliquée dans la page de niveau supérieur avec les pointeurs vers les nouvelles pages
coco. . dada. . 12. . . mom dudu dodo dede dada mom dodo racine Feuilles avec les enreg
mom dudu racine dodo dede dada dodo Insert bébé dede. . 13 dada. . coco. . bébé. . . Feuilles avec les enreg
dede. . dada. . 14 coco. . bébé. . mom dudu dodo dede dada mom dodo Insert bébé racine . . .
dada. . 15 coco. . bébé. . . . mom dudu dodo dede dada coco mom dodo Insert bébé racine
dada. . 16 coco. . bébé. . . . mom dudu dodo dede dada coco mom dodo dede insert bébé
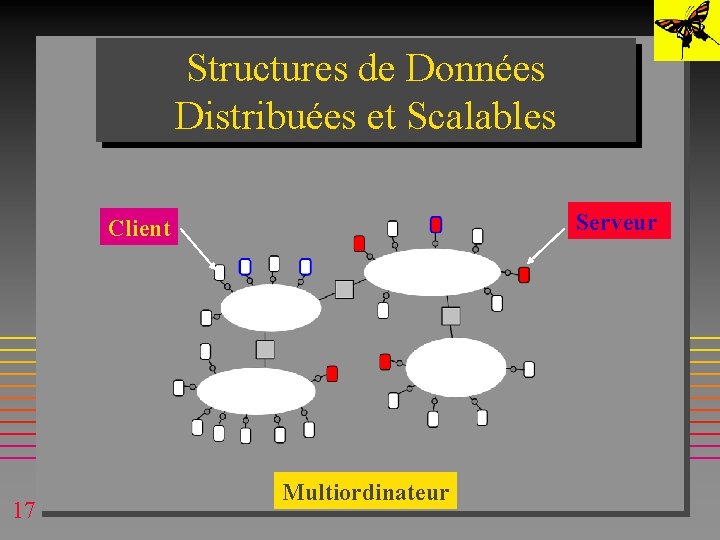
Structures de Données Distribuées et Scalables Serveur Client 17 Multiordinateur
Opérations relationnelles n Restrictions A = 'C' – sur attribut-clé du fichier - + rapides avec hachage – sur autres attributs - rech. seq. ou par indexe n Restrictions à intervalle – sur attribut-clé ou pas - + rapide avec les arbres-B n Projections – recherche séquentielle (peut être plus efficace avec le hachage) – pourquoi ? 18
Jointures n Equijointures + rapides avec le hachage – comment faire ? n - jointures: technique générale – Boucles imbriquées – Tri-interclassement (sort-merge) – Index – Hash » Linear Hash 19
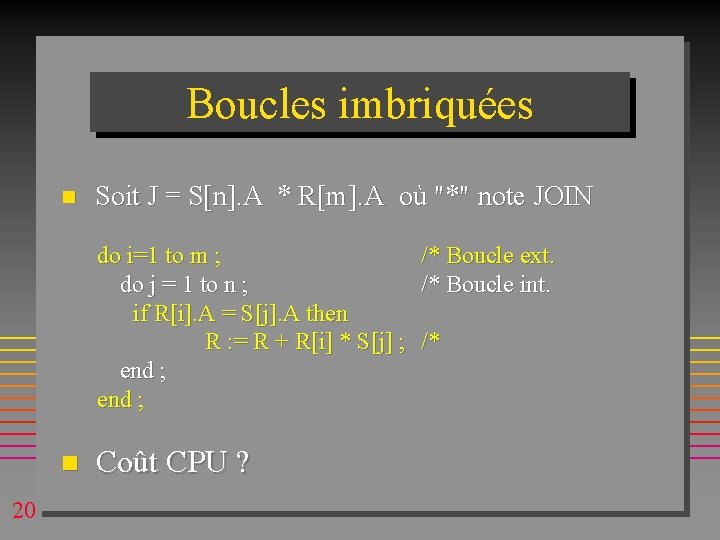
Boucles imbriquées n Soit J = S[n]. A * R[m]. A où "*" note JOIN do i=1 to m ; do j = 1 to n ; if R[i]. A = S[j]. A then R : = R + R[i] * S[j] ; end ; n 20 Coût CPU ? /* Boucle ext. /* Boucle int. /*
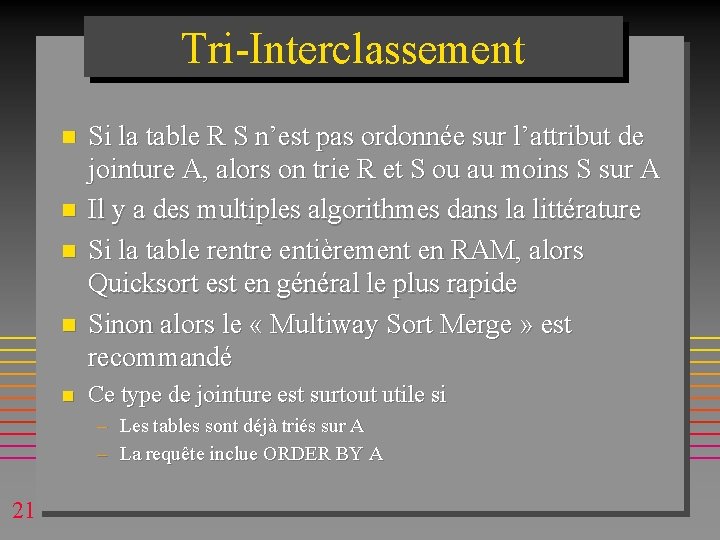
Tri-Interclassement n n n Si la table R S n’est pas ordonnée sur l’attribut de jointure A, alors on trie R et S ou au moins S sur A Il y a des multiples algorithmes dans la littérature Si la table rentre entièrement en RAM, alors Quicksort est en général le plus rapide Sinon alors le « Multiway Sort Merge » est recommandé Ce type de jointure est surtout utile si – Les tables sont déjà triés sur A – La requête inclue ORDER BY A 21
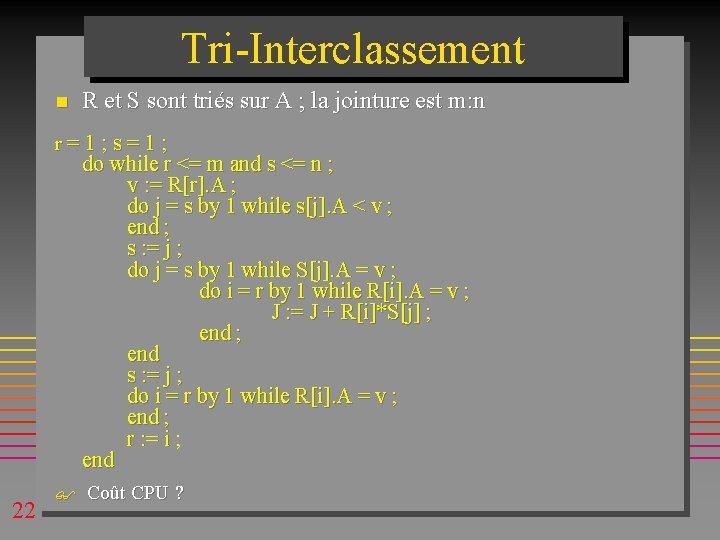
Tri-Interclassement n R et S sont triés sur A ; la jointure est m: n r = 1 ; s = 1 ; do while r <= m and s <= n ; v : = R[r]. A ; do j = s by 1 while s[j]. A < v ; end ; s : = j ; do j = s by 1 while S[j]. A = v ; do i = r by 1 while R[i]. A = v ; J : = J + R[i]*S[j] ; end s : = j ; do i = r by 1 while R[i]. A = v ; end ; r : = i ; end 22 $ Coût CPU ?
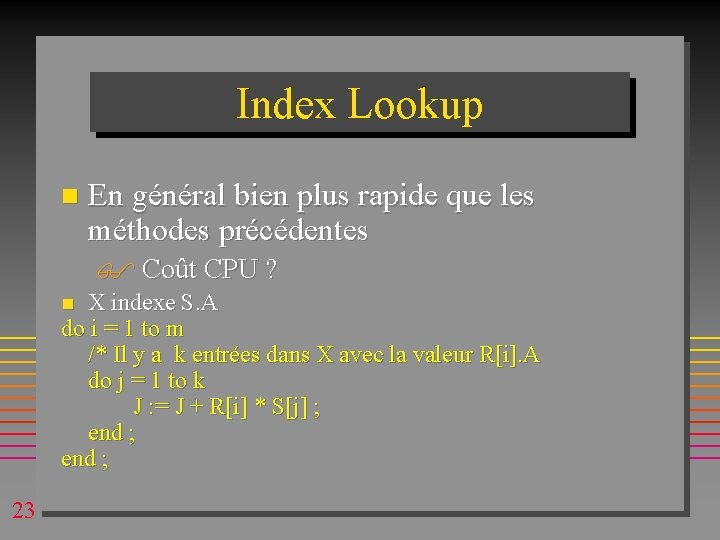
Index Lookup n En général bien plus rapide que les méthodes précédentes $ Coût CPU ? X indexe S. A do i = 1 to m /* Il y a k entrées dans X avec la valeur R[i]. A do j = 1 to k J : = J + R[i] * S[j] ; end ; n 23
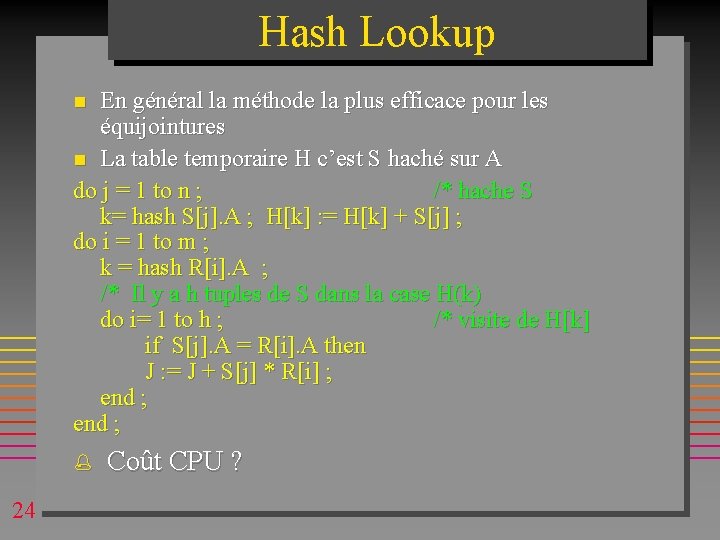
Hash Lookup En général la méthode la plus efficace pour les équijointures n La table temporaire H c’est S haché sur A do j = 1 to n ; /* hache S k= hash S[j]. A ; H[k] : = H[k] + S[j] ; do i = 1 to m ; k = hash R[i]. A ; /* Il y a h tuples de S dans la case H(k) do i= 1 to h ; /* visite de H[k] if S[j]. A = R[i]. A then J : = J + S[j] * R[i] ; end ; n % 24 Coût CPU ?
Linear Hash Lookup n La taille de la table S peut être inconnue – S peut être une table temporaire crée pendant l’évaluation d’une restriction » Mode pipeline n n Hachage statique est alors peu performant LH solutionne ce problème – Si H est en RAM, alors la variante LKRHash semble le plus efficace » Conçu par P. Larson & al (Microsoft) » Utilisée dans de nombreux produits MS n 25 LH est aussi préférable pour l’évaluation bi-passe ou multi-passe
Mode d'exécution d'une opération relationnelle n Matérialisation – La table résultante est créée pour l'opération suivante dans l'arbre d'exécution n Pipeline – – – On passe un tuple à la fois par l'arbre Moindre coût mémoire Pas toujours possible » ORDER BY, Hash Lookup… n 26 Mixte
Optimisation de requêtes n L'optimiseur assigne un coût à toute opération relationnelle de la requête – Typiquement: nombre de pages examinées – Surtout on examine les jointures » Le coût prévisible de chaque méthode possible n 27 – En général les indexes diminue les coûts – L'arbre algébrique d'exécution de la requête devient annoté Chaque arbre annoté devient un plan d'exécution
Optimisation de requêtes (Choix des arbres algébriques) n Pour générer des plans on examine – Les arbres gauches résultants des améliorations algébriques » Approche générale – Les arbres gauches et ramifiés » Surtout pour les BDs parallèles n L'espace des plans est en général très grand – Des milliers de plans pour déjà pour quelques relations à joindre 28
Optimisation de requêtes On choisi le plan minimisant le coût total – System R (IBM) n n Surtout, il faut choisir l'ordre des jointures On examine – Tout plan possible » Programmation dynamique – Meilleur coût de tout (R 1 JOIN R 2) – Sur cette base, meilleur coût de tout (R 1 JOIN R 2) JOIN R 3 – etc » Programmation dynamique à la "Selinger" – On peut conserver un coût non optimal s'il permet optimiser une opération plus tard – Jointure par tri-interclassement suivie par ORDER BY 29
Optimisation de requêtes n On examine par une heuristique certains plans seulement – "Hill Climbing" » On commence avec un plan OK – On varie des composantes – Une autre méthode pour la jointure… » On choisi le plan moins cher alors – On continue les variations jusqu'au temps limite où le meilleur plan – "Greedy Algorithm" » Une simplification de la programmation dynamique 30 – A chaque étape on ne retient que le meilleur plan.
Gestion de tampons (buffers) Cachez les pages peut largement améliorer les performances n Particulièrement pour les RAMs 32 -256 MO, – populaires aujourd'hui, mais rares et chères hier n 31
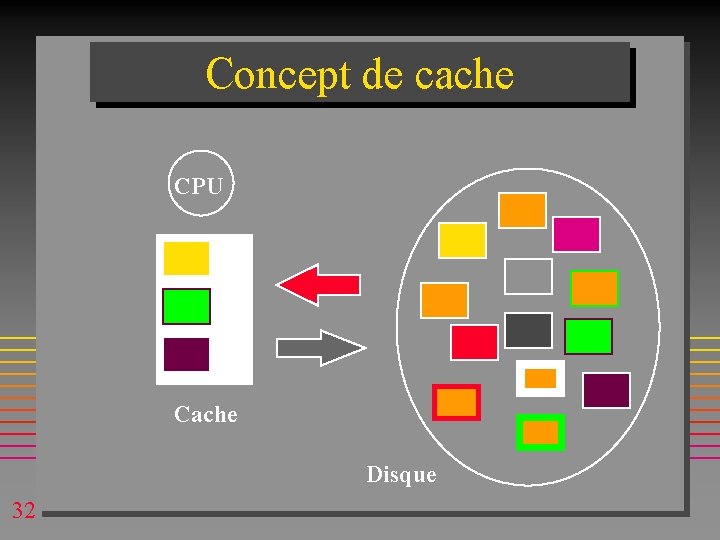
Concept de cache CPU Cache Disque 32
Strategies pour la gestion de caches n Stratégie typique: LRU » remplacer la page le moins usité n Il a été prouvé que pour les BDs il vaut mieux une stratégie dite LRU-2 (Waikum & al, Sigmod 1993) 33
Bases parallèles n Partitionnement d'une table sur les mémoires de plusieurs CPUs – mémoire partagée (shared memory) » CPUs d'une même machine – mémoires locales (shared-nothing) » même machine ou multiordinateur réseau – réseau 10 Mb/s au moins – partionnement statique ou scalable n n Exécution en parallèle d'opérations sur une BD Amélioration notable de temps de réponse – traitement parallèle – traitement en RAM n 34 Amélioration possible de la fiabilité – partitionnement redondant
Partitionnement n Aléatoire – par place disponible n Localité de référence – Tuples de Paris sur le site à Paris etc. n Haché – – n le plus simple ex. Teradata, Sybase statique ou scalable (LH*. . . ) problème de non-uniformité Ordonné – Statique (ex. Teradata, Sybase ? ) – Scalable (RP*. . . ) n 35 Multi-attribut – Scalable (k-RP*. . . )
Opérations relationnelles n Sélection et/ou projection – sur l'attribut de partitionnement » message au site concerné – sur un autre attribut » messages à tous les sites – sur un intervalle de l'attribut de partitionnement » messages aux sites concernés » message(s) à tous les sites – sur un autre intervalle » message(s) à tous les sites 36
Jointures parallèles n Equi-jointures – Hachage » la méthode en général la plus efficace – "Probing" » quand une de tables est petite n Theta-jointures – fichiers ordonnés parallèles 37
Fonctions agrégats n n Sum – somme de sommes parallèles Count – somme de comptages parallèles Avg – SUM et COUNT parallèles – somme de sommes / somme de comptages Autres (MIN, MAX, VAR, TOP. . . ) – selon le cas 38
Conclusion n n n Gestion de structures physiques est un aspect fondamental de la conception des SGBD Leur choix détermine les performances Les principes changes rapidement: RAMs bien plus grandes et moins chères Nouveaux supports : RAIDs par exemple Nouveaux types de données: k-d et multimédia nécessitant nouvelles structures: – arbre-R, arbre k-d, arbres quad. . n Structures parallèles ou distribuées: – DLH, LH*, RP*. . . 39
FIN 40