Dzisiaj na wykadzie Regresja wieloraka podstawy i zaoenia
- Slides: 36
Dzisiaj na wykładzie • Regresja wieloraka – podstawy i założenia • Przykładowe oblicznia w SASie • Weryfikacja założeń w SASie • Zadanie
Regresja wieloraka Bada związki między zmienną objaśnianą (zależną) i zmiennymi objaśniającymi (niezależnymi)
Typowe zadanie Jak przewidzieć odsetek upadków zwierząt przy transporcie? Jakie zmienne związane są z upadkami zwierząt? Co decyduje o upadkach zwierząt? Które z nich są najważniejsze i w jakim stopniu są powiązane ze stratami zwierząt?
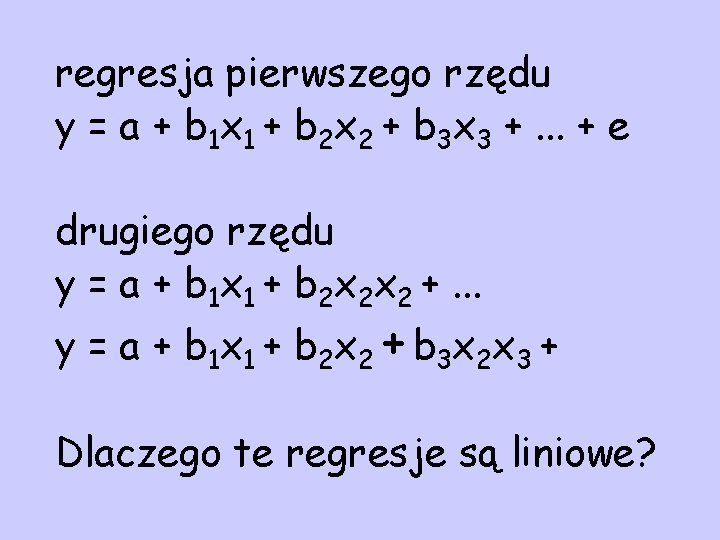
regresja pierwszego rzędu y = a + b 1 x 1 + b 2 x 2 + b 3 x 3 +. . . + e drugiego rzędu y = a + b 1 x 1 + b 2 x 2 x 2 +. . . y = a + b 1 x 1 + b 2 x 2 + b 3 x 2 x 3 + Dlaczego te regresje są liniowe?
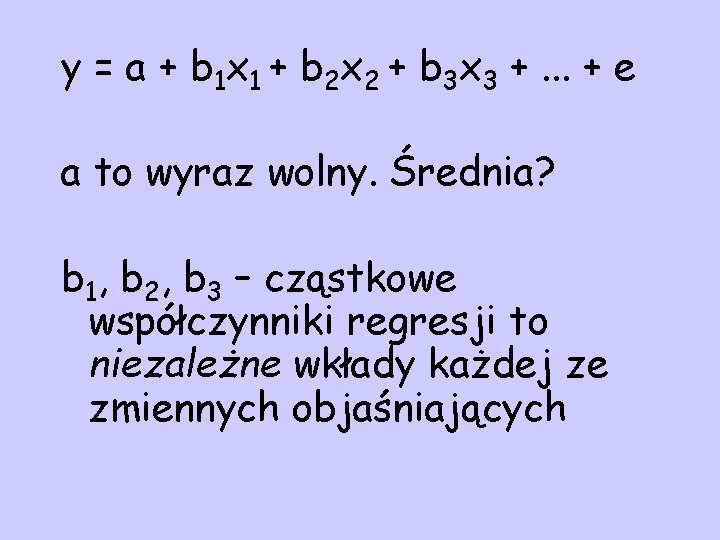
y = a + b 1 x 1 + b 2 x 2 + b 3 x 3 +. . . + e a to wyraz wolny. Średnia? b 1, b 2, b 3 – cząstkowe współczynniki regresji to niezależne wkłady każdej ze zmiennych objaśniających
Współczynniki cząstkowe obrazują zależności po uwzględnieniu pozostałych czynników. Jak je oszacować?
Jak wyznaczyć prostą regresji • metoda najmniejszych kwadratów ważonych • metoda najmniejszych reszt bezwględnych
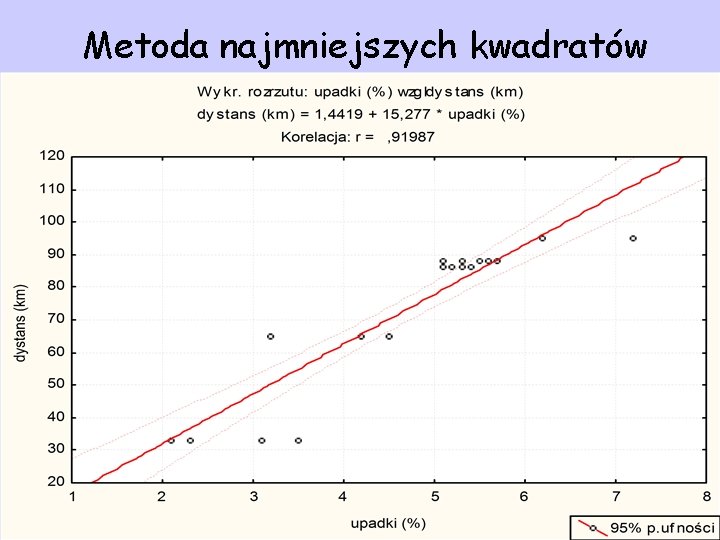
Metoda najmniejszych kwadratów
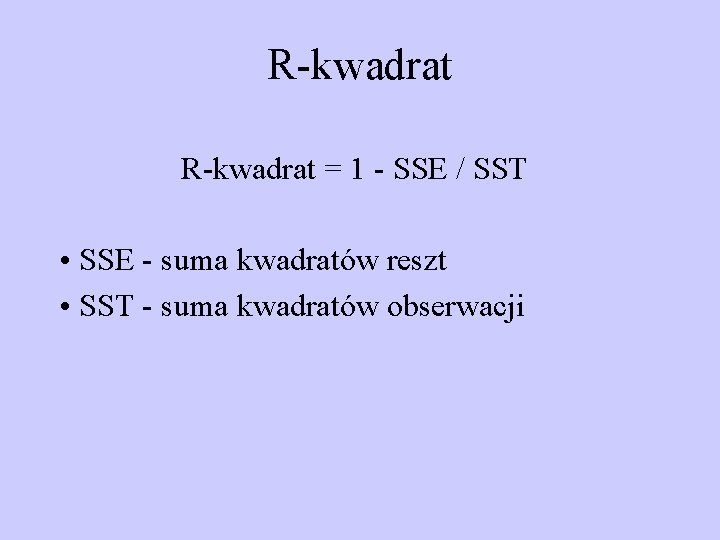
R-kwadrat czyli współczynnik determinacji • Mówi o jakości przewidywania • R 2=30% znaczy 30% wariancji opisane przez zmienne opisujące i 70% wciąż nie opisane (błędy)
R-kwadrat = 1 - SSE / SST • SSE - suma kwadratów reszt • SST - suma kwadratów obserwacji
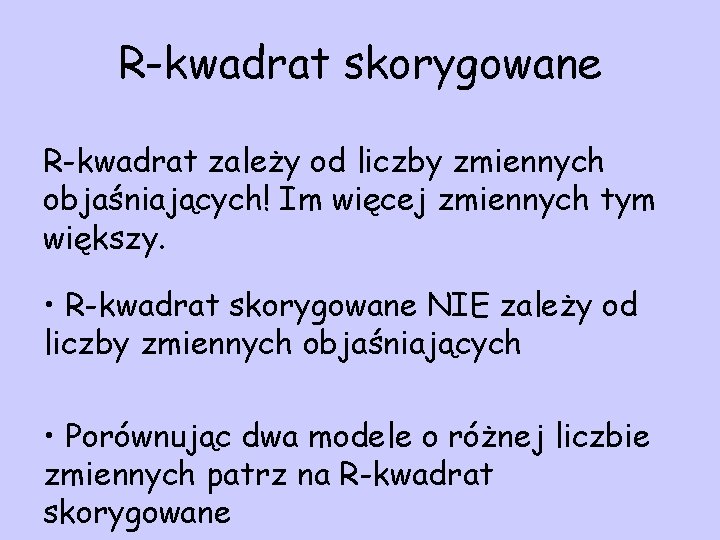
R-kwadrat skorygowane R-kwadrat zależy od liczby zmiennych objaśniających! Im więcej zmiennych tym większy. • R-kwadrat skorygowane NIE zależy od liczby zmiennych objaśniających • Porównując dwa modele o różnej liczbie zmiennych patrz na R-kwadrat skorygowane
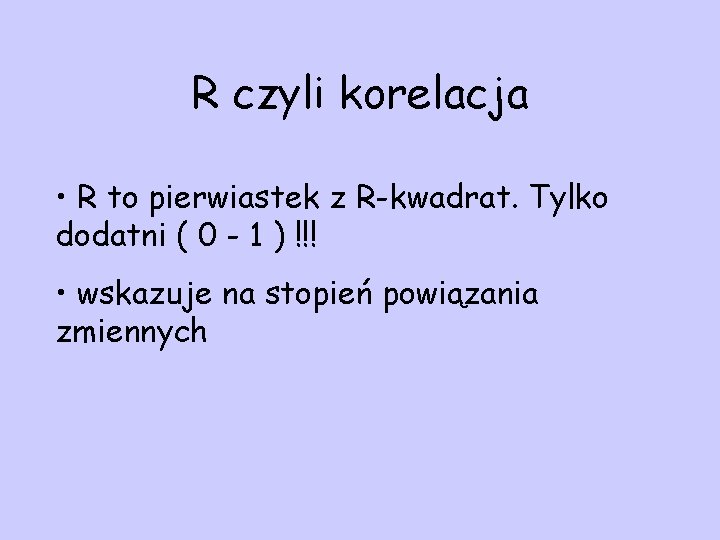
R czyli korelacja • R to pierwiastek z R-kwadrat. Tylko dodatni ( 0 - 1 ) !!! • wskazuje na stopień powiązania zmiennych
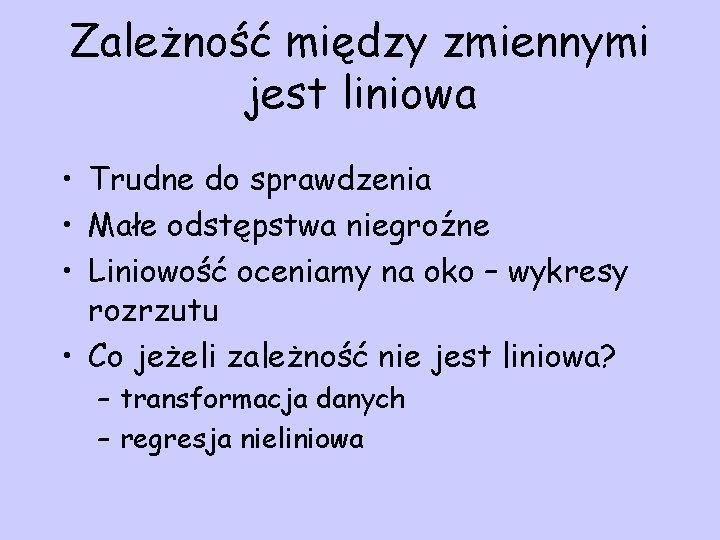
Zależność między zmiennymi jest liniowa • Trudne do sprawdzenia • Małe odstępstwa niegroźne • Liniowość oceniamy na oko – wykresy rozrzutu • Co jeżeli zależność nie jest liniowa? – transformacja danych – regresja nieliniowa
Regresja mówi o współwystępowaniu zjawisk, a nie o przyczynach i skutkach! Regresja liczby kradzieży na liczbę policjantów jest dodatnia!
Zwodnicza regresja Jeżeli w modelu umieścisz dużą liczbę zmiennych objaśniających część z nich na pewno będzie istotna. Im więcej danych tym mniej złudne są wyniki. Ile?
Reszty mają rozkład normalny • Ważne przy testowaniu, nie przy szacowaniu • Stosujemy histogramy reszt i wykresy normalności reszt • Niewielkie odchylenia nie są groźne • Dobry model daje duży R-kwadrat i normalność reszt. Czy taki potrafimy znaleźć?
Nadmiarowość danych • % upadków przy transporcie tak samo dobrze opisuje liczba przejechanych kilometrów jak i dystans do ubojni (to to samo) • Należy uważać, żeby zmienne objaśniające nie były zbytnio skorelowane
Odstające obserwacje Znacznie przekłamują oszacowania. Najczęściej to błędy powstałe przy wpisywaniu danych. Najlepiej usunąć je przed analizą regresji.
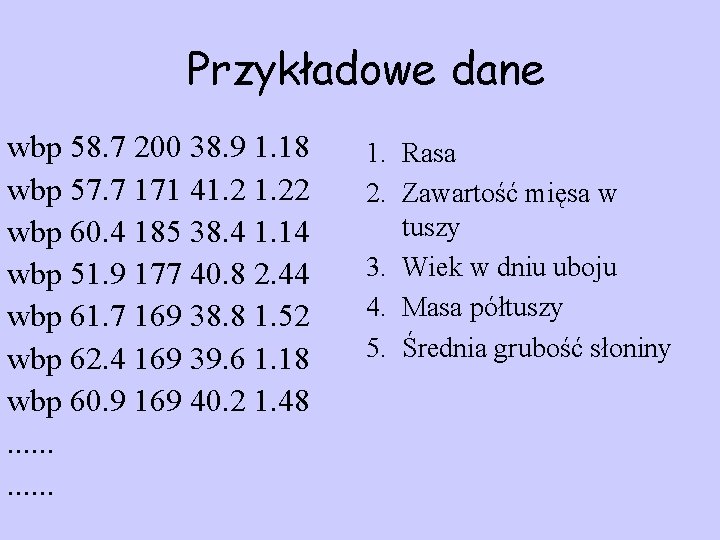
Przykładowe dane wbp 58. 7 200 38. 9 1. 18 wbp 57. 7 171 41. 22 wbp 60. 4 185 38. 4 1. 14 wbp 51. 9 177 40. 8 2. 44 wbp 61. 7 169 38. 8 1. 52 wbp 62. 4 169 39. 6 1. 18 wbp 60. 9 169 40. 2 1. 48. . . 1. Rasa 2. Zawartość mięsa w tuszy 3. Wiek w dniu uboju 4. Masa półtuszy 5. Średnia grubość słoniny
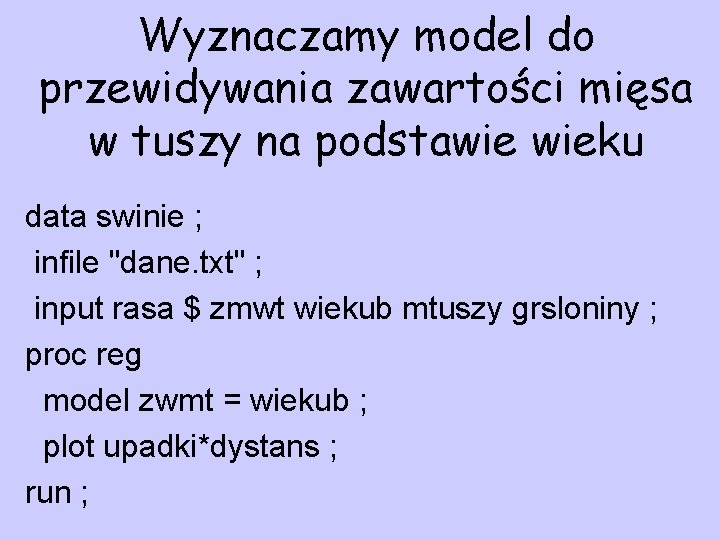
Wyznaczamy model do przewidywania zawartości mięsa w tuszy na podstawie wieku data swinie ; infile "dane. txt" ; input rasa $ zmwt wiekub mtuszy grsloniny ; proc reg model zwmt = wiekub ; plot upadki*dystans ; run ;
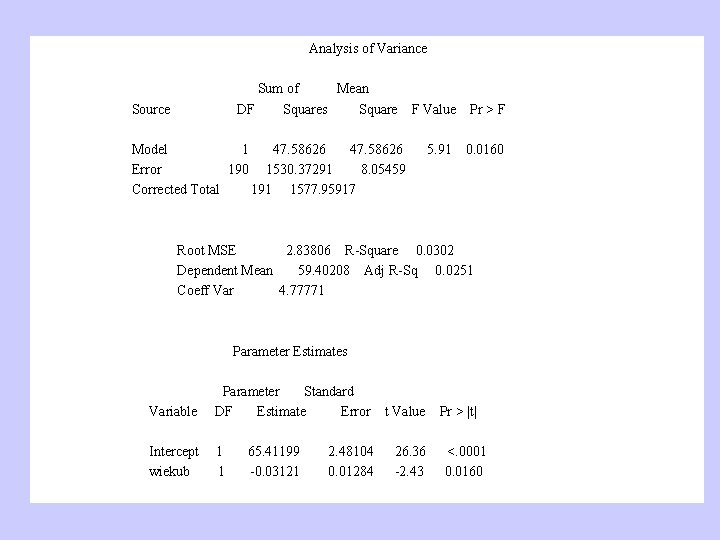
Analysis of Variance Sum of Mean DF Squares Square Source F Value Model 1 47. 58626 Error 190 1530. 37291 8. 05459 Corrected Total 191 1577. 95917 5. 91 Pr > F 0. 0160 Root MSE 2. 83806 R-Square 0. 0302 Dependent Mean 59. 40208 Adj R-Sq 0. 0251 Coeff Var 4. 77771 Parameter Estimates Variable Parameter Standard DF Estimate Error Intercept wiekub 1 1 65. 41199 -0. 03121 2. 48104 0. 01284 t Value 26. 36 -2. 43 Pr > |t| <. 0001 0. 0160
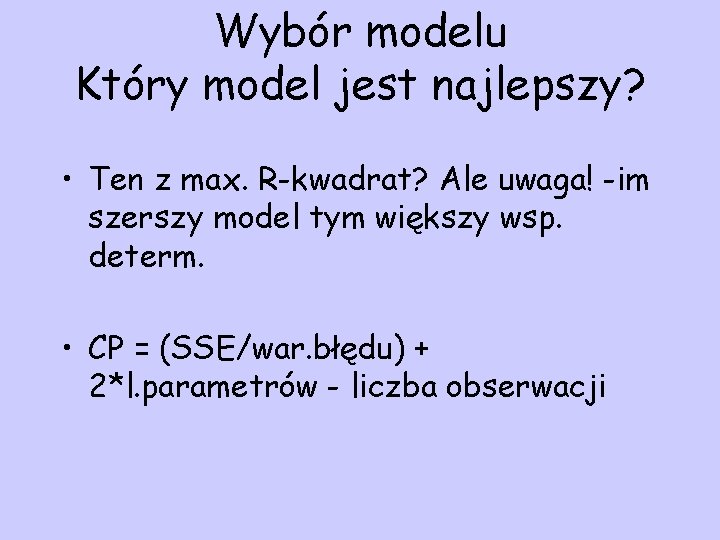
Wybór modelu Który model jest najlepszy? • Ten z max. R-kwadrat? Ale uwaga! -im szerszy model tym większy wsp. determ. • CP = (SSE/war. błędu) + 2*l. parametrów - liczba obserwacji
Jak wyznaczyć najlepszy model? • Najlepiej rozpatrywać każdy model z osobna (za dużo kombinacji). • Jeżeli więcej zmiennych kandydujących to korzystamy z regresji krokowej – wstecznej – postępującej – i innych
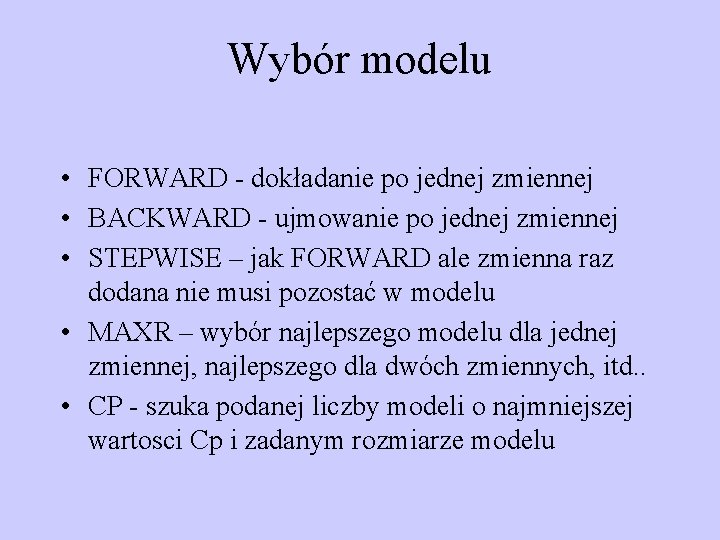
Wybór modelu • FORWARD - dokładanie po jednej zmiennej • BACKWARD - ujmowanie po jednej zmiennej • STEPWISE – jak FORWARD ale zmienna raz dodana nie musi pozostać w modelu • MAXR – wybór najlepszego modelu dla jednej zmiennej, najlepszego dla dwóch zmiennych, itd. . • CP - szuka podanej liczby modeli o najmniejszej wartosci Cp i zadanym rozmiarze modelu
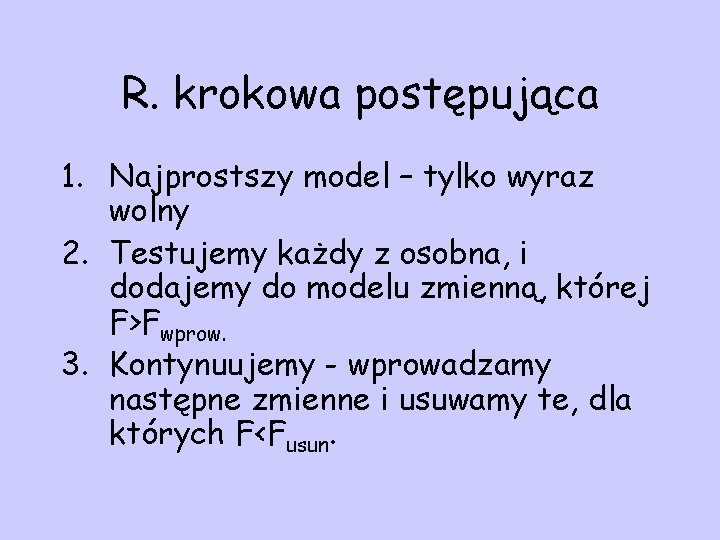
R. krokowa postępująca 1. Najprostszy model – tylko wyraz wolny 2. Testujemy każdy z osobna, i dodajemy do modelu zmienną, której F>Fwprow. 3. Kontynuujemy - wprowadzamy następne zmienne i usuwamy te, dla których F<Fusun.
Wybór modelu proc reg model zwmt = wiekub mtuszy grsloniny / selection=stepwise ; run ;
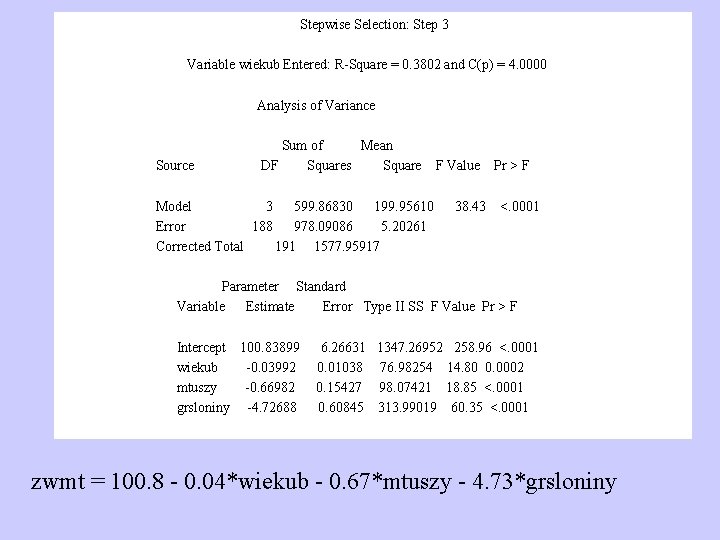
Stepwise Selection: Step 3 Variable wiekub Entered: R-Square = 0. 3802 and C(p) = 4. 0000 Analysis of Variance Source Sum of Mean DF Squares Square Model 3 599. 86830 199. 95610 Error 188 978. 09086 5. 20261 Corrected Total 191 1577. 95917 F Value 38. 43 Pr > F <. 0001 Parameter Standard Variable Estimate Error Type II SS F Value Pr > F Intercept 100. 83899 wiekub -0. 03992 mtuszy -0. 66982 grsloniny -4. 72688 6. 26631 0. 01038 0. 15427 0. 60845 1347. 26952 258. 96 <. 0001 76. 98254 14. 80 0. 0002 98. 07421 18. 85 <. 0001 313. 99019 60. 35 <. 0001 zwmt = 100. 8 - 0. 04*wiekub - 0. 67*mtuszy - 4. 73*grsloniny
Po dopasowaniu modelu zawsze analizujemy reszty. Powtarzamy analizę jeżeli mamy duże wartości odstające!
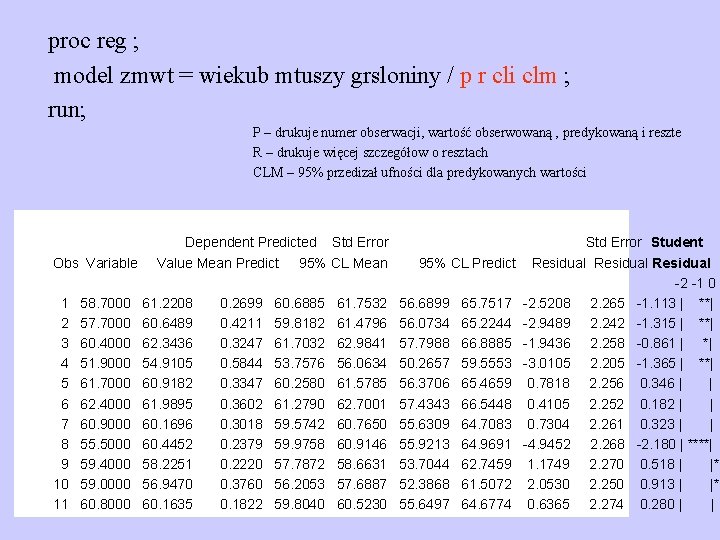
proc reg ; model zmwt = wiekub mtuszy grsloniny / p r cli clm ; run; P – drukuje numer obserwacji, wartość obserwowaną , predykowaną i reszte R – drukuje więcej szczegółow o resztach CLM – 95% przedizał ufności dla predykowanych wartości Obs Variable 1 2 3 4 5 6 7 8 9 10 11 58. 7000 57. 7000 60. 4000 51. 9000 61. 7000 62. 4000 60. 9000 55. 5000 59. 4000 59. 0000 60. 8000 Dependent Predicted Std Error Value Mean Predict 95% CL Mean 61. 2208 60. 6489 62. 3436 54. 9105 60. 9182 61. 9895 60. 1696 60. 4452 58. 2251 56. 9470 60. 1635 0. 2699 0. 4211 0. 3247 0. 5844 0. 3347 0. 3602 0. 3018 0. 2379 0. 2220 0. 3760 0. 1822 60. 6885 59. 8182 61. 7032 53. 7576 60. 2580 61. 2790 59. 5742 59. 9758 57. 7872 56. 2053 59. 8040 61. 7532 61. 4796 62. 9841 56. 0634 61. 5785 62. 7001 60. 7650 60. 9146 58. 6631 57. 6887 60. 5230 95% CL Predict 56. 6899 56. 0734 57. 7988 50. 2657 56. 3706 57. 4343 55. 6309 55. 9213 53. 7044 52. 3868 55. 6497 65. 7517 65. 2244 66. 8885 59. 5553 65. 4659 66. 5448 64. 7083 64. 9691 62. 7459 61. 5072 64. 6774 Std Error Student Residual -2 -1 0 1 -2. 5208 2. 265 -1. 113 | **| -2. 9489 2. 242 -1. 315 | **| -1. 9436 2. 258 -0. 861 | *| -3. 0105 2. 205 -1. 365 | **| 0. 7818 2. 256 0. 346 | | 0. 4105 2. 252 0. 182 | | 0. 7304 2. 261 0. 323 | | -4. 9452 2. 268 -2. 180 | ****| 1. 1749 2. 270 0. 518 | |* 2. 0530 2. 250 0. 913 | |* 0. 6365 2. 274 0. 280 | |
Reszty studentyzowane - reszty podzielone przez odchylenie standardowe reszt – duża liczba obserwacji z wartościami bezwzględnymi >2 wskazuje na nieadekwatność modelu. Wartosci D Cooka – odzwierciedlają zmianę w oszacowaniu, gdyby obserwacje usunięto z analizy. Duża wartość (>1) wskazuje, że obserwacja silnie wpływa na oszacowania w modelu – możliwe że jest to obserwacja odstająca!
Wpływowe obserwacje Obserwacje, które mają największy wpływ na oszacowania parametrów w modelu. proc reg ; model zmwt = wiekub mtuszy grsloniny / influential ; run;
• RSTUDENT – reszta studentyzowana, uwaga na wartości >2 • DFFITS- podobne do wartości D Cooka, , uwaga na te, które > 2 • DFBETAS – uwaga na wartości >2
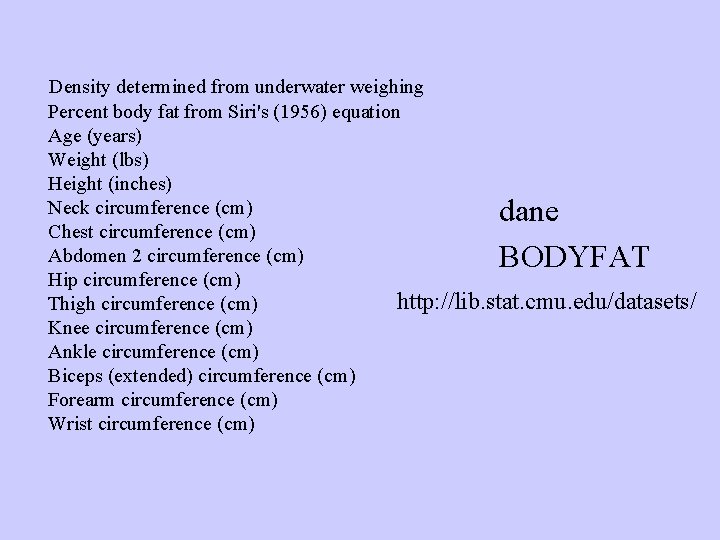
Problem na ćwiczenia udział tłuszczu w ciele • Ważny dla zdrowia • Trudny w pomiarze - wymaga ważenia ciała w wodzie. • Czy można go przewidzieć na podstawie łatwych pomiarów.
Density determined from underwater weighing Percent body fat from Siri's (1956) equation Age (years) Weight (lbs) Height (inches) Neck circumference (cm) Chest circumference (cm) Abdomen 2 circumference (cm) Hip circumference (cm) http: //lib. stat. cmu. edu/datasets/ Thigh circumference (cm) Knee circumference (cm) Ankle circumference (cm) Biceps (extended) circumference (cm) Forearm circumference (cm) Wrist circumference (cm) dane BODYFAT
Zadania na ćwiczenia • Skonstruuj dobry model predykcji udziału tłuszczu w ciele • Które zmienne są najlepiej objaśniają udział tłuszczu w ciele człowieka? • Dokonaj analizy reszt. Usuń przypadki zniekształcające przewidywanie i popraw model.
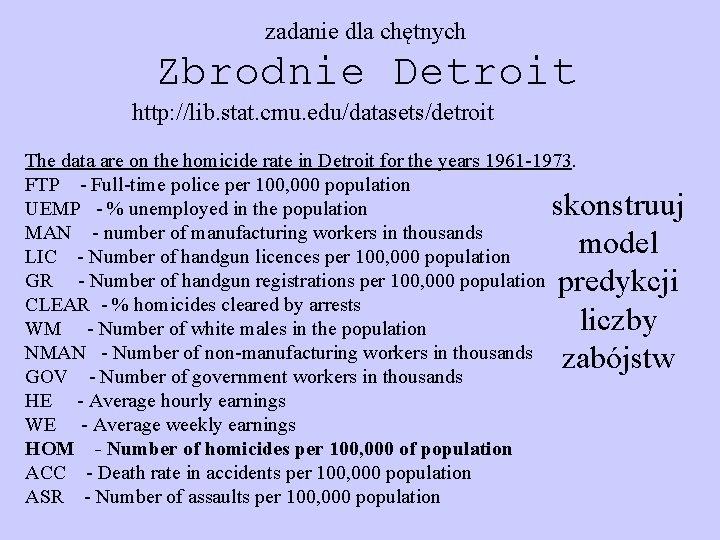
zadanie dla chętnych Zbrodnie Detroit http: //lib. stat. cmu. edu/datasets/detroit The data are on the homicide rate in Detroit for the years 1961 -1973. FTP - Full-time police per 100, 000 population UEMP - % unemployed in the population MAN - number of manufacturing workers in thousands LIC - Number of handgun licences per 100, 000 population GR - Number of handgun registrations per 100, 000 population CLEAR - % homicides cleared by arrests WM - Number of white males in the population NMAN - Number of non-manufacturing workers in thousands GOV - Number of government workers in thousands HE - Average hourly earnings WE - Average weekly earnings HOM - Number of homicides per 100, 000 of population ACC - Death rate in accidents per 100, 000 population ASR - Number of assaults per 100, 000 population skonstruuj model predykcji liczby zabójstw