Analisis Klastering Imelda Atastina CS 4333 Data Mining
- Slides: 34
Analisis Klastering Imelda Atastina CS 4333 Data Mining - IMD 1
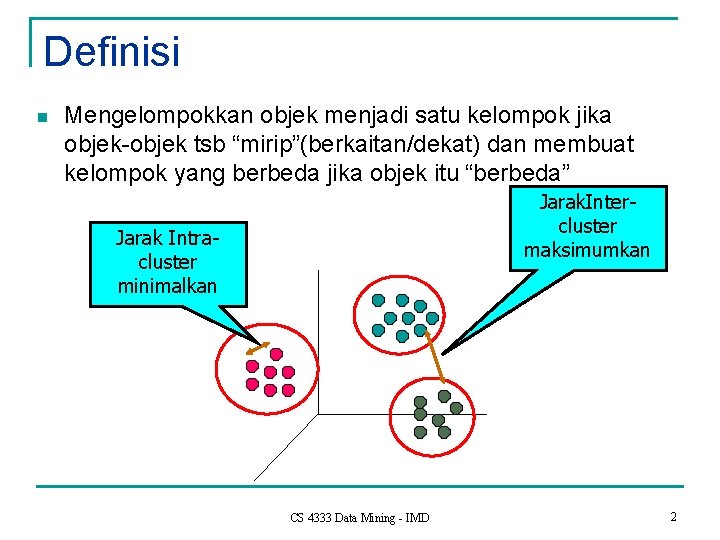
Definisi n Mengelompokkan objek menjadi satu kelompok jika objek-objek tsb “mirip”(berkaitan/dekat) dan membuat kelompok yang berbeda jika objek itu “berbeda” Jarak. Intercluster maksimumkan Jarak Intracluster minimalkan CS 4333 Data Mining - IMD 2
Kegunaan n n Pemahaman Memahami karakteristik objek yang memiliki kelompok yang sama. contoh : protein yang memiliki fungsi yang sama, stock saham yang memiliki fluktuasi yang sama Ringkasan (Summary) Sehingga data yang diolah merupakan dataset yang lebih kecil saja CS 4333 Data Mining - IMD 3
Bukan Klaterisasi n Klasifikasi (Supervised classification) q n Segmentasi Sederhana q n Membagi kelompok registrasi siswa berdasarkan urutan hasil ujian penerimaan Hasil-hasil query q n Mempunyai informasi label kelas Pengelompokan berdasarkan spesifikasi eksternal Graph partitioning CS 4333 Data Mining - IMD 4
Macam-macam Proses Klasterisasi n n n Hierarchical vs Partitioning Exclusive vs Overlapping vs Fuzzy Complete vs Partial CS 4333 Data Mining - IMD 5
Jenis-jenis Klaster n n n Well-separated Prototype based Graph based Density based Shared property CS 4333 Data Mining - IMD 6
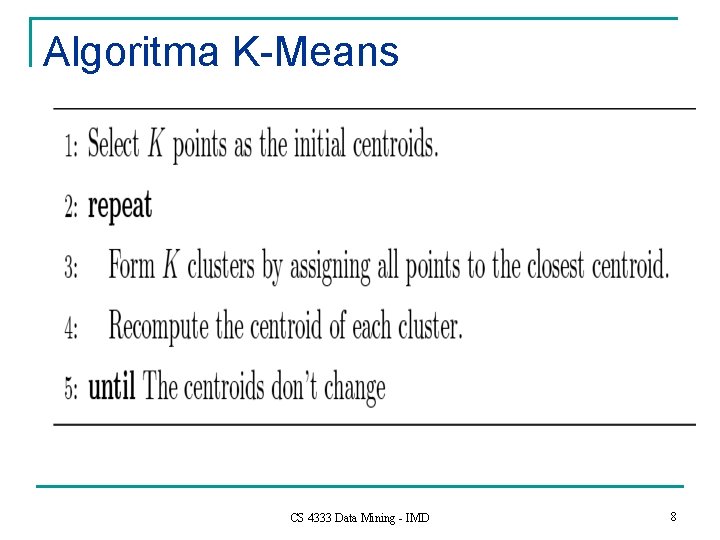
K-Means n n n Merupakan salah satu algoritma Partitional clustering Setiap klaster berkaitan dengan sebuah titik pusat klaster (centroid) Setiap titik dimasukkan ke dalam klaster dengan centroid terdekat. Jumlah klaster harus ditentukan sebelumnya Algoritma dasar K-Means sangat sederhana CS 4333 Data Mining - IMD 7
Algoritma K-Means CS 4333 Data Mining - IMD 8
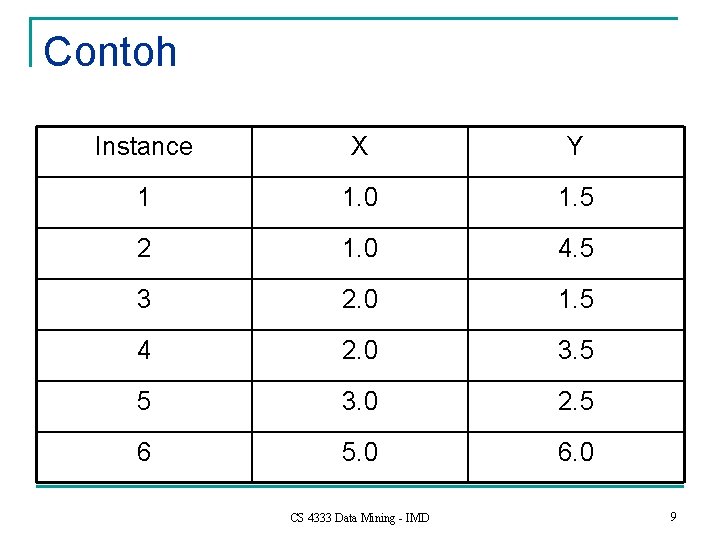
Contoh Instance X Y 1 1. 0 1. 5 2 1. 0 4. 5 3 2. 0 1. 5 4 2. 0 3. 5 5 3. 0 2. 5 6 5. 0 6. 0 CS 4333 Data Mining - IMD 9
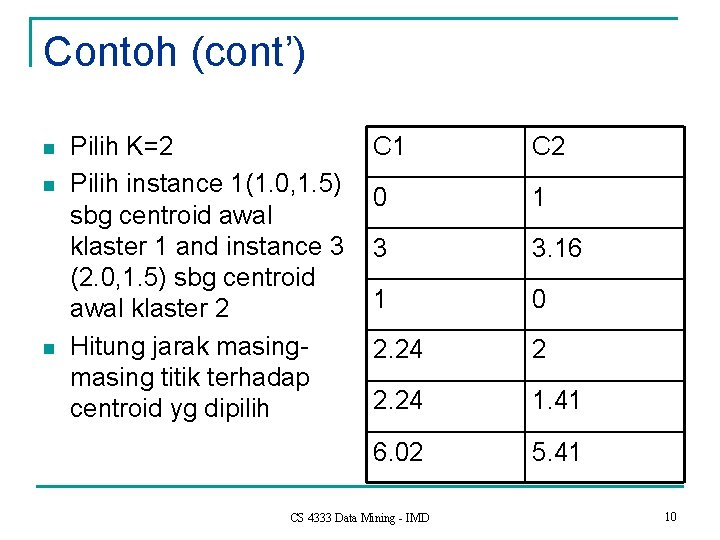
Contoh (cont’) n n n Pilih K=2 Pilih instance 1(1. 0, 1. 5) sbg centroid awal klaster 1 and instance 3 (2. 0, 1. 5) sbg centroid awal klaster 2 Hitung jarak masing titik terhadap centroid yg dipilih C 1 C 2 0 1 3 3. 16 1 0 2. 24 2 2. 24 1. 41 6. 02 5. 41 CS 4333 Data Mining - IMD 10
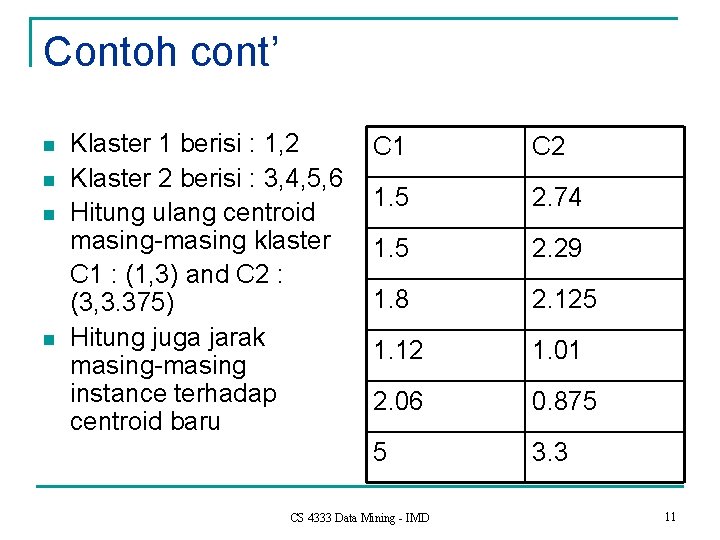
Contoh cont’ n n Klaster 1 berisi : 1, 2 Klaster 2 berisi : 3, 4, 5, 6 Hitung ulang centroid masing-masing klaster C 1 : (1, 3) and C 2 : (3, 3. 375) Hitung juga jarak masing-masing instance terhadap centroid baru C 1 C 2 1. 5 2. 74 1. 5 2. 29 1. 8 2. 125 1. 12 1. 01 2. 06 0. 875 5 3. 3 CS 4333 Data Mining - IMD 11
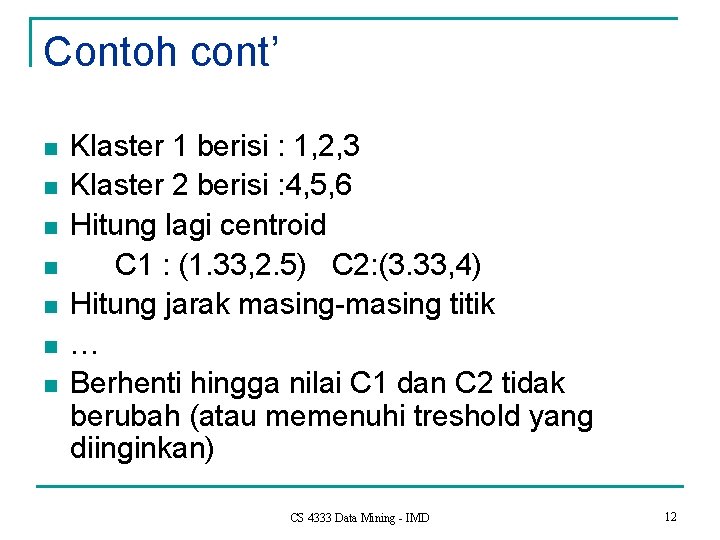
Contoh cont’ n n n n Klaster 1 berisi : 1, 2, 3 Klaster 2 berisi : 4, 5, 6 Hitung lagi centroid C 1 : (1. 33, 2. 5) C 2: (3. 33, 4) Hitung jarak masing-masing titik … Berhenti hingga nilai C 1 dan C 2 tidak berubah (atau memenuhi treshold yang diinginkan) CS 4333 Data Mining - IMD 12
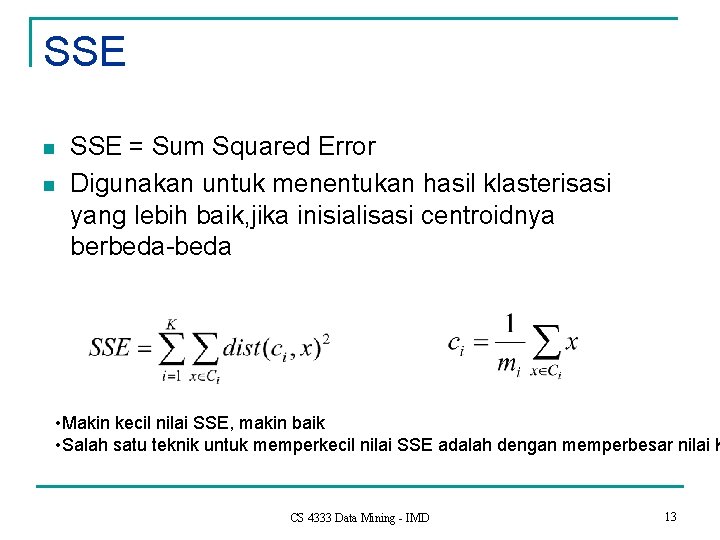
SSE n n SSE = Sum Squared Error Digunakan untuk menentukan hasil klasterisasi yang lebih baik, jika inisialisasi centroidnya berbeda-beda • Makin kecil nilai SSE, makin baik • Salah satu teknik untuk memperkecil nilai SSE adalah dengan memperbesar nilai K CS 4333 Data Mining - IMD 13
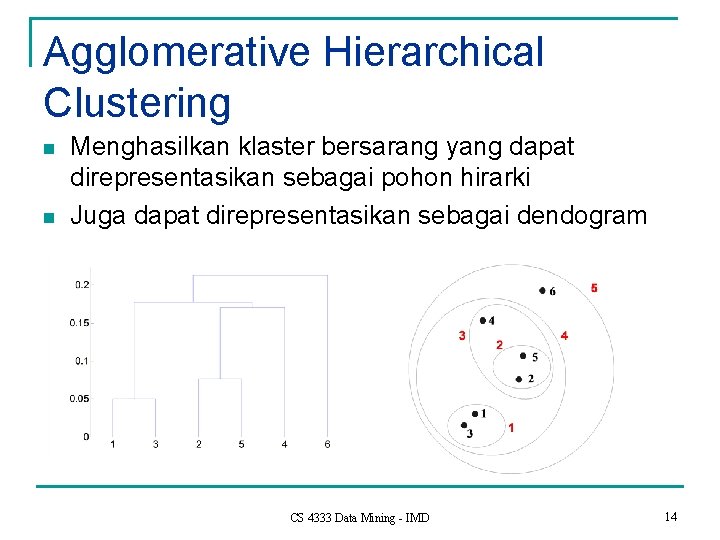
Agglomerative Hierarchical Clustering n n Menghasilkan klaster bersarang yang dapat direpresentasikan sebagai pohon hirarki Juga dapat direpresentasikan sebagai dendogram CS 4333 Data Mining - IMD 14
Jenis hierarchical clustering n n Agglomerative Dimulai dengan setiap titik dianggap sebagai sebuah klaster, secara bertahap setiap klaster digabungkan hingga akhirnya menjadi satu klaster saja Divisive Kebalikan dari agglomerative, dimulai dengan semua titik dianggap berada pada satu klaster, secara bertahap dibagi hingga setiap klaster berisi satu titik CS 4333 Data Mining - IMD 15
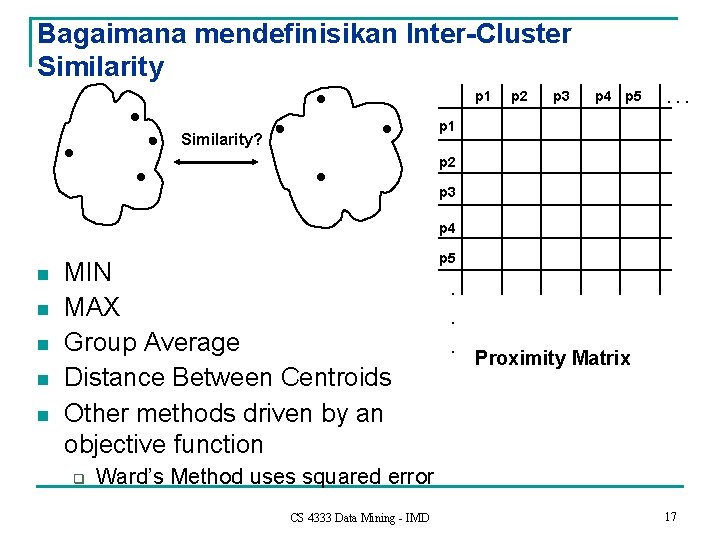
Algoritma Dasar Agglomerative Hierarchical Clustering Compute the proximity matrix, if necessary 2. Repeat 3. Merge the closest two cluster 4. Update the proximity matrix to reflect the proximity between the new cluster and the original clusters 5. Until Only one cluster remains * Cara menghitung jarak antara 2 cluster 1. CS 4333 Data Mining - IMD 16
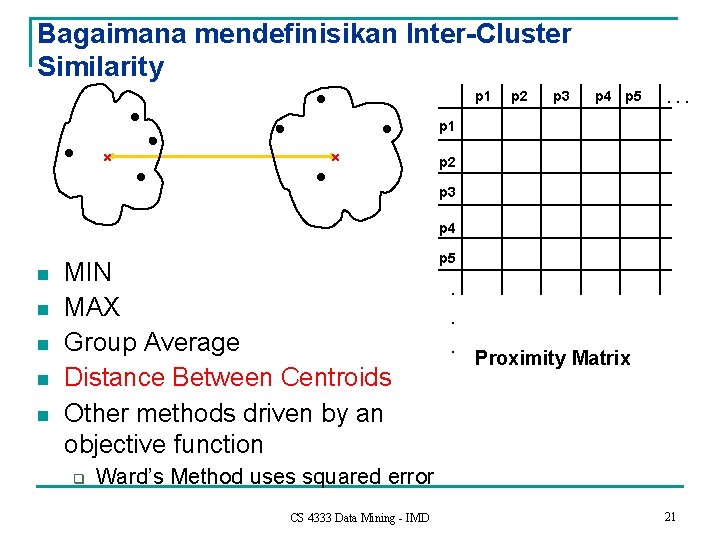
Bagaimana mendefinisikan Inter-Cluster Similarity p 1 p 2 p 3 p 4 p 5 . . . p 1 Similarity? p 2 p 3 p 4 n n n MIN MAX Group Average Distance Between Centroids Other methods driven by an objective function q p 5 . . . Proximity Matrix Ward’s Method uses squared error CS 4333 Data Mining - IMD 17
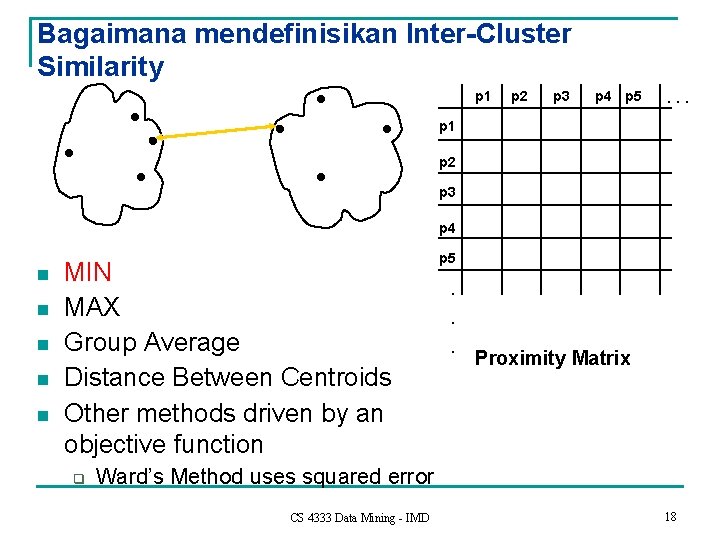
Bagaimana mendefinisikan Inter-Cluster Similarity p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 n n n MIN MAX Group Average Distance Between Centroids Other methods driven by an objective function q p 5 . . . Proximity Matrix Ward’s Method uses squared error CS 4333 Data Mining - IMD 18
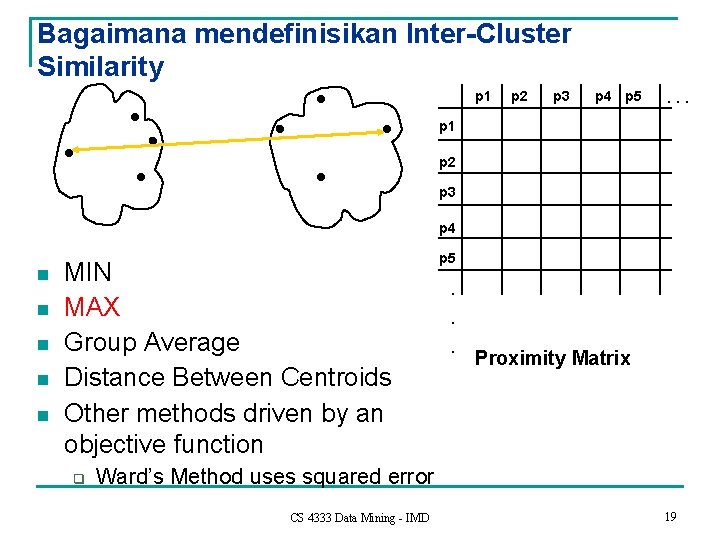
Bagaimana mendefinisikan Inter-Cluster Similarity p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 n n n MIN MAX Group Average Distance Between Centroids Other methods driven by an objective function q p 5 . . . Proximity Matrix Ward’s Method uses squared error CS 4333 Data Mining - IMD 19
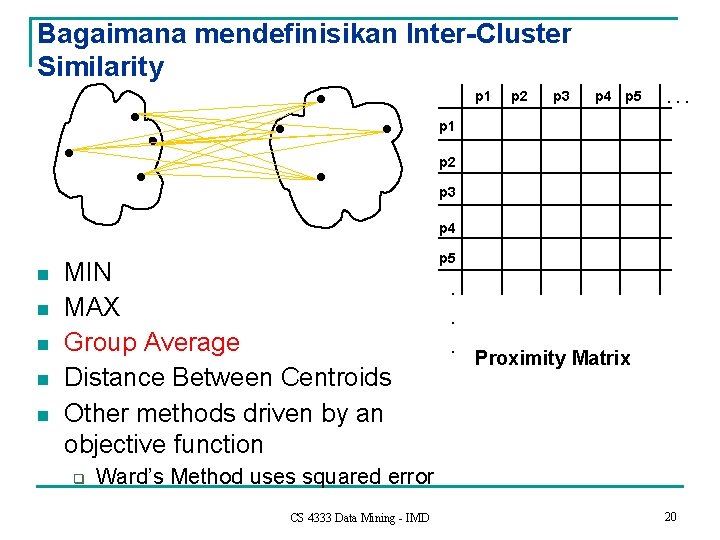
Bagaimana mendefinisikan Inter-Cluster Similarity p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 n n n MIN MAX Group Average Distance Between Centroids Other methods driven by an objective function q p 5 . . . Proximity Matrix Ward’s Method uses squared error CS 4333 Data Mining - IMD 20
Bagaimana mendefinisikan Inter-Cluster Similarity p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 n n n MIN MAX Group Average Distance Between Centroids Other methods driven by an objective function q p 5 . . . Proximity Matrix Ward’s Method uses squared error CS 4333 Data Mining - IMD 21
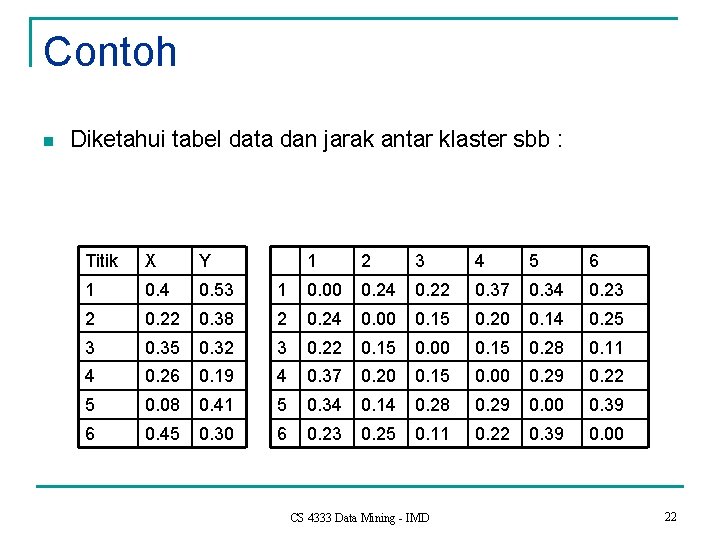
Contoh n Diketahui tabel data dan jarak antar klaster sbb : Titik X Y 1 2 3 4 5 6 1 0. 4 0. 53 1 0. 00 0. 24 0. 22 0. 37 0. 34 0. 23 2 0. 22 0. 38 2 0. 24 0. 00 0. 15 0. 20 0. 14 0. 25 3 0. 35 0. 32 3 0. 22 0. 15 0. 00 0. 15 0. 28 0. 11 4 0. 26 0. 19 4 0. 37 0. 20 0. 15 0. 00 0. 29 0. 22 5 0. 08 0. 41 5 0. 34 0. 14 0. 28 0. 29 0. 00 0. 39 6 0. 45 0. 30 6 0. 23 0. 25 0. 11 0. 22 0. 39 0. 00 CS 4333 Data Mining - IMD 22
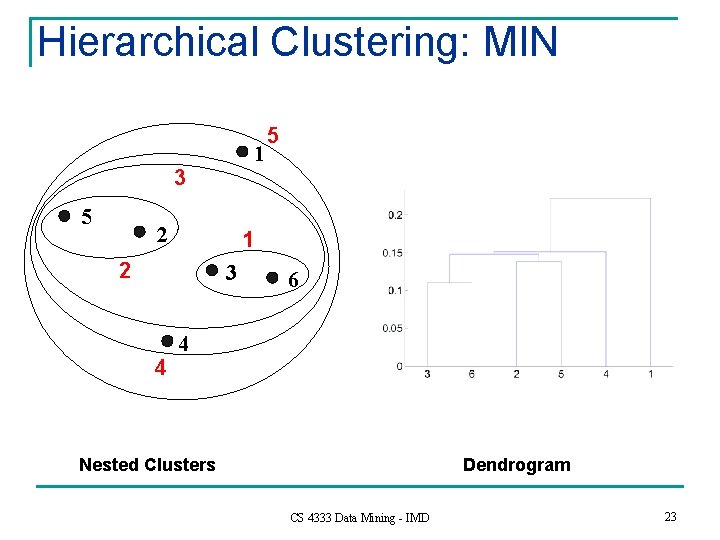
Hierarchical Clustering: MIN 1 3 5 2 1 2 3 4 5 6 4 Nested Clusters Dendrogram CS 4333 Data Mining - IMD 23
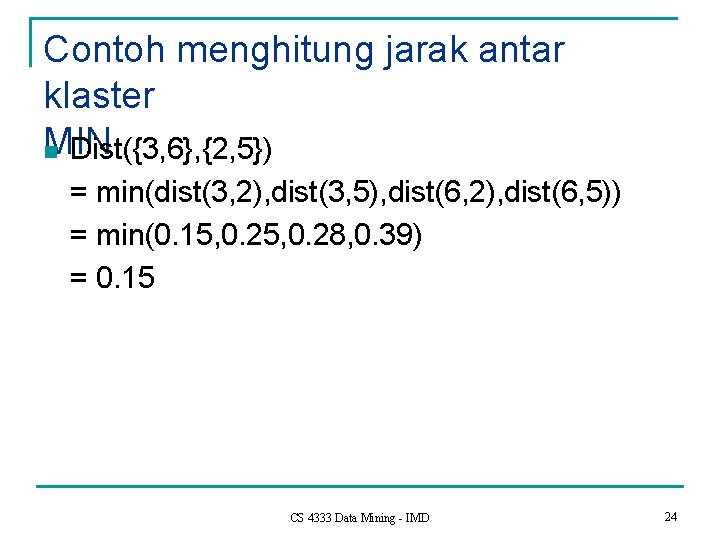
Contoh menghitung jarak antar klaster MIN n Dist({3, 6}, {2, 5}) = min(dist(3, 2), dist(3, 5), dist(6, 2), dist(6, 5)) = min(0. 15, 0. 28, 0. 39) = 0. 15 CS 4333 Data Mining - IMD 24
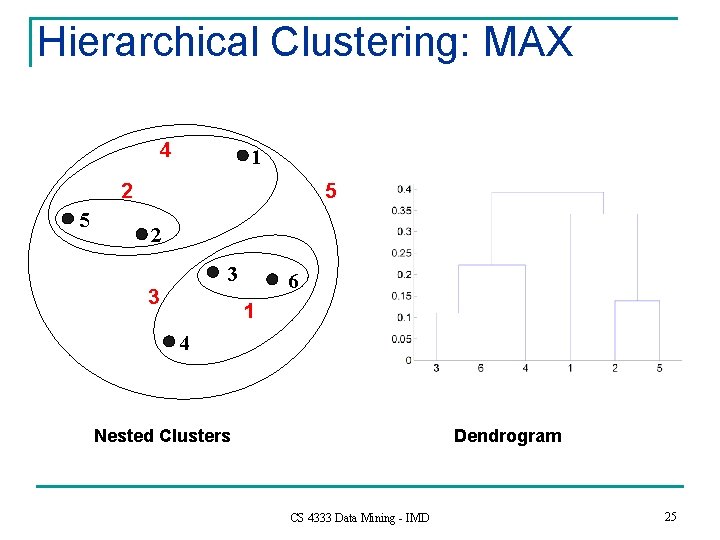
Hierarchical Clustering: MAX 4 1 2 5 5 2 3 3 6 1 4 Nested Clusters Dendrogram CS 4333 Data Mining - IMD 25
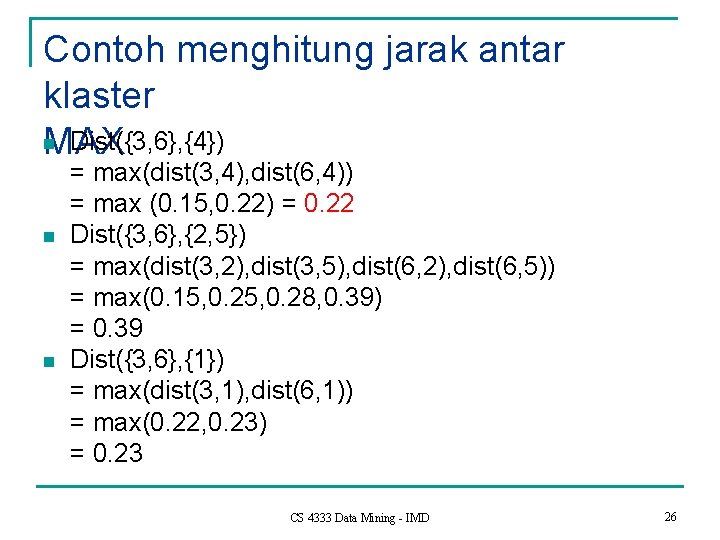
Contoh menghitung jarak antar klaster n Dist({3, 6}, {4}) MAX n n = max(dist(3, 4), dist(6, 4)) = max (0. 15, 0. 22) = 0. 22 Dist({3, 6}, {2, 5}) = max(dist(3, 2), dist(3, 5), dist(6, 2), dist(6, 5)) = max(0. 15, 0. 28, 0. 39) = 0. 39 Dist({3, 6}, {1}) = max(dist(3, 1), dist(6, 1)) = max(0. 22, 0. 23) = 0. 23 CS 4333 Data Mining - IMD 26
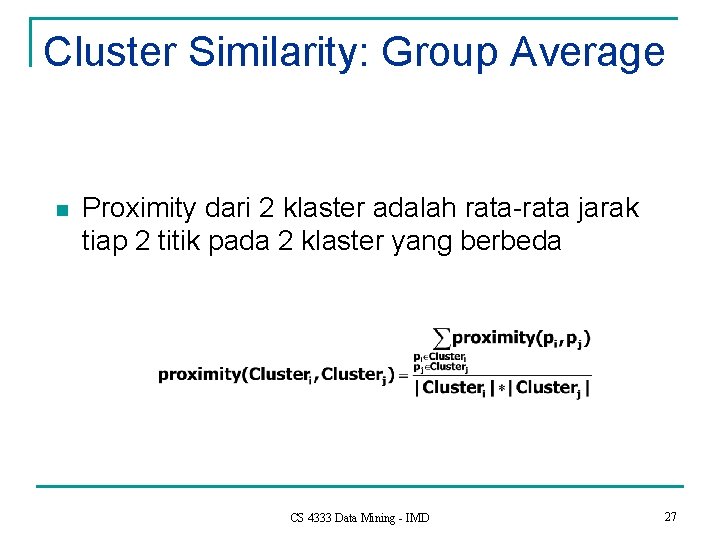
Cluster Similarity: Group Average n Proximity dari 2 klaster adalah rata-rata jarak tiap 2 titik pada 2 klaster yang berbeda CS 4333 Data Mining - IMD 27
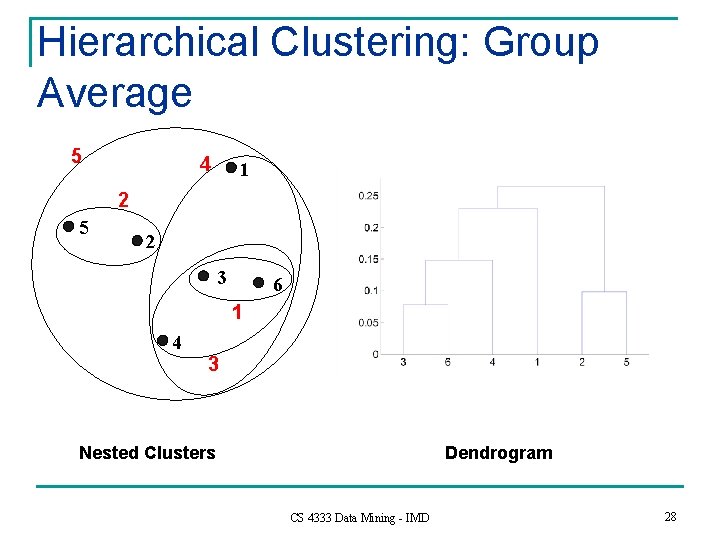
Hierarchical Clustering: Group Average 5 4 1 2 5 2 3 6 1 4 3 Nested Clusters Dendrogram CS 4333 Data Mining - IMD 28
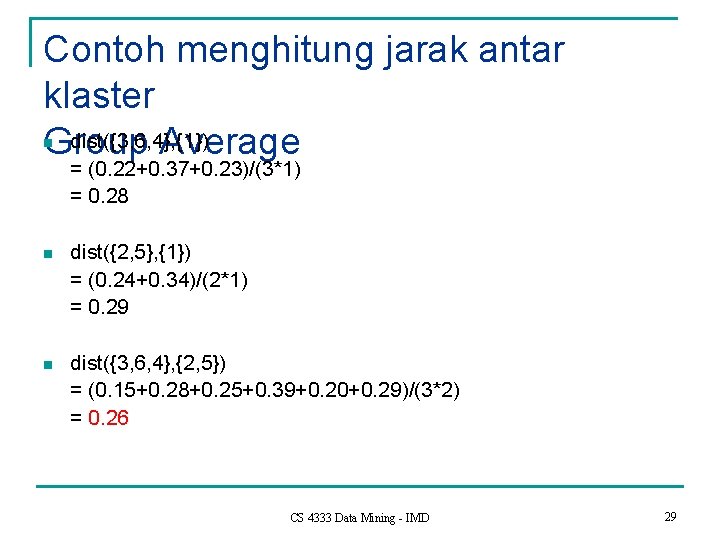
Contoh menghitung jarak antar klaster dist({3, 6, 4}, {1}) Group Average n = (0. 22+0. 37+0. 23)/(3*1) = 0. 28 n dist({2, 5}, {1}) = (0. 24+0. 34)/(2*1) = 0. 29 n dist({3, 6, 4}, {2, 5}) = (0. 15+0. 28+0. 25+0. 39+0. 20+0. 29)/(3*2) = 0. 26 CS 4333 Data Mining - IMD 29
Hierarchical Clustering: Group Average n n Merupakan jalan tengah antara MIN dan MAX (Single Linkage & Complete Linkage) Kelebihannya q n Tidak terlalu terpengaruh oleh noise & outliers Kekurangan q Bias terhadap globular clusters CS 4333 Data Mining - IMD 30
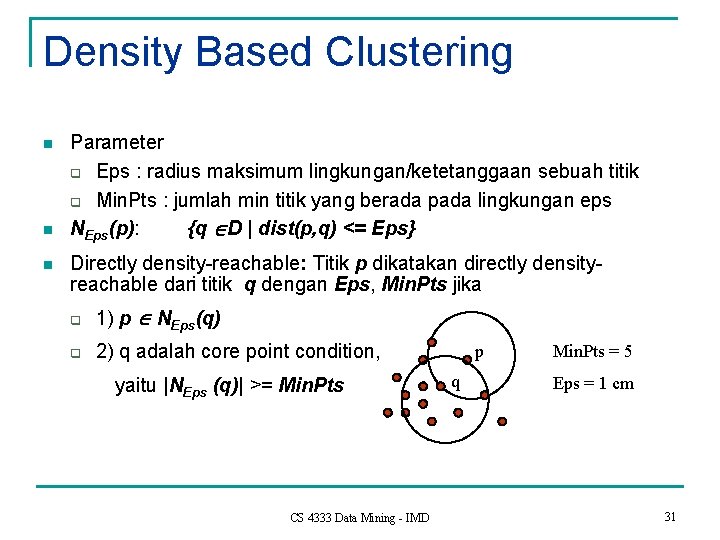
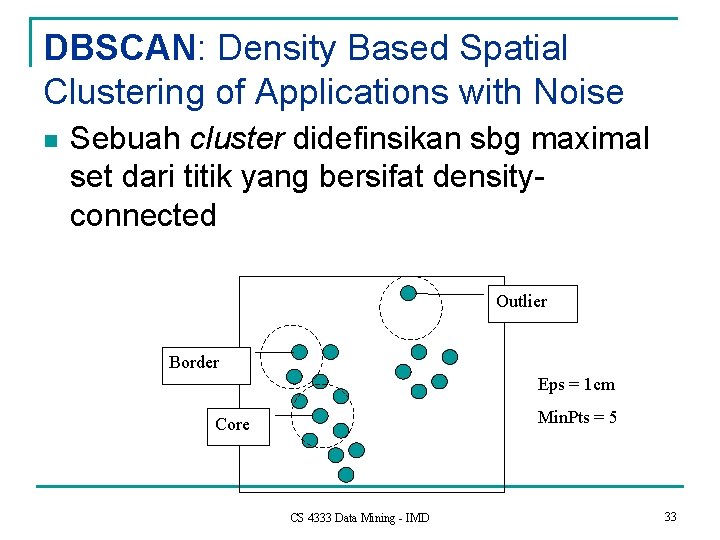
Density Based Clustering n n n Parameter q Eps : radius maksimum lingkungan/ketetanggaan sebuah titik q Min. Pts : jumlah min titik yang berada pada lingkungan eps NEps(p): {q D | dist(p, q) <= Eps} Directly density-reachable: Titik p dikatakan directly densityreachable dari titik q dengan Eps, Min. Pts jika q 1) p NEps(q) q 2) q adalah core point condition, yaitu |NEps (q)| >= Min. Pts CS 4333 Data Mining - IMD p q Min. Pts = 5 Eps = 1 cm 31
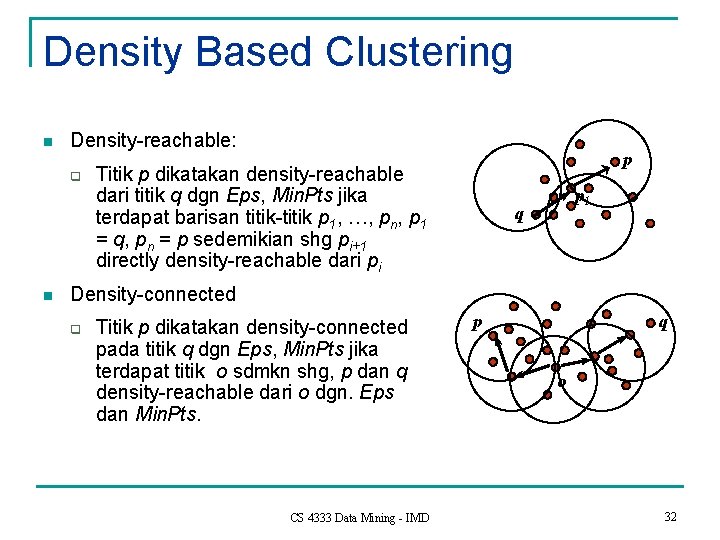
Density Based Clustering n Density-reachable: q n p Titik p dikatakan density-reachable dari titik q dgn Eps, Min. Pts jika terdapat barisan titik-titik p 1, …, pn, p 1 = q, pn = p sedemikian shg pi+1 directly density-reachable dari pi p 1 q Density-connected q Titik p dikatakan density-connected pada titik q dgn Eps, Min. Pts jika terdapat titik o sdmkn shg, p dan q density-reachable dari o dgn. Eps dan Min. Pts. CS 4333 Data Mining - IMD p q o 32
DBSCAN: Density Based Spatial Clustering of Applications with Noise n Sebuah cluster didefinsikan sbg maximal set dari titik yang bersifat densityconnected Outlier Border Eps = 1 cm Min. Pts = 5 Core CS 4333 Data Mining - IMD 33
Algoritma DBSCAN q q q Arbitrary select a point p Retrieve all points density-reachable from p wrt Eps and Min. Pts. If p is a core point, a cluster is formed. If p is a border point, no points are density-reachable from p and DBSCAN visits the next point of the database. Continue the process until all of the points have been processed. CS 4333 Data Mining - IMD 34