1 Computao de Alto Desempenho Tecnologias de Alta
- Slides: 32
1 Computação de Alto Desempenho • Tecnologias de Alta Velocidade de Operação – Exemplos: 750 MHz, 1 GHz • Exploração de Paralelismo – Alta Granulosidade • Programas • Processos – Baixa Granulosidade • Instruções 1 a jecompp
Paralelismo no Nível de Programas e Processos 2 • Arquiteturas de Processamento com Diversos Processadores (máquinas paralelas) • Arquiteturas de Processamento com Diversos Computadores (rede de computadores) 1 a jecompp
Paralelismo no Nível de Instruções 3 (ILP - Instruction Level Parallelism) • Processador que Executam Instruções em Paralelo – – – Pipelining Superpipelining Superscalar VLIW - Very long Instruction Word Vetorial etc. 1 a jecompp
4 Desempenho • Desempenho final depende de vários fatores – Características da Aplicação – Mecanismo de Comunicação – Qualidade do Código Gerado pelo Compilador – Arquitetura dos Processadores – Arquitetura dos Computadores 1 a jecompp
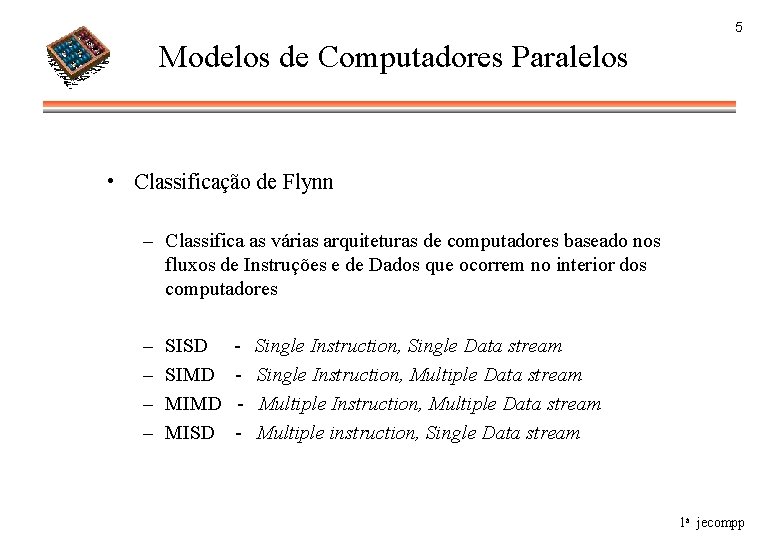
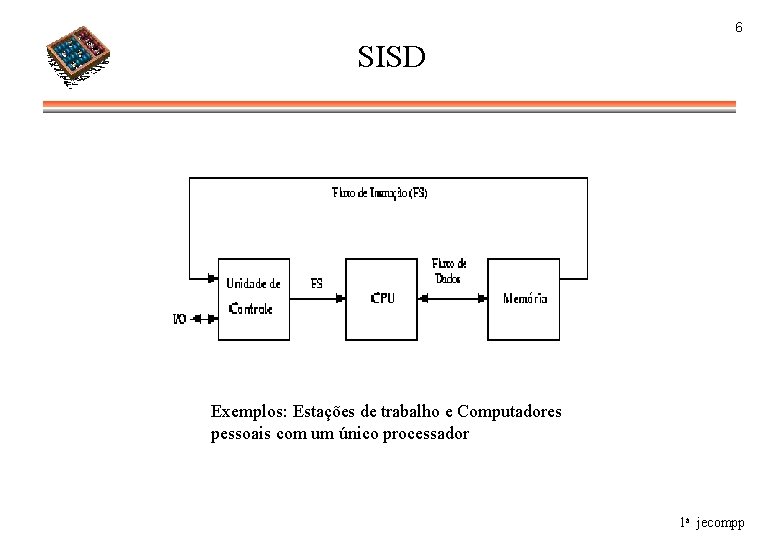
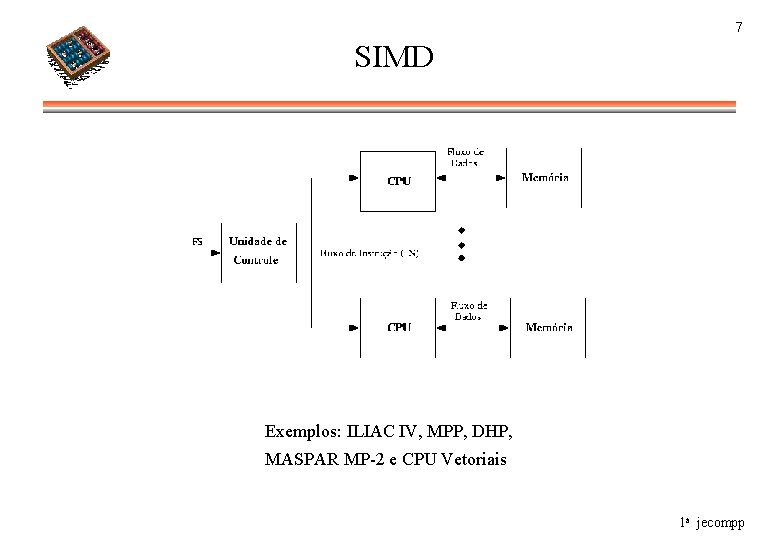
5 Modelos de Computadores Paralelos • Classificação de Flynn – Classifica as várias arquiteturas de computadores baseado nos fluxos de Instruções e de Dados que ocorrem no interior dos computadores – – SISD SIMD MISD - Single Instruction, Single Data stream Single Instruction, Multiple Data stream Multiple instruction, Single Data stream 1 a jecompp
6 SISD Exemplos: Estações de trabalho e Computadores pessoais com um único processador 1 a jecompp
7 SIMD Exemplos: ILIAC IV, MPP, DHP, MASPAR MP-2 e CPU Vetoriais 1 a jecompp
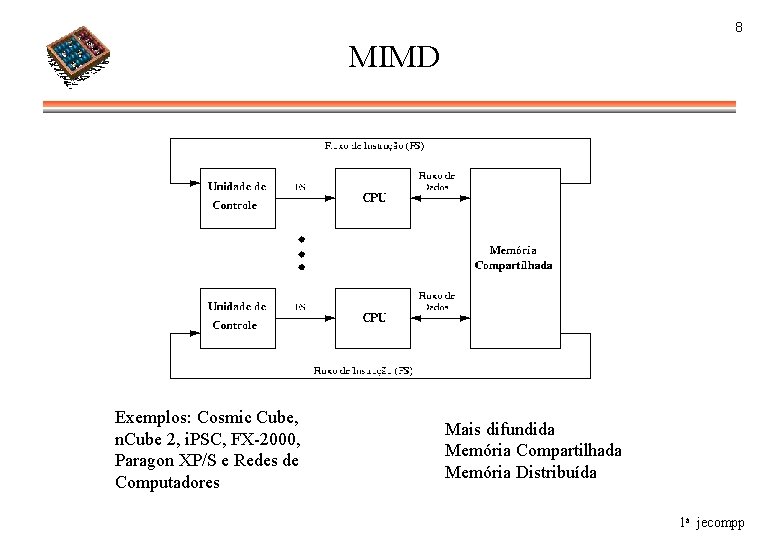
8 MIMD Exemplos: Cosmic Cube, n. Cube 2, i. PSC, FX-2000, Paragon XP/S e Redes de Computadores Mais difundida Memória Compartilhada Memória Distribuída 1 a jecompp
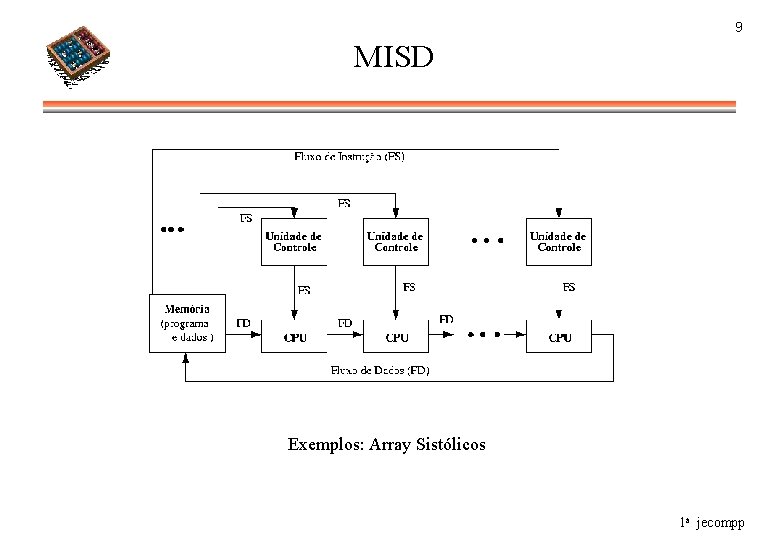
9 MISD Exemplos: Array Sistólicos 1 a jecompp
10 Resumo • MIMD – Maioria dos sistemas paralelos existentes – Mais adequado à computação paralela de “propósito geral” • SIMD e MISD – Computação específica • SISD – Computação Seqüencial 1 a jecompp
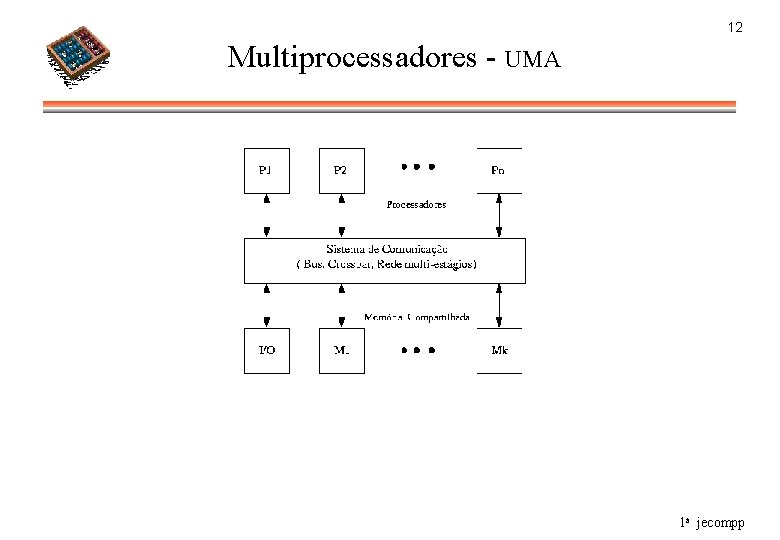
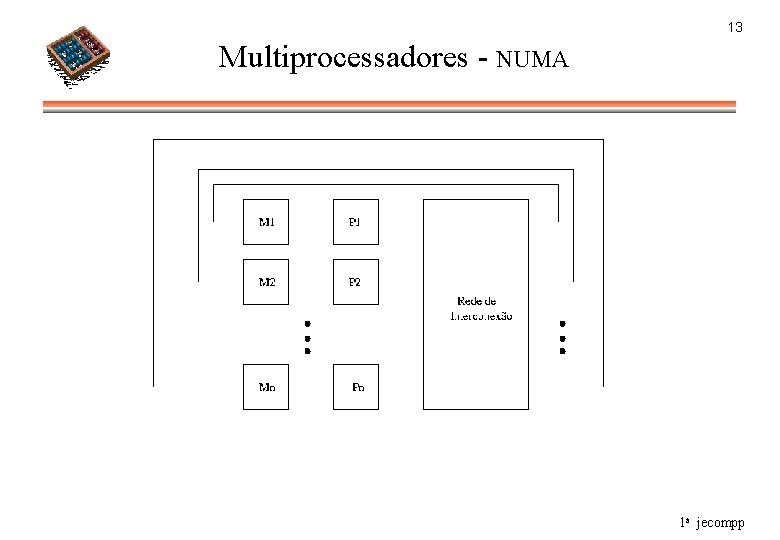
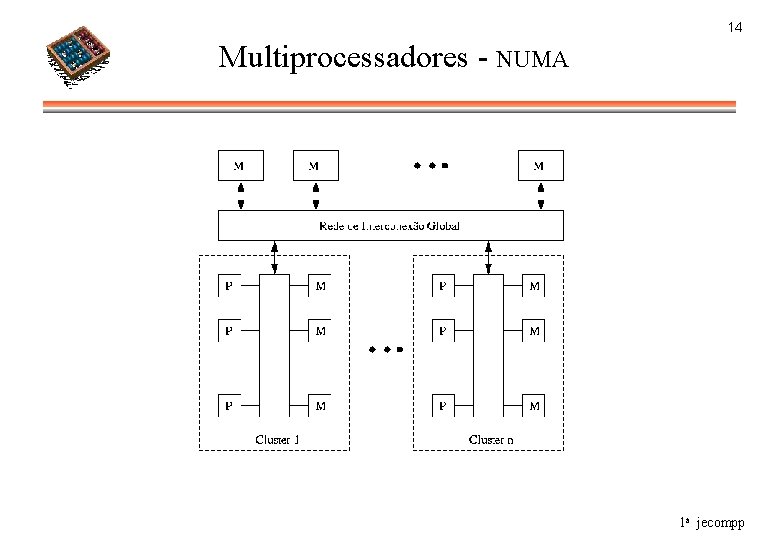
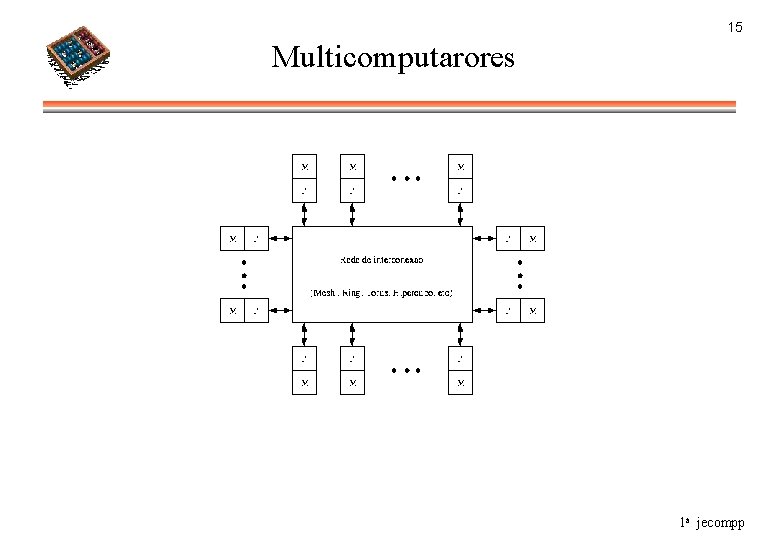
11 Máquinas MIMD • Multiprocessadores de Memória Compartilhada -memory multiprocessors) – UMA (shared (Uniform-Memory-Access) – NUMA (Non. Uniform-Memory-Access) • Multicomputadores passing multicomputers) (message- – Redes de Computadores 1 a jecompp
12 Multiprocessadores - UMA 1 a jecompp
13 Multiprocessadores - NUMA 1 a jecompp
14 Multiprocessadores - NUMA 1 a jecompp
15 Multicomputarores 1 a jecompp
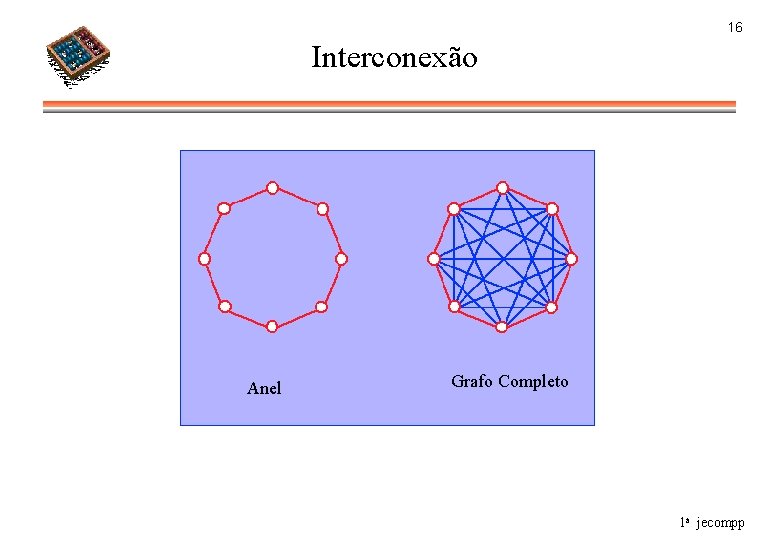
16 Interconexão Anel Grafo Completo 1 a jecompp
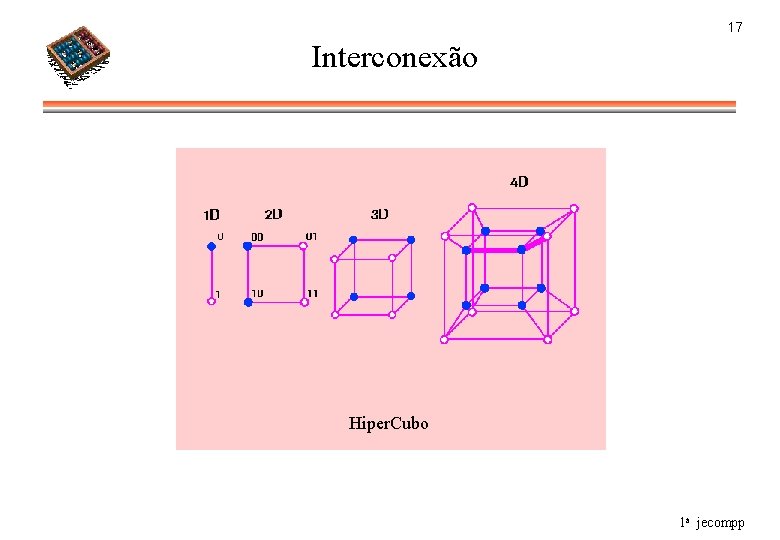
17 Interconexão Hiper. Cubo 1 a jecompp
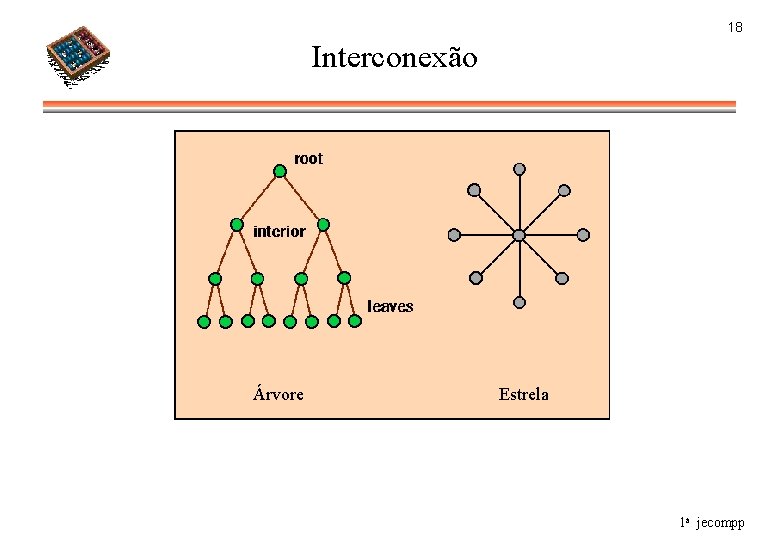
18 Interconexão Árvore Estrela 1 a jecompp
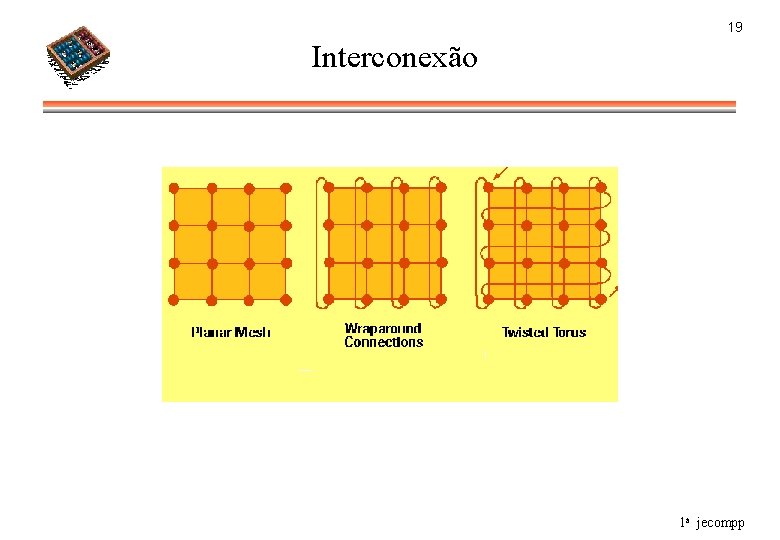
19 Interconexão 1 a jecompp
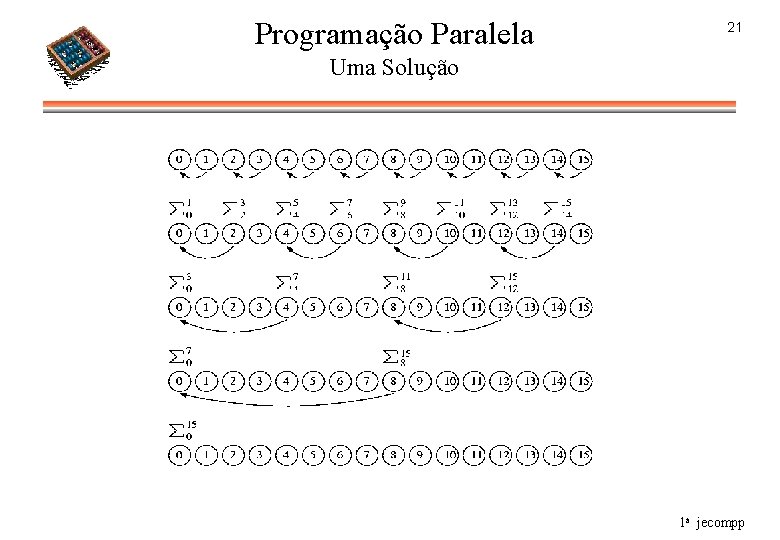
Programação Paralela 20 Exemplo • Somar 16 valores, utilizando-se 16 processadores • Quantas operações soma são realizadas? • Qual o ganho em relação à solução usando um único processador? 1 a jecompp
Programação Paralela 21 Uma Solução 1 a jecompp
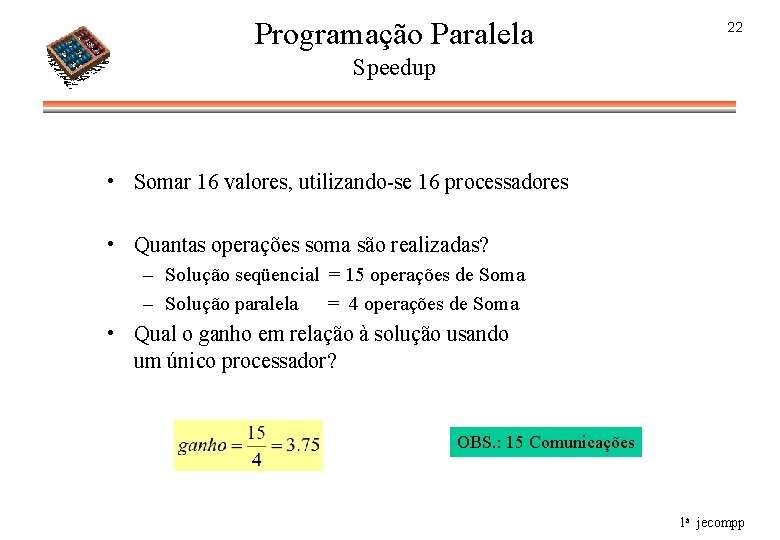
Programação Paralela 22 Speedup • Somar 16 valores, utilizando-se 16 processadores • Quantas operações soma são realizadas? – Solução seqüencial = 15 operações de Soma – Solução paralela = 4 operações de Soma • Qual o ganho em relação à solução usando um único processador? OBS. : 15 Comunicações 1 a jecompp
23 Desempenho • Speedup - Ganho apresentado pela máquina paralela em relação a uma máquina seqüencial • Qual o comportamento do speedup com o aumento do número de processadores? – Ideal: N – Realidade: menor que N 1 a jecompp
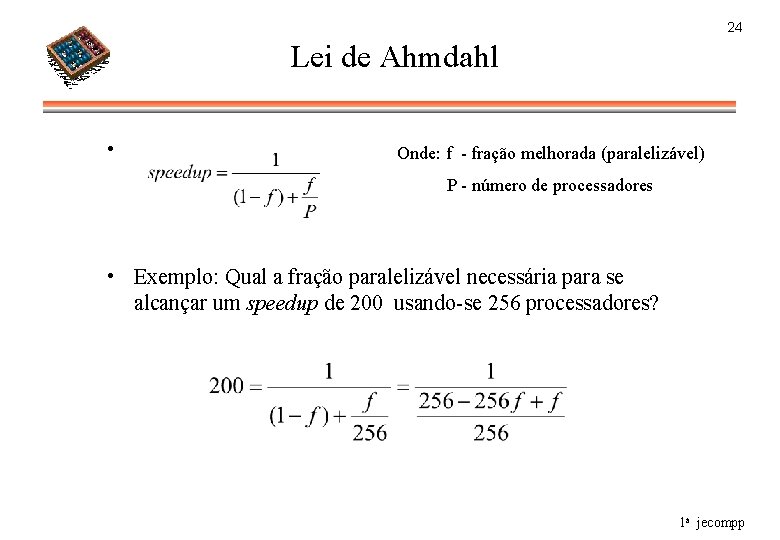
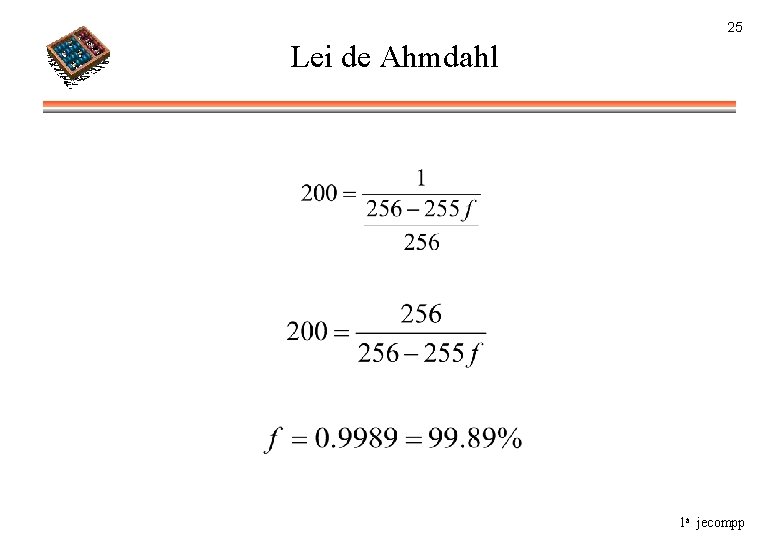
24 Lei de Ahmdahl • Onde: f - fração melhorada (paralelizável) P - número de processadores • Exemplo: Qual a fração paralelizável necessária para se alcançar um speedup de 200 usando-se 256 processadores? 1 a jecompp
25 Lei de Ahmdahl 1 a jecompp
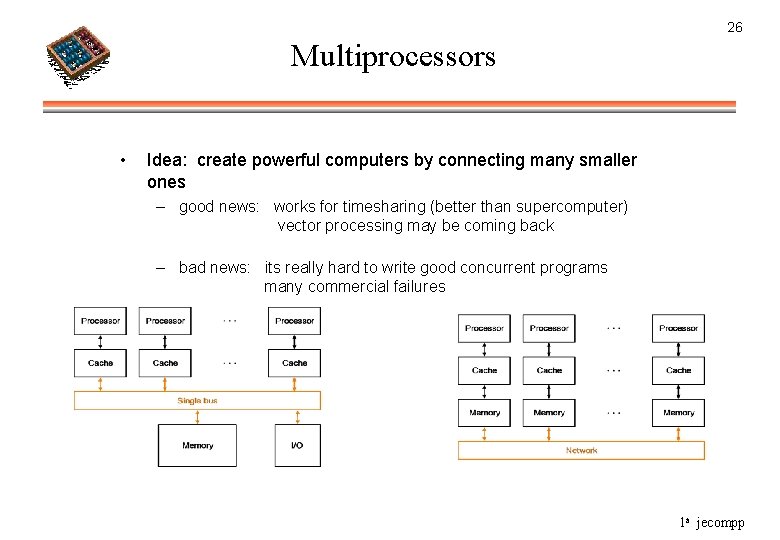
26 Multiprocessors • Idea: create powerful computers by connecting many smaller ones – good news: works for timesharing (better than supercomputer) vector processing may be coming back – bad news: its really hard to write good concurrent programs many commercial failures 1 a jecompp
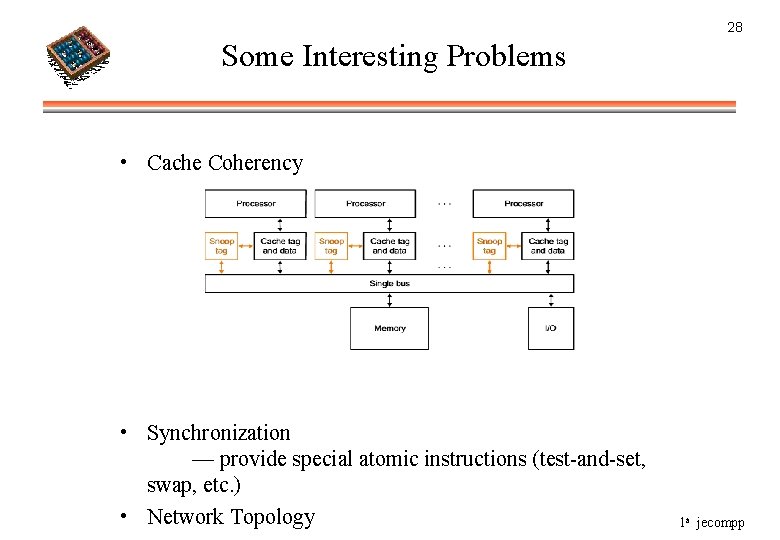
27 Questions • How do parallel processors share data? — single address space (SMP vs. NUMA) — message passing • How do parallel processors coordinate? — synchronization (locks, semaphores) — built into send / recieve primitives — operating system protocols • How are they implemented? — connected by a single bus — connected by a network 1 a jecompp
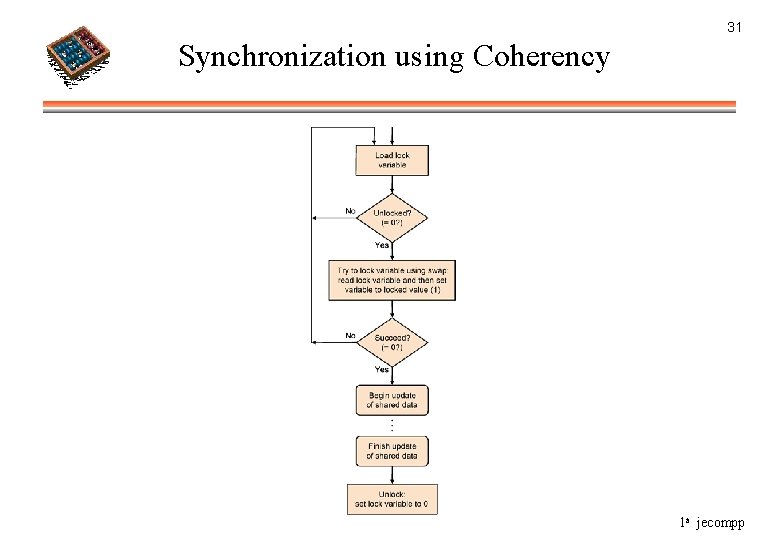
28 Some Interesting Problems • Cache Coherency • Synchronization — provide special atomic instructions (test-and-set, swap, etc. ) • Network Topology 1 a jecompp
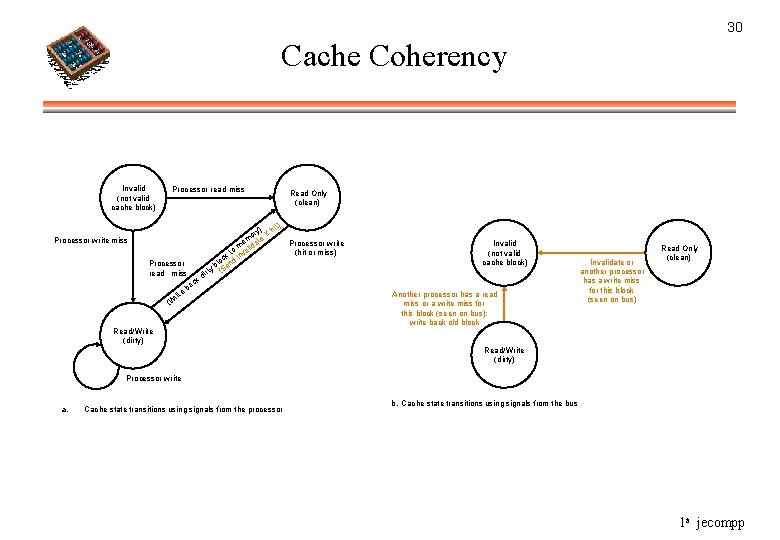
29 Cache Coherency • Most popular protocol - Snooping • Multiple Copies – read - processors must have the most recent copy – write - exclusive access • write-invalidate (write-back) • write-update (write-through) 1 a jecompp
30 Cache Coherency Invalid (not valid cache block) Processor read miss Processor write miss Processor read miss r (W it e ck ba Read Only (clean) t) y) hi or e i f em t Processor write m ida t o nval (hit or miss) k i c lo end b rty (S di Read/Write (dirty) Invalid (not valid cache block) Another processor has a read miss or a write miss for this block (seen on bus); write back old block Invalidate or another processor has a write miss for this block (seen on bus) Read Only (clean) Read/Write (dirty) Processor write a. Cache state transitions using signals from the processor b. Cache state transitions using signals from the bus 1 a jecompp
31 Synchronization using Coherency 1 a jecompp
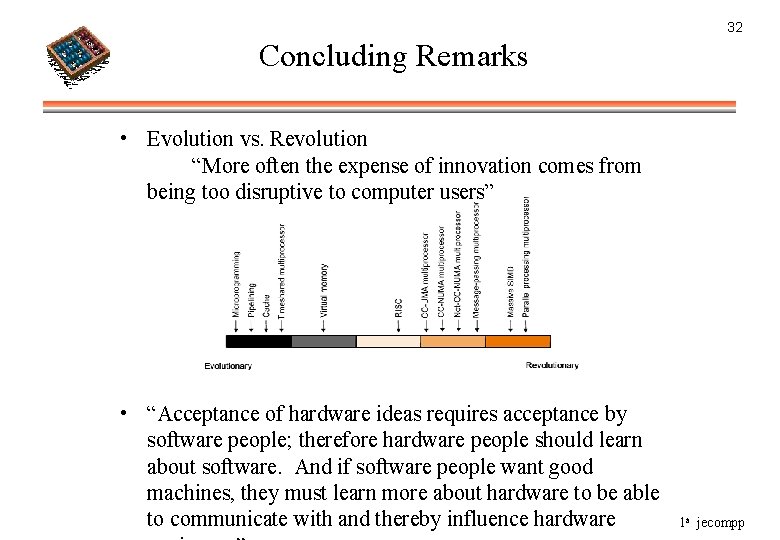
32 Concluding Remarks • Evolution vs. Revolution “More often the expense of innovation comes from being too disruptive to computer users” • “Acceptance of hardware ideas requires acceptance by software people; therefore hardware people should learn about software. And if software people want good machines, they must learn more about hardware to be able to communicate with and thereby influence hardware 1 a jecompp