GEOSTATYSTYKA I ANALIZA PRZESTRZENNA Wykad dla III roku
- Slides: 50
GEOSTATYSTYKA I ANALIZA PRZESTRZENNA Wykład dla III roku Geografii specjalność - geoinformacja Alfred Stach Instytut Geoekologii i Geoinformacji Wydział Nauk Geograficznych i Geologicznych UAM
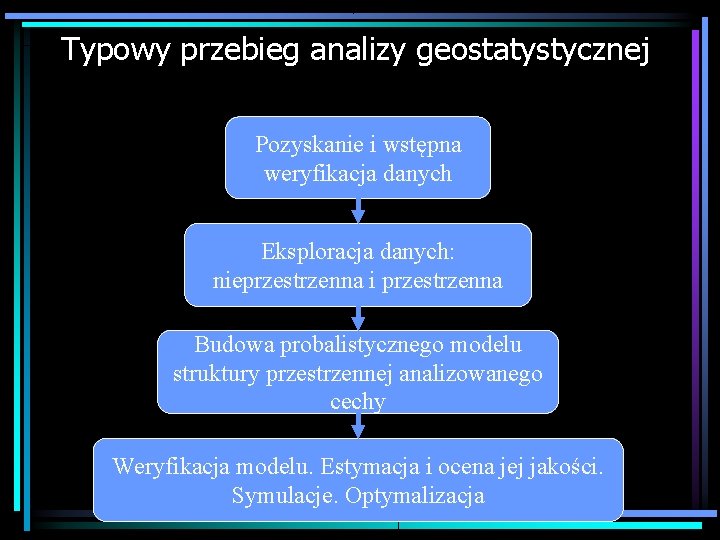
Typowy przebieg analizy geostatystycznej Pozyskanie i wstępna weryfikacja danych Eksploracja danych: nieprzestrzenna i przestrzenna Budowa probalistycznego modelu struktury przestrzennej analizowanego cechy Weryfikacja modelu. Estymacja i ocena jej jakości. Symulacje. Optymalizacja
Eksploracyjna analiza danych • Ogólne informacje o danych źródłowych: – ogólna charakterystyka zjawiska/zjawisk generującego przestrzenną/czasową zmienność analizowanej cechy/cech – typ próbkowania: przestrzenny i czasowy – relacja lokalizacji próbek do głównych czynników zmienność przestrzennej / czasowej analizowanej cechy / cech – jednolitość metodyki; źródła i rozmiary błędów pomiarowych
Eksploracyjna analiza danych • Nieprzestrzenna jednej zmiennej: – typ rozkładu: jedno-, wielomodalny – typ rozkładu: symetryczny (potencjalnie normalny), asymetryczny (skośny) – istnienie danych globalnie odstających (ekstremów) • Nieprzestrzenna dwóch zmiennych: – typ i siła korelacji zmiennych ilościowych – istotność różnic grup zmiennej/ych ilościowych wyróżnionych względem zmiennej jakościowej
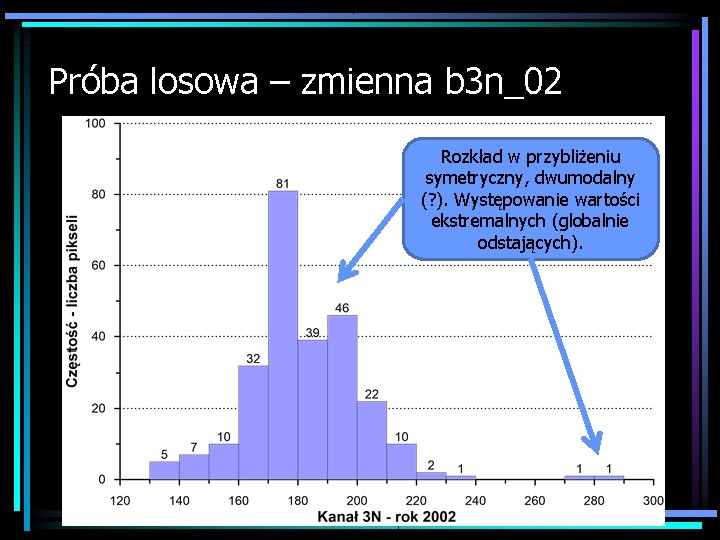
Próba losowa – zmienna b 3 n_02 Rozkład w przybliżeniu symetryczny, dwumodalny (? ). Występowanie wartości ekstremalnych (globalnie odstających).
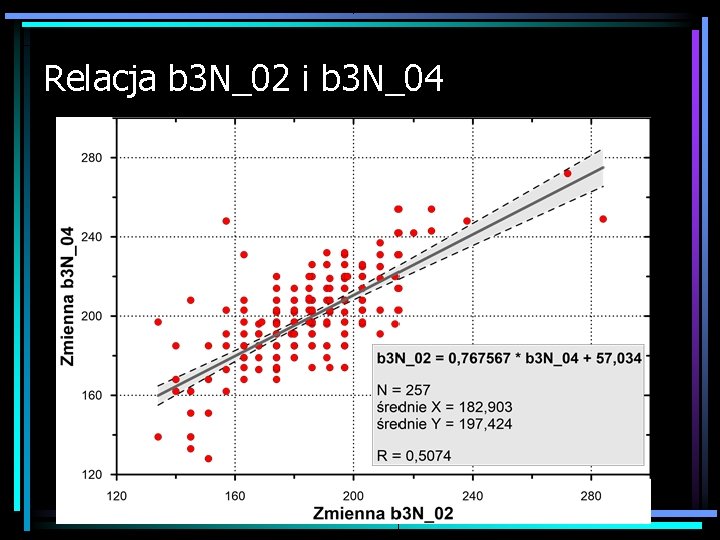
Relacja b 3 N_02 i b 3 N_04
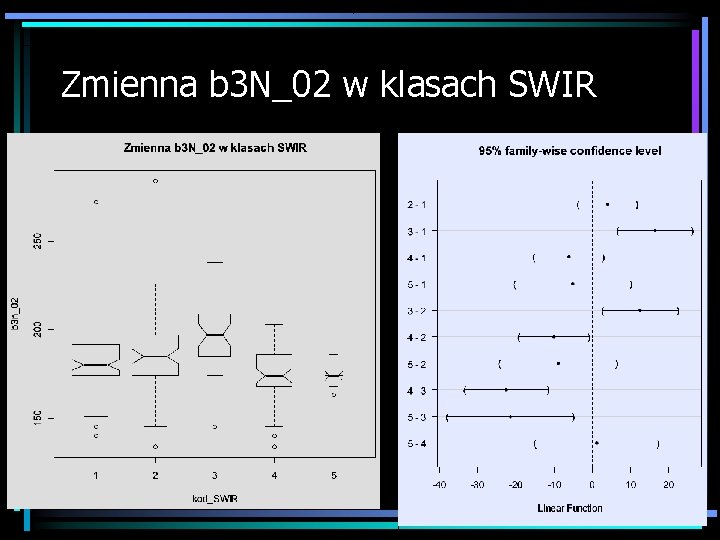
Zmienna b 3 N_02 w klasach SWIR
Eksploracyjna analiza danych • Przestrzenna jednej zmiennej: – typ próbkowania – istnienie danych lokalnie odstających; potencjalne przyczyny – ogólny pogląd na zmienność przestrzenną, wykorzystanie prostej automatycznej procedury interpolacji – istnienie efektu proporcjonalności lokalnej średniej/wariancji – rozgrupowanie danych przy próbkowaniu preferencyjnym
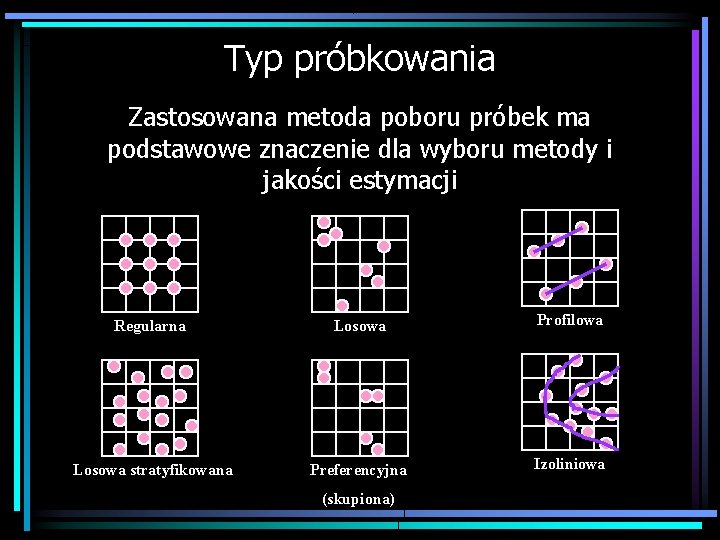
Typ próbkowania Zastosowana metoda poboru próbek ma podstawowe znaczenie dla wyboru metody i jakości estymacji Regularna Losowa Profilowa Losowa stratyfikowana Preferencyjna Izoliniowa (skupiona)
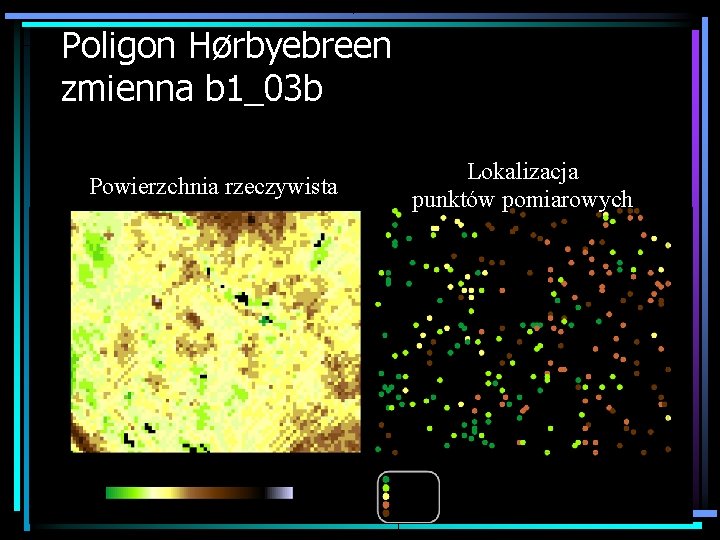
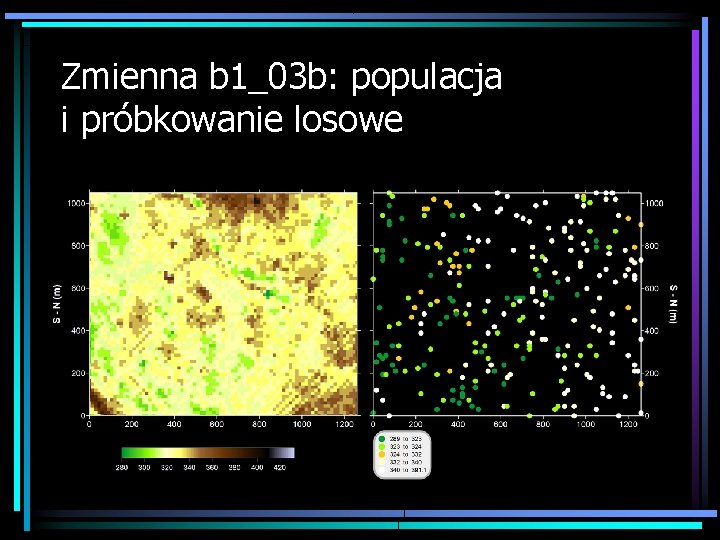
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Lokalizacja punktów pomiarowych
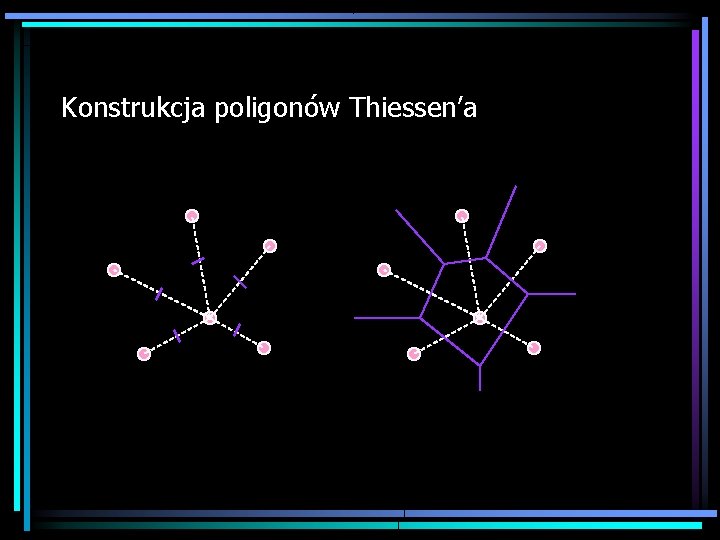
Polygony Thiessen’a • Poligony Thiessen’a (Voronoi): – • Założenie, że wartości cechy w nie opróbowanych lokalizacjach są równe wartościom dla najbliżej położonego punktu pomiarowego Metoda wektorowa – – Regularnie rozmieszczone punkty dają w tej metodzie regularną siatkę poligonów Punkty rozproszone (nieregularnie rozrzucone) powodują powstanie siatki nieregularnych poligonów
Konstrukcja poligonów Thiessen’a
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – poligony Thiessena
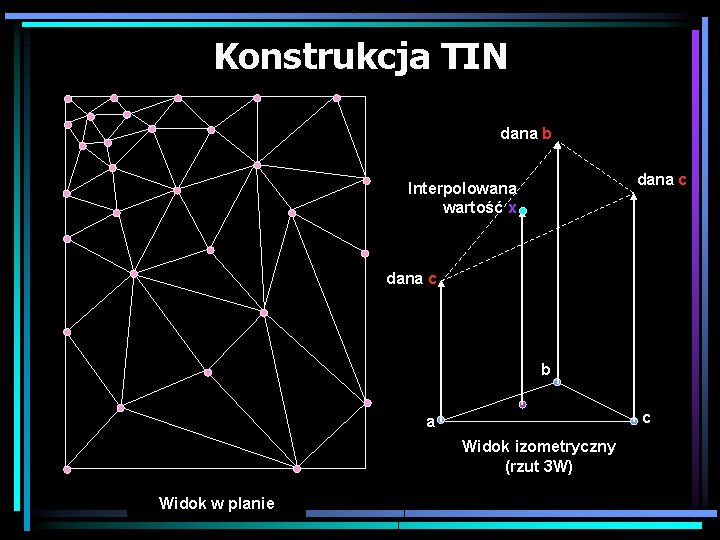
Traingulacja (TIN) • Inna metoda wektorowa często stosowana do tworzenia cyfrowych modeli rzeźby terenu (digital terrain models - DTM) – Sąsiadujące punkty są łączone liniami (krawędziami), i w efekcie powstaje siatka nieregularnych trójkątów • Obliczenia rzeczywistej odległości między punktami danych w przestrzeni trójwymiarowej przy pomocy trygonometrii • Obliczenia interpolowanej wartości z położenia na płaszczyźnie przechodzącej przez trzy sąsiadujące ze sobą punkty pomiarowe
Konstrukcja TIN dana b dana c Interpolowana wartość x dana c b c a Widok izometryczny (rzut 3 W) Widok w planie
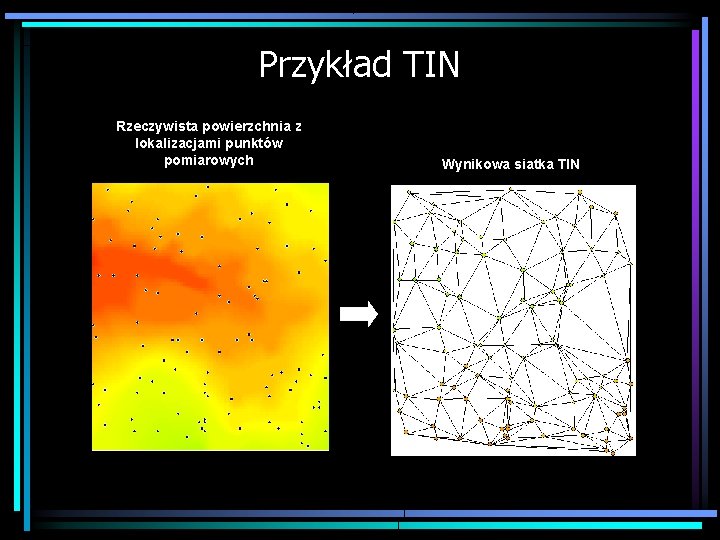
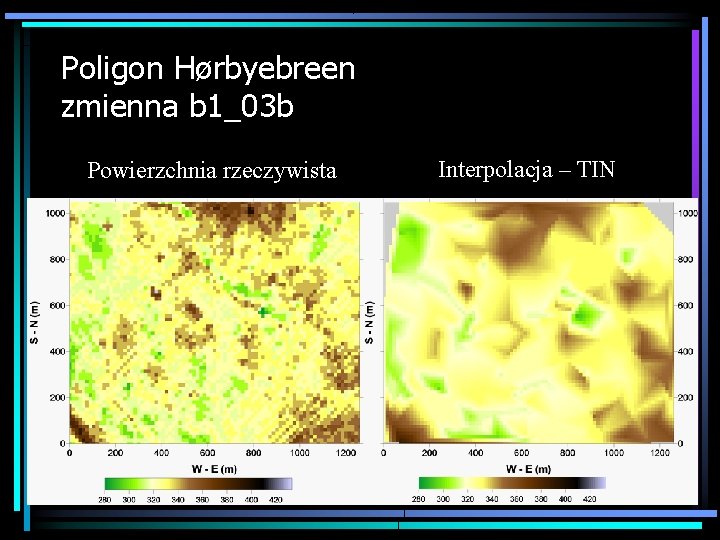
Przykład TIN Rzeczywista powierzchnia z lokalizacjami punktów pomiarowych Wynikowa siatka TIN
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – TIN
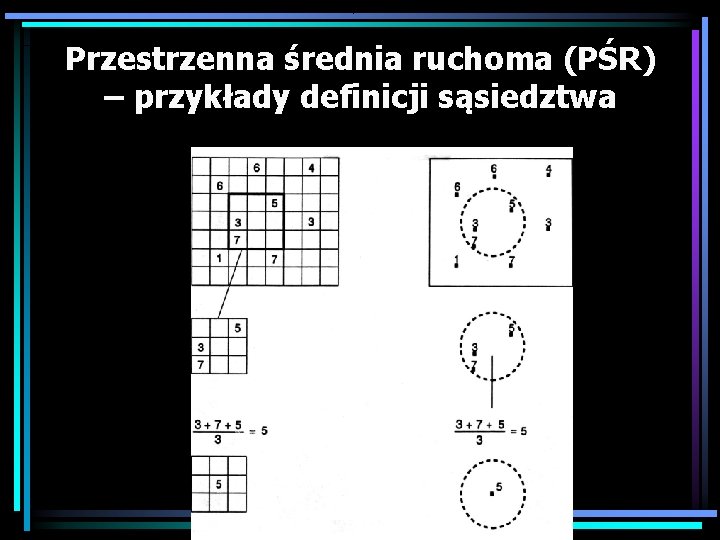
Przestrzenna średnia ruchoma • Metoda mająca zastosowanie zarówno dla danych wektorowych, jak i rastrowych: – – – Bardzo popularna w GIS Oblicza nieznaną wartość cechy dla określonej lokalizacji na podstawie zakresu wartości dla najbliżej lezących punktów pomiarowych Kryteria „sąsiedztwa” do obliczeń są określane za pomocą reguły wprowadzanej przez operatora: • Wielkość, kształt sąsiedztwa i/lub charakter danych
Przestrzenna średnia ruchoma (PŚR) – przykłady definicji sąsiedztwa
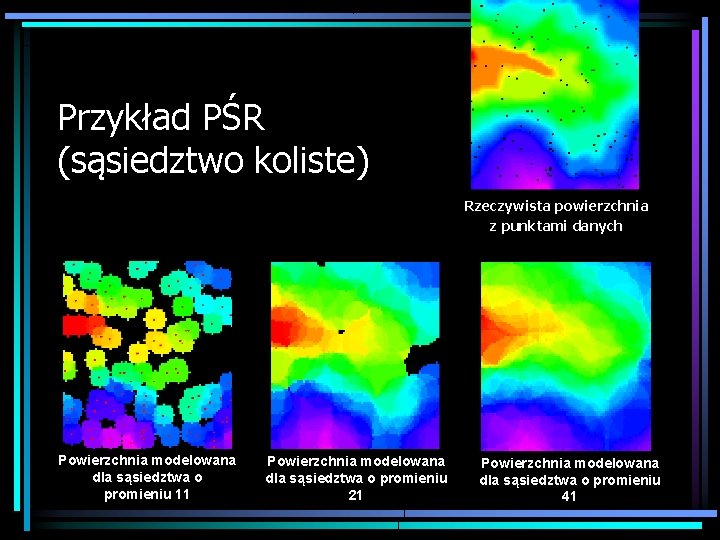
Przykład PŚR (sąsiedztwo koliste) Rzeczywista powierzchnia z punktami danych Powierzchnia modelowana dla sąsiedztwa o promieniu 11 Powierzchnia modelowana dla sąsiedztwa o promieniu 21 Powierzchnia modelowana dla sąsiedztwa o promieniu 41
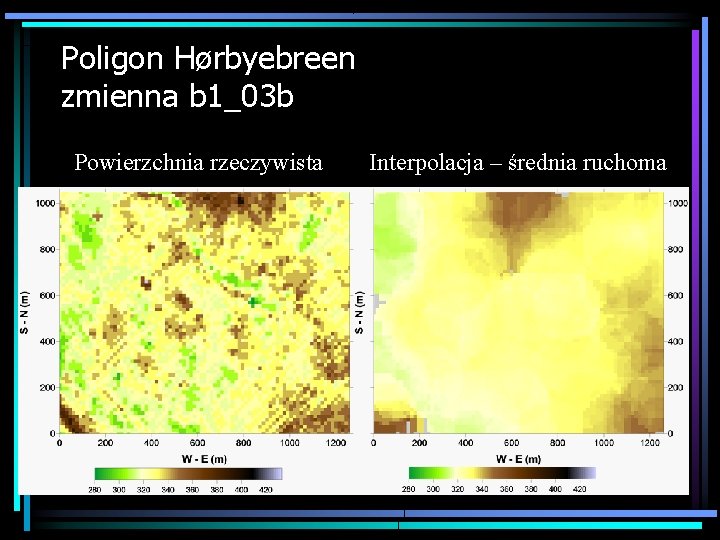
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – średnia ruchoma
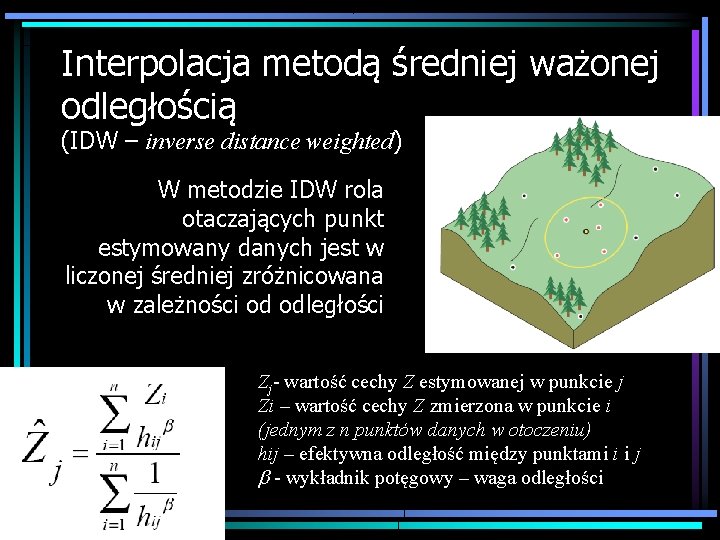
Interpolacja metodą średniej ważonej odległością (IDW – inverse distance weighted) W metodzie IDW rola otaczających punkt estymowany danych jest w liczonej średniej zróżnicowana w zależności od odległości Zj- wartość cechy Z estymowanej w punkcie j Zi – wartość cechy Z zmierzona w punkcie i (jednym z n punktów danych w otoczeniu) hij – efektywna odległość między punktami i i j - wykładnik potęgowy – waga odległości
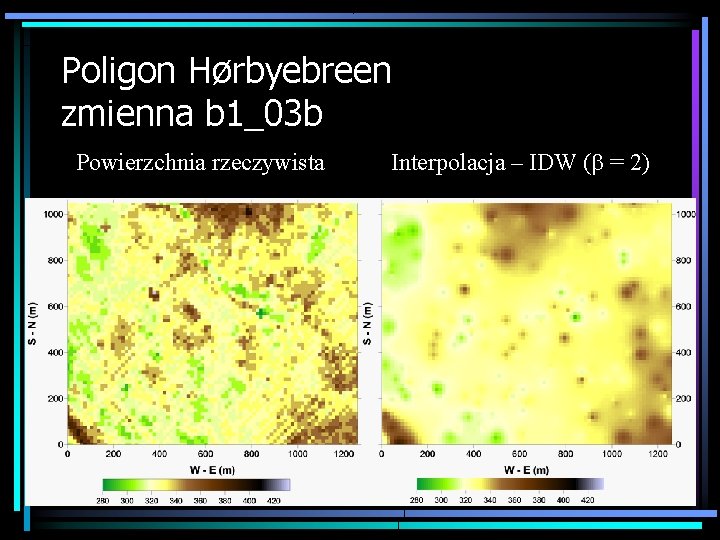
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – IDW ( = 2)
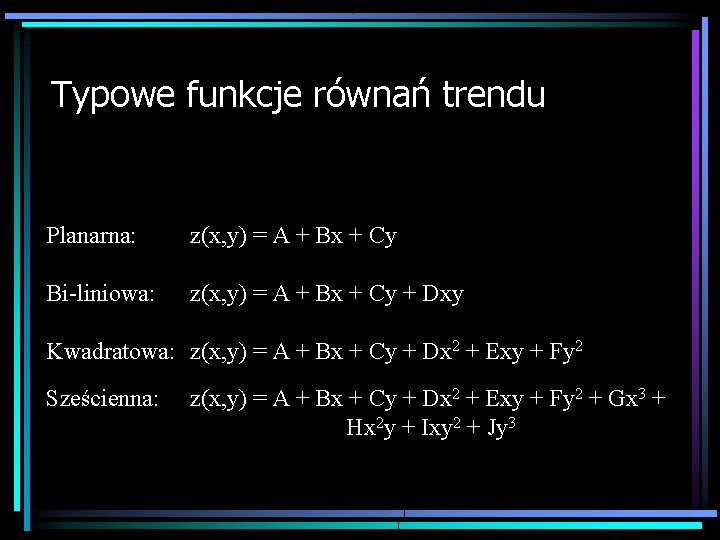
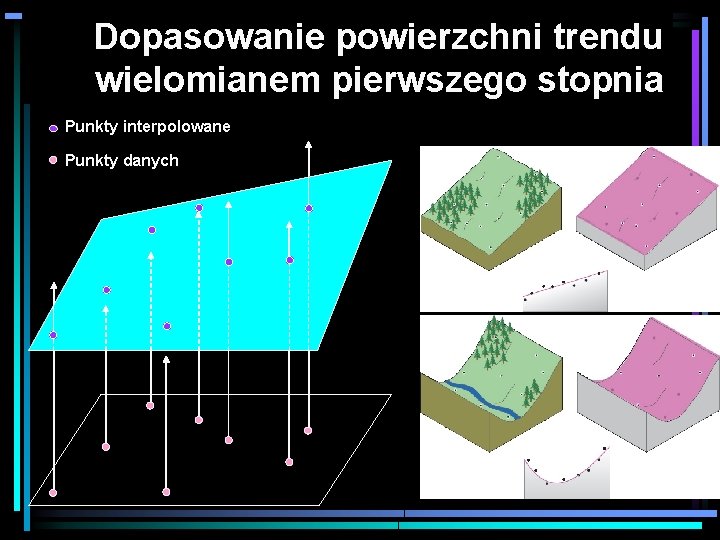
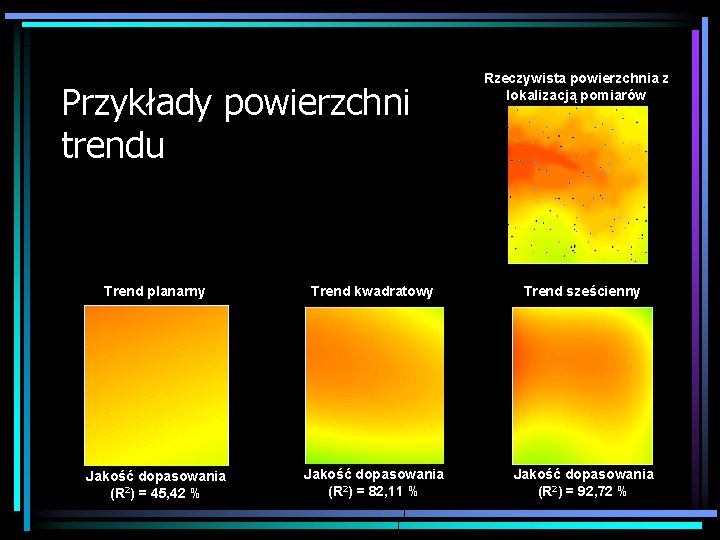
Powierzchnie trendu • Wykorzystanie regresji wielomianowej aby dopasować metodą najmniejszych kwadratów powierzchnię do punktów danych – Zazwyczaj operator może decydować o stopniu wielomianu stosowanego w dopasowaniu powierzchni – Wraz ze wzrostem stopnia wielomianu dopasowywana powierzchnia staje się coraz bardziej skomplikowana • Nie zawsze wielomian wyższego stopnia generuje powierzchnię bardziej dokładną – jest to uzależnione od charakteru danych • Im niższy błąd RMS tym lepiej interpolowana powierzchnia odwzorowuje punkty danych • Najczęściej stosuje się wielomiany od 1 do 3 rzędu
Typowe funkcje równań trendu Planarna: z(x, y) = A + Bx + Cy Bi-liniowa: z(x, y) = A + Bx + Cy + Dxy Kwadratowa: z(x, y) = A + Bx + Cy + Dx 2 + Exy + Fy 2 Sześcienna: z(x, y) = A + Bx + Cy + Dx 2 + Exy + Fy 2 + Gx 3 + Hx 2 y + Ixy 2 + Jy 3
Dopasowanie powierzchni trendu wielomianem pierwszego stopnia Punkty interpolowane Punkty danych
Przykłady powierzchni trendu Rzeczywista powierzchnia z lokalizacją pomiarów Trend planarny Trend kwadratowy Trend sześcienny Jakość dopasowania (R 2) = 45, 42 % Jakość dopasowania (R 2) = 82, 11 % Jakość dopasowania (R 2) = 92, 72 %
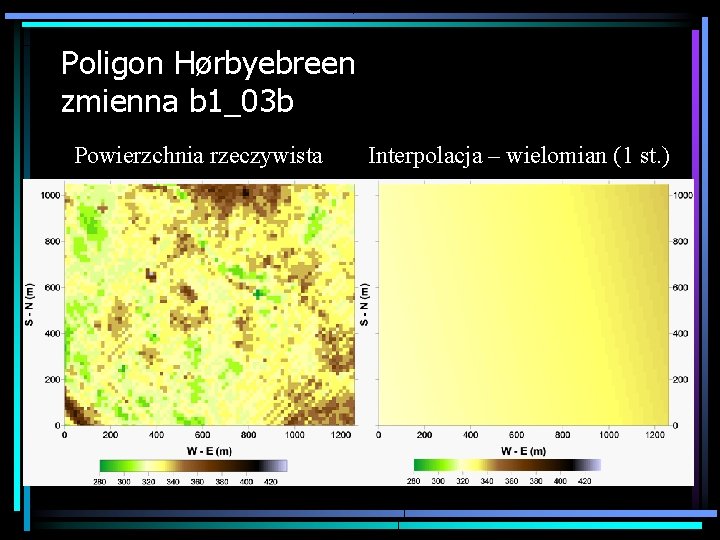
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – wielomian (1 st. )
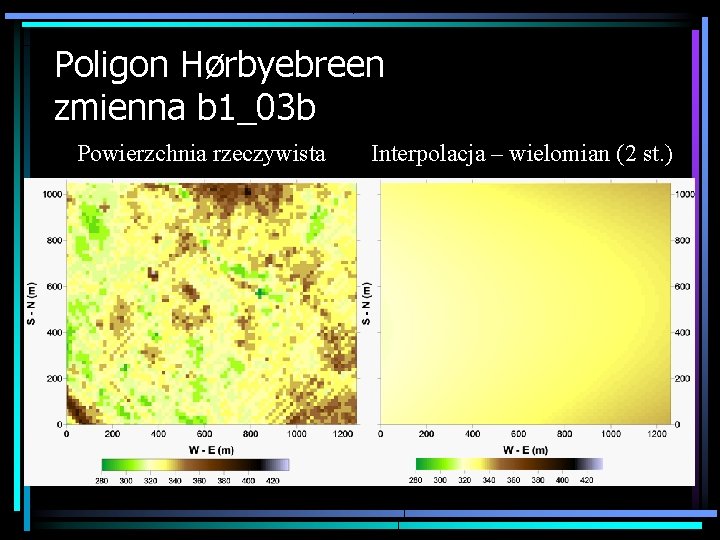
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – wielomian (2 st. )
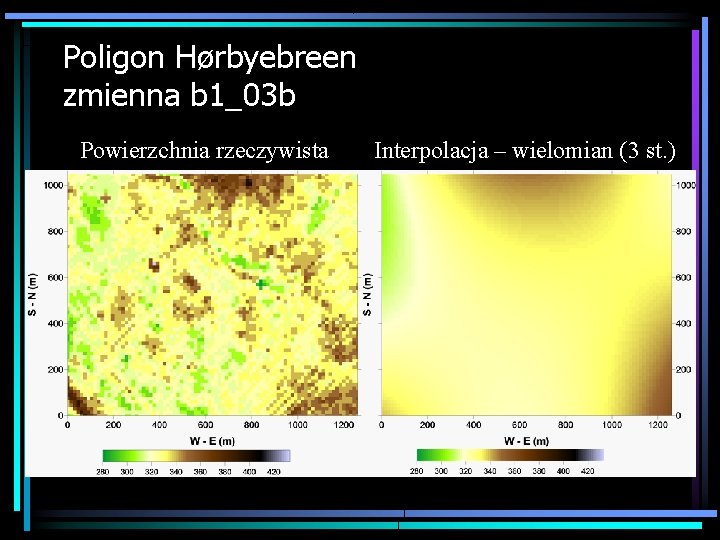
Poligon Hørbyebreen zmienna b 1_03 b Powierzchnia rzeczywista Interpolacja – wielomian (3 st. )
Eksploracyjna analiza danych • Przestrzenna jednej zmiennej: – typ próbkowania – istnienie danych lokalnie odstających; potencjalne przyczyny – ogólny pogląd na zmienność przestrzenną, wykorzystanie prostej automatycznej procedury interpolacji – istnienie efektu proporcjonalności lokalnej średniej/wariancji – rozgrupowanie danych przy próbkowaniu preferencyjnym
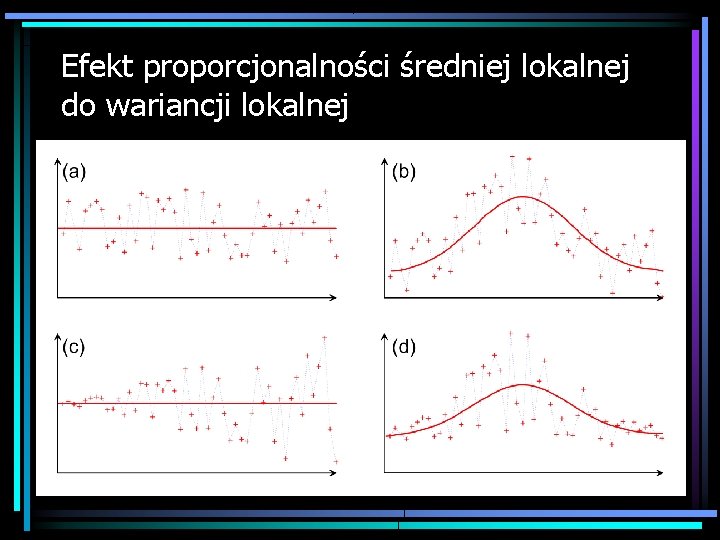
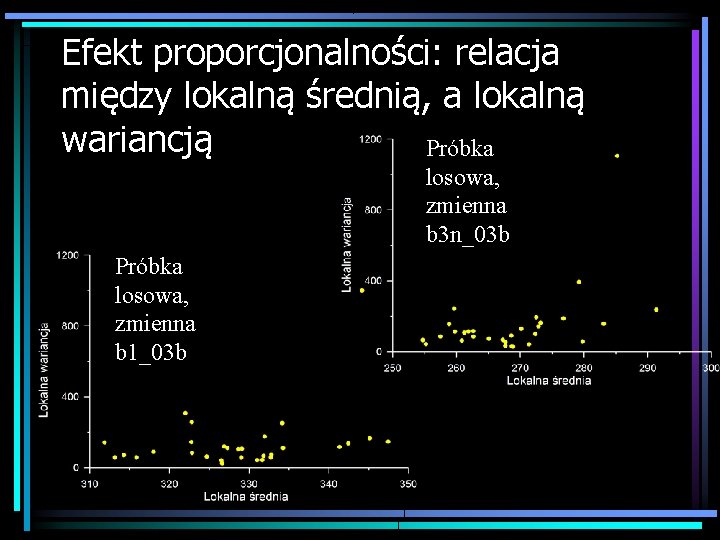
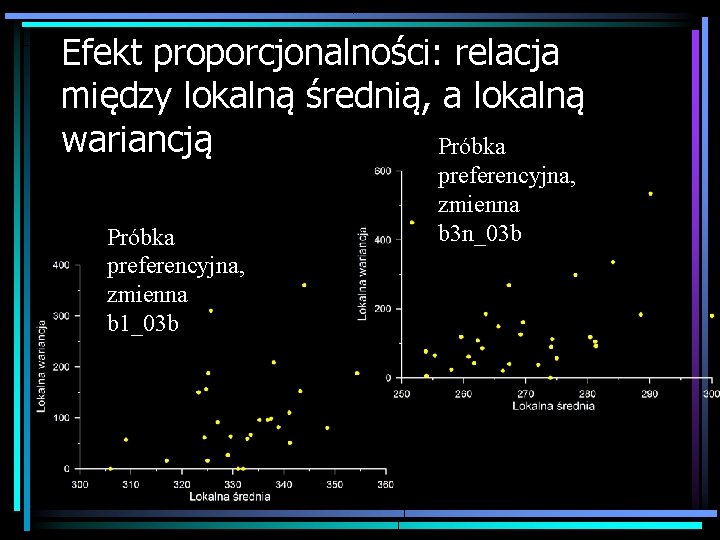
Efekt proporcjonalności średniej lokalnej do wariancji lokalnej
Zmienna b 1_03 b: populacja i próbkowanie losowe
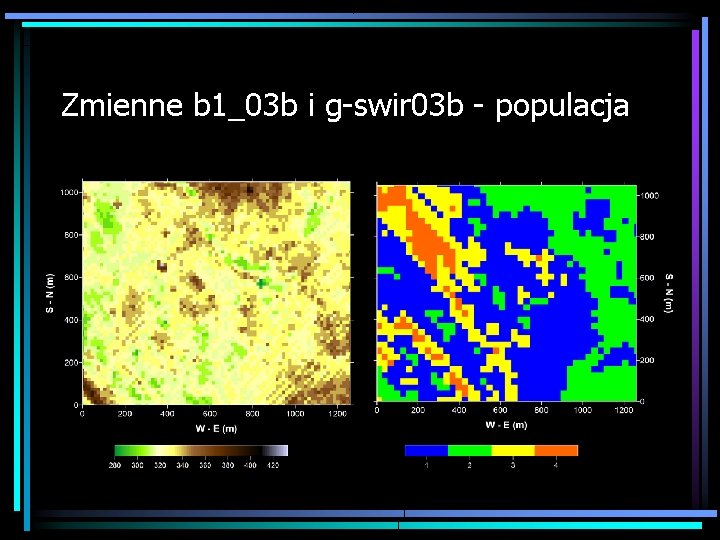
Zmienne b 1_03 b i g-swir 03 b - populacja
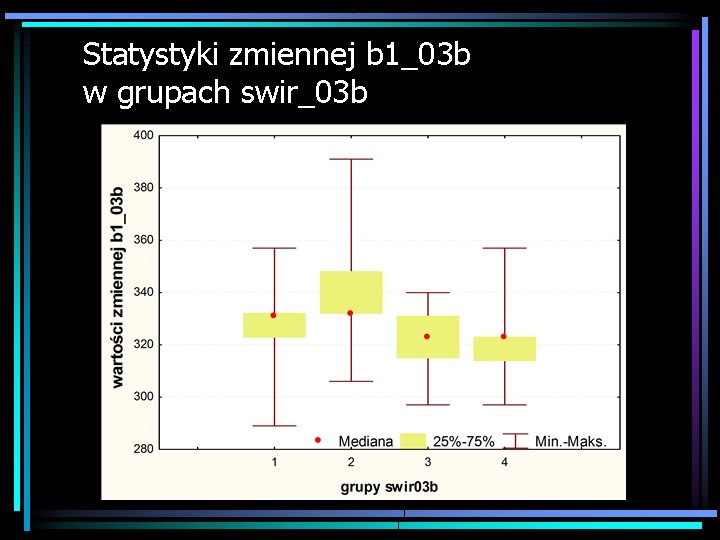
Statystyki zmiennej b 1_03 b w grupach swir_03 b
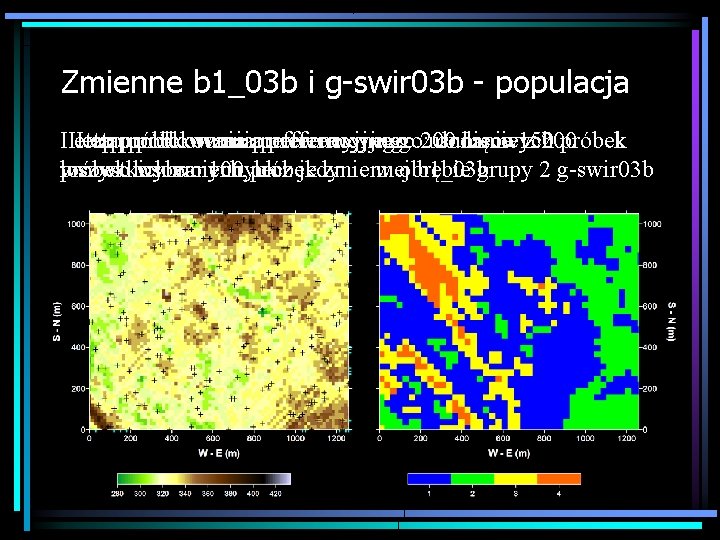
Zmienne b 1_03 b i g-swir 03 b - populacja IIIetappróbkowaniapreferencyjnego: 200 usunięcie dodanie losowych 150 z 200 próbek losowo wszystkich wybranych, zmiennych 100 próbek lecz jedynie zmiennej w obrębie b 1_03 b grupy 2 g-swir 03 b
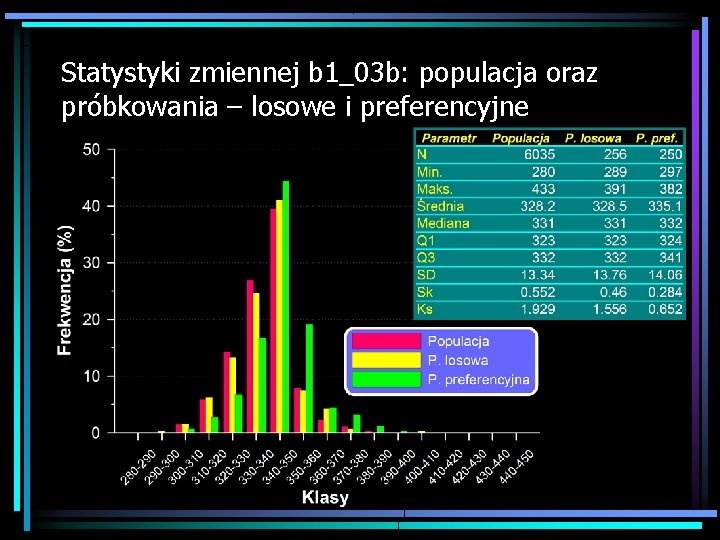
Statystyki zmiennej b 1_03 b: populacja oraz próbkowania – losowe i preferencyjne
Efekt proporcjonalności: relacja między lokalną średnią, a lokalną wariancją Próbka losowa, zmienna b 3 n_03 b Próbka losowa, zmienna b 1_03 b
Efekt proporcjonalności: relacja między lokalną średnią, a lokalną wariancją Próbka preferencyjna, zmienna b 1_03 b preferencyjna, zmienna b 3 n_03 b
Eksploracyjna analiza danych • Przestrzenna jednej zmiennej: – typ próbkowania – istnienie danych lokalnie odstających; potencjalne przyczyny – ogólny pogląd na zmienność przestrzenną, wykorzystanie prostej automatycznej procedury interpolacji – istnienie efektu proporcjonalności lokalnej średniej/wariancji – rozgrupowanie danych przy próbkowaniu preferencyjnym
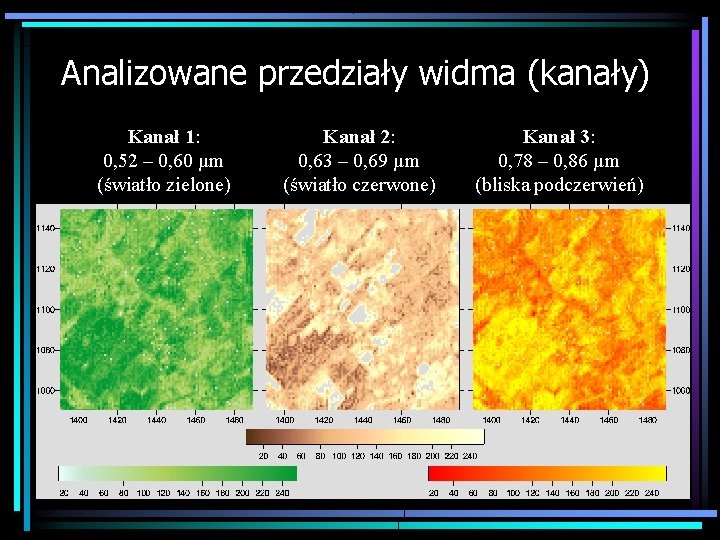
Analizowane przedziały widma (kanały) Kanał 1: 0, 52 – 0, 60 µm (światło zielone) Kanał 2: 0, 63 – 0, 69 µm (światło czerwone) Kanał 3: 0, 78 – 0, 86 µm (bliska podczerwień)
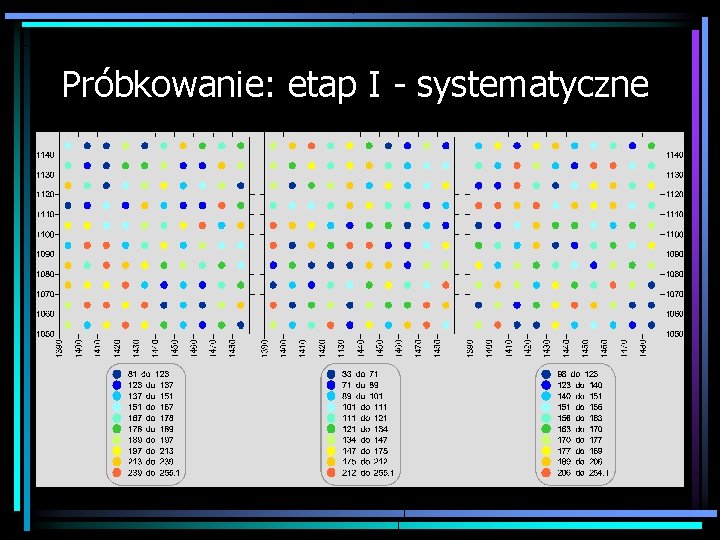
Próbkowanie: etap I - systematyczne
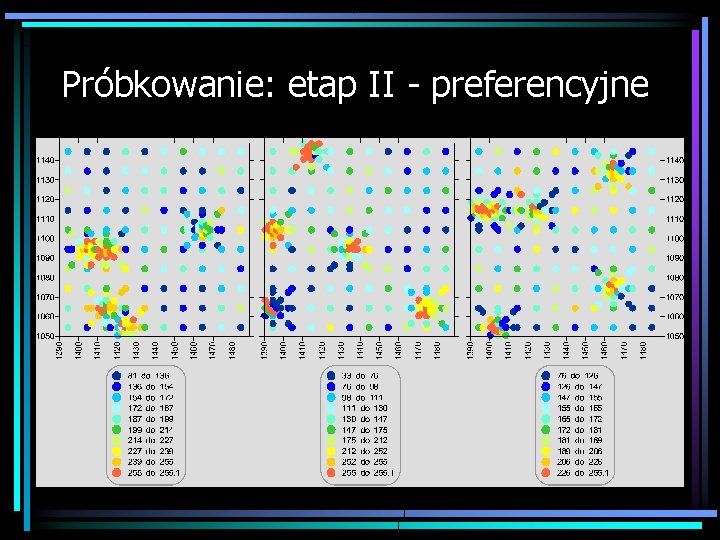
Próbkowanie: etap II - preferencyjne
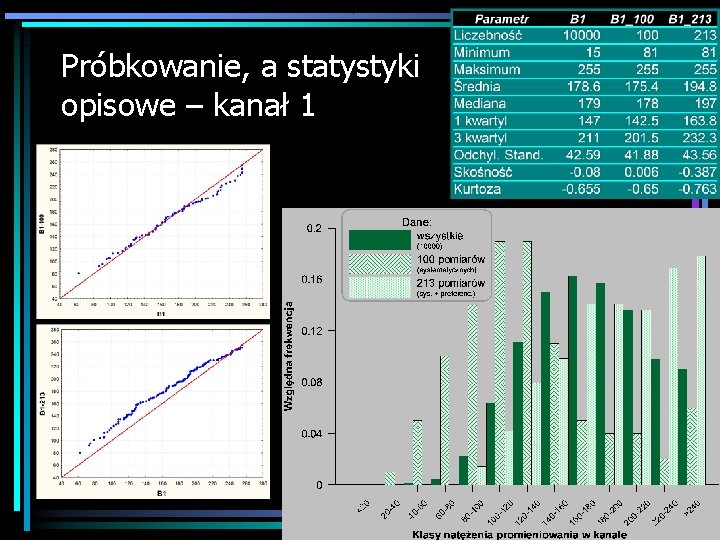
Próbkowanie, a statystyki opisowe – kanał 1
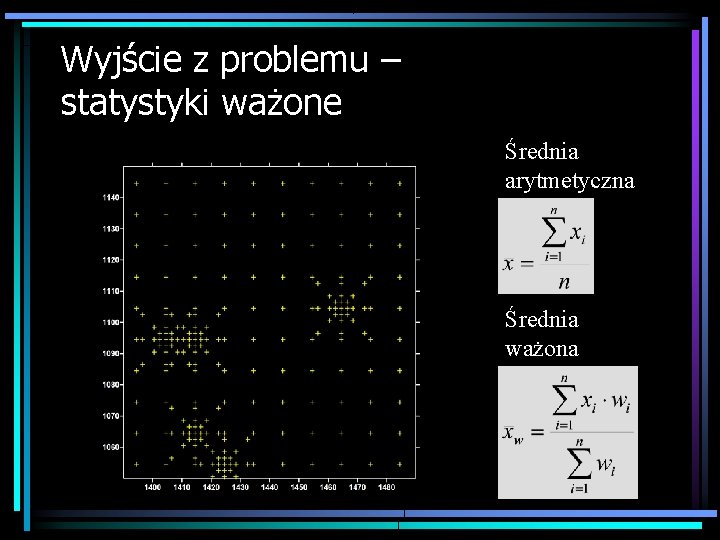
Wyjście z problemu – statystyki ważone Średnia arytmetyczna Średnia ważona
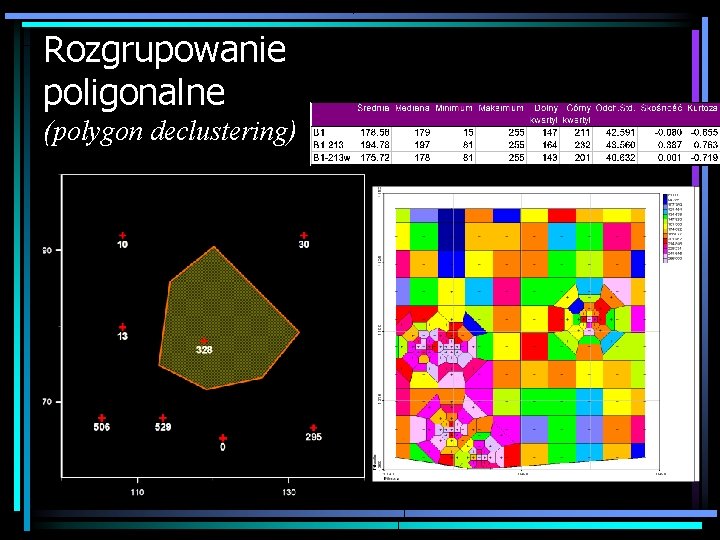
Rozgrupowanie poligonalne (polygon declustering)
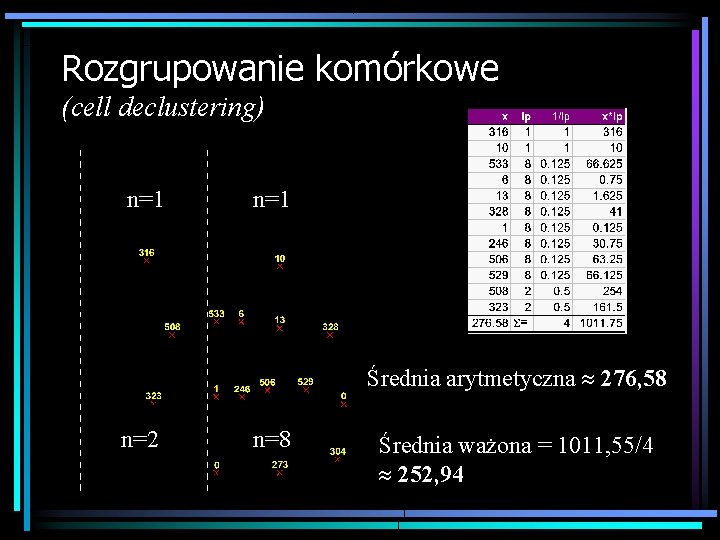
Rozgrupowanie komórkowe (cell declustering) n=1 Średnia arytmetyczna » 276, 58 n=2 n=8 Średnia ważona = 1011, 55/4 » 252, 94
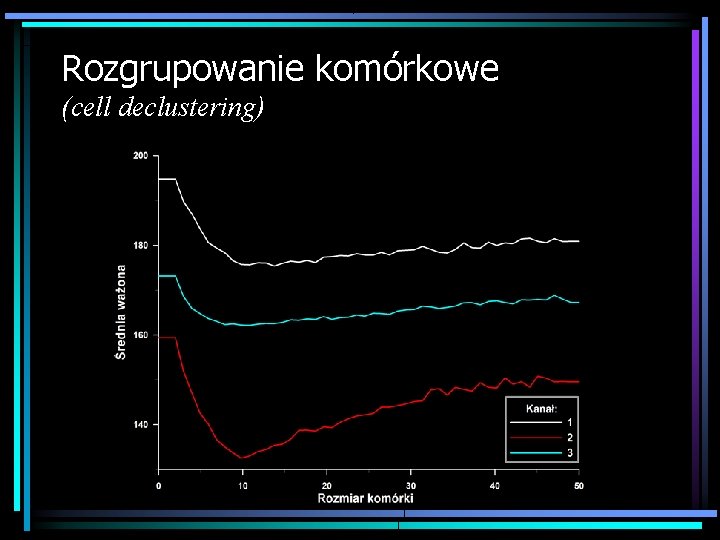
Rozgrupowanie komórkowe (cell declustering)
Zmienna zregionalizowana (ang. regionalized variable) • Zmienna zregionalizowana to podstawowe pojęcie geostatystyki, które zostało zaproponowane przez G. Matherona w 1965 r. • Jest to zmienna rozłożona w przestrzeni, używana do opisu zjawisk zachodzących na pewnym obszarze. • Zmienne zregionalizowane mają właściwości pośrednie między zmiennymi losowymi i zmiennymi deterministycznymi • Z jednej strony charakteryzują się wzajemną korelacją związaną z przestrzennym rozkładem danego zjawiska, z drugiej zaś strony mogą być traktowane lokalnie, jako zmienne losowe - mające określony rozkład prawdopodobieństwa
Zmienna zregionalizowana (ang. regionalized variable) • Dwoistą naturę zmiennych zregionalizowanych wyraża najlepiej funkcja losowa zmiennej przestrzennej Z(x), będąca zbiorem zmiennych losowych, w różnych położeniach. Ma ona następujące własności: – lokalnie w danym punkcie wartość z(x) funkcji losowej Z(x) traktowana jest jako pewna realizacja zmiennej losowej, – w dowolnej parze punktów x. oraz x+h zmienne losowe Z(x. ) oraz Z(x. +h) są związane pewną zależnością korelacyjną wynikającą z przestrzennej ciągłości badanego zjawiska. • Przykładami zmiennych zregionalizowanych mogą być: zanieczyszczenie określoną substancją na pewnym obszarze, jasność spektralna pikseli na zdjęciu satelitarnym, temperatura powietrza, wilgotność gleby, natężenie określonego procesu społecznego lub gospodarczego na badanym obszarze.