Seminar Machine Learning WS 200304 Support Vector Regression
- Slides: 27
Seminar Machine Learning WS 2003/04 Support Vector Regression Sebastian Schneegans 1
Übersicht I. Konzept der Support Vector Regression Erläuterung der Problemstellung und der Lösungsideen, Formulieren der Aufgabe als Optimierungsproblem II. Lösen des Optimierungsproblems Aufstellen des Lagrangepolynoms, Ermitteln der Ebenengleichung und Anwenden des Kernel-Tricks III. Variationen der Support Vector Regression a) υ-SVR b) Weitere Variationen Support Vector Regression – Sebastian Schneegans 2
Teil I: Konzept der Support Vector Regression – Sebastian Schneegans 3
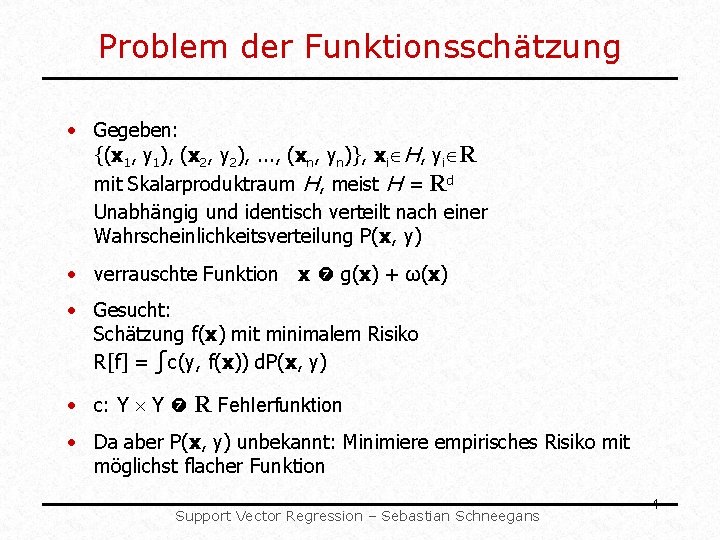
Problem der Funktionsschätzung • Gegeben: {(x 1, y 1), (x 2, y 2), . . . , (xn, yn)}, xi H, yi R mit Skalarproduktraum H, meist H = Rd Unabhängig und identisch verteilt nach einer Wahrscheinlichkeitsverteilung P(x, y) • verrauschte Funktion x g(x) + ω(x) • Gesucht: Schätzung f(x) mit minimalem Risiko R[f] = ∫c(y, f(x)) d. P(x, y) • c: Y Y R Fehlerfunktion • Da aber P(x, y) unbekannt: Minimiere empirisches Risiko mit möglichst flacher Funktion Support Vector Regression – Sebastian Schneegans 4
Grundidee der SVR Übertragung der Prinzipien von SVM auf die Funktionsschätzung: • Lineare Approximation durch Hyperebene der Form f(x) = w, x + b • Repräsentation durch (wenige) Support Vectors • Nicht-Linearität durch Kernel-Funktion Φ(xi), Φ(xj) = k(xi, xj) Support Vector Regression – Sebastian Schneegans 5
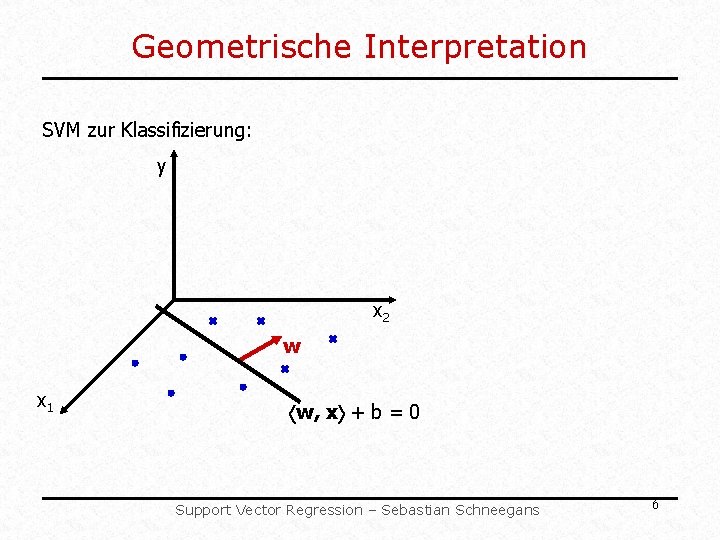
Geometrische Interpretation SVM zur Klassifizierung: y x 2 w x 1 w, x + b = 0 Support Vector Regression – Sebastian Schneegans 6
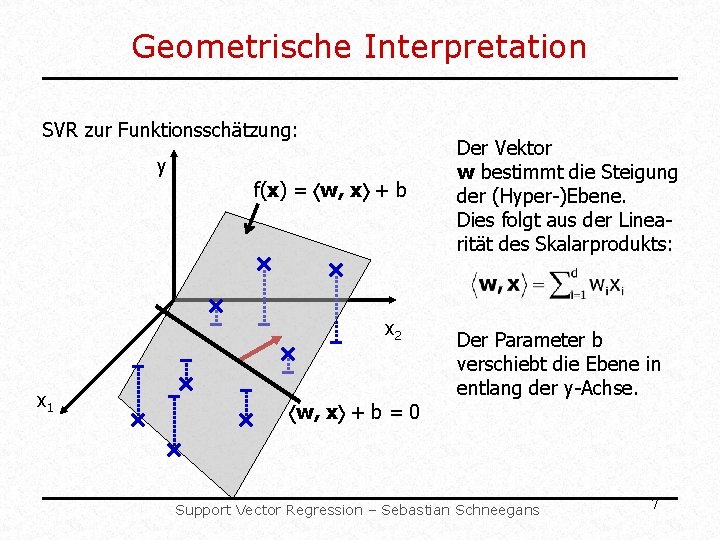
Geometrische Interpretation SVR zur Funktionsschätzung: y f(x) = w, x + b x 2 x 1 w, x + b = 0 Der Vektor w bestimmt die Steigung der (Hyper-)Ebene. Dies folgt aus der Linearität des Skalarprodukts: Der Parameter b verschiebt die Ebene in entlang der y-Achse. Support Vector Regression – Sebastian Schneegans 7
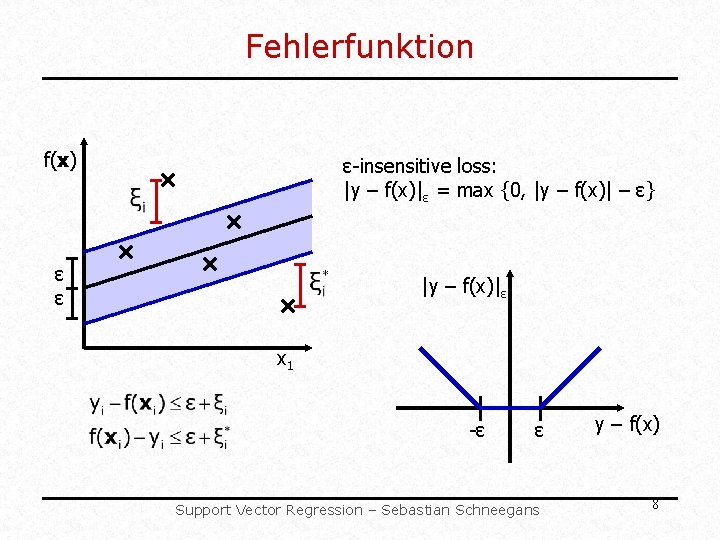
Fehlerfunktion f(x) ε-insensitive loss: |y – f(x)|ε = max {0, |y – f(x)| – ε} ε ε |y – f(x)|ε x 1 -ε ε Support Vector Regression – Sebastian Schneegans y – f(x) 8
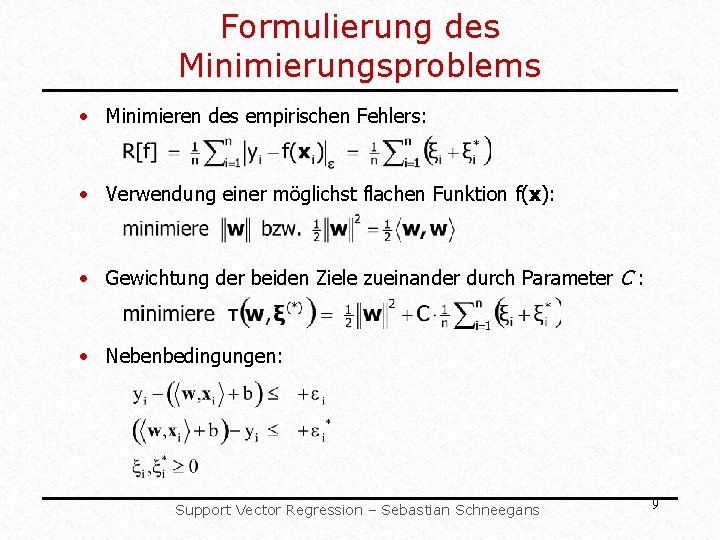
Formulierung des Minimierungsproblems • Minimieren des empirischen Fehlers: • Verwendung einer möglichst flachen Funktion f(x): • Gewichtung der beiden Ziele zueinander durch Parameter C : • Nebenbedingungen: Support Vector Regression – Sebastian Schneegans 9
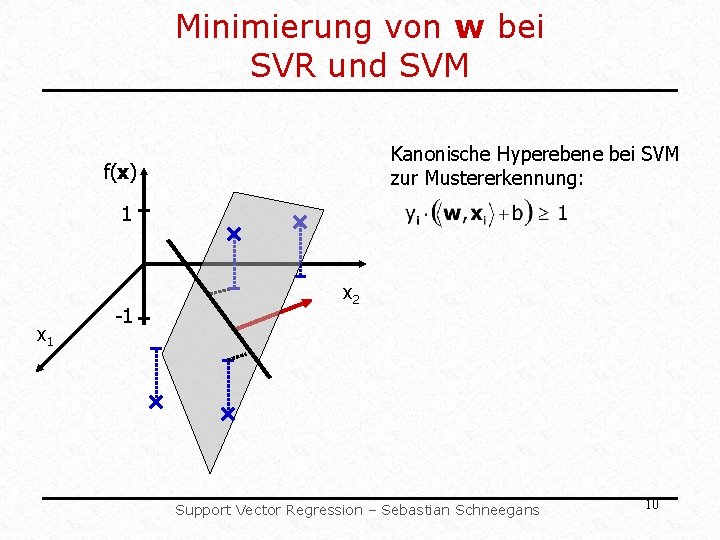
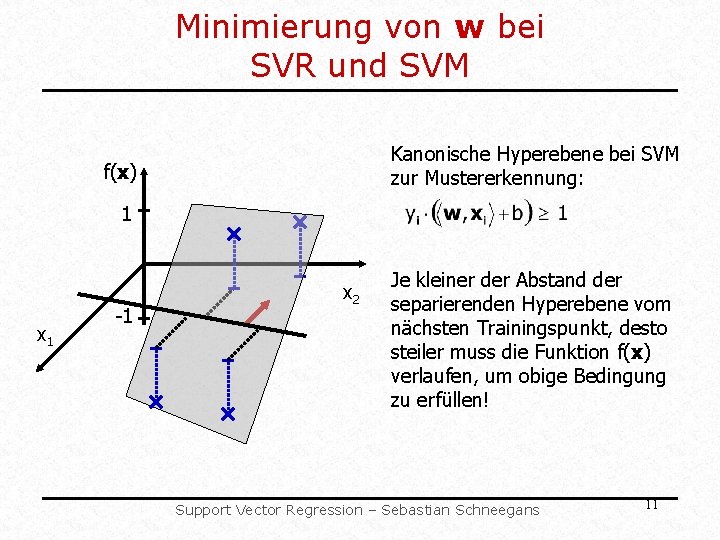
Minimierung von w bei SVR und SVM Kanonische Hyperebene bei SVM zur Mustererkennung: f(x) 1 x 1 -1 x 2 Support Vector Regression – Sebastian Schneegans 10
Minimierung von w bei SVR und SVM Kanonische Hyperebene bei SVM zur Mustererkennung: f(x) 1 x 1 -1 x 2 Je kleiner der Abstand der separierenden Hyperebene vom nächsten Trainingspunkt, desto steiler muss die Funktion f(x) verlaufen, um obige Bedingung zu erfüllen! Support Vector Regression – Sebastian Schneegans 11
Teil II: Lösen des Optimierungsproblems Support Vector Regression – Sebastian Schneegans 12
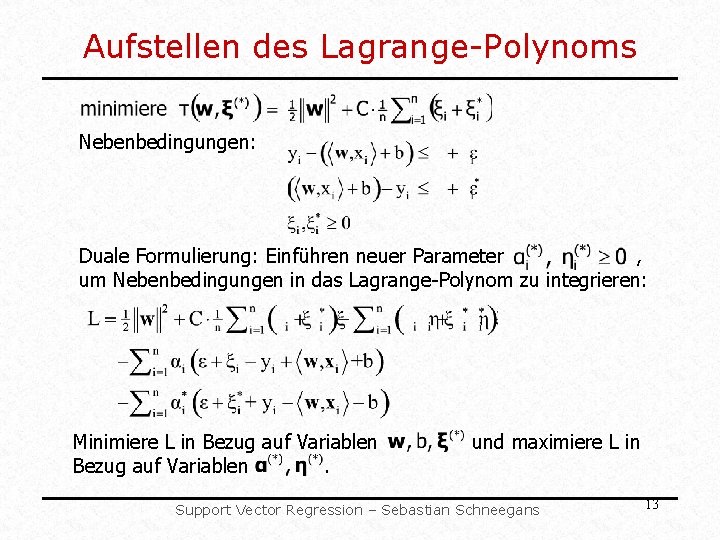
Aufstellen des Lagrange-Polynoms Nebenbedingungen: Duale Formulierung: Einführen neuer Parameter , um Nebenbedingungen in das Lagrange-Polynom zu integrieren: Minimiere L in Bezug auf Variablen. und maximiere L in Support Vector Regression – Sebastian Schneegans 13
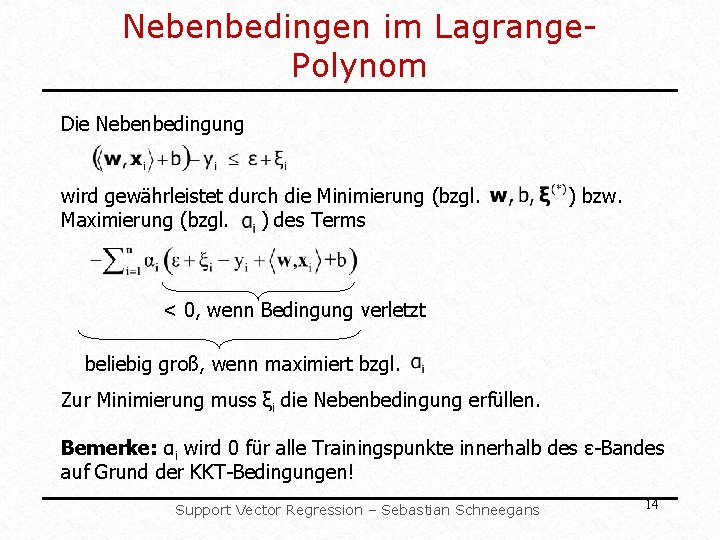
Nebenbedingen im Lagrange. Polynom Die Nebenbedingung wird gewährleistet durch die Minimierung (bzgl. Maximierung (bzgl. ) des Terms ) bzw. < 0, wenn Bedingung verletzt beliebig groß, wenn maximiert bzgl. Zur Minimierung muss ξi die Nebenbedingung erfüllen. Bemerke: αi wird 0 für alle Trainingspunkte innerhalb des ε-Bandes auf Grund der KKT-Bedingungen! Support Vector Regression – Sebastian Schneegans 14
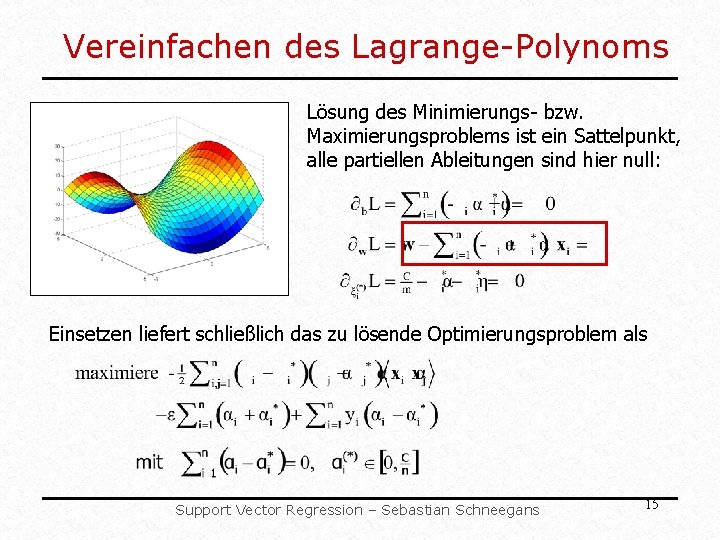
Vereinfachen des Lagrange-Polynoms Lösung des Minimierungs- bzw. Maximierungsproblems ist ein Sattelpunkt, alle partiellen Ableitungen sind hier null: Einsetzen liefert schließlich das zu lösende Optimierungsproblem als Support Vector Regression – Sebastian Schneegans 15
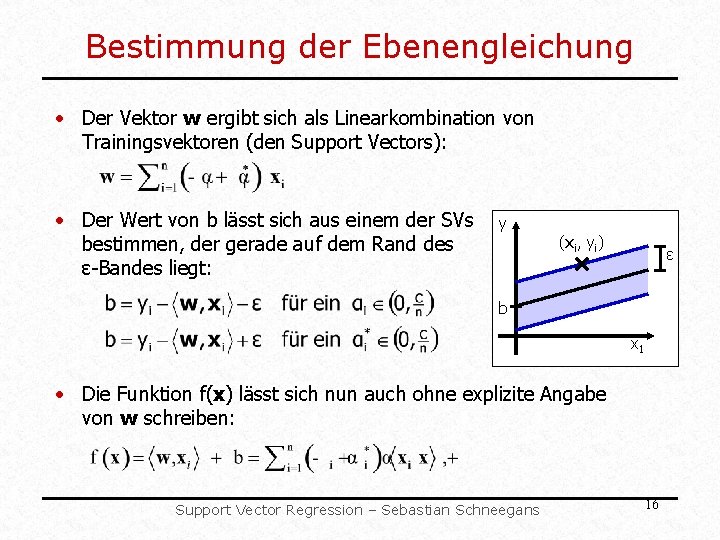
Bestimmung der Ebenengleichung • Der Vektor w ergibt sich als Linearkombination von Trainingsvektoren (den Support Vectors): • Der Wert von b lässt sich aus einem der SVs bestimmen, der gerade auf dem Rand des ε-Bandes liegt: y (xi, yi) ε b x 1 • Die Funktion f(x) lässt sich nun auch ohne explizite Angabe von w schreiben: Support Vector Regression – Sebastian Schneegans 16
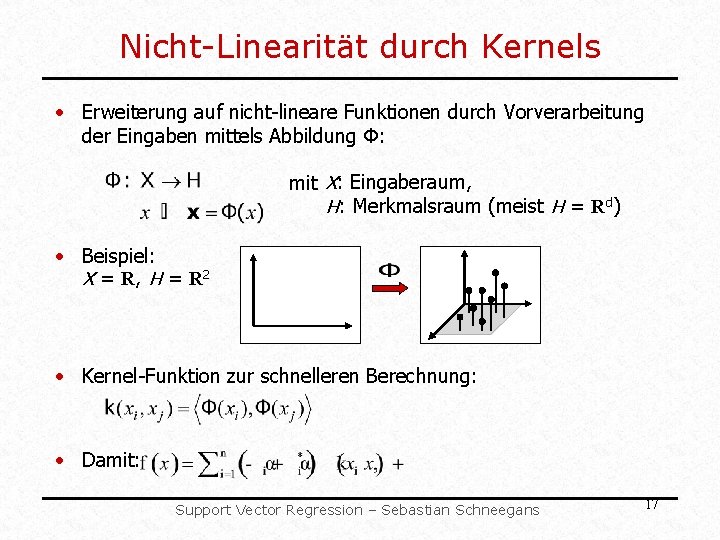
Nicht-Linearität durch Kernels • Erweiterung auf nicht-lineare Funktionen durch Vorverarbeitung der Eingaben mittels Abbildung Φ: mit X: Eingaberaum, H: Merkmalsraum (meist H = Rd) • Beispiel: X = R, H = R 2 • Kernel-Funktion zur schnelleren Berechnung: • Damit: Support Vector Regression – Sebastian Schneegans 17
Teil III: Variationen der Support Vector Regression a) ν-Support Vector Regression – Sebastian Schneegans 18
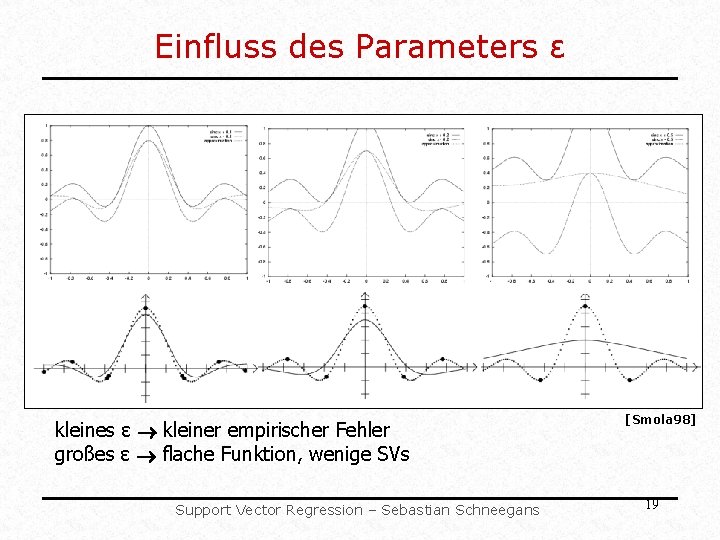
Einfluss des Parameters ε kleines ε kleiner empirischer Fehler großes ε flache Funktion, wenige SVs Support Vector Regression – Sebastian Schneegans [Smola 98] 19
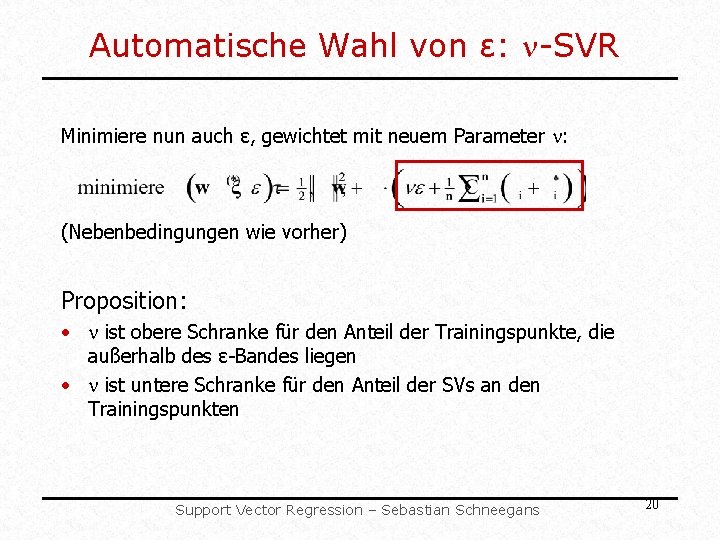
Automatische Wahl von ε: -SVR Minimiere nun auch ε, gewichtet mit neuem Parameter : (Nebenbedingungen wie vorher) Proposition: • ist obere Schranke für den Anteil der Trainingspunkte, die außerhalb des ε-Bandes liegen • ist untere Schranke für den Anteil der SVs an den Trainingspunkten Support Vector Regression – Sebastian Schneegans 20
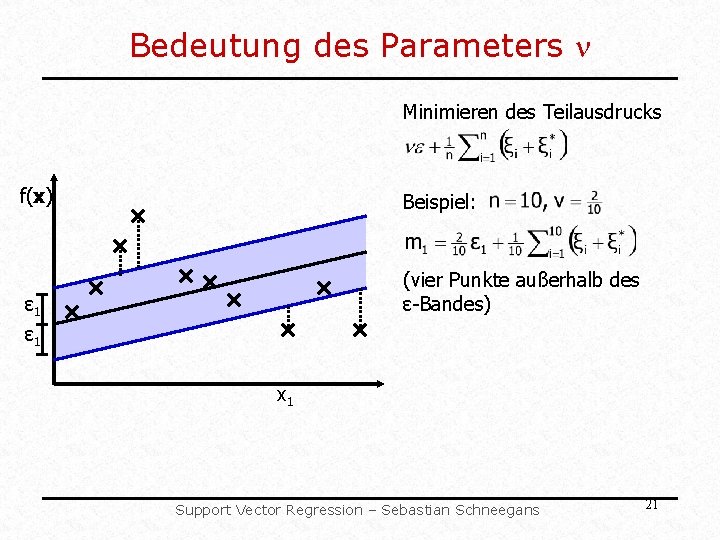
Bedeutung des Parameters Minimieren des Teilausdrucks f(x) Beispiel: (vier Punkte außerhalb des ε-Bandes) ε 1 x 1 Support Vector Regression – Sebastian Schneegans 21
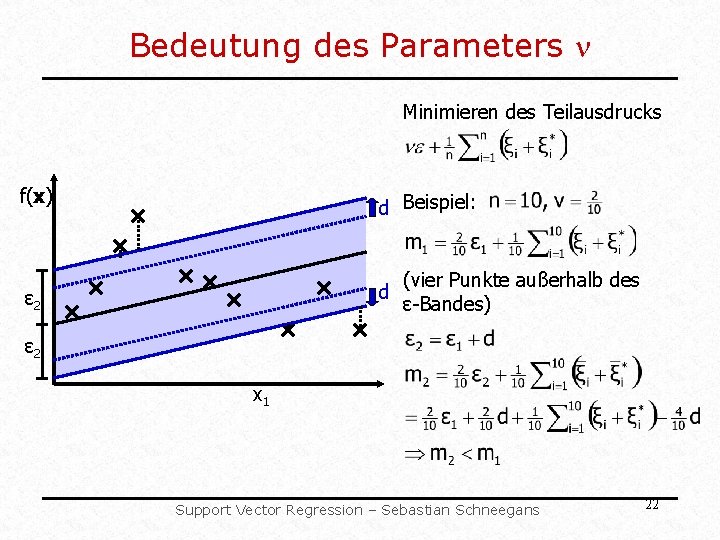
Bedeutung des Parameters Minimieren des Teilausdrucks f(x) d Beispiel: ε 2 d (vier Punkte außerhalb des ε-Bandes) ε 2 x 1 Support Vector Regression – Sebastian Schneegans 22
Teil III: Variationen der Support Vector Regression b) Weitere Variationen Support Vector Regression – Sebastian Schneegans 23
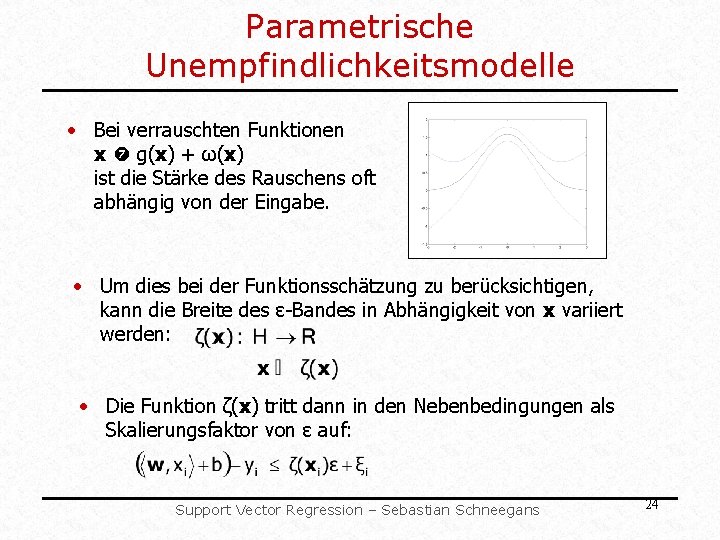
Parametrische Unempfindlichkeitsmodelle • Bei verrauschten Funktionen x g(x) + ω(x) ist die Stärke des Rauschens oft abhängig von der Eingabe. • Um dies bei der Funktionsschätzung zu berücksichtigen, kann die Breite des ε-Bandes in Abhängigkeit von x variiert werden: • Die Funktion ζ(x) tritt dann in den Nebenbedingungen als Skalierungsfaktor von ε auf: Support Vector Regression – Sebastian Schneegans 24
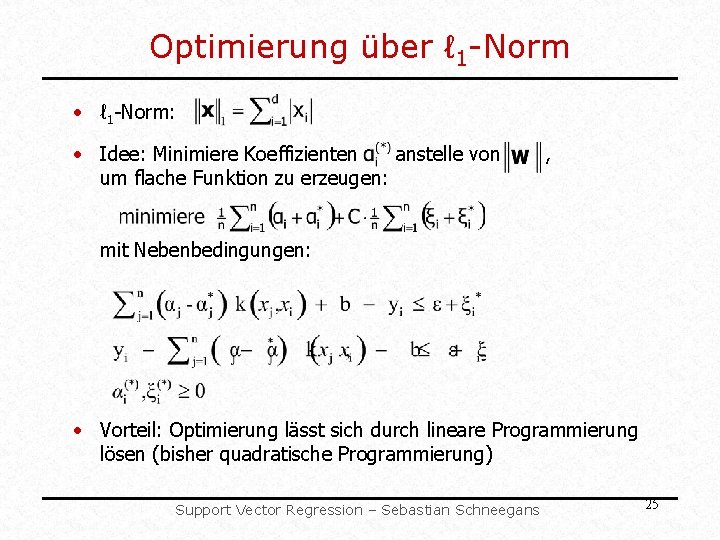
Optimierung über ℓ 1 -Norm • ℓ 1 -Norm: • Idee: Minimiere Koeffizienten anstelle von um flache Funktion zu erzeugen: , mit Nebenbedingungen: • Vorteil: Optimierung lässt sich durch lineare Programmierung lösen (bisher quadratische Programmierung) Support Vector Regression – Sebastian Schneegans 25
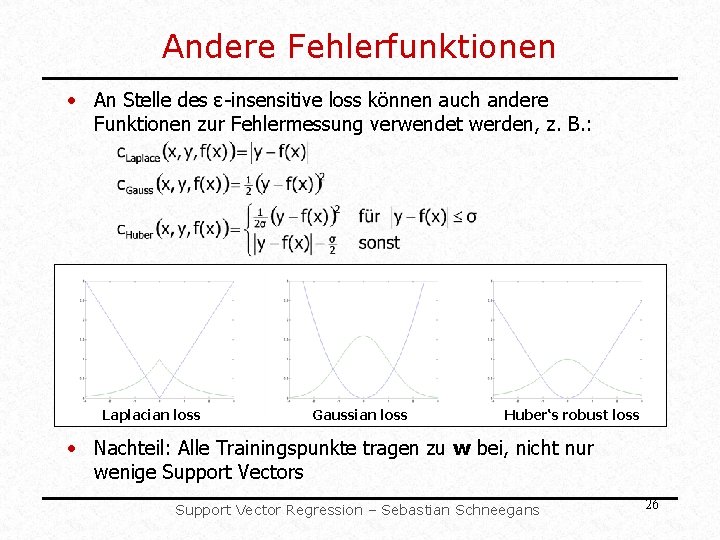
Andere Fehlerfunktionen • An Stelle des ε-insensitive loss können auch andere Funktionen zur Fehlermessung verwendet werden, z. B. : Laplacian loss Gaussian loss Huber‘s robust loss • Nachteil: Alle Trainingspunkte tragen zu w bei, nicht nur wenige Support Vectors Support Vector Regression – Sebastian Schneegans 26
Zusammenfassung • Support Vector Regression als Übertragung der SVM auf das Problem der Funktionsschätzung • Lineare Regression durch Hyperebene • Bestimmen der Ebenengleichung über Minimierungsproblem mit Nebenbedingungen • Duale Formulierung als Lagrange-Polynom • Erweiterung auf nicht-linearen Fall durch Kernel-Trick • -SVR zur einfacheren Bestimmung der Parameter Support Vector Regression – Sebastian Schneegans 27