Autocorrelazione dei residui Come pu originarsi Esempio il
- Slides: 26
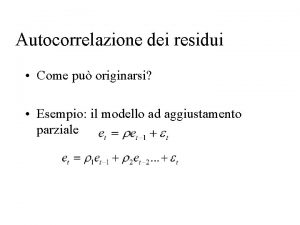
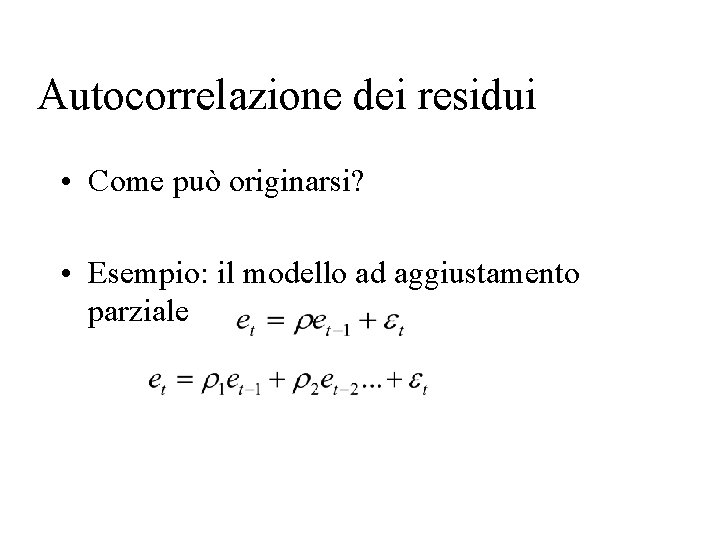
Autocorrelazione dei residui • Come può originarsi? • Esempio: il modello ad aggiustamento parziale
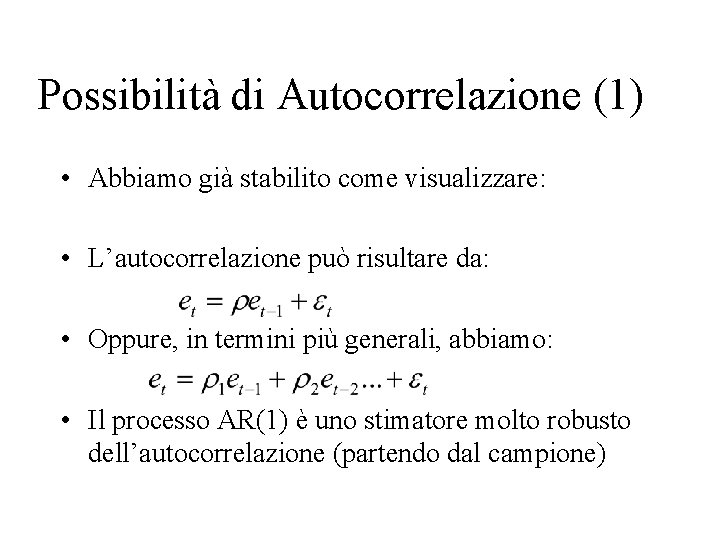
Possibilità di Autocorrelazione (1) • Abbiamo già stabilito come visualizzare: • L’autocorrelazione può risultare da: • Oppure, in termini più generali, abbiamo: • Il processo AR(1) è uno stimatore molto robusto dell’autocorrelazione (partendo dal campione)
Possibilità di Autocorrelazione (2) • La maggior parte della correlazione trasmessa da errori precedenti è catturata dall’impatto di e t-1 • Eccezioni: – Correlazioni stagionali o trimestrali; – Correlazioni spaziali (hanno significati complessi) • Nella maggior parte dei casi, correzioni AR(1) sono sufficienti
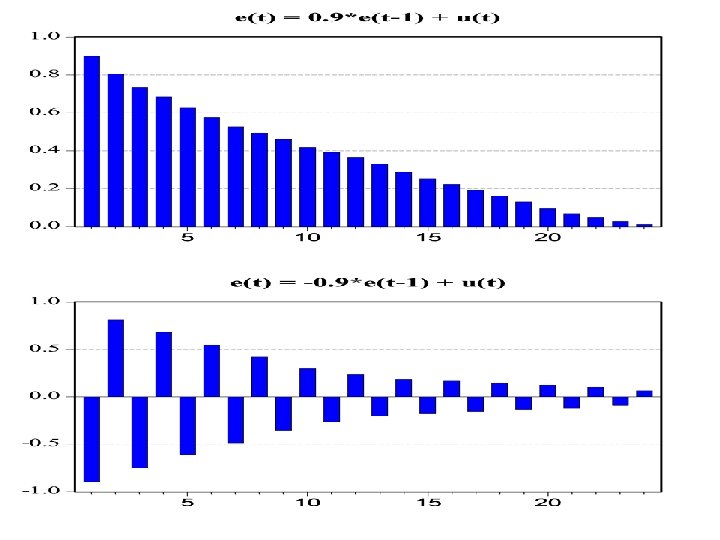
Autocorrelazione Positiva • Se r è positivo abbiamo che gli errori tendono a mantenere lo stesso segno in osservazioni contigue • (Autocorrelazione genuina) shock esterni dispiegano effetti per molto tempo (ad esempio investimenti pubblicitari, promozioni, etc. • Visual Inspection: clustering effects (gruppi di errori con stesso segno).
Autocorrelazione Negativa • Se r è negativo abbiamo termini di errore che tendono a cambiare segno (da negativi diventano positivi) per osservazioni contigue. • Esiste un pattern ciclico nella distribuzione degli errori; • Problemi particolarmente rilevanti nel caso dei dati economici; VI PRESENTO UN SIGNORE CHE TROVEREMO PIU’ AVANTI. IL “CORRELOGRAMMA”
Diagnosi • Abbiamo già stabilito che i coefficienti sono unbiased; • Possiamo utilizzare gli errori osservati per diagnosticare la presenza di autocorrelazione; • Test: • - Analisi del correlogramma – DW Studieremo la relazione tra residui e valori ritardati dei residui stessi
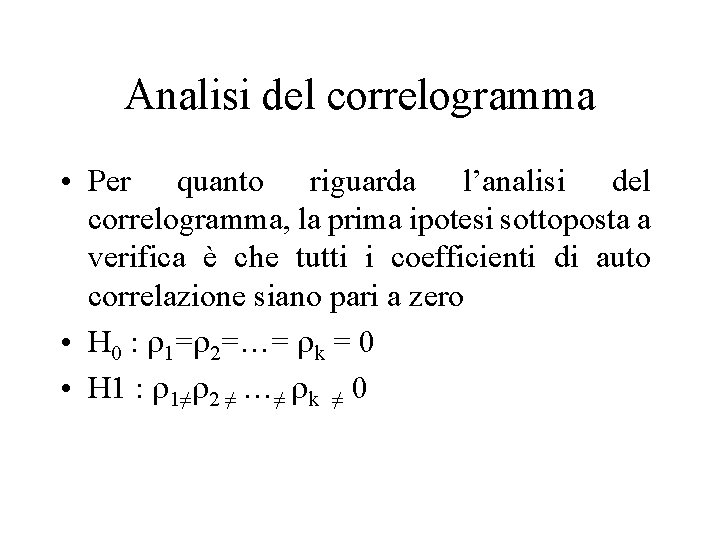
Analisi del correlogramma • Per quanto riguarda l’analisi del correlogramma, la prima ipotesi sottoposta a verifica è che tutti i coefficienti di auto correlazione siano pari a zero • H 0 : r 1=r 2=…= rk = 0 • H 1 : r 1≠r 2 ≠ …≠ rk ≠ 0
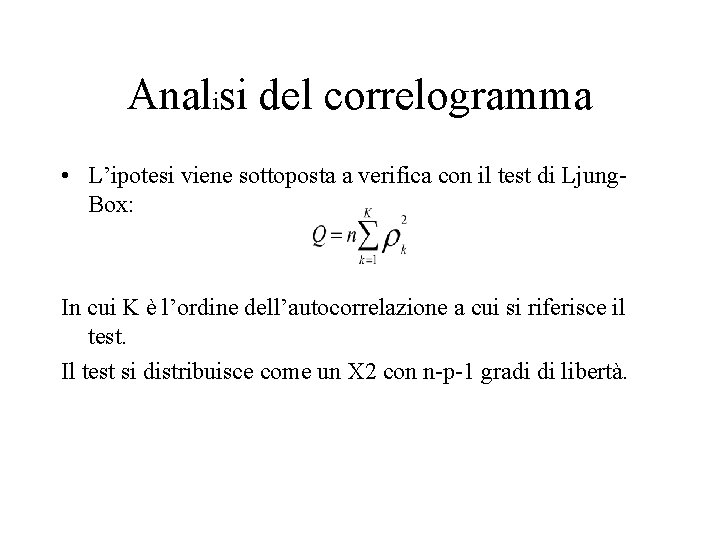
Analisi del correlogramma • L’ipotesi viene sottoposta a verifica con il test di Ljung. Box: In cui K è l’ordine dell’autocorrelazione a cui si riferisce il test. Il test si distribuisce come un X 2 con n-p-1 gradi di libertà.
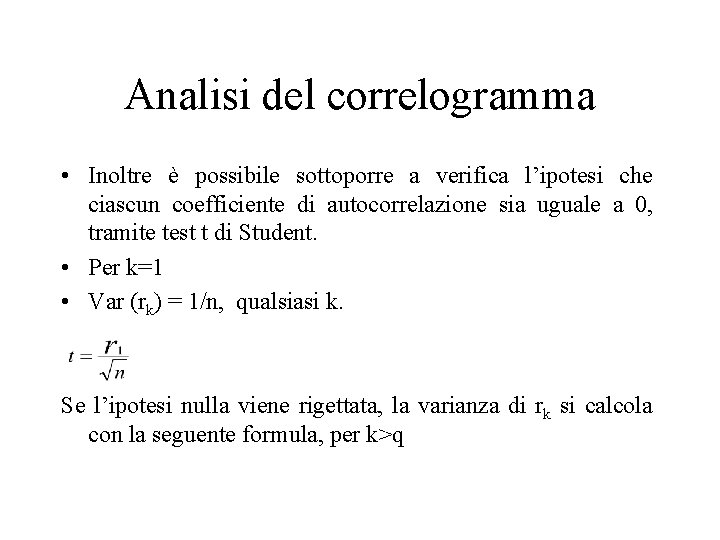
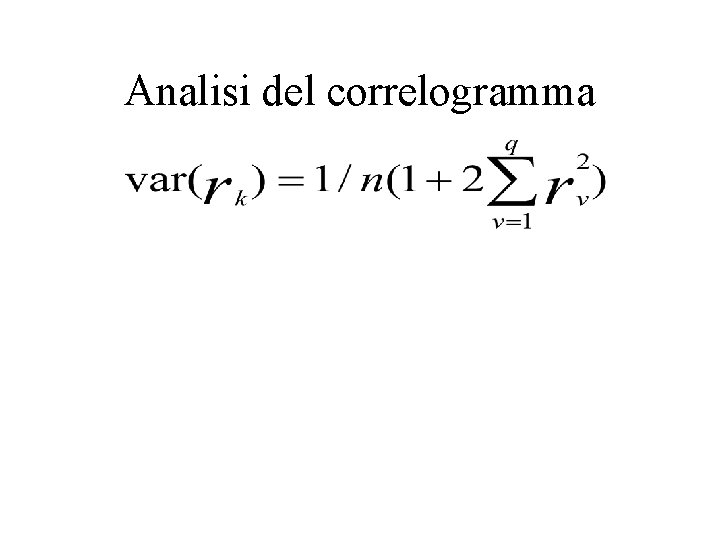
Analisi del correlogramma • Inoltre è possibile sottoporre a verifica l’ipotesi che ciascun coefficiente di autocorrelazione sia uguale a 0, tramite test t di Student. • Per k=1 • Var (rk) = 1/n, qualsiasi k. Se l’ipotesi nulla viene rigettata, la varianza di rk si calcola con la seguente formula, per k>q
Analisi del correlogramma
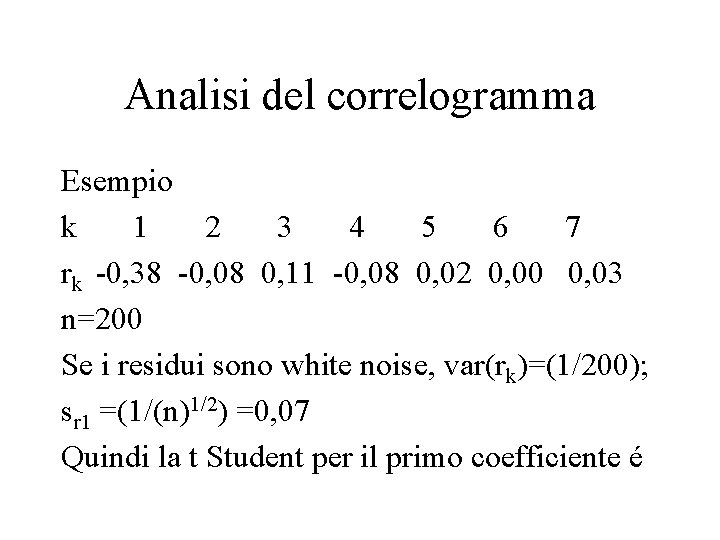
Analisi del correlogramma Esempio k 1 2 3 4 5 6 7 rk -0, 38 -0, 08 0, 11 -0, 08 0, 02 0, 00 0, 03 n=200 Se i residui sono white noise, var(rk)=(1/200); sr 1 =(1/(n)1/2) =0, 07 Quindi la t Student per il primo coefficiente é
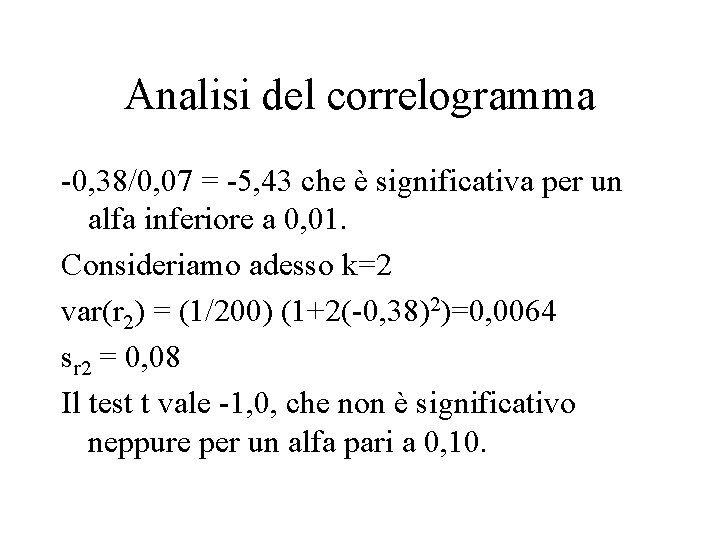
Analisi del correlogramma -0, 38/0, 07 = -5, 43 che è significativa per un alfa inferiore a 0, 01. Consideriamo adesso k=2 var(r 2) = (1/200) (1+2(-0, 38)2)=0, 0064 sr 2 = 0, 08 Il test t vale -1, 0, che non è significativo neppure per un alfa pari a 0, 10.
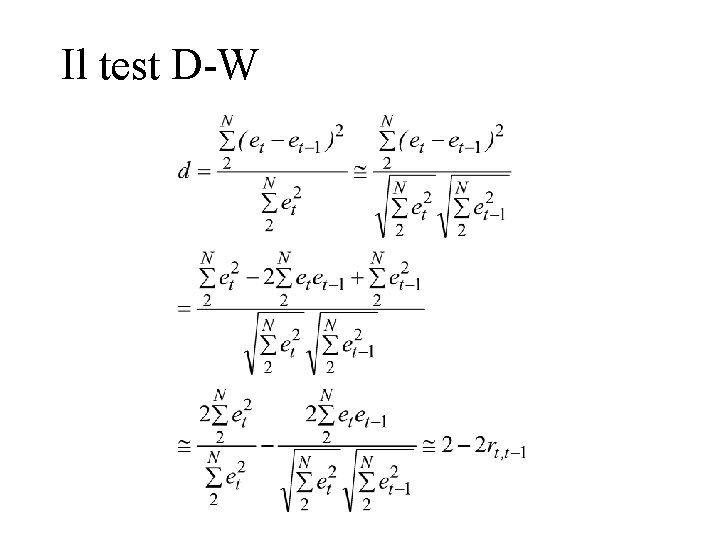
Il test D-W
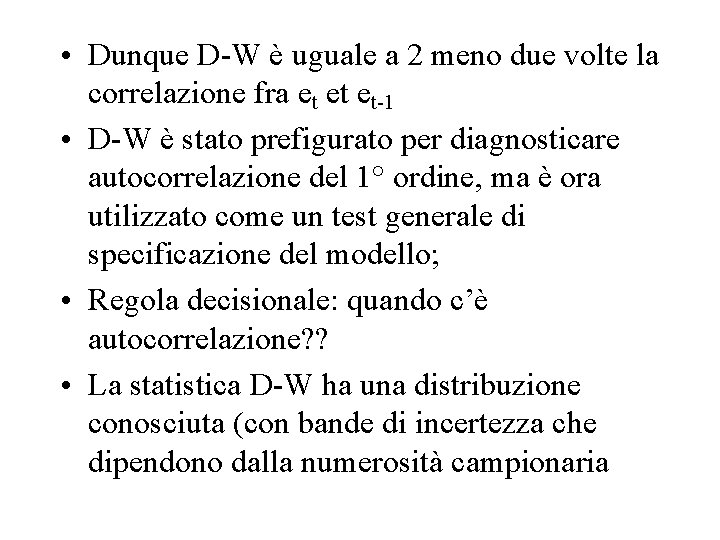
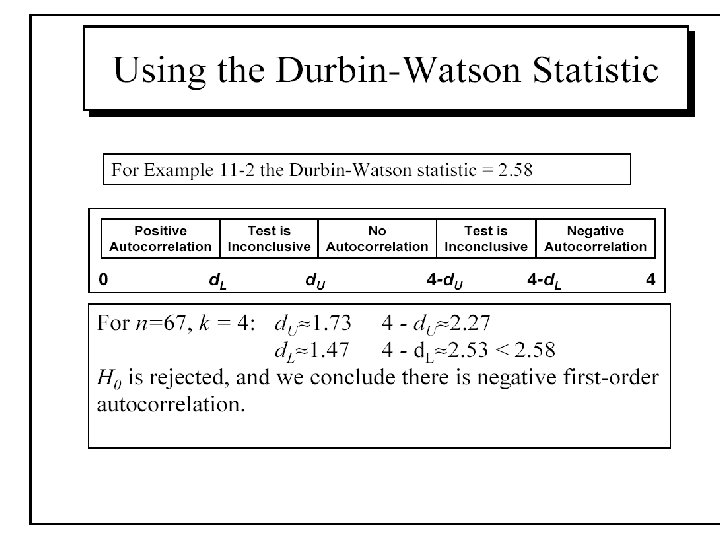
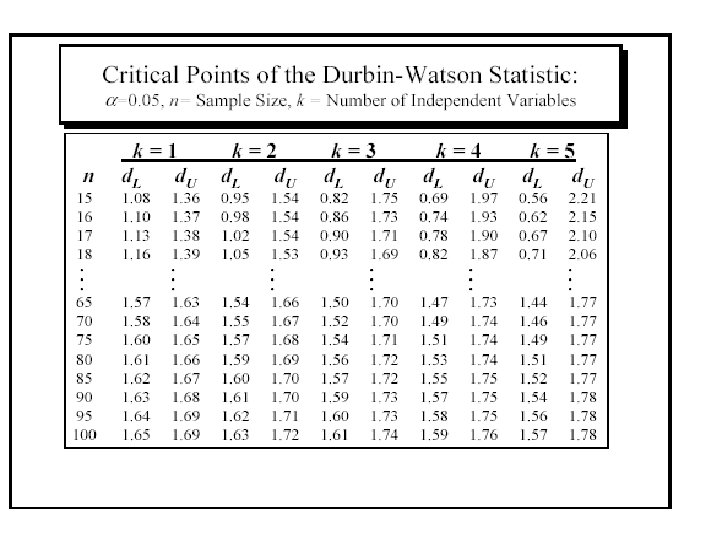
• Dunque D-W è uguale a 2 meno due volte la correlazione fra et et et-1 • D-W è stato prefigurato per diagnosticare autocorrelazione del 1° ordine, ma è ora utilizzato come un test generale di specificazione del modello; • Regola decisionale: quando c’è autocorrelazione? ? • La statistica D-W ha una distribuzione conosciuta (con bande di incertezza che dipendono dalla numerosità campionaria
• La statistica Durbin-Watson è distribuita simmetricamente attorno al valore 2 • Valori superiori a 2 indicano autocorrelazione negativa; • Valori inferiori a 2 indicano autocorrelazione positiva; • Eviews vi calcola il valore (proveremo a farlo anche manualmente).
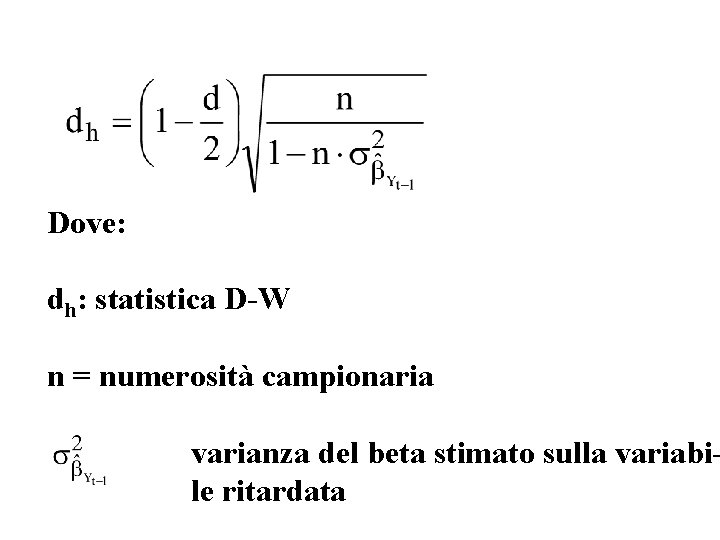
Lagged Dependent Variables • The Durbin Watson Statistic is not a valid test statistic when the equation includes a lagged dependent variable as one of the explanatory variables. • Use instead the Durbin-h test statistic which is normally distributed:
Dove: dh: statistica D-W n = numerosità campionaria varianza del beta stimato sulla variabile ritardata
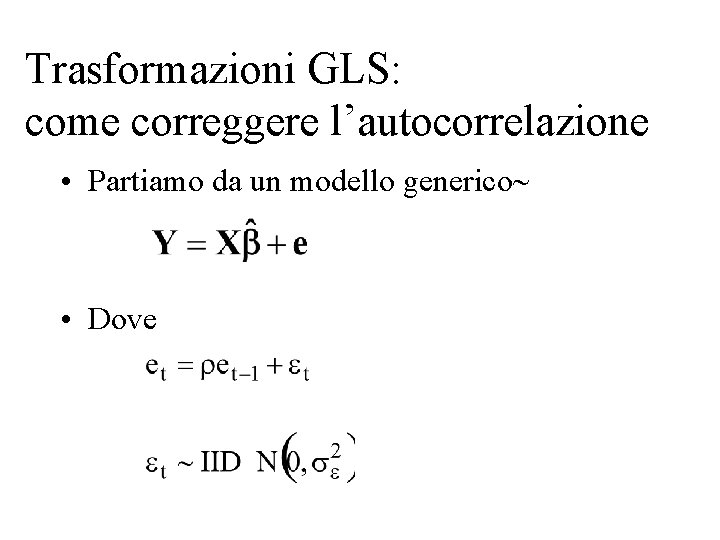
Trasformazioni GLS: come correggere l’autocorrelazione • Partiamo da un modello generico • Dove
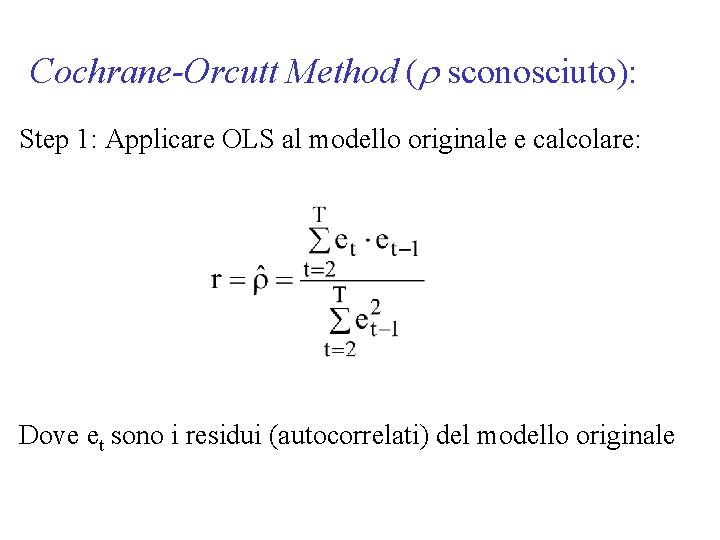
Cochrane-Orcutt Method (r sconosciuto): Step 1: Applicare OLS al modello originale e calcolare: Dove et sono i residui (autocorrelati) del modello originale
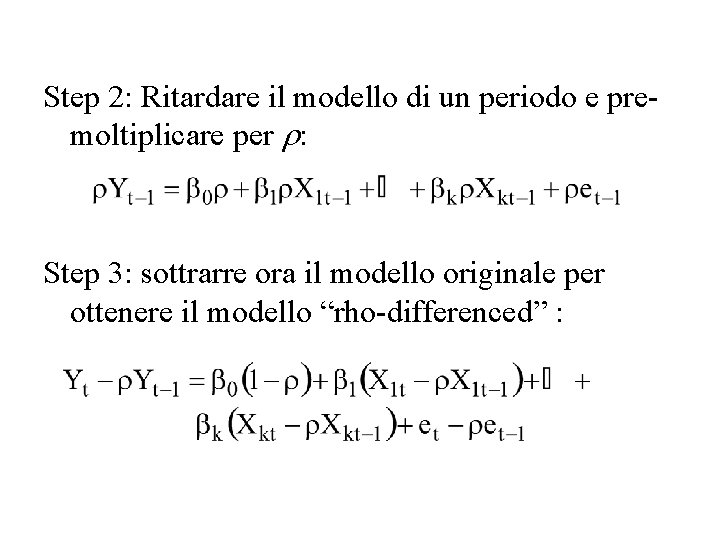
Step 2: Ritardare il modello di un periodo e premoltiplicare per r: Step 3: sottrarre ora il modello originale per ottenere il modello “rho-differenced” :
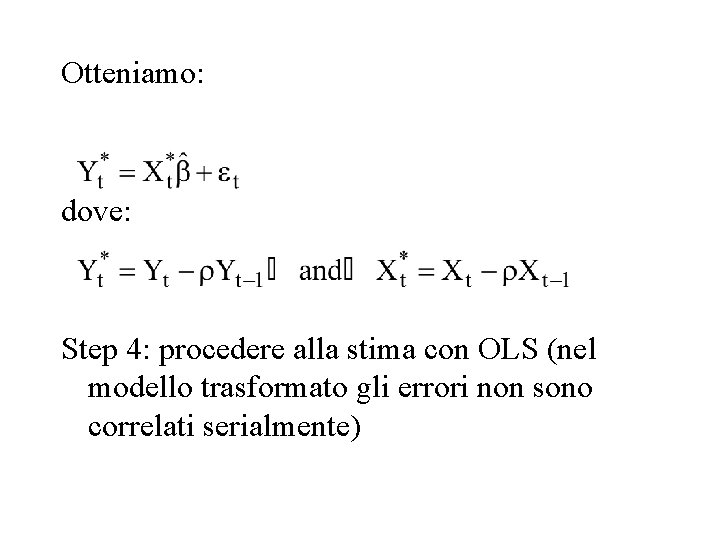
Otteniamo: dove: Step 4: procedere alla stima con OLS (nel modello trasformato gli errori non sono correlati serialmente)
Nota tecnica • Il metodo C-O stima un primo r (con gli errori OLS) • Successivamente stima con GLS e ottiene e che utilizza per una nuova stima di r ….
Hildreth-Lu Method • Equivalent to the Cochrane-Orcutt method. • Use the rho-difference model, searching over a grid of different values for r between -1 and +1 selecting the value which minimizes the sum of squared residuals for the transformed model. • Typical grid: r = -0. 95, -0. 90, -0. 85, … , 0. 85, 0. 90, 0. 95