Conceitos Avanados de Arquitetura de Computadores Arquiteturas RISC
- Slides: 52
Conceitos Avançados de Arquitetura de Computadores Arquiteturas RISC Reduced Instruction Set Computer
Máquinas CISC Complex Instruction Set Computer • Crise do Software – Dificuldades em achar programadores – Aumento da complexidade dos sistema – Aumento do preço do software – Surgimento de linguagens de alto nível – Aumento na complexidade do hardware: Unidades de execução e controle complexas I N E F I C I Ê N C I A
Máquinas CISC Complex Instruction Set Computer • Será que esta complexidade é realmente necessária?
Solução: Busca da eficiência na simplicidade • Máquinas RISC Reduced Instruction Set Computer
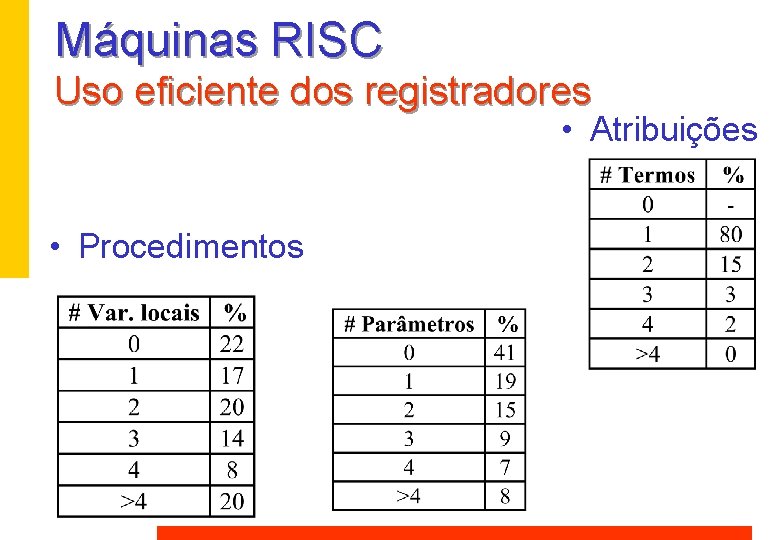
Filosofia RISC • Tornar as máquinas mais simples de modo a torná-las mais velozes: – Poucas instruções, simples e com poucos formatos – Poucos modos de endereçamento – Muitos registradores => Menos buscas na memória => implementação mais eficiente
Máquina RISC Implementação eficiente – Conjunto reduzido de instruções simples – Grande número de registradores – Operação similar a uma linha de montagem – Complexidade transferida para o compilador
Máquinas RISC Uso eficiente dos registradores • Atribuições • Procedimentos
Pipeline
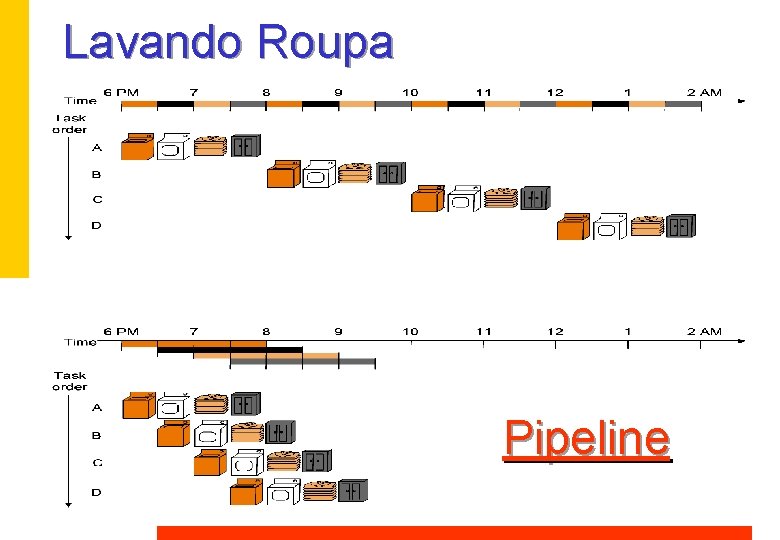
Lavando Roupa Pipeline
O que é pipeline? • É composto por uma série de estágios operando em paralelo onde uma parte do trabalho é feito em cada estágio. • O trabalho não está concluído até que tenha passado por todos os estágios.
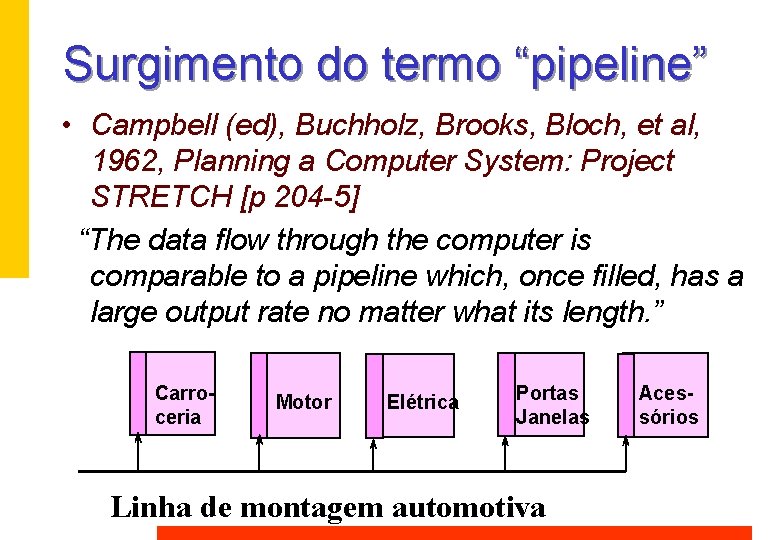
Surgimento do termo “pipeline” • Campbell (ed), Buchholz, Brooks, Bloch, et al, 1962, Planning a Computer System: Project STRETCH [p 204 -5] “The data flow through the computer is comparable to a pipeline which, once filled, has a large output rate no matter what its length. ” Carroceria Motor Elétrica Portas Janelas Linha de montagem automotiva Acessórios
Para que pipeline? Velocidade • Exemplos: – IBM 7030 100 x mais rápido que o 704 (o mais rápido naquele tempo). Melhorias comuns dariam 10 x mais. – IBM 360/91 é 1 a 2 ordens de magnitude mais rápido que o 7090. Sem pipeline se conseguiria apenas 4 x mais. – O 6502 tem throughput similar ao 8080 (que tem clock 4 x mais rápido)
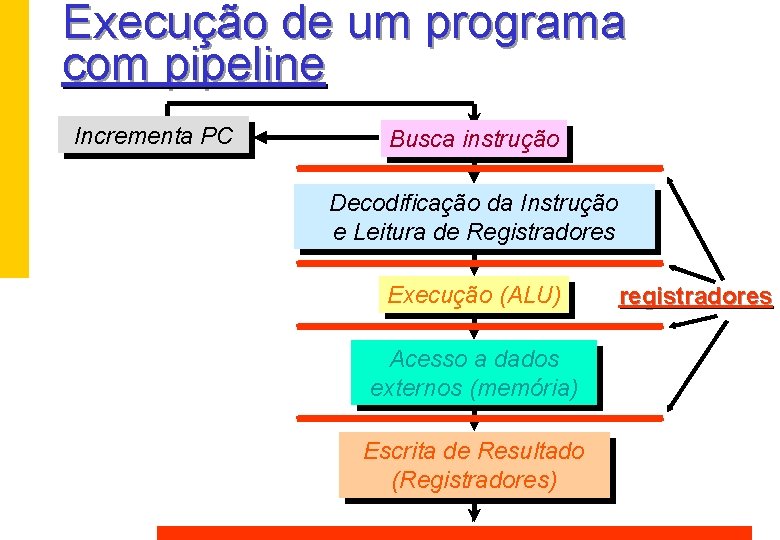
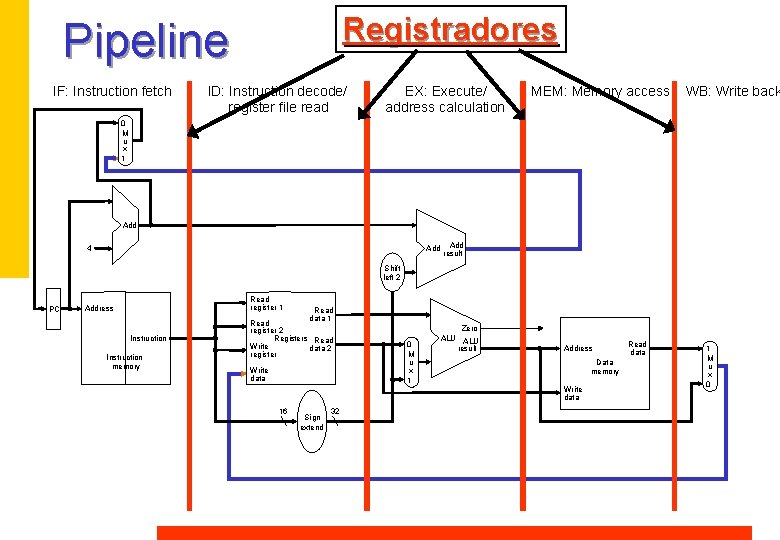
Execução de um programa com pipeline Incrementa PC Busca instrução Decodificação da Instrução e Leitura de Registradores Execução (ALU) Acesso a dados externos (memória) Escrita de Resultado (Registradores) registradores
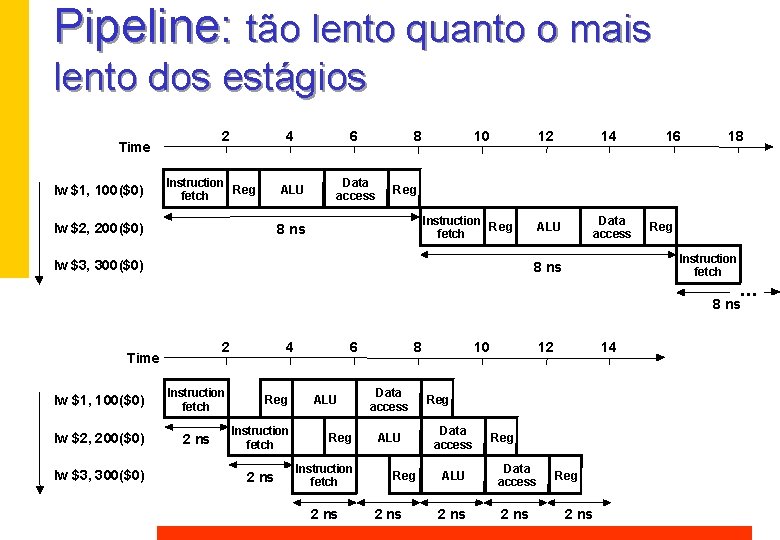
Pipeline • Em condições ideais, o ganho em performance é igual ao número de estágios do pipeline • Para estágios desbalanceados isto não acontece: Tempo por estágio = Tempo do estágio mais lento • Há um aumento de tempo de cada estágio por conta dos registradores necessários ao Pipeline • Mesmo que uma instrução não use um estágio, seu tempo é computado
Pipeline: tão lento quanto o mais lento dos estágios 2 Time lw $1, 100($0) Instruction Reg fetch lw $2, 200($0) 4 6 8 ALU Data access 10 12 14 ALU Data access 16 18 Reg Instruction Reg fetch 8 ns lw $3, 300($0) Reg Instruction fetch 8 ns . . . 8 ns 2 Time lw $1, 100($0) Instruction fetch lw $2, 200($0) 2 ns lw $3, 300($0) 4 Reg Instruction fetch 2 ns 6 ALU Reg Instruction fetch 2 ns 8 Data access ALU Reg 2 ns 10 14 12 Reg Data access Reg ALU Data access 2 ns Reg 2 ns
Registradores Pipeline IF: Instruction fetch ID: Instruction decode/ register file read EX: Execute/ address calculation MEM: Memory access WB: Write back 0 M u x 1 Add 4 Add result Shift left 2 PC Read register 1 Address Instruction memory Read data 1 Read register 2 Registers Read Write data 2 register Write data 16 Sign extend 32 0 M u x 1 Zero ALU result Address Data memory Write data Read data 1 M u x 0
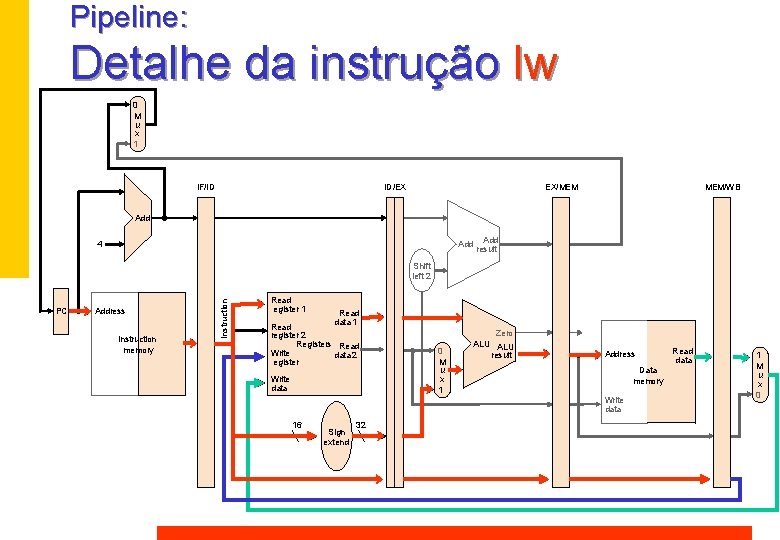
Pipeline: Detalhe da instrução lw 0 M u x 1 IF/ID ID/EX EX/MEM MEM/WB Add 4 Add result PC Address Instruction memory Instruction Shift left 2 Read egister 1 Read data 1 Read register 2 Registers Read Write data 2 egister Write data 16 Sign extend 32 0 M u x 1 Zero ALU result Address Data memory Write data Read data 1 M u x 0
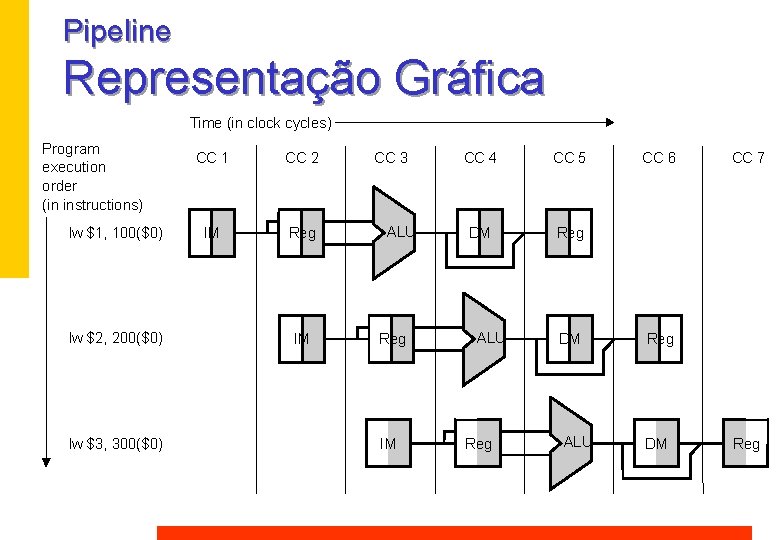
Pipeline Representação Gráfica Time (in clock cycles) Program execution order (in instructions) lw $1, 100($0) lw $2, 200($0) lw $3, 300($0) CC 1 CC 2 IM Reg IM CC 3 ALU Reg IM CC 4 CC 5 DM Reg ALU Reg DM ALU CC 6 CC 7 Reg DM Reg
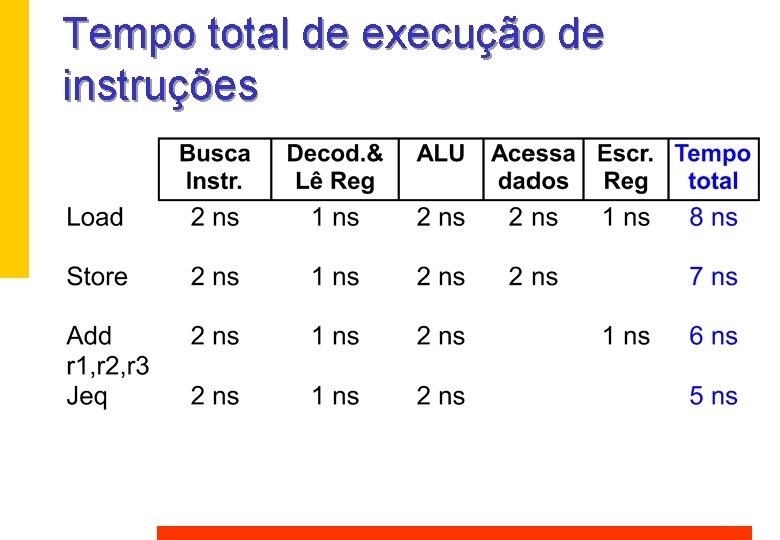
Tempo total de execução de instruções
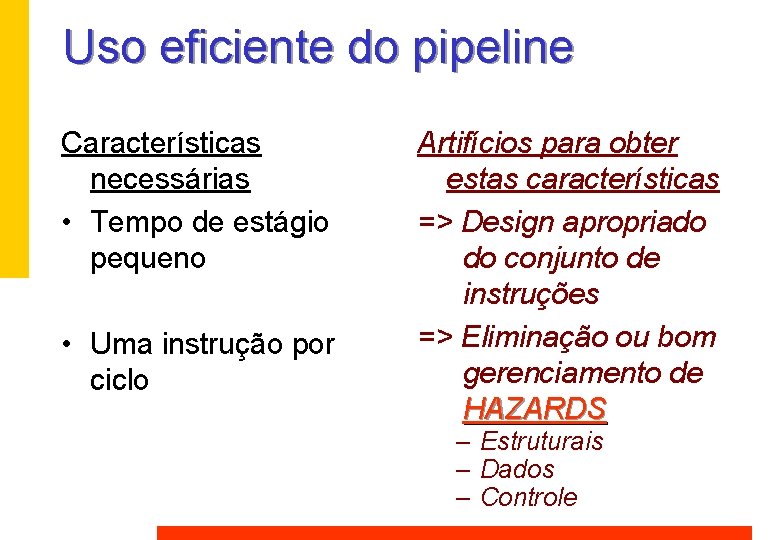
Uso eficiente do pipeline Características necessárias • Tempo de estágio pequeno • Uma instrução por ciclo Artifícios para obter estas características => Design apropriado do conjunto de instruções => Eliminação ou bom gerenciamento de HAZARDS – Estruturais – Dados – Controle
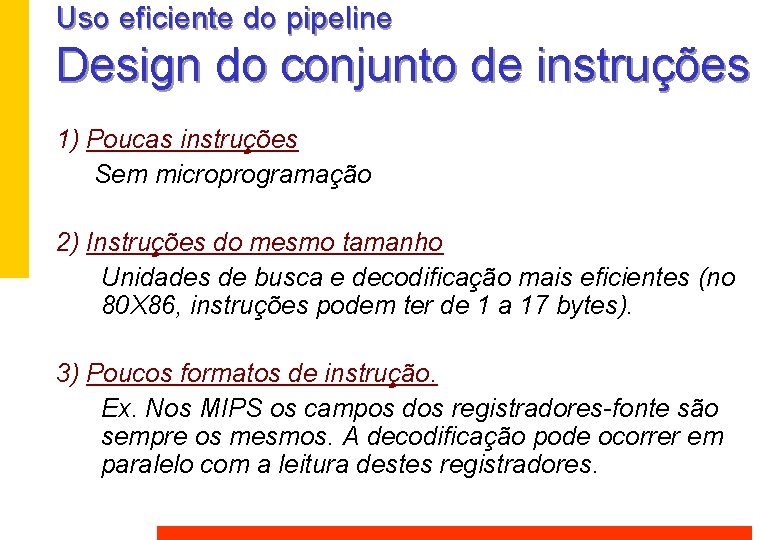
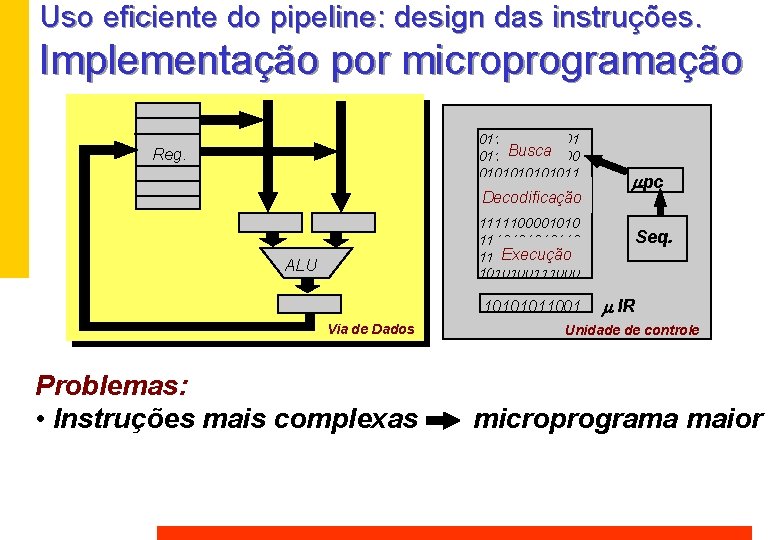
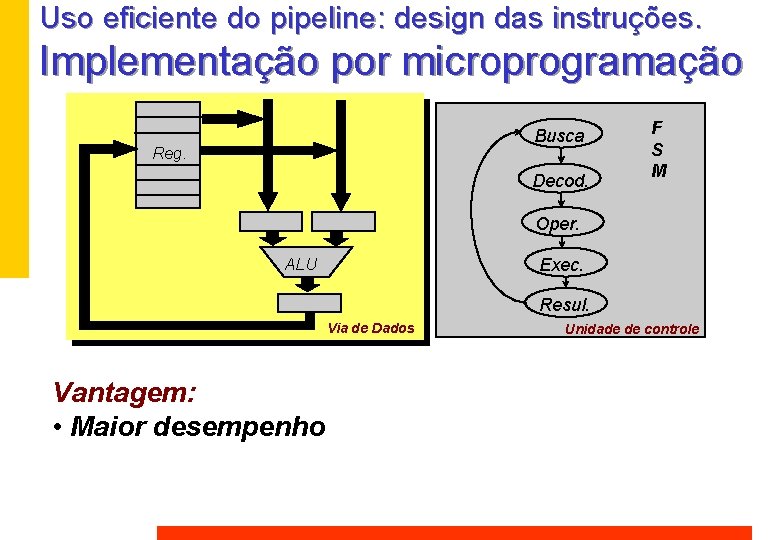
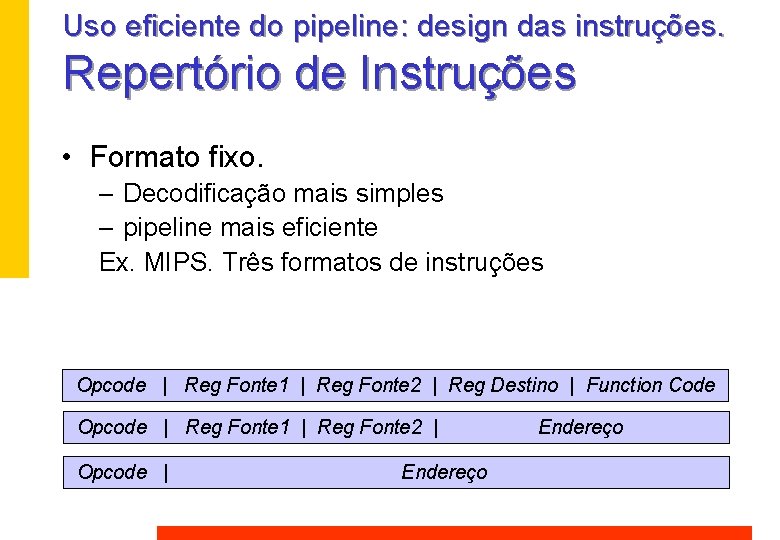
Uso eficiente do pipeline Design do conjunto de instruções 1) Poucas instruções Sem microprogramação 2) Instruções do mesmo tamanho Unidades de busca e decodificação mais eficientes (no 80 X 86, instruções podem ter de 1 a 17 bytes). 3) Poucos formatos de instrução. Ex. Nos MIPS os campos dos registradores-fonte são sempre os mesmos. A decodificação pode ocorrer em paralelo com a leitura destes registradores.
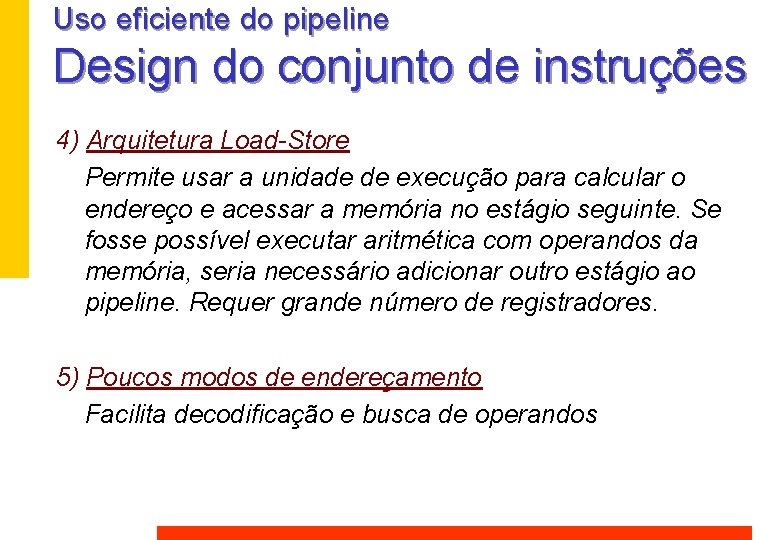
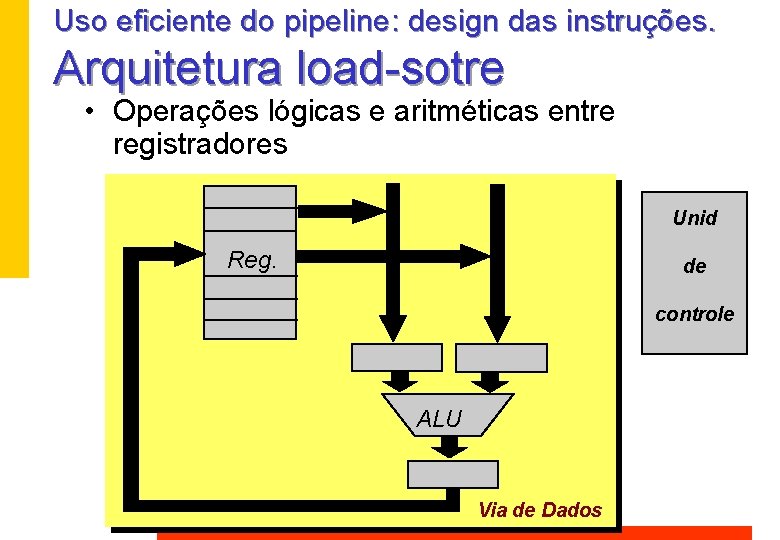
Uso eficiente do pipeline Design do conjunto de instruções 4) Arquitetura Load-Store Permite usar a unidade de execução para calcular o endereço e acessar a memória no estágio seguinte. Se fosse possível executar aritmética com operandos da memória, seria necessário adicionar outro estágio ao pipeline. Requer grande número de registradores. 5) Poucos modos de endereçamento Facilita decodificação e busca de operandos
Uso eficiente do pipeline: design das instruções. Implementação por microprogramação 011010001 Busca 011110100 0101011 1110001011001 Decodificação 101011001 1111100001010 111010110 Execução 111101011 1010100111000 Reg. ALU 10101011001 Via de Dados Problemas: • Instruções mais complexas mpc Seq. m IR Unidade de controle microprograma maior
Uso eficiente do pipeline: design das instruções. Implementação por microprogramação Busca Reg. Decod. F S M Oper. Exec. ALU Resul. Via de Dados Vantagem: • Maior desempenho Unidade de controle
Uso eficiente do pipeline: design das instruções. Arquitetura load-sotre • Operações lógicas e aritméticas entre registradores Unid Reg. de controle ALU Via de Dados
Uso eficiente do pipeline: design das instruções. Repertório de Instruções • Formato fixo. – Decodificação mais simples – pipeline mais eficiente Ex. MIPS. Três formatos de instruções Opcode | Reg Fonte 1 | Reg Fonte 2 | Reg Destino | Function Code Opcode | Reg Fonte 1 | Reg Fonte 2 | Opcode | Endereço
Uso eficiente do pipeline: design das instruções. Repertório de Instruções • Poucos modos de endereçamento – Facilita decodificação e execução • Instruções com 3 operandos (registradores) Ex: add r 1, r 2, r 3 => r 1 = r 2 + r 3 • Muitos registradores e de uso geral
Uso eficiente do pipeline Eliminação ou bom gerenciamento de HAZARDS O que são: Situações em que a próxima instrução não pode ser executada no próximo ciclo, inserindo uma bolha (provocando um stall) Tipos – Estruturais Conflito no uso dos recursos – Dados Dependência de dados – Controle Alteração do fluxo do programa por instruções de desvio, chamada de funções, interrupções
Uso eficiente do pipeline Hazard Estrutural Causas: - Recursos não suficientemente replicados ex: portas de escrita na memória ou mem. de dados = mem. Instruções Solução: replicar recursos - Unidade funcionais muito lentas ex: Multiplicação e divisão Solução: pipelinezar o recurso
Uso eficiente do pipeline Hazard de Dados Tipos de Dependências de Dados - Dependência Verdadeira: Read-after-Write (RAW) - Dependência de Saída: Write-after-Write (WAW) - Antidependências: Write-after-Read (WAR)
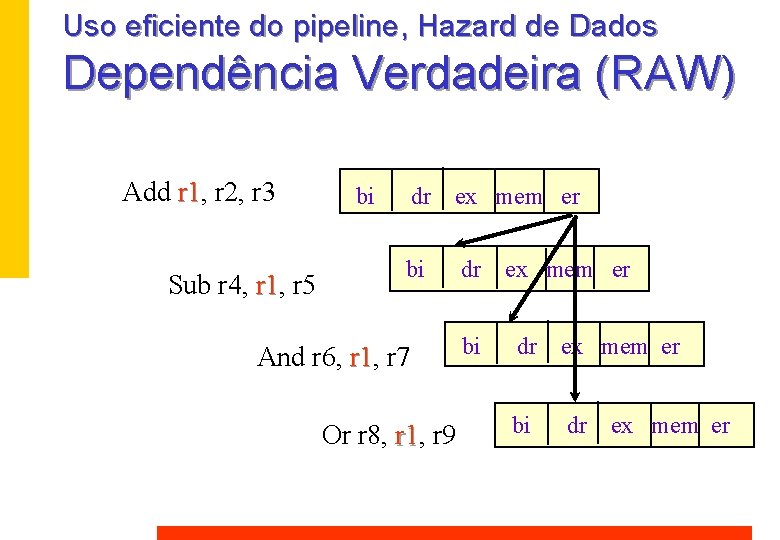
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) Add r 1, r 1 r 2, r 3 Sub r 4, r 1 r 5 bi dr ex mem er bi And r 6, r 1 r 7 Or r 8, r 1 r 9 dr ex mem er bi dr ex mem er
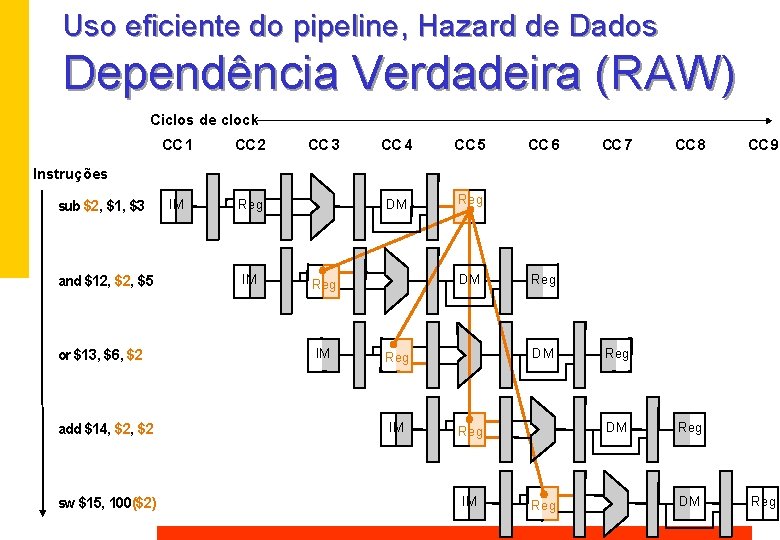
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) Ciclos de clock CC 1 CC 2 IM Reg CC 3 CC 4 CC 5 DM Reg CC 6 CC 7 CC 8 CC 9 Instruções sub $2, $1, $3 and $12, $5 or $13, $6, $2 add $14, $2 sw $15, 100($2) IM DM Reg IM Reg Reg DM Reg
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) • A solução está em dar tempo para o resultado ser usado pela instrução dependente. 1) Inserir NOPs ou bolhas 2) Inserir instruções independentes entre as dependentes 3) Método do curto circuito ou forwarding
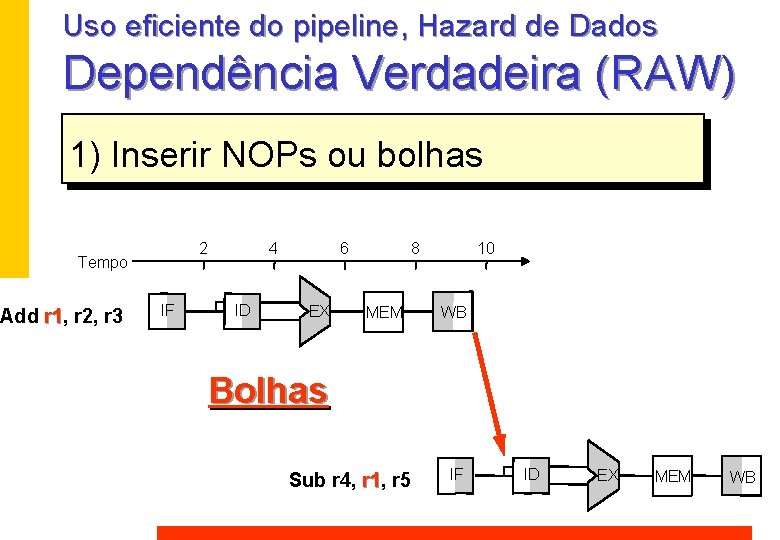
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) 1) Inserir NOPs ou bolhas 2 Tempo Add r 1, r 1 r 2, r 3 IF 4 ID 6 EX 8 MEM 10 WB Bolhas Sub r 4, r 1 r 5 IF ID EX MEM WB
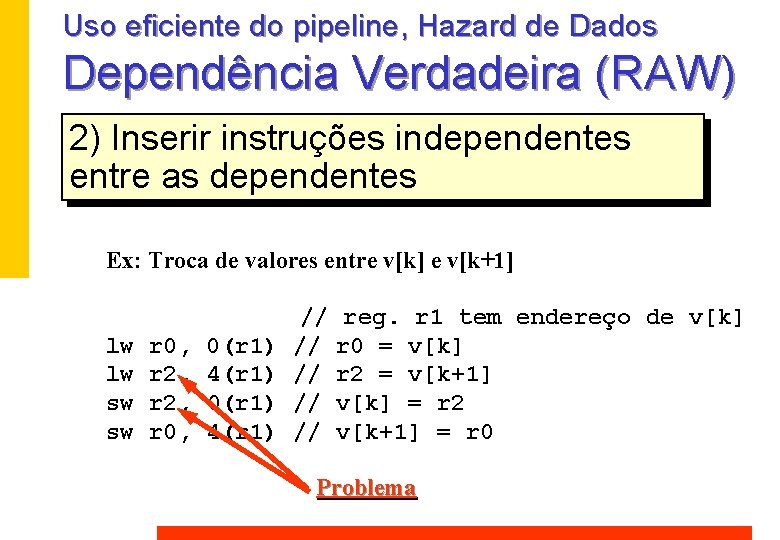
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) 2) Inserir instruções independentes entre as dependentes Ex: Troca de valores entre v[k] e v[k+1] lw lw sw sw r 0, r 2, r 0, 0(r 1) 4(r 1) // // // reg. r 1 tem endereço de v[k] r 0 = v[k] r 2 = v[k+1] v[k] = r 2 v[k+1] = r 0 Problema
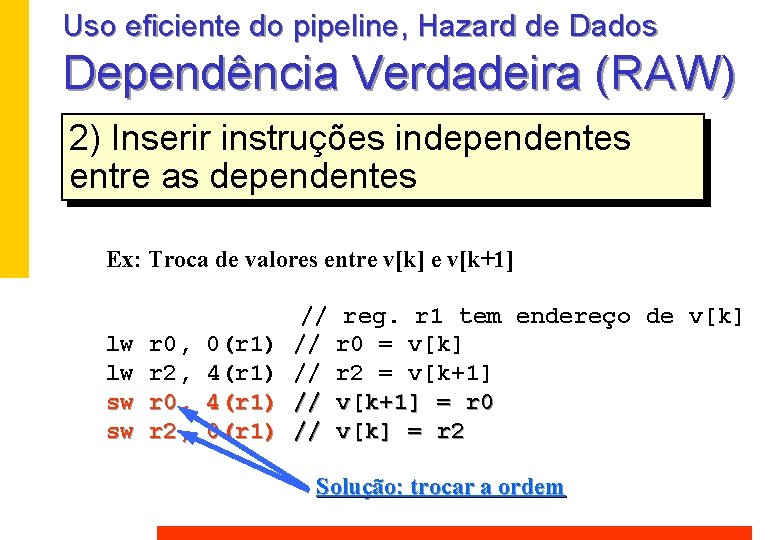
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) 2) Inserir instruções independentes entre as dependentes Ex: Troca de valores entre v[k] e v[k+1] lw lw sw sw r 0, r 2, 0(r 1) 4(r 1) 0(r 1) // // // reg. r 1 tem endereço de v[k] r 0 = v[k] r 2 = v[k+1] = r 0 v[k] = r 2 Solução: trocar a ordem
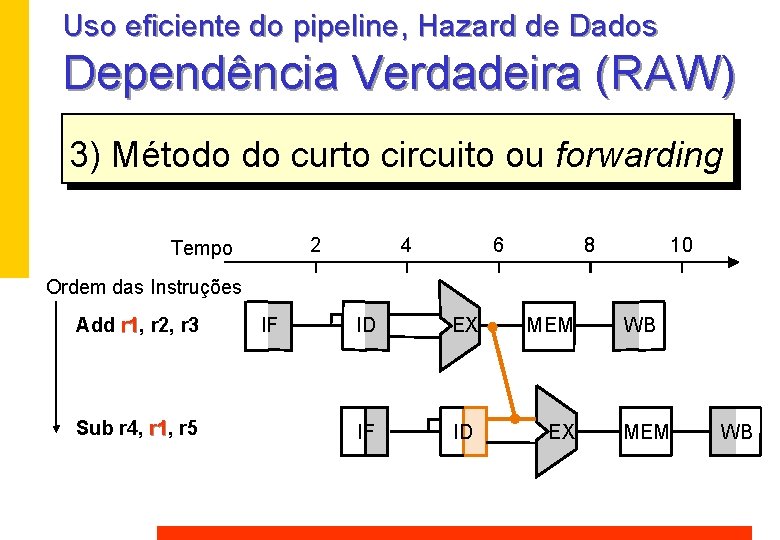
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) 3) Método do curto circuito ou forwarding 2 Tempo 4 6 8 10 Ordem das Instruções Add r 1, r 1 r 2, r 3 Sub r 4, r 1 r 5 IF ID EX MEM IF ID EX WB MEM WB
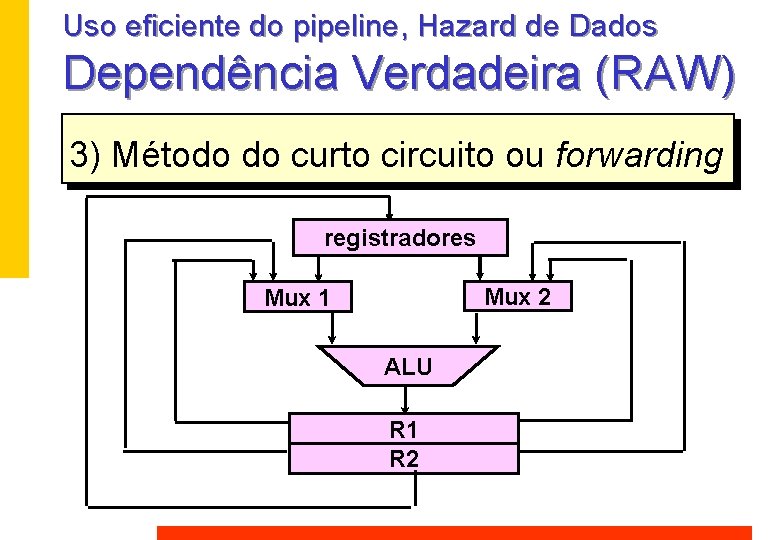
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) 3) Método do curto circuito ou forwarding registradores Mux 2 Mux 1 ALU R 1 R 2
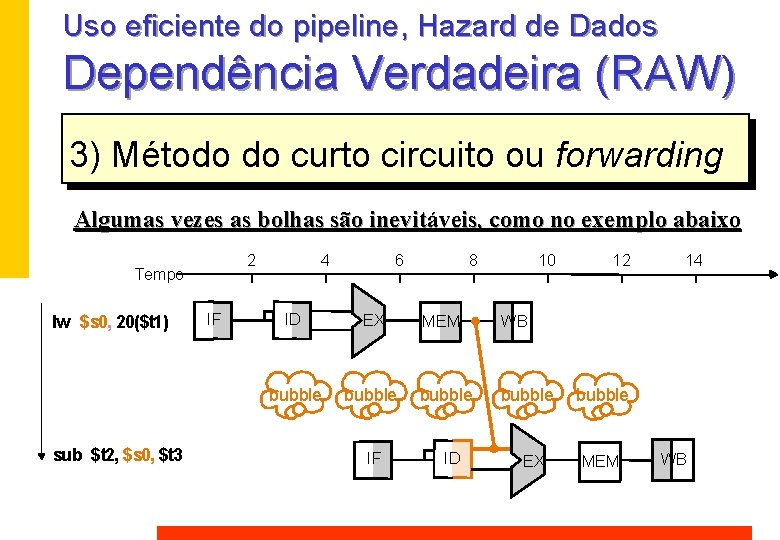
Uso eficiente do pipeline, Hazard de Dados Dependência Verdadeira (RAW) 3) Método do curto circuito ou forwarding Algumas vezes as bolhas são inevitáveis, como no exemplo abaixo 2 Tempo lw $s 0, 20($t 1) sub $t 2, $s 0, $t 3 IF 4 6 ID EX bubble IF 8 10 12 MEM WB bubble ID EX MEM 14 WB
Uso eficiente do pipeline Hazard de Controle • Necessidade da alteração no fluxo do programa: – Interrupções, exceções – Desvios condicionais e incondicionais – Chamadas e retornos de subrotinas • Qual o comportamento do pipeline na ocorrência de instruções de desvio condicional?
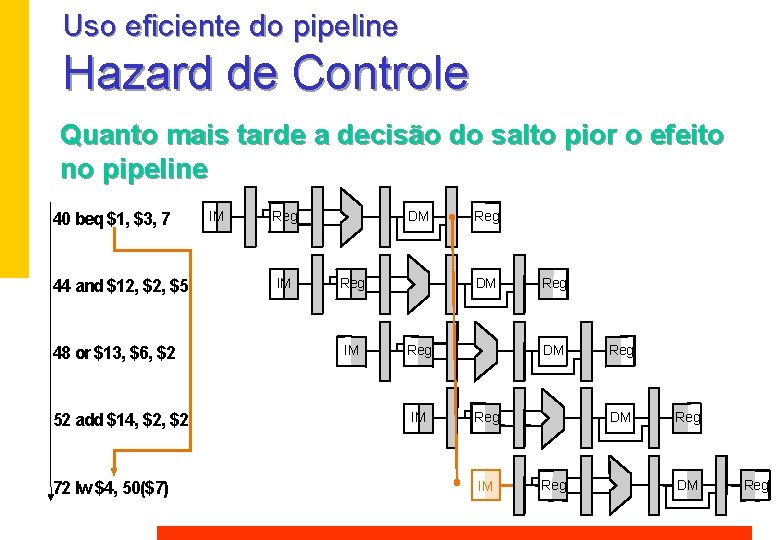
Uso eficiente do pipeline Hazard de Controle Quanto mais tarde a decisão do salto pior o efeito no pipeline 40 beq $1, $3, 7 44 and $12, $5 48 or $13, $6, $2 52 add $14, $2 72 lw $4, 50($7) IM Reg IM DM Reg IM Reg DM Reg
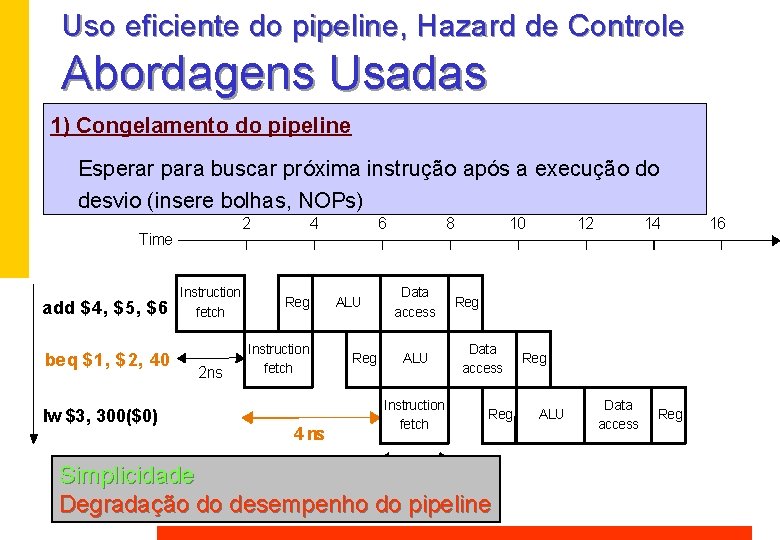
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas 1) Congelamento do pipeline Esperar para buscar próxima instrução após a execução do desvio (insere bolhas, NOPs) 2 Time add $4, $5, $6 beq $1, $2, 40 lw $3, 300($0) Instruction fetch 2 ns 4 Reg Instruction fetch 4 ns 6 ALU Reg 8 Data access ALU Instruction fetch 10 14 12 Reg Data access Reg 2 ns Simplicidade Degradação do desempenho do pipeline Reg ALU Data access Reg 16
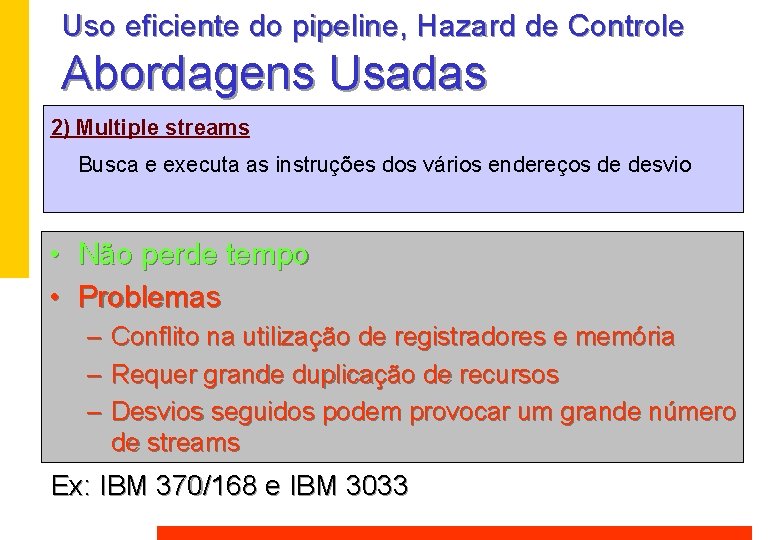
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas 2) Multiple streams Busca e executa as instruções dos vários endereços de desvio • • Não perde tempo Problemas – Conflito na utilização de registradores e memória – Requer grande duplicação de recursos – Desvios seguidos podem provocar um grande número de streams Ex: IBM 370/168 e IBM 3033
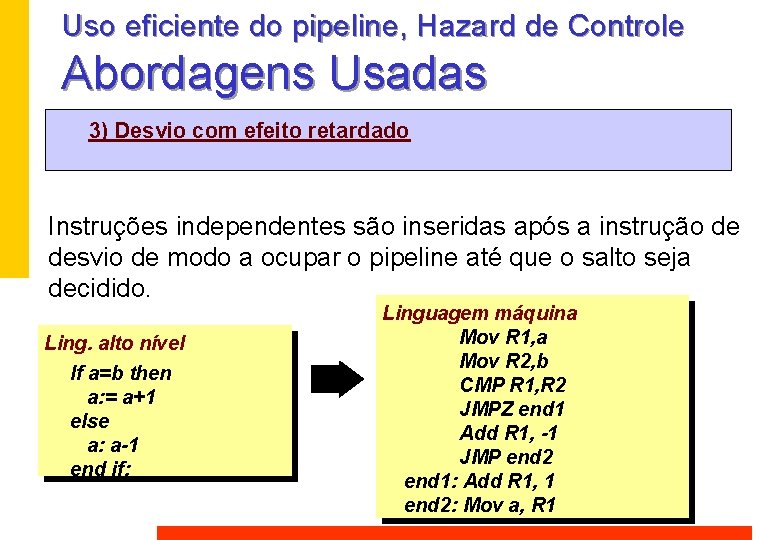
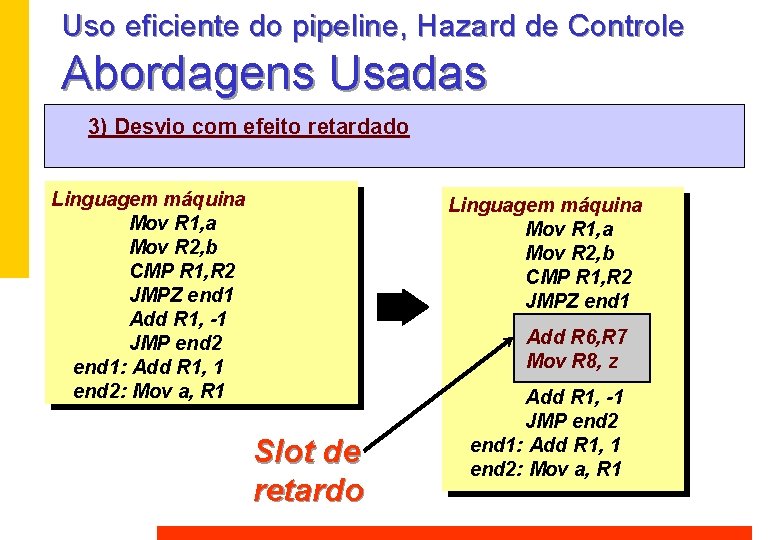
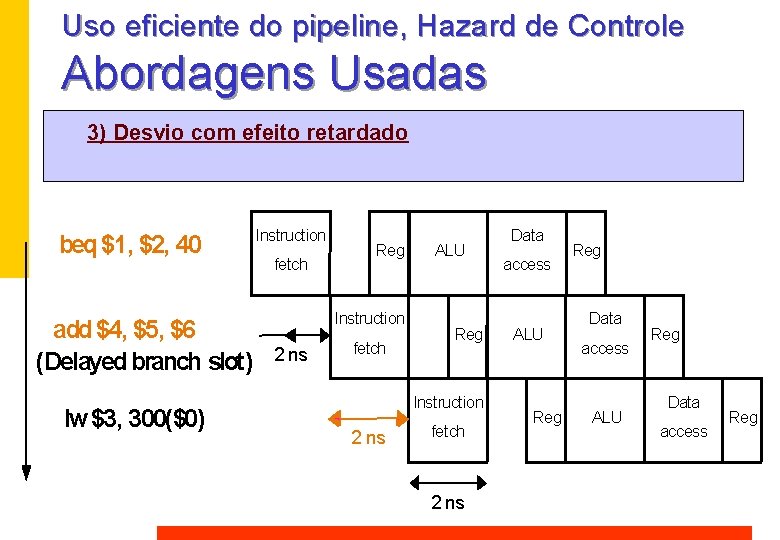
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas 3) Desvio com efeito retardado Instruções independentes são inseridas após a instrução de desvio de modo a ocupar o pipeline até que o salto seja decidido. Ling. alto nível If a=b then a: = a+1 else a: a-1 end if; Linguagem máquina Mov R 1, a Mov R 2, b CMP R 1, R 2 JMPZ end 1 Add R 1, -1 JMP end 2 end 1: Add R 1, 1 end 2: Mov a, R 1
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas 3) Desvio com efeito retardado Linguagem máquina Mov R 1, a Mov R 2, b CMP R 1, R 2 JMPZ end 1 Add R 1, -1 JMP end 2 end 1: Add R 1, 1 end 2: Mov a, R 1 Linguagem máquina Mov R 1, a Mov R 2, b CMP R 1, R 2 JMPZ end 1 Add R 6, R 7 Mov R 8, z Slot de retardo Add R 1, -1 JMP end 2 end 1: Add R 1, 1 end 2: Mov a, R 1
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas 3) Desvio com efeito retardado beq $1, $2, 40 add $4, $5, $6 (Delayed branch slot) lw $3, 300($0) Instruction fetch Reg Instruction 2 ns fetch ALU Reg Instruction 2 ns fetch 2 ns Data access ALU Reg Data access Reg
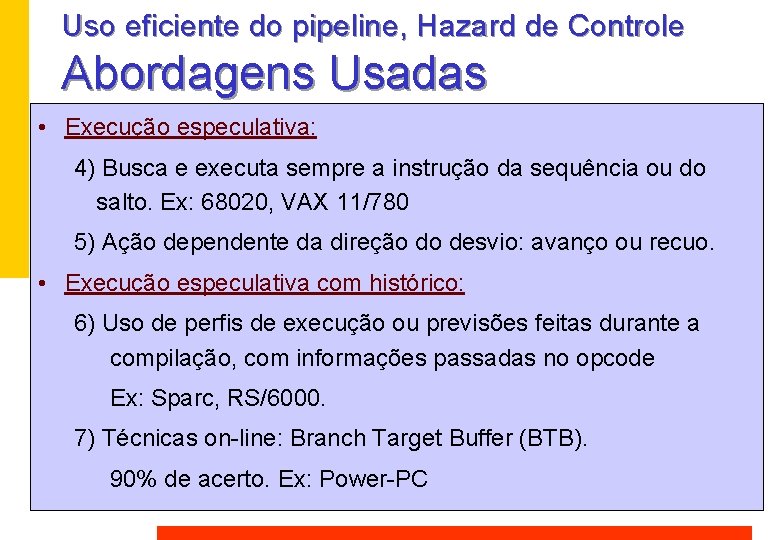
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas • Execução especulativa: 4) Busca e executa sempre a instrução da sequência ou do salto. Ex: 68020, VAX 11/780 5) Ação dependente da direção do desvio: avanço ou recuo. • Execução especulativa com histórico: 6) Uso de perfis de execução ou previsões feitas durante a compilação, com informações passadas no opcode Ex: Sparc, RS/6000. 7) Técnicas on-line: Branch Target Buffer (BTB). 90% de acerto. Ex: Power-PC
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas Branch Target Buffer (BTB)
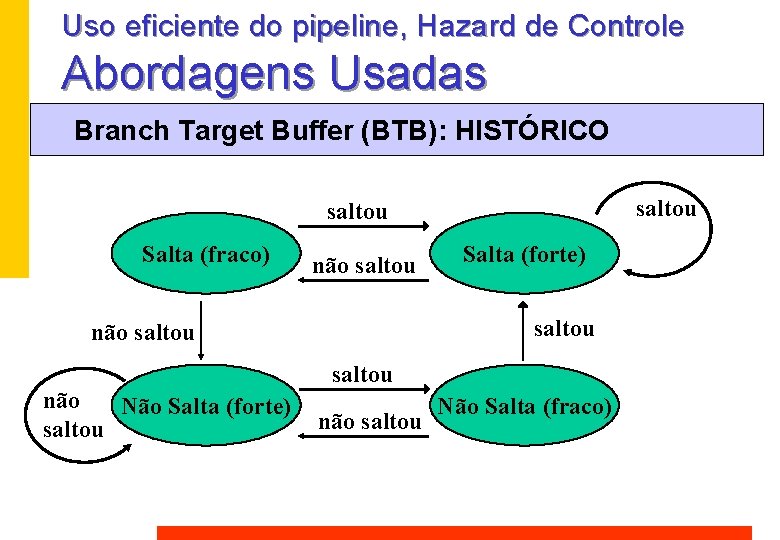
Uso eficiente do pipeline, Hazard de Controle Abordagens Usadas Branch Target Buffer (BTB): HISTÓRICO saltou Salta (fraco) não saltou não Não Salta (forte) saltou não saltou Não Salta (fraco)
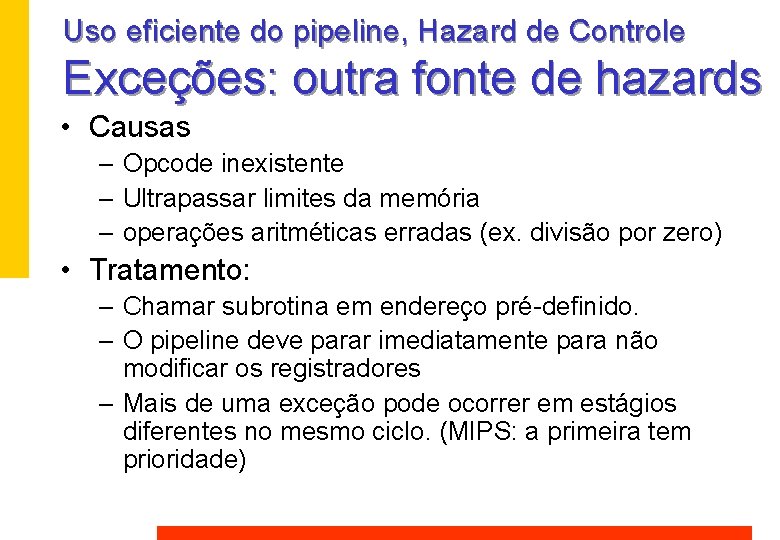
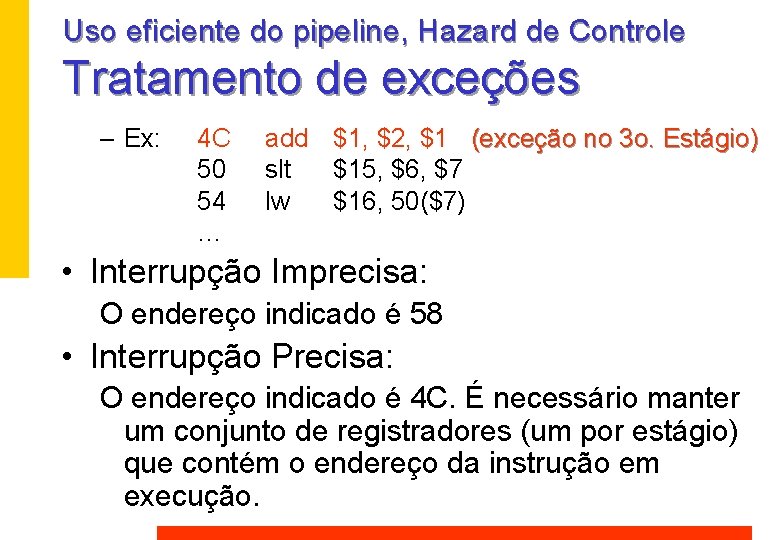
Uso eficiente do pipeline, Hazard de Controle Exceções: outra fonte de hazards • Causas – Opcode inexistente – Ultrapassar limites da memória – operações aritméticas erradas (ex. divisão por zero) • Tratamento: – Chamar subrotina em endereço pré-definido. – O pipeline deve parar imediatamente para não modificar os registradores – Mais de uma exceção pode ocorrer em estágios diferentes no mesmo ciclo. (MIPS: a primeira tem prioridade)
Uso eficiente do pipeline, Hazard de Controle Tratamento de exceções – Ex: 4 C 50 54 … add $1, $2, $1 (exceção no 3 o. Estágio) slt $15, $6, $7 lw $16, 50($7) • Interrupção Imprecisa: O endereço indicado é 58 • Interrupção Precisa: O endereço indicado é 4 C. É necessário manter um conjunto de registradores (um por estágio) que contém o endereço da instrução em execução.
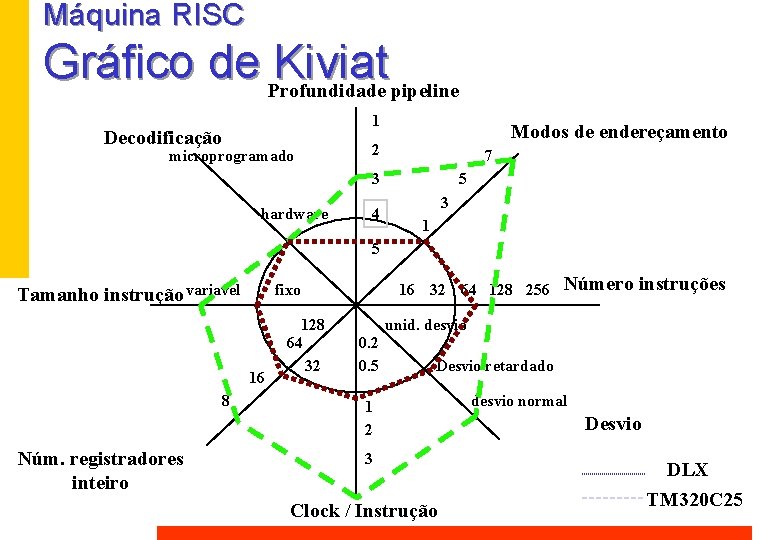
Máquina RISC Gráfico de Profundidade Kiviat pipeline 1 Decodificação microprogramado Modos de endereçamento 2 7 3 hardware 4 5 3 1 5 Tamanho instrução variavel fixo 16 8 Núm. registradores inteiro 128 64 32 16 32 64 128 256 0. 2 0. 5 Número instruções unid. desvio Desvio retardado 1 2 3 Clock / Instrução desvio normal Desvio DLX TM 320 C 25