CLUSTERNGKMELEME GR VE KMEANS ALGORTMASI Hazrlayan ve Sunan
- Slides: 33
CLUSTERİNG(KÜMELEME) GİRİŞ VE K-MEANS ALGORİTMASI Hazırlayan ve Sunan Ferah Sultan Can 04 -06 -7919
Giriş • Teknolojik gelişmelerin başdöndürücü hızla ilerlediği günümüz iş ve bilimdünyasında veri toplama, veriden bilgi elde etme, veriyi depolama ve transfer etme konularına gereksinim her geçen gün daha da artmaktadır. Bilgi, sermayenin en önemli bileşenlerinden birisi haline gelmiştir. Veritabanlarında depolanan verinin boyutu terrabaytlar seviyesine gelmiştir. Bu şekilde depolanan veri, ham şekliyle karar alma süreçlerinde kullanılamadığından, veri madenciliği adı verilen analiz yöntemleriyle ham veriden bilgiye ulaşılmaya çalışılmaktadır.
Tanım Veri kümeleme analizi, hem veri madenciliğinin, hem de veri depolama ve veri transferinin en önemli yöntemlerinden birisidir.
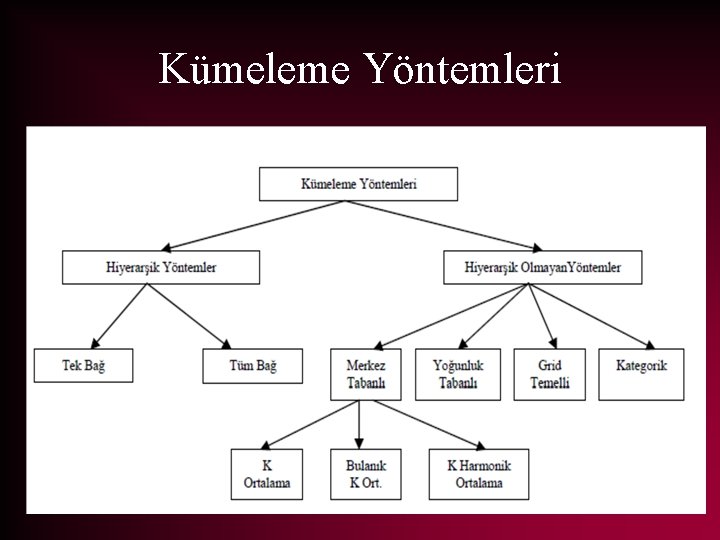
Veri kümeleme yöntemleri en genel olarak hiyerarşik ve hiyerarşik olmayan kümeleme olarak ikiye ayrılır.
KÜMELEME ANALİZİ • Kümeleme analizi; veri madenciliği ve istatistik alanından bakıldığında veri analizi ve desen tanıma işlemleri, vektör nicemleme alanından bakıldığında ise depolama ve transfer işlemleri için kullanılan bir veri işleme yöntemidir. • Kümeleme analizi bir yığını oluşturan bireylerin birden fazla özelliklerini karşılaştırmak suretiyle farklı alt gruplara bölünmesini sağlayan istatistiksel sınıflandırma tekniği olarak tanımlanmaktadır
Yani; kümeleme analizi bir araştırmada incelenen birimleri aralarındaki benzerliklerine göre belirli gruplar içinde toplayarak sınıflandırma yapmayı, birimlerin ortak özelliklerini ortaya koymayı ve bu sınıflar ile ilgili genel tanımlar yapmayı sağlayan bir yöntemdir
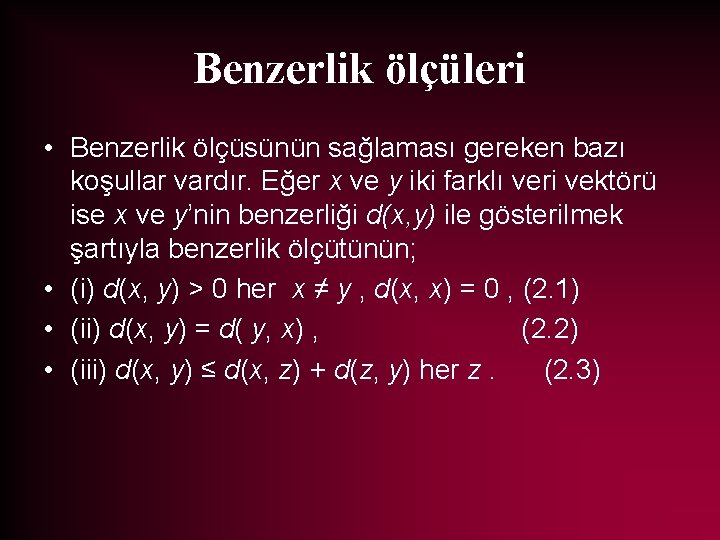
Benzerlik ölçüleri • Benzerlik ölçüsünün sağlaması gereken bazı koşullar vardır. Eğer x ve y iki farklı veri vektörü ise x ve y’nin benzerliği d(x, y) ile gösterilmek şartıyla benzerlik ölçütünün; • (i) d(x, y) > 0 her x ≠ y , d(x, x) = 0 , (2. 1) • (ii) d(x, y) = d( y, x) , (2. 2) • (iii) d(x, y) ≤ d(x, z) + d(z, y) her z. (2. 3)
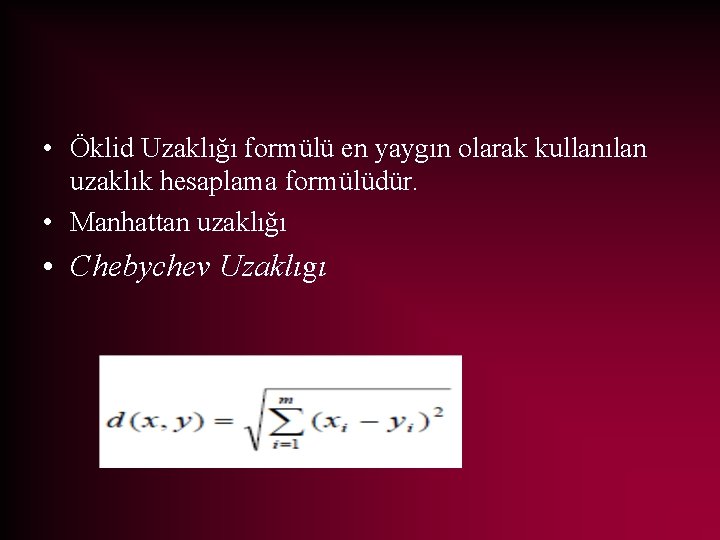
• Öklid Uzaklığı formülü en yaygın olarak kullanılan uzaklık hesaplama formülüdür. • Manhattan uzaklığı • Chebychev Uzaklıgı
Kümeleme Yöntemleri
Hiyerarşik Kümeleme • Hiyerarşik kümeleme yöntemlerinin tümü ilk adımda bütün kayıtları, tek kayıttan oluşan ayrı bir küme olarak değerlendirir. Daha sonra bu kümeler arasında uzaklıkları en az olan iki tanesini birleştirerek bir tane iki elemanlı küme haline getirir. Bunu izleyen her adımda, varolan kümeler arasında, birbirlerine uzaklıkları en küçük olan iki adet küme birleştirilerek tek bir küme haline getirilir. Bu birleştirme işlemleri, daha önceden belirlenen sayıda küme kalana kadar devam eder.
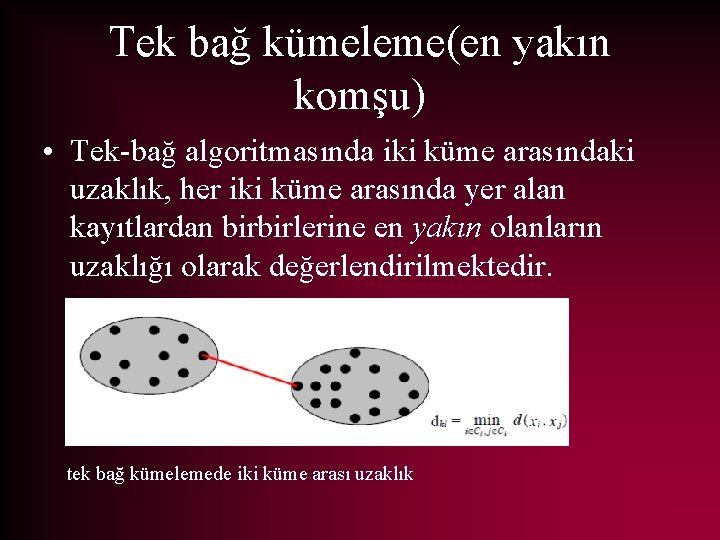
Tek bağ kümeleme(en yakın komşu) • Tek-bağ algoritmasında iki küme arasındaki uzaklık, her iki küme arasında yer alan kayıtlardan birbirlerine en yakın olanların uzaklığı olarak değerlendirilmektedir. tek bağ kümelemede iki küme arası uzaklık
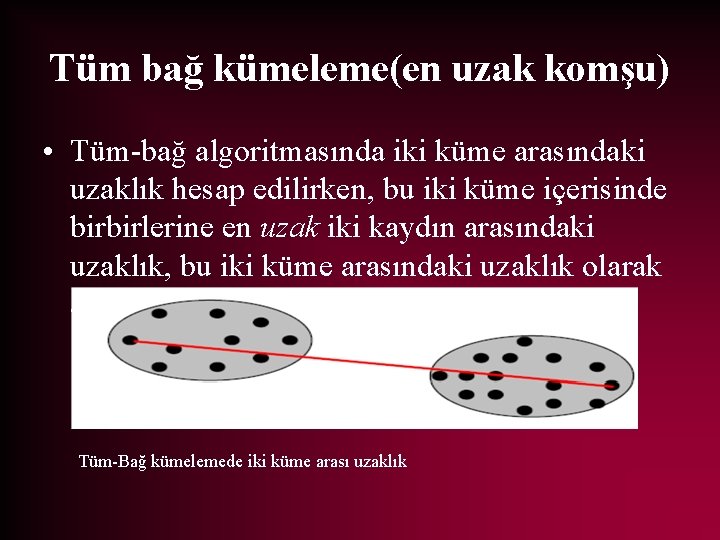
Tüm bağ kümeleme(en uzak komşu) • Tüm-bağ algoritmasında iki küme arasındaki uzaklık hesap edilirken, bu iki küme içerisinde birbirlerine en uzak iki kaydın arasındaki uzaklık, bu iki küme arasındaki uzaklık olarak alınır. Tüm-Bağ kümelemede iki küme arası uzaklık
Hiyerarşik Olmayan Kümeleme • Kümelenmesi gereken çok sayıda kaydın bulunduğu uygulamalarda, birleştirme ağacının oluşturulması gibi çok ağır bir iş yükü getiren bir algoritma yerine hiyerarşik olmayan yöntemler daha verimli olmaktadır. Ancak hiyerarşik olmayan yöntemlerin zayıf tarafları da vardır. • Bunlardan en önemlisi, kümeleme işlemi sonucunda oluşması istenilen küme adedinin işlemden önce algoritma tarafından bilinmesinin gerekliliğidir.
Verilerin farklı kümeler arasında yinelemeli olarak yerleştirilmesi esasına dayanır. Bu tip kümelemeyi K tane merkezi bulabilmek için J(X, C) amaç fonksiyonunun en iyilemesi problemi olarak tanımlamaktadır. Merkez tabanlı kümelemede en temel kümeleme algoritması K- ortalama kümeleme algoritmasıdır. Bulanık K-Ortalama ve K-Harmonik Ortalama algoritmaları ise K- Ortalama’dan türetilmiş esnek kümeleme algoritmalarıdır.
K-MEANS ALGORTMASI GENEL BİLGİLER • En iyi bilinen ve yaygın kullanılan algoritmalardan biri olan kmeans, verileri sınıflandıran bir kümeleme algoritmasıdır. Verilen nesneleri nitelik veya özelliklerine göre k adet sınıfa ayırmak amacıyla kullanılır. Sınıflandırma, verilerin en yakın veya benzer oldukları küme merkezleri (centroid) etrafına yerlestirilmesi ile gerçeklestirilir. • Bu çalısmada kullanılan k-means algoritması, J. Mac. Queen [10] tarafından 1967 yılında tanıtılmıstır. Çalısma yönteminde, Öklit uzaklıgı temel alınarak kümeleme yapılmaktadır. Bu yöntem yıllardır bilimsel ve endüstriyel uygulamalarda en yogun • kullanılan kümeleme algoritması haline gelmistir.
Algoritmaya k-means adı verilmesinin nedeni, algoritmanın çalısmasından önce sabit bir küme sayısına ihtiyaç duyulmasıdır. Küme sayısı k ile gösterilir ve elemanlarının birbirlerine olan yakınlıklarına göre olusacak grup sayısını ifade eder. Buna göre k önceden bilinen ve kümeleme islemi bitene kadar degeri degismeyen sabit bir pozitif tamsayıdır.
Çok yaygın kullanımı olan bu algoritmanın şöyle belirtildigi gibi birtakım zayıf yanları da bulunmaktadır:
• Algoritmanın basında giris parametresi olarak bir k sayısına ihtiyacı vardır. Elde edilecek olan sonuçlar k sayısına göre degiskenlik gösterebilir. Eger küme sayısı belirli degil ise deneme yoluyla en uygun sayı bulunur • Çakısan kümelerde iyi sonuç vermez. • Her eleman aynı anda verilen bir kümenin içindedir veya dısındadır. • K-means algoritması sadece sayısal veriler ile kullanılabilmektedir. Kategorik verilerin kümelenmesi için k-means algoritması bir çözüm sunmaz
d boyutlu metrik uzayda verilen n adet nesnenin aynı kümelerdeki nesneler diğer kümelerdekine kıyasla daha benze olacak şekilde k adet kümeye yerleştirilerek bölünmesinin yapılmasıdır. bu algoritma şu parametreleri alır: k: kaç küme olacak d: kaç nesne olacak.
K-means yöntemi, ilk önce n adet nesneden rasgele k adet nesne seçer ve bu nesnelerin her biri , bir kümenin merkezini veya orta noktasını temsil eder. geriye kalan nesnelerden her biri kendisine en yakın olan küme merkezine göre kümelere dağılırlar. yani bir nesne hangi kümenin merkezine daha yakınsa o kümeye yerleşir. ardından her küme için ortalama hesaplanır ve hesaplanan bu değer o kümenin yeni merkezi olur. bu işlem, tüm nesneler kümelere yerleşinceye kadar devam eder.
K-means Algoritmasının Adımları • 1. ADIM: küme merkezlerini temsil edecek k adet eleman belirlenir. (Ancak elemanların degerleri birbirine çok yakın ise, seçim rastgele yapılır veya birbirinden uzak elemanlar seçilir. )
2. ADIM: • okunan elemanlar kendilerine en yakın k adet küme merkezinden birine dahil edilir.
3. ADIM: • her bir kümeye eklenen yeni eleman ile, küme elemanlarının agırlıklı ortalaması tekrar hesaplanarak yeni bir küme merkezi bulunur.
4. ADIM: • Kümeleme islemi, tüm elemanların tekrar aynı veya farklı bir kümeye dahil edilmesiyle devam eder. Elemanların bir kümeye dahil edilmesi ve küme merkezlerinin tekrar hesaplanması islemlerine ait döngü, küme sınırlarının degisimi bitene kadar devam eder.
K-means algoritması bilgisayar programına uygulanırken şu adımlar izlenir:
Kısaca algoritmamız; 1. Küme sayısı (k) okunur. Bu deger algoritmaya dısardan verilir. 2. k adet rastgele küme merkezi belirlenir. ilk k eleman merkez olabilir. 3. Elemanların merkezlere yakınlıkları hesaplanır. 4. Elemanlar yakın oldukları merkezlere göre kümelenir 5. Kümelerin ortalamaları hesaplanarak yeni küme merkezleri belirlenir 6. Kümelenecek baska eleman var mı? Hayır ise git. Evet ise dur.
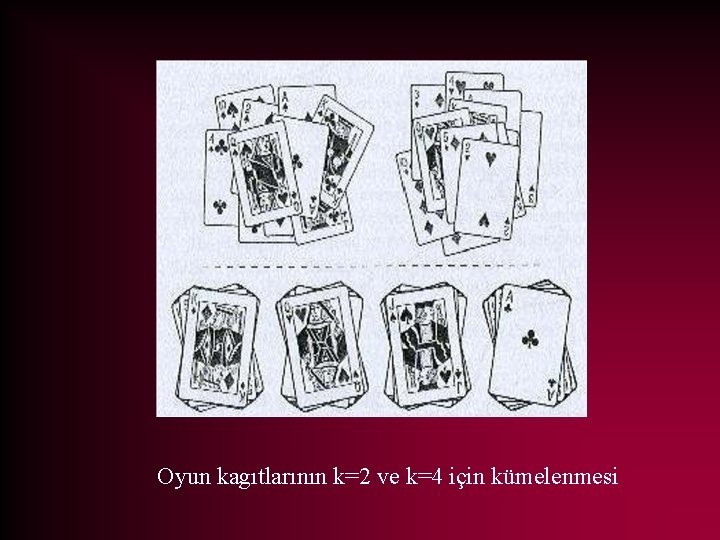
K Sayısının Kümelemeye Etkisi • K islem öncesinde bilinen ve kümelemeislemi bitene kadar degeri degismeyen sabit bir pozitif tamsayıdır. şekilde deste oyun kagıdının k=2 ve k=4 için kümeleme sonuçları gösterilmektedir. Sekilden görülecegi gibi k’nın farklı degerler alması, her biri geçerli olan çok farklı kümeler olusmasını saglamaktadır. Hangisinin daha etkili oldugu, hangi kümelemenin kullanılacagına baglıdır.
Oyun kagıtlarının k=2 ve k=4 için kümelenmesi
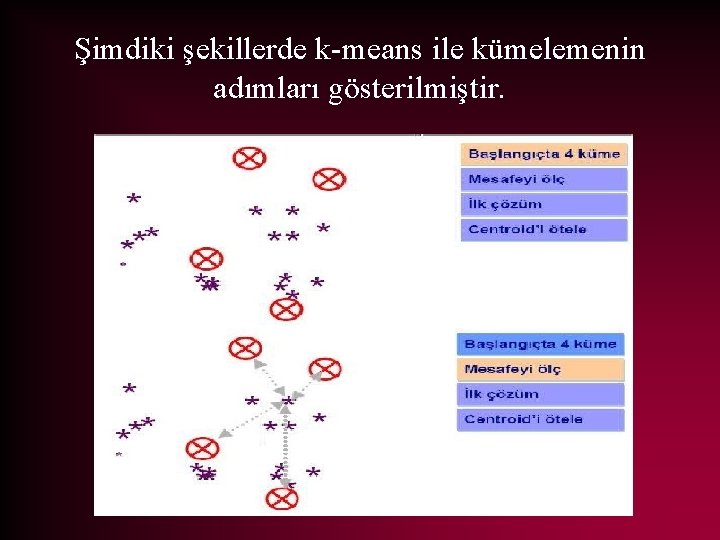
Şimdiki şekillerde k-means ile kümelemenin adımları gösterilmiştir.
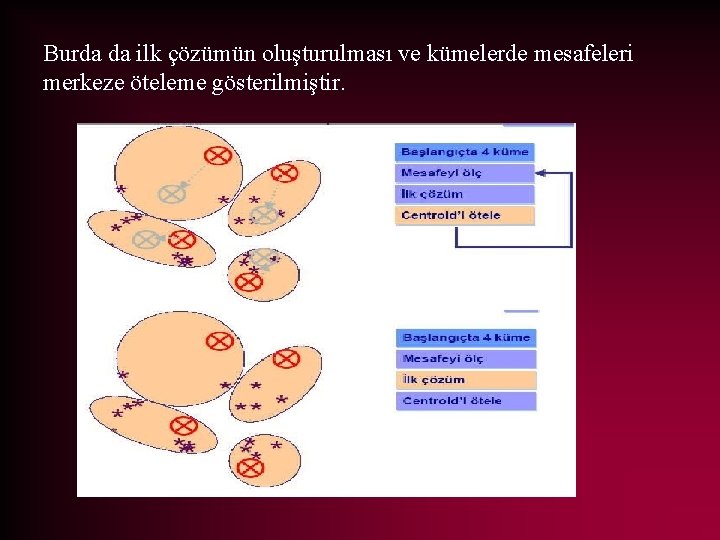
Burda da ilk çözümün oluşturulması ve kümelerde mesafeleri merkeze öteleme gösterilmiştir.
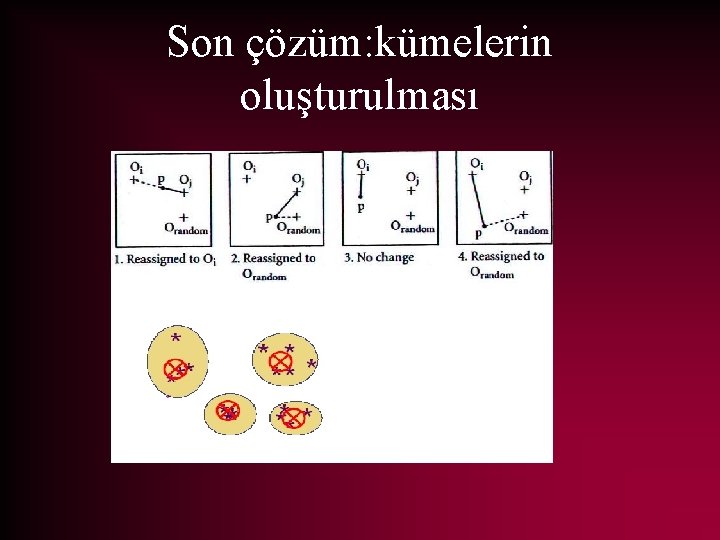
Son çözüm: kümelerin oluşturulması
• Şimdi de k-means algoritmasının verilen gözlem noktalarında bir uygulama örneğini sizlere tahtada sunacağım. .
TEŞEKKÜRLER