Projektowanie cyfrowych systemw w oparciu o ukady PLD
- Slides: 20
Projektowanie cyfrowych systemów w oparciu o układy PLD (i VLSI) Ernest Jamro Dodawanie
Literatura • Omondi A. R Computer Arithmetic Systems. Algorithms Architecture and Implementations, Prentice Hall 1994. • Pirsch P. , Architectures for Digital Signal Processing, Chichester UK, Wiley 1998. • U. Mayer-Baese Digital Signal Processing with Field Programmable Gate Arrays, Springer, Berlin 2001 • Keshab K. Parhi VLSI Digital Signal Processing Systems, J. Wiley & sons, 1999 • Kazimierz Wiatr Akceleracja Obliczeń w systemach wizyjnych, WNT, W-wa 2003 • E. Jamro, K. Wiatr, Układy mnożące przez stały współczynnik implementowane w układach programowalnych FPGA, http: //home. agh. edu. pl/~jamro/2001 KCM_pl. pdf • www. xilinx. com • www. altera. com
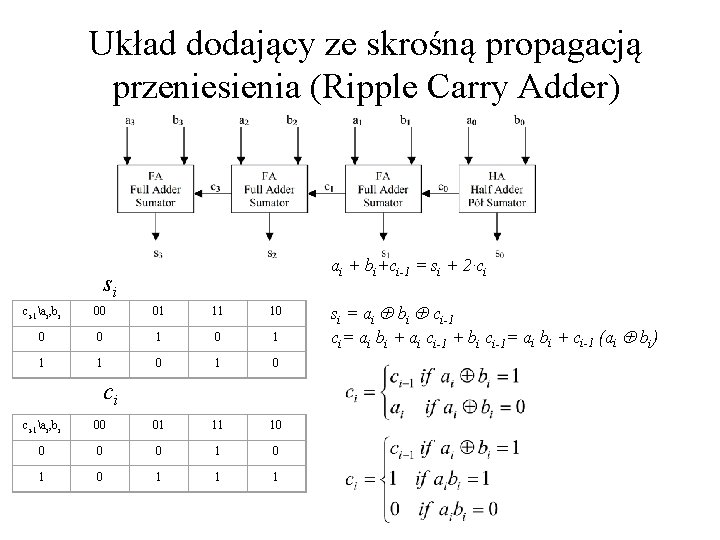
Układ dodający ze skrośną propagacją przeniesienia (Ripple Carry Adder) ai + bi+ci-1 = si + 2·ci si ci-1ai, bi 00 01 11 10 0 0 1 1 1 0 ci ci-1ai, bi 00 01 11 10 0 1 0 1 1 1 si = ai bi ci-1 ci= ai bi + ai ci-1 + bi ci-1= ai bi + ci-1 (ai bi)
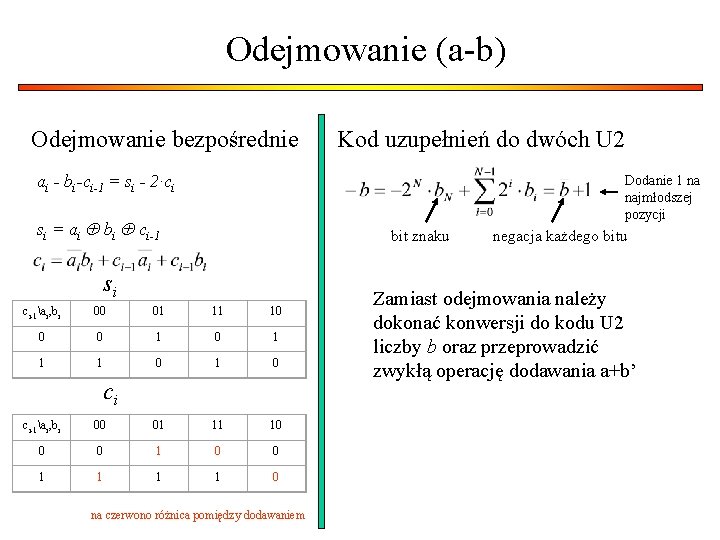
Odejmowanie (a-b) Odejmowanie bezpośrednie Kod uzupełnień do dwóch U 2 ai - bi-ci-1 = si - 2·ci Dodanie 1 na najmłodszej pozycji si = ai bi ci-1 bit znaku si ci-1ai, bi 00 01 11 10 0 0 1 1 1 0 ci ci-1ai, bi 00 01 11 10 0 0 1 1 1 1 0 na czerwono różnica pomiędzy dodawaniem negacja każdego bitu Zamiast odejmowania należy dokonać konwersji do kodu U 2 liczby b oraz przeprowadzić zwykłą operację dodawania a+b’
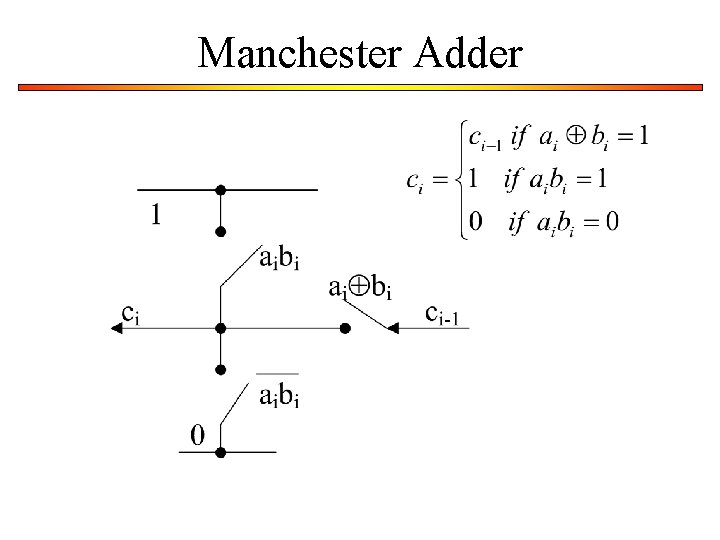
Manchester Adder
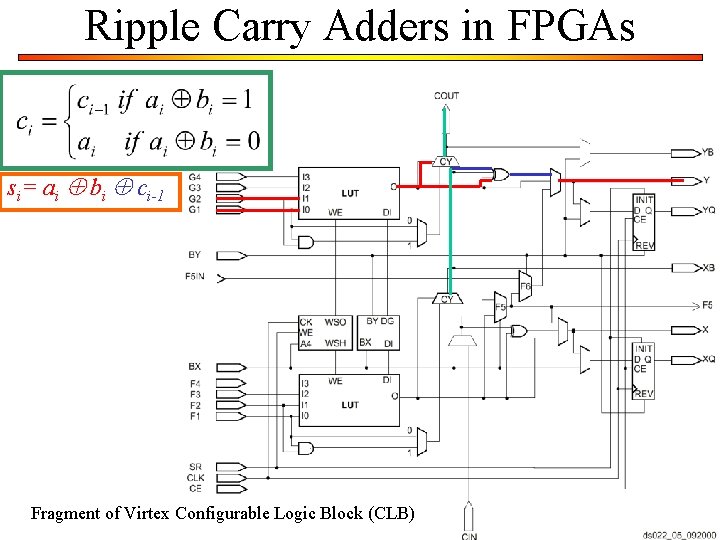
Ripple Carry Adders in FPGAs si= ai bi ci-1 Fragment of Virtex Configurable Logic Block (CLB)
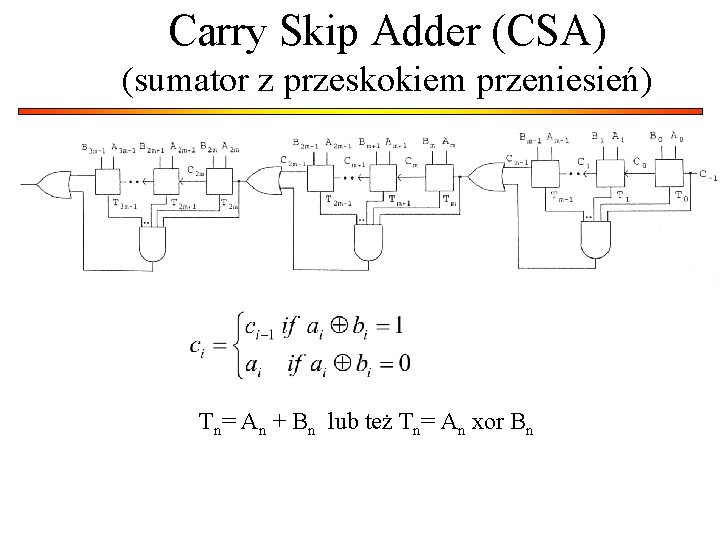
Carry Skip Adder (CSA) (sumator z przeskokiem przeniesień) Tn= An + Bn lub też Tn= An xor Bn
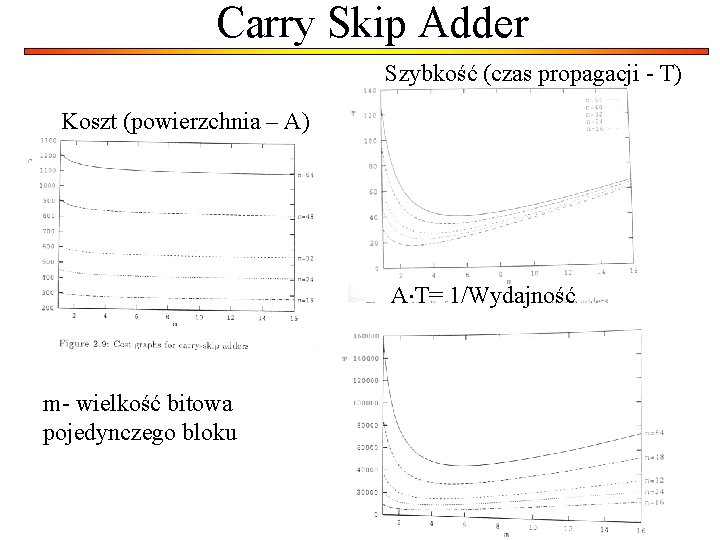
Carry Skip Adder Szybkość (czas propagacji - T) Koszt (powierzchnia – A) A T= 1/Wydajność m- wielkość bitowa pojedynczego bloku
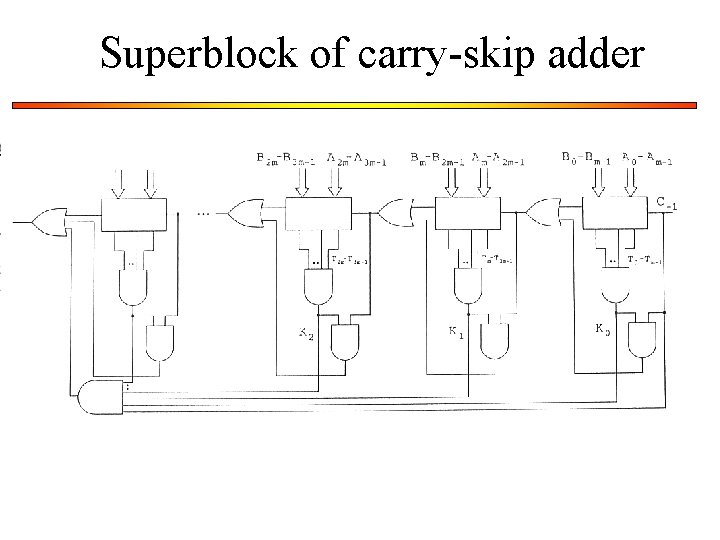
Superblock of carry-skip adder
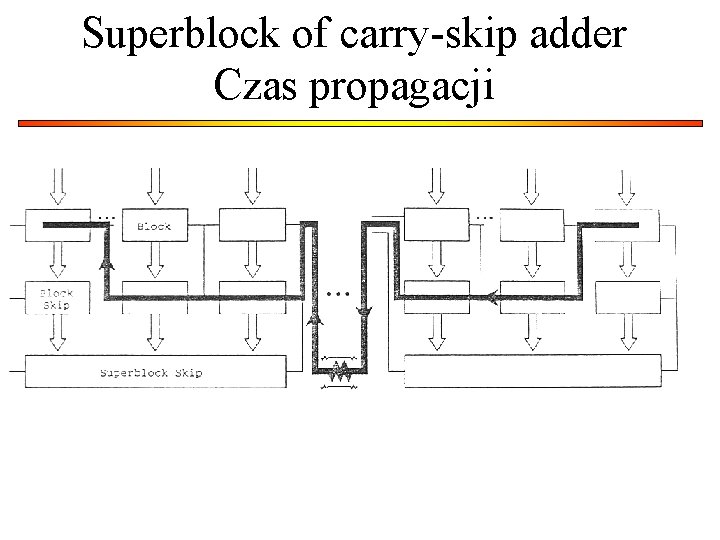
Superblock of carry-skip adder Czas propagacji
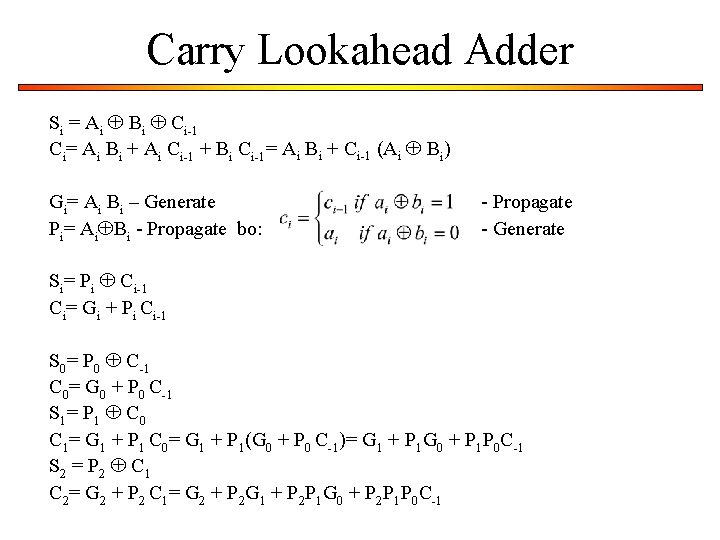
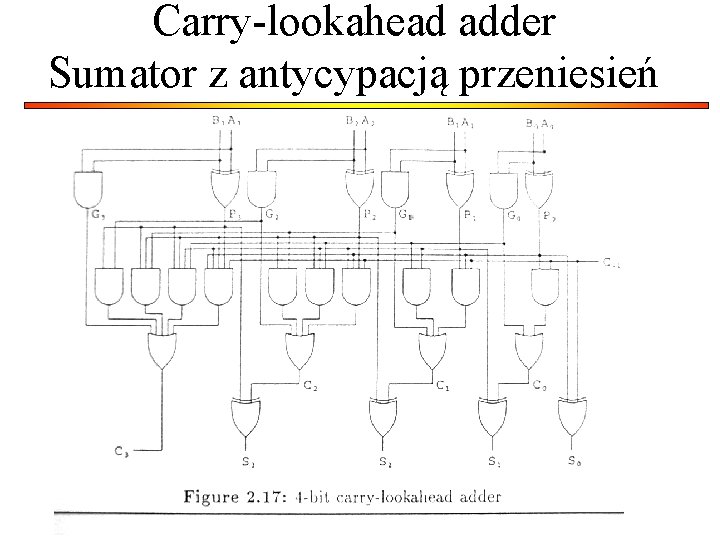
Carry Lookahead Adder Si = Ai Bi Ci-1 Ci= Ai Bi + Ai Ci-1 + Bi Ci-1= Ai Bi + Ci-1 (Ai Bi) Gi= Ai Bi – Generate Pi= Ai Bi - Propagate bo: - Propagate - Generate Si= Pi Ci-1 Ci= Gi + Pi Ci-1 S 0= P 0 C-1 C 0= G 0 + P 0 C-1 S 1 = P 1 C 0 C 1= G 1 + P 1 C 0= G 1 + P 1(G 0 + P 0 C-1)= G 1 + P 1 G 0 + P 1 P 0 C-1 S 2 = P 2 C 1 C 2= G 2 + P 2 C 1= G 2 + P 2 G 1 + P 2 P 1 G 0 + P 2 P 1 P 0 C-1
Carry-lookahead adder Sumator z antycypacją przeniesień
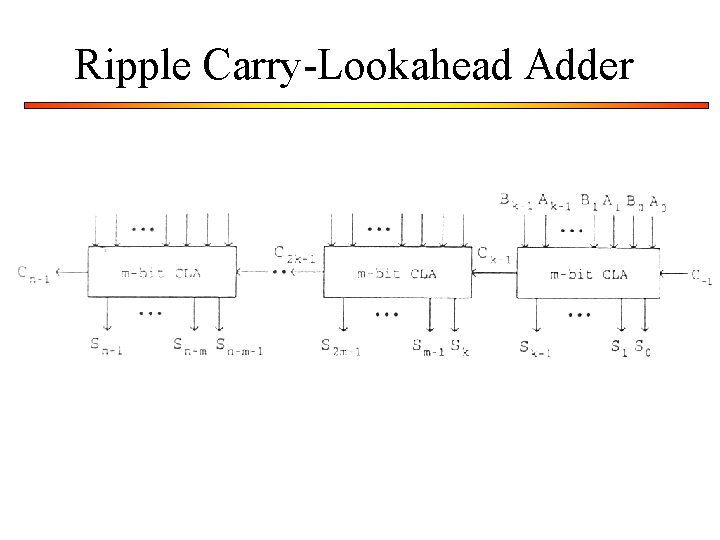
Ripple Carry-Lookahead Adder
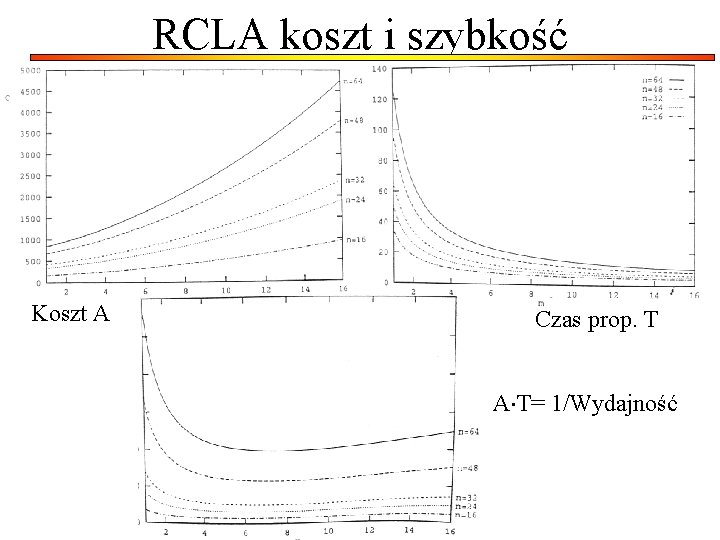
RCLA koszt i szybkość Koszt A Czas prop. T A T= 1/Wydajność
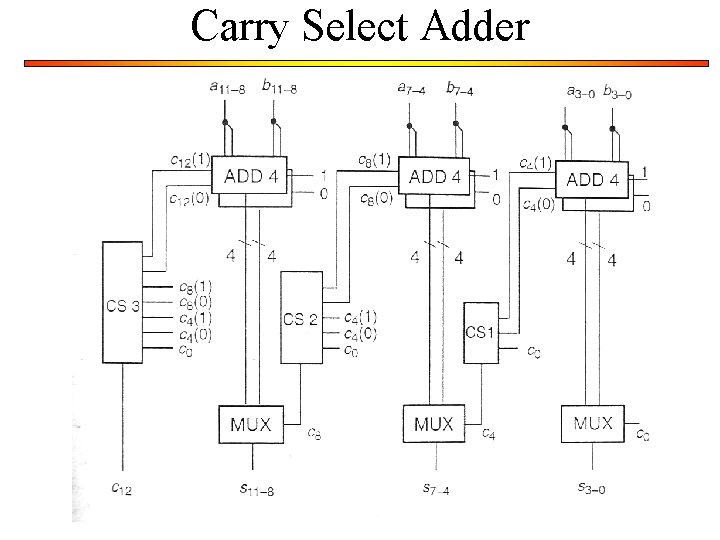
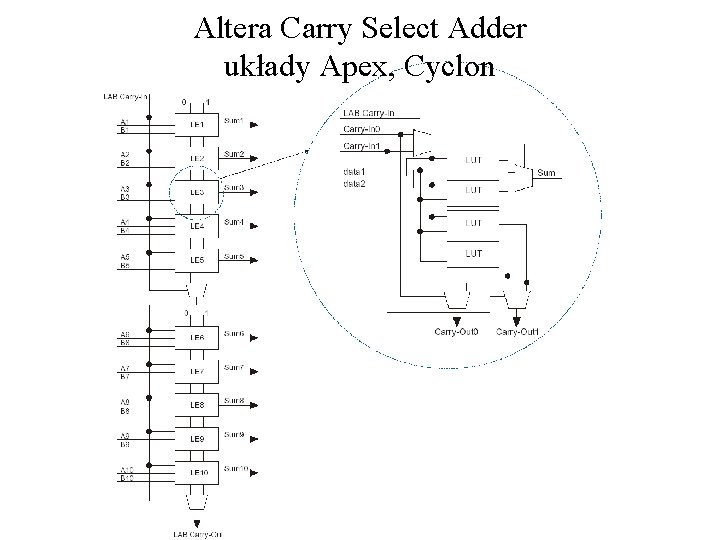
Carry Select Adder
Altera Carry Select Adder układy Apex, Cyclon
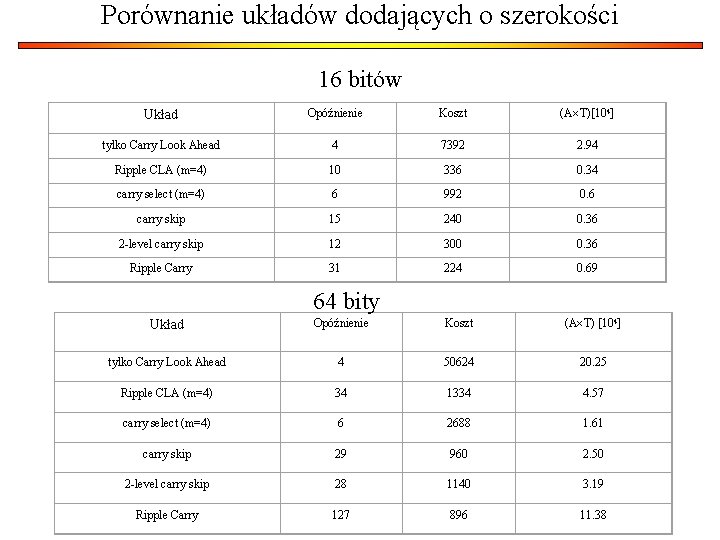
Porównanie układów dodających o szerokości 16 bitów Układ Opóźnienie Koszt (A T)[104] tylko Carry Look Ahead 4 7392 2. 94 Ripple CLA (m=4) 10 336 0. 34 carry select (m=4) 6 992 0. 6 carry skip 15 240 0. 36 2 -level carry skip 12 300 0. 36 Ripple Carry 31 224 0. 69 64 bity Układ Opóźnienie Koszt (A T) [104] tylko Carry Look Ahead 4 50624 20. 25 Ripple CLA (m=4) 34 1334 4. 57 carry select (m=4) 6 2688 1. 61 carry skip 29 960 2. 50 2 -level carry skip 28 1140 3. 19 Ripple Carry 127 896 11. 38
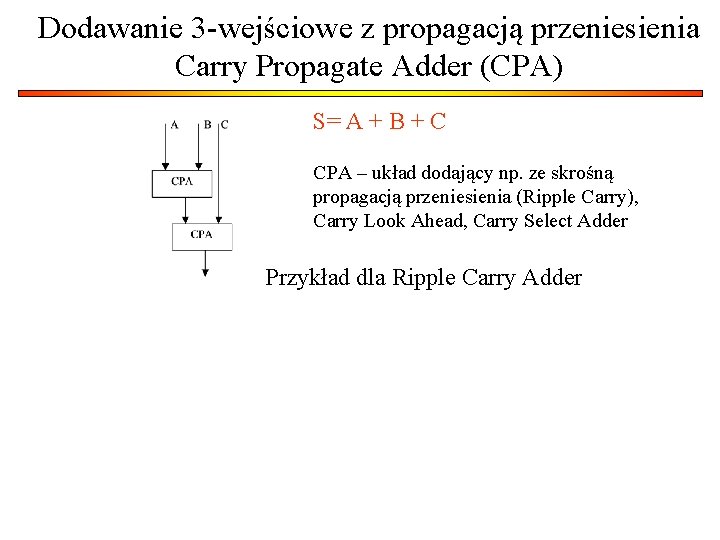
Dodawanie 3 -wejściowe z propagacją przeniesienia Carry Propagate Adder (CPA) S= A + B + C CPA – układ dodający np. ze skrośną propagacją przeniesienia (Ripple Carry), Carry Look Ahead, Carry Select Adder Przykład dla Ripple Carry Adder
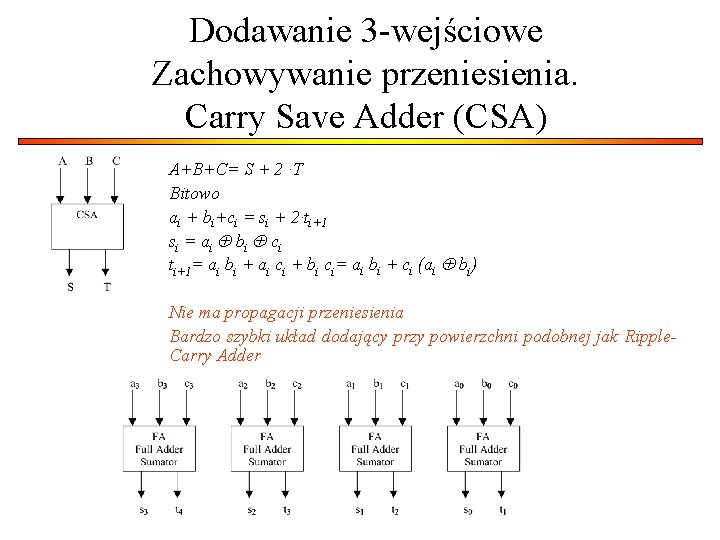
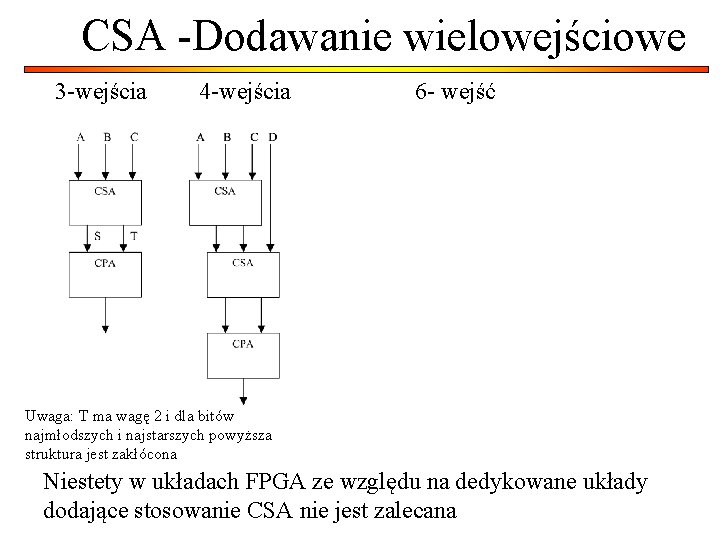
Dodawanie 3 -wejściowe Zachowywanie przeniesienia. Carry Save Adder (CSA) A+B+C= S + 2 ·T Bitowo ai + bi+ci = si + 2·ti+1 si = ai bi ci ti+1= ai bi + ai ci + bi ci= ai bi + ci (ai bi) Nie ma propagacji przeniesienia Bardzo szybki układ dodający przy powierzchni podobnej jak Ripple. Carry Adder
CSA -Dodawanie wielowejściowe 3 -wejścia 4 -wejścia 6 - wejść Uwaga: T ma wagę 2 i dla bitów najmłodszych i najstarszych powyższa struktura jest zakłócona Niestety w układach FPGA ze względu na dedykowane układy dodające stosowanie CSA nie jest zalecana