
WWW NCBI NLM NIH GOV Pub Med Scientific
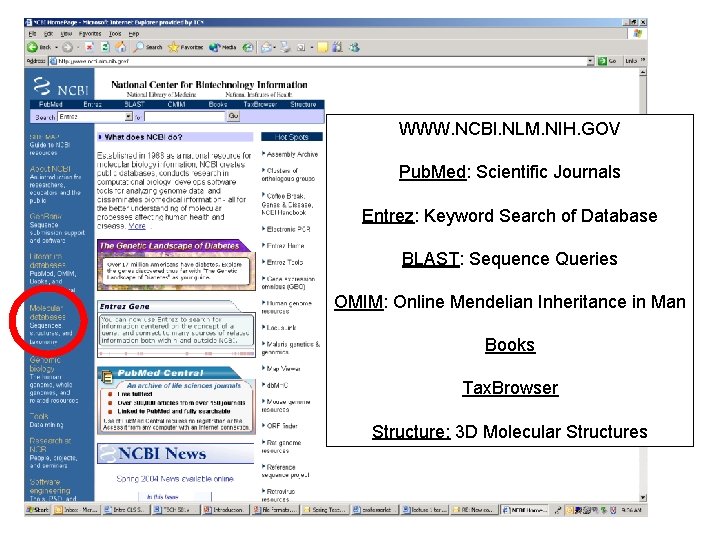
WWW. NCBI. NLM. NIH. GOV Pub. Med: Scientific Journals Entrez: Keyword Search of Database BLAST: Sequence Queries OMIM: Online Mendelian Inheritance in Man Books Tax. Browser Structure: 3 D Molecular Structures
Sequence Files Since the information relevant to biological processes is contained in the gene or protein sequence, all genetic and protein data are contained in “sequence” files. Importantly, there is a “directionality” that exists in nature that is conserved in the sequence file; Nucleic Acids are always written 5’ to 3’ (describing the 5’ or 3’ free hydroxyl group used in the phosphodiesterase bond). nucleic acids (genes): 5’-AGCTCGTGTAGACCATTC-3’ Amino Acids are always written with the free amino (N-terminus) first and the carboxylic acid (C-terminus) last. amino acids (proteins): amino-IPKERYRGQIESIWA-carboxy
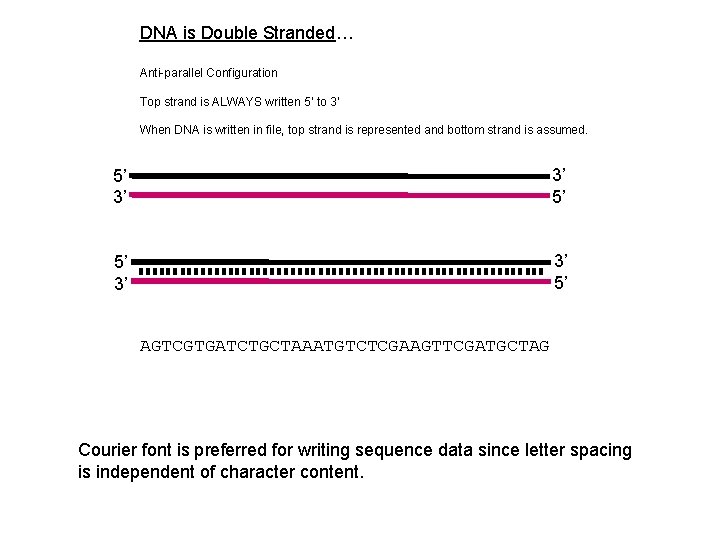
DNA is Double Stranded… Anti-parallel Configuration Top strand is ALWAYS written 5’ to 3’ When DNA is written in file, top strand is represented and bottom strand is assumed. 5’ 3’ 3’ 5’ AGTCGTGATCTGCTAAATGTCTCGAAGTTCGATGCTAG ||||||||||||||||||| TCAGCACTAGACGATTTACAGAGCTTCAAGATACGATC Courier font is preferred for writing sequence data since letter spacing is independent of character content.
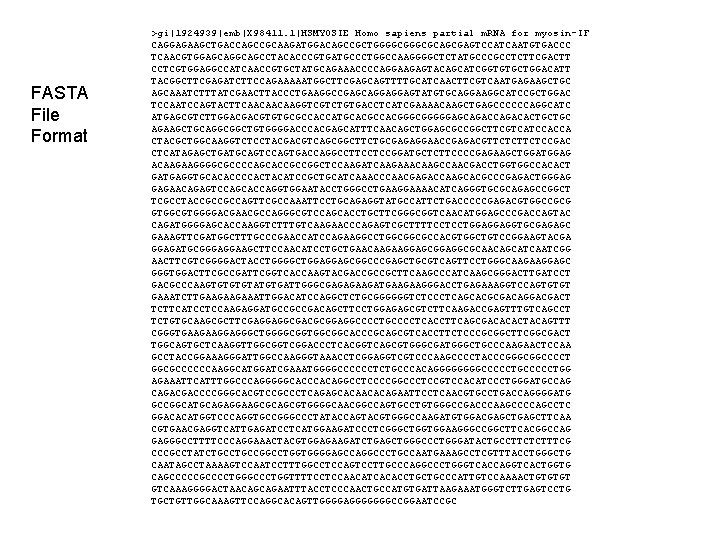
FASTA File Format >gi|1924939|emb|X 98411. 1|HSMYOSIE Homo sapiens partial m. RNA for myosin-IF CAGGAGAAGCTGACCAGCCGCAAGATGGACAGCCGCTGGGGCGCAGCGAGTCCATCAATGTGACCC TCAACGTGGAGCAGCCTACACCCGTGATGCCCTGGCCAAGGGGCTCTATGCCCGCCTCTTCGACTT CCTCGTGGAGGCCATCAACCGTGCTATGCAGAAACCCCAGGAAGAGTACAGCATCGGTGTGCTGGACATT TACGGCTTCGAGATCTTCCAGAAAAATGGCTTCGAGCAGTTTTGCATCAACTTCGTCAATGAGAAGCTGC AGCAAATCTTTATCGAACTTACCCTGAAGGCCGAGCAGGAGGAGTATGTGCAGGAAGGCATCCGCTGGAC TCCAATCCAGTACTTCAACAACAAGGTCGTCTGTGACCTCATCGAAAACAAGCTGAGCCCCCCAGGCATC ATGAGCGTCTTGGACGACGTGTGCGCCACCATGCACGCCACGGGGGAGCAGACACTGCTGC AGAAGCTGCAGGCGGCTGTGGGGACCCACGAGCATTTCAACAGCTGGAGCGCCGGCTTCGTCATCCACCA CTACGCTGGCAAGGTCTCCTACGACGTCAGCGGCTTCTGCGAGAGGAACCGAGACGTTCTCCGAC CTCATAGAGCTGATGCAGTCCAGTGACCAGGCCTTCCTCCGGATGCTCTTCCCCGAGAAGCTGGAG ACAAGAAGGGGCGCCCCAGCACCGCCGGCTCCAAGATCAAGAAACAAGCCAACGACCTGGTGGCCACACT GATGAGGTGCACACCCCACTACATCCGCTGCATCAAACCCAACGAGACCAAGCACGCCCGAGACTGGGAG GAGAACAGAGTCCAGCACCAGGTGGAATACCTGGGCCTGAAGGAAAACATCAGGGTGCGCAGAGCCGGCT TCGCCTACCGCCGCCAGTTCGCCAAATTCCTGCAGAGGTATGCCATTCTGACCCCCGAGACGTGGCCGCG GTGGCGTGGGGACGAACGCCAGGGCGTCCAGCACCTGCTTCGGGCGGTCAACATGGAGCCCGACCAGTAC CAGATGGGGAGCACCAAGGTCTTTGTCAAGAACCCAGAGTCGCTTTTCCTCCTGGAGGAGGTGCGAGAGC GAAAGTTCGATGGCTTTGCCCGAACCATCCAGAAGGCCTGGCGGCGCCACGTGGCTGTCCGGAAGTACGA GGAGATGCGGGAGGAAGCTTCCAACATCCTGCTGAACAAGAAGGAGCGGAGGCGCAACAGCATCAATCGG AACTTCGTCGGGGACTACCTGGGGCTGGAGGAGCGGCCCGAGCTGCGTCAGTTCCTGGGCAAGAAGGAGC GGGTGGACTTCGCCGATTCGGTCACCAAGTACGACCGCCGCTTCAAGCCCATCAAGCGGGACTTGATCCT GACGCCCAAGTGTATGTGATTGGGCGAGAGAAGATGAAGAAGGGACCTGAGAAAGGTCCAGTGTGT GAAATCTTGAAGAAGAAATTGGACATCCAGGCTCTGCGGGGGGTCTCCCTCAGCACGCGACAGGACGACT TCTTCATCCTCCAAGAGGATGCCGCCGACAGCTTCCTGGAGAGCGTCTTCAAGACCGAGTTTGTCAGCCT TCTGTGCAAGCGCTTCGAGGAGGCGACGCGGAGGCCCCTCACCTTCAGCGACACACTACAGTTT CGGGTGAAGAAGGAGGGCTGGGGCGGTGGCGGCACCCGCAGCGTCACCTTCTCCCGCGGCTTCGGCGACT TGGCAGTGCTCAAGGTTGGCGGTCGGACCCTCACGGTCAGCGTGGGCGATGGGCTGCCCAAGAACTCCAA GCCTACCGGAAAGGGATTGGCCAAGGGTAAACCTCGGAGGTCGTCCCAAGCCCCTACCCGGGCGGCCCCT GGCGCCCCCCAAGGCATGGATCGAAATGGGGCCCCCCTCTGCCCACAGGGGCCCCCTGG AGAAATTCATTTGGCCCAGGGGGCACCCACAGGCCTCCCCGGCCCTCCGTCCACATCCCTGGGATGCCAG CAGACGACCCCGGGCACGTCCGCCCTCAGAGCACAACACAGAATTCCTCAACGTGCCTGACCAGGGGATG GCCGGCATGCAGAGGAAGCGCAGCGTGGGGCAACGGCCAGTGCCTGTGGGCCGACCCAAGCCCCAGCCTC GGACACATGGTCCCAGGTGCCGGGCCCTATACCAGTACGTGGGCCAAGATGTGGACGAGCTTCAA CGTGAACGAGGTCATTGAGATCCTCATGGAAGATCCCTCGGGCTGGTGGAAGGGCCGGCTTCACGGCCAG GAGGGCCTTTTCCCAGGAAACTACGTGGAGAAGATCTGAGCTGGGCCCTGGGATACTGCCTTCTCTTTCG CCCGCCTATCTGCCGGCCTGGTGGGGAGCCAGGCCCTGCCAATGAAAGCCTCGTTTACCTGGGCTG CAATAGCCTAAAAGTCCAATCCTTTGGCCTCCAGTCCTTGCCCAGGCCCTGGGTCACCAGGTCACTGGTG CAGCCCCCGCCCCTGGGCCCTGGTTTTCCTCCAACATCACACCTGCTGCCCATTGTCCAAAACTGTGTGT GTCAAAGGGGACTAACAGCAGAATTTACCTCCCAACTGCCATGTGATTAAGAAATGGGTCTTGAGTCCTG TGCTGTTGGCAAAGTTCCAGGCACAGTTGGGGAGGGGGGGCCGGAATCCGC
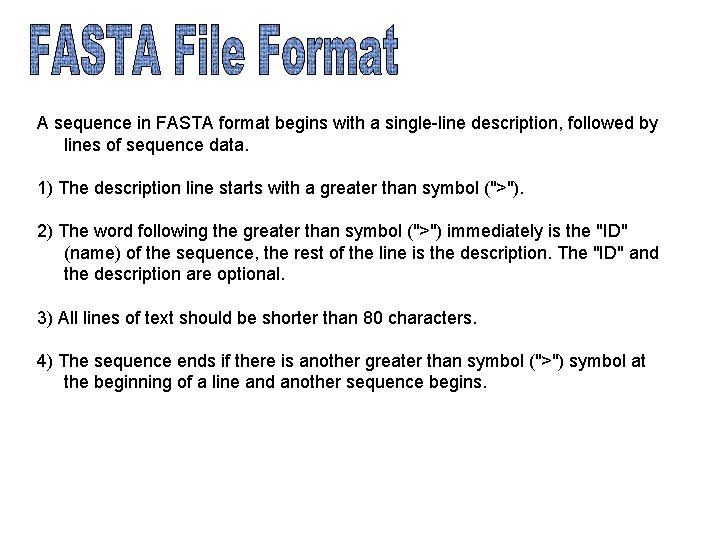
A sequence in FASTA format begins with a single-line description, followed by lines of sequence data. 1) The description line starts with a greater than symbol (">"). 2) The word following the greater than symbol (">") immediately is the "ID" (name) of the sequence, the rest of the line is the description. The "ID" and the description are optional. 3) All lines of text should be shorter than 80 characters. 4) The sequence ends if there is another greater than symbol (">") symbol at the beginning of a line and another sequence begins.
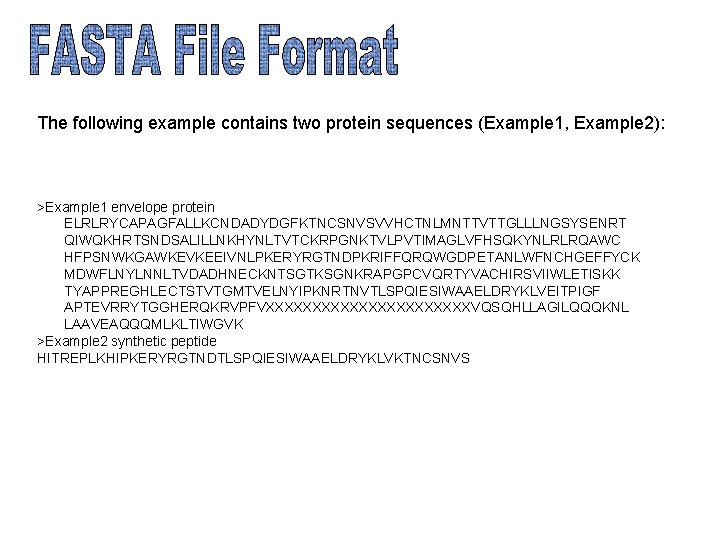
The following example contains two protein sequences (Example 1, Example 2): >Example 1 envelope protein ELRLRYCAPAGFALLKCNDADYDGFKTNCSNVSVVHCTNLMNTTVTTGLLLNGSYSENRT QIWQKHRTSNDSALILLNKHYNLTVTCKRPGNKTVLPVTIMAGLVFHSQKYNLRLRQAWC HFPSNWKGAWKEVKEEIVNLPKERYRGTNDPKRIFFQRQWGDPETANLWFNCHGEFFYCK MDWFLNYLNNLTVDADHNECKNTSGTKSGNKRAPGPCVQRTYVACHIRSVIIWLETISKK TYAPPREGHLECTSTVTGMTVELNYIPKNRTNVTLSPQIESIWAAELDRYKLVEITPIGF APTEVRRYTGGHERQKRVPFVXXXXXXXXXXXVQSQHLLAGILQQQKNL LAAVEAQQQMLKLTIWGVK >Example 2 synthetic peptide HITREPLKHIPKERYRGTNDTLSPQIESIWAAELDRYKLVKTNCSNVS
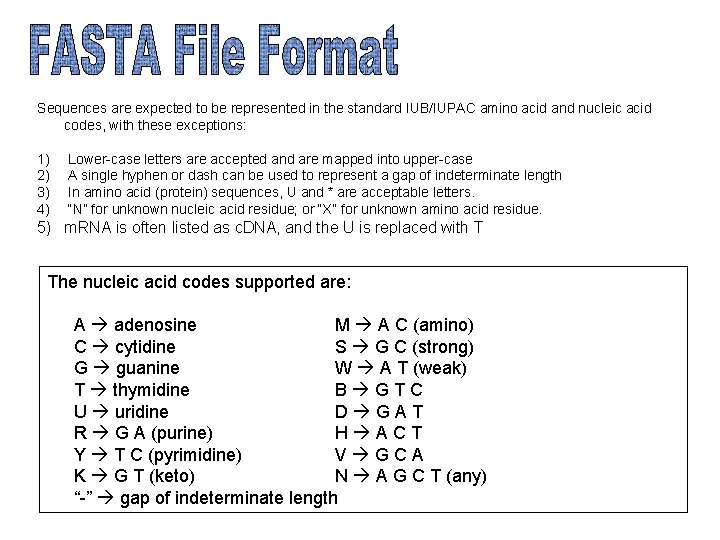
Sequences are expected to be represented in the standard IUB/IUPAC amino acid and nucleic acid codes, with these exceptions: 1) 2) 3) 4) Lower-case letters are accepted and are mapped into upper-case A single hyphen or dash can be used to represent a gap of indeterminate length In amino acid (protein) sequences, U and * are acceptable letters. “N” for unknown nucleic acid residue; or “X” for unknown amino acid residue. 5) m. RNA is often listed as c. DNA, and the U is replaced with T The nucleic acid codes supported are: A adenosine M A C (amino) C cytidine S G C (strong) G guanine W A T (weak) T thymidine B GTC U uridine D GAT R G A (purine) H ACT Y T C (pyrimidine) V GCA K G T (keto) N A G C T (any) “-” gap of indeterminate length
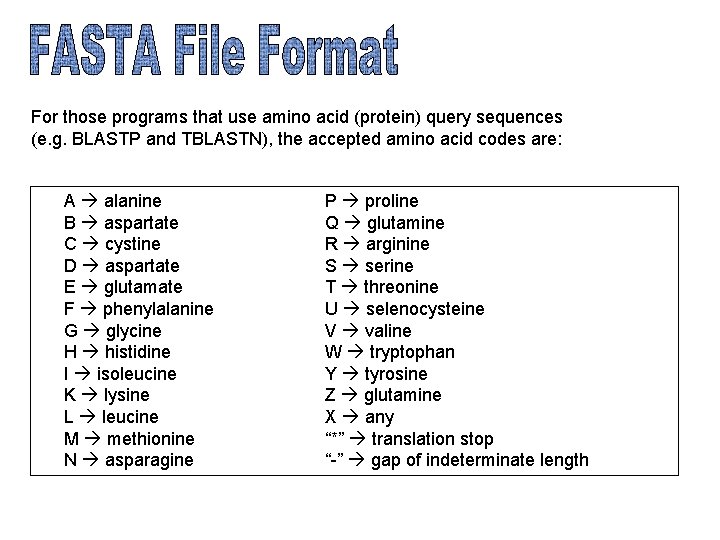
For those programs that use amino acid (protein) query sequences (e. g. BLASTP and TBLASTN), the accepted amino acid codes are: A alanine B aspartate C cystine D aspartate E glutamate F phenylalanine G glycine H histidine I isoleucine K lysine L leucine M methionine N asparagine P proline Q glutamine R arginine S serine T threonine U selenocysteine V valine W tryptophan Y tyrosine Z glutamine X any “*” translation stop “-” gap of indeterminate length
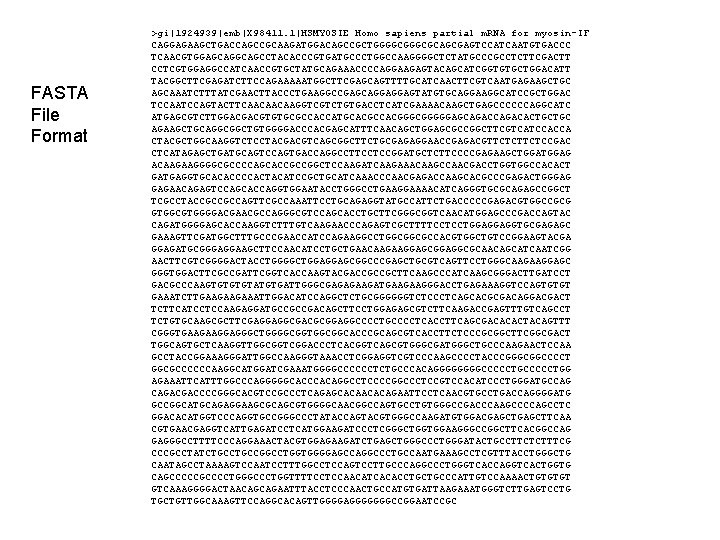
FASTA File Format >gi|1924939|emb|X 98411. 1|HSMYOSIE Homo sapiens partial m. RNA for myosin-IF CAGGAGAAGCTGACCAGCCGCAAGATGGACAGCCGCTGGGGCGCAGCGAGTCCATCAATGTGACCC TCAACGTGGAGCAGCCTACACCCGTGATGCCCTGGCCAAGGGGCTCTATGCCCGCCTCTTCGACTT CCTCGTGGAGGCCATCAACCGTGCTATGCAGAAACCCCAGGAAGAGTACAGCATCGGTGTGCTGGACATT TACGGCTTCGAGATCTTCCAGAAAAATGGCTTCGAGCAGTTTTGCATCAACTTCGTCAATGAGAAGCTGC AGCAAATCTTTATCGAACTTACCCTGAAGGCCGAGCAGGAGGAGTATGTGCAGGAAGGCATCCGCTGGAC TCCAATCCAGTACTTCAACAACAAGGTCGTCTGTGACCTCATCGAAAACAAGCTGAGCCCCCCAGGCATC ATGAGCGTCTTGGACGACGTGTGCGCCACCATGCACGCCACGGGGGAGCAGACACTGCTGC AGAAGCTGCAGGCGGCTGTGGGGACCCACGAGCATTTCAACAGCTGGAGCGCCGGCTTCGTCATCCACCA CTACGCTGGCAAGGTCTCCTACGACGTCAGCGGCTTCTGCGAGAGGAACCGAGACGTTCTCCGAC CTCATAGAGCTGATGCAGTCCAGTGACCAGGCCTTCCTCCGGATGCTCTTCCCCGAGAAGCTGGAG ACAAGAAGGGGCGCCCCAGCACCGCCGGCTCCAAGATCAAGAAACAAGCCAACGACCTGGTGGCCACACT GATGAGGTGCACACCCCACTACATCCGCTGCATCAAACCCAACGAGACCAAGCACGCCCGAGACTGGGAG GAGAACAGAGTCCAGCACCAGGTGGAATACCTGGGCCTGAAGGAAAACATCAGGGTGCGCAGAGCCGGCT TCGCCTACCGCCGCCAGTTCGCCAAATTCCTGCAGAGGTATGCCATTCTGACCCCCGAGACGTGGCCGCG GTGGCGTGGGGACGAACGCCAGGGCGTCCAGCACCTGCTTCGGGCGGTCAACATGGAGCCCGACCAGTAC CAGATGGGGAGCACCAAGGTCTTTGTCAAGAACCCAGAGTCGCTTTTCCTCCTGGAGGAGGTGCGAGAGC GAAAGTTCGATGGCTTTGCCCGAACCATCCAGAAGGCCTGGCGGCGCCACGTGGCTGTCCGGAAGTACGA GGAGATGCGGGAGGAAGCTTCCAACATCCTGCTGAACAAGAAGGAGCGGAGGCGCAACAGCATCAATCGG AACTTCGTCGGGGACTACCTGGGGCTGGAGGAGCGGCCCGAGCTGCGTCAGTTCCTGGGCAAGAAGGAGC GGGTGGACTTCGCCGATTCGGTCACCAAGTACGACCGCCGCTTCAAGCCCATCAAGCGGGACTTGATCCT GACGCCCAAGTGTATGTGATTGGGCGAGAGAAGATGAAGAAGGGACCTGAGAAAGGTCCAGTGTGT GAAATCTTGAAGAAGAAATTGGACATCCAGGCTCTGCGGGGGGTCTCCCTCAGCACGCGACAGGACGACT TCTTCATCCTCCAAGAGGATGCCGCCGACAGCTTCCTGGAGAGCGTCTTCAAGACCGAGTTTGTCAGCCT TCTGTGCAAGCGCTTCGAGGAGGCGACGCGGAGGCCCCTCACCTTCAGCGACACACTACAGTTT CGGGTGAAGAAGGAGGGCTGGGGCGGTGGCGGCACCCGCAGCGTCACCTTCTCCCGCGGCTTCGGCGACT TGGCAGTGCTCAAGGTTGGCGGTCGGACCCTCACGGTCAGCGTGGGCGATGGGCTGCCCAAGAACTCCAA GCCTACCGGAAAGGGATTGGCCAAGGGTAAACCTCGGAGGTCGTCCCAAGCCCCTACCCGGGCGGCCCCT GGCGCCCCCCAAGGCATGGATCGAAATGGGGCCCCCCTCTGCCCACAGGGGCCCCCTGG AGAAATTCATTTGGCCCAGGGGGCACCCACAGGCCTCCCCGGCCCTCCGTCCACATCCCTGGGATGCCAG CAGACGACCCCGGGCACGTCCGCCCTCAGAGCACAACACAGAATTCCTCAACGTGCCTGACCAGGGGATG GCCGGCATGCAGAGGAAGCGCAGCGTGGGGCAACGGCCAGTGCCTGTGGGCCGACCCAAGCCCCAGCCTC GGACACATGGTCCCAGGTGCCGGGCCCTATACCAGTACGTGGGCCAAGATGTGGACGAGCTTCAA CGTGAACGAGGTCATTGAGATCCTCATGGAAGATCCCTCGGGCTGGTGGAAGGGCCGGCTTCACGGCCAG GAGGGCCTTTTCCCAGGAAACTACGTGGAGAAGATCTGAGCTGGGCCCTGGGATACTGCCTTCTCTTTCG CCCGCCTATCTGCCGGCCTGGTGGGGAGCCAGGCCCTGCCAATGAAAGCCTCGTTTACCTGGGCTG CAATAGCCTAAAAGTCCAATCCTTTGGCCTCCAGTCCTTGCCCAGGCCCTGGGTCACCAGGTCACTGGTG CAGCCCCCGCCCCTGGGCCCTGGTTTTCCTCCAACATCACACCTGCTGCCCATTGTCCAAAACTGTGTGT GTCAAAGGGGACTAACAGCAGAATTTACCTCCCAACTGCCATGTGATTAAGAAATGGGTCTTGAGTCCTG TGCTGTTGGCAAAGTTCCAGGCACAGTTGGGGAGGGGGGGCCGGAATCCGC
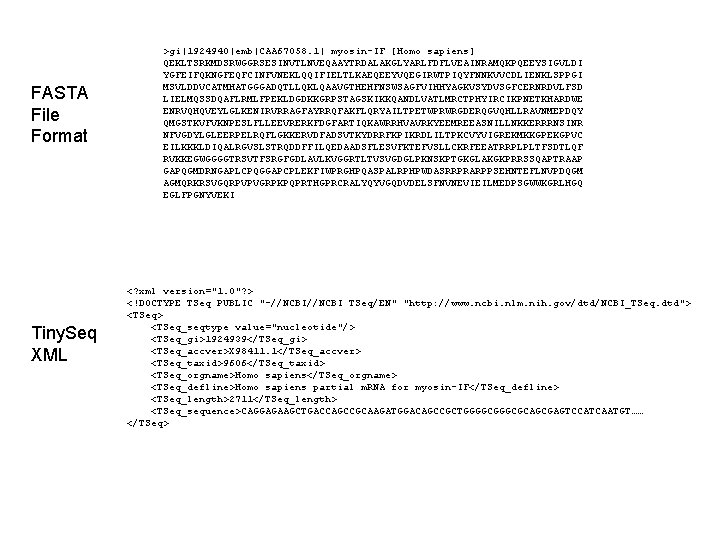
FASTA File Format Tiny. Seq XML >gi|1924940|emb|CAA 67058. 1| myosin-IF [Homo sapiens] QEKLTSRKMDSRWGGRSESINVTLNVEQAAYTRDALAKGLYARLFDFLVEAINRAMQKPQEEYSIGVLDI YGFEIFQKNGFEQFCINFVNEKLQQIFIELTLKAEQEEYVQEGIRWTPIQYFNNKVVCDLIENKLSPPGI MSVLDDVCATMHATGGGADQTLLQKLQAAVGTHEHFNSWSAGFVIHHYAGKVSYDVSGFCERNRDVLFSD LIELMQSSDQAFLRMLFPEKLDGDKKGRPSTAGSKIKKQANDLVATLMRCTPHYIRCIKPNETKHARDWE ENRVQHQVEYLGLKENIRVRRAGFAYRRQFAKFLQRYAILTPETWPRWRGDERQGVQHLLRAVNMEPDQY QMGSTKVFVKNPESLFLLEEVRERKFDGFARTIQKAWRRHVAVRKYEEMREEASNILLNKKERRRNSINR NFVGDYLGLEERPELRQFLGKKERVDFADSVTKYDRRFKPIKRDLILTPKCVYVIGREKMKKGPEKGPVC EILKKKLDIQALRGVSLSTRQDDFFILQEDAADSFLESVFKTEFVSLLCKRFEEATRRPLPLTFSDTLQF RVKKEGWGGGGTRSVTFSRGFGDLAVLKVGGRTLTVSVGDGLPKNSKPTGKGLAKGKPRRSSQAPTRAAP GAPQGMDRNGAPLCPQGGAPCPLEKFIWPRGHPQASPALRPHPWDASRRPRARPPSEHNTEFLNVPDQGM AGMQRKRSVGQRPVPVGRPKPQPRTHGPRCRALYQYVGQDVDELSFNVNEVIEILMEDPSGWWKGRLHGQ EGLFPGNYVEKI <? xml version="1. 0"? > <!DOCTYPE TSeq PUBLIC "-//NCBI TSeq/EN" "http: //www. ncbi. nlm. nih. gov/dtd/NCBI_TSeq. dtd"> <TSeq_seqtype value="nucleotide"/> <TSeq_gi>1924939</TSeq_gi> <TSeq_accver>X 98411. 1</TSeq_accver> <TSeq_taxid>9606</TSeq_taxid> <TSeq_orgname>Homo sapiens</TSeq_orgname> <TSeq_defline>Homo sapiens partial m. RNA for myosin-IF</TSeq_defline> <TSeq_length>2711</TSeq_length> <TSeq_sequence>CAGGAGAAGCTGACCAGCCGCAAGATGGACAGCCGCTGGGGCGCAGCGAGTCCATCAATGT…… </TSeq>
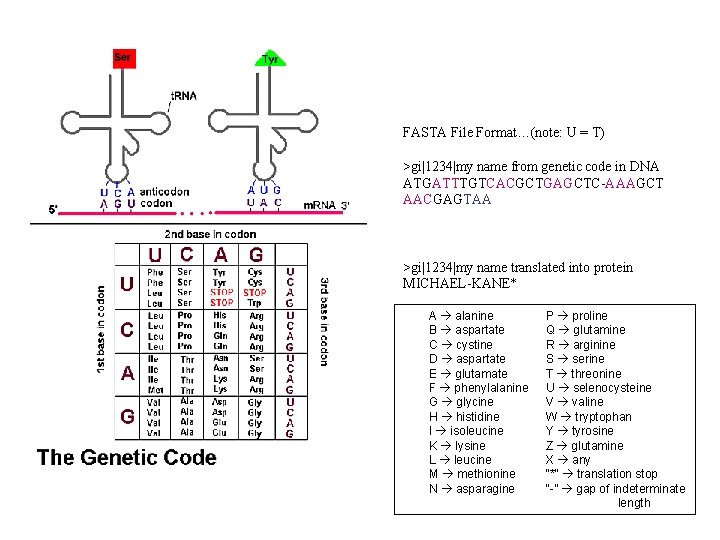
FASTA File Format…(note: U = T) >gi|1234|my name from genetic code in DNA ATGATTTGTCACGCTGAGCTC-AAAGCT AACGAGTAA >gi|1234|my name translated into protein MICHAEL-KANE* A alanine B aspartate C cystine D aspartate E glutamate F phenylalanine G glycine H histidine I isoleucine K lysine L leucine M methionine N asparagine P proline Q glutamine R arginine S serine T threonine U selenocysteine V valine W tryptophan Y tyrosine Z glutamine X any “*” translation stop “-” gap of indeterminate length
Where do we get DNA sequence information? DNA Sequencing Methods -conversion of biological/bioanalytical data into sequence information There automated, high-throughput sequencing centers that COMPLETELY automate (robotics and information systems) DNA sequencing, preliminary identification and publishing.
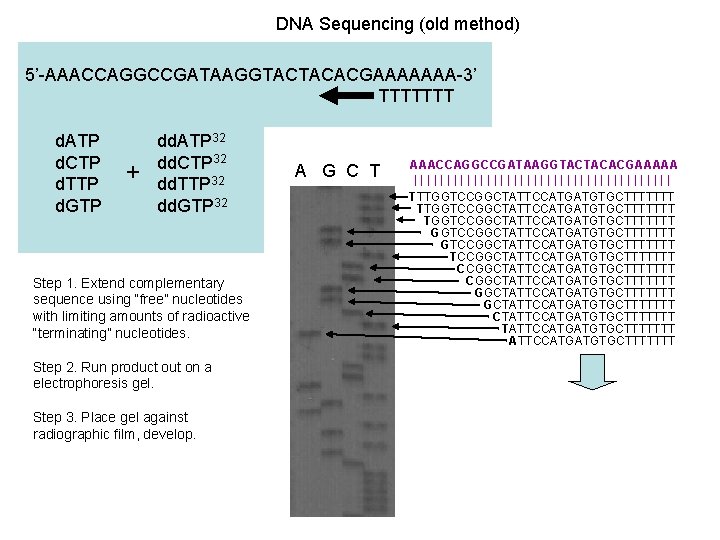
DNA Sequencing (old method) 5’-AAACCAGGCCGATAAGGTACTACACGAAAAAAA-3’ TTTTTTT d. ATP d. CTP d. TTP d. GTP + dd. ATP 32 dd. CTP 32 dd. TTP 32 dd. GTP 32 Step 1. Extend complementary sequence using “free” nucleotides with limiting amounts of radioactive “terminating” nucleotides. Step 2. Run product out on a electrophoresis gel. Step 3. Place gel against radiographic film, develop. A G C T AAACCAGGCCGATAAGGTACTACACGAAAAA |||||||||||||||||||| TTTGGTCCGGCTATTCCATGATGTGCTTTTTTT GTCCGGCTATTCCATGATGTGCTTTTTTT GGCTATTCCATGATGTGCTTTTTTT ATTCCATGATGTGCTTTTTTT
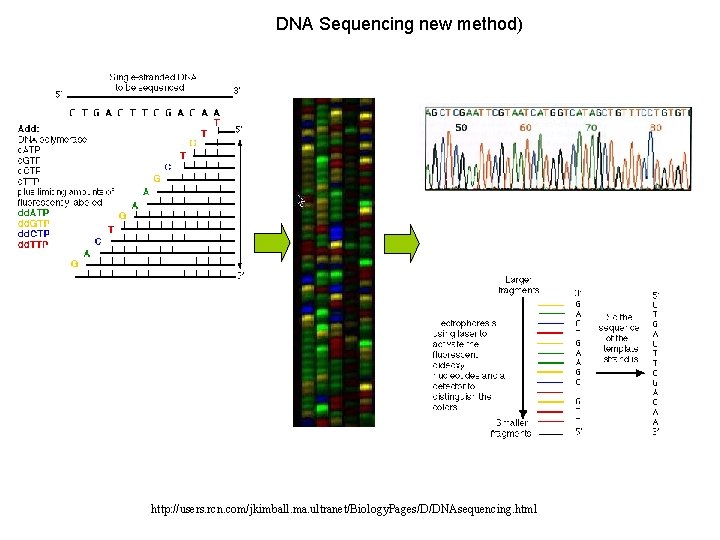
DNA Sequencing new method) http: //users. rcn. com/jkimball. ma. ultranet/Biology. Pages/D/DNAsequencing. html
GGATCCTGCAAGGAGGGATACAAATTACATTTGTCAAAACCCACAGCATGTTGACCACCAGGAGGA GACCCCATGTGACTCCAGGACCCTGGTTGATAACAACGTATCGAGATTCCTCACATGGAACCAGTGCGCT CCTGTGGTGGAGGGTGTACCTGTGTCAGGGGGTACGTGGACATTTTCTGCAGTTTTTGATCAATT TTGCAATGAACTAAATCTGTGGTATAAAAATAAAGTCTATTAAAAGAATCCAAGGCTCCCTCTCACG ATAAGATAAAGTCCCCATTTTACTCCTCTCAGCCCTGGAGAAAGGAGAGGCCAGGTCCCACCACCT TCCACCAGCATGGACCCCCAGTCCAGACCCCACGCCTTTTCTCAGCATCCTCAGACCAGCAGGACTTGCA GCAATGGGGAATTAGGCACCTGACTTCTCCTTCATCTACCTTTGGCTGGGGGCCTCCAGCCTTGACCTTC GCTCTGAGAGTCTCAGGTCCAGAGCCAGTTCTCCCATGACGTGATATGTTTCCAGAGCAGGTTCCT GGGTGAGATAAAAGGATTTGGGCTGAACAGGGTGGAGCATTGGAATGGCACTCAGGGCAAAGGC AGAGGTGTGCGTGGCAGCGCCCTGGCTGTCCCTGCAAAGGGCACTGGGCACTAGAGCCGCTC GGGCCCCTAGGACGGTGCTGCCGTTTGAAGCCATGCCCCAGCATCCAGGCAACAGGTGGCTGAGGCTG CTGCAGATCTGGAGCAGGGTTATGAGCACCTGGAGATGCACCAGACCTTCCAGGAGCTG GGGCCCATTTTCAGGTAAAGCCCTGGCCCTCGCTGGGAACACCCAGATCCCTGCTGCCC AGGACCCTGCCAGGCACTCAGCACTGCCATTCCCAGCAGGTCCCGGCACTCTGCATCCTTTGGAGGATG GGGAAGGAGTGCAGCACATGCTGGTCTGTGGTGCTGCCAGGGGATAGTGCAGAGAAAACCCCA GCTCACTGCAGAGAGGGCAGGACTCAGAAGCACTAAAGTTGAAAGGTTCCAGGGAGCCAGCAGGAGGG CTTTAGCTGTGAAGCCGCTAATCCAGGAGCAGGGTGGACAGGAGACACTTTGGATTGGGACTGCA GGGTGGGGCCACGAGGGACATGACCCCGTCCAGCAGGGCCTCCTGCTTGGCCCCACAGGTACAACTTG GGAGGACCACGCATGGTGTGATGCTGCCGGAGGATGTGGAGAAGCTGCAACAGGTGGACAGCCT GCATCCCTGCAGGATGATCCTGGAGCCCTGGGTGGCCTACAGACAACATCGTGGGCACAAATGTGGCGT GTTCTTGTTGTAAGCGGCGAGTTGGGAGCTGAGAGCTGGGAGCAGGGTGGGCAGCCTGGGTGTAGGGG GGAGGCGAGAGAGGTAGGACCCAAAAGCACATCTGCCCTGGGCCCCTGTGGTGGGCAGTGAGGGTGAG CACCCGGCCCAGAGGACGGCCATCCTGTGGGGTCGCGTCTGCACTGTGGGTTGGGGAAGCAGGGCGG TGGTGGAGAAATGGGCACCTCTGCAGAGAAGACGCAGAGCAATGAGCCCTTCTGTGTAGTGAG AACCCGCTCTGCACCAACCTCGGCGGCTGCTTTCTCTTGCGGTCTGGGGACTGTCCTTCCCATAGGTCA GAAAACTGAGGCCCTGAGAAGGGGACTTCCACTGGCCCAGGTCACAGGCTGAGTGCTGAGCCTGGTGTT CGCCGGGGCCGCAGCCTCAGGGCGCTCAGGGTCCCTGCAGTCCTGGCAAACCTTCCTGATGGGG ACAGTCCGGGGCAGGAGGCAGGTGGGGACGCAGGTGGCTGGTGGTTCCGTTGTTCTCAGAAGCAAGGC ACAAGGTGGGGCGGTTGATGGCACTGGGGAGGATGTTTCCTGGCCCGTGGAGAGGGTGGCGCCTGGTC AGGTGGGCAGGGAGAGGCTGATGCTTGGAGTCGGTCACCTGCAGGGATGTTGTCATTAGGACGGGGGA AGGACTGGATGAGGATGTCACAGTGGTGACAGCCCCCACTCCATGGTAGGAAGGGAACGCTATTGGGAA TAGTGGGGTTTAGGTAAAAGGGCACCCGTGGGTCGGGGCCTTCACTGAGGCTGGCCTATAGATGACATC TGGGAGAGAGTCAGGACCCAGGAAGGCAGGTCCAGGA
- Slides: 15