
TEMA VI ESQUEMA GENERAL Definicin general Clasificacin Caso
- Slides: 83
TEMA VI
ESQUEMA GENERAL Definición general Clasificación Caso paramétrico: análisis estadísticos aplicables Formato del diseño multigrupo completamente al azar, modelo estructural y componentes de variación DISEÑOS EXPERIMENTALES MULTIGRUPO
Concepto Los diseños multigrupo, de uso frecuente en ciencia psicológica y social, son estructuras de una sola variable independiente a tres o más valores o niveles. Al seleccionar más de dos valores de la variable independiente o causal, es posible extraer la relación funcional entre la variable independiente y dependiente del experimento. Por dicha razón, estas estructuras se conocen por experimentos funcionales o paramétricos (Plutchik, 1968)
Clasificación
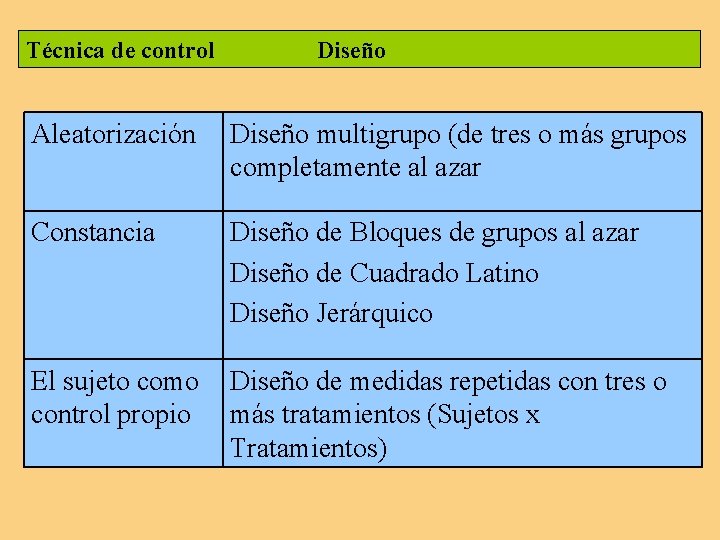
Técnica de control Diseño Aleatorización Diseño multigrupo (de tres o más grupos completamente al azar Constancia Diseño de Bloques de grupos al azar Diseño de Cuadrado Latino Diseño Jerárquico El sujeto como control propio Diseño de medidas repetidas con tres o más tratamientos (Sujetos x Tratamientos)
Diseño multigrupo al azar
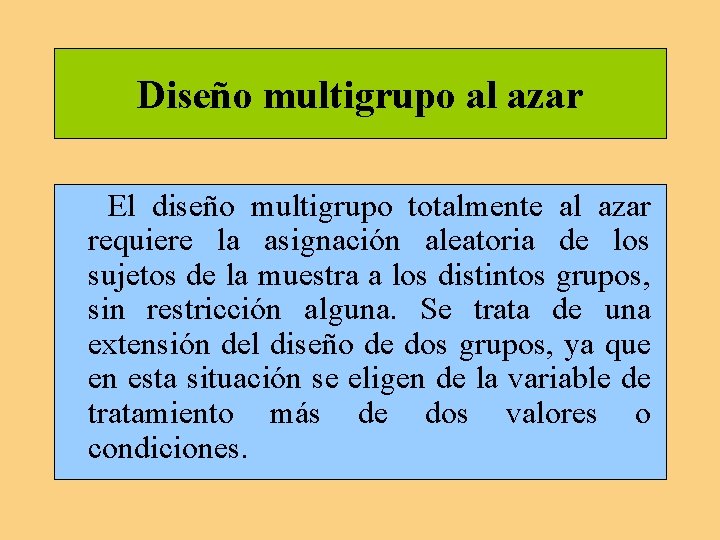
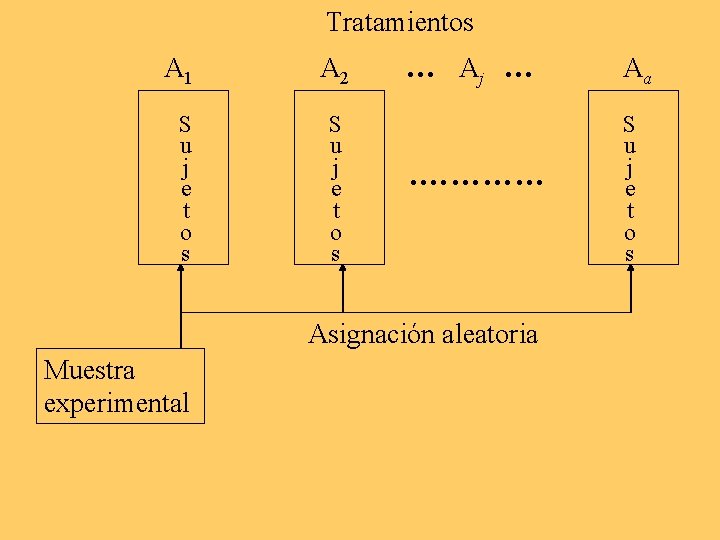
Diseño multigrupo al azar El diseño multigrupo totalmente al azar requiere la asignación aleatoria de los sujetos de la muestra a los distintos grupos, sin restricción alguna. Se trata de una extensión del diseño de dos grupos, ya que en esta situación se eligen de la variable de tratamiento más de dos valores o condiciones.
Formato del diseño de multigrupo al azar
Tratamientos A 1 A 2 S u j e t o s … Aj …. ………… Asignación aleatoria Muestra experimental Aa S u j e t o s
Análisis aplicables
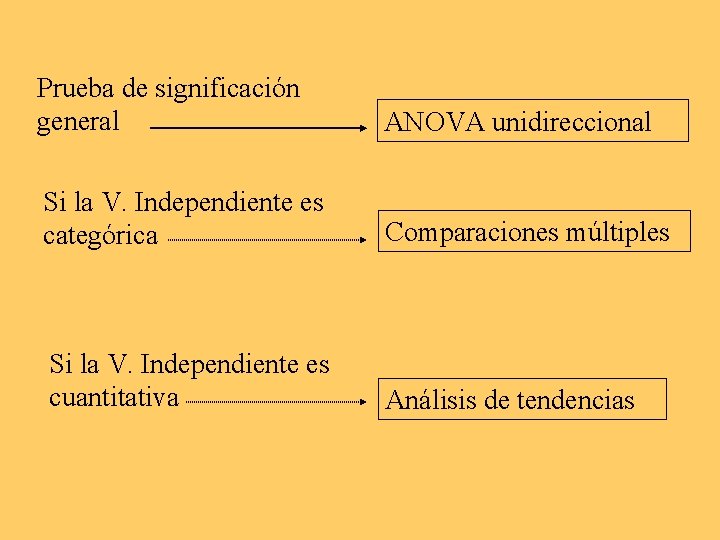
Prueba de significación general ANOVA unidireccional Si la V. Independiente es categórica Comparaciones múltiples Si la V. Independiente es cuantitativa Análisis de tendencias
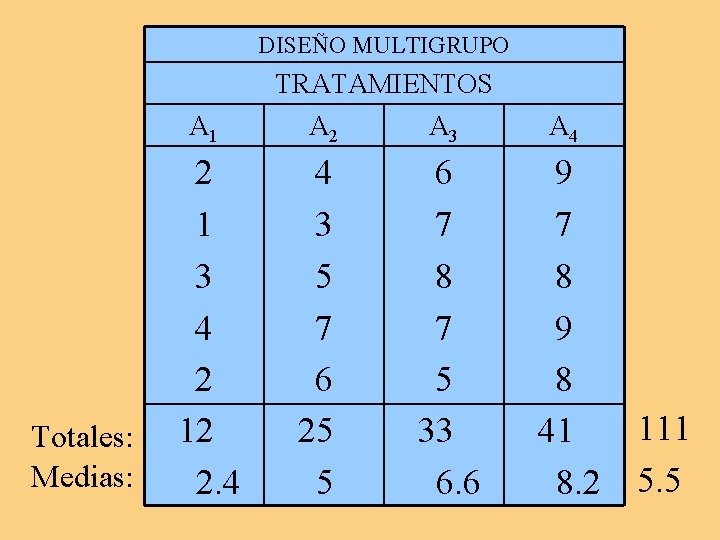
Caso paramétrico. Ejemplo 1 Supóngase que se pretende probar si la cantidad de repasos es una variable decisiva en la retención (memoria de recuerdo), para un conjunto de palabras monosílabas de igual valor asociativo. De la variable independiente o variable repaso se seleccionan los siguientes valores: presentación de la lista sin repaso (condición A 1), dos presentaciones de la lista, siendo la segunda presentación un repaso (condición A 2), tres presentaciones y dos repasos (condición A 3) y, por último, cuatro presentaciones y tres repasos (condición A 4). . //. .
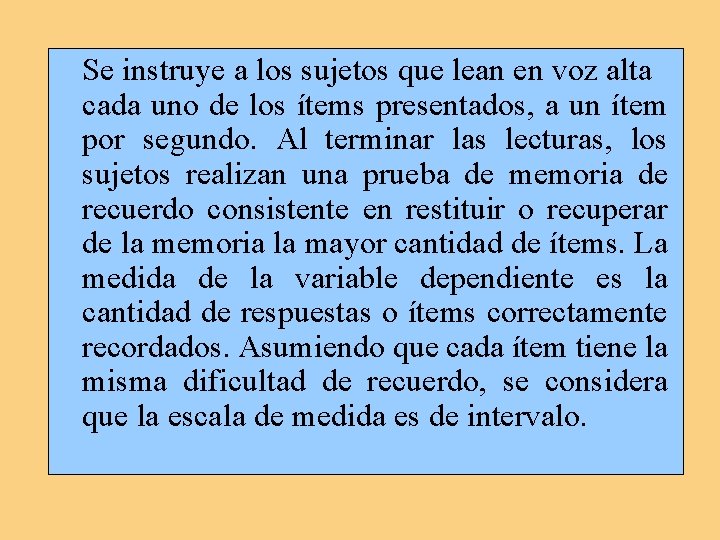
Se instruye a los sujetos que lean en voz alta cada uno de los ítems presentados, a un ítem por segundo. Al terminar las lecturas, los sujetos realizan una prueba de memoria de recuerdo consistente en restituir o recuperar de la memoria la mayor cantidad de ítems. La medida de la variable dependiente es la cantidad de respuestas o ítems correctamente recordados. Asumiendo que cada ítem tiene la misma dificultad de recuerdo, se considera que la escala de medida es de intervalo.
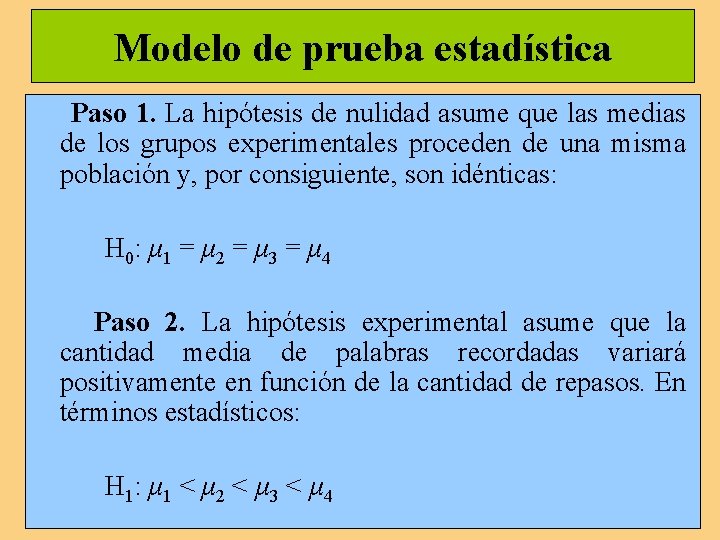
Modelo de prueba estadística Paso 1. La hipótesis de nulidad asume que las medias de los grupos experimentales proceden de una misma población y, por consiguiente, son idénticas: H 0: μ 1 = μ 2 = μ 3 = μ 4 Paso 2. La hipótesis experimental asume que la cantidad media de palabras recordadas variará positivamente en función de la cantidad de repasos. En términos estadísticos: H 1: μ 1 < μ 2 < μ 3 < μ 4
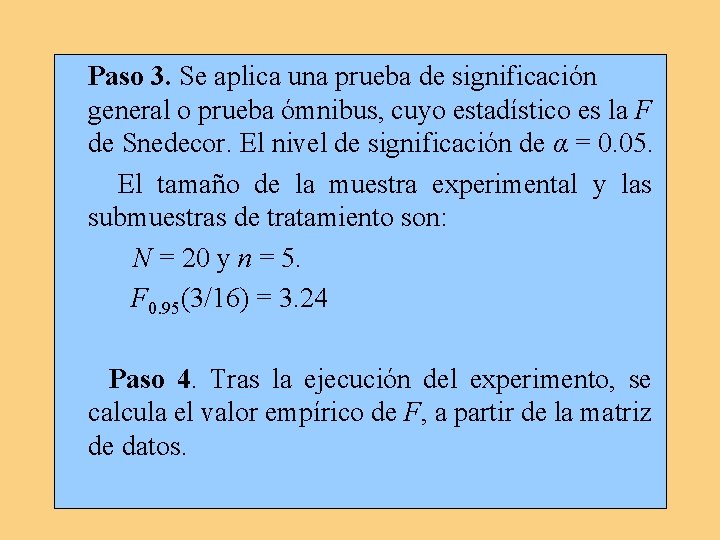
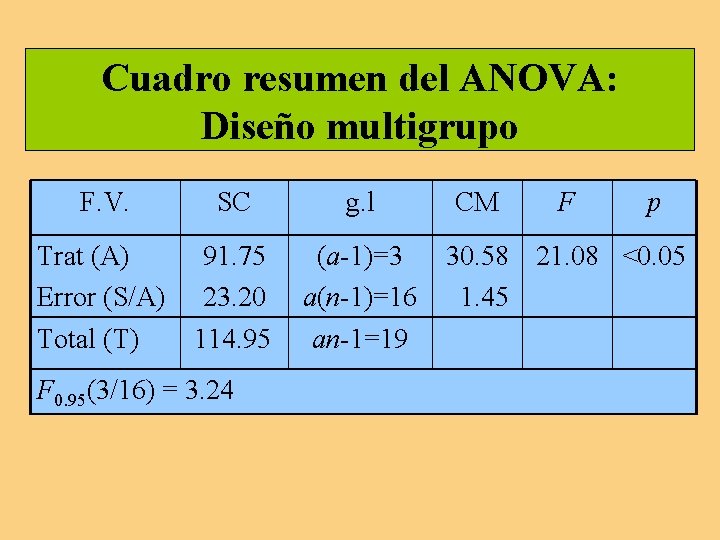
Paso 3. Se aplica una prueba de significación general o prueba ómnibus, cuyo estadístico es la F de Snedecor. El nivel de significación de α = 0. 05. El tamaño de la muestra experimental y las submuestras de tratamiento son: N = 20 y n = 5. F 0. 95(3/16) = 3. 24 Paso 4. Tras la ejecución del experimento, se calcula el valor empírico de F, a partir de la matriz de datos.
Matriz de datos del diseño
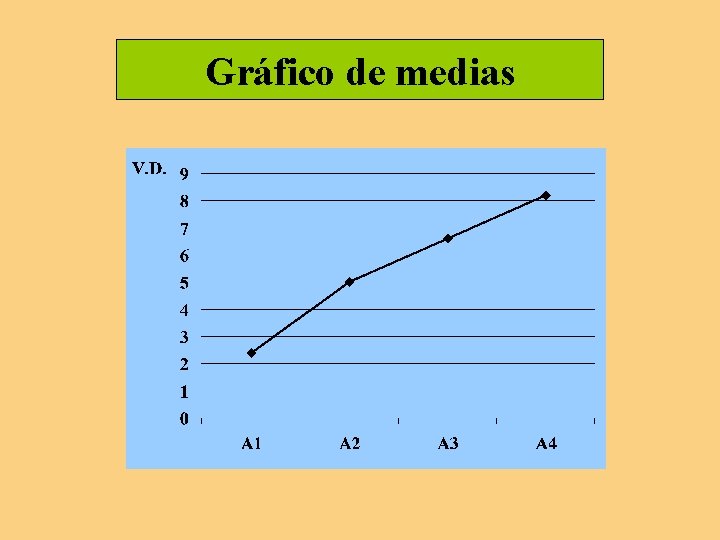
DISEÑO MULTIGRUPO TRATAMIENTOS Totales: Medias: A 1 A 2 A 3 A 4 2 1 3 4 2 12 2. 4 4 3 5 7 6 25 5 6 7 8 7 5 33 6. 6 9 7 8 9 8 41 8. 2 111 5. 5
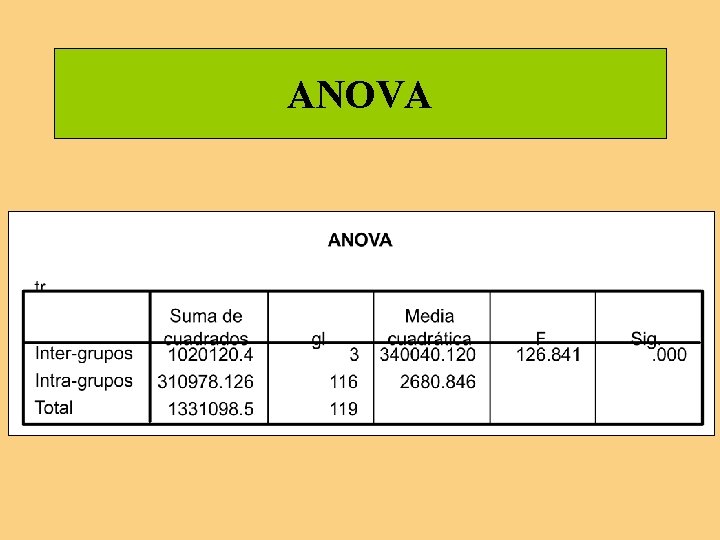
ANOVA unidireccional
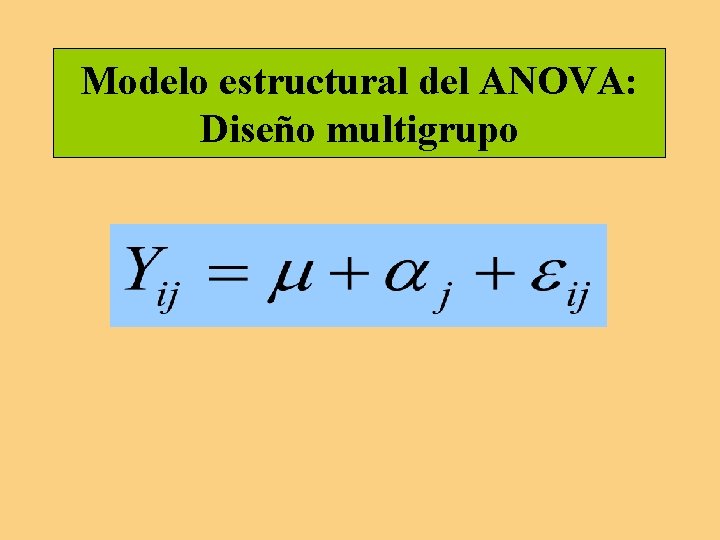
Modelo estructural del ANOVA: Diseño multigrupo
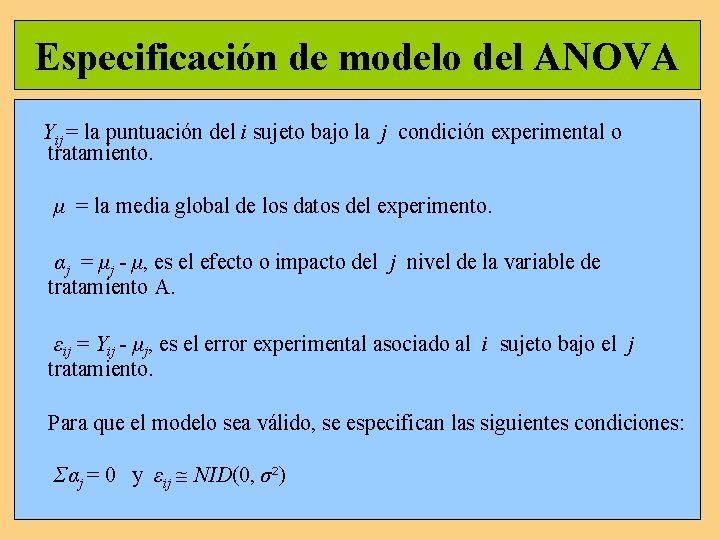
Especificación de modelo del ANOVA Yij = la puntuación del i sujeto bajo la j condición experimental o tratamiento. μ = la media global de los datos del experimento. αj = μj - μ, es el efecto o impacto del j nivel de la variable de tratamiento A. εij = Yij - μj, es el error experimental asociado al i sujeto bajo el j tratamiento. Para que el modelo sea válido, se especifican las siguientes condiciones: Σαj = 0 y εij NID(0, σ²)
Cuadro resumen del ANOVA: Diseño multigrupo F. V. SC g. l Trat (A) Error (S/A) 91. 75 23. 20 (a-1)=3 a(n-1)=16 Total (T) 114. 95 an-1=19 F 0. 95(3/16) = 3. 24 CM F p 30. 58 21. 08 <0. 05 1. 45
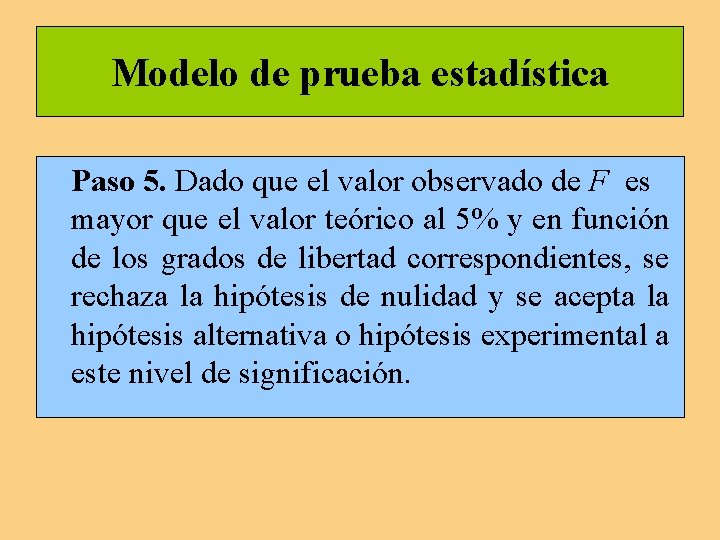
Modelo de prueba estadística Paso 5. Dado que el valor observado de F es mayor que el valor teórico al 5% y en función de los grados de libertad correspondientes, se rechaza la hipótesis de nulidad y se acepta la hipótesis alternativa o hipótesis experimental a este nivel de significación.
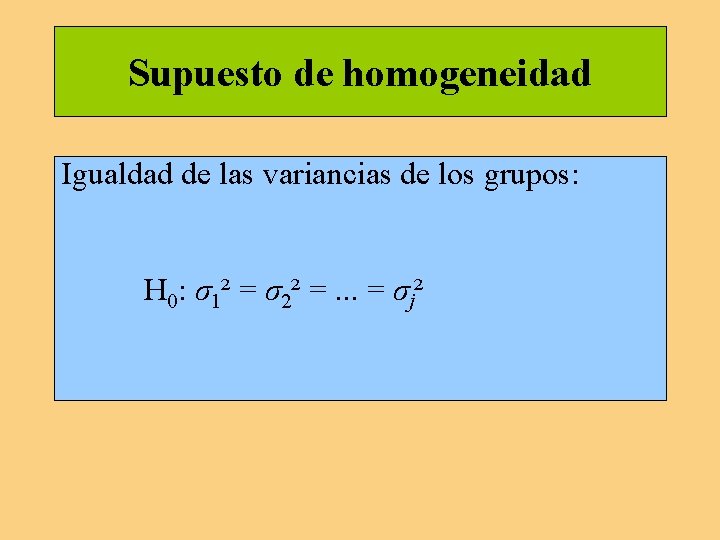
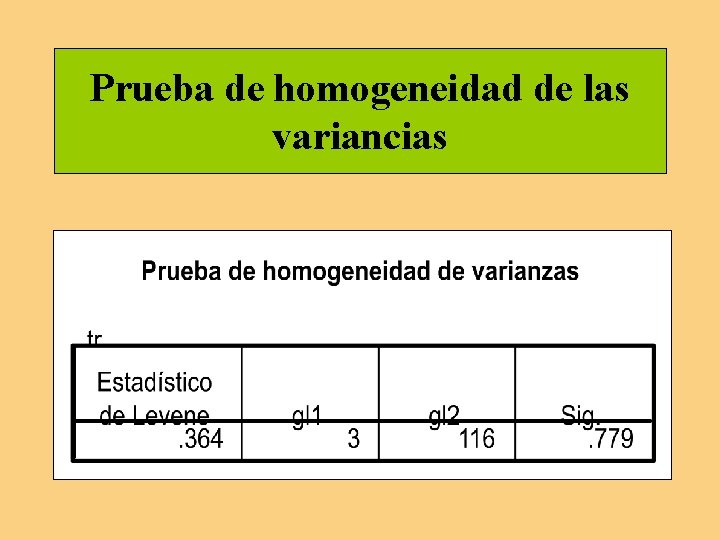
Supuesto de homogeneidad Igualdad de las variancias de los grupos: H 0: σ1² = σ2² =. . . = σj²
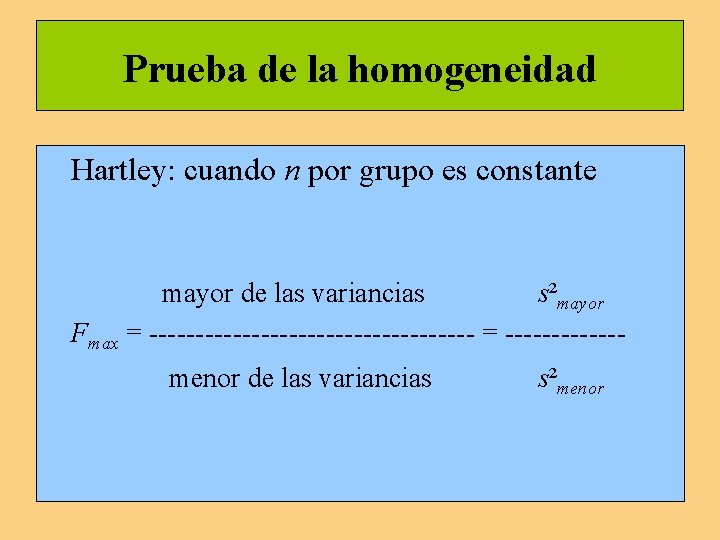
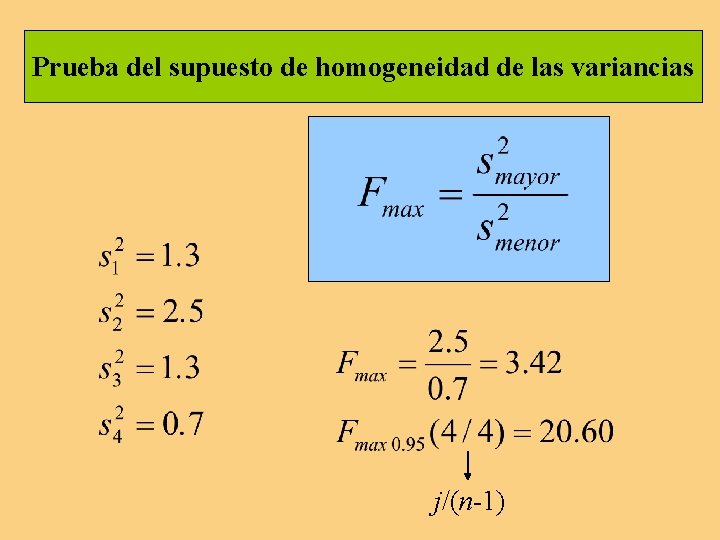
Prueba de la homogeneidad Hartley: cuando n por grupo es constante mayor de las variancias s²mayor Fmax = ------------------ = ------menor de las variancias s²menor
Prueba del supuesto de homogeneidad de las variancias j/(n-1)
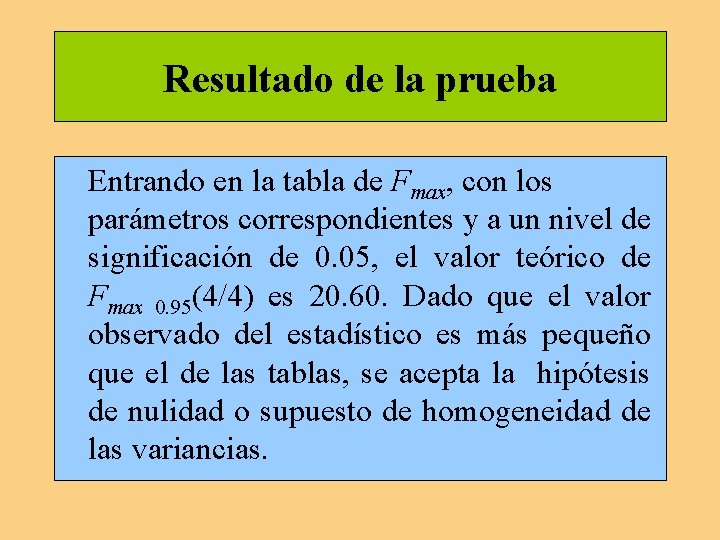
Resultado de la prueba Entrando en la tabla de Fmax, con los parámetros correspondientes y a un nivel de significación de 0. 05, el valor teórico de Fmax 0. 95(4/4) es 20. 60. Dado que el valor observado del estadístico es más pequeño que el de las tablas, se acepta la hipótesis de nulidad o supuesto de homogeneidad de las variancias.
Comparaciones múltiples
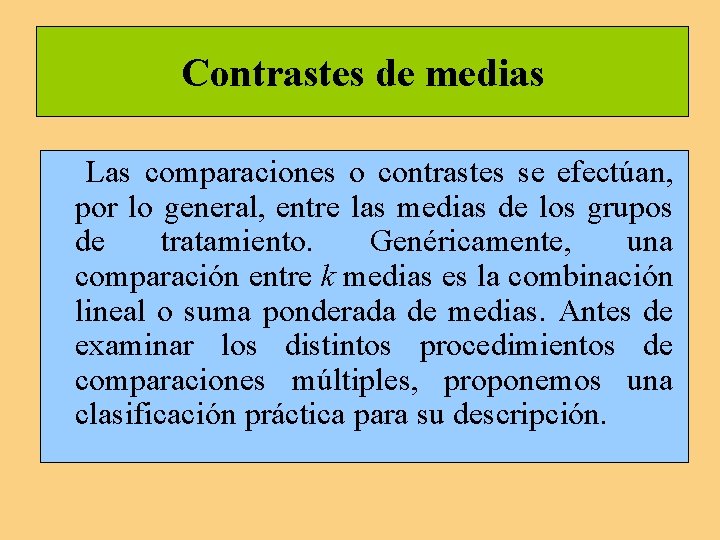
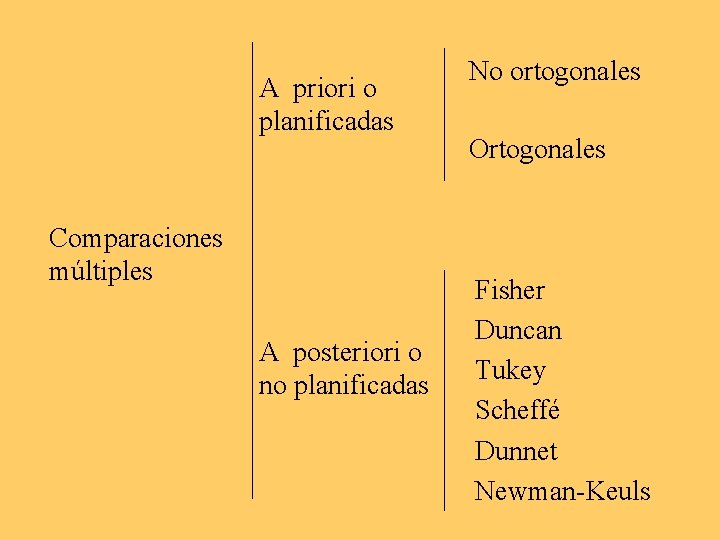
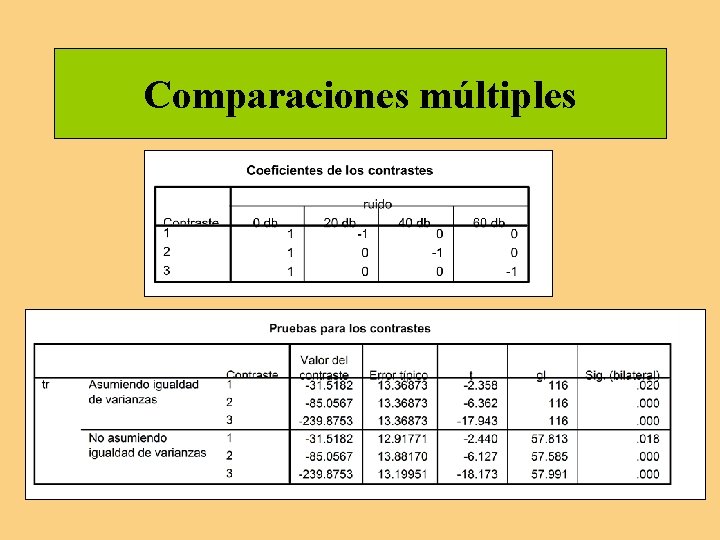
Contrastes de medias Las comparaciones o contrastes se efectúan, por lo general, entre las medias de los grupos de tratamiento. Genéricamente, una comparación entre k medias es la combinación lineal o suma ponderada de medias. Antes de examinar los distintos procedimientos de comparaciones múltiples, proponemos una clasificación práctica para su descripción.
A priori o planificadas Comparaciones múltiples A posteriori o no planificadas No ortogonales Ortogonales Fisher Duncan Tukey Scheffé Dunnet Newman-Keuls
Contrastes a priori o planificados Las comparaciones a priori o planificadas se formulan de acuerdo con los intereses previos o teóricos del investigador, y se plantean antes de obtener los resultados del experimento. Según su naturaleza, las comparaciones planificadas son no ortogonales y ortogonales.
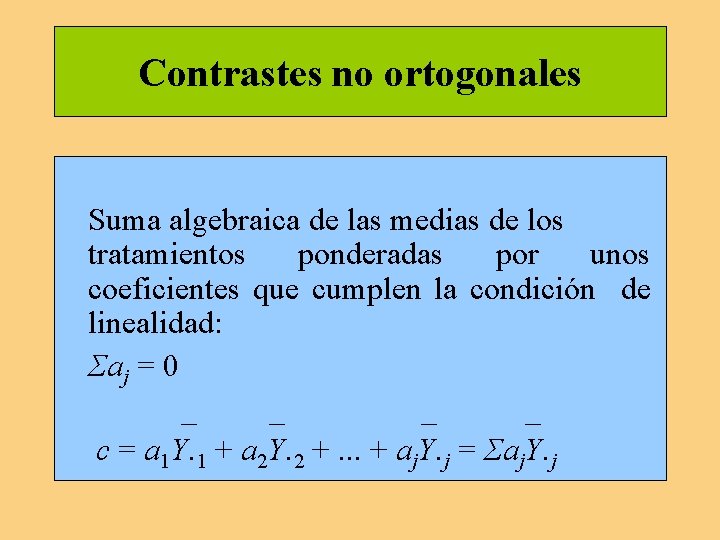
Contrastes no ortogonales Suma algebraica de las medias de los tratamientos ponderadas por unos coeficientes que cumplen la condición de linealidad: Σaj = 0 _ _ c = a 1 Y. 1 + a 2 Y. 2 +. . . + aj. Y. j = Σaj. Y. j
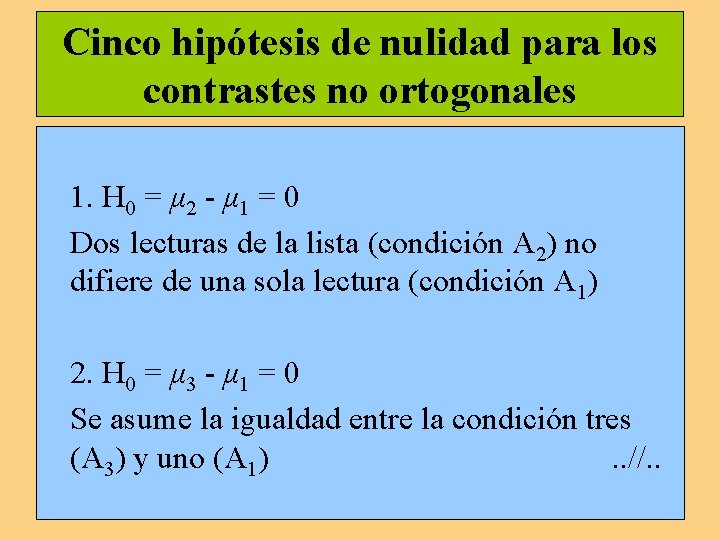
Cinco hipótesis de nulidad para los contrastes no ortogonales 1. H 0 = μ 2 - μ 1 = 0 Dos lecturas de la lista (condición A 2) no difiere de una sola lectura (condición A 1) 2. H 0 = μ 3 - μ 1 = 0 Se asume la igualdad entre la condición tres (A 3) y uno (A 1). . //. .
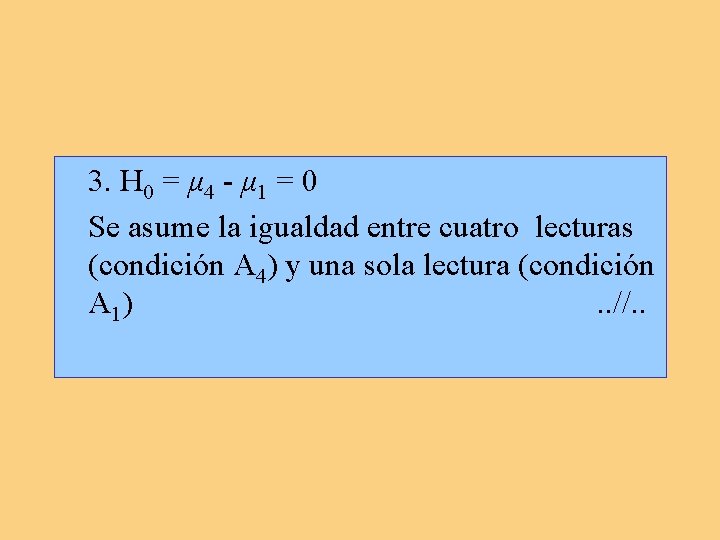
3. H 0 = μ 4 - μ 1 = 0 Se asume la igualdad entre cuatro lecturas (condición A 4) y una sola lectura (condición A 1). . //. .
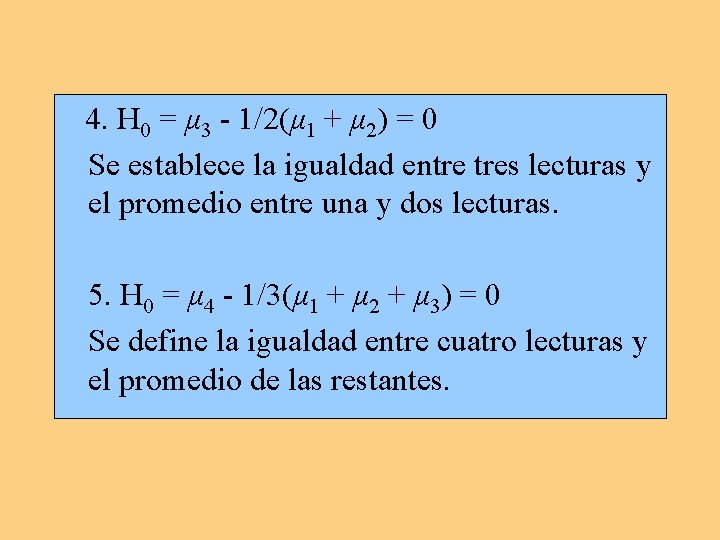
4. H 0 = μ 3 - 1/2(μ 1 + μ 2) = 0 Se establece la igualdad entre tres lecturas y el promedio entre una y dos lecturas. 5. H 0 = μ 4 - 1/3(μ 1 + μ 2 + μ 3) = 0 Se define la igualdad entre cuatro lecturas y el promedio de las restantes.
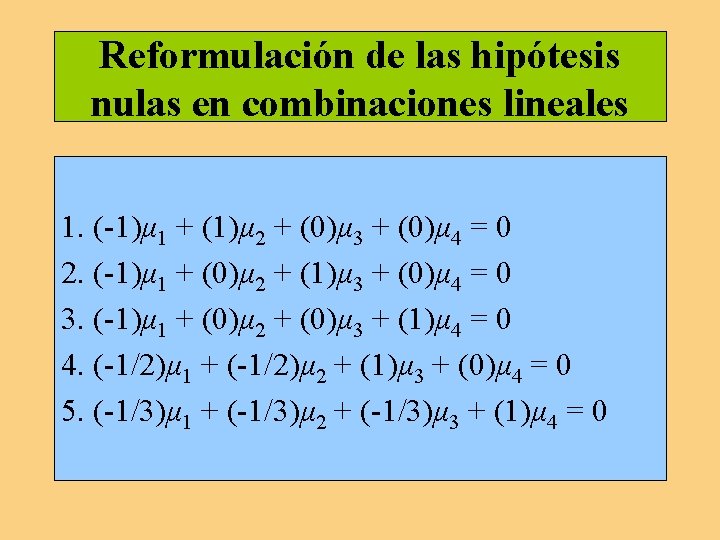
Reformulación de las hipótesis nulas en combinaciones lineales 1. (-1)μ 1 + (1)μ 2 + (0)μ 3 + (0)μ 4 = 0 2. (-1)μ 1 + (0)μ 2 + (1)μ 3 + (0)μ 4 = 0 3. (-1)μ 1 + (0)μ 2 + (0)μ 3 + (1)μ 4 = 0 4. (-1/2)μ 1 + (-1/2)μ 2 + (1)μ 3 + (0)μ 4 = 0 5. (-1/3)μ 1 + (-1/3)μ 2 + (-1/3)μ 3 + (1)μ 4 = 0
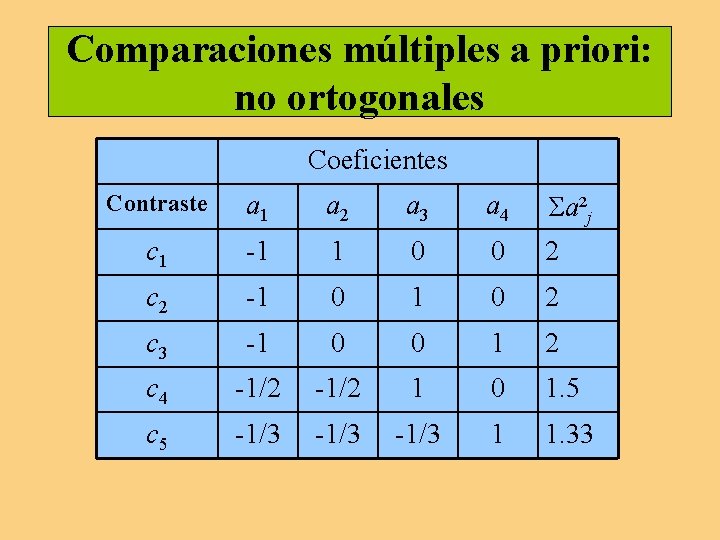
Comparaciones múltiples a priori: no ortogonales Coeficientes Contraste a 1 a 2 a 3 a 4 Σa²j c 1 -1 1 0 0 2 c 2 -1 0 2 c 3 -1 0 0 1 2 c 4 -1/2 1 0 1. 5 c 5 -1/3 1 1. 33
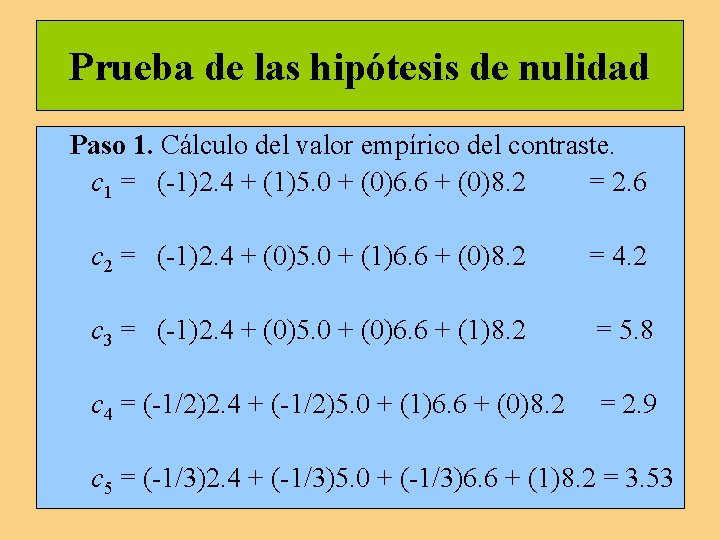
Prueba de las hipótesis de nulidad Paso 1. Cálculo del valor empírico del contraste. c 1 = (-1)2. 4 + (1)5. 0 + (0)6. 6 + (0)8. 2 = 2. 6 c 2 = (-1)2. 4 + (0)5. 0 + (1)6. 6 + (0)8. 2 = 4. 2 c 3 = (-1)2. 4 + (0)5. 0 + (0)6. 6 + (1)8. 2 = 5. 8 c 4 = (-1/2)2. 4 + (-1/2)5. 0 + (1)6. 6 + (0)8. 2 = 2. 9 c 5 = (-1/3)2. 4 + (-1/3)5. 0 + (-1/3)6. 6 + (1)8. 2 = 3. 53
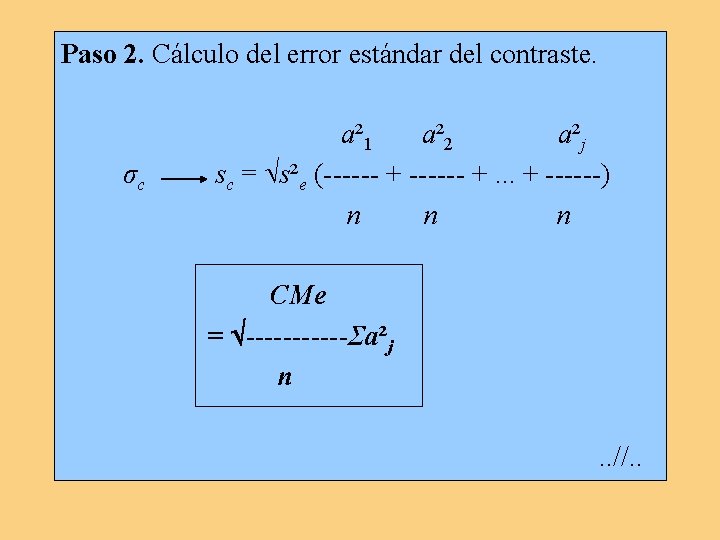
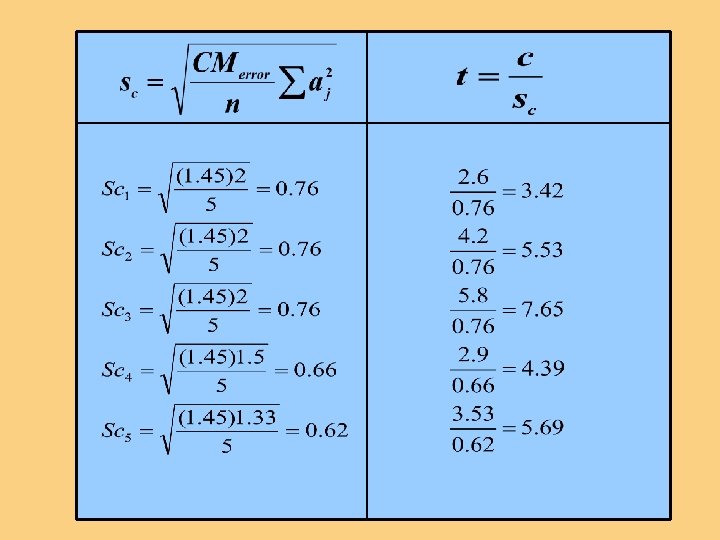
Paso 2. Cálculo del error estándar del contraste. σc a² 1 a² 2 a²j sc = s²e (------ +. . . + ------) n n n CMe = ------Σa²j n. . //. .
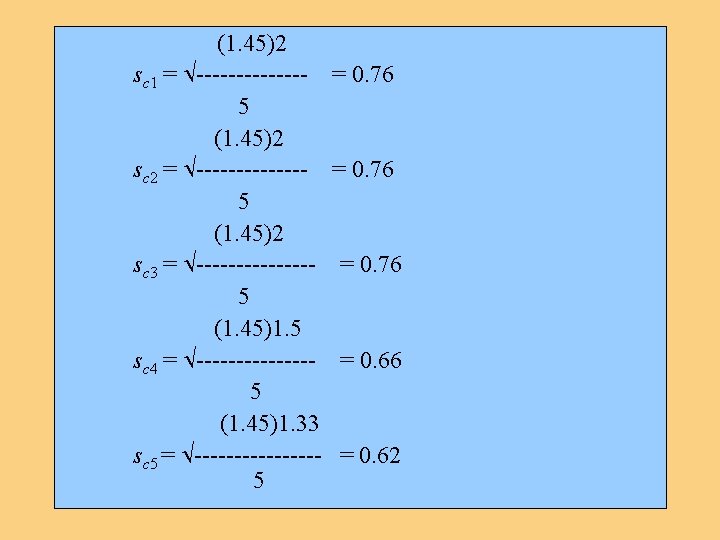
donde s²e = CMe es la variancia del error o Cuadrado Medio del error del Análisis de la Variancia. Así, se obtienen los errores estándar de los distintos contrastes que se muestran en la siguiente pantalla. . . //. .
(1. 45)2 sc 1 = -------5 (1. 45)2 sc 2 = -------5 (1. 45)2 sc 3 = -------5 (1. 45)1. 5 sc 4 = -------5 (1. 45)1. 33 sc 5 = --------5 = 0. 76 = 0. 62
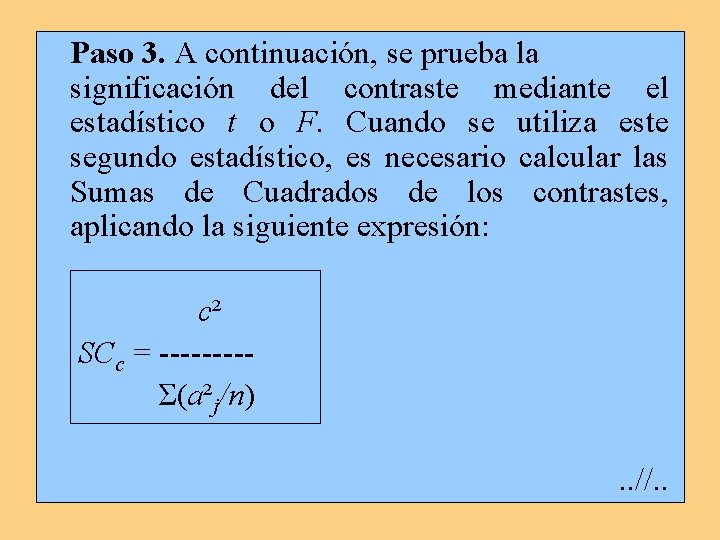
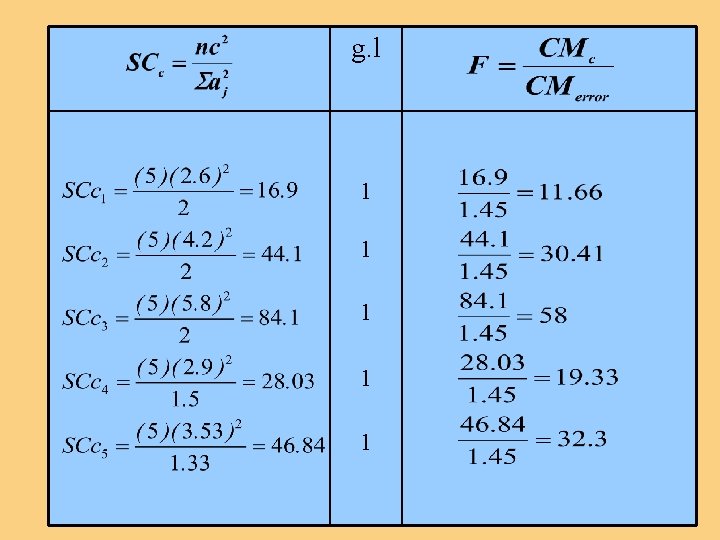
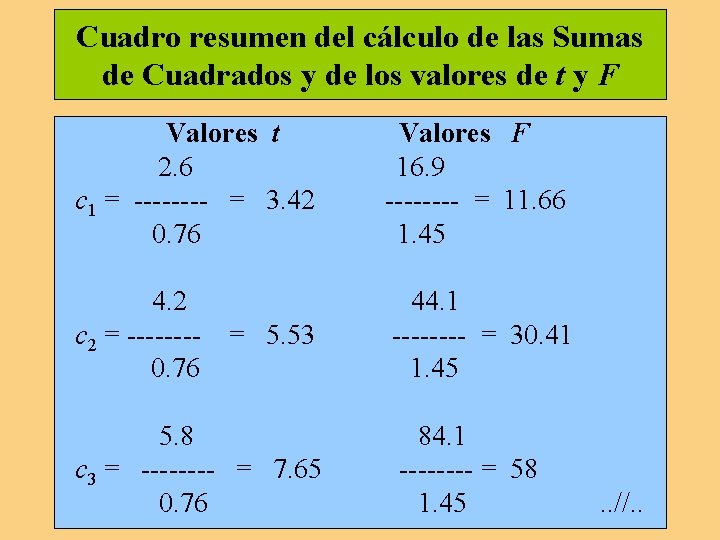
Paso 3. A continuación, se prueba la significación del contraste mediante el estadístico t o F. Cuando se utiliza este segundo estadístico, es necesario calcular las Sumas de Cuadrados de los contrastes, aplicando la siguiente expresión: c² SCc = ----Σ(a²j/n). . //. .
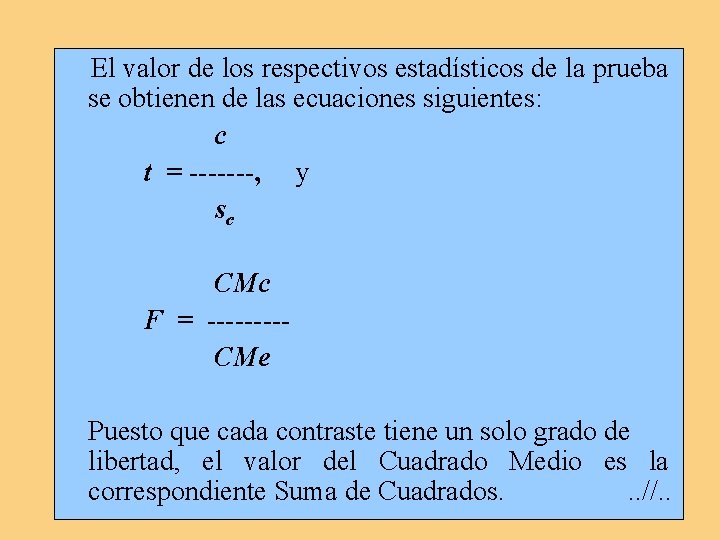
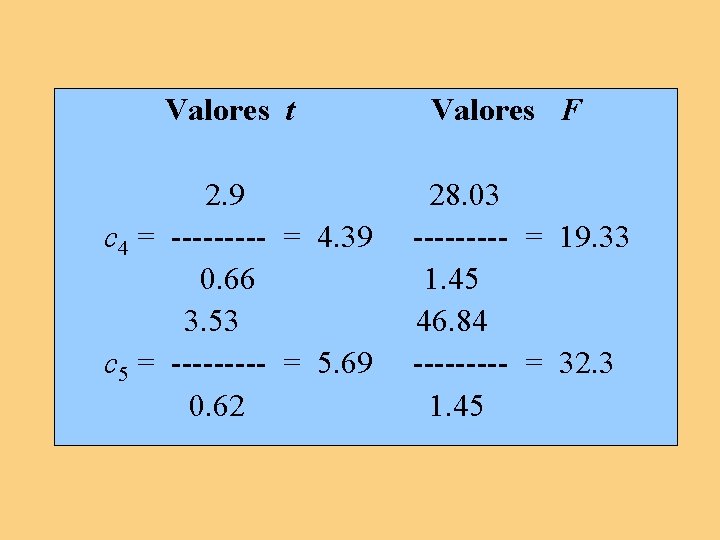
El valor de los respectivos estadísticos de la prueba se obtienen de las ecuaciones siguientes: c t = -------, y sc CMc F = ----CMe Puesto que cada contraste tiene un solo grado de libertad, el valor del Cuadrado Medio es la correspondiente Suma de Cuadrados. . . //. .
g. l 1 1 1
Cuadro resumen de los valores de t y F
Cuadro resumen del cálculo de las Sumas de Cuadrados y de los valores de t y F Valores t 2. 6 c 1 = ---- = 3. 42 0. 76 Valores F 16. 9 ---- = 11. 66 1. 45 4. 2 c 2 = -------0. 76 44. 1 ---- = 30. 41 1. 45 = 5. 53 5. 8 c 3 = ---- = 7. 65 0. 76 84. 1 ---- = 58 1. 45 . . //. .
Valores t 2. 9 c 4 = ----- = 4. 39 0. 66 3. 53 c 5 = ----- = 5. 69 0. 62 Valores F 28. 03 ----- = 19. 33 1. 45 46. 84 ----- = 32. 3 1. 45
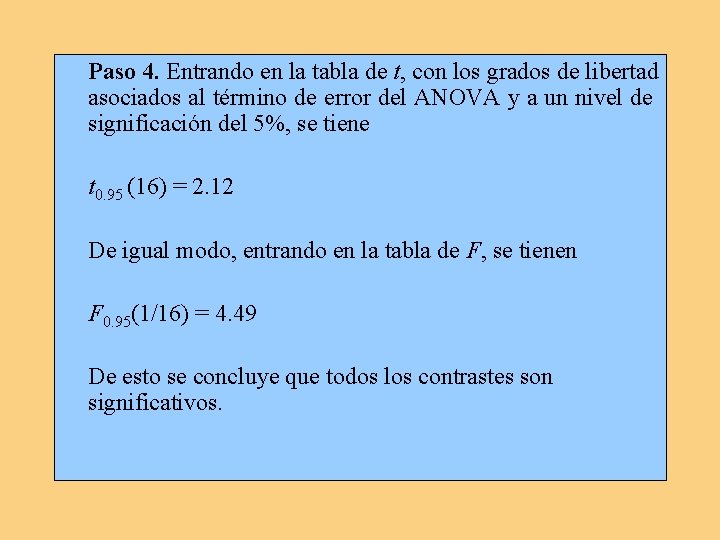
Paso 4. Entrando en la tabla de t, con los grados de libertad asociados al término de error del ANOVA y a un nivel de significación del 5%, se tiene t 0. 95 (16) = 2. 12 De igual modo, entrando en la tabla de F, se tienen F 0. 95(1/16) = 4. 49 De esto se concluye que todos los contrastes son significativos.
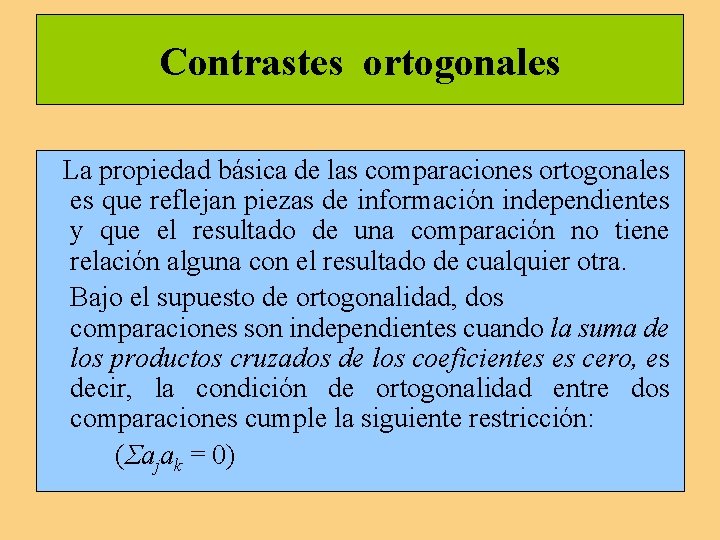
Contrastes ortogonales La propiedad básica de las comparaciones ortogonales es que reflejan piezas de información independientes y que el resultado de una comparación no tiene relación alguna con el resultado de cualquier otra. Bajo el supuesto de ortogonalidad, dos comparaciones son independientes cuando la suma de los productos cruzados de los coeficientes es cero, es decir, la condición de ortogonalidad entre dos comparaciones cumple la siguiente restricción: (Σajak = 0)
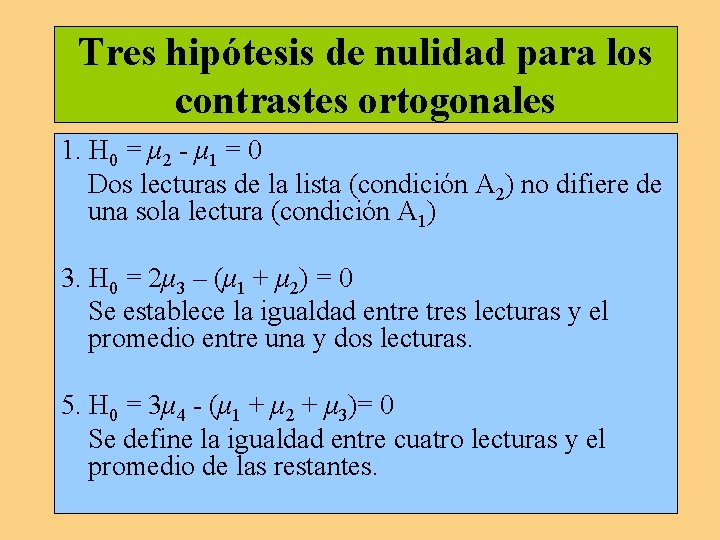
Tres hipótesis de nulidad para los contrastes ortogonales 1. H 0 = μ 2 - μ 1 = 0 Dos lecturas de la lista (condición A 2) no difiere de una sola lectura (condición A 1) 3. H 0 = 2μ 3 – (μ 1 + μ 2) = 0 Se establece la igualdad entre tres lecturas y el promedio entre una y dos lecturas. 5. H 0 = 3μ 4 - (μ 1 + μ 2 + μ 3)= 0 Se define la igualdad entre cuatro lecturas y el promedio de las restantes.
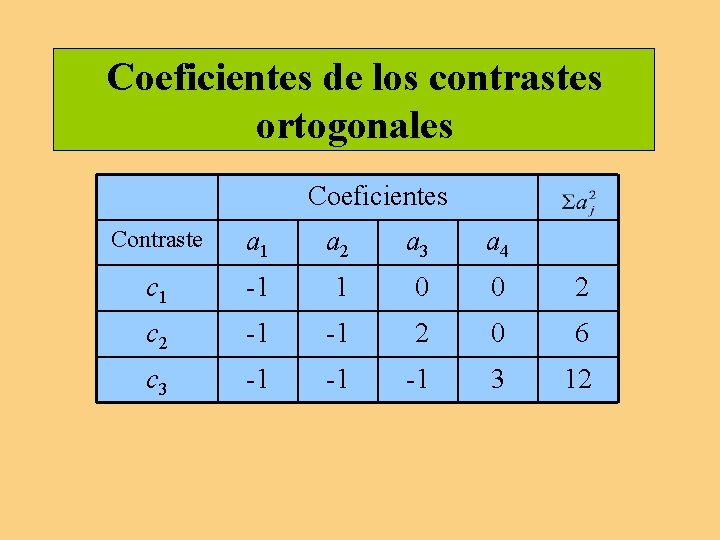
Coeficientes de los contrastes ortogonales Coeficientes Contraste a 1 a 2 a 3 a 4 c 1 -1 1 0 0 2 c 2 -1 -1 2 0 6 c 3 -1 -1 -1 3 12
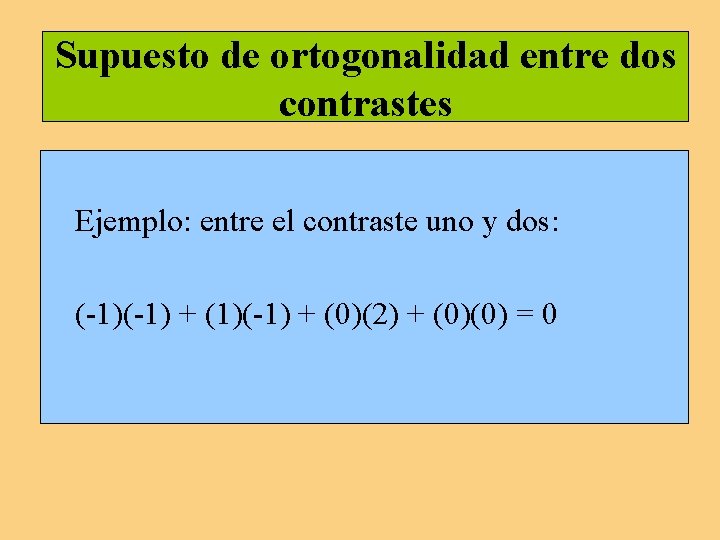
Supuesto de ortogonalidad entre dos contrastes Ejemplo: entre el contraste uno y dos: (-1) + (1)(-1) + (0)(2) + (0)(0) = 0
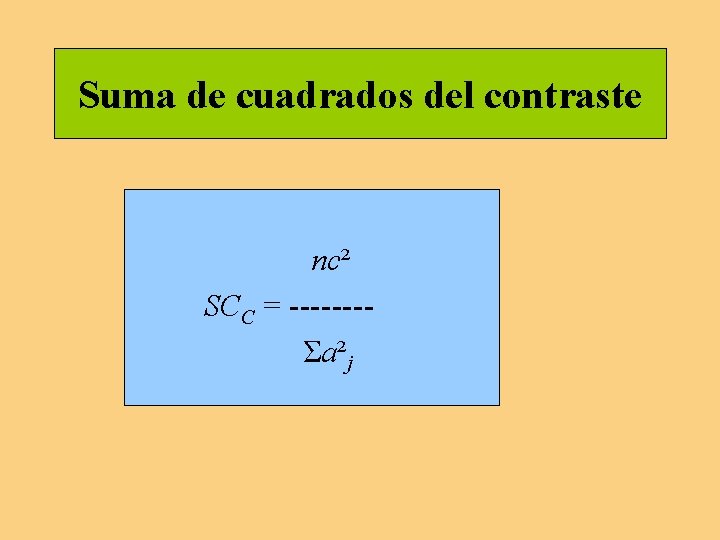
Suma de cuadrados del contraste nc² SCC = -------Σa²j
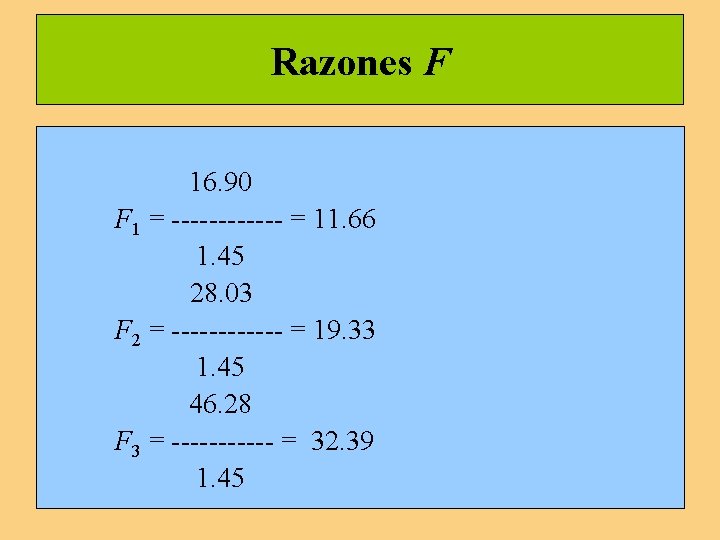
Razones F 16. 90 F 1 = ------ = 11. 66 1. 45 28. 03 F 2 = ------ = 19. 33 1. 45 46. 28 F 3 = ------ = 32. 39 1. 45
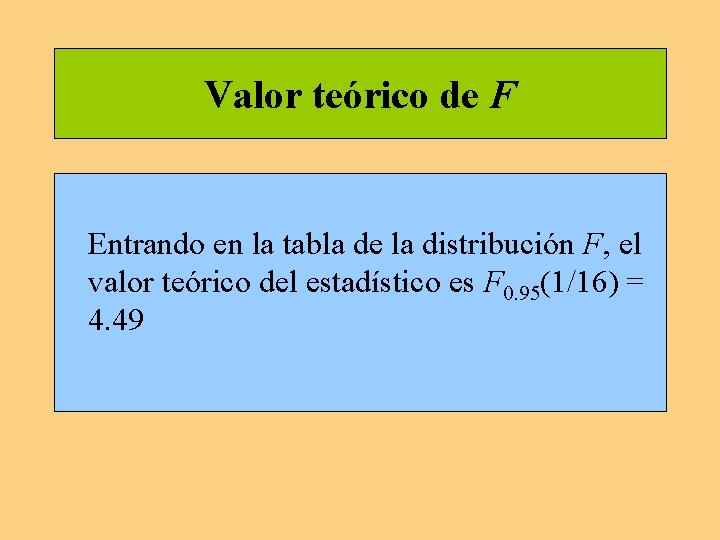
Valor teórico de F Entrando en la tabla de la distribución F, el valor teórico del estadístico es F 0. 95(1/16) = 4. 49
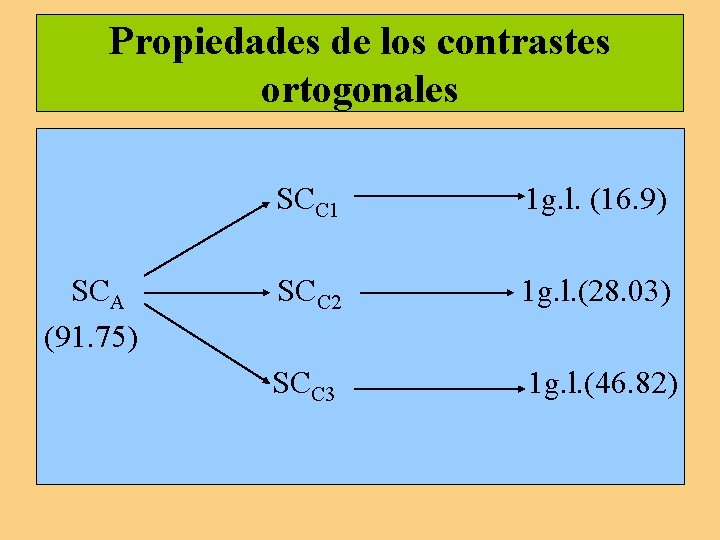
Características de los contrastes ortogonales Una propiedad característica de las comparaciones ortogonales es la descomposición de la Suma de Cuadrados de tratamientos del ANOVA en tantos componentes ortogonales (independientes) como grados de libertad de esa fuente de variación (se dispone de un grado de libertad por componente) Siguiendo con el ejemplo propuesto, la Suma de Cuadrados de tratamientos, SCA, tiene a - 1 grados de libertad y, como consecuencia, tres componentes ortogonales (siendo a igual a cuatro)
Propiedades de los contrastes ortogonales SCA (91. 75) SCC 1 1 g. l. (16. 9) SCC 2 1 g. l. (28. 03) SCC 3 1 g. l. (46. 82)
Desventajas de los contrastes a priori o planificados Se corre el riesgo de cometer más errores de Tipo I al asumir como verdadera la hipótesis de nulidad; es decir, hay la posibilidad de realizar más rechazos falsos de la hipótesis de nulidad o de no efectos. En línea con esa problemática, es conveniente distinguir dos tipos de errores: Error de Tipo I por comparación (PC) y tasa de error por familia (PF). El error PC, simbolizado por α, es la probabilidad de cometer un error de Tipo I por comparación. . . //. .
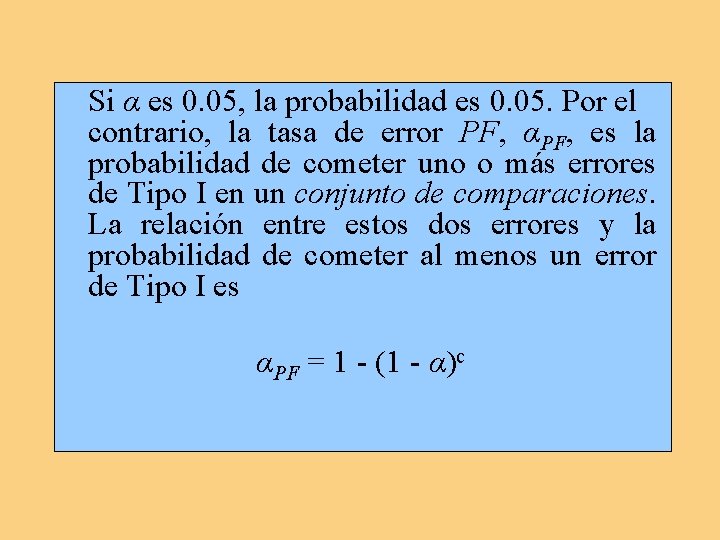
Si α es 0. 05, la probabilidad es 0. 05. Por el contrario, la tasa de error PF, αPF, es la probabilidad de cometer uno o más errores de Tipo I en un conjunto de comparaciones. La relación entre estos dos errores y la probabilidad de cometer al menos un error de Tipo I es αPF = 1 - (1 - α)c
Cálculo del error PF Así, con cinco comparaciones (c = 5), y un α de 0. 05, la probabilidad de cometer un error PF es 1 - 0. 955 = 0. 23. De forma aproximada, esa probabilidad se calcula por (c)(α), 5(0. 05) = 0. 25. En el caso de las comparaciones ortogonales estudiadas, la probabilidad de rechazar una de las hipótesis de nulidad siendo verdadera es 1 (0. 95)3 = 0. 14. Esta probabilidad tiende a aumentar con el número de comparaciones independientes. . . //. .
Así, para un conjunto de comparaciones independientes, es posible que algunas sean significativas como resultado de la propia metodología. Para evitar esas dificultades se aplican las comparaciones a posteriori, post hoc, o comparaciones simultáneas.
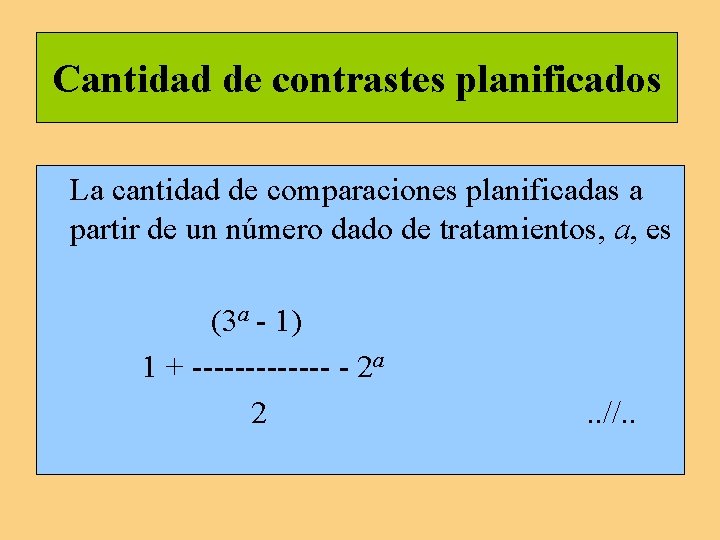
Cantidad de contrastes planificados La cantidad de comparaciones planificadas a partir de un número dado de tratamientos, a, es (3 a - 1) 1 + ------- - 2 a 2 . . //. .
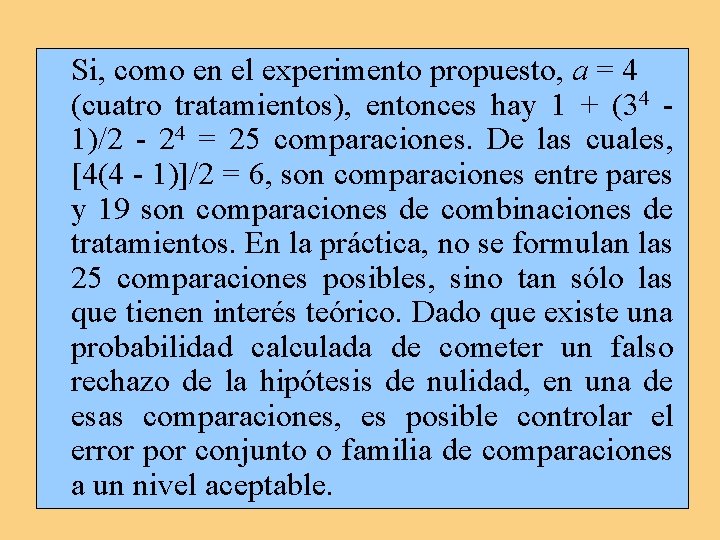
Si, como en el experimento propuesto, a = 4 (cuatro tratamientos), entonces hay 1 + (34 1)/2 - 24 = 25 comparaciones. De las cuales, [4(4 - 1)]/2 = 6, son comparaciones entre pares y 19 son comparaciones de combinaciones de tratamientos. En la práctica, no se formulan las 25 comparaciones posibles, sino tan sólo las que tienen interés teórico. Dado que existe una probabilidad calculada de cometer un falso rechazo de la hipótesis de nulidad, en una de esas comparaciones, es posible controlar el error por conjunto o familia de comparaciones a un nivel aceptable.
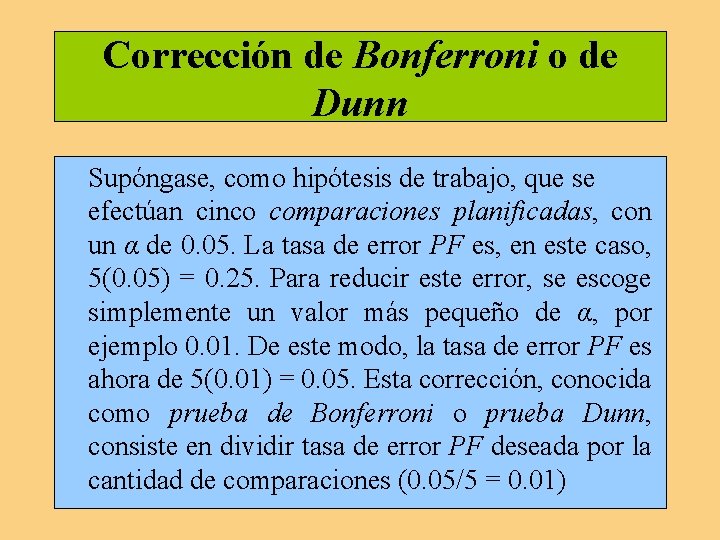
Corrección de Bonferroni o de Dunn Supóngase, como hipótesis de trabajo, que se efectúan cinco comparaciones planificadas, con un α de 0. 05. La tasa de error PF es, en este caso, 5(0. 05) = 0. 25. Para reducir este error, se escoge simplemente un valor más pequeño de α, por ejemplo 0. 01. De este modo, la tasa de error PF es ahora de 5(0. 01) = 0. 05. Esta corrección, conocida como prueba de Bonferroni o prueba Dunn, consiste en dividir tasa de error PF deseada por la cantidad de comparaciones (0. 05/5 = 0. 01)
Contrastes no planificados o a posteriori El objetivo de los contrastes no planificados es obtener el máximo de información de los datos de un experimento. Los contrastes no planificados son procedimientos para efectuar comparaciones a posteriori. Estos procedimientos poseen, de otra parte, la ventaja de mantener constante la probabilidad de cometer errores de Tipo I cuando se toma la decisión estadística. . . //. .
Los métodos propuestos se conocen por comparaciones simultáneas. Con comparaciones no planificadas, a posteriori o post hoc, los pruebas estadísticas citadas van encaminados a reducir el tamaño de la región crítica, y controlan el error PF mediante el ajuste del valor alfa. . . //. .
Con comparaciones no planificadas o post hoc, hay técnicas encaminadas a reducir el tamaño de la región crítica, que controlan el error PF mediante el ajuste del valor alfa. Entre los distintos métodos, se encuentran las pruebas de Scheffé (1959), Tukey (1953), Newman-Keuls (Newman, 1939 y Keuls, 1952), Duncan (1953), y Dunnett (1955).
Análisis de tendencias
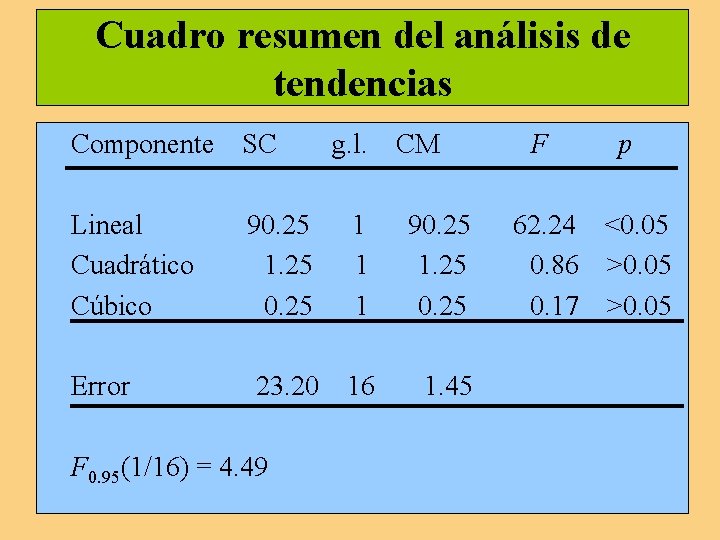
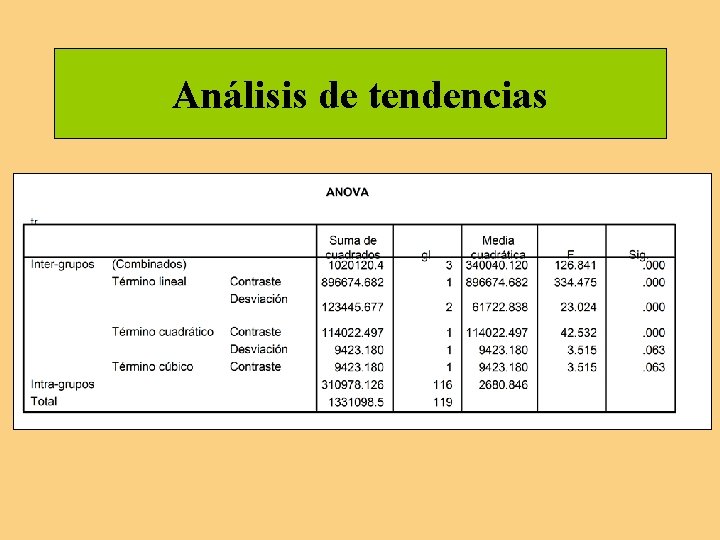
Concepto Una de las técnicas de análisis de tendencias es el método de polinomios ortogonales. En virtud de ese procedimiento, es posible dividir la variación o Suma de Cuadrados de tratamientos en una serie de componentes independientes de tendencia como, por ejemplo, lineal, cuadrado, cúbico, etc. Cada componente ortogonal aporta información particular sobre una clase de tendencia o relación entre la variable independiente y la variable dependiente. Al mismo tiempo, este procedimiento permite verificar estadísticamente la significación de cada componente de tendencia.
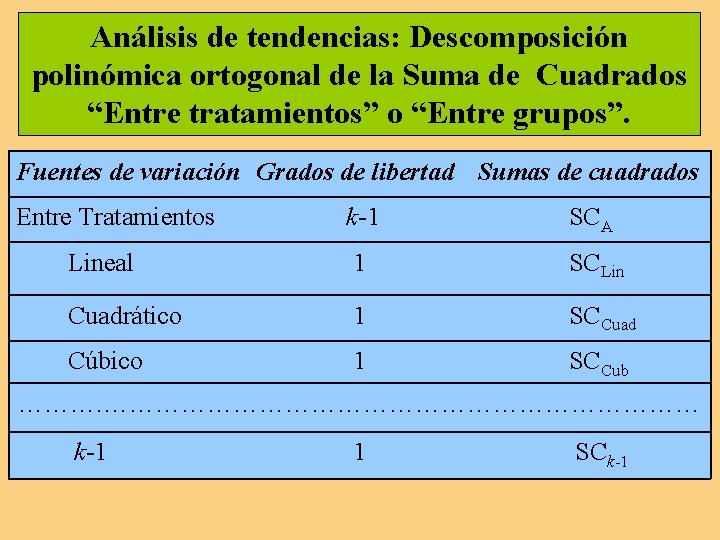
Análisis de tendencias: Descomposición polinómica ortogonal de la Suma de Cuadrados “Entre tratamientos” o “Entre grupos”. Fuentes de variación Grados de libertad Sumas de cuadrados Entre Tratamientos k-1 SCA Lineal 1 SCLin Cuadrático 1 SCCuad Cúbico 1 SCCub ……………………………… k-1 1 SCk-1
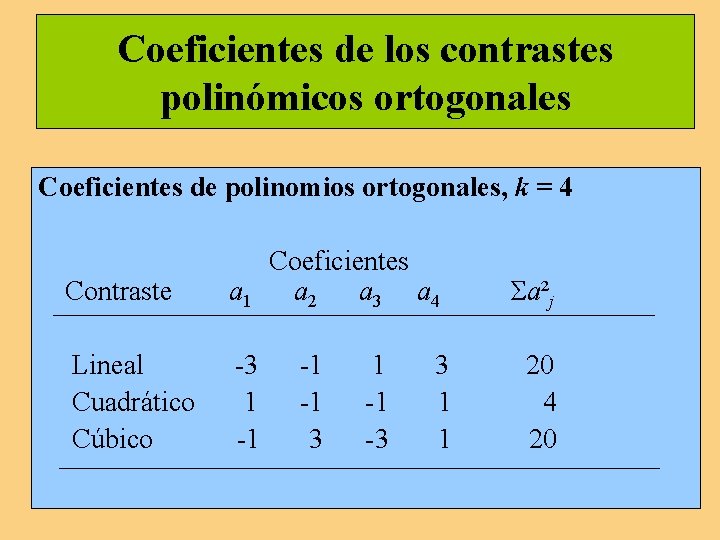
Coeficientes de los contrastes polinómicos ortogonales Coeficientes de polinomios ortogonales, k = 4 Contraste Coeficientes a 1 a 2 a 3 a 4 Lineal Cuadrático Cúbico -3 1 -1 -1 -1 3 1 -1 -3 3 1 1 Σa²j 20 4 20
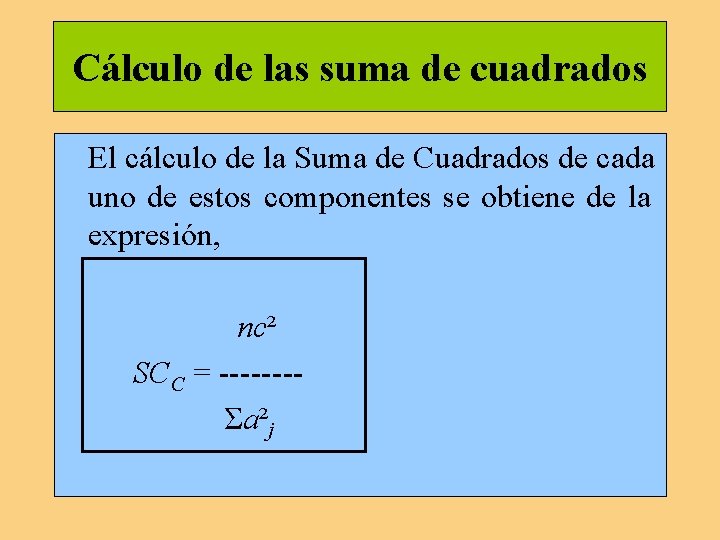
Cálculo de las suma de cuadrados El cálculo de la Suma de Cuadrados de cada uno de estos componentes se obtiene de la expresión, nc² SCC = -------Σa²j
Cuadro resumen del análisis de tendencias Componente SC Lineal Cuadrático Cúbico 90. 25 1. 25 0. 25 1 1 1 90. 25 1. 25 0. 25 23. 20 16 1. 45 Error F 0. 95(1/16) = 4. 49 g. l. CM F p 62. 24 <0. 05 0. 86 >0. 05 0. 17 >0. 05
Gráfico de medias
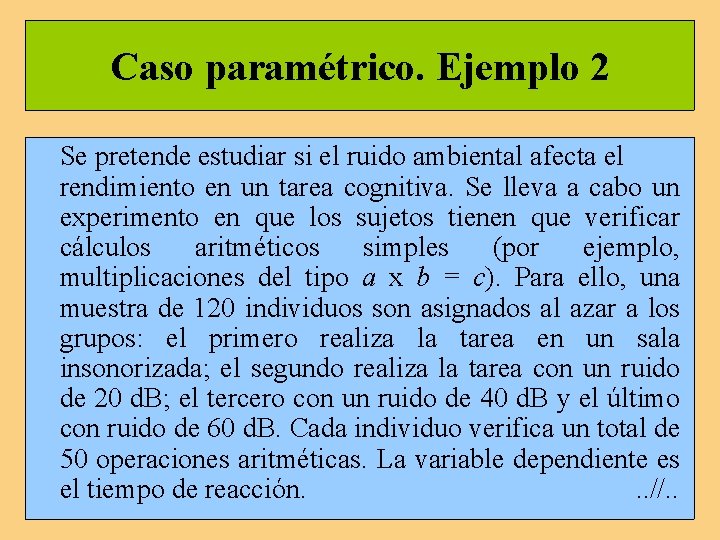
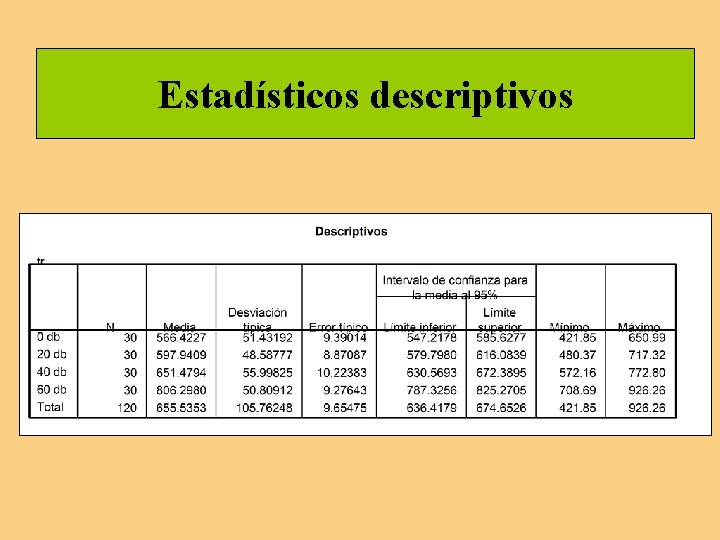
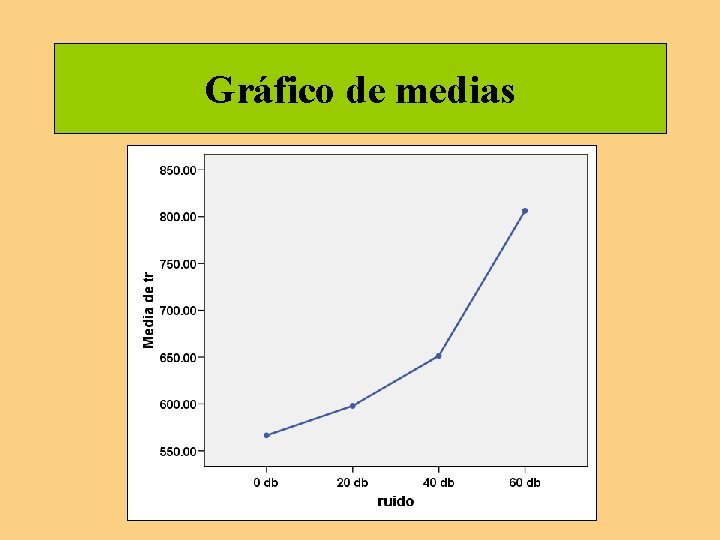
Caso paramétrico. Ejemplo 2 Se pretende estudiar si el ruido ambiental afecta el rendimiento en un tarea cognitiva. Se lleva a cabo un experimento en que los sujetos tienen que verificar cálculos aritméticos simples (por ejemplo, multiplicaciones del tipo a x b = c). Para ello, una muestra de 120 individuos son asignados al azar a los grupos: el primero realiza la tarea en un sala insonorizada; el segundo realiza la tarea con un ruido de 20 d. B; el tercero con un ruido de 40 d. B y el último con ruido de 60 d. B. Cada individuo verifica un total de 50 operaciones aritméticas. La variable dependiente es el tiempo de reacción. . . //. .
Estadísticos descriptivos
Prueba de homogeneidad de las variancias
ANOVA
Comparaciones múltiples
Análisis de tendencias
Gráfico de medias
Ventajas y desventajas El diseño multigrupo completamente al azar permite examinar, desde una perspectiva amplia, las distintas estrategias de análisis aplicables a los datos experimentales. En primer lugar, el análisis unidimensional de la variancia o indicador general de variación de las medias de los grupos. . . //. .
En segundo lugar, las estrategias que prueban las microhipótesis de investigación; es decir, las comparaciones múltiples entre medias. Por último, para aquellas situaciones donde la variable independiente es cuantitativa y con valores equidistantes, el análisis de tendencias mediante el procedimiento de modelación polinómica ortogonal.