
Tema 8 Secuenciacin y Proyecto Genoma Humano 8
- Slides: 58
Tema 8. Secuenciación y Proyecto Genoma Humano 8. 1 Métodos de secuenciación 8. 2 Ensamblaje de una secuencia de DNA continua 8. 3 Estrategias de secuenciación del genoma: secuenciación aleatoria y jerárquica 8. 4 El Proyecto Genoma Humano 8. 5 Número, estructura y distribución de los genes humanos Referencias: Brown 2002, págs. 60 -64, 164 -181 y 188195. Lander et al. 2001, Nature 409: 860 -891.
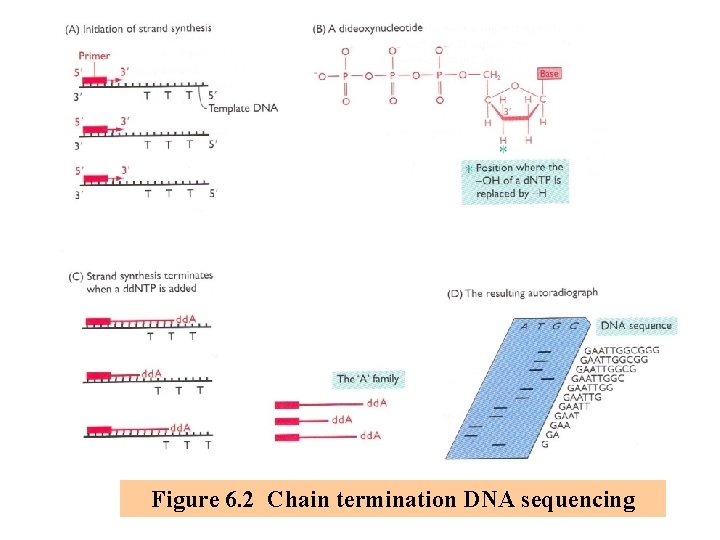
Figure 6. 2 Chain termination DNA sequencing
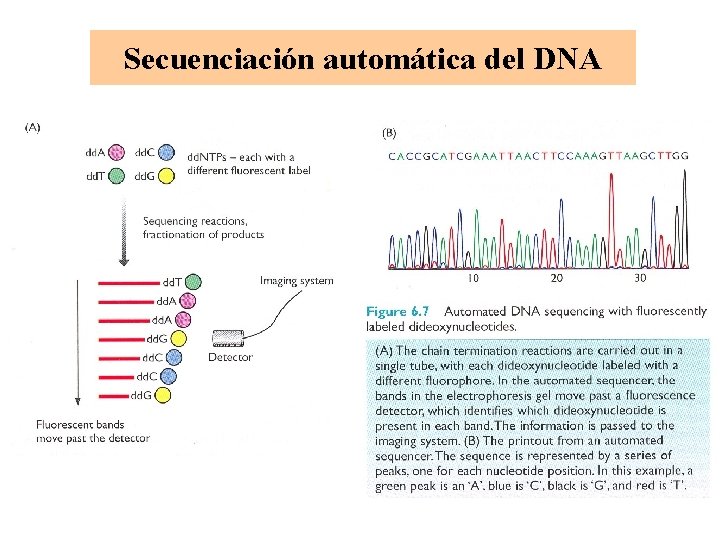
Secuenciación automática del DNA
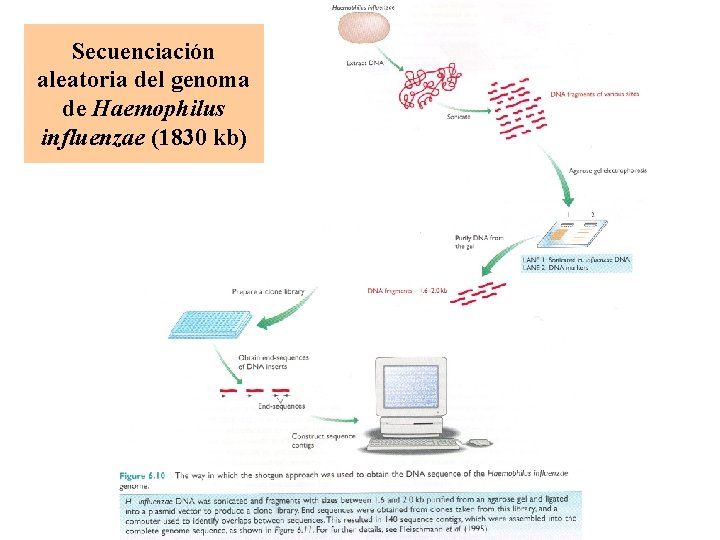
Secuenciación aleatoria del genoma de Haemophilus influenzae (1830 kb)
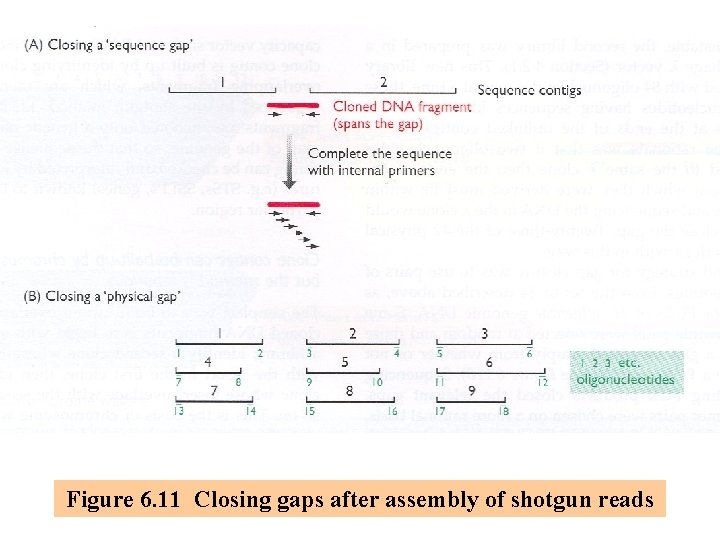
Figure 6. 11 Closing gaps after assembly of shotgun reads
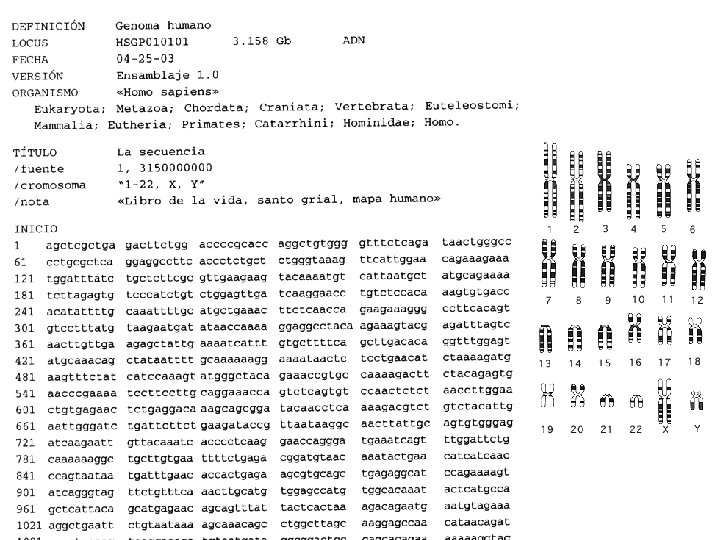
The human genome El genoma humano
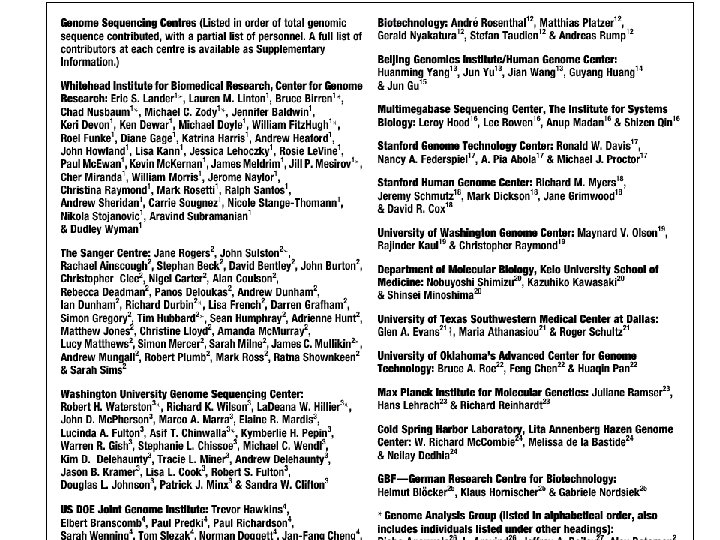
El Proyecto Genoma Humano 1. Consorcio de 20 laboratorios públicos pertenecientes a 6 países. Liderado por F. S. Collins y E. Lander. 2. Discusión y debate en la comunidad científica 1984 -1990. Iniciativa: Departament of Energy y National Institutes of Health (US). Comienzo del proyecto: 1990. Borrador: Oct 2000. Publicación: Feb 2001. Finalización: Octubre 2004. 3. Secuenciación aleatoria jerárquica (Hierarchical Shotgun Sequencing). 4. Material: DNA obtenido de donantes anónimos. La identidad de los donantes no es conocida (ni siquiera por ellos mismos). 5. Los datos se han hecho públicos a través de los bancos públicos de datos sin ninguna restricción a medida que se progresaba en el proyecto. 6. Publicación: Nature 409: 860 -921 (15 febrero 2001); Nature 431: 931 -945 (21 Octubre 2004).
Estrategias de Secuenciación de genomas Aproximación Clon a clon (Consorcio público) Francis Collins Eric Lander
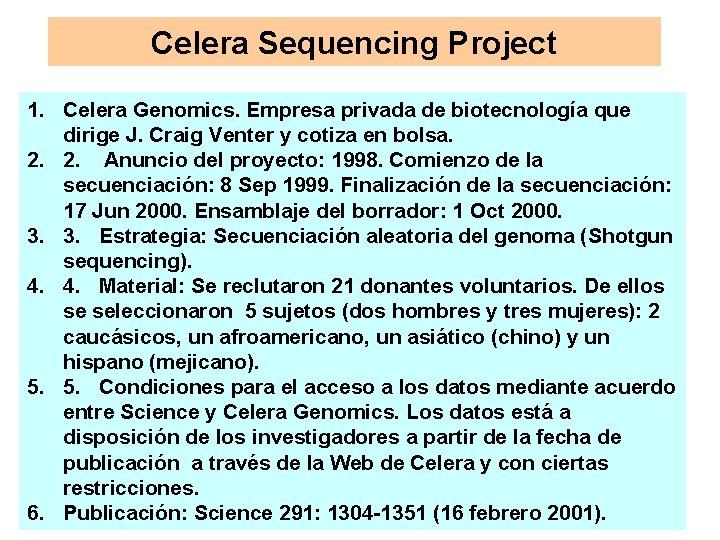
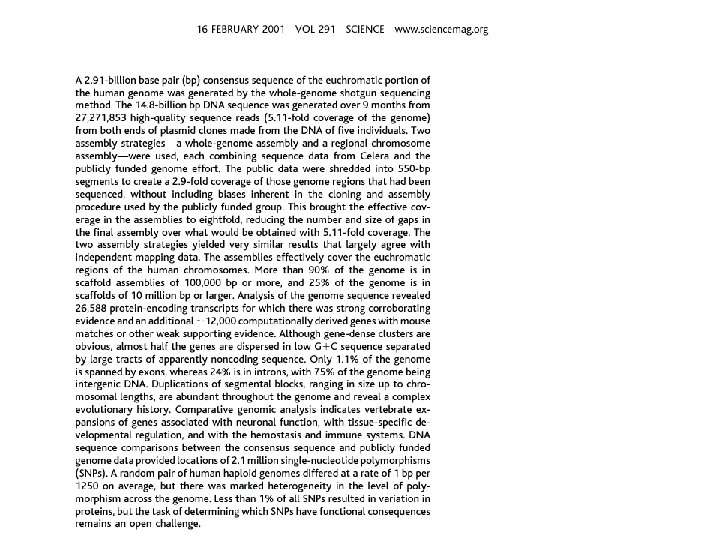
Celera Sequencing Project 1. Celera Genomics. Empresa privada de biotecnología que dirige J. Craig Venter y cotiza en bolsa. 2. 2. Anuncio del proyecto: 1998. Comienzo de la secuenciación: 8 Sep 1999. Finalización de la secuenciación: 17 Jun 2000. Ensamblaje del borrador: 1 Oct 2000. 3. 3. Estrategia: Secuenciación aleatoria del genoma (Shotgun sequencing). 4. 4. Material: Se reclutaron 21 donantes voluntarios. De ellos se seleccionaron 5 sujetos (dos hombres y tres mujeres): 2 caucásicos, un afroamericano, un asiático (chino) y un hispano (mejicano). 5. 5. Condiciones para el acceso a los datos mediante acuerdo entre Science y Celera Genomics. Los datos está a disposición de los investigadores a partir de la fecha de publicación a través de la Web de Celera y con ciertas restricciones. 6. Publicación: Science 291: 1304 -1351 (16 febrero 2001).
Secuenciación del genoma (Aproximación aleatoria) J. Craig Venter
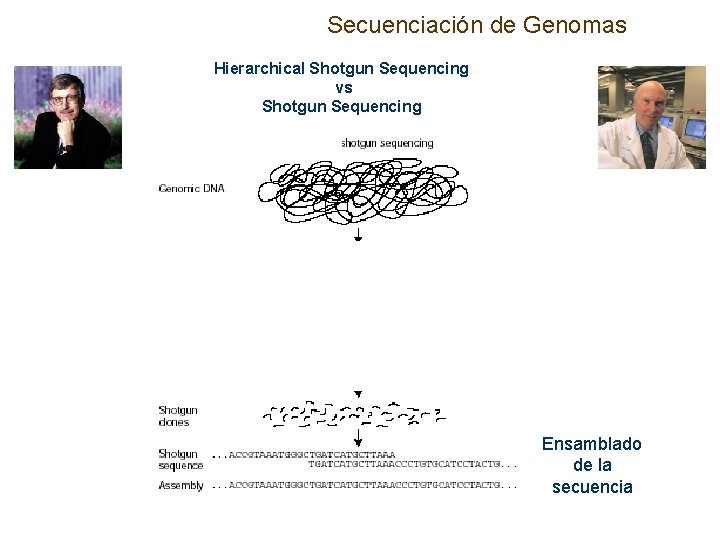
Secuenciación de Genomas Hierarchical Shotgun Sequencing vs Shotgun Sequencing Ensamblado de la secuencia
Secuenciación del genoma (Aproximación aleatoria) Se utilizan algoritmos computaciones para ensamblar contigs derivados de miles de secuencias solapantes Se obtiene una redundancia 5 -10 El alineamiento ensambla clones contiguos y aumenta la exactitud de la secuencia creando una consenso
26 de Junio del 2000 Presentación de la Secuencia del genoma humano Estamos aprendiendo el lenguaje con el que Dios creó la vida. Aumenta nuestro asombro por la complejidad, la belleza y la maravilla del más sagrado y divino don de Dios.
El genoma humano 15 y 16 de Febrero 2001: Publicación secuencia borrador del genoma humano
Celera
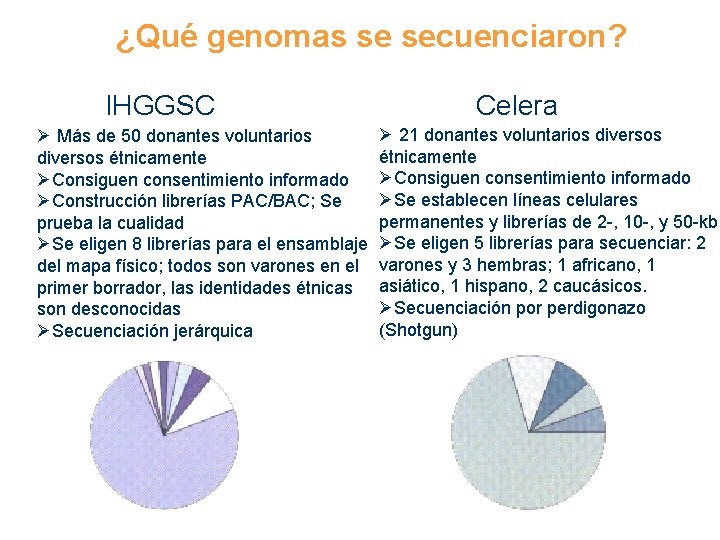
¿Qué genomas se secuenciaron? IHGGSC Ø Más de 50 donantes voluntarios diversos étnicamente ØConsiguen consentimiento informado ØConstrucción librerías PAC/BAC; Se prueba la cualidad ØSe eligen 8 librerías para el ensamblaje del mapa físico; todos son varones en el primer borrador, las identidades étnicas son desconocidas ØSecuenciación jerárquica Celera Ø 21 donantes voluntarios diversos étnicamente ØConsiguen consentimiento informado ØSe establecen líneas celulares permanentes y librerías de 2 -, 10 -, y 50 -kb ØSe eligen 5 librerías para secuenciar: 2 varones y 3 hembras; 1 africano, 1 asiático, 1 hispano, 2 caucásicos. ØSecuenciación por perdigonazo (Shotgun)
Generación del borrador Paisaje genómico amplio Variación en contenido GC Islas Cp. G Comparación de distancia genética y física Contenido de repeticiones Contenido de genes Análisis del proteoma
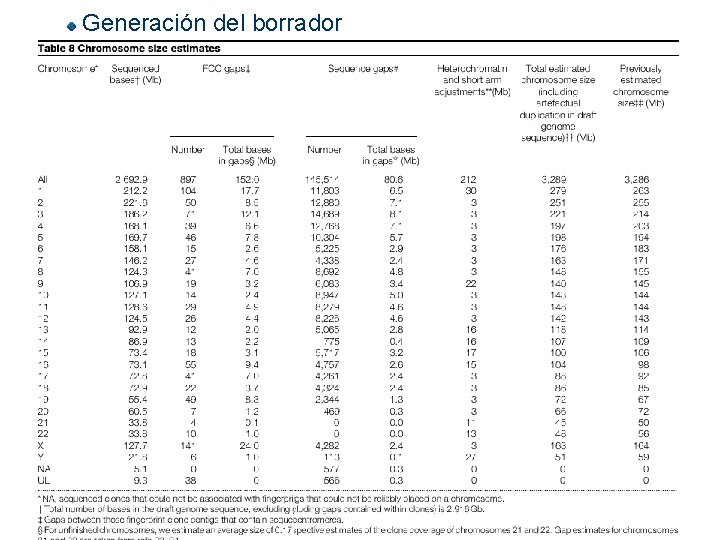
Generación del borrador
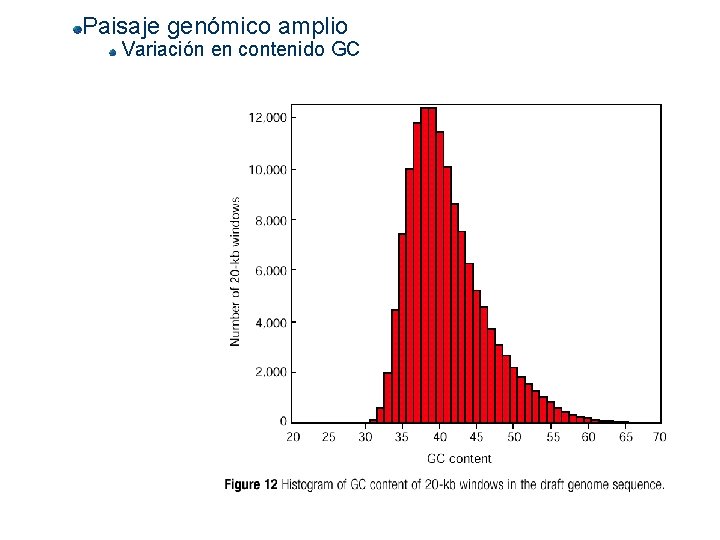
Paisaje genómico amplio Variación en contenido GC
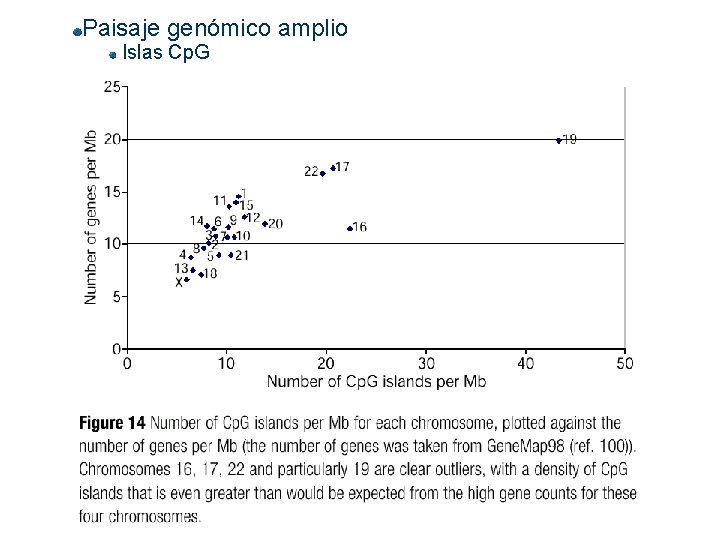
Paisaje genómico amplio Islas Cp. G
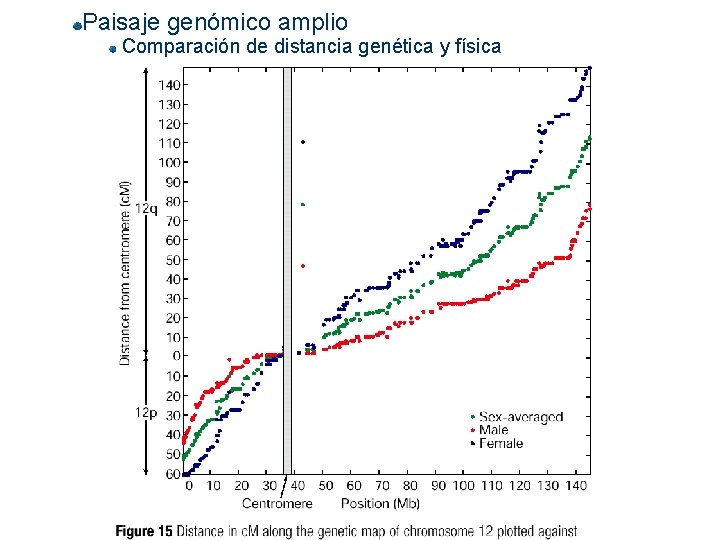
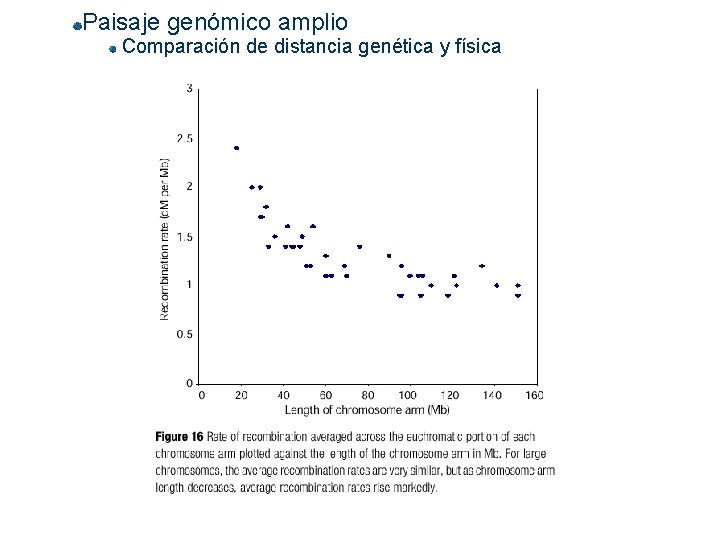
Paisaje genómico amplio Comparación de distancia genética y física
Paisaje genómico amplio Comparación de distancia genética y física
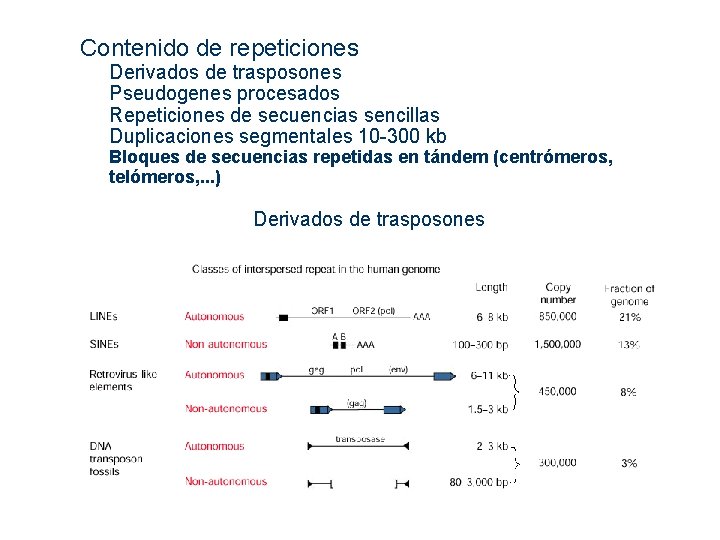
Contenido de repeticiones Derivados de trasposones Pseudogenes procesados Repeticiones de secuencias sencillas Duplicaciones segmentales 10 -300 kb Bloques de secuencias repetidas en tándem (centrómeros, telómeros, . . . ) Derivados de trasposones
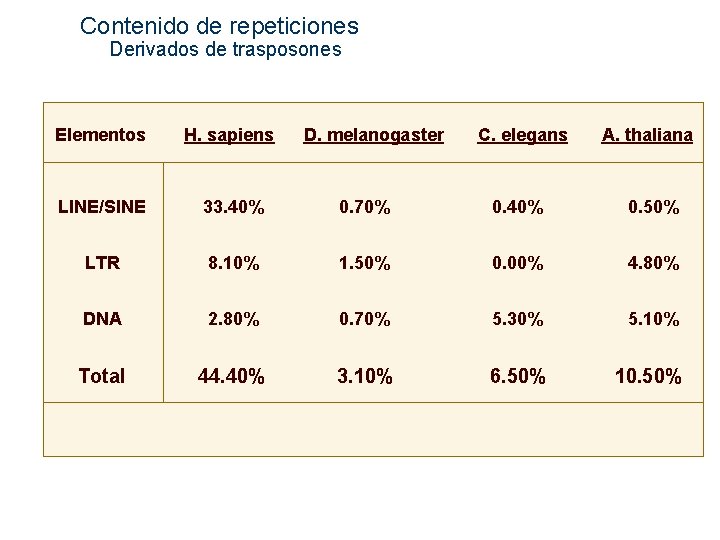
Contenido de repeticiones Derivados de trasposones Elementos H. sapiens LINE/SINE 33. 40% 0. 70% 0. 40% 0. 50% LTR 8. 10% 1. 50% 0. 00% 4. 80% DNA 2. 80% 0. 70% 5. 30% 5. 10% 44. 40% 3. 10% 6. 50% 10. 50% Total D. melanogaster C. elegans A. thaliana
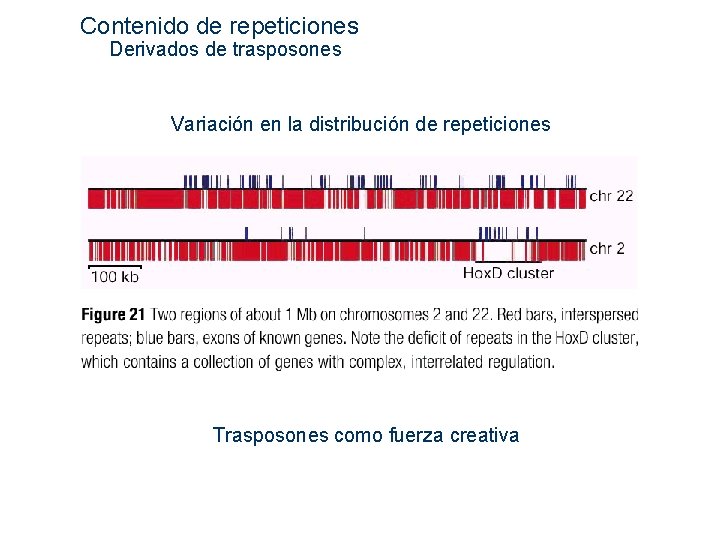
Contenido de repeticiones Derivados de trasposones Variación en la distribución de repeticiones Trasposones como fuerza creativa
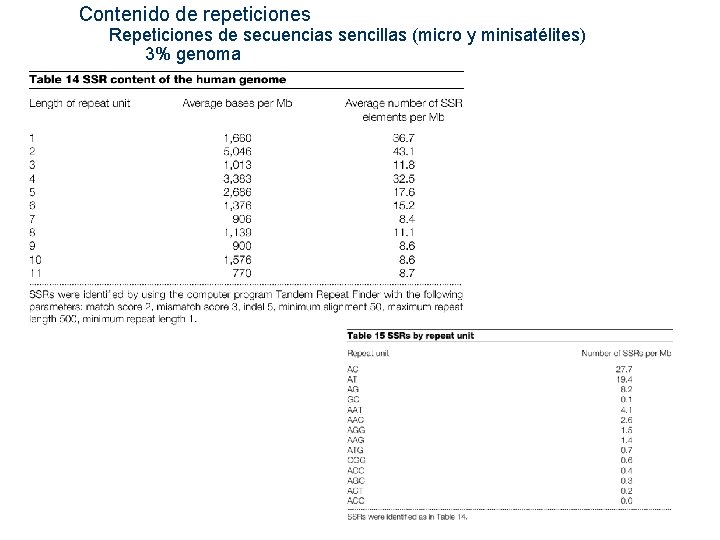
Contenido de repeticiones Repeticiones de secuencias sencillas (micro y minisatélites) 3% genoma
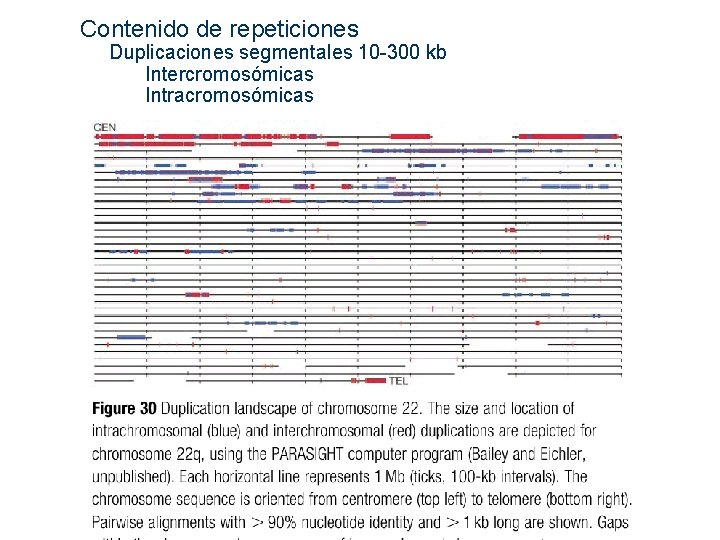
Contenido de repeticiones Duplicaciones segmentales 10 -300 kb Intercromosómicas Intracromosómicas
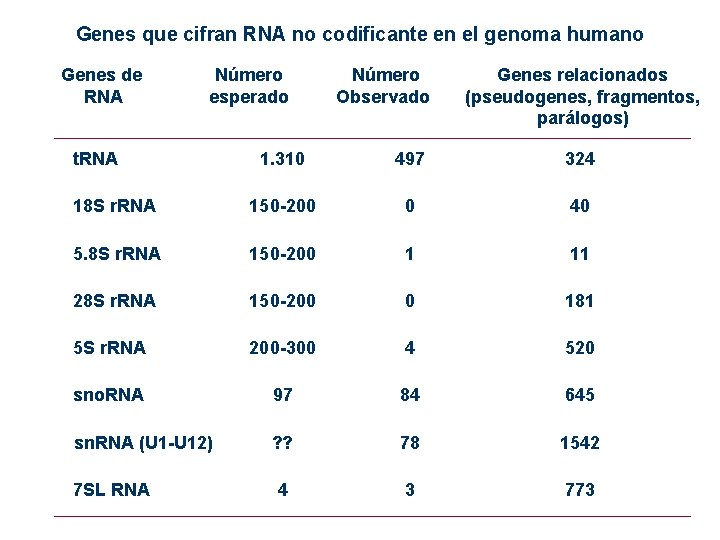
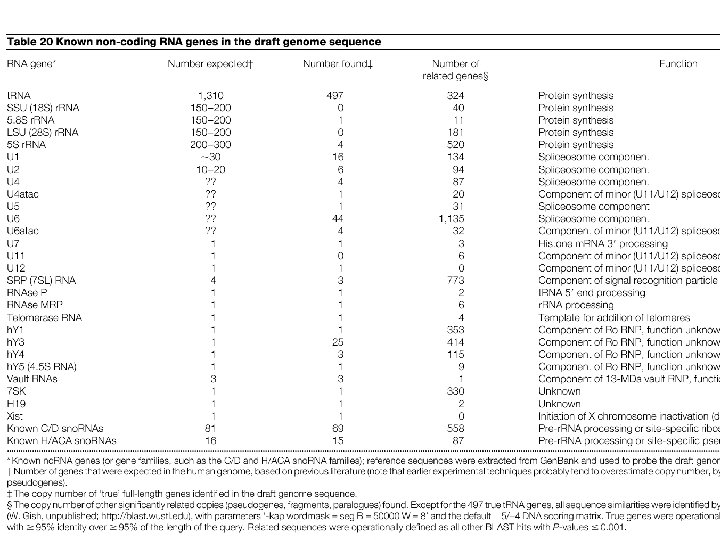
Genes que cifran RNA no codificante en el genoma humano Genes de RNA Número esperado t. RNA Número Observado Genes relacionados (pseudogenes, fragmentos, parálogos) 1. 310 497 324 18 S r. RNA 150 -200 0 40 5. 8 S r. RNA 150 -200 1 11 28 S r. RNA 150 -200 0 181 5 S r. RNA 200 -300 4 520 sno. RNA 97 84 645 sn. RNA (U 1 -U 12) ? ? 78 1542 4 3 773 7 SL RNA
Contenido de genes RNAs no codificantes (nc. RNA)
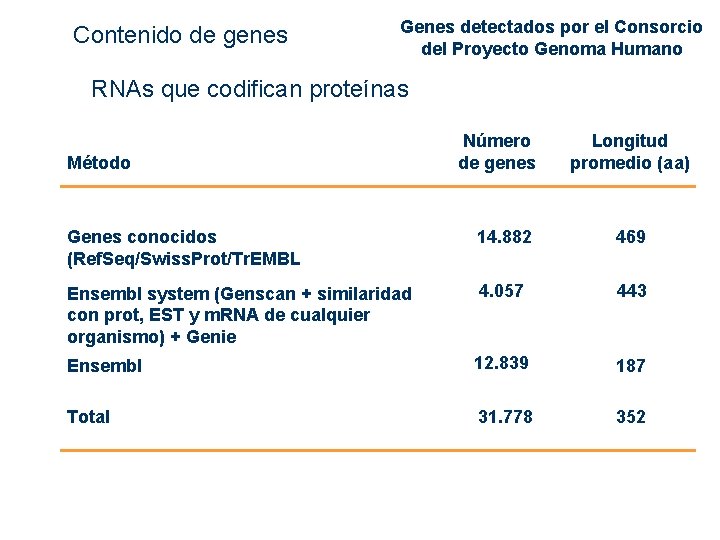
Genes detectados por el Consorcio del Proyecto Genoma Humano Contenido de genes RNAs que codifican proteínas Método Número de genes Longitud promedio (aa) Genes conocidos (Ref. Seq/Swiss. Prot/Tr. EMBL 14. 882 469 Ensembl system (Genscan + similaridad con prot, EST y m. RNA de cualquier organismo) + Genie 4. 057 443 Ensembl 12. 839 187 Total 31. 778 352
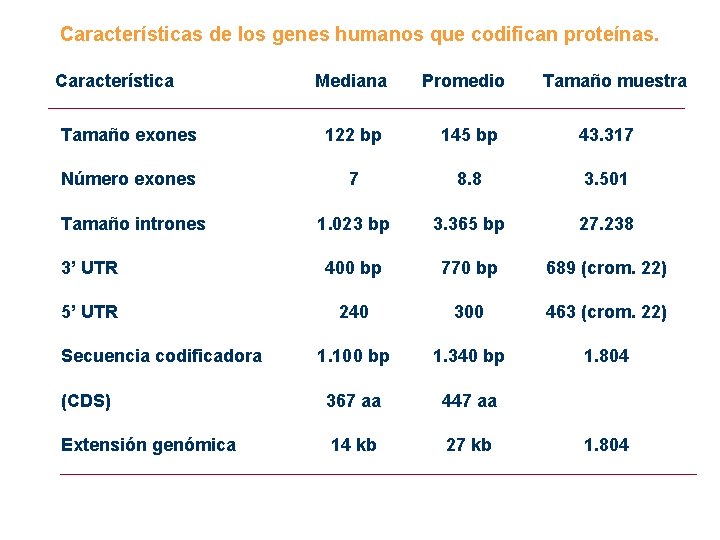
Características de los genes humanos que codifican proteínas. Característica Mediana Promedio Tamaño muestra Tamaño exones 122 bp 145 bp 43. 317 Número exones 7 8. 8 3. 501 Tamaño intrones 1. 023 bp 3. 365 bp 27. 238 3’ UTR 400 bp 770 bp 689 (crom. 22) 5’ UTR 240 300 463 (crom. 22) 1. 100 bp 1. 340 bp 1. 804 (CDS) 367 aa 447 aa Extensión genómica 14 kb 27 kb Secuencia codificadora 1. 804
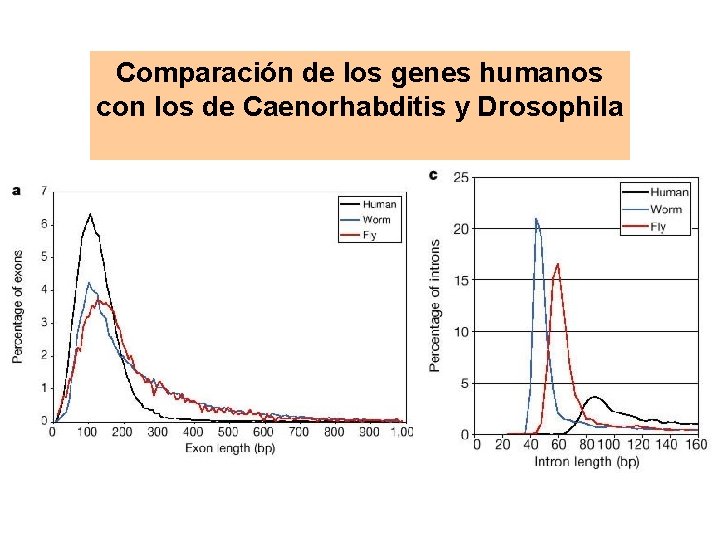
Comparación de los genes humanos con los de Caenorhabditis y Drosophila
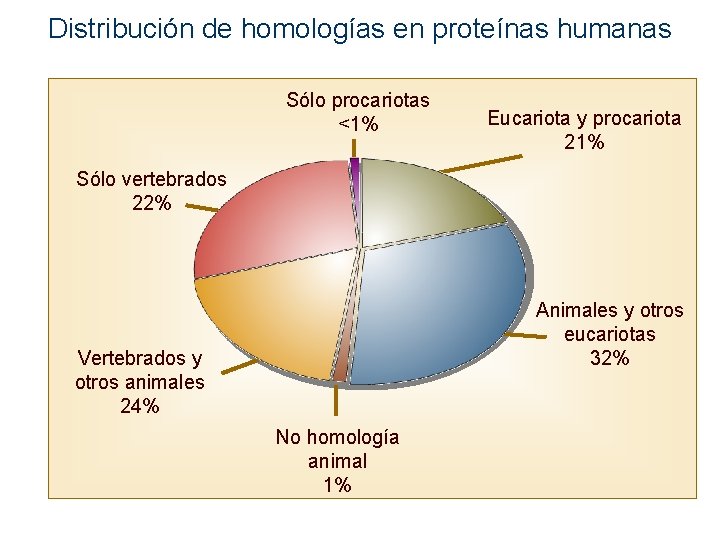
Distribución de homologías en proteínas humanas Sólo procariotas <1% Eucariota y procariota 21% Sólo vertebrados 22% Animales y otros eucariotas 32% Vertebrados y otros animales 24% No homología animal 1%
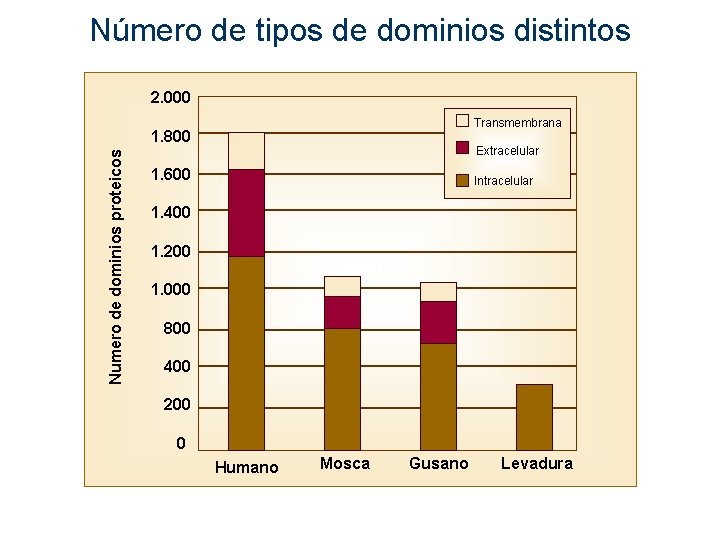
Número de tipos de dominios distintos 2. 000 Transmembrana Numero de dominios proteicos 1. 800 Extracelular 1. 600 Intracelular 1. 400 1. 200 1. 000 800 400 200 0 Humano Mosca Gusano Levadura
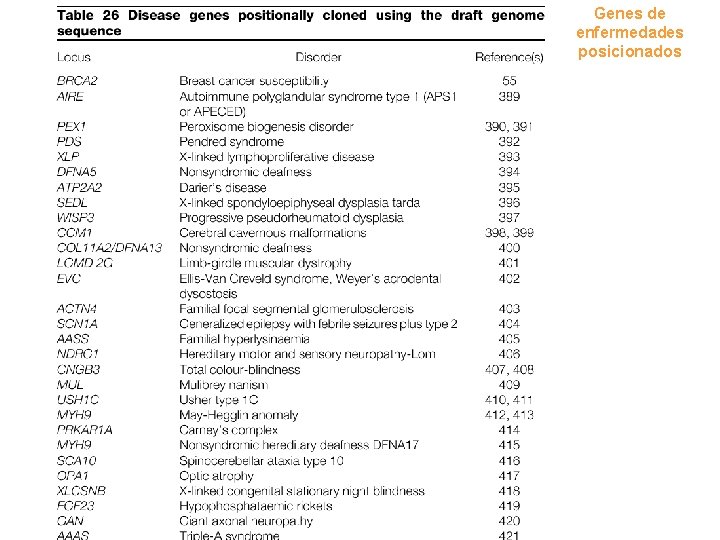
Genes de enfermedades posicionados
Celera
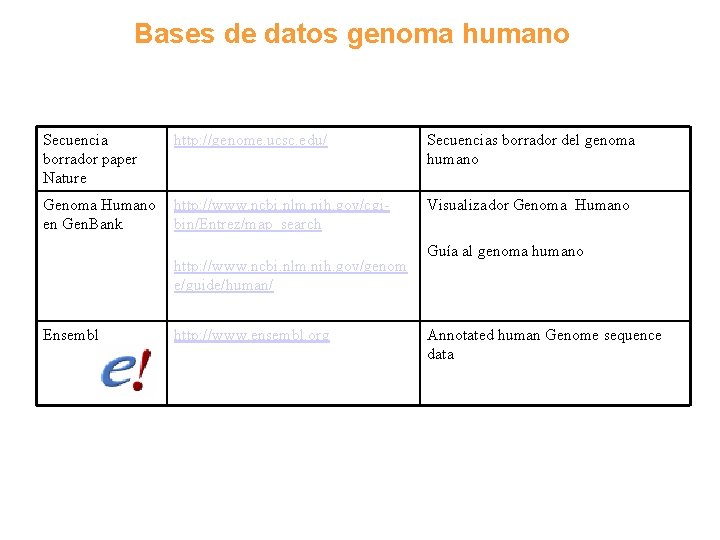
Bases de datos genoma humano Secuencia borrador paper Nature http: //genome. ucsc. edu/ Secuencias borrador del genoma humano Genoma Humano en Gen. Bank http: //www. ncbi. nlm. nih. gov/cgibin/Entrez/map_search Visualizador Genoma Humano http: //www. ncbi. nlm. nih. gov/genom e/guide/human/ Ensembl http: //www. ensembl. org Guía al genoma humano Annotated human Genome sequence data
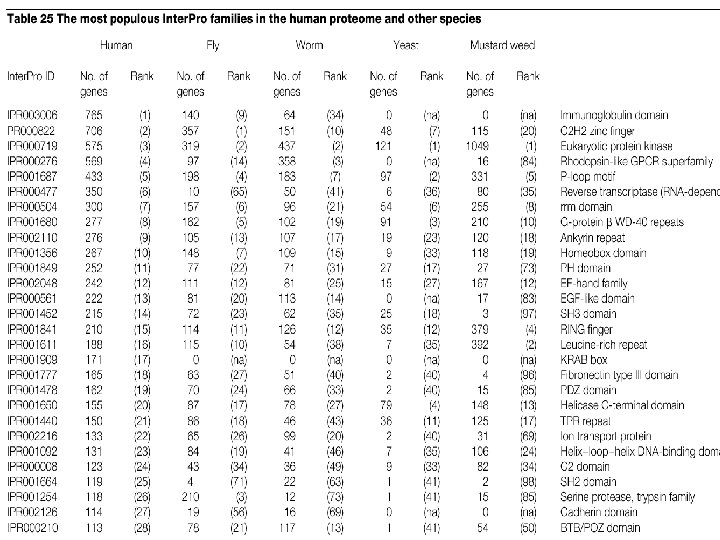
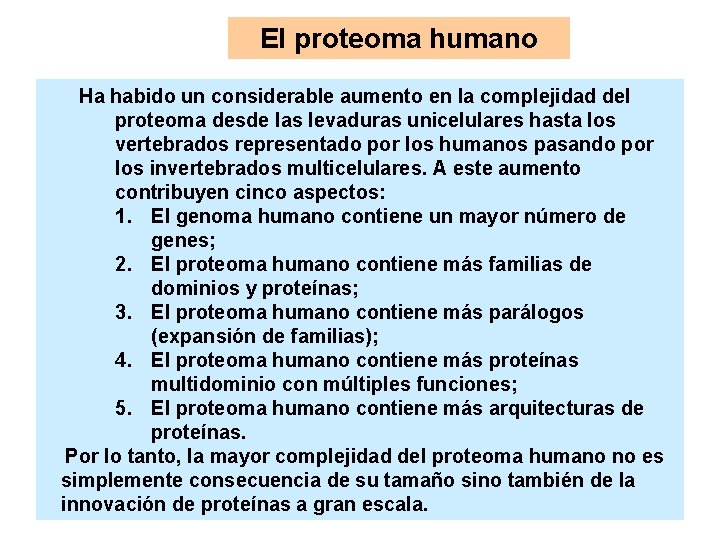
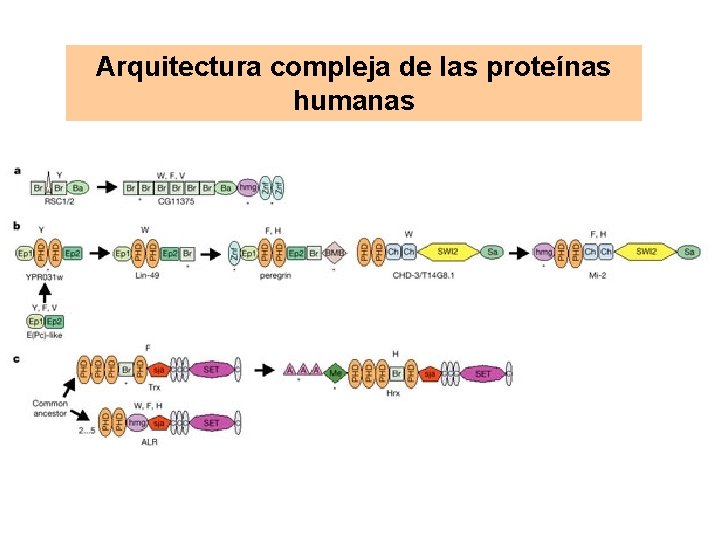
El proteoma humano Ha habido un considerable aumento en la complejidad del proteoma desde las levaduras unicelulares hasta los vertebrados representado por los humanos pasando por los invertebrados multicelulares. A este aumento contribuyen cinco aspectos: 1. El genoma humano contiene un mayor número de genes; 2. El proteoma humano contiene más familias de dominios y proteínas; 3. El proteoma humano contiene más parálogos (expansión de familias); 4. El proteoma humano contiene más proteínas multidominio con múltiples funciones; 5. El proteoma humano contiene más arquitecturas de proteínas. Por lo tanto, la mayor complejidad del proteoma humano no es simplemente consecuencia de su tamaño sino también de la innovación de proteínas a gran escala.
Arquitectura compleja de las proteínas humanas
Genoma Humano (versión 21 -Oct-2004)
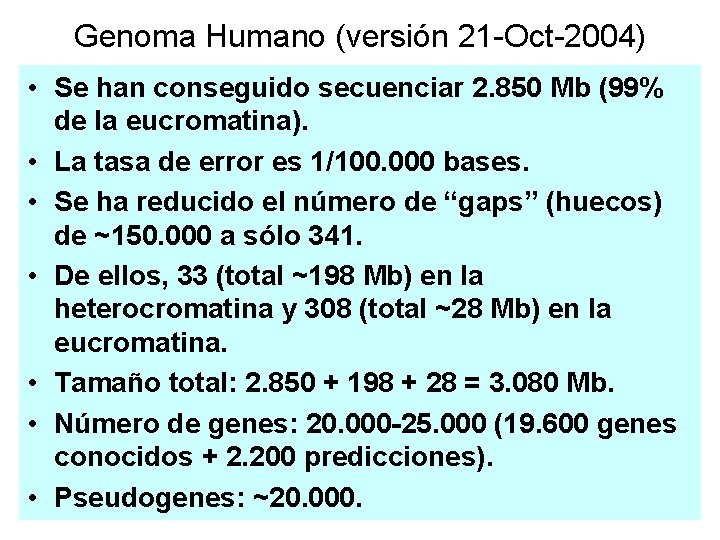
Genoma Humano (versión 21 -Oct-2004) • Se han conseguido secuenciar 2. 850 Mb (99% de la eucromatina). • La tasa de error es 1/100. 000 bases. • Se ha reducido el número de “gaps” (huecos) de ~150. 000 a sólo 341. • De ellos, 33 (total ~198 Mb) en la heterocromatina y 308 (total ~28 Mb) en la eucromatina. • Tamaño total: 2. 850 + 198 + 28 = 3. 080 Mb. • Número de genes: 20. 000 -25. 000 (19. 600 genes conocidos + 2. 200 predicciones). • Pseudogenes: ~20. 000.
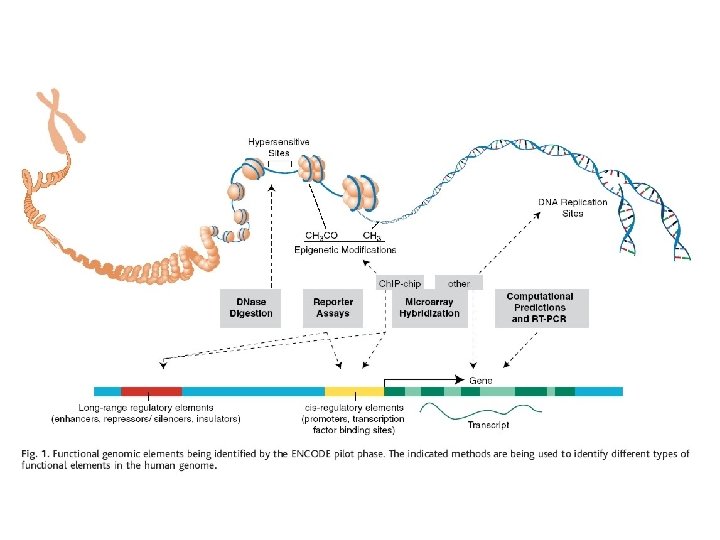
El proyecto ENCODE • El proyecto ENCODE (Encyclopedia od DNA elements) pretende identificar TODOS los elementos funcionales de la secuencia del genoma humano. • Fase piloto. Análisis detallado de 44 regiones discretas repartidas por todo el genoma que suman ~30 Mb (~1%). • Fase de desarrollo tecnológico. • Fase de producción. Aplicación de las técnicas desarrolladas en la fase anterior al conjunto del genoma.
Es un recurso gigantesco que cambiará la humanidad, como lo hizo la imprenta J. D. Watson
Este es un Estamos Antes Pronto auténtico pensábamos viviendo el miraremos en periodo que nuestro profundidad momento histórico, un futuro estaba en nosotros intelectual nuevo punto en las estrellas, mismo y más grande de partida ahora sabemos decidiremos de laestá historia que en los queremos genes Craig ser Matt Ridley Venter Watson E. O. JDWilson
¡Bienvenidos a la era de la Genómica!