
Teil 5 Maschinelles Lernen Definitionen und Abgrenzungen Was
Teil 5 Maschinelles Lernen
Definitionen und Abgrenzungen Ø Was ist Lernen? ðZentrale Fähigkeit von „intelligenten Systemen“ in Natur und KI ðZielgerichtete Veränderung von Wissen und/oder Verhaltensweisen durch Erfahrung ðViele Formen des Lernens: ²motorisches Lernen, Regellernen, Sprachlernen, Lernen mit Lehrern, Lernen in der Entwicklung, . . . Ø Was ist kein Lernen? ðEinfaches Speichern von Daten (keine Veränderung) ðfestes Programmieren von Lösungen (keine Erfahrung)
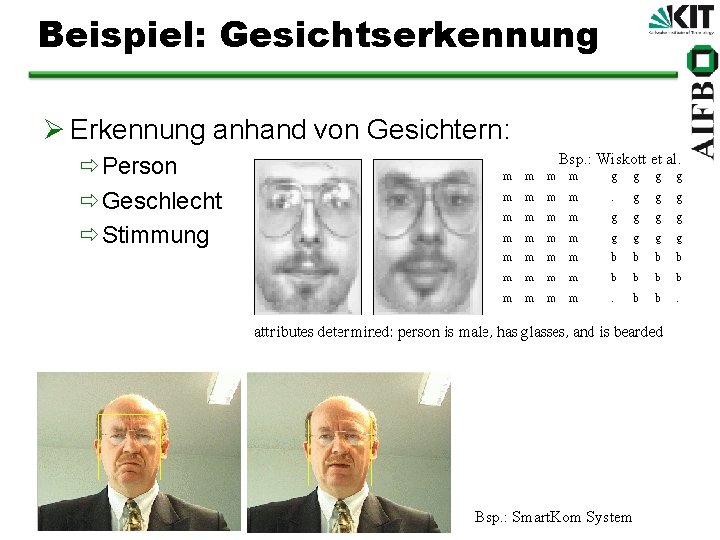
Beispiel: Gesichtserkennung Ø Erkennung anhand von Gesichtern: ðPerson ðGeschlecht ðStimmung Bsp. : Wiskott et al. Bsp. : Smart. Kom System
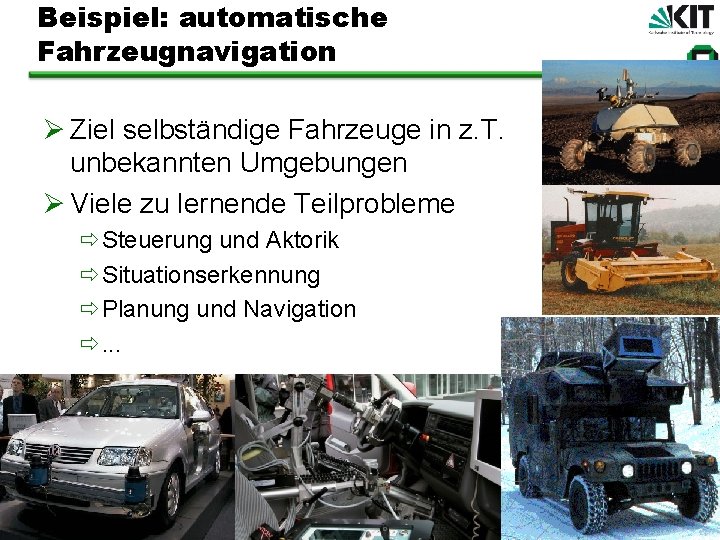
Beispiel: automatische Fahrzeugnavigation Ø Ziel selbständige Fahrzeuge in z. T. unbekannten Umgebungen Ø Viele zu lernende Teilprobleme ðSteuerung und Aktorik ðSituationserkennung ðPlanung und Navigation ð. . .
Beispiel: Spiele Ø Backgammon, Schach, Mühle etc. Ø Gutes „Spielfeld“ für neue Verfahren Ø Typische Domäne von Menschen Ø Beispiel: TD-Gammon nutzt temporal difference (TD) Algorithmen und trainiert, während es mit sich selbst spielt Ø Auf dem Treffen der American Association of Artificial Intelligence wurde 1998 ein Großmeister (der damalige Weltmeister) in 99 von 100 Spielen von einer Maschine besiegt.
Beispiel: Handschriftenerkennung Ø Erkennen von handgeschriebenen Zeichen hat bis 1995 sehr schlecht funktioniert. Ø Künstliche Neuronale Netze haben dies im Apple Newton wesentlich verbessert. “. . . vastly improved hand-writing recognition. . . ” (BYTE May 1996) Ø 2003: Die aktuelle Version von Mac OS besitzt eine integrierte Unterstützung für Stifteingabe, die auf der Schrifterkennung des Newton basiert.
Wozu maschinelles Lernen? Ø Anwendungsfelder: ð Data Mining: Extraktion von Wissen aus Daten ð Selbst-adaptierende Programme/Filter: dynamische Anpassung an Nutzer und Situationen ð Aktionslernen: Robotik, Steuerungen, Unterstützung bei Entscheidungen ð Anwendungen, die schwer programmierbar sind (explizites Modell nicht verfügbar oder zu teuer): Sprachverarbeitung, Fahrzeugsteuerung Ø Besseres Verständnis des menschlichen Lernens und Lehrens ð Kognitionswissenschaften: Theorien des Wissenserwerbs (z. B. durch Übung) ð Technische Umsetzung: in Lernsysteme, Recommender Systeme etc.
Spezifikation von Lernproblemen Ø Lernen = Verbesserung der Leistung eines Systems ð bei einer Aufgabe A, ð in Bezug auf ein Leistungsmaß/eine Zielfunktion Z, ð basierend auf der vorhergehenden Erfahrung E. Ø Beispiel: Schach spielen ð A: spiele Schach und gewinne ð Z: Prozentsatz der gewonnenen Spiele in der ersten Liga ð E: Möglichkeit, gegen sich selbst zu spielen Ø Zu lösende Fragen: ð Wie genau soll die Erfahrung gesammelt werden? ð Was genau soll eigentlich gelernt werden? ð Wie wird das Gelernte repräsentiert? ð Welcher Lernalgorithmus soll angewandt werden?
Beispiel: Schach spielen Ø Typ der Erfahrung im Training ð Vorgegebene Situationen oder selbst erzeugte? ð Bewertung mit oder ohne Lehrer? ð Wissen über das Spiel (z. B. Eröffnungen oder Endspiel)? Ø Problem: Wie repräsentativ ist die Trainingserfahrung in Bezug auf das Lernziel? Ø Auswahl der zu lernenden Funktion V ð Aktionsauswahl V: Brett Zug ð Brettauswertung V: Brett Bewertung ð Optionsvergleich V: Brett x Brett {0, 1} ð Ideale Funktion V, angenäherte Funktion V‘ ð Ziel des Lernprozesses: Annäherung von V‘ an das optimale V
Beispiel: Schach spielen - Zielfunktion Ø Eine Möglichkeit ð αβ-Suche ð Liefert korrekte und optimale Werte, aber praktisch nicht berechenbar, da zu aufwendig. Ø Repräsentation der Zielfunktion ð Sammlung von Regeln? ð Neuronales Netz? ð Polynome (z. B. linear, quadratisch) der Brettmerkmale? ð andere? Ø Beispiel: ð x 1/2 vorhandene weiße/schwarze Steine, x 3/4 bedrohte weiße/schwarze Steine, x 5/6 weiße/schwarze Offiziere
Beispiel: Schach spielen - Lernen Ø Wie kann man trainieren? ð V zu lernende Funktion ð V‘ bisher gelernte Funktion ð (b, Vb) Trainingsbeispiel Ø Möglichkeit, Trainingsbeispiel festzulegen: ð Vb : = V‘(b. Nachfolger) Ø Lernregel ð Methode der kleinsten Quadrate (Least Mean Square, LMS): wiederhole • Zufällige Auswahl einer Brettsituation b mit bekanntem Vb • Fehlerberechnung für die Situation error(b) : = Vb - V‘(b) • Für jedes Feature werden die Gewichte angepaßt: wi : = wi + . xi. error(b) • ist eine kleine Lernrate (konstant)
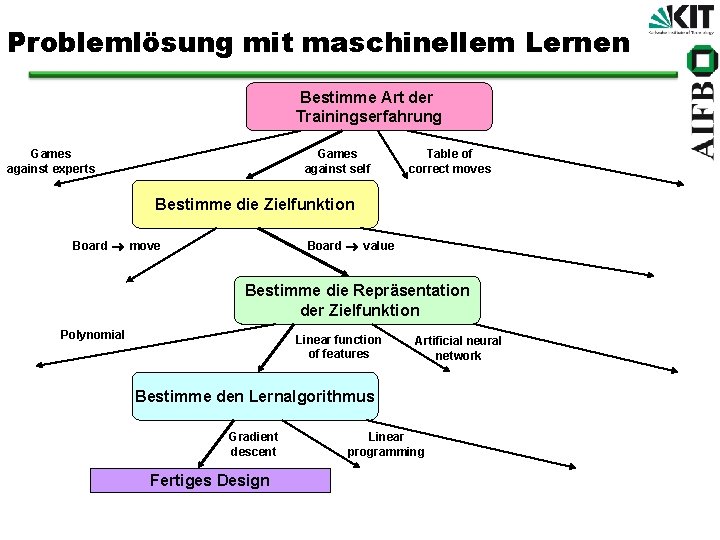
Problemlösung mit maschinellem Lernen Bestimme Art der Trainingserfahrung Games against experts Games against self Table of correct moves Bestimme die Zielfunktion Board move Board value Bestimme die Repräsentation der Zielfunktion Polynomial Linear function of features Artificial neural network Bestimme den Lernalgorithmus Gradient descent Fertiges Design Linear programming
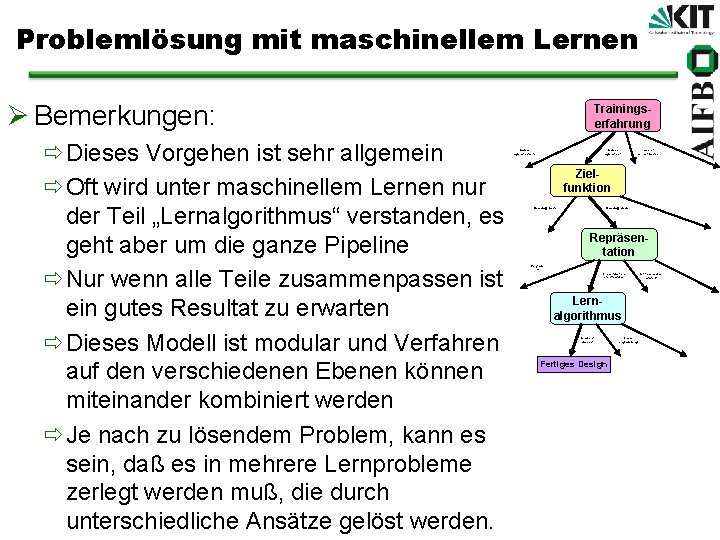
Problemlösung mit maschinellem Lernen Ø Bemerkungen: ðDieses Vorgehen ist sehr allgemein ðOft wird unter maschinellem Lernen nur der Teil „Lernalgorithmus“ verstanden, es geht aber um die ganze Pipeline ðNur wenn alle Teile zusammenpassen ist ein gutes Resultat zu erwarten ðDieses Modell ist modular und Verfahren auf den verschiedenen Ebenen können miteinander kombiniert werden ðJe nach zu lösendem Problem, kann es sein, daß es in mehrere Lernprobleme zerlegt werden muß, die durch unterschiedliche Ansätze gelöst werden. Trainingserfahrung Games against experts Games against self Table of correct moves Zielfunktion Board move Board value Repräsentation Polynomi al Linear function of six features Lernalgorithmus Gradient descent Fertiges Design Linear programming Artificial neural network
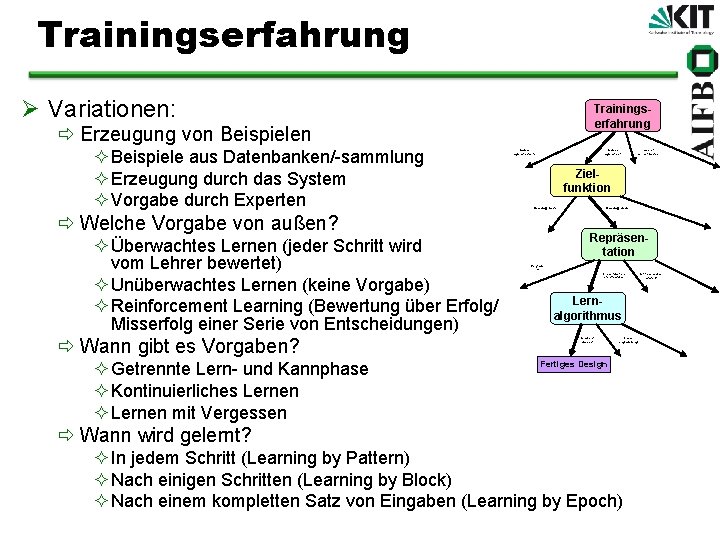
Trainingserfahrung Ø Variationen: Trainingserfahrung ð Erzeugung von Beispielen ² Beispiele aus Datenbanken/-sammlung ² Erzeugung durch das System ² Vorgabe durch Experten Games against experts Games against self Zielfunktion Board move ð Welche Vorgabe von außen? ² Überwachtes Lernen (jeder Schritt wird vom Lehrer bewertet) ² Unüberwachtes Lernen (keine Vorgabe) ² Reinforcement Learning (Bewertung über Erfolg/ Misserfolg einer Serie von Entscheidungen) ð Wann gibt es Vorgaben? ² Getrennte Lern- und Kannphase ² Kontinuierliches Lernen ² Lernen mit Vergessen Table of correct moves Board value Repräsentation Polynomi al Linear function of six features Lernalgorithmus Gradient descent Linear programming Fertiges Design ð Wann wird gelernt? ² In jedem Schritt (Learning by Pattern) ² Nach einigen Schritten (Learning by Block) ² Nach einem kompletten Satz von Eingaben (Learning by Epoch) Artificial neural network
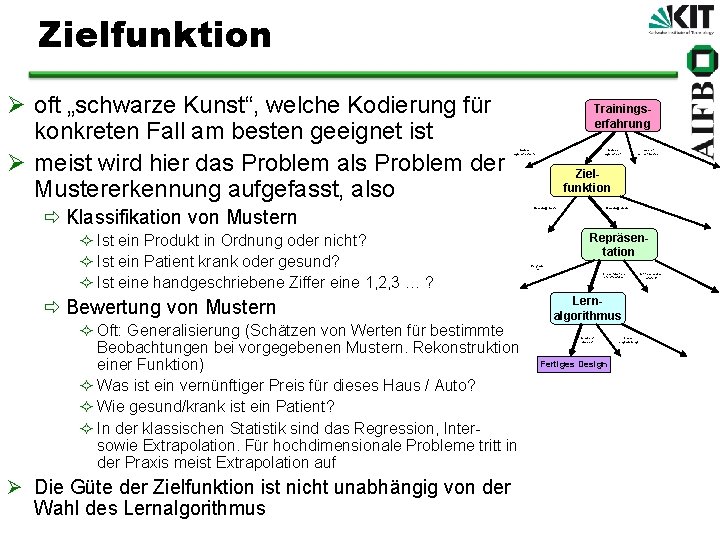
Zielfunktion Ø oft „schwarze Kunst“, welche Kodierung für konkreten Fall am besten geeignet ist Ø meist wird hier das Problem als Problem der Mustererkennung aufgefasst, also Trainingserfahrung Games against experts ð Klassifikation von Mustern ² Ist ein Produkt in Ordnung oder nicht? ² Ist ein Patient krank oder gesund? ² Ist eine handgeschriebene Ziffer eine 1, 2, 3 … ? ð Bewertung von Mustern ² Oft: Generalisierung (Schätzen von Werten für bestimmte Beobachtungen bei vorgegebenen Mustern. Rekonstruktion einer Funktion) ² Was ist ein vernünftiger Preis für dieses Haus / Auto? ² Wie gesund/krank ist ein Patient? ² In der klassischen Statistik sind das Regression, Intersowie Extrapolation. Für hochdimensionale Probleme tritt in der Praxis meist Extrapolation auf Ø Die Güte der Zielfunktion ist nicht unabhängig von der Wahl des Lernalgorithmus Games against self Table of correct moves Zielfunktion Board move Board value Repräsentation Polynomi al Linear function of six features Lernalgorithmus Gradient descent Fertiges Design Linear programming Artificial neural network
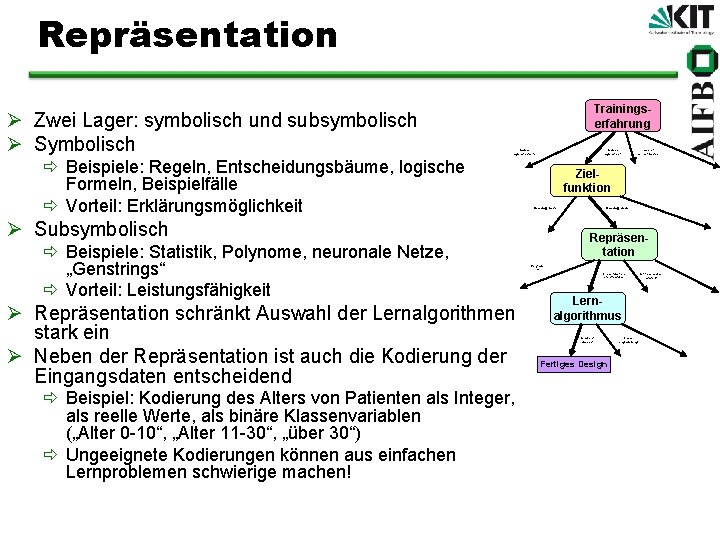
Repräsentation Ø Zwei Lager: symbolisch und subsymbolisch Ø Symbolisch Trainingserfahrung Games against experts ð Beispiele: Regeln, Entscheidungsbäume, logische Formeln, Beispielfälle ð Vorteil: Erklärungsmöglichkeit Games against self Zielfunktion Board move Ø Subsymbolisch ð Beispiele: Statistik, Polynome, neuronale Netze, „Genstrings“ ð Vorteil: Leistungsfähigkeit Ø Repräsentation schränkt Auswahl der Lernalgorithmen stark ein Ø Neben der Repräsentation ist auch die Kodierung der Eingangsdaten entscheidend ð Beispiel: Kodierung des Alters von Patienten als Integer, als reelle Werte, als binäre Klassenvariablen („Alter 0 -10“, „Alter 11 -30“, „über 30“) ð Ungeeignete Kodierungen können aus einfachen Lernproblemen schwierige machen! Table of correct moves Board value Repräsentation Polynomi al Linear function of six features Lernalgorithmus Gradient descent Fertiges Design Linear programming Artificial neural network
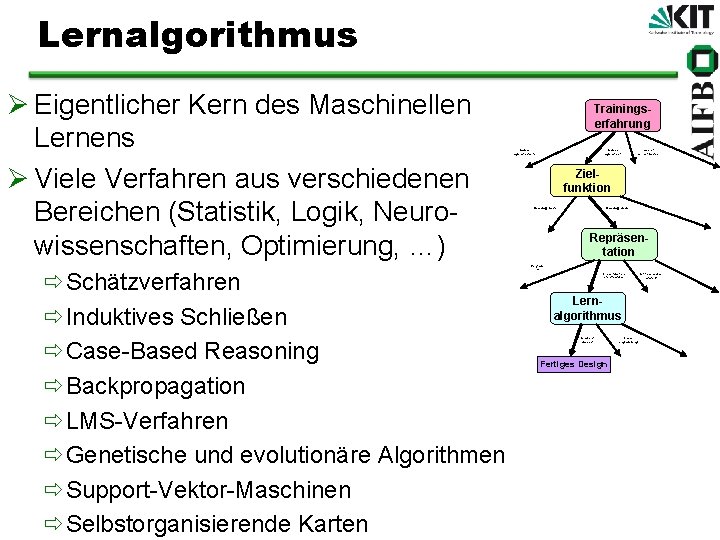
Lernalgorithmus Ø Eigentlicher Kern des Maschinellen Lernens Ø Viele Verfahren aus verschiedenen Bereichen (Statistik, Logik, Neurowissenschaften, Optimierung, …) ðSchätzverfahren ðInduktives Schließen ðCase-Based Reasoning ðBackpropagation ðLMS-Verfahren ðGenetische und evolutionäre Algorithmen ðSupport-Vektor-Maschinen ðSelbstorganisierende Karten Trainingserfahrung Games against experts Games against self Table of correct moves Zielfunktion Board move Board value Repräsentation Polynomi al Linear function of six features Lernalgorithmus Gradient descent Fertiges Design Linear programming Artificial neural network
Herausforderungen beim Maschinellen Lernen Ø Welche Verfahren eignen sich wann, um Funktionen anzunähern? Ø Entscheidungen beim Design einer Lösung. . . ð Anzahl der Beispiele? ð Komplexität des Problems Ø Wie wird die Lösung des Problems durch Umwelt beeinflusst? ð Verrauschte Daten ð Mehrere Datenquellen Ø Ø Was sind die theoretischen Grenzen der Lernbarkeit? Wie kann Vorwissen genutzt werden? Welche Anregungen können wir aus der Natur abschauen? Wie können Systeme selbstständig Repräsentationen finden?
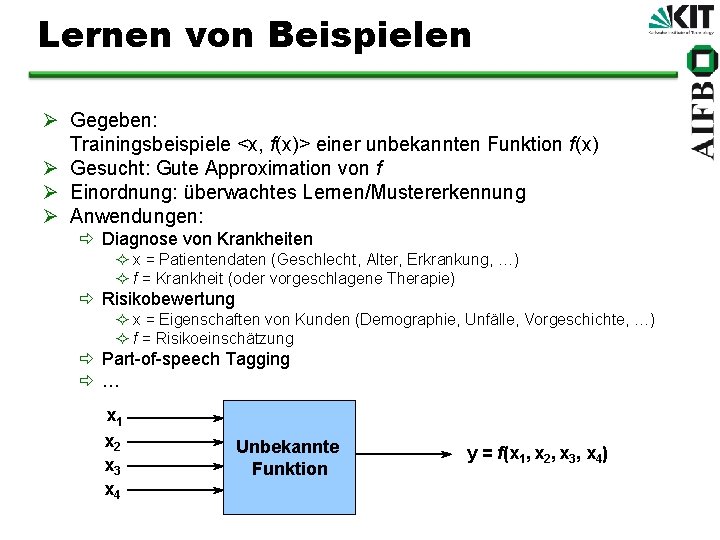
Lernen von Beispielen Ø Gegeben: Trainingsbeispiele <x, f(x)> einer unbekannten Funktion f(x) Ø Gesucht: Gute Approximation von f Ø Einordnung: überwachtes Lernen/Mustererkennung Ø Anwendungen: ð Diagnose von Krankheiten ² x = Patientendaten (Geschlecht, Alter, Erkrankung, …) ² f = Krankheit (oder vorgeschlagene Therapie) ð Risikobewertung ² x = Eigenschaften von Kunden (Demographie, Unfälle, Vorgeschichte, …) ² f = Risikoeinschätzung ð Part-of-speech Tagging ð… x 1 x 2 x 3 x 4 Unbekannte Funktion y = f(x 1, x 2, x 3, x 4)
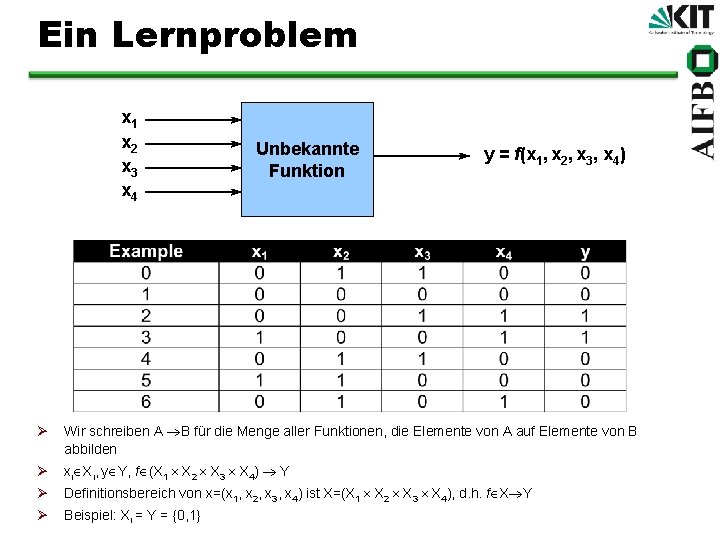
Ein Lernproblem x 1 x 2 x 3 x 4 Unbekannte Funktion y = f(x 1, x 2, x 3, x 4) Ø Wir schreiben A B für die Menge aller Funktionen, die Elemente von A auf Elemente von B abbilden Ø xi Xi, y Y, f (X 1 X 2 X 3 X 4) Y Ø Definitionsbereich von x=(x 1, x 2, x 3, x 4) ist X=(X 1 X 2 X 3 X 4), d. h. f X Y Ø Beispiel: Xi = Y = {0, 1}
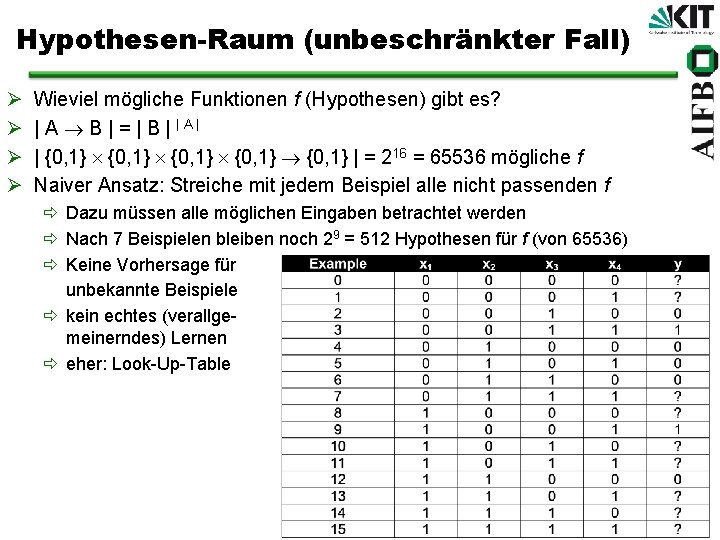
Hypothesen-Raum (unbeschränkter Fall) Ø Ø Wieviel mögliche Funktionen f (Hypothesen) gibt es? | A B | = | B | |A| | {0, 1} {0, 1} | = 216 = 65536 mögliche f Naiver Ansatz: Streiche mit jedem Beispiel alle nicht passenden f ð Dazu müssen alle möglichen Eingaben betrachtet werden ð Nach 7 Beispielen bleiben noch 29 = 512 Hypothesen für f (von 65536) ð Keine Vorhersage für unbekannte Beispiele ð kein echtes (verallgemeinerndes) Lernen ð eher: Look-Up-Table
Begriffslernen Ø Ein Begriff (engl. : concept) bezeichnet eine Menge von Entitäten mit gemeinsamen Eigenschaften. Ø Beim Begriffslernen (concept learning) enthält der Wertebereich der zu lernenden Funktion f nur die Werte 1 (wahr, gehört zum Begriff) und 0 (falsch, gehört nicht zum Begriff).
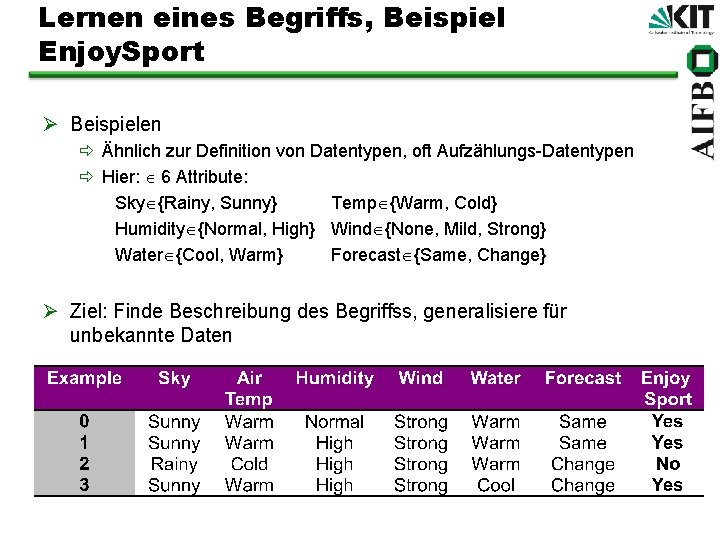
Lernen eines Begriffs, Beispiel Enjoy. Sport Ø Beispielen ð Ähnlich zur Definition von Datentypen, oft Aufzählungs-Datentypen ð Hier: 6 Attribute: Sky {Rainy, Sunny} Temp {Warm, Cold} Humidity {Normal, High} Wind {None, Mild, Strong} Water {Cool, Warm} Forecast {Same, Change} Ø Ziel: Finde Beschreibung des Begriffss, generalisiere für unbekannte Daten
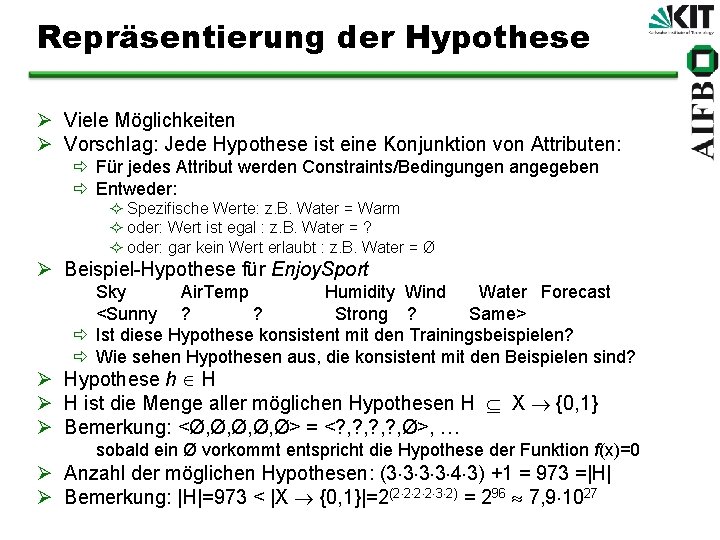
Repräsentierung der Hypothese Ø Viele Möglichkeiten Ø Vorschlag: Jede Hypothese ist eine Konjunktion von Attributen: ð Für jedes Attribut werden Constraints/Bedingungen angegeben ð Entweder: ² Spezifische Werte: z. B. Water = Warm ² oder: Wert ist egal : z. B. Water = ? ² oder: gar kein Wert erlaubt : z. B. Water = Ø Ø Beispiel-Hypothese für Enjoy. Sport Sky Air. Temp Humidity Wind Water Forecast <Sunny ? ? Strong ? Same> ð Ist diese Hypothese konsistent mit den Trainingsbeispielen? ð Wie sehen Hypothesen aus, die konsistent mit den Beispielen sind? Ø Hypothese h H Ø H ist die Menge aller möglichen Hypothesen H X {0, 1} Ø Bemerkung: <Ø, Ø, Ø> = <? , ? , Ø>, … sobald ein Ø vorkommt entspricht die Hypothese der Funktion f(x)=0 Ø Anzahl der möglichen Hypothesen: (3 3 4 3) +1 = 973 =|H| Ø Bemerkung: |H|=973 < |X {0, 1}|=2(2 2 3 2) = 296 7, 9 1027
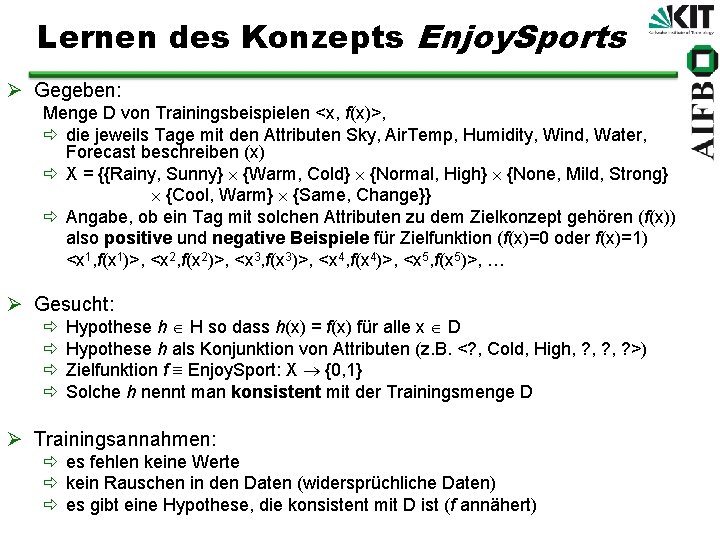
Lernen des Konzepts Enjoy. Sports Ø Gegeben: Menge D von Trainingsbeispielen <x, f(x)>, ð die jeweils Tage mit den Attributen Sky, Air. Temp, Humidity, Wind, Water, Forecast beschreiben (x) ð X = {{Rainy, Sunny} {Warm, Cold} {Normal, High} {None, Mild, Strong} {Cool, Warm} {Same, Change}} ð Angabe, ob ein Tag mit solchen Attributen zu dem Zielkonzept gehören (f(x)) also positive und negative Beispiele für Zielfunktion (f(x)=0 oder f(x)=1) <x 1, f(x 1)>, <x 2, f(x 2)>, <x 3, f(x 3)>, <x 4, f(x 4)>, <x 5, f(x 5)>, … Ø Gesucht: ð ð Hypothese h H so dass h(x) = f(x) für alle x D Hypothese h als Konjunktion von Attributen (z. B. <? , Cold, High, ? , ? >) Zielfunktion f Enjoy. Sport: X {0, 1} Solche h nennt man konsistent mit der Trainingsmenge D Ø Trainingsannahmen: ð es fehlen keine Werte ð kein Rauschen in den Daten (widersprüchliche Daten) ð es gibt eine Hypothese, die konsistent mit D ist (f annähert)
Grundidee des induktiven Lernens Ø Induktion vs. Deduktion ð Deduktion: aus gegebenen Fakten neue Fakten ableiten (Beweis) ² Gegeben: A B, B C, Folgerung: A C ² “Vom Allgemeinen zum Speziellen” ð Induktion: aus gegebenen Fakten neue Fakten mutmaßen (Hypothese) ² Gegeben: Fliegt(Amsel), Fliegt(Storch), Folgerung: Fliegt(Vogel) ² “Vom Speziellen zum Allgemeinen” Ø Idee des induktiven Lernens: ð Lerne eine Funktion aus Beispielen Ø Annahme beim induktiven Lernen ð Eine Hypothese, die für eine hinreichend große Beispielmenge die Zielfunktion gut annähert, wird die Funktion auch gut für unbekannte Beispiele annähern. Ø Aber zunächst: Wie kann ein Lernverfahren konkret aussehen?
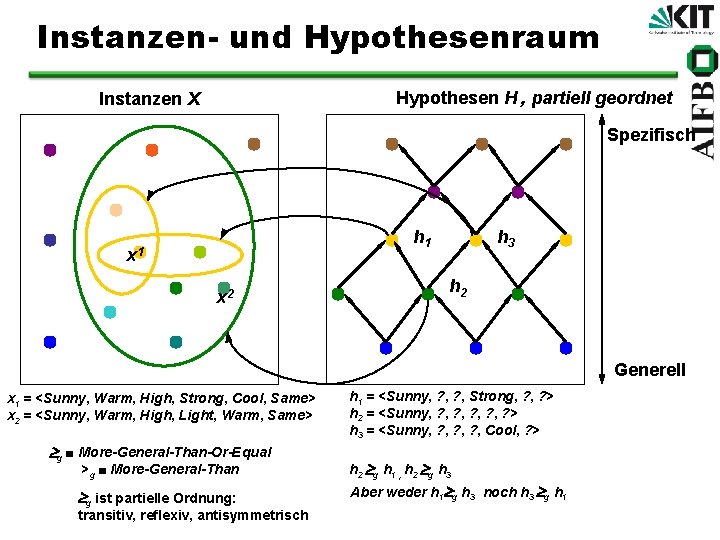
Instanzen- und Hypothesenraum Hypothesen H , partiell geordnet Instanzen X Spezifisch h 1 x 2 h 3 h 2 Generell x 1 = <Sunny, Warm, High, Strong, Cool, Same> x 2 = <Sunny, Warm, High, Light, Warm, Same> g More-General-Than-Or-Equal h 1 = <Sunny, ? , Strong, ? > h 2 = <Sunny, ? , ? , ? > h 3 = <Sunny, ? , ? , Cool, ? > >g More-General-Than h 2 g h 1 , h 2 g h 3 g ist partielle Ordnung: Aber weder h 1 g h 3 noch h 3 g h 1 transitiv, reflexiv, antisymmetrisch
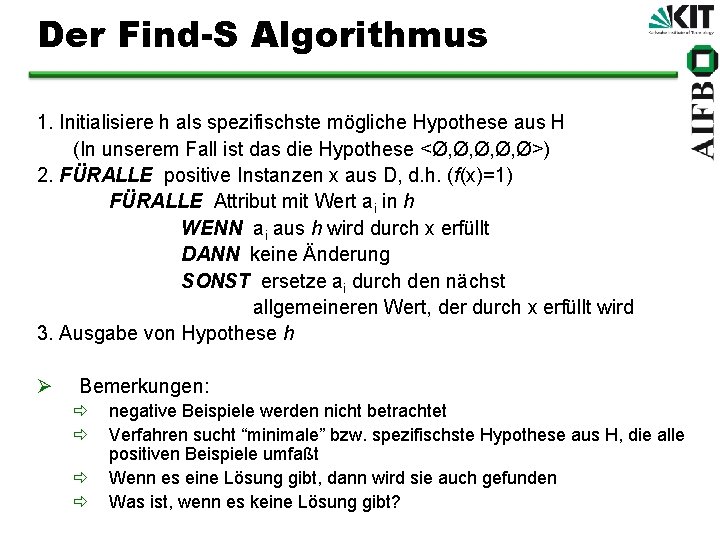
Der Find-S Algorithmus 1. Initialisiere h als spezifischste mögliche Hypothese aus H (In unserem Fall ist das die Hypothese <Ø, Ø, Ø>) 2. FÜRALLE positive Instanzen x aus D, d. h. (f(x)=1) FÜRALLE Attribut mit Wert ai in h WENN ai aus h wird durch x erfüllt DANN keine Änderung SONST ersetze ai durch den nächst allgemeineren Wert, der durch x erfüllt wird 3. Ausgabe von Hypothese h Ø Bemerkungen: ð ð negative Beispiele werden nicht betrachtet Verfahren sucht “minimale” bzw. spezifischste Hypothese aus H, die alle positiven Beispiele umfaßt Wenn es eine Lösung gibt, dann wird sie auch gefunden Was ist, wenn es keine Lösung gibt?
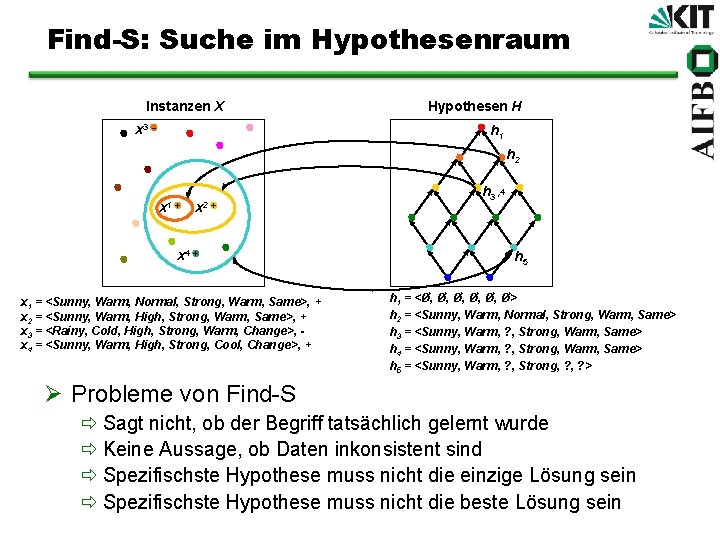
Find-S: Suche im Hypothesenraum Instanzen X x 3 - Hypothesen H h 1 h 2 x 1 + x 2 + x 4 + x 1 = <Sunny, Warm, Normal, Strong, Warm, Same>, + x 2 = <Sunny, Warm, High, Strong, Warm, Same>, + x 3 = <Rainy, Cold, High, Strong, Warm, Change>, x 4 = <Sunny, Warm, High, Strong, Cool, Change>, + h 3 , 4 h 5 h 1 = <Ø, Ø, Ø, Ø> h 2 = <Sunny, Warm, Normal, Strong, Warm, Same> h 3 = <Sunny, Warm, ? , Strong, Warm, Same> h 4 = <Sunny, Warm, ? , Strong, Warm, Same> h 5 = <Sunny, Warm, ? , Strong, ? > Ø Probleme von Find-S ð Sagt nicht, ob der Begriff tatsächlich gelernt wurde ð Keine Aussage, ob Daten inkonsistent sind ð Spezifischste Hypothese muss nicht die einzige Lösung sein ð Spezifischste Hypothese muss nicht die beste Lösung sein
Versionsraum Ø Definition: konsistente Hypothesen ð Eine Hypothese h ist konsistent mit einer Menge von Trainingsdaten D eines Zielkbegriffs f genau dann wenn h(x) = f(x) für alle Beispiele <x, f(x)> aus D gilt ð konsistent(h, D) : <x, f(x)> D: h(x) = f(x) Ø Definition: Versionsraum ð Der Versionsraum VSH, D, zu einem Hypothesenraum H und Trainingsbeispielen D ist die Teilmenge der Hypothesen aus H, die konsistent mit allen Trainingsdaten aus D sind ð VSH, D : { h H | konsistent(h, D) } Ø Bemerkung: ð Wenn wir nicht nur an einer gültigen Lösung interessiert sind, dann ist der Versionsraum interessant.
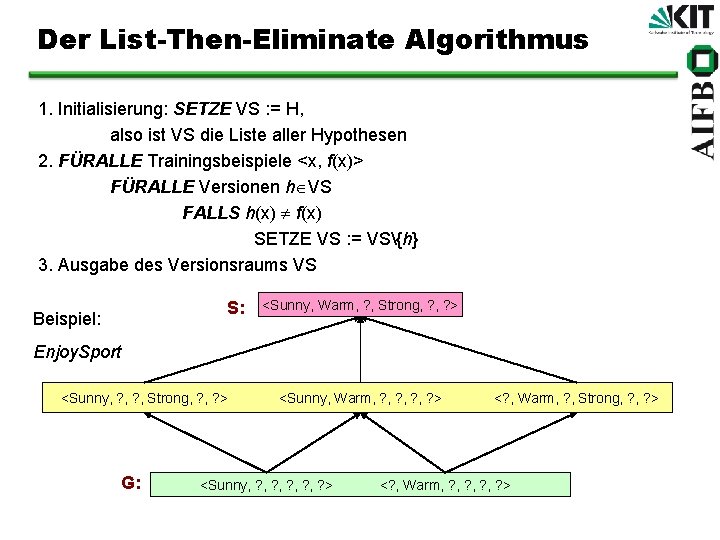
Der List-Then-Eliminate Algorithmus 1. Initialisierung: SETZE VS : = H, also ist VS die Liste aller Hypothesen 2. FÜRALLE Trainingsbeispiele <x, f(x)> FÜRALLE Versionen h VS FALLS h(x) f(x) SETZE VS : = VS{h} 3. Ausgabe des Versionsraums VS S: Beispiel: <Sunny, Warm, ? , Strong, ? > Enjoy. Sport <Sunny, ? , Strong, ? > G: <Sunny, Warm, ? , ? > <Sunny, ? , ? , ? > <? , Warm, ? , Strong, ? > <? , Warm, ? , ? >
Repräsentierung des Versionsraumes Ø Bemerkung zum Versionsraum ð Offensichtlich gibt es am meisten spezifische und am meisten generelle Versionen ð Jede Hypothese, die “dazwischen” liegt, muss auch eine Lösung sein Ø Definition: Generelle Schranke ð Die generelle Schranke G des Versionsraumes VSH, D ist die Menge der generellsten Hypothesen ð G= {g H| konsistent(g, D) und h H: (h >g g konsistent(h, D))} ð Das heißt, jedes h, das mehr Elemente zum Begriff dazunimmt als ein g, nimmt auch Fehler auf Ø Definition: Spezifische Schranke ð Die spezifische Schranke S des Versionsraumes VSH, D ist die Menge der spezifischsten Hypothesen ð G= {g H| konsistent(g, D) und h H: (g >g h konsistent(h, D))} ð Das heißt, jedes h, das weniger Elemente im Begriff hat als ein g, dem fehlen gültige Beispiele

Versionsraum-Theorem Ø Versionsraumtheorem ð Jede Hypothese des Versionsraums liegt zwischen S und G ð VSH, D = { h H | s S: g G: g gh gs } Ø Bemerkung ð Beweis: Übung und/oder bei Mitchell nachschauen ð Hinweis: ² Zeige erst: Wenn g, s VSH, D und g gh gs, dann ist auch h VSH, D ² Zeige dann: Wenn h VSH, D, dann gibt es ein g G, mit g gh • Beweisidee: – Aus Definition von G folgt: Es gilt entweder h G oder es gibt ein h‘>gh, h‘ VSH, D – Dann kann man das gleiche mit h‘ fortführen. – Da H endlich ist, muß man irgendwann an ein h“ kommen mit h“ G ² Und analog: Wenn h VSH, D, dann gibt es ein s S, mit h gs
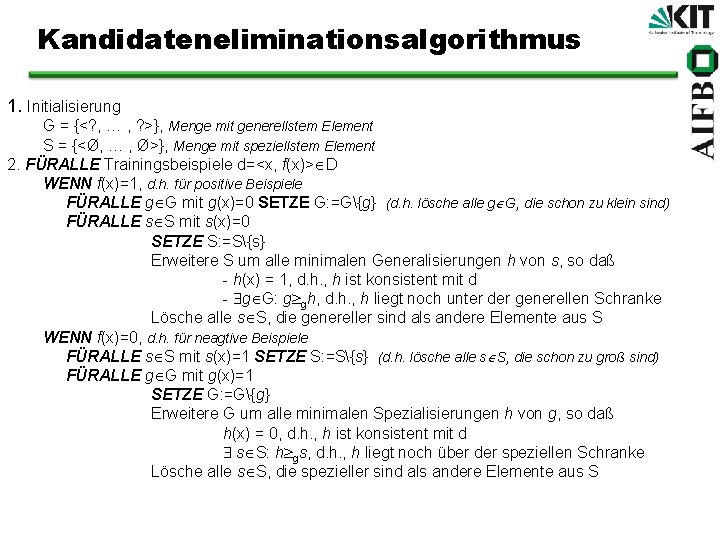
Kandidateneliminationsalgorithmus 1. Initialisierung G = {<? , … , ? >}, Menge mit generellstem Element S = {<Ø, … , Ø>}, Menge mit speziellstem Element 2. FÜRALLE Trainingsbeispiele d=<x, f(x)> D WENN f(x)=1, d. h. für positive Beispiele FÜRALLE g G mit g(x)=0 SETZE G: =G{g} (d. h. lösche alle g G, die schon zu klein sind) FÜRALLE s S mit s(x)=0 SETZE S: =S{s} Erweitere S um alle minimalen Generalisierungen h von s, so daß - h(x) = 1, d. h. , h ist konsistent mit d - g G: g gh, d. h. , h liegt noch unter der generellen Schranke Lösche alle s S, die genereller sind als andere Elemente aus S WENN f(x)=0, d. h. für neagtive Beispiele FÜRALLE s S mit s(x)=1 SETZE S: =S{s} (d. h. lösche alle s S, die schon zu groß sind) FÜRALLE g G mit g(x)=1 SETZE G: =G{g} Erweitere G um alle minimalen Spezialisierungen h von g, so daß h(x) = 0, d. h. , h ist konsistent mit d s S: h gs, d. h. , h liegt noch über der speziellen Schranke Lösche alle s S, die spezieller sind als andere Elemente aus S
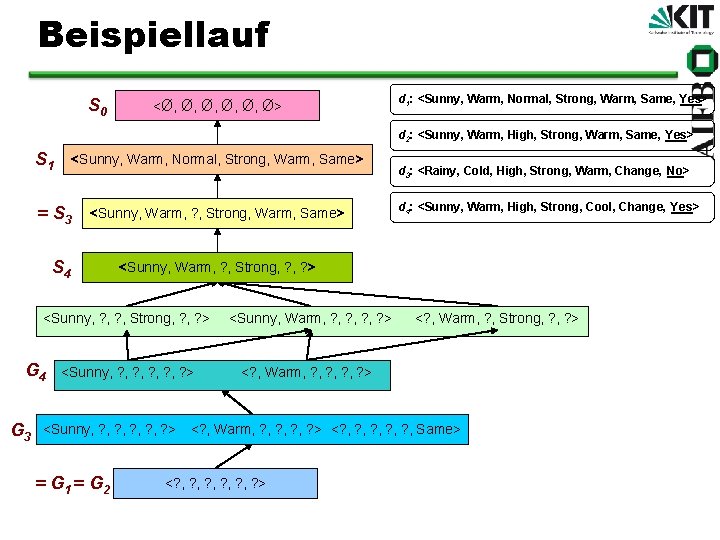
Beispiellauf S 0 <Ø, Ø, Ø, Ø> d 1: <Sunny, Warm, Normal, Strong, Warm, Same, Yes> d 2: <Sunny, Warm, High, Strong, Warm, Same, Yes> S 1 <Sunny, Warm, Normal, Strong, Warm, Same> = S 3 <Sunny, Warm, ? , Strong, Warm, Same> S 4 G 3 <Sunny, ? , ? , ? > = G 1 = G 2 d 4: <Sunny, Warm, High, Strong, Cool, Change, Yes> <Sunny, Warm, ? , Strong, ? > <Sunny, ? , Strong, ? > G 4 d 3: <Rainy, Cold, High, Strong, Warm, Change, No> <Sunny, Warm, ? , ? > <? , Warm, ? , Strong, ? , ? > <? , Warm, ? , ? , ? > <? , ? , ? , Same> <? , ? , ? , ? >
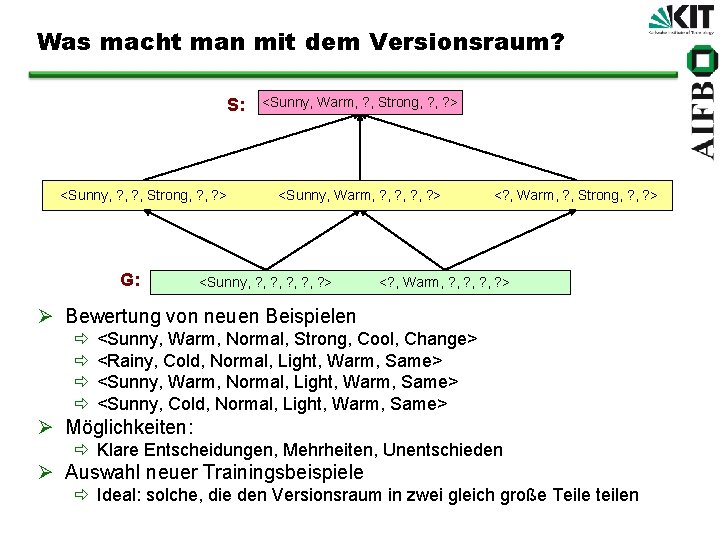
Was macht man mit dem Versionsraum? S: <Sunny, ? , Strong, ? > G: <Sunny, Warm, ? , Strong, ? > <Sunny, Warm, ? , ? > <Sunny, ? , ? , ? > <? , Warm, ? , Strong, ? > <? , Warm, ? , ? > Ø Bewertung von neuen Beispielen ð ð <Sunny, Warm, Normal, Strong, Cool, Change> <Rainy, Cold, Normal, Light, Warm, Same> <Sunny, Warm, Normal, Light, Warm, Same> <Sunny, Cold, Normal, Light, Warm, Same> Ø Möglichkeiten: ð Klare Entscheidungen, Mehrheiten, Unentschieden Ø Auswahl neuer Trainingsbeispiele ð Ideal: solche, die den Versionsraum in zwei gleich große Teile teilen
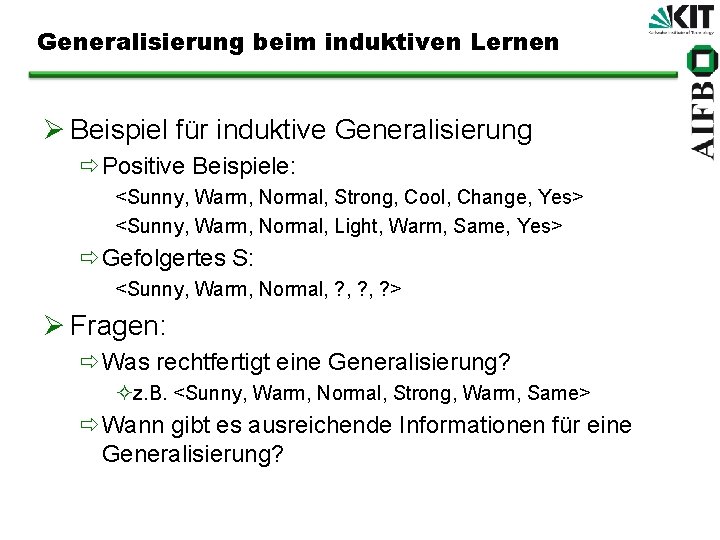
Generalisierung beim induktiven Lernen Ø Beispiel für induktive Generalisierung ðPositive Beispiele: <Sunny, Warm, Normal, Strong, Cool, Change, Yes> <Sunny, Warm, Normal, Light, Warm, Same, Yes> ðGefolgertes S: <Sunny, Warm, Normal, ? , ? > Ø Fragen: ðWas rechtfertigt eine Generalisierung? ²z. B. <Sunny, Warm, Normal, Strong, Warm, Same> ðWann gibt es ausreichende Informationen für eine Generalisierung?
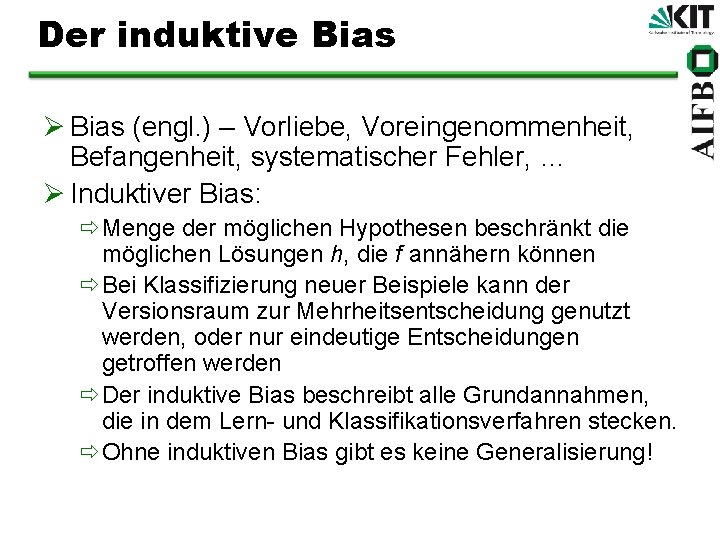
Der induktive Bias Ø Bias (engl. ) – Vorliebe, Voreingenommenheit, Befangenheit, systematischer Fehler, … Ø Induktiver Bias: ðMenge der möglichen Hypothesen beschränkt die möglichen Lösungen h, die f annähern können ðBei Klassifizierung neuer Beispiele kann der Versionsraum zur Mehrheitsentscheidung genutzt werden, oder nur eindeutige Entscheidungen getroffen werden ðDer induktive Bias beschreibt alle Grundannahmen, die in dem Lern- und Klassifikationsverfahren stecken. ðOhne induktiven Bias gibt es keine Generalisierung!
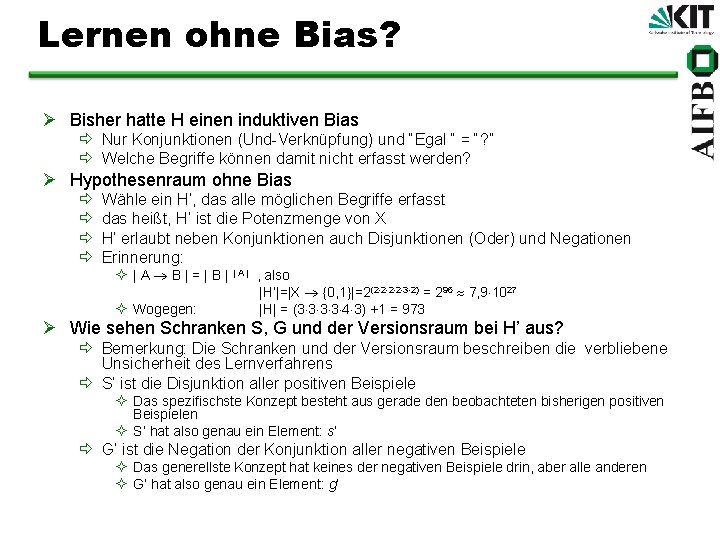
Lernen ohne Bias? Ø Bisher hatte H einen induktiven Bias ð Nur Konjunktionen (Und-Verknüpfung) und “Egal “ = “? ” ð Welche Begriffe können damit nicht erfasst werden? Ø Hypothesenraum ohne Bias ð ð Wähle ein H’, das alle möglichen Begriffe erfasst das heißt, H’ ist die Potenzmenge von X H’ erlaubt neben Konjunktionen auch Disjunktionen (Oder) und Negationen Erinnerung: ² | A B | = | B | | A | , also |H‘|=|X {0, 1}|=2(2 2 3 2) = 296 7, 9 1027 ² Wogegen: |H| = (3 3 4 3) +1 = 973 Ø Wie sehen Schranken S, G und der Versionsraum bei H’ aus? ð Bemerkung: Die Schranken und der Versionsraum beschreiben die verbliebene Unsicherheit des Lernverfahrens ð S’ ist die Disjunktion aller positiven Beispiele ² Das spezifischste Konzept besteht aus gerade den beobachteten bisherigen positiven Beispielen ² S’ hat also genau ein Element: s’ ð G’ ist die Negation der Konjunktion aller negativen Beispiele ² Das generellste Konzept hat keines der negativen Beispiele drin, aber alle anderen ² G’ hat also genau ein Element: g’
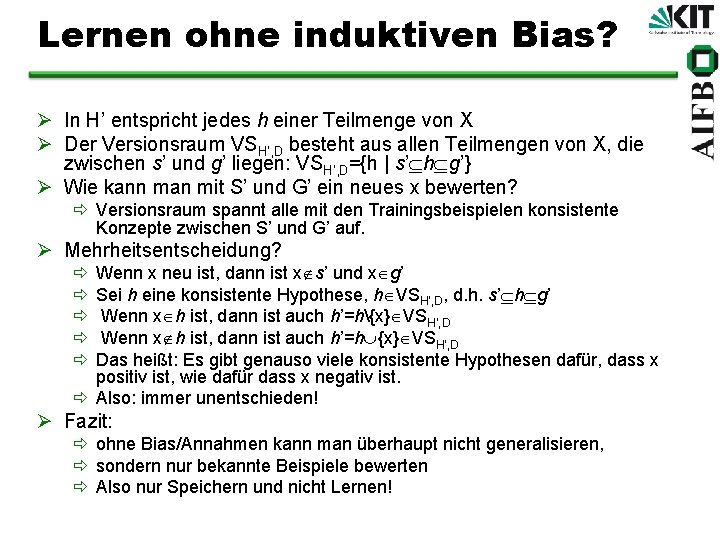
Lernen ohne induktiven Bias? Ø In H’ entspricht jedes h einer Teilmenge von X Ø Der Versionsraum VSH‘, D besteht aus allen Teilmengen von X, die zwischen s’ und g’ liegen: VSH‘, D={h | s’ h g’} Ø Wie kann man mit S’ und G’ ein neues x bewerten? ð Versionsraum spannt alle mit den Trainingsbeispielen konsistente Konzepte zwischen S’ und G’ auf. Ø Mehrheitsentscheidung? ð ð ð Wenn x neu ist, dann ist x s’ und x g’ Sei h eine konsistente Hypothese, h VSH‘, D, d. h. s’ h g’ Wenn x h ist, dann ist auch h’=h{x} VSH‘, D Wenn x h ist, dann ist auch h’=h {x} VSH‘, D Das heißt: Es gibt genauso viele konsistente Hypothesen dafür, dass x positiv ist, wie dafür dass x negativ ist. ð Also: immer unentschieden! Ø Fazit: ð ohne Bias/Annahmen kann man überhaupt nicht generalisieren, ð sondern nur bekannte Beispiele bewerten ð Also nur Speichern und nicht Lernen!
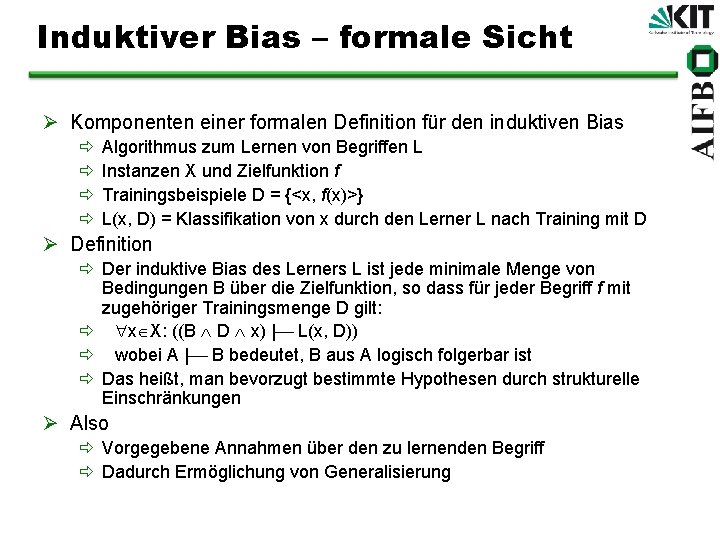
Induktiver Bias – formale Sicht Ø Komponenten einer formalen Definition für den induktiven Bias ð ð Algorithmus zum Lernen von Begriffen L Instanzen X und Zielfunktion f Trainingsbeispiele D = {<x, f(x)>} L(x, D) = Klassifikation von x durch den Lerner L nach Training mit D Ø Definition ð Der induktive Bias des Lerners L ist jede minimale Menge von Bedingungen B über die Zielfunktion, so dass für jeder Begriff f mit zugehöriger Trainingsmenge D gilt: ð x X: ((B D x) | L(x, D)) ð wobei A | B bedeutet, B aus A logisch folgerbar ist ð Das heißt, man bevorzugt bestimmte Hypothesen durch strukturelle Einschränkungen Ø Also ð Vorgegebene Annahmen über den zu lernenden Begriff ð Dadurch Ermöglichung von Generalisierung
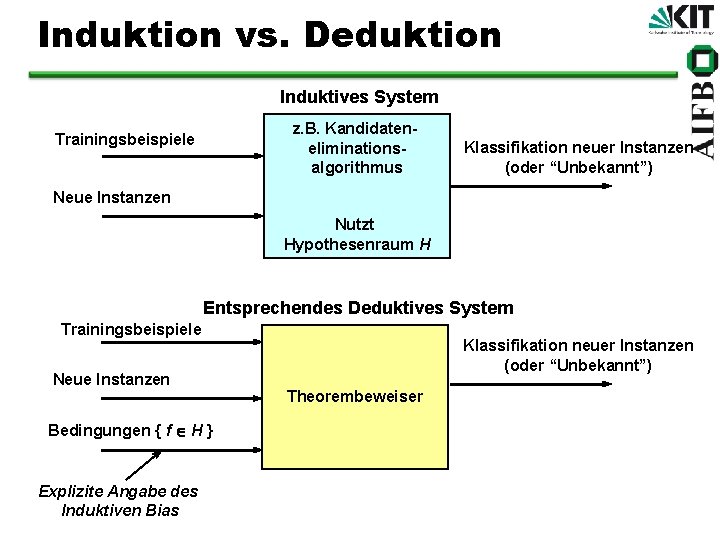
Induktion vs. Deduktion Induktives System z. B. Kandidateneliminationsalgorithmus Trainingsbeispiele Klassifikation neuer Instanzen (oder “Unbekannt”) Neue Instanzen Nutzt Hypothesenraum H Entsprechendes Deduktives System Trainingsbeispiele Neue Instanzen Bedingungen { f H } Explizite Angabe des Induktiven Bias Klassifikation neuer Instanzen (oder “Unbekannt”) Theorembeweiser
Lerner mit unterschiedlichem Bias Ø Lerner ohne Bias, “Auswendiglernen” ð Nur Klassifizierung von vorher Gesehenem ð Speichert Beispiele ð Kann nur solche x klassifizieren, die schon gesehen wurden Ø Versionsraum und Kandidateneliminationsalgorithmus ð Stärkerer Bias: Konzepte lassen sich als h aus H beschreiben ð Speichert Schranken für Generalisierungen und Spezialisierungen ð Klassifikation von x genau dann, wenn es im Versionsraum liegt und alle Versionen in der Bewertung übereinstimmen Ø Kandidateneliminationsalgorithmus mit Mehrheitsentscheidung ð Noch stärkerer Bias: Konzepte lassen sich als h aus H beschreiben Mehrheit der Konzepte in H wird recht haben ð Klassifikation von x, wenn es eine mehrheitliche Klassifikation der Versionen gibt (z. B. mehr als 70%) ð Hier sind implizit statistische Annahmen vorhanden, wie repräsentativ die Trainingsbeispiele sind Ø Find-S ð Noch stärkerer Bias: die spezifischste Hypothese gilt ð Implizite Annahme: alle noch nicht bekannten Beispiele sind negativ ð Klassifiziert x anhand von S
Zusammenfassung einiger Begriffe Ø Überwachtes Lernen ð Begriff - teilt X in zugehörige und nicht zugehörige (also +/-) Beispiele ð Zielfunktion – die Funktion f(x) die jeder Eingabe eine Bewertung zuordnet (z. B. Konzeptzugehörigkeit) ð Hypothese – Vorschlag für eine Funktion, die mutmaßlich ähnlich zu f ist ð Hypothesenraum – Menge aller möglichen Hypothesen, die das Lernsystem erlaubt ð Trainingsbeispiele – Paare der Form <x, f(x)> ð Klassifikation – Funktionen mit diskreten Werten, die Klassen bezeichnen Ø Versionsraum-Algorithmen ð Algorithmen: Find-S, List-Then-Eliminate, Kandidatenelimination ð Konsistente Hypothesen – solche, die zu allen beobachteten Beispielen passen ð Versionsraum – Menge aller aktuell konsistenten Hypothesen Ø Induktives Lernen ð Induktive Generalisierung – Verfahren, welches Hypothesen generiert, die auch Fälle bewerten, die noch nicht bekannt sind Ø Annahmen beim induktiven Lernen ð Keine widersprüchlichen Daten, kein Rauschen, keine Fehler ð Es gibt ein h im Hypothesenraum, das f ausreichend annähhert
Zusammenfassung Ø Konzeptlernen ist eine Suche in H ð Hypothesenraum H ist der Suchraum ð Lernen entspricht Suchen und Finden der richtigen Hypothese Ø Hypothesenraum kann geordnet werden (generell-spezifisch) ð Die more-general-than Relation ist eine partielle Ordnung ð H hat eine obere und untere Schranke Ø Versionsraum und Kandidateneliminationsalgorithmus ð S und G Schranken beschreiben die Unsicherheit der Lerners ð Versionsraum kann genutzt werden, um Vorhersagen für neue Beispiele zu machen Ø Verfahren kann genutzt werden, um Beispiele auszuwählen Ø Jedes Beispiel muss nur einmal gezeigt werden Ø Induktiver Bias ð induktiver Ansatz vs. deduktiver Ansatz ð Begriff des induktiven Bias ð Lernen mit unterschiedlich hohem Bias
Literatur Ø Machine Learning, Tom Mitchell, Mc. Graw Hill, 1997 Ø "Neural Networks - A Systematic Introduction", Raul Rojas, Springer-Verlag, Berlin, 1996. Ø "Theorie der neuronalen Netze", Raul Rojas, Springer-Verlag, Berlin, 1993/99. Ø. . .
Weitere Lernverfahren Ø Symbolisch ðEntscheidungsbäume ðFallbasiertes Schließen (CBR) ð. . . Ø Subsymbolisch ðNeuronale Netze ðSupport Vector Machines ðGenetische Algorithmen ð…
- Slides: 47