
Strojov peklad s vyuitm zvislostn syntaxe Zdenk abokrtsk
Strojový překlad s využitím závislostní syntaxe Zdeněk Žabokrtský Ústav formální a aplikované lingvistiky, MFF UK 1/29
Osnova Část 1: Treex – víceúčelový systém pro NLP Část 2: tektogramatický překlad v Treexu FI MUNI, 18. května 2011 2/29
Motivace 1 – společná platforma předchozí zkušenost (léto 2005): sice existuje řada softwarových nástrojů pro zpracování jazyka, ale propojit je do komplexnější aplikace je nesmírně pracné důvody nejrůznější způsoby komunikace (co nástroj, to nový souborový formát nebo protokol… nekonečné konverze) problémy s instalací a platformovou přenositelností problémy s daty/modely nejasné, neexistující, nebo příliš restriktivní licence nekompatibilní nebo těžko převoditelné podkladové lingvistické teorie… důsledky: komplexnější aplikace se podaří sestavit jen zřídka řada nástrojů zůstává ve stavu laboratorních prototypů, použitých pouze pro dílčí experiment FI MUNI, 18. května 2011 3/29
Motivace 2 – strojový překlad hypotéza: tektogramatická rovina jazykového popisu abstrahuje od řady jazykově specifických „strategií“ jazyky jsou si z pohledu tektogramatiky podobnější tektogramatika by mohla usnadnit strojový překlad nedokážeme dokázat/vyvrátit formálně, nezbývá než zkusit to naimplementovat velice komplexní úloha, zvládnutelná pouze v kvalitním softwarovém rámci strojový překlad jako pilotní aplikace FI MUNI, 18. května 2011 4/29
Výchozí rozhodnutí (1) žádná omezení na ose pravidla vs. statistika nepředstíráme „theory neutrality” - lingvistická reprezentace ve stylu Pražského závislostního treebanku (PDT) morfologická, povrchově syntaktické a hloubkově syntaktická rovina plus složková rovina (phrase structure, constituency) využití technologií vzniklých okolo PDT editor stromů Tr. Ed XML schémata pro lingvistická data již existující taggery, parsery… FI MUNI, 18. května 2011 5/29
Výchozí rozhodnutí (2) Linux Perl jako hlavní jazyk „wrappery“ v Perlu pro nástroje implementované v jiných jazycích extrémní důraz na modularitu znovupoužitelnost zaměnitelnost podpora distribuovaného zpracování podpora zpracování vícejazyčných dat FI MUNI, 18. května 2011 6/29
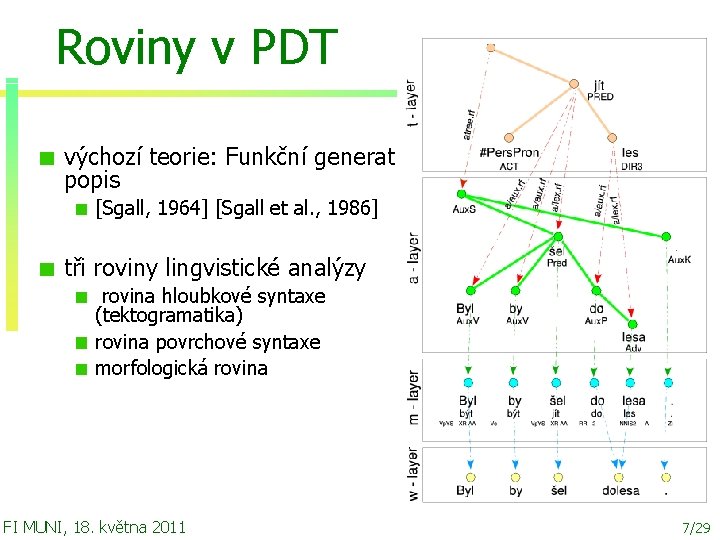
Roviny v PDT výchozí teorie: Funkční generativní popis [Sgall, 1964] [Sgall et al. , 1986] tři roviny lingvistické analýzy rovina hloubkové syntaxe (tektogramatika) rovina povrchové syntaxe morfologická rovina FI MUNI, 18. května 2011 7/29
Adaptace rovin PDT úpravy vyplývající z praktických zkušeností s využíváním dat většinou monotónní rozšíření na t-rovině přidaný atribut formeme zkrácený zápis morfosyntaktické formy, např. n: 2, n: k+3, v: že+vfin, v: rc, adj: attr nové atributy pro práci s klauzemi, pojmenovanými entitami, slovesným rodem… drobná změna v koordinacích na a-rovině přesun is_member na předložku radikálnější změny: sloučení všech rovin do jednoho souboru sloučení m-roviny a a-roviny do jediného stromu FI MUNI, 18. května 2011 8/29
Struktura Treexu vrstvy zdrojového kódu („cibule“): souborová reprezentace (Treex: : PML) serializace do / čtení z Prague Markup Language (XML) jádro (Treex: : Core) moduly pro přístup k datům v paměti (API) hlavní spouštěcí kód, paralelizace XML schémata … bloky (Treex: : Block) základní výkonné jednotky další perlové nástroje nebo wrappery k neperlovým nástrojům (Treex: : Tools) data natrénované pravděpodobnostní modely… FI MUNI, 18. května 2011 9/29
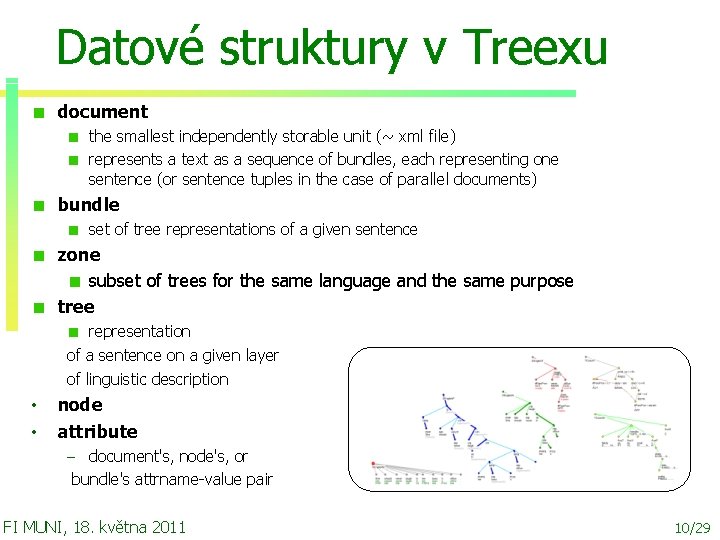
Datové struktury v Treexu document the smallest independently storable unit (~ xml file) represents a text as a sequence of bundles, each representing one sentence (or sentence tuples in the case of parallel documents) bundle set of tree representations of a given sentence zone subset of trees for the same language and the same purpose tree representation of a sentence on a given layer of linguistic description • • node attribute – document's, node's, or bundle's attrname-value pair FI MUNI, 18. května 2011 10/29
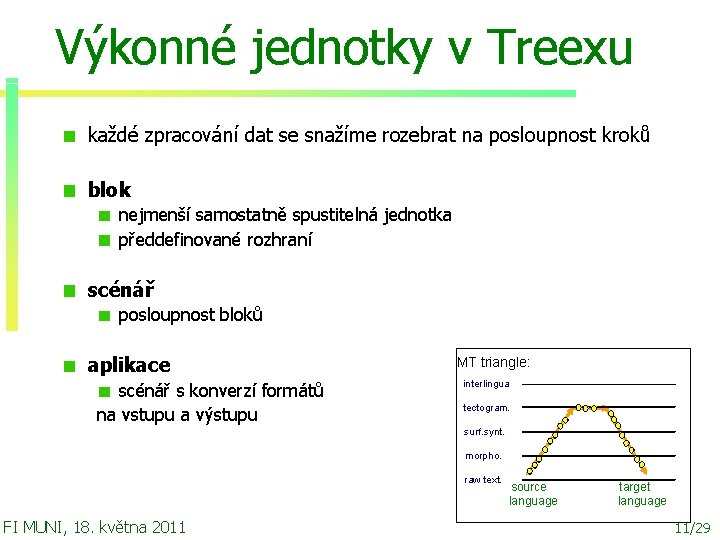
Výkonné jednotky v Treexu každé zpracování dat se snažíme rozebrat na posloupnost kroků blok nejmenší samostatně spustitelná jednotka předdefinované rozhraní scénář posloupnost bloků aplikace scénář s konverzí formátů na vstupu a výstupu MT triangle: interlingua tectogram. surf. synt. morpho. raw text. FI MUNI, 18. května 2011 source language target language 11/29
Integrace nástrojů do Tecto. MT využití existujících i nově vyvinutých nástrojů, např. editor stromových struktur [Pajas, Štěpánek, 2005] morfologické taggery, např. [Hajič, 2004] závislostní syntaktické analyzátory, např. [Mc. Donald et al. , 2005], [Holan, Žabokrtský, 2006] [Nivre et al. , 2007] složkové syntaktické analyzátory, např. [Collins, 1999] [Charniak, Johnson, 2005] [Klein, Manning, 2003] převodník složkových a závislostních stromů, [Žabokrtský, Kučerová, 2002] rozpoznávač koreferenčních vztahů, [Kučová, Žabokrtský, 2005] generátor vět z tektogramatické roviny, [Ptáček, Žabokrtský, 2006] analyzátor gramatémů, [Razímová, Žabokrtský, 2005] zarovnávač paralelních stromů, [Mareček et al. , 2008] lematizátory, např. [Popel, 2009] 12/29
Treex goes to CPAN The Comprehensive Perl Archive Network široce uznávaný standard pro distribuci modulů v Perlu unikátní archív (i mimo svět Perlu) jaro 2011 – zahájen převod modulů Treexu do cpaních balíčků zatím balíček Treex-Core využití dzil s pluginem Testing. Mania výrazné zlepšení kvality kódu díky automatizovaným testům FI MUNI, 18. května 2011 13/29
Část 2: Překlad s využitím tektogramatické roviny FI MUNI, 18. května 2011 14/29
Proč je překlad těžký? velikost slovní zásoby složitost gramatiky tvarosloví, větná skladba… repertoár výrazových prostředků (funkce vs. forma) typologická variabilita jazyků It will be delivered to Mr. Green's assistants at the nearest meeting. nesymetrie repertoárů forem i funkcí porozumění obsahu synonymie, homonymie referenční výrazy, pojmenované entity … metafory, konotace … konvence pro užívání interpunkce, číslic … žánr, styl, dialekty, jazykový humor … 15/29
Proč je strojový překlad těžký? člověk při překladu intenzivně využívá znalost světa (sausage of lovers, selective driving, welded wine…) počítač může sice napodobovat překladatele-člověka využitím slovníků a již přeložených textů, … … ale nenajde v nich všechno centrální problém strojového překladu: obrovský stavový prostor řídká data 16/29
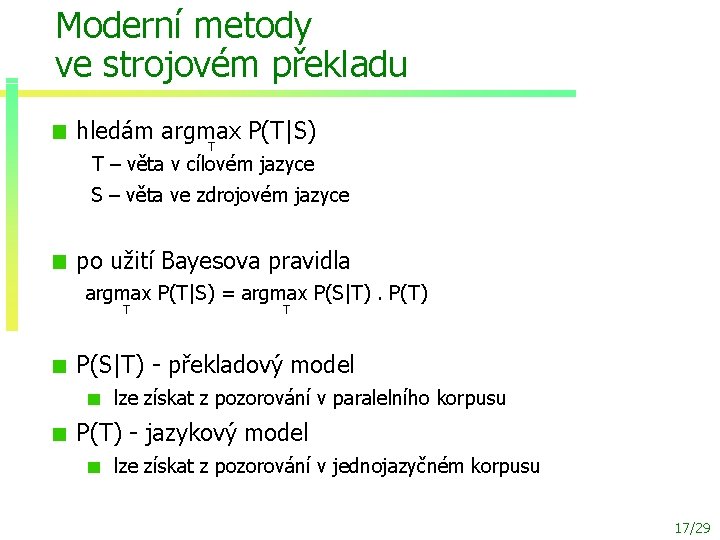
Moderní metody ve strojovém překladu hledám argmax P(T|S) T T – věta v cílovém jazyce S – věta ve zdrojovém jazyce po užití Bayesova pravidla argmax P(T|S) = argmax P(S|T). P(T) T T P(S|T) - překladový model lze získat z pozorování v paralelního korpusu P(T) - jazykový model lze získat z pozorování v jednojazyčném korpusu 17/29
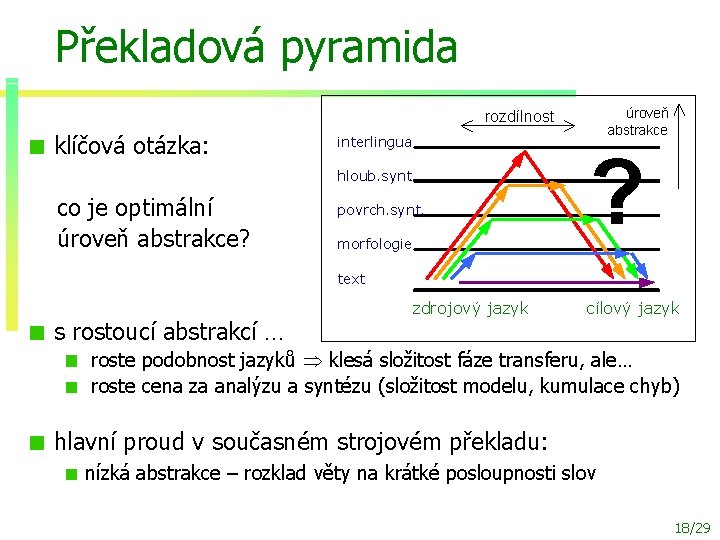
Překladová pyramida úroveň abstrakce rozdílnost klíčová otázka: interlingua hloub. synt. . co je optimální úroveň abstrakce? povrch. synt. . morfologie. ? text s rostoucí abstrakcí … zdrojový jazyk cílový jazyk roste podobnost jazyků klesá složitost fáze transferu, ale… roste cena za analýzu a syntézu (složitost modelu, kumulace chyb) hlavní proud v současném strojovém překladu: nízká abstrakce – rozklad věty na krátké posloupnosti slov 18/29
Strojový překlad a tektogramatika motivace pro použití tektogramatiky z hlediska pravděpodobnostních modelů nabízí lingvisticky adekvátní předpoklady nezávislosti 1. faktorizuje transfer do relativně samostatných kanálů (lexikalizace, syntaktická realizace, morfologický význam) 2. abstrahuje od morfologických strategií použitých v jednotlivých jazycích 3. používá syntaktický stromový kontext (místo lineárního) hypotéza: tektogramatika by mohla vést ke konstrukci efektivnějšího překladového pravděpodobnostního modelu 19/29
Využití lingvistických dat v Tecto. MT zapojení existujících i nově vytvářených lingvisticky značkovaných dat, mj. syntakticky značkované korpusy např. Pražský závislostní korpus, Penn Treebank morfologicky značkované korpusy např. Český národní korpus, British National Corpus slovníky, např. VALLEX [Lopatková, Žabokrtský, 2002] pravděpodobnostní překladové slovníky, např. [Cuřín et al. , 2004] paralelní korpusy, např. Cz. Eng [Bojar, Žabokrtský, 2006] 20/29
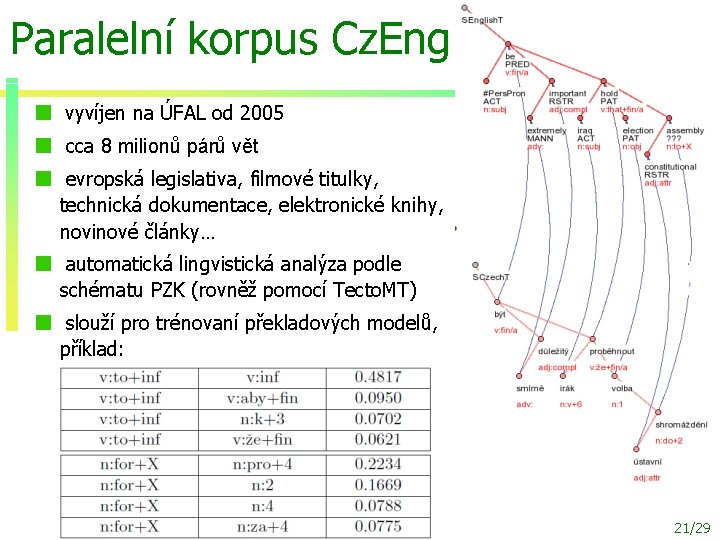
Paralelní korpus Cz. Eng vyvíjen na ÚFAL od 2005 cca 8 milionů párů vět evropská legislativa, filmové titulky, technická dokumentace, elektronické knihy, novinové články… automatická lingvistická analýza podle schématu PZK (rovněž pomocí Tecto. MT) slouží pro trénovaní překladových modelů, příklad: 21/29
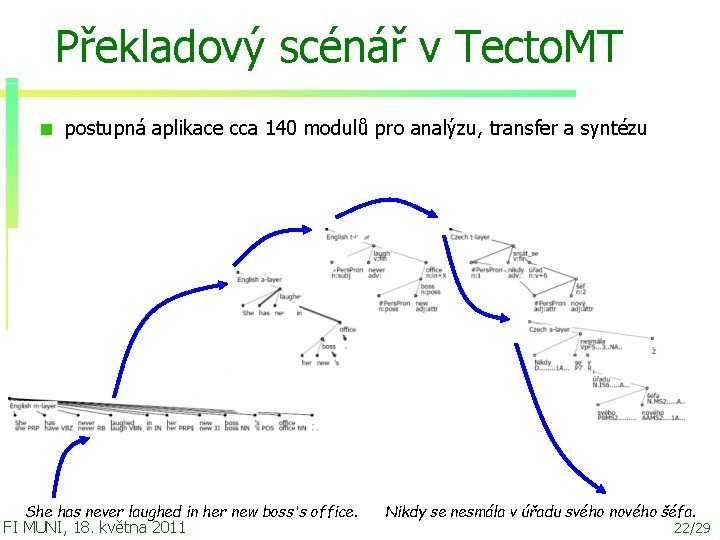
Překladový scénář v Tecto. MT postupná aplikace cca 140 modulů pro analýzu, transfer a syntézu She has never laughed in her new boss's office. FI MUNI, 18. května 2011 Nikdy se nesmála v úřadu svého nového šéfa. 22/29
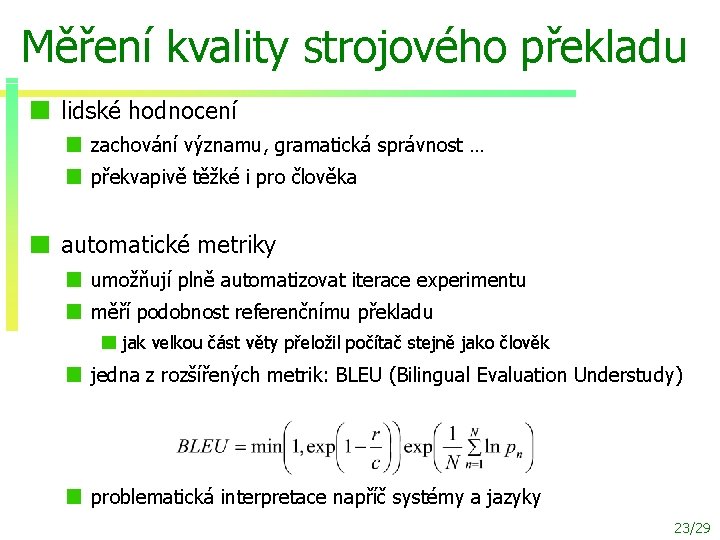
Měření kvality strojového překladu lidské hodnocení zachování významu, gramatická správnost … překvapivě těžké i pro člověka automatické metriky umožňují plně automatizovat iterace experimentu měří podobnost referenčnímu překladu jak velkou část věty přeložil počítač stejně jako člověk jedna z rozšířených metrik: BLEU (Bilingual Evaluation Understudy) problematická interpretace napříč systémy a jazyky 23/29
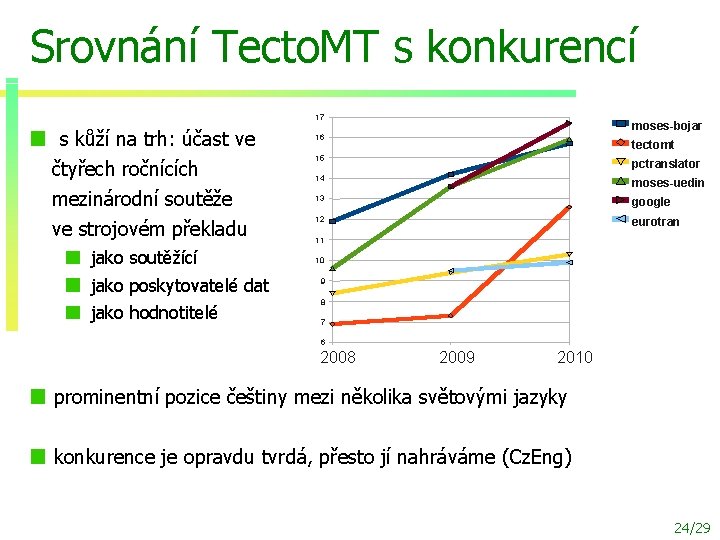
Srovnání Tecto. MT s konkurencí 17 s kůží na trh: účast ve čtyřech ročnících mezinárodní soutěže ve strojovém překladu jako soutěžící moses-bojar 16 tectomt 15 pctranslator 14 moses-uedin 13 google 12 eurotran 11 10 jako poskytovatelé dat 9 jako hodnotitelé 8 7 6 2008 2009 2010 prominentní pozice češtiny mezi několika světovými jazyky konkurence je opravdu tvrdá, přesto jí nahráváme (Cz. Eng) 24/29
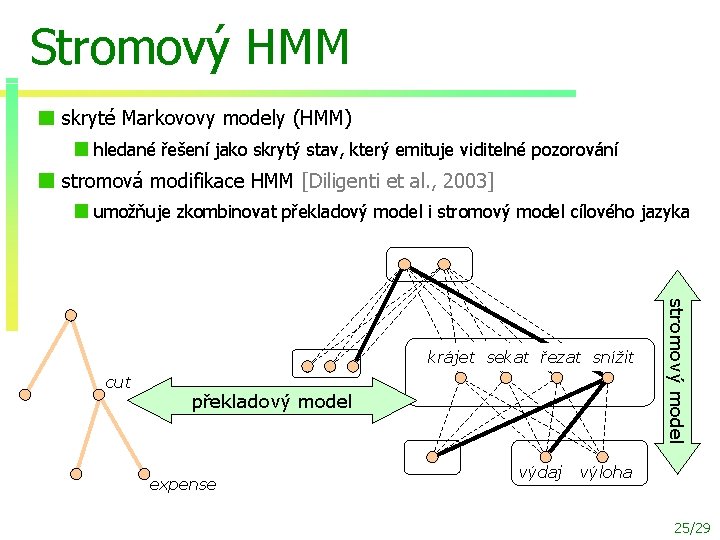
Stromový HMM skryté Markovovy modely (HMM) hledané řešení jako skrytý stav, který emituje viditelné pozorování stromová modifikace HMM [Diligenti et al. , 2003] umožňuje zkombinovat překladový model i stromový model cílového jazyka cut překladový model expense výdaj stromový model krájet sekat řezat snížit výloha 25/29
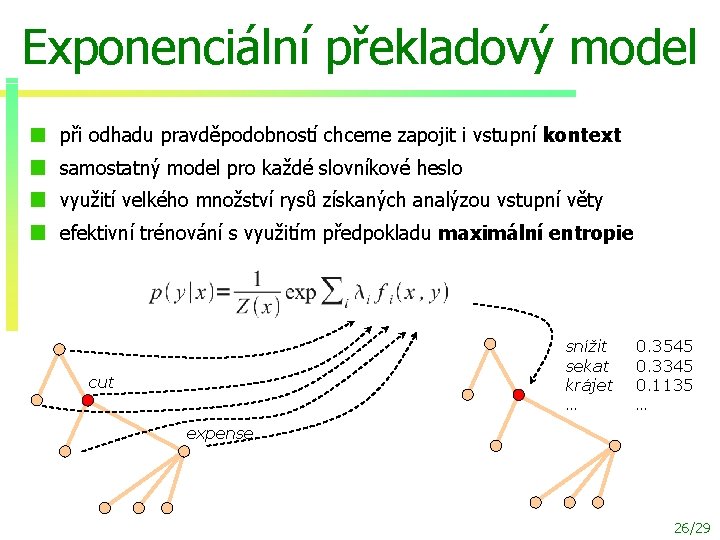
Exponenciální překladový model při odhadu pravděpodobností chceme zapojit i vstupní kontext samostatný model pro každé slovníkové heslo využití velkého množství rysů získaných analýzou vstupní věty efektivní trénování s využitím předpokladu maximální entropie snížit sekat krájet … cut 0. 3545 0. 3345 0. 1135 … expense 26/29
Další využití Treexu (vedle MT) zpracování i jiných jazyků než češtiny a angličtiny, např. tamilština [Ramasamy, Žabokrtský, 2011] ruština [Mareček, Kljueva, 2009] latina (Milano), němčina (Mainz)… využití v dalších výzkumných projektech na ÚFAL automatizovaná lingvistická analýza dat pro jiná pracoviště využití syntaktické analýzy pro predikci prozodie [Romportl, 2010] využití ve výuce na MFF diplomové a disertační práce úkoly v předmětu Zdroje lingvistických dat 27/29
Závěr: Poučení z treexového vývoje zcela zásadní: společný vývoj v SVN Perl Best Practices! Moose! Testy! I v Perlu lze realizovat velký projekt. příklon k dobře definovaným API namísto souborových formátů paralelizace výpočtu už je samozřejmostí hlavní motor vývoje: soutěže v překladu stále otevřená otázka: vyplatí se vůbec v MT používat lingvistiku? FI MUNI, 18. května 2011 28/29
Děkuji za pozornost! Ukázky překladu The EU and India are willing to reach a free trade agreement in 2008. EU a Indie jsou ochotné dosáhnout dohodu o volném obchodě v roce 2008. Currently, the bilateral trade Indo-European reaches already nearly 60 milliards euros per year. Nyní již skoro 60 miliard bilaterálního obchodního indoevropského dosahu eur ročně. The EU is the major trading partner of India and represents the 18% of its foreign trade. EU je hlavní obchodní partner Indie a představuje 18 % jeho zahraničního obchodu. 29/29
- Slides: 29