
STATISTIEK II Hoofdstuk 5 Toetsen voor twee populaties

- Slides: 38
STATISTIEK II Hoofdstuk 5: Toetsen voor twee populaties Vanhoomissen & Valkeneers, hoofdstuk 5
PREVIOUSLY ON STATISTIEK II • In wetenschappelijk onderzoek vertrekken we vanuit een onderzoeksvraag waaruit wordt afgeleid wat de populatie is en wat de onderzoekseenheden zijn. Om die vraag te beantwoorden verzamelen we data in de vorm van steekproeven omdat de hele populatie vaak moeilijk te onderzoeken is. Die steekproeven worden volgens bepaalde regels getrokken. • Om via de verzamelde data de onderzoeksvraag te beantwoorden hebben we kansberekeningen nodig: kansen stellen ons in staat om te beslissen of een observatie heel uitzonderlijk is of eerder heel gewoon. • Om kansen te berekenen maken we gebruik van kansverdelingen: theoretische verdelingen van mogelijke waarden en bijhorende kansen van een variabele. In de psychologie wordt de normale verdeling vaak gebruikt, aangezien veel kenmerken van mensen als normaal verdeeld in de populatie worden beschouwd. • Omdat voor elk kenmerk een normale verdeling met een ander gemiddelde en standaarddeviatie geldt, is het onmogelijk om voor elke verdeling de exacte kansen te kennen. Daarom herleiden we die normale verdeling naar een standaardnormale verdeling door z-scores te berekenen. Daarna kunnen we de kansen van de z-scores aflezen uit een tabel. • Bij hypothesetoetsing gebruiken we de steekproevenverdeling van het gemiddelde als kansverdeling. Ook hier zetten we waarden (gemiddelden!) om naar z-scores. We kunnen dan beslissen of ons geobserveerde gemiddelde uitzonderlijk is of niet. Als het uitzonderlijk is – volgens de verdeling die bij H 0 hoort – dan verwerpen we H 0. 2 Hoofdstuk 5: Toetsen voor 2 populaties
SAMENVATTING • We zijn nooit helemaal zeker van de juistheid van onze conclusie na hypothesetoetsing: fouten zijn mogelijk, en belangrijk is dat we weten hoe groot de kans is op een fout. • Bij hypothesetoetsing kan je overschrijdingskansen gebruiken, maar net zo goed kan je de kritieke waarden berekenen die bij de overschrijdingskansen horen. • Hypotheses kunnen éénzijdig of tweezijdig getoetst worden. Eénzijdig toetsen geeft meer kans op significante resultaten, maar mag enkel toegepast worden als er een duidelijk verantwoorde richting in de hypothese zit. • Naargelang de toetsingssituatie gebruiken we een verschillende toets om onze hypotheses te toetsen. Deze toetsen zijn ruwweg in te delen in twee groepen. Voor een parametrische toets moet de situatie aan meer voorwaarden voldoen, maar daar staat tegenover dat deze toetsen makkelijker een effect detecteren. Nonparametrische toetsen zijn minder afhankelijk van voorwaarden, maar ook minder krachtig. 3 Hoofdstuk 5: Toetsen voor 2 populaties
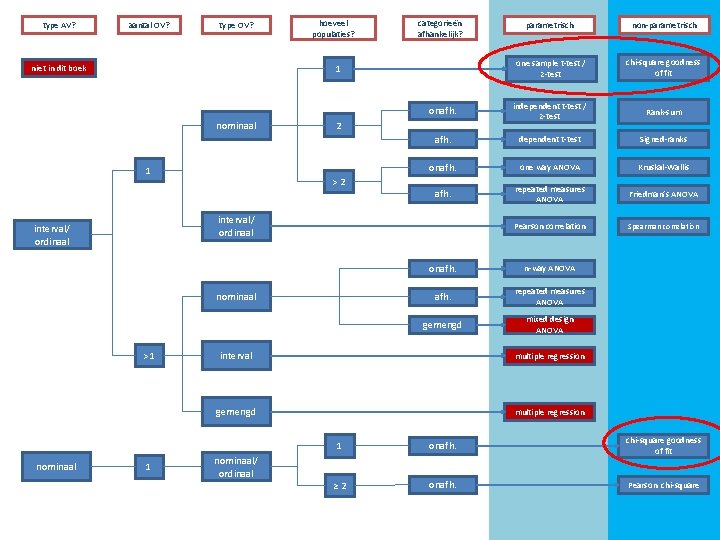
type AV? aantal OV? type OV? niet in dit boek hoeveel populaties? parametrisch non-parametrisch one sample t-test / z-test chi-square goodness of fit onafh. independent t-test / z-test Rank-sum afh. dependent t-test Signed-ranks onafh. one way ANOVA Kruskal-Wallis afh. repeated measures ANOVA Friedman’s ANOVA Pearson correlation Spearman correlation 1 nominaal 1 2 >2 interval/ ordinaal nominaal >1 nominaal categorieën afhankelijk? 1 onafh. n-way ANOVA afh. repeated measures ANOVA gemengd mixed design ANOVA interval multiple regression gemengd multiple regression nominaal/ ordinaal 1 onafh. chi-square goodness of fit ≥ 2 onafh. Pearson chi-square
VANDAAG Toetsen voor twee populaties T-toets voor 2 gemiddelden, Wilcoxon Rank sum toets
STEEKPROEVEN 2 populaties vergelijken 2 steekproeven trekken Afhankelijke of onafhankelijke steekproeven? -> wordt niet bepaald door de populatie, maar wel door de manier van steekproeftrekken! 1. Afhankelijk met herhaalde metingen Uit de populatie wordt een steekproef getrokken waarvan een test wordt afgenomen. Op een ander moment nemen we opnieuw deze test af van exact dezelfde individuen Test voor slaperigheid afnemen van 30 studenten bij het begin van het hoorcollege Statistiek. Na 1 uur dezelfde test afnemen bij dezelfde studenten -> is er een effect van het hoorcollege op de slaperigheid? 6 Hoofdstuk 5: Toetsen voor 2 populaties
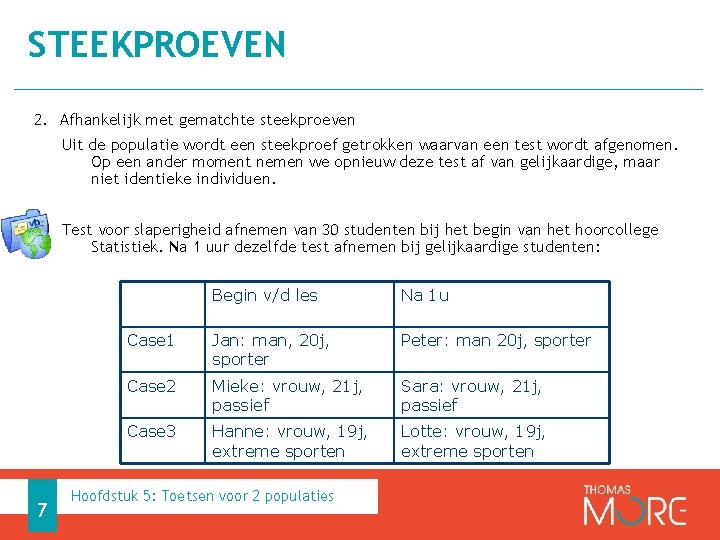
STEEKPROEVEN 2. Afhankelijk met gematchte steekproeven Uit de populatie wordt een steekproef getrokken waarvan een test wordt afgenomen. Op een ander moment nemen we opnieuw deze test af van gelijkaardige, maar niet identieke individuen. Test voor slaperigheid afnemen van 30 studenten bij het begin van het hoorcollege Statistiek. Na 1 uur dezelfde test afnemen bij gelijkaardige studenten: 7 Begin v/d les Na 1 u Case 1 Jan: man, 20 j, sporter Peter: man 20 j, sporter Case 2 Mieke: vrouw, 21 j, passief Sara: vrouw, 21 j, passief Case 3 Hanne: vrouw, 19 j, extreme sporten Lotte: vrouw, 19 j, extreme sporten Hoofdstuk 5: Toetsen voor 2 populaties
STEEKPROEVEN 3. Onafhankelijke steekproeven Voor het trekken van een tweede steekproef wordt op geen enkele manier rekening gehouden met de eerste steekproef. De grootte kan zelfs verschillen. Test voor slaperigheid afnemen van 30 willekeurige studenten bij het begin van het hoorcollege Statistiek. Na 1 uur dezelfde test afnemen bij 40 studenten die opnieuw willekeurig worden geselecteerd. Extra controle: randomisatie bij matching: elk lid van een gematcht paar random toewijzen aan een conditie/tijdstip bij onafhankelijke steekproeven: aselect getrokken cases worden randomgewijs toegekend aan een conditie/tijdstip 8 Hoofdstuk 5: Toetsen voor 2 populaties
Z-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 1. Toetsingssituatie Verschilt het gemiddelde in populatie 1 van het gemiddelde in populatie 2 waaruit de steekproeven afkomstig zijn? Besteden jongens evenveel tijd aan huiswerk als meisjes in de lagere school? Belangrijk: onafhankelijke steekproeven 9 Hoofdstuk 5: Toetsen voor 2 populaties
Z-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 2. Voorwaarden • σ1 en σ2 zijn bekend en populaties zijn normaal verdeeld (ook bij kleine n) • σ1 en σ2 zijn niet bekend en/of populaties zijn niet normaal verdeeld, maar n 1 ≥ 100 en n 2 ≥ 100 Want: • als σ’s niet bekend zijn maar n 1 ≥ 100 en n 2 ≥ 100 dan mag je s gebruiken • als populaties niet normaal verdeeld zijn maar n 1 ≥ 100 en n 2 ≥ 100 dan mag je aannemen dat de afhankelijke variabele ook normaal verdeeld is 10 Hoofdstuk 5: Toetsen voor 2 populaties
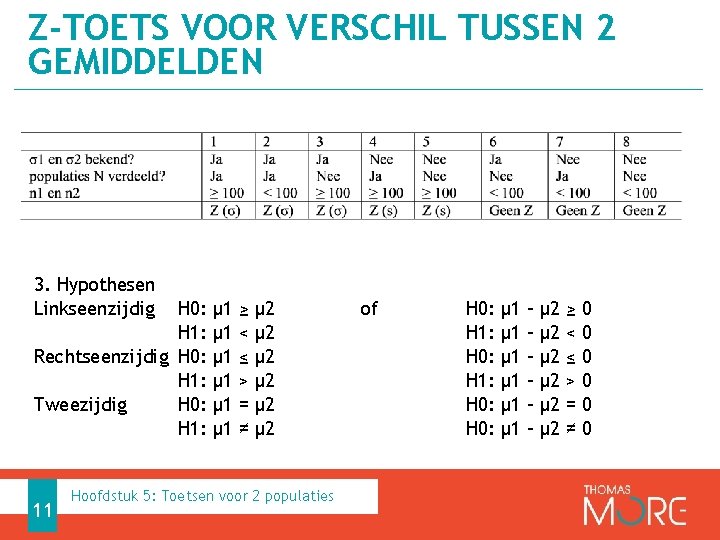
Z-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 3. Hypothesen Linkseenzijdig H 0: H 1: Rechtseenzijdig H 0: H 1: Tweezijdig H 0: H 1: 11 µ 1 µ 1 µ 1 ≥ < ≤ > = ≠ µ 2 µ 2 µ 2 Hoofdstuk 5: Toetsen voor 2 populaties of H 0: H 1: H 0: µ 1 µ 1 µ 1 - µ 2 µ 2 µ 2 ≥ < ≤ > = ≠ 0 0 0
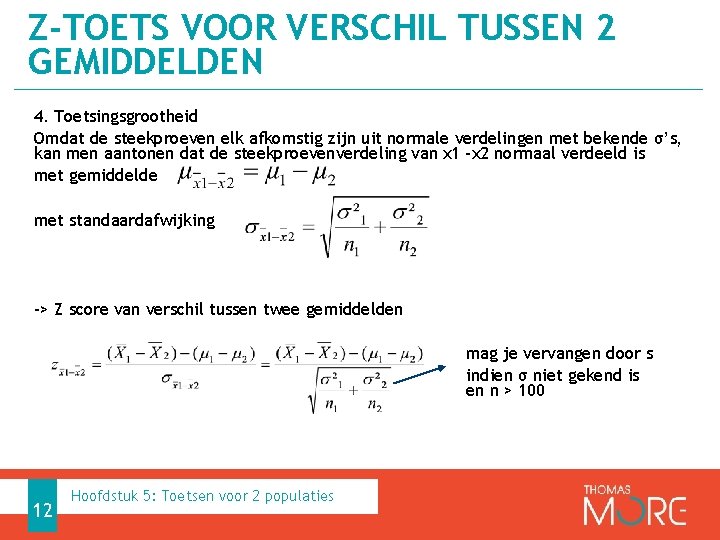
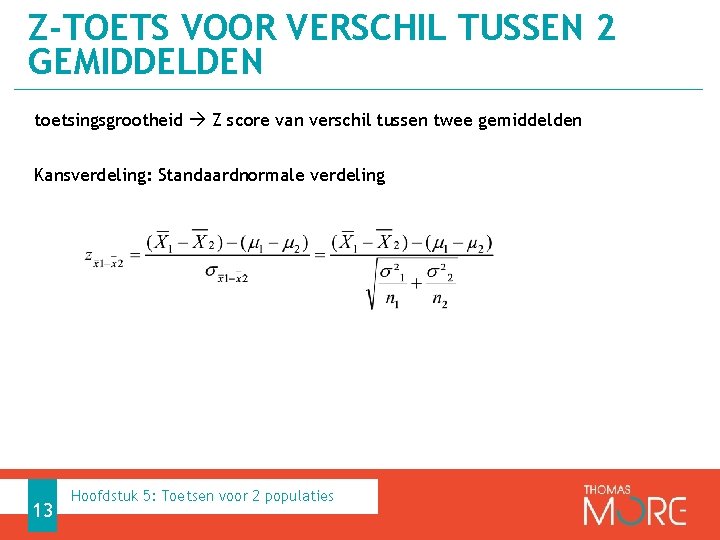
Z-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 4. Toetsingsgrootheid Omdat de steekproeven elk afkomstig zijn uit normale verdelingen met bekende σ’s, kan men aantonen dat de steekproevenverdeling van x 1 –x 2 normaal verdeeld is met gemiddelde met standaardafwijking -> Z score van verschil tussen twee gemiddelden mag je vervangen door s indien σ niet gekend is en n > 100 12 Hoofdstuk 5: Toetsen voor 2 populaties
Z-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN toetsingsgrootheid Z score van verschil tussen twee gemiddelden Kansverdeling: Standaardnormale verdeling 13 Hoofdstuk 5: Toetsen voor 2 populaties
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 1. Toetsingssituatie Verschilt het gemiddelde in populatie 1 van het gemiddelde in populatie 2 waaruit de steekproeven afkomstig zijn? Vb. Besteden jongens evenveel tijd aan huiswerk dan meisjes in de lagere school? Belangrijk: onafhankelijke steekproeven 2. Voorwaarden • σ1 en σ2 zijn niet bekend en populaties zijn normaal verdeeld en n 1 < 100 en n 2 < 100 • populaties zijn niet normaal verdeeld, 30 < n 1 < 100 en 30 < n 2 < 100 14 Hoofdstuk 5: Toetsen voor 2 populaties
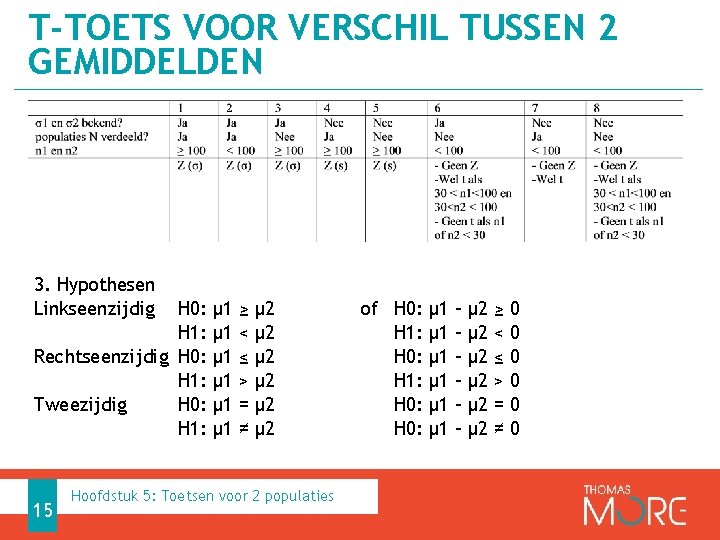
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 3. Hypothesen Linkseenzijdig H 0: H 1: Rechtseenzijdig H 0: H 1: Tweezijdig H 0: H 1: 15 µ 1 µ 1 µ 1 ≥ < ≤ > = ≠ µ 2 µ 2 µ 2 Hoofdstuk 5: Toetsen voor 2 populaties of H 0: H 1: H 0: µ 1 µ 1 µ 1 - µ 2 µ 2 µ 2 ≥ < ≤ > = ≠ 0 0 0
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 2 varianten om de toetsingsgrootheid te berekenen: • Variant 1: varianties in twee populaties zijn gelijk • Variant 2: varianties in twee populaties zijn niet gelijk >> F-toets voor gelijke varianties (later meer uitgebreid) 16 Hoofdstuk 5: Toetsen voor 2 populaties
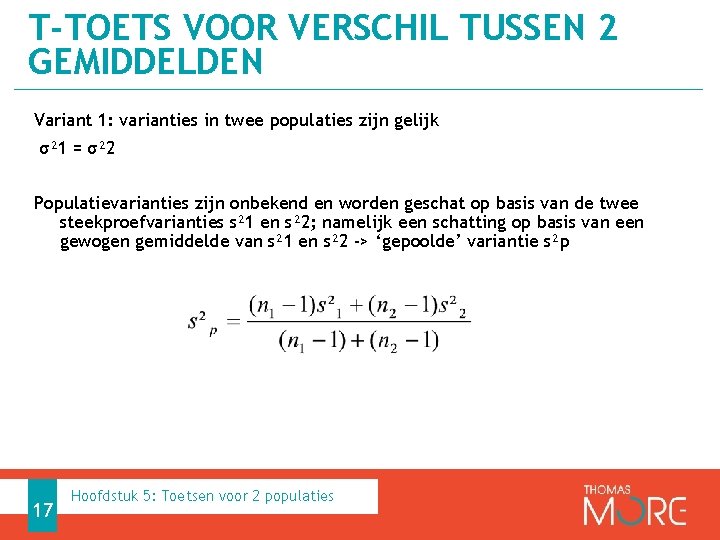
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN Variant 1: varianties in twee populaties zijn gelijk σ² 1 = σ² 2 Populatievarianties zijn onbekend en worden geschat op basis van de twee steekproefvarianties s² 1 en s² 2; namelijk een schatting op basis van een gewogen gemiddelde van s² 1 en s² 2 -> ‘gepoolde’ variantie s²p 17 Hoofdstuk 5: Toetsen voor 2 populaties
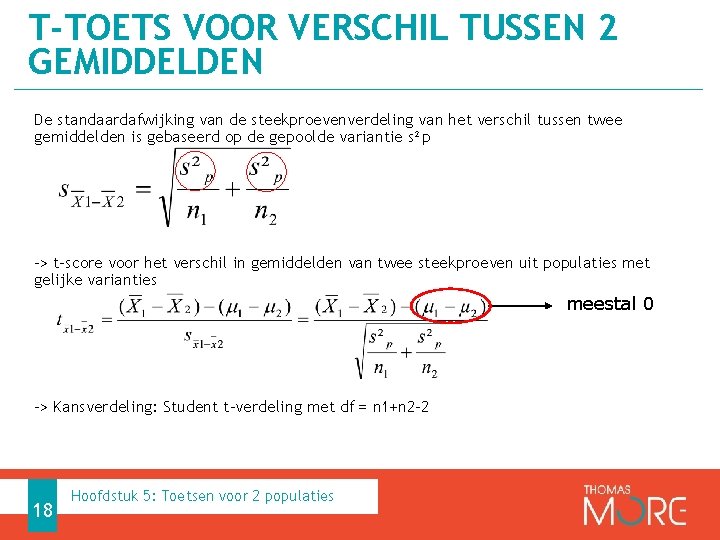
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN De standaardafwijking van de steekproevenverdeling van het verschil tussen twee gemiddelden is gebaseerd op de gepoolde variantie s²p -> t-score voor het verschil in gemiddelden van twee steekproeven uit populaties met gelijke varianties meestal 0 -> Kansverdeling: Student t-verdeling met df = n 1+n 2 -2 18 Hoofdstuk 5: Toetsen voor 2 populaties
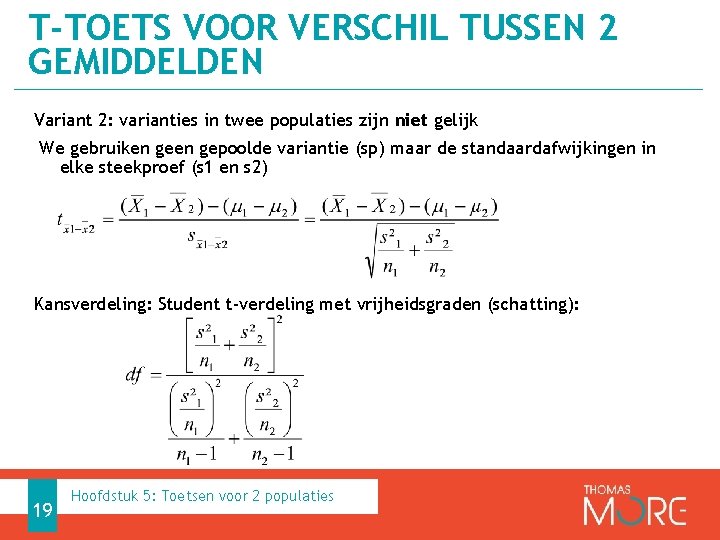
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN Variant 2: varianties in twee populaties zijn niet gelijk We gebruiken gepoolde variantie (sp) maar de standaardafwijkingen in elke steekproef (s 1 en s 2) Kansverdeling: Student t-verdeling met vrijheidsgraden (schatting): 19 Hoofdstuk 5: Toetsen voor 2 populaties
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 5. Beslissingsregels a. overschrijdingskansen - H 0 verwerpen indien: Pl (tx 1 -x 2) ≤ α? Pr (tx 1 -x 2) ≤ α? Pd (tx 1 -x 2) ≤ α? >> linkseenzijdig >> rechtseenzijdig >> tweezijdig b. kritieke waarden : H 0 verwerpen indien: vb. voor α =. 05 en df = 17. (Andere α of df -> andere kritieke waarden!!) tx 1 -x 2 ≤ -1. 74 tx 1 -x 2 ≥ 1. 74 tx 1 -x 2 ≤ -2. 11 of 20 ≥ 2. 11 Hoofdstuk 5: Toetsen voor 2 populaties >> linkseenzijdig >> rechtseenzijdig >> tweezijdig
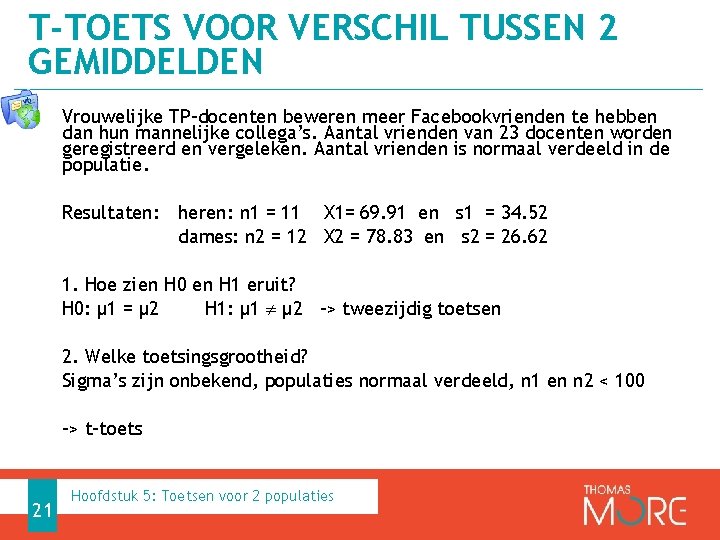
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN Vrouwelijke TP-docenten beweren meer Facebookvrienden te hebben dan hun mannelijke collega’s. Aantal vrienden van 23 docenten worden geregistreerd en vergeleken. Aantal vrienden is normaal verdeeld in de populatie. Resultaten: heren: n 1 = 11 X 1= 69. 91 en s 1 = 34. 52 dames: n 2 = 12 X 2 = 78. 83 en s 2 = 26. 62 1. Hoe zien H 0 en H 1 eruit? H 0: µ 1 = µ 2 H 1: µ 1 µ 2 -> tweezijdig toetsen 2. Welke toetsingsgrootheid? Sigma’s zijn onbekend, populaties normaal verdeeld, n 1 en n 2 < 100 -> t-toets 21 Hoofdstuk 5: Toetsen voor 2 populaties
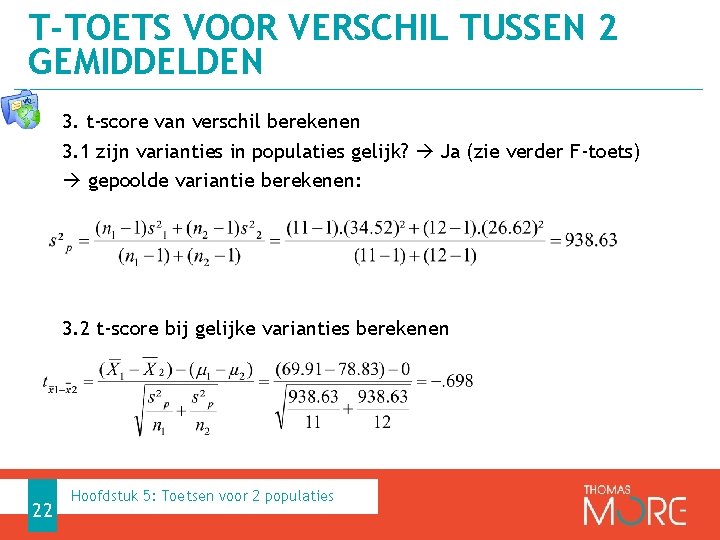
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 3. t-score van verschil berekenen 3. 1 zijn varianties in populaties gelijk? Ja (zie verder F-toets) gepoolde variantie berekenen: 3. 2 t-score bij gelijke varianties berekenen 22 Hoofdstuk 5: Toetsen voor 2 populaties
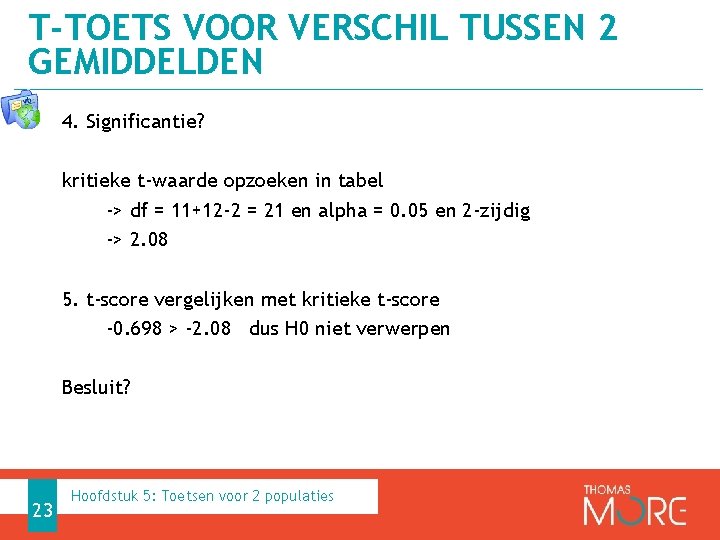
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 4. Significantie? kritieke t-waarde opzoeken in tabel -> df = 11+12 -2 = 21 en alpha = 0. 05 en 2 -zijdig -> 2. 08 5. t-score vergelijken met kritieke t-score -0. 698 > -2. 08 dus H 0 niet verwerpen Besluit? 23 Hoofdstuk 5: Toetsen voor 2 populaties
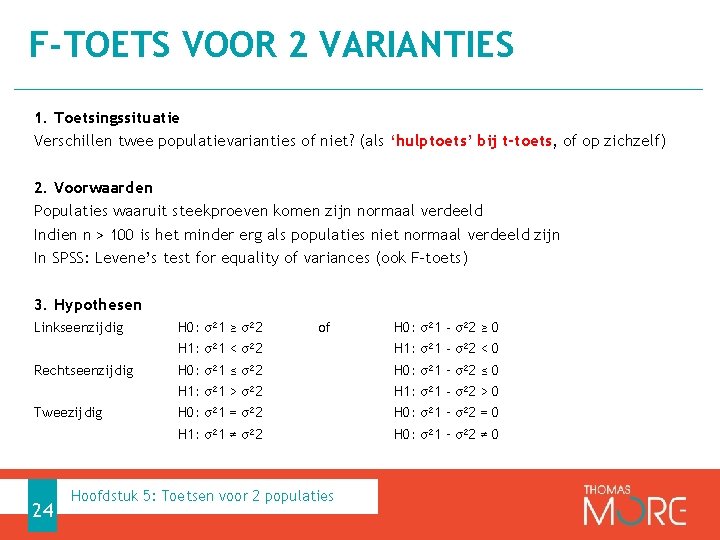
F-TOETS VOOR 2 VARIANTIES 1. Toetsingssituatie Verschillen twee populatievarianties of niet? (als ‘hulptoets’ bij t-toets, of op zichzelf) 2. Voorwaarden Populaties waaruit steekproeven komen zijn normaal verdeeld Indien n > 100 is het minder erg als populaties niet normaal verdeeld zijn In SPSS: Levene’s test for equality of variances (ook F-toets) 3. Hypothesen Linkseenzijdig Rechtseenzijdig Tweezijdig 24 H 0: σ² 1 ≥ σ² 2 of H 0: σ² 1 - σ² 2 ≥ 0 H 1: σ² 1 < σ² 2 H 1: σ² 1 - σ² 2 < 0 H 0: σ² 1 ≤ σ² 2 H 0: σ² 1 – σ² 2 ≤ 0 H 1: σ² 1 > σ² 2 H 1: σ² 1 - σ² 2 > 0 H 0: σ² 1 = σ² 2 H 0: σ² 1 – σ² 2 = 0 H 1: σ² 1 ≠ σ² 2 H 0: σ² 1 – σ² 2 ≠ 0 Hoofdstuk 5: Toetsen voor 2 populaties
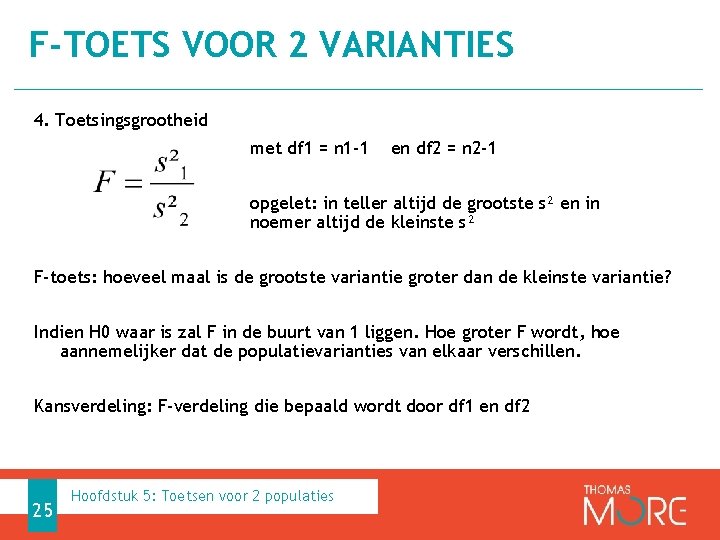
F-TOETS VOOR 2 VARIANTIES 4. Toetsingsgrootheid met df 1 = n 1 -1 en df 2 = n 2 -1 opgelet: in teller altijd de grootste s² en in noemer altijd de kleinste s² F-toets: hoeveel maal is de grootste variantie groter dan de kleinste variantie? Indien H 0 waar is zal F in de buurt van 1 liggen. Hoe groter F wordt, hoe aannemelijker dat de populatievarianties van elkaar verschillen. Kansverdeling: F-verdeling die bepaald wordt door df 1 en df 2 25 Hoofdstuk 5: Toetsen voor 2 populaties
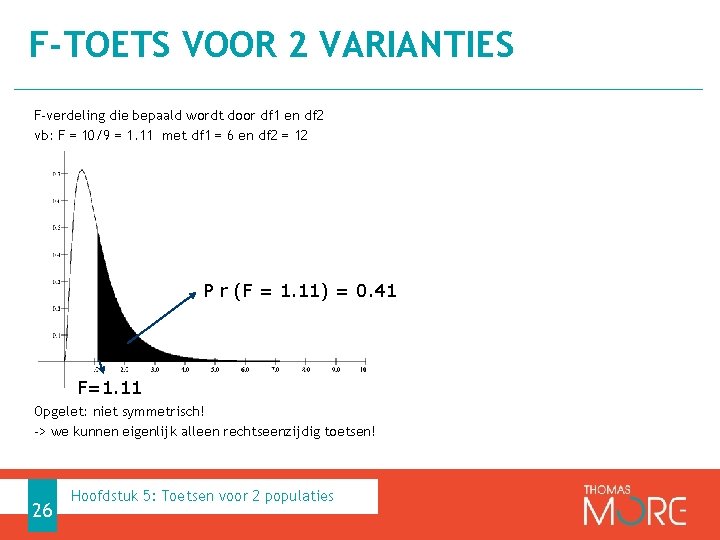
F-TOETS VOOR 2 VARIANTIES F-verdeling die bepaald wordt door df 1 en df 2 vb: F = 10/9 = 1. 11 met df 1 = 6 en df 2 = 12 P r (F = 1. 11) = 0. 41 F=1. 11 Opgelet: niet symmetrisch! -> we kunnen eigenlijk alleen rechtseenzijdig toetsen! 26 Hoofdstuk 5: Toetsen voor 2 populaties
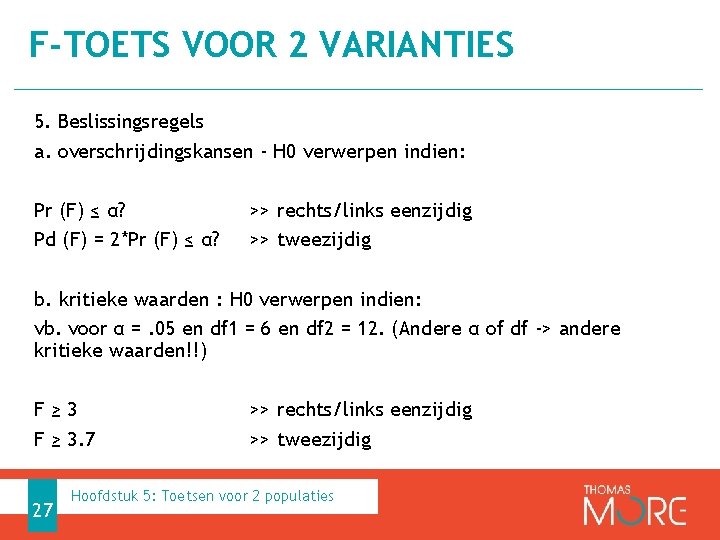
F-TOETS VOOR 2 VARIANTIES 5. Beslissingsregels a. overschrijdingskansen - H 0 verwerpen indien: Pr (F) ≤ α? Pd (F) = 2*Pr (F) ≤ α? >> rechts/links eenzijdig >> tweezijdig b. kritieke waarden : H 0 verwerpen indien: vb. voor α =. 05 en df 1 = 6 en df 2 = 12. (Andere α of df -> andere kritieke waarden!!) F≥ 3 F ≥ 3. 7 27 >> rechts/links eenzijdig >> tweezijdig Hoofdstuk 5: Toetsen voor 2 populaties
F-TOETS VOOR 2 VARIANTIES F-toets wordt in SPSS vaak mee gerapporteerd bij andere toetsen (Levene’s test bij t-test, ANOVA) 28 Hoofdstuk 5: Toetsen voor 2 populaties
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN IN SPSS • Demo SPSS – independent samples t-test • Muziekvoorkeuren Waarom luisteren we liever naar onze favoriete muziek dan naar andere muziek? Dopamineproductie vergelijken bij luisteren naar favoriete vs niet-favoriete muziek. 29 Hoofdstuk 5: Toetsen voor 2 populaties
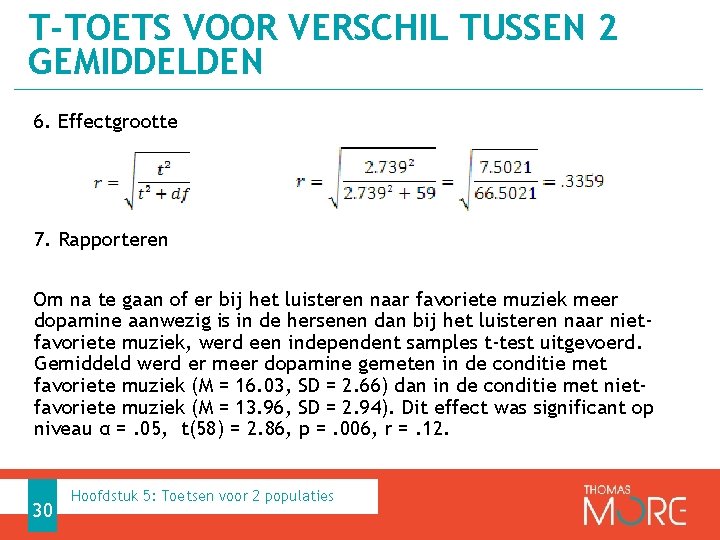
T-TOETS VOOR VERSCHIL TUSSEN 2 GEMIDDELDEN 6. Effectgrootte 7. Rapporteren Om na te gaan of er bij het luisteren naar favoriete muziek meer dopamine aanwezig is in de hersenen dan bij het luisteren naar nietfavoriete muziek, werd een independent samples t-test uitgevoerd. Gemiddeld werd er meer dopamine gemeten in de conditie met favoriete muziek (M = 16. 03, SD = 2. 66) dan in de conditie met nietfavoriete muziek (M = 13. 96, SD = 2. 94). Dit effect was significant op niveau α =. 05, t(58) = 2. 86, p =. 006, r =. 12. 30 Hoofdstuk 5: Toetsen voor 2 populaties
WILCOXON RANK-SUM / MANNWHITNEY TOETS Verschil tussen 2 medianen ipv tussen 2 gemiddelden omdat variabele ook op ordinaal niveau kan gemeten worden 1. Toetsingssituatie Verschillen de scores in populatie 1 over het algemeen van de scores in populatie 2 waaruit de steekproeven afkomstig zijn? Vb. Verschillen mannen en vrouwen in opleidingsniveau ( = ordinale variabele)? = nonparametrische variant van onafhankelijke t-toets 2. Voorwaarden onafhankelijke steekproeven minstens ordinaal meetniveau scores hoeven niet normaal verdeeld te zijn 31 Hoofdstuk 5: Toetsen voor 2 populaties
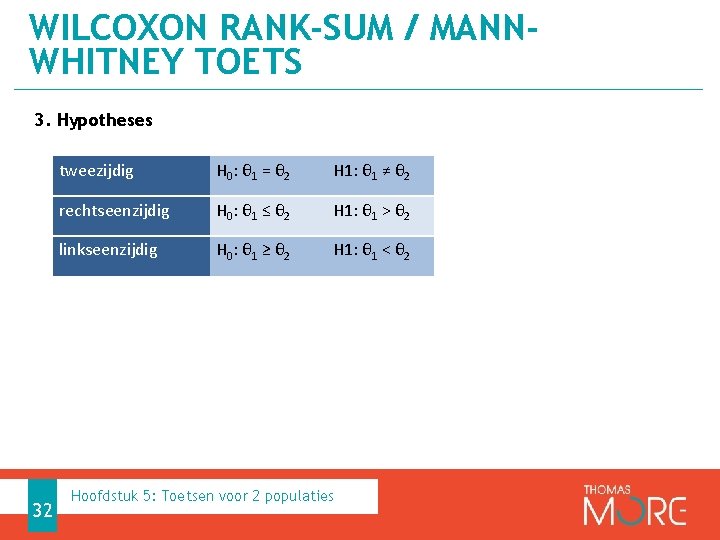
WILCOXON RANK-SUM / MANNWHITNEY TOETS 3. Hypotheses 32 tweezijdig H 0: θ 1 = θ 2 H 1: θ 1 ≠ θ 2 rechtseenzijdig H 0: θ 1 ≤ θ 2 H 1: θ 1 > θ 2 linkseenzijdig H 0: θ 1 ≥ θ 2 H 1: θ 1 < θ 2 Hoofdstuk 5: Toetsen voor 2 populaties
WILCOXON RANK-SUM / MANNWHITNEY TOETS 4. Toetsingsgrootheid U bij Mann-Whitney W bij Wilcoxon SPSS: Analyze > nonparametric > 2 independent samples 5. Beslissingsregel Is de gevonden P (Asymp. Sig. 2 -tailed) kleiner dan α ? ja: verwerp H 0 nee: verwerp H 0 niet Ter herinnering: SPSS geeft 2 -zijdige overschrijdingskans -> als je éénzijdige overschrijdingskans nodig hebt (omdat je links- of rechtszijdig wil toetsen): overschrijdingskans uit SPSS delen door 2 en kijken of dat getal ≤ α (bv. 0. 05) 33 Hoofdstuk 5: Toetsen voor 2 populaties
WILCOXON RANK-SUM / MANNWHITNEY TOETS 4. Toetsingsgrootheid U bij Mann-Whitney W bij Wilcoxon SPSS: Analyze > nonparametric > 2 independent samples 5. Beslissingsregel Is de gevonden P (Asymp. Sig. 2 -tailed) kleiner dan α ? ja: verwerp H 0 nee: verwerp H 0 niet Ter herinnering: SPSS geeft 2 -zijdige overschrijdingskans -> als je éénzijdige overschrijdingskans nodig hebt (omdat je links- of rechtszijdig wil toetsen): overschrijdingskans uit SPSS delen door 2 en kijken of dat getal ≤ α (bv. 0. 05) 34 Hoofdstuk 5: Toetsen voor 2 populaties
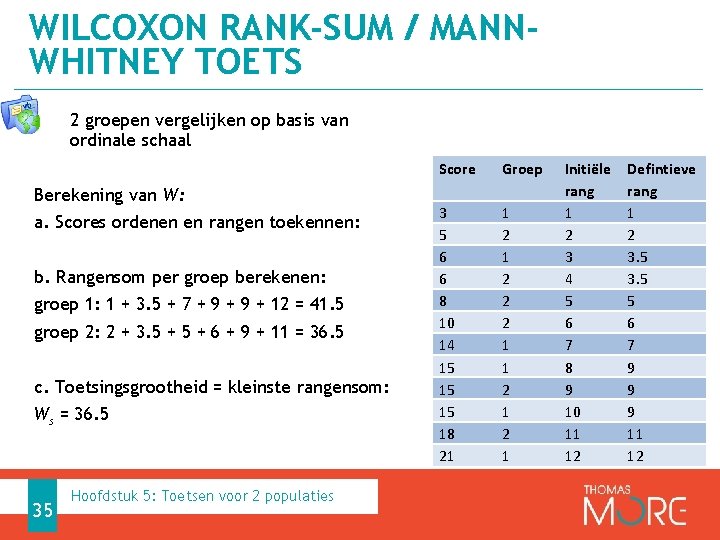
WILCOXON RANK-SUM / MANNWHITNEY TOETS 2 groepen vergelijken op basis van ordinale schaal Berekening van W: a. Scores ordenen en rangen toekennen: b. Rangensom per groep berekenen: groep 1: 1 + 3. 5 + 7 + 9 + 12 = 41. 5 groep 2: 2 + 3. 5 + 6 + 9 + 11 = 36. 5 c. Toetsingsgrootheid = kleinste rangensom: Ws = 36. 5 35 Hoofdstuk 5: Toetsen voor 2 populaties Score Groep 3 5 6 6 8 10 14 15 15 15 18 21 1 2 2 2 1 1 2 1 Initiële rang 1 2 3 4 5 6 7 8 9 10 11 12 Defintieve rang 1 2 3. 5 5 6 7 9 9 9 11 12
WILCOXON RANK-SUM / MANNWHITNEY TOETS d. Ws omzetten naar z-score: wiskundige verwachting: standaarddeviatie: z-formule: overschrijdingskans: 36 Hoofdstuk 5: Toetsen voor 2 populaties
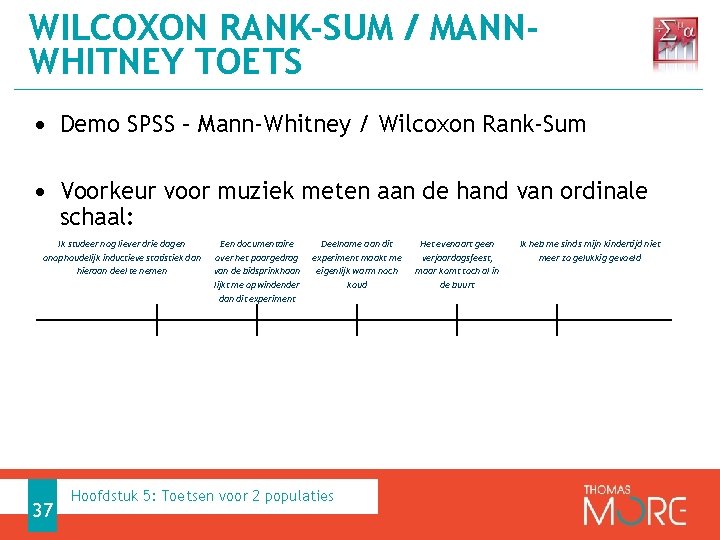
WILCOXON RANK-SUM / MANNWHITNEY TOETS • Demo SPSS – Mann-Whitney / Wilcoxon Rank-Sum • Voorkeur voor muziek meten aan de hand van ordinale schaal: Ik studeer nog liever drie dagen onophoudelijk inductieve statistiek dan hieraan deel te nemen 37 Een documentaire over het paargedrag van de bidsprinkhaan lijkt me opwindender dan dit experiment Deelname aan dit experiment maakt me eigenlijk warm noch koud Hoofdstuk 5: Toetsen voor 2 populaties Het evenaart geen verjaardagsfeest, maar komt toch al in de buurt Ik heb me sinds mijn kindertijd niet meer zo gelukkig gevoeld
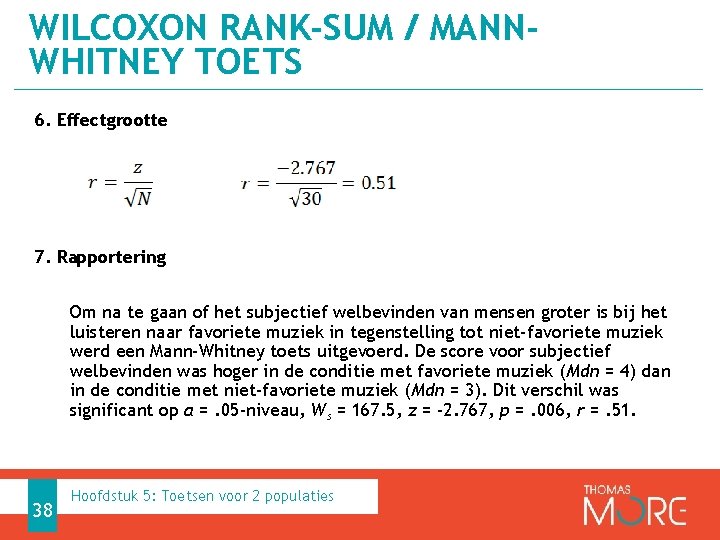
WILCOXON RANK-SUM / MANNWHITNEY TOETS 6. Effectgrootte 7. Rapportering Om na te gaan of het subjectief welbevinden van mensen groter is bij het luisteren naar favoriete muziek in tegenstelling tot niet-favoriete muziek werd een Mann-Whitney toets uitgevoerd. De score voor subjectief welbevinden was hoger in de conditie met favoriete muziek (Mdn = 4) dan in de conditie met niet-favoriete muziek (Mdn = 3). Dit verschil was significant op α =. 05 -niveau, Ws = 167. 5, z = -2. 767, p =. 006, r =. 51. 38 Hoofdstuk 5: Toetsen voor 2 populaties