
So Se 06 Statistik mit SPSS 22 06
- Slides: 15
So. Se 06, Statistik mit SPSS 22 -06 -06
Überblick Kreuztabellen 1. Ziel der Kreuztabellierung 2. Übersicht CROSSTABS - Syntax 3. 2 x 2 Kreuztabellen - Kontingenztabelle: Absolute Häufigkeiten - Kontingenztabelle: Spaltenprozente - Kontingenztabelle: Zeilenprozente - Indifferenztabelle 4. Tests und Zusammenhangsmaße
1. Ziel der Kreuztabellierung è In einer Kreutabelle wird die gemeinsame Verteilung zweier (oder auch mehrerer) Variablen angegeben. Damit können Zusammenhänge zwischen nominalskalierten Variablen (bzw. ordinalen/ metrischen Variablen mit wenigen Ausprägungen) dargestellt werden. è Mit SPSS können zwei- und mehrdimensionale Kreuztabellen erstellt und div. Tests und Zusammenhangsmaße berechnet werden. Ausserdem können Balkendiagramme erstellt werden. è Typische Fragestellungen: • Welche Zusammenhänge sind zu erkennen? • In welche Richtung gehen die Zusammenhänge? • Wie stark sind die Zusammenhänge? • Sind die Zusammenhänge signifikant?
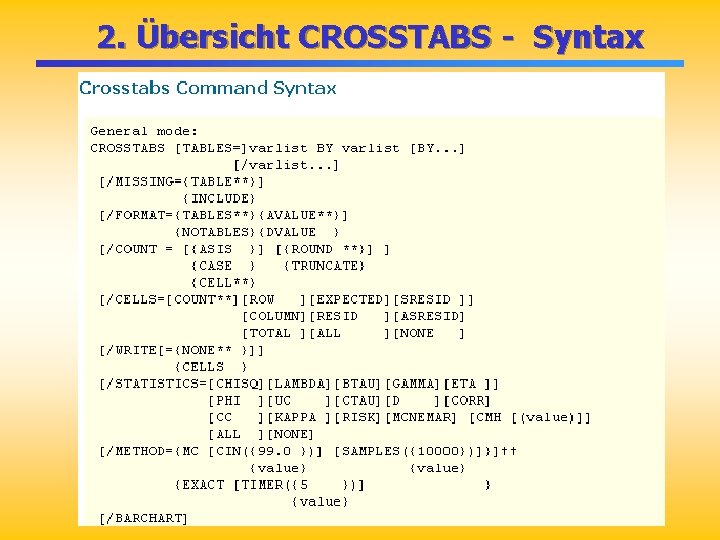
2. Übersicht CROSSTABS - Syntax
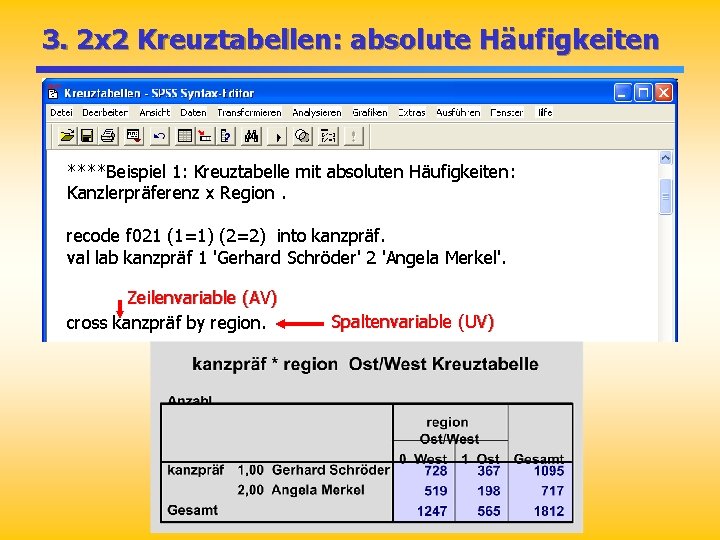
3. 2 x 2 Kreuztabellen: absolute Häufigkeiten ****Beispiel 1: Kreuztabelle mit absoluten Häufigkeiten: Kanzlerpräferenz x Region. recode f 021 (1=1) (2=2) into kanzpräf. val lab kanzpräf 1 'Gerhard Schröder' 2 'Angela Merkel'. Zeilenvariable (AV) cross kanzpräf by region. Spaltenvariable (UV)
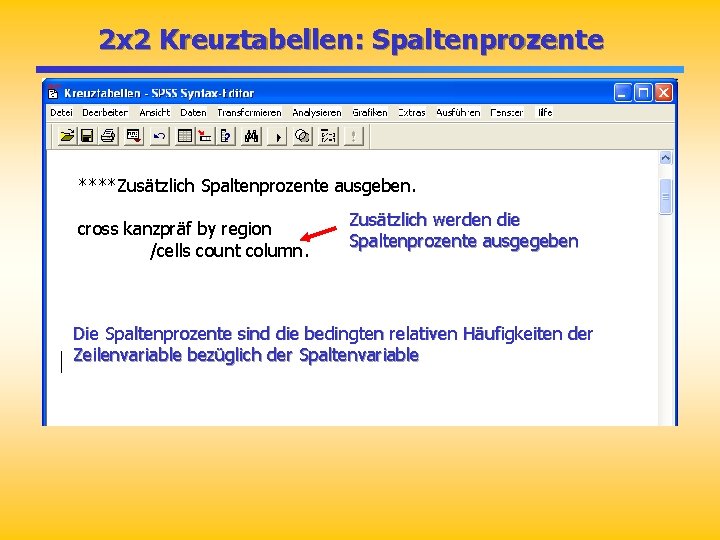
2 x 2 Kreuztabellen: Spaltenprozente ****Zusätzlich Spaltenprozente ausgeben. cross kanzpräf by region /cells count column. Zusätzlich werden die Spaltenprozente ausgegeben Die Spaltenprozente sind die bedingten relativen Häufigkeiten der Zeilenvariable bezüglich der Spaltenvariable
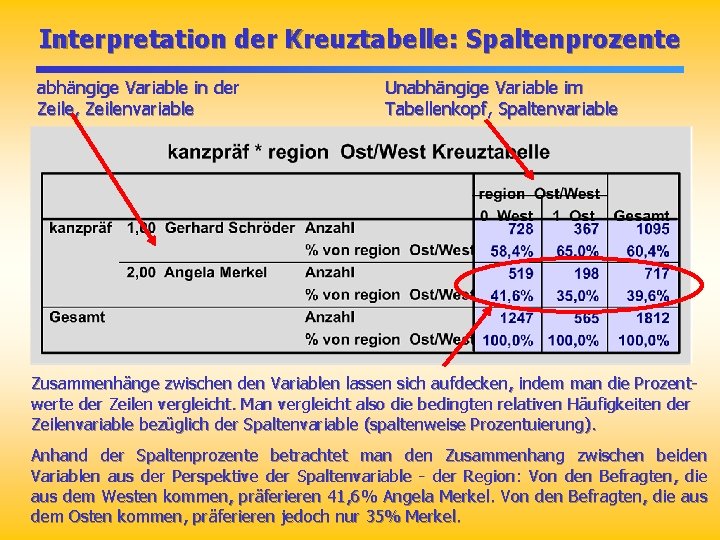
Interpretation der Kreuztabelle: Spaltenprozente abhängige Variable in der Zeile, Zeilenvariable Unabhängige Variable im Tabellenkopf, Spaltenvariable Zusammenhänge zwischen den Variablen lassen sich aufdecken, indem man die Prozentwerte der Zeilen vergleicht. Man vergleicht also die bedingten relativen Häufigkeiten der Zeilenvariable bezüglich der Spaltenvariable (spaltenweise Prozentuierung). Anhand der Spaltenprozente betrachtet man den Zusammenhang zwischen beiden Variablen aus der Perspektive der Spaltenvariable - der Region: Von den Befragten, die aus dem Westen kommen, präferieren 41, 6% Angela Merkel. Von den Befragten, die aus dem Osten kommen, präferieren jedoch nur 35% Merkel.
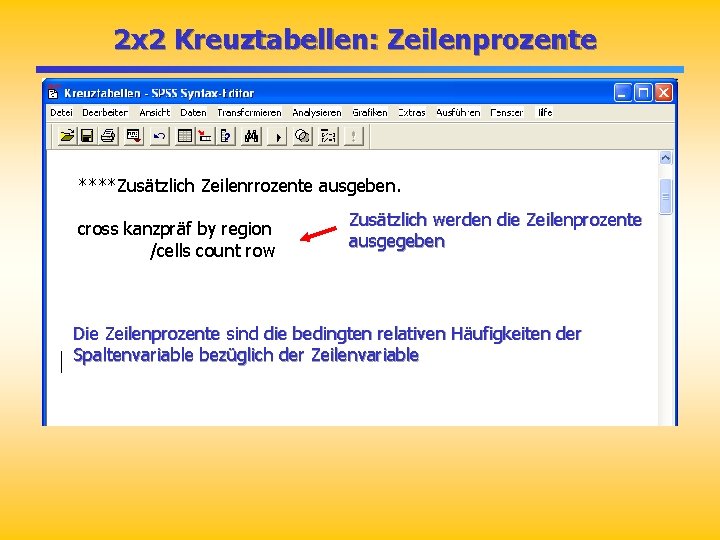
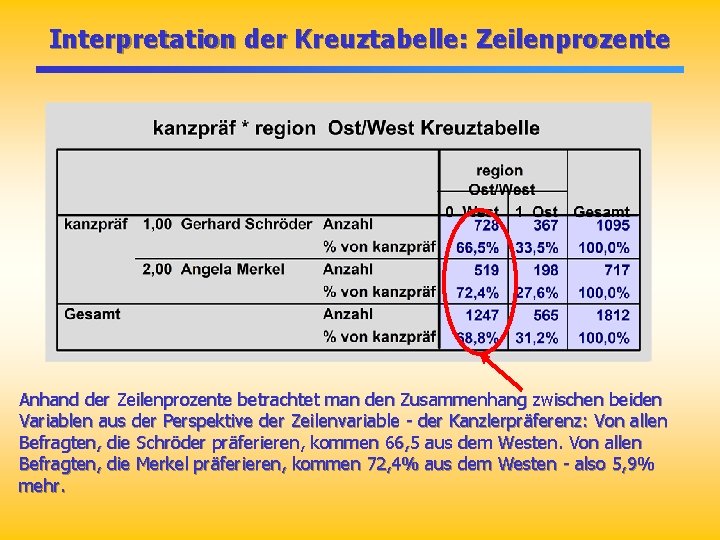
2 x 2 Kreuztabellen: Zeilenprozente ****Zusätzlich Zeilenrrozente ausgeben. cross kanzpräf by region /cells count row Zusätzlich werden die Zeilenprozente ausgegeben Die Zeilenprozente sind die bedingten relativen Häufigkeiten der Spaltenvariable bezüglich der Zeilenvariable
Interpretation der Kreuztabelle: Zeilenprozente Anhand der Zeilenprozente betrachtet man den Zusammenhang zwischen beiden Variablen aus der Perspektive der Zeilenvariable - der Kanzlerpräferenz: Von allen Befragten, die Schröder präferieren, kommen 66, 5 aus dem Westen. Von allen Befragten, die Merkel präferieren, kommen 72, 4% aus dem Westen - also 5, 9% mehr.
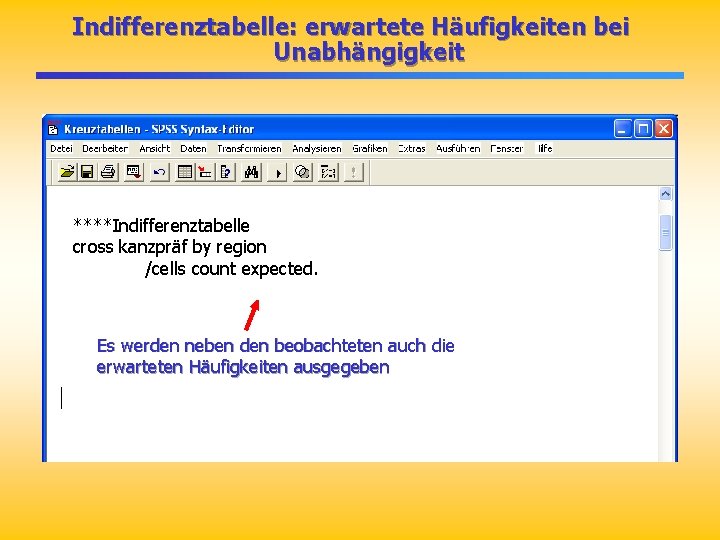
Indifferenztabelle: erwartete Häufigkeiten bei Unabhängigkeit ****Indifferenztabelle cross kanzpräf by region /cells count expected. Es werden neben den beobachteten auch die erwarteten Häufigkeiten ausgegeben
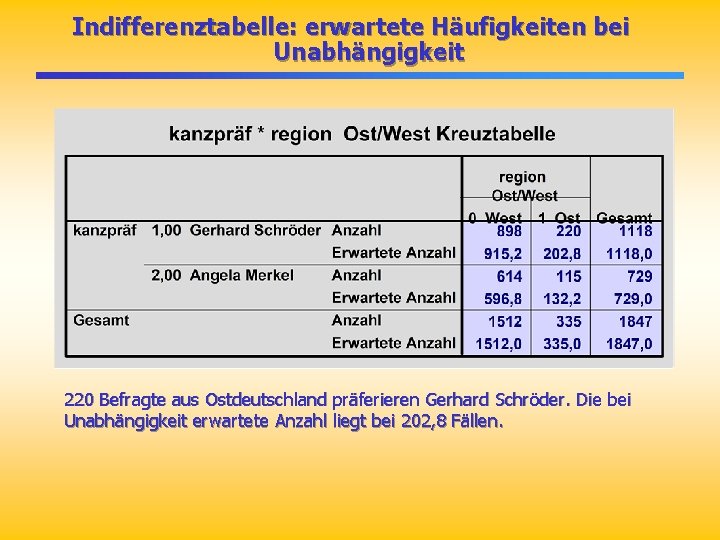
Indifferenztabelle: erwartete Häufigkeiten bei Unabhängigkeit 220 Befragte aus Ostdeutschland präferieren Gerhard Schröder. Die bei Unabhängigkeit erwartete Anzahl liegt bei 202, 8 Fällen.
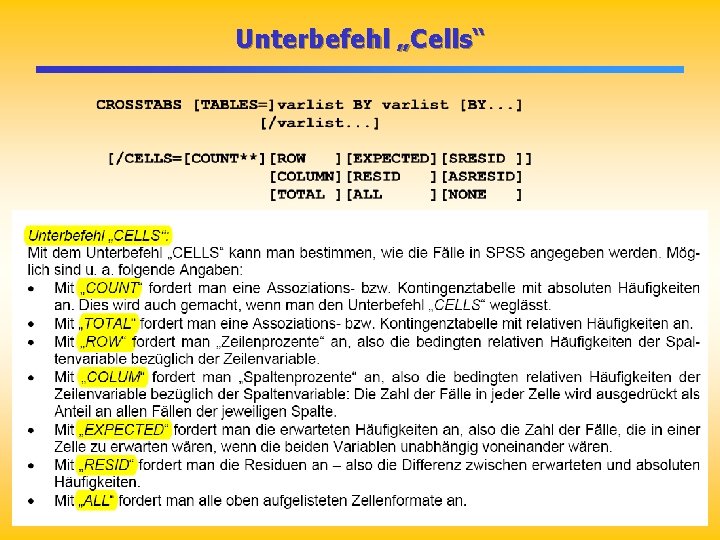
Unterbefehl „Cells“
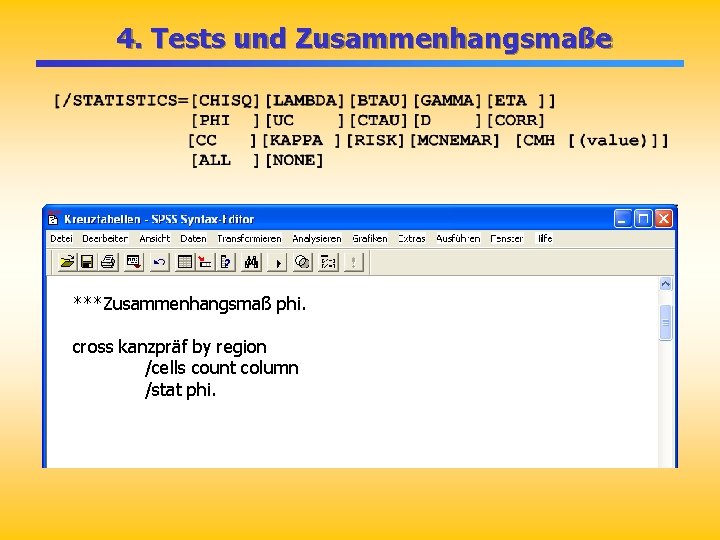
4. Tests und Zusammenhangsmaße ***Zusammenhangsmaß phi. cross kanzpräf by region /cells count column /stat phi.
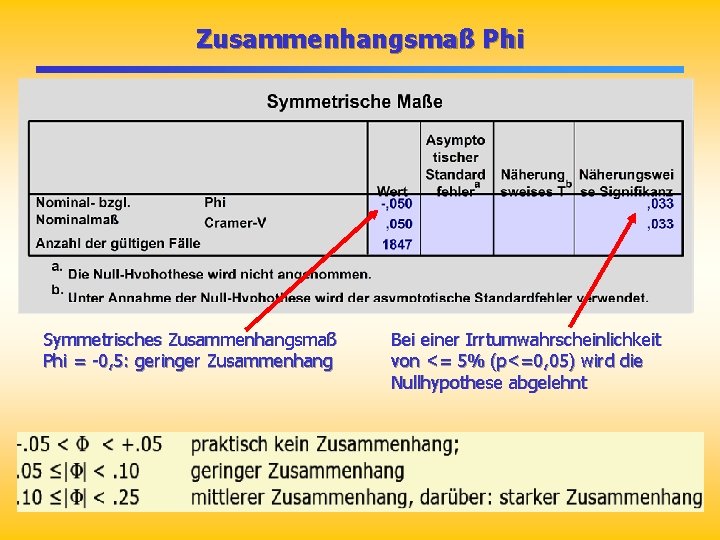
Zusammenhangsmaß Phi Symmetrisches Zusammenhangsmaß Phi = -0, 5: geringer Zusammenhang Bei einer Irrtumwahrscheinlichkeit von <= 5% (p<=0, 05) wird die Nullhypothese abgelehnt
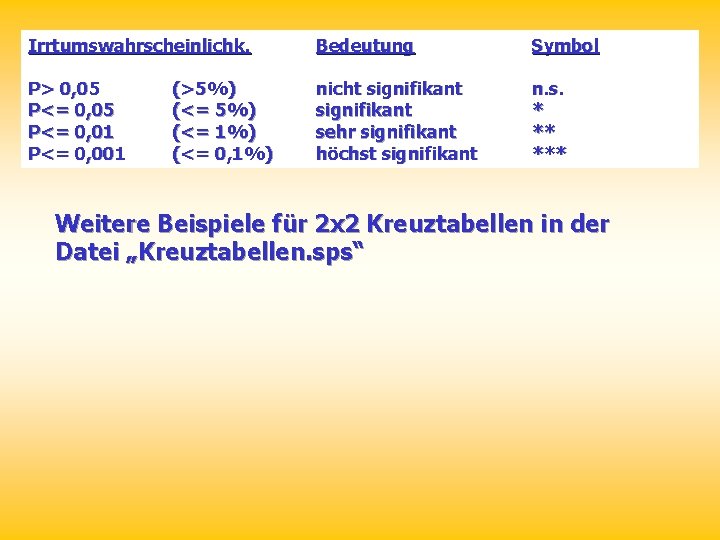
Irrtumswahrscheinlichk. Bedeutung Symbol P> 0, 05 P<= 0, 01 P<= 0, 001 nicht signifikant sehr signifikant höchst signifikant n. s. * ** *** (>5%) (<= 1%) (<= 0, 1%) Weitere Beispiele für 2 x 2 Kreuztabellen in der Datei „Kreuztabellen. sps“