
Sistemas RI na Web Daniel Bezerra Jairo Matheus
Sistemas RI na Web Daniel Bezerra, Jairo Matheus, Miguel Wanderlei {db, jmva, mdsw}@cin. ufpe. br 1
Agenda Introdução Estratégias de Orientação Arquiteturas Web Crawlers Engenhos de Busca Page. Rank Surface. Web & Deep. Web The Onion Router (Tor) 2
Introdução 3
Um pouco de história. . . 1989 - Tim Berners-Lee propõe a criação da Web 1990 - Casamento entre WWW e Hypertext 1991… Primeiros Browsers Hypertext Transfer Protocol (HTTP) Hyper. Text Markup Language (HTML) 4
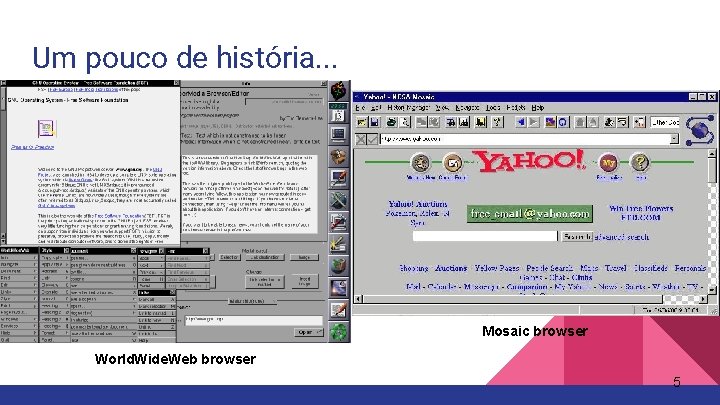
Um pouco de história. . . Mosaic browser World. Wide. Web browser 5
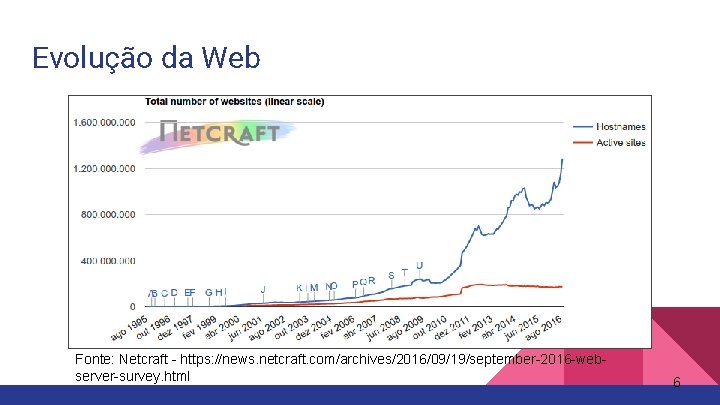
Evolução da Web Fonte: Netcraft - https: //news. netcraft. com/archives/2016/09/19/september-2016 -webserver-survey. html 6
Desafios Grande quantidade de dados Descentralizada Dados voláteis Conteúdo heterogêneo Informações redundantes 7
Estratégias de Orientação 8
Estratégias Browsing Busca 9
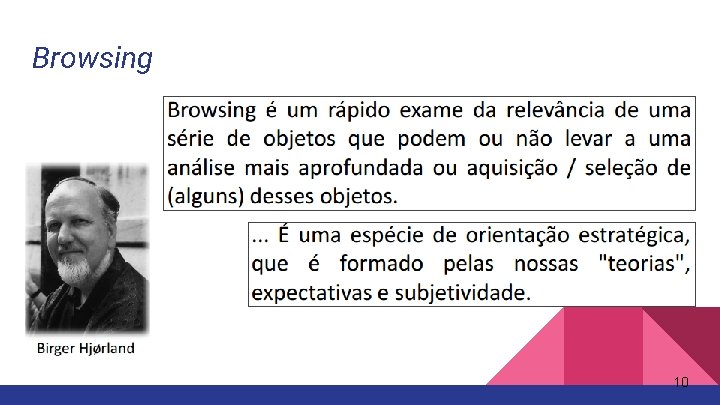
Browsing 10
Busca Realizada através de sistemas de indexação e busca de documentos 11
Browsing X Busca Browsing é uma estratégia subjetiva Depende do reconhecimento de informações relevantes Busca Se baseia em consultas (queries) Half duplex (conversa por turno) 12
Engenhos de Busca Arquiteturas Arquitetura distribuída - gatherers e brokers Arquitetura centralizada - crawlers 13
Arquiteturas 14
Arquitetura Centralizada Objetivo Indexar a Web Como Buscam páginas web Processam a página localmente Salvam a informação indexada 15
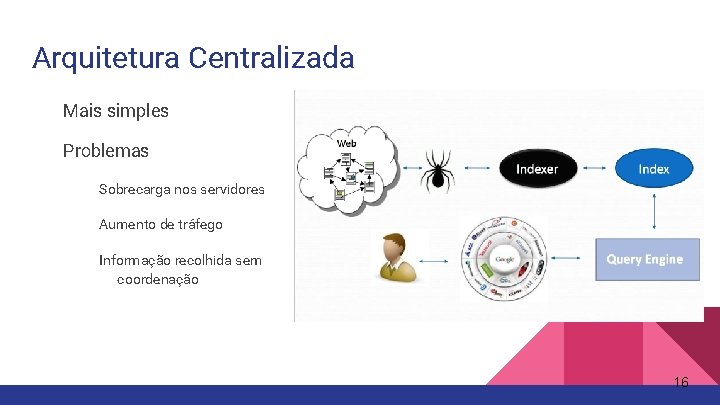
Arquitetura Centralizada Mais simples Problemas Sobrecarga nos servidores Aumento de tráfego Informação recolhida sem coordenação 16
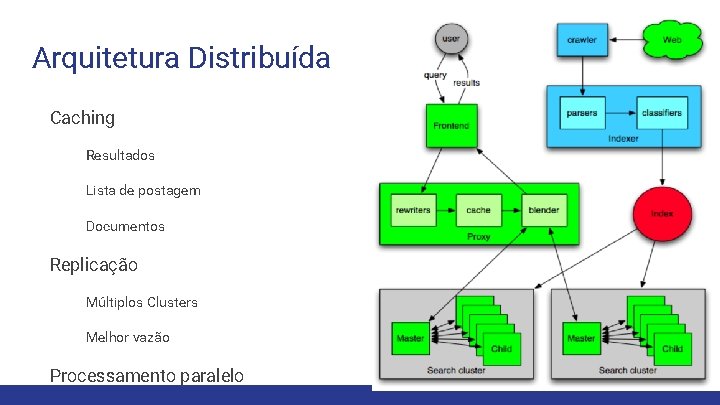
Arquitetura Distribuída Caching Resultados Lista de postagem Documentos Replicação Múltiplos Clusters Melhor vazão Processamento paralelo 17
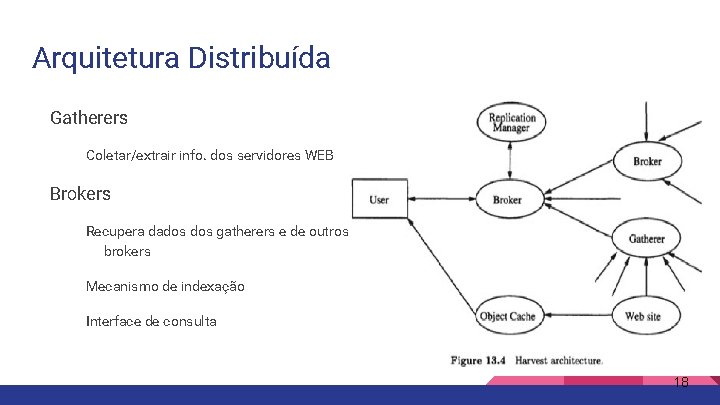
Arquitetura Distribuída Gatherers Coletar/extrair info. dos servidores WEB Brokers Recupera dados gatherers e de outros brokers Mecanismo de indexação Interface de consulta 18
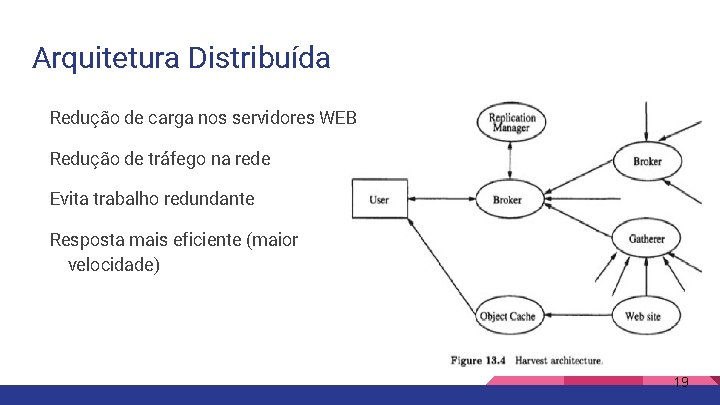
Arquitetura Distribuída Redução de carga nos servidores WEB Redução de tráfego na rede Evita trabalho redundante Resposta mais eficiente (maior velocidade) 19
Web Crawlers 20
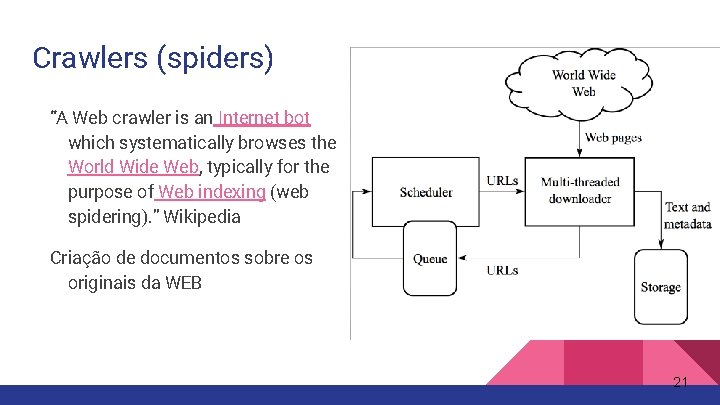
Crawlers (spiders) “A Web crawler is an Internet bot which systematically browses the World Wide Web, typically for the purpose of Web indexing (web spidering). ” Wikipedia Criação de documentos sobre os originais da WEB 21
Crawlers (spiders) Alguns Open-source crawlers Datapark. Search is a crawler and search engine released under the GNU General Public License. GNU Wget is a command-line-operated crawler written in C and released under the GPL. It is typically used to mirror Web and FTP sites. GRUB is an open source distributed search crawler that Wikia Search used to crawl the web. Heritrix is the Internet Archive's archival-quality crawler, designed for archiving periodic snapshots of a large portion of the Web. It was written in Java. Nutch is a highly extensible and scalable web crawler written in Java and released under an Apache License. It is based on Apache Hadoop and can be used with Apache Solr or Elasticsearch. Open Search Server is a search engine and web crawler software release under the GPL. PHP-Crawler is a simple PHP and My. SQL based crawler released under the BSD License. Easy to install, it became popular for small My. SQL-driven websites on shared hosting. [citation needed] 22
Crawlers (spiders) Scrapy - open source webcrawler framework, written in python (licensed under BSD). Spiders Selectors Xpath CSS Item Vantagens em atividades de parse e afins 23
Engenhos de Busca 24
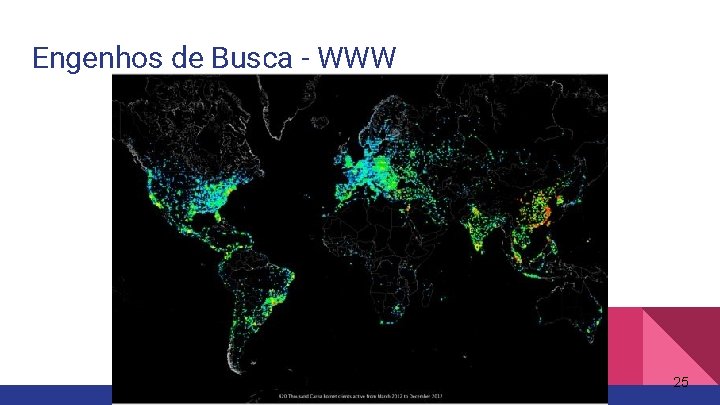
Engenhos de Busca - WWW 25
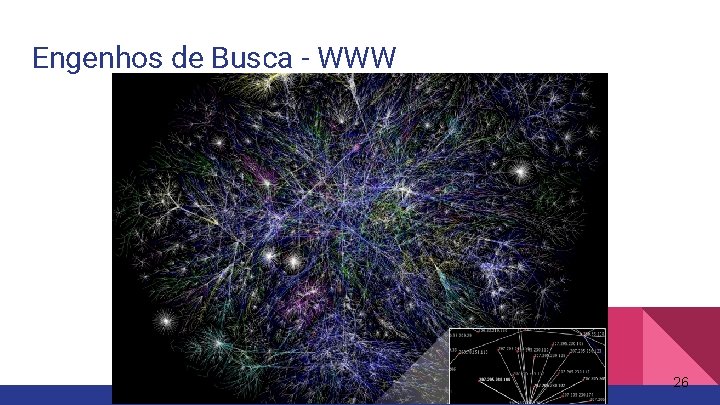
Engenhos de Busca - WWW 26
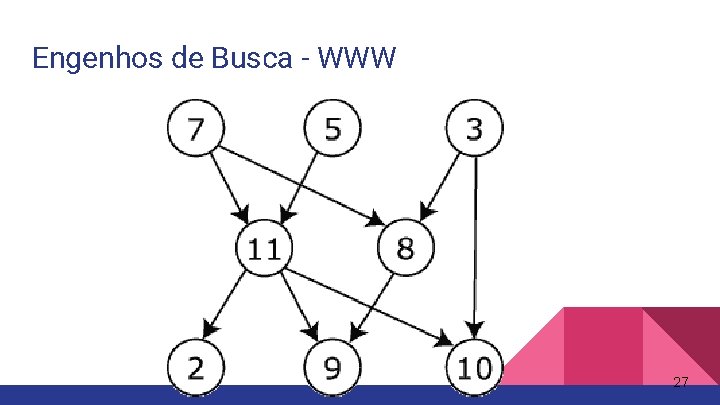
Engenhos de Busca - WWW 27
Engenhos de Busca Evolução da busca na web 1993 - Spiders criados para coletar URLs 1994 - Yahoo Coletas manuais de sites Hierarquia de tópicos 1995 - Altavista Grande capacidade de processar buscas Suporte a bool, frases e operadores 28
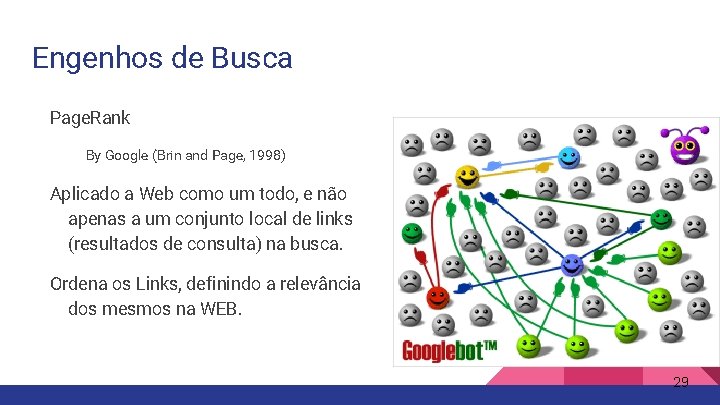
Engenhos de Busca Page. Rank By Google (Brin and Page, 1998) Aplicado a Web como um todo, e não apenas a um conjunto local de links (resultados de consulta) na busca. Ordena os Links, definindo a relevância dos mesmos na WEB. 29
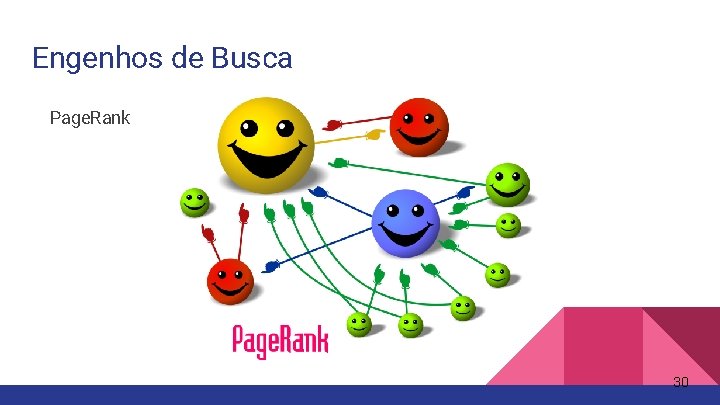
Engenhos de Busca Page. Rank 30
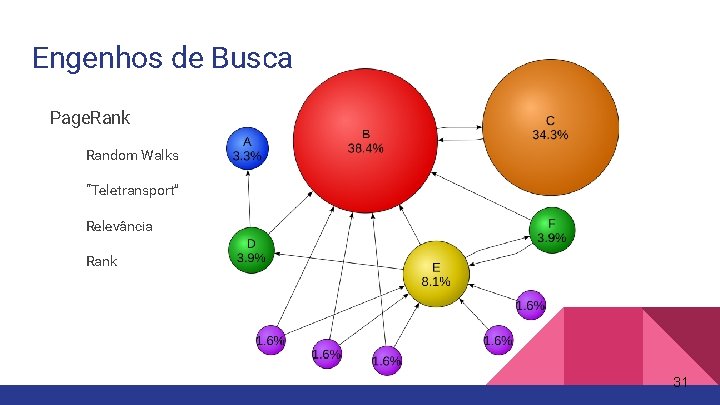
Engenhos de Busca Page. Rank Random Walks “Teletransport” Relevância Rank 31
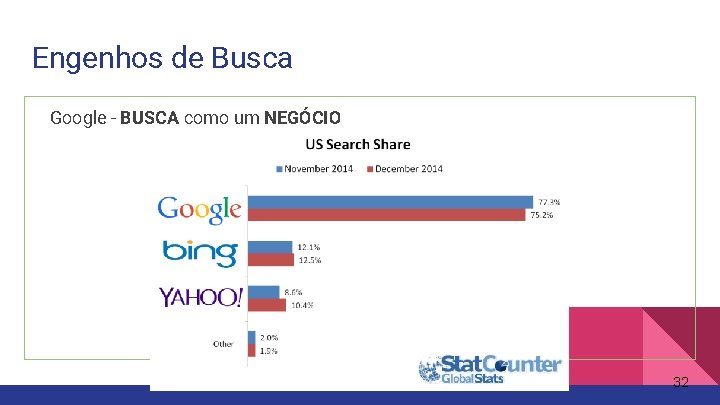
Engenhos de Busca Google - BUSCA como um NEGÓCIO 32
Engenhos de Busca Google - BUSCA como um NEGÓCIO SEO - Search Engine Optimization 33
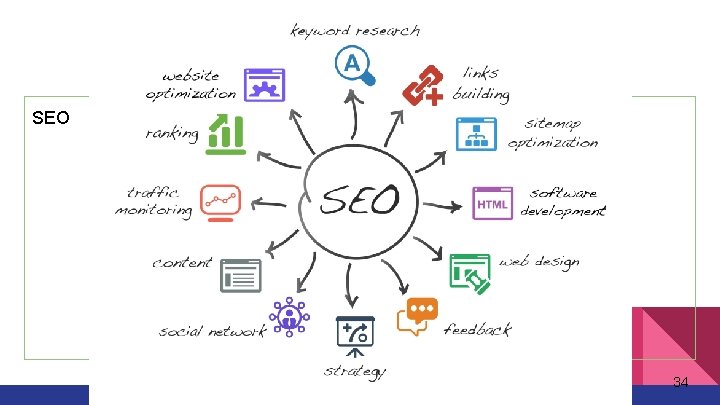
SEO 34
Engenhos de Busca Google - BUSCA como um NEGÓCIO SEO - Search Engine Optimization Black Hat SEO Penalidades do Google Resultados “Melhores” para cada usuário UX Conteúdo 35
Como pesquisa funciona? 36
Engenhos de Busca 37
Engenhos de Busca Google voice search Usuário -> áudio -> texto -> busca Mais uma camada no sistema Reconhecimento de voz IA PLN [https: //www. google. com/search/about/features/01] 38
Engenhos de Busca 39
Engenhos de Busca Google Image search Quora How does google image search engine work? What is the algorithm used by Google's reverse image search (i. e. search by image)? 40
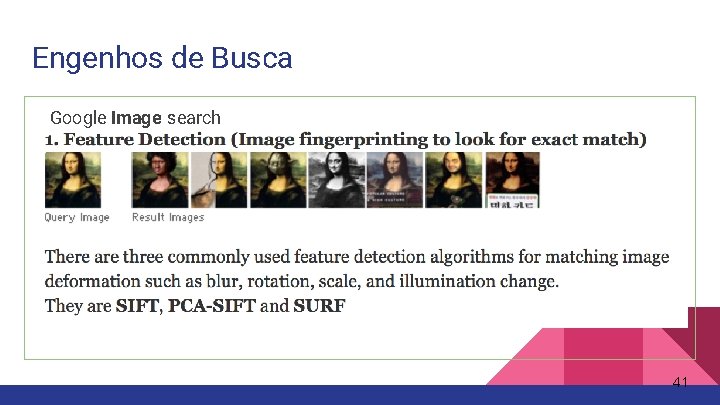
Engenhos de Busca Google Image search 41
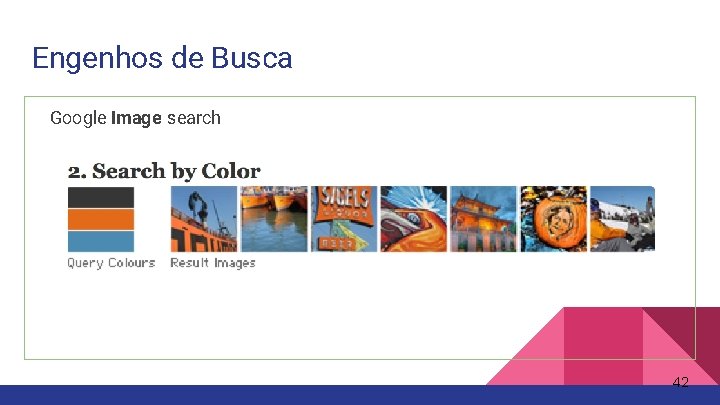
Engenhos de Busca Google Image search 42
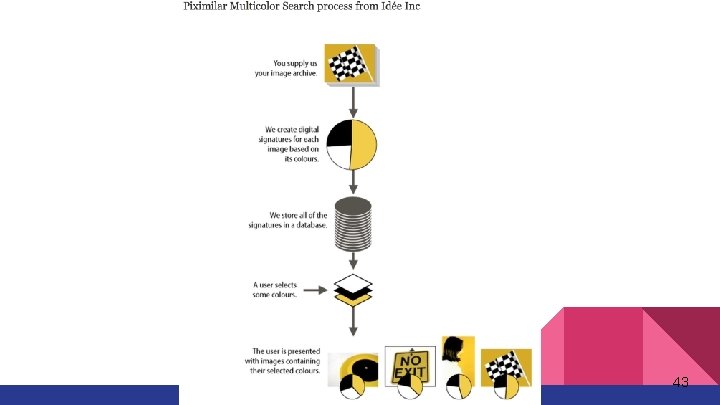
43
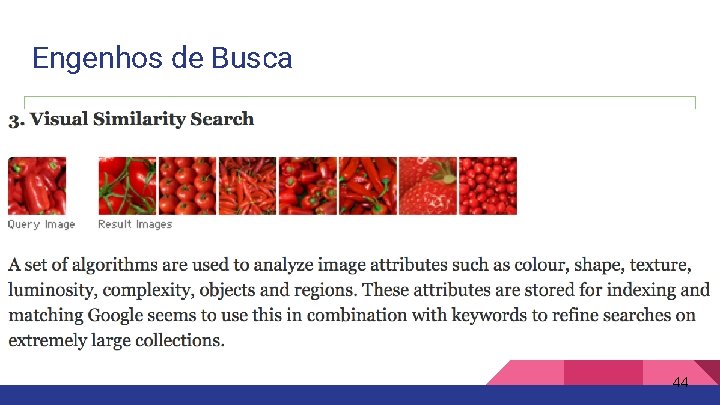
Engenhos de Busca Google Image search 44
Engenhos de Busca Google Image search “But what I guess the most important algorithm they use for ranking their results is based on Image compression technique using Auto-Encoders. ” - Sai Kiran at Quora 45
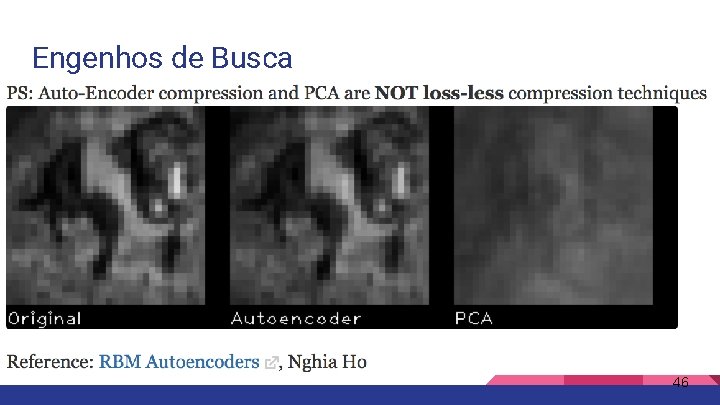
Engenhos de Busca Google Image search 46
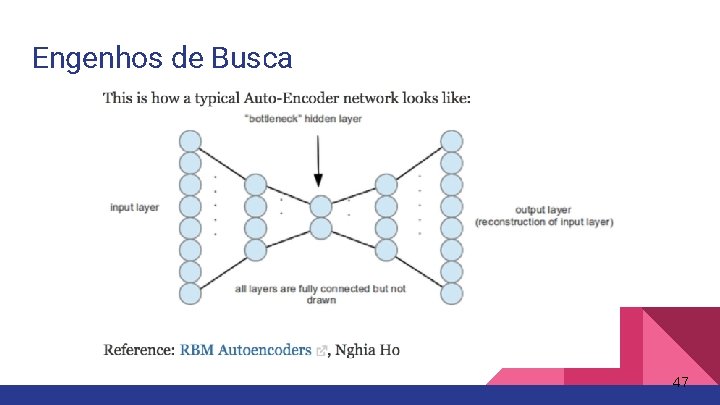
Engenhos de Busca 47
48
As Duas Webs. . . Surface Web Deep Web 49
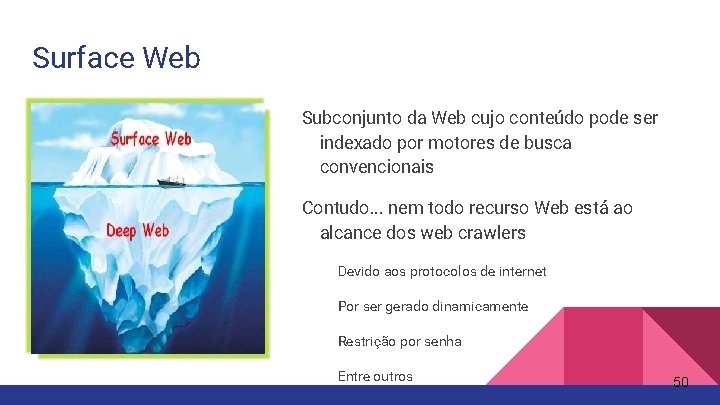
Surface Web Subconjunto da Web cujo conteúdo pode ser indexado por motores de busca convencionais Contudo. . . nem todo recurso Web está ao alcance dos web crawlers Devido aos protocolos de internet Por ser gerado dinamicamente Restrição por senha Entre outros 50
Deep Web Subconjunto da Web que não faz parte da Surface Web Motores de busca tradicionais não conseguem enxergar esse conteúdo em sua maioria, é criado dinamicamente como resultado de uma query Más práticas e negligência, entre outras causas, também podem tornar um site invisível. 51
Deep Web 2001 A Internet era composta de ~ 3 M de domínios A estimativa era de que a Deep Web era entre 400 a 500 vezes maior do que a Surface Web. Isso motivou empresas e grupos de pesquisa a tentar criar formas de navegar nesse enorme oceano e trazer o que era relevante à superfície Contudo. . . A melhor maneira automatizada de navegar na Deep Web ainda é matéria de pesquisa. 52
Site. Map Criado pelo Google em 2005 Protocolo que dá ao administrador de um website a possibilidade de informar a motores de busca todas as URLs disponíveis no seu domínio É um arquivo com os endereços das URLs do domínio Metadados associados às páginas Data de criação, período de atualização, importância dentro do domínio, conteúdo das páginas (vídeo, imagem, . . . ) 53
O Deep. Web Crawler da Google Mesmo com Sitemap, ainda há muito que se pode aproveitar da Deep Web Deep. Web Crawler Outro caminho para incorporar conteúdo relevante ao índice do Google O módulo afeta 1000 das 35 000 pesquisas por segundo Todavia, o volume inexplorado ainda é muito grande 54
The Onion Router (TOR) 55
The Onion Router (TOR) Software que provê anonimato na Internet Redireciona o tráfego para uma rede voluntária espalhada pelo mundo todo para mascarar a posição de um determinado usuário Foi criado com o intuito de proteger a privacidade As mensagens são criptografadas inúmeras vezes, em cada ponto da rede. Cada membro da rede (onion router) decifra apenas uma camada para obter as instruções de roteamento e, logo após, envia o restante do pacote para o próximo membro 56
The Onion Router (TOR) Pode ser usado também por servidores. Servidores que só se comunicam através de TOR são denominados serviços escondidos. Serviços e websites que utilizam TOR não podem ser indexados por motores de busca. Infelizmente, é amplamente utilizado por criminosos de todo tipo. 57
Conclusão 58
Conclusão A Internet cresce de forma rápida e não estruturada Aumento da demanda de armazenamento e processamento de sistemas de RI Necessidades de ferramentas de RI mais eficientes Apesar dos avanços, é muito difícil resolver estes problemas de forma definitiva 59
Sistemas RI na Web Daniel Bezerra, Jairo Matheus, Miguel Wanderlei {db, jmva, mdsw}@cin. ufpe. br
- Slides: 60