
Relation de subsumption entre schmas de types Donnes
Relation de subsumption entre schémas de types Données semi-structurées et typage de données
Au sommaire… ü ü ü Introduction 1. Données semi-structurées 2. Modéliser des données semi-structurées 3. Subsumption entre schémas Conclusion Bibliographie
Introduction ü ü ü Le Web : une base de données géante non structurée Comment concevoir un SGBD adapté au Web ? Plus généralement : comment mutualiser des informations homogènes à partir de sources de données hétérogènes ? Les SGBD standards ne supportent pas l’hétérogénéité… Il faut faire appel à des modèles plus flexibles qui s’adaptent à la forme des données plutôt que de l’imposer.
1. Données semi-structurées ü ü Quelques définitions Quelques propriétés Quelques enjeux Et quelques problèmes !
Quelques définitions ü ü ü Première définition : toute forme de données n’étant ni une base de données ni de la donnée brute… => champ de définition large Deuxième définition : toute forme de données possédant une structure implicite, non rattachée à un schéma => données auto-descriptives Exemples : => page Web => texte => document XML
Quelques propriétés ü ü Propriétés des données : => données auto-descriptives => données hétérogènes Propriétés de la structure : => structure implicite => structure irrégulière => peu de contraintes Confusion entre données et structure Pas de connaissances a priori de la structure
Quelques enjeux ü ü ü ü Flexibilité de l’échange de données Intégration de données Gestion de l’hétérogénéité Système qui s’adapte aux données et non pas le contraire Augmentation des possibilités de requêtage Définir des schémas de données Correspondance entre schémas => subsumption
Quelques problèmes ü ü Les SGBD standard ne sont pas adaptés => ne supportent pas l’hétérogénéité => niveau de contrainte trop élevé => structure explicite et régulière => connaissance du schéma obligatoire Comment modéliser les données semi-structurées ?
2. Modéliser des données semi-structurées ü ü Modèle de données Modèle OEM Schéma de types Assignation de schémas
Modèle de données ü ü Graphe étiqueté, orienté, avec un nœud racine => arcs orientés et étiquetés => un nœud racine unique => presque un arbre Exemple : description des personnages de la bande dessinée Astérix
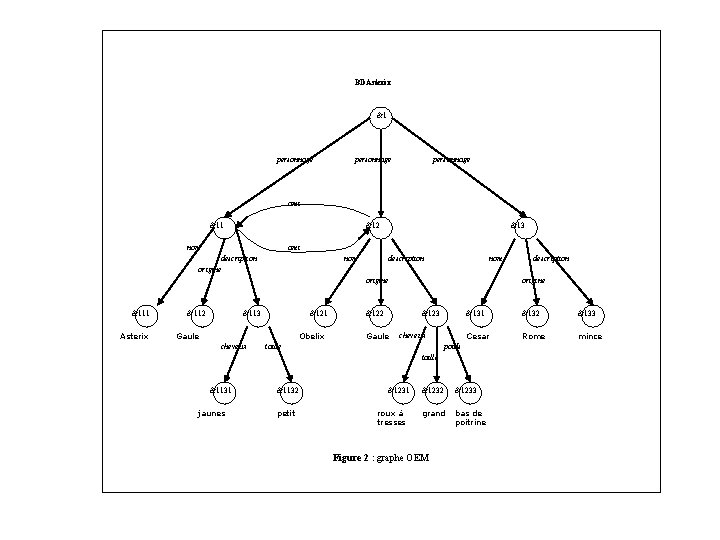
BDAsterix &1 personnage ami &11 &12 &13 ami nom description origine nom description nom origine &111 Asterix &112 &113 &121 Gaule Obelix cheveux origine &122 &123 Gaule cheveux taille &131 &132 &133 Cesar Rome mince poids taille &1131 jaunes &1132 petit description &1231 roux à tresses &1232 &1233 grand bas de poitrine Figure 2 : graphe OEM
Modèle OEM ü ü ü OEM : Object Exchange Model => Tsimmis Project de Stanford Modèle minimaliste permettant de représenter un grand nombre de formes de données, dont les BD standard Nœuds = objets avec oid => objets atomiques vs objets complexes => o. atomiques : int, string, … = nœuds-feuilles => o. complexes : {(étiquette, oid)} = nœuds-intermédiaires
Schéma de données (1/2) ü Modèle simplifié => nœud racine unique => arcs orientés => nœuds identifiés (oid) et étiquetés (sauf la racine) => nœuds-références étiquetés avec « & »
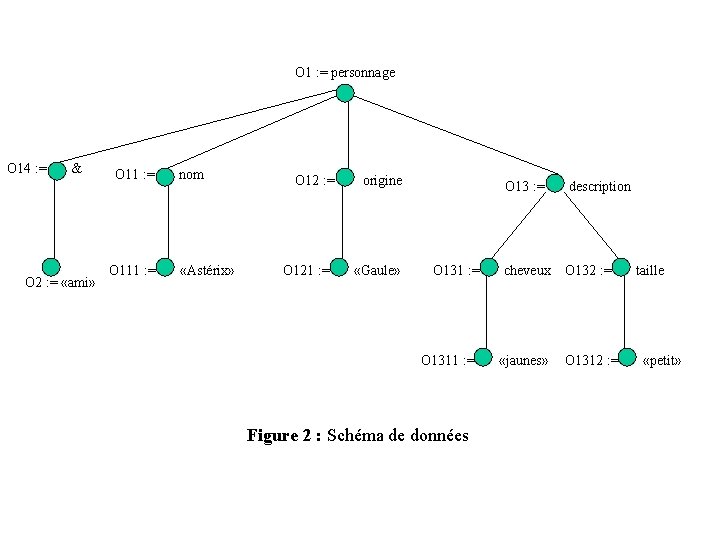
O 1 : = personnage O 14 : = & O 2 : = «ami» O 11 : = nom O 111 : = «Astérix» O 12 : = origine O 121 : = «Gaule» O 13 : = description O 131 : = cheveux O 1311 : = «jaunes» Figure 2 : Schéma de données O 132 : = taille O 1312 : = «petit»
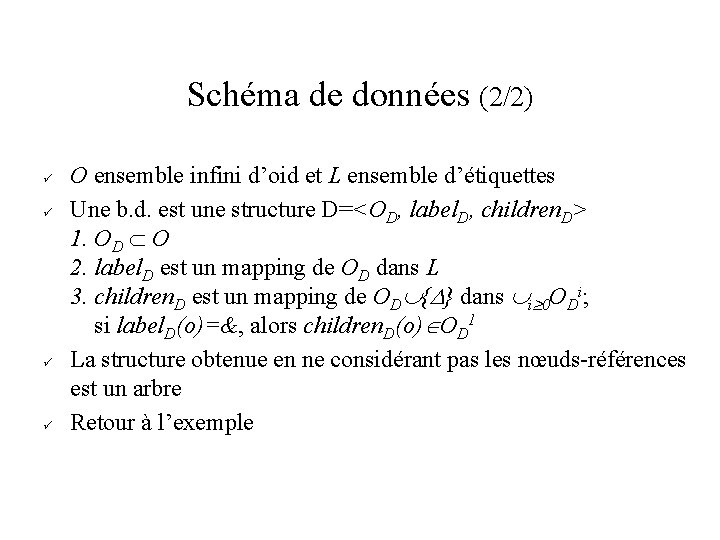
Schéma de données (2/2) ü ü O ensemble infini d’oid et L ensemble d’étiquettes Une b. d. est une structure D=<OD, label. D, children. D> 1. OD O 2. label. D est un mapping de OD dans L 3. children. D est un mapping de OD { } dans i 0 ODi; si label. D(o)=&, alors children. D(o) OD 1 La structure obtenue en ne considérant pas les nœuds-références est un arbre Retour à l’exemple
Schéma de types (1/2) ü ü Exploiter la structure avec un système de typage des données => notion d’objets typés Utilisation d’un schéma de types pour décrire ce système => prédicats sur les étiquettes => expressions régulières sur les descendants
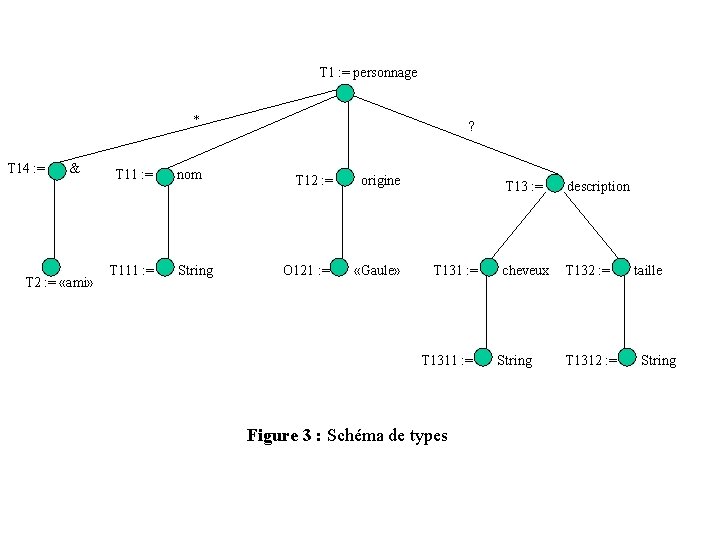
T 1 : = personnage * T 14 : = & T 2 : = «ami» ? T 11 : = nom T 12 : = origine T 111 : = String O 121 : = «Gaule» T 13 : = description T 131 : = cheveux T 1311 : = String Figure 3 : Schéma de types T 132 : = taille T 1312 : = String
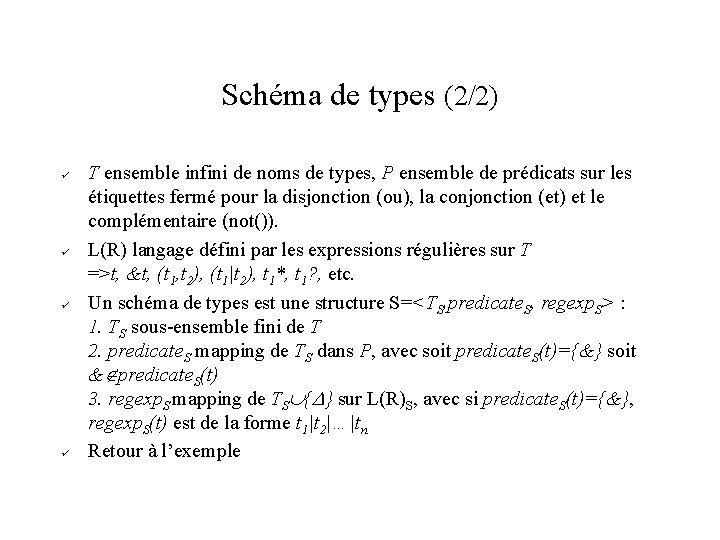
Schéma de types (2/2) ü ü T ensemble infini de noms de types, P ensemble de prédicats sur les étiquettes fermé pour la disjonction (ou), la conjonction (et) et le complémentaire (not()). L(R) langage défini par les expressions régulières sur T =>t, &t, (t 1, t 2), (t 1|t 2), t 1*, t 1? , etc. Un schéma de types est une structure S=<TS, predicate. S, regexp. S> : 1. TS sous-ensemble fini de T 2. predicate. S mapping de TS dans P, avec soit predicate. S(t)={&} soit & predicate. S(t) 3. regexp. S mapping de TS { } sur L(R)S, avec si predicate. S(t)={&}, regexp. S(t) est de la forme t 1|t 2|…|tn Retour à l’exemple
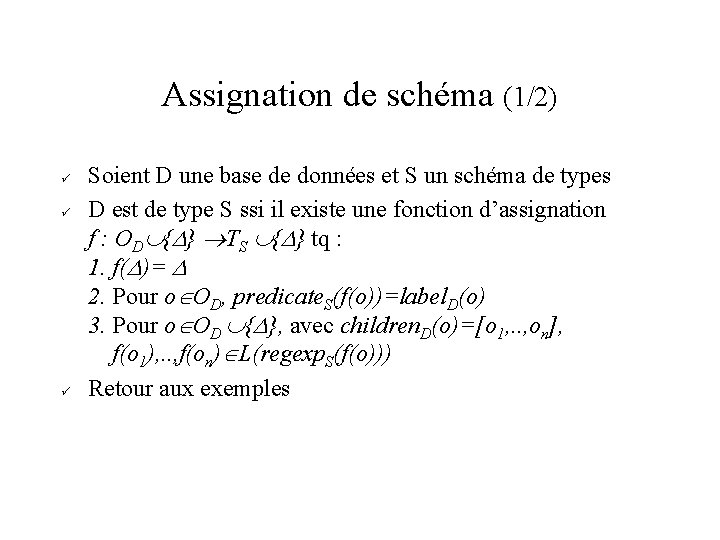
Assignation de schéma (1/2) ü ü ü Soient D une base de données et S un schéma de types D est de type S ssi il existe une fonction d’assignation f : OD { } TS { } tq : 1. f( )= 2. Pour o OD, predicate. S(f(o))=label. D(o) 3. Pour o OD { }, avec children. D(o)=[o 1, . . , on], f(o 1), . . , f(on) L(regexp. S(f(o))) Retour aux exemples
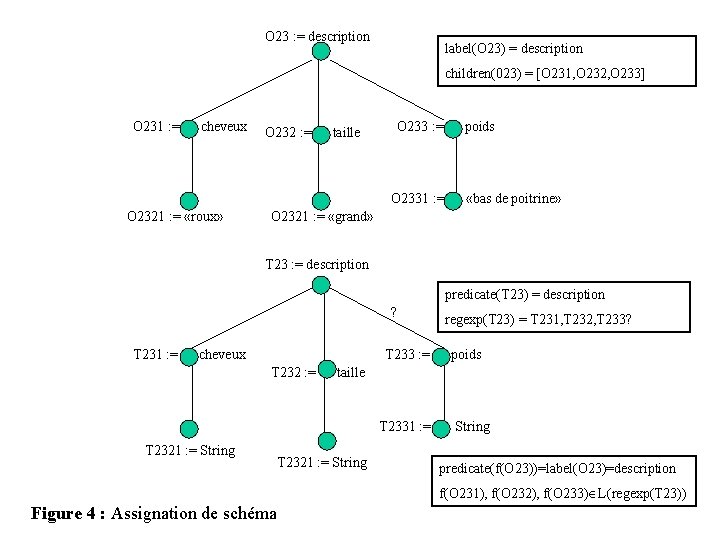
O 23 : = description label(O 23) = description children(023) = [O 231, O 232, O 233] O 231 : = cheveux O 232 : = taille O 233 : = poids O 2331 : = «bas de poitrine» O 2321 : = «roux» O 2321 : = «grand» T 23 : = description predicate(T 23) = description ? T 231 : = cheveux regexp(T 23) = T 231, T 232, T 233? T 233 : = poids T 232 : = taille T 2331 : = String T 2321 : = String predicate(f(O 23))=label(O 23)=description f(O 231), f(O 232), f(O 233) L(regexp(T 23)) Figure 4 : Assignation de schéma
Assignation de schéma (2/2) ü ü Première remarque : Il existe un schéma minimal Any assignable à toute base de données. Seconde remarque : Pour chaque base de données S, il existe un schéma S ne typant que cette base, noté S[D].
3. Subsumption entre schémas ü ü Le problème Subsumption de schémas Propriétés Utilisation de la subsumption
Le problème ü ü ü Comment intégrer des données traitant des informations homogènes provenant de sources hétérogènes ? Quelle correspondance entre 2 schémas de types ? Exemple
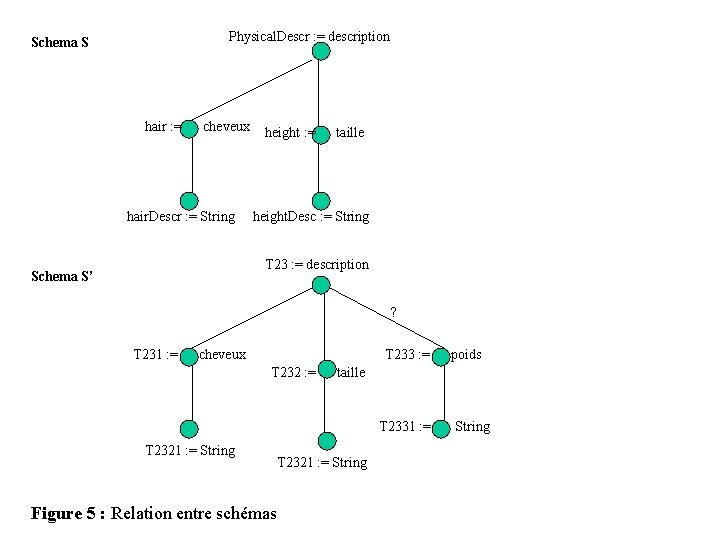
Schema S Physical. Descr : = description hair : = cheveux hair. Descr : = String height : = taille height. Desc : = String T 23 : = description Schema S’ ? T 231 : = cheveux T 233 : = poids T 232 : = taille T 2331 : = String T 2321 : = String Figure 5 : Relation entre schémas
Subsumption de schémas ü ü Définition intuitive: relation de correspondance entre les types de deux schémas, mapping entre deux schémas. => assignation de types entre schémas Soient S et S’ deux schémas de types, S subsume S’ s’il existe une fonction de mapping g: TS { } TS’ { } tq : 1. g(t)= ssi t= 2. t TS, predicate. S(t) predicate. S’(g(t)) 3. t TS { }, g(L(regexp. S(t))) L(regexp. S’(g(t))) Si S subsume S’ et S’ subsume S alors on a une relation d’équivalence entre S et S’ Exemple
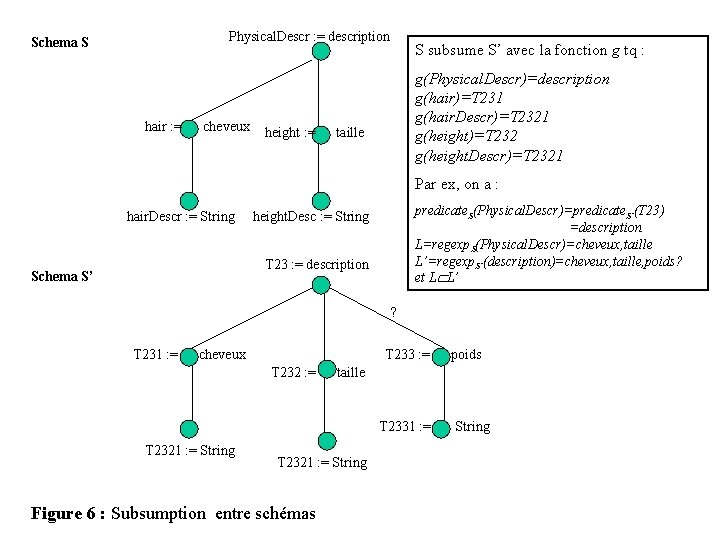
Schema S Physical. Descr : = description hair : = cheveux S subsume S’ avec la fonction g tq : g(Physical. Descr)=description g(hair)=T 231 g(hair. Descr)=T 2321 g(height)=T 232 g(height. Descr)=T 2321 height : = taille Par ex, on a : hair. Descr : = String predicate. S(Physical. Descr)=predicate. S’(T 23) =description L=regexp. S(Physical. Descr)=cheveux, taille L’=regexp. S’(description)=cheveux, taille, poids? et L L’ height. Desc : = String T 23 : = description Schema S’ ? T 231 : = cheveux T 233 : = poids T 232 : = taille T 2331 : = String T 2321 : = String Figure 6 : Subsumption entre schémas
Propriétés de la subsumption ü ü S[D] subsume tout schéma assignable à D La relation de subsumption est transitive Si S est assignable à D et S subsume S’ alors S’ est assignable a D => utile pour la validation de schémas Avantages : => travail sur des schémas (tailles < taille des données) => pas d’accès direct aux données
Utilisation de la subsumption ü ü Idée forte : accéder aux données par le schéma le plus adéquat Système de requêtes : pour une requête donnée, indépendante d’un schéma, trouver le schéma permettant d’obtenir le résultat borne inférieure pour le relation de susbsumption : pour deux schémas, il existe un schéma maximal subsumant les deux autres. => optimiser les informations de typage communes => détermination du bon schéma Systèmes de requêtes, systèmes de stockage, intégration…
Conclusion ü ü ü Notion théorique l’on retrouve dans de nombreux travaux sur les données semi-structurées : XML Schema, YATL, etc. Le typage de données est d’une grande complexité => la subsumption permet de travailler sur des schémas plutôt que sur les bases de données directement Améliorer les systèmes de requêtes est l’une des principales motivations
Bibliographie ü ü Subsumption for XML types - Gabriel M Kuper & Jérôme Siméon (2001) Semi-structured data - Peter Buneman (1997) Querying semi-structured data - Serge Abiteboul (1997) Adding structure to unstructured data - Peter Buneman, Susan Davidson, Duan Fernandez, Dan suciu (1997)
- Slides: 30