
Regresin Linear Correlacin de Pearson r Regresin Mltiple
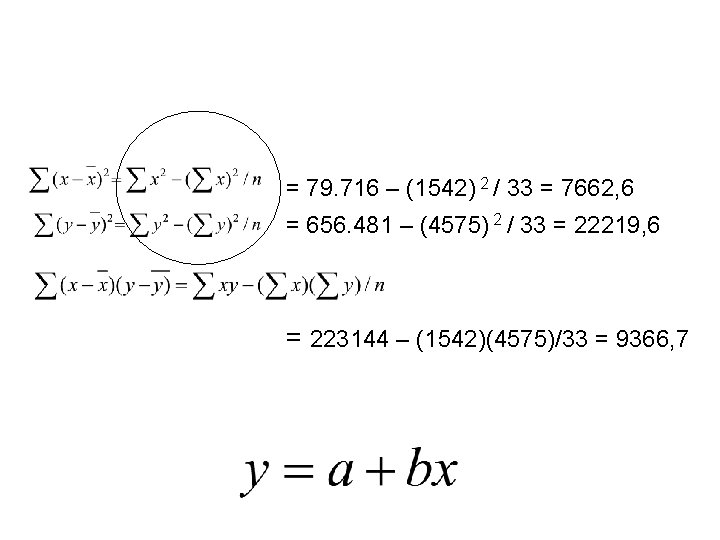
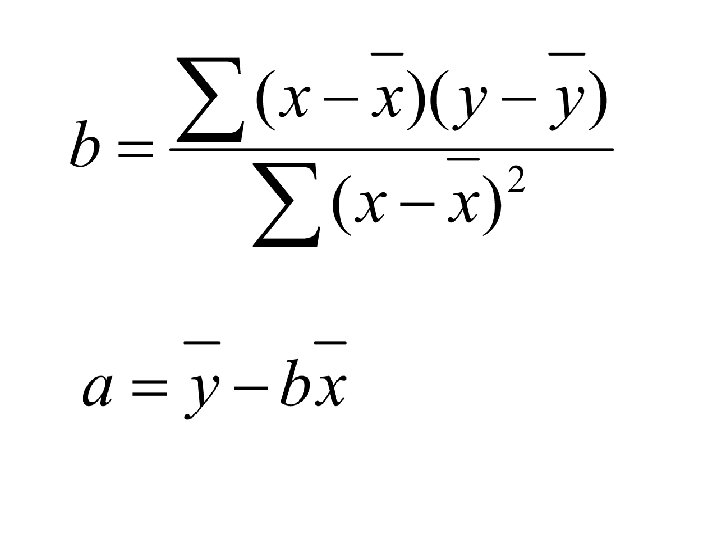
- Slides: 68
Regresión Linear Correlación de Pearson, r Regresión Múltiple Regresión Logística Regresión de Poisson
Propósitos de RL • Evaluar si las dos variables están asociadas (r) • Predecir en base a una variable, ¿qué se obtiene de la otra? (ARS) • Evaluar grado de concordancia entre los valores de las dos variables (ARS)
Supuestos 1. Existencia (para cualquier valor de la variable X, Y es una variable al azar con una cierta probabilidad de distrib teniendo un promedio y varianza finitos) 2. Independencia (los valores de Y son estadísticamente independientes uno de otro). 3. Linearidad (el promedio de Y es una función linear de X)
4. Homocedasticidad (La varianza de Y es la misma para cualquier X) 5. Distribución normal (Para cualquier valor de X, Y tiene distribución normal)
Variables • Dependiente: eje Y • Independiente: eje X • Intervalares • Distribución normal • Gráfico: PLOT DE DISPERSIÓN • Pares de observaciones
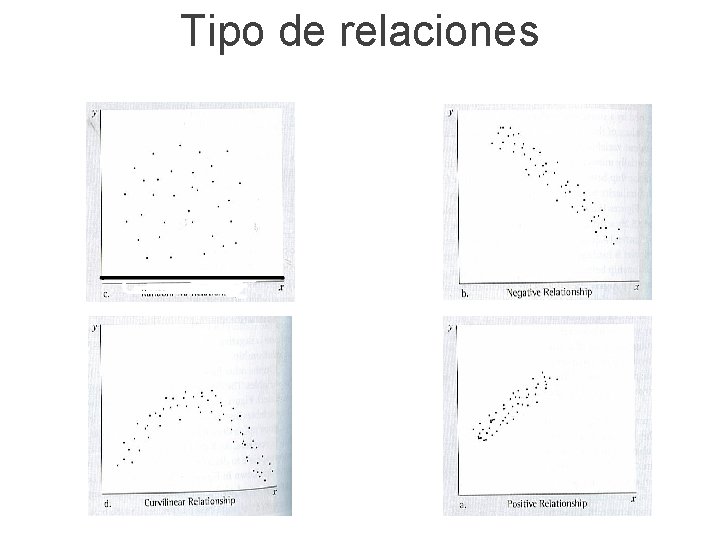
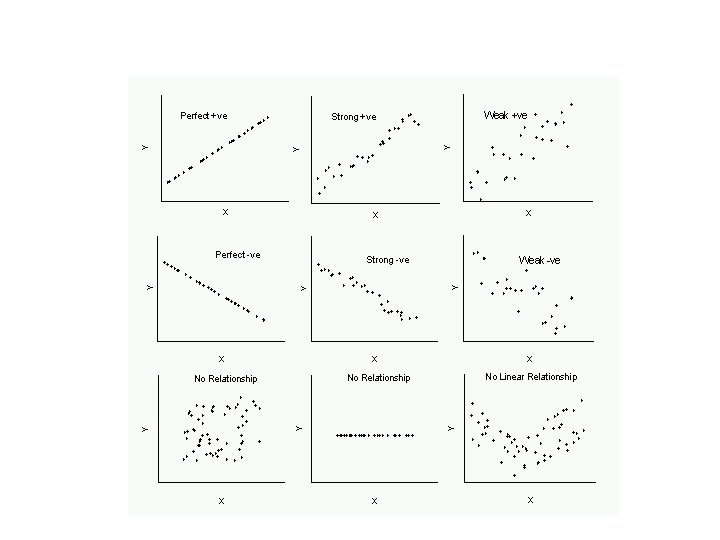
Tipo de relaciones
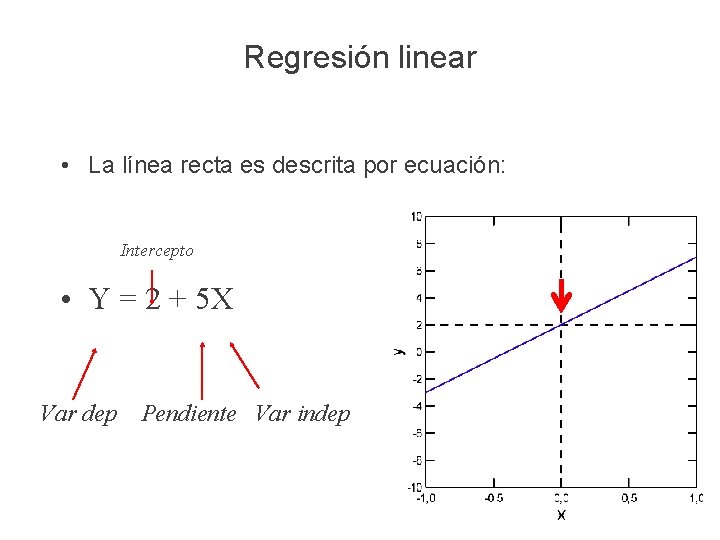
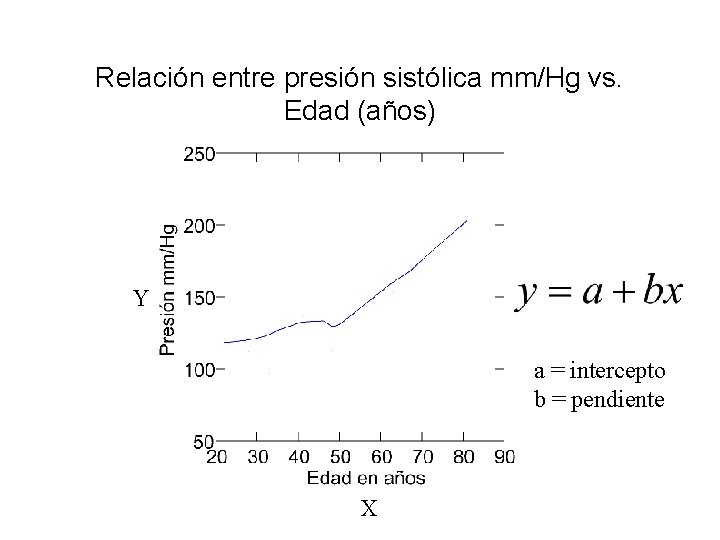
Regresión linear • La línea recta es descrita por ecuación: Intercepto • Y = 2 + 5 X Var dep FPLOT y = x+2 Pendiente Var indep
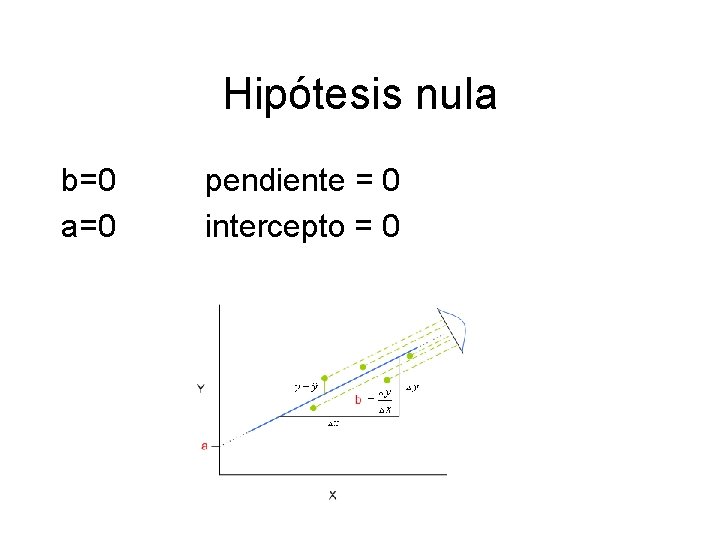
Hipótesis nula b=0 a=0 pendiente = 0 intercepto = 0
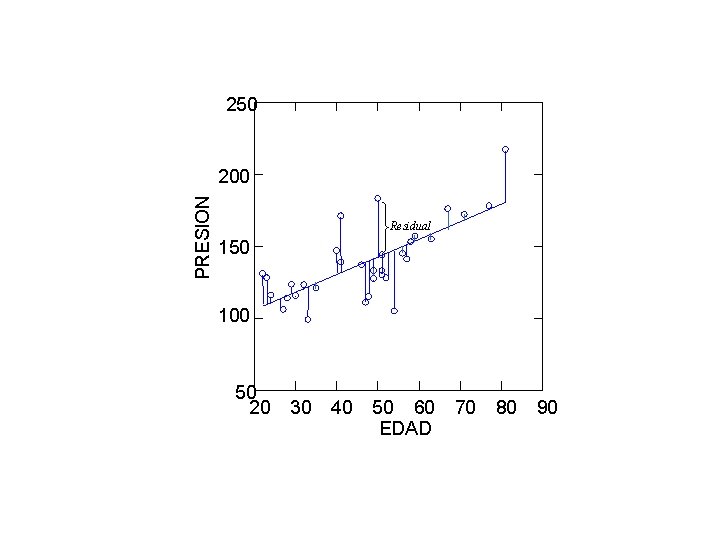
Relación entre presión sistólica mm/Hg vs. Edad (años) Y a = intercepto b = pendiente X
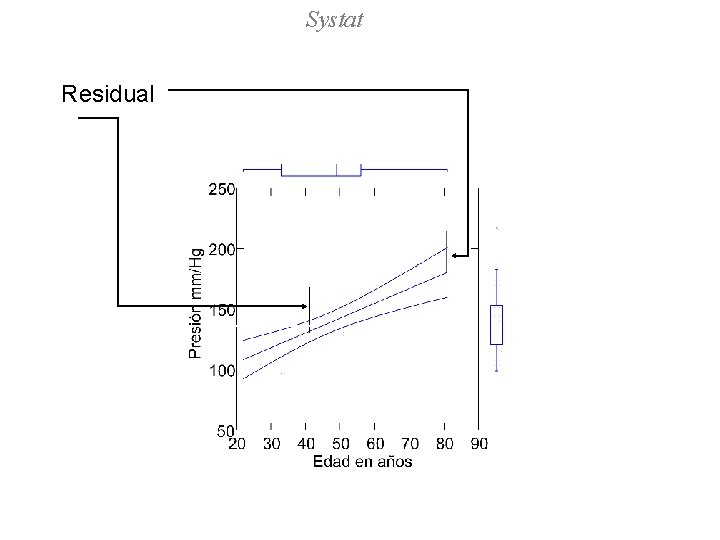
Systat Residual
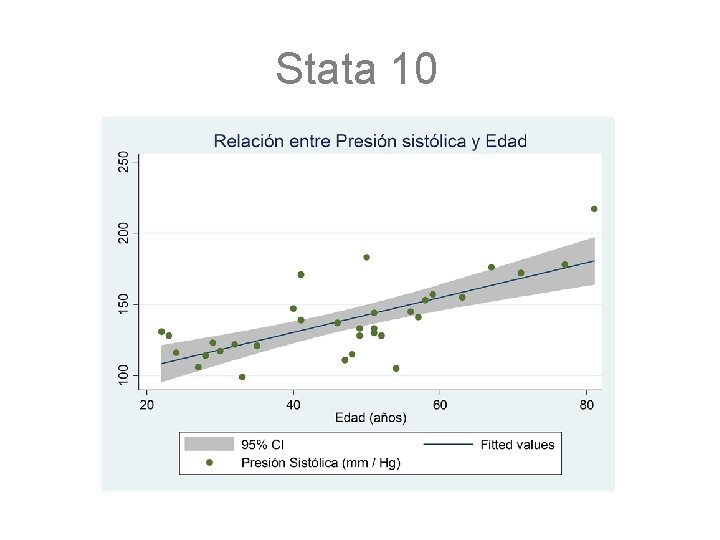
Stata 10
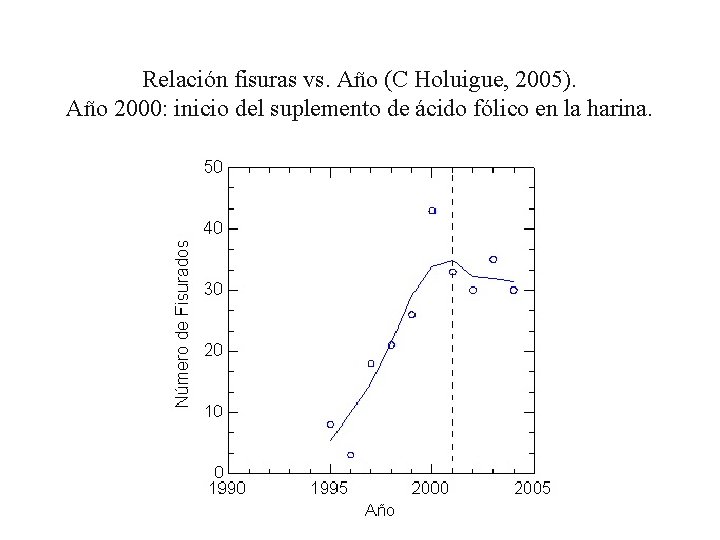
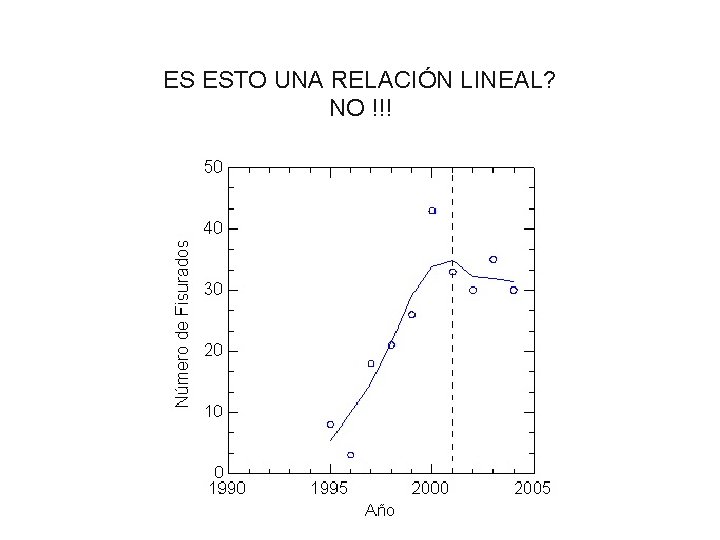
Relación fisuras vs. Año (C Holuigue, 2005). Año 2000: inicio del suplemento de ácido fólico en la harina.
ES ESTO UNA RELACIÓN LINEAL? NO !!!
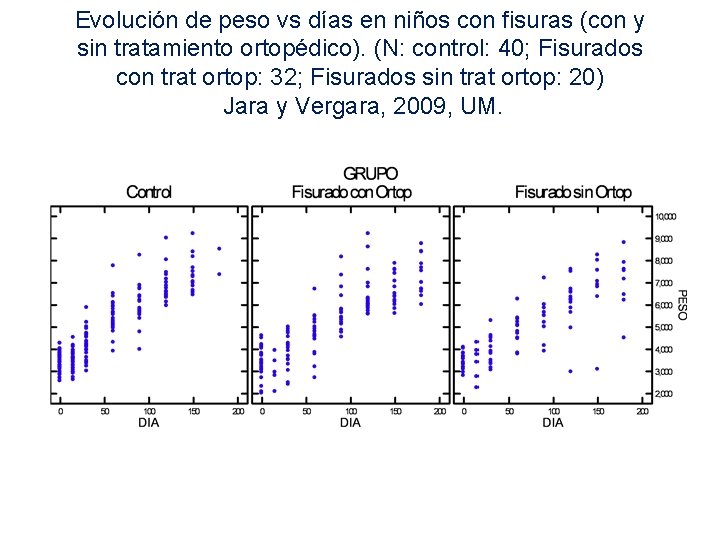
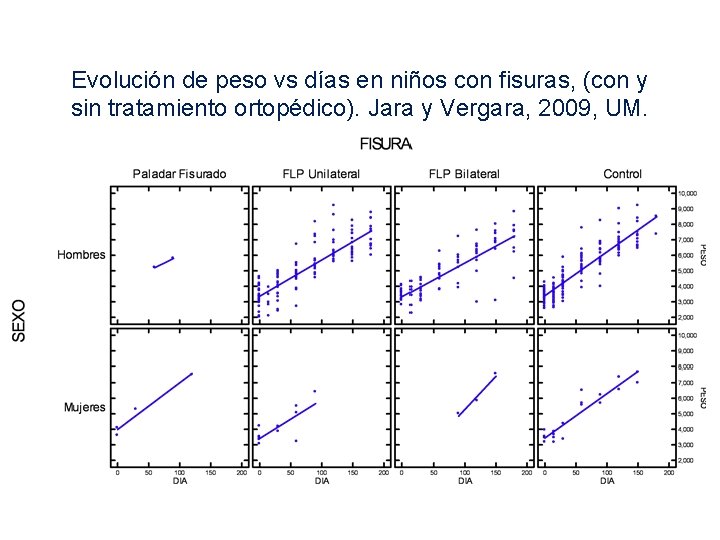
Evolución de peso vs días en niños con fisuras (con y sin tratamiento ortopédico). (N: control: 40; Fisurados con trat ortop: 32; Fisurados sin trat ortop: 20) Jara y Vergara, 2009, UM.
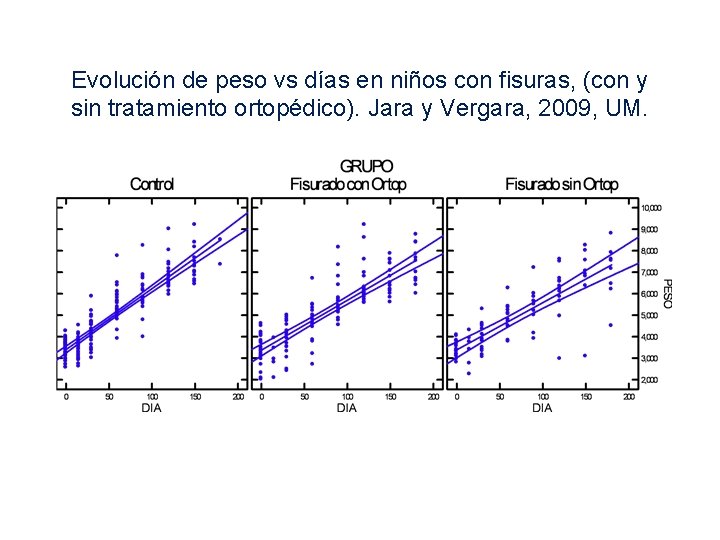
Evolución de peso vs días en niños con fisuras, (con y sin tratamiento ortopédico). Jara y Vergara, 2009, UM.
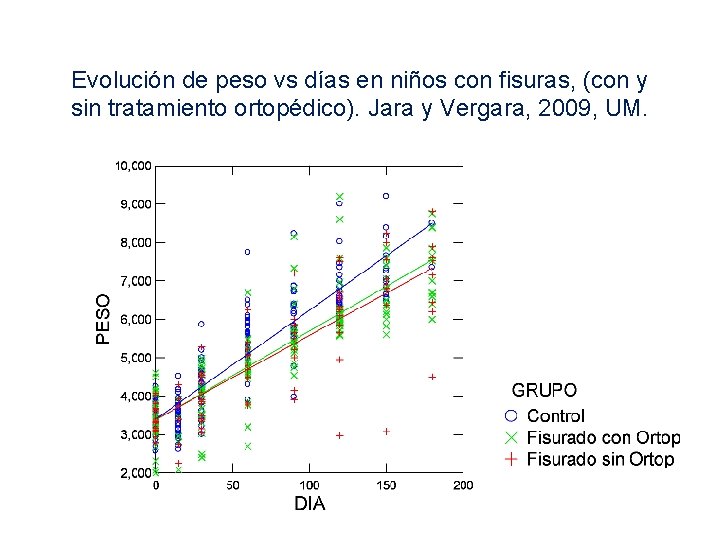
Evolución de peso vs días en niños con fisuras, (con y sin tratamiento ortopédico). Jara y Vergara, 2009, UM.
Evolución de peso vs días en niños con fisuras, (con y sin tratamiento ortopédico). Jara y Vergara, 2009, UM.
Requisitos • Las dos variables deben ser continuas • Deben ser independientes una de la otra • Deben tener distribución normal
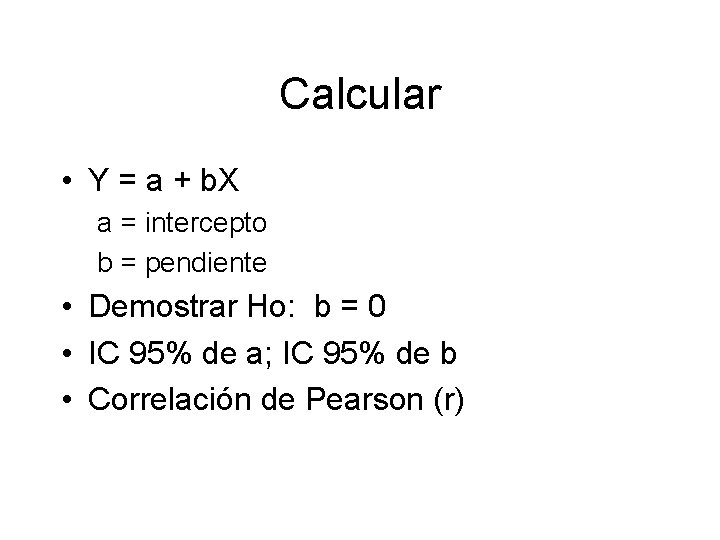
Calcular • Y = a + b. X a = intercepto b = pendiente • Demostrar Ho: b = 0 • IC 95% de a; IC 95% de b • Correlación de Pearson (r)
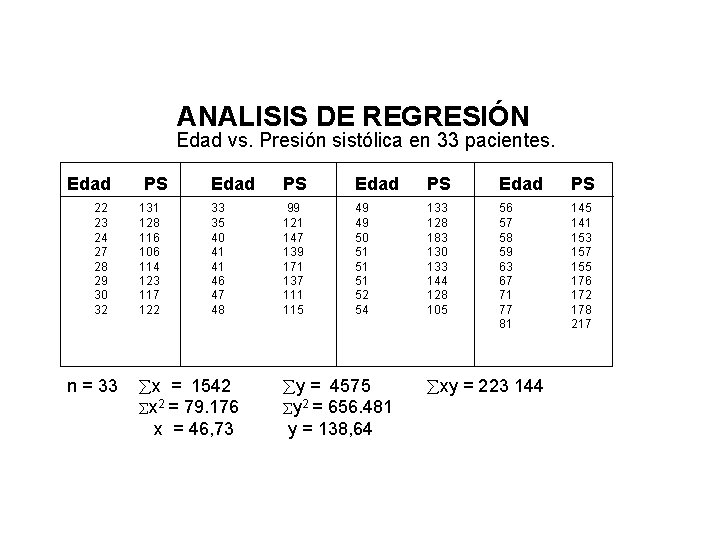
ANALISIS DE REGRESIÓN Edad vs. Presión sistólica en 33 pacientes. Edad 22 23 24 27 28 29 30 32 n = 33 PS 131 128 116 106 114 123 117 122 Edad PS 33 35 40 41 41 46 47 48 99 121 147 139 171 137 111 115 49 49 50 51 51 51 52 54 133 128 183 130 133 144 128 105 56 57 58 59 63 67 71 77 81 145 141 153 157 155 176 172 178 217 åx = 1542 åx 2 = 79. 176 x = 46, 73 åy = 4575 åy 2 = 656. 481 y = 138, 64 åxy = 223 144
= 79. 716 – (1542) 2 / 33 = 7662, 6 = 656. 481 – (4575) 2 / 33 = 22219, 6 = 223144 – (1542)(4575)/33 = 9366, 7
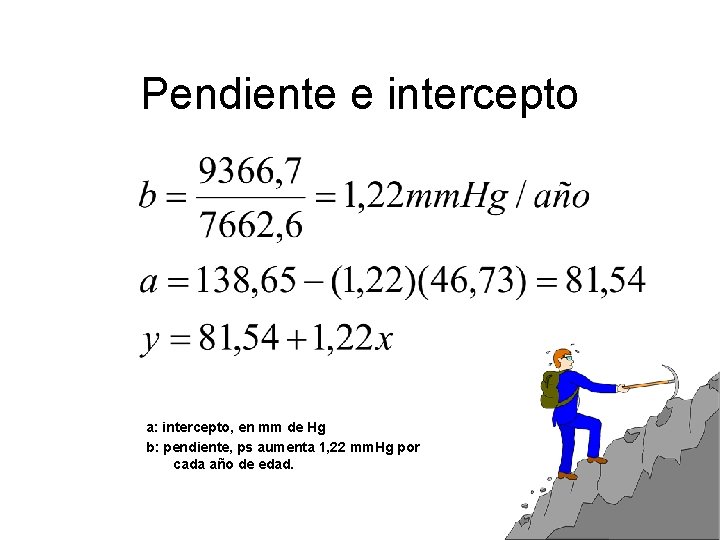
Pendiente e intercepto a: intercepto, en mm de Hg b: pendiente, ps aumenta 1, 22 mm. Hg por cada año de edad.
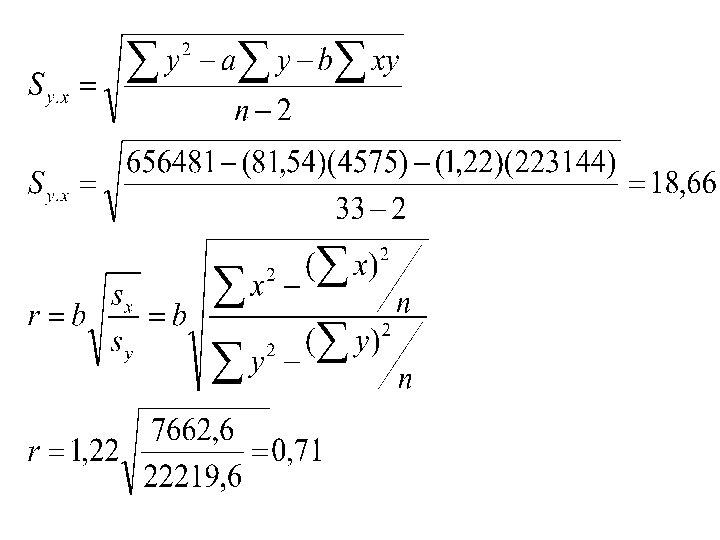
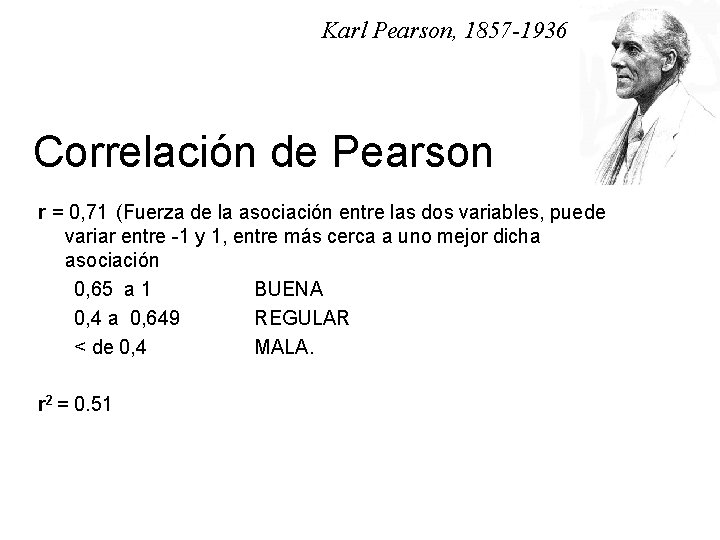
Karl Pearson, 1857 -1936 Correlación de Pearson r = 0, 71 (Fuerza de la asociación entre las dos variables, puede variar entre -1 y 1, entre más cerca a uno mejor dicha asociación 0, 65 a 1 BUENA 0, 4 a 0, 649 REGULAR < de 0, 4 MALA. r 2 = 0. 51
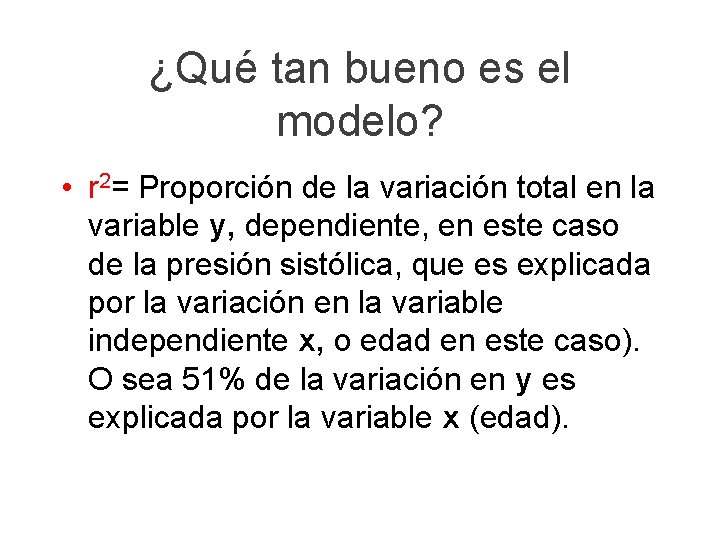
¿Qué tan bueno es el modelo? • r 2= Proporción de la variación total en la variable y, dependiente, en este caso de la presión sistólica, que es explicada por la variación en la variable independiente x, o edad en este caso). O sea 51% de la variación en y es explicada por la variable x (edad).
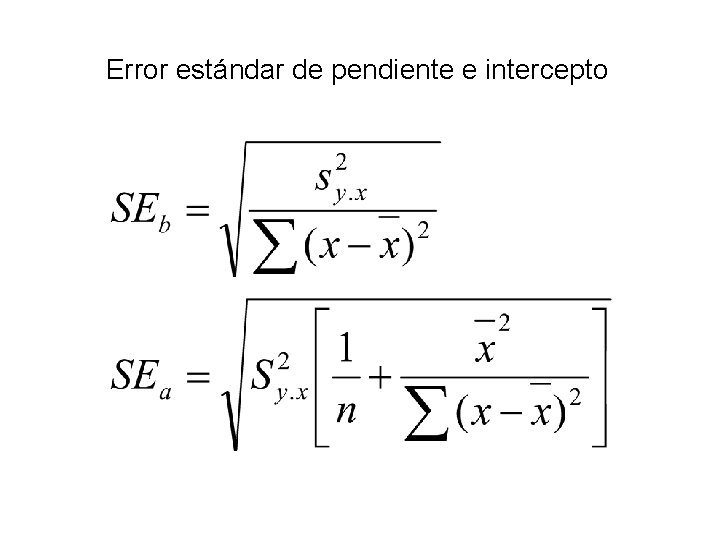
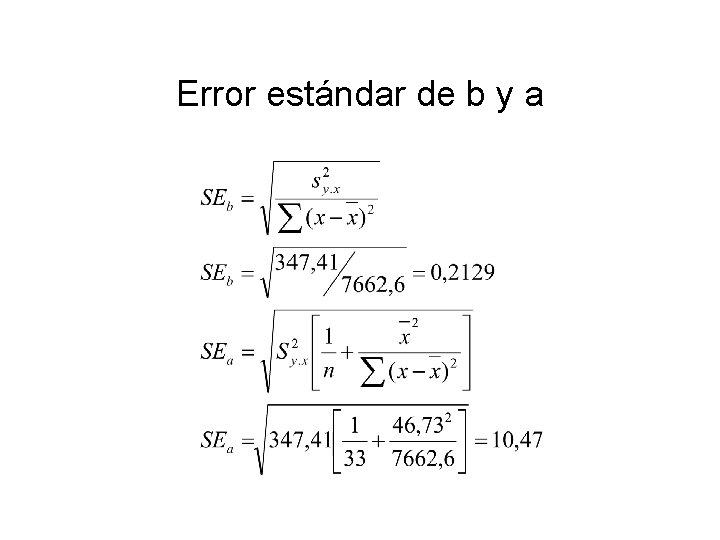
Error estándar de pendiente e intercepto
Error estándar de b y a
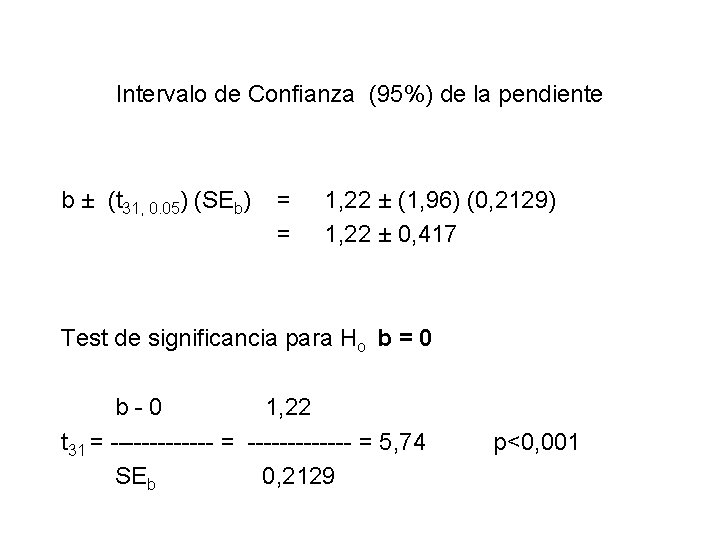
Intervalo de Confianza (95%) de la pendiente b ± (t 31, 0. 05) (SEb) = = 1, 22 ± (1, 96) (0, 2129) 1, 22 ± 0, 417 Test de significancia para Ho b = 0 b-0 1, 22 t 31 = ------------- = 5, 74 SEb 0, 2129 p<0, 001
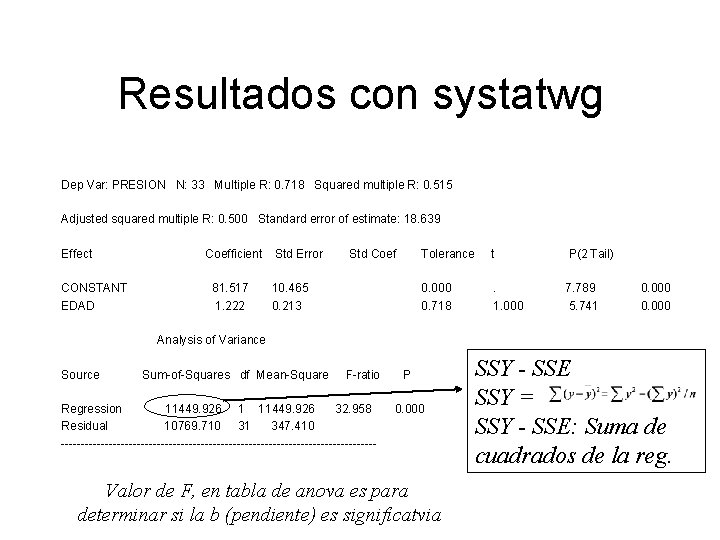
Resultados con systatwg Dep Var: PRESION N: 33 Multiple R: 0. 718 Squared multiple R: 0. 515 Adjusted squared multiple R: 0. 500 Standard error of estimate: 18. 639 Effect CONSTANT EDAD Coefficient 81. 517 1. 222 Std Error Std Coef 10. 465 0. 213 Tolerance t P(2 Tail) 0. 000 0. 718 . 1. 000 7. 789 5. 741 0. 000 Analysis of Variance Source Sum-of-Squares df Mean-Square F-ratio Regression 11449. 926 1 11449. 926 32. 958 Residual 10769. 710 31 347. 410 ---------------------------------------- P 0. 000 Valor de F, en tabla de anova es para determinar si la b (pendiente) es significatvia SSY - SSE SSY = SSY - SSE: Suma de cuadrados de la reg.
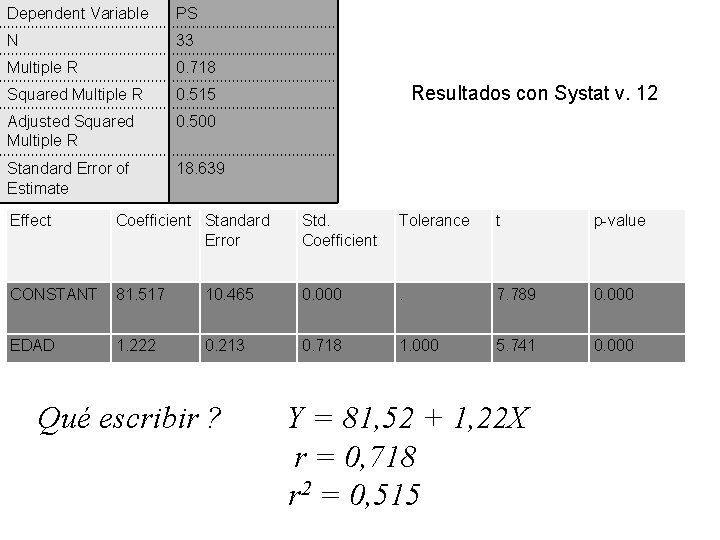
Dependent Variable PS N 33 Multiple R 0. 718 Squared Multiple R 0. 515 Adjusted Squared Multiple R 0. 500 Resultados con Systat v. 12 Standard Error of 18. 639 Estimate Regression Coefficients B = (X'X)-1 X'Y Effect Coefficient Standard Error Std. Coefficient Tolerance t p-value CONSTANT 81. 517 10. 465 0. 000 . 7. 789 0. 000 EDAD 1. 222 0. 213 0. 718 1. 000 5. 741 0. 000 Qué escribir ? Y = 81, 52 + 1, 22 X r = 0, 718 r 2 = 0, 515
250 PRESION 200 Residual 150 100 50 20 30 40 50 60 EDAD 70 80 90
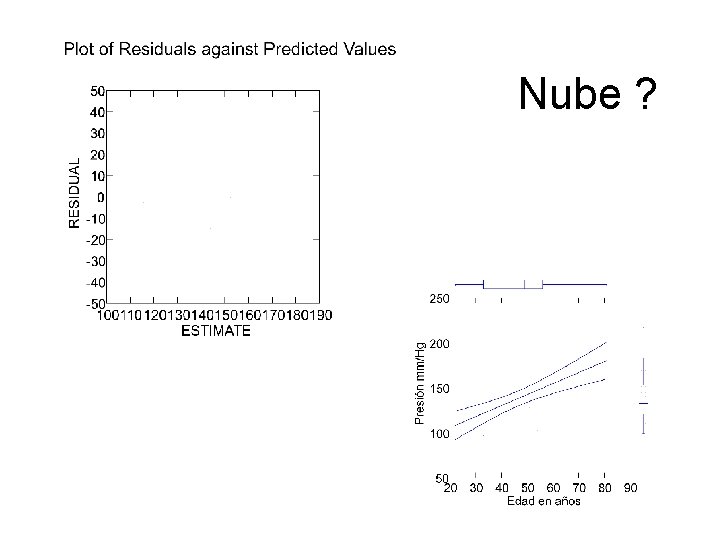
Nube ?
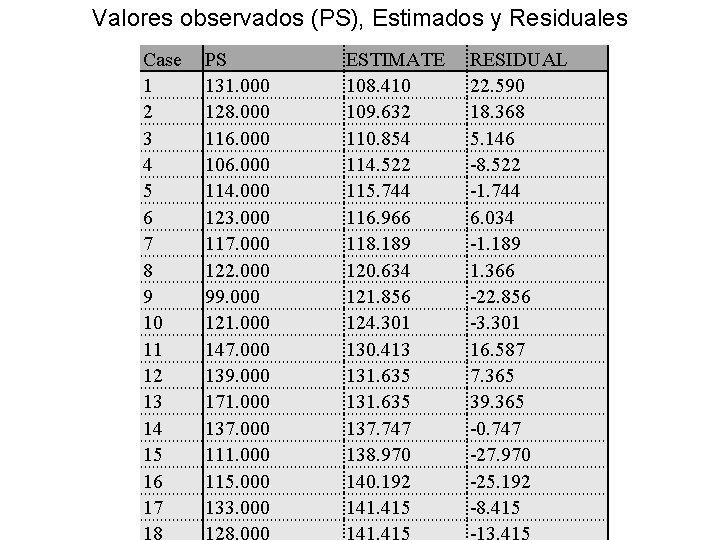
Valores observados (PS), Estimados y Residuales Case 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 PS 131. 000 128. 000 116. 000 106. 000 114. 000 123. 000 117. 000 122. 000 99. 000 121. 000 147. 000 139. 000 171. 000 137. 000 111. 000 115. 000 133. 000 ESTIMATE 108. 410 109. 632 110. 854 114. 522 115. 744 116. 966 118. 189 120. 634 121. 856 124. 301 130. 413 131. 635 137. 747 138. 970 140. 192 141. 415 RESIDUAL 22. 590 18. 368 5. 146 -8. 522 -1. 744 6. 034 -1. 189 1. 366 -22. 856 -3. 301 16. 587 7. 365 39. 365 -0. 747 -27. 970 -25. 192 -8. 415
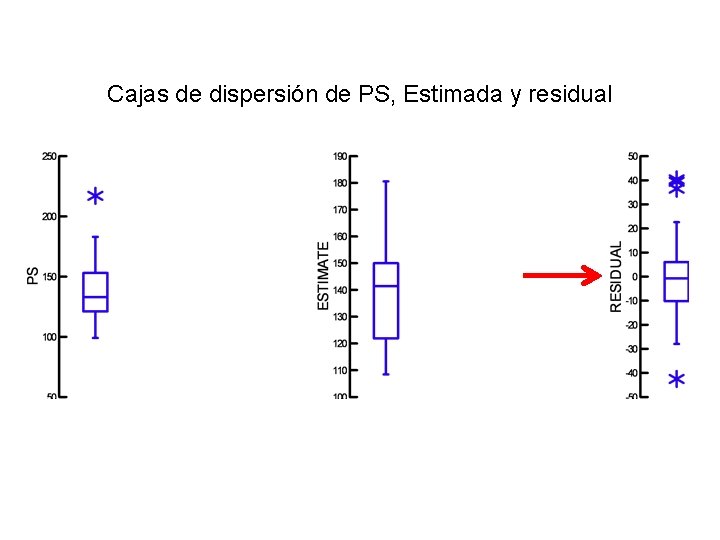
Cajas de dispersión de PS, Estimada y residual
Regresión – Características de una relación (Wilkinson, 1996) ¿Existe? ¿Qué fuerza tiene? ¿Qué tamaño? ¿Qué dirección tiene? ¿Qué patrón tiene?
Existencia de la relación. • El valor de p en la tabla de análisis de varianza de la regresión nos indica si el modelo es significativamente diferente del azar. • Los test t y valores de p asociados con los coeficientes individuales nos indican si existe una relación entre cada variable independiente y la variable dependiente.
Fuerza de la asociación. • Uno no está satisfecho con saber si existe una relación además quiere saber que tan fuerte es. Generalmente la vemos con el valor de R múltiple, el R múltiple al cuadrado, el R cuadrado ajustado, y el error estándar de la media. El mejor de todos es R cuadrado ajustado. • R múltiple al cuadrado indica la proporción de varianza en la variable dependiente que puede ser explicada por la(s) variable(s) independiente(s).
Tamaño de la asociación • A veces uno está interesado en el tamaño de los coeficientes de la regresión más que en demostrar que difieren de 0. • Para esto simplemente ver los valores de los coeficientes.
Dirección de la asociación. • El signo de los coeficientes nos da esta dirección.
Patrón de la asociación. 1 Los plots y los estadísticos basados en los valores residuales nos dan información acerca del patrón de la relación : · Es la relación linear? · Presentan los plots algún valor “escapado”, o fuera de lugar (outlier”)? · Existe indicación por los valores de Cook, residual estandarizado, o Leverage de algún caso influyente? · Están los residuales curvados o por otro lado presentan forma o dirección irregular? En otras palabras deberá agregarse otras variables al modelo? · Los residuales están formando una banda horizontal a lo largo de todo el rango de la variable dependiente? , o sea están los residuales homoscedásticos? · Tienen los residuales una distribución normal? Homocedasticidad: de -homo (igual) y scedastic: disperso
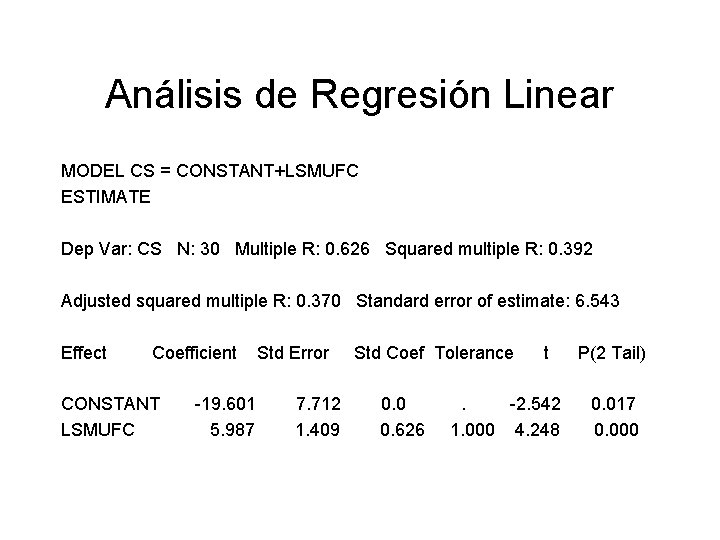
Análisis de Regresión Linear MODEL CS = CONSTANT+LSMUFC ESTIMATE Dep Var: CS N: 30 Multiple R: 0. 626 Squared multiple R: 0. 392 Adjusted squared multiple R: 0. 370 Standard error of estimate: 6. 543 Effect Coefficient CONSTANT LSMUFC -19. 601 5. 987 Std Error 7. 712 1. 409 Std Coef Tolerance 0. 0 0. 626 t . -2. 542 1. 000 4. 248 P(2 Tail) 0. 017 0. 000
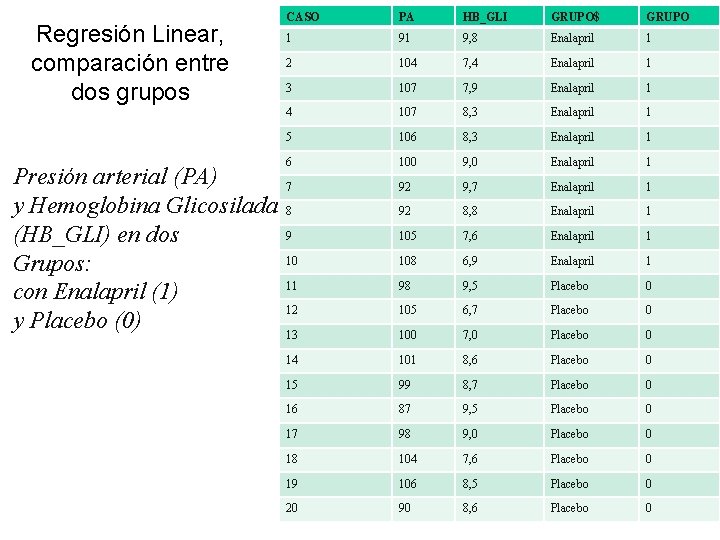
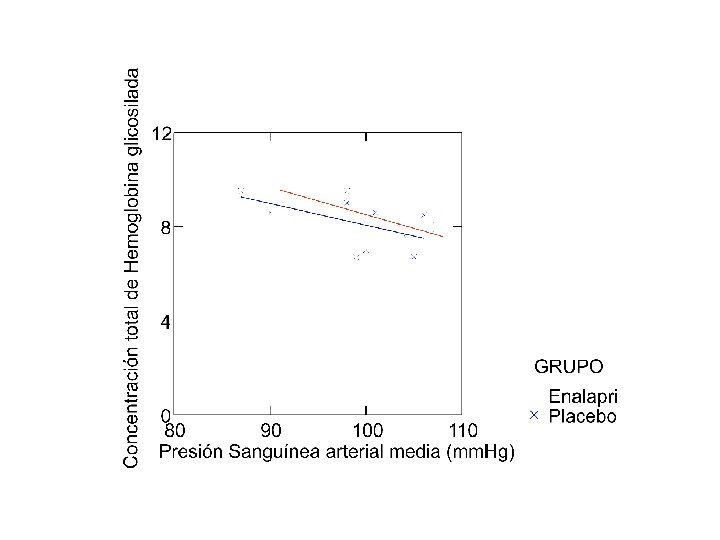
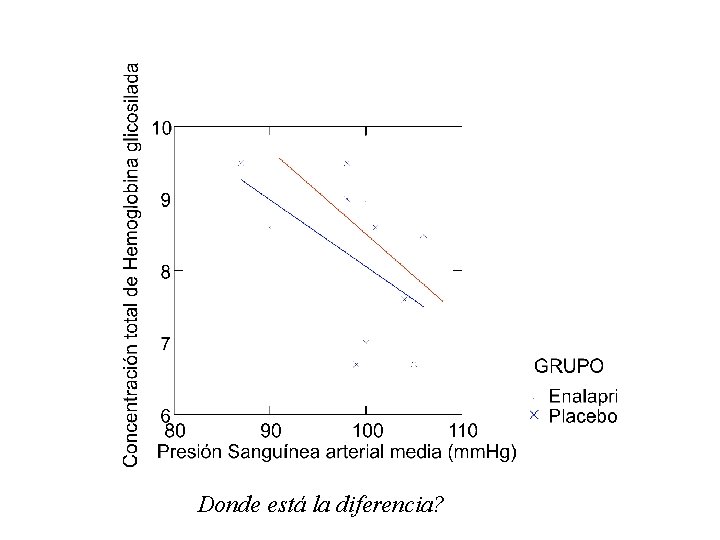
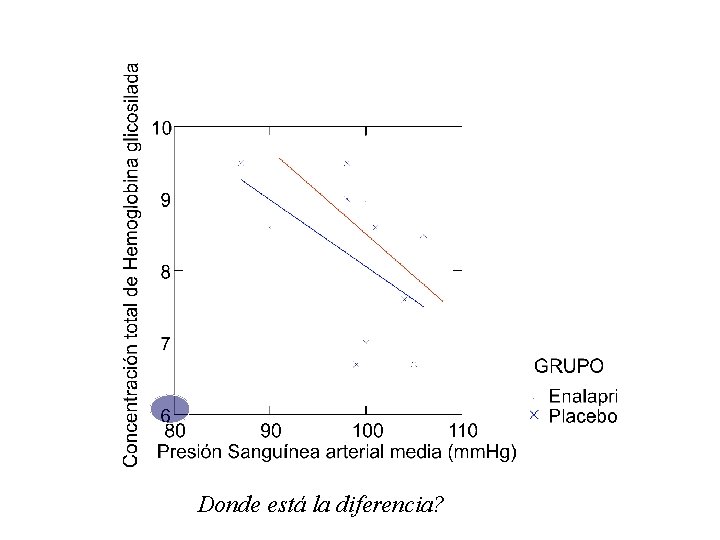
Regresión Linear, comparación entre dos grupos Presión arterial (PA) y Hemoglobina Glicosilada (HB_GLI) en dos Grupos: con Enalapril (1) y Placebo (0) CASO PA HB_GLI GRUPO$ GRUPO 1 91 9, 8 Enalapril 1 2 104 7, 4 Enalapril 1 3 107 7, 9 Enalapril 1 4 107 8, 3 Enalapril 1 5 106 8, 3 Enalapril 1 6 100 9, 0 Enalapril 1 7 92 9, 7 Enalapril 1 8 92 8, 8 Enalapril 1 9 105 7, 6 Enalapril 1 10 108 6, 9 Enalapril 1 11 98 9, 5 Placebo 0 12 105 6, 7 Placebo 0 13 100 7, 0 Placebo 0 14 101 8, 6 Placebo 0 15 99 8, 7 Placebo 0 16 87 9, 5 Placebo 0 17 98 9, 0 Placebo 0 18 104 7, 6 Placebo 0 19 106 8, 5 Placebo 0 20 90 8, 6 Placebo 0
Donde está la diferencia?
Donde está la diferencia?
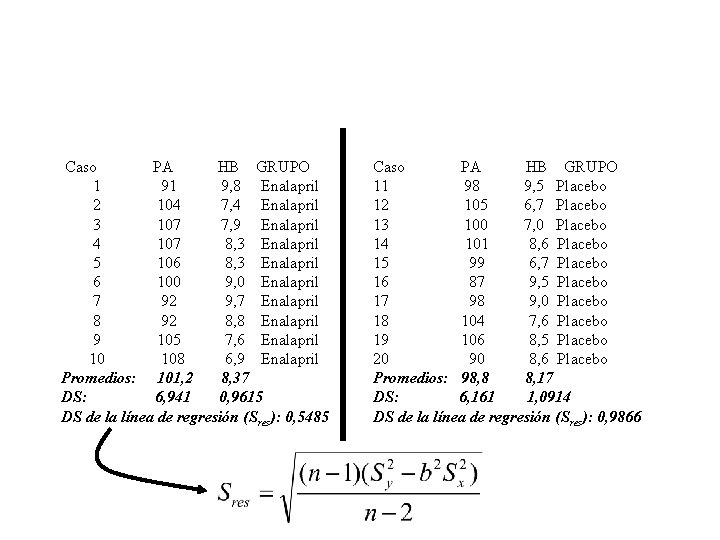
Caso PA HB GRUPO 1 91 9, 8 Enalapril 2 104 7, 4 Enalapril 3 107 7, 9 Enalapril 4 107 8, 3 Enalapril 5 106 8, 3 Enalapril 6 100 9, 0 Enalapril 7 92 9, 7 Enalapril 8 92 8, 8 Enalapril 9 105 7, 6 Enalapril 10 108 6, 9 Enalapril Promedios: 101, 2 8, 37 DS: 6, 941 0, 9615 DS de la línea de regresión (Sres): 0, 5485 Caso PA HB GRUPO 11 98 9, 5 Placebo 12 105 6, 7 Placebo 13 100 7, 0 Placebo 14 101 8, 6 Placebo 15 99 6, 7 Placebo 16 87 9, 5 Placebo 17 98 9, 0 Placebo 18 104 7, 6 Placebo 19 106 8, 5 Placebo 20 90 8, 6 Placebo Promedios: 98, 8 8, 17 DS: 6, 161 1, 0914 DS de la línea de regresión (Sres): 0, 9866
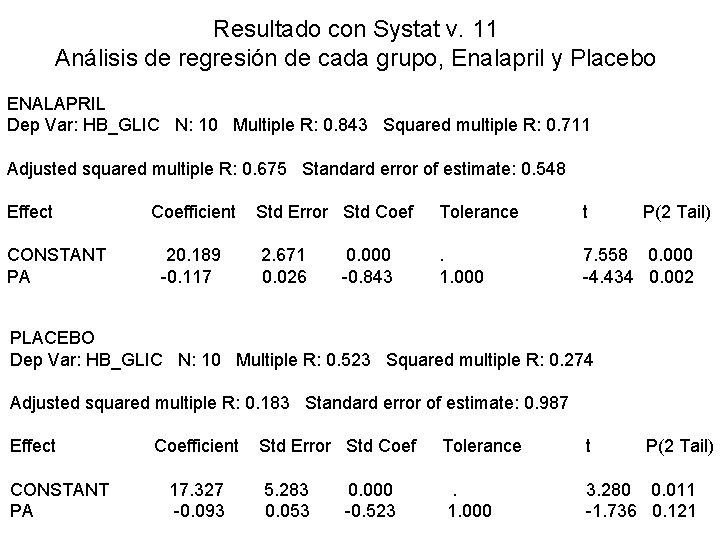
Resultado con Systat v. 11 Análisis de regresión de cada grupo, Enalapril y Placebo ENALAPRIL Dep Var: HB_GLIC N: 10 Multiple R: 0. 843 Squared multiple R: 0. 711 Adjusted squared multiple R: 0. 675 Standard error of estimate: 0. 548 Effect CONSTANT PA Coefficient 20. 189 -0. 117 Std Error Std Coef Tolerance t 2. 671 0. 026 . 1. 000 7. 558 0. 000 -4. 434 0. 002 0. 000 -0. 843 P(2 Tail) PLACEBO Dep Var: HB_GLIC N: 10 Multiple R: 0. 523 Squared multiple R: 0. 274 Adjusted squared multiple R: 0. 183 Standard error of estimate: 0. 987 Effect CONSTANT PA Coefficient 17. 327 -0. 093 Std Error Std Coef Tolerance t 5. 283 0. 053 . 1. 000 3. 280 0. 011 -1. 736 0. 121 0. 000 -0. 523 P(2 Tail)
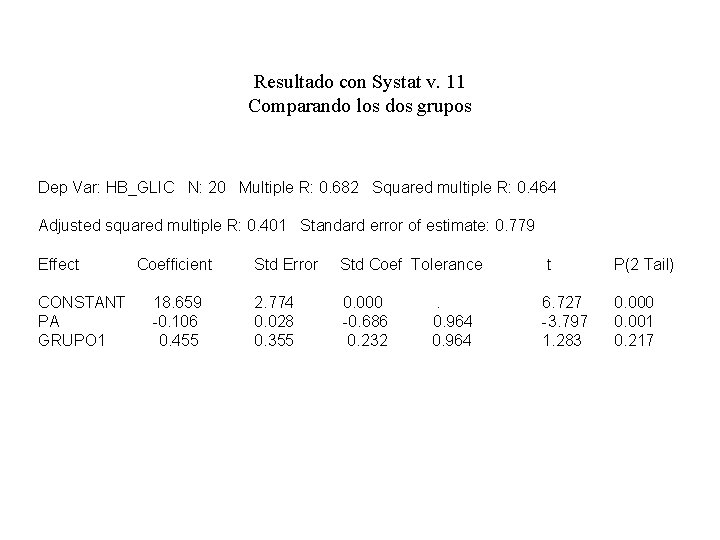
Resultado con Systat v. 11 Comparando los dos grupos Dep Var: HB_GLIC N: 20 Multiple R: 0. 682 Squared multiple R: 0. 464 Adjusted squared multiple R: 0. 401 Standard error of estimate: 0. 779 Effect CONSTANT PA GRUPO 1 Coefficient 18. 659 -0. 106 0. 455 Std Error Std Coef Tolerance t P(2 Tail) 2. 774 0. 028 0. 355 0. 000 -0. 686 0. 232 6. 727 -3. 797 1. 283 0. 000 0. 001 0. 217 . 0. 964
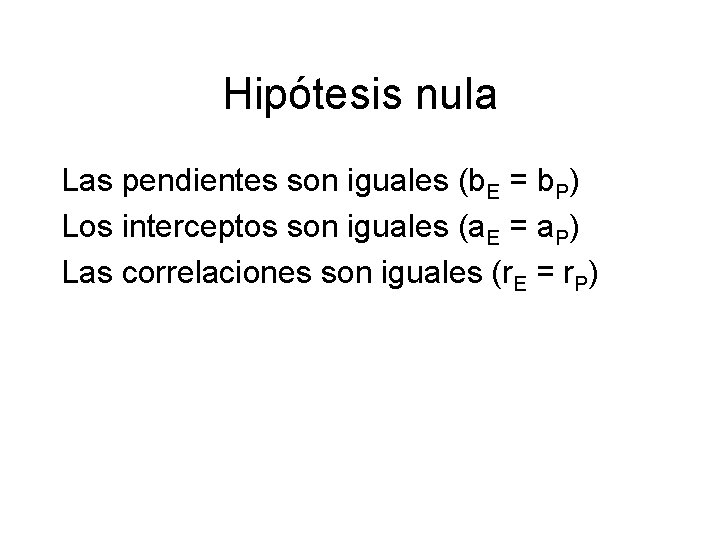
Hipótesis nula Las pendientes son iguales (b. E = b. P) Los interceptos son iguales (a. E = a. P) Las correlaciones son iguales (r. E = r. P)
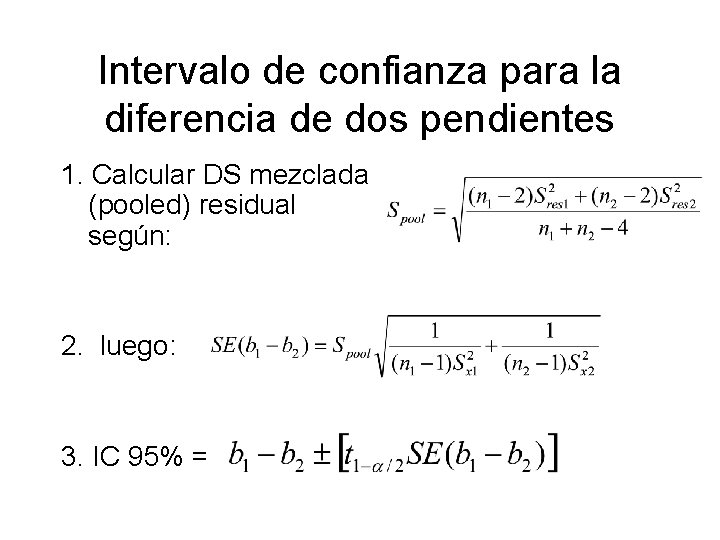
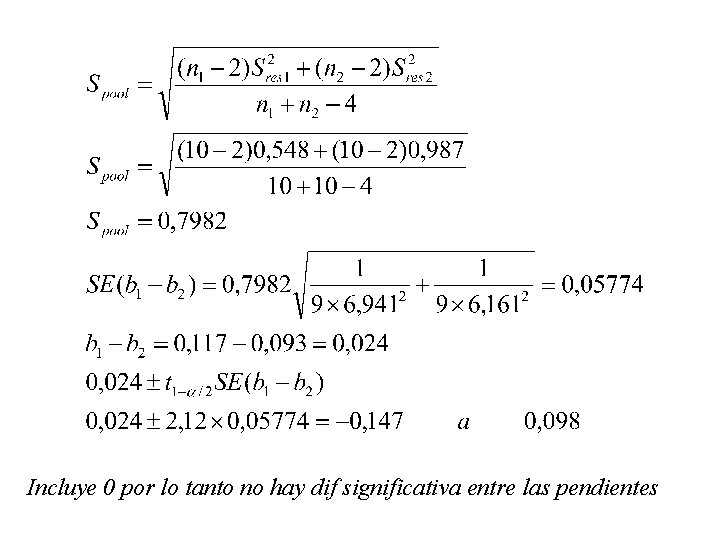
Intervalo de confianza para la diferencia de dos pendientes 1. Calcular DS mezclada (pooled) residual según: 2. luego: 3. IC 95% =
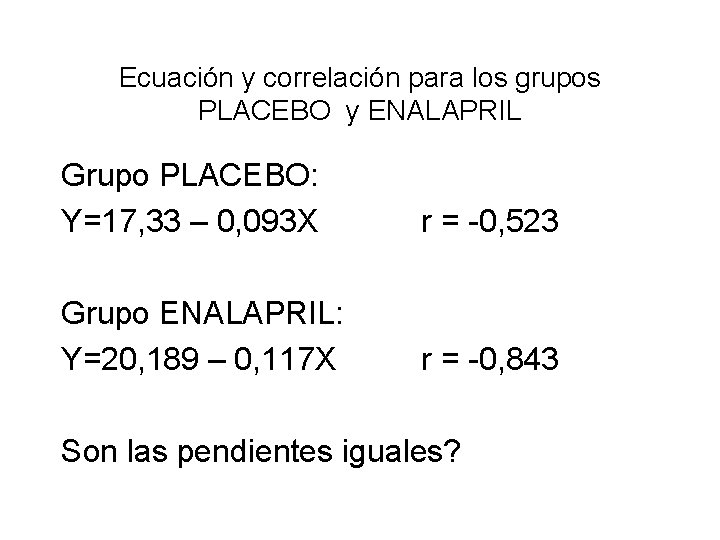
Ecuación y correlación para los grupos PLACEBO y ENALAPRIL Grupo PLACEBO: Y=17, 33 – 0, 093 X r = -0, 523 Grupo ENALAPRIL: Y=20, 189 – 0, 117 X r = -0, 843 Son las pendientes iguales?
Incluye 0 por lo tanto no hay dif significativa entre las pendientes
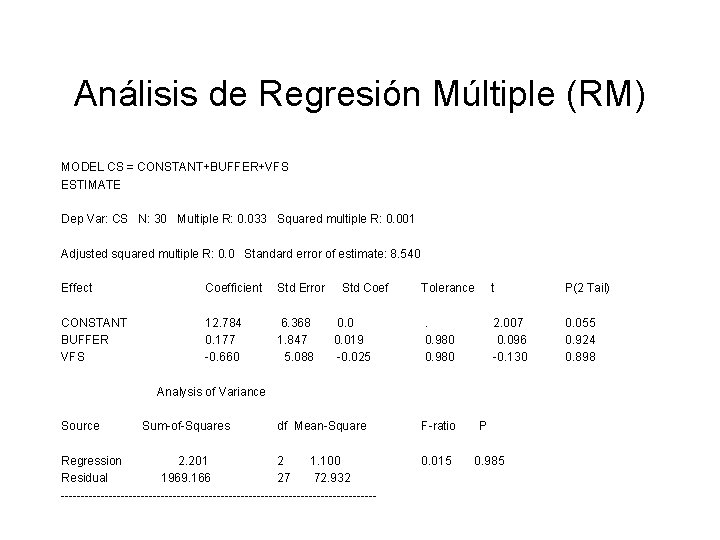
Análisis de Regresión Múltiple (RM) MODEL CS = CONSTANT+BUFFER+VFS ESTIMATE Dep Var: CS N: 30 Multiple R: 0. 033 Squared multiple R: 0. 001 Adjusted squared multiple R: 0. 0 Standard error of estimate: 8. 540 Effect Coefficient Std Error CONSTANT BUFFER VFS 12. 784 0. 177 -0. 660 6. 368 1. 847 5. 088 Std Coef 0. 019 -0. 025 Tolerance t P(2 Tail) . 0. 980 2. 007 0. 096 -0. 130 0. 055 0. 924 0. 898 Analysis of Variance Source Sum-of-Squares df Mean-Square Regression 2. 201 2 1. 100 Residual 1969. 166 27 72. 932 ---------------------------------------- F-ratio 0. 015 P 0. 985
Regresión Logística • Variable dependiente o de interés en el estudio: binaria (tiene infarto / no tiene inf. ) • En lugar de utilizar una combinación de variables exploratorias para predecir la variable dependiente como en RM, se predice una transformación de la variable dependiente
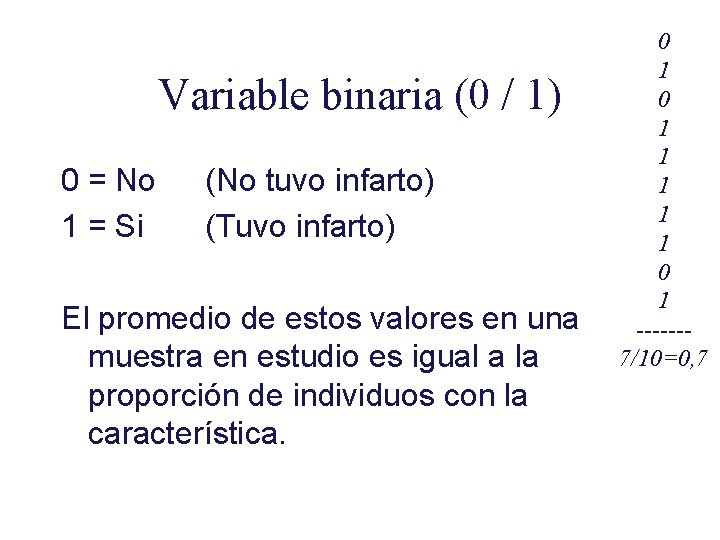
Variable binaria (0 / 1) 0 = No 1 = Si (No tuvo infarto) (Tuvo infarto) El promedio de estos valores en una muestra en estudio es igual a la proporción de individuos con la característica. 0 1 1 1 0 1 ------7/10=0, 7
Modelo de regresión logística: • Predecirá la proporción de sujetos con la característica de interés (o la probabilidad de un individuo de tener la característica) para cualquier combinación de las variables exploratorias en el modelo. • Se utiliza una transformación de esta proporción ya que si no es imposible trabajar con valores fuera del rango de 0 a 1
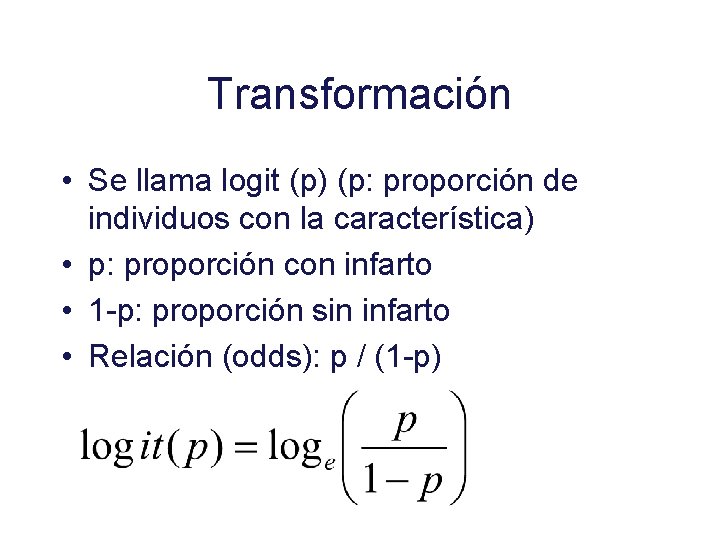
Transformación • Se llama logit (p) (p: proporción de individuos con la característica) • p: proporción con infarto • 1 -p: proporción sin infarto • Relación (odds): p / (1 -p)
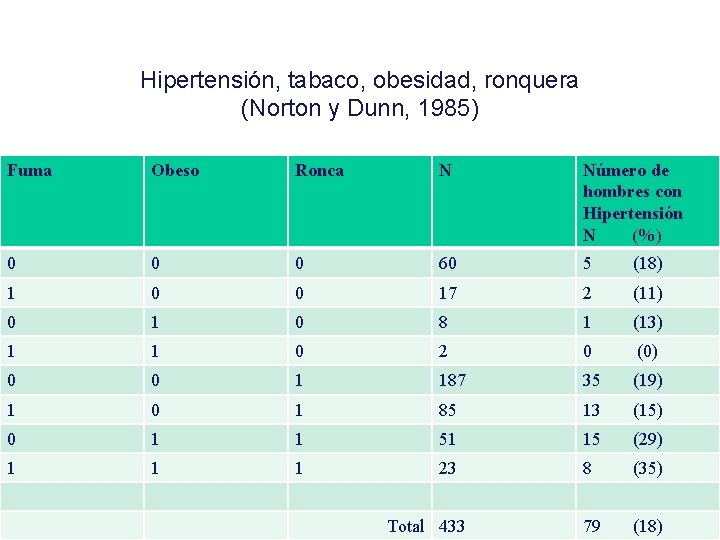
Hipertensión, tabaco, obesidad, ronquera (Norton y Dunn, 1985) Fuma Obeso Ronca N Número de hombres con Hipertensión N (%) 0 0 0 60 5 (18) 1 0 0 17 2 (11) 0 1 0 8 1 (13) 1 1 0 2 0 (0) 0 0 1 187 35 (19) 1 0 1 85 13 (15) 0 1 1 51 15 (29) 1 1 1 23 8 (35) 79 (18) Total 433
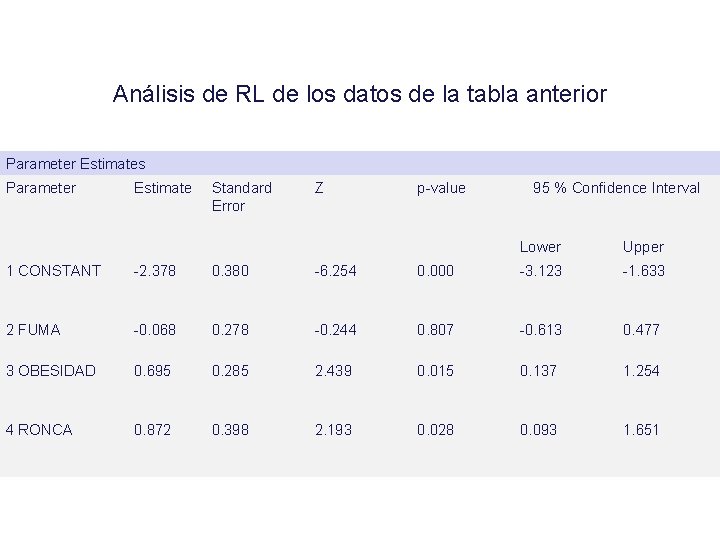
Análisis de RL de los datos de la tabla anterior Parameter Estimates Parameter Estimate Standard Error Z p-value 95 % Confidence Interval Lower Upper 1 CONSTANT -2. 378 0. 380 -6. 254 0. 000 -3. 123 -1. 633 2 FUMA -0. 068 0. 278 -0. 244 0. 807 -0. 613 0. 477 3 OBESIDAD 0. 695 0. 285 2. 439 0. 015 0. 137 1. 254 4 RONCA 0. 872 0. 398 2. 193 0. 028 0. 093 1. 651
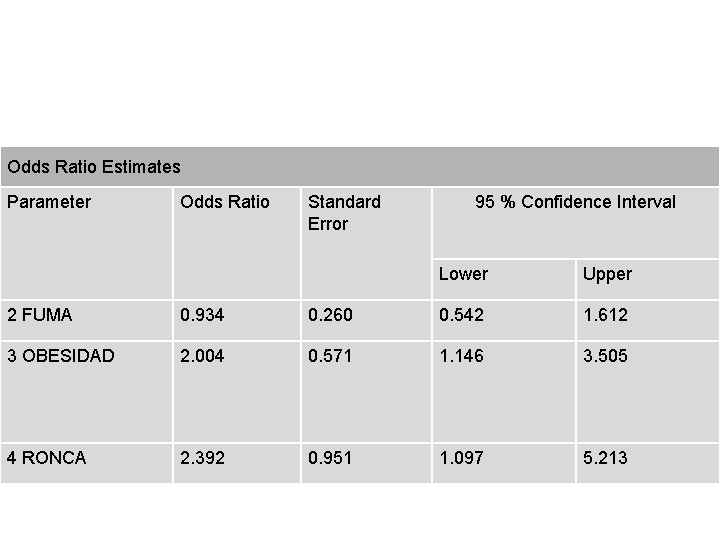
Odds Ratio Estimates Parameter Odds Ratio Standard Error 95 % Confidence Interval Lower Upper 2 FUMA 0. 934 0. 260 0. 542 1. 612 3 OBESIDAD 2. 004 0. 571 1. 146 3. 505 4 RONCA 2. 392 0. 951 1. 097 5. 213
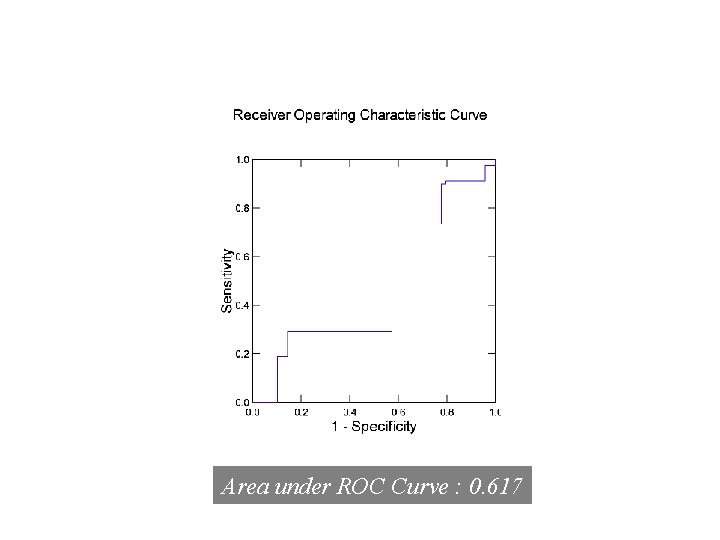
Area under ROC Curve : 0. 617
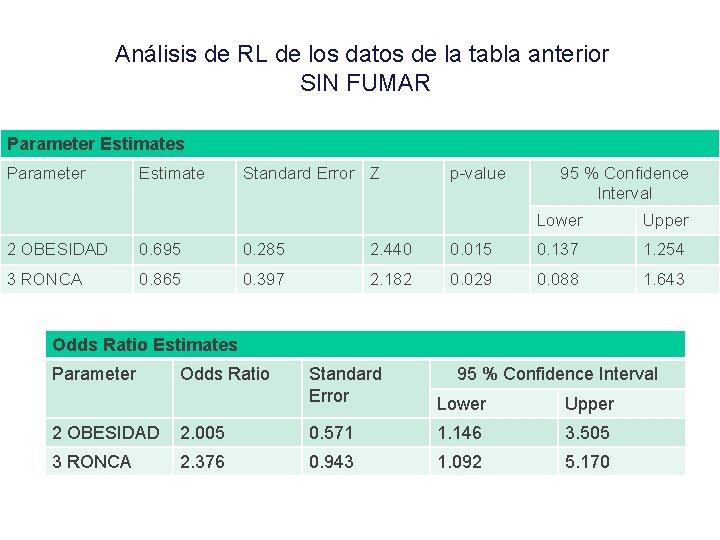
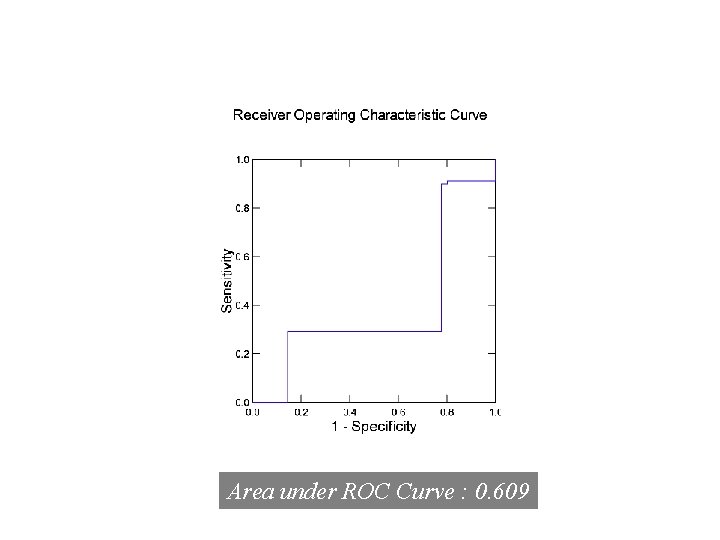
Análisis de RL de los datos de la tabla anterior SIN FUMAR Parameter Estimates Parameter Estimate Standard Error Z p-value 95 % Confidence Interval Lower Upper 2 OBESIDAD 0. 695 0. 285 2. 440 0. 015 0. 137 1. 254 3 RONCA 0. 865 0. 397 2. 182 0. 029 0. 088 1. 643 Odds Ratio Estimates Parameter Odds Ratio Standard Error 95 % Confidence Interval Lower Upper 2 OBESIDAD 2. 005 0. 571 1. 146 3. 505 3 RONCA 2. 376 0. 943 1. 092 5. 170
Area under ROC Curve : 0. 609
ROC: Receiver Operating Curve • Plot de la sensibilidad vs 1 -especificidad para cada posible punto de corte, y unión de ellos. • Si el “costo” de un resultado falso negativo es el mismo que del resultado de un falso positivo, la mejor zona de corte es aquella que maximiza la suma de la sensibilidad y especificidad, la cual es el punto más cerca al rincón superior izquierdo
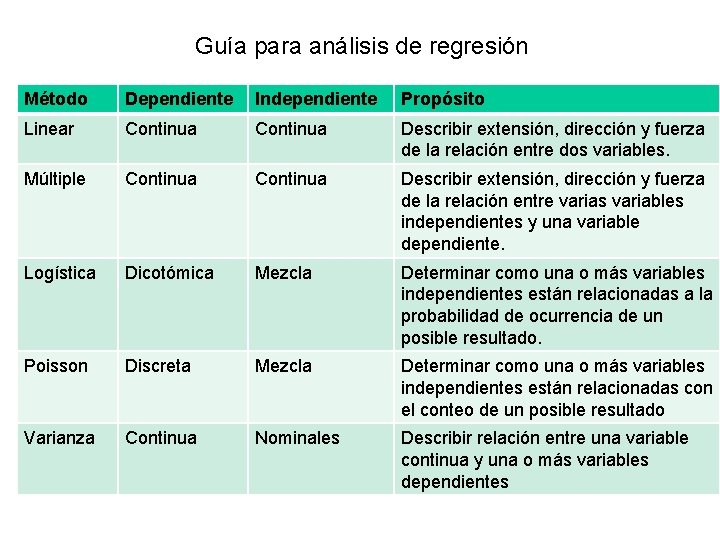
Guía para análisis de regresión Método Dependiente Independiente Propósito Linear Continua Describir extensión, dirección y fuerza de la relación entre dos variables. Múltiple Continua Describir extensión, dirección y fuerza de la relación entre varias variables independientes y una variable dependiente. Logística Dicotómica Mezcla Determinar como una o más variables independientes están relacionadas a la probabilidad de ocurrencia de un posible resultado. Poisson Discreta Mezcla Determinar como una o más variables independientes están relacionadas con el conteo de un posible resultado Varianza Continua Nominales Describir relación entre una variable continua y una o más variables dependientes
RESUMEN • Regresión lineal: x / y: intervalares, independiente / dependiente. • Regresión múltiple: una dependiente, varias dependientes (intervalares). • Regresión logística: una dependiente (nominal), varias independientes (puede haber nominales, ordinales, intervalares).