
Reconocimiento Automtico del Habla FonticaFonologa Luis Villaseor Pineda
Reconocimiento Automático del Habla Fonética/Fonología Luis Villaseñor Pineda, Carlos Alberto Reyes Laboratorio de Tecnologías del Lenguaje Coordinación de Ciencias Computacionales, Instituto Nacional de Astrofísica, Óptica y Electrónica Laboratorio de Tecnologías del Lenguaje
… pero y ¿ qué es el habla ? l l l l l un pensamiento expresado en voz alta… el mandato abrumador de la conciencia… una canción de cuna… el llamado a la justicia en Irak… el saludo al despertar… la explicación paciente del profesor de primaria… el grito de auxilio de la víctima… la incomprensible anuncio de nuestra partida en el aeropuerto… la grabación impersonal de nuestra contestadora… … Laboratorio de Tecnologías del Lenguaje 2
Según el diccionario… l Voz (l. voce) l l 1 Sustantivo femenino. Sonido que, en el hombre y ciertos animales, produce el aire expelido de los pulmones al hacer vibrar las cuerdas vocales. Hablar (l. fabulari) l 1 Verbo intransitivo. Darse a entender por medio de palabras. Laboratorio de Tecnologías del Lenguaje 3
Contenido l l ¿Qué es un reconocedor automático de habla? Forma y contenido del habla Principios físicos del sonido / habla Mecanismos del lenguaje humano Laboratorio de Tecnologías del Lenguaje 4
¿Qué es un reconocedor de habla? l Es un proceso que convierte una señal acústica (sonido) capturada por micrófono -u otro dispositivo - a un conjunto de palabras (texto) l l Es la identificacion de las palabras de una elocución (habla >> transcrición ortográfica) Basado en técnicas de reconocimiento de patrones Dichos patrones son aprendidos a partir de grandes conjuntos de datos, usando técnicas estocásticas Laboratorio de Tecnologías del Lenguaje 5
¿Para qué sirve un reconocedor de habla? l Su principal objetivo es facilitar/mejorar la comunicación entre el hombre y la computadora, ya que la comunicación hablada es un medio natural para intercambio de información l Además, casi toda actividad humana es social y el habla es parte esencial de esa actividad Laboratorio de Tecnologías del Lenguaje 6
Problemática l l El habla es una compleja combinación de procesos a diferentes niveles que es usada para transmitir información Variabilidad de la señal: l l l Variabilidad intra-locutor: estado emocional, ambiente, estado de salud, etc. Variabilidad inter-locutor: diferencias fisiológicas, acento, dialectos, etc. Canal acústico: Teléfono, micrófono, ruido ambiental, etc.
Características de un Reconocedor • Tipo de habla: aislada, continua • Dependiente o Independiente del locutor • Número de palabras que reconocen • Tipo de texto que reconocen • Tipo de canal Laboratorio de Tecnologías del Lenguaje 8
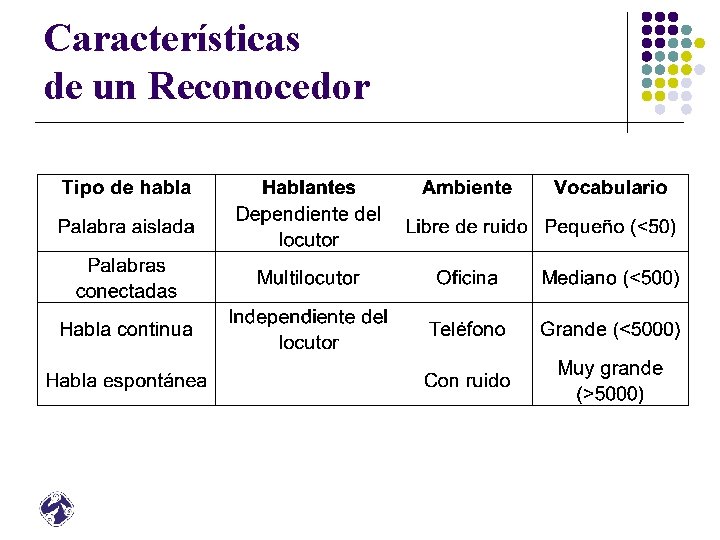
Características de un Reconocedor
Dos grandes áreas: l Principios físicos del sonido en particular del habla l Mecanismos del lenguaje a diferentes niveles (los primeros) Laboratorio de Tecnologías del Lenguaje 10
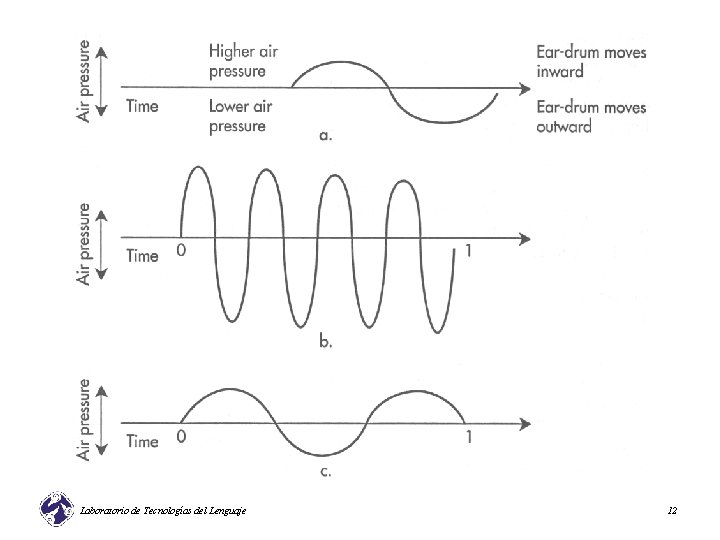
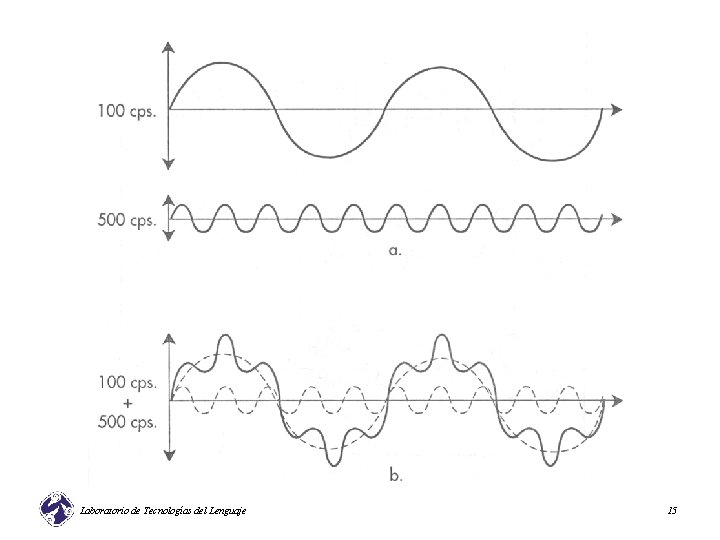
Principios físicos del sonido l l Todos los sonidos, incluyendo el habla, provocan el movimiento de las moléculas del aire Algunos producen un movimiento del aire en patrones regulares: l Al tocar una cuerda de una guitarra Casos contrarios: l Cerrar una puerta Gráficamente representamos un sonido como una curva senoidal l En un eje la presión del aire en otro eje el tiempo Laboratorio de Tecnologías del Lenguaje 11
Laboratorio de Tecnologías del Lenguaje 12
Frecuencia y Amplitud l l l El número de vibraciones producidas por segundo es llamada frecuencia Una vibración de 100 veces por segundo tiene una frecuencia de 100 ciclos por segundo o 100 Hertz (Hz) Los sonidos agudos tienen una alta frecuencia los graves baja La intensidad de un sonido es la cantidad de aire desplazado La intensidad se describe en términos de la amplitud de la curva La amplitud es medida en decibeles d. B Laboratorio de Tecnologías del Lenguaje 13
Frecuencia Dominante l l Los ejemplos anteriores son tonos puros La mayoría de los sonidos son compuestos l l l Una frecuencia dominante o fundamental (pitch) Acompañada de un conjunto de frecuencias secundarias (timbre) En particular para el habla ciertas frecuencias secundarias llamadas formantes sirven para distinguir entre los fonemas Laboratorio de Tecnologías del Lenguaje 14
Laboratorio de Tecnologías del Lenguaje 15
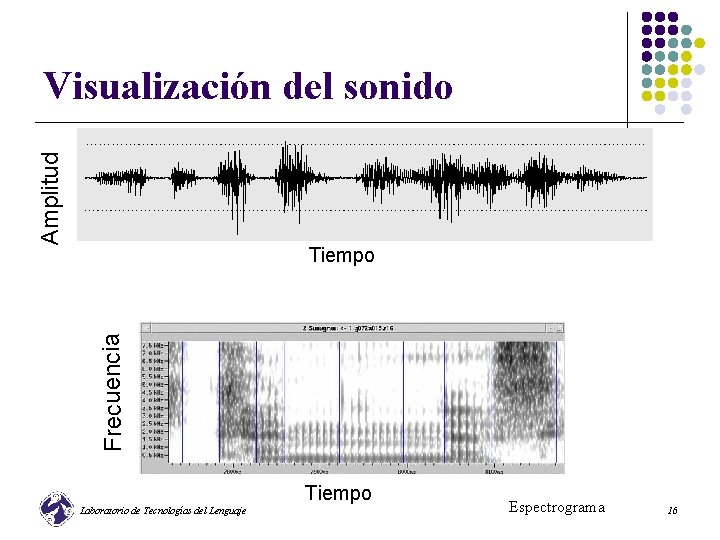
Amplitud Visualización del sonido Frecuencia Tiempo Laboratorio de Tecnologías del Lenguaje Espectrograma 16
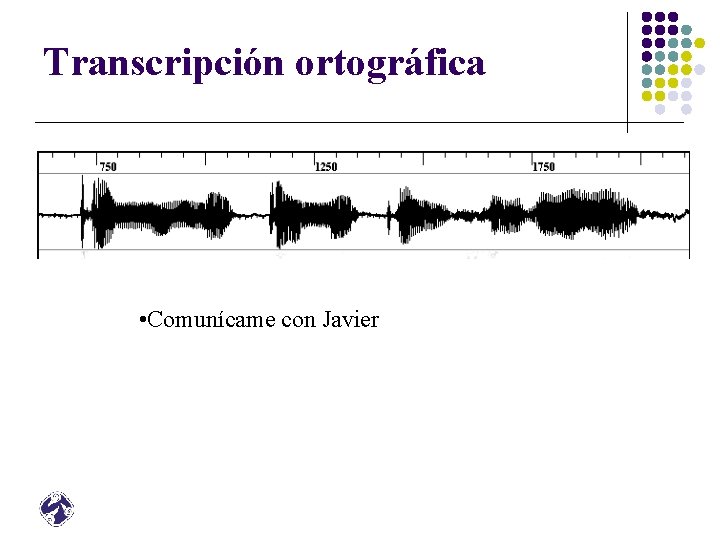
Transcripción ortográfica • Comunícame con Javier
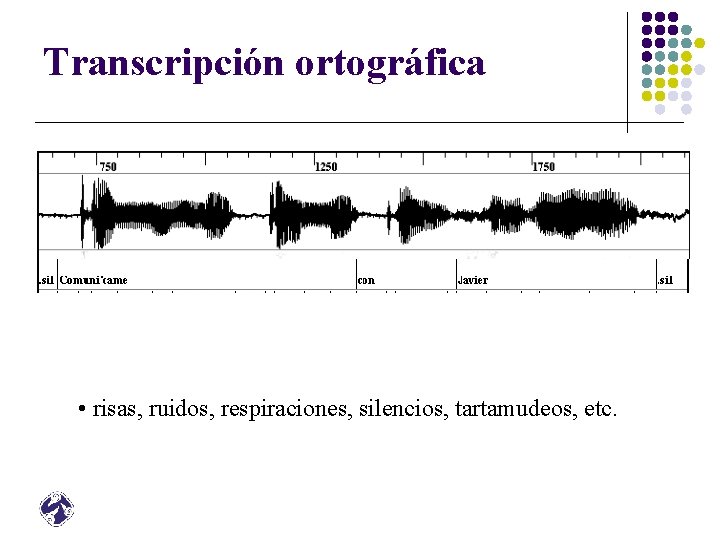
Transcripción ortográfica • risas, ruidos, respiraciones, silencios, tartamudeos, etc.
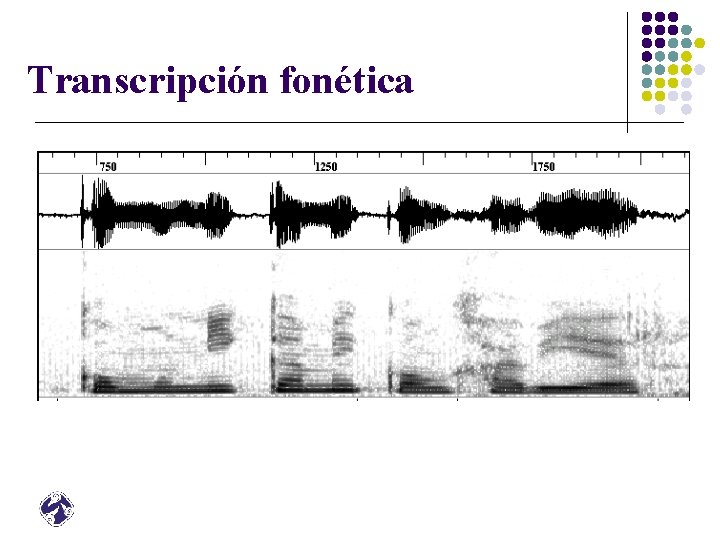
Transcripción fonética
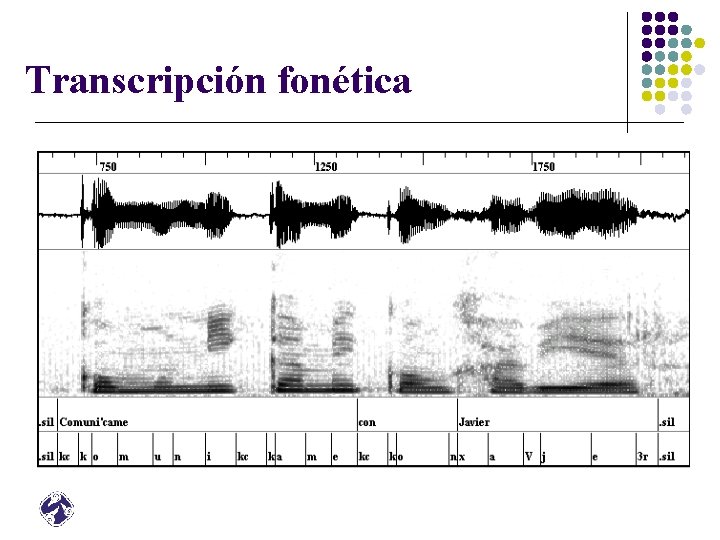
Transcripción fonética
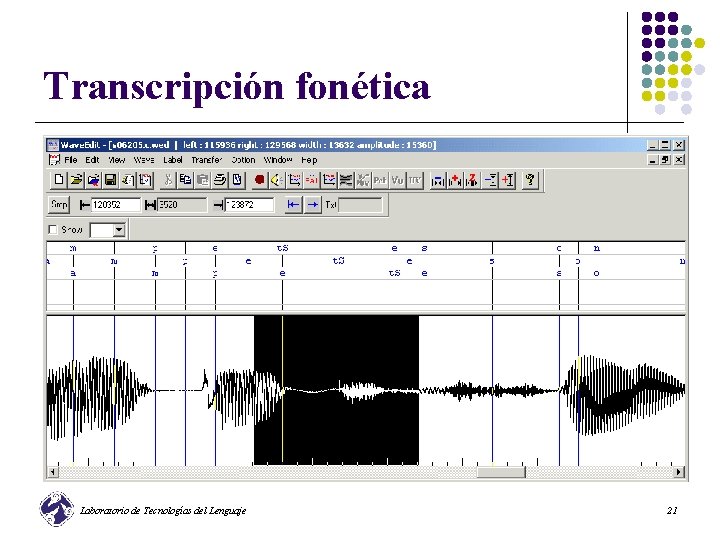
Transcripción fonética Laboratorio de Tecnologías del Lenguaje 21
Fonética l Entrada l l Salida l l Señal acústica Alfabeto fonético Estudia: l l Formación de las consonantes y las vocales en el tracto vocal Clasificación de vocales, consonantes por su forma, posición de la lengua y músculos bucales involucrados Laboratorio de Tecnologías del Lenguaje 22
Corpus DIMEx 100 l Todo inicia a partir de un corpus recolectado de la Web l El Corpus 230 (Villaseñor et al. , 2004) l l l 344, 619 frases un vocabulario de 235, 891 unidades léxicas 15 milliones de palabras Laboratorio de Tecnologías del Lenguaje 23
Corpus DIMEx 100 l l Selección de 15, 000 frases entre 5 y 15 palabras. Seleccionamos 7000 frases con las más pequeñas perplejidades l l Aseguramos un corpus rico y balanceado Eliiminamos frases con palabras extranjeras o abreviaturas Finalmente nos quedamos con 5010 frases l El corpus fue grabado por 100 hablantes, cada uno con 50 frases individuales + 10 frases grabadas por todos los hablantes. l En resumen 6000 frases: 5000 frases diferentes grabadas una vez y 10 frases grabadas 100 veces cada una. Laboratorio de Tecnologías del Lenguaje l 24
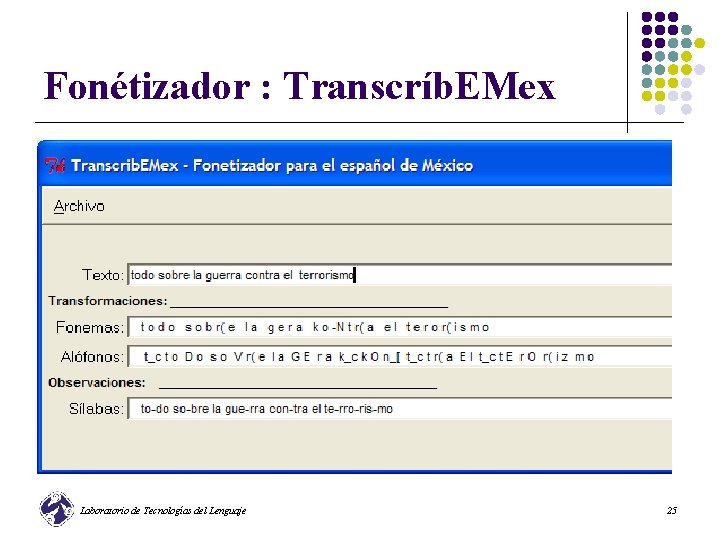
Fonétizador : Transcríb. EMex Laboratorio de Tecnologías del Lenguaje 25
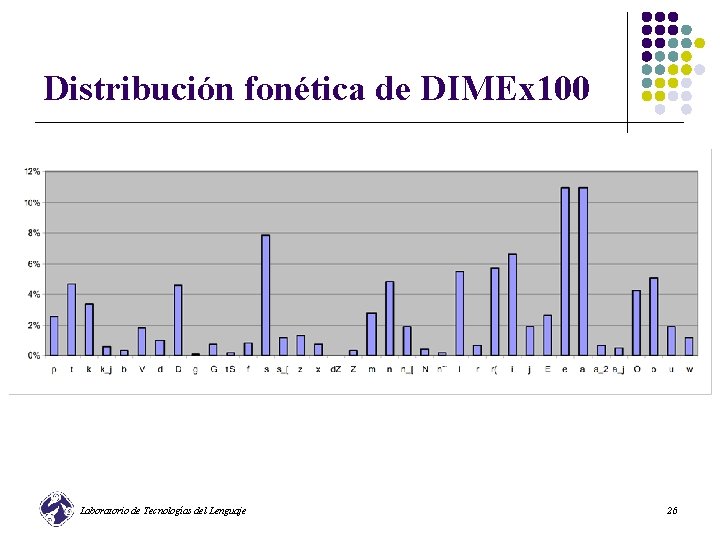
Distribución fonética de DIMEx 100 Laboratorio de Tecnologías del Lenguaje 26
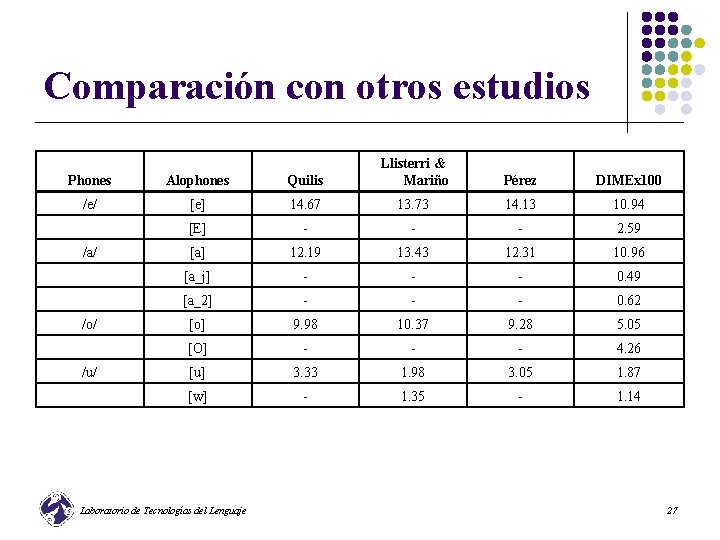
Comparación con otros estudios Phones Alophones Quilis Llisterri & Mariño /e/ [e] 14. 67 13. 73 14. 13 10. 94 [E] - - - 2. 59 /a/ [a] 12. 19 13. 43 12. 31 10. 96 [a_j] - - - 0. 49 [a_2] - - - 0. 62 /o/ [o] 9. 98 10. 37 9. 28 5. 05 [O] - - - 4. 26 /u/ [u] 3. 33 1. 98 3. 05 1. 87 [w] - 1. 35 - 1. 14 Laboratorio de Tecnologías del Lenguaje Pérez DIMEx 100 27
Fonología l Entrada: l l Salida: l l Secuencia de fonos/sonidos (en un alfabeto fonético) Secuencia de fonemas (letras) en un alfabeto abstracto Estudia: l l Las relaciones entre sonidos y fonemas (unidades las cuales tienen una cierta función en el nivel superior) Por ejemplo: ocho Laboratorio de Tecnologías del Lenguaje 28
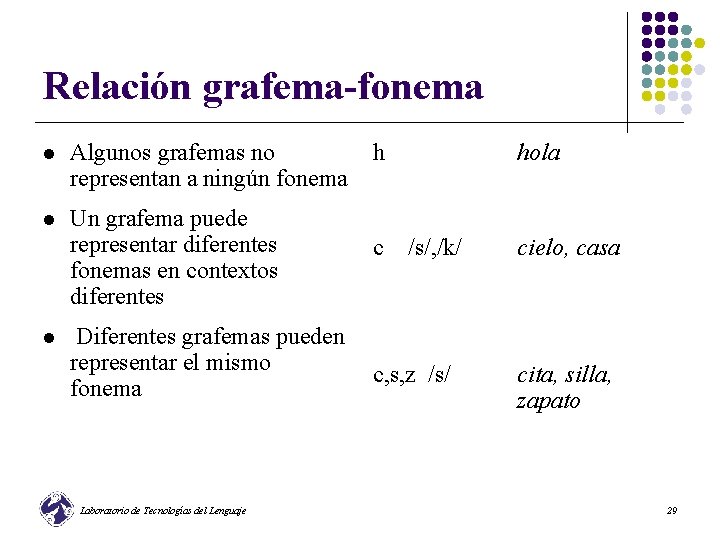
Relación grafema-fonema l Algunos grafemas no h representan a ningún fonema l Un grafema puede representar diferentes fonemas en contextos diferentes l c /s/, /k/ Diferentes grafemas pueden representar el mismo c, s, z /s/ fonema Laboratorio de Tecnologías del Lenguaje hola cielo, casa cita, silla, zapato 29
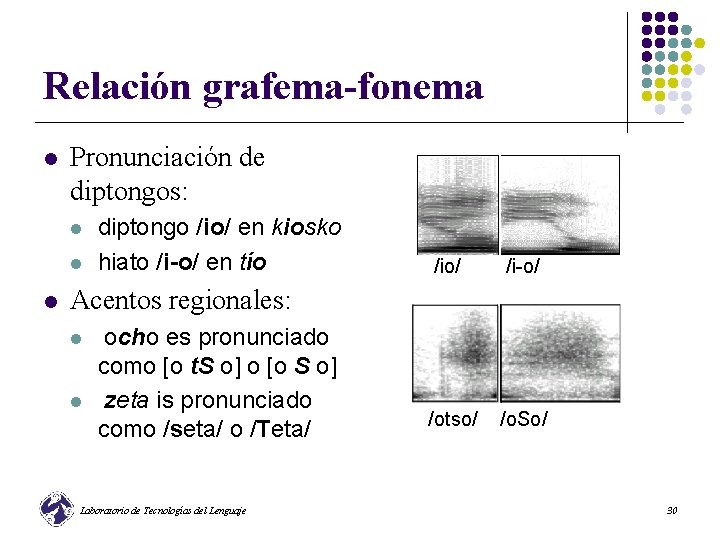
Relación grafema-fonema l Pronunciación de diptongos: l l l diptongo /io/ en kiosko hiato /i-o/ en tío /io/ /i-o/ /otso/ /o. So/ Acentos regionales: l l ocho es pronunciado como [o t. S o] o [o S o] zeta is pronunciado como /seta/ o /Teta/ Laboratorio de Tecnologías del Lenguaje 30
Características de la Percepción Humana l El oído humano está especializado en el reconocimiento de voz l l l Aunque es capaz de detectar frecuencias de 20 Hz a 20000 Hz Es mucho más sensible en el rango de la voz: 1000 Hz a 6000 Hz No procesa las frecuencias de forma individual, sino por grupos de frecuencias Laboratorio de Tecnologías del Lenguaje 31
Ruido, voz y expectativa l Un oído especializado en el lenguaje l Discriminar entre ruido y palabra l l ¡A pesar de que el ruido sea voz! Capacidad para reconstruir un mensaje Y si yo viera… Que elocuente… Laboratorio de Tecnologías del Lenguaje 32
Ruido, voz y expectativa l Un oído especializado en el lenguaje l Discriminar entre ruido y palabra l l ¡A pesar de que el ruido sea voz! Capacidad para reconstruir un mensaje Y si yo viera… te mojabas Que elocuente… a todos los niños Laboratorio de Tecnologías del Lenguaje 33
Reconocer y Entender RAH Entendimiento l El primer paso para entender es reconocer l En los seres humanos estos dos procesos están fuertemente entrelazados Laboratorio de Tecnologías del Lenguaje 34
Reconocer l l Adquisición de la señal hablada Extracción de características Clasificación y modelado de las señales (dentro de esta parte se encuentran los modelos acústicos, léxicos y los de lenguaje). Métodos de búsqueda y reconocimiento Laboratorio de Tecnologías del Lenguaje 35
Capturando la señal l l La señal de voz es redundante y algunos datos irrelevantes para el proceso de reconocimiento Para reducir la cantidad de datos: l Usar filtros para eliminar frecuencias arriba de 3100 Hz y debajo de 100 Hz Laboratorio de Tecnologías del Lenguaje 36
Capturando la señal. . . l El muestreo: l l Tomamos rebanadas muestras de la señal (el cine es el mismo caso) El número de muestras depende de las frecuencias que deseamos incluir en nuestro análisis: l l La tasa de muestreo mínima es el doble de la más alta frecuencia de interés Para una frecuencia de 3100 Hz necesitamos 6200 muestras por segundo Laboratorio de Tecnologías del Lenguaje 37
Procesamiento de Señal l Extracción de características l l Llevar la señal digital a una representación matemática simple con la cual trabajar Transformada de fourier discreta (DFT) o FFT l l LPC MFCC Laboratorio de Tecnologías del Lenguaje 38
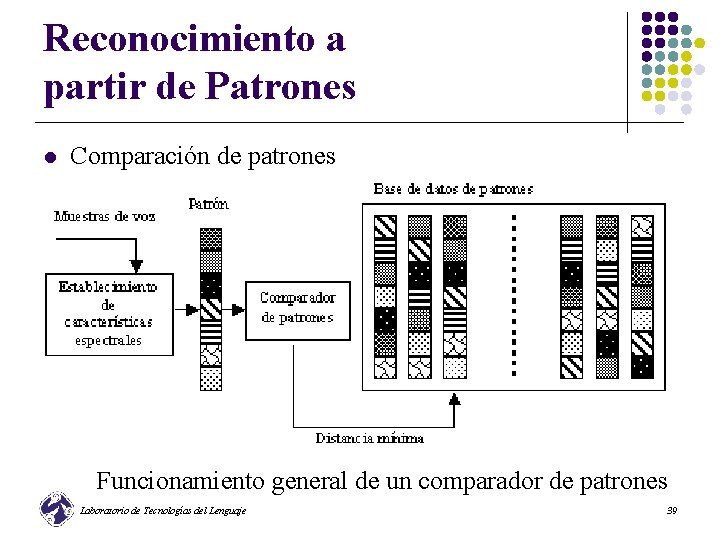
Reconocimiento a partir de Patrones l Comparación de patrones Funcionamiento general de un comparador de patrones Laboratorio de Tecnologías del Lenguaje 39
Reconocimiento a partir de Patrones l Comparación de patrones l l Vocabularios pequeños Variabilidad fonética Operación a nivel de palabra Alineación temporal Laboratorio de Tecnologías del Lenguaje 40
Reconocimiento a partir de Patrones l Modelos estocásticos l Selección no-determinística entre un conjunto de posibilidades l A diferencia del apareo de patrones no existe una comparación entre los modelos almacenados y la entrada l Un análisis probabilístico es la base de la selección (modelos ocultos de Markov) l Grandes cantidades de datos para entrenamiento l Operación a nivel de fonemas y semi-fonemas Laboratorio de Tecnologías del Lenguaje 41
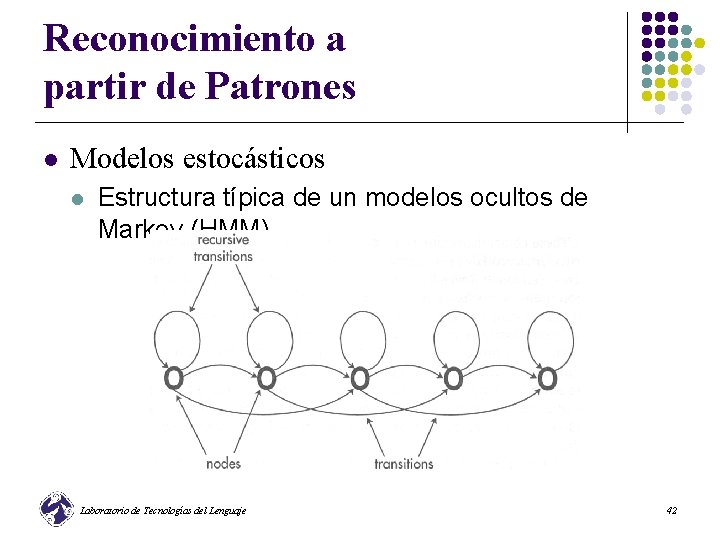
Reconocimiento a partir de Patrones l Modelos estocásticos l Estructura típica de un modelos ocultos de Markov (HMM) Laboratorio de Tecnologías del Lenguaje 42
Creando un reconocedor para el Español Mexicano l Se tomaron los modelos acústicos del francés l l Para la gran mayoría de manera directa Para tres fonemas se crearon los modelos de español mezclando modelos del francés l l l /t. S/ => campeche /x/ => tecnológico /L/ => desarrollo Laboratorio de Tecnologías del Lenguaje 43
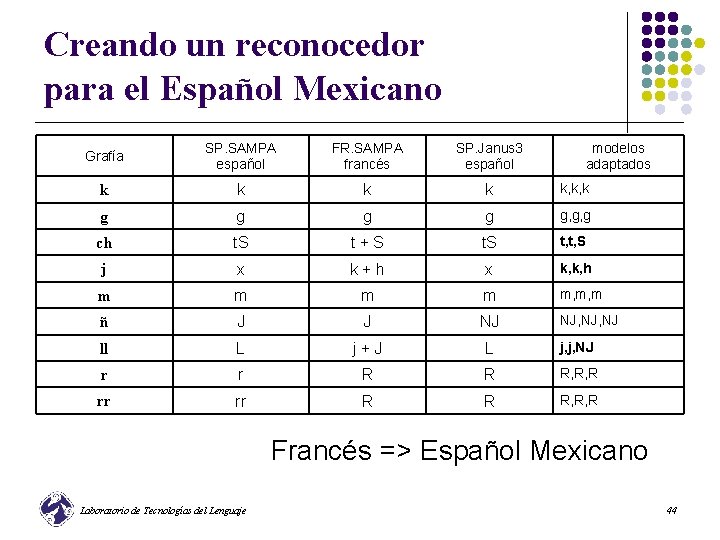
Creando un reconocedor para el Español Mexicano Grafía SP. SAMPA español FR. SAMPA francés SP. Janus 3 español modelos adaptados k k k, k, k g g g, g, g ch t. S t+S t. S t, t, S j x k+h x k, k, h m m m, m, m ñ J J NJ NJ, NJ ll L j+J L j, j, NJ r r R R R, R, R rr rr R R R, R, R Francés => Español Mexicano Laboratorio de Tecnologías del Lenguaje 44
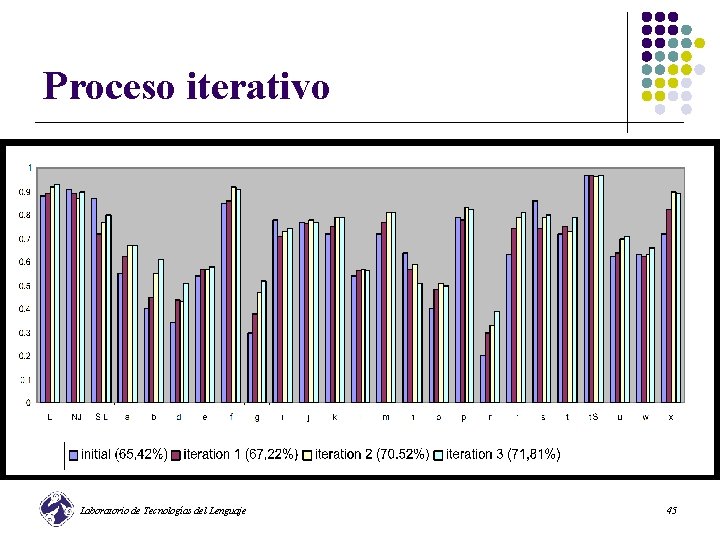
Proceso iterativo Laboratorio de Tecnologías del Lenguaje 45
Fenómenos del habla espontánea l La enunciación de una locución es un proceso complejo donde la construcción de la oración y su pronunciación son procesos interdependientes “Speech is more than just an audible version of text” (M. Hunt) Laboratorio de Tecnologías del Lenguaje 46
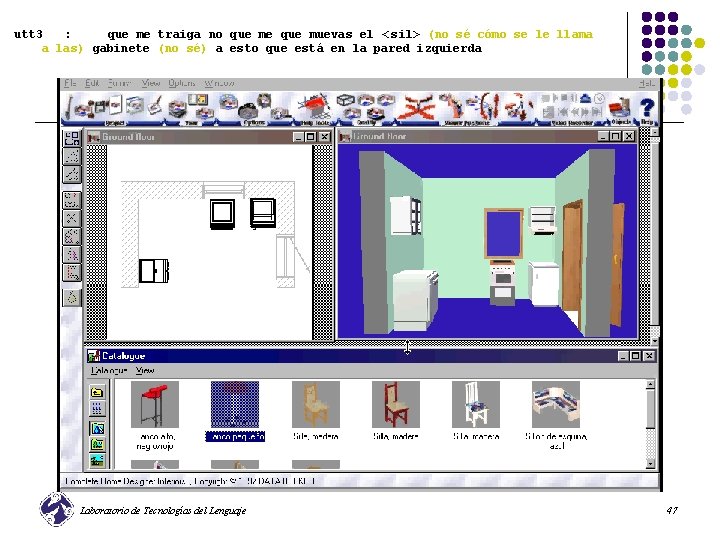
utt 3 : que me traiga no que me que muevas el < sil> (no sé cómo se le llama a las) gabinete (no sé) a esto que está en la pared izquierda Laboratorio de Tecnologías del Lenguaje 47
Fenómenos del habla espontánea l Expresiones incrustadas utt 96 : centro ? a ver este esa mesa (por favor) la puedes poner en el utt 119 : ah <sil> sabes qué este quiero que la gires a a la mesa <sil> de tal forma que (ay dónde está el mouse ? ) de tal forma que esta parte <sil> quede pegada a la ventana <sil> esta parte superior <ruido> bueno utt 7 : <ruido> eh puedes poner este <ruido> este estante lo puedes poner <sil> eh también en esta pared (pero <sil> no sé ) más o menos a esta altura en la pared de este lado en la pared de del fondo Laboratorio de Tecnologías del Lenguaje 48
Fenómenos del habla espontánea l Reparaciones / Abandonos utt 95 : bueno primero nos tra-traemos la / cómo se le llama a la parte de arriba de la estufa la que absorbe ? utt 80 : entonces el primero <no-vocal> el tercero perdón Laboratorio de Tecnologías del Lenguaje 49
Fenómenos del habla espontánea l Ambigüedad/Redundancia utt 39 : ahora sí <sil> el <sil> estante este que está aquí abajo <sil> lo puedes poner en esta esquina <sil> en la esquina de esta pared utt 73 : hay espacio para que estante quede aquí en esta pared ? utt 121: parte puedes llevar esta alacena <sil> aquí a esta a la parte superior de esta esquina Laboratorio de Tecnologías del Lenguaje 50
Características sintácticas del habla espontánea l Orden de las palabras l l l pon la estufa junto al refri pon junto al refri la estufa Pronombres clíticos l l l utt 70 : u: puedes girarlo <sil> eh en el mismo sentido ? utt 61 : u: podrías mostrármelos ? utt 9 : u: pónmelo <sil> aquí <sil> en esta esquina Laboratorio de Tecnologías del Lenguaje 51
Características sintácticas del habla espontánea l Construcciones difíciles l l utt 50 : u: utt 208: u: pero a una altura más grande eh no tanto <sil> oh haz de cuenta que no quede pegadita l Construcciones propias del español mexicano l utt 35 : u: utt 187: l utt 97 : u: l l ahorita ponla en cualquier lugar enseguidita ajá quiero una que sea así largita más o menos del tamaño del refri este acá arribita Laboratorio de Tecnologías del Lenguaje 52
Aplicación: Búsqueda en Audio l Objetivo: l l Dado un término en forma textual deseamos localizar dicho término en una colección de grabaciones (conversaciones, discursos, etc. ) Organizar las colecciones de audio por temas tratados, personajes entrevistados, etc. Laboratorio de Tecnologías del Lenguaje 53
Primer enfoque l Indexado a partir de la transcripción: l l Después de transformar el audio en texto, con ayuda de un reconocedor gran vocabulario de habla continua, generamos un índice de las palabras presentes en la transcripción Tratamos la transcripción con las técnicas actuales de recuperación y extracción de información. Laboratorio de Tecnologías del Lenguaje 54
Segundo enfoque l Indexado basado en fonemas: l l La transformación del audio sólo llega hasta la etapa de fonemas, ésta es la base a partir de la cual se hará la búsqueda del texto deseado. La búsqueda puede dar un mayor número de respuestas falsas que el enfoque anterior, pero tiene un mejor comportamiento con palabras fuera del diccionario (nombre de personas, lugares, términos extranjeros, etc. ) Laboratorio de Tecnologías del Lenguaje 55
A notar… l l El reconocimiento fonético aun está lejos de un reconocimiento perfecto Usando información lingüística (modelos de lenguaje) es posible incrementar su rendimiento l Un modelo de lenguaje captura (probabilísticamente) las secuencias propias de un lenguaje l l “El que madruga … “A buen entendedor … Laboratorio de Tecnologías del Lenguaje 56
A notar… l l El reconocimiento fonético aun está lejos de un reconocimiento perfecto Usando información lingüística (modelos de lenguaje) es posible incrementar su rendimiento l Un modelo de lenguaje captura (probabilísticamente) las secuencias propias de un lenguaje l l “El que madruga, Dios le ayuda” “A buen entendedor, pocas palabras” Laboratorio de Tecnologías del Lenguaje 57
A notar… l l Los modelos acústicos recuperan pistas auditivas las cuales son la base para la reconstrucción del mensaje. Los modelos de lenguaje aportan información sobre el lenguaje y el contexto para la reconstrucción del lenguaje l Un modelo de lenguaje es más fácil de construir mientras más acotado sea el dominio Laboratorio de Tecnologías del Lenguaje 58
A notar… l El comportamiento de los reconocedores es mejor si el contexto es limitado. l l En noticieros de 5 a 20% de error Otros contenidos de 30 a 60% de error Se puede indexar una hora de audio en 5 minutos (no se menciona la calidad) Existen ya sistemas multilingües! Laboratorio de Tecnologías del Lenguaje 59
Una solución posible l Llegar a la transcripción pero apoyarse también en su información fonética Proponer un método para recuperación de información en documentos orales enriqueciendo su representación a través de codificación fonética. Laboratorio de Tecnologías del Lenguaje 60
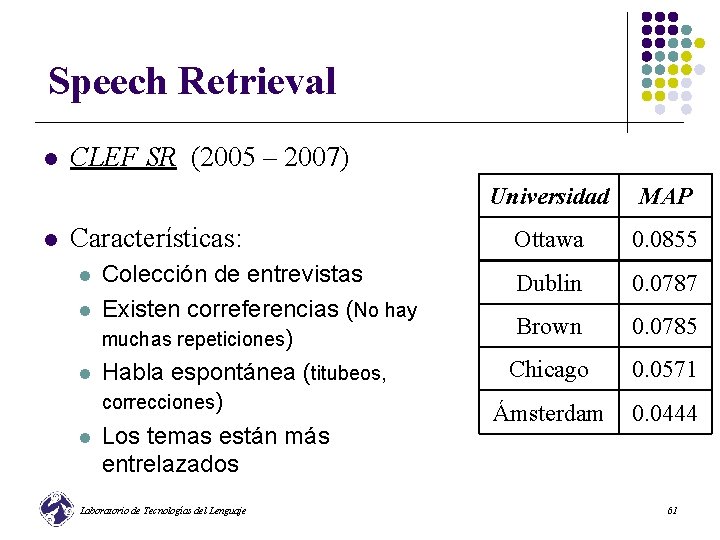
Speech Retrieval l l CLEF SR (2005 – 2007) Características: l l Colección de entrevistas Existen correferencias (No hay muchas repeticiones) Habla espontánea (titubeos, correcciones) Los temas están más entrelazados Laboratorio de Tecnologías del Lenguaje Universidad MAP Ottawa 0. 0855 Dublin 0. 0787 Brown 0. 0785 Chicago 0. 0571 Ámsterdam 0. 0444 61
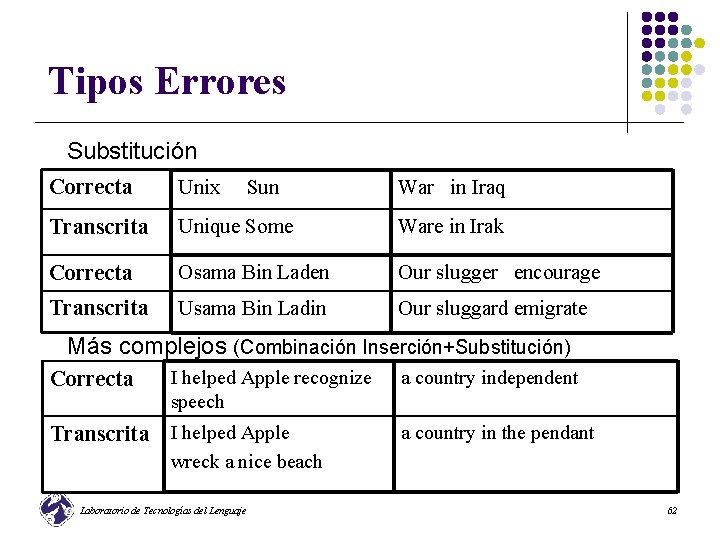
Tipos Errores Substitución Correcta Unix Sun War in Iraq Transcrita Unique Some Ware in Irak Correcta Osama Bin Laden Our slugger encourage Transcrita Usama Bin Ladin Our sluggard emigrate Más complejos (Combinación Inserción+Substitución) Correcta I helped Apple recognize speech Transcrita I helped Apple a country independent a country in the pendant wreck a nice beach Laboratorio de Tecnologías del Lenguaje 62
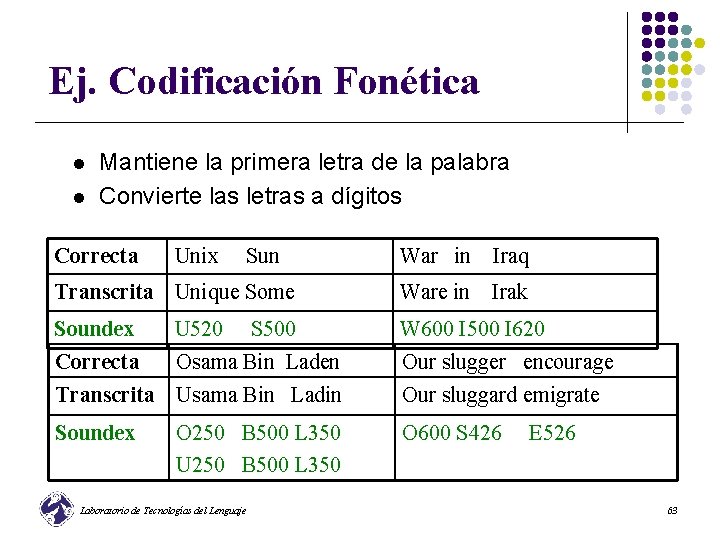
Ej. Codificación Fonética l l Mantiene la primera letra de la palabra Convierte las letras a dígitos Correcta Unix Sun War in Iraq Transcrita Unique Some Ware in Irak Soundex Correcta W 600 I 500 I 620 Our slugger encourage U 520 S 500 Osama Bin Laden Transcrita Usama Bin Ladin Our sluggard emigrate Soundex O 600 S 426 E 526 O 250 B 500 L 350 U 250 B 500 L 350 Laboratorio de Tecnologías del Lenguaje 63
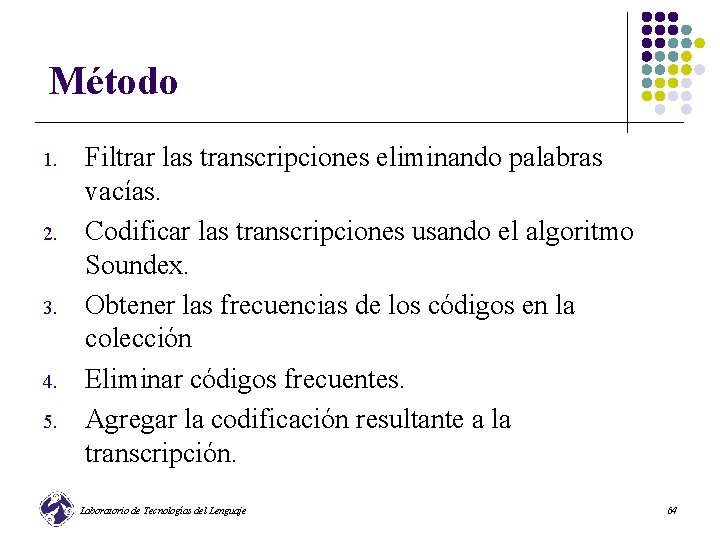
Método 1. 2. 3. 4. 5. Filtrar las transcripciones eliminando palabras vacías. Codificar las transcripciones usando el algoritmo Soundex. Obtener las frecuencias de los códigos en la colección Eliminar códigos frecuentes. Agregar la codificación resultante a la transcripción. Laboratorio de Tecnologías del Lenguaje 64
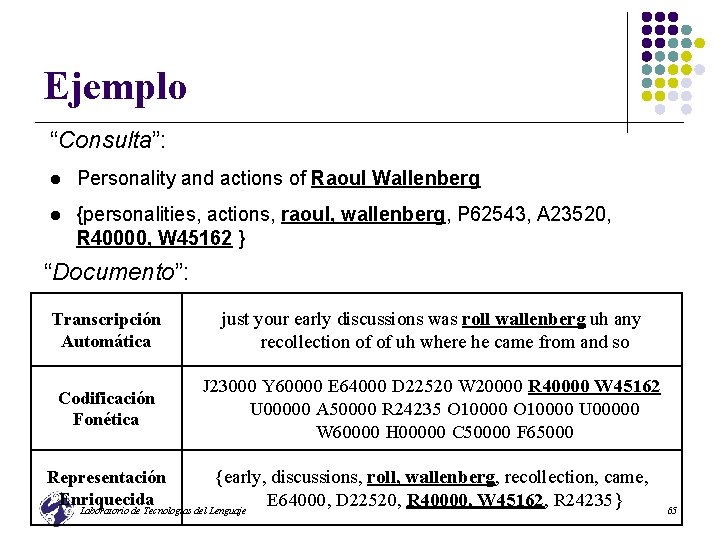
Ejemplo “Consulta”: l Personality and actions of Raoul Wallenberg l {personalities, actions, raoul, wallenberg, P 62543, A 23520, R 40000, W 45162 } “Documento”: Transcripción Automática just your early discussions was roll wallenberg uh any recollection of of uh where he came from and so Codificación Fonética J 23000 Y 60000 E 64000 D 22520 W 20000 R 40000 W 45162 U 00000 A 50000 R 24235 O 10000 U 00000 W 60000 H 00000 C 50000 F 65000 {early, discussions, roll, wallenberg, recollection, came, Representación Enriquecida E 64000, D 22520, R 40000, W 45162, R 24235} Laboratorio de Tecnologías del Lenguaje 65
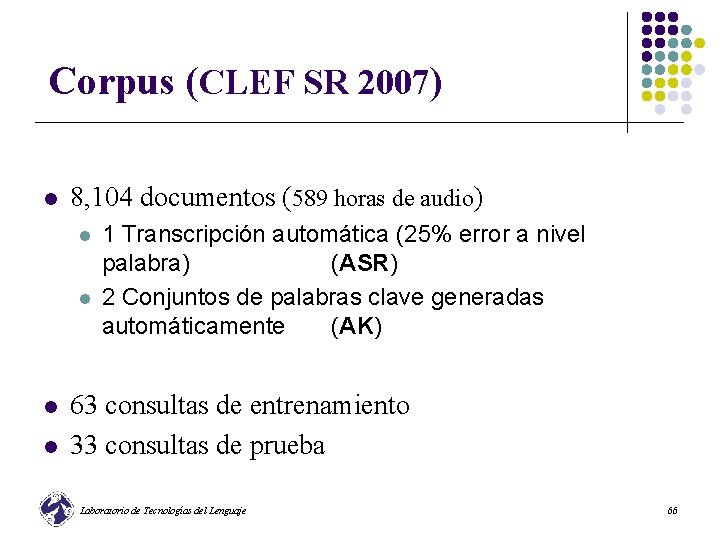
Corpus (CLEF SR 2007) l 8, 104 documentos (589 horas de audio) l l 1 Transcripción automática (25% error a nivel palabra) (ASR) 2 Conjuntos de palabras clave generadas automáticamente (AK) 63 consultas de entrenamiento 33 consultas de prueba Laboratorio de Tecnologías del Lenguaje 66
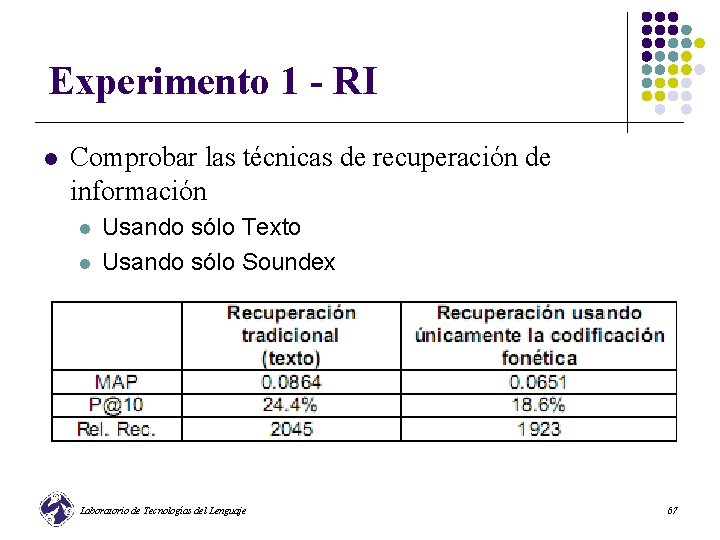
Experimento 1 - RI l Comprobar las técnicas de recuperación de información l l Usando sólo Texto Usando sólo Soundex Laboratorio de Tecnologías del Lenguaje 67
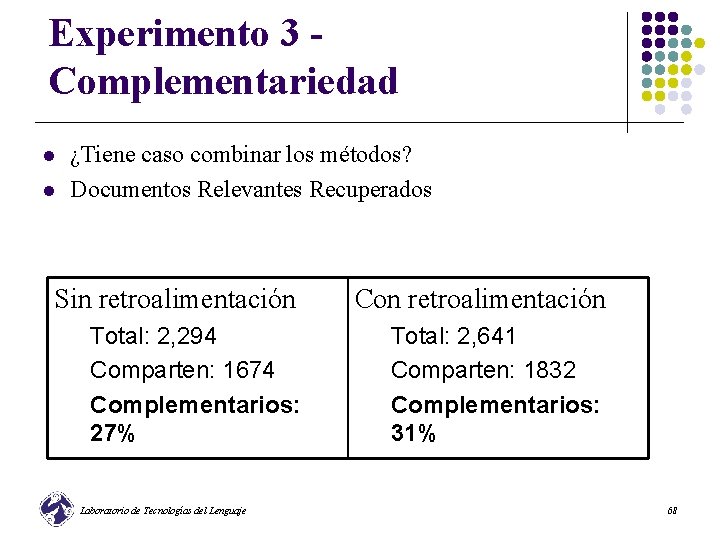
Experimento 3 Complementariedad l l ¿Tiene caso combinar los métodos? Documentos Relevantes Recuperados Sin retroalimentación Con retroalimentación Total: 2, 294 Comparten: 1674 Complementarios: 27% Total: 2, 641 Comparten: 1832 Complementarios: 31% Laboratorio de Tecnologías del Lenguaje 68
Experimento 4 - Combinando l Consulta sobre los documentos enriquecidos (Texto + Soundex) Usar diferentes pesos en la consulta l Ejemplo de una consulta: l l l #weight(2. 0 palabra 1 2. 0 palabra 2 1. 0 código 1 1. 0 código 2) Asigna un peso de 2 a las palabras y un peso de 1 a los códigos Laboratorio de Tecnologías del Lenguaje 69
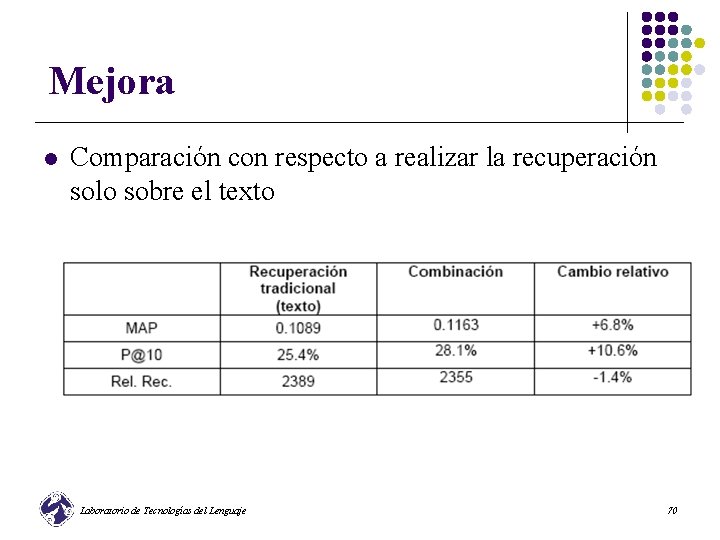
Mejora l Comparación con respecto a realizar la recuperación solo sobre el texto Laboratorio de Tecnologías del Lenguaje 70
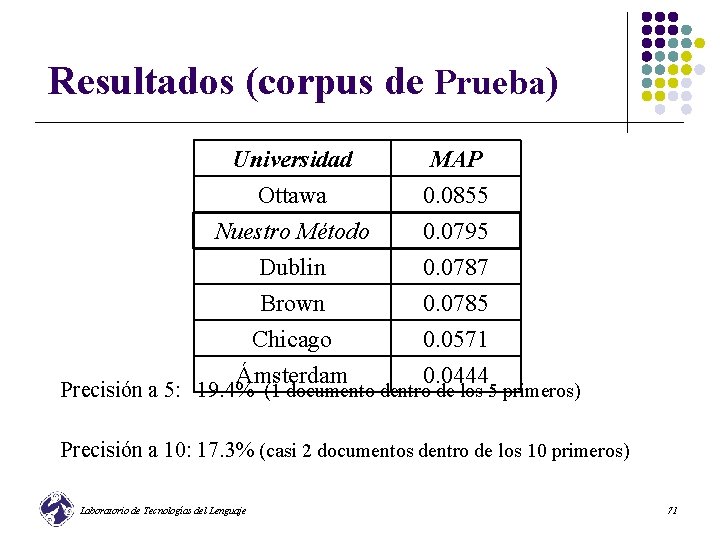
Resultados (corpus de Prueba) Universidad Ottawa Nuestro Método Dublin MAP 0. 0855 0. 0795 0. 0787 Brown Chicago Ámsterdam 0. 0785 0. 0571 0. 0444 Precisión a 5: 19. 4% (1 documento dentro de los 5 primeros) Precisión a 10: 17. 3% (casi 2 documentos dentro de los 10 primeros) Laboratorio de Tecnologías del Lenguaje 71
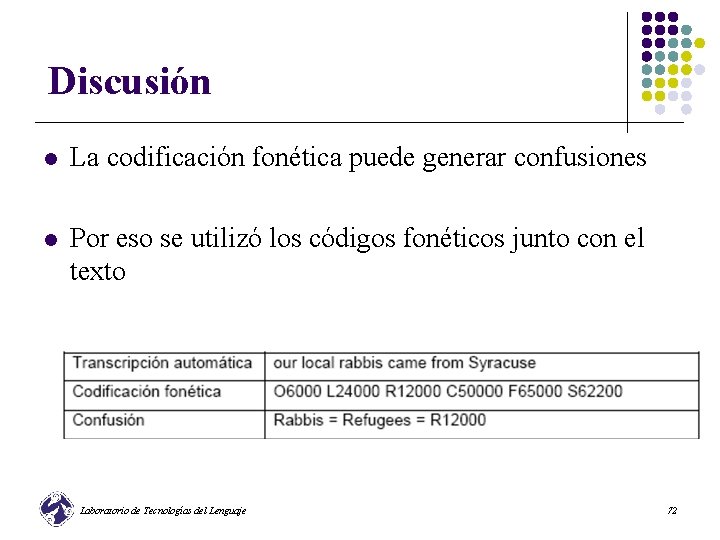
Discusión l La codificación fonética puede generar confusiones l Por eso se utilizó los códigos fonéticos junto con el texto Laboratorio de Tecnologías del Lenguaje 72
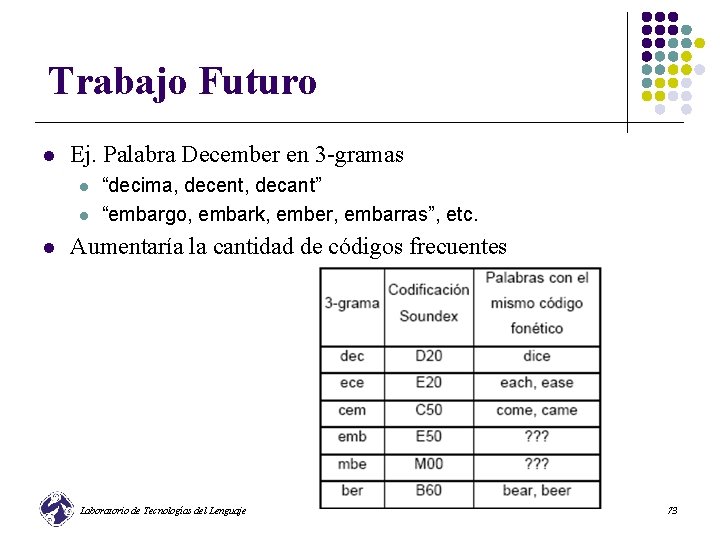
Trabajo Futuro l Ej. Palabra December en 3 -gramas l l l “decima, decent, decant” “embargo, embark, ember, embarras”, etc. Aumentaría la cantidad de códigos frecuentes Laboratorio de Tecnologías del Lenguaje 73
Aplicación: Personalizando la Interfaz • Una interfaz dinámica que cambie su apariencia o que proponga los elementos más comúnmente utilizados por un usuario específico La señal de voz abarca diferentes tipos de información: l l l l Un mensaje. Un lenguaje. La emoción. El género. La edad. La identidad del hablante. Laboratorio de Tecnologías del Lenguaje 74
Reconocimiento del hablante diferente a la Verificación de usuarios. Ø En la verificación del hablante lo que se desea es comprobar cuando la persona que habla es, o no es, la persona que afirma ser, en este caso, el sistema tiene información sobre la identidad del usuario. Ø Reconocimiento del hablante busca hacer una caracterización y reconocimiento de la identidad del hablante gracias a su señal de voz. Laboratorio de Tecnologías del Lenguaje 75
En particular l Deseamos contar con un sistema identificador de hablantes que cumpla con las siguientes restricciones: l l 1. Independiente del texto – el hablante no tenga que decir un texto en específico 2. Independencia de un reconocedor fonético – No deseamos segmentar la señal identificando los fonemas l Podemos reconocer al hablante por como pronuncia, por su timbre, por su “modismos” Laboratorio de Tecnologías del Lenguaje 76
Solución: aprendizaje automático l l Tomamos un conjunto de grabaciones de los hablantes en cuestión (un corpus) Caracterizamos las grabaciones – extraemos características acústicas de la señal de cada grabación Le entregamos al algoritmo de aprendizaje las características para cada grabación distinguiendo entre usuarios Obtenemos un clasificador Laboratorio de Tecnologías del Lenguaje 77
Corpus l l l Para las fases de entrenamiento y evaluación se usó el corpus DIMEx 100. Corpus oral para el español mexicano, conformado por grabaciones de 100 personas. Cada una de ellas grabó 50 frases (44 k. Hz). Los textos leídos son diferentes para cada individuo 3. 5 seg. voz. Duración total del corpus es de 291 minutos de voz. Laboratorio de Tecnologías del Lenguaje 78
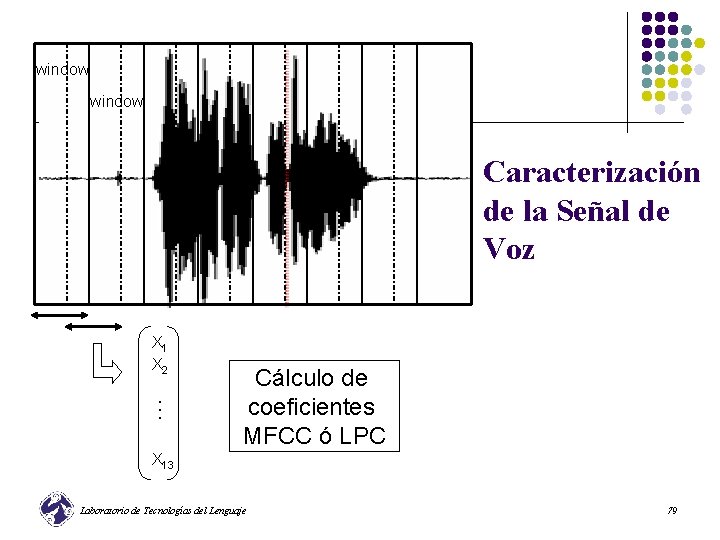
window Caracterización de la Señal de Voz X 1 X 2 … Cálculo de coeficientes MFCC ó LPC X 13 Laboratorio de Tecnologías del Lenguaje 79
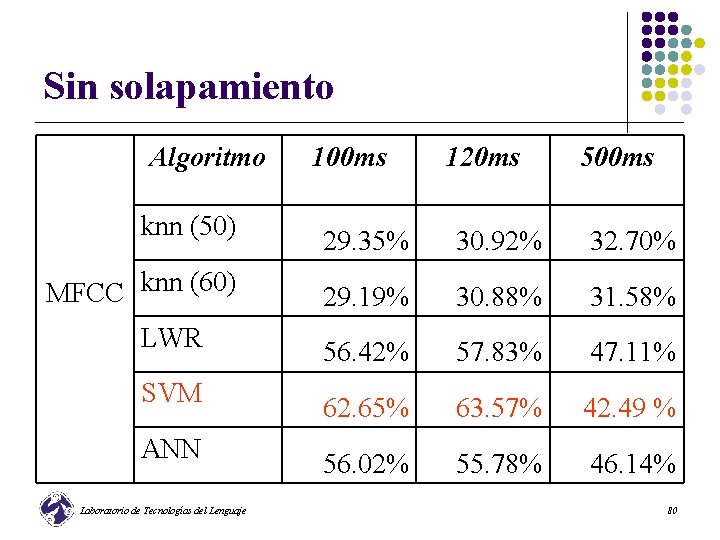
Sin solapamiento Algoritmo knn (50) MFCC knn (60) LWR SVM ANN Laboratorio de Tecnologías del Lenguaje 100 ms 120 ms 500 ms 29. 35% 30. 92% 32. 70% 29. 19% 30. 88% 31. 58% 56. 42% 57. 83% 47. 11% 62. 65% 63. 57% 42. 49 % 56. 02% 55. 78% 46. 14% 80
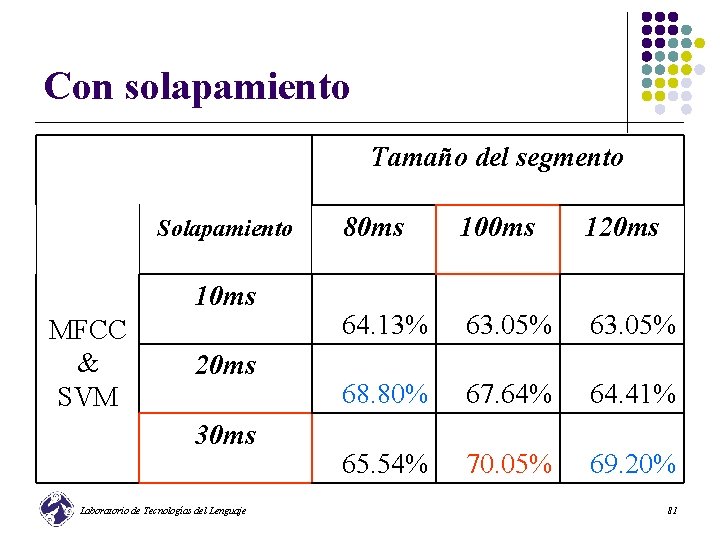
Con solapamiento Tamaño del segmento Solapamiento 10 ms MFCC & SVM 20 ms 30 ms Laboratorio de Tecnologías del Lenguaje 80 ms 100 ms 120 ms 64. 13% 63. 05% 68. 80% 67. 64% 64. 41% 65. 54% 70. 05% 69. 20% 81
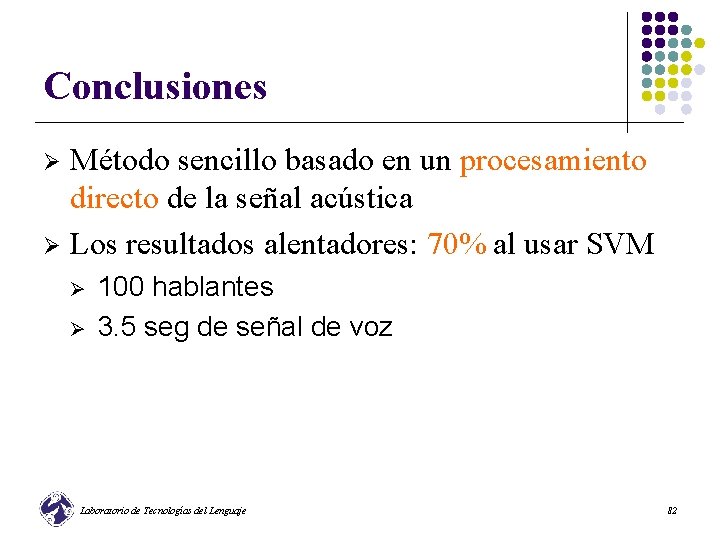
Conclusiones Método sencillo basado en un procesamiento directo de la señal acústica Ø Los resultados alentadores: 70% al usar SVM Ø Ø Ø 100 hablantes 3. 5 seg de señal de voz Laboratorio de Tecnologías del Lenguaje 82
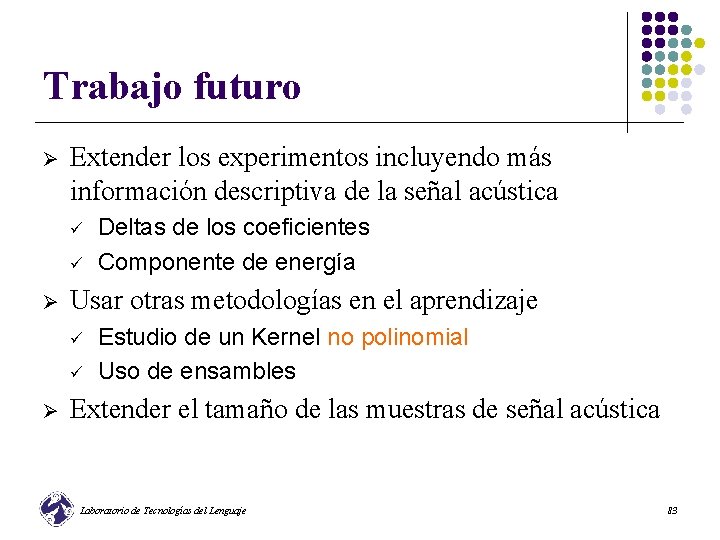
Trabajo futuro Ø Extender los experimentos incluyendo más información descriptiva de la señal acústica ü ü Ø Usar otras metodologías en el aprendizaje ü ü Ø Deltas de los coeficientes Componente de energía Estudio de un Kernel no polinomial Uso de ensambles Extender el tamaño de las muestras de señal acústica Laboratorio de Tecnologías del Lenguaje 83
Aplicación: Personalizando la Interfaz • Una interfaz dinámica que cambie su apariencia o que proponga los elementos más comúnmente utilizados por un usuario específico La señal de voz abarca diferentes tipos de información: l l l l Un mensaje. Un lenguaje. La emoción. El género. La edad. La identidad del hablante. Laboratorio de Tecnologías del Lenguaje 84
¿Cómo se ha abordado? l Primer enfoque: Basan la IAL en el empleo de características lingüísticas propias de cada lenguaje. Realizan segmentación de fonemas y utilizan modelos de lenguaje. l l Sistemas basados en reconocimiento de fonemas Segundo enfoque: Explotar directamente la señal acústica para la IAL, obteniendo características tales como la prosodia, ritmo, entonación, entre otras. l Sistemas no basados en reconocimiento de fonemas. Laboratorio de Tecnologías del Lenguaje 85
Dificultades del primer enfoque l Necesidad de un estudio previo de cada lenguaje l l l Necesidad de la creación de modelos de lenguaje l l l Un módulo para la segmentación de la señal de voz en fonemas Un proceso de etiquetado manual realizado por expertos a nivel fonético Corpus grandes de texto y/o transcripciones ortográficas de grabaciones Estadística de todos las posibles combinaciones de fonemas No son de utilidad para lenguas que no cuentan convenciones claramente establecidas para su escritura Laboratorio de Tecnologías del Lenguaje 86
Segundo enfoque l Los lingüistas parten de que existe otro tipo de características las cuales no pueden segmentarse como los fonemas, porque actúan simultáneamente sobre más de un segmento. l Suprasegmentos: el acento, el tono (sucesión de ellos – entonación-) y la duración. l El acento: l Español normalmente grave l Francés normalmente agudo Laboratorio de Tecnologías del Lenguaje 87
Características suprasegmentales l Tono: como recurso de diferenciación léxica, para lenguas como el chino o el vietnamita. l Por ejemplo: /ma/ puede significar varias cosas: l l l con un tono estático alto significa madre con tono dinámico ascendente significa cáñamo con un tono dinámico ascendente-descendente significa caballo con un tono descendente significa riña Las lenguas de la familia congo-nigerianas, sinotibetanas y algunas de las lenguas indígenas de México (otomí, mazahua, chichimeca entre otras) Laboratorio de Tecnologías del Lenguaje 88
Características suprasegmentales l Entonación: sucesión de tonos, como recurso de función expresiva, para lenguas románicas l Por ejemplo: l ¿Cómo estás? l ¿cómo? ¡estás! l Ritmo: es la pauta de tensión formada por la combinación de las sílabas tónicas y atonas, largas y breves l Ritmos: stress timed, syllable timed, acentual y silábico. Laboratorio de Tecnologías del Lenguaje 89
El problema l Como extraer las características suprasegmentales del habla, como la prosodia, el ritmo, la entonación entre otras. • [Li 1994] Localizar automáticamente el núcleo-silábico (por ejemplo las vocales). Generar vectores espectrales de regiones cercanas al núcleo silábico, tanto para entrenamiento como prueba. • [Itahasi 1994 y 1995] Uso la frecuencia fundamental (pitch) ya que su estimación es más robusta en ambientes ruidosos que los parámetros espectrales de Li • [Thyme-Gobbel y Hutchins 1996] Caracterizaron la prosodia a través contornos del pitch y la amplitud entre una sílaba y otra Laboratorio de Tecnologías del Lenguaje 90
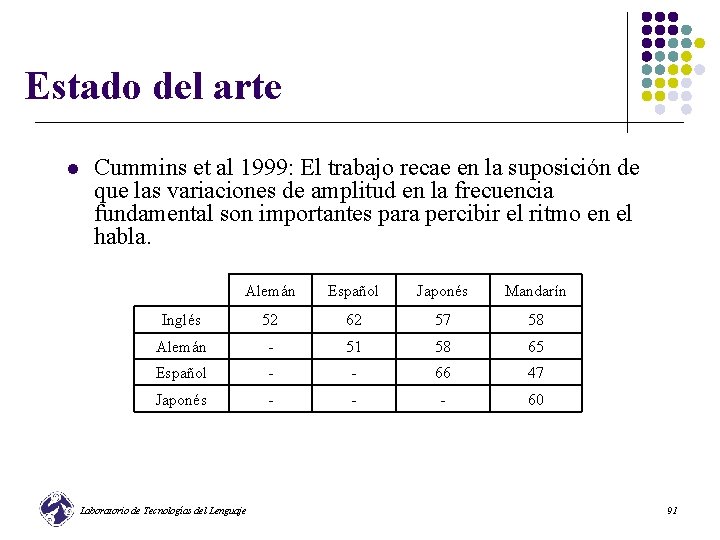
Estado del arte l Cummins et al 1999: El trabajo recae en la suposición de que las variaciones de amplitud en la frecuencia fundamental son importantes para percibir el ritmo en el habla. Alemán Español Japonés Mandarín Inglés 52 62 57 58 Alemán - 51 58 65 Español - - 66 47 Japonés - - - 60 Laboratorio de Tecnologías del Lenguaje 91
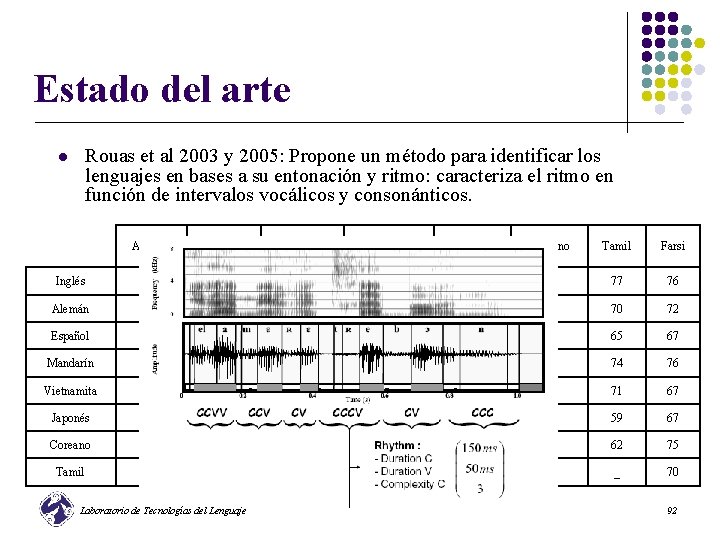
Estado del arte Rouas et al 2003 y 2005: Propone un método para identificar los lenguajes en bases a su entonación y ritmo: caracteriza el ritmo en función de intervalos vocálicos y consonánticos. l Alemán Español Mandarín Vietnamita Japonés Coreano Tamil Farsi Inglés 60 68 75 68 68 79 77 76 Alemán _ 59 62 66 66 71 70 72 Español _ _ 81 62 63 76 65 67 Mandarín _ _ _ 50 51 74 74 76 Vietnamita _ _ 69 56 71 67 Japonés _ _ _ 66 59 67 Coreano _ _ _ 62 75 Tamil _ _ _ _ 70 Laboratorio de Tecnologías del Lenguaje 92
Objetivo l Desarrollar un método para la identificación del lenguaje hablado sin recurrir a la representación fonética de la señal de voz, con un nuevo método de caracterización de los elementos suprasegmentales del habla. l Suposición: el ritmo puede ser una característica fundamental para la identificación y éste se localiza en las frecuencias bajas Laboratorio de Tecnologías del Lenguaje 93
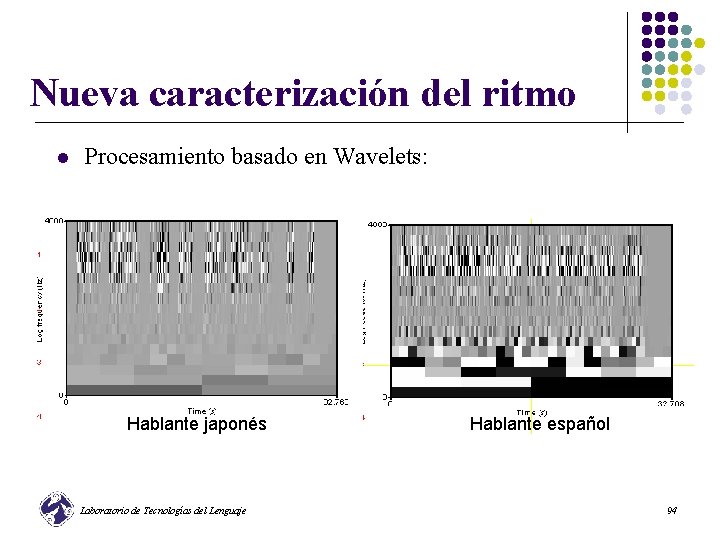
Nueva caracterización del ritmo l Procesamiento basado en Wavelets: Hablante japonés Laboratorio de Tecnologías del Lenguaje Hablante español 94
Nueva caracterización l Uso de la transformada Daubechies 4 coeficientes l Muestras de 30 y 50 seg. l Reducción de la información por medio de truncado de aproximación con un umbral del 1% Laboratorio de Tecnologías del Lenguaje 95
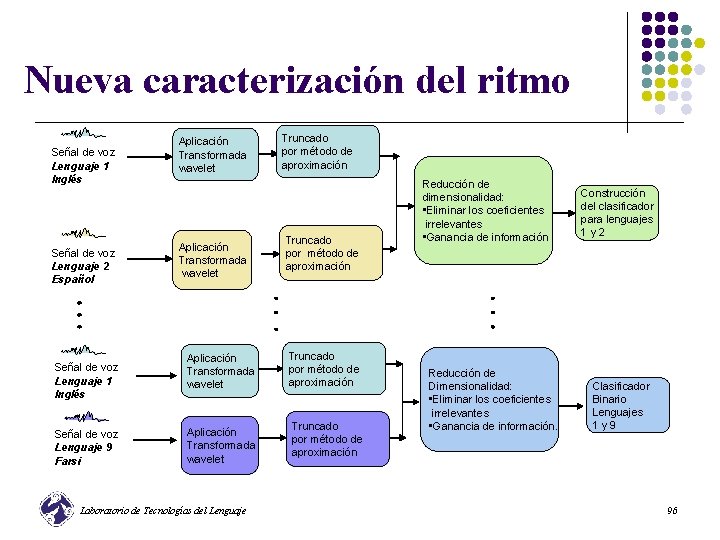
Nueva caracterización del ritmo Señal de voz Lenguaje 1 Inglés Señal de voz Lenguaje 2 Español Señal de voz Lenguaje 1 Inglés Señal de voz Lenguaje 9 Farsi Aplicación Transformada wavelet Laboratorio de Tecnologías del Lenguaje Truncado por método de aproximación Reducción de dimensionalidad: • Eliminar los coeficientes irrelevantes • Ganancia de información Reducción de Dimensionalidad: • Eliminar los coeficientes irrelevantes • Ganancia de información. Construcción del clasificador para lenguajes 1 y 2 Clasificador Binario Lenguajes 1 y 9 96
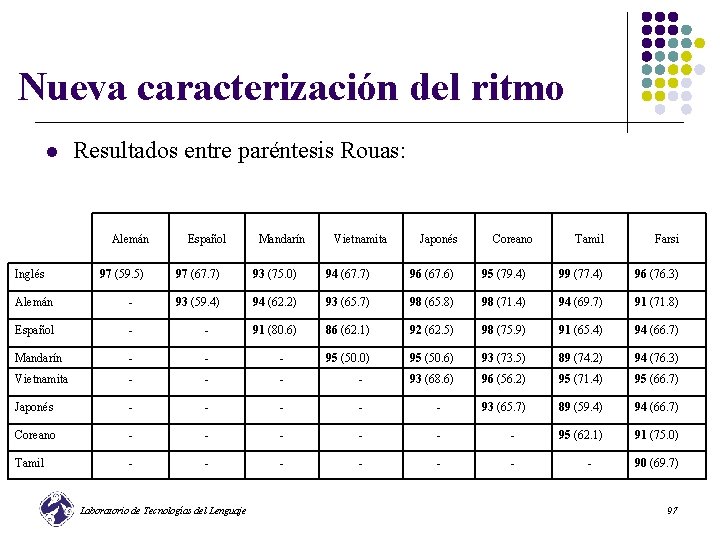
Nueva caracterización del ritmo l Resultados entre paréntesis Rouas: Alemán Inglés 97 (59. 5) Español Mandarín Vietnamita Japonés Coreano Tamil Farsi 97 (67. 7) 93 (75. 0) 94 (67. 7) 96 (67. 6) 95 (79. 4) 99 (77. 4) 96 (76. 3) 93 (59. 4) 94 (62. 2) 93 (65. 7) 98 (65. 8) 98 (71. 4) 94 (69. 7) 91 (71. 8) 91 (80. 6) 86 (62. 1) 92 (62. 5) 98 (75. 9) 91 (65. 4) 94 (66. 7) 95 (50. 0) 95 (50. 6) 93 (73. 5) 89 (74. 2) 94 (76. 3) 93 (68. 6) 96 (56. 2) 95 (71. 4) 95 (66. 7) 93 (65. 7) 89 (59. 4) 94 (66. 7) 95 (62. 1) 91 (75. 0) Alemán - Español - - Mandarín - - - Vietnamita - - Japonés - - - Coreano - - - Tamil - - - Laboratorio de Tecnologías del Lenguaje - 90 (69. 7) 97
Resultados promedio Laboratorio de Tecnologías del Lenguaje 98
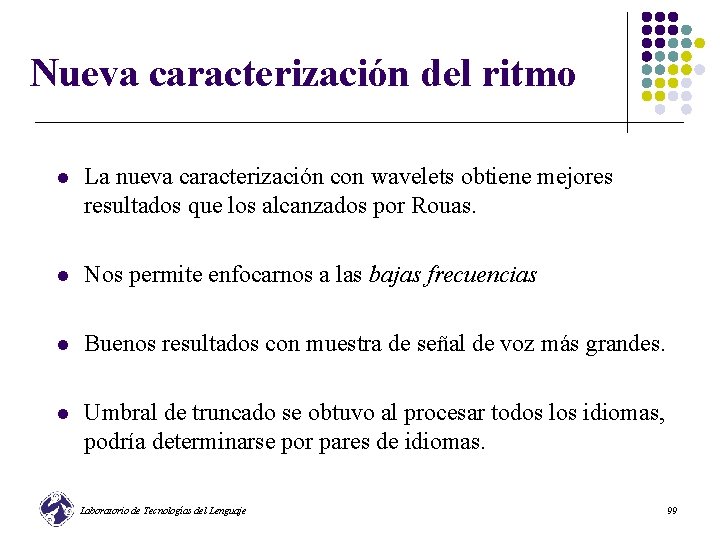
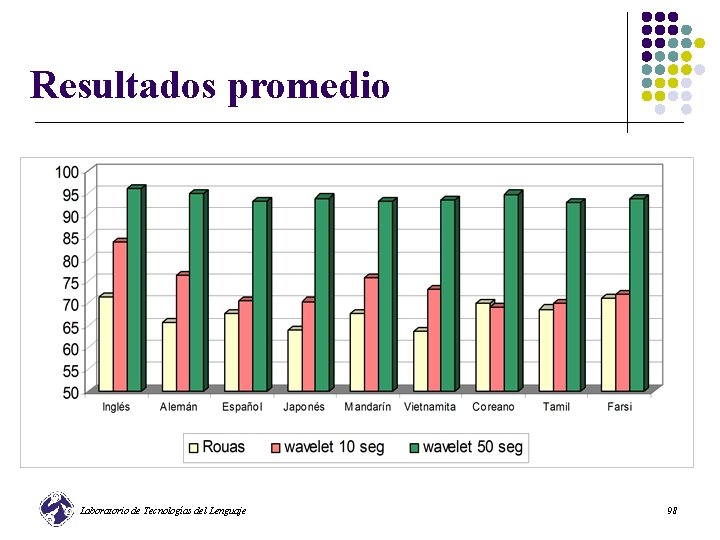
Nueva caracterización del ritmo l La nueva caracterización con wavelets obtiene mejores resultados que los alcanzados por Rouas. l Nos permite enfocarnos a las bajas frecuencias l Buenos resultados con muestra de señal de voz más grandes. l Umbral de truncado se obtuvo al procesar todos los idiomas, podría determinarse por pares de idiomas. Laboratorio de Tecnologías del Lenguaje 99
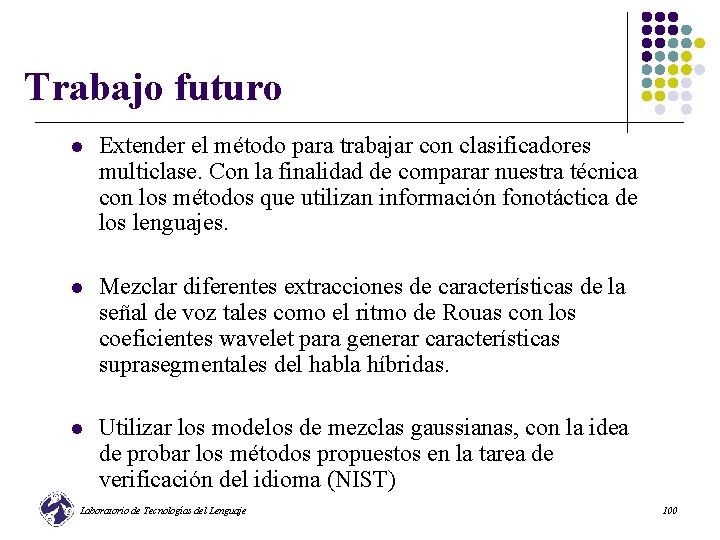
Trabajo futuro l Extender el método para trabajar con clasificadores multiclase. Con la finalidad de comparar nuestra técnica con los métodos que utilizan información fonotáctica de los lenguajes. l Mezclar diferentes extracciones de características de la señal de voz tales como el ritmo de Rouas con los coeficientes wavelet para generar características suprasegmentales del habla híbridas. l Utilizar los modelos de mezclas gaussianas, con la idea de probar los métodos propuestos en la tarea de verificación del idioma (NIST) Laboratorio de Tecnologías del Lenguaje 100
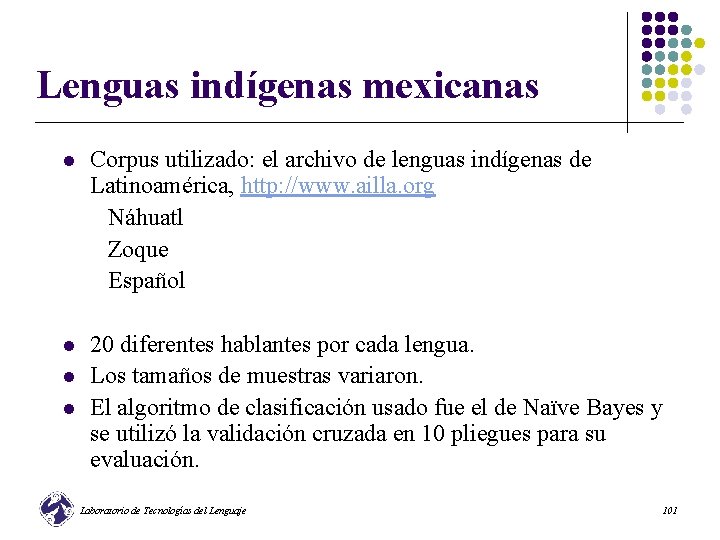
Lenguas indígenas mexicanas l Corpus utilizado: el archivo de lenguas indígenas de Latinoamérica, http: //www. ailla. org Náhuatl Zoque Español l 20 diferentes hablantes por cada lengua. Los tamaños de muestras variaron. El algoritmo de clasificación usado fue el de Naïve Bayes y se utilizó la validación cruzada en 10 pliegues para su evaluación. l l Laboratorio de Tecnologías del Lenguaje 101
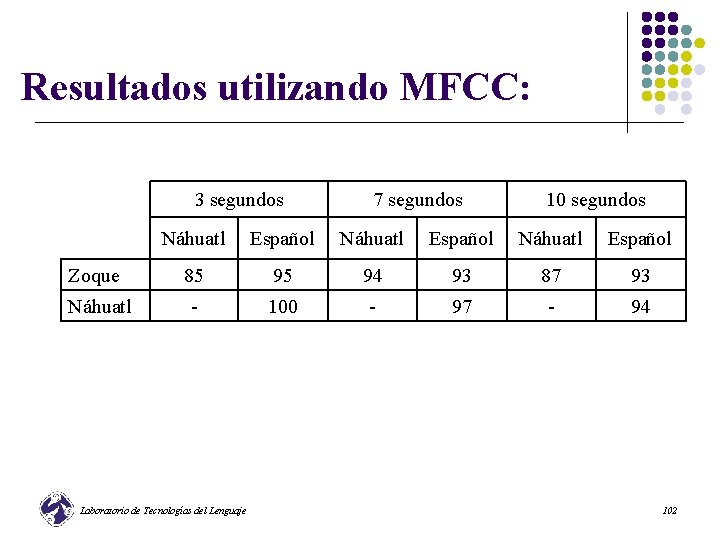
Resultados utilizando MFCC: 3 segundos Zoque Náhuatl 7 segundos 10 segundos Náhuatl Español 85 95 94 93 87 93 - 100 - 97 - 94 Laboratorio de Tecnologías del Lenguaje 102
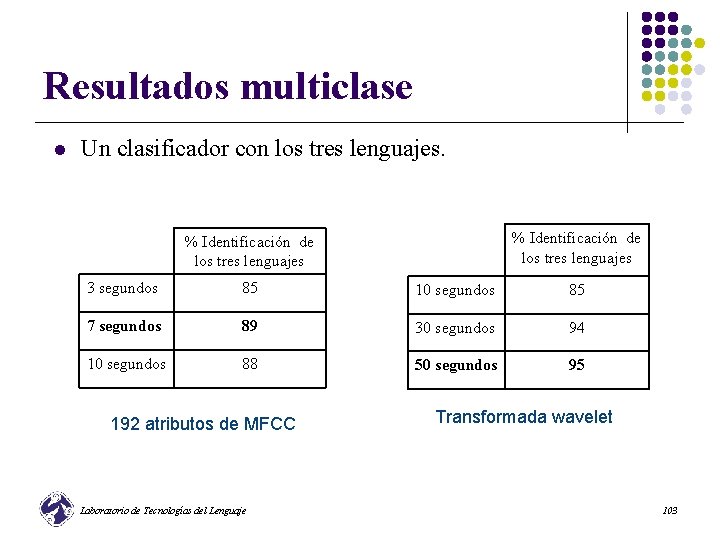
Resultados multiclase l Un clasificador con los tres lenguajes. % Identificación de los tres lenguajes 3 segundos 85 10 segundos 85 7 segundos 89 30 segundos 94 10 segundos 88 50 segundos 95 192 atributos de MFCC Laboratorio de Tecnologías del Lenguaje Transformada wavelet 103
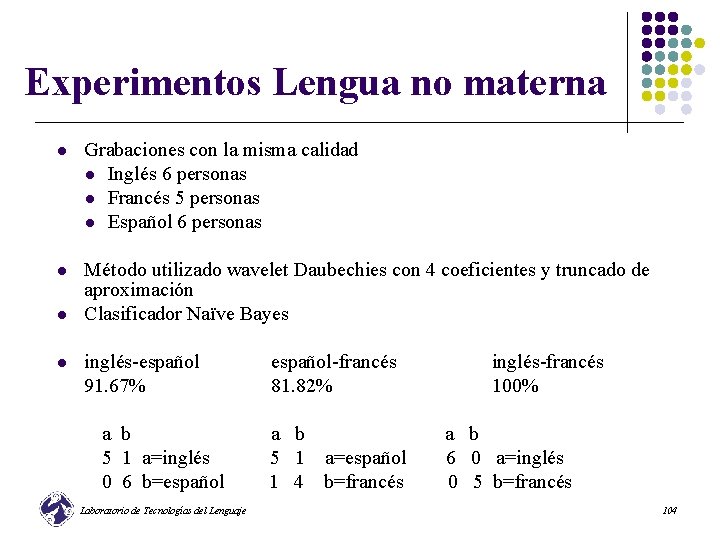
Experimentos Lengua no materna l Grabaciones con la misma calidad l Inglés 6 personas l Francés 5 personas l Español 6 personas l Método utilizado wavelet Daubechies con 4 coeficientes y truncado de aproximación Clasificador Naïve Bayes l l inglés-español 91. 67% español-francés 81. 82% inglés-francés 100% a b a b 5 1 a=inglés 5 1 a=español 6 0 a=inglés 0 6 b=español 1 4 b=francés 0 5 b=francés Laboratorio de Tecnologías del Lenguaje 104
- Slides: 104