
Prefix Span Mining Sequential Patterns Efficiently by PrefixProjected
Prefix. Span� Mining Sequential Patterns Efficiently by Prefix-Projected Pattern Growth 學生 : 907737 張資昊 907747 蔡明成 指導老師 : 劉俞志
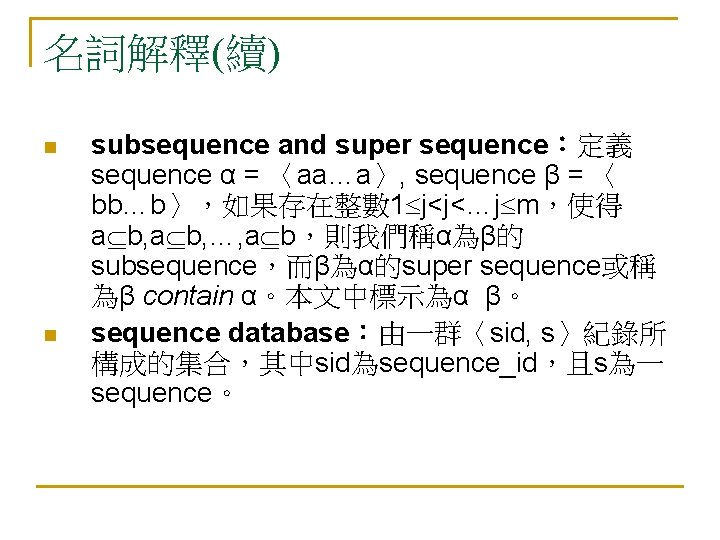
名詞解釋(續) n n subsequence and super sequence:定義 sequence α = 〈aa…a〉, sequence β = 〈 bb…b〉,如果存在整數 1 j<j<…j m,使得 a b, …, a b,則我們稱α為β的 subsequence,而β為α的super sequence或稱 為β contain α。本文中標示為α β。 sequence database:由一群〈sid, s〉紀錄所 構成的集合,其中sid為sequence_id,且s為一 sequence。
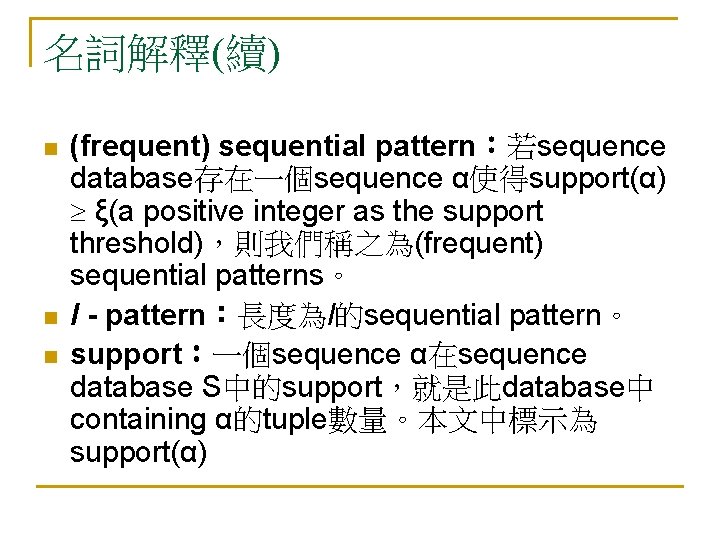
名詞解釋(續) n n n (frequent) sequential pattern:若sequence database存在一個sequence α使得support(α) ξ(a positive integer as the support threshold),則我們稱之為(frequent) sequential patterns。 l - pattern:長度為l的sequential pattern。 support:一個sequence α在sequence database S中的support,就是此database中 containing α的tuple數量。本文中標示為 support(α)
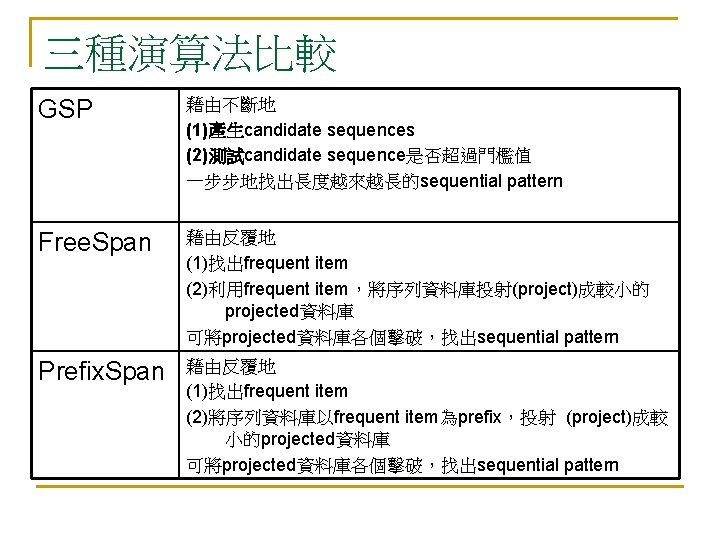
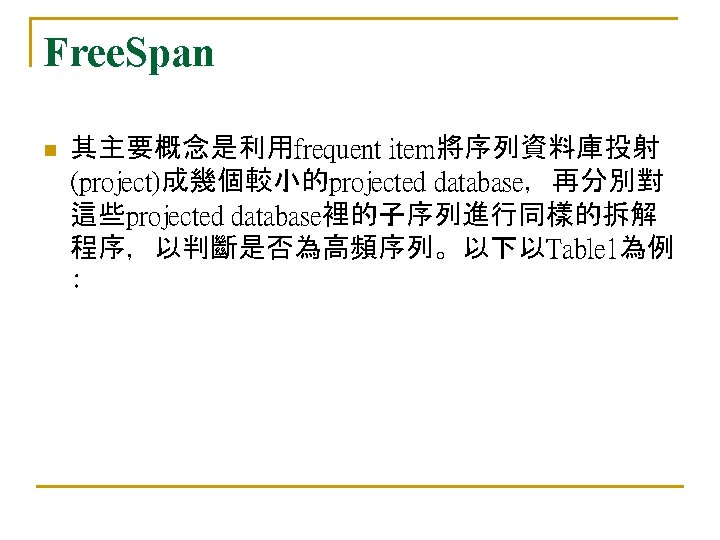
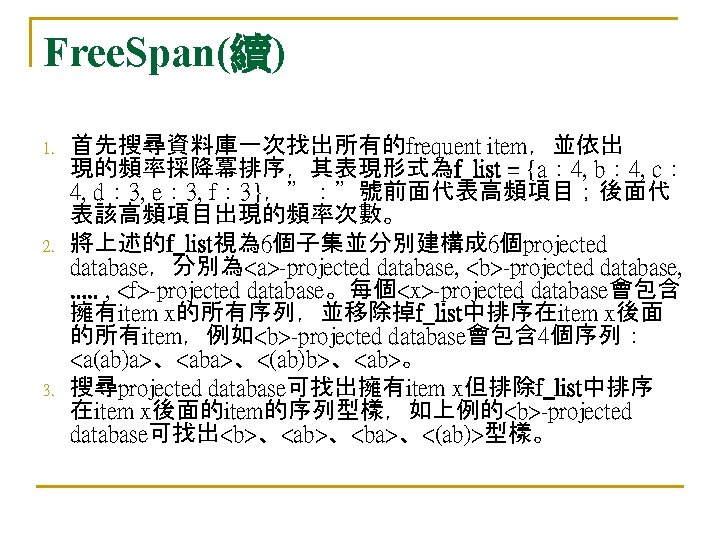
三種演算法比較 GSP 藉由不斷地 (1)產生candidate sequences (2)測試candidate sequence是否超過門檻值 一步步地找出長度越來越長的sequential pattern Free. Span 藉由反覆地 (1)找出frequent item (2)利用frequent item,將序列資料庫投射(project)成較小的 projected資料庫 可將projected資料庫各個擊破,找出sequential pattern Prefix. Span 藉由反覆地 (1)找出frequent item (2)將序列資料庫以frequent item為prefix,投射 (project)成較 小的projected資料庫 可將projected資料庫各個擊破,找出sequential pattern
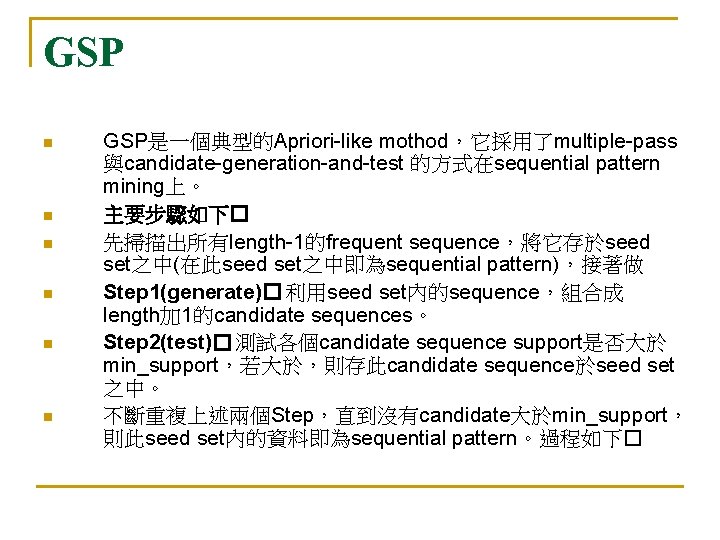
GSP n n n GSP是一個典型的Apriori-like mothod,它採用了multiple-pass 與candidate-generation-and-test 的方式在sequential pattern mining上。 主要步驟如下� 先掃描出所有length-1的frequent sequence,將它存於seed set之中(在此seed set之中即為sequential pattern),接著做 Step 1(generate)� 利用seed set內的sequence,組合成 length加 1的candidate sequences。 Step 2(test)� 測試各個candidate sequence support是否大於 min_support,若大於,則存此candidate sequence於seed set 之中。 不斷重複上述兩個Step,直到沒有candidate大於min_support, 則此seed set內的資料即為sequential pattern。過程如下�
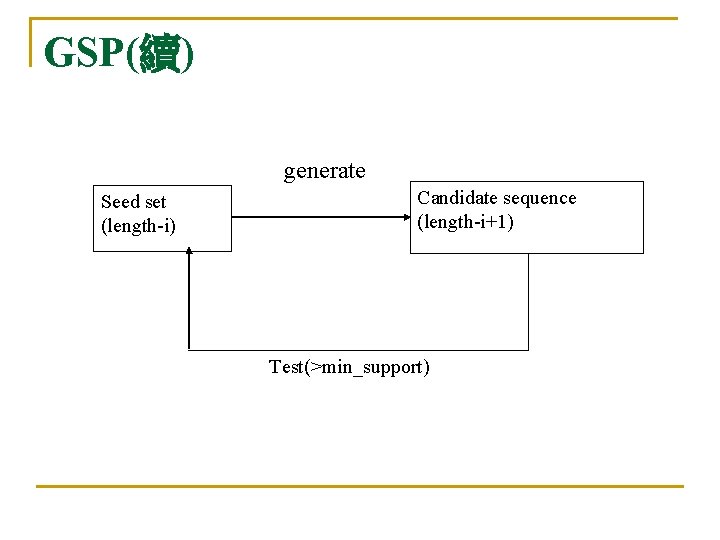
GSP(續) generate Seed set (length-i) Candidate sequence (length-i+1) Test(>min_support)
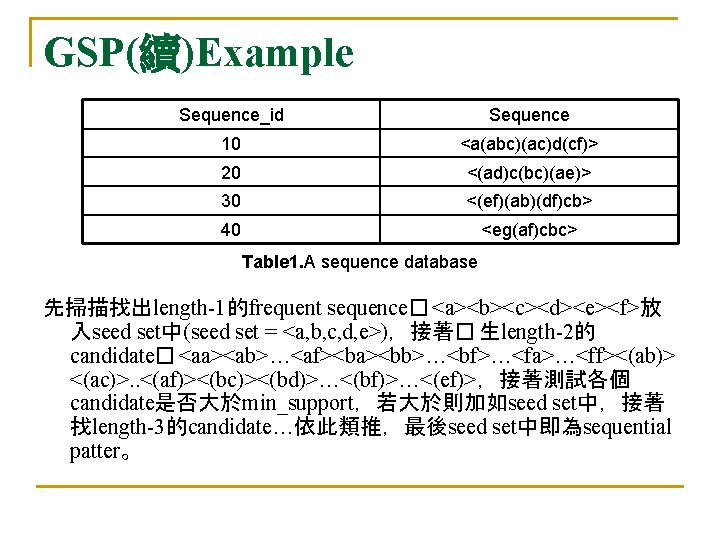
GSP(續)Example Sequence_id Sequence 10 <a(abc)(ac)d(cf)> 20 <(ad)c(bc)(ae)> 30 <(ef)(ab)(df)cb> 40 <eg(af)cbc> Table 1. A sequence database 先掃描找出length-1的frequent sequence� <a><b><c><d><e><f>放 入seed set中(seed set = <a, b, c, d, e>),接著� 生length-2的 candidate� <aa><ab>…<af><ba><bb>…<bf>…<fa>…<ff><(ab)> <(ac)>. . <(af)><(bc)><(bd)>…<(bf)>…<(ef)>,接著測試各個 candidate是否大於min_support,若大於則加如seed set中,接著 找length-3的candidate…依此類推,最後seed set中即為sequential patter。
GSP(續) Apriori-like的缺點 q q q 會產生大量的candidate sequence (例如: 1000個 length-1的frequent sequence將會產生 1, 499, 500 個候選序列)。 必須重複多次掃描資料庫。 難以挖掘較長的sequential pattern。
Mining sequential patterns by prefix projections n 一般sequence中element所包含的items是未 經過整理且沒有一定順序性的,因此本文在此 假設element中的items是透過字母排序的。例 如,將〈a(bac)(ca)d(fc)〉整理為〈 a(abc)(ac)d(cf)〉使得sequence的表示方法得 以一致。
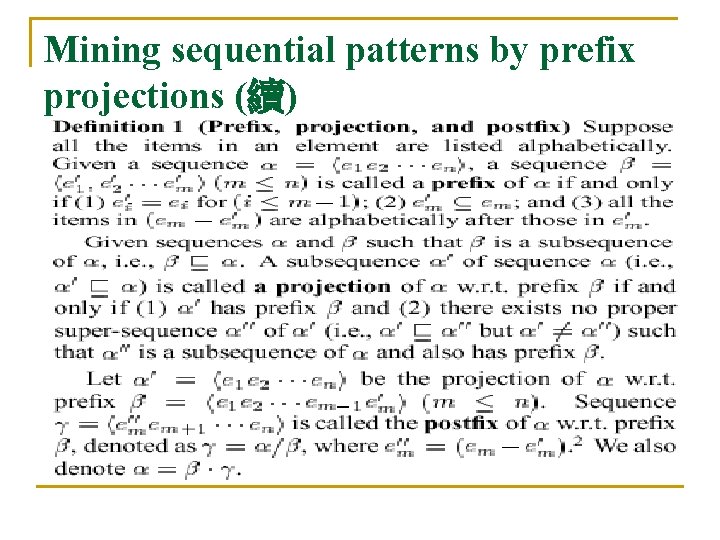
Mining sequential patterns by prefix projections (續)
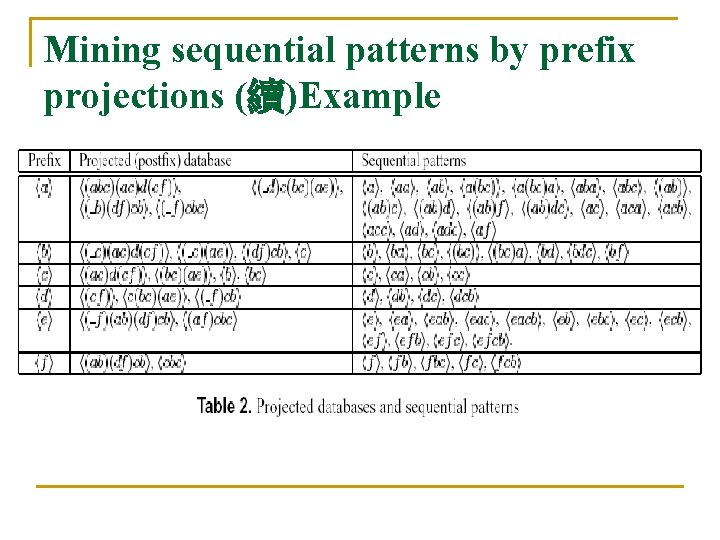
Mining sequential patterns by prefix projections (續)Example n n Example (Prefix. Span) � 我們使用Table 1中的 sequence database S及min_sup為 2例子透過prefixprojection method來mining,如以下步驟: Step 1:先找length-1的sequential patterns。透過 掃描S一次我們可以得到length-1的sequential pattern 〈a〉: 4, 〈b〉: 4, 〈c〉: 4, 〈d〉: 3, 〈e〉: 3, 〈f〉: 3(〈pattern〉:計算出的support值)。 Step 2:分割搜尋空間。將這些sequential patterns 切割為六個,包括(1)具有prefix〈a〉;…;(6)具有 prefix〈f〉的。 Step 3:找出sequential patterns的subsets。 藉由 以下方法建立projected databases及利用遞迴方式來 mining,如Table 2�
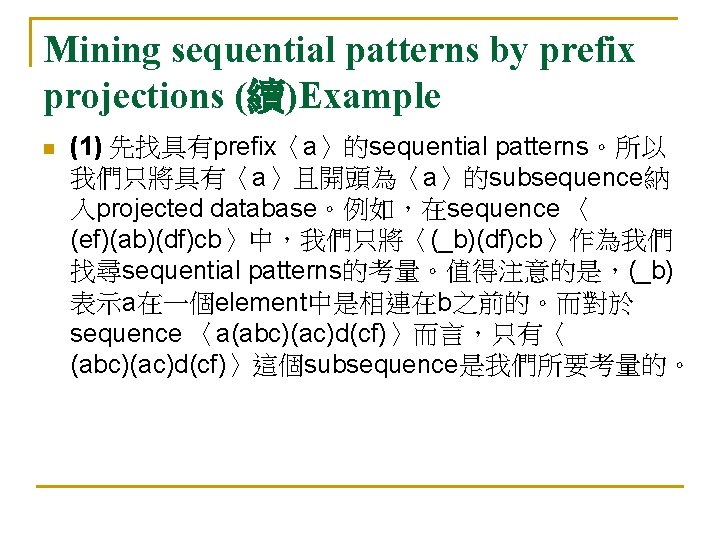
Mining sequential patterns by prefix projections (續)Example n (1) 先找具有prefix〈a〉的sequential patterns。所以 我們只將具有〈a〉且開頭為〈a〉的subsequence納 入projected database。例如,在sequence 〈 (ef)(ab)(df)cb〉中,我們只將〈(_b)(df)cb〉作為我們 找尋sequential patterns的考量。值得注意的是,(_b) 表示a在一個element中是相連在b之前的。而對於 sequence 〈a(abc)(ac)d(cf)〉而言,只有〈 (abc)(ac)d(cf)〉這個subsequence是我們所要考量的。
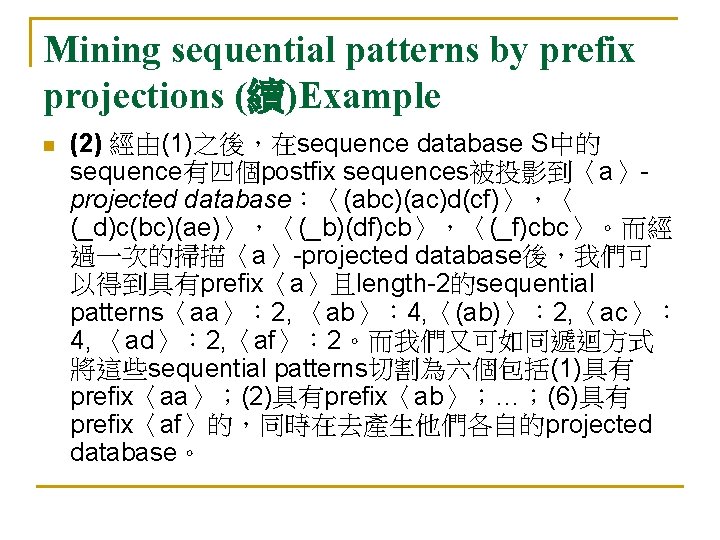
Mining sequential patterns by prefix projections (續)Example n (2) 經由(1)之後,在sequence database S中的 sequence有四個postfix sequences被投影到〈a〉projected database:〈(abc)(ac)d(cf)〉,〈 (_d)c(bc)(ae)〉,〈(_b)(df)cb〉,〈(_f)cbc〉。而經 過一次的掃描〈a〉-projected database後,我們可 以得到具有prefix〈a〉且length-2的sequential patterns〈aa〉: 2, 〈ab〉: 4, 〈(ab)〉: 2, 〈ac〉: 4, 〈ad〉: 2, 〈af〉: 2。而我們又可如同遞迴方式 將這些sequential patterns切割為六個包括(1)具有 prefix〈aa〉;(2)具有prefix〈ab〉;…;(6)具有 prefix〈af〉的,同時在去產生他們各自的projected database。
Mining sequential patterns by prefix projections (續)Example n (3) 當某個prefix的projected database只剩下 少於min_sup的(postfix) subsequences時,我 們就可確定其無法再產生sequential patterns 了,也就不用繼續再進行下去了。如上例中〈 aa〉-projected database只會剩下一個 subsequence 〈(_bc)(ac)d(cf)〉。
Mining sequential patterns by prefix projections (續)Example
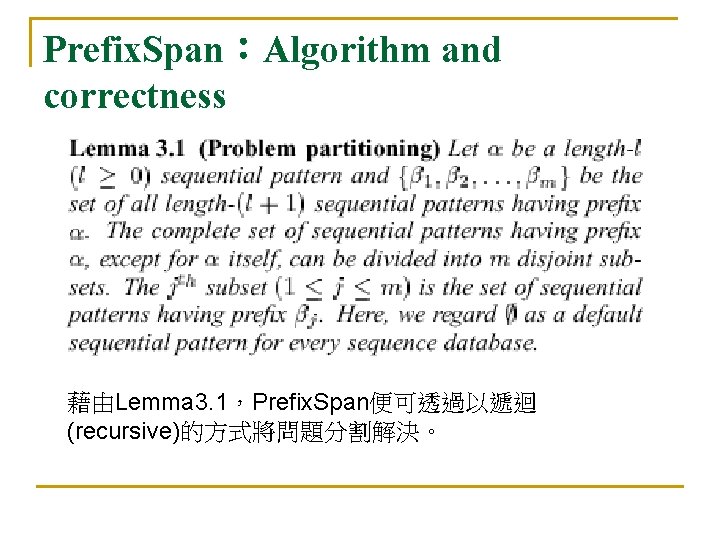
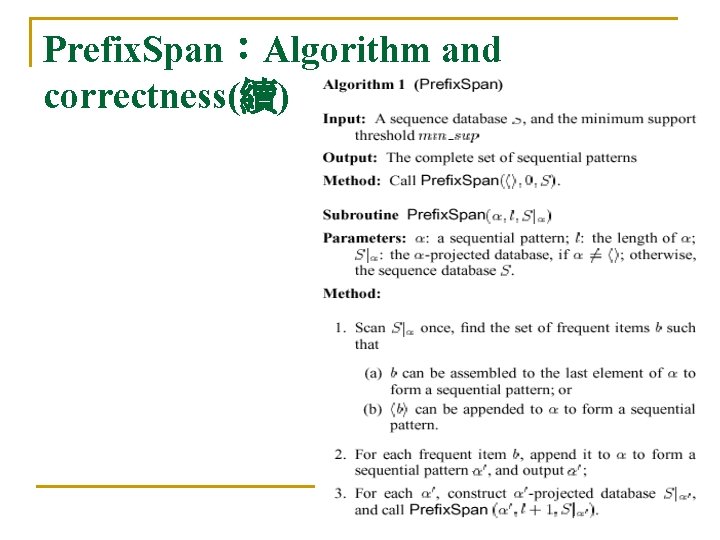
Prefix. Span:Algorithm and correctness 藉由Lemma 3. 1,Prefix. Span便可透過以遞迴 (recursive)的方式將問題分割解決。
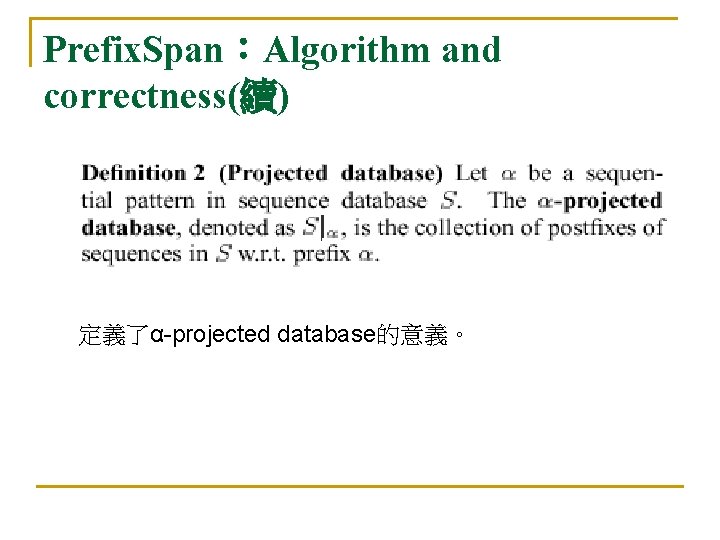
Prefix. Span:Algorithm and correctness(續) 定義了α-projected database的意義。
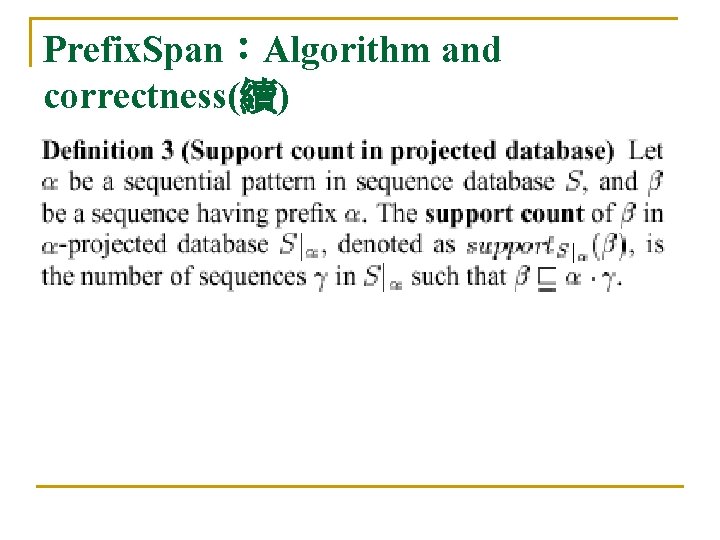
Prefix. Span:Algorithm and correctness(續)
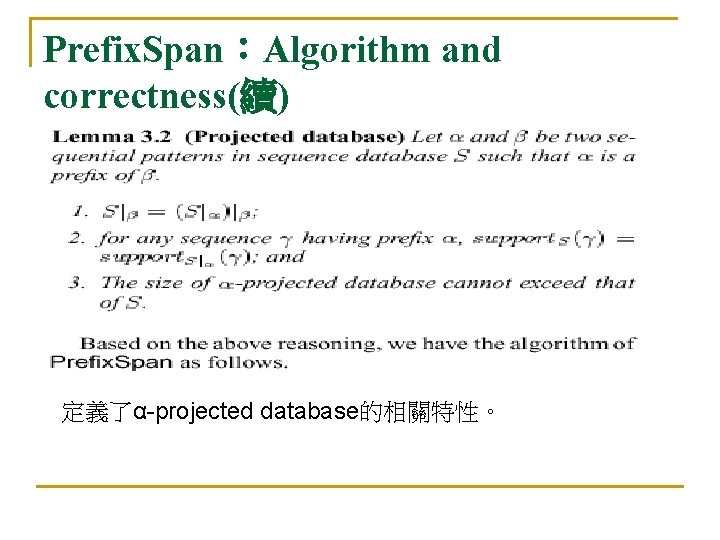
Prefix. Span:Algorithm and correctness(續) 定義了α-projected database的相關特性。
Prefix. Span:Algorithm and correctness(續)
Scaling up pattern growth by bi-level projection n n 由於Prefix. Span的主要成本在於projected databases 的建立,因此本節利用bi-level projection來降低 projected database的空間,其介紹如下� Example 4 � Step 1� 與3. 2節level-by-level projection方式相同, 先掃描序列資料庫S找出length-1 sequential pattern� <a>, <b>, <c>, <d>, <e>, <f>. Step 2� 用 6× 6 matrix代替建立projected database-如 下圖Table 3�
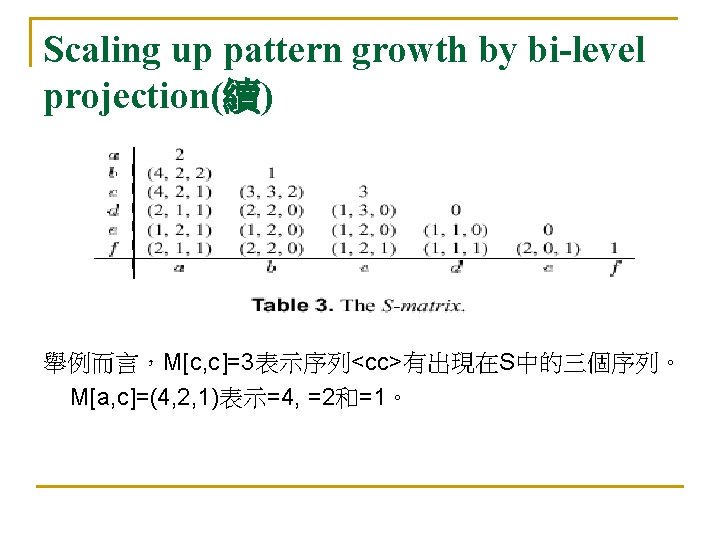
Scaling up pattern growth by bi-level projection(續) 舉例而言,M[c, c]=3表示序列<cc>有出現在S中的三個序列。 M[a, c]=(4, 2, 1)表示=4, =2和=1。
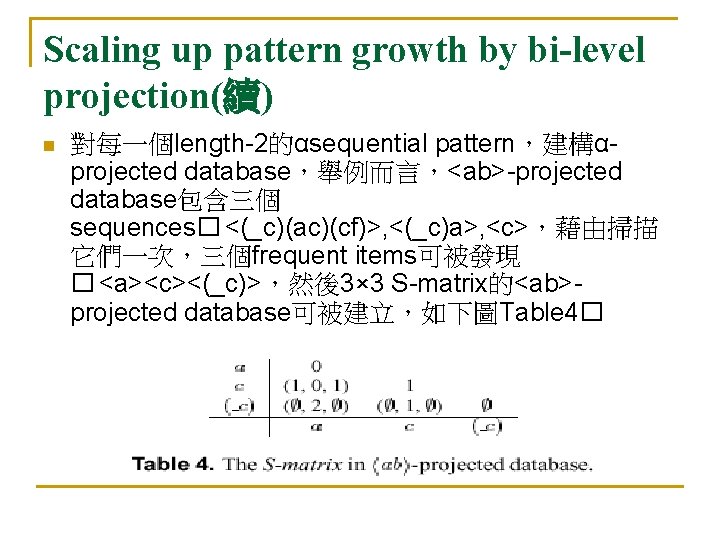
Scaling up pattern growth by bi-level projection(續) n 對每一個length-2的αsequential pattern,建構αprojected database,舉例而言,<ab>-projected database包含三個 sequences� <(_c)(ac)(cf)>, <(_c)a>, <c>,藉由掃描 它們一次,三個frequent items可被發現 � <a><c><(_c)>,然後3× 3 S-matrix的<ab>projected database可被建立,如下圖Table 4�
Scaling up pattern growth by bi-level projection(續) n 由圖所示,只有<(_c)a>可以被產生成 sequential pattern(support=2),不需要進一步 的projection(因為其中有一sequence<(_c)a> 已無希望產生更長的pattern),所以bi-level的 方法較level-by-level節省空間,以Example 3 為例,level-by-level需產生 53個projected database,而用bi-level只需產生 22個(只需要 length-2的sequential pattern)。
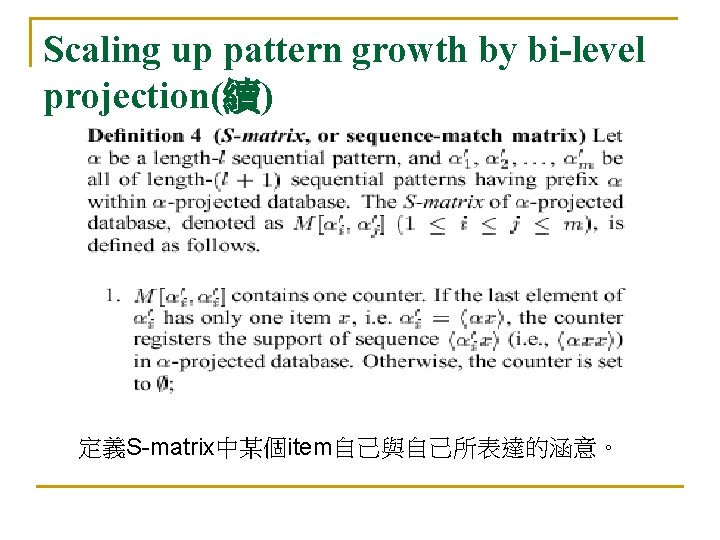
Scaling up pattern growth by bi-level projection(續) 定義S-matrix中某個item自己與自己所表達的涵意。
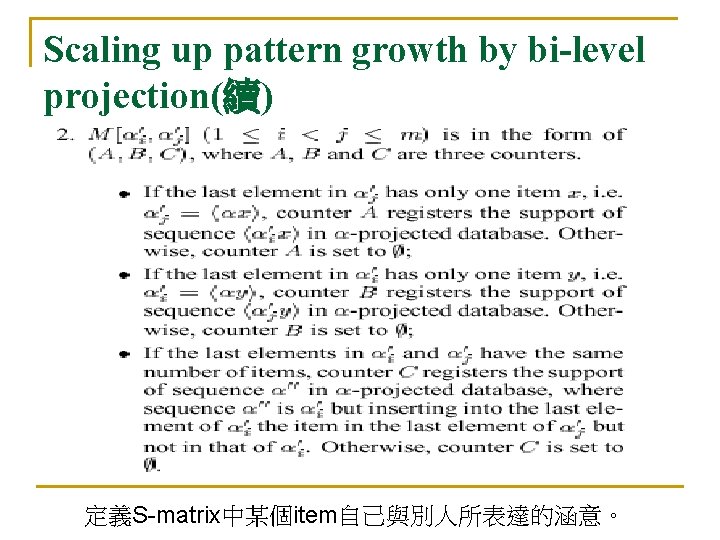
Scaling up pattern growth by bi-level projection(續) 定義S-matrix中某個item自己與別人所表達的涵意。
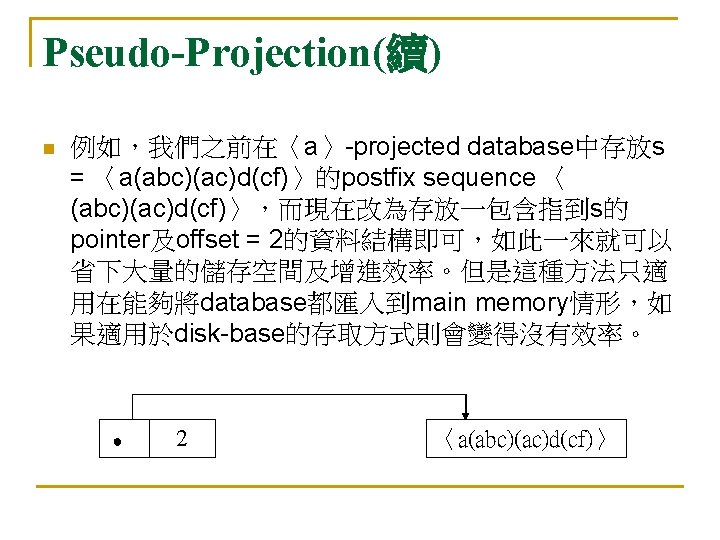
Pseudo-Projection n 對於Prefix. Span而言,最主要的成本在於不斷 的遞迴建置projected database。所以本文採 用一種所謂pseudo-projection technique來減 少這些建置成本。這是一種藉由儲存對應 sequence之pointer及offset的方式來省去儲 存大量postfix subsequences的空間。
Experimental Results and Performance Study n 實驗配備: 233 MHz Pentium PC machine with 128 megabytes main memory,running Microsoft Windows/NT. All the method using Microsoft Visual C++ 6. 0。 n 4種方法之效能比較� GSP. Free. Span with alternative level projected. Prefix. Span-1. Prefix. Span with level-by-level projected. Prefix. Span-2. Prefix. Span with bi-level projected. n n
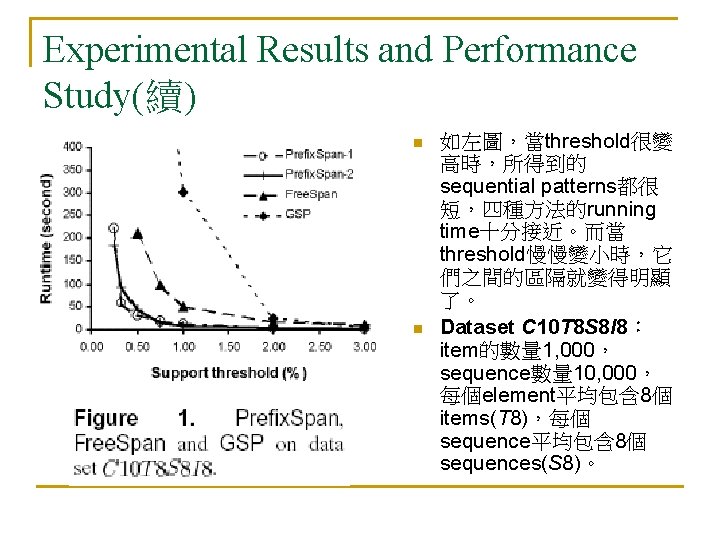
Experimental Results and Performance Study(續) n n 如左圖,當threshold很變 高時,所得到的 sequential patterns都很 短,四種方法的running time十分接近。而當 threshold慢慢變小時,它 們之間的區隔就變得明顯 了。 Dataset C 10 T 8 S 8 I 8: item的數量 1, 000, sequence數量 10, 000, 每個element平均包含 8個 items(T 8),每個 sequence平均包含 8個 sequences(S 8)。
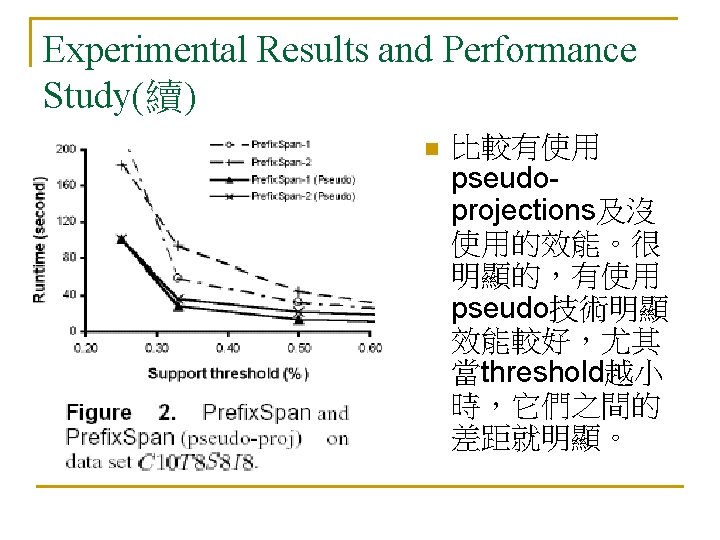
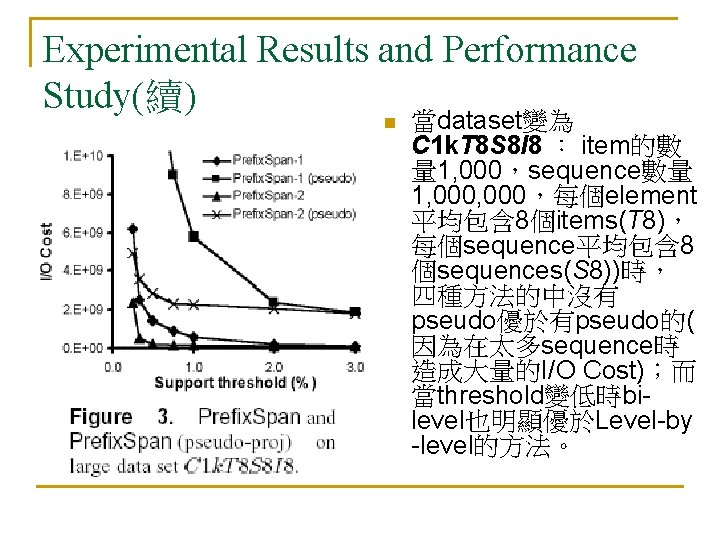
Experimental Results and Performance Study(續) n 當dataset變為 C 1 k. T 8 S 8 I 8 : item的數 量 1, 000,sequence數量 1, 000,每個element 平均包含 8個items(T 8), 每個sequence平均包含 8 個sequences(S 8))時, 四種方法的中沒有 pseudo優於有pseudo的( 因為在太多sequence時 造成大量的I/O Cost);而 當threshold變低時bilevel也明顯優於Level-by -level的方法。
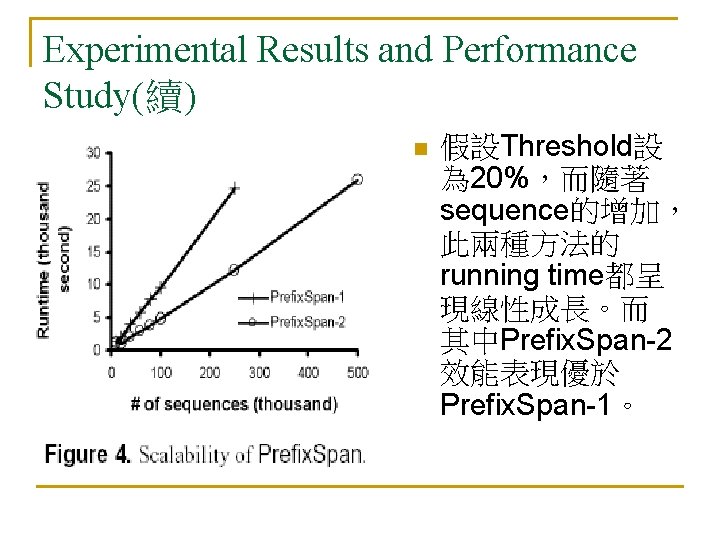
Experimental Results and Performance Study(續) n 假設Threshold設 為 20%,而隨著 sequence的增加, 此兩種方法的 running time都呈 現線性成長。而 其中Prefix. Span-2 效能表現優於 Prefix. Span-1。
Experimental Results and Performance Study(續) n 總結以上,此效能測試顯示在threshold較小時, 效能及擴充性表現Prefix. Span優於Free. Span 及GSP,而Free. Span又優於GSP;而 Prefix. Span-2使用bi-level可大量減少 Projection的數量,所以在低low threshold需 產生大量projection時,效能表現優於 Prefix. Span-1。而若能將database全部載入 main memory,則能使用pseudo的方法來增 加效能及節省空間。
問題討論 n n n Prefix. Span與Free. Span產生pattern方法皆 著重在與frequent item有關的projected database,故其效能較佳。 Prefix. Span較Free. Span能有效縮減 projected database。 Apriori 的特性被整合到Prefix. Span的bilevel projection(例如3 -way checking)。
Q&A
- Slides: 42