
My SQL HDFS MYSQL HDFS Hive Hive HDFS
- Slides: 54
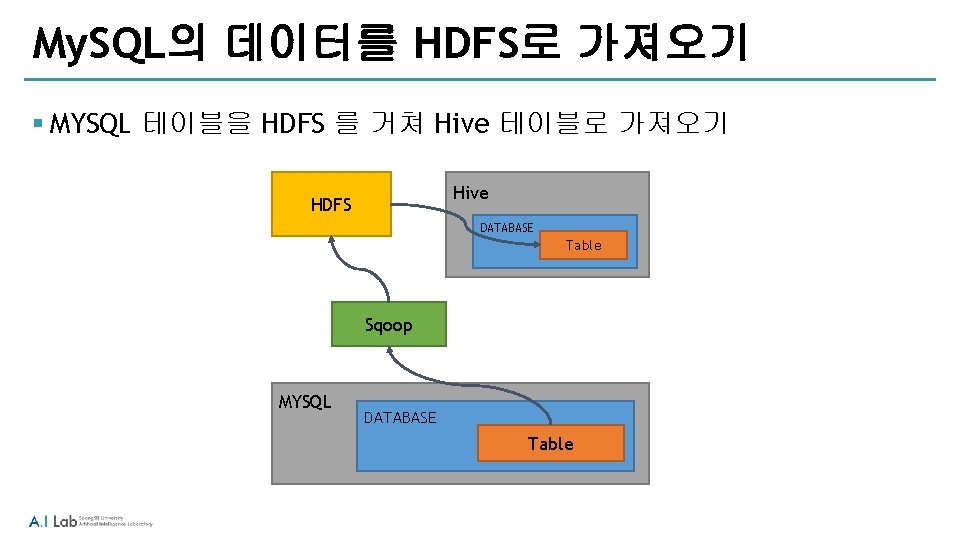
My. SQL의 데이터를 HDFS로 가져오기 § MYSQL 테이블을 HDFS 를 거쳐 Hive 테이블로 가져오기 Hive HDFS DATABASE Table Sqoop MYSQL DATABASE Table
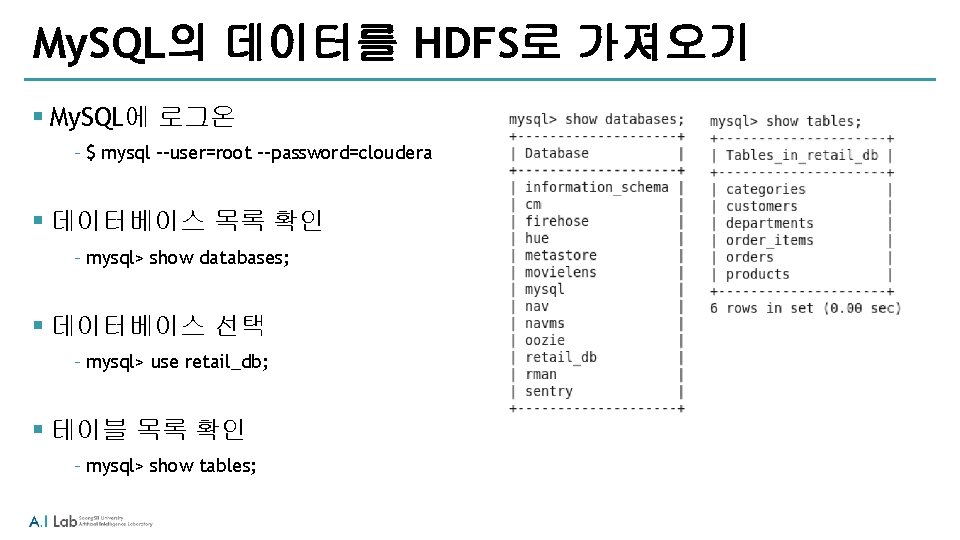
My. SQL의 데이터를 HDFS로 가져오기 § My. SQL에 로그온 ‐$ mysql –-user=root –-password=cloudera § 데이터베이스 목록 확인 ‐mysql> show databases; § 데이터베이스 선택 ‐mysql> use retail_db; § 테이블 목록 확인 ‐mysql> show tables;
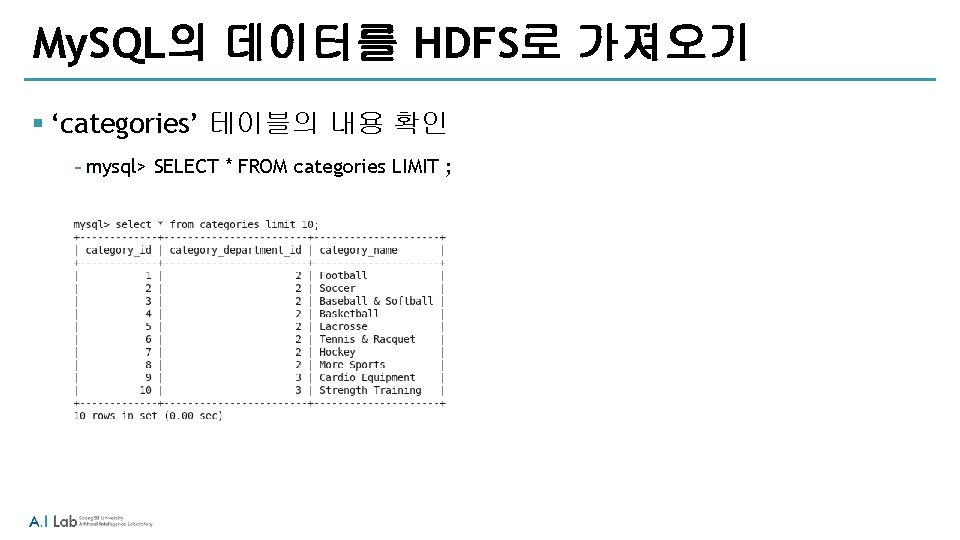
My. SQL의 데이터를 HDFS로 가져오기 § ‘categories’ 테이블의 내용 확인 ‐mysql> SELECT * FROM categories LIMIT ;
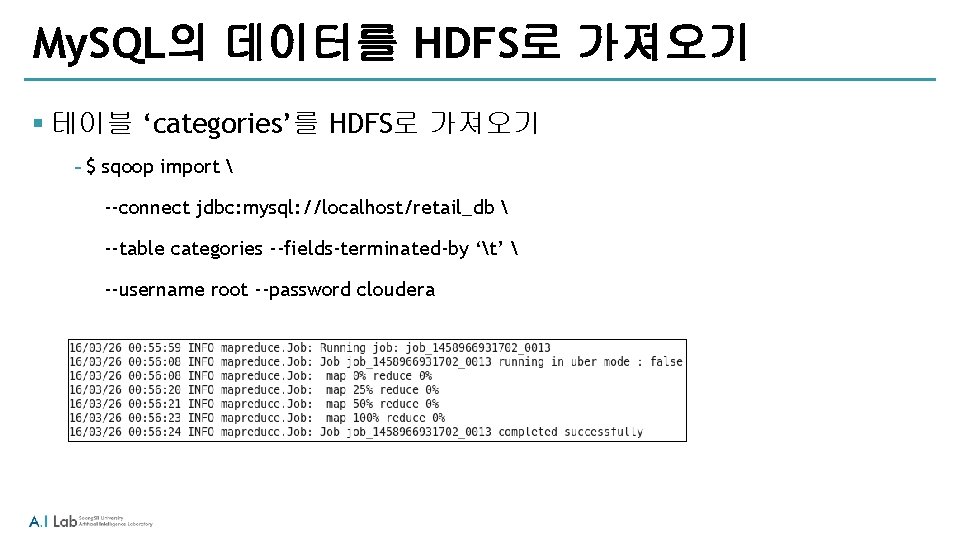
My. SQL의 데이터를 HDFS로 가져오기 § 테이블 ‘categories’를 HDFS로 가져오기 ‐$ sqoop import --connect jdbc: mysql: //localhost/retail_db --table categories --fields-terminated-by ‘t’ --username root --password cloudera
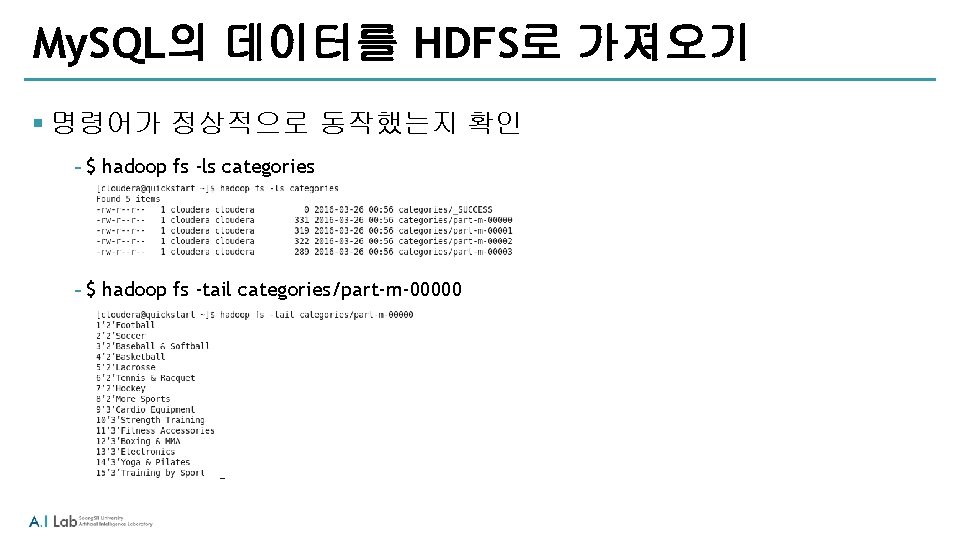
My. SQL의 데이터를 HDFS로 가져오기 § 명령어가 정상적으로 동작했는지 확인 ‐$ hadoop fs -ls categories ‐$ hadoop fs -tail categories/part-m-00000
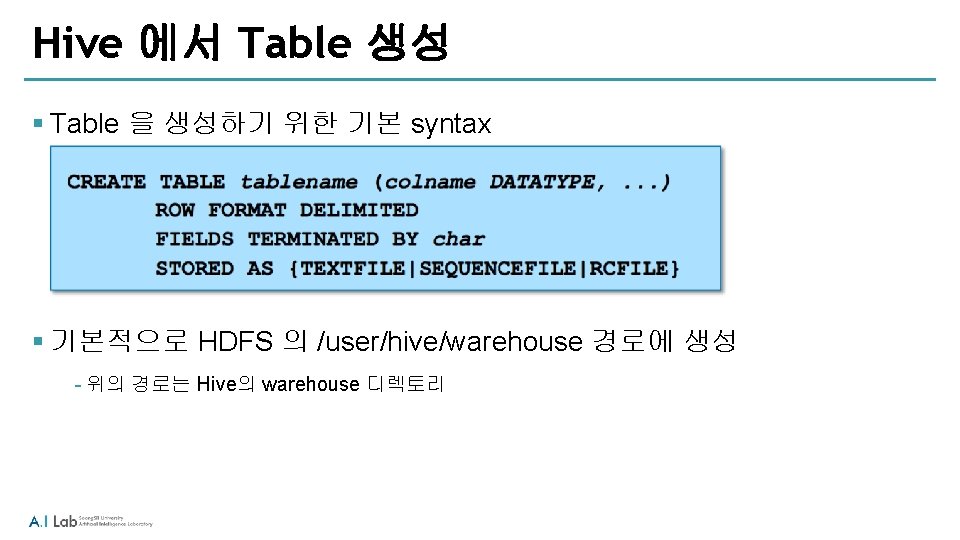
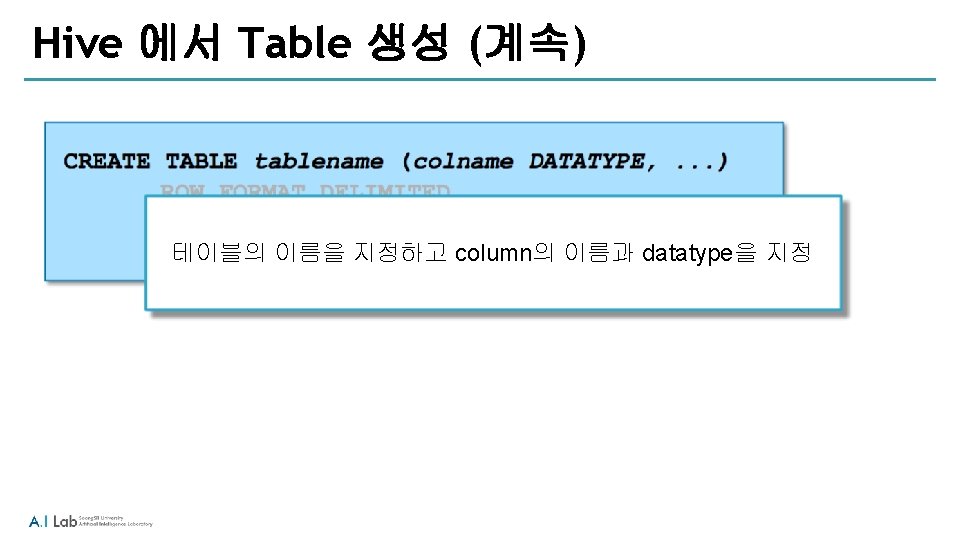
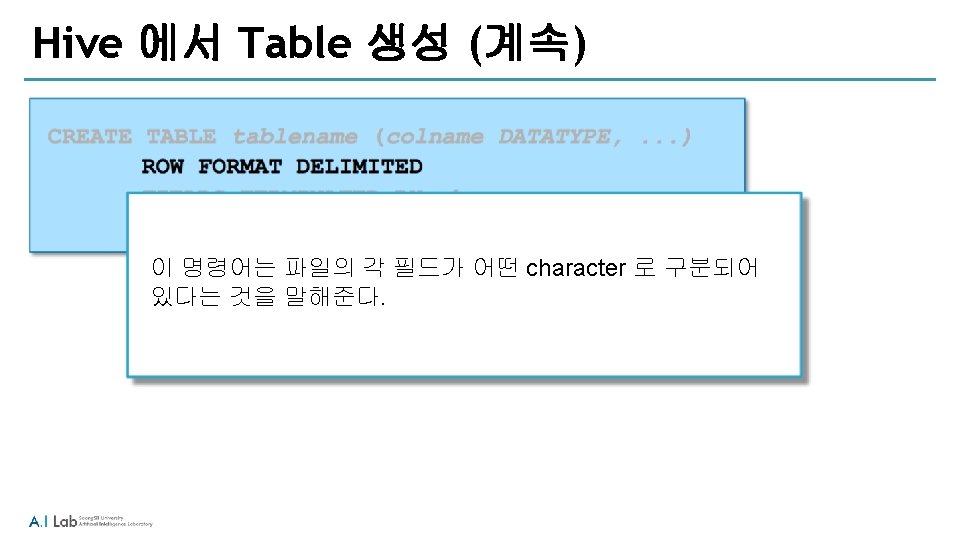
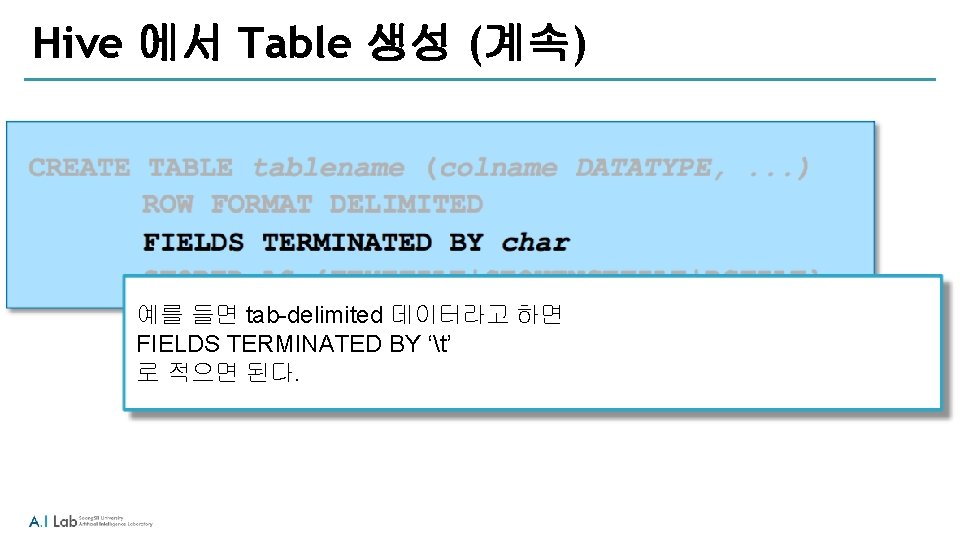
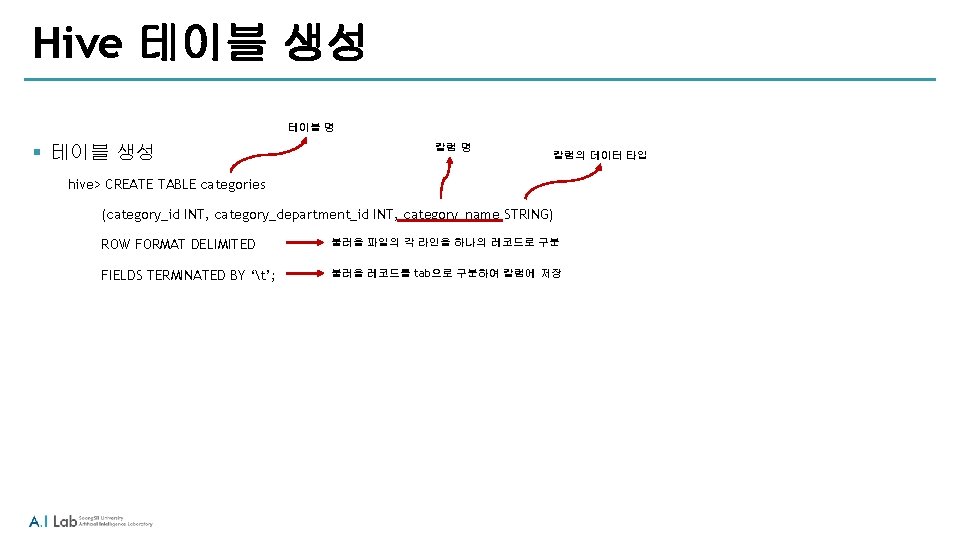
Hive 테이블 생성 테이블 명 § 테이블 생성 칼럼 명 칼럼의 데이터 타입 hive> CREATE TABLE categories (category_id INT, category_department_id INT, category_name STRING) ROW FORMAT DELIMITED 불러올 파일의 각 라인을 하나의 레코드로 구분 FIELDS TERMINATED BY ‘t’; 불러올 레코드를 tab으로 구분하여 칼럼에 저장
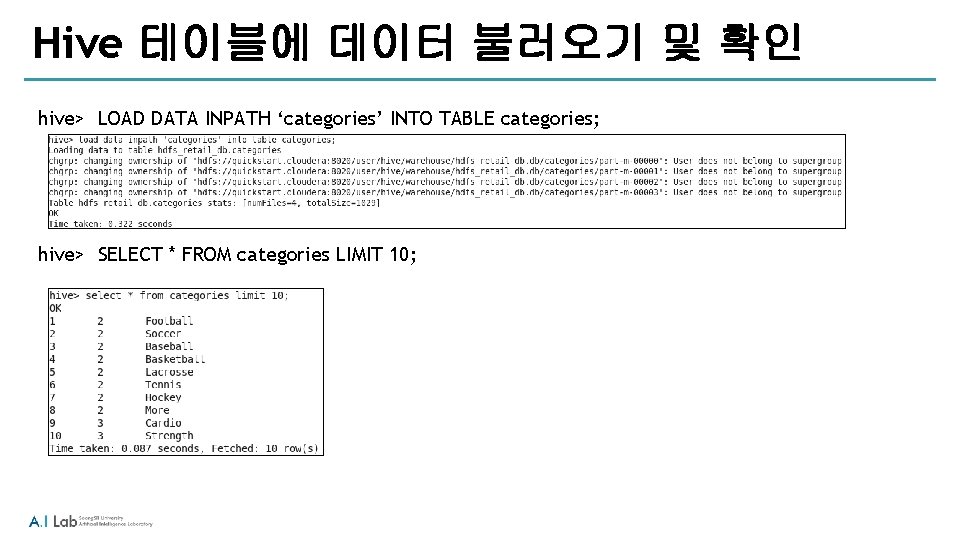
Hive 테이블에 데이터 불러오기 및 확인 hive> LOAD DATA INPATH ‘categories’ INTO TABLE categories; hive> SELECT * FROM categories LIMIT 10;
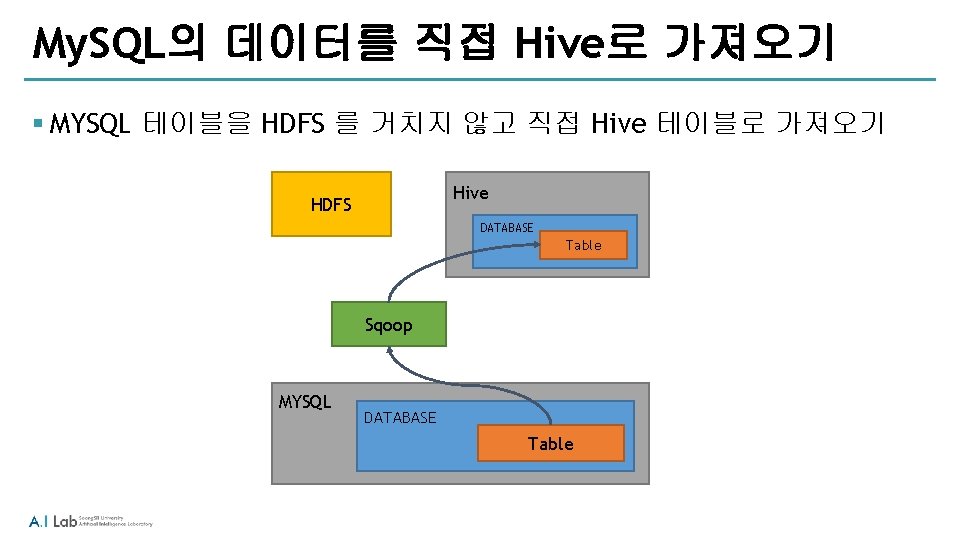
My. SQL의 데이터를 직접 Hive로 가져오기 § MYSQL 테이블을 HDFS 를 거치지 않고 직접 Hive 테이블로 가져오기 Hive HDFS DATABASE Table Sqoop MYSQL DATABASE Table
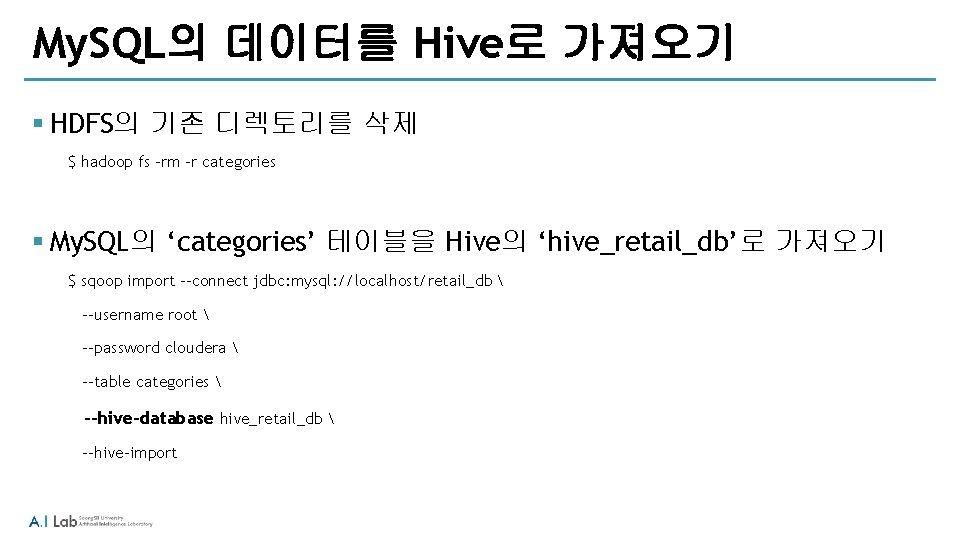
My. SQL의 데이터를 Hive로 가져오기 § HDFS의 기존 디렉토리를 삭제 $ hadoop fs –rm –r categories § My. SQL의 ‘categories’ 테이블을 Hive의 ‘hive_retail_db’로 가져오기 $ sqoop import --connect jdbc: mysql: //localhost/retail_db --username root --password cloudera --table categories --hive-database hive_retail_db --hive-import
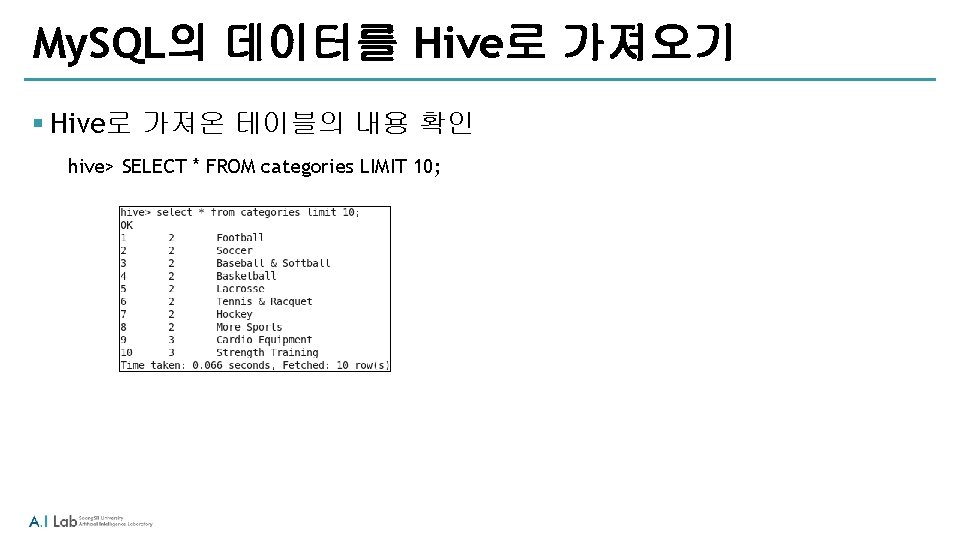
My. SQL의 데이터를 Hive로 가져오기 § Hive로 가져온 테이블의 내용 확인 hive> SELECT * FROM categories LIMIT 10;
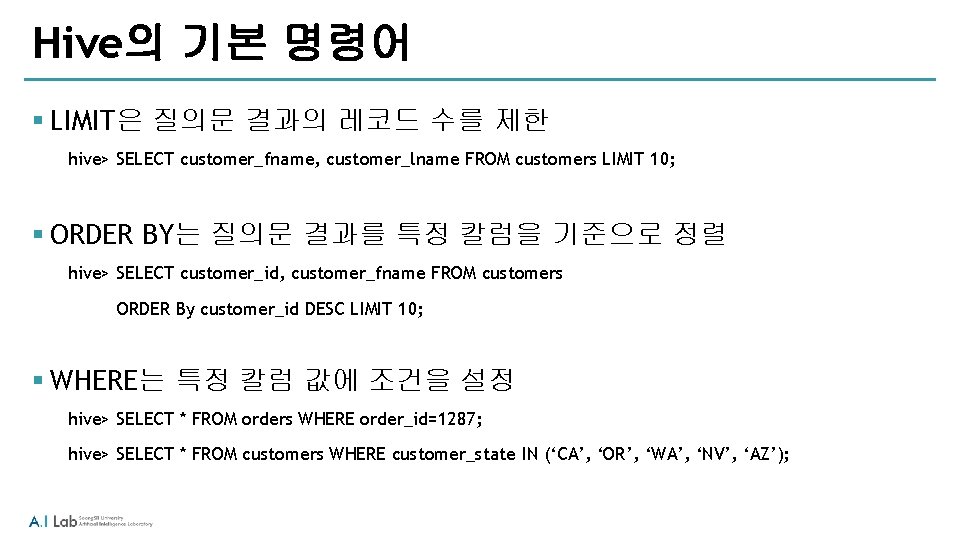
Hive의 기본 명령어 § LIMIT은 질의문 결과의 레코드 수를 제한 hive> SELECT customer_fname, customer_lname FROM customers LIMIT 10; § ORDER BY는 질의문 결과를 특정 칼럼을 기준으로 정렬 hive> SELECT customer_id, customer_fname FROM customers ORDER By customer_id DESC LIMIT 10; § WHERE는 특정 칼럼 값에 조건을 설정 hive> SELECT * FROM orders WHERE order_id=1287; hive> SELECT * FROM customers WHERE customer_state IN (‘CA’, ‘OR’, ‘WA’, ‘NV’, ‘AZ’);
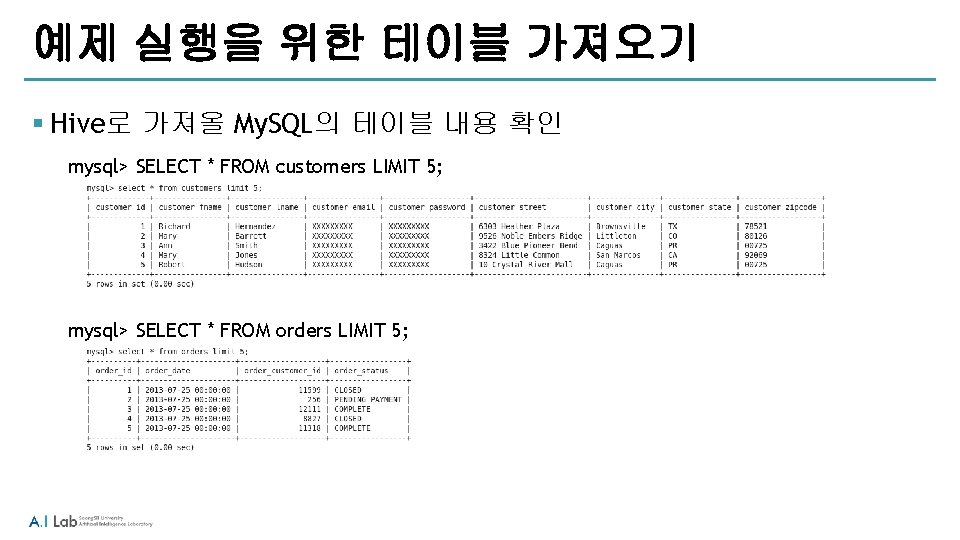
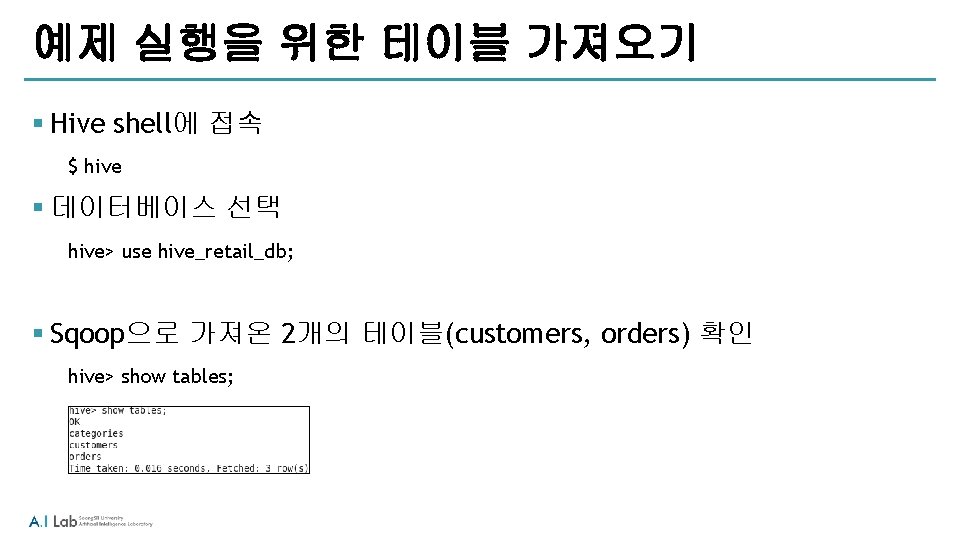
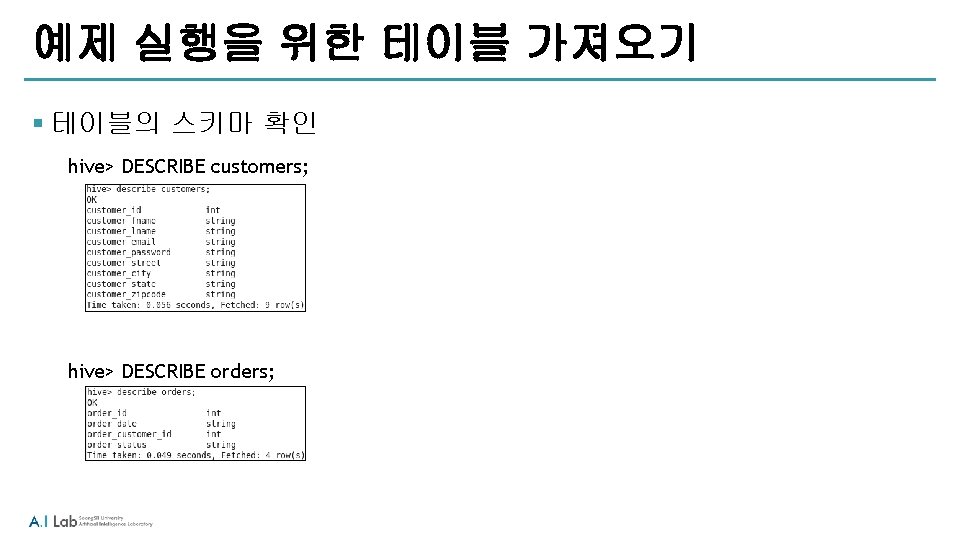
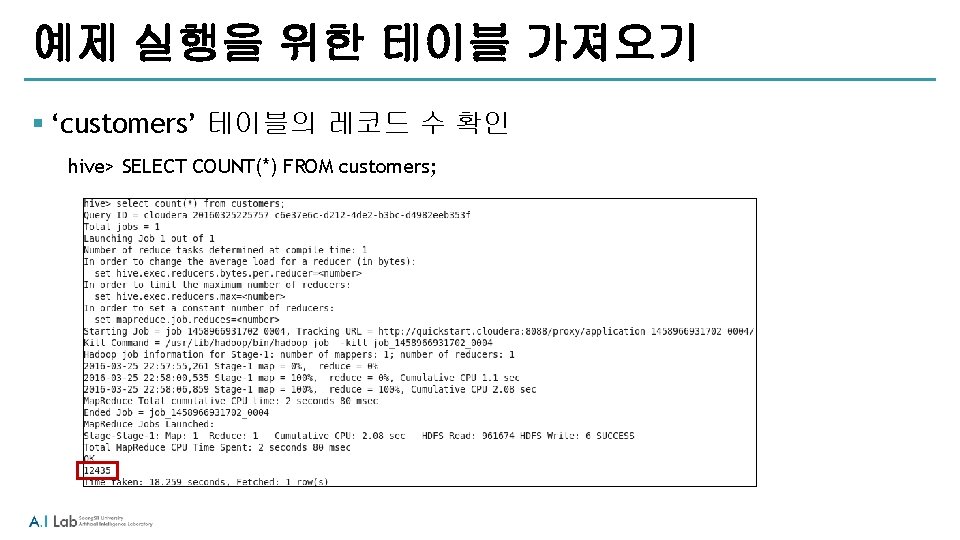
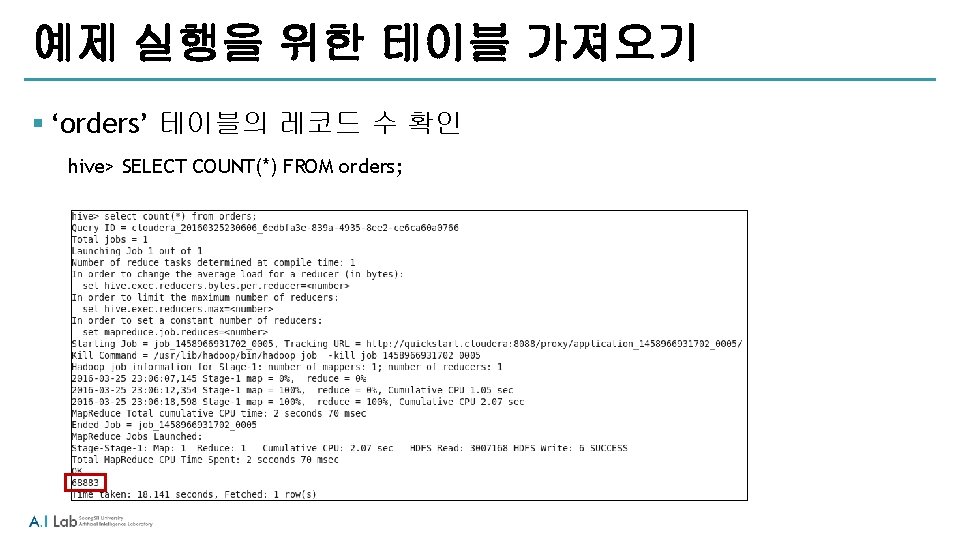
예제 실행을 위한 테이블 가져오기 § Hive로 가져올 My. SQL의 테이블 내용 확인 mysql> SELECT * FROM customers LIMIT 5; mysql> SELECT * FROM orders LIMIT 5;
예제 실행을 위한 테이블 가져오기 § ‘retail_db’의 ‘customers’ 테이블을 Hive로 가져오기 $ sqoop import --connect jdbc: mysql: //localhost/retail_db --username root --password cloudera --table customers --hive-database hive_retail_db --hive-import § ‘retail_db’의 ‘orders’ 테이블을 Hive로 가져오기 $ sqoop import --connect jdbc: mysql: //localhost/retail_db --username root --password cloudera --table orders --hive-database hive_retail_db --hive-import
예제 실행을 위한 테이블 가져오기 § ‘retail_db’의 ‘products’ 테이블을 Hive로 가져오기 $ sqoop import --connect jdbc: mysql: //localhost/retail_db --username root --password cloudera --table products --hive-database hive_retail_db --hive-import § ‘retail_db’의 ‘departments’ 테이블을 Hive로 가져오기 $ sqoop import --connect jdbc: mysql: //localhost/retail_db --username root --password cloudera --table departments --hive-database hive_retail_db --hive-import
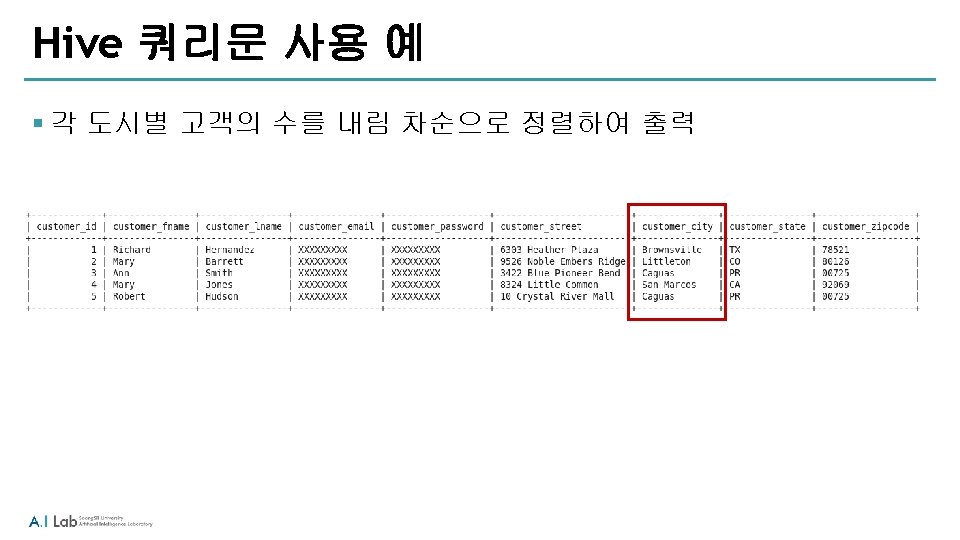
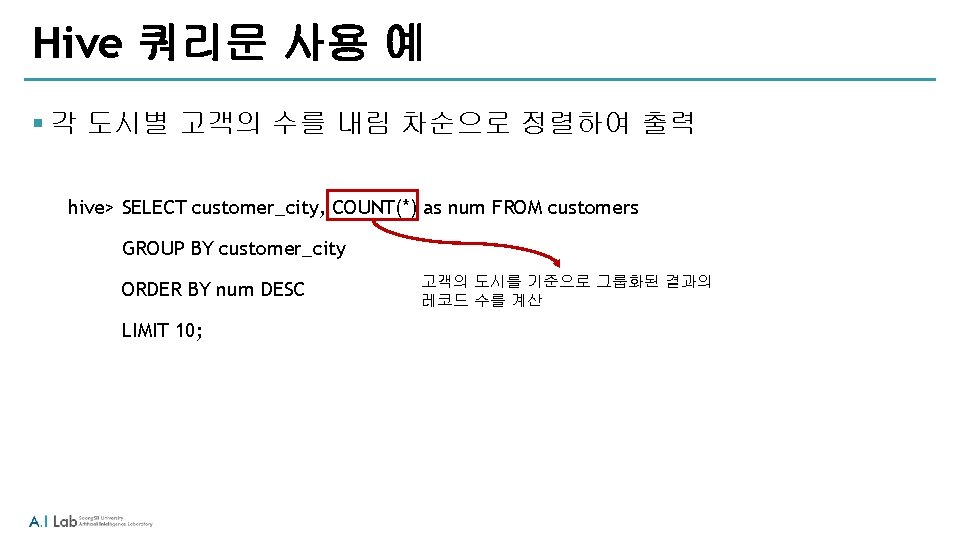
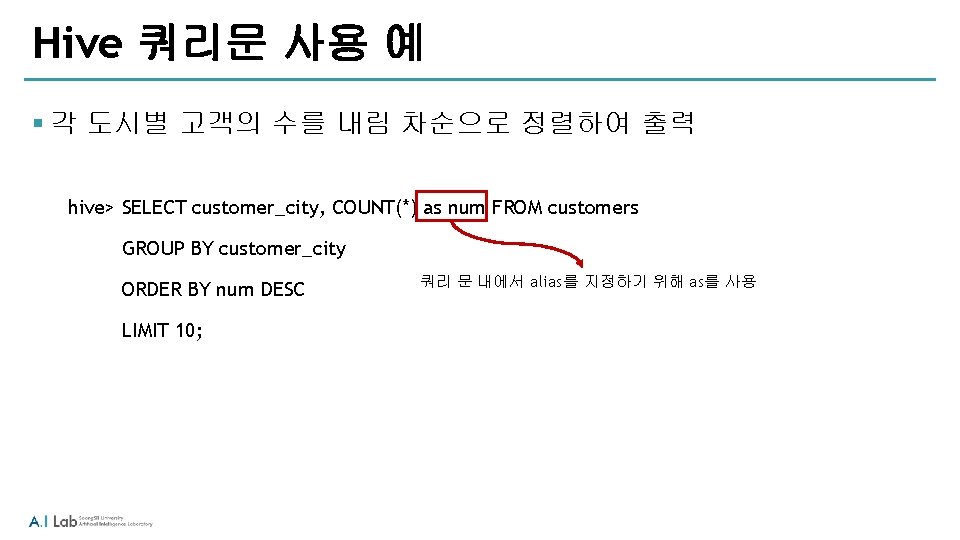
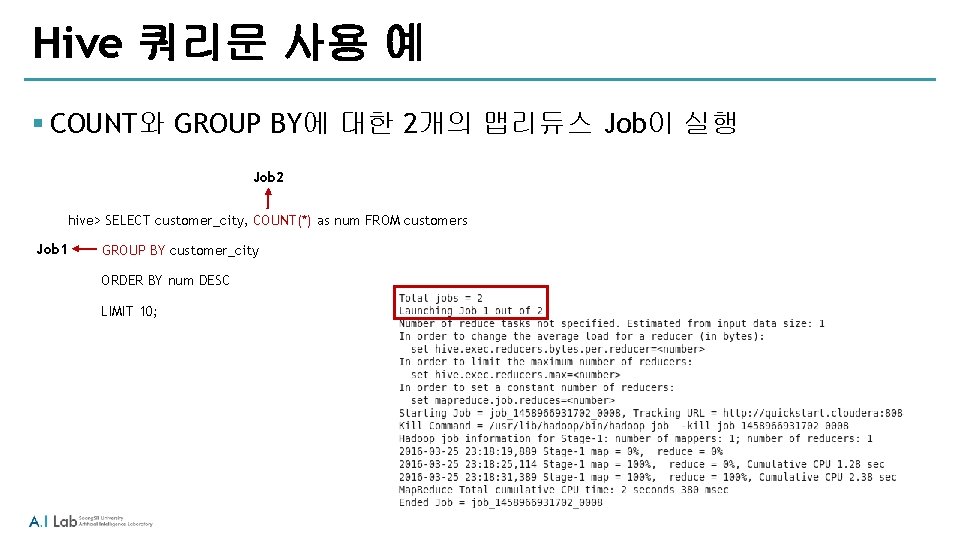
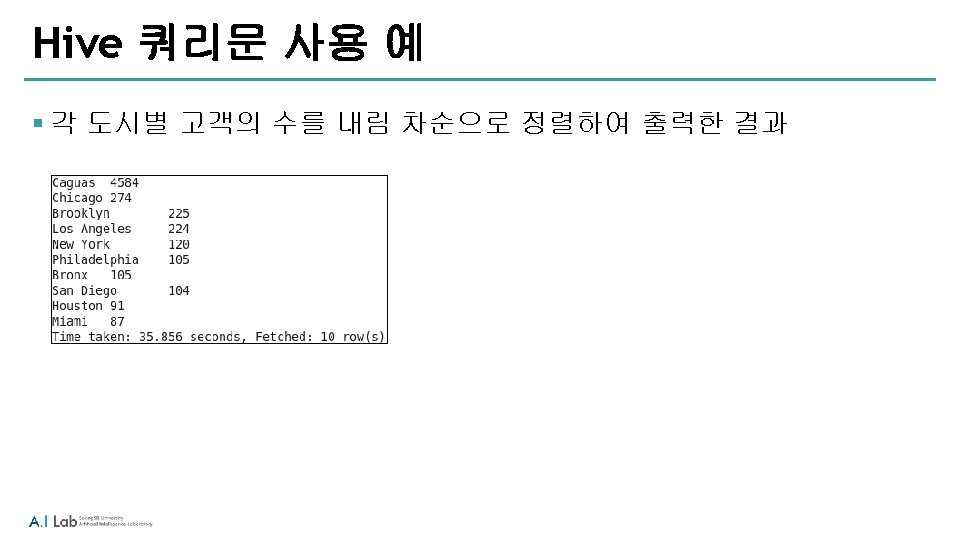
Hive 쿼리문 사용 예 § 각 도시별 고객의 수를 내림 차순으로 정렬하여 출력 hive> SELECT customer_city, COUNT(*) as num FROM customers GROUP BY customer_city ORDER BY num DESC LIMIT 10; 쿼리 문 내에서 alias를 지정하기 위해 as를 사용
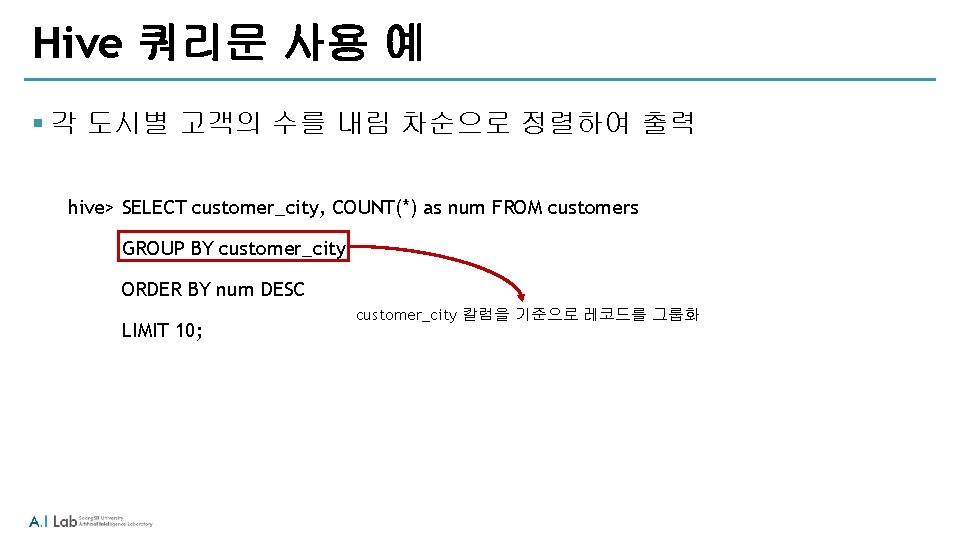
Hive 쿼리문 사용 예 § 각 도시별 고객의 수를 내림 차순으로 정렬하여 출력 hive> SELECT customer_city, COUNT(*) as num FROM customers GROUP BY customer_city ORDER BY num DESC LIMIT 10; customer_city 칼럼을 기준으로 레코드를 그룹화
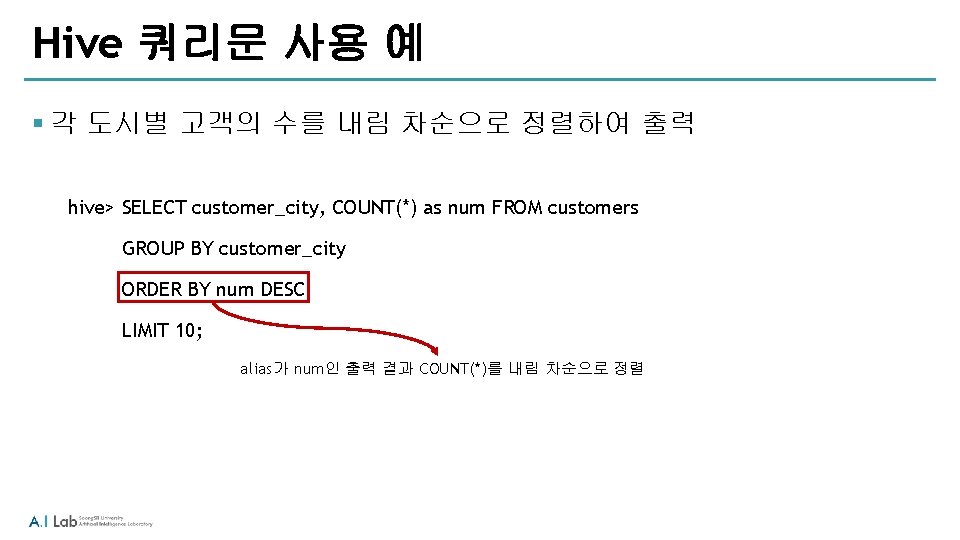
Hive 쿼리문 사용 예 § 각 도시별 고객의 수를 내림 차순으로 정렬하여 출력 hive> SELECT customer_city, COUNT(*) as num FROM customers GROUP BY customer_city ORDER BY num DESC LIMIT 10; alias가 num인 출력 결과 COUNT(*)를 내림 차순으로 정렬
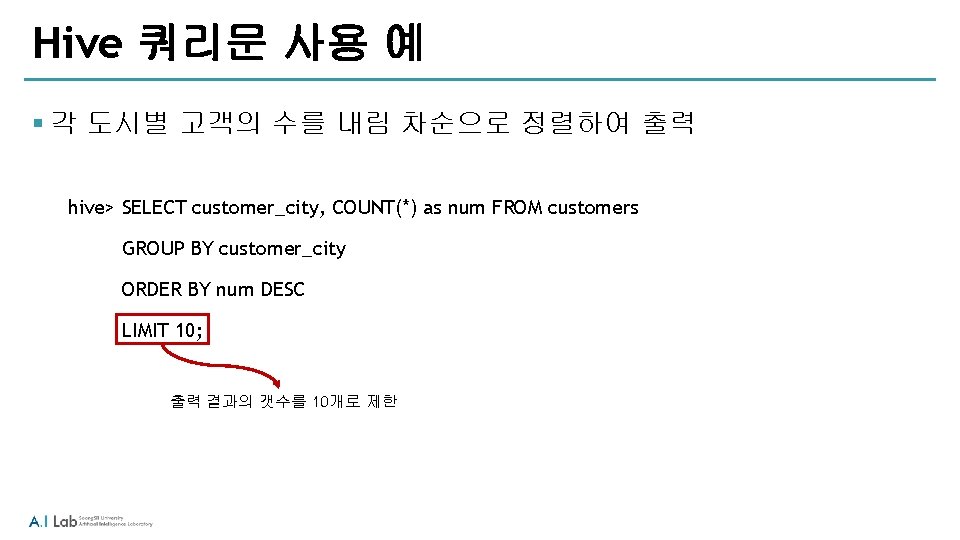
Hive 쿼리문 사용 예 § 각 도시별 고객의 수를 내림 차순으로 정렬하여 출력 hive> SELECT customer_city, COUNT(*) as num FROM customers GROUP BY customer_city ORDER BY num DESC LIMIT 10; 출력 결과의 갯수를 10개로 제한
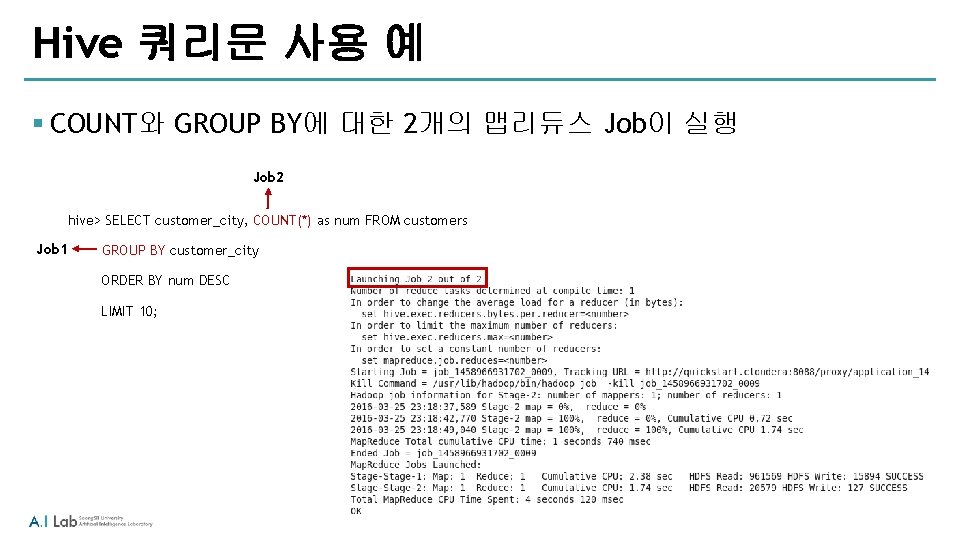
Hive 쿼리문 사용 예 § COUNT와 GROUP BY에 대한 2개의 맵리듀스 Job이 실행 Job 2 hive> SELECT customer_city, COUNT(*) as num FROM customers Job 1 GROUP BY customer_city ORDER BY num DESC LIMIT 10;
Hive 쿼리문 사용 예 § COUNT와 GROUP BY에 대한 2개의 맵리듀스 Job이 실행 Job 2 hive> SELECT customer_city, COUNT(*) as num FROM customers Job 1 GROUP BY customer_city ORDER BY num DESC LIMIT 10;
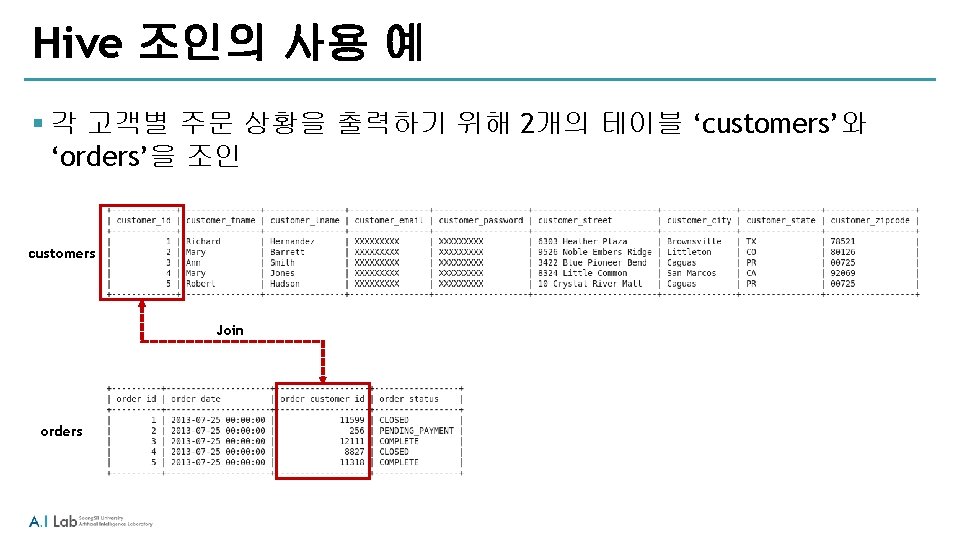
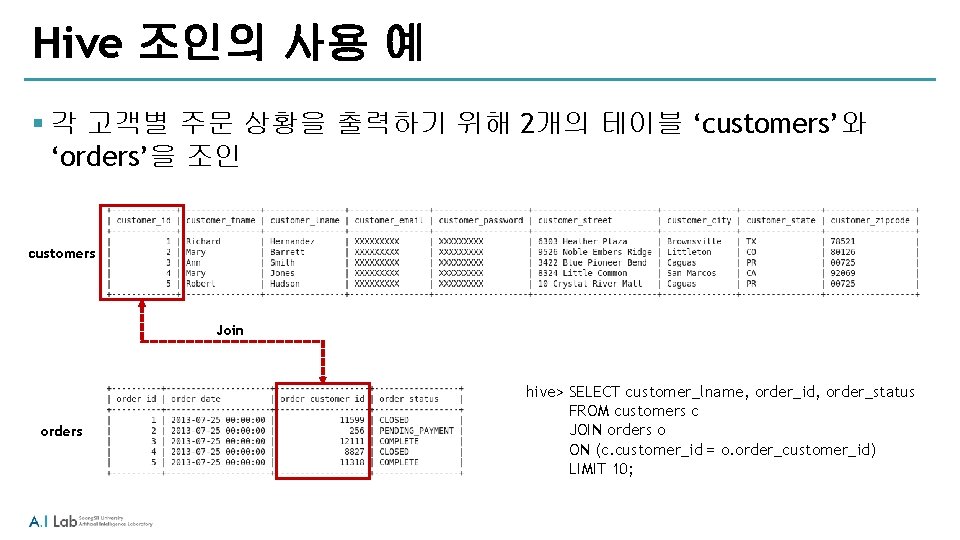
Hive 조인의 사용 예 § 각 고객별 주문 상황을 출력하기 위해 2개의 테이블 ‘customers’와 ‘orders’을 조인 customers Join orders hive> SELECT customer_lname, order_id, order_status FROM customers c JOIN orders o ON (c. customer_id = o. order_customer_id) LIMIT 10;
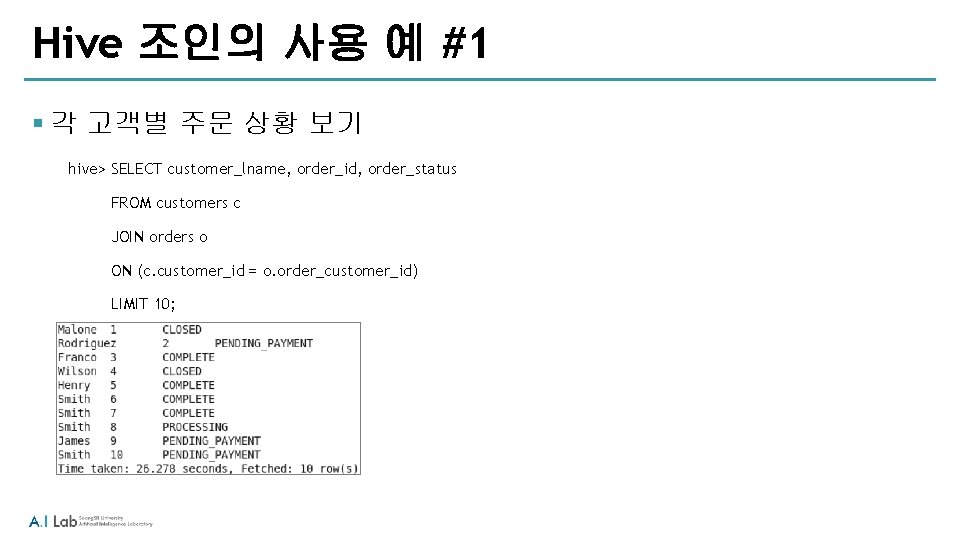
Hive 조인의 사용 예 #1 § 각 고객별 주문 상황 보기 hive> SELECT customer_lname, order_id, order_status FROM customers c JOIN orders o ON (c. customer_id = o. order_customer_id) LIMIT 10;
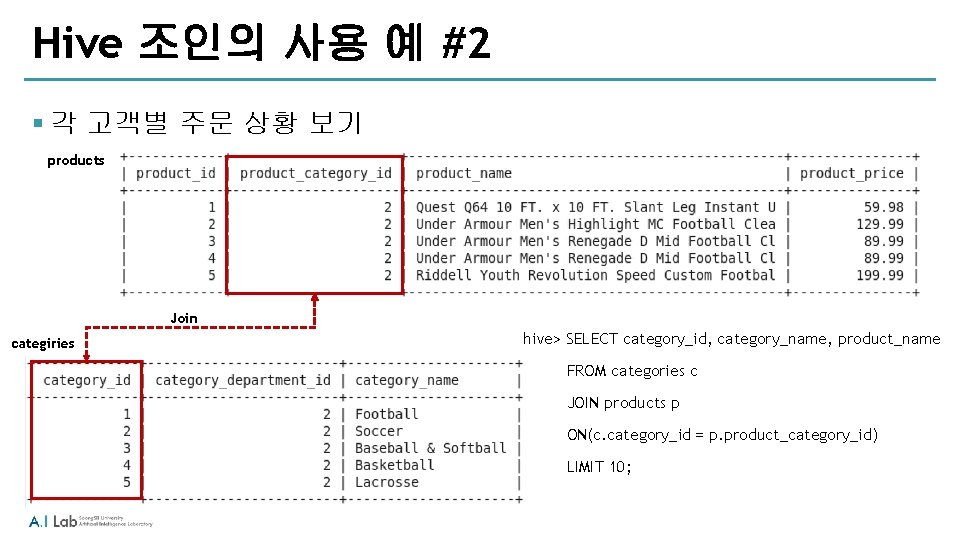
Hive 조인의 사용 예 #2 § 각 고객별 주문 상황 보기 products Join categiries hive> SELECT category_id, category_name, product_name FROM categories c JOIN products p ON(c. category_id = p. product_category_id) LIMIT 10;
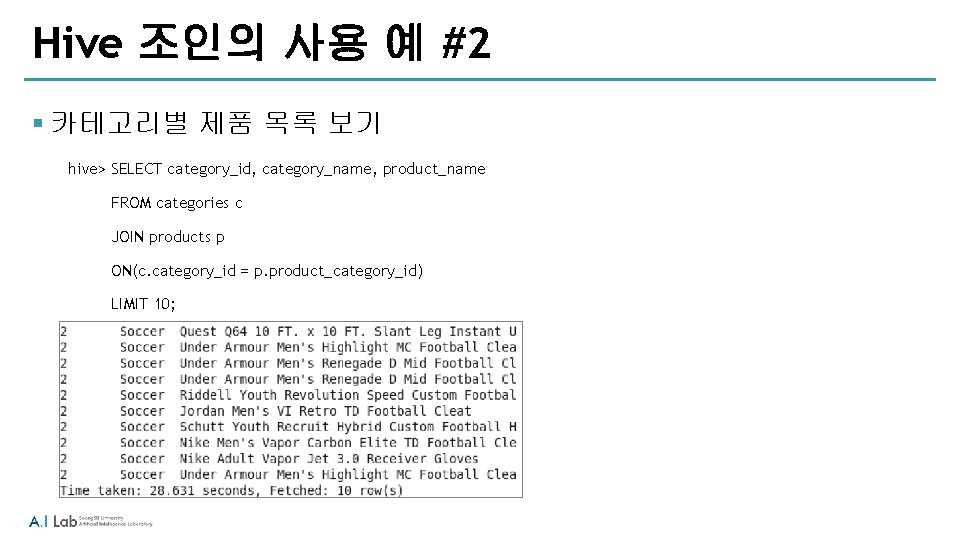
Hive 조인의 사용 예 #2 § 카테고리별 제품 목록 보기 hive> SELECT category_id, category_name, product_name FROM categories c JOIN products p ON(c. category_id = p. product_category_id) LIMIT 10;
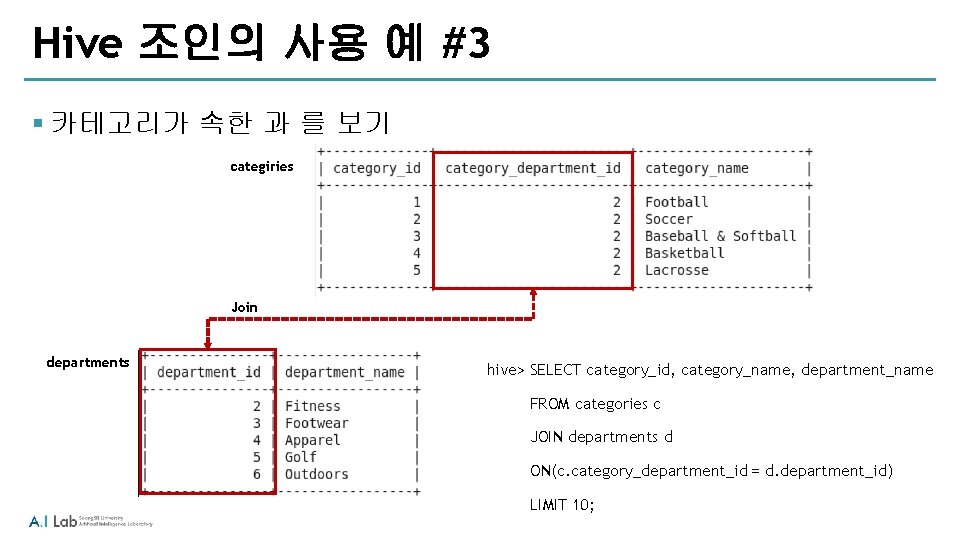
Hive 조인의 사용 예 #3 § 카테고리가 속한 과 를 보기 categiries Join departments hive> SELECT category_id, category_name, department_name FROM categories c JOIN departments d ON(c. category_department_id = d. department_id) LIMIT 10;
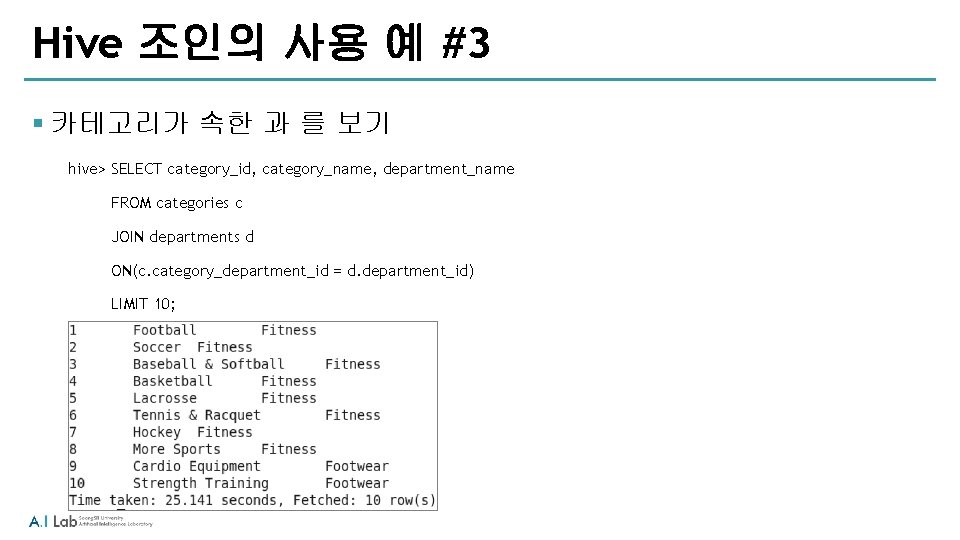
Hive 조인의 사용 예 #3 § 카테고리가 속한 과 를 보기 hive> SELECT category_id, category_name, department_name FROM categories c JOIN departments d ON(c. category_department_id = d. department_id) LIMIT 10;