
Multimodal Deep Learning Jiquan Ngiam Aditya Khosla Mingyu
- Slides: 46
Multimodal Deep Learning Jiquan Ngiam Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng Stanford University
Mc. Gurk Effect Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
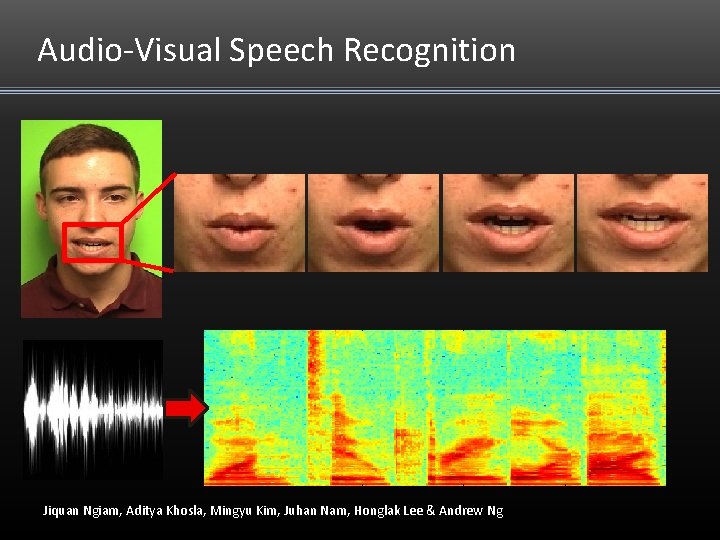
Audio-Visual Speech Recognition Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
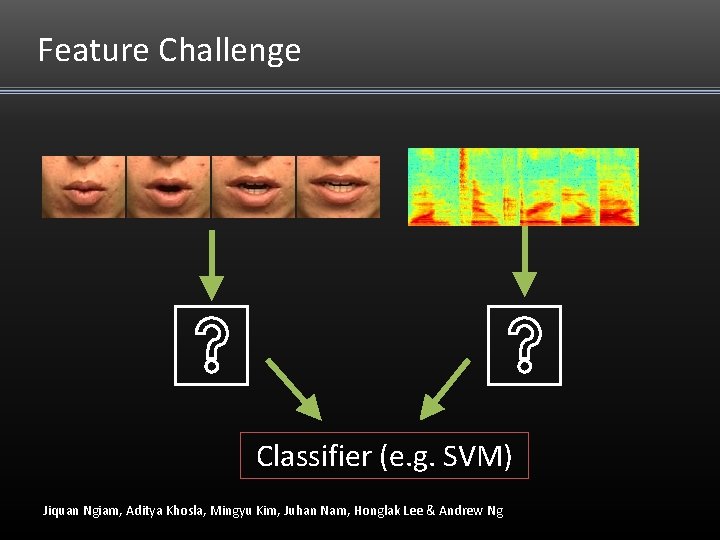
Feature Challenge Classifier (e. g. SVM) Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Representing Lips • Can we learn better representations for audio/visual speech recognition? • How can multimodal data (multiple sources of input) be used to find better features? Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
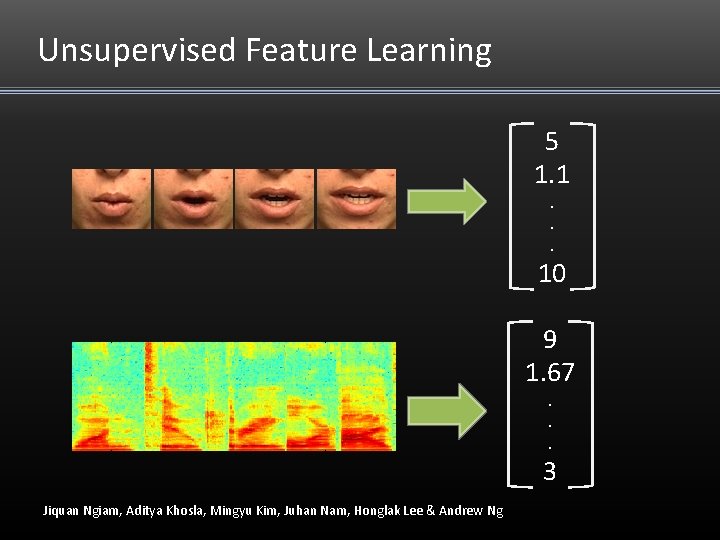
Unsupervised Feature Learning 5 1. 1. . . 10 9 1. 67. . . 3 Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
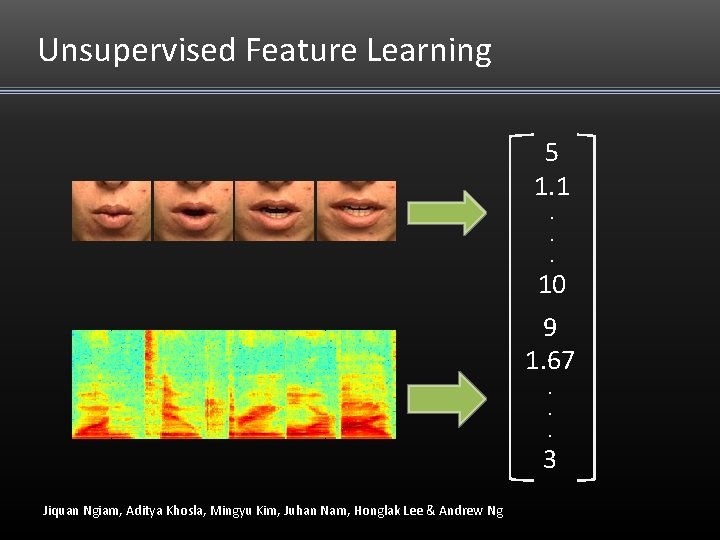
Unsupervised Feature Learning 5 1. 1. . . 10 9 1. 67. . . 3 Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
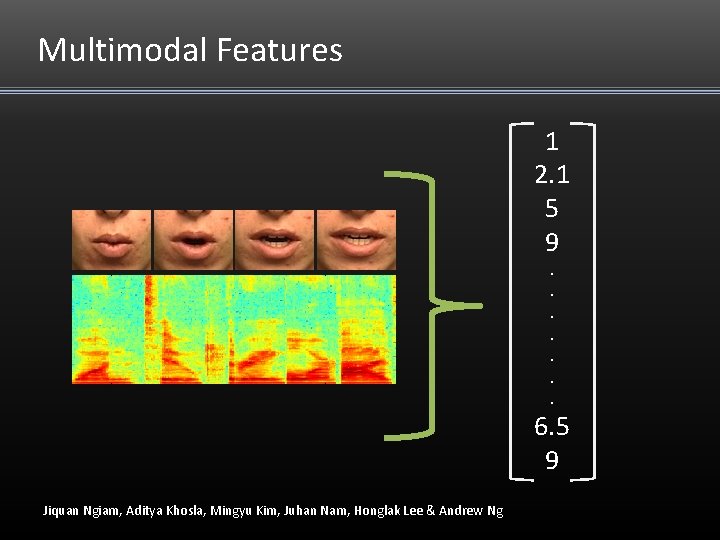
Multimodal Features 1 2. 1 5 9. . . . 6. 5 9 Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
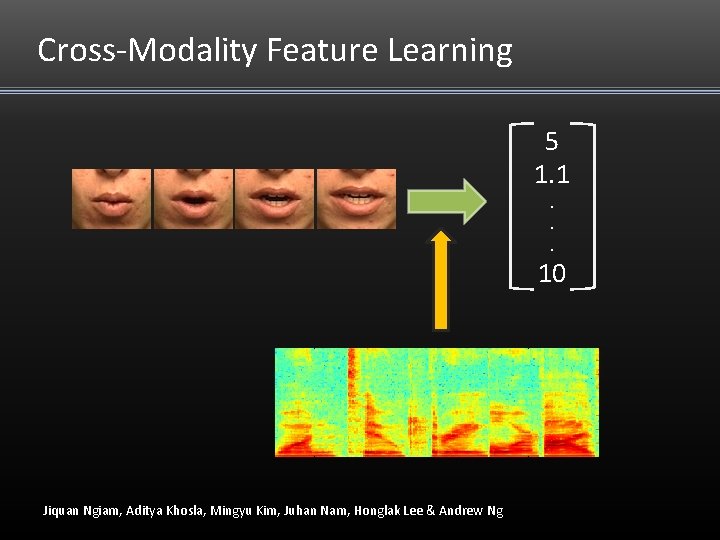
Cross-Modality Feature Learning 5 1. 1. . . 10 Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Feature Learning Models Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
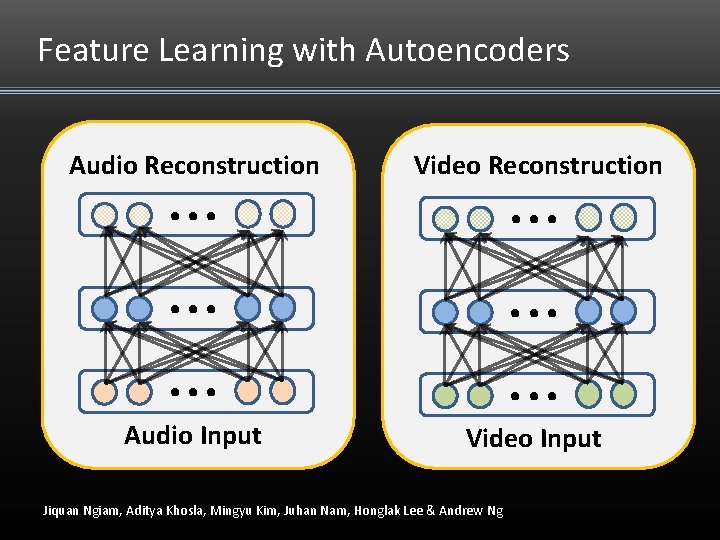
Feature Learning with Autoencoders Audio Reconstruction . . Video Reconstruction Audio Input Video Input . . Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
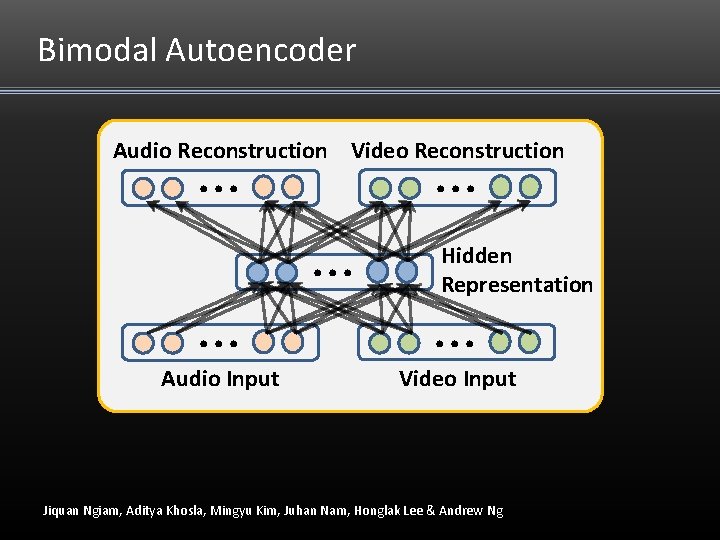
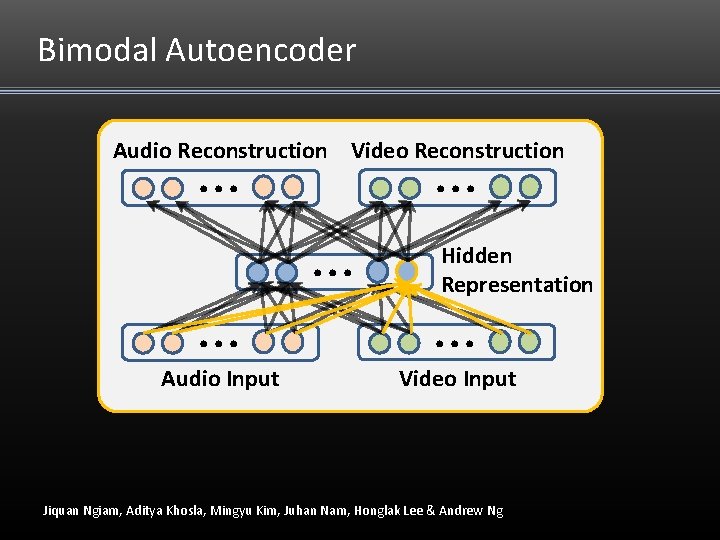
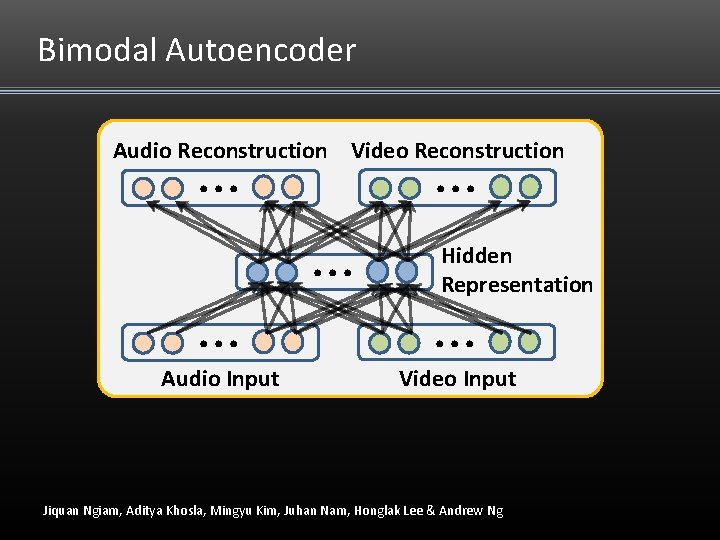
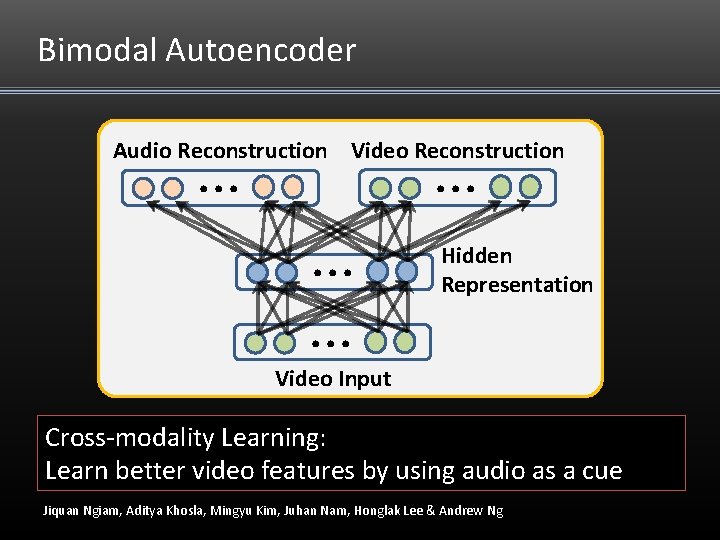
Bimodal Autoencoder Audio Reconstruction Video Reconstruction . . Audio Input . . . Hidden Representation . . . Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Bimodal Autoencoder Audio Reconstruction Video Reconstruction . . Audio Input . . . Hidden Representation . . . Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
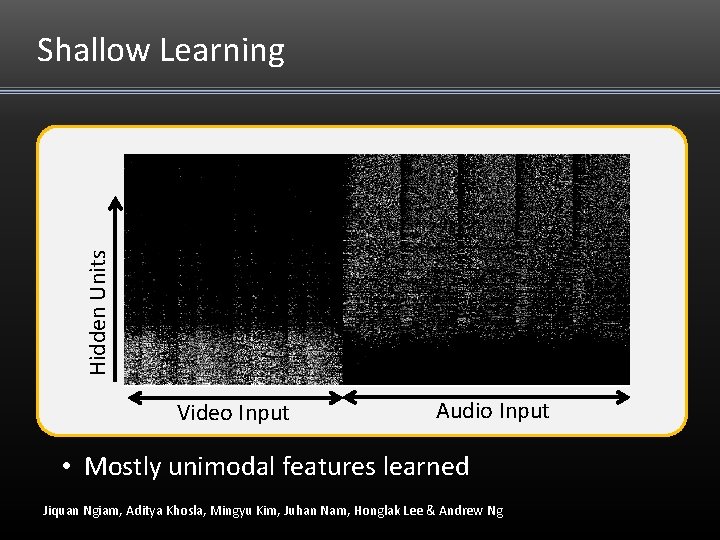
Hidden Units Shallow Learning Video Input Audio Input • Mostly unimodal features learned Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Bimodal Autoencoder Audio Reconstruction Video Reconstruction . . Audio Input . . . Hidden Representation . . . Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Bimodal Autoencoder Audio Reconstruction Video Reconstruction . . . Hidden Representation Video Input Cross-modality Learning: Learn better video features by using audio as a cue Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
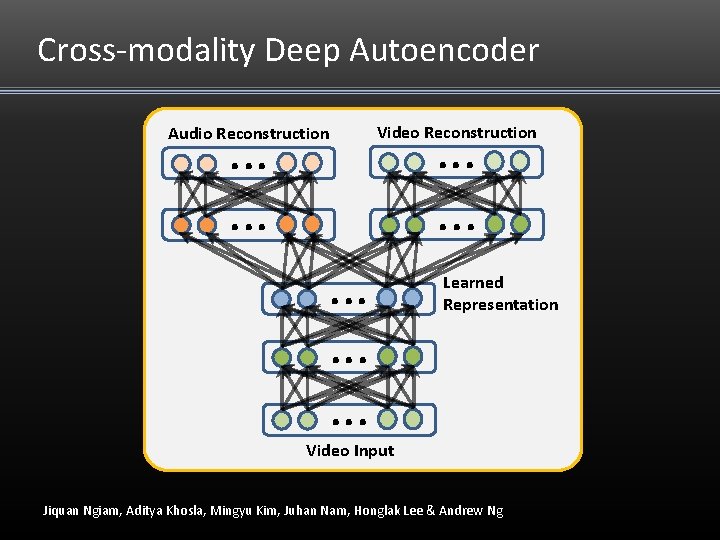
Cross-modality Deep Autoencoder . . . Audio Reconstruction . . . . Video Reconstruction Learned Representation Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
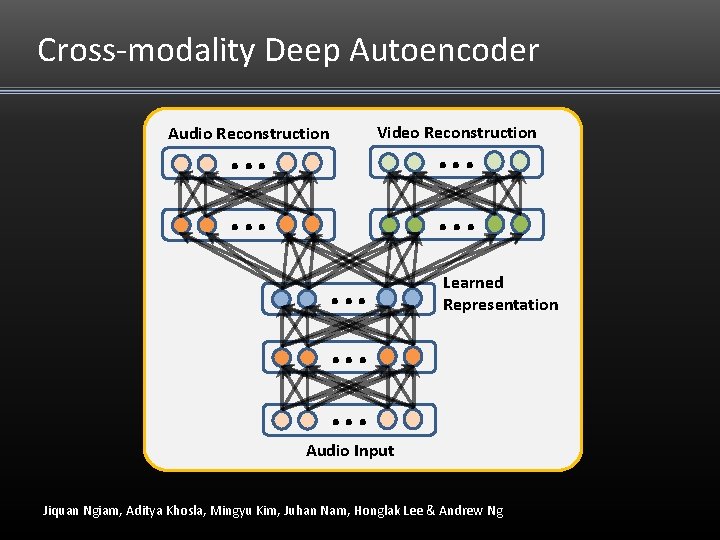
Cross-modality Deep Autoencoder . . . Audio Reconstruction . . . . Video Reconstruction Learned Representation Audio Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
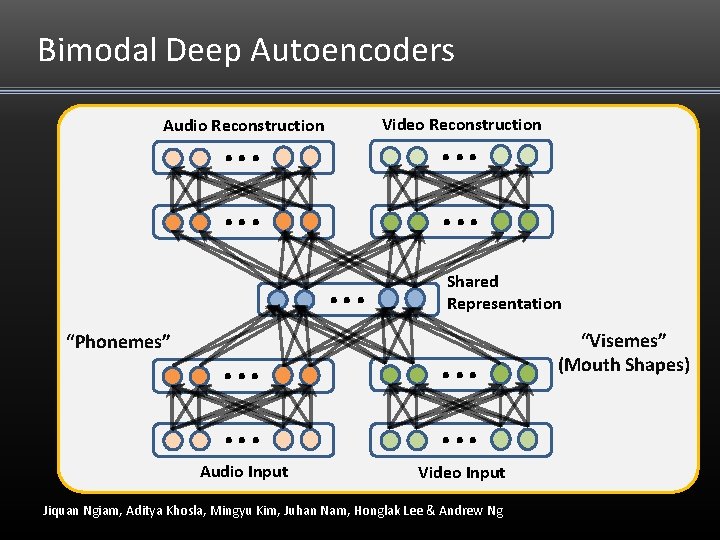
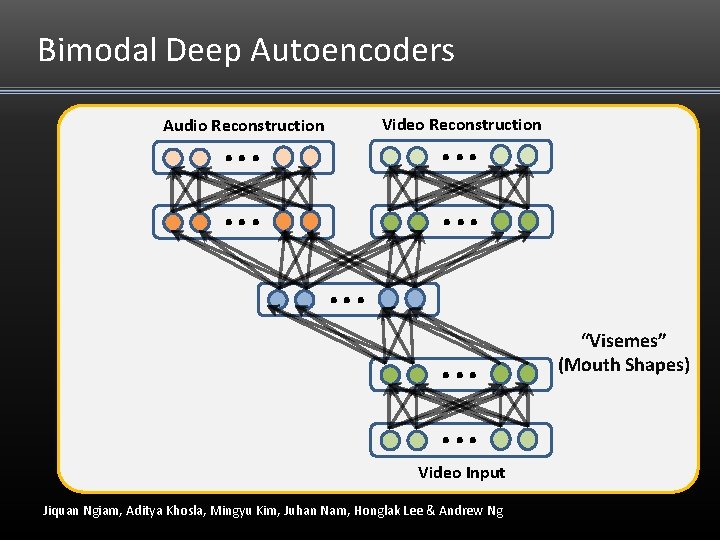
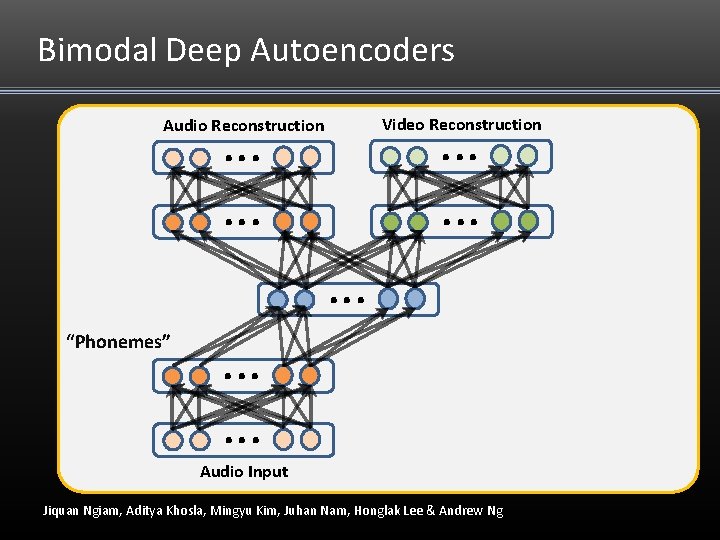
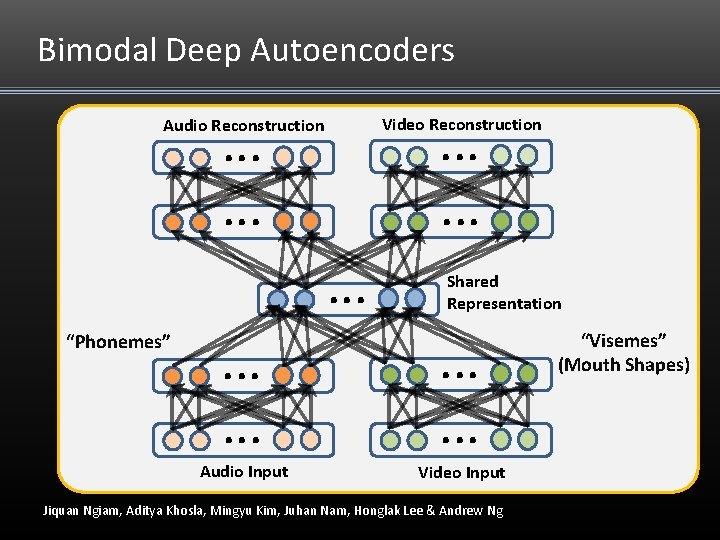
Bimodal Deep Autoencoders . . . Video Reconstruction Audio Reconstruction . . . “Phonemes” Shared Representation . . . Audio Input Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng “Visemes” (Mouth Shapes)
Bimodal Deep Autoencoders . . . Video Reconstruction Audio Reconstruction . . Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng “Visemes” (Mouth Shapes)
Bimodal Deep Autoencoders . . . Video Reconstruction Audio Reconstruction . . . “Phonemes” . . . Audio Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Bimodal Deep Autoencoders . . . Video Reconstruction Audio Reconstruction . . . “Phonemes” Shared Representation . . . Audio Input Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng “Visemes” (Mouth Shapes)
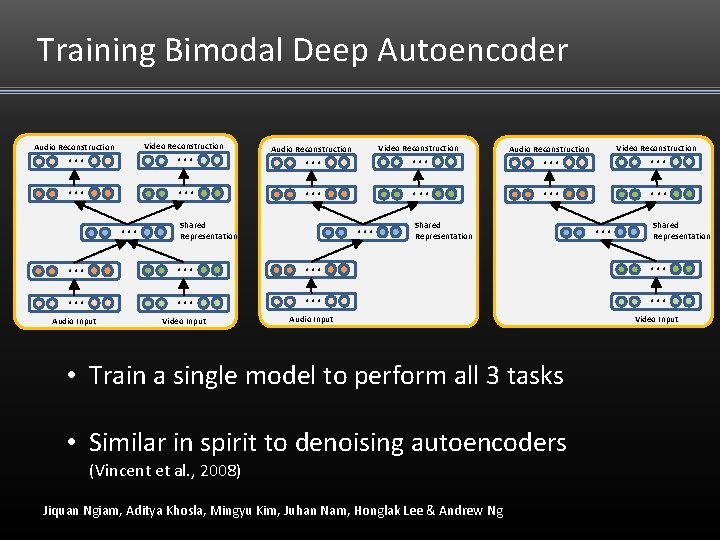
Training Bimodal Deep Autoencoder. . . Video Reconstruction Audio Reconstruction . . . Shared Representation . . . Video Reconstruction Audio Reconstruction Shared Representation . . . . Audio Input Video Input • Train a single model to perform all 3 tasks • Similar in spirit to denoising autoencoders (Vincent et al. , 2008) Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Evaluations Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
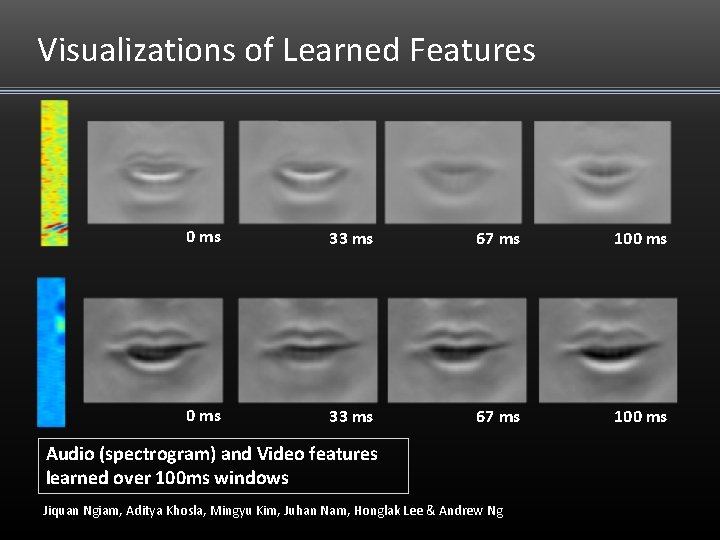
Visualizations of Learned Features 0 ms 33 ms 67 ms 100 ms Audio (spectrogram) and Video features learned over 100 ms windows Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
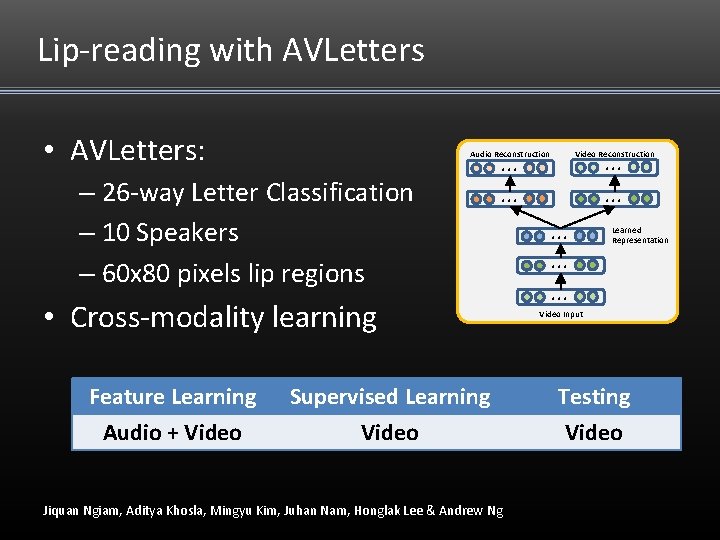
Lip-reading with AVLetters • AVLetters: – 26 -way Letter Classification – 10 Speakers – 60 x 80 pixels lip regions • Cross-modality learning Feature Learning Audio + Video . . . Video Reconstruction Audio Reconstruction Supervised Learning Video Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng . . Learned Representation Video Input Testing Video
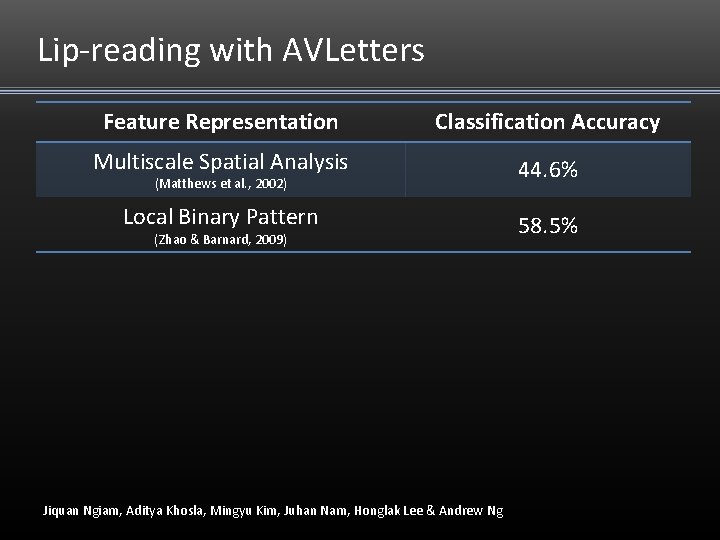
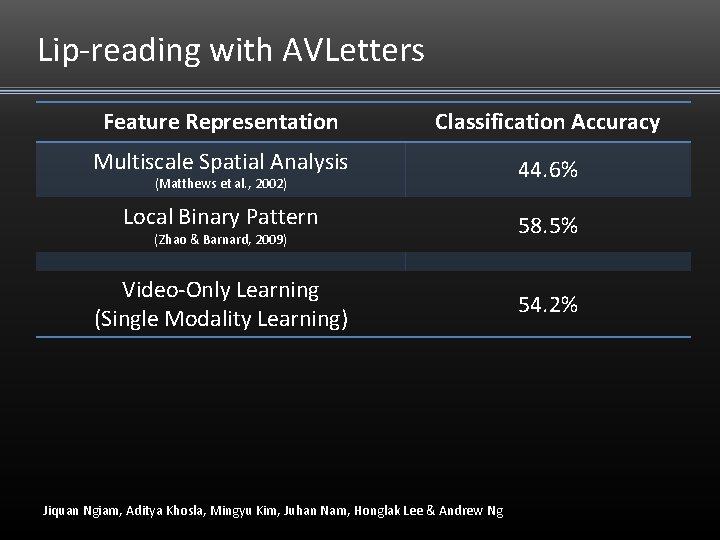
Lip-reading with AVLetters Feature Representation Classification Accuracy Multiscale Spatial Analysis 44. 6% Local Binary Pattern 58. 5% (Matthews et al. , 2002) (Zhao & Barnard, 2009) Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Lip-reading with AVLetters Feature Representation Classification Accuracy Multiscale Spatial Analysis 44. 6% Local Binary Pattern 58. 5% Video-Only Learning (Single Modality Learning) 54. 2% (Matthews et al. , 2002) (Zhao & Barnard, 2009) Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
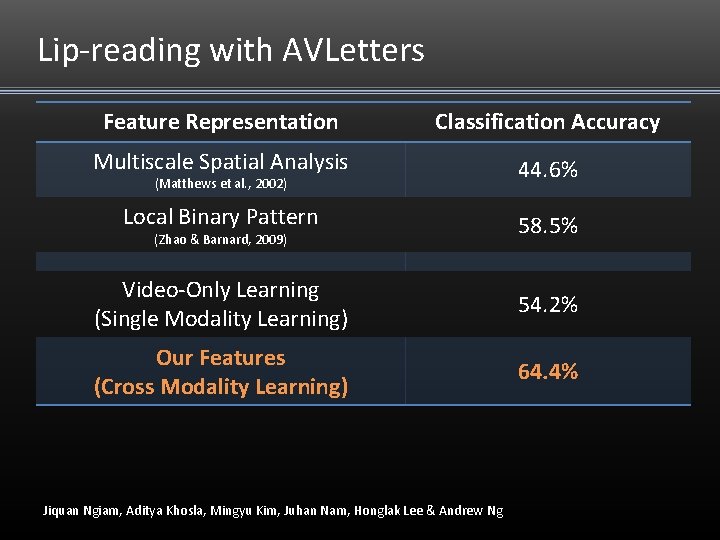
Lip-reading with AVLetters Feature Representation Classification Accuracy Multiscale Spatial Analysis 44. 6% Local Binary Pattern 58. 5% Video-Only Learning (Single Modality Learning) 54. 2% Our Features (Cross Modality Learning) 64. 4% (Matthews et al. , 2002) (Zhao & Barnard, 2009) Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
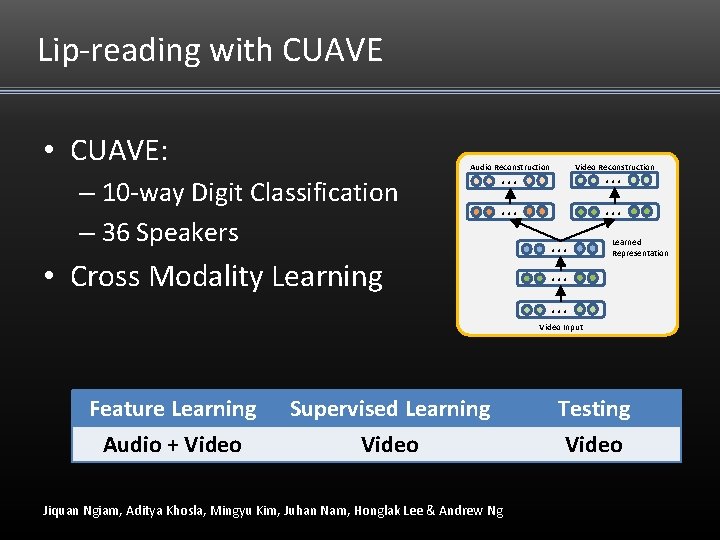
Lip-reading with CUAVE • CUAVE: . . . Video Reconstruction Audio Reconstruction – 10 -way Digit Classification – 36 Speakers • Cross Modality Learning . . Learned Representation Video Input Feature Learning Audio + Video Supervised Learning Video Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng Testing Video
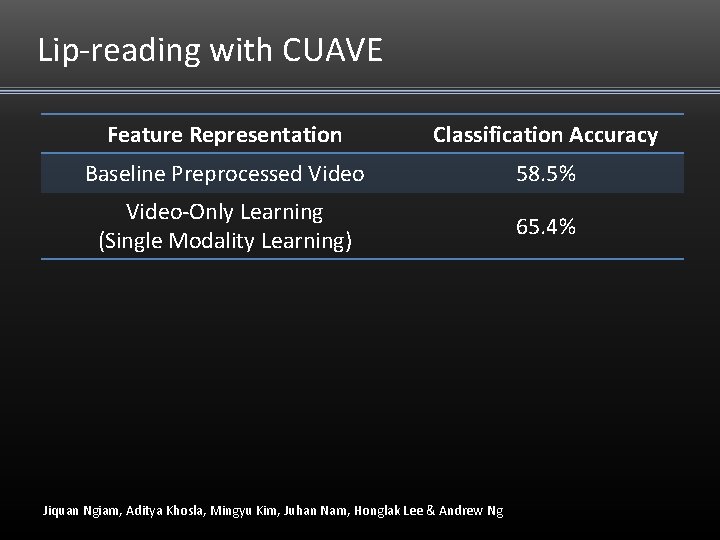
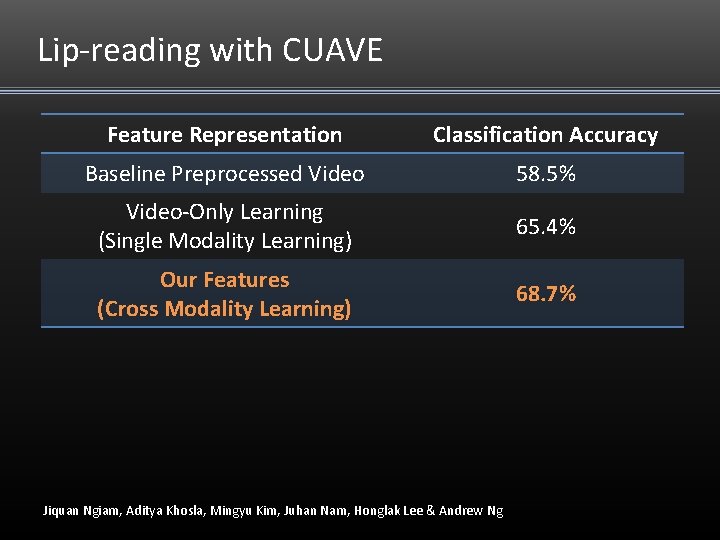
Lip-reading with CUAVE Feature Representation Classification Accuracy Baseline Preprocessed Video 58. 5% Video-Only Learning (Single Modality Learning) 65. 4% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Lip-reading with CUAVE Feature Representation Classification Accuracy Baseline Preprocessed Video 58. 5% Video-Only Learning (Single Modality Learning) 65. 4% Our Features (Cross Modality Learning) 68. 7% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
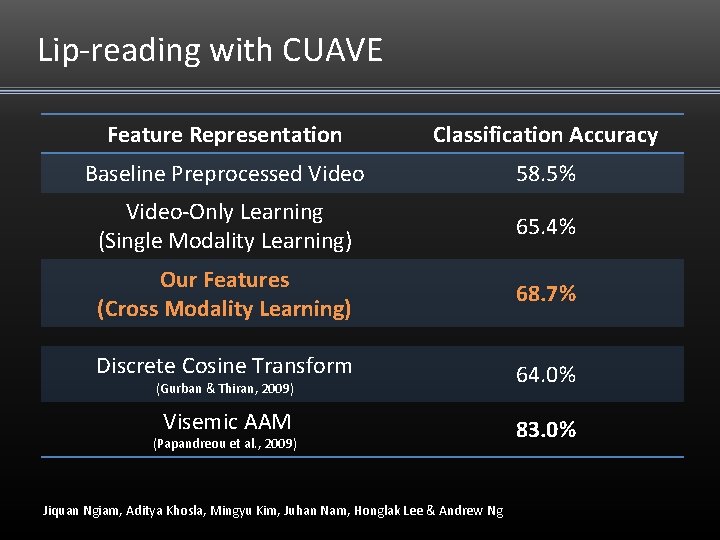
Lip-reading with CUAVE Feature Representation Classification Accuracy Baseline Preprocessed Video 58. 5% Video-Only Learning (Single Modality Learning) 65. 4% Our Features (Cross Modality Learning) 68. 7% Discrete Cosine Transform 64. 0% Visemic AAM 83. 0% (Gurban & Thiran, 2009) (Papandreou et al. , 2009) Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
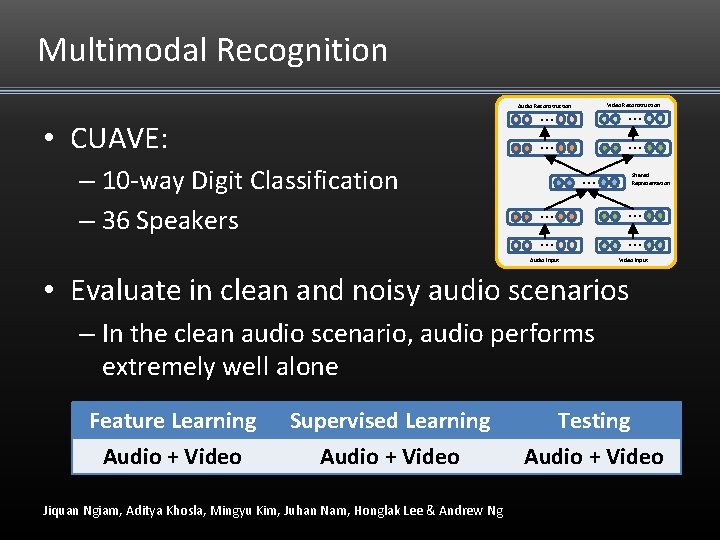
Multimodal Recognition. . . Video Reconstruction Audio Reconstruction • CUAVE: – 10 -way Digit Classification – 36 Speakers . . . Shared Representation . . . Audio Input Video Input • Evaluate in clean and noisy audio scenarios – In the clean audio scenario, audio performs extremely well alone Feature Learning Audio + Video Supervised Learning Audio + Video Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng Testing Audio + Video
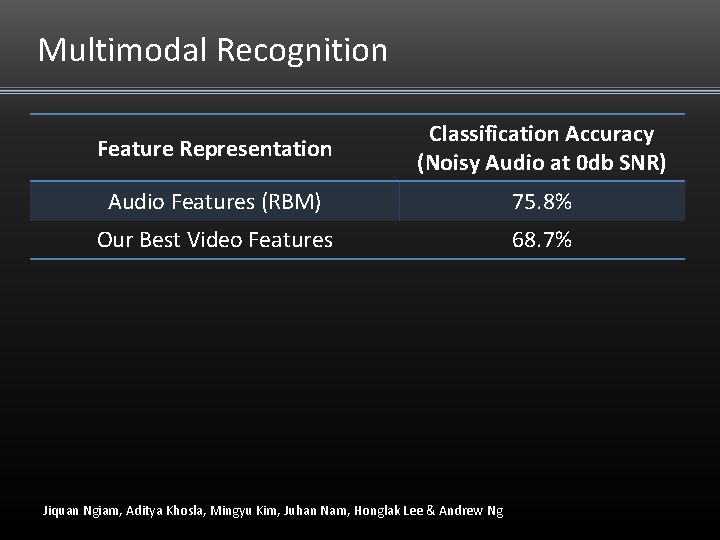
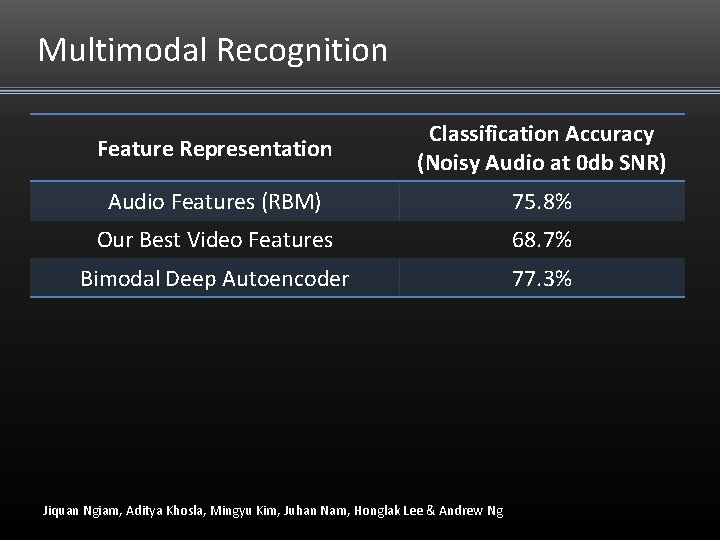
Multimodal Recognition Feature Representation Classification Accuracy (Noisy Audio at 0 db SNR) Audio Features (RBM) 75. 8% Our Best Video Features 68. 7% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Multimodal Recognition Feature Representation Classification Accuracy (Noisy Audio at 0 db SNR) Audio Features (RBM) 75. 8% Our Best Video Features 68. 7% Bimodal Deep Autoencoder 77. 3% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
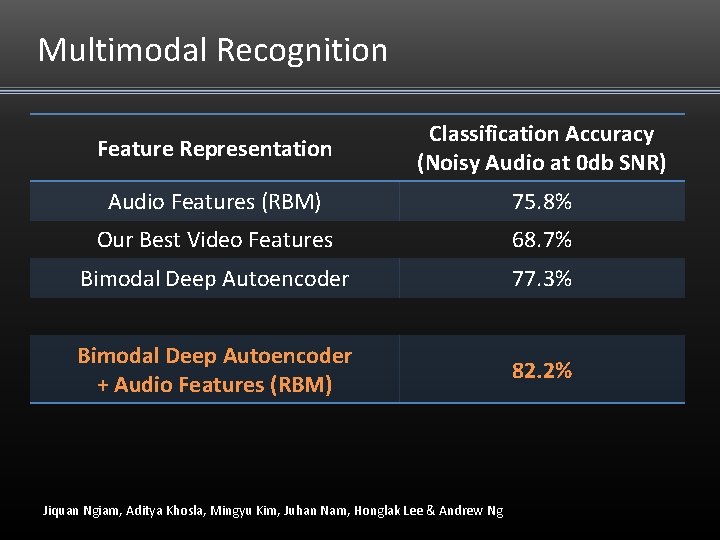
Multimodal Recognition Feature Representation Classification Accuracy (Noisy Audio at 0 db SNR) Audio Features (RBM) 75. 8% Our Best Video Features 68. 7% Bimodal Deep Autoencoder 77. 3% Bimodal Deep Autoencoder + Audio Features (RBM) 82. 2% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
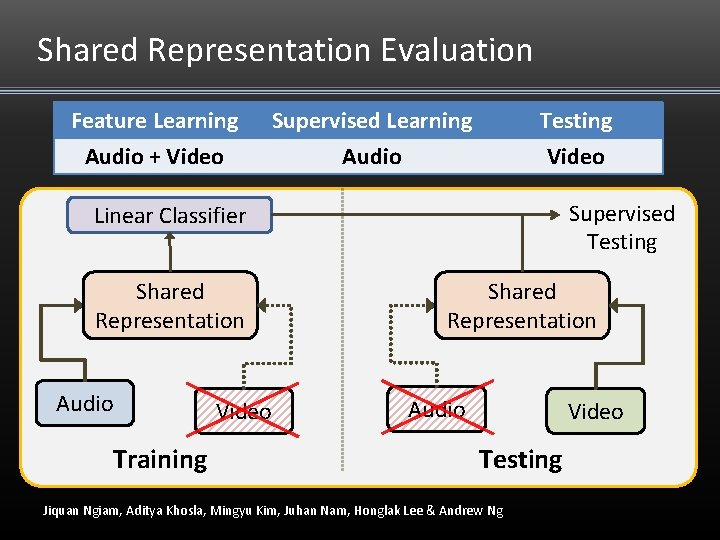
Shared Representation Evaluation Feature Learning Audio + Video Supervised Learning Audio Testing Video Supervised Testing Linear Classifier Shared Representation Audio Training Video Shared Representation Audio Video Testing Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
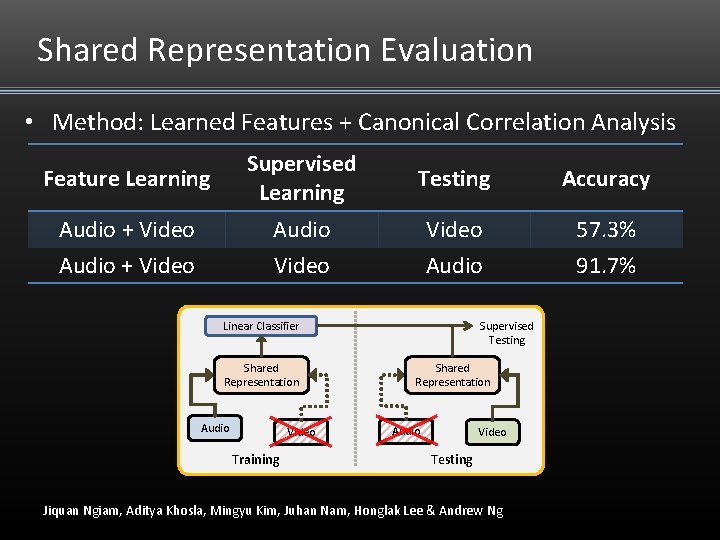
Shared Representation Evaluation • Method: Learned Features + Canonical Correlation Analysis Feature Learning Supervised Learning Testing Accuracy Audio + Video Audio 57. 3% 91. 7% Supervised Testing Linear Classifier Shared Representation Audio Video Training Shared Representation Audio Video Testing Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
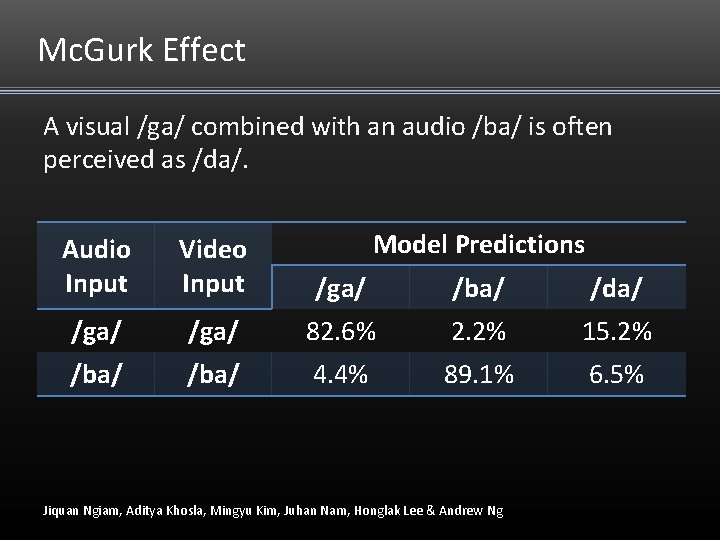
Mc. Gurk Effect A visual /ga/ combined with an audio /ba/ is often perceived as /da/. Model Predictions Audio Input Video Input /ga/ /ba/ /da/ /ga/ 82. 6% 2. 2% 15. 2% /ba/ 4. 4% 89. 1% 6. 5% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
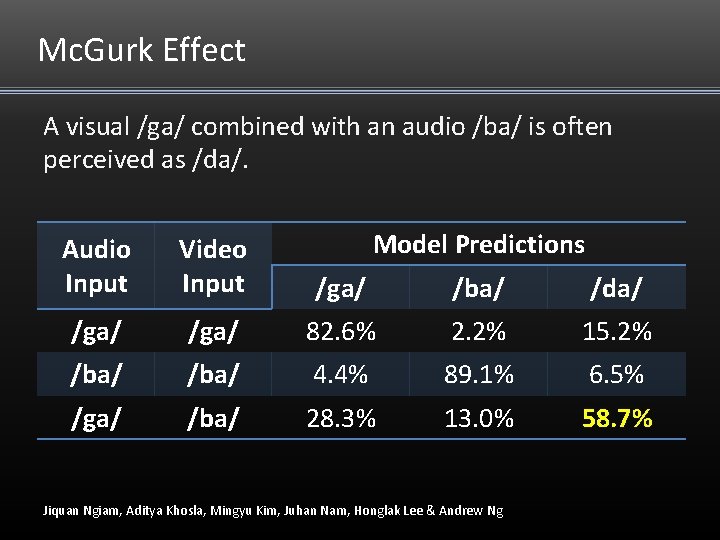
Mc. Gurk Effect A visual /ga/ combined with an audio /ba/ is often perceived as /da/. Model Predictions Audio Input Video Input /ga/ /ba/ /da/ /ga/ 82. 6% 2. 2% 15. 2% /ba/ 4. 4% 89. 1% 6. 5% /ga/ /ba/ 28. 3% 13. 0% 58. 7% Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
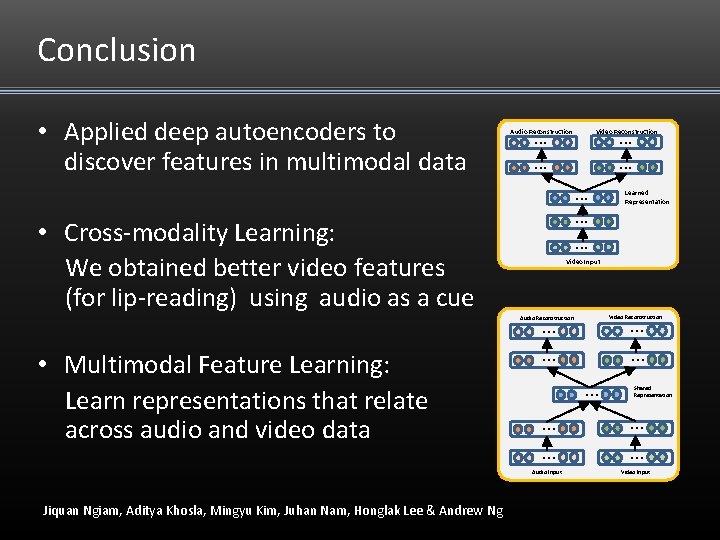
Conclusion • Applied deep autoencoders to discover features in multimodal data . . . Video Reconstruction Audio Reconstruction . . • Cross-modality Learning: We obtained better video features (for lip-reading) using audio as a cue Video Input . . . Video Reconstruction Audio Reconstruction • Multimodal Feature Learning: Learn representations that relate across audio and video data Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng Learned Representation . . . Shared Representation . . . Audio Input Video Input
Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng
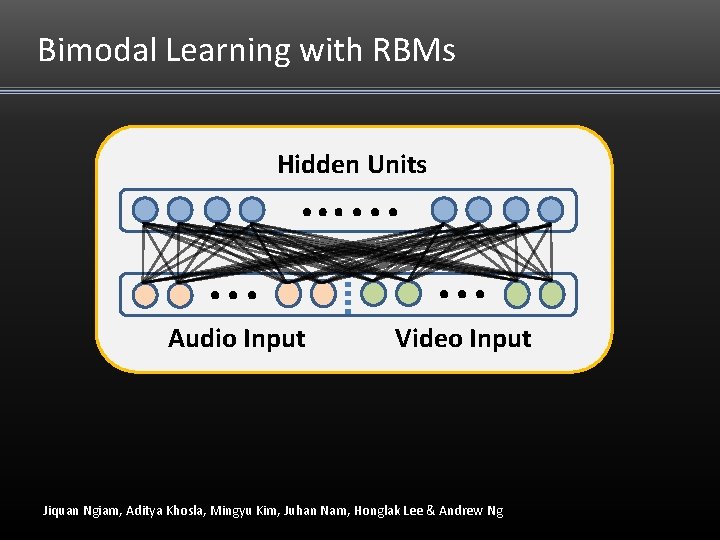
Bimodal Learning with RBMs Hidden Units . . . …. . . Audio Input . . . Video Input Jiquan Ngiam, Aditya Khosla, Mingyu Kim, Juhan Nam, Honglak Lee & Andrew Ng