
Mtodos estatsticos em aprendizagem Mestrado FEI Paulo Santos
- Slides: 55
Métodos estatísticos em aprendizagem Mestrado FEI Paulo Santos
Aprendizagem: raciocínio com incerteza a partir de observações • aprender teorias probabilísticas sobre o mundo a partir da experiência; • soluções gerais para os problemas de ruído, memorização e previsão ótima
Aprendizagem estatística • Conceitos fundamentais: – Dados: evidências, i. e. instanciações de algumas ou de todas as variáveis aleatórias que descrevem o domínio; – Hipóteses: teorias probabilísticas de como o domínio funciona • incluindo teorias lógicas como casos particulares.
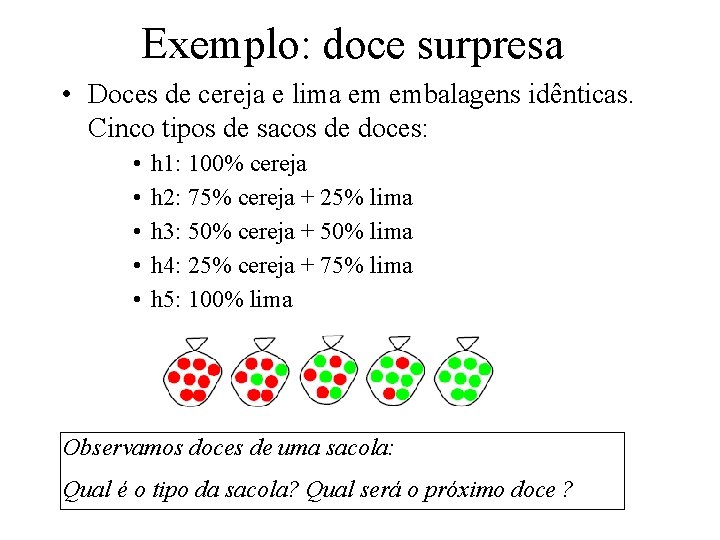
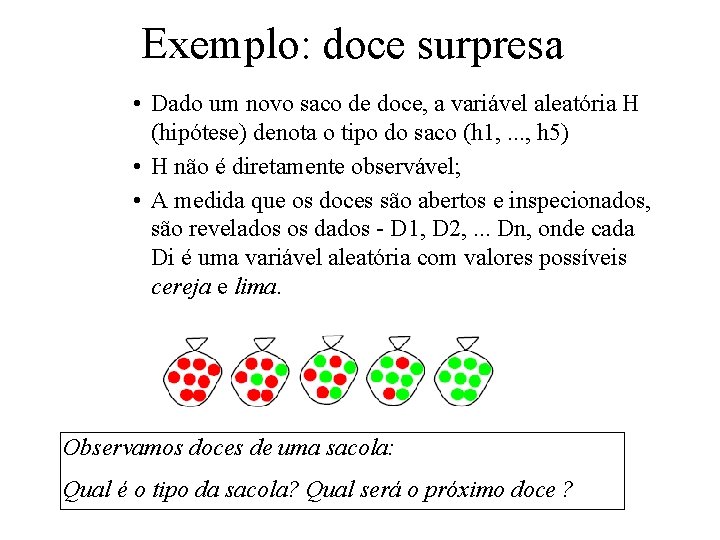
Exemplo: doce surpresa • Doces de cereja e lima em embalagens idênticas. Cinco tipos de sacos de doces: • • • h 1: 100% cereja h 2: 75% cereja + 25% lima h 3: 50% cereja + 50% lima h 4: 25% cereja + 75% lima h 5: 100% lima Observamos doces de uma sacola: Qual é o tipo da sacola? Qual será o próximo doce ?
Exemplo: doce surpresa • Dado um novo saco de doce, a variável aleatória H (hipótese) denota o tipo do saco (h 1, . . . , h 5) • H não é diretamente observável; • A medida que os doces são abertos e inspecionados, são revelados os dados - D 1, D 2, . . . Dn, onde cada Di é uma variável aleatória com valores possíveis cereja e lima. Observamos doces de uma sacola: Qual é o tipo da sacola? Qual será o próximo doce ?
Aprendizagem Bayesiana • Calcula a probabilidade de cada hipótese, considerando-se os dados, e faz previsões de acordo com ela; – as previsões são feitas com o uso de todas as hipóteses, ponderadas com suas probabilidades – A aprendizagem é reduzida à inferência probabilística
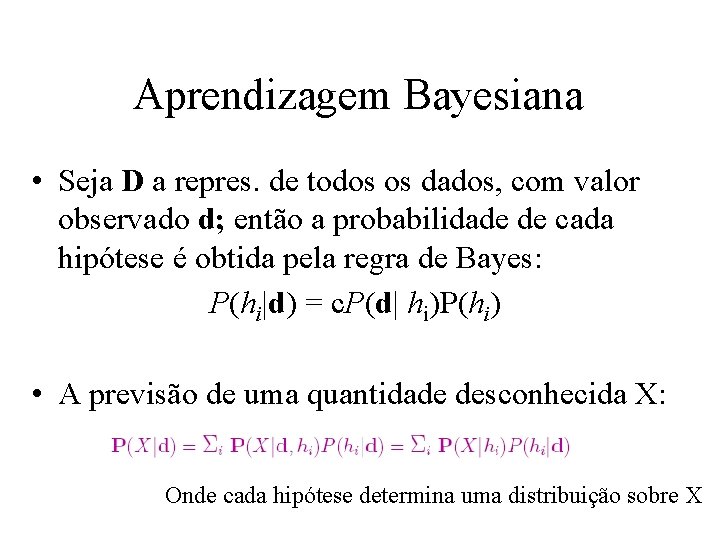
Aprendizagem Bayesiana • Seja D a repres. de todos os dados, com valor observado d; então a probabilidade de cada hipótese é obtida pela regra de Bayes: P(hi|d) = c. P(d| hi)P(hi) • A previsão de uma quantidade desconhecida X: Onde cada hipótese determina uma distribuição sobre X
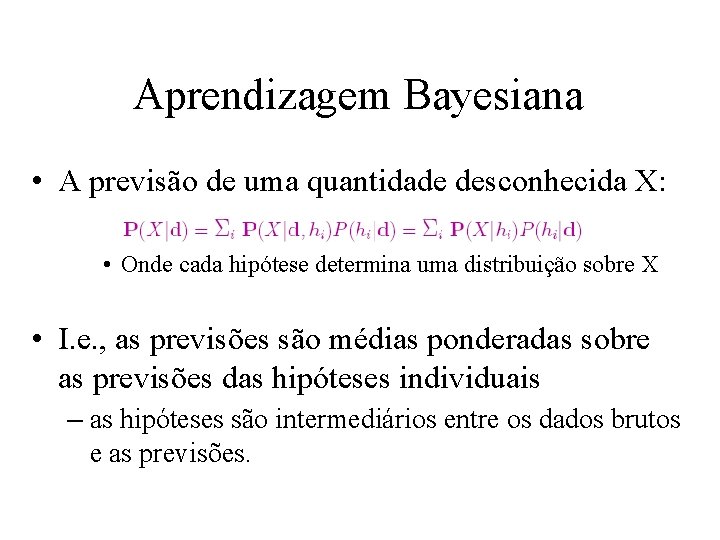
Aprendizagem Bayesiana • A previsão de uma quantidade desconhecida X: • Onde cada hipótese determina uma distribuição sobre X • I. e. , as previsões são médias ponderadas sobre as previsões das hipóteses individuais – as hipóteses são intermediários entre os dados brutos e as previsões.
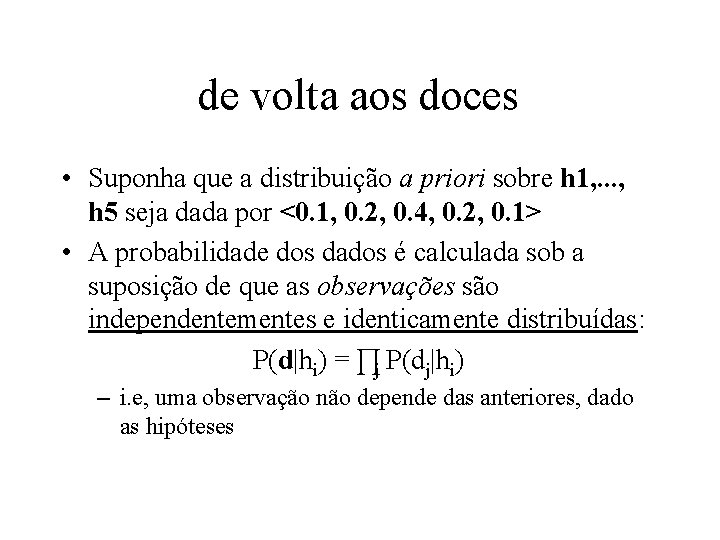
de volta aos doces • Suponha que a distribuição a priori sobre h 1, . . . , h 5 seja dada por <0. 1, 0. 2, 0. 4, 0. 2, 0. 1> • A probabilidade dos dados é calculada sob a suposição de que as observações são independentementes e identicamente distribuídas: P(d|hi) = ∏j P(dj|hi) – i. e, uma observação não depende das anteriores, dado as hipóteses
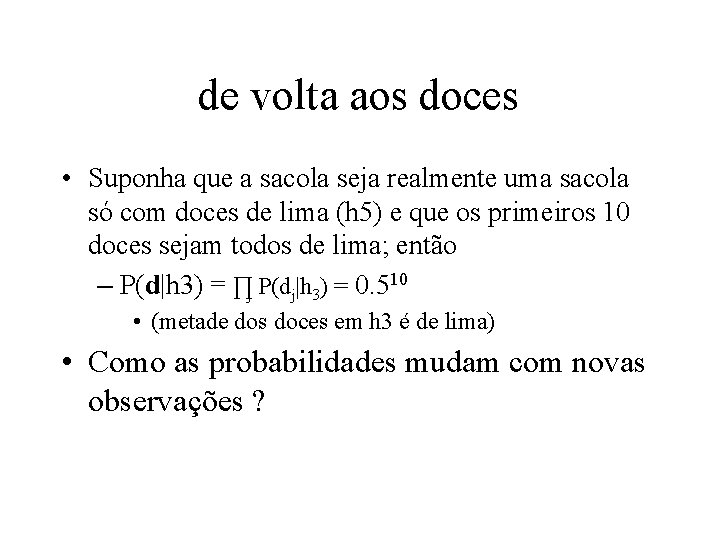
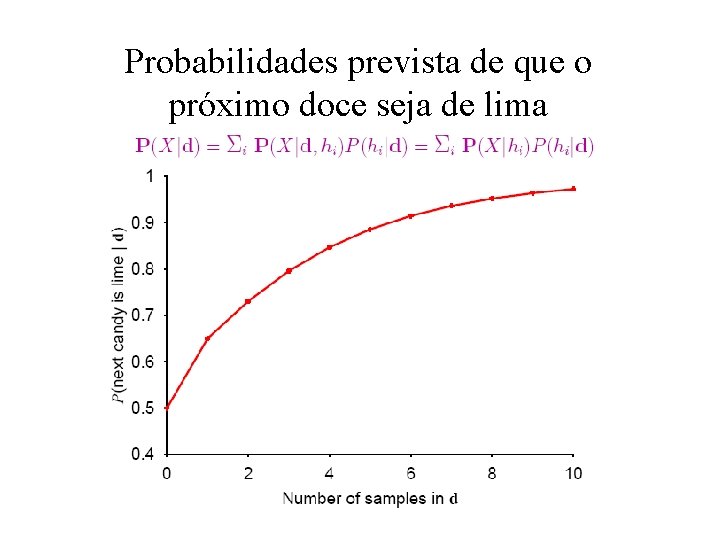
de volta aos doces • Suponha que a sacola seja realmente uma sacola só com doces de lima (h 5) e que os primeiros 10 doces sejam todos de lima; então – P(d|h 3) = ∏j P(dj|h 3) = 0. 510 • (metade dos doces em h 3 é de lima) • Como as probabilidades mudam com novas observações ?
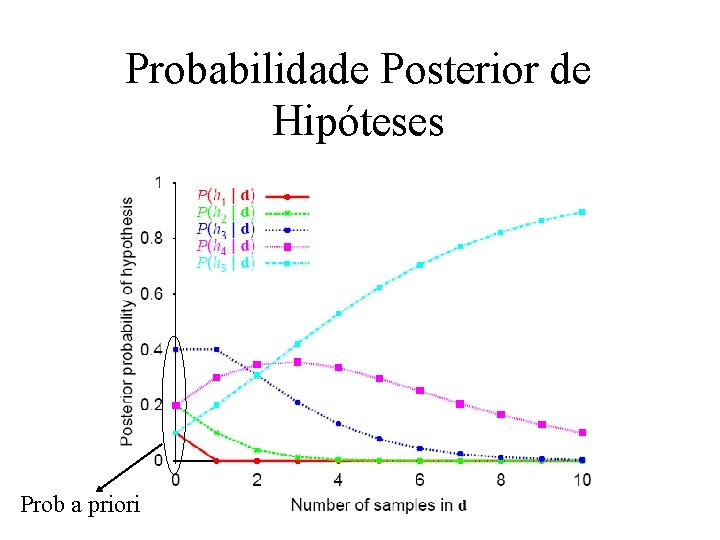
Probabilidade Posterior de Hipóteses Prob a priori
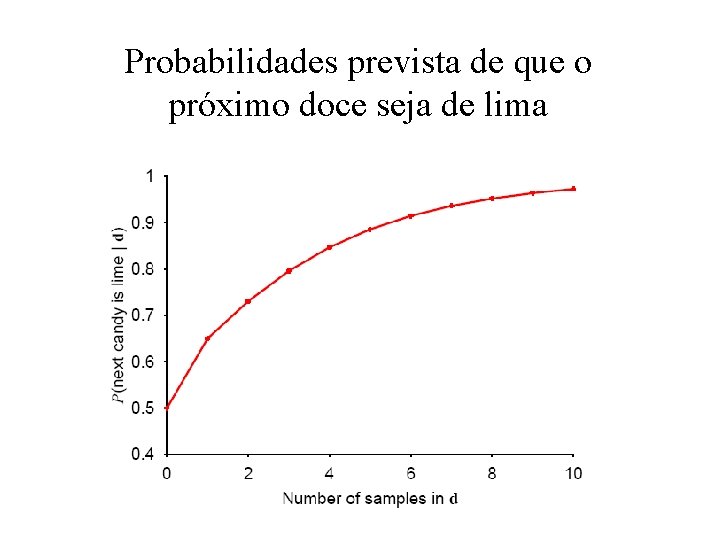
Probabilidades prevista de que o próximo doce seja de lima
Probabilidades prevista de que o próximo doce seja de lima
Aprendizagem Bayesiana • Dada a distribuição a priori de todas as hipóteses • A hipótese verdadeira eventualmente domina a previsão Bayesiana • A previsão é ótima quer o conjunto de dados seja pequeno ou grande • para problemas reais de aprendizagem o espaço de hipóteses é em geral muito grande ou infinito
Aprendizagem Bayesiana aproximada : MAP • Fazer previsões com uma única hipótese: a mais provável: – hi que maximize P(hi|d) – hipótese de máximo a posteriori: MAP – previsões aproximadamente Bayesianas: P(X|d) ≈ P(X|h. MAP) • após 3 doces de lima seguidos h. MAP= h 5 • o 4 o doce será previsto de lima com 100% de certeza
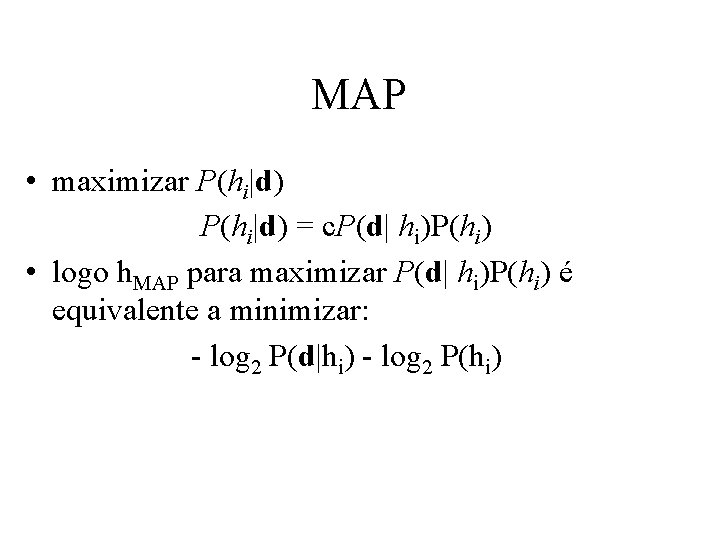
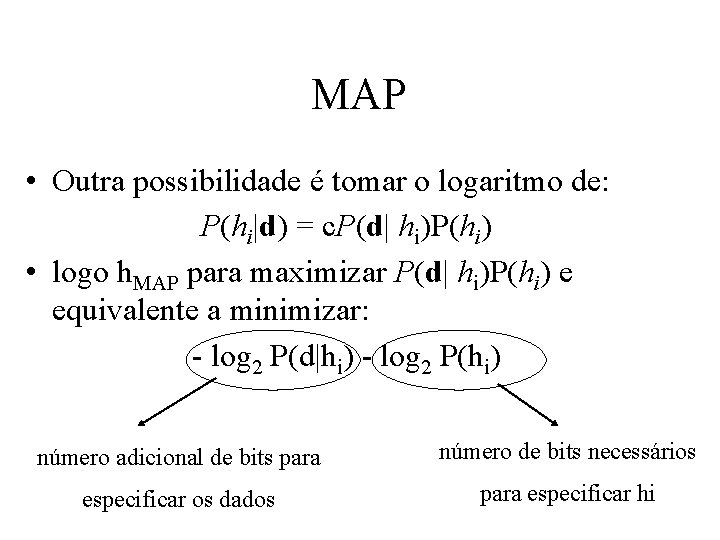
MAP • maximizar P(hi|d) = c. P(d| hi)P(hi) • logo h. MAP para maximizar P(d| hi)P(hi) é equivalente a minimizar: - log 2 P(d|hi) - log 2 P(hi)
MAP • Outra possibilidade é tomar o logaritmo de: P(hi|d) = c. P(d| hi)P(hi) • logo h. MAP para maximizar P(d| hi)P(hi) e equivalente a minimizar: - log 2 P(d|hi) - log 2 P(hi) número adicional de bits para número de bits necessários especificar os dados para especificar hi
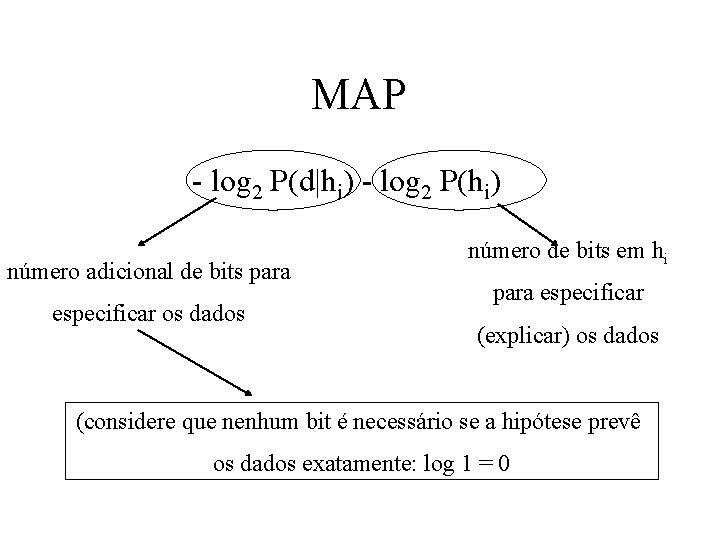
MAP - log 2 P(d|hi) - log 2 P(hi) número adicional de bits para especificar os dados número de bits em hi para especificar (explicar) os dados (considere que nenhum bit é necessário se a hipótese prevê os dados exatamente: log 1 = 0
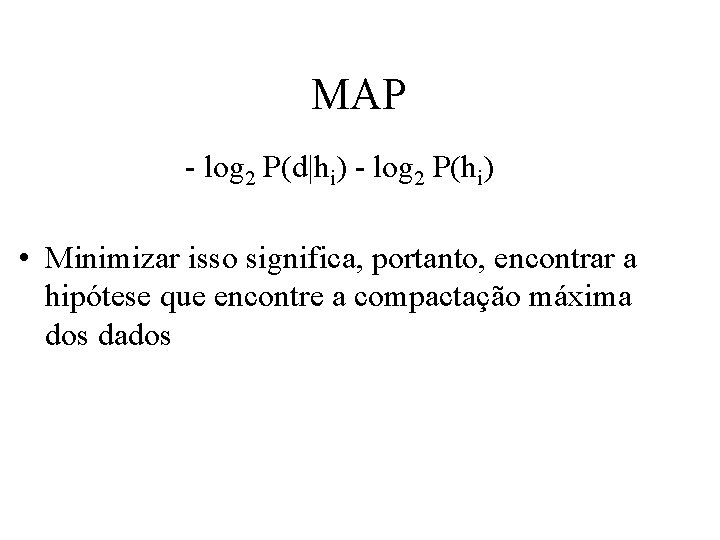
MAP - log 2 P(d|hi) - log 2 P(hi) • Minimizar isso significa, portanto, encontrar a hipótese que encontre a compactação máxima dos dados
MAP • encontrar a hipótese que encontre a compactação máxima dos dados Principal idéia por traz dá aprendizagem por comprimento mínimo de descrição (CMD) [minimum description length (MDL) learning]: minimizar o tamanho da hipótese e das codificações dos dados
Aprendizagem de parâmetros com dados completos • Aprendizagem de parâmetros com dados completos: – descoberta dos parâmetros numéricos para um modelo de probabilidade cuja estrutura é fixa – Dados são completos quando cada ponto de dados contém valores para toda variável no modelo de probabilidade que está sendo aprendido. • simplificam o processo de aprendizagem
Exemplo • saco de doces de um novo fabricante cujas proporções de cereja e lima são completamente desconhecidas (entre 0 e 1) – quantidade contínua de hipóteses • O parâmetro (θ ) é a proporção de doces de cereja (1 - θ é a prop de lima) • A hipótese é hθ
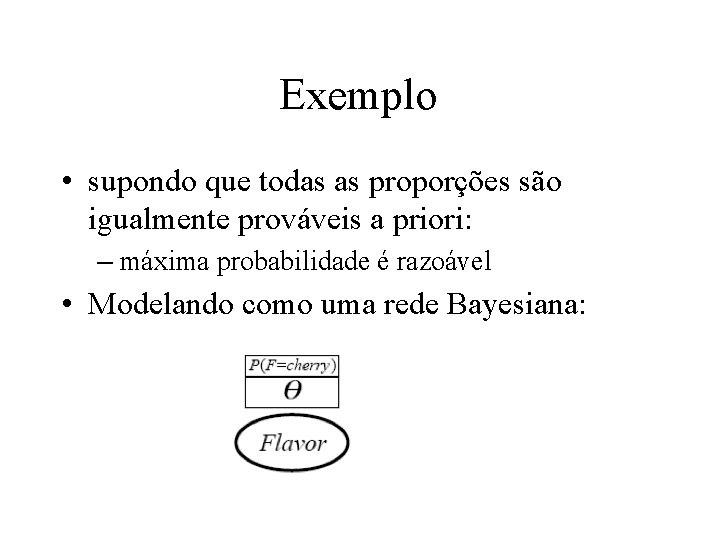
Exemplo • supondo que todas as proporções são igualmente prováveis a priori: – máxima probabilidade é razoável • Modelando como uma rede Bayesiana:
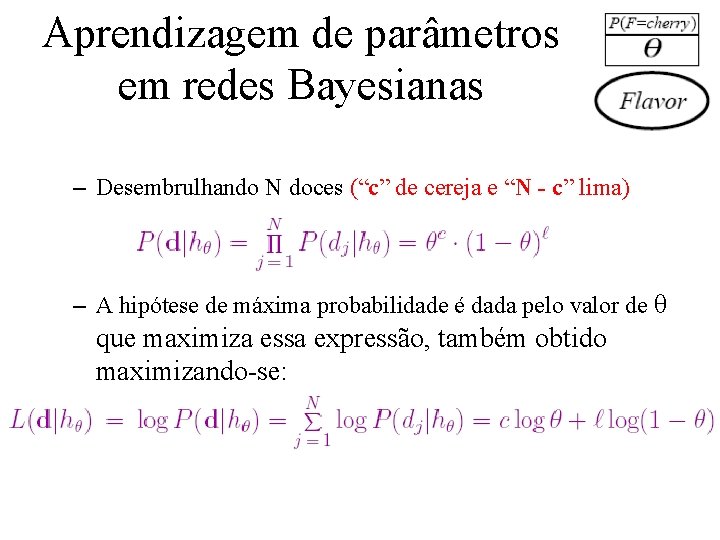
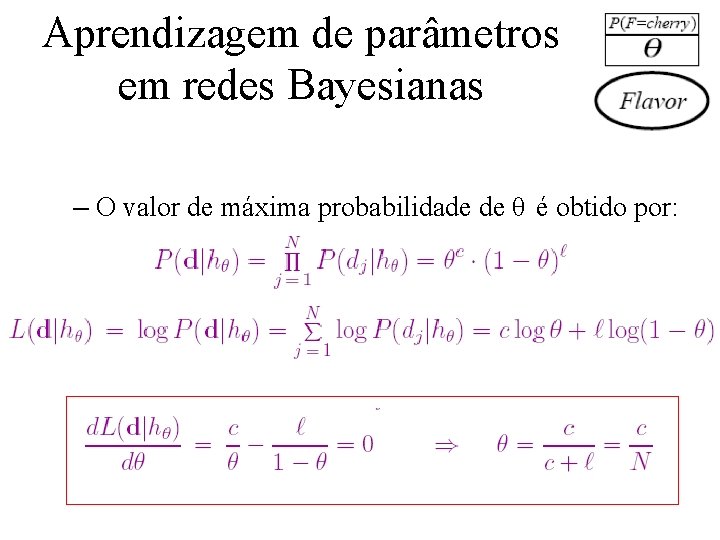
Aprendizagem de parâmetros em redes Bayesianas – Desembrulhando N doces (“c” de cereja e “N - c” lima) – A hipótese de máxima probabilidade é dada pelo valor de θ que maximiza essa expressão, também obtido maximizando-se:
Aprendizagem de parâmetros em redes Bayesianas – O valor de máxima probabilidade de θ é obtido por:
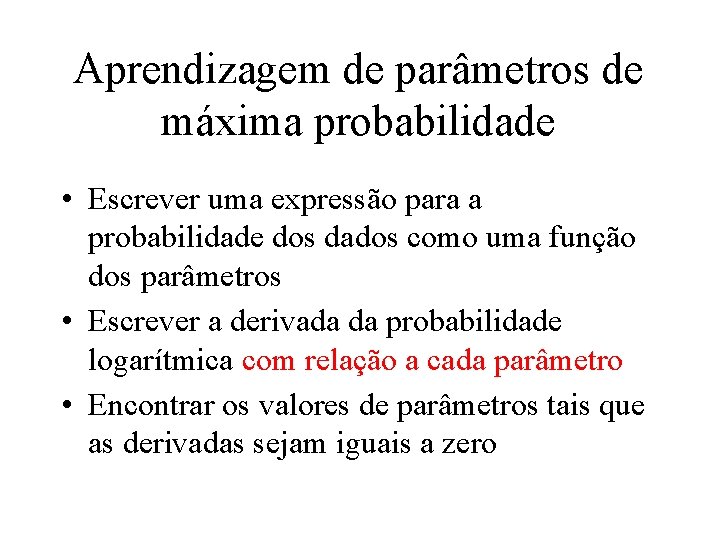
Aprendizagem de parâmetros de máxima probabilidade • Escrever uma expressão para a probabilidade dos dados como uma função dos parâmetros • Escrever a derivada da probabilidade logarítmica com relação a cada parâmetro • Encontrar os valores de parâmetros tais que as derivadas sejam iguais a zero
Aprendizagem de parâmetros de máxima probabilidade • Principal problema (small sample size problem): – para conjuntos de dados pequenos, alguns eventos recebem probabilidade zero – divisão não definida
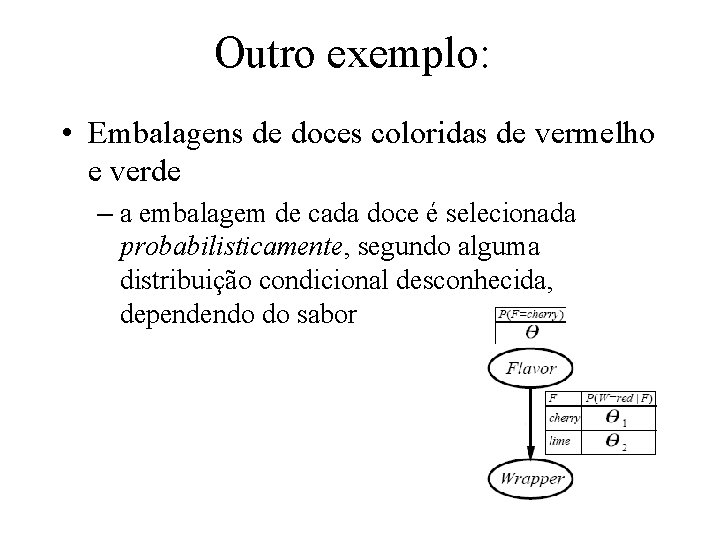
Outro exemplo: • Embalagens de doces coloridas de vermelho e verde – a embalagem de cada doce é selecionada probabilisticamente, segundo alguma distribuição condicional desconhecida, dependendo do sabor
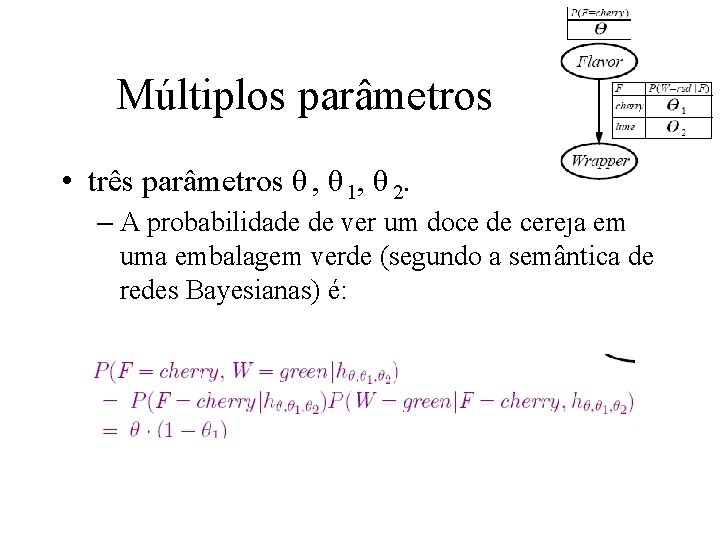
Múltiplos parâmetros • três parâmetros θ , θ 1, θ 2. – A probabilidade de ver um doce de cereja em uma embalagem verde (segundo a semântica de redes Bayesianas) é:
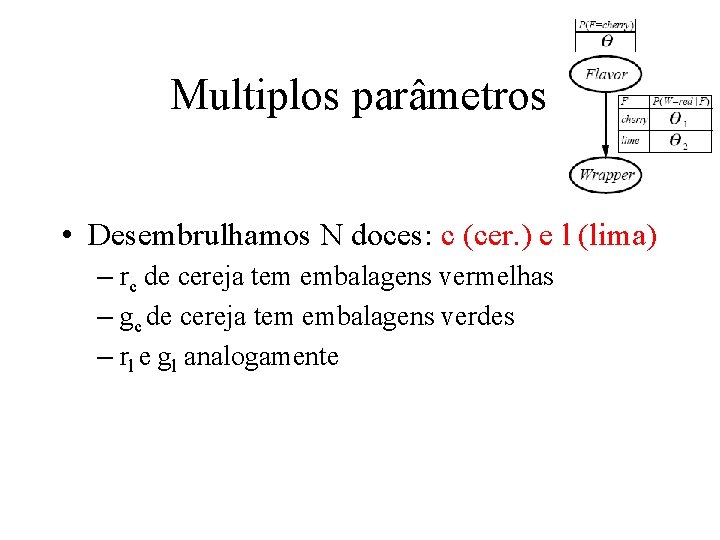
Multiplos parâmetros • Desembrulhamos N doces: c (cer. ) e l (lima) – rc de cereja tem embalagens vermelhas – gc de cereja tem embalagens verdes – rl e gl analogamente
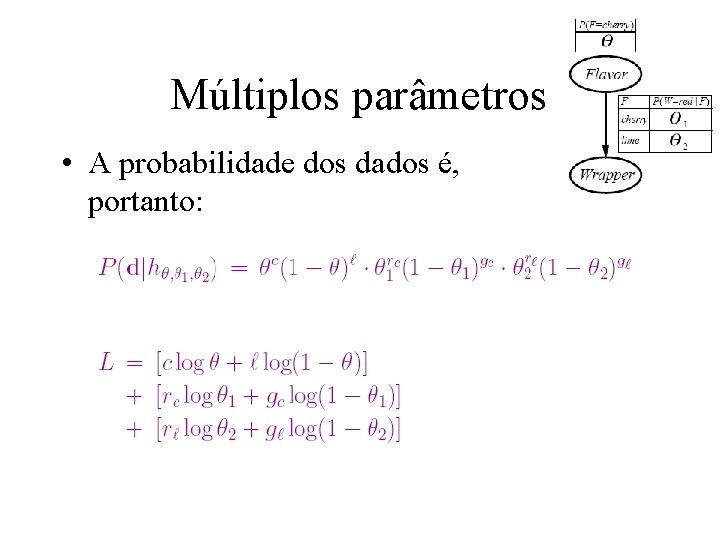
Múltiplos parâmetros • A probabilidade dos dados é, portanto:
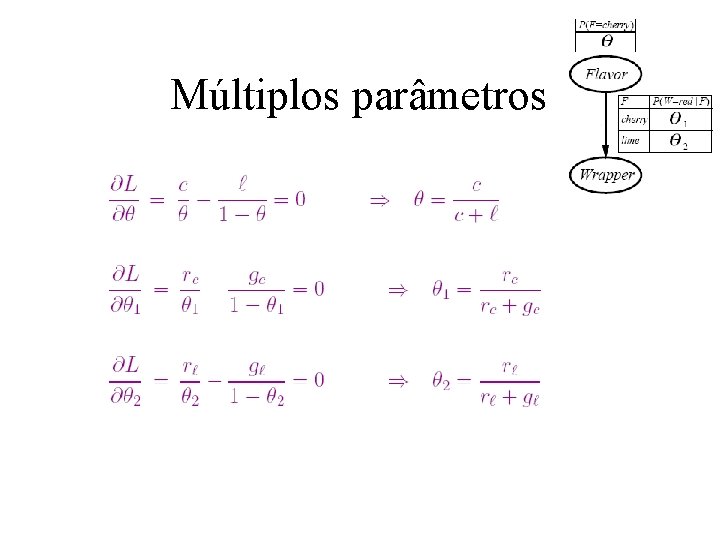
Múltiplos parâmetros
Múltiplos parâmetros • esses resultados podem ser estendidos a qqr rede Bayesiana cujas probabilidades condicionais são dadas como tabelas • com dados completos, o problema de aprendizagem de parâmetros por máxima probabilidade se decompõe em problemas de aprendizagem separados: um para cada parâmetro. • os valores de parâmetros para uma variável, dados seus pais, são as frequências observadas dos valores de variáveis para cada configuração dos valores dos pais
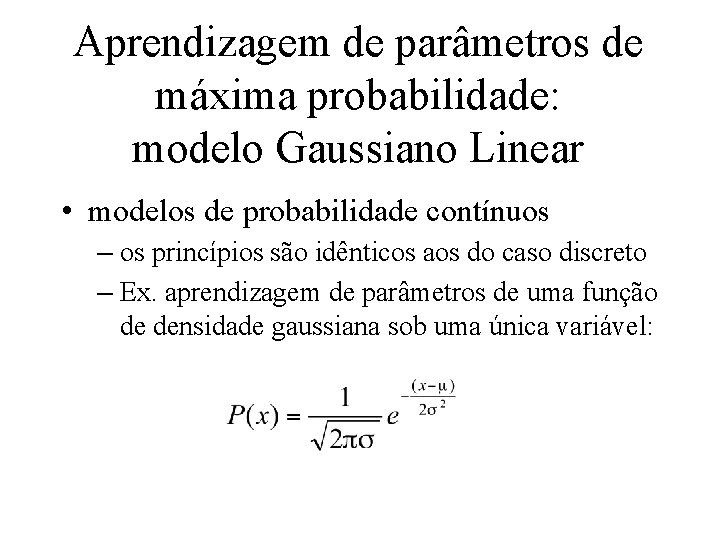
Aprendizagem de parâmetros de máxima probabilidade: modelo Gaussiano Linear • modelos de probabilidade contínuos – os princípios são idênticos aos do caso discreto – Ex. aprendizagem de parâmetros de uma função de densidade gaussiana sob uma única variável:
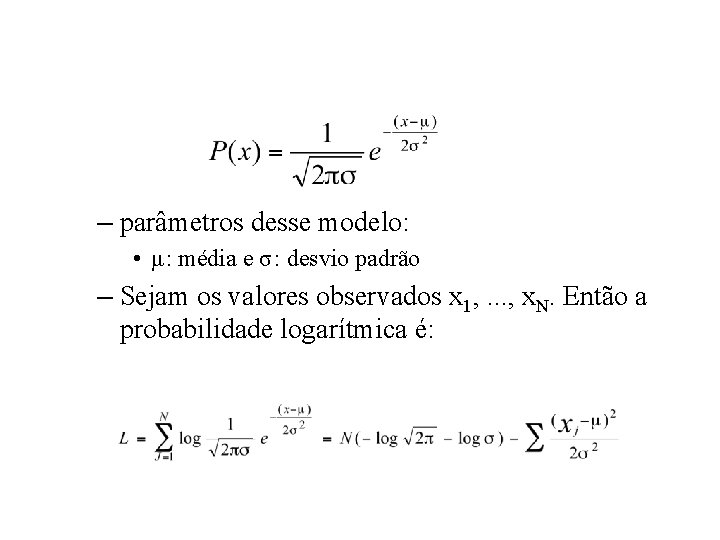
– parâmetros desse modelo: • μ: média e σ: desvio padrão – Sejam os valores observados x 1, . . . , x. N. Então a probabilidade logarítmica é:
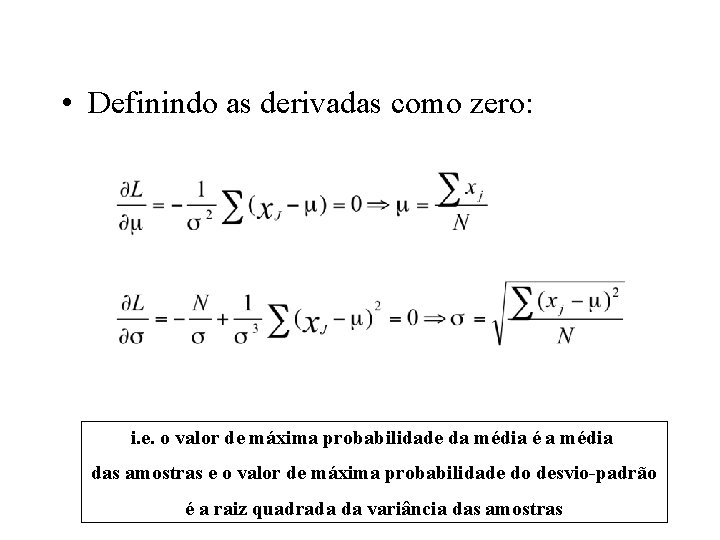
• Definindo as derivadas como zero: i. e. o valor de máxima probabilidade da média é a média das amostras e o valor de máxima probabilidade do desvio-padrão é a raiz quadrada da variância das amostras
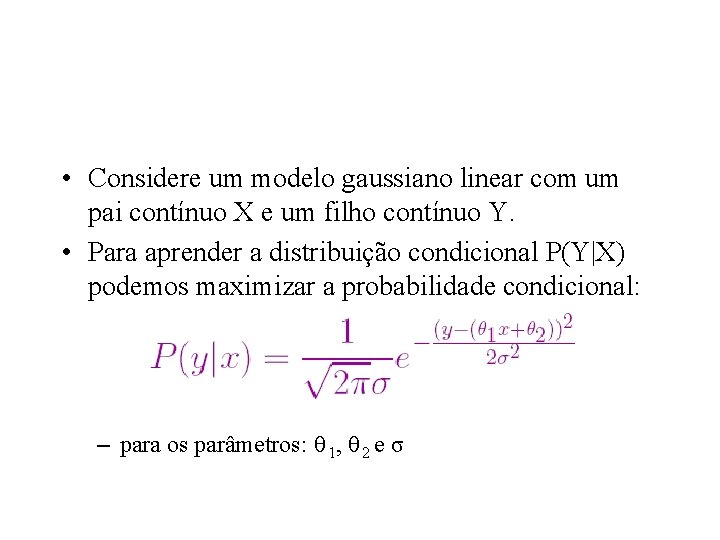
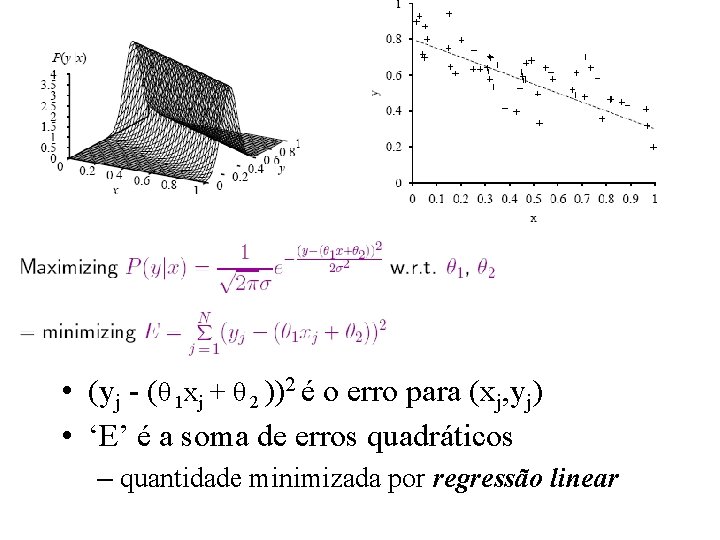
• Considere um modelo gaussiano linear com um pai contínuo X e um filho contínuo Y. • Para aprender a distribuição condicional P(Y|X) podemos maximizar a probabilidade condicional: – para os parâmetros: θ 1, θ 2 e σ
• (yj - (θ 1 xj + θ 2 ))2 é o erro para (xj, yj) • ‘E’ é a soma de erros quadráticos – quantidade minimizada por regressão linear
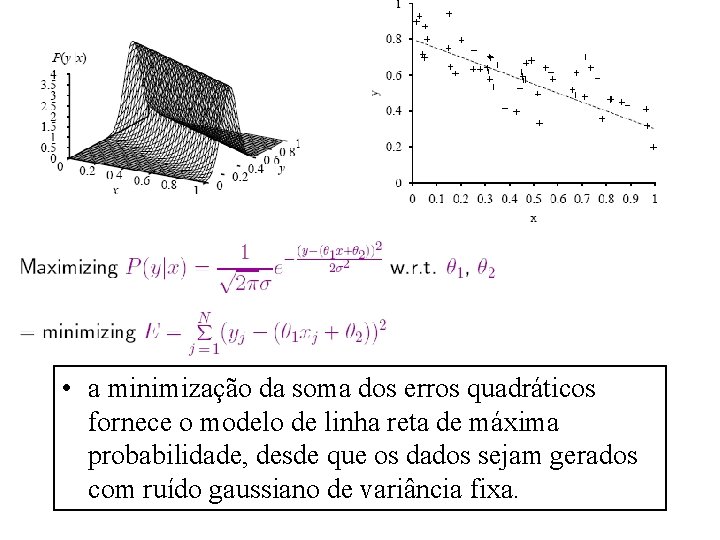
• a minimização da soma dos erros quadráticos fornece o modelo de linha reta de máxima probabilidade, desde que os dados sejam gerados com ruído gaussiano de variância fixa.
Aprendizagem de estruturas de redes Bayesianas • Até agora supomos que a estrutura da rede bayesiana é dada: – somente aprende-se os parâmetros • Em alguns casos o modelo causal está indisponível ou em disputa
Aprendizagem de estruturas • Abordagem óbvia: – buscar um modelo: • iniciar com um modelo que não contenha nenhum vínculo e começar a adicionar pais correspondentes a cada nó, ajustando os parâmetros e medindo a exatidão do modelo resultante. • começar com um palpite inicial sobre a estrutura e utilizar busca por subida de encosta para fazer modificações, retornando os parâmetros após cada mudança de estrutura. – modificações: inversão, adição ou eliminação de arcos. – busca sobre ordenações possíveis
Aprendizagem de estruturas • Uma boa estrutura foi encontrada? – testar se as asserções de independência condicional implícitas na estrutura são realmente satisfeitas nos dados. P(Sex/Sab, Bar|Vai. Esperar) = P(Sex/Sab|Vai. Esperar)P(Bar|Vai. Esperar) • Verificar nos dados se esta equação é válida. – ainda que a estrutura descreva a verdadeira natureza causal do domínio, flutuações estatísticas no conjunto de dados significam que a equação nunca será satisfeita exatamente, e então precisamos utilizar um teste estatístico apropriado para verificar se existe evidência estatística suficiente de que a hipótese de independência foi violada • quanto mais rígido for este teste, mais vínculos serão adicionados e maior o risco de superadaptação.
Aprendizagem de variáveis ocultas • Variáveis ocultas (ou latentes) – ex. registros médicos contêm sintomas observáveis e o tratamento, mas raramente uma observação da doença! • Por que não construir um modelo sem esta variável?
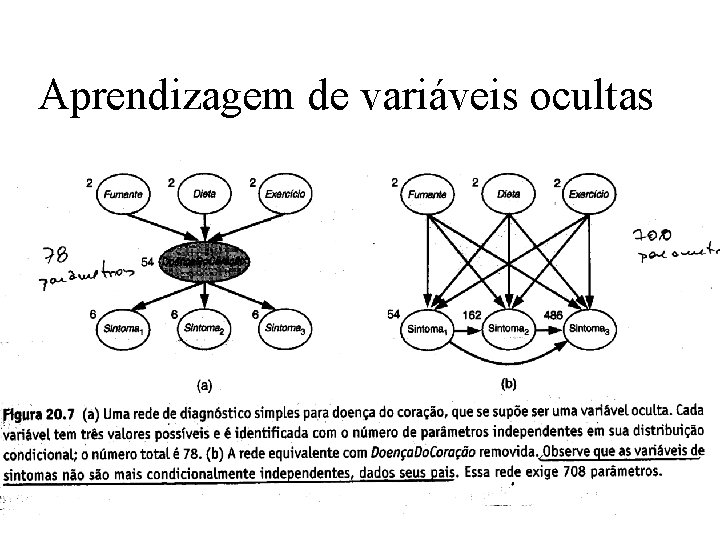
Aprendizagem de variáveis ocultas
Aprendizagem de variáveis ocultas • Variáveis latentes podem reduzir drasticamente o número de parâmetros exigidos para especificar uma rede Bayesiana.
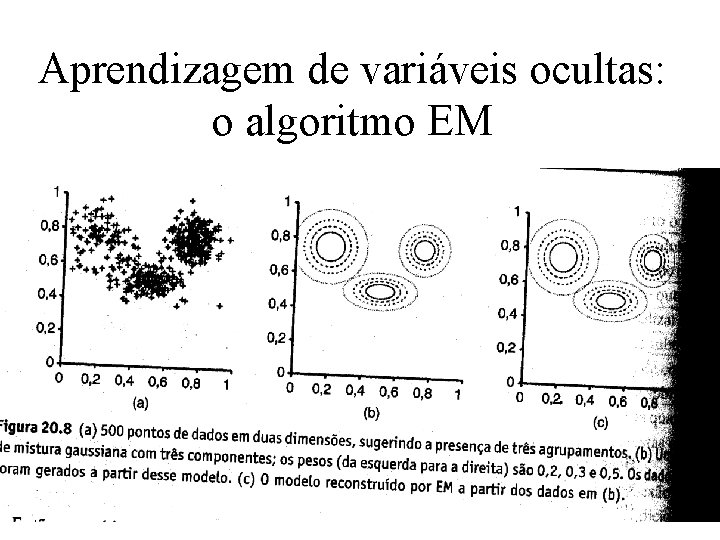
Aprendizagem de variáveis ocultas: o algoritmo EM • EM: Expectation Maximization (Esperança Maximização) – Formação de agrupamentos não supervisionados • Distinguir várias categorias em uma coleção de objetos • não supervisionado: os rótulos não são dados
Aprendizagem de variáveis ocultas: o algoritmo EM – Formação de agrupamentos não supervisionados • Começamos dados • ajustar alguma distribuição de probabilidades que pudesse ter gerado os dados • Pressupõe que os dados são gerados a partir de uma distribuição de mistura P – uma distribuição tem k componentes, cada um dos quais é uma distribuição: P(x) = ∑ki=1 P(C = i) P(x|C = i)
Aprendizagem de variáveis ocultas: o algoritmo EM – Formação de agrupamentos não supervisionados • No caso de dados contínuos: – gaussiana multivariada: fornece uma família de distribuições chamada mistura de distribuições gaussianas – wi = P(C=i) --- peso de cada componente – μi ---- media de cada componente – Σi --- co-variância de cada componente
Aprendizagem de variáveis ocultas: o algoritmo EM
o algoritmo EM – O problema de formação de agrupamentos nãosupervisionados consiste em recuperar um modelo de mistura como o da Fig. 20. 8(b) a partir de dados brutos como os da Fig. 20. 8 (a). – Idéia básica: • fingir que conhecemos os parâmetros do modelo e depois deduzir a probabilidade de cada ponto de dados pertencer a cada componente • depois disso, readaptamos os componentes aos dados, onde cada componente é ajustado ao conjunto de dados inteiro, cada ponto ponderado com a possibilidade de pertencer a esse componente
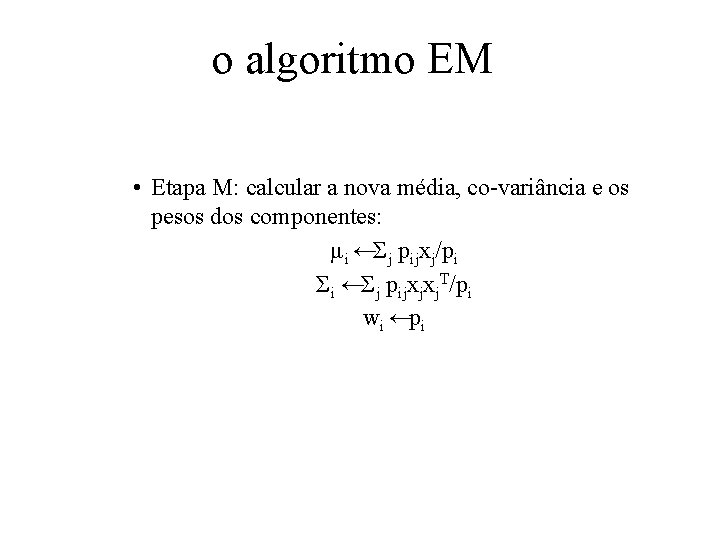
o algoritmo EM – Para mistura de distribuições gaussianas, inicalizamos arbitrariamente os parâmetros do modelo de mistura e repetimos: • Etapa E: calcular as probabilidades pij=P(C=i|xj) – a probabilidade de que o dado xj tenha sido gerado pelo componente i. – pela regra de Bayes: pij= a. P(xj|C = i)P(C=i) » P(xj|C = i): probabilidade em xj do i-esimo gaussiano » P(C = i): peso para o iesimo gaussiano – definir: pi = Σj pij • Etapa M:
o algoritmo EM – Para mistura de distribuições gaussianas, inicalizamos arbitrariamente os parâmetros do modelo de mistura e repetimos: • Etapa E: calcular as probabilidades pij=P(C=i|xj) – a probabilidade de que o dado xj tenha sido gerado pelo componente i. – pela regra de Bayes: pij= a. P(xj|C = i)P(C=i) » P(xj|C = i): probabilidade em xj do i-esimo gaussiano » P(C = i): peso para o iesimo gaussiano – definir: pi = Σj pij (somar sobre todas probabilidades de todos os pontos j terem sido gerados pela gaussiana i) • Etapa M:
o algoritmo EM • Etapa M: calcular a nova média, co-variância e os pesos dos componentes: μ i ←Σj pijxj/pi Σi ←Σj pijxjxj. T/pi wi ←pi
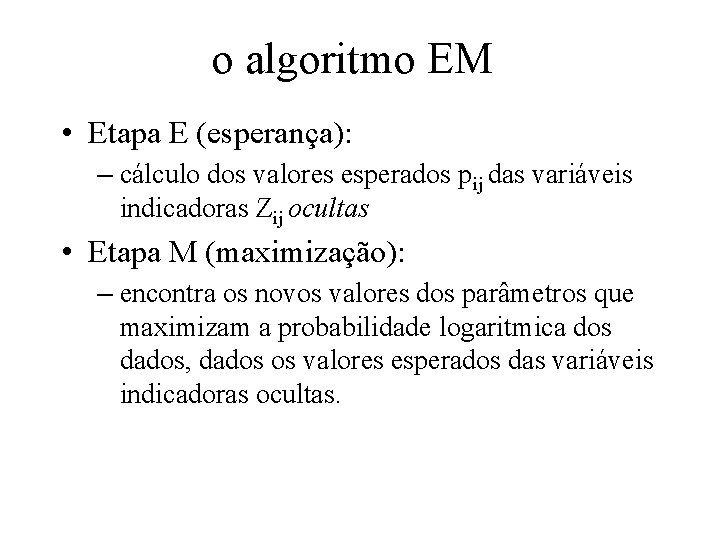
o algoritmo EM • Etapa E (esperança): – cálculo dos valores esperados pij das variáveis indicadoras Zij ocultas • Etapa M (maximização): – encontra os novos valores dos parâmetros que maximizam a probabilidade logaritmica dos dados, dados os valores esperados das variáveis indicadoras ocultas.
Aprendizagem de redes Bayesianas com variáveis ocultas • Execício: – leia e entenda esta seção. Uma questão sobre este assunto cairá na prova. • (dica: para entender esta seção você terá antes que entender -- quase -- todo o capítulo!)