
Mthodologie de lobservation Partie B Statistiques Cours 4
Méthodologie de l’observation Partie B Statistiques Cours 4
Recherche de description • Rappel = décrire les caractéristiques (les distributions) d’une ou plusieurs variables mesurées sur un échantillon ou une population. • 2 caractéristiques à dégager : – les indices de tendance centrale des données – les indices de dispersion • Présentation des informations et données – les transformations possibles et nécessaires données – les représentations graphiques des résultats
L’indice de tendance centrale • = indique la caractéristique la plus représentative de tous les individus du groupe en la ramenant à un individu type qui se situerait au « centre » de la distribution • Il rend possible la comparaison entre des groupes d’individus différents sur base de la mesure d’une même variable • Ex : les éléphants d’Afrique ont « en moyenne » une masse supérieure à celle des éléphants d’Asie
L’indice de dispersion • = exprime l’étendue de la variabilité des observations • Les données peuvent être concentrées autour de la tendance centrale ou au contraire très dispersées Exemple : • un groupe d’élèves (classe A) avec une moyenne de 10/20 mais dont les résultats en fin d’année s’étendent de 5/20 à 18/20 • un groupe d’élèves (classe B) avec une moyenne de 10/20 mais dont les cotes s’établiraient de 9/20 à 14/20 La classe A a un indice de dispersion supérieur à la classe B
Les indices de tendance centrale • Echelle nominale le mode • Echelle ordinale la médiane • Echelle intervalle la moyenne

Pour les échelles nominales : le mode • Le mode (Mo) = la modalité de la variable nominale dont la fréquence (absolue et relative) est la plus élevée – 2 modes distribution bimodale – 3 modes distribution trimodale Exemple : tableau des fréquences pour la variable « type d’étude » Modalités Fréquenc es (fi) Pourcenta ges (Pi) Le mode de la variable « type d’étude » est la modalité « médecine » économie médecine droit philo 40 80 30 50 20 40 15 25 Total 200 100
Pour les échelles ordinales : la médiane • La médiane (Md) = la valeur qui divise exactement en deux la distribution de l’échantillon, de manière qu’il y ait 50% des observations qui la précèdent et 50% qui la suivent (les catégories ou les scores étant rangés au préalable). • Remarque: Le mode (Mo) peut également être utilisé pour résumer une distribution constituée de catégories ordonnées. Il définit la modalité qui recueille la plus haute fréquence.
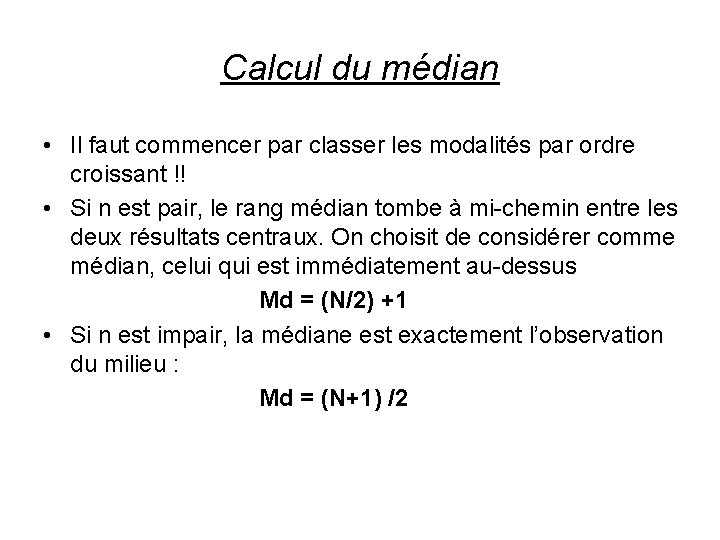
Calcul du médian • Il faut commencer par classer les modalités par ordre croissant !! • Si n est pair, le rang médian tombe à mi-chemin entre les deux résultats centraux. On choisit de considérer comme médian, celui qui est immédiatement au-dessus Md = (N/2) +1 • Si n est impair, la médiane est exactement l’observation du milieu : Md = (N+1) /2
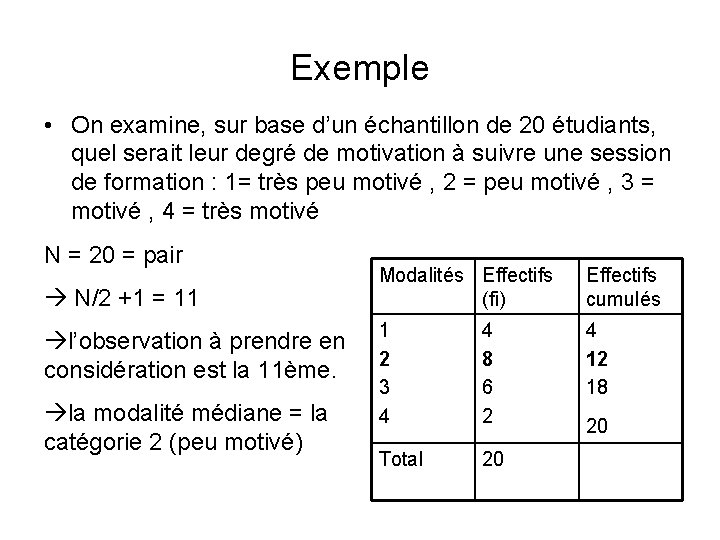
Exemple • On examine, sur base d’un échantillon de 20 étudiants, quel serait leur degré de motivation à suivre une session de formation : 1= très peu motivé , 2 = peu motivé , 3 = motivé , 4 = très motivé N = 20 = pair N/2 +1 = 11 l’observation à prendre en considération est la 11ème. la modalité médiane = la catégorie 2 (peu motivé) Modalités Effectifs (fi) Effectifs cumulés 1 2 3 4 4 8 6 2 4 12 18 Total 20 20
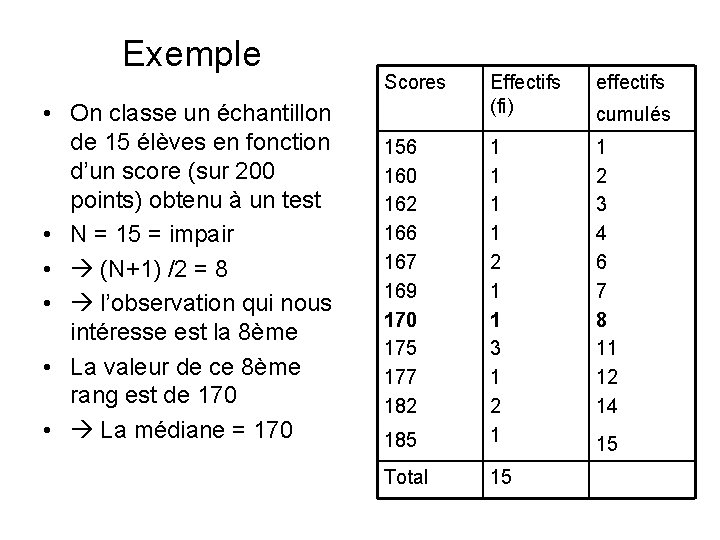
Exemple • On classe un échantillon de 15 élèves en fonction d’un score (sur 200 points) obtenu à un test • N = 15 = impair • (N+1) /2 = 8 • l’observation qui nous intéresse est la 8ème • La valeur de ce 8ème rang est de 170 • La médiane = 170 Scores Effectifs (fi) effectifs 1 2 3 4 6 7 8 11 12 14 185 1 1 2 1 1 3 1 2 1 Total 15 156 160 162 166 167 169 170 175 177 182 cumulés 15
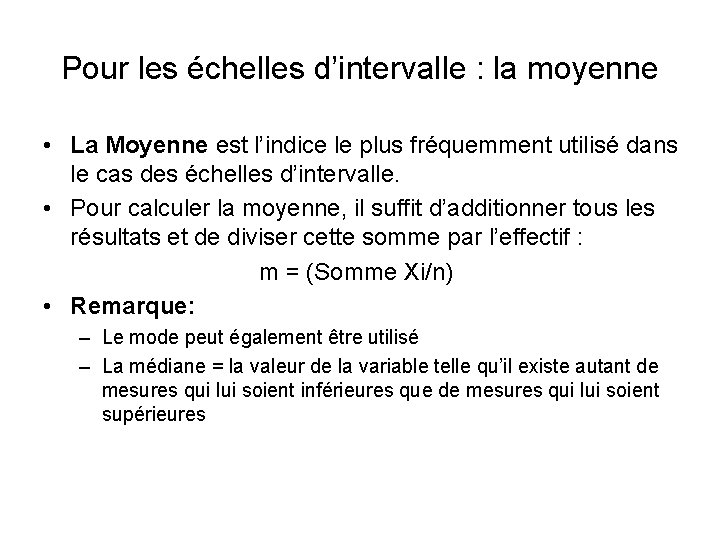
Pour les échelles d’intervalle : la moyenne • La Moyenne est l’indice le plus fréquemment utilisé dans le cas des échelles d’intervalle. • Pour calculer la moyenne, il suffit d’additionner tous les résultats et de diviser cette somme par l’effectif : m = (Somme Xi/n) • Remarque: – Le mode peut également être utilisé – La médiane = la valeur de la variable telle qu’il existe autant de mesures qui lui soient inférieures que de mesures qui lui soient supérieures
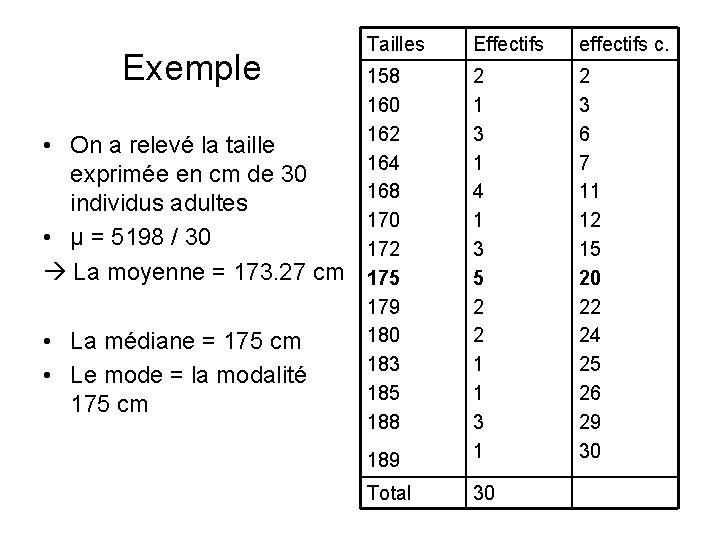
Exemple • On a relevé la taille exprimée en cm de 30 individus adultes • µ = 5198 / 30 La moyenne = 173. 27 cm • La médiane = 175 cm • Le mode = la modalité 175 cm Tailles Effectifs effectifs c. 158 160 162 164 168 170 172 175 179 180 183 185 188 2 1 3 1 4 1 3 5 2 2 1 1 3 1 2 3 6 7 11 12 15 20 22 24 25 26 29 30 189 Total 30
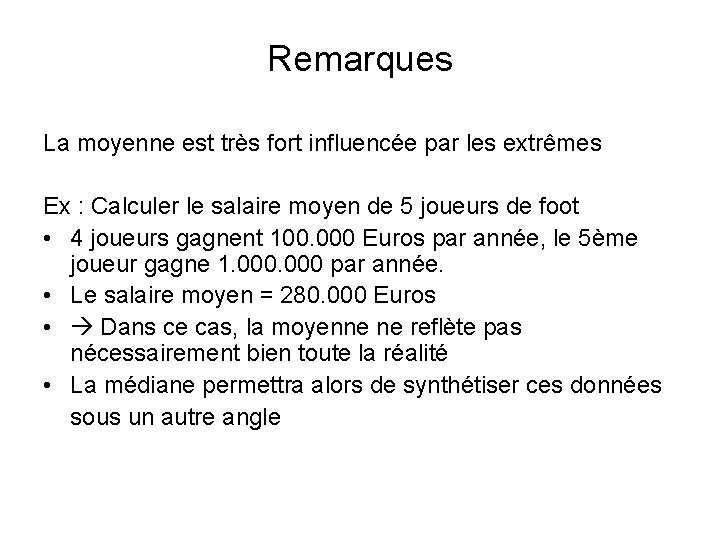
Remarques La moyenne est très fort influencée par les extrêmes Ex : Calculer le salaire moyen de 5 joueurs de foot • 4 joueurs gagnent 100. 000 Euros par année, le 5ème joueur gagne 1. 000 par année. • Le salaire moyen = 280. 000 Euros • Dans ce cas, la moyenne ne reflète pas nécessairement bien toute la réalité • La médiane permettra alors de synthétiser ces données sous un autre angle
Remarques • Le mode est facilement repérable et interprétable. Cependant, il ne tient pas compte de toutes les données et ne se prête pas au traitement arithmétique • La médiane est facilement interprétable et aisée à déterminer mais elle ne se prête pas aux traitements arithmétiques • La moyenne est facilement interprétable, aisée à calculer et se prête bien aux traitements arithmétiques
Les indices de dispersion • Les indices de dispersion nous fournissent une information sur la façon dont les données sont distribuées autour de la tendance centrale • Deux séries statistiques peuvent avoir une même moyenne mais présenter un étalement différent autour de cette valeur moyenne
Les indices de dispersion • Echelle nominale (l’entropie) • Echelle ordinale l’espace interquartile • Echelle intervalle l’écart-type
Pour les échelles nominales • S’il existe un indice de dispersion approprié à une échelle nominale (l’entropie), dans la pratique, il est rarement calculé et utilisé • Une distribution d’une variable caractérisée par des effectifs égaux dans toutes les classes sera considérée comme peu homogène, fort dispersée • Une distribution où une des modalités reçoit tout l’effectif de l’échantillon sera définie comme très homogène, non dispersée
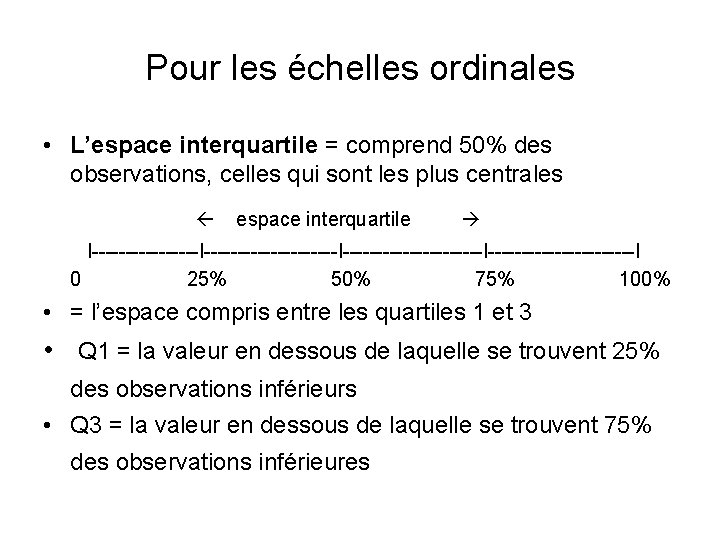
Pour les échelles ordinales • L’espace interquartile = comprend 50% des observations, celles qui sont les plus centrales espace interquartile I--------------------I----------------------I 0 25% 50% 75% 100% • = l’espace compris entre les quartiles 1 et 3 • Q 1 = la valeur en dessous de laquelle se trouvent 25% des observations inférieurs • Q 3 = la valeur en dessous de laquelle se trouvent 75% des observations inférieures
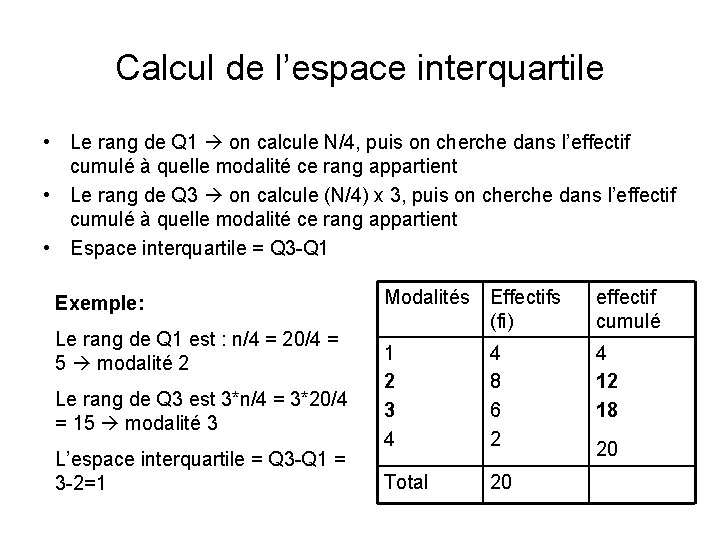
Calcul de l’espace interquartile • Le rang de Q 1 on calcule N/4, puis on cherche dans l’effectif cumulé à quelle modalité ce rang appartient • Le rang de Q 3 on calcule (N/4) x 3, puis on cherche dans l’effectif cumulé à quelle modalité ce rang appartient • Espace interquartile = Q 3 -Q 1 Exemple: Le rang de Q 1 est : n/4 = 20/4 = 5 modalité 2 Le rang de Q 3 est 3*n/4 = 3*20/4 = 15 modalité 3 L’espace interquartile = Q 3 -Q 1 = 3 -2=1 Modalités Effectifs (fi) effectif cumulé 1 2 3 4 4 8 6 2 4 12 18 Total 20 20
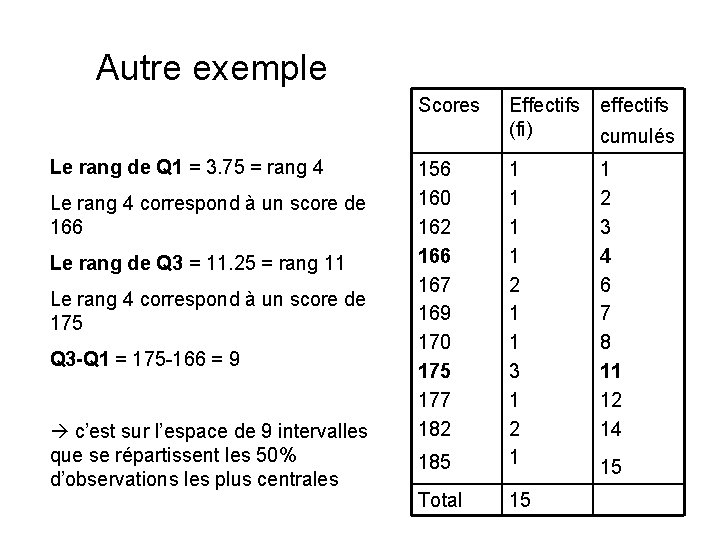
Autre exemple Le rang de Q 1 = 3. 75 = rang 4 Le rang 4 correspond à un score de 166 Le rang de Q 3 = 11. 25 = rang 11 Le rang 4 correspond à un score de 175 Q 3 -Q 1 = 175 -166 = 9 c’est sur l’espace de 9 intervalles que se répartissent les 50% d’observations les plus centrales Scores Effectifs effectifs (fi) cumulés 156 160 162 166 167 169 170 175 177 182 185 1 1 2 1 1 3 1 2 1 Total 15 1 2 3 4 6 7 8 11 12 14 15
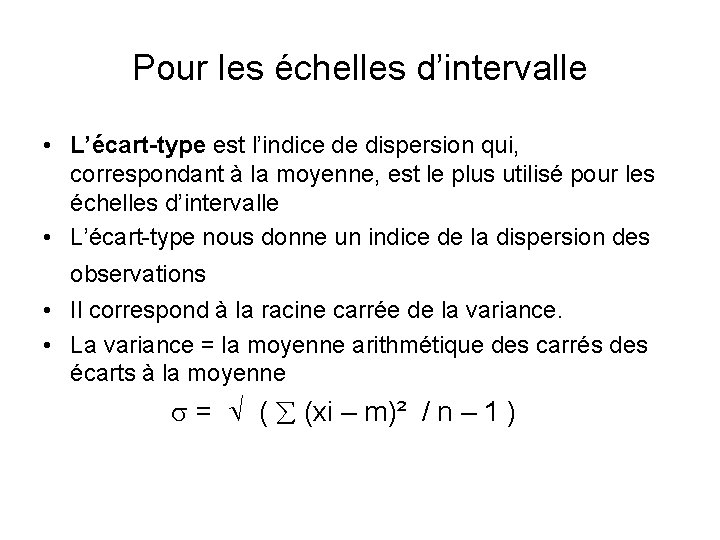
Pour les échelles d’intervalle • L’écart-type est l’indice de dispersion qui, correspondant à la moyenne, est le plus utilisé pour les échelles d’intervalle • L’écart-type nous donne un indice de la dispersion des observations • Il correspond à la racine carrée de la variance. • La variance = la moyenne arithmétique des carrés des écarts à la moyenne = ( (xi – m)² / n – 1 )
L’écart-type • Il sert à caractériser l’écart plus ou moins grand de l’ensemble des valeurs par rapport à la valeur moyenne – Si la dispersion est faible, cela signifie que les résultats sont groupés autour de la moyenne. – Si la dispersion est forte, cela signifie que les résultats sont fort dispersés autour de la moyenne. • Remarque : l’écart-type est différent de l’étendue. L’étendue est la différence entre la plus grande et la plus petite de s valeurs observées
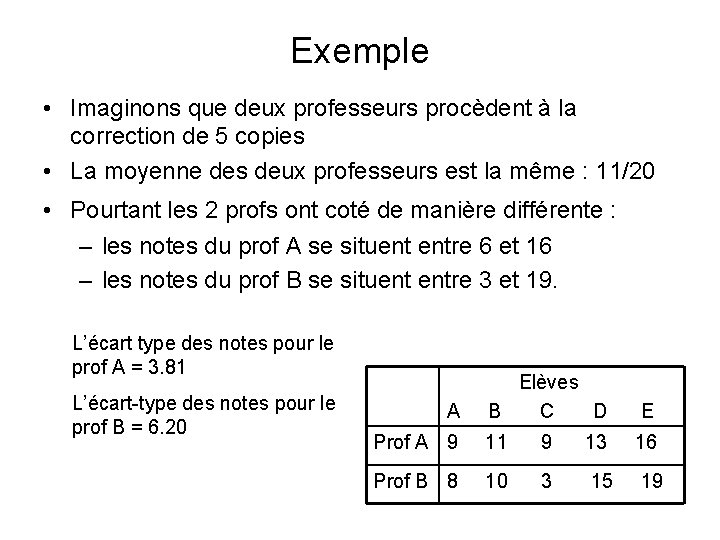
Exemple • Imaginons que deux professeurs procèdent à la correction de 5 copies • La moyenne des deux professeurs est la même : 11/20 • Pourtant les 2 profs ont coté de manière différente : – les notes du prof A se situent entre 6 et 16 – les notes du prof B se situent entre 3 et 19. L’écart type des notes pour le prof A = 3. 81 L’écart-type des notes pour le prof B = 6. 20 Elèves A B C D E Prof A 9 11 9 13 16 Prof B 8 10 3 15 19
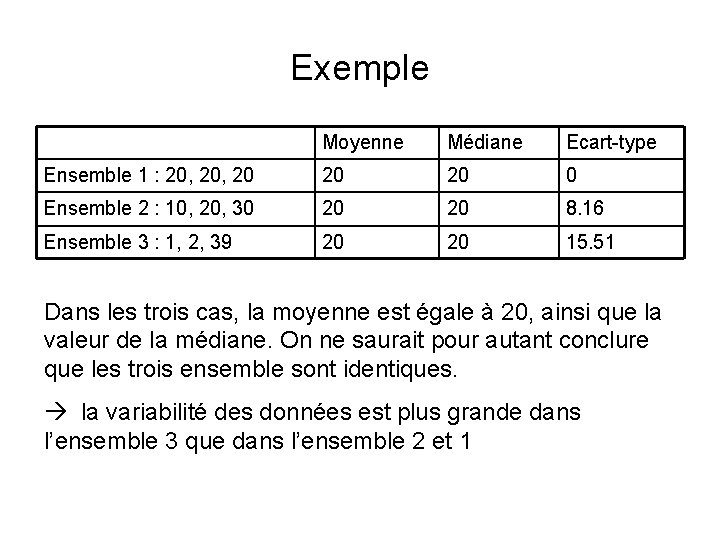
Exemple Moyenne Médiane Ecart-type Ensemble 1 : 20, 20 20 0 Ensemble 2 : 10, 20, 30 20 20 8. 16 Ensemble 3 : 1, 2, 39 20 20 15. 51 Dans les trois cas, la moyenne est égale à 20, ainsi que la valeur de la médiane. On ne saurait pour autant conclure que les trois ensemble sont identiques. la variabilité des données est plus grande dans l’ensemble 3 que dans l’ensemble 2 et 1
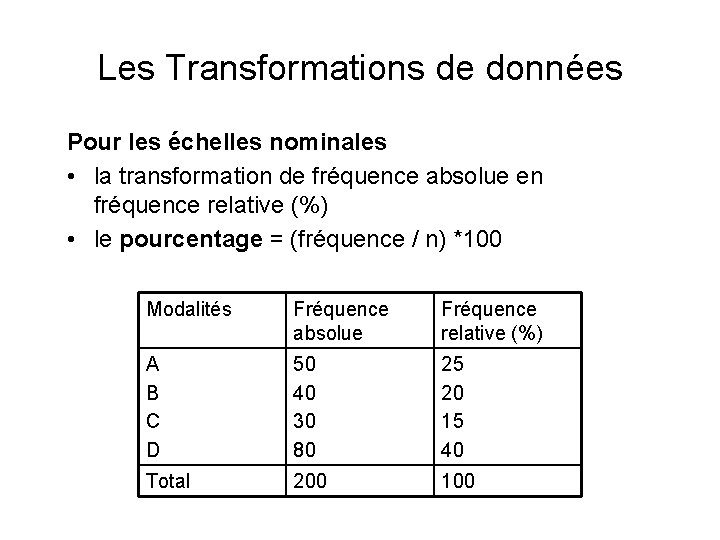
Les Transformations de données Pour les échelles nominales • la transformation de fréquence absolue en fréquence relative (%) • le pourcentage = (fréquence / n) *100 Modalités Fréquence absolue Fréquence relative (%) A B C D 50 40 30 80 25 20 15 40 Total 200 100
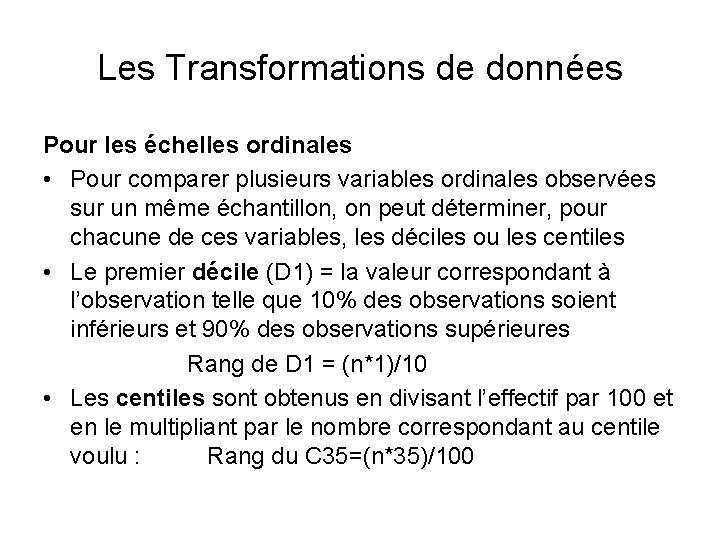
Les Transformations de données Pour les échelles ordinales • Pour comparer plusieurs variables ordinales observées sur un même échantillon, on peut déterminer, pour chacune de ces variables, les déciles ou les centiles • Le premier décile (D 1) = la valeur correspondant à l’observation telle que 10% des observations soient inférieurs et 90% des observations supérieures Rang de D 1 = (n*1)/10 • Les centiles sont obtenus en divisant l’effectif par 100 et en le multipliant par le nombre correspondant au centile voulu : Rang du C 35=(n*35)/100
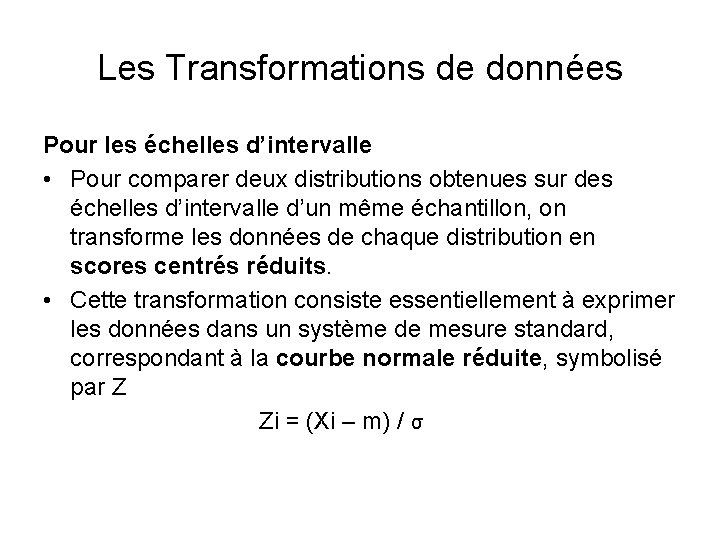
Les Transformations de données Pour les échelles d’intervalle • Pour comparer deux distributions obtenues sur des échelles d’intervalle d’un même échantillon, on transforme les données de chaque distribution en scores centrés réduits. • Cette transformation consiste essentiellement à exprimer les données dans un système de mesure standard, correspondant à la courbe normale réduite, symbolisé par Z Zi = (Xi – m) / σ
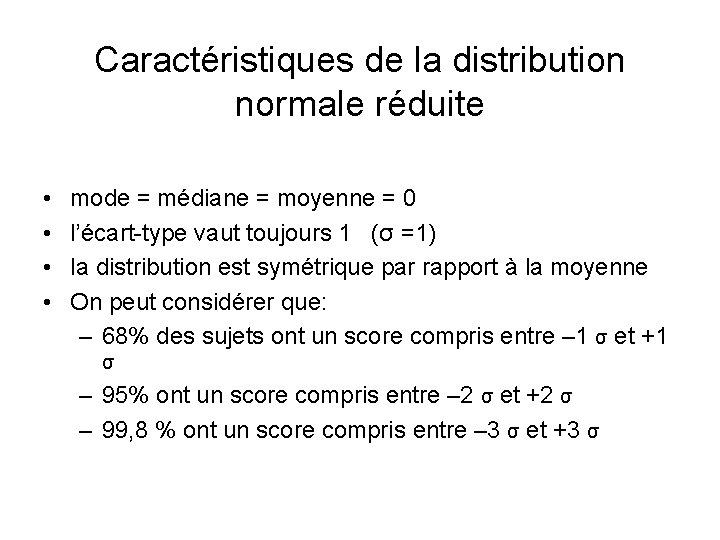
Caractéristiques de la distribution normale réduite • • mode = médiane = moyenne = 0 l’écart-type vaut toujours 1 (σ =1) la distribution est symétrique par rapport à la moyenne On peut considérer que: – 68% des sujets ont un score compris entre – 1 σ et +1 σ – 95% ont un score compris entre – 2 σ et +2 σ – 99, 8 % ont un score compris entre – 3 σ et +3 σ
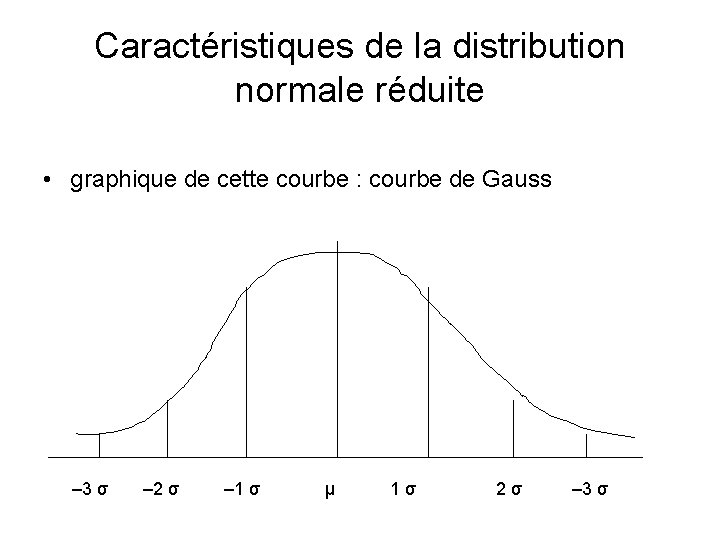
Caractéristiques de la distribution normale réduite • graphique de cette courbe : courbe de Gauss – 3 σ – 2 σ – 1 σ µ 1 σ 2 σ – 3 σ
Les représentations graphiques • le graphique à barres (histogramme) – pour les échelles nominales, ordinales et d’intervalle • le diagramme circulaire (pie, tarte) – pour les échelles nominales et ordinales • la ligne brisée des fréquences – pour les échelles ordinales et d’intervalle
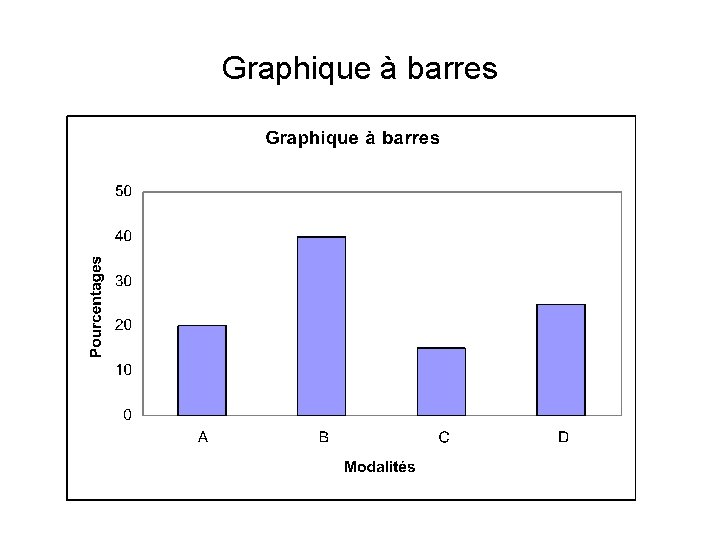
Graphique à barres
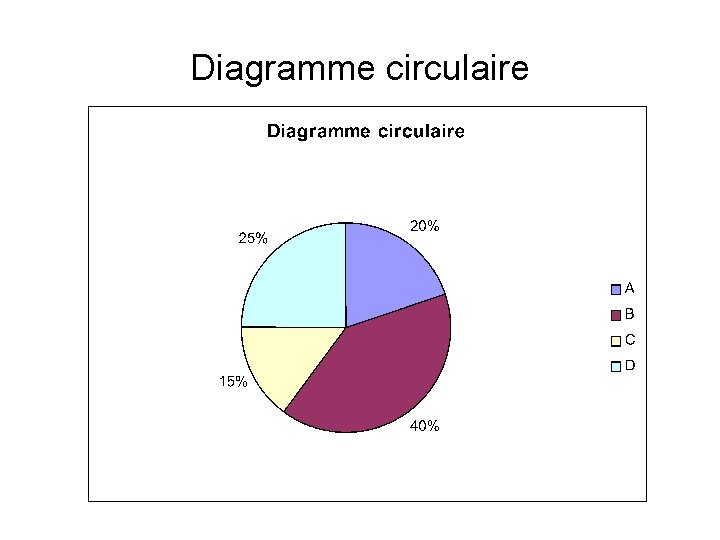
Diagramme circulaire
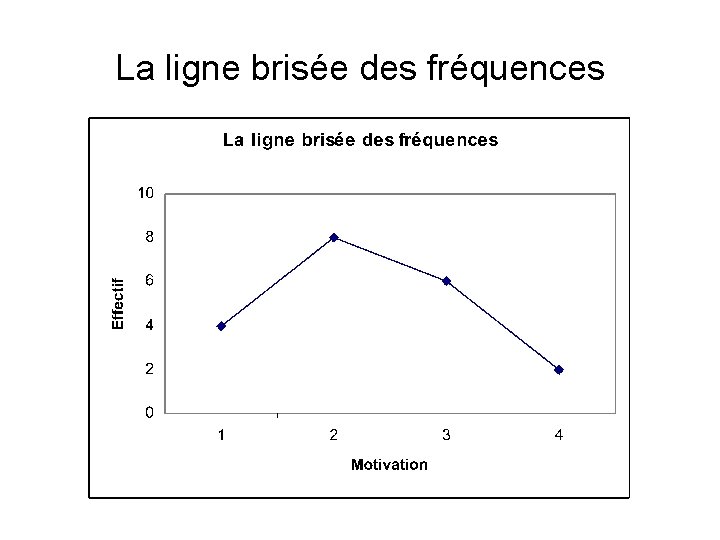
La ligne brisée des fréquences
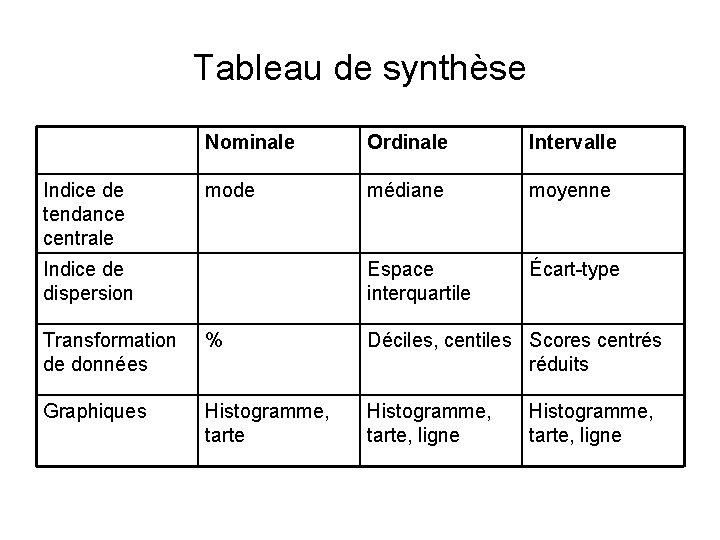
Tableau de synthèse Indice de tendance centrale Nominale Ordinale Intervalle mode médiane moyenne Espace interquartile Écart-type Indice de dispersion Transformation de données % Déciles, centiles Scores centrés réduits Graphiques Histogramme, tarte, ligne
Techniques spécifiques • Quelques techniques souvent utilisées en statistiques descriptives … • Uniquement dans le cas des échelles d’intervalle ! • • Les taux de croissance Les indices Les tableaux et figures Les transformations de données
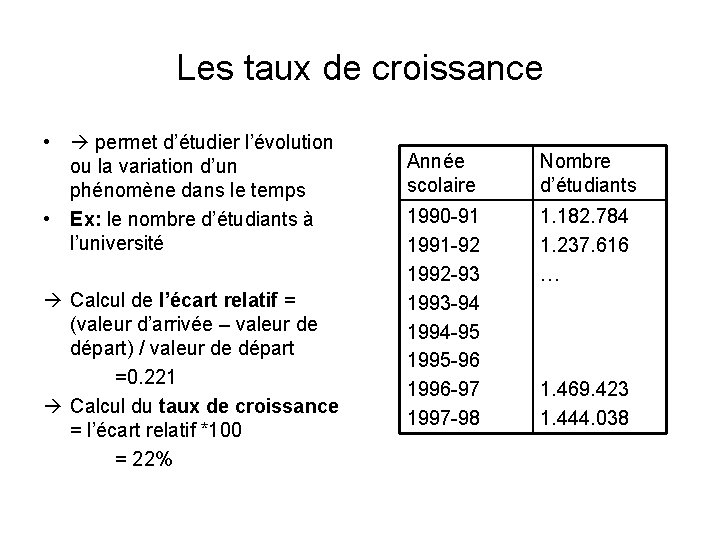
Les taux de croissance • permet d’étudier l’évolution ou la variation d’un phénomène dans le temps • Ex: le nombre d’étudiants à l’université Calcul de l’écart relatif = (valeur d’arrivée – valeur de départ) / valeur de départ =0. 221 Calcul du taux de croissance = l’écart relatif *100 = 22% Année scolaire Nombre d’étudiants 1990 -91 1991 -92 1992 -93 1993 -94 1994 -95 1995 -96 1996 -97 1997 -98 1. 182. 784 1. 237. 616 … 1. 469. 423 1. 444. 038
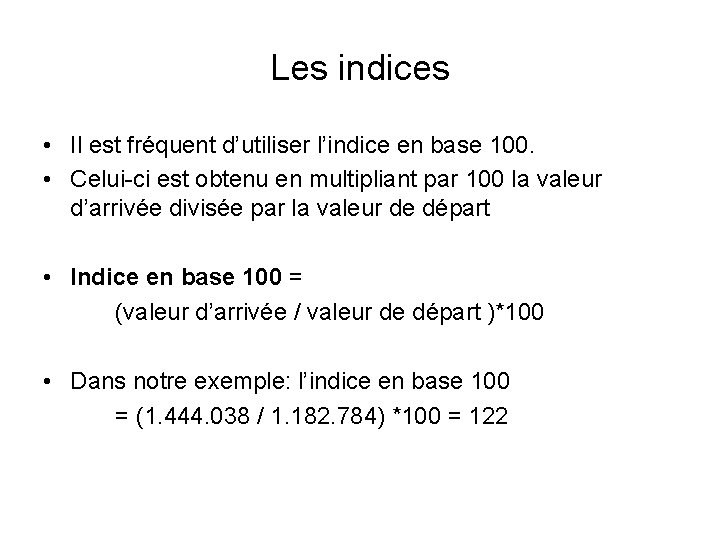
Les indices • Il est fréquent d’utiliser l’indice en base 100. • Celui-ci est obtenu en multipliant par 100 la valeur d’arrivée divisée par la valeur de départ • Indice en base 100 = (valeur d’arrivée / valeur de départ )*100 • Dans notre exemple: l’indice en base 100 = (1. 444. 038 / 1. 182. 784) *100 = 122
Les tableaux et figures Pour les tableaux, figures, etc. : • Une légende permet de préciser les différentes variables et leurs modalités respectives • En dessous, indiquer les sources données recueillies (ONSS, FOREM, …) • Préciser les caractéristiques essentielles de la population concernée • Un titre clair
Les transformations de données 1) proportion et pourcentage • Ex: dans un échantillon, le nombre d’hommes = 20 • en valeur relative, les hommes représentent donc 2/5 de l’échantillon (20/50) • soit 40% 2) Taux, parts, coefficients • = proportions sous d’autres noms • Ex: taux de scolarité 3) Les rapports à une donnée extérieure • on rapport la partie à une donnée extérieure • Ex: ratio financier, densité de population, rendement
- Slides: 39