
Maschinelles Lernen Hidden Markov Modelle HMM Rabiner Tutorial
Maschinelles Lernen Hidden Markov Modelle (HMM) (Rabiner Tutorial)
Grundidee • Finde zu einer Beobachtung (Serie von Beobachtungen) die zugrundeliegende „Struktur“ • Basis: stochastisches Modell basierend auf Markov-Ketten (jedes Ereignis ist nur von seinem Vorgänger abhängig) • Anwendungen: – Spracherkennung – Tagging • Ziehen von bunten Kugeln aus verschiedenen Urnen hinter einer Wand
Geschichte • benannt nach Andrei A. Markov (1856 1922) ihrem Entwickler • Markov Modelle anfänglich für linguistische Zwecke • Modellieren von Buchstabensequenzen in der russischen Literatur (1913) • später Entwicklung als allgemeines statistisches Werkzeug
Markov-Ketten • Sequenz von Zufallsvariablen X = (X 1, . . . , XT) – Xt+1 hängt ab vom Wert von Xt – X 1, . . . , Xt-1 braucht man nicht zu kennen • Beispiel: Zufallsvariable misst Anzahl der Bücher einer Bibliothek – Um „Anzahl der Bücher morgen“ vorhersagen zu können, genügt es „Anzahl der Bücher heute“ zu kennen. – Die Anzahl der Bücher der letzten Woche oder sogar der letzten Jahre benötigt man für die Vorhersage nicht.
Definitionen • Stochastischer Prozess: – Ein stochstischer Prozess oder Zufallsprozess ist eine Folge von elementaren Zufallsereignissen • Zustände: – Die möglichen Zufallswerte in einem stochastischen Prozess heißen Zustände des Prozesses. Man sagt, dass sich der Prozess zum Zeitpunkt t in Zustand Xt=St befindet.
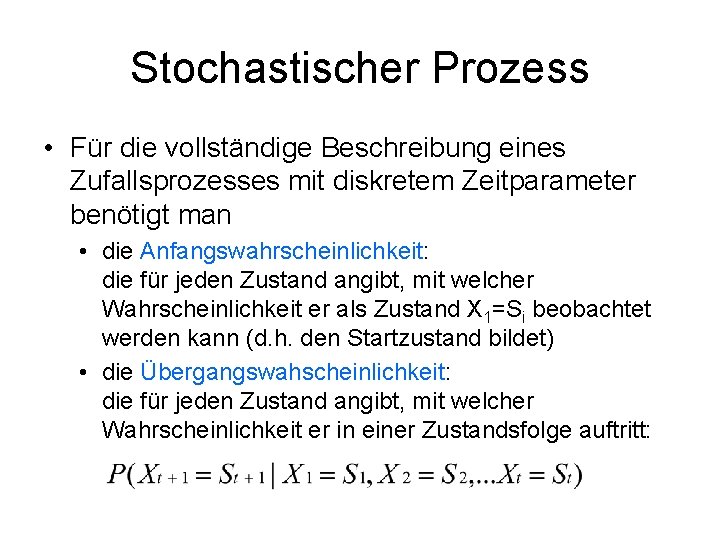
Stochastischer Prozess • Für die vollständige Beschreibung eines Zufallsprozesses mit diskretem Zeitparameter benötigt man • die Anfangswahrscheinlichkeit: die für jeden Zustand angibt, mit welcher Wahrscheinlichkeit er als Zustand X 1=Si beobachtet werden kann (d. h. den Startzustand bildet) • die Übergangswahscheinlichkeit: die für jeden Zustand angibt, mit welcher Wahrscheinlichkeit er in einer Zustandsfolge auftritt:
Beispiel • Ein Textgenerator hat ein Lexikon mit Wörtern • von denen an jeder Position jedes auftreten kann Ω = {geschickt, werden, wir} • wir beobachten an jeder Position, welches Wort generiert wurde • Sei – X 1 das Wort zum ersten Beobachtungszeitpunkt – X 2 das Wort zum zweiten Beobachtungszeitpunkt, usw. • Dann ist die Folge der Wörter ein stochastischer Prozess mit diskreter Zufallsvariable und diskretem Zeitparameter
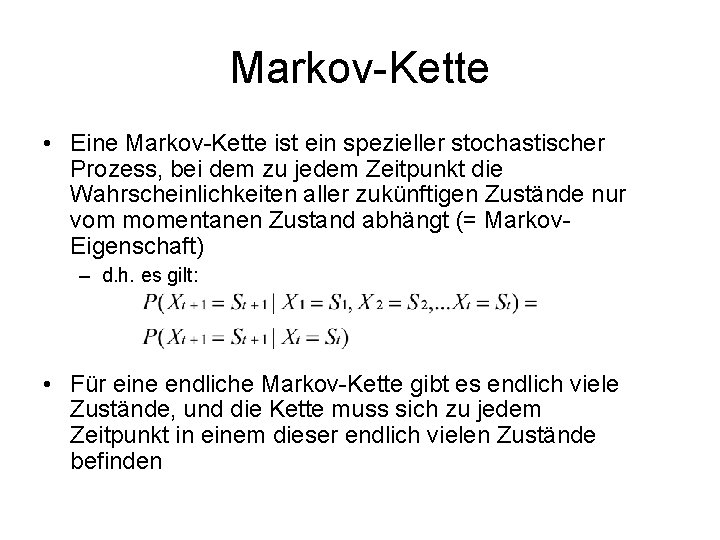
Markov-Kette • Eine Markov-Kette ist ein spezieller stochastischer Prozess, bei dem zu jedem Zeitpunkt die Wahrscheinlichkeiten aller zukünftigen Zustände nur vom momentanen Zustand abhängt (= Markov. Eigenschaft) – d. h. es gilt: • Für eine endliche Markov-Kette gibt es endlich viele Zustände, und die Kette muss sich zu jedem Zeitpunkt in einem dieser endlich vielen Zustände befinden
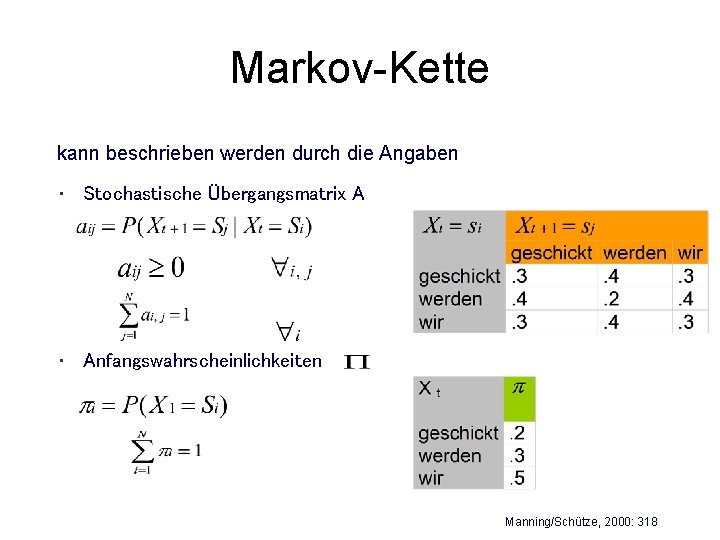
Markov-Kette kann beschrieben werden durch die Angaben • Stochastische Übergangsmatrix A • Anfangswahrscheinlichkeiten Manning/Schütze, 2000: 318
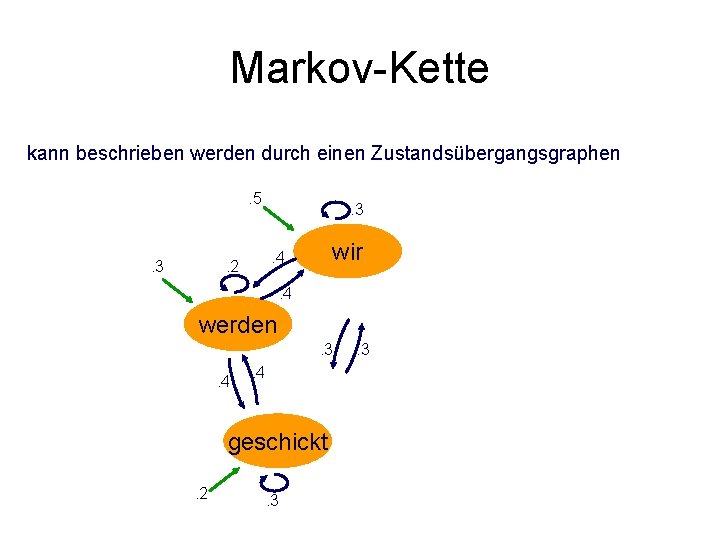
Markov-Kette kann beschrieben werden durch einen Zustandsübergangsgraphen. 5 . 3 wir . 4 . 2 . 4 werden. 3. 4 geschickt. 2 . 3
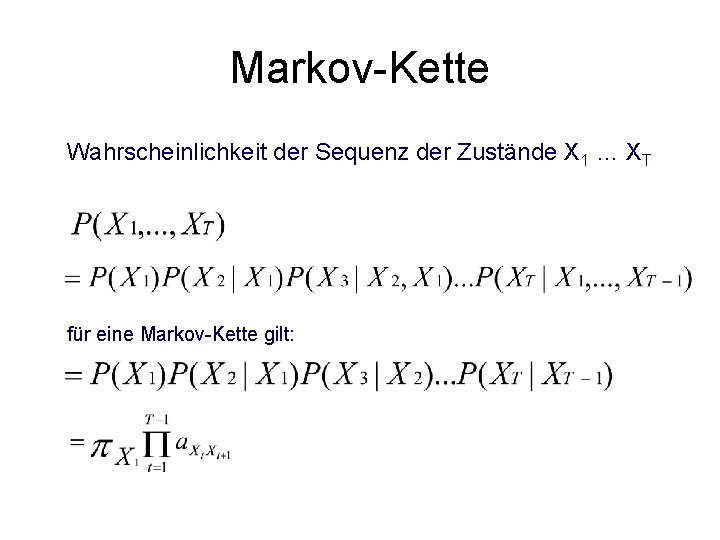
Markov-Kette Wahrscheinlichkeit der Sequenz der Zustände X 1 … XT für eine Markov-Kette gilt:
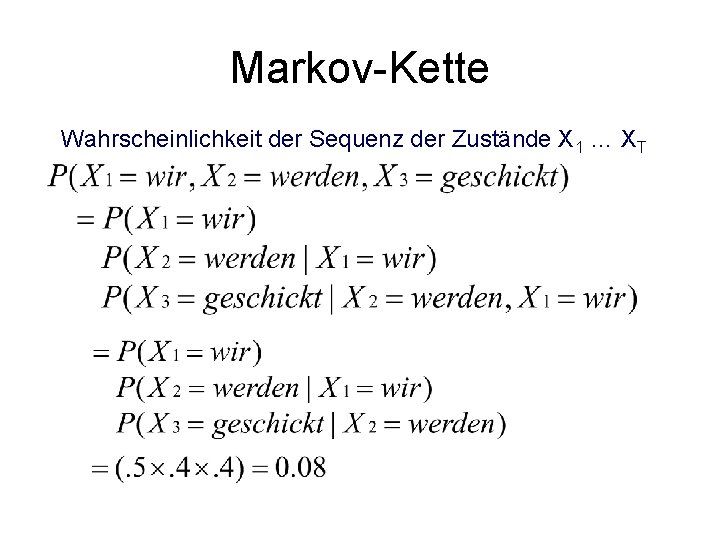
Markov-Kette Wahrscheinlichkeit der Sequenz der Zustände X 1 … XT
Markov-Modell (MM) • Ein Markov-Modell ordnet jedem Zustand (andere Variante: jedem Zustandsübergang) eine Ausgabe zu, die ausschließlich vom aktuellen Zustand (bzw. Zustandsübergang) abhängig ist • Ausgabe: Sequenz von Ereignissen, die Beobachtungen in der Beobachtungssequenz repräsentieren • Zur Unterscheidung auch Visible Markov Model (VMM) genannt
Hidden Markov Modell (HMM) • Konzept des Markov Models wird erweitert: – Beobachtung ist Wahrscheinlichkeitsfunktion des Zustandes • Emissionswahrscheinlichkeiten für Beobachtung werden benötigt – Wahrscheinlichkeit, dass zur Zeit t das Symbol k beobachtet wird, – unter der Vorraussetzung, dass das Model sich zur Zeit t im Zustand Si befindet und als nächstes (zum Zeitpunkt t + 1) in den Zustand Sj übergeht. • Ein Hidden Markov Model ist ein Markov-Modell – bei dem nur die Sequenz der Ausgaben beobachtbar ist, – die Sequenz der Zustände verborgen bleibt • Es kann mehrere Zustandssequenzen geben, dieselbe Ausgabe erzeugen
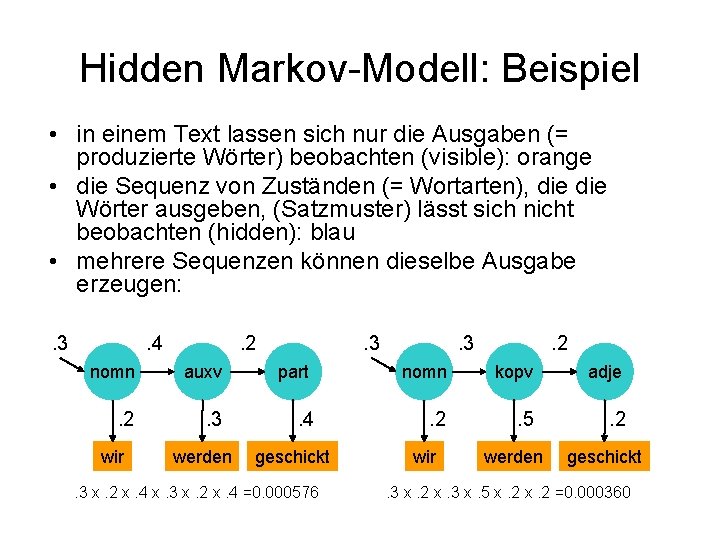
Hidden Markov-Modell: Beispiel • in einem Text lassen sich nur die Ausgaben (= produzierte Wörter) beobachten (visible): orange • die Sequenz von Zuständen (= Wortarten), die Wörter ausgeben, (Satzmuster) lässt sich nicht beobachten (hidden): blau • mehrere Sequenzen können dieselbe Ausgabe erzeugen: . 3 . 4 . 2 nomn auxv . 2 . 3 wir werden . 3 part . 4 geschickt . 3 x. 2 x. 4 x. 3 x. 2 x. 4 =0. 000576 . 3 . 2 nomn kopv adje . 2 . 5 . 2 wir werden geschickt . 3 x. 2 x. 3 x. 5 x. 2 =0. 000360
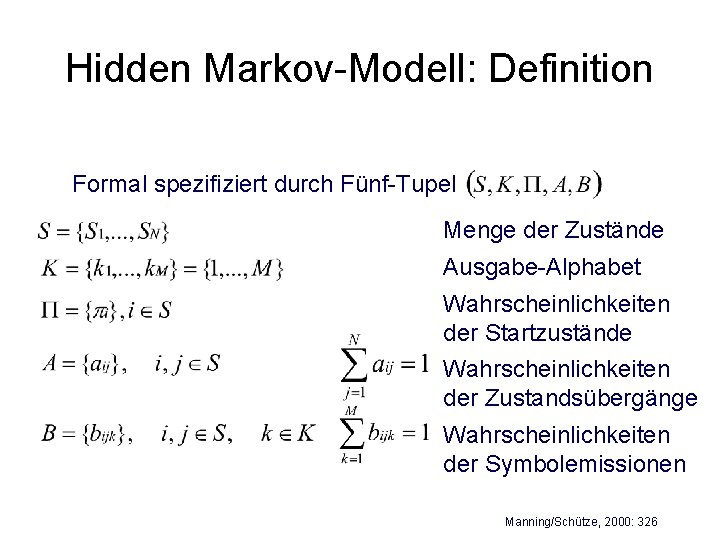
Hidden Markov-Modell: Definition Formal spezifiziert durch Fünf-Tupel Menge der Zustände Ausgabe-Alphabet Wahrscheinlichkeiten der Startzustände Wahrscheinlichkeiten der Zustandsübergänge Wahrscheinlichkeiten der Symbolemissionen Manning/Schütze, 2000: 326
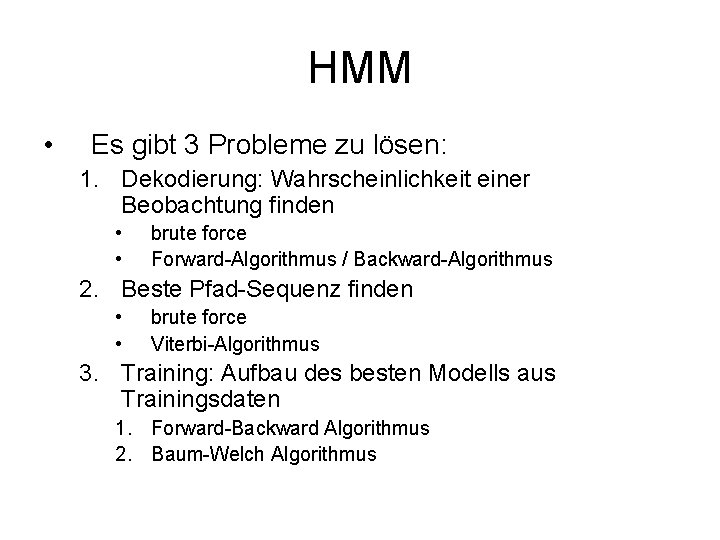
HMM • Es gibt 3 Probleme zu lösen: 1. Dekodierung: Wahrscheinlichkeit einer Beobachtung finden • • brute force Forward-Algorithmus / Backward-Algorithmus 2. Beste Pfad-Sequenz finden • • brute force Viterbi-Algorithmus 3. Training: Aufbau des besten Modells aus Trainingsdaten 1. Forward-Backward Algorithmus 2. Baum-Welch Algorithmus
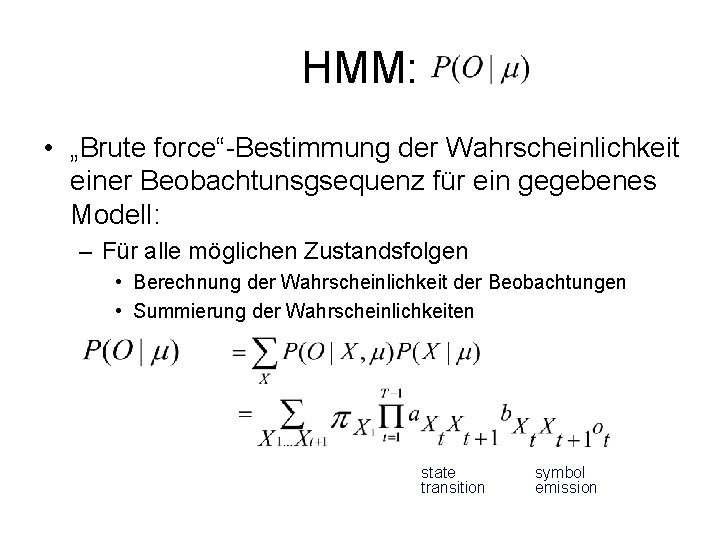
HMM: • „Brute force“-Bestimmung der Wahrscheinlichkeit einer Beobachtunsgsequenz für ein gegebenes Modell: – Für alle möglichen Zustandsfolgen • Berechnung der Wahrscheinlichkeit der Beobachtungen • Summierung der Wahrscheinlichkeiten state transition symbol emission
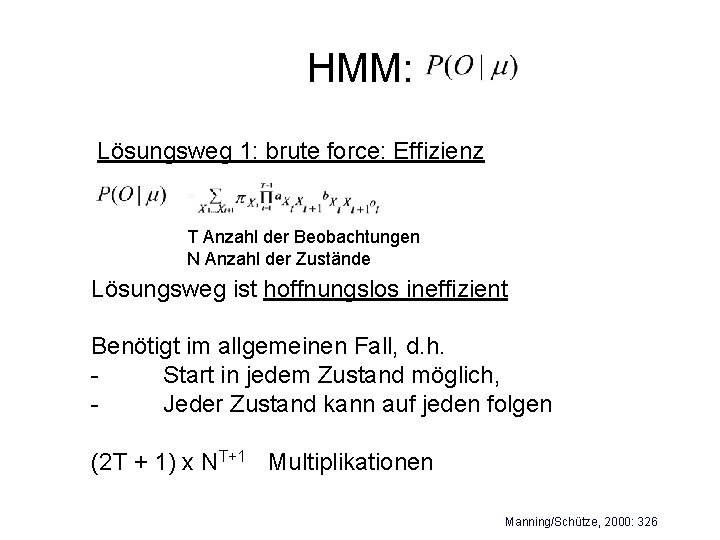
HMM: Lösungsweg 1: brute force: Effizienz T Anzahl der Beobachtungen N Anzahl der Zustände Lösungsweg ist hoffnungslos ineffizient Benötigt im allgemeinen Fall, d. h. Start in jedem Zustand möglich, Jeder Zustand kann auf jeden folgen (2 T + 1) x NT+1 Multiplikationen Manning/Schütze, 2000: 326
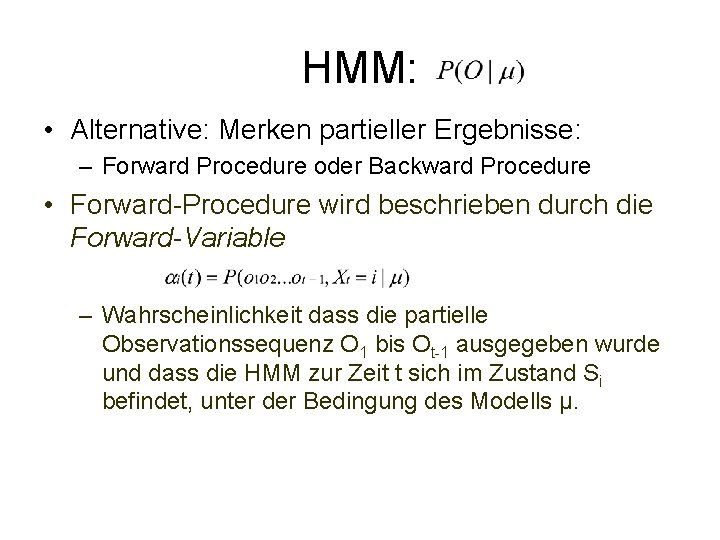
HMM: • Alternative: Merken partieller Ergebnisse: – Forward Procedure oder Backward Procedure • Forward-Procedure wird beschrieben durch die Forward-Variable – Wahrscheinlichkeit dass die partielle Observationssequenz O 1 bis Ot-1 ausgegeben wurde und dass die HMM zur Zeit t sich im Zustand Si befindet, unter der Bedingung des Modells μ.
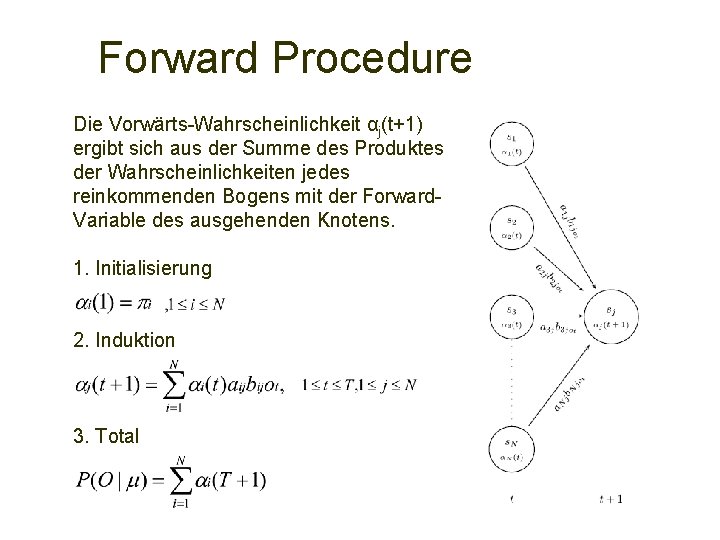
Forward Procedure Die Vorwärts-Wahrscheinlichkeit αj(t+1) ergibt sich aus der Summe des Produktes der Wahrscheinlichkeiten jedes reinkommenden Bogens mit der Forward. Variable des ausgehenden Knotens. 1. Initialisierung 2. Induktion 3. Total
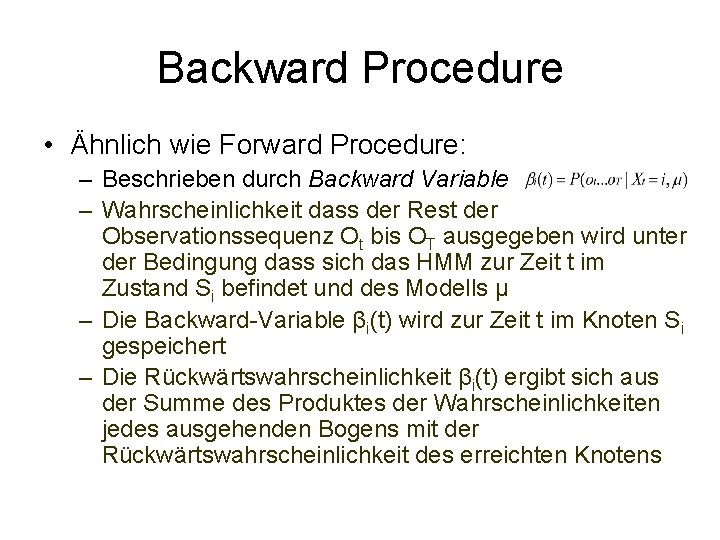
Backward Procedure • Ähnlich wie Forward Procedure: – Beschrieben durch Backward Variable – Wahrscheinlichkeit dass der Rest der Observationssequenz Ot bis OT ausgegeben wird unter der Bedingung dass sich das HMM zur Zeit t im Zustand Si befindet und des Modells μ – Die Backward-Variable βi(t) wird zur Zeit t im Knoten Si gespeichert – Die Rückwärtswahrscheinlichkeit βi(t) ergibt sich aus der Summe des Produktes der Wahrscheinlichkeiten jedes ausgehenden Bogens mit der Rückwärtswahrscheinlichkeit des erreichten Knotens
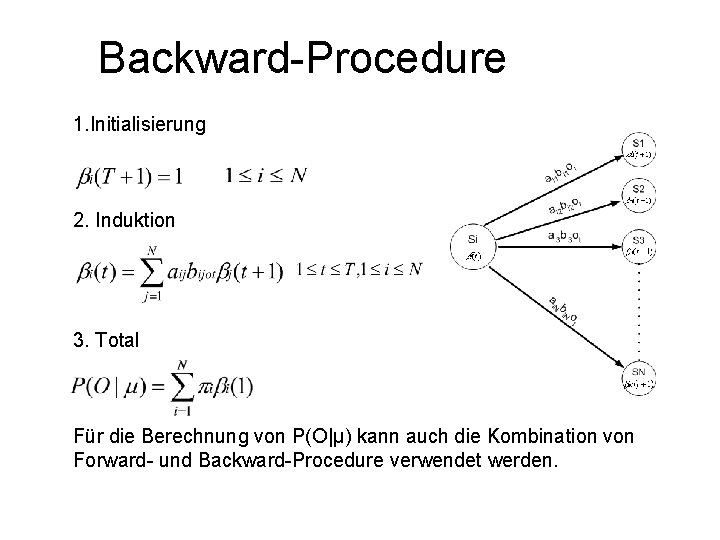
Backward-Procedure 1. Initialisierung 2. Induktion 3. Total Für die Berechnung von P(O|μ) kann auch die Kombination von Forward- und Backward-Procedure verwendet werden.
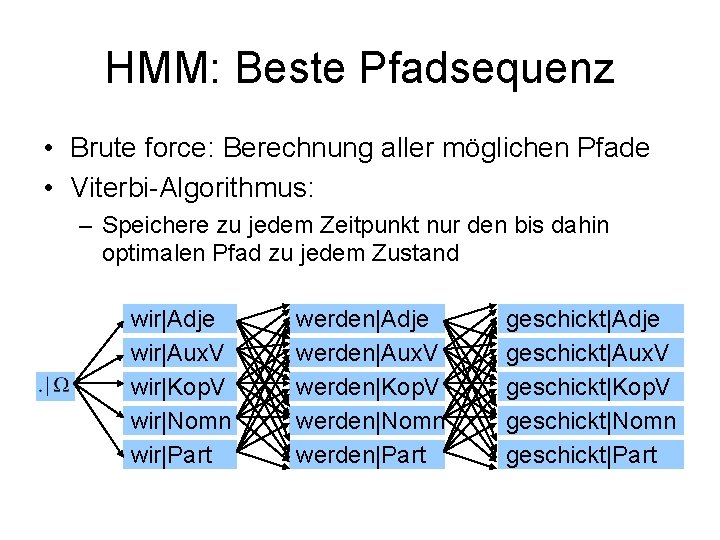
HMM: Beste Pfadsequenz • Brute force: Berechnung aller möglichen Pfade • Viterbi-Algorithmus: – Speichere zu jedem Zeitpunkt nur den bis dahin optimalen Pfad zu jedem Zustand wir|Adje wir|Aux. V wir|Kop. V wir|Nomn wir|Part werden|Adje werden|Aux. V werden|Kop. V werden|Nomn werden|Part geschickt|Adje geschickt|Aux. V geschickt|Kop. V geschickt|Nomn geschickt|Part
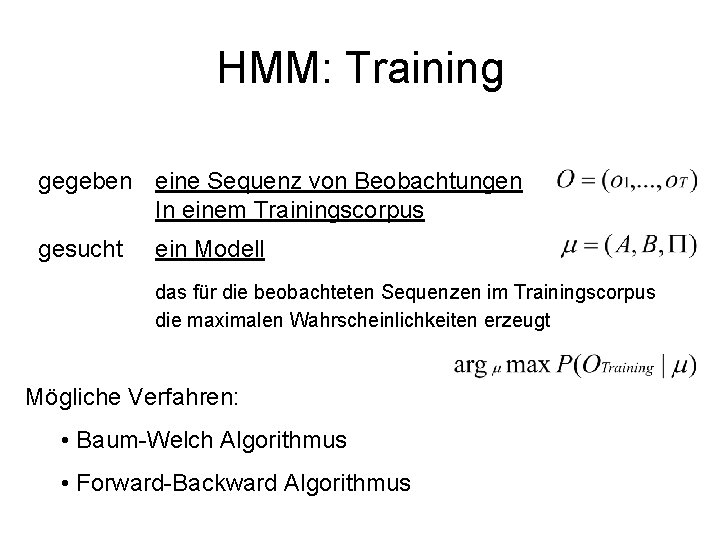
HMM: Training gegeben eine Sequenz von Beobachtungen In einem Trainingscorpus gesucht ein Modell das für die beobachteten Sequenzen im Trainingscorpus die maximalen Wahrscheinlichkeiten erzeugt Mögliche Verfahren: • Baum-Welch Algorithmus • Forward-Backward Algorithmus
Baum-Welch Algorithmus • Spezialfall des EM (Expectation Maximization) Algorithmus • Iterativer Algorithmus: versucht ein beliebig gewähltes Start-Modell 0 hinsichtlich OTraining zu optimieren – Mittels Berechnungen herausfinden, welche Transitionen und Symbolemissionen bei Ausgabesequenz O wahrscheinlich am häufigsten genutzt werden. – Erhalten eines überarbeiteten Models μ´ durch Erhöhen dieser Wahrscheinlichkeiten
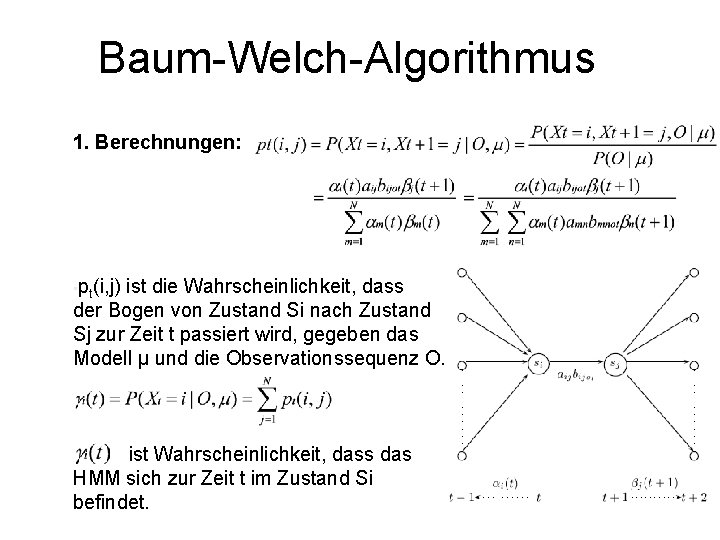
Baum-Welch-Algorithmus 1. Berechnungen: • pt(i, j) ist die Wahrscheinlichkeit, dass der Bogen von Zustand Si nach Zustand Sj zur Zeit t passiert wird, gegeben das Modell μ und die Observationssequenz O. ist Wahrscheinlichkeit, dass das HMM sich zur Zeit t im Zustand Si befindet.
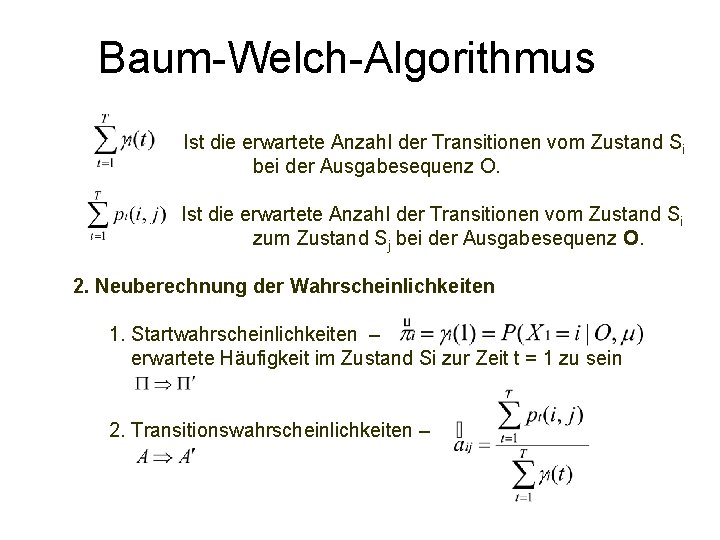
Baum-Welch-Algorithmus Ist die erwartete Anzahl der Transitionen vom Zustand Si bei der Ausgabesequenz O. Ist die erwartete Anzahl der Transitionen vom Zustand Si zum Zustand Sj bei der Ausgabesequenz O. 2. Neuberechnung der Wahrscheinlichkeiten 1. Startwahrscheinlichkeiten – erwartete Häufigkeit im Zustand Si zur Zeit t = 1 zu sein 2. Transitionswahrscheinlichkeiten –
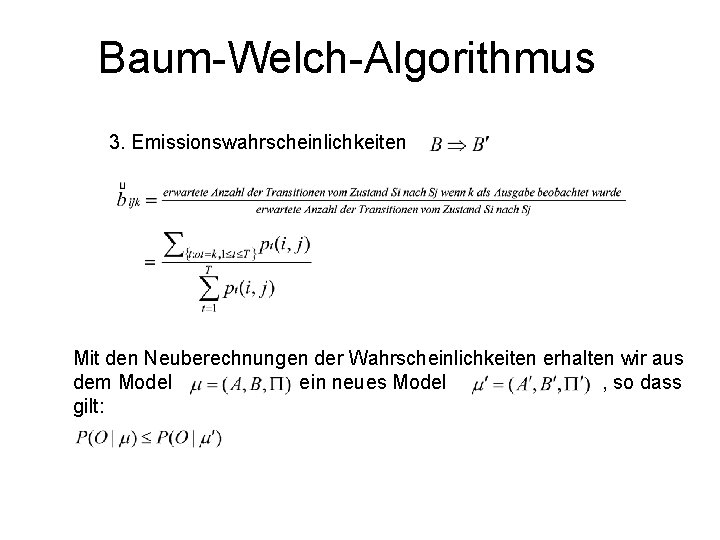
Baum-Welch-Algorithmus 3. Emissionswahrscheinlichkeiten Mit den Neuberechnungen der Wahrscheinlichkeiten erhalten wir aus dem Model ein neues Model , so dass gilt:
Baum-Welch-Algorithmus Die Iteration erfolgt solange, bis keine signifikante Verbesserung der Ergebnisse mehr sichtbar ist. • Der Baum-Welch-Algorithmus garantiert nicht, dass das beste Modell gefunden wird, da der Prozess in einem lokalen Maximum stecken bleiben kann (z. B. Sattelpunkt). • • Baum-Welch-Algorithmus ist dennoch effektiv für HMMs. Für das Finden des globalen Maximums sollten die Parameter des Ausgangs HMMs in der Region nahe des globalen Maximums liegen. • Anfängliches Abschätzen der Werte ist besser als zufälliges Wählen. Schätzen von B ist dabei wichtig. Zufälliges Wählen von A und Π ist ausreichend. •
Beziehung zu Bayes • Vermeidung der Unabhängigkeitsannahme: – Interpretiere Abhängigkeiten der Features als Übergangswahrscheinlichkeiten der Zustände – Features entsprechen Zuständen • Bayesian (Belief) Network!
- Slides: 31