
Marcel Riedel Marcus Zelend Danny Christl Aufgabenstellung Recherche
Marcel Riedel, Marcus Zelend, Danny Christl
Aufgabenstellung • Recherche von Tools für einen massiv-parallelen Clusterrechner
Was ist ein Cluster? • Vernetzung mehrerer Einzelrechner • Knoten meist über schnelles Netz verbunden • erscheinen in vielen Fällen nach außen als einziger Rechner • Zweck des Clusterings: – Erhöhung der Rechenkapazität – Erhöhung der Verfügbarkeit
Homogene vs. heterogene Cluster • Homogene Cluster: – gleiche Hardware – gleiches Betriebssystem auf allen Knoten • Heterogene Cluster: – Es kommen Knoten mit unterschiedlicher Hardware und/oder unterschiedlichen Betriebssystemen zum Einsatz
Begriffe: MPI • „Message Passing Interface“ – Programmierschnittstelle für den Nachrichtenaustausch zwischen Knoten eines verteilten Systems – mehrere Prozesse arbeiten an einem Problem und schicken sich dabei gegenseitig Nachrichten – Nachrichtenaustausch z. B. über TCP oder gemeinsamen Hauptspeicher – Implementierungen z. B. in C++, Java, Python
Begriffe: SMP • „Symmetric Multi. Processing“ – Multiprozessor-Computerarchitektur – 2 oder mehrere identische CPUs teilen sich gemeinsamen Hauptspeicher – für massiv-parallele Cluster ungeeignet – andere Multiprozessorarchitekturen: • NUMA (Non-Uniform Memory Access) • ASMP (Asymmetric Multiprocessing)
Begriffe: SSI • „Single System Image“
High Performance Computing Cluster • Hohe Rechenleistung durch gemeinsame, parallele Verarbeitung zu verarbeitender Jobs durch die Knoten • Rechenleistung des Clusters = Summe der Leistung der einzelnen Knoten • Schnellster Cluster: BCN Supercomputer-Center, Spanien 10240 Knoten bringen 62, 6 TFLOPS
High Performance Computing Cluster • Verwendung: – Berechnung, Modellierung und Simulation komplexer Systeme z. B. Wettervorhersage, Klimamodelle – Verarbeitung riesiger Messdatenmengen – Erstellung komplexer 3 D-Modelle und Animationsfilme
Hardwarekonzept • Homogener Knotenaufbau • Ein Master-Node und beliebig viele Compute-Nodes • Distributed Memory-Architektur • Einzelnen Knoten enthalten nur essentielle Komponenten • Vernetzung über Hochgeschwindigkeitsnetz z. B. Inifiniband
Softwarekonzept • Als OS fast ausschließlich Linux im HPC-Bereich • Dateisystem – NFS für kleine und mittlere Cluster – CXFS, Lustre, Polyserve für große Cluster • Boot-From-LAN-Konzept für Compute-Nodes • Clustertools übernehmen Verwaltung
Softwarekonzept • Clustertools übernehmen Verwaltung – Power-Management – Automatische Suche nach neuen Knoten – Job-Management, Batch-Queue-System – MPI-Implementierung
Funktionsweise • Dekomposition: Zerlegung komplexer Aufgaben in Teilaufgaben • Job-Management-System auf Master -Node erledigt Zuteilung und Queueing der Teilaufgaben für die Compute-Nodes • Abarbeitung der Teilaufgaben auf den Compute-Nodes • Zusammenfügen der Ergebnisse auf dem Master-Node • Kommunikation zwischen den einzelnen Knoten erfolgt über MPI
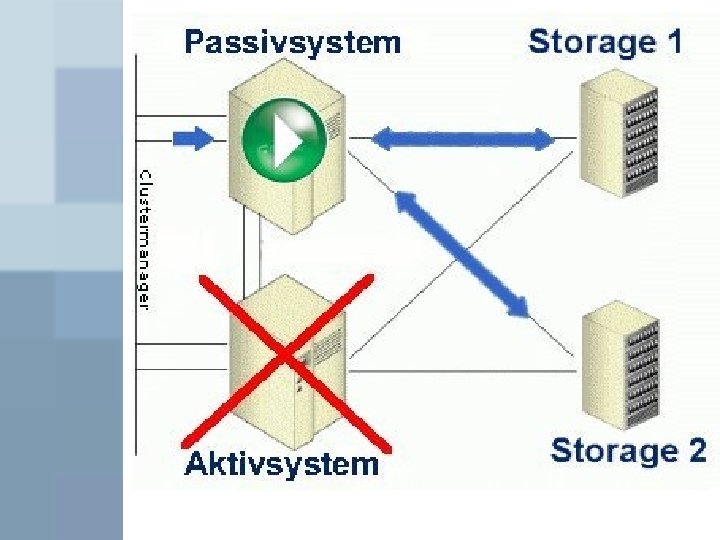
Hochverfügbarkeitscluster (HA-Cluster) • Stellen ständig Daten und Dienste zur Verfügung • 2 Arten: Aktiv-/Aktiv-Cluster Aktiv-/Passiv-Cluster • Festplatten – und Serverausfälle minimieren • Zusätzliche Rechner im System • Keine Verringerung der Systemleistung, dafür hohe Kosten und etwas längere Ausfallzeit
• Verwendung in Servern, gekoppelt mit einem NAS (Network Attached Storage ), die Dienste (Web-, Datenbank-, FTP- und Mail-Server ) • Ausfall Internetpräsenz bedeutet: hoher wirtschaftlicher Schaden und Imageverlust
Aktiv-/ Passiv-Cluster • Ersatzknoten ohne Funktion (Stand. By) • Bei Ausfall: Deaktivierung des Hauptsystems (Reparatur) und Aktivierung des Ersatzsystems • Clustermanager verteilt Aufgaben neu
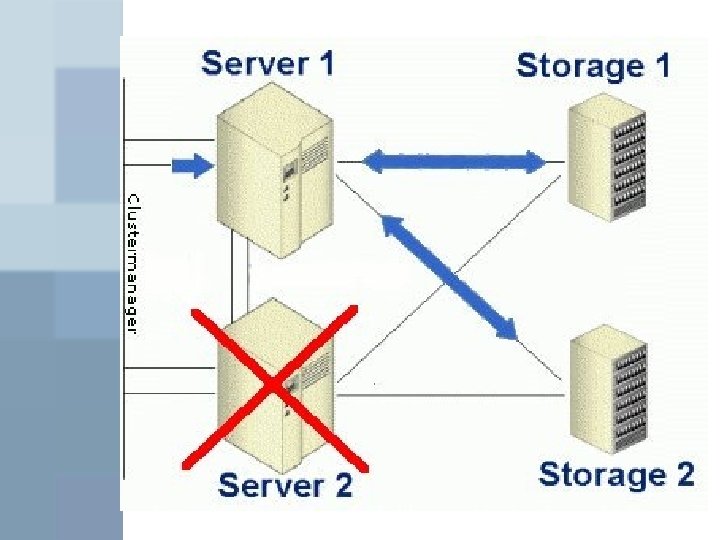
Aktiv-/ Aktiv-Cluster • Alle Knoten teilen sich Aufgabe • Bei Ausfall: Entfernen des defekten Rechners logisch aus dem System • Restliche Knoten teilen sich die Aufgaben des Ausfallrechners, gesteuert durch den Clustermanager (evtl. Neustarten der Prozesse) • Verringerung der Systemleistung, aber sehr kleine Ausfallzeit
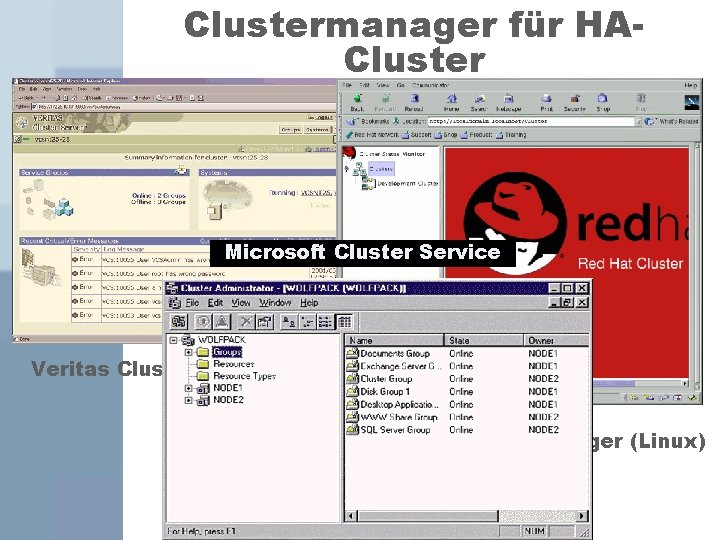
Clustermanager für HACluster Microsoft Cluster Service Veritas Cluster Manager Red Hat Cluster Manager (Linux)
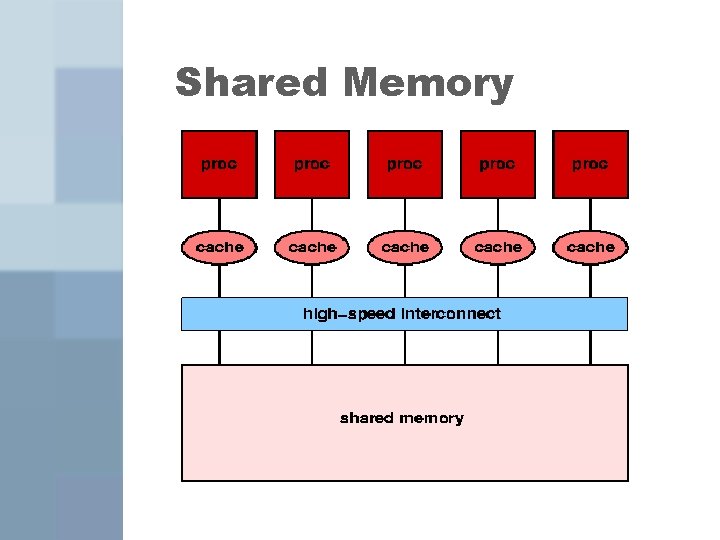
Shared Memory
Shared Memory • Alle Knoten greifen auf gemeinsamen Speicher zu • Verbindungsnetz stellt nötige Protokolle für gleichzeitigen Speicherzugriff verschiedener Knoten bereit • Zugriffsweise aller Knoten ist identisch Latenzzeit stets gleich • Verbindungsnetzwerk wird Flaschenhals bei hoher Knotenzahl • Kann über PVM als ein großer Parallelrechner angesprochen werden
Verwendung von Shared Memory • Verwendung der Shared Memory Architektur bei: – Cluster mit geringer Knotenzahl – Aufgaben mit geringem Datenaufkommen – Programmen, deren Parallelisierung zu aufwändig ist
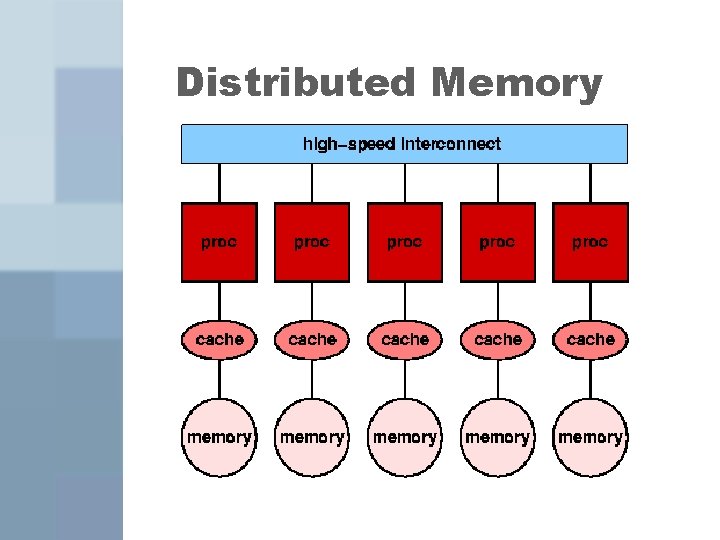
Distributed Memory
Distributed Memory • Jeder Knoten besitzt eigenen Arbeitsspeicher • Kein Zugriff auf „fremden“ Speicher Informationsaustausch über Nachrichten über MPI • Nachteil: erhöhter Programmieraufwand, da explizites Ansprechen und Verwaltung der verteilten Ressourcen notwendig
Verwendung von Distributed Memory • Verwendung der Distributed Memory Architektur bei: – Cluster mit hoher Knotenzahl – Aufgaben mit hohem Datenaufkommen – Parallelisierte Programme bereits vorhanden bzw. Neuentwicklung
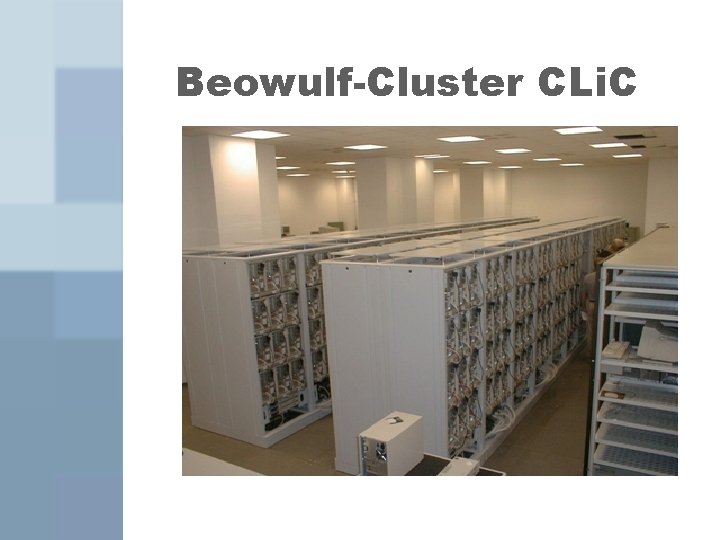
Beowulf-Cluster • HPC-Cluster mit folgenden Eigenschaften: – Knoten sind einfache vernetzte Desktop-PCs – Kommunikation über TCP/IP – Betriebssystem: Linux / BSD
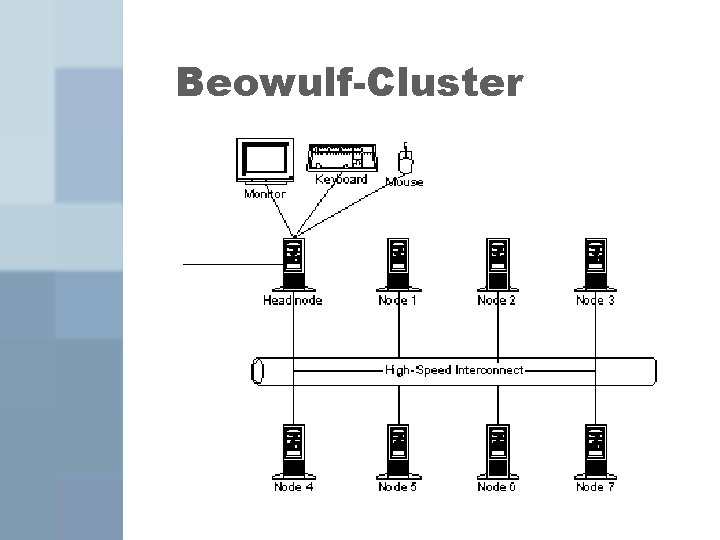
Beowulf-Cluster
Vor- und Nachteile von Beowulf-Cluster • Vorteile: – Problemlose Skalierbarkeit – Lösen komplexer Aufgaben mit billiger COTS-Hardware – Austausch defekter Rechnerknoten im laufenden Betrieb möglich • Nachteile: – Hoher Platzbedarf – Hoher Energieverbrauch – Hohe Wärmeentwicklung
Beowulf-Cluster CLi. C
Open. Mosix (Cluster. Knoppix)
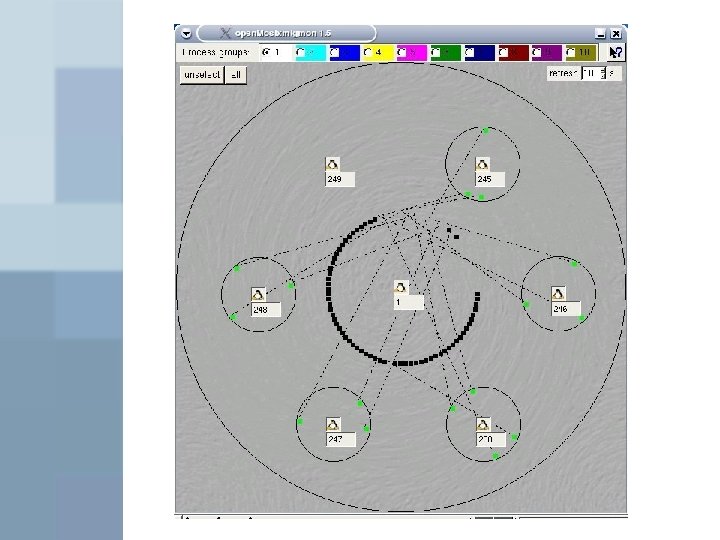
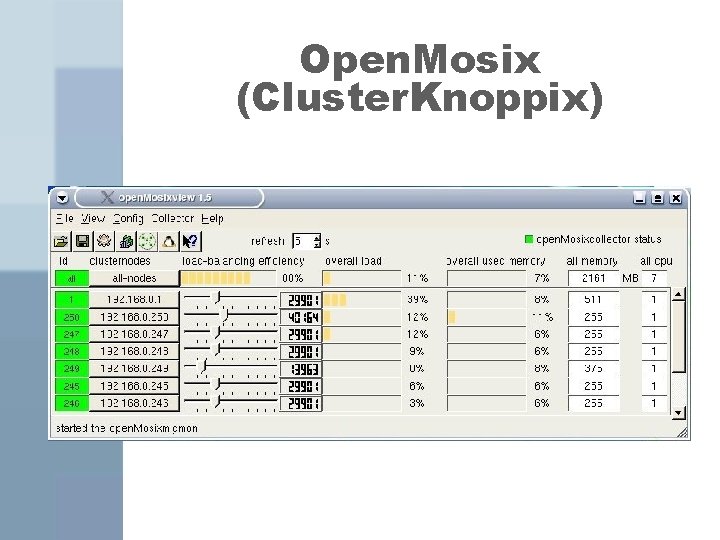
• Kernelpatch für Linux • Userland Tools (zur Administration) • Arbeitet als SSI-Cluster (Single System Image) • Clusterrechner und normale Personal. Computer können verwendet werden • Betrieb ohne HDD möglich (PXE-fähig) • Kein Master oder Serverrechner (Nodes gleichberechtigt) • Auslastung erreicht durch regelmäßige Multicast-Messages • Erscheint für den Nutzer als Multi-CPUSystem
• Prozessbearbeitung: – Prozess wird auf einem System gestartet (Home Node) – Prozess überschreitet Lastgrenze (einstellbar) – Rechner prüft auf nicht ausgelastete Nodes im Cluster – Gefunden-> Migration des Prozesses auf den gefunden Rechner – Speicherseiten des Home Nodes werden kopiert und über das Netz an den gefundenen Rechner geschickt – Kernel kopiert Seiten in den RAM
– Prozess wird auf Rechner fortgesetzt – Auf Home Node bleibt Deputy (Sheriff) zurück -> zum Abfangen der Systemaufrufe des Prozesses
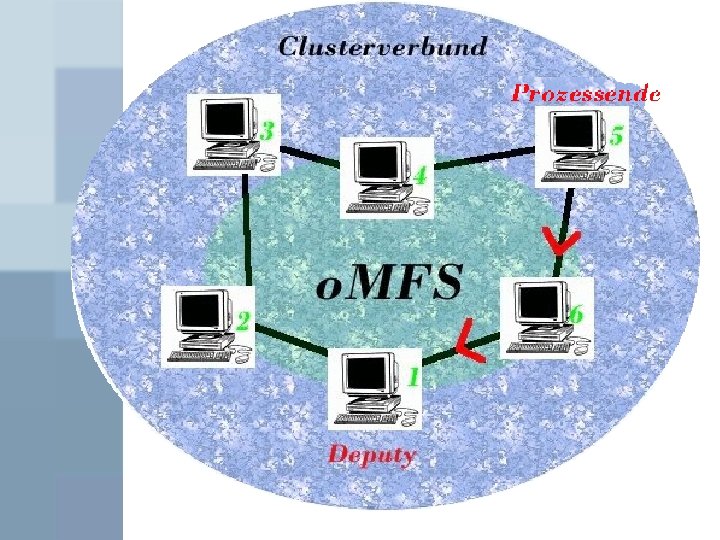
• o. MFS (open. Mosix File-System) – Prozesse mit ständigen Zugriff auf Daten müssten jedes Mal auf den Home Node zurück migriert werden – Starke Zunahme der Netzwerklast und starke Performanceeinbußen – o. MFS macht Daten clusterweit bekannt – In aktueller open. Mosix-Version ersetzt durch GFS (Global File System )
• Fazit: – Ungeeignet für vorherrschendes System, da zu viele Knoten – Unüberschaubar – Starke Performanceeinbußen durch erhöhte Netzwerklast (Multicast. Messages)
Kerrighed • SSI-Betriebssystem für Cluster (Modulpaket, Linux-Kernelpatch) • Verbund herkömmlicher PCs zu symmetrischem Multiprozessorsystem (SMP) • speziell für wissenschaftliche numerische Berechnungen
Kerrighed • Clusterweites Prozessmanagment • Unterstützung für clusterweites Shared Memory • Cluster File System • Transparentes Prozess. Checkpointing • Hohe Verfügbarkeit der User. Anwendungen • Einstellbare SSI-Features
Kerrighed • Fazit: – Systeme mit SMP-Architektur sind für massiv-parallele Rechner (mehr als 16 CPUs) nicht geeignet – Online-Dokumentation wenig aussagekräftig
Parallel. Knoppix
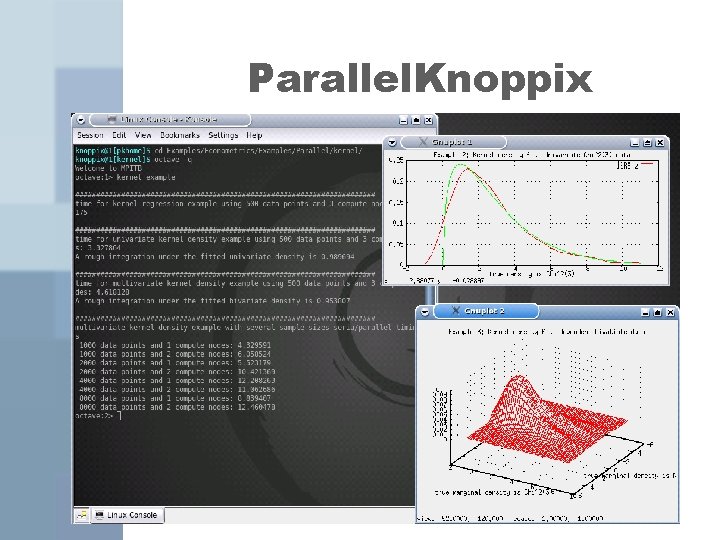
Parallel. Knoppix • vor allem für Cluster-Neulinge geeignet (ausführliches Tutorial) • Einsatz von Live-CD, Master. Knoten auch in virtueller Maschine • keine Software-Installation auf den Client-Knoten nötig • mehrere MPI-Implementierungen (open. MP, LAM-MPI, MPICH)
OSCAR • Open Source Cluster Application Resources • Projekt der Open. Cluster. Group • Sammlung von Softwarepakten zum einfachen Aufbau von Clustern auf Basis von PVM / MPI mit umfangreichen Werkzeugen für Clustermanagement und Analyse
OSCAR • Implementierung der aktuellen „bestknown practices“ für HPC-Cluster ständige Weiterentwicklung • Nutzbar unter verschiedenen Linuxdistributionen • Geeignet für nichtspezialisierte HPCCluster mit Knotenanzahl zwischen 4 und 100 • Durch PVM auch in heterogenen Umgebungen lauffähig
Komponenten von OSCAR • • C 3 – Cluster Command Control LAM/MPI PVM Maui PBS Scheduler Open. SSH Open. SSL SIS – System Installation Suite
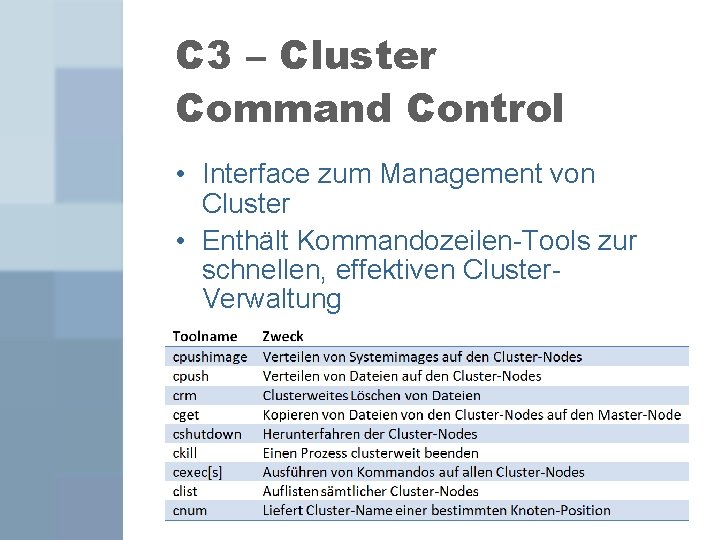
C 3 – Cluster Command Control • Interface zum Management von Cluster • Enthält Kommandozeilen-Tools zur schnellen, effektiven Cluster. Verwaltung
LAM/MPI • LAM – eine spezielle MPIImplementierung • Unterstützt MPI V 1. 2 und Teile von MPI V 2 sowie aktives Debugging • Volle Kompatibilität zu anderen MPIImplementierungen • Unterstützte Funktionen: Checkpoint/Restart, High Performance Communication, Integration von PBS, Easy Application Debugging
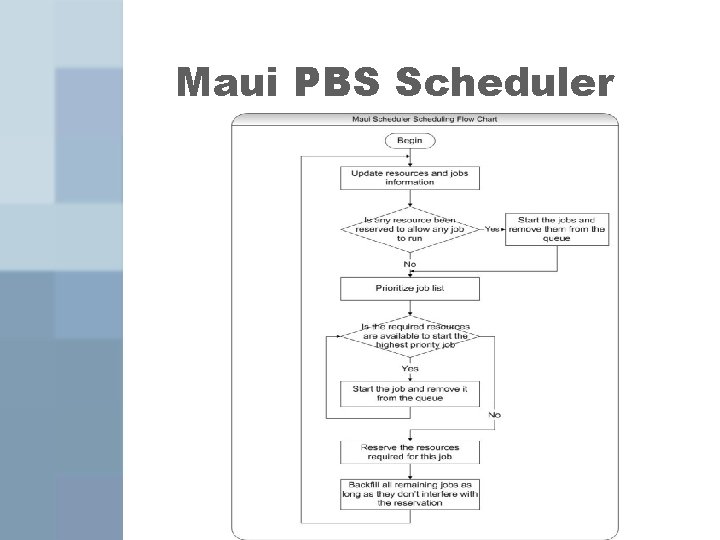
Weitere Komponenten • SIS – System Installation Suite – Ermöglicht automatisierte Installation und Konfiguration von HPC-Cluster – Nachträgliche Änderung der Einstellungen leicht möglich • PVM (Parallel Virtual Machine) – Alternative zu MPI – Parallelrechner wird emuliert • Maui PBS Scheduler – Erweiterter Job-Scheduler mit • verschiedene Queue-Richtlinien, • dynamische Job-Prioritäten • Gleichbereichtigungsalgorithmen
Maui PBS Scheduler
Beurteilung von OSCAR • geeignet für vorliegendes System • Enthält alle nötigen Tools zur Einrichtung, Wartung und Betrieb • Aber: – Clustergröße bereits am oberen Ende der von OSCAR unterstützten Cluster – Keine Angabe zu Power Management, evtl. Zusatztools nötig
Fazit • Keine zufriedenstellende Lösung gefunden • für spezielle Problem ist eine “Massen”-Lösung im Open. Source/Freeware-Bereich unmöglich • Anpassung von Clustersoftware über kommerzielle Firmen stellt sich als beste Lösung heraus
- Slides: 52