
LES DONNES MANQUANTES PACKAGES VIM Amelia miss Forest
- Slides: 37
LES DONNÉES MANQUANTES
PACKAGES � VIM � Amelia � miss. Forest � miss. MDA
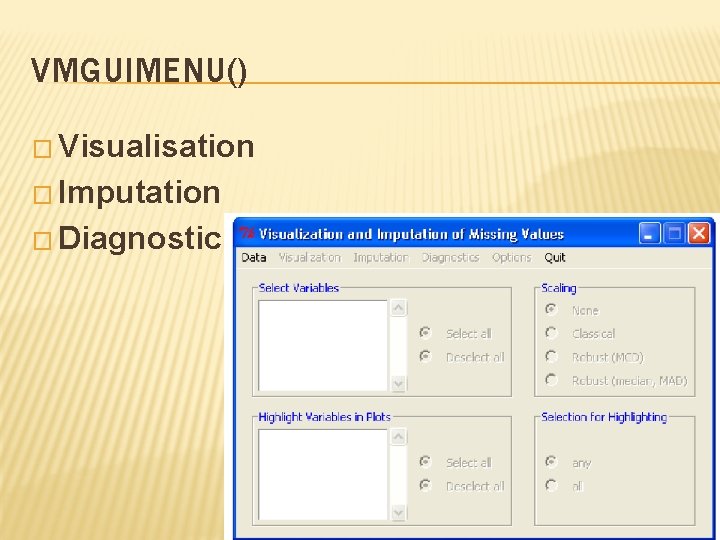
PACKAGE VIM =VISUALIZATION AND IMPUTATION OF MISSING VALUES � 0. Console graphique: vm. Guimenu() � I. Prévisualisation des NA (aggr, bar. Miss, hist. Miss, marginmatrix, marginplot, matrixplot) � II. Imputation (irmi, hotdeck, k. NN) � III. Visualisation des imputations
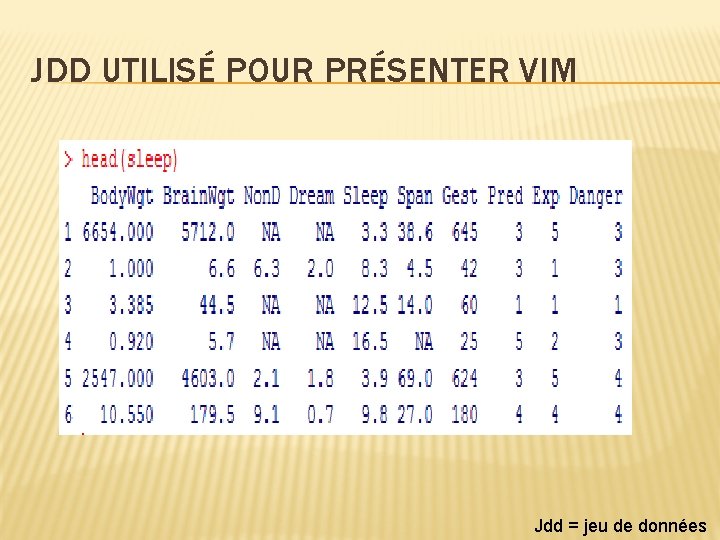
JDD UTILISÉ POUR PRÉSENTER VIM Jdd = jeu de données
VMGUIMENU() � Visualisation � Imputation � Diagnostic
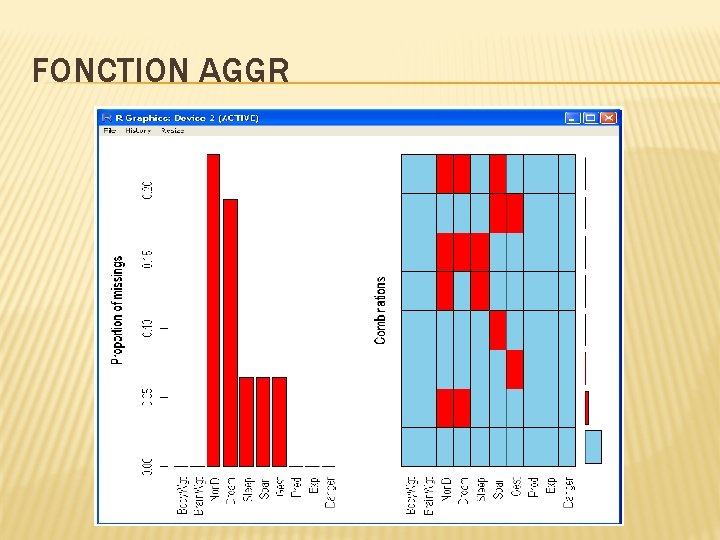
FONCTION AGGR
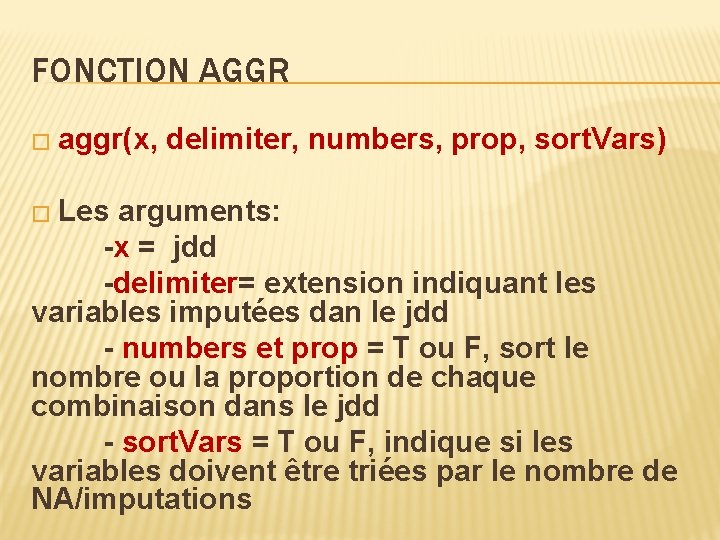
FONCTION AGGR � aggr(x, � Les delimiter, numbers, prop, sort. Vars) arguments: -x = jdd -delimiter= extension indiquant les variables imputées dan le jdd - numbers et prop = T ou F, sort le nombre ou la proportion de chaque combinaison dans le jdd - sort. Vars = T ou F, indique si les variables doivent être triées par le nombre de NA/imputations
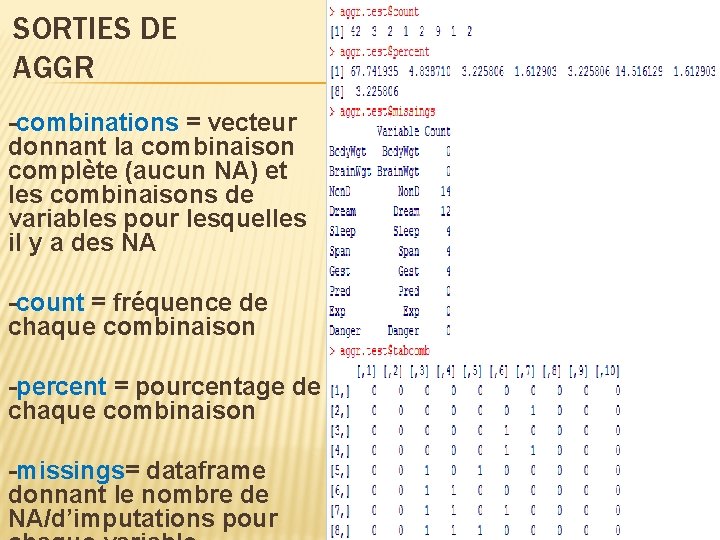
SORTIES DE AGGR -combinations = vecteur donnant la combinaison complète (aucun NA) et les combinaisons de variables pour lesquelles il y a des NA -count = fréquence de chaque combinaison -percent = pourcentage de chaque combinaison -missings= dataframe donnant le nombre de NA/d’imputations pour
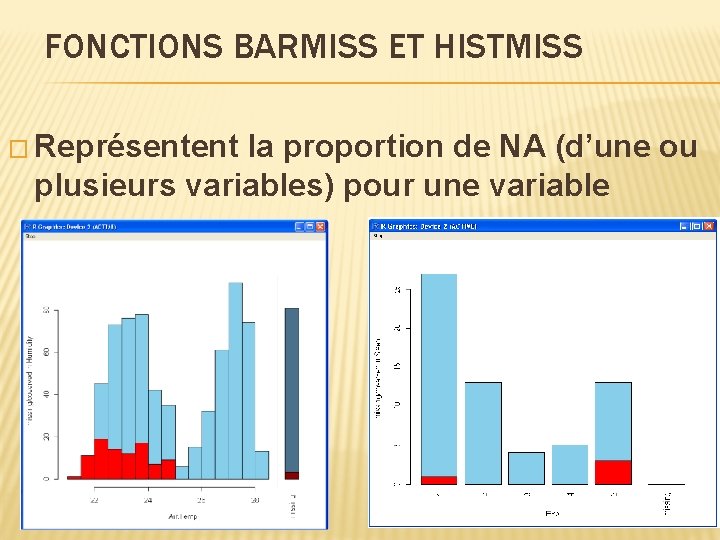
FONCTIONS BARMISS ET HISTMISS � Représentent la proportion de NA (d’une ou plusieurs variables) pour une variable
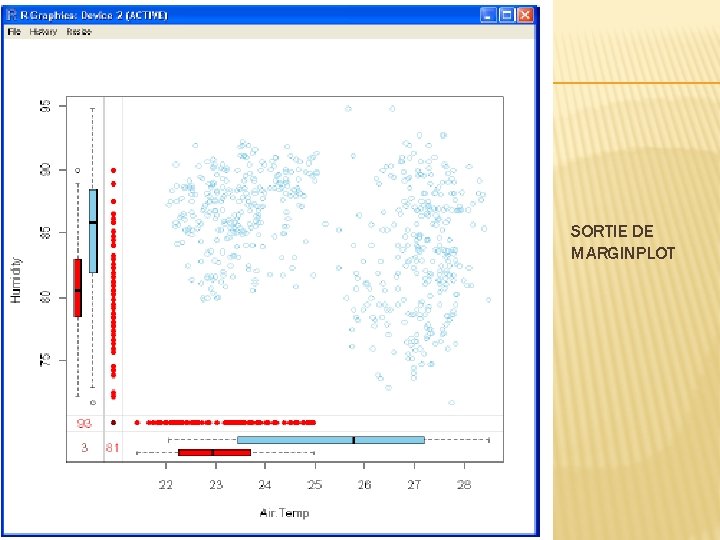
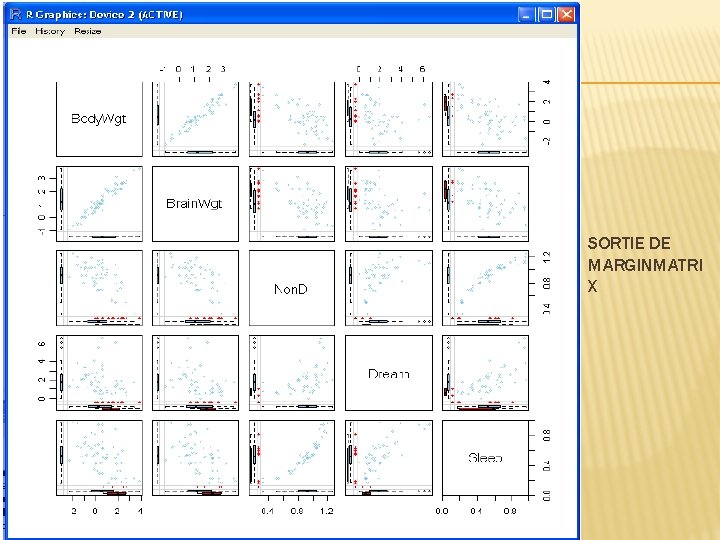
FONCTION MARGINMATRIX ET MARGINPLOT � marginplot(x, delimiter) - x=matrice ayant deux colonnes (2 variables du jdd) Þ Plot les données observées d’une variable en fonction de l’autre et ajoute des informations sur les NA � marginmatrix(x, delimiter) - x =jdd => Idem mais pour plusieurs variables (tous les graphes sur une fenêtre)
SORTIE DE MARGINPLOT
SORTIE DE MARGINMATRI X
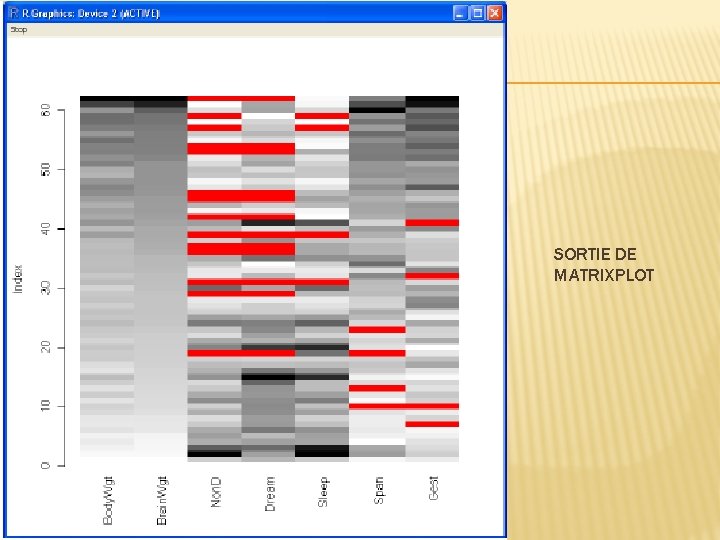
FONCTION MATRIXPLOT � matrixplot(x, delimiter, sortby, col) - x = jdd - sortby = variable par laquelle il faut trier les données - col = 1, 2, 3 ou 4; choix des couleurs pour NA, données imputées, données observées. Þ Matrice de même taille que le jdd où un rectangle = 1 cellule, colorée selon la nature de cette donnée
SORTIE DE MATRIXPLOT
FONCTION IRMI: PRINCIPE � Régression de la variable ayant NA (Y) en fonction des autres variables (X 1, X 2. . . ) � Change de Y, prend la variable suivante ayant NA � Recommence sur tout jdd jusqu’à ce que les valeurs imputées ne bougent plus.
FONCTION IRMI = ITERATIVE ROBUST MODELBASED IMPUTATION � But: imputation simple ou multiple � irmi(x, eps, noise, mi) � Les arguments: -x=jdd -eps = seuil de convergence (laissé par défaut) -noise= rajoute du bruit à la valeur imputée (le fait par défaut, mettre FALSE sinon) -mi= nombre d’imputations que l’on veut
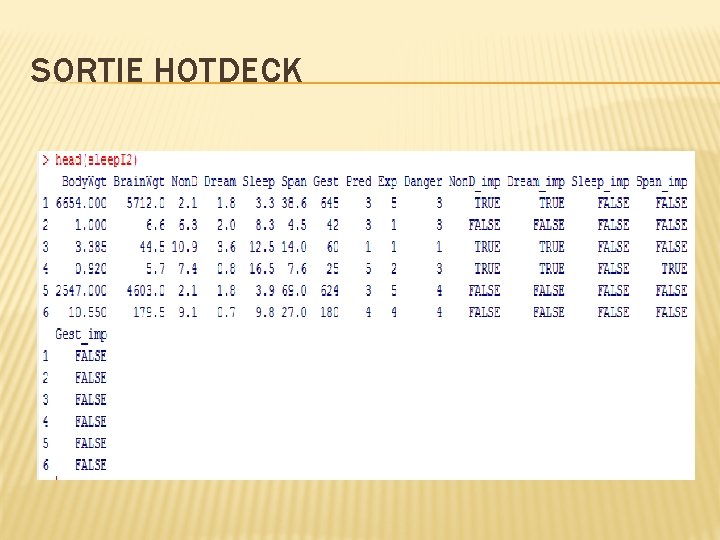
FONCTION HOTDECK � hotdeck(x, variable, imp_var) � Les arguments: - x = jdd - variable = sélection des variables à imputer - imp_var=T ou F, par défaut T => rajoute pour chaque variable imputée une colonne nommée « nomvariable_imp » où les données imputées sont indiquées par un « TRUE » � Sortie = le jdd imputée avec la position des données imputées (si imp_var=T)
SORTIE HOTDECK
FONCTION KNN: PRINCIPE � Individu n°i avec NA pour Y et profil x (X 1, X 2…) � Prend les individus avec profil x le plus proche de i = ses « voisins » � Estime la valeur Y pour i selon celles des voisins � Estimation par moyenne, médiane…
FONCTION KNN k. NN(x, variable, metric, k, dist_var, weights, num. Fun, cat. Fun, imp_var) � Les arguments -variable= variables à imputer -metric= métrique pour calculer les distances - k= nombre de voisins - dist_var = nom des variables pour calculer les distances - weights = poids des variables utilisées pour calculer les distances - num. Fun = fonction utilisée pour imputer la donnée (variable quantitative: moyenne, médiane…) -cat. Fun = fonction utilisée pour imputer la donnée �
FONCTIONS APRÈS IMPUTATION � Pbox � scatt. Miss � scatt. Jitt � Scattmatrix. Miss � colormap. Miss � pairs. VIM � parcoord. Miss
PACKAGE AMELIA I. Imputation multiple (amelia, write. amelia II. Visualisation et qualité de l’imputation (missmap, plot, overimpute, mi. meld) This package is named after this famous missing person Amelia E. Source : http: //gking. harvard. edu/amelia
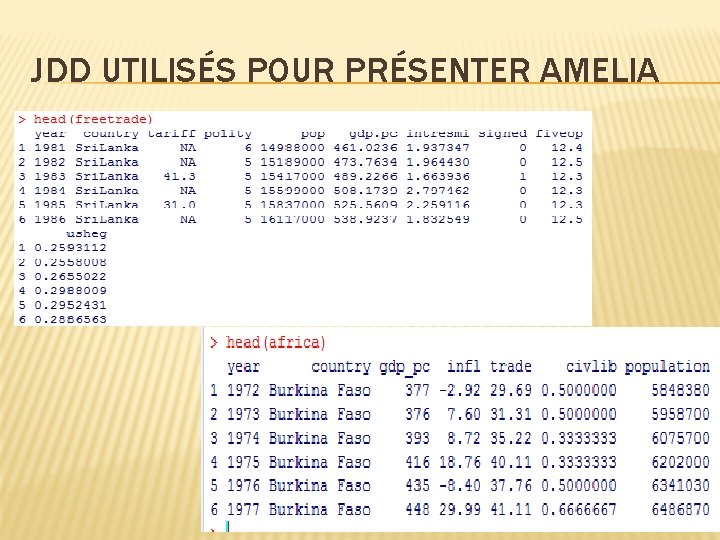
JDD UTILISÉS POUR PRÉSENTER AMELIA
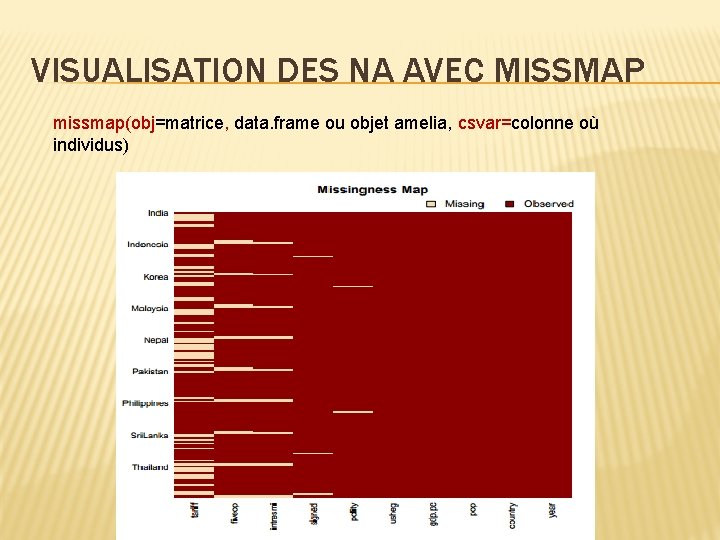
VISUALISATION DES NA AVEC MISSMAP missmap(obj=matrice, data. frame ou objet amelia, csvar=colonne où individus)
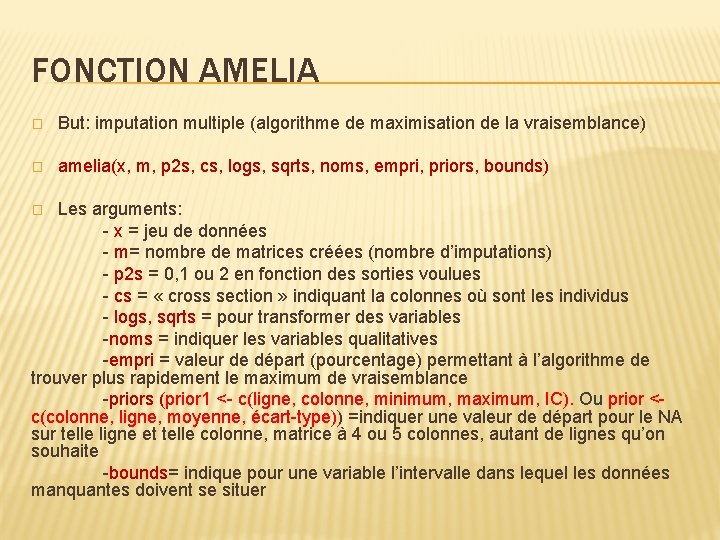
FONCTION AMELIA � But: imputation multiple (algorithme de maximisation de la vraisemblance) � amelia(x, m, p 2 s, cs, logs, sqrts, noms, empri, priors, bounds) Les arguments: - x = jeu de données - m= nombre de matrices créées (nombre d’imputations) - p 2 s = 0, 1 ou 2 en fonction des sorties voulues - cs = « cross section » indiquant la colonnes où sont les individus - logs, sqrts = pour transformer des variables -noms = indiquer les variables qualitatives -empri = valeur de départ (pourcentage) permettant à l’algorithme de trouver plus rapidement le maximum de vraisemblance -priors (prior 1 <- c(ligne, colonne, minimum, maximum, IC). Ou prior <- c(colonne, ligne, moyenne, écart-type)) =indiquer une valeur de départ pour le NA sur telle ligne et telle colonne, matrice à 4 ou 5 colonnes, autant de lignes qu’on souhaite -bounds= indique pour une variable l’intervalle dans lequel les données manquantes doivent se situer �
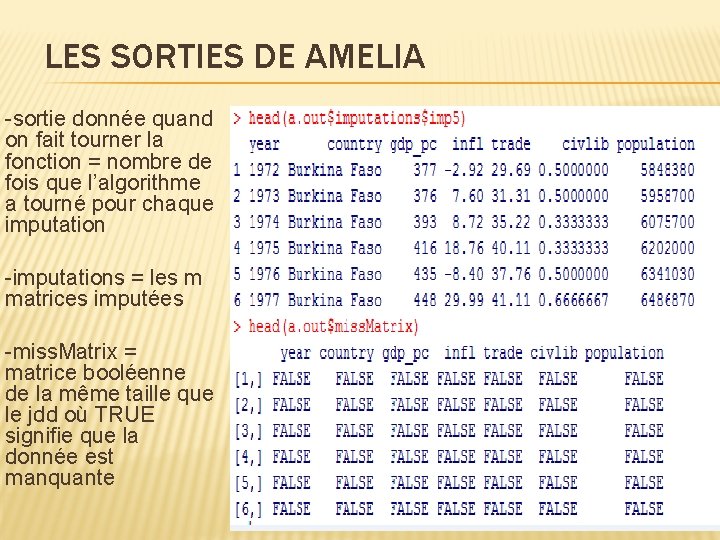
LES SORTIES DE AMELIA -sortie donnée quand on fait tourner la fonction = nombre de fois que l’algorithme a tourné pour chaque imputation -imputations = les m matrices imputées -miss. Matrix = matrice booléenne de la même taille que le jdd où TRUE signifie que la donnée est manquante
FONCTION WRITE. AMELIA � Enregistrement des jeux de données imputés � write. amelia(obj , file. stem, format, separate, orig. data) Les arguments: - obj = l’objet amelia - file. stem= nom donné à l’objet enregistré (ex: amelia_jdd) - format= csv, txt… -separate= TRUE si on veut séparer avoir les jdd séparés, FALSE si on les concatène tous par ligne -orig. data= TRUE si on concatène au jdd original � � On peut ouvrir chacun des m jdd imputés: read. table( « localisation/amelia_jdd 1 » ) pour avoir le 1 er, remplacer 1 par 2 pour avoir le second etc… � Faire un graphique de chaque jdd pour vérifier que l’imputation n’a pas « trop » changé les données
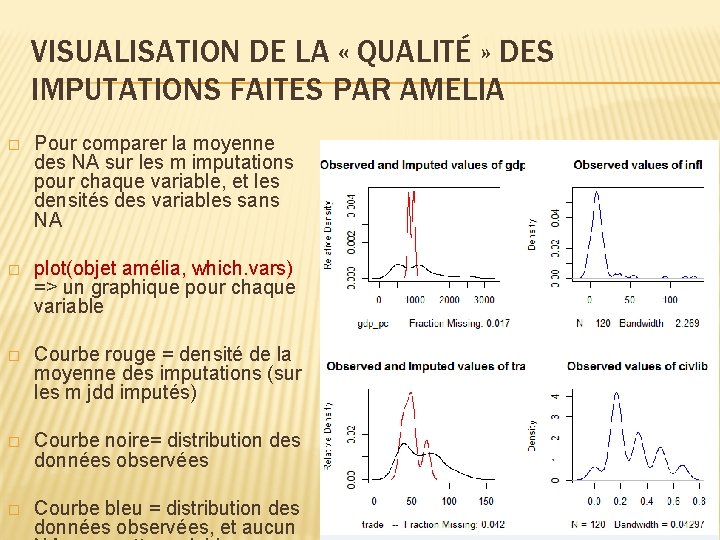
VISUALISATION DE LA « QUALITÉ » DES IMPUTATIONS FAITES PAR AMELIA � Pour comparer la moyenne des NA sur les m imputations pour chaque variable, et les densités des variables sans NA � plot(objet amélia, which. vars) => un graphique pour chaque variable � Courbe rouge = densité de la moyenne des imputations (sur les m jdd imputés) � Courbe noire= distribution des données observées � Courbe bleu = distribution des données observées, et aucun
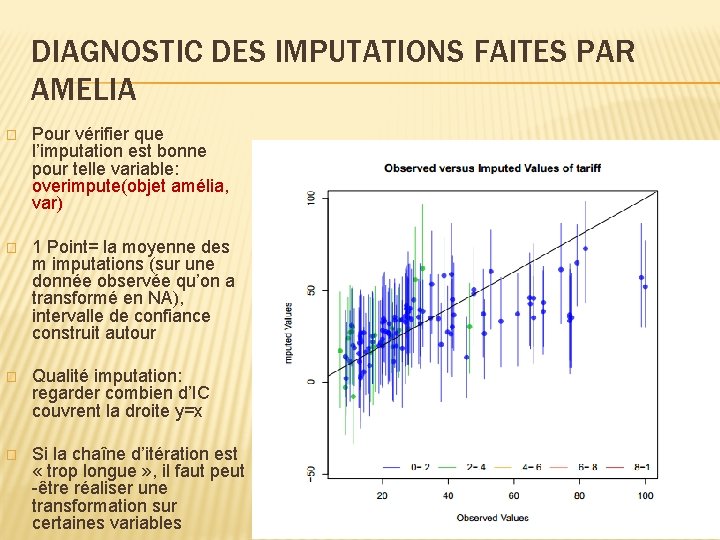
DIAGNOSTIC DES IMPUTATIONS FAITES PAR AMELIA � Pour vérifier que l’imputation est bonne pour telle variable: overimpute(objet amélia, var) � 1 Point= la moyenne des m imputations (sur une donnée observée qu’on a transformé en NA), intervalle de confiance construit autour � Qualité imputation: regarder combien d’IC couvrent la droite y=x � Si la chaîne d’itération est « trop longue » , il faut peut -être réaliser une transformation sur certaines variables
ANALYSER LES DONNÉES IMPUTÉES � Pour avoir la moyenne et la variance d’une quantité nous intéressant (la moyenne, des coefficients, ou des paramètres) � Ex: je fais une régression sur chaque jdd imputé, je stocke les coefficients de régression de chaque variable, ainsi que leur variance � mi. meld(q, se) - q = matrice de dim p*m où il y a ce qu’on veut analyser - se = matrice de dim p*m avec les écarts types des quantités précédentes � Sorties: -q=valeur moyenne de la quantité d’intérêt sur les m jdd -se= écart-type de chaque quantité d’intérêt
PACKAGE MISSFOREST � Imputation simple et obtention des erreurs d’imputation (miss. Forest, mix. Error)
PRINCIPE MISSFOREST � Imputation dans le cas de données mixtes, dont les relations ne sont pas forcément linéaires Exemple: Y et x 1, x 2 1) met des 0 où il y a des NA 2) fait un arbre pour prévoir Y en fonction de x 1 et x 2 => valeur estimée pour Y 3) fait un arbre pour prévoir x 1 en fonction de Y et x 2 => valeur estimée pour x 1 4)Idem avec x 2 5)Recommence jusqu’à convergence � � Similaire à irmi, mais on n’a pas une combinaison linéaires des prédicteurs
FONCTION MISSFOREST � miss. Forest(xmis, maxiter, ntree, variablewise) Les arguments: - xmis=jdd - maxiter= nombre d’itération maximum à faire - ntree = nombre d’arbres dans chaque forêt - variablewise= pour avoir les erreurs pour chaque variable séparée (=TRUE), sinon sort une erreur pour tout le jdd � Les sorties: - ximp= jdd imputé - OOBerror= erreur d’imputation estimée pour chaque variable (NRMSE pour les variables quantitatives, proportion de mal classés pour les qualitatives) - error = « vraie » erreur d’imputation �
FONCTION MIXERROR � But: calculer l’erreur d’imputation pour des données mixtes. � mix. Error(ximp, xmis, xtrue) � Les arguments: -ximp=jdd imputé -xmiss=jdd avec NA -xtrue=jdd complet (sans NA, ni imputation) Les sorties: -une erreur d’imputation pour les variables qualitatives (proportion de mauvais classement), une autre pour les variables quantitatives (nrmse) �
PACKAGE MISSMDA � Imputation simple ou multiple via les composantes principales
MISSMDA � http: //math. agrocampus- ouest. fr/infoglue. Deliver. Live/developpement/ miss. MDA � Cours Julie Josse (hier si vous souvenez bien)
SOURCES � Site R cran � http: //www. unt. edu/rss/class/Jon/Benchmark s/Missing. Value. Imputation_JDS_Nov 2010. pdf � http: //txcdk. unt. edu/iralab/sites/default/files/A MELIAII_Handout. pdf