
Le test de Jonckheere pour la construction dalgorithme
- Slides: 37
Le test de Jonckheere pour la construction d’algorithme de résistance dans le VIH Philippe Flandre INSERM U 720 CHU Pitié-Salpêtrière
La résistance dans le VIH • Patients sous traitement • Génotypique – Gènes env, gag, et pol – Gène pol • Transcriptase inverse • Intégrase • Protéase virale • Phénotypique – Définir la sensibilité ou résistance à tel ou tel molécule
Les traitements • Inhibiteurs de la Transcriptase Inverse – Nucléosidiques et nucléotidiques (INTI) • AZT, ABC, DDI, 3 TC, FTC, D 4 T, TDF – Non nucléosidiques (INNTI) • EFV, NVP, TMC 125 • Inhibiteurs de la Protéase (IP) – IDV, ATZ, Fos. APV, DRV, NFV, LPV, SQV, TPV – RTV • Trithérapie – 2 INTIs + 1 IP – 2 INTIs + 1 INNTI
La réponse aux traitements • Depuis 1996 et les trithérapies réduction de la mortalité • Réponse en terme de charge virale – Baisse de la charge virale (continue) • Ex: 50 000 copies 500 copies réduction 2 log 10 – Baisse > 1 log 10 (discret) – Charge virale < 50 copies/ml (discret)
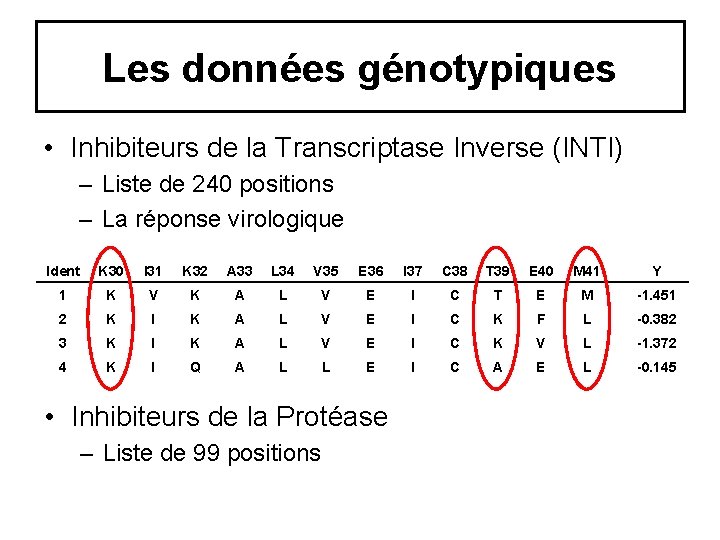
Les données génotypiques • Inhibiteurs de la Transcriptase Inverse (INTI) – Liste de 240 positions – La réponse virologique Ident K 30 I 31 K 32 A 33 L 34 V 35 E 36 I 37 C 38 T 39 E 40 M 41 Y 1 K V K A L V E I C T E M -1. 451 2 K I K A L V E I C K F L -0. 382 3 K I K A L V E I C K V L -1. 372 4 K I Q A L L E I C A E L -0. 145 • Inhibiteurs de la Protéase – Liste de 99 positions
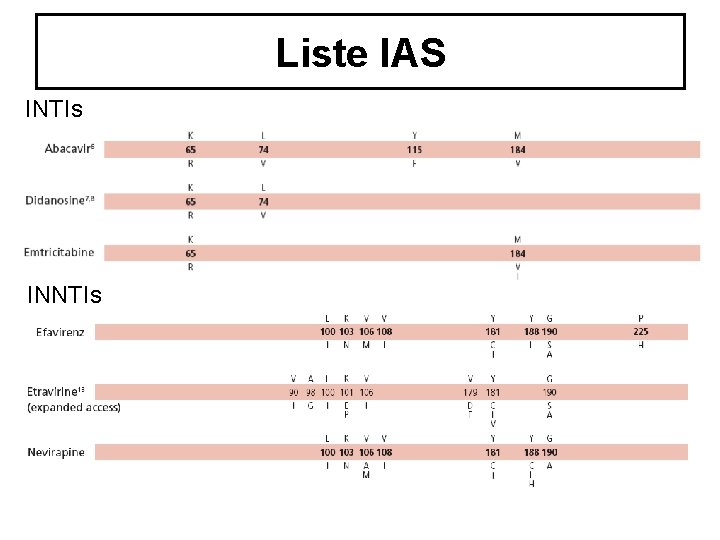
Liste IAS INTIs INNTIs
ANRS • Groupe AC 11 • Relation géno-réponse virologique • Mise à jour régulière des algorithmes – Communication et publications – Propres études du groupe – Études autres
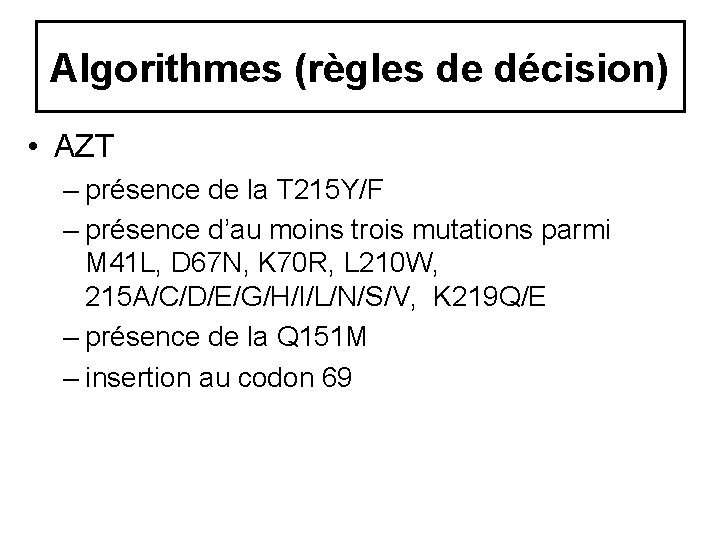
Algorithmes (règles de décision) • AZT – présence de la T 215 Y/F – présence d’au moins trois mutations parmi M 41 L, D 67 N, K 70 R, L 210 W, 215 A/C/D/E/G/H/I/L/N/S/V, K 219 Q/E – présence de la Q 151 M – insertion au codon 69
Analyse statistique • Procédure en 2 étapes – Relation entre chaque position et la réponse • Test Wilcoxon p<0. 20 • Fréquence de la mutation > 5% • on retient N mutations – Recherche de la meilleur combinaison de mutations • De N on sélectionne K mutations • Test non-paramétrique de Jonckheere
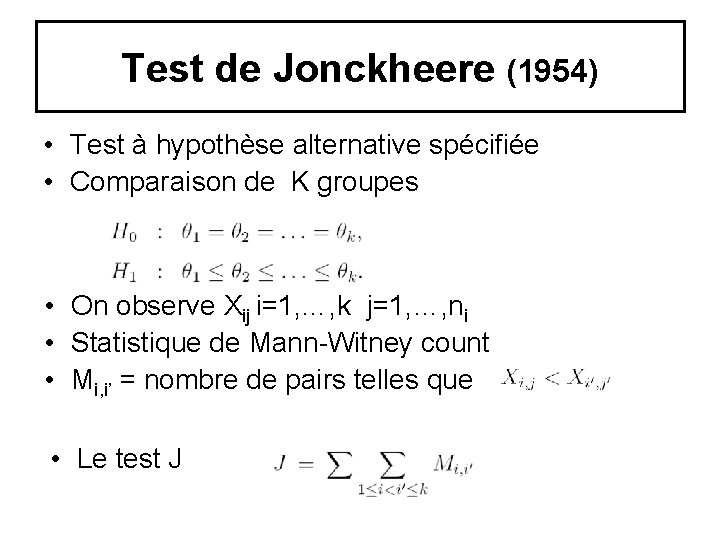
Test de Jonckheere (1954) • Test à hypothèse alternative spécifiée • Comparaison de K groupes • On observe Xij i=1, …, k j=1, …, ni • Statistique de Mann-Witney count • Mi, i’ = nombre de pairs telles que • Le test J
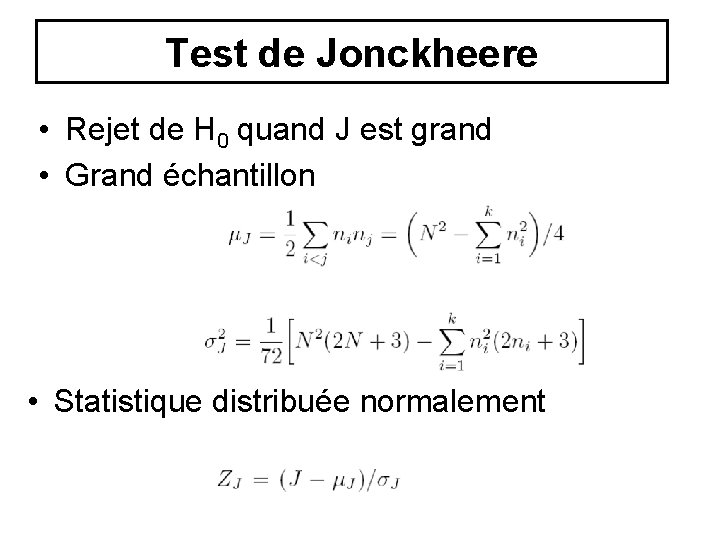
Test de Jonckheere • Rejet de H 0 quand J est grand • Grand échantillon • Statistique distribuée normalement
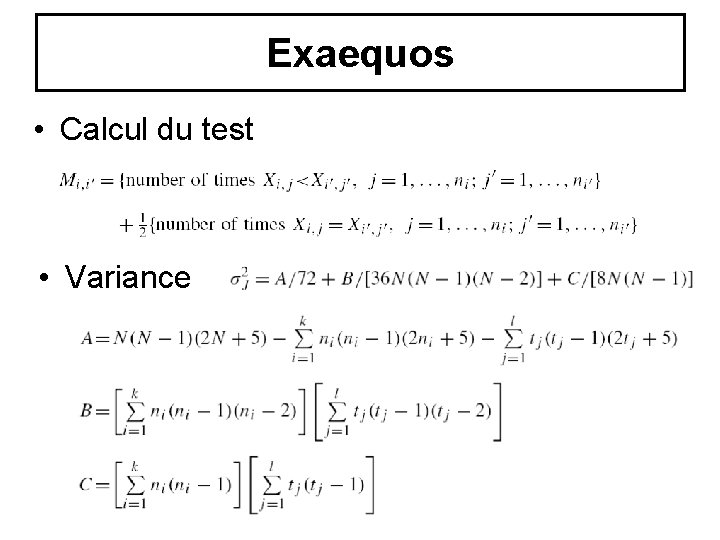
Exaequos • Calcul du test • Variance
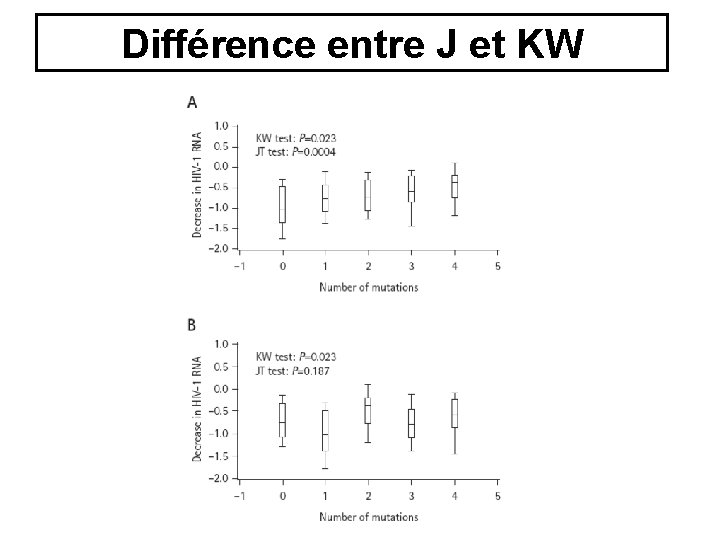
Différence entre J et KW
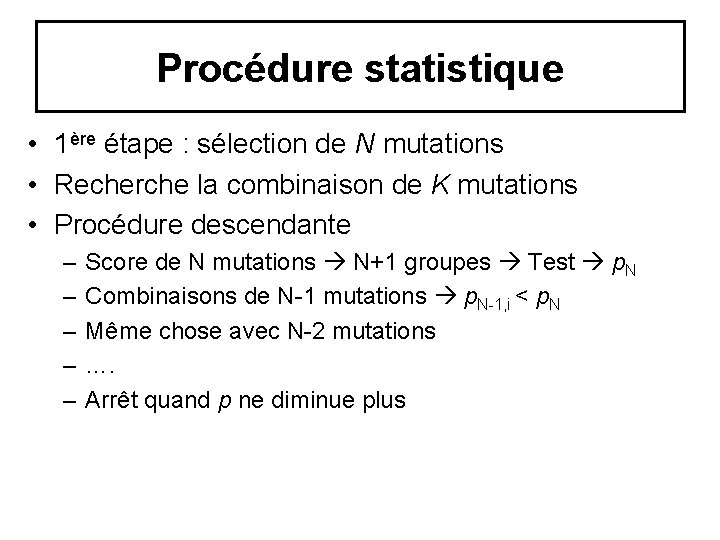
Procédure statistique • 1ère étape : sélection de N mutations • Recherche la combinaison de K mutations • Procédure descendante – – – Score de N mutations N+1 groupes Test p. N Combinaisons de N-1 mutations p. N-1, i < p. N Même chose avec N-2 mutations …. Arrêt quand p ne diminue plus
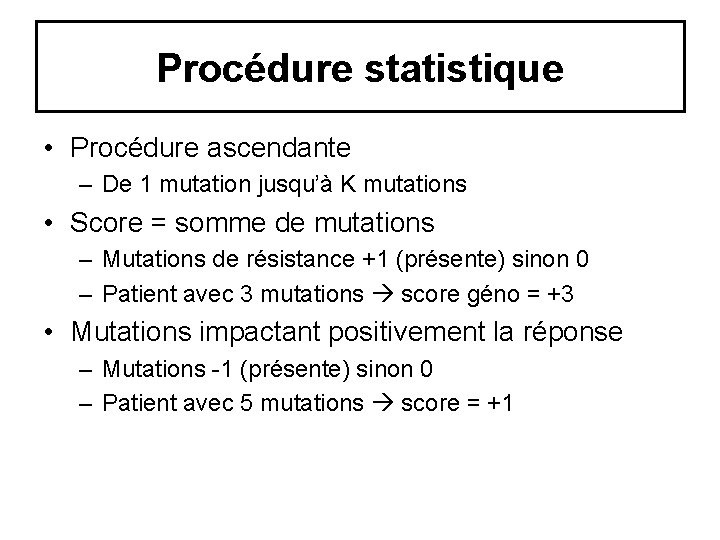
Procédure statistique • Procédure ascendante – De 1 mutation jusqu’à K mutations • Score = somme de mutations – Mutations de résistance +1 (présente) sinon 0 – Patient avec 3 mutations score géno = +3 • Mutations impactant positivement la réponse – Mutations -1 (présente) sinon 0 – Patient avec 5 mutations score = +1
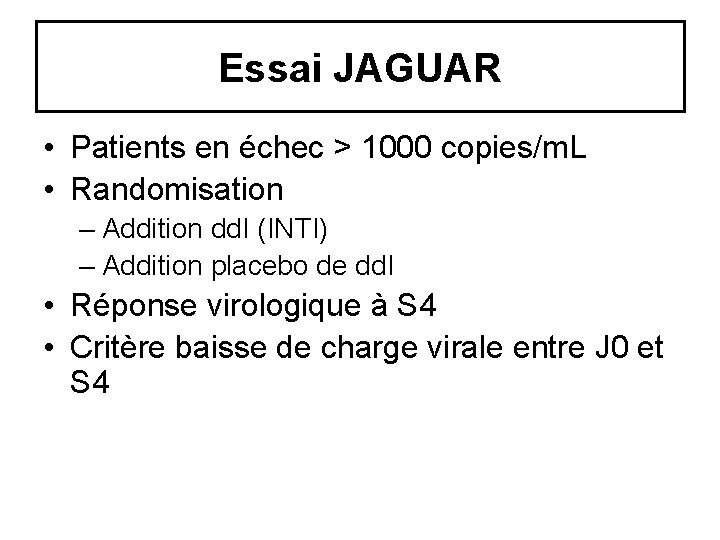
Essai JAGUAR • Patients en échec > 1000 copies/m. L • Randomisation – Addition dd. I (INTI) – Addition placebo de dd. I • Réponse virologique à S 4 • Critère baisse de charge virale entre J 0 et S 4
Analyse de Jaguar • Supériorité du bras dd. I • Analyse génotypique – 1ère étape : 10 mutations sont retenues • 8 mutations de résistance (M 41 L, D 67 N, T 69 D, L 74 V, V 118 I, L 210 W, T 215 Y/F, K 219 Q/E) • 2 mutations se sensibilité (K 70 R, M 184 V/I)
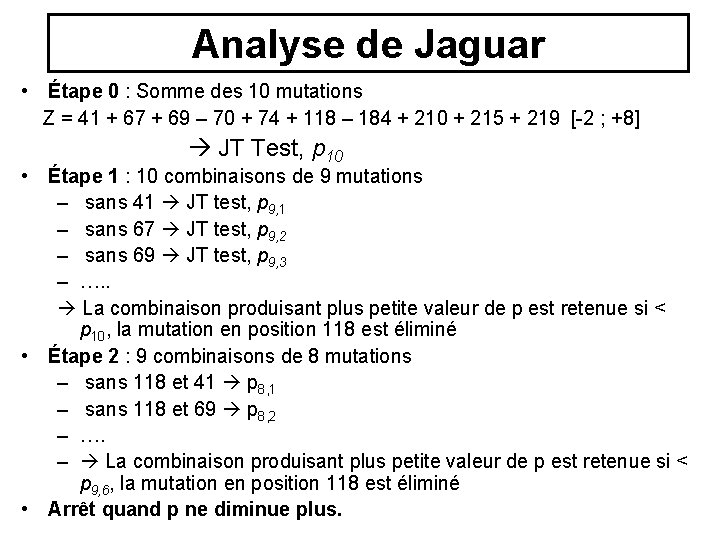
Analyse de Jaguar • Étape 0 : Somme des 10 mutations Z = 41 + 67 + 69 – 70 + 74 + 118 – 184 + 210 + 215 + 219 [-2 ; +8] JT Test, p 10 • Étape 1 : 10 combinaisons de 9 mutations – sans 41 JT test, p 9, 1 – sans 67 JT test, p 9, 2 – sans 69 JT test, p 9, 3 – …. . La combinaison produisant plus petite valeur de p est retenue si < p 10, la mutation en position 118 est éliminé • Étape 2 : 9 combinaisons de 8 mutations – sans 118 et 41 p 8, 1 – sans 118 et 69 p 8, 2 – …. – La combinaison produisant plus petite valeur de p est retenue si < p 9, 6, la mutation en position 118 est éliminé • Arrêt quand p ne diminue plus.
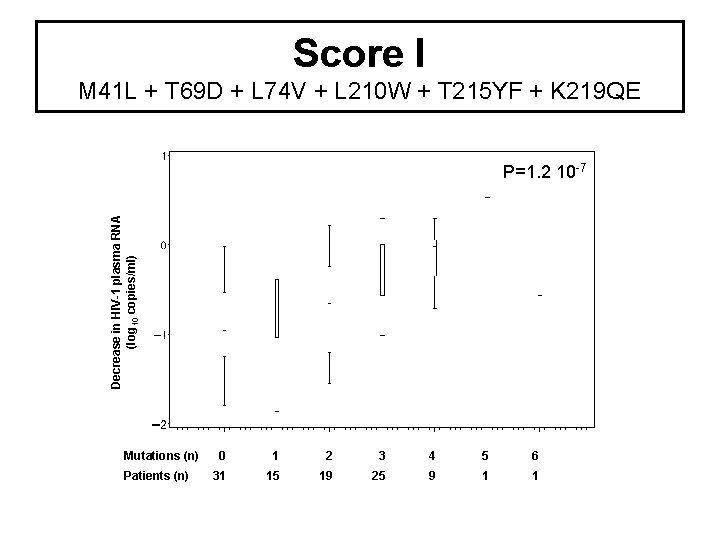
Score I M 41 L + T 69 D + L 74 V + L 210 W + T 215 YF + K 219 QE Decrease in HIV-1 plasma RNA (log 10 copies/ml) P=1. 2 10 -7 Mutations (n) Patients (n) 0 1 2 3 4 5 6 31 15 19 25 9 1 1
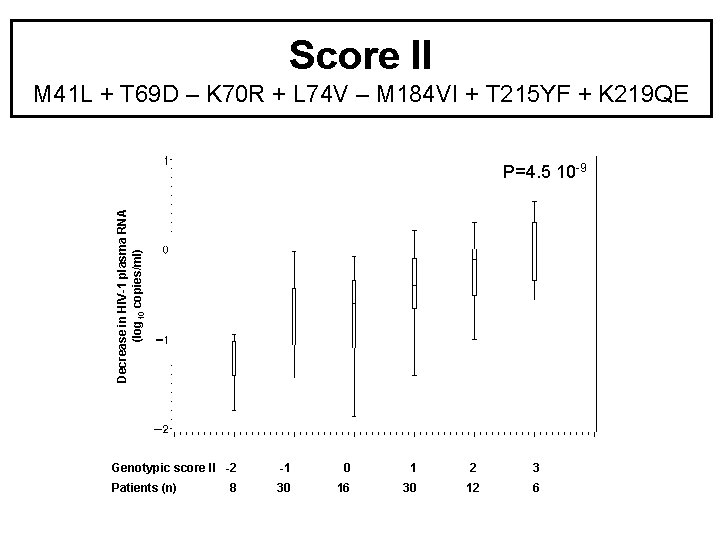
Score II M 41 L + T 69 D – K 70 R + L 74 V – M 184 VI + T 215 YF + K 219 QE Decrease in HIV-1 plasma RNA (log 10 copies/ml) P=4. 5 10 -9 Genotypic score II -2 -1 0 1 2 3 Patients (n) 30 16 30 12 6 8
Discussion des résultats • Clinicien : quelle est la valeur prédictive de ce score ? • Analyse non paramétrique pas de mesure de prédiction type R²
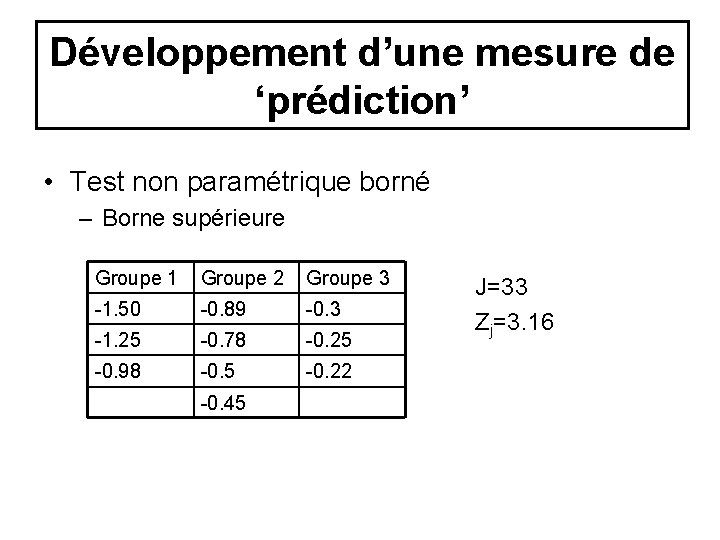
Développement d’une mesure de ‘prédiction’ • Test non paramétrique borné – Borne supérieure Groupe 1 Groupe 2 Groupe 3 -1. 50 -0. 89 -0. 3 -1. 25 -0. 78 -0. 25 -0. 98 -0. 5 -0. 22 -0. 45 J=33 Zj=3. 16
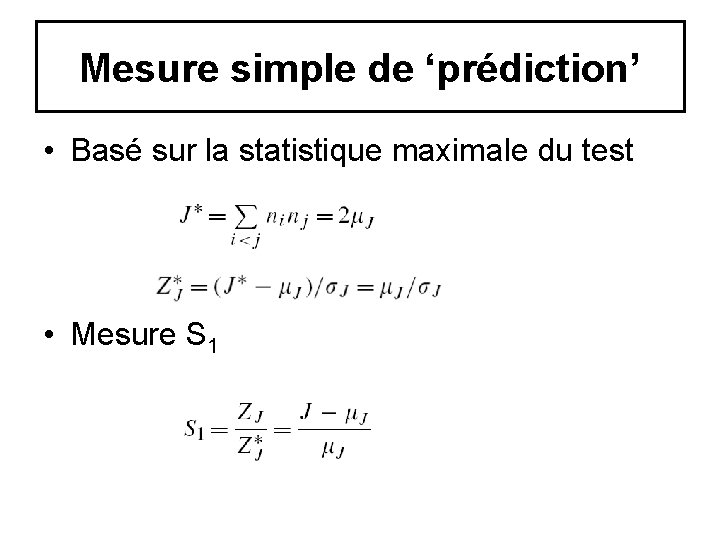
Mesure simple de ‘prédiction’ • Basé sur la statistique maximale du test • Mesure S 1
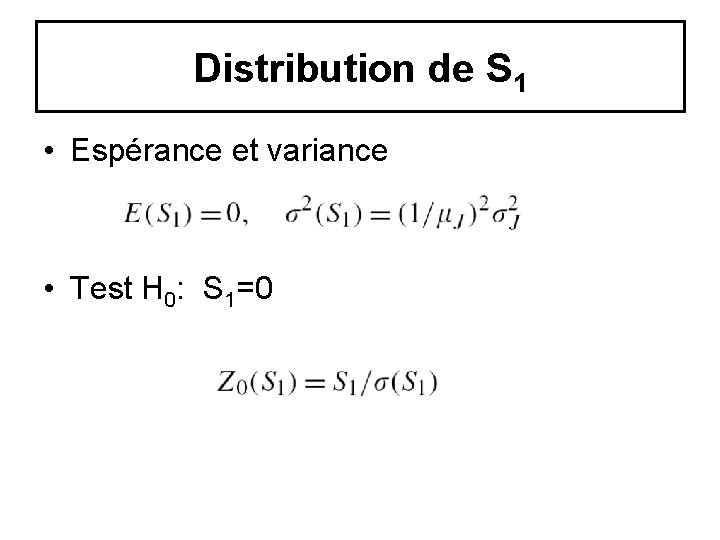
Distribution de S 1 • Espérance et variance • Test H 0: S 1=0
Mesures d’association • Mesure Gamma (Goodman et Kruskal) • 2 variables U et V • Question ‘Est-ce que U a tendance à augmenter si V augmente’
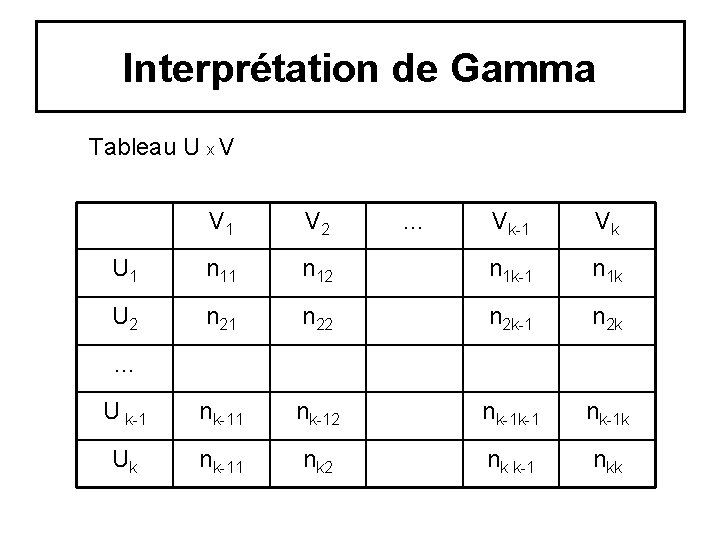
Interprétation de Gamma Tableau U x V V 1 V 2 U 1 n 11 U 2 … Vk-1 Vk n 12 n 1 k-1 n 1 k n 21 n 22 n 2 k-1 n 2 k U k-1 nk-12 nk-1 k-1 nk-1 k Uk nk-11 nk 2 nk k-1 nkk …
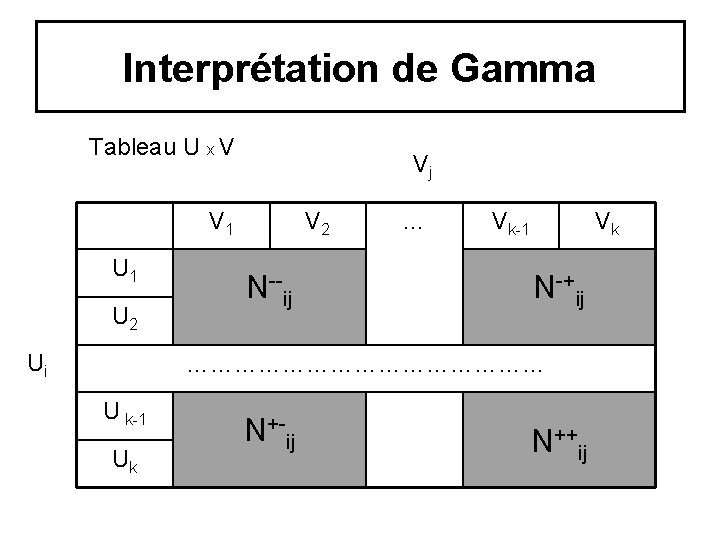
Interprétation de Gamma Tableau U x V Vj V 1 U 2 Ui V 2 N--ij … Vk-1 Vk N-+ij …………………… U k-1 Uk N+-ij N++ij
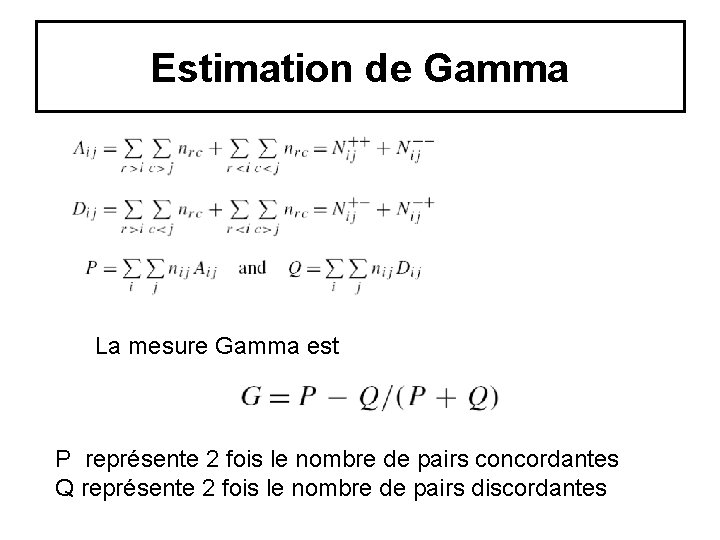
Estimation de Gamma La mesure Gamma est P représente 2 fois le nombre de pairs concordantes Q représente 2 fois le nombre de pairs discordantes
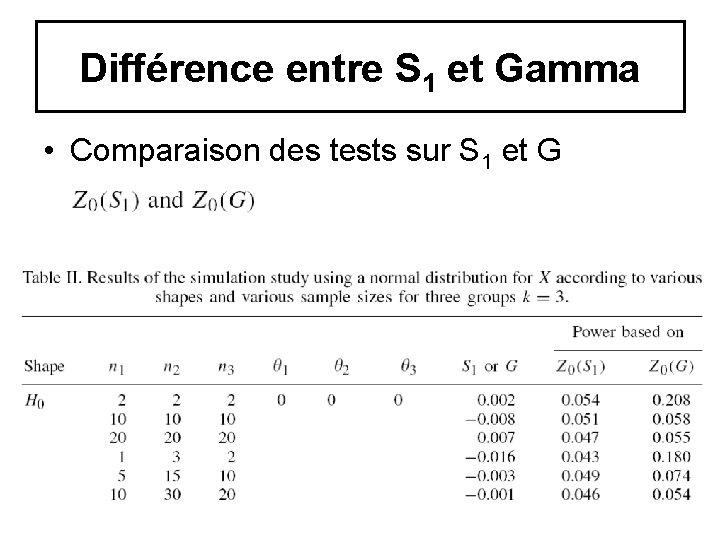
Différence entre S 1 et Gamma • Comparaison des tests sur S 1 et G
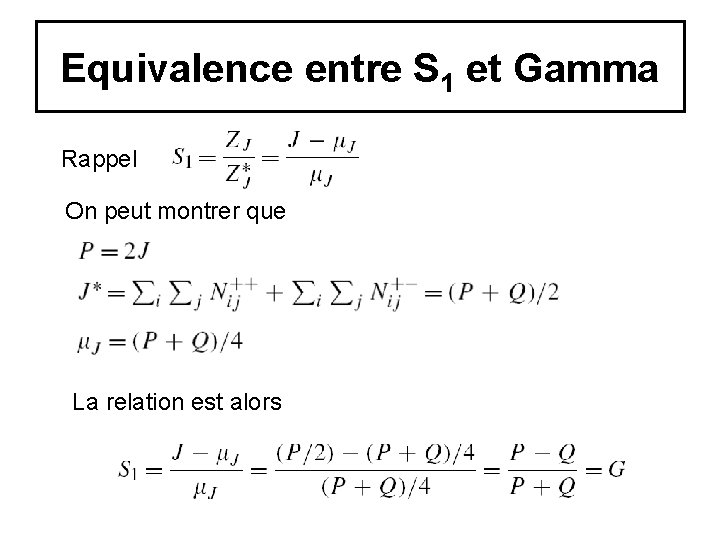
Equivalence entre S 1 et Gamma Rappel On peut montrer que La relation est alors
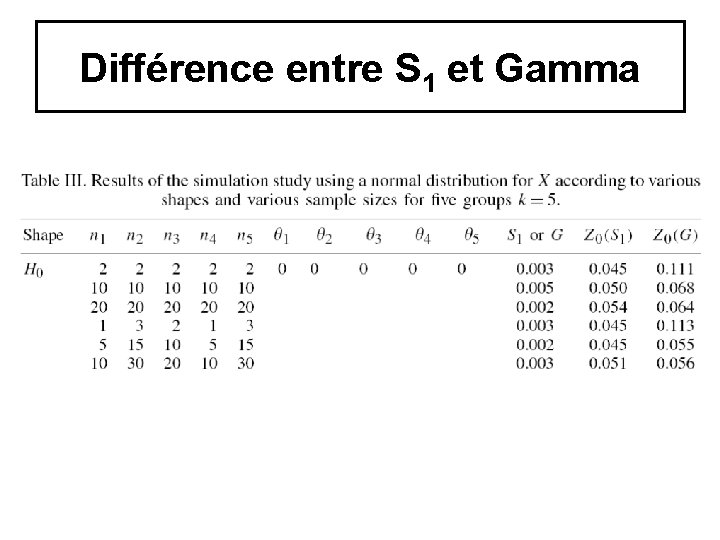
Différence entre S 1 et Gamma
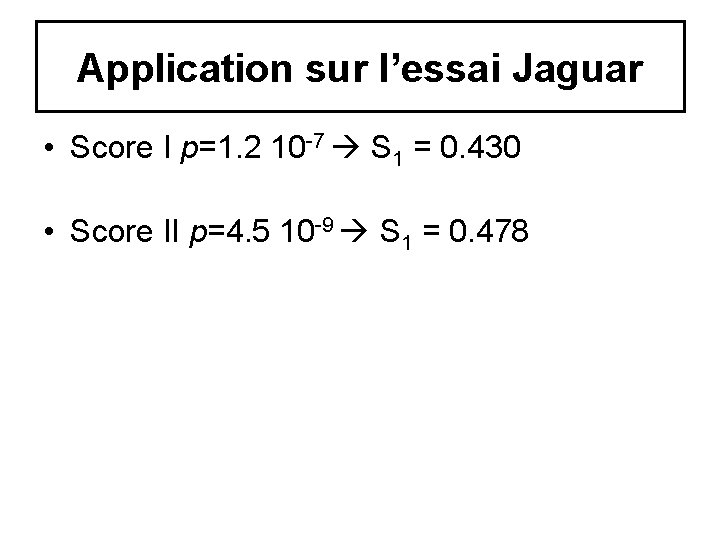
Application sur l’essai Jaguar • Score I p=1. 2 10 -7 S 1 = 0. 430 • Score II p=4. 5 10 -9 S 1 = 0. 478
Conclusion • • • Méthode simple Test et mesure d’association Pas de poids pour les mutations Estimation des poids par bootstrap Validation externe de ces algorithmes Le modèle linéaire – Colinéarité entre les mutations très forte – Effectif faible – Structure du modèle
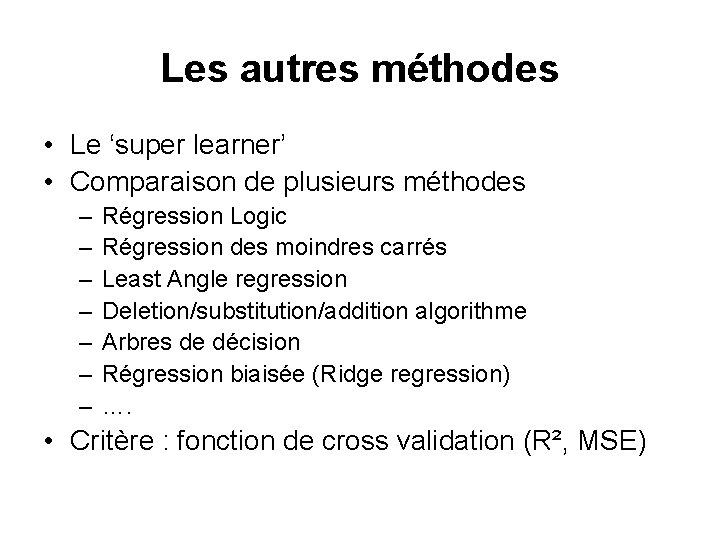
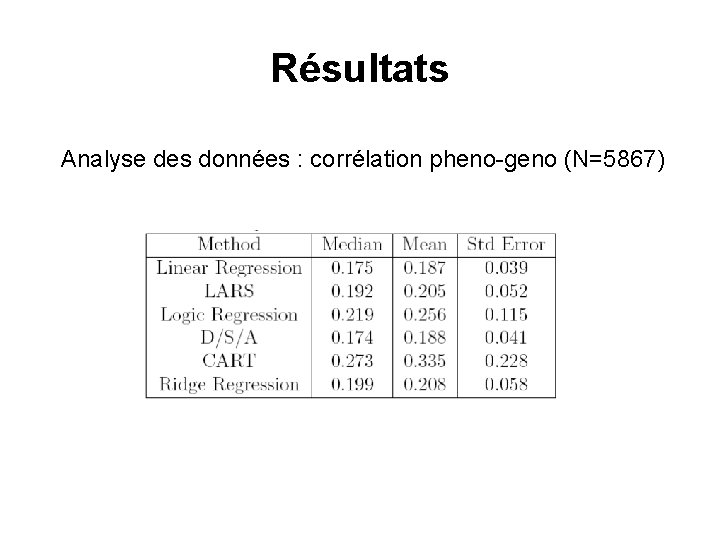
Les autres méthodes • Le ‘super learner’ • Comparaison de plusieurs méthodes – – – – Régression Logic Régression des moindres carrés Least Angle regression Deletion/substitution/addition algorithme Arbres de décision Régression biaisée (Ridge regression) …. • Critère : fonction de cross validation (R², MSE)
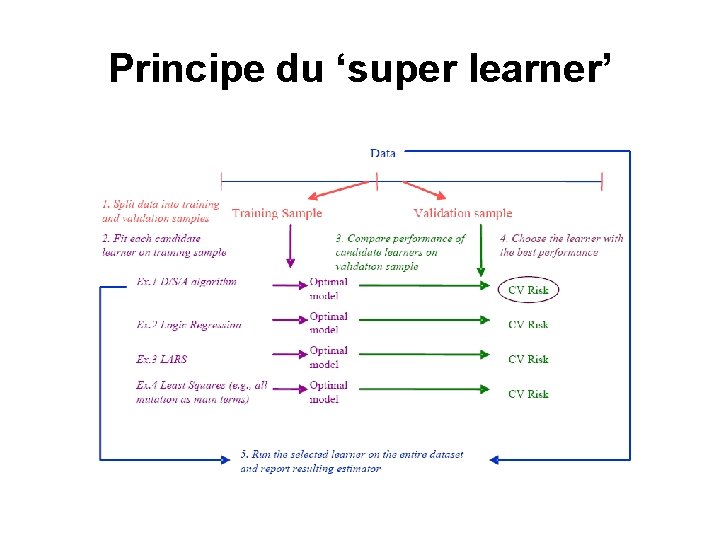
Principe du ‘super learner’
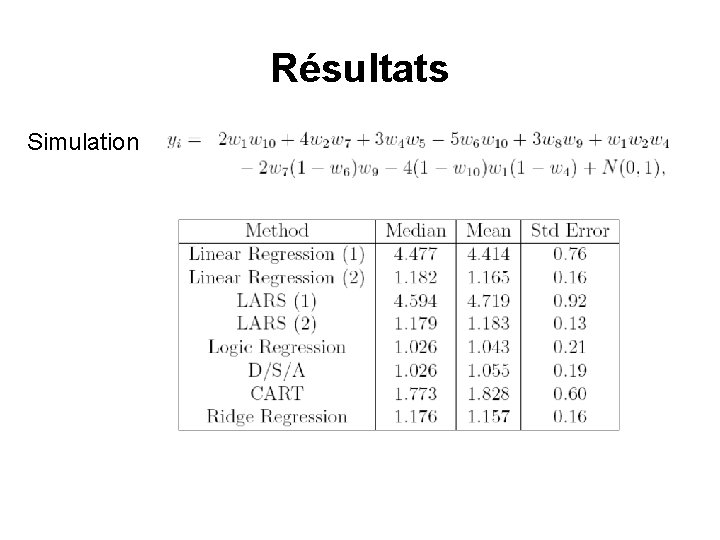
Résultats Simulation
Résultats Analyse des données : corrélation pheno-geno (N=5867)