
KONSEP DATA MINING Disusun Oleh Dr Lily Wulandari
- Slides: 47
KONSEP DATA MINING Disusun Oleh : Dr Lily Wulandari Universitas Gunadarma Logo Seminar
Tool Data Mining Dan Fungsinya Dalam Suatu Sistem
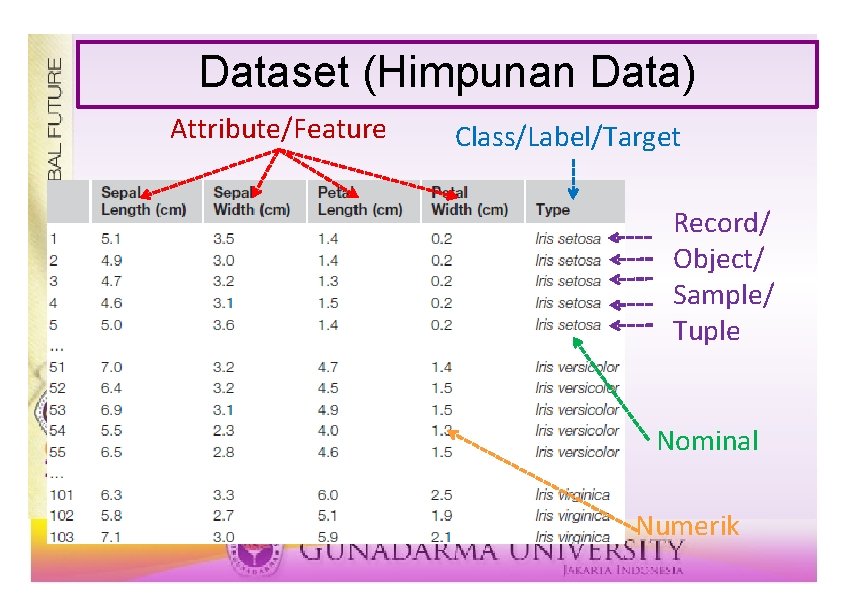
1. Himpunan Data (Dataset) • Atribut adalah faktor atau parameter yang menyebabkan class/label/target terjadi • Jenis dataset ada dua: Private dan Public • Private Dataset: data set dapat diambil dari organisasi yang kita jadikan obyek penelitian – Bank, Rumah Sakit, Industri, Pabrik, Perusahaan Jasa, etc 3
1. Himpunan Data (Dataset) • Public Dataset: data set dapat diambil dari repositori pubik yang disepakati oleh para peneliti data mining – UCI Repository (http: //www. ics. uci. edu/~mlearn/MLRepository. html) – ACM KDD Cup (http: //www. sigkdd. org/kddcup/) – Prediction. IO (http: //docs. prediction. io/datacollection/sample/) • Trend penelitian data mining saat ini adalah menguji metode yang dikembangkan oleh peneliti dengan public dataset, sehingga penelitian dapat bersifat: comparable, repeatable dan verifiable 4
Dataset (Himpunan Data) Attribute/Feature Class/Label/Target Record/ Object/ Sample/ Tuple Nominal 5 Numerik
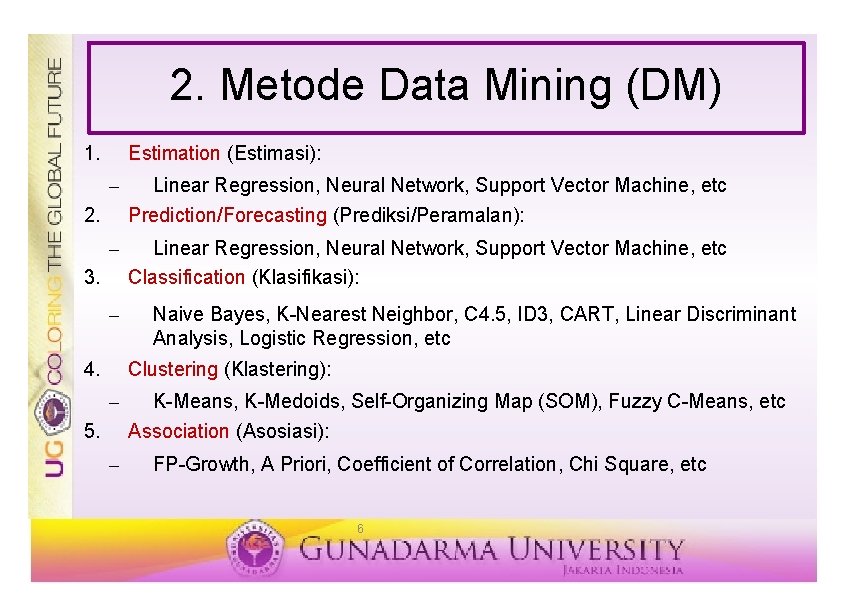
2. Metode Data Mining (DM) 1. Estimation (Estimasi): – Linear Regression, Neural Network, Support Vector Machine, etc Prediction/Forecasting (Prediksi/Peramalan): – Linear Regression, Neural Network, Support Vector Machine, etc Classification (Klasifikasi): 2. 3. – 4. Naive Bayes, K-Nearest Neighbor, C 4. 5, ID 3, CART, Linear Discriminant Analysis, Logistic Regression, etc Clustering (Klastering): – 5. – K-Means, K-Medoids, Self-Organizing Map (SOM), Fuzzy C-Means, etc Association (Asosiasi): FP-Growth, A Priori, Coefficient of Correlation, Chi Square, etc 6
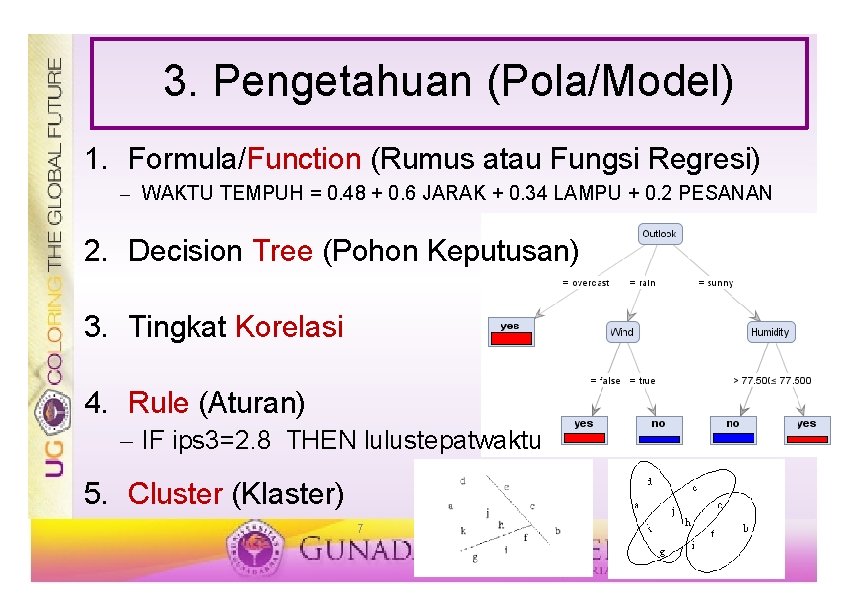
3. Pengetahuan (Pola/Model) 1. Formula/Function (Rumus atau Fungsi Regresi) – WAKTU TEMPUH = 0. 48 + 0. 6 JARAK + 0. 34 LAMPU + 0. 2 PESANAN 2. Decision Tree (Pohon Keputusan) 3. Tingkat Korelasi 4. Rule (Aturan) – IF ips 3=2. 8 THEN lulustepatwaktu 5. Cluster (Klaster) 7
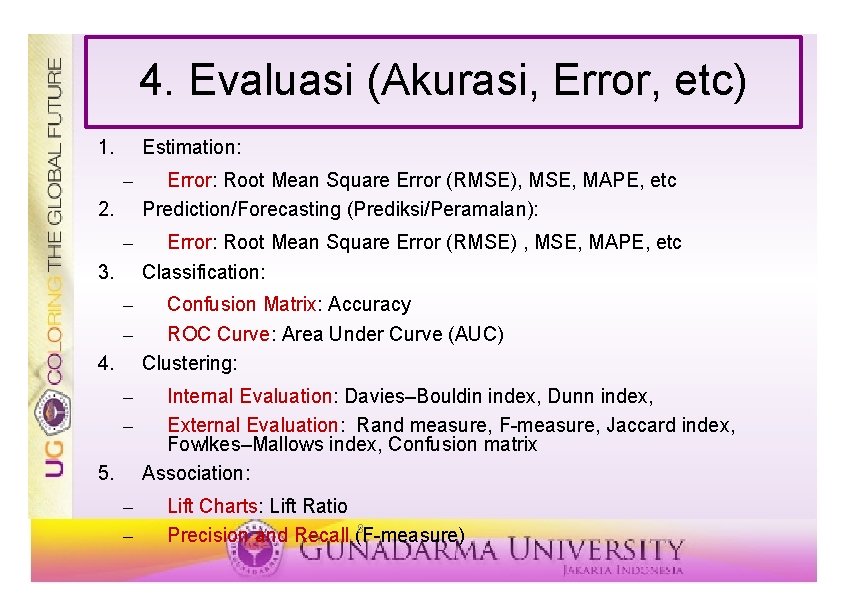
4. Evaluasi (Akurasi, Error, etc) 1. Estimation: – Error: Root Mean Square Error (RMSE), MSE, MAPE, etc Prediction/Forecasting (Prediksi/Peramalan): – Error: Root Mean Square Error (RMSE) , MSE, MAPE, etc Classification: – – Confusion Matrix: Accuracy ROC Curve: Area Under Curve (AUC) Clustering: – – Internal Evaluation: Davies–Bouldin index, Dunn index, External Evaluation: Rand measure, F-measure, Jaccard index, Fowlkes–Mallows index, Confusion matrix Association: 2. 3. 4. 5. – – Lift Charts: Lift Ratio 8 Precision and Recall (F-measure)
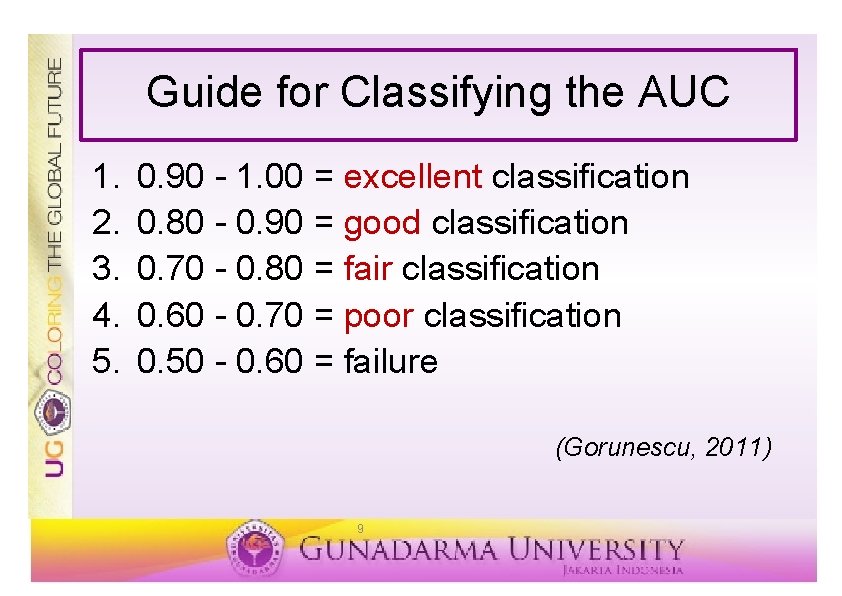
Guide for Classifying the AUC 1. 2. 3. 4. 5. 0. 90 - 1. 00 = excellent classification 0. 80 - 0. 90 = good classification 0. 70 - 0. 80 = fair classification 0. 60 - 0. 70 = poor classification 0. 50 - 0. 60 = failure (Gorunescu, 2011) 9
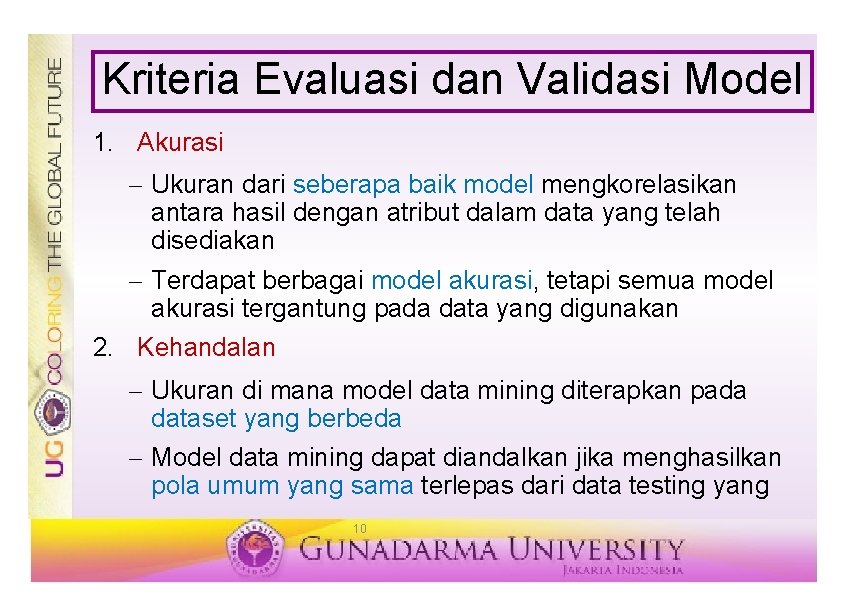
Kriteria Evaluasi dan Validasi Model 1. Akurasi – Ukuran dari seberapa baik model mengkorelasikan antara hasil dengan atribut dalam data yang telah disediakan – Terdapat berbagai model akurasi, tetapi semua model akurasi tergantung pada data yang digunakan 2. Kehandalan – Ukuran di mana model data mining diterapkan pada dataset yang berbeda – Model data mining dapat diandalkan jika menghasilkan pola umum yang sama terlepas dari data testing yang 10
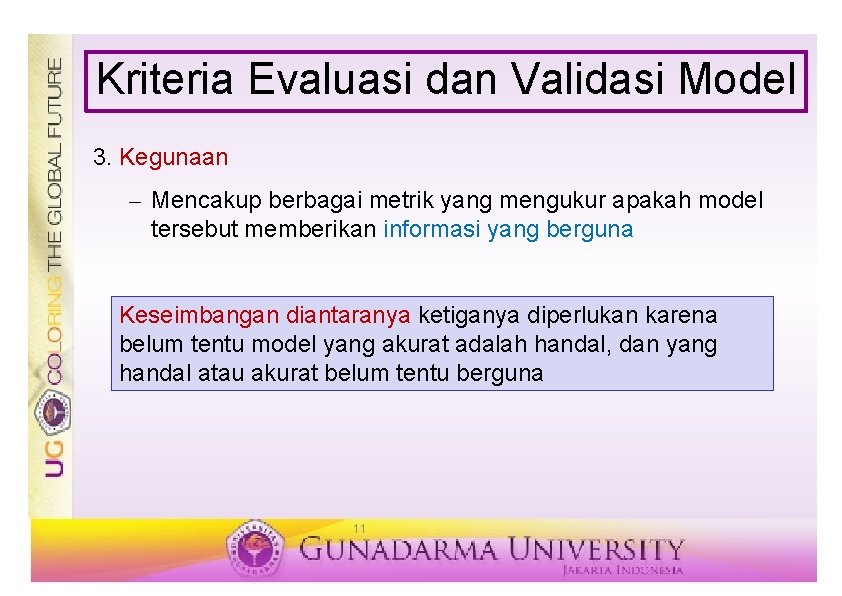
Kriteria Evaluasi dan Validasi Model 3. Kegunaan – Mencakup berbagai metrik yang mengukur apakah model tersebut memberikan informasi yang berguna Keseimbangan diantaranya ketiganya diperlukan karena belum tentu model yang akurat adalah handal, dan yang handal atau akurat belum tentu berguna 11
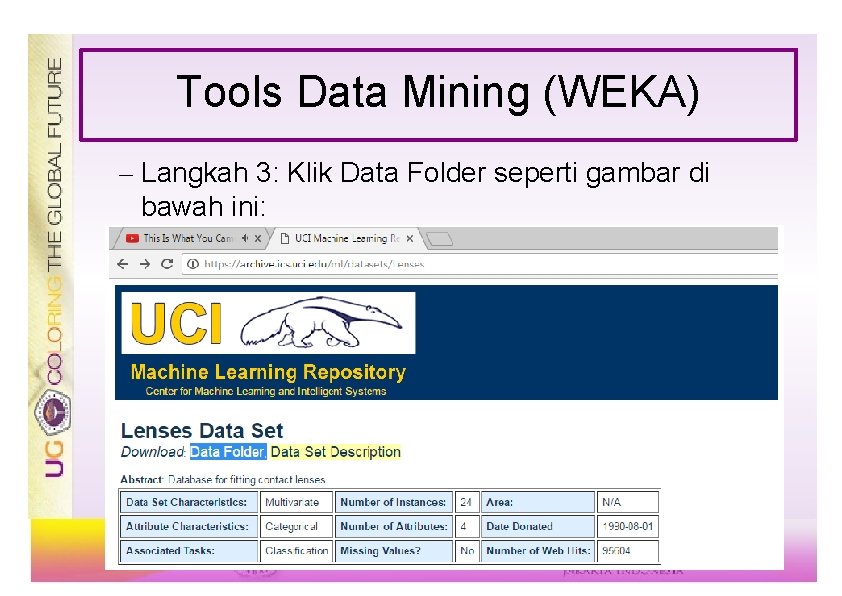
Tools Data Mining (WEKA) • Berikut ini contoh pemakaian WEKA untuk fungsi Data Mining klasifikasi. • Langkah-langkah persiapan data: – Langkah 1: Buka link https: //archive. ics. uci. edu/ml/datasets. html – Langkah 2: Pilihlah satu dataset yang diinginkan. Pada contoh kali ini digunakan dataset lenses (https: //archive. ics. uci. edu/ml/datasets/Lenses).
Tools Data Mining (WEKA) – Langkah 3: Klik Data Folder seperti gambar di bawah ini:
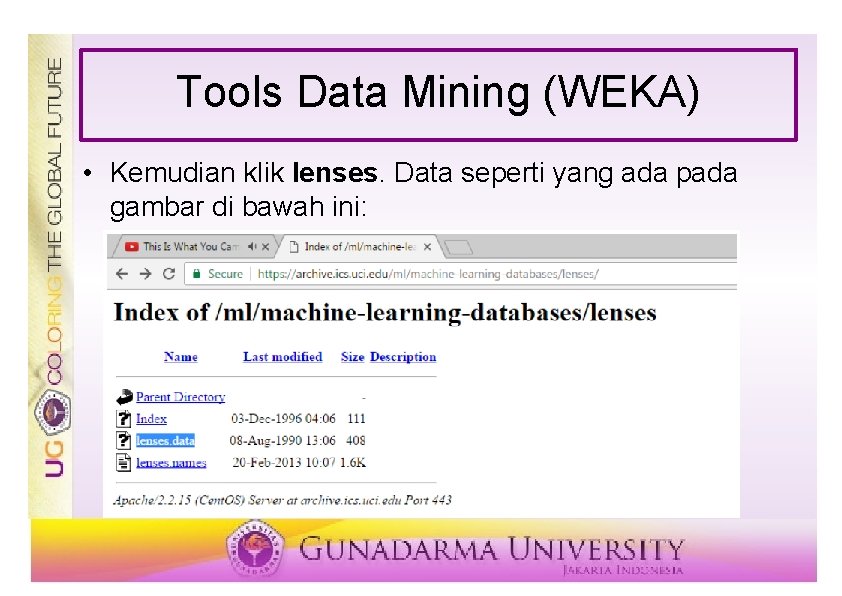
Tools Data Mining (WEKA) • Kemudian klik lenses. Data seperti yang ada pada gambar di bawah ini:
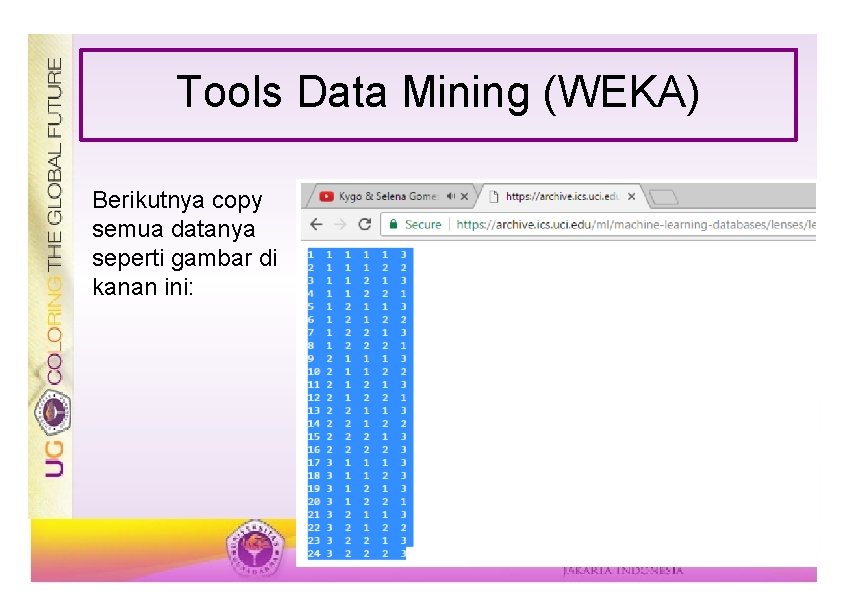
Tools Data Mining (WEKA) Berikutnya copy semua datanya seperti gambar di kanan ini:
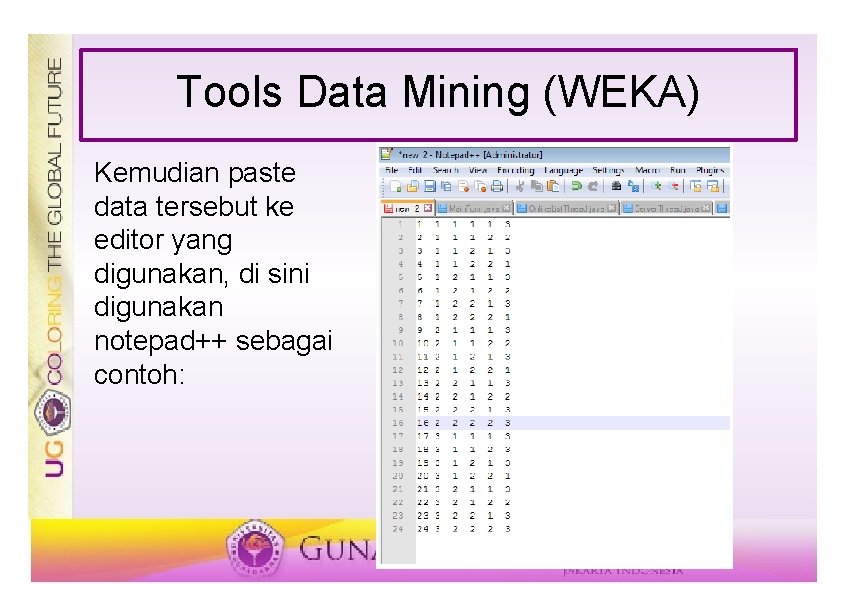
Tools Data Mining (WEKA) Kemudian paste data tersebut ke editor yang digunakan, di sini digunakan notepad++ sebagai contoh:
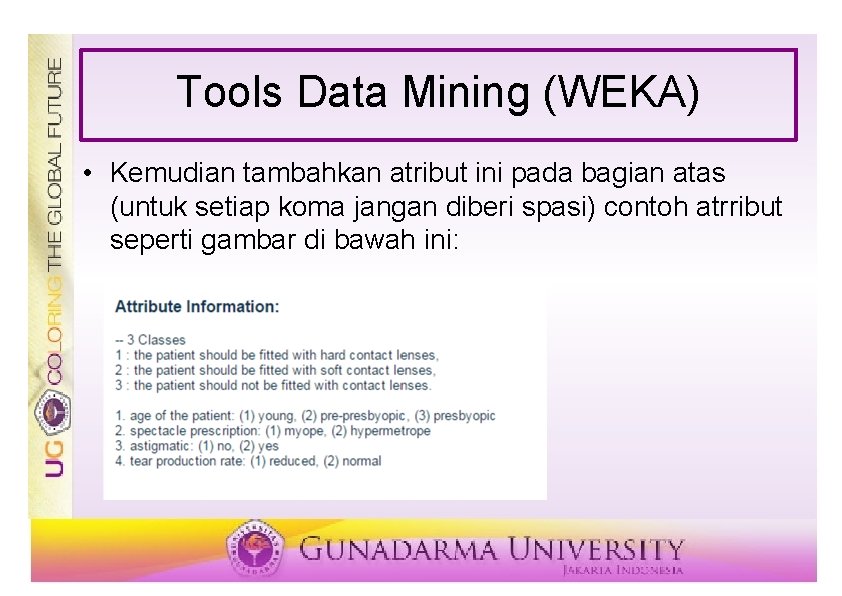
Tools Data Mining (WEKA) • Kemudian tambahkan atribut ini pada bagian atas (untuk setiap koma jangan diberi spasi) contoh atrribut seperti gambar di bawah ini:
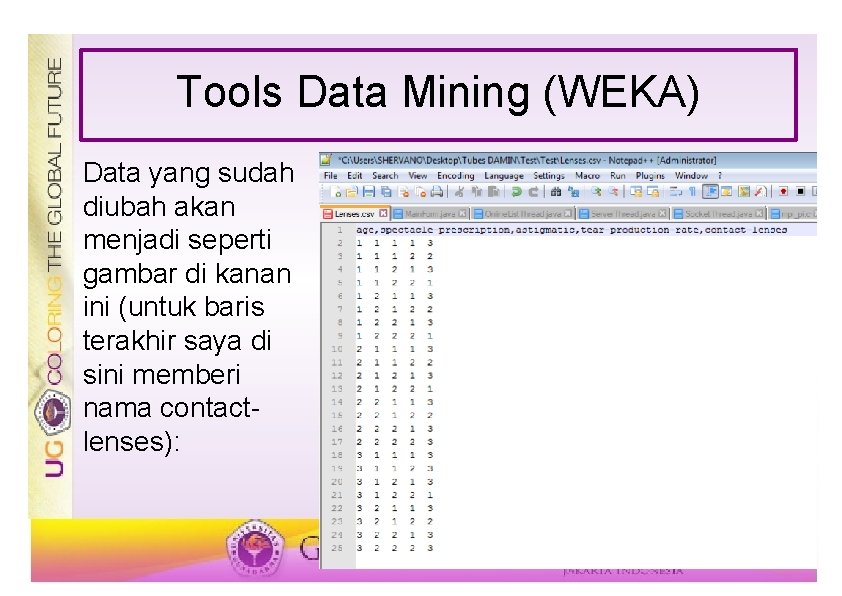
Tools Data Mining (WEKA) Data yang sudah diubah akan menjadi seperti gambar di kanan ini (untuk baris terakhir saya di sini memberi nama contactlenses):
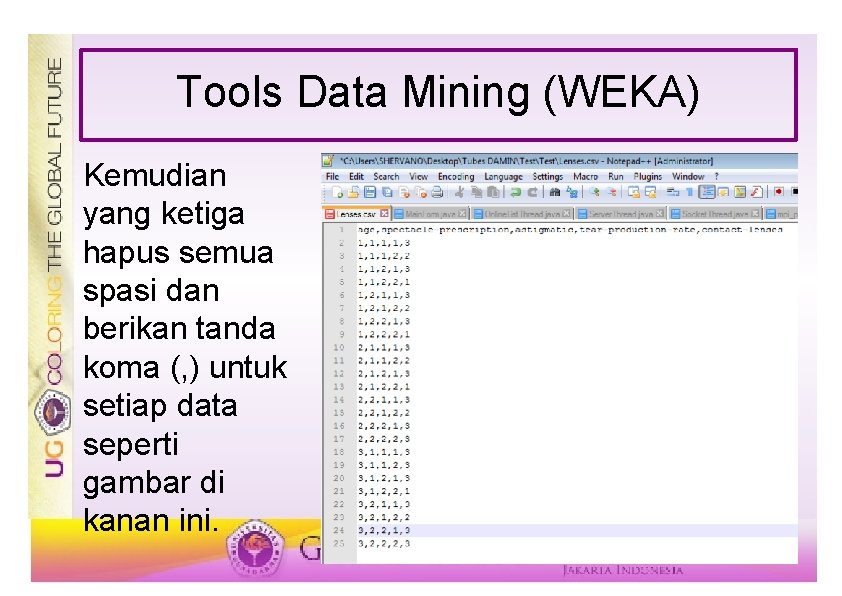
Tools Data Mining (WEKA) Kemudian yang ketiga hapus semua spasi dan berikan tanda koma (, ) untuk setiap data seperti gambar di kanan ini.
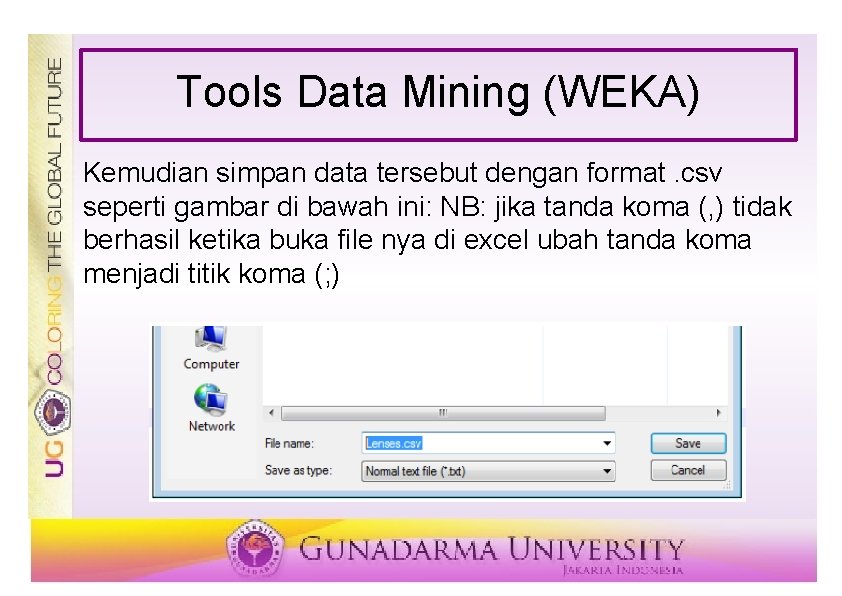
Tools Data Mining (WEKA) Kemudian simpan data tersebut dengan format. csv seperti gambar di bawah ini: NB: jika tanda koma (, ) tidak berhasil ketika buka file nya di excel ubah tanda koma menjadi titik koma (; )
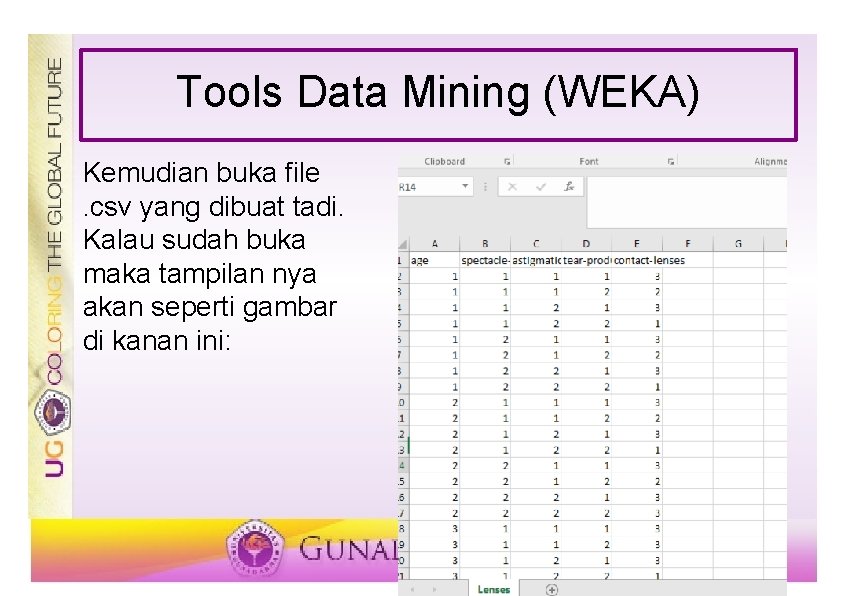
Tools Data Mining (WEKA) Kemudian buka file. csv yang dibuat tadi. Kalau sudah buka maka tampilan nya akan seperti gambar di kanan ini:
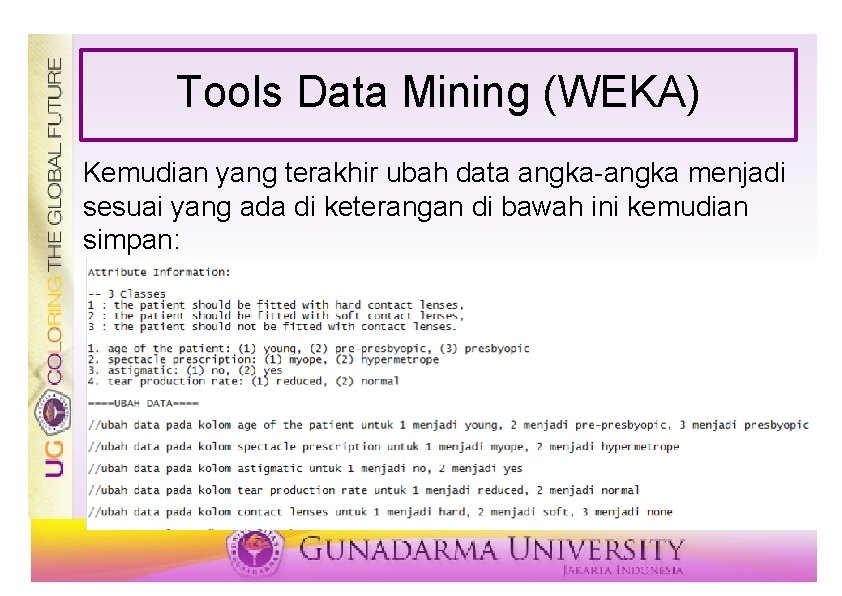
Tools Data Mining (WEKA) Kemudian yang terakhir ubah data angka-angka menjadi sesuai yang ada di keterangan di bawah ini kemudian simpan:
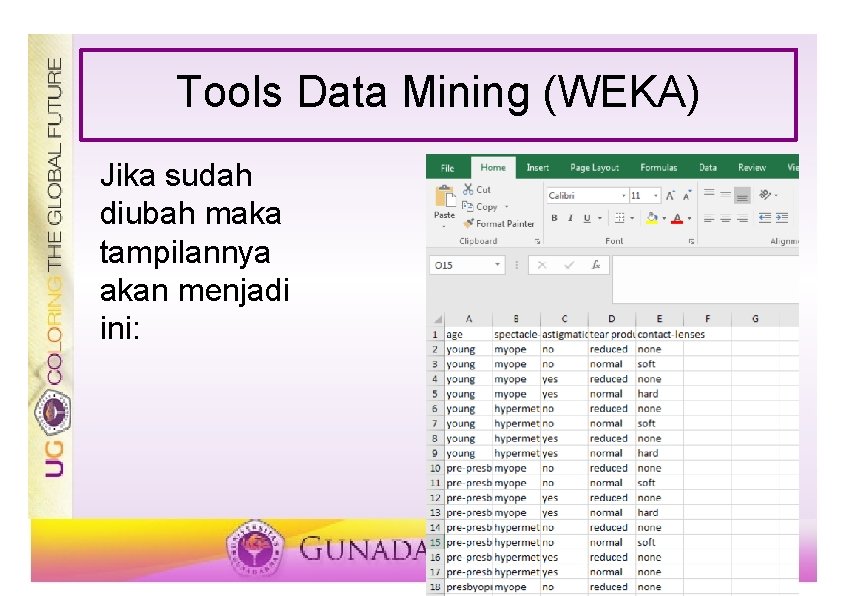
Tools Data Mining (WEKA) Jika sudah diubah maka tampilannya akan menjadi ini:
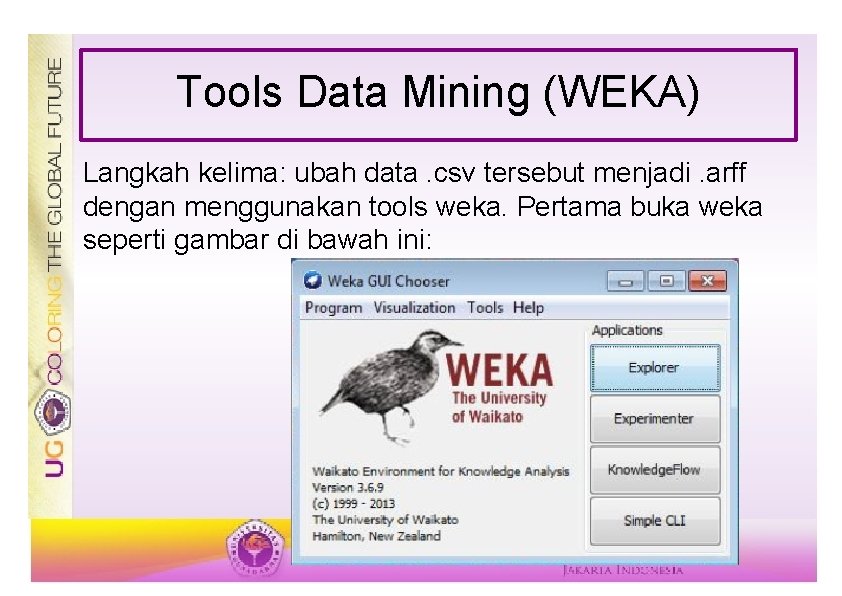
Tools Data Mining (WEKA) Langkah kelima: ubah data. csv tersebut menjadi. arff dengan menggunakan tools weka. Pertama buka weka seperti gambar di bawah ini:
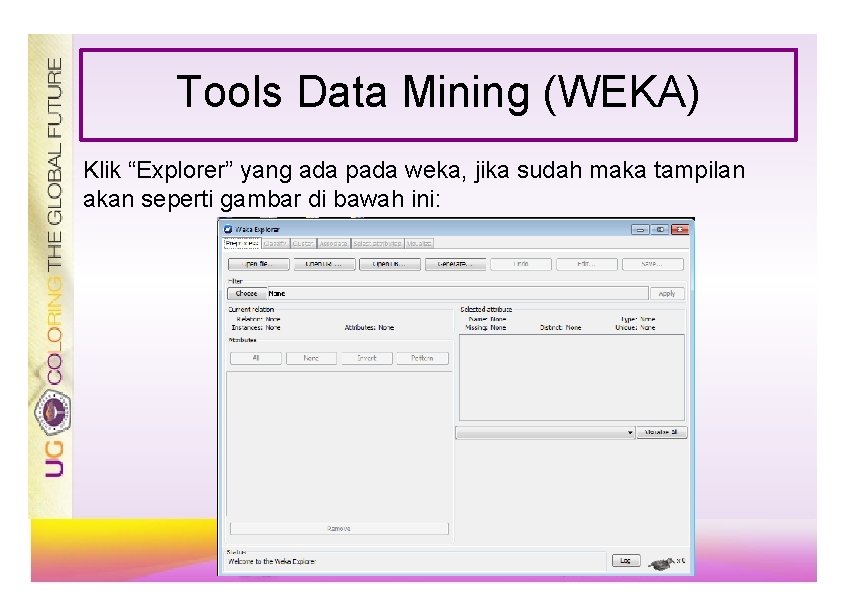
Tools Data Mining (WEKA) Klik “Explorer” yang ada pada weka, jika sudah maka tampilan akan seperti gambar di bawah ini:
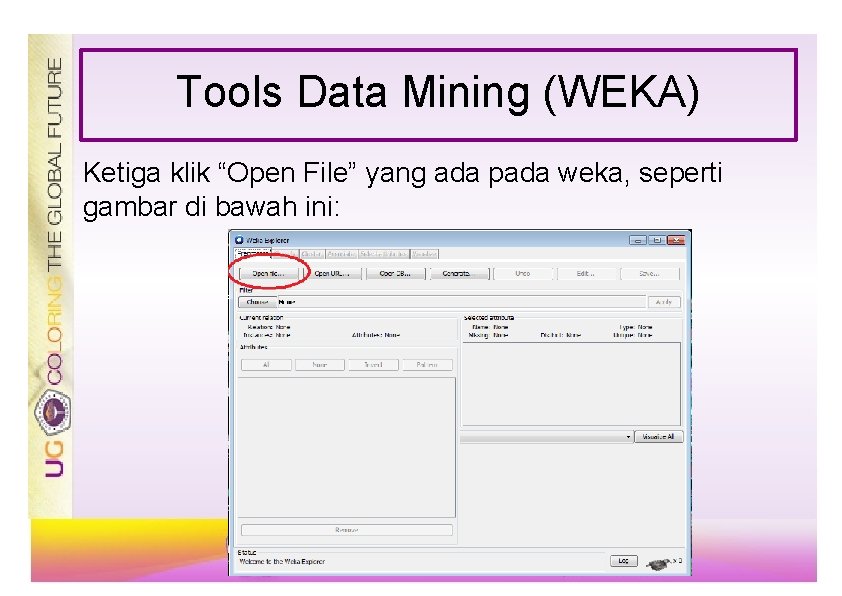
Tools Data Mining (WEKA) Ketiga klik “Open File” yang ada pada weka, seperti gambar di bawah ini:
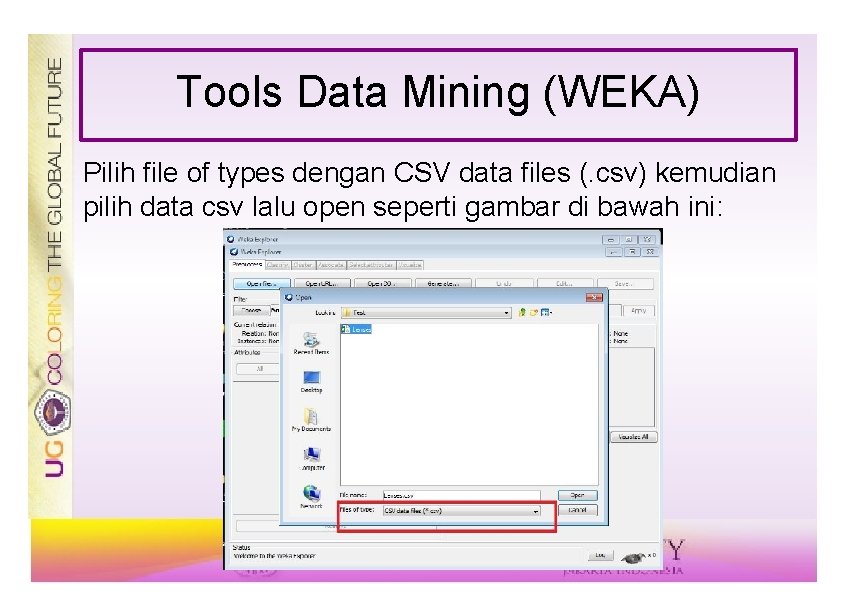
Tools Data Mining (WEKA) Pilih file of types dengan CSV data files (. csv) kemudian pilih data csv lalu open seperti gambar di bawah ini:
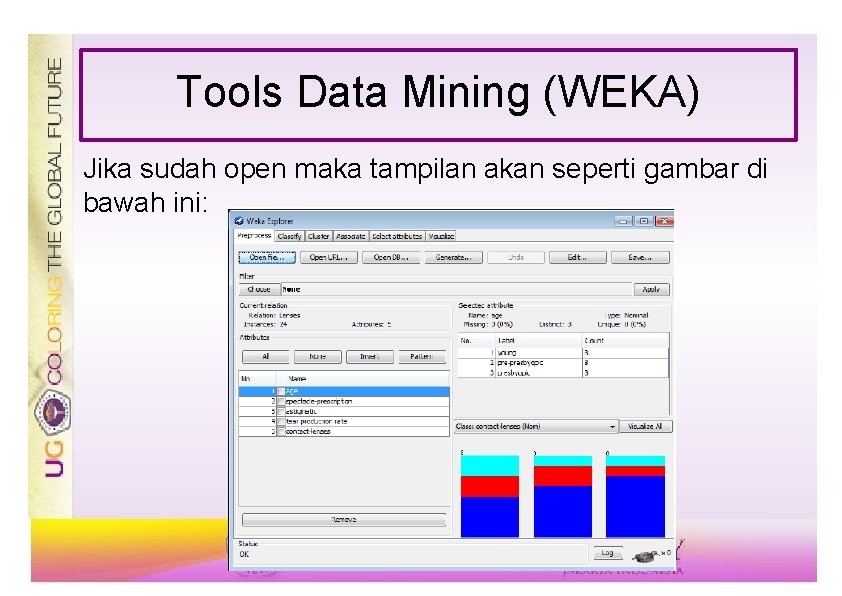
Tools Data Mining (WEKA) Jika sudah open maka tampilan akan seperti gambar di bawah ini:
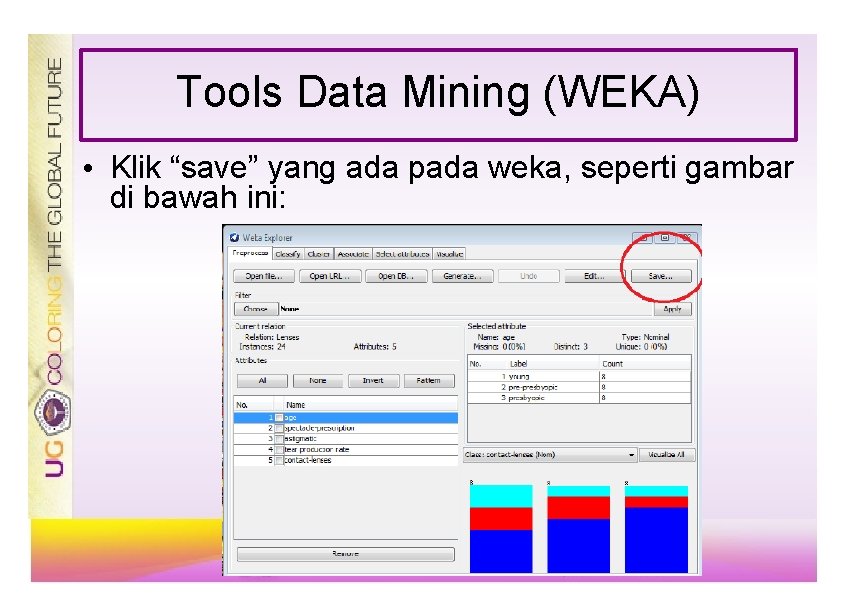
Tools Data Mining (WEKA) • Klik “save” yang ada pada weka, seperti gambar di bawah ini:
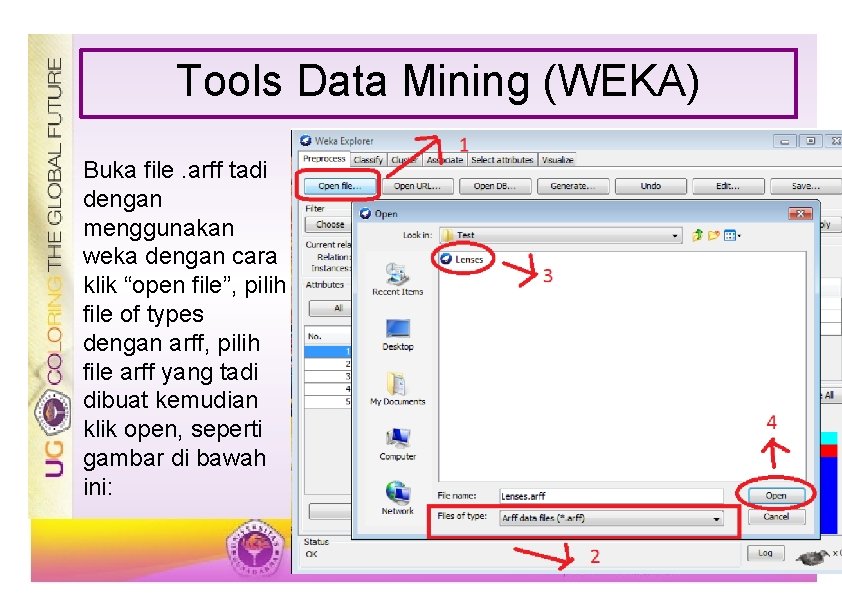
Tools Data Mining (WEKA) Buka file. arff tadi dengan menggunakan weka dengan cara klik “open file”, pilih file of types dengan arff, pilih file arff yang tadi dibuat kemudian klik open, seperti gambar di bawah ini:
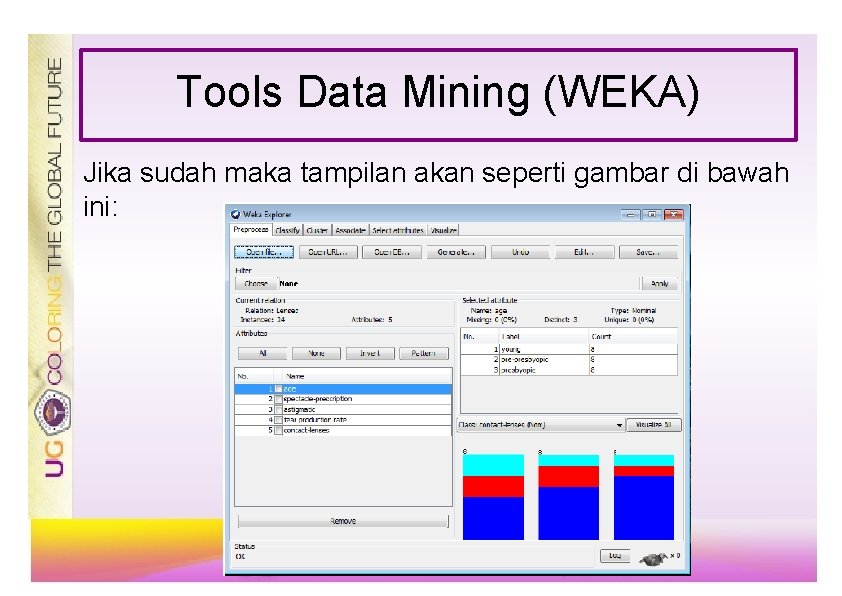
Tools Data Mining (WEKA) Jika sudah maka tampilan akan seperti gambar di bawah ini:
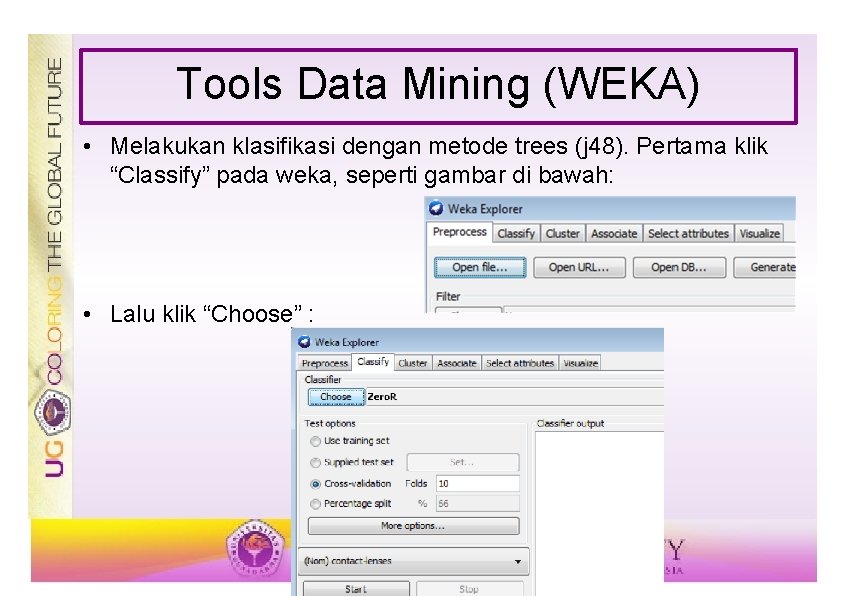
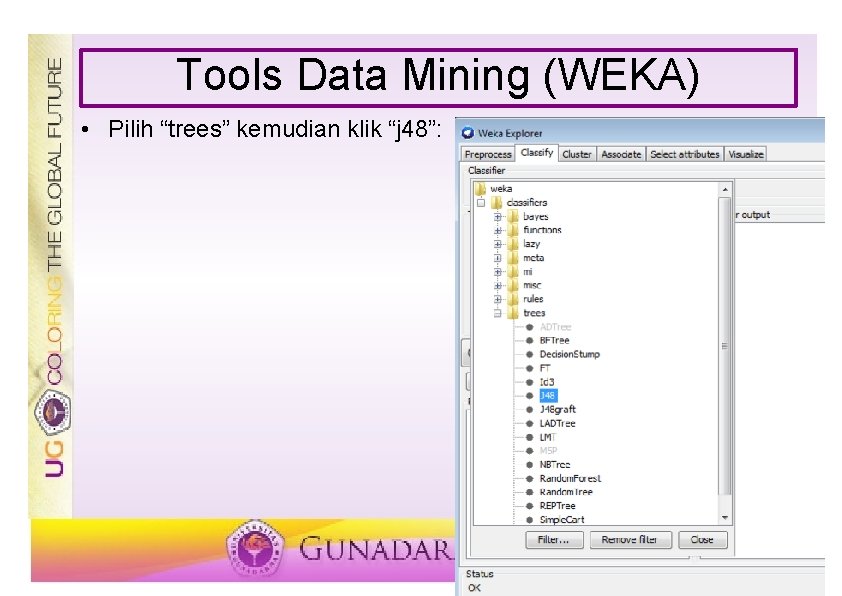
Tools Data Mining (WEKA) • Melakukan klasifikasi dengan metode trees (j 48). Pertama klik “Classify” pada weka, seperti gambar di bawah: • Lalu klik “Choose” :
Tools Data Mining (WEKA) • Pilih “trees” kemudian klik “j 48”:
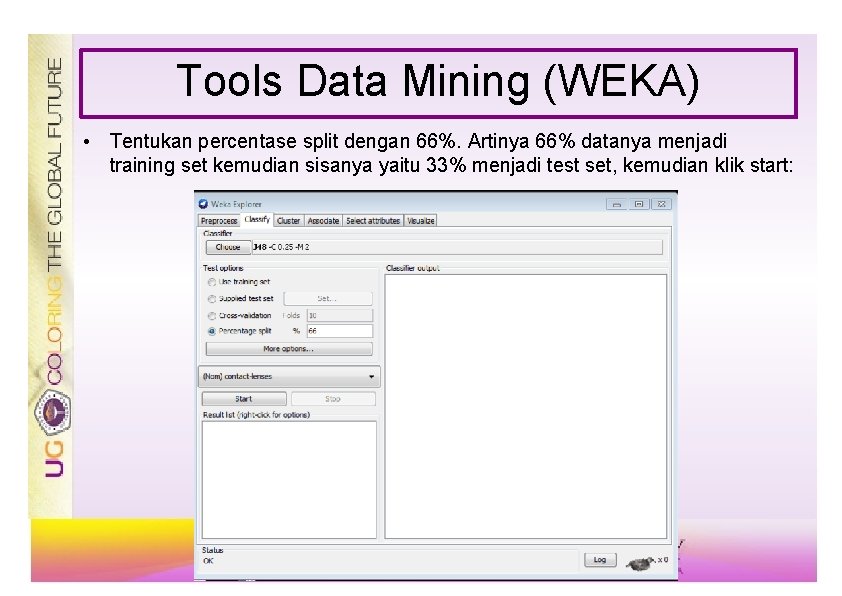
Tools Data Mining (WEKA) • Tentukan percentase split dengan 66%. Artinya 66% datanya menjadi training set kemudian sisanya yaitu 33% menjadi test set, kemudian klik start:
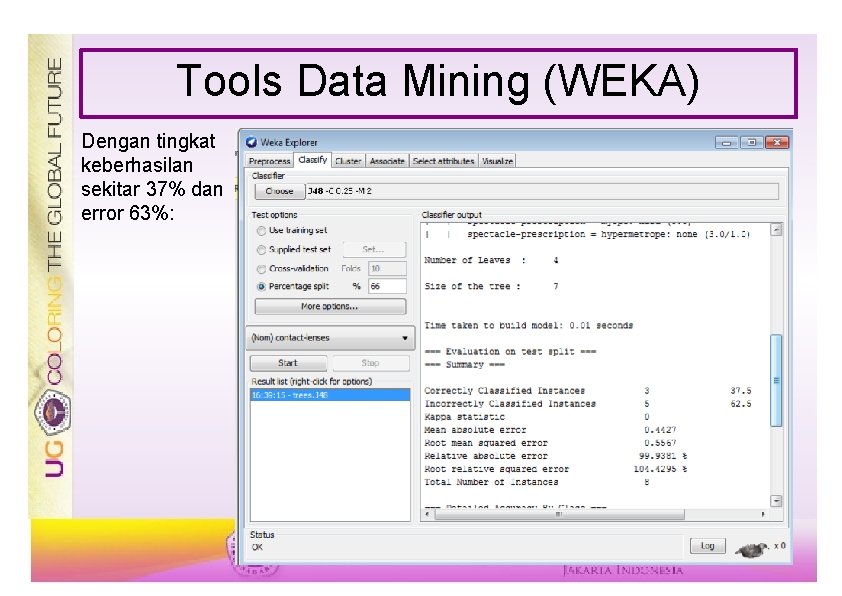
Tools Data Mining (WEKA) Dengan tingkat keberhasilan sekitar 37% dan error 63%:
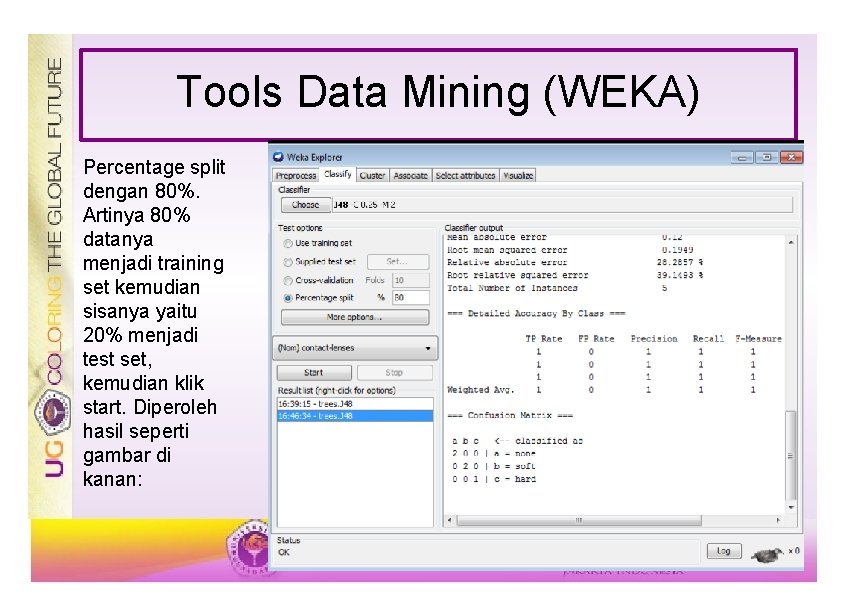
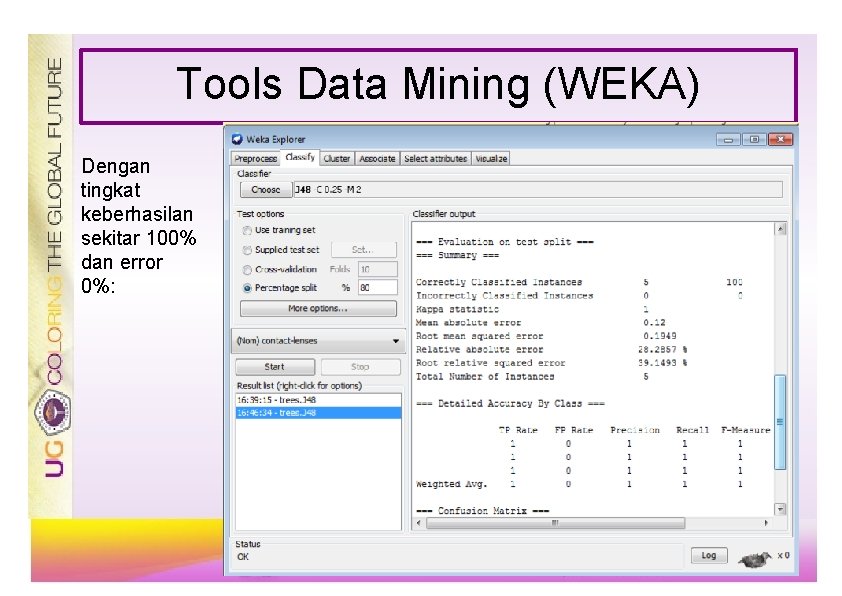
Tools Data Mining (WEKA) Percentage split dengan 80%. Artinya 80% datanya menjadi training set kemudian sisanya yaitu 20% menjadi test set, kemudian klik start. Diperoleh hasil seperti gambar di kanan:
Tools Data Mining (WEKA) Dengan tingkat keberhasilan sekitar 100% dan error 0%:
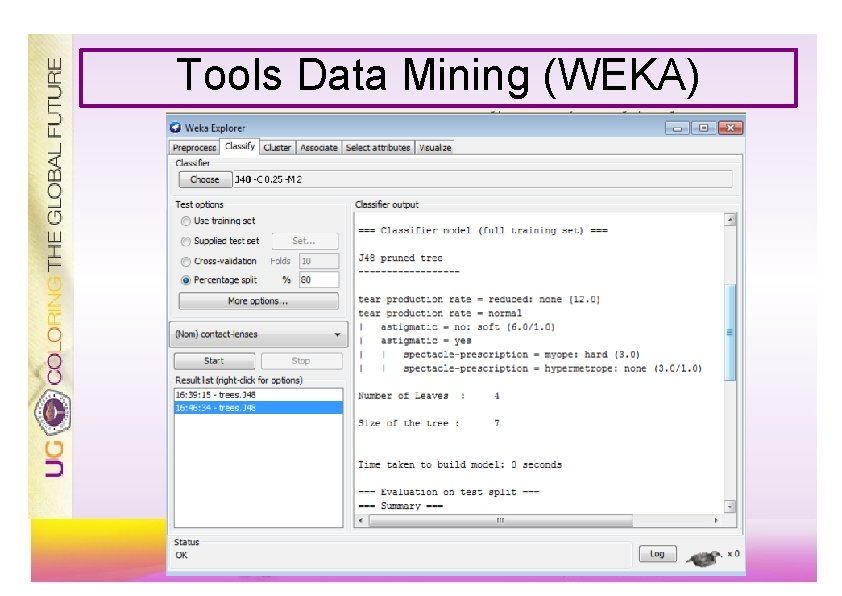
Tools Data Mining (WEKA)
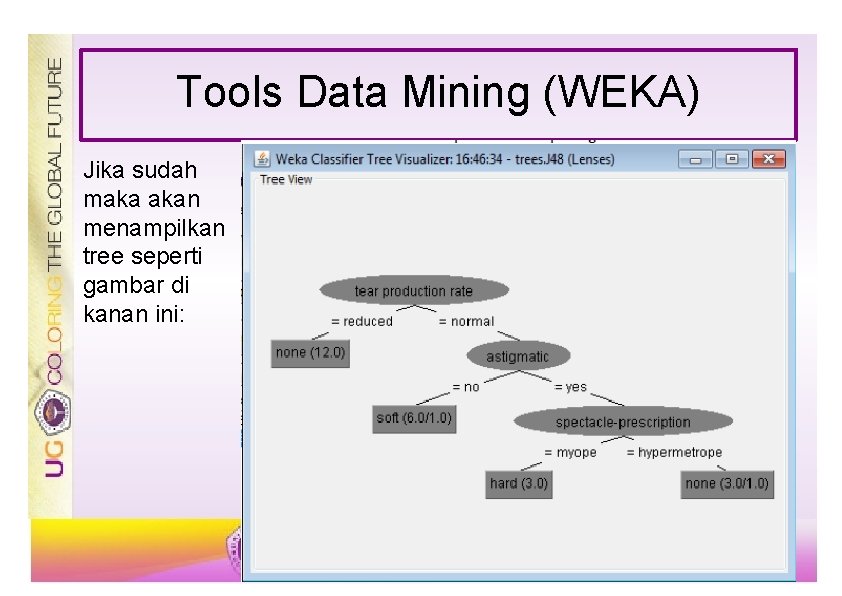
Tools Data Mining (WEKA) Makna dari hasil model ini dapat dibaca sbb: • tear production rate nya reduced maka none (artinya pasien tidak harus dilengkapi dengan lensa kontak. ) • jika tear production rate nya normal (artinya jika Tingkat produksi air mata normal dalam artian tidak ada perubahan) – lihat jika astigmatic no maka soft (artinya jika astigmatic no maka pasien harus dilengkapi dengan lensa kontak soft) – jika astigmatic nya yes • maka liat lagi spectacle prescription (kondisi) jika pasien myope (rabun jauh) berarti pasien harus dilengkapi dengan lensa kontak hard, • sedangkan jika pasien hypermetrope (rabun dekat) maka pasien tidak harus dilengkapi dengan lensa kontak.
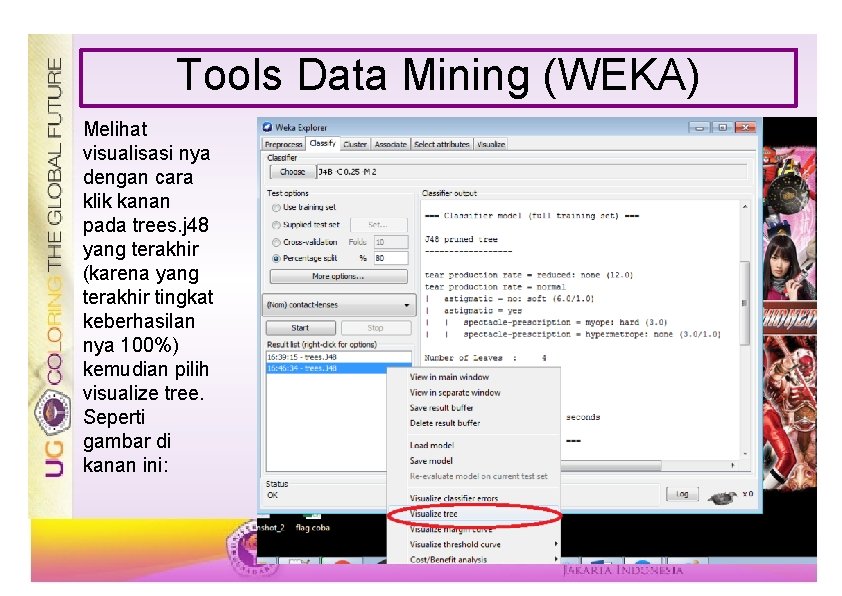
Tools Data Mining (WEKA) Melihat visualisasi nya dengan cara klik kanan pada trees. j 48 yang terakhir (karena yang terakhir tingkat keberhasilan nya 100%) kemudian pilih visualize tree. Seperti gambar di kanan ini:
Tools Data Mining (WEKA) Jika sudah maka akan menampilkan tree seperti gambar di kanan ini:
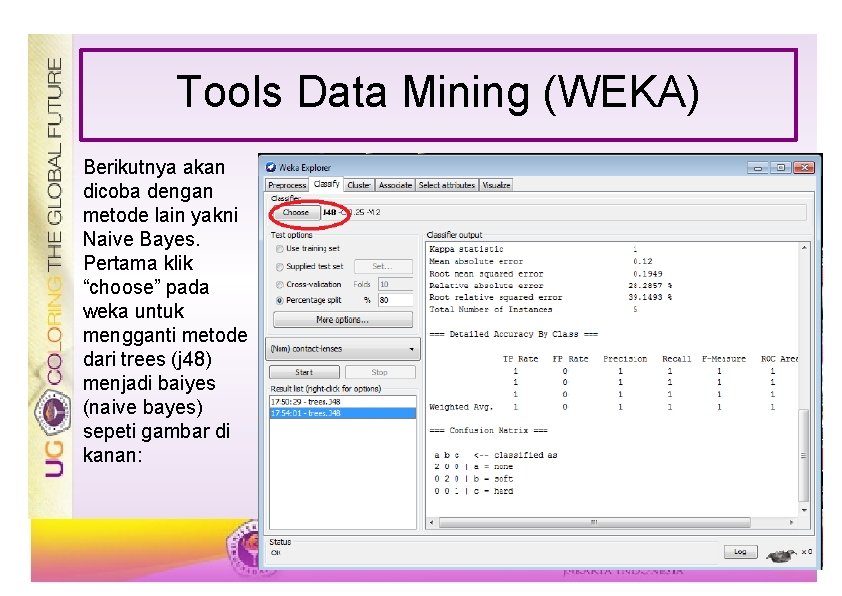
Tools Data Mining (WEKA) Berikutnya akan dicoba dengan metode lain yakni Naive Bayes. Pertama klik “choose” pada weka untuk mengganti metode dari trees (j 48) menjadi baiyes (naive bayes) sepeti gambar di kanan:
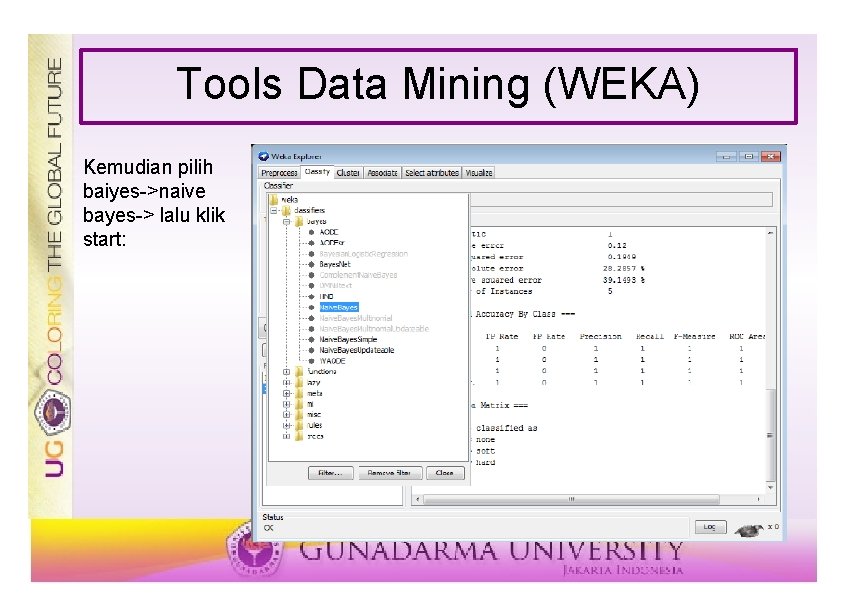
Tools Data Mining (WEKA) Kemudian pilih baiyes->naive bayes-> lalu klik start:
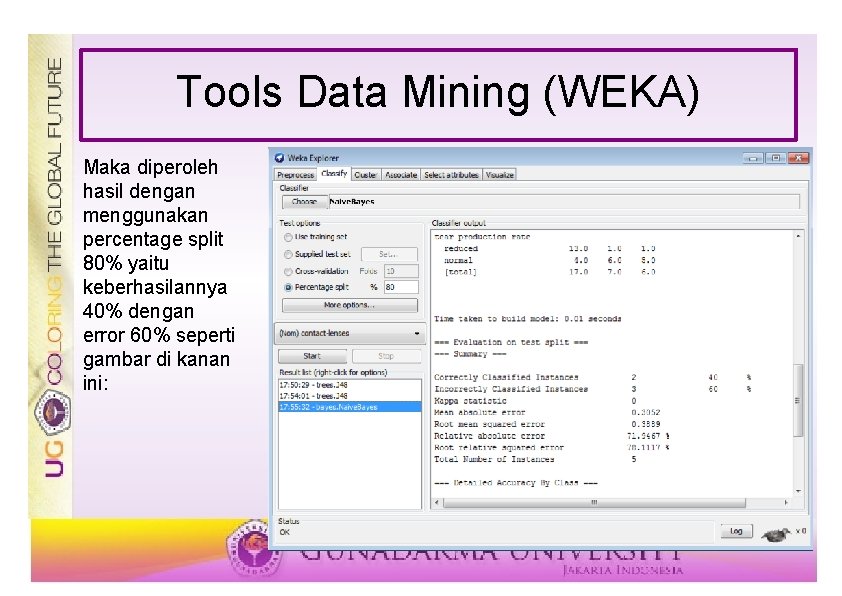
Tools Data Mining (WEKA) Maka diperoleh hasil dengan menggunakan percentage split 80% yaitu keberhasilannya 40% dengan error 60% seperti gambar di kanan ini:
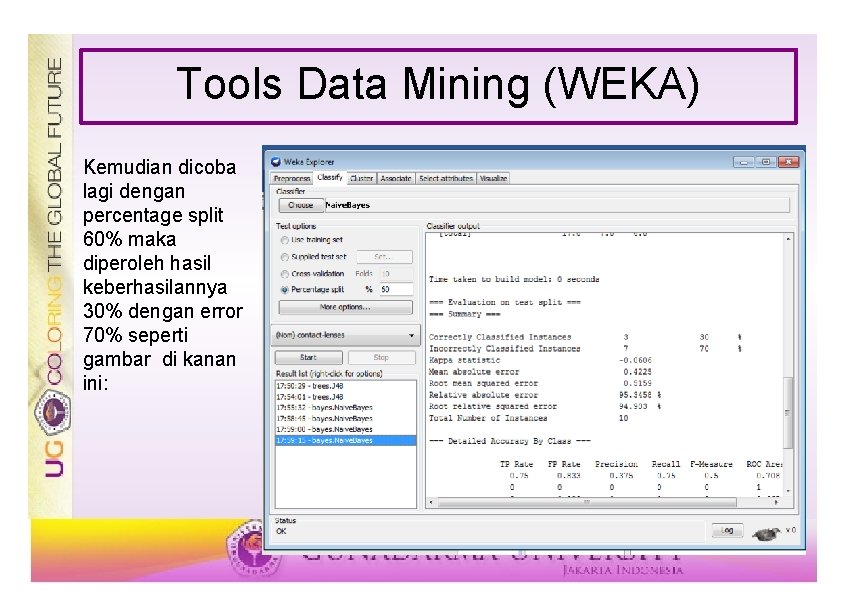
Tools Data Mining (WEKA) Kemudian dicoba lagi dengan percentage split 60% maka diperoleh hasil keberhasilannya 30% dengan error 70% seperti gambar di kanan ini:
Tools Data Mining (WEKA) • Jadi kesimpulannya setelah melakukan percobaan klasifikasi dengan menggunakan metode trees (j 48) dan bayes (naive bayes) dan menggunakan dataset “Lenses” maka dapat disumpulkan pengklasifikasiannya lebih baik menggunakan metode tree (j 48) karena keberhasilannya 100% sedangkan metode bayes (naive bayes) keberhasilannya hanya 40%.