
Kodiranje slovnih znakova Razvojem Interneta i meunarodne komunikacije
- Slides: 24
Kodiranje slovnih znakova
► Razvojem Interneta i međunarodne komunikacije putem računala počeo se pojavljivati problem prikaza slovnih znakova na različitim računalima, tipkovnicama, različitim jezicima i pismima ► Većina zemalja u svijetu je raspored slovnih znakova na tipkovnicama računala prilagođavala svojem jeziku i svojim specifičnim znakovima
► Slovne znakove računalo prepoznaje kao kodove (brojeve) ► Masovnom upotrebom Interneta i elektroničke pošte nastaje problem prikaza slovnih znakova na računalima ► Komunikacija među ljudima koji se nalaze u različitim dijelovima svijeta bila je otežana
► različitim slovnim znakovima dodjeljivane su iste kodne pozicije ► Problemi prepoznavanja koda i prikaza su najčešći kod specifičnih znakova unutar jednog jezika ► Slovni znakovi latiničnog pisma kojima se koristi engleski jezik prvi su dobili jedinstvene kodove koji se koriste u cijelom svijetu
Model kodiranja ► Model kodiranja sastoji se od četiri osnovne razine prikazivanja, a to su: 1. repertoar znakova; 2. set kodiranih znakova; 3. algoritam za kodiranje; 4. shema kodiranja znakova.
► Repertoar znakova je skup svih znakova koje je potrebno kodirati ► Skup tih znakova može biti otvoren kao kod UNICODE-a ili zatvoren kao u drugim kodnim sustavima (ASCII, ANSI) ► Otvoreni skup znakova može se dodatno proširivati dodavanjem novih znakova
► Set kodiranih znakova je dobiven mapiranjem iz nekog repertoara u set kodova, odnosno cijelih brojeva ► Svakom znaku iz repertoara dodijeljuje se jedinstveni broj, odnosno kodna pozicija ► Niz brojeva (kodova) ne mora ići po redu, već se može ostaviti puno praznina za buduću upotrebu ili kontrolne funkcije
► Algoritam za kodiranje je metoda za prikaz znakova u digitalnom obliku ► Vrši se mapiranje kodnih pozicija u podatkovni niz (8 bitni kod, 16 bitni kod, 32 bitni kod) ► Shema kodiranja znakova je način mapiranja koda. Govori kojim redom su poslagani bajtovi u 16 i 32 bitnim kodovima ► U heksadecimalnom sustavu 16 -bitno kodiranje ima raspon od 0000 do FFFF
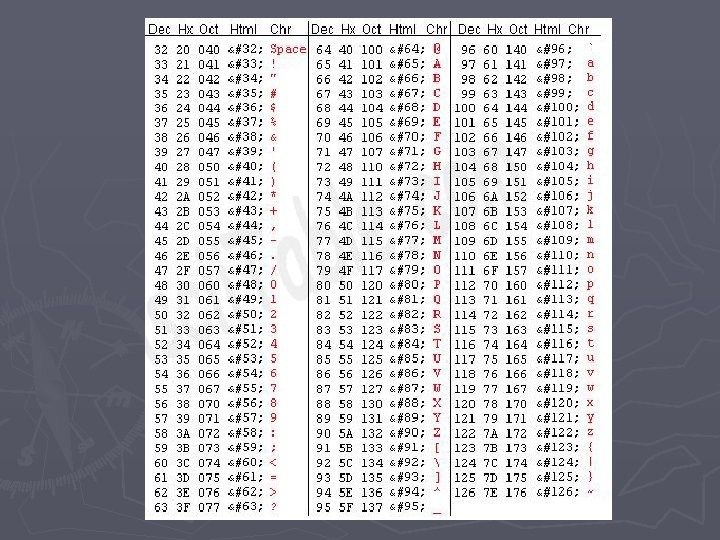
Kodni sustavi ASCII ili ISO 646 ► American Standard Code for Information Interchange je najstariji kodni sustav i temelji se na 8 bitnom kodiranju ► U decimalnom sustavu kodiranje u ASCII standardu kreće od broja 32, pod kojim se nalazi praznina (razmak) do broja 126 pod kojim se nalazi tilda. ► Kodovi od 0 - 31 i 127 rezervirani su za kontrolne kodove (sistemske komande) Pozicije od 128 do 255 se ne koriste u ASCII-u
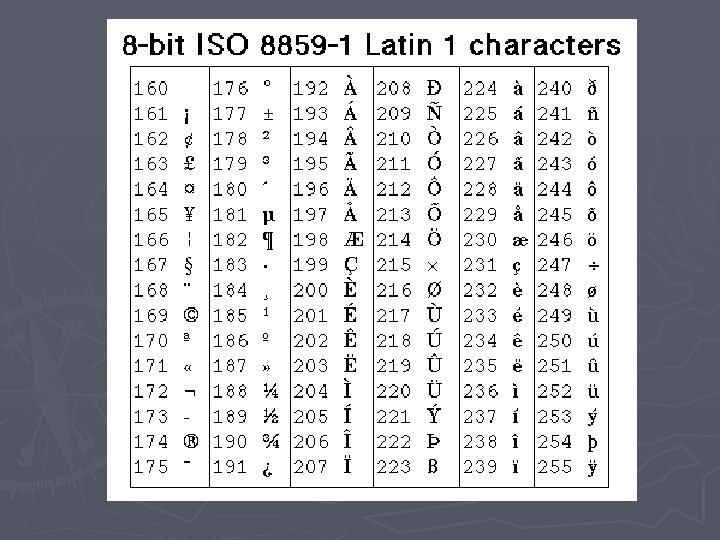
ISO Latin 1 ili ISO 8859 -1 ► Kodni susutav Latin 1 je 8 -bitni kodni sustav. Sadrži kodove od 160 do 255 to su znakovi sa naglascima i druga slova potrebna za pisanje u zapadnoj Europi i ASCII podskup znakova koji se nalaze na istim kodnim pozicijama. Tekstovi pisani ASCII kodnim sustavom izgledaju jednako i ako se čitaju nekim Latin 1 fontom zbog istih kodnih pozicija znakova.
► ISO Latin 2 je sustav kodiranja koji u sebi sadrži slova potrebna za pisanje u jezicima srednje Europe ► On u sebi sadrži specifične znakove hrvatske abecede
UNICODE ili ISO 10646 ► Unicode se kao standard razvija od 1988. godine , a 1991. godine je utemeljen UNICODE konzorcij kao neprofitna organizacija. UNICODE konzorcij čine: Apple, HP, IBM, Microsoft, Oracle, SAP, SAM. Nastao je iz potrebe za standardiziranom i univerzalnom shemom šifriranja pisanih znakova i teksta. UNICODE omogućuje internacionalnu izmjenu tekstovnih podataka, podržava sve svjetske jezike i pokriva područje egzotičnih jezičnih skupina.
► UNICODE tablica – font prvobitno je mogla prihvatiti 65 535 znakova ► Temelji se na 16 -bitnom kodiranju ► Znakovi imaju jedinstvene kodne brojeve izražene u heksadecimalnom obliku i mogu biti od 0000 do FFFF ► To nije zatvoreni sustav; može nadopunjavati svoj skup znakova
► Uvidjelo se da je prvobitnih 65 535 kodnih pozicija malo pa se raspon proširio i sada može prihvatiti 1 114 111 znakova Osnovni standardi kodiranja unutar UNICODE-a su UTF 32, UTF 16 i UTF 8 ► UTF 32 troši 4 bajta, odnosno 32 bita po kodnoj poziciji i koristi se za specijalne primjene. ►
► UTF 16 troši 2 bajta, odnosno 16 bitova po kodnoj poziciji ► UTF 8 je najrašireniji standard kodiranja ► Takozvani ASCII repertoar od 0 do 128 predstavlja se kao jedan bajt za svaki znak. Svi drugi kodovi prikazani su tako da se jedan znak predstavlja kao niz od 2 do 4 bajta od kojih je svaki u rasponu od 128 do 255
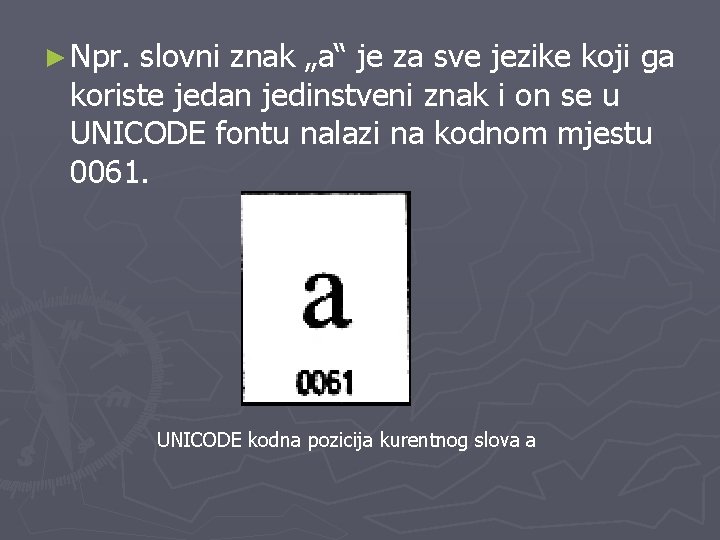
► Npr. slovni znak „a“ je za sve jezike koji ga koriste jedan jedinstveni znak i on se u UNICODE fontu nalazi na kodnom mjestu 0061. UNICODE kodna pozicija kurentnog slova a
► UNICODE font je organiziran tako da su u njemu slovni znakovi složeni po kodnim tablicama ► Ne dopušta višestruko šifriranje istog znaka, niti dopušta da više znakova imaju istu šifru ► Zadržao je kodni dio ASCII i ANSI standarda koji imaju 256 kodnih pozicija.
► Pisani tekstovi izgledaju besprijekorno ako se gledaju nekim UNICODE fontom ► UNICODE rješava odnos Interneta i tiskovine, gdje se pod pojmom interneta podrazumijeva komunikacija pismima različitih naroda
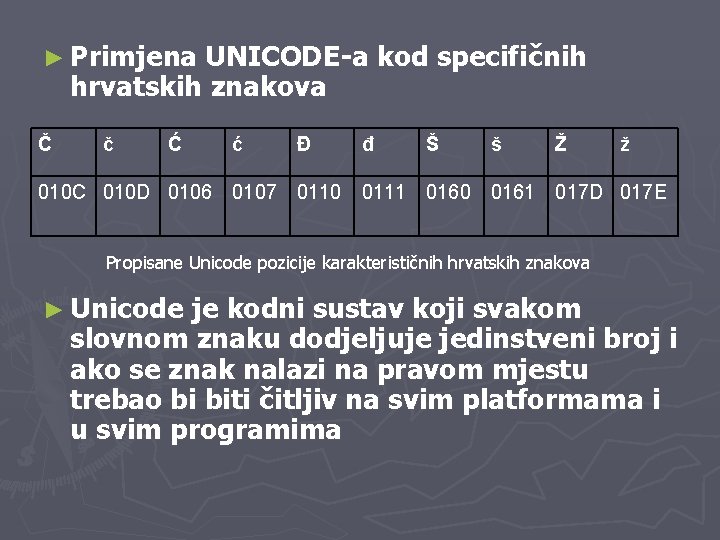
► Primjena UNICODE-a kod specifičnih hrvatskih znakova Č č Ć 010 C 010 D 0106 ć Đ đ Š š Ž ž 0107 0110 0111 0160 0161 017 D 017 E Propisane Unicode pozicije karakterističnih hrvatskih znakova ► Unicode je kodni sustav koji svakom slovnom znaku dodjeljuje jedinstveni broj i ako se znak nalazi na pravom mjestu trebao bi biti čitljiv na svim platformama i u svim programima
► Uz pomoć Unicode-a grafički programi kojima se svakodnevno služimo omogućuju nam korištenje svih hrvatskih znakova ► Proces je često obrnut, npr. kad je grafičko rješenje ambalaže ili brošure sa originalnim fontom potrebno primijeniti na stranim tržištima. U tom slučaju grafički dizajner projektira nove znakove karakteristične za određeni jezik i proširuje font, koji se može dalje primjenjivati
► Česti su zahtjevi izdavačkih kuća za uređivanjem karakterističnih slovnih znakova ► Na primjer, kad kod gotovih prijeloma knjiga koji su pohranjeni u arhivi treba otvoriti dokumente na novim računalima, unijeti potrebne tekstualne izmjene i formatirati za ispis na novim platformama
► Problem se rješava na način da se taj „stari“ font uredi za rad na novim platformama, tako da se karakteristični hrvatski znakovi stave na nove, primjerice Unicode, pozicije ► Prilikom projektiranja karakterističnih znakova hrvatske abecede potrebno je voditi računa o svim karakteristikama tog fonta, kako ne bi došlo do vizualnog odskakanja karakterističnih slovnih znakova od cjeline