
KLASIFIKASI PARKET KAYU JATI MENGGUNAKAN METODE SUPPORT VECTOR
- Slides: 26
KLASIFIKASI PARKET KAYU JATI MENGGUNAKAN METODE SUPPORT VECTOR MACHINES (SVM) RINA YULIANA SIAGIAN 50407731
Latar Belakang Masalah • Dalam industri parket kayu jati menggunakan tenaga manusia belum akurat perlu otomatisasi pengklasifikasian. • Ekstraksi fitur klasifikasi tekstur parket kayu jati. • Metode klasifikasi Support Vector Machines ini dipilih karena cukup efektif sebagai metode klasifikasi yang berhubungan dengan permukaan kayu (Prasetiyo, 2010).
Batasan Masalah Mengklasifikasi parket kayu jati ke dalam kelas 1, 2, dan 3 dengan menggunakan metode Support Vector Machines. Mengklasifikasi parket kayu jati dengan Support Vector Machines.
Support Vector Machines (SVM) Support Vector Machine (SVM) adalah satu teknik klasifikasi data dengan proses pelatihan dan proses pengujian. Support Vector Machines menghasilkan suatu classifier yang akan bekerja dengan baik.
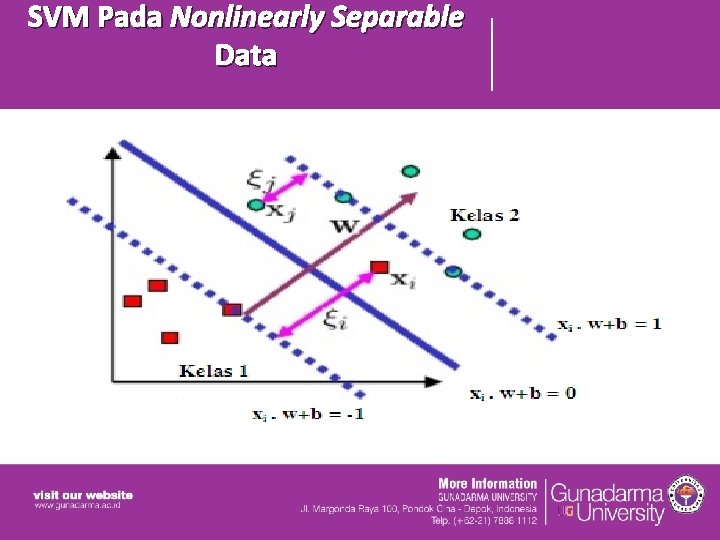
SVM Pada Nonlinearly Separable Data
Multi Class SVM Berikut ini adalah metode yang umum untuk mengimplementasikan multi class SVM : 1. Metode ”One Against All” 2. Metode ”One Against One” digunakan
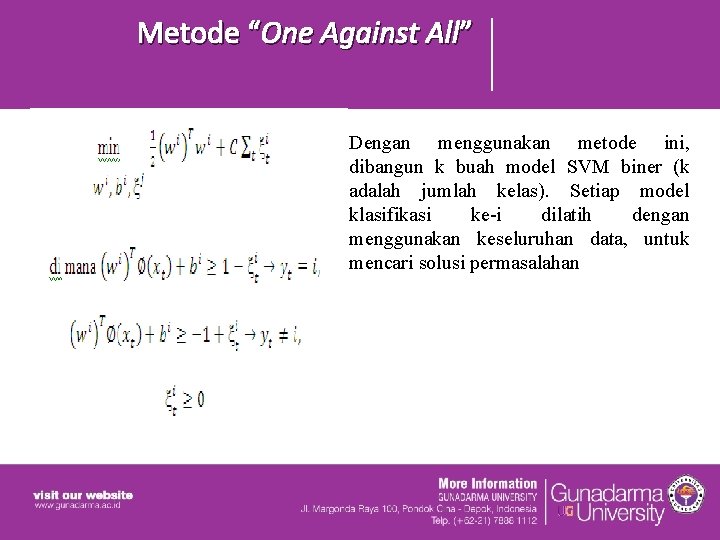
Metode “One Against All” Dengan menggunakan metode ini, dibangun k buah model SVM biner (k adalah jumlah kelas). Setiap model klasifikasi ke-i dilatih dengan menggunakan keseluruhan data, untuk mencari solusi permasalahan
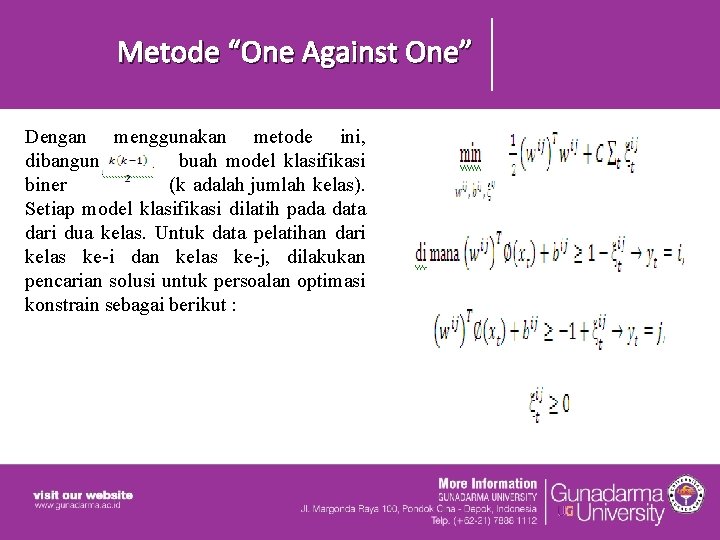
Metode “One Against One” Dengan menggunakan metode ini, dibangun buah model klasifikasi biner (k adalah jumlah kelas). Setiap model klasifikasi dilatih pada data dari dua kelas. Untuk data pelatihan dari kelas ke-i dan kelas ke-j, dilakukan pencarian solusi untuk persoalan optimasi konstrain sebagai berikut :
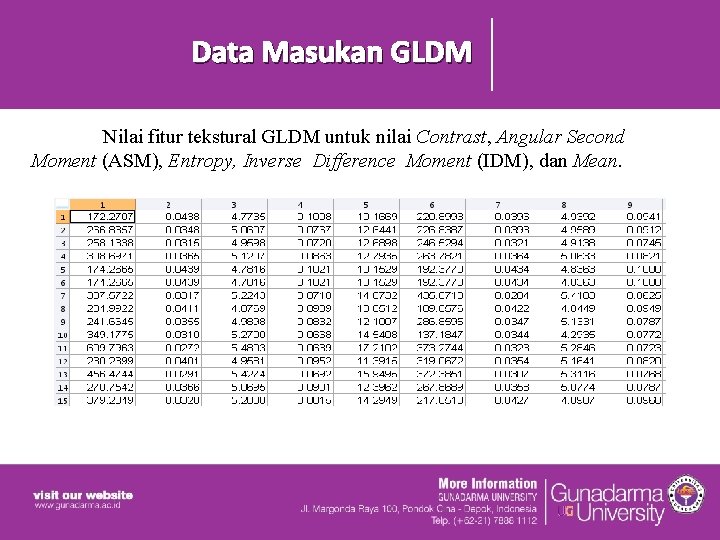
Data Masukan GLDM Nilai fitur tekstural GLDM untuk nilai Contrast, Angular Second Moment (ASM), Entropy, Inverse Difference Moment (IDM), dan Mean.
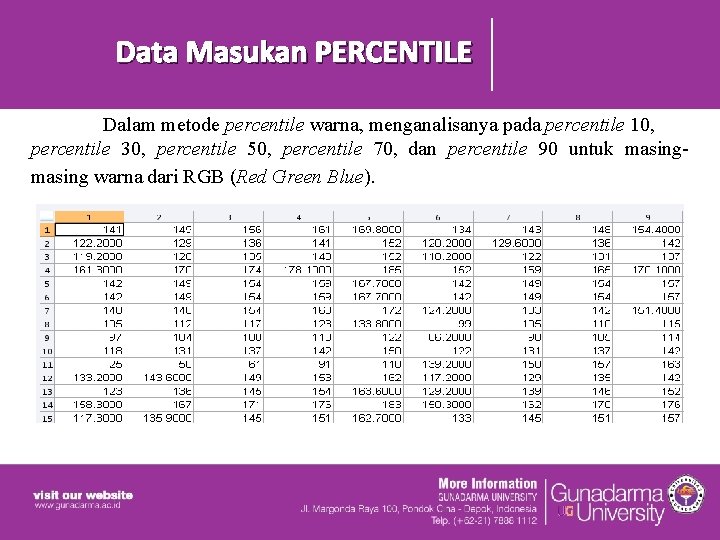
Data Masukan PERCENTILE Dalam metode percentile warna, menganalisanya pada percentile 10, percentile 30, percentile 50, percentile 70, dan percentile 90 untuk masing warna dari RGB (Red Green Blue).
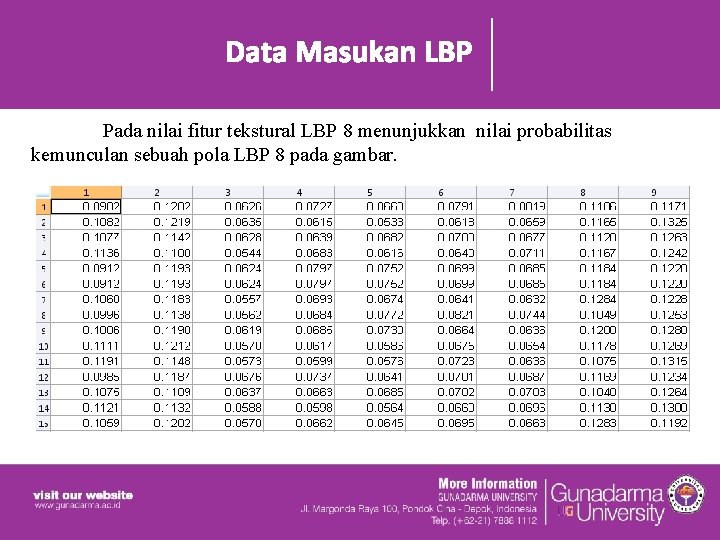
Data Masukan LBP Pada nilai fitur tekstural LBP 8 menunjukkan nilai probabilitas kemunculan sebuah pola LBP 8 pada gambar.
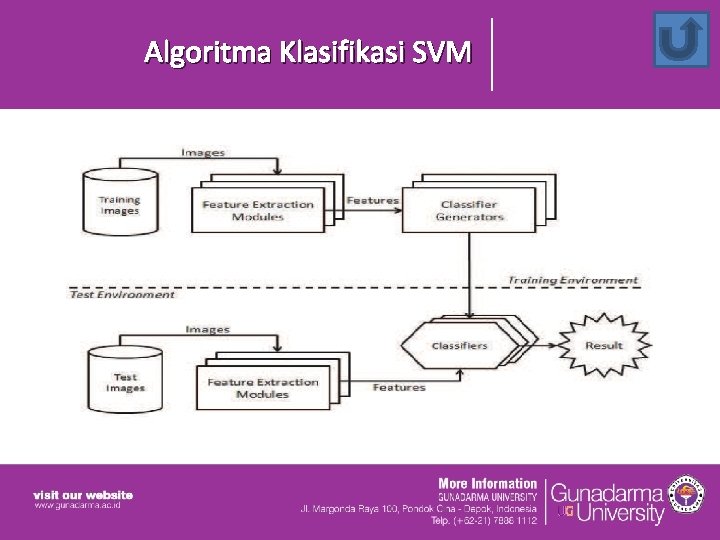
Algoritma Klasifikasi SVM
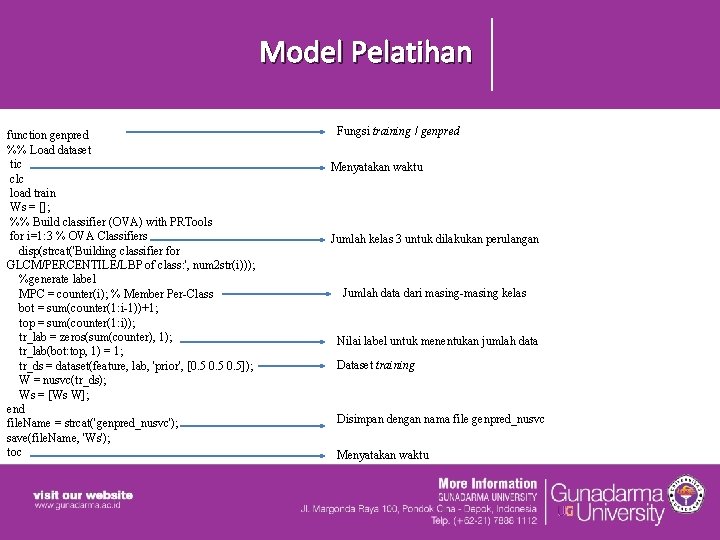
Model Pelatihan function genpred %% Load dataset tic clc load train Ws = []; %% Build classifier (OVA) with PRTools for i=1: 3 % OVA Classifiers disp(strcat('Building classifier for GLCM/PERCENTILE/LBP of class: ', num 2 str(i))); %generate label MPC = counter(i); % Member Per-Class bot = sum(counter(1: i-1))+1; top = sum(counter(1: i)); tr_lab = zeros(sum(counter), 1); tr_lab(bot: top, 1) = 1; tr_ds = dataset(feature, lab, 'prior', [0. 5]); W = nusvc(tr_ds); Ws = [Ws W]; end file. Name = strcat('genpred_nusvc'); save(file. Name, 'Ws'); toc Fungsi training / genpred Menyatakan waktu Jumlah kelas 3 untuk dilakukan perulangan Jumlah data dari masing-masing kelas Nilai label untuk menentukan jumlah data Dataset training Disimpan dengan nama file genpred_nusvc Menyatakan waktu
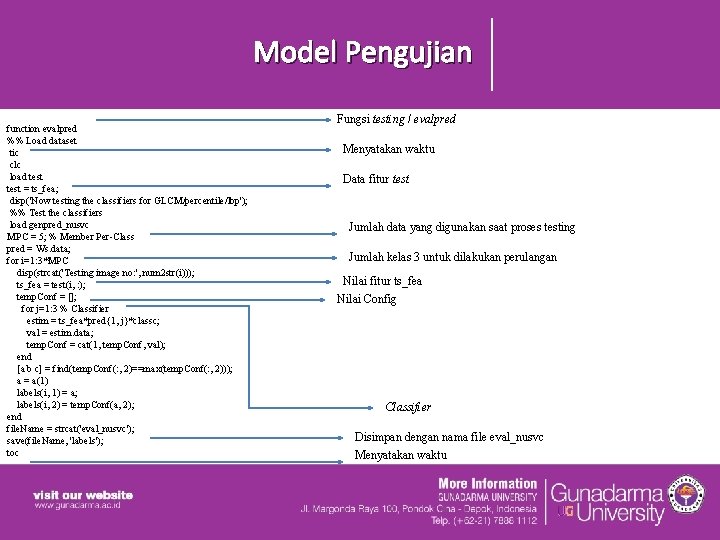
Model Pengujian function evalpred %% Load dataset tic clc load test = ts_fea; disp('Now testing the classifiers for GLCM/percentile/lbp'); %% Test the classifiers load genpred_nusvc MPC = 5; % Member Per-Class pred = Ws. data; for i=1: 3*MPC disp(strcat('Testing image no: ', num 2 str(i))); ts_fea = test(i, : ); temp. Conf = []; for j=1: 3 % Classifier estim = ts_fea*pred{1, j}*classc; val = estim. data; temp. Conf = cat(1, temp. Conf, val); end [a b c] = find(temp. Conf(: , 2)==max(temp. Conf(: , 2))); a = a(1) labels(i, 1) = a; labels(i, 2) = temp. Conf(a, 2); end file. Name = strcat('eval_nusvc'); save(file. Name, 'labels'); toc Fungsi testing / evalpred Menyatakan waktu Data fitur test Jumlah data yang digunakan saat proses testing Jumlah kelas 3 untuk dilakukan perulangan Nilai fitur ts_fea Nilai Config Classifier Disimpan dengan nama file eval_nusvc Menyatakan waktu
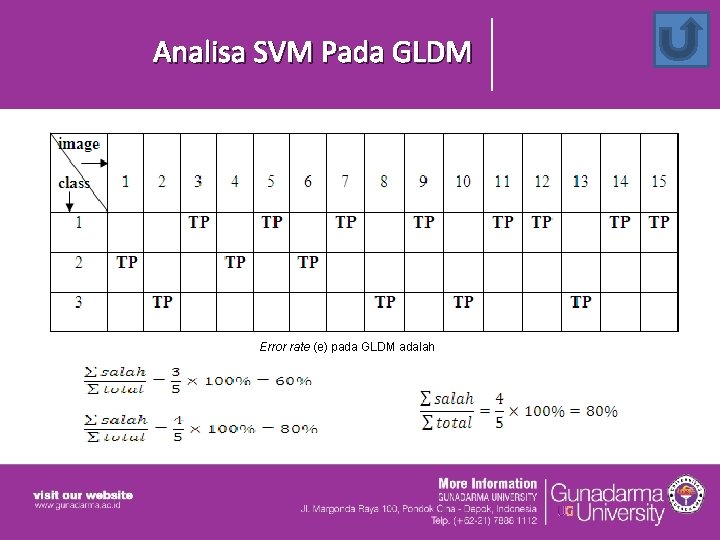
Analisa Hasil Analisa hasil klasifikasi SVM ini didapatkan dari train dan test. Fitur yang ditraining didapatkan dari fitur yang gambarnya tidak digunakan pada training dan fitur yang gambarnya digunakan pada training. Bentuk dari analisa hasil klasifikasi SVM berupa persentasi tingkat akurat prediksi kelas mana yang cocok dari masing-masing gambar. Berikut analisa hasil dari fitur GLDM, fitur PERCENTILE, dan fitur LBP yang gambarnya tidak digunakan pada tahap training :
Analisa SVM Pada GLDM Error rate (e) pada GLDM adalah
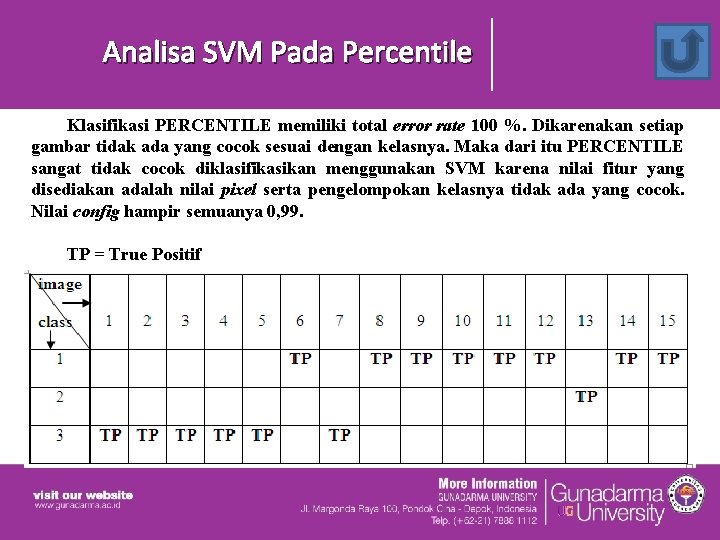
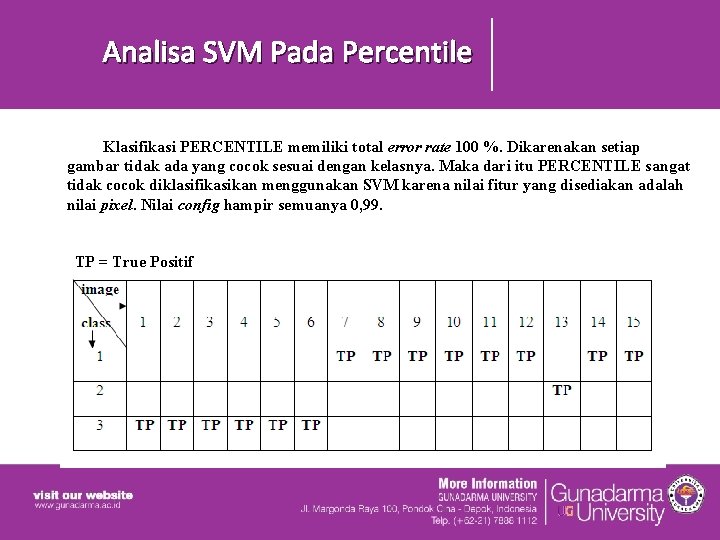
Analisa SVM Pada Percentile Klasifikasi PERCENTILE memiliki total error rate 100 %. Dikarenakan setiap gambar tidak ada yang cocok sesuai dengan kelasnya. Maka dari itu PERCENTILE sangat tidak cocok diklasifikasikan menggunakan SVM karena nilai fitur yang disediakan adalah nilai pixel serta pengelompokan kelasnya tidak ada yang cocok. Nilai config hampir semuanya 0, 99. TP = True Positif
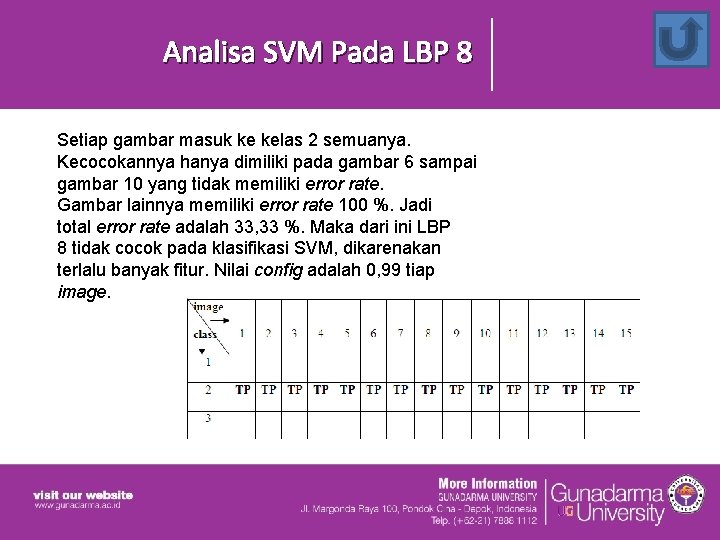
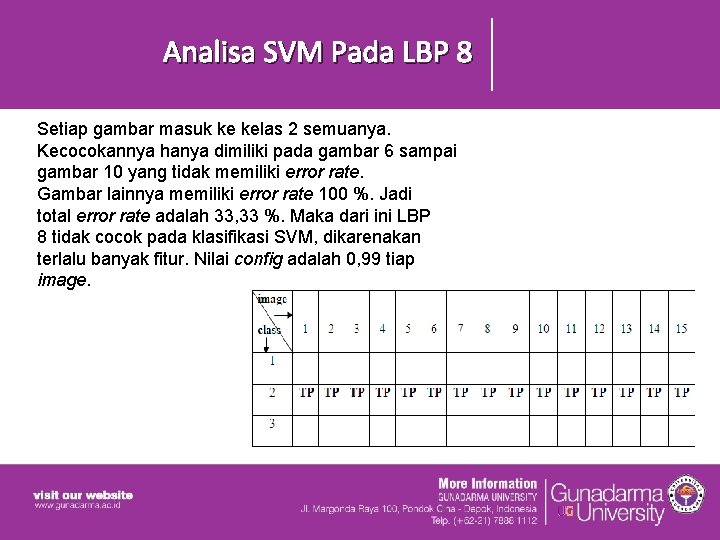
Analisa SVM Pada LBP 8 Setiap gambar masuk ke kelas 2 semuanya. Kecocokannya hanya dimiliki pada gambar 6 sampai gambar 10 yang tidak memiliki error rate. Gambar lainnya memiliki error rate 100 %. Jadi total error rate adalah 33, 33 %. Maka dari ini LBP 8 tidak cocok pada klasifikasi SVM, dikarenakan terlalu banyak fitur. Nilai config adalah 0, 99 tiap image.
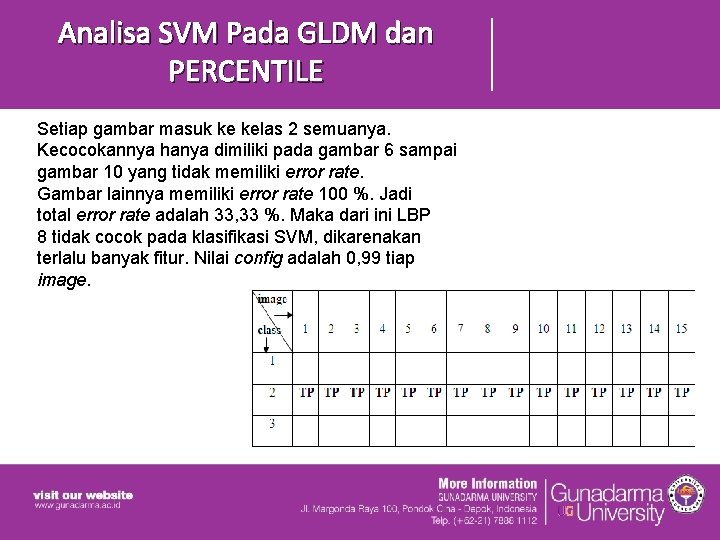
Analisa SVM Pada GLDM dan PERCENTILE Setiap gambar masuk ke kelas 2 semuanya. Kecocokannya hanya dimiliki pada gambar 6 sampai gambar 10 yang tidak memiliki error rate. Gambar lainnya memiliki error rate 100 %. Jadi total error rate adalah 33, 33 %. Maka dari ini LBP 8 tidak cocok pada klasifikasi SVM, dikarenakan terlalu banyak fitur. Nilai config adalah 0, 99 tiap image.
Analisa Hasil Selanjutnya analisa hasil dari fitur GLDM, fitur PERCENTILE, dan fitur LBP yang gambarnya digunakan pada training. Fitur yang gambarnya digunakan pada training dilakukan percobaan sebanyak 5 kali. Berikut analisa hasil dari fitur GLDM, fitur PERCENTILE, dan fitur LBP yang gambarnya digunakan pada tahap training
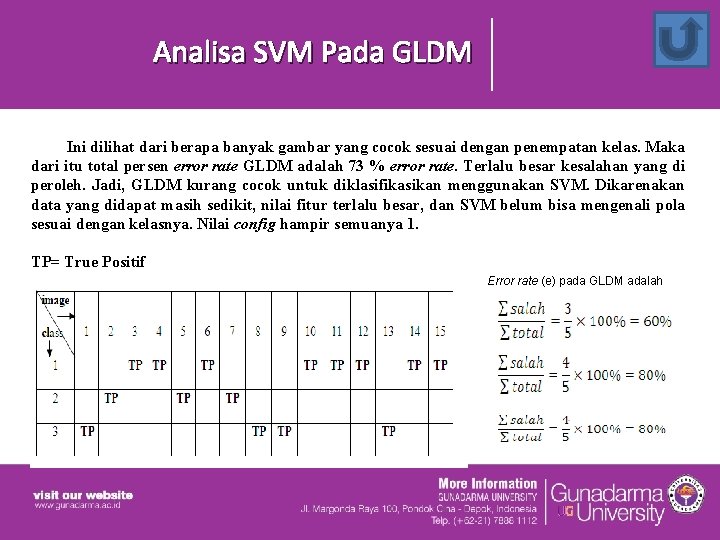
Analisa SVM Pada GLDM Ini dilihat dari berapa banyak gambar yang cocok sesuai dengan penempatan kelas. Maka dari itu total persen error rate GLDM adalah 73 % error rate. Terlalu besar kesalahan yang di peroleh. Jadi, GLDM kurang cocok untuk diklasifikasikan menggunakan SVM. Dikarenakan data yang didapat masih sedikit, nilai fitur terlalu besar, dan SVM belum bisa mengenali pola sesuai dengan kelasnya. Nilai config hampir semuanya 1. TP= True Positif Error rate (e) pada GLDM adalah
Analisa SVM Pada Percentile Klasifikasi PERCENTILE memiliki total error rate 100 %. Dikarenakan setiap gambar tidak ada yang cocok sesuai dengan kelasnya. Maka dari itu PERCENTILE sangat tidak cocok diklasifikasikan menggunakan SVM karena nilai fitur yang disediakan adalah nilai pixel. Nilai config hampir semuanya 0, 99. TP = True Positif
Analisa SVM Pada LBP 8 Setiap gambar masuk ke kelas 2 semuanya. Kecocokannya hanya dimiliki pada gambar 6 sampai gambar 10 yang tidak memiliki error rate. Gambar lainnya memiliki error rate 100 %. Jadi total error rate adalah 33, 33 %. Maka dari ini LBP 8 tidak cocok pada klasifikasi SVM, dikarenakan terlalu banyak fitur. Nilai config adalah 0, 99 tiap image.
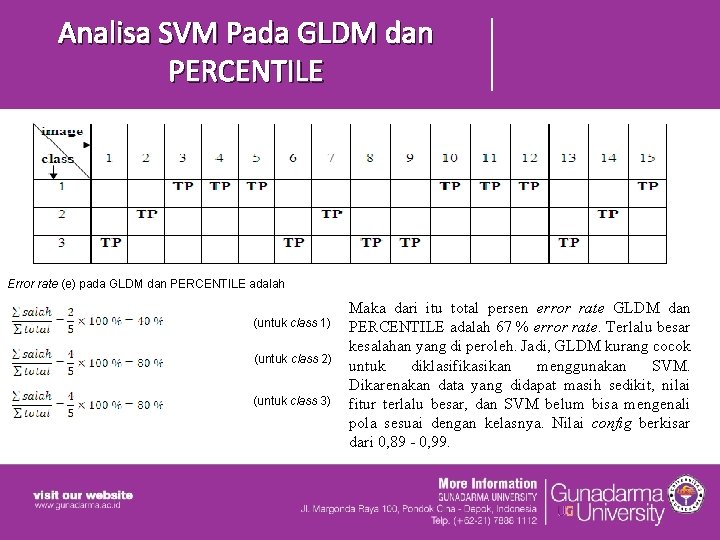
Analisa SVM Pada GLDM dan PERCENTILE Error rate (e) pada GLDM dan PERCENTILE adalah (untuk class 1) (untuk class 2) (untuk class 3) Maka dari itu total persen error rate GLDM dan PERCENTILE adalah 67 % error rate. Terlalu besar kesalahan yang di peroleh. Jadi, GLDM kurang cocok untuk diklasifikasikan menggunakan SVM. Dikarenakan data yang didapat masih sedikit, nilai fitur terlalu besar, dan SVM belum bisa mengenali pola sesuai dengan kelasnya. Nilai config berkisar dari 0, 89 - 0, 99.
Kesimpulan Skripsi ini menghasilkan program untuk menentukan klasifikasi SVM pada fitur GLDM, PERCENTILE, dan LBP. Proses klasifikasi SVM dapat dilihat dari error rate dari masing-masing fitur. Error rate yang terbaik adalah fitur GLDM dan PERCENTILE yang imagenya digunakan pada training yaitu 40 % untuk kelas 1, 80 % untuk kelas 2, dan 80 % untuk kelas 3. Besarnya nilai error rate ini disebabkan oleh jumlah fitur yang terlalu banyak dan jumlah training image yang terlalu sedikit sehingga classifier sulit untuk memberikan confidence value yang cukup signifikan.
Saran Klasifikasi SVM ini dapat ditingkatkan dengan melakukan penambahan data yang digunakan untuk training dan mereduksi jumlah fitur yang digunakan. Selain itu, kombinasi dari fitur yang memberikan hasil terbaik yaitu GLDM dan PERCENTILE dapat digunakan sebagai rekomendasi metode ekstraksi fitur untuk penelitian lain yang sejenis.