
Katseandmete anals II http www ut eetammarutstat htm
- Slides: 24
Katseandmete analüüs II http: //www. ut. ee/~tammarut/stat. htm 2015 Kui osaled vähemalt neljas praktikumis, siis ei pea analüüsimiseks kasutatud programmi valdamist eraldi tõestama!
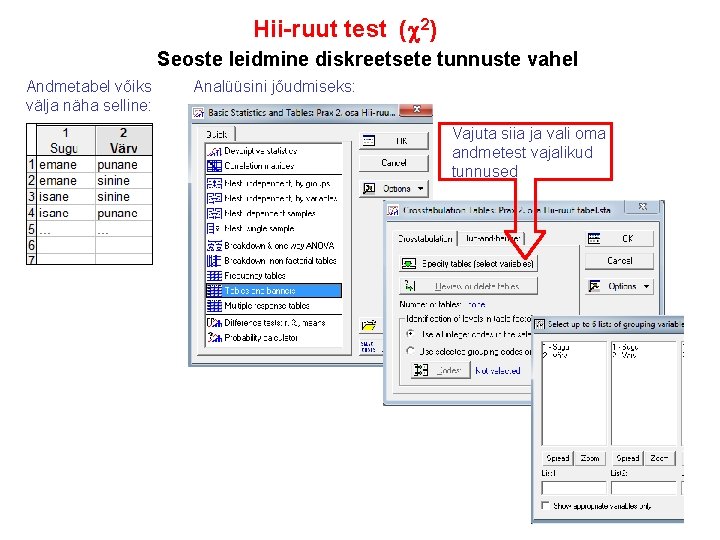
Hii-ruut test ( 2) Seoste leidmine diskreetsete tunnuste vahel Andmetabel võiks välja näha selline: Analüüsini jõudmiseks: Vajuta siia ja vali oma andmetest vajalikud tunnused
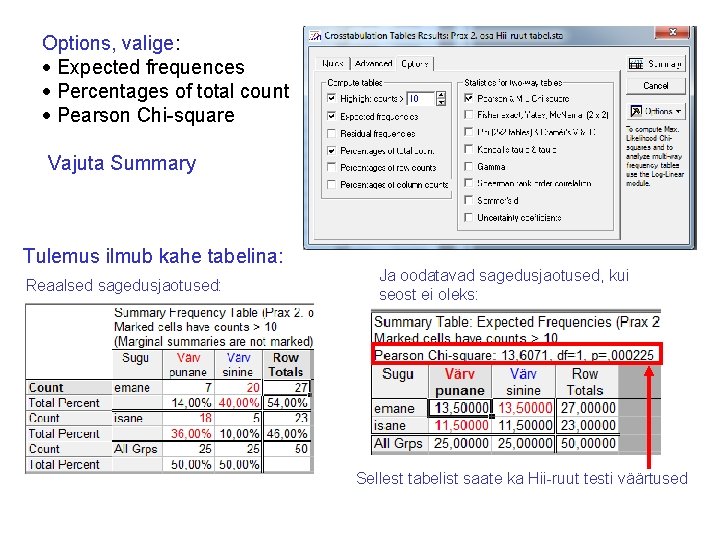
Options, valige: Expected frequences Percentages of total count Pearson Chi-square Vajuta Summary Tulemus ilmub kahe tabelina: Reaalsed sagedusjaotused: Ja oodatavad sagedusjaotused, kui seost ei oleks: Sellest tabelist saate ka Hii-ruut testi väärtused
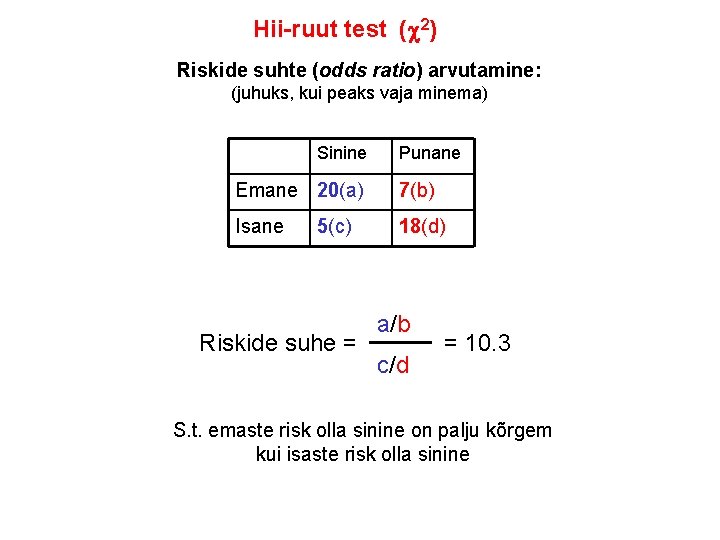
Hii-ruut test ( 2) Riskide suhte (odds ratio) arvutamine: (juhuks, kui peaks vaja minema) Sinine Punane Emane 20(a) 7(b) Isane 18(d) 5(c) Riskide suhe = a/b c/d = 10. 3 S. t. emaste risk olla sinine on palju kõrgem kui isaste risk olla sinine
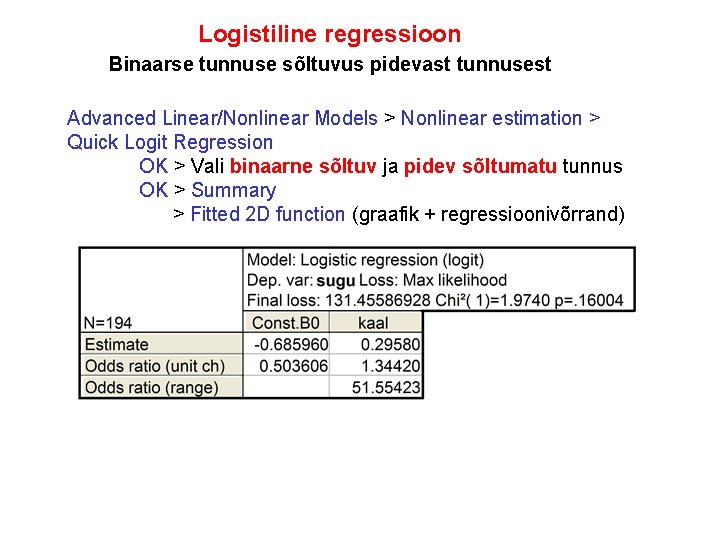
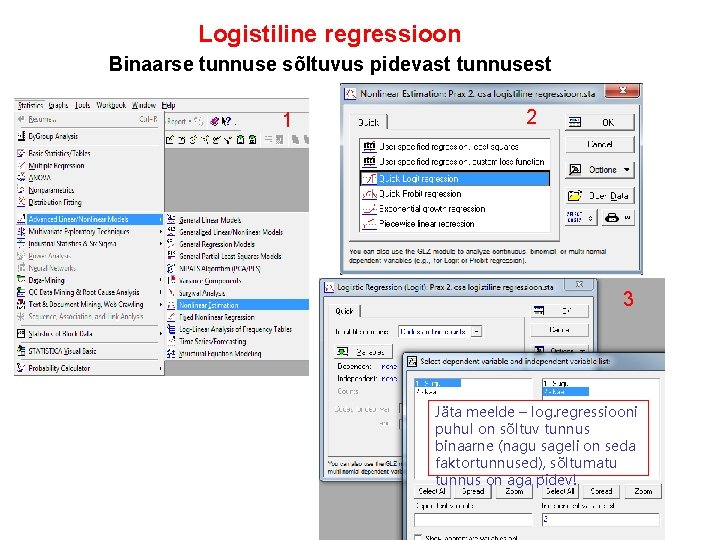
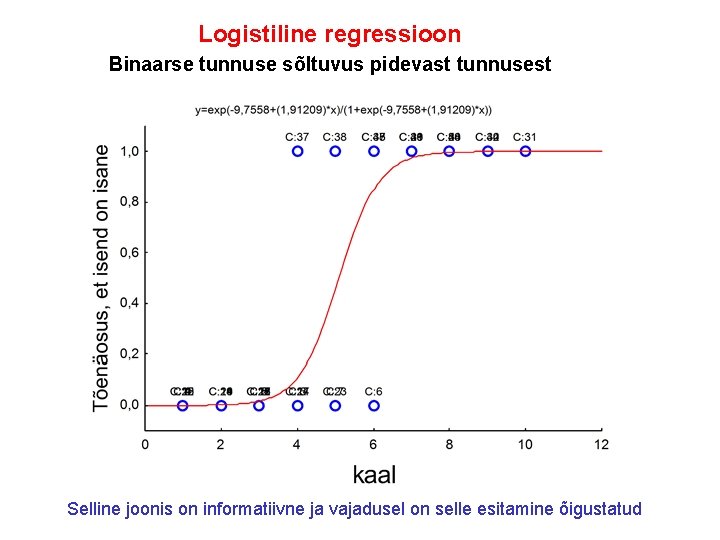
Logistiline regressioon Binaarse tunnuse sõltuvus pidevast tunnusest Advanced Linear/Nonlinear Models > Nonlinear estimation > Quick Logit Regression OK > Vali binaarne sõltuv ja pidev sõltumatu tunnus OK > Summary > Fitted 2 D function (graafik + regressioonivõrrand)
Logistiline regressioon Binaarse tunnuse sõltuvus pidevast tunnusest 1 2 3 Jäta meelde – log. regressiooni puhul on sõltuv tunnus binaarne (nagu sageli on seda faktortunnused), sõltumatu tunnus on aga pidev!
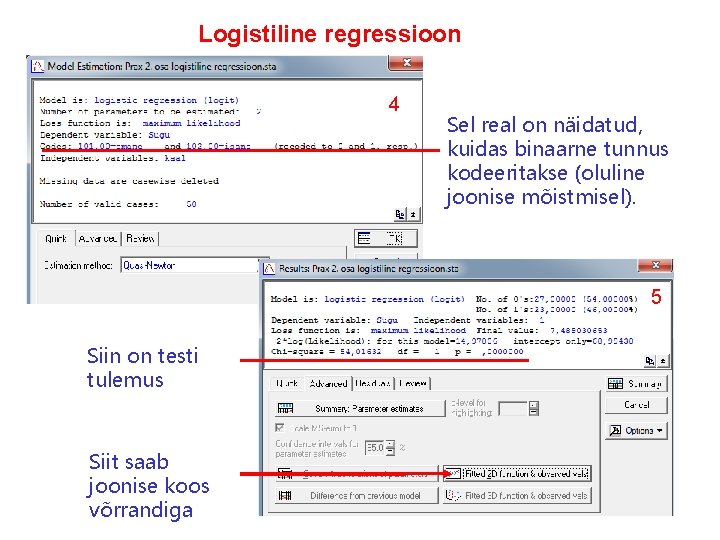
Logistiline regressioon 4 Sel real on näidatud, kuidas binaarne tunnus kodeeritakse (oluline joonise mõistmisel). 5 Siin on testi tulemus Siit saab joonise koos võrrandiga
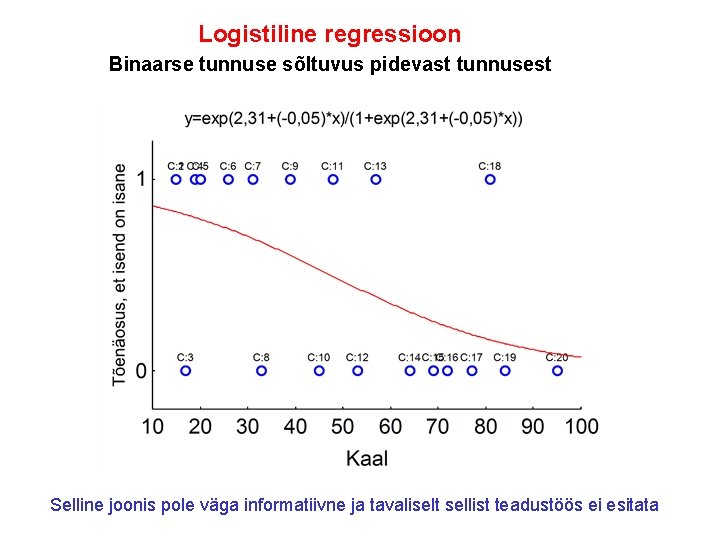
Logistiline regressioon Binaarse tunnuse sõltuvus pidevast tunnusest Selline joonis pole väga informatiivne ja tavaliselt sellist teadustöös ei esitata
Logistiline regressioon Binaarse tunnuse sõltuvus pidevast tunnusest Selline joonis on informatiivne ja vajadusel on selle esitamine õigustatud
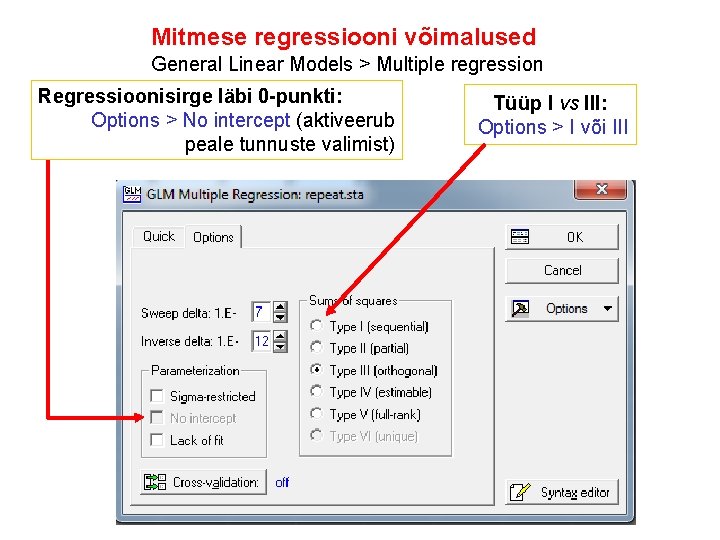
Mitmese regressiooni võimalused General Linear Models > Multiple regression Regressioonisirge läbi 0 -punkti: Options > No intercept (aktiveerub peale tunnuste valimist) Tüüp I vs III: Options > I või III
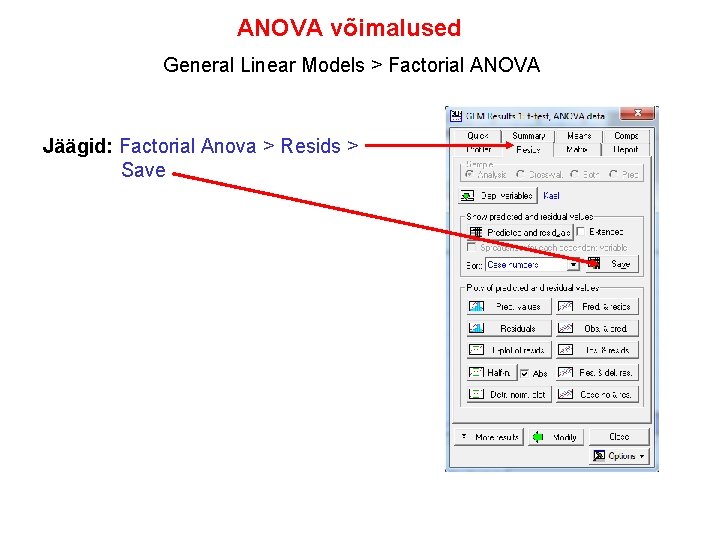
ANOVA võimalused General Linear Models > Factorial ANOVA Jäägid: Factorial Anova > Resids > Save
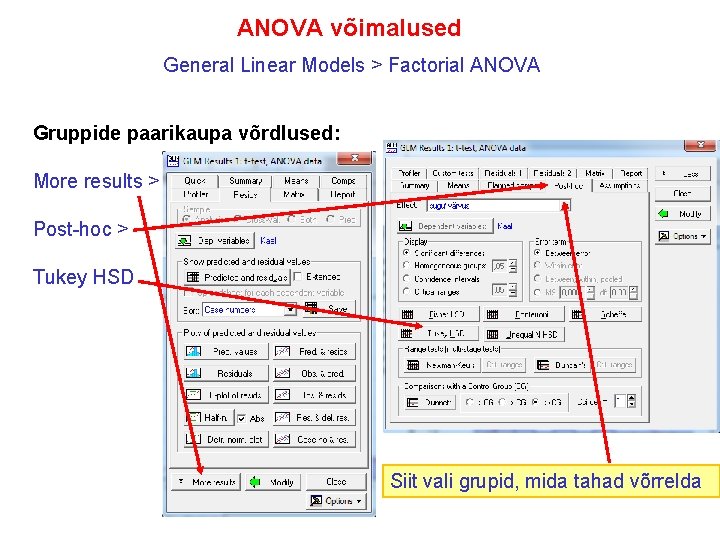
ANOVA võimalused General Linear Models > Factorial ANOVA Gruppide paarikaupa võrdlused: More results > Post-hoc > Tukey HSD Siit vali grupid, mida tahad võrrelda
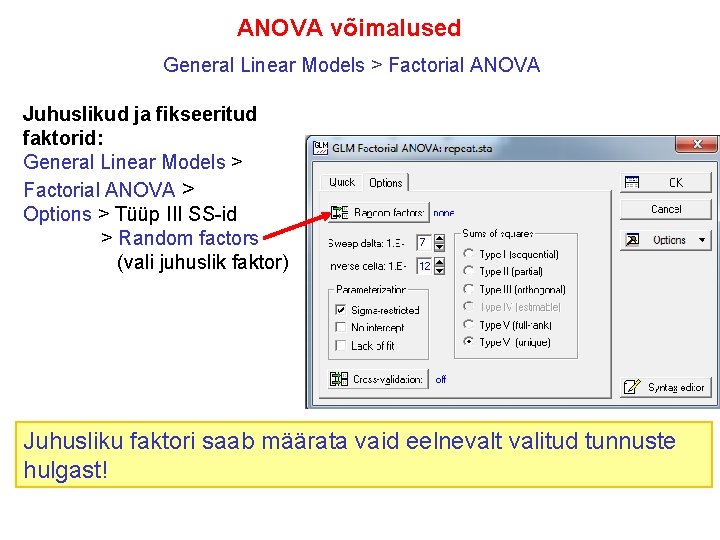
ANOVA võimalused General Linear Models > Factorial ANOVA Juhuslikud ja fikseeritud faktorid: General Linear Models > Factorial ANOVA > Options > Tüüp III SS-id > Random factors (vali juhuslik faktor) Juhusliku faktori saab määrata vaid eelnevalt valitud tunnuste hulgast!
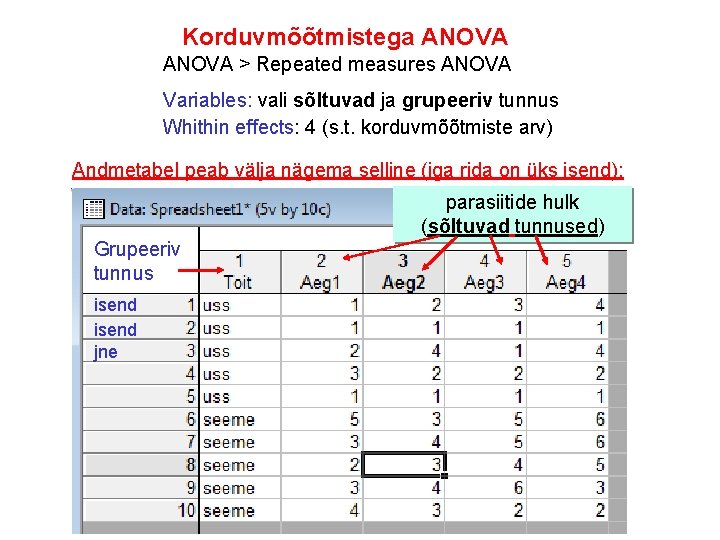
Korduvmõõtmistega ANOVA > Repeated measures ANOVA Variables: vali sõltuvad ja grupeeriv tunnus Whithin effects: 4 (s. t. korduvmõõtmiste arv) Andmetabel peab välja nägema selline (iga rida on üks isend): Grupeeriv tunnus isend jne parasiitide hulk (sõltuvad tunnused)
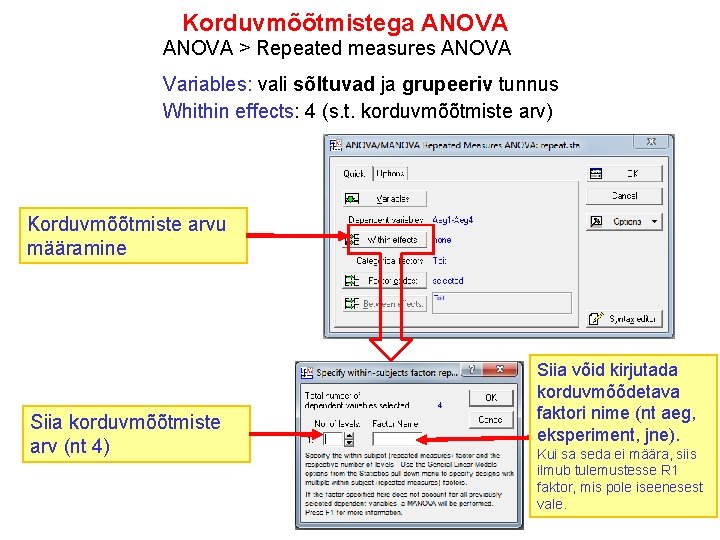
Korduvmõõtmistega ANOVA > Repeated measures ANOVA Variables: vali sõltuvad ja grupeeriv tunnus Whithin effects: 4 (s. t. korduvmõõtmiste arv) Korduvmõõtmiste arvu määramine Siia korduvmõõtmiste arv (nt 4) Siia võid kirjutada korduvmõõdetava faktori nime (nt aeg, eksperiment, jne). Kui sa seda ei määra, siis ilmub tulemustesse R 1 faktor, mis pole iseenesest vale.
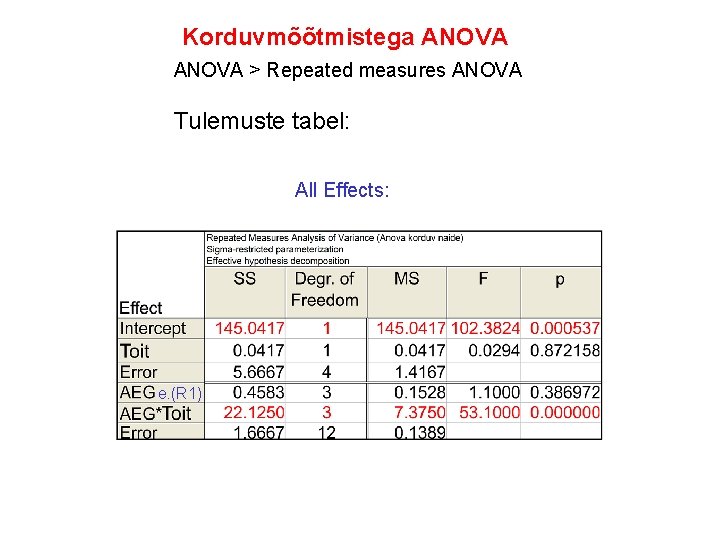
Korduvmõõtmistega ANOVA > Repeated measures ANOVA Tulemuste tabel: All Effects: e. (R 1)
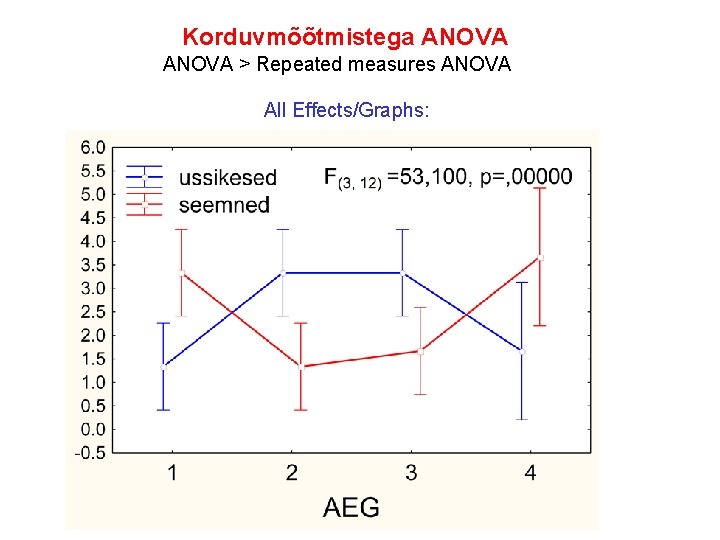
Korduvmõõtmistega ANOVA > Repeated measures ANOVA All Effects/Graphs:
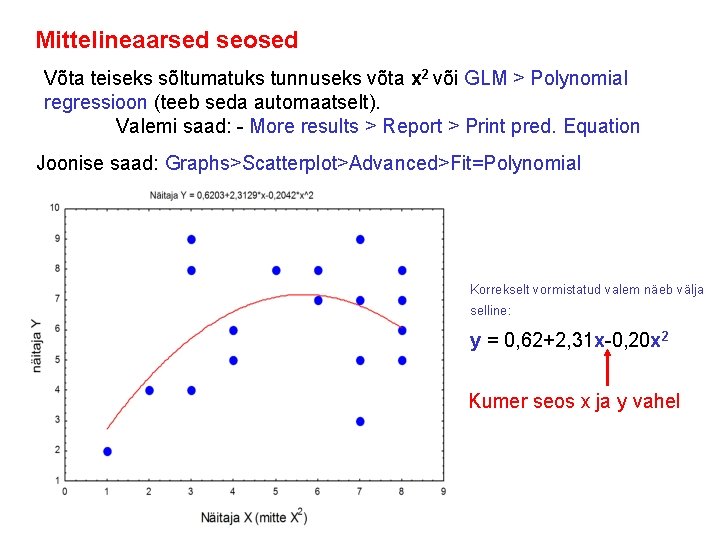
Mittelineaarsed seosed Võta teiseks sõltumatuks tunnuseks võta x 2 või GLM > Polynomial regressioon (teeb seda automaatselt). Valemi saad: - More results > Report > Print pred. Equation Joonise saad: Graphs>Scatterplot>Advanced>Fit=Polynomial Korrekselt vormistatud valem näeb välja selline: y = 0, 62+2, 31 x-0, 20 x 2 Pildile käib x mitte x 2! Kumer seos x ja y vahel
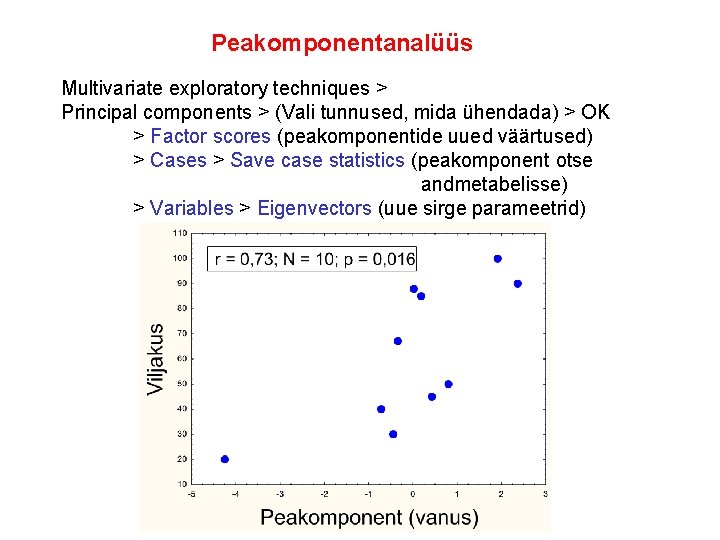
Peakomponentanalüüs Multivariate exploratory techniques > Principal components > (Vali tunnused, mida ühendada) > OK > Factor scores (peakomponentide uued väärtused) > Cases > Save case statistics (peakomponent otse andmetabelisse) > Variables > Eigenvectors (uue sirge parameetrid)
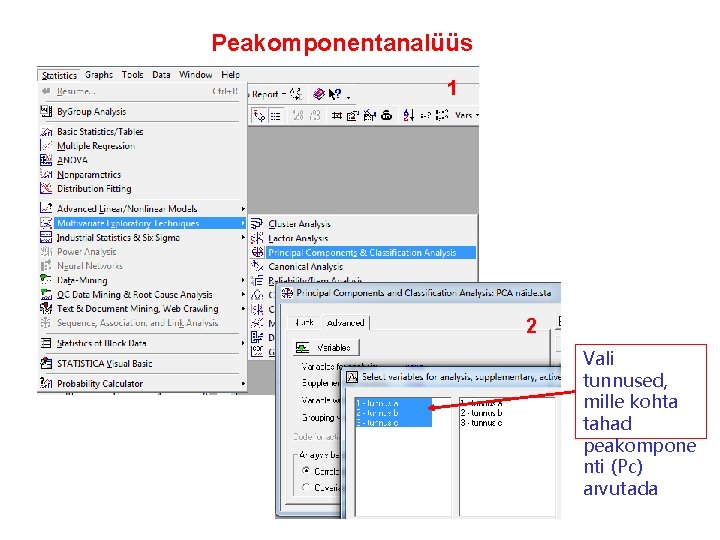
Peakomponentanalüüs 1 2 Vali tunnused, mille kohta tahad peakompone nti (Pc) arvutada
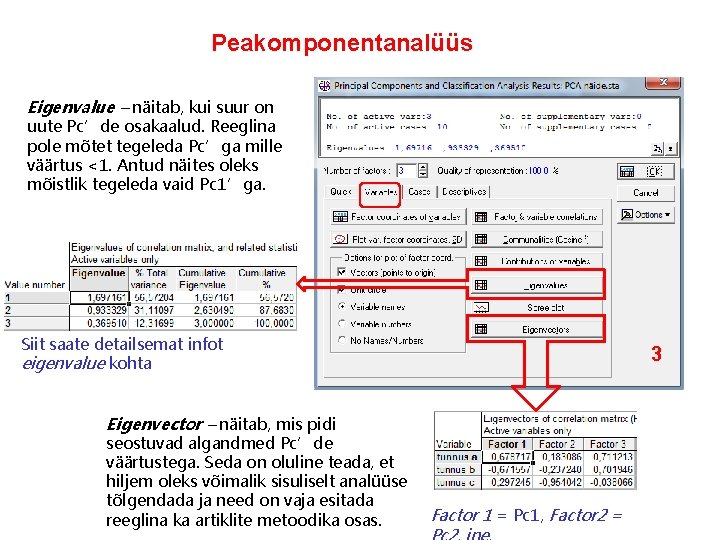
Peakomponentanalüüs Eigenvalue – näitab, kui suur on uute Pc’de osakaalud. Reeglina pole mõtet tegeleda Pc’ga mille väärtus <1. Antud näites oleks mõistlik tegeleda vaid Pc 1’ga. Siit saate detailsemat infot eigenvalue kohta 3 Eigenvector – näitab, mis pidi seostuvad algandmed Pc’de väärtustega. Seda on oluline teada, et hiljem oleks võimalik sisuliselt analüüse tõlgendada ja need on vaja esitada reeglina ka artiklite metoodika osas. Factor 1 = Pc 1, Factor 2 =
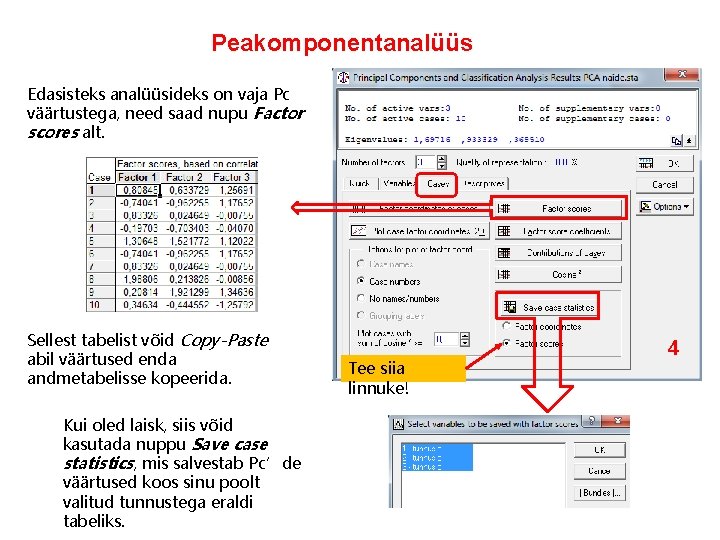
Peakomponentanalüüs Edasisteks analüüsideks on vaja Pc väärtustega, need saad nupu Factor scores alt. Sellest tabelist võid Copy-Paste abil väärtused enda andmetabelisse kopeerida. Kui oled laisk, siis võid kasutada nuppu Save case statistics, mis salvestab Pc’de väärtused koos sinu poolt valitud tunnustega eraldi tabeliks. Tee siia linnuke! 4
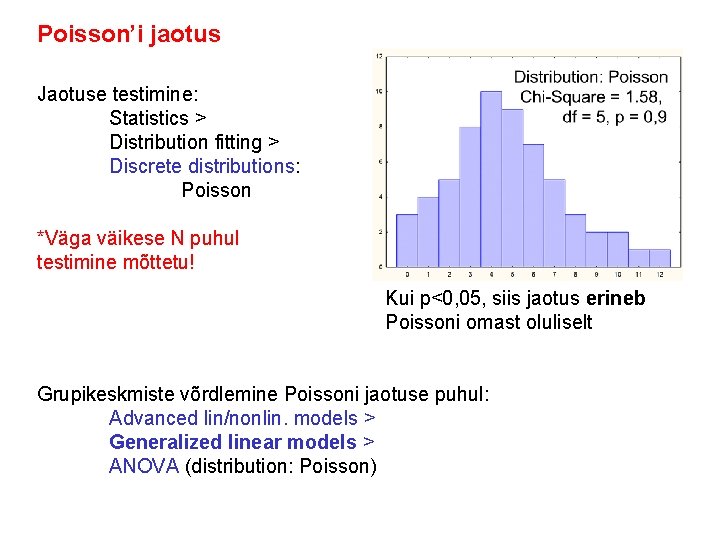
Poisson’i jaotus Jaotuse testimine: Statistics > Distribution fitting > Discrete distributions: Poisson *Väga väikese N puhul testimine mõttetu! Kui p<0, 05, siis jaotus erineb Poissoni omast oluliselt Grupikeskmiste võrdlemine Poissoni jaotuse puhul: Advanced lin/nonlin. models > Generalized linear models > ANOVA (distribution: Poisson)
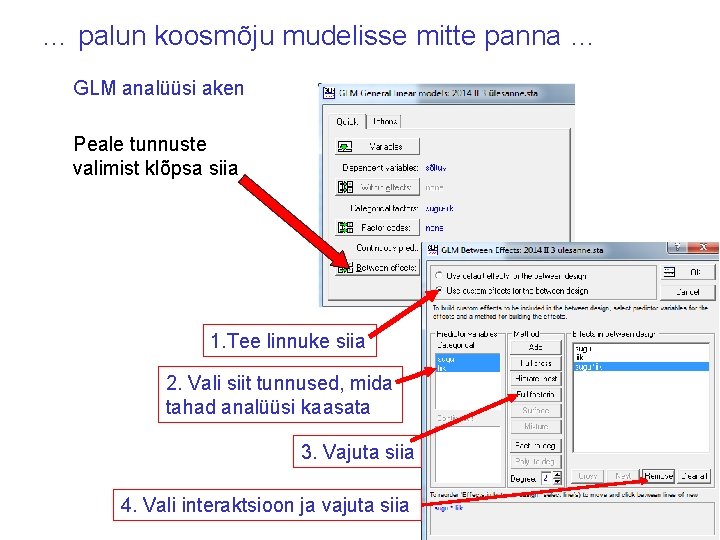
… palun koosmõju mudelisse mitte panna … GLM analüüsi aken Peale tunnuste valimist klõpsa siia 1. Tee linnuke siia 2. Vali siit tunnused, mida tahad analüüsi kaasata 3. Vajuta siia 4. Vali interaktsioon ja vajuta siia