
JEDNOCZYNNIKOWA ANALIZA WARIANCJI Zastosowanie statystyki w bioinynierii w
JEDNOCZYNNIKOWA ANALIZA WARIANCJI Zastosowanie statystyki w bioinżynierii ćw 5
Ogólny model liniowy � Ogólny model liniowy umożliwia ilościowy opis związku między cechami � jest rozszerzeniem modelu regresji wielorakiej dla pojedynczej zmiennej zależnej w którym błąd ma rozkład normalny � która jest rozszerzeniem modelu prostej regresji liniowej � Uogólniony model liniowy jest rozszerzeniem ogólnego modelu liniowego � Np. regresja logistyczna
Klasyfikacja ogólnych modeli liniowych � Klasyfikacja ogólnych modeli liniowych w zależności od rodzaju i charakteru zmiennych objaśniających: � tylko predyktory jakościowe (skategoryzowane) – analiza wariancji (ANOVA) � tylko zmienne objaśniające ciągłe – modele regresji � predyktory jakościowe, jak i ciągłe – analiza kowariancji (ANCOVA) � Układy zawierające czynniki jakościowe losowe – układy mieszane
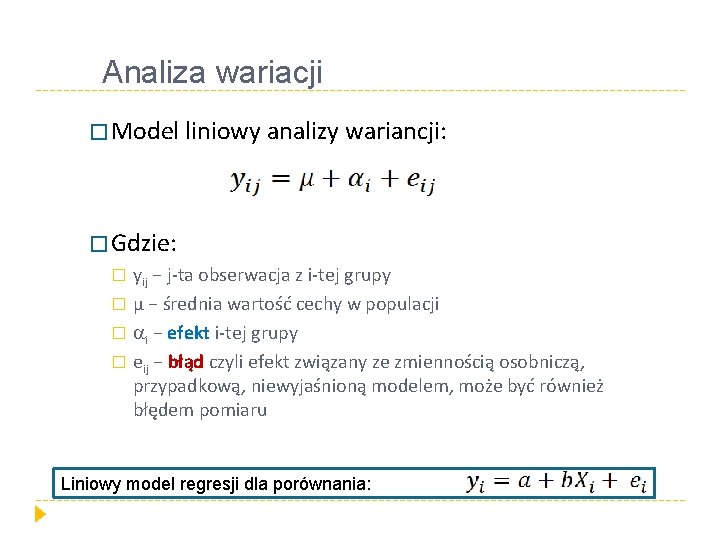
Analiza wariacji � Model liniowy analizy wariancji: � Gdzie: � yij − j-ta obserwacja z i-tej grupy µ − średnia wartość cechy w populacji � i − efekt i-tej grupy � eij − błąd czyli efekt związany ze zmiennością osobniczą, przypadkową, niewyjaśnioną modelem, może być również błędem pomiaru � Liniowy model regresji dla porównania:
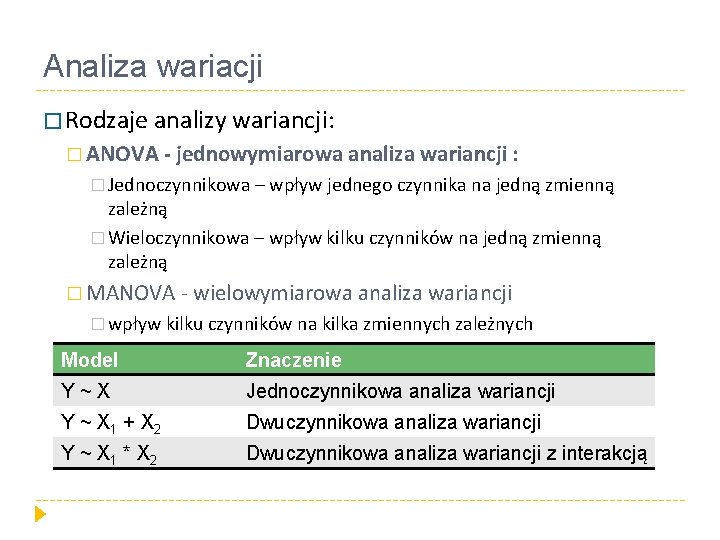
Analiza wariacji � Rodzaje analizy wariancji: � ANOVA - jednowymiarowa analiza wariancji : � Jednoczynnikowa – wpływ jednego czynnika na jedną zmienną zależną � Wieloczynnikowa – wpływ kilku czynników na jedną zmienną zależną � MANOVA - wielowymiarowa analiza wariancji � wpływ kilku czynników na kilka zmiennych zależnych Model Znaczenie Y ~ X Jednoczynnikowa analiza wariancji Y ~ X 1 + X 2 Dwuczynnikowa analiza wariancji Y ~ X 1 * X 2 Dwuczynnikowa analiza wariancji z interakcją
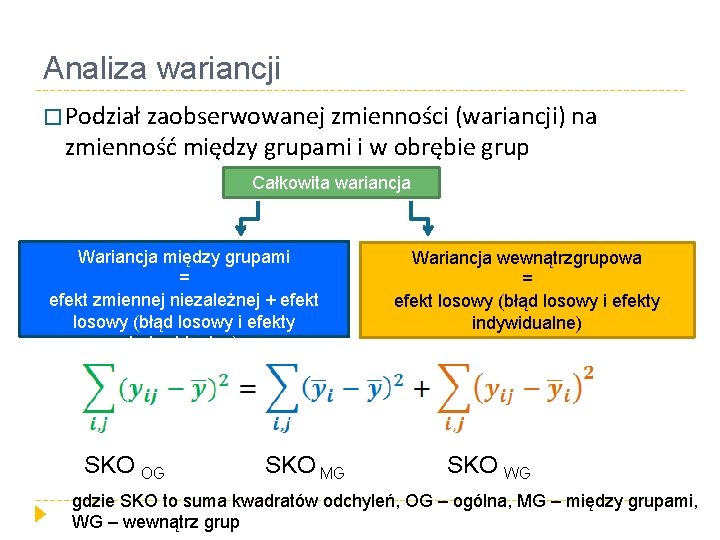
Analiza wariancji � Podział zaobserwowanej zmienności (wariancji) na zmienność między grupami i w obrębie grup Całkowita wariancja Wariancja między grupami = efekt zmiennej niezależnej + efekt losowy (błąd losowy i efekty indywidualne) SKO OG SKO MG Wariancja wewnątrzgrupowa = efekt losowy (błąd losowy i efekty indywidualne) SKO WG gdzie SKO to suma kwadratów odchyleń, OG – ogólna, MG – między grupami, WG – wewnątrz grup
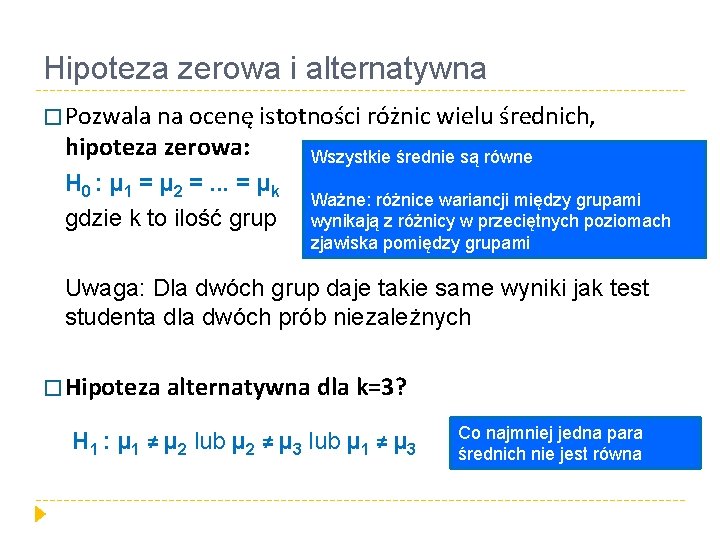
Hipoteza zerowa i alternatywna � Pozwala na ocenę istotności różnic wielu średnich, hipoteza zerowa: H 0 : µ 1 = µ 2 =. . . = µk gdzie k to ilość grup Wszystkie średnie są równe Ważne: różnice wariancji między grupami wynikają z różnicy w przeciętnych poziomach zjawiska pomiędzy grupami Uwaga: Dla dwóch grup daje takie same wyniki jak test studenta dla dwóch prób niezależnych � Hipoteza alternatywna dla k=3? H : µ ≠ µ lub µ ≠ µ 1 1 2 2 3 1 3 Co najmniej jedna para średnich nie jest równa
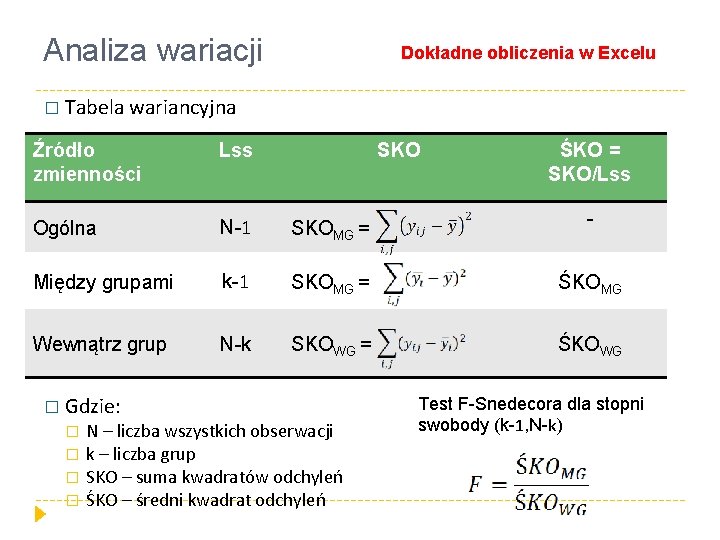
Analiza wariacji Dokładne obliczenia w Excelu � Tabela wariancyjna Źródło zmienności Lss Ogólna N-1 SKOMG = - Między grupami k-1 SKOMG = ŚKOMG Wewnątrz grup N-k SKOWG = ŚKOWG � Gdzie: � � SKO N – liczba wszystkich obserwacji k – liczba grup SKO – suma kwadratów odchyleń ŚKO – średni kwadrat odchyleń ŚKO = SKO/Lss Test F-Snedecora dla stopni swobody (k-1, N-k)
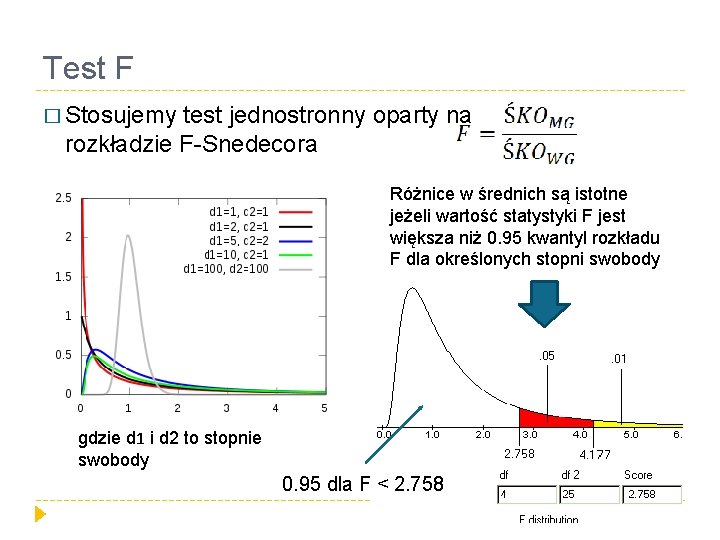
Test F � Stosujemy test jednostronny oparty na rozkładzie F-Snedecora Różnice w średnich są istotne jeżeli wartość statystyki F jest większa niż 0. 95 kwantyl rozkładu F dla określonych stopni swobody gdzie d 1 i d 2 to stopnie swobody 0. 95 dla F < 2. 758
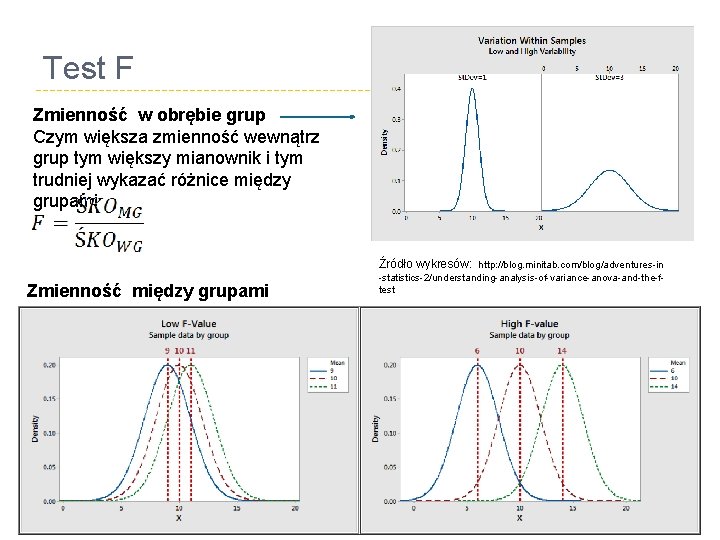
Test F Zmienność w obrębie grup Czym większa zmienność wewnątrz grup tym większy mianownik i tym trudniej wykazać różnice między grupami Źródło wykresów: http: //blog. minitab. com/blog/adventures-in Zmienność między grupami -statistics-2/understanding-analysis-of-variance-anova-and-the-ftest
ANOVA - założenia � Zmienna zależna jest mierzona na skali ilościowej � Zmienne objaśniające są niezależne – losowy dobór do grup � Rozkład wyników w każdej grupie ma rozkład zbliżony do normalnego � Wariancje w grupach są jednorodne (homogeniczność wariancji) � Równoliczność obserwacji w podgrupach Dodatkowo: � Addytywność efektów – brak interakcji, ważne przy analizie wieloczynnikowej
Homogeniczność wariancji i normalność rozkładu a równoliczność grup � Przy różnej liczebności w podgrupach sprawdzamy czy nie ma istotnych odstępst testem chi-kwadrat ANALIZA > TESTY NIEPARAMETRYCZNE > TESTY TRADYCYJNE > CHI-KWADRAT � Przy równolicznych grupach ANOVA jest odporna na brak równości wariancji i normalności rozkładu � Nierównoliczne grupy i brak równości wariancji? Statystyka F będzie przeszacowana, jeśli wariancja jest większa w grupie mniej licznej – większe ryzyko fałszywego odrzucenia H 0 � Statystyka F będzie niedoszacowana, jeśli wariancja jest większa w grupie liczniejszej – większe ryzyko nieodrzucenia fałszywej H 0 �
Analiza wariancji - założenia � Testowanie jednorodności wariancji – test Test Leven’a � Istotny statystycznie wynik wskazuje na różnice w zmienności pomiędzy grupami Założenia do analizy wariancji nie są spełnione SPSS: Eksploracja → Wykresy → Rozrzut-poziom z testem Levene-a → nie przekształcone Bazując na średniej SPSS: Analiza → porównywanie średnich → Jednoczynnikowa ANOVA → opcje → jednorodność wariancji
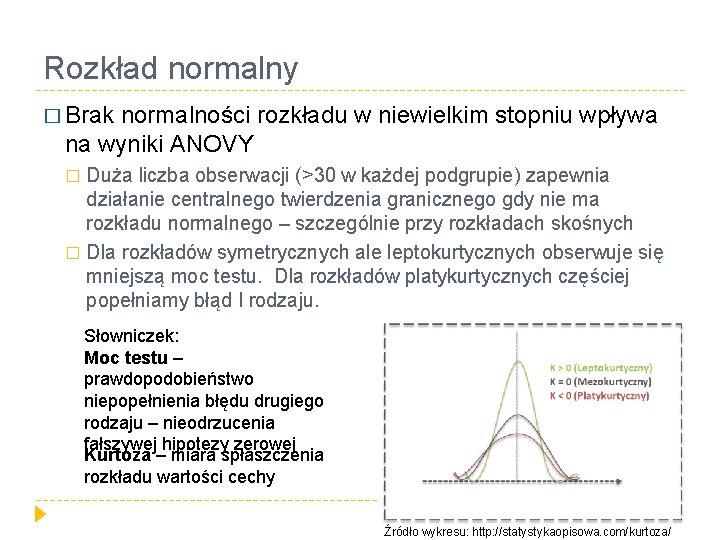
Rozkład normalny � Brak normalności rozkładu w niewielkim stopniu wpływa na wyniki ANOVY Duża liczba obserwacji (>30 w każdej podgrupie) zapewnia działanie centralnego twierdzenia granicznego gdy nie ma rozkładu normalnego – szczególnie przy rozkładach skośnych � Dla rozkładów symetrycznych ale leptokurtycznych obserwuje się mniejszą moc testu. Dla rozkładów platykurtycznych częściej popełniamy błąd I rodzaju. � Słowniczek: Moc testu – prawdopodobieństwo niepopełnienia błędu drugiego rodzaju – nieodrzucenia fałszywej hipotezy zerowej Kurtoza – miara spłaszczenia rozkładu wartości cechy Źródło wykresu: http: //statystykaopisowa. com/kurtoza/
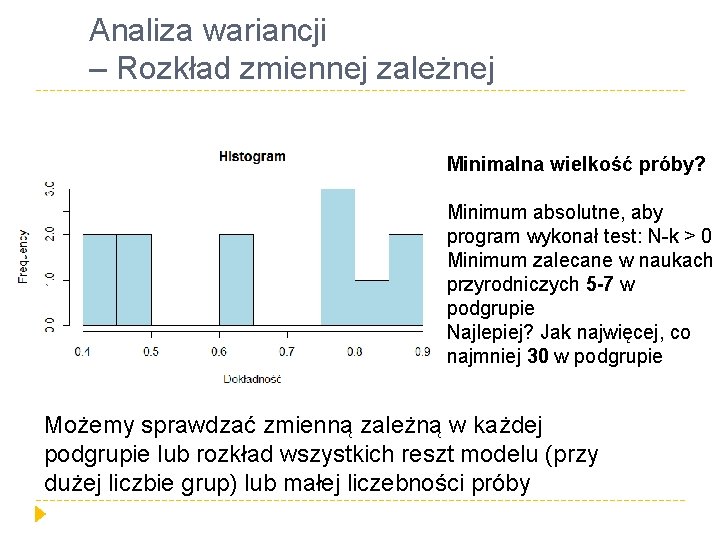
Analiza wariancji – Rozkład zmiennej zależnej Minimalna wielkość próby? Minimum absolutne, aby program wykonał test: N-k > 0 Minimum zalecane w naukach przyrodniczych 5 -7 w podgrupie Najlepiej? Jak najwięcej, co najmniej 30 w podgrupie Możemy sprawdzać zmienną zależną w każdej podgrupie lub rozkład wszystkich reszt modelu (przy dużej liczbie grup) lub małej liczebności próby
Brak jednorodności wariancji � Sprawdzamy czy nie ma obserwacji odstających w grupach � Dokonujemy transformacji zmiennej zależnej � Wykluczamy grupę, w której wariancja różni się od pozostałych � Stosujemy test nieparametryczny � Używamy korekty Welcha lub Brown-Forsythe’a – poprawki do statystyki F uwzględniającej nierówne wariancji. Stosowane wymiennie, jednak test Welcha jest bardziej konserwatywny i ma większą moc. SPSS: Analiza → porównywanie średnich → Jednoczynnikowa ANOVA → opcje → Welch
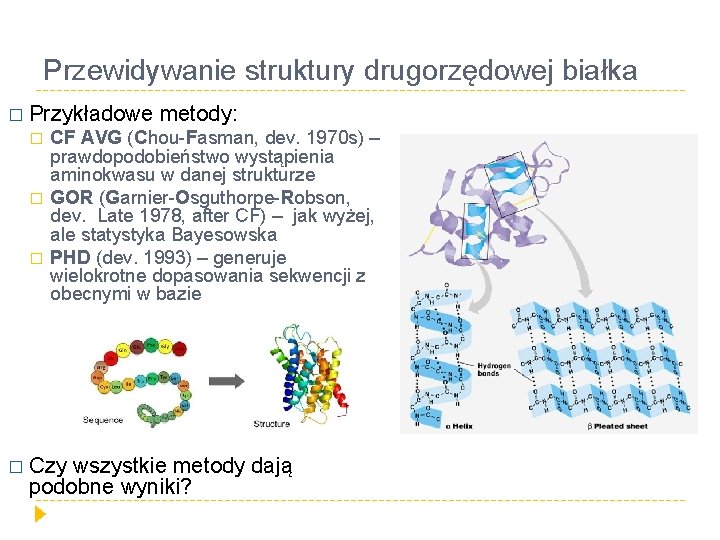
Przewidywanie struktury drugorzędowej białka � Przykładowe metody: � � � CF AVG (Chou-Fasman, dev. 1970 s) – prawdopodobieństwo wystąpienia aminokwasu w danej strukturze GOR (Garnier-Osguthorpe-Robson, dev. Late 1978, after CF) – jak wyżej, ale statystyka Bayesowska PHD (dev. 1993) – generuje wielokrotne dopasowania sekwencji z obecnymi w bazie � Czy wszystkie metody dają podobne wyniki?
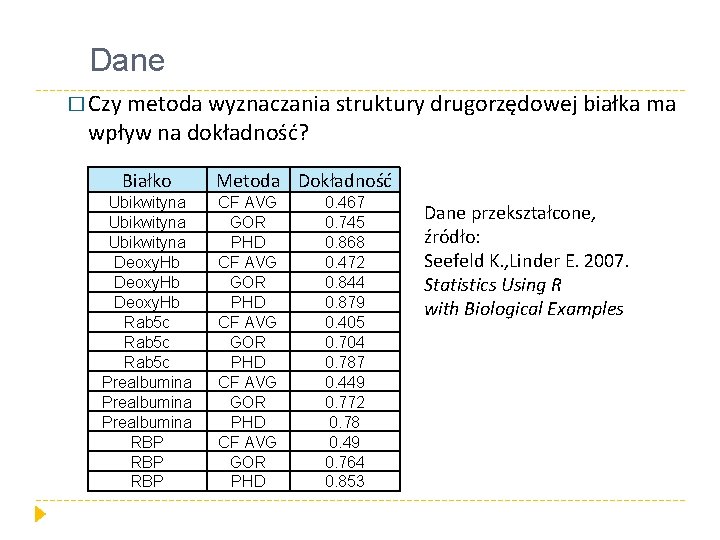
Dane � Czy metoda wyznaczania struktury drugorzędowej białka ma wpływ na dokładność? Białko Ubikwityna Deoxy. Hb Rab 5 c Prealbumina RBP RBP Metoda Dokładność CF AVG GOR PHD CF AVG GOR PHD 0. 467 0. 745 0. 868 0. 472 0. 844 0. 879 0. 405 0. 704 0. 787 0. 449 0. 772 0. 78 0. 49 0. 764 0. 853 Dane przekształcone, źródło: Seefeld K. , Linder E. 2007. Statistics Using R with Biological Examples
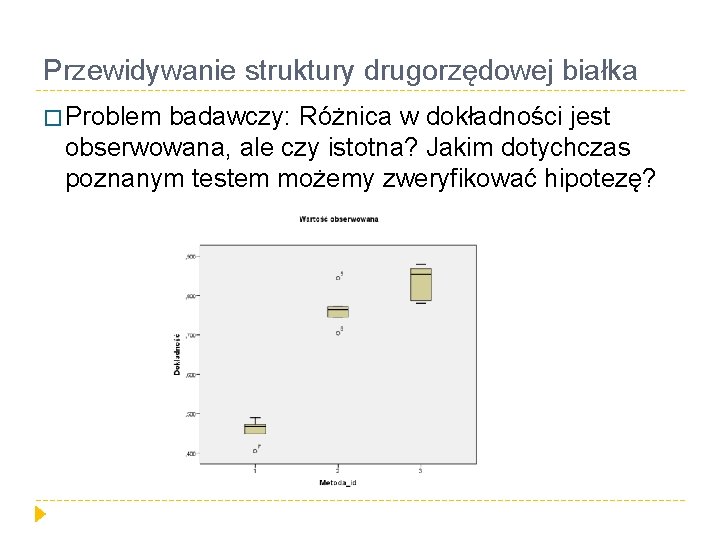
Przewidywanie struktury drugorzędowej białka � Problem badawczy: Różnica w dokładności jest obserwowana, ale czy istotna? Jakim dotychczas poznanym testem możemy zweryfikować hipotezę?
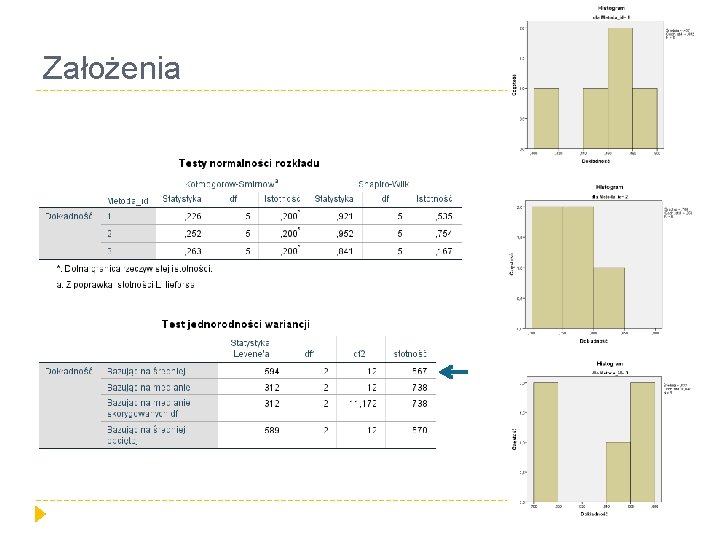
Założenia
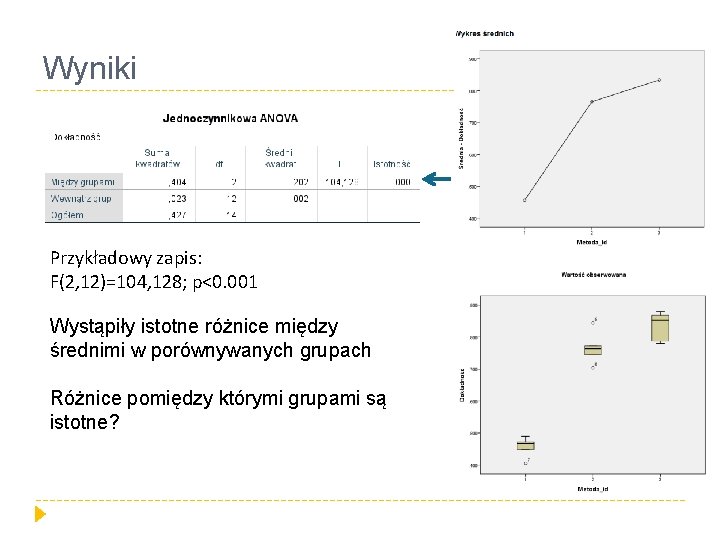
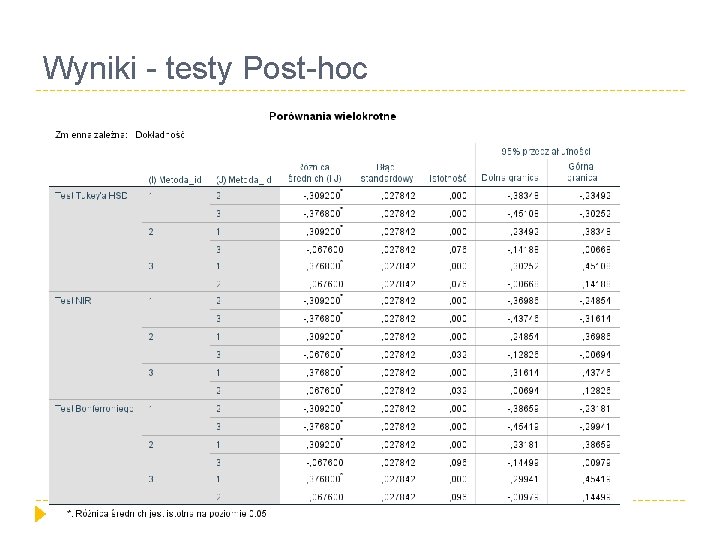
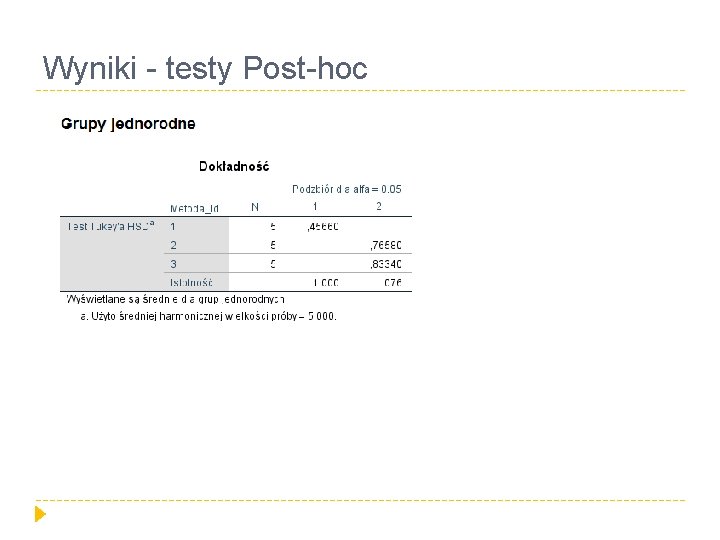
Wyniki Przykładowy zapis: F(2, 12)=104, 128; p<0. 001 Wystąpiły istotne różnice między średnimi w porównywanych grupach Różnice pomiędzy którymi grupami są istotne?
Testy Post-Hoc równoliczne grupy, równe wariancje � Testy post-hoc wykonujemy, kiedy różnice pomiędzy grupami są istotne. � Tukey, nazwy alternatywne: � Po polsku: UIR – test Uczciwie Istotnych Różnic � Po angielsku: HSD – Honestly Significant Differences Test pierwszego wyboru przy spełnionych założeniach. Podobny do poprawki Bonferroniego, ale ma większą moc przy dużej liczbie porównań. � Inne popularne testy: � Dunnett, Duncan
Testy Post-Hoc nierównoliczne grupy, równe wariancje � LSD Fishera, nazwy alternatywne: � Po polsku: NIR – Najmniejsza Istotna Różnica � Po polsku: LSD – Least Squared Difference Polega na wykonaniu k(k-1)/2 testów t-studenta bez poprawki � Bardzo liberalny test, stosowany pomocniczo � � Bonferroni Polega na wykonaniu k(k-1)/2 testów t-studenta z poprawką na liczbę porównań � Poprawka polega na podzieleniu błędu pierwszego rodzaju (α) na liczbę porównań � Nie zakłada się równoliczności grup � Konserwatywny, większa moc przy małej liczbie porównań � � Sheffe – jak wyżej, ale dzieli α na 2 * konserwatywny. k(k-1)/2. Najbardziej
Testy Post-Hoc nierównoliczne grupy, nierówne wariancje � C Dunnetta � Porównania stosowany przy niespełnionych założeniach dla równości wariancji � T 2 Tamhane’a � Konserwatywny test stosowany przy niespełnionych założeniach dla równości wariancji
Wyniki - testy Post-hoc
Wyniki - testy Post-hoc
Zadania � Irysy: Czy działki kielicha różnią się istotnie pomiędzy gatunkami Irysów? źródło: R, pakiet datasets � Wit. D 3: Czy istnieje różnica w ekspresji receptorów CD 14 pod wpływem witaminy D 3 i jej analogów w zależności od zastosowanej terapii oraz mutacji w linii komórkowej? źródło: R, pakiet PBImisc
Źródła � Podręczniki: � � Bedyńska S. , Cypryańska M. 2013. Statystyczny drogowskaz. Praktyczne Wprowadzenie do analizy wariancji. Wydawnictwo akademickie SEDNO. Biecek P. 2013. Analiza danych z programem R. Modele liniowe z efektami stałymi, losowymi, mieszanymi. Wydawnictwo naukowe PWN. Olech W. , Wieczorek M. 2003. Zastosowanie metod statystyki w doświadczalnictwie zootechnicznym. Wydawnictwo SGGW. Seefeld K. , Linder E. 2007. Statistics Using R with Biological Examples. https: //cran. r-project. org/doc/contrib/Seefeld_Stats. RBio. pdf � Wybrane grafiki + polecana lektura poza podręcznikami: � http: //blog. minitab. com/blog/adventures-in-statistics-2/understanding-analysisof-variance-anova-and-the-f-test
- Slides: 28