
INITIERE IN TEORIA RETELELOR NEURALE 1 Sisteme informatice
- Slides: 53
INITIERE IN TEORIA RETELELOR NEURALE 1
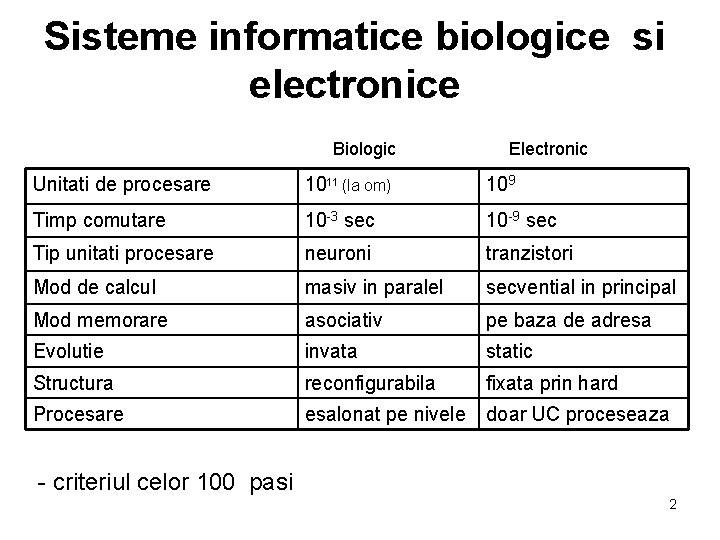
Sisteme informatice biologice si electronice Biologic Electronic Unitati de procesare 1011 (la om) 109 Timp comutare 10 -3 sec 10 -9 sec Tip unitati procesare neuroni tranzistori Mod de calcul masiv in paralel secvential in principal Mod memorare asociativ pe baza de adresa Evolutie invata static Structura reconfigurabila fixata prin hard Procesare esalonat pe nivele doar UC proceseaza - criteriul celor 100 pasi 2
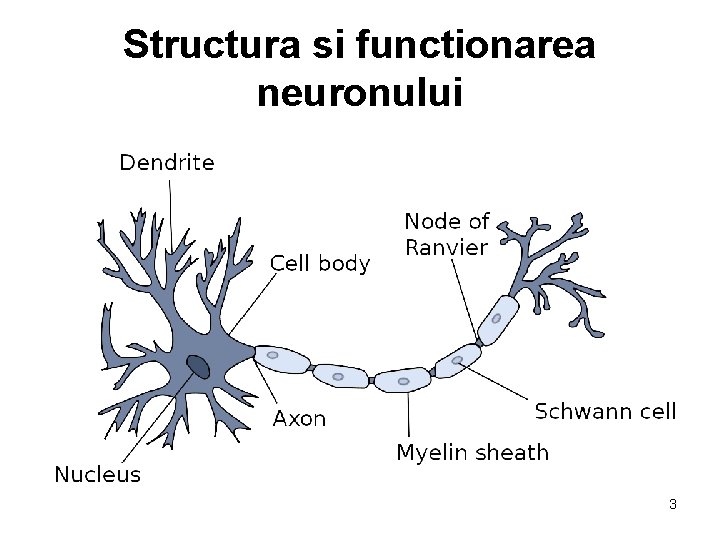
Structura si functionarea neuronului 3
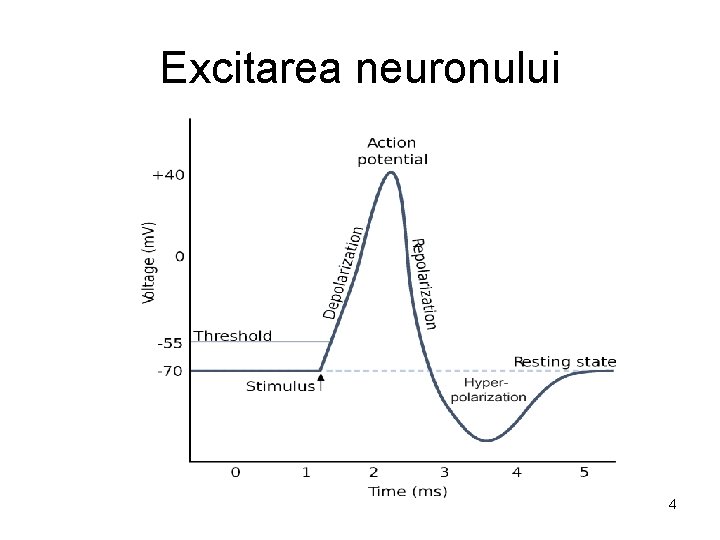
Excitarea neuronului 4
Caracteristicile neuronului • • intrare vectoriala iesire scalara excitatiile sunt cumulate prag peste care neuronul se excita 5
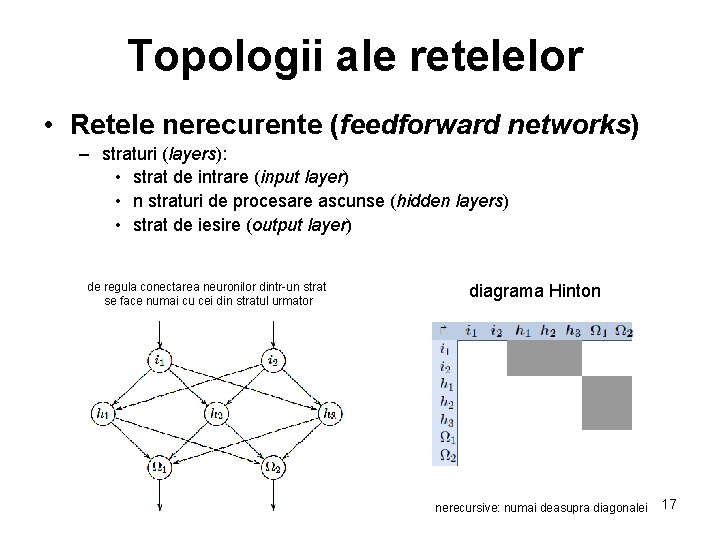
Componentele retelei neurale Definitia retelei: • Triplet (N, V, w) – N : setul de neuroni – V : conexiuni (synapse) intre neronii i si j – w(i, j) – ponderea (weight) conexiunii dintre neuronii i si j -> W : weight matrix – Hinton diagram • neuronul, elementul de baza al retelei 6
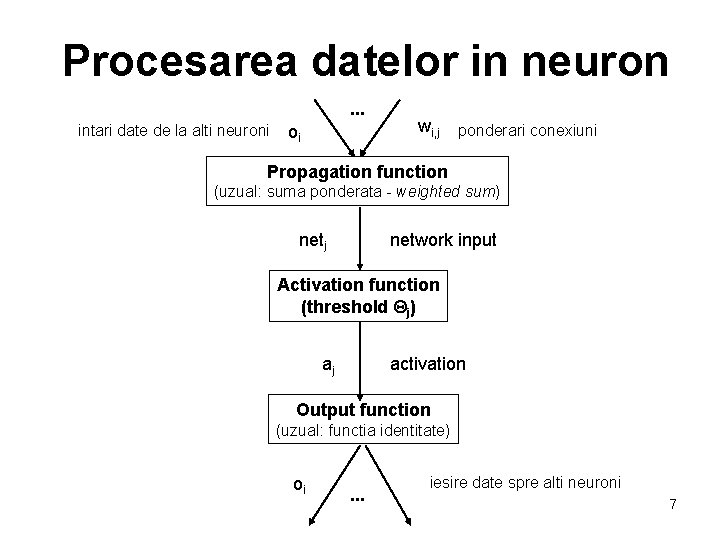
Procesarea datelor in neuron. . . intari date de la alti neuroni oi wi, j ponderari conexiuni Propagation function (uzual: suma ponderata - weighted sum) netj network input Activation function (threshold Qj) aj activation Output function (uzual: functia identitate) oi . . . iesire date spre alti neuroni 7
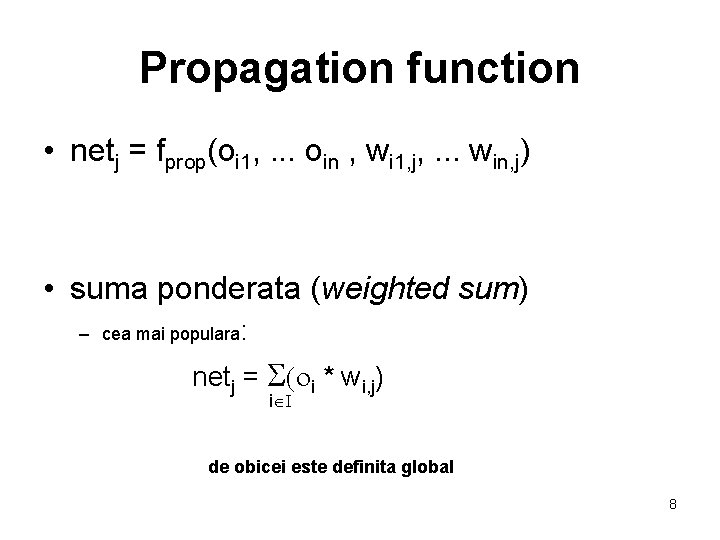
Propagation function • netj = fprop(oi 1, . . . oin , wi 1, j, . . . win, j) • suma ponderata (weighted sum) – cea mai populara: netj = S(oi * wi, j) iÎI de obicei este definita global 8
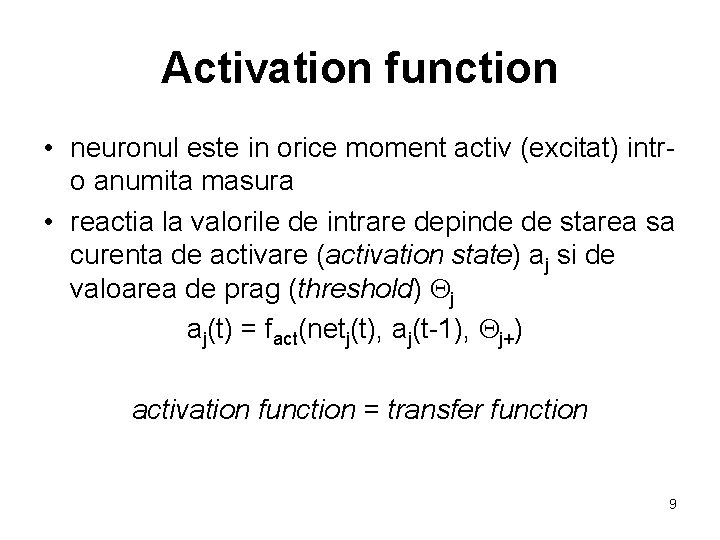
Activation function • neuronul este in orice moment activ (excitat) intro anumita masura • reactia la valorile de intrare depinde de starea sa curenta de activare (activation state) aj si de valoarea de prag (threshold) Qj aj(t) = fact(netj(t), aj(t-1), Qj+) activation function = transfer function 9
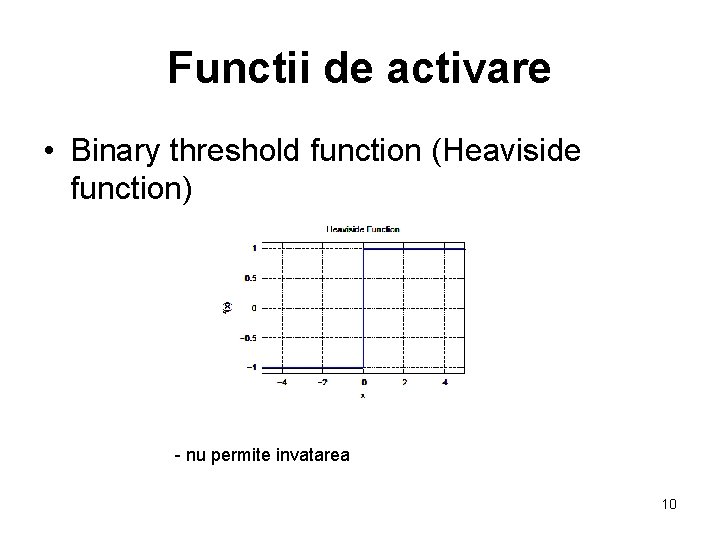
Functii de activare • Binary threshold function (Heaviside function) - nu permite invatarea 10
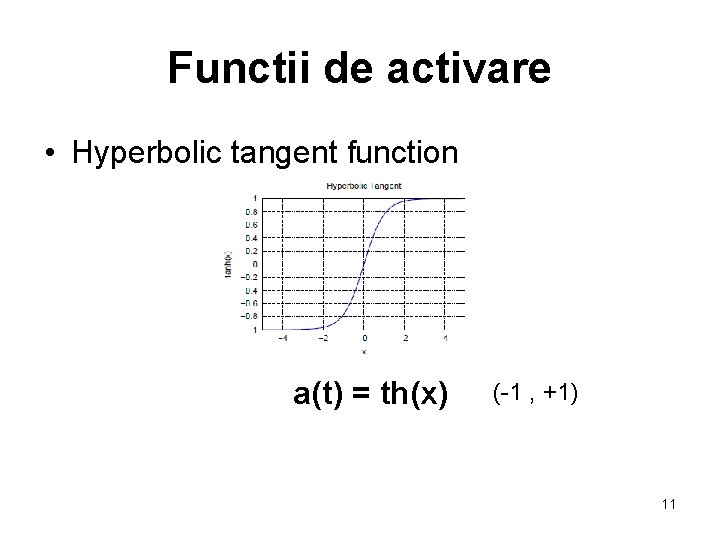
Functii de activare • Hyperbolic tangent function a(t) = th(x) (-1 , +1) 11
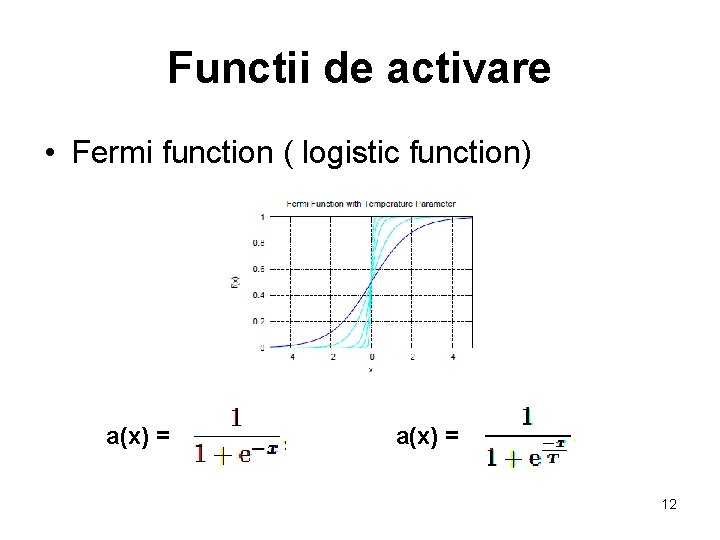
Functii de activare • Fermi function ( logistic function) a(x) = 12
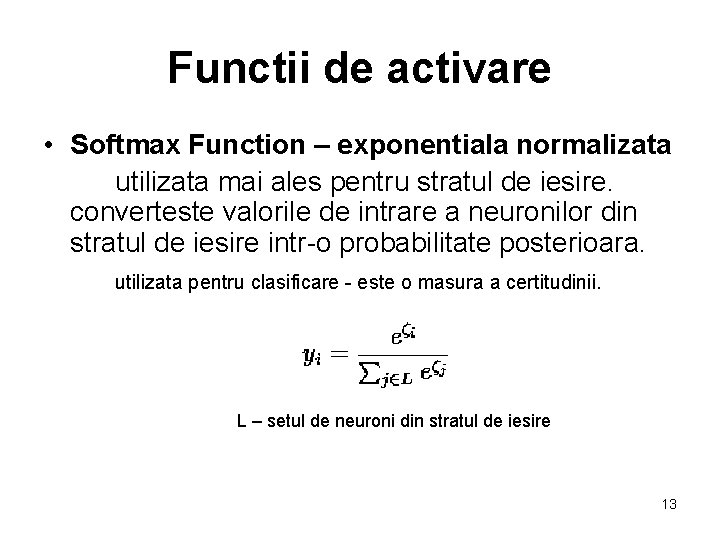
Functii de activare • Softmax Function – exponentiala normalizata utilizata mai ales pentru stratul de iesire. converteste valorile de intrare a neuronilor din stratul de iesire intr-o probabilitate posterioara. utilizata pentru clasificare - este o masura a certitudinii. L – setul de neuroni din stratul de iesire 13
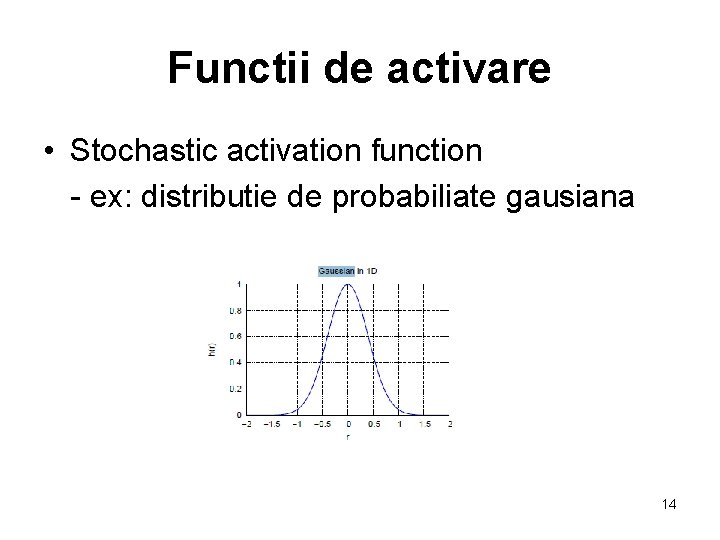
Functii de activare • Stochastic activation function - ex: distributie de probabiliate gausiana 14
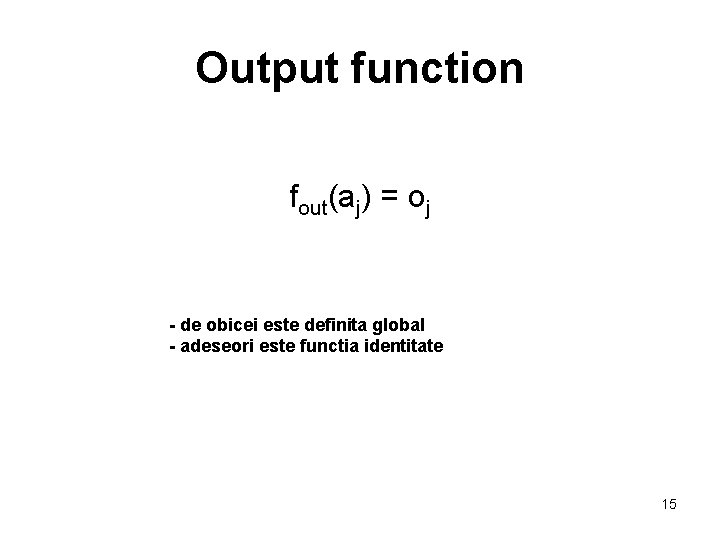
Output function fout(aj) = oj - de obicei este definita global - adeseori este functia identitate 15
Topologii ale retelelor • topoligies = desingns • fiecare topologie e descrisa printr-o diagrama Hinton (nivele de gri pentru legaturile cu pondere ≠ 0) 16
Topologii ale retelelor • Retele nerecurente (feedforward networks) – straturi (layers): • strat de intrare (input layer) • n straturi de procesare ascunse (hidden layers) • strat de iesire (output layer) de regula conectarea neuronilor dintr-un strat se face numai cu cei din stratul urmator diagrama Hinton nerecursive: numai deasupra diagonalei 17
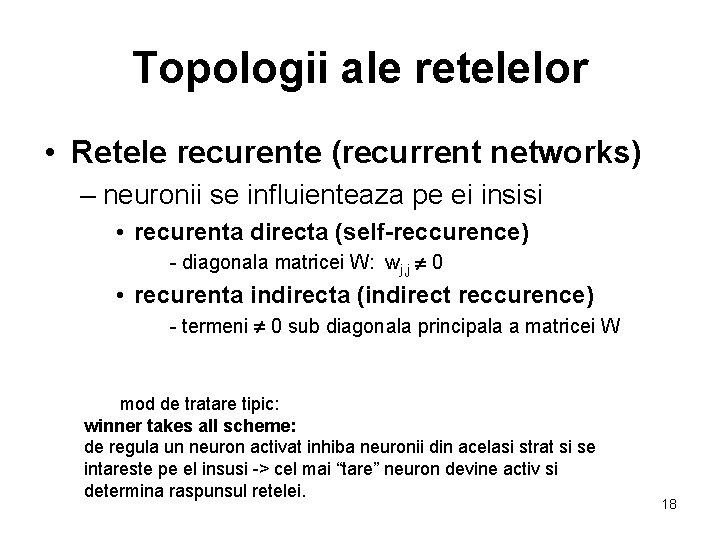
Topologii ale retelelor • Retele recurente (recurrent networks) – neuronii se influienteaza pe ei insisi • recurenta directa (self-reccurence) - diagonala matricei W: wj, j ¹ 0 • recurenta indirecta (indirect reccurence) - termeni ¹ 0 sub diagonala principala a matricei W mod de tratare tipic: winner takes all scheme: de regula un neuron activat inhiba neuronii din acelasi strat si se intareste pe el insusi -> cel mai “tare” neuron devine activ si determina raspunsul retelei. 18
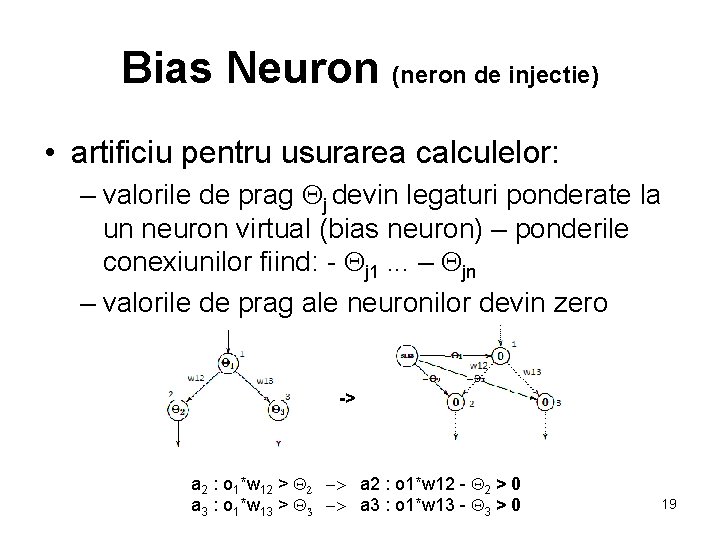
Bias Neuron (neron de injectie) • artificiu pentru usurarea calculelor: – valorile de prag Qj devin legaturi ponderate la un neuron virtual (bias neuron) – ponderile conexiunilor fiind: - Qj 1. . . – Qjn – valorile de prag ale neuronilor devin zero -> a 2 : o 1*w 12 > Q 2 -> a 2 : o 1*w 12 - Q 2 > 0 a 3 : o 1*w 13 > Q 3 -> a 3 : o 1*w 13 - Q 3 > 0 19
Activarea neuronilor • Activare sincrona (Synchronous activation) • Activare asincrona (Asynchronous activation) – ordine aleatoare – permutarea aleatoare – ordine topologica – ordine fixa 20
Fundamente ale invatarii • O retea neurala poate invata prin: 1. 2. 3. 4. 5. 6. 7. dezvoltarea de noi conexiuni eliminarea de conexiuni existente modificarea ponderilor conexiunilor existente modificarea valorilor de prag ale neuronilor dezvolarea de noi neuroni desfiintarea unor neuroni existenti modificarea functiilor neuronului (propagare, activare, iesire) 21
Proceduri de invatare • Procedura de invatare: – algoritm implementat prin programare • Invatare supravegheata (supervised learning) – Antrenare (training) • Invatare nesupravegheata (unsupervised learning) – reteaua identifica patternuri similare pe care sa le clasifice in categorii similare. • Invatare semi-supravegheata (semi-supervised learning) – labeled data – unlabeled data 22
Invatare supravegheata (supervised learning) • Antrenare (training) • P – trainig set – set finit de perechi (p, t) - epoch – p – vectorul de intrare (input pattern), – t - vectorul de iesire dorit (training input) • Etapele invatarii: – se aplica vectorul de intrare (input pattern) – datele de intrare se propaga prin retea pana se genereaza iesirea – se compara iesirea cu vectorul de iesire dorit (teaching input) – se calculeza vectorul diferenta – vectorul de eroare – se calculeza corectiile retelei in functie de vectorul de eroare – se aplica corectiile calculate la retea – criteriul de progres: eroarea patratica medie (uzual) 23
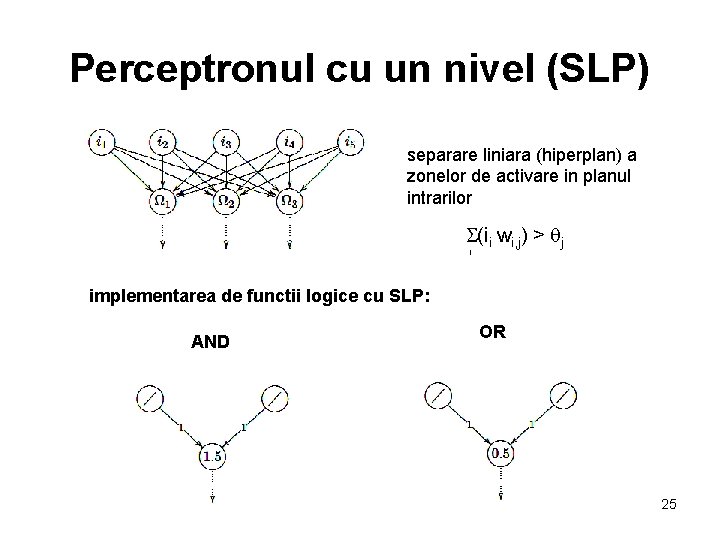
Perceptronul • o retea nerecursiva (feedforward network) care contine: – stratul de intrare (input layer - retina) care legaturi cu pondere fixa (de obicei unitara - identity neurons) cu stratul urmator – unul sau mai multe straturi ascunse (hidden layers) care au legaturi ponderate care se pot modifica (antrenabile) – stratul de iesire (output layer) Reprezentare neuroni (propag/activ): – toate straturile sunt complet conexe cu stratul urmator. Nivel perceptron (numarul de straturi antrenabile): - cu un singur nivel SLP (Singlelayer Perceptron) - cu mai multe nivele MLP (Multilayer Perceptron) 24
Perceptronul cu un nivel (SLP) separare liniara (hiperplan) a zonelor de activare in planul intrarilor S(ii wi, j) > qj i implementarea de functii logice cu SLP: AND OR 25
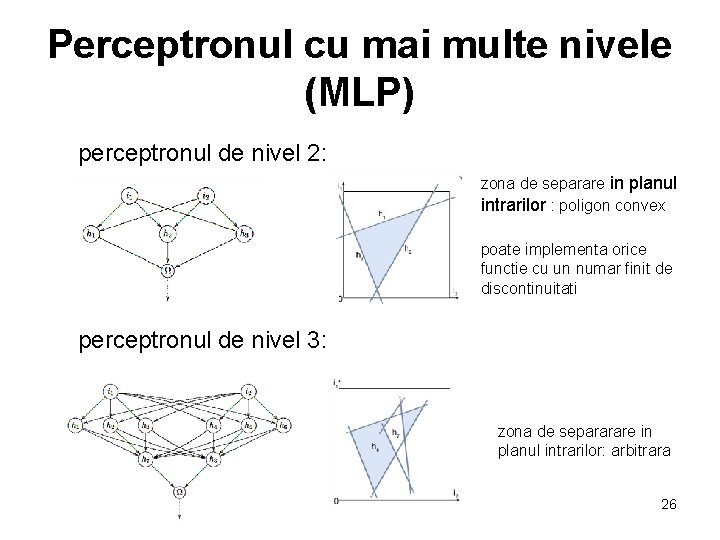
Perceptronul cu mai multe nivele (MLP) perceptronul de nivel 2: zona de separare in planul intrarilor : poligon convex poate implementa orice functie cu un numar finit de discontinuitati perceptronul de nivel 3: zona de separarare in planul intrarilor: arbitrara 26
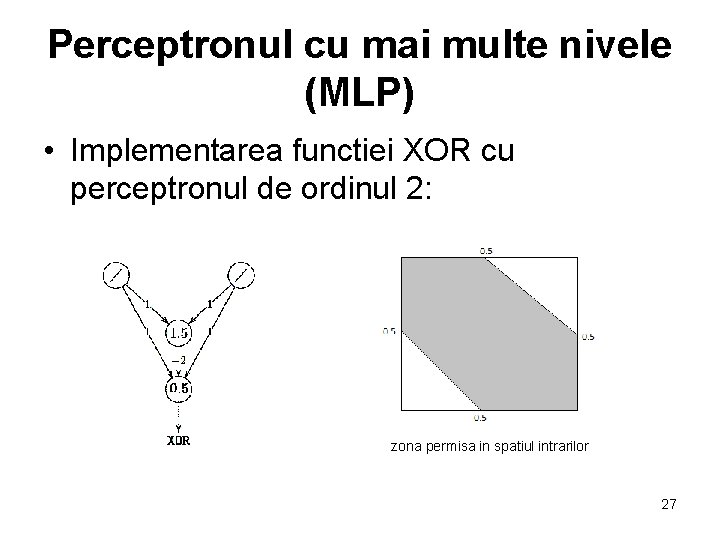
Perceptronul cu mai multe nivele (MLP) • Implementarea functiei XOR cu perceptronul de ordinul 2: zona permisa in spatiul intrarilor 27
Invatarea- legea lui Hebb (Hebbian rule) • sta la baza multor metode de invatare: – neuronul j primeste un stimul de la neuronul i: • daca ambii neuroni se activeaza in acelasi timp atrunci ponderea legaturii wij creste • in caz contrar wij se micsoreaza – learning rate h 28
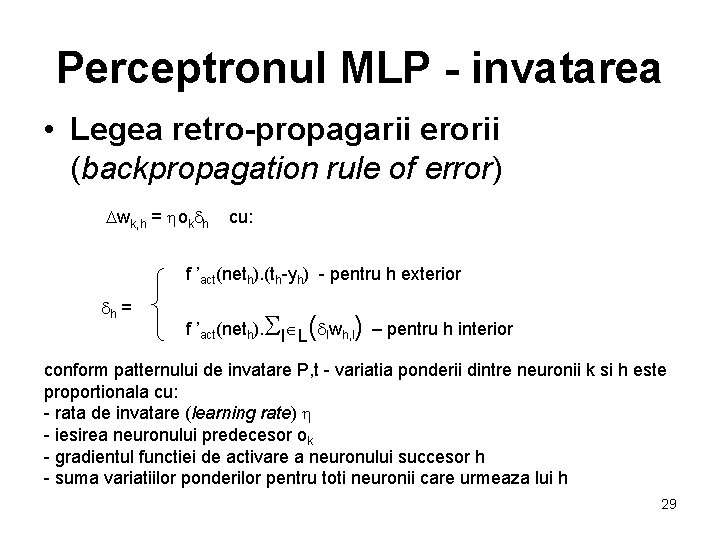
Perceptronul MLP - invatarea • Legea retro-propagarii erorii (backpropagation rule of error) Dwk, h = hokdh cu: f ’act(neth). (th-yh) - pentru h exterior dh = f ’act(neth). SlÎL(dlwh, l) – pentru h interior conform patternului de invatare P, t - variatia ponderii dintre neuronii k si h este proportionala cu: - rata de invatare (learning rate) h - iesirea neuronului predecesor ok - gradientul functiei de activare a neuronului succesor h - suma variatiilor ponderilor pentru toti neuronii care urmeaza lui h 29
Perceptronul MLP - aplicatii • recunoastere automata a vorbirii • recunoastere automata imagini (obiecte, fete umane) • traducere automata 30
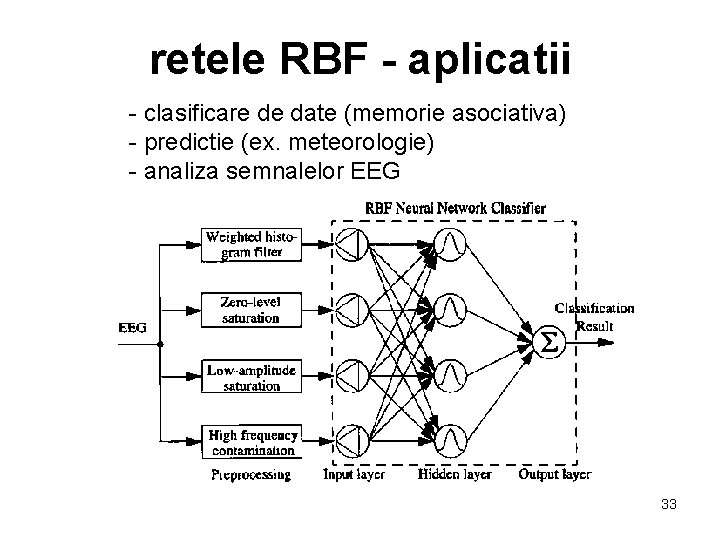
Retele RBF • • RBF: Radial Basis Functions 3 straturi (unul singur ascuns) nerecursiva, complet conexa / strat neuronii de iesire: – functia de propagare: suma ponderata – functia de activare: identitate • neuronii ascunsi: – functia de propagare: norma dintre vectorul de intrare y si centrul neuronului ch – functia de activare: clopotul gaussian 31
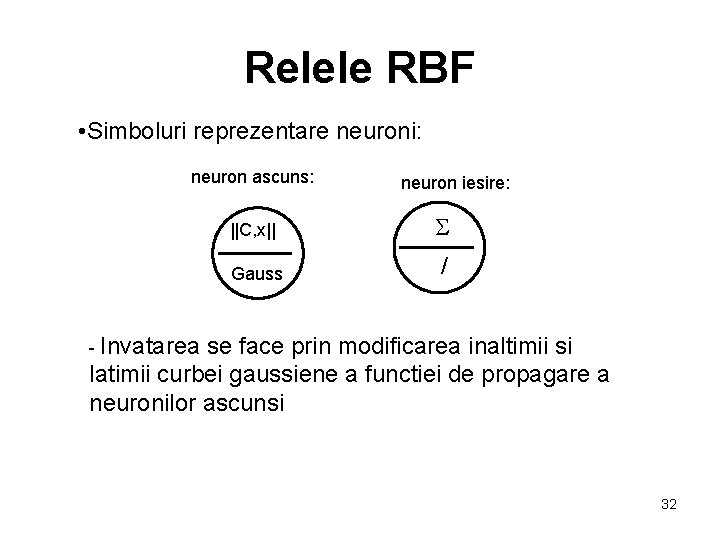
Relele RBF • Simboluri reprezentare neuroni: neuron ascuns: neuron iesire: ||C, x|| S Gauss / - Invatarea se face prin modificarea inaltimii si latimii curbei gaussiene a functiei de propagare a neuronilor ascunsi 32
retele RBF - aplicatii - clasificare de date (memorie asociativa) - predictie (ex. meteorologie) - analiza semnalelor EEG 33
Retele convolutive • Convolutional Neural Network (CNN) - mai multe straturi in care neuronii proceseaza portiuni din imagine - receptive fields. - neuronii din fiecare strat sunt grupati pe volume, avand latime, inaltime si adancime – fiecare strat de pe adancime proceseaza aceiasi portiune de imagine. Aplicatii: recunoatere de imagini, procesarea limbajului natural 34
Retele recurente de tip perceptron (Reccurent Multilayer Perceptron) • in principiu o retea MLP recurenta face mai bine calculele decat un MLP ordinar. • dificil de tratat matematic • probleme de convergenta. 35
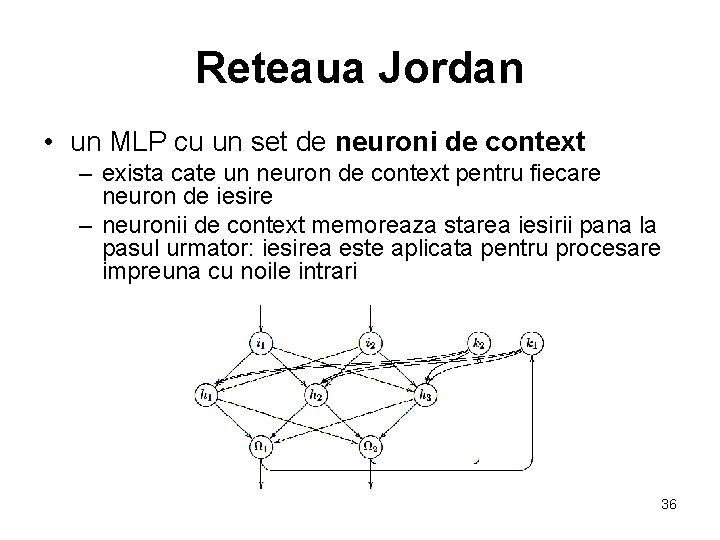
Reteaua Jordan • un MLP cu un set de neuroni de context – exista cate un neuron de context pentru fiecare neuron de iesire – neuronii de context memoreaza starea iesirii pana la pasul urmator: iesirea este aplicata pentru procesare impreuna cu noile intrari 36
Reteaua Hopfield • complet conexa: nu se poate separa pe straturi • fiecare neuron are definit un spin binar: (functie de activare binara) • comportare asemanatoare unor particule intr-un camp magnetic • aplicatii : modelarea memoriei asociative, recunoasteri si completari de patternuri 37
Reteaua LVQ • LVQ : Learning Vector Quantization • pasul de trecere spre retele care invata fara supraveghere: retele SOM (Self Organinzing feature Maps) • spatiul intrarilor e divizat in zone separate (discretization, quantification); fiecare zona are un vector reprezentativ codebook vector. • zonele nu trebuie sa fie neaparat disjuncte – se pot suprapune partial 38
Retele LVQ - Invatarea supervizata - initializare: se plaseaza vectorii codebook in mod aleator - se aplica patternul de antrenare P - se masoara distanta ||P-C|| - se determina vectorul codebook cel mai apropiat: min ||P-ci|| (winner) 39
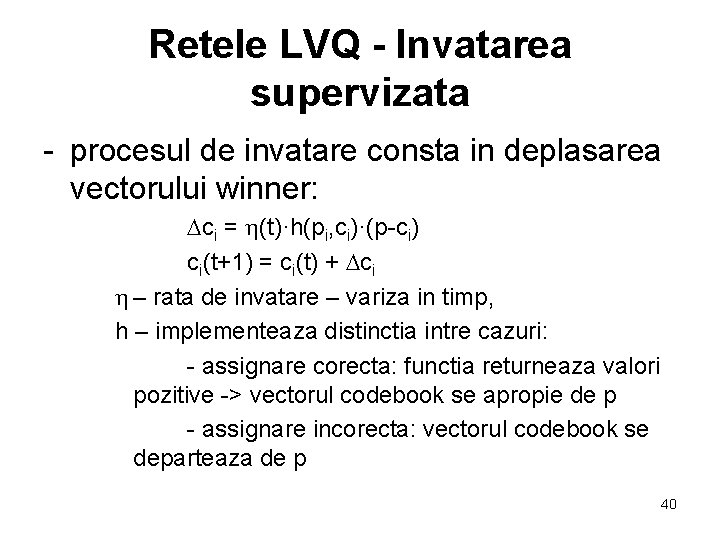
Retele LVQ - Invatarea supervizata - procesul de invatare consta in deplasarea vectorului winner: Dci = h(t)·h(pi, ci)·(p-ci) ci(t+1) = ci(t) + Dci h – rata de invatare – variza in timp, h – implementeaza distinctia intre cazuri: - assignare corecta: functia returneaza valori pozitive -> vectorul codebook se apropie de p - assignare incorecta: vectorul codebook se departeaza de p 40
Retele SOM – cu invatare nesupervizata • SOM (Self Organinzing feature Maps) • intereseaza neuronul care este activ – nu intereseaza valorea exacta a iesirii (biologic: intereseaza care muschi e actionat si nu cat de tare) • Structura: – N : spatiul intrarilor – G : gridul pe care asezati neuronii conform relatiilor de vecinatate -> topologia retelei – neuron SOM este un neuron cu centrul ck in spatiul intrarilor – un SOM este un set de K neuroni SOM – relatiile de vecinatate sunt definite de functia toplogica (topology function) h(i, k, t), unde i este nuronul castigator (winner) – dimensiunea topologiei este G – metoda: pentru un set de intrare P neuronul castigator (cu norma minima) determina raspunsul retelei (winner take all scheme) 41
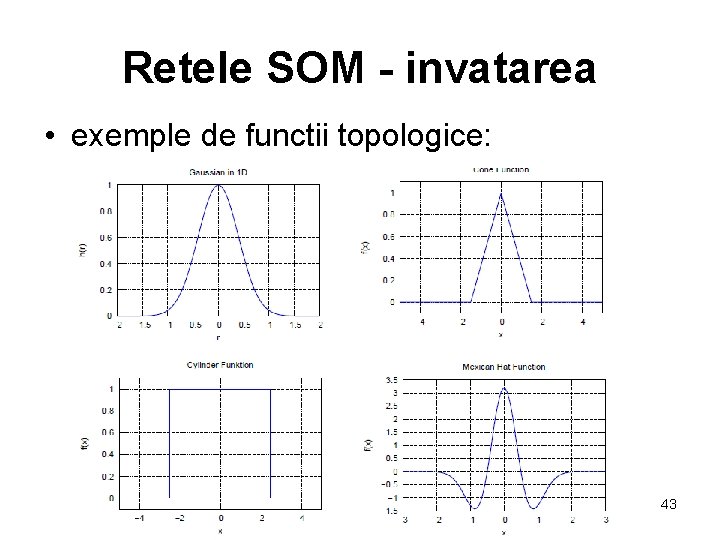
Retele SOM - invatarea • la inceput: invatare supraveheata (procedura ca la retelele LVQ) • functia topologica: – determina cum influienteaza vecinii un neuron in timpul invatarii – valori mari – vecinatate mai apropiata – trebuie sa fie unimodala (un singur maxim – la neuronul castigator) 42
Retele SOM - invatarea • exemple de functii topologice: 43
Retele SOM - aplicatii • implementare memorie asociativa cu invatare spontana • recunoastere vocala • clasificare dupa caracteristici • meteorologie si oceanografie (previziune) • prioritizare proiecte mari pe faze • extragerea de informatii relevante din volumuri mari de date (data mining) 44
Implementarea retelelor • simulare prin procesare secventiala (microprocesoare) evolutie: - cresterea vitezei si a puterii de procesare: - cresterea densitatii (rezolutie 14 nm. . . 5 nm in 2020 ) - > cresterea vitezei de procesare (cap si ind parazite) - crestere temperatura -> scadere tensiune de lucru unitate centrala de la 5 V la 0. 8 V - registri mari 32 b - 64 b - 128 b (IBM) - 256 b si 512 b (graphic processor) - cresterea capacitatii si vitezei mediilor de memorare si stocare a datelor - paralelizarea procesarii secventiale: sisteme multi-core, sisteme multi- chips (cu sute de procesoare lucrand in paralel) 45
Implementarea retelelor • Simulare prin procesare paralela - FPGA - care pot contine: CPU, MEM, DSP ; FLOPS (Floating Point OPerations per Second) ; MAC (Multiply ACcumulate) - dezvoltarea de hardware virtual (Hardware virtualization) utilizand limbaje de programare specifice: VHDL (Virtual Hardware Description Language) - dezvoltarea de programe conform standardului Open. CL pentru sisteme hibride - se impart sarcinile pe componentele hard in functie de gradul de paralelism dorit in prelucrare - ex. sumarile ponderate pe neuron se pot realiza eficient in DSP-uri sau se pot implenta hard in FPGA. • Realizare de circuite specializate (neuromorphic computing) True. North – IBM 4096 nuclee cu 256 neuroni programabili – fiecare cu 256 synapses 2014: Sy. NAPSE chip - Sy. NAPSE University Neurogrid – Standford Univ. calcul analogic – simuleza 106 neurons si 109 synapses viteza retelei: 10 pasi/sec 46
Clase de probleme care se pot rezolva cu ajutorul retelelor neuronale • • Clasificare si recunoastere: recunoasterea caracterelor, recunoasterea vorbirii, clasificarea semnalelor (ex: clasificarea electrocardiogramelor in normale sau patologice), etc. Gruparea si categorizarea datelor: analiza si compresia datelor. Aproximare si estimare: extragerea dependentei functionale dintre doua marimi pornind de la un set de valori ale celor doua marimi (in general valorile sint alterate de zgomot). Predictie: aproximarea urmatoarei valori din serie. Ex: predictia evolutiei stocurilor, predictia in meteorologie, etc. Optimizare: proiectarea circuitelor electronice, alocarea resurselor, probleme de rutare in retea, etc. Stocarea si regasirea informatiei dupa continut: memoria asociativa proiectarea bazelor de date multimedia. Modelare si control adaptiv: Reteaua neuronala este antrenata pornind de la un model de referinta. Prelucrarea si analiza semnalelor. 47
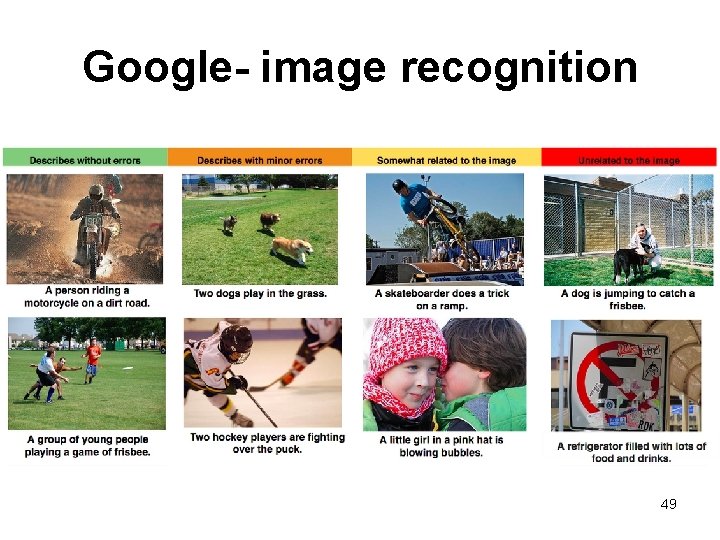
Google- image recognition • Colaborare intre Google si Stanford University. • descrie intreaga scena , nu doar obiecte individuale. • algoritmii utilizati incearca sa explice ceea ce se petrece in imagini intr-un limbaj natural coerent • se utilizeaza doua retele neurale: una pentru recunoastere de imagini si cealalta pentru procesarea limbajului natural; retelele au 10 -30 straturi. • retelele sunt antrenate cu milioane de exemple care ajusteaza gradual parametrii pana ce se obtin rezultatele dorite. (cazul semi-supervized learning) http: //gizmodo. com/googles-image-recognition-software-can-now-describe-ent-1660033808 http: //googleresearch. blogspot. ro/2014/09/building-deeper-understanding-of-images. html#uds-search-results 48
Google- image recognition 49
ANNABELL • ANNABELL – Artificial Neural Network with Adaptive Behaviour Exploited for Language Learning. • Grup de cercetători italieni (Universitatea din Sassari), în colaborare cu cercetători de la universitatea din Plymouth din Marea Britanie • creier artificial format cu o retea neurala cu circa 2 milioane de neuroni • antrenata cu 1585 de propoziţii, care conţin diverse cuvinte şi părţi gramaticale • reteaua învaţă, fiind capabila, pe baza a ceea ce a învăţat, să converseze cu cercetătorii; comportare echivalenta cu un copil de 4 ani. 50
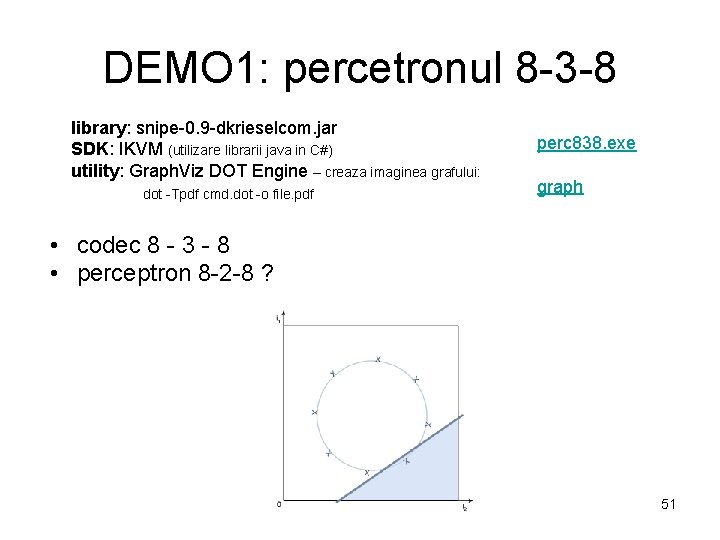
DEMO 1: percetronul 8 -3 -8 library: snipe-0. 9 -dkrieselcom. jar SDK: IKVM (utilizare librarii java in C#) utility: Graph. Viz DOT Engine – creaza imaginea grafului: dot -Tpdf cmd. dot -o file. pdf perc 838. exe graph • codec 8 - 3 - 8 • perceptron 8 -2 -8 ? 51
DEMO 2: retea 4 -7 -3 - retera nerecursiva: - input layer : 4 neuroni - hidden layer : 7 neuroni - functia de activare : tanh - out layer : 3 neuroni - functia de activare: softmax nndemo graph • invatare : criteriul cross entropy error (in loc de eroarea patratica medie) - setul de date din biologie : 3 specii de irisi - vectorul de intrare 4 valori : lungimea si latimea sepalelor si a petalelor in cm - iesiri in functie de specie: – setosa = 0 0 1, versicolor = 0 1 0, virginica = 1 0 0 - 180 de epochs din care 150 pentru antrenare 30 pentru testare • la sfarsit: graful retelei 52
Bibliografie http: //www. doc. ic. ac. uk/~nd/surprise_96/journal/vol 4/cs 11/report. html http: //www. dkriesel. com/en/science/neural_networks http: //www. codeproject. com/Articles/1035958/Neuro-Sim https: //github. com/cliftonm/neurosim http: //www. brindusescu. org/article_4_lang_ro https: //en. wikibooks. org/wiki/Artificial_Neural_Networks http: //www. cs. bham. ac. uk/~jxb/NN/l 14. pdf https: //www. byclb. com/TR/Tutorials/neural_networks/ 53