
Informativno predavanje o klaster raunarima Nataa Babaev Igor
Informativno predavanje o klaster računarima Nataša Babačev / Igor Jeremić matematički fakultet • Message Passing Interface • Rešavanje linearnih sistema jednačina velikih dimenzija • Rešavanje Poissonove PDJ
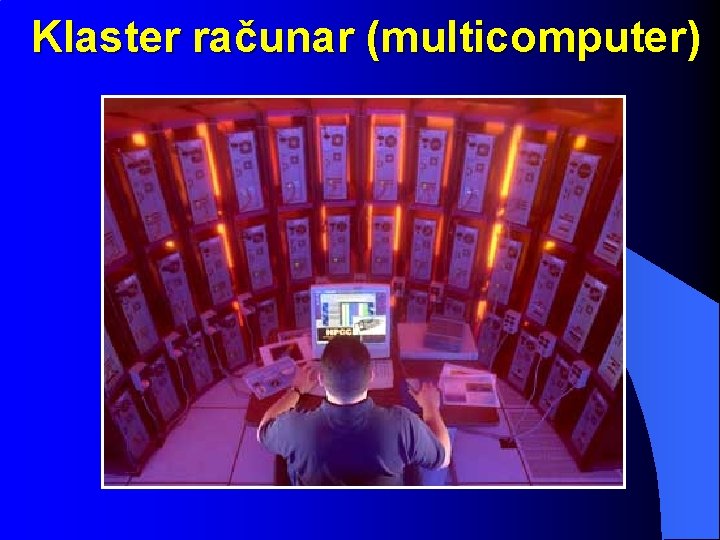
Klaster računar (multicomputer)
Kako ubrzati zahtevne proračune Korišćenjem boljeg hardware-a Optimizacijom algoritama Korišćenjem distribuiranih računarskih sistema
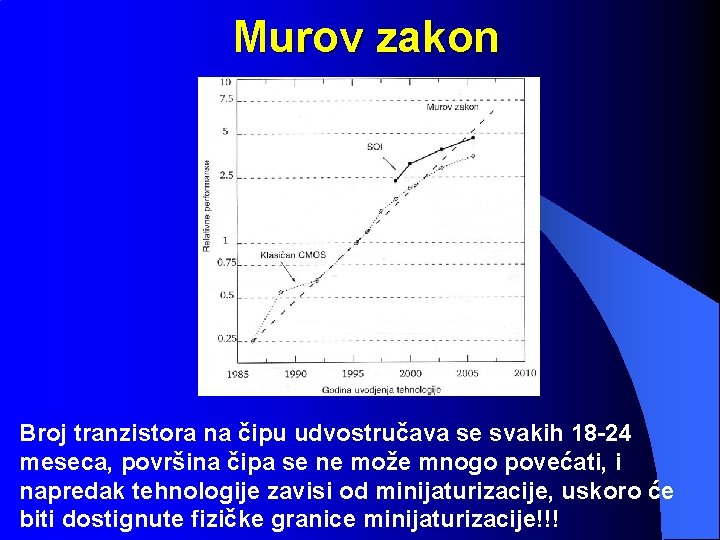
Murov zakon Broj tranzistora na čipu udvostručava se svakih 18 -24 meseca, površina čipa se ne može mnogo povećati, i napredak tehnologije zavisi od minijaturizacije, uskoro će biti dostignute fizičke granice minijaturizacije!!!
Murov zakon Rešenje problema! Promena tehnologije Kvantni računari Biohemijski i DNK zasnovani nanoračunari Mehanički nanoračunari Paralelizacija već postojećih računarskih sistema (može se iskoristiti i na računarima novih tehnologija)
Klaster računar predstavlja grupu povezanih autonomnih računara koji rade zajedno kao jedan paralelni računar Labavo vezan višeprocesorski sistem Svaki računar u mreži može imati više procesora Računari mogu deliti isti disk prostor (NFS) Distribuirana Memorija OS: Li. NUX + software Beowulf (oba su besplatna) Skalabilnost celog sistema Otkazivanjem nekog čvora ne dolazi do pada sistema
Klaster u odnosu na druge sisteme mainframe
Klaster u odnosu na druge sisteme Vector supercomputer
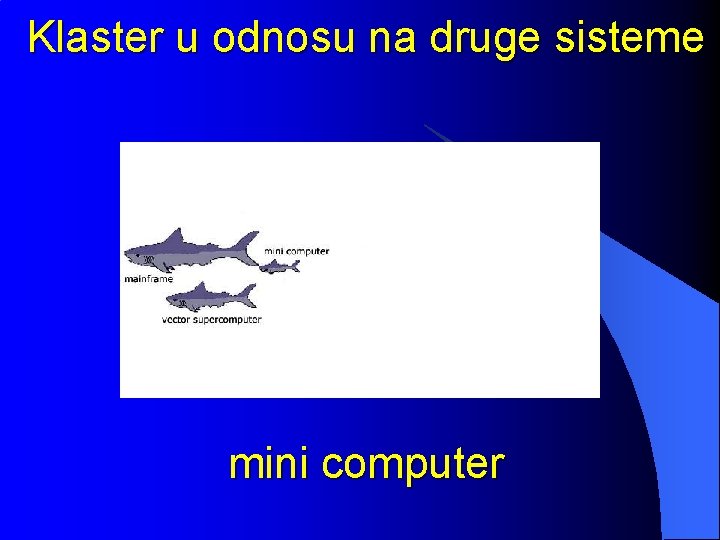
Klaster u odnosu na druge sisteme mini computer
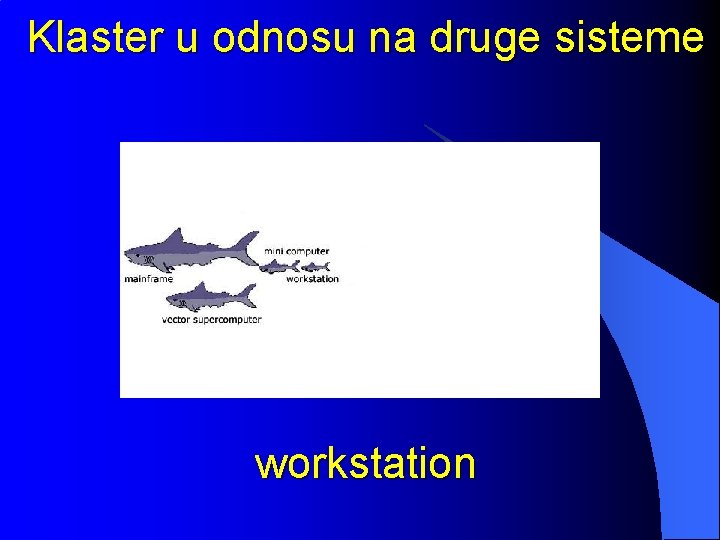
Klaster u odnosu na druge sisteme workstation
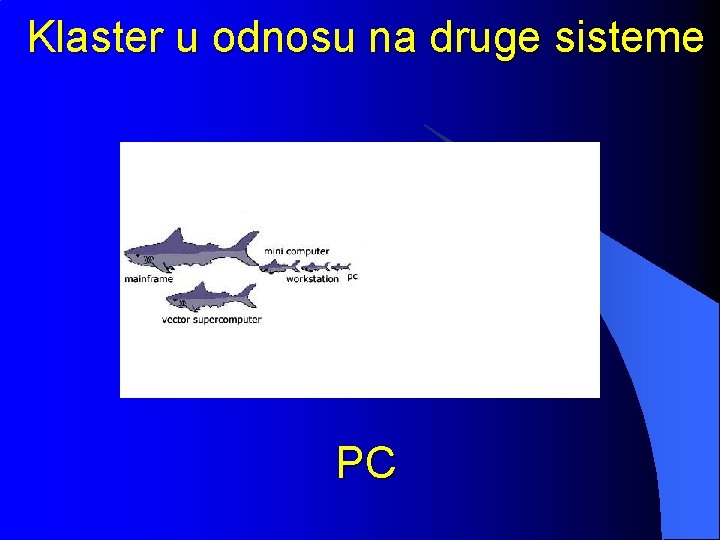
Klaster u odnosu na druge sisteme PC
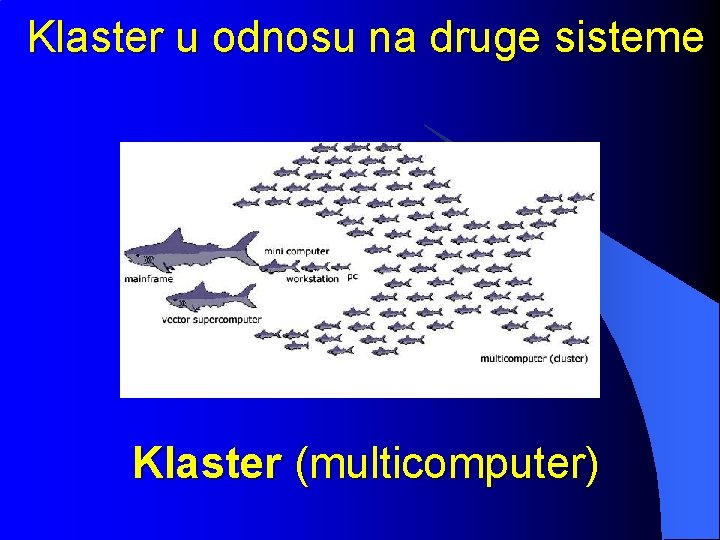
Klaster u odnosu na druge sisteme Klaster (multicomputer)
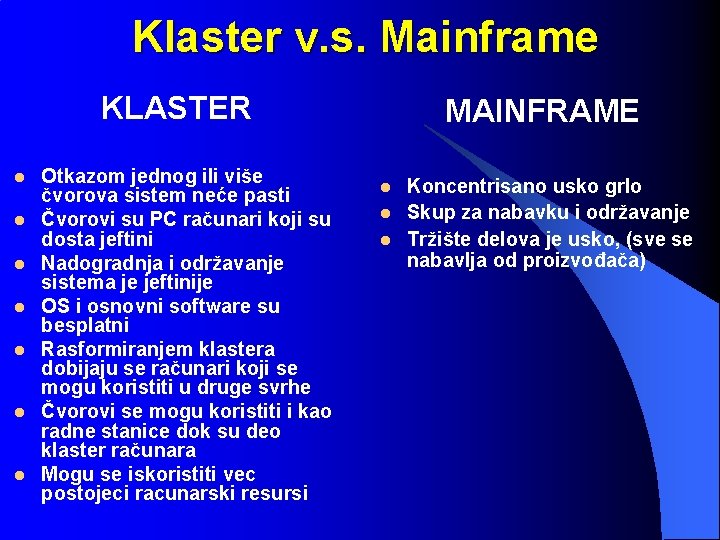
Klaster v. s. Mainframe KLASTER l l l l Otkazom jednog ili više čvorova sistem neće pasti Čvorovi su PC računari koji su dosta jeftini Nadogradnja i održavanje sistema je jeftinije OS i osnovni software su besplatni Rasformiranjem klastera dobijaju se računari koji se mogu koristiti u druge svrhe Čvorovi se mogu koristiti i kao radne stanice dok su deo klaster računara Mogu se iskoristiti vec postojeci racunarski resursi MAINFRAME l l l Koncentrisano usko grlo Skup za nabavku i održavanje Tržište delova je usko, (sve se nabavlja od proizvođača)
Klaster računar Dva najčešća razloga za korišćenje klaster računara su • Poboljšanje performansi, paralelno izračunavanje • Povećanje sigurnosti sistema (dva simetrična računara rade isti posao, u slučaju otkaza jednog računara sistem neće pasti)
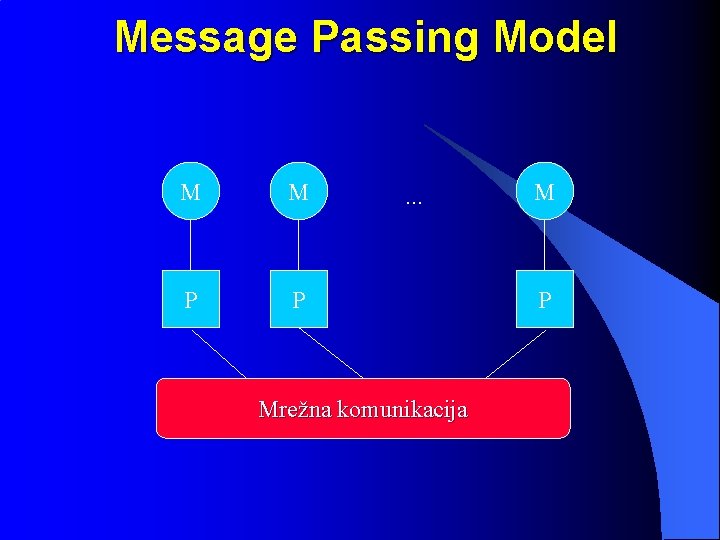
Message Passing Model М M P P . . . Mrežna komunikacija M P
MPI (Message Passing Interface) MPI predstavlja specifikaciju standarda biblioteke za rutina za razmenu poruka između čvorova klaster računara MPI standard je definisan od strane “MPI Forum-a” http: //www. mpi-forum. org/ Razvijeno je više implementacija MPI standarda Podržani jezici su C, C++ i FORTRAN MPICH je besplatna implementacija MPI standarda
MPI standard Podržan je MIMD model paralelnog izračunavanja, takođe podržan je i SPMD model Omogućava portabilnost koda Efikasna implementacija na različitim arhitekturama Funkcionalnost biblioteke Podrška za heterogene paralelne arhitekture • Ne bavi se: • Učitavanjem procesa u procesore • Zamenom procesa tokom izvršavanja • Debagovanjem • Paralelnim upisom i ispisom podataka
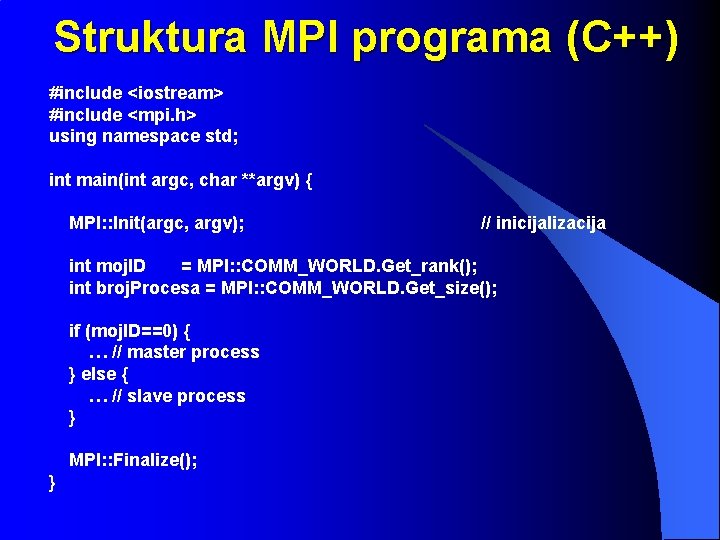
Struktura MPI programa (C++) #include <iostream> #include <mpi. h> using namespace std; int main(int argc, char **argv) { MPI: : Init(argc, argv); // inicijalizacija int moj. ID = MPI: : COMM_WORLD. Get_rank(); int broj. Procesa = MPI: : COMM_WORLD. Get_size(); if (moj. ID==0) { … // master process } else { … // slave process } MPI: : Finalize(); }
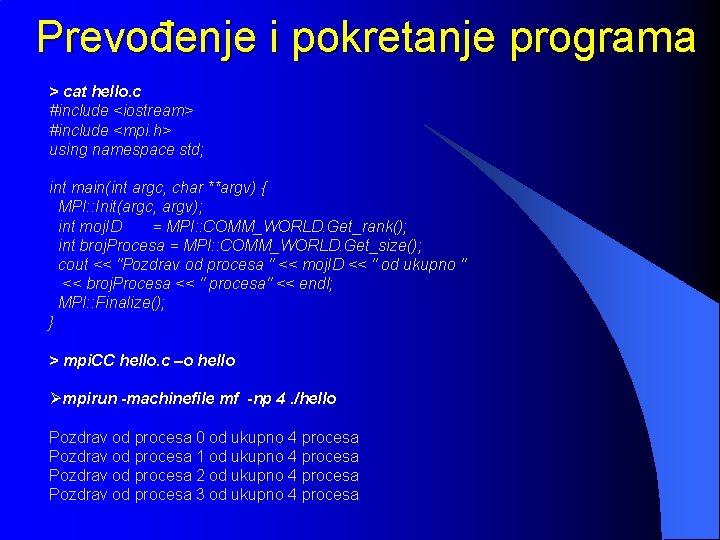
Prevođenje i pokretanje programa > cat hello. c #include <iostream> #include <mpi. h> using namespace std; int main(int argc, char **argv) { MPI: : Init(argc, argv); int moj. ID = MPI: : COMM_WORLD. Get_rank(); int broj. Procesa = MPI: : COMM_WORLD. Get_size(); cout << "Pozdrav od procesa " << moj. ID << " od ukupno " << broj. Procesa << " procesa" << endl; MPI: : Finalize(); } > mpi. CC hello. c –o hello Ømpirun -machinefile mf -np 4. /hello Pozdrav od procesa 0 od ukupno 4 procesa Pozdrav od procesa 1 od ukupno 4 procesa Pozdrav od procesa 2 od ukupno 4 procesa Pozdrav od procesa 3 od ukupno 4 procesa
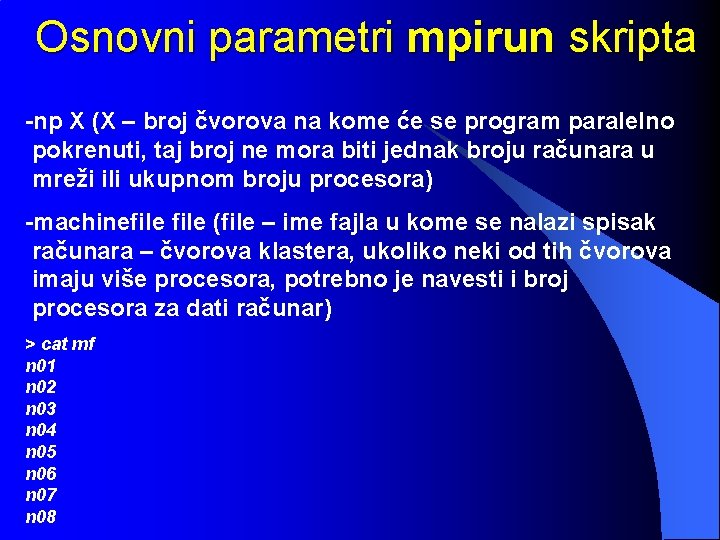
Osnovni parametri mpirun skripta -np X (X – broj čvorova na kome će se program paralelno pokrenuti, taj broj ne mora biti jednak broju računara u mreži ili ukupnom broju procesora) -machinefile (file – ime fajla u kome se nalazi spisak računara – čvorova klastera, ukoliko neki od tih čvorova imaju više procesora, potrebno je navesti i broj procesora za dati računar) > cat mf n 01 n 02 n 03 n 04 n 05 n 06 n 07 n 08
Osnovne funkcije • MPI: : Init(argc, argv) inicijalizuje proces koji će razmenjivati poruke sa drugim procesima, poziva se iz main() f-je i argumenti su mu argumenti main() f-je. • MPI: : Finalize() poziva se na kraju života procesa • MPI: : COMM_WORLD. Get_rank(); vraća identifikacioni broj procesa • MPI: : COMM_WORLD. Get_size(); vraća ukupan broj procesa koji učestvuju u izračunavanju (ovaj broj je fiksan, i zadaje se pri pokretanju programa kao parametar skripte mpirun)
Međuprocesna komunikacija • Direktna komunikacija između procesa (Point-to-point) • Sinhrona i Asinhrona komunikacija • Blocking & Nonblocking komunikacija • Kolektivna komunikacija • Sinhronizacija • Kolektivne operacije
Point-to-point: MPI_Send() • MPI: : COMM_WORLD. Send (void *podatak, int dužina, MPI_Datatype tip, int dest, int tag) • podatak – pokazivač na memorijsku lokaciju na kojoj se nalaze podaci za slanje • dužina – dužina podatka koji se šalje (dužina kao broj elemenata niza podatak a ne u bajtovima) • MPI_Datatype – tip podatka koji se šalje • dest – rang odredišnog procesa (primaoca) • tag – dodatni identifikator podatka
Point-to-point: MPI_Recv() • MPI: : COMM_WORLD. Recv (void *podatak, int dužina, MPI_Datatype tip, int src, int tag) • podatak – pokazivač na memorijsku lokaciju na kojoj se nalaze podaci za slanje • dužina – dužina podatka koji se šalje (dužina kao broj elemenata niza podatak a ne u bajtovima) • MPI_Datatype – tip podatka koji se šalje • src – rang pošiljaoca • tag – dodatni identifikator podatka
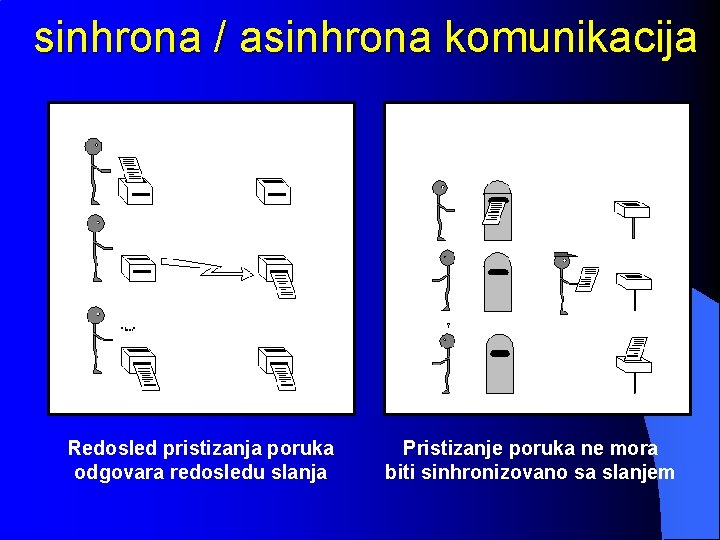
sinhrona / asinhrona komunikacija Redosled pristizanja poruka odgovara redosledu slanja Pristizanje poruka ne mora biti sinhronizovano sa slanjem
blocking / non-blocking • Blocking Funkcija je blokirana dok poruka ne bude odaslata ili primljena • Non-blocking Funkcija po slanju prepušta programu dalje izvršavanje, ne vodeći računa o tome da li je slanje poruke završeno
Kolektivna komunikacija • Svi procesi u komunikatoru pozivaju funkciju • Procesi nastavljaju rad tek kad svi izađu iz funkcije • Nema oznake komunikacije (tag) • Tri tipa kolektivne komunikacije
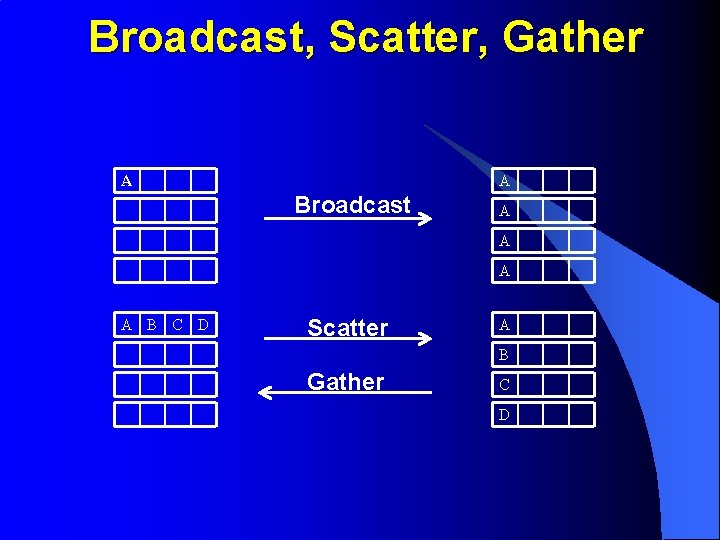
Broadcast, Scatter, Gather A A Broadcast A A B C D Scatter A B Gather C D
Kolektivne operacije MPI: : COMM_WORLD. Reduce (sendbuf, recvbuf, count, datatype, op, root) • Računa rezultat podataka iz grupe procesa • Rezultat upisuje u recvbuf koji prima samo proces root • Operacije (op): • Globalni maksimum, minimum • Zbir, proizvod • Logičke operacije • Korisnički definisane (user-defined)
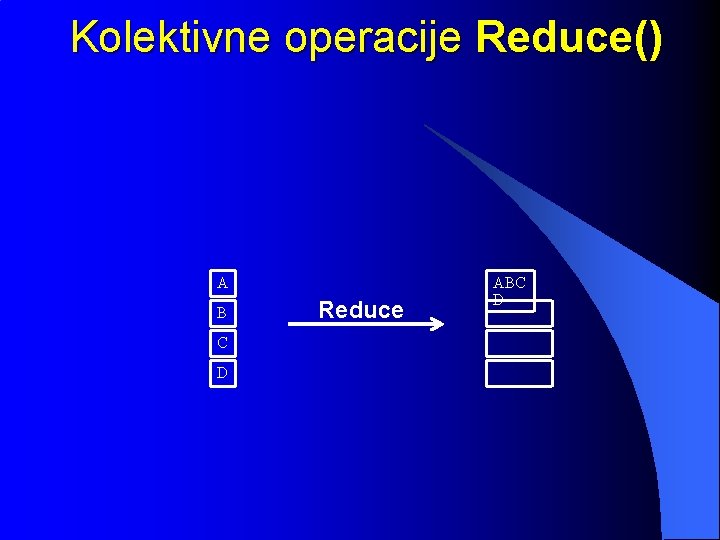
Kolektivne operacije Reduce() A B C D Reduce ABC D
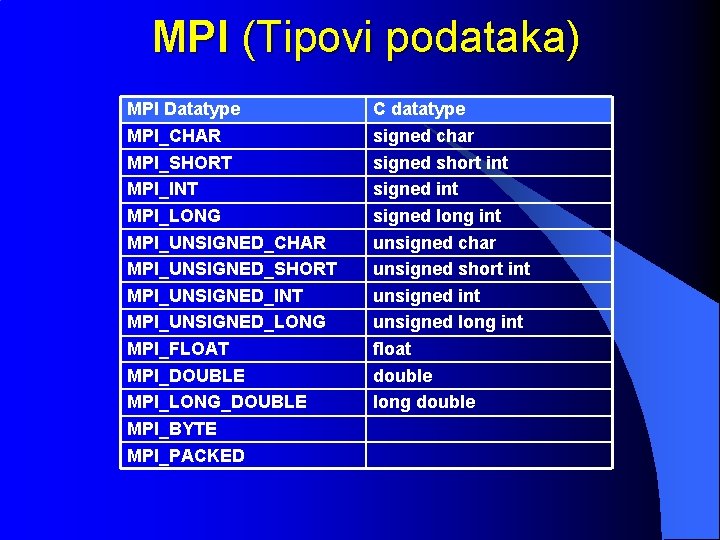
MPI (Tipovi podataka) MPI Datatype MPI_CHAR MPI_SHORT MPI_INT MPI_LONG MPI_UNSIGNED_CHAR MPI_UNSIGNED_SHORT MPI_UNSIGNED_INT MPI_UNSIGNED_LONG MPI_FLOAT MPI_DOUBLE MPI_LONG_DOUBLE MPI_BYTE MPI_PACKED C datatype signed char signed short int signed long int unsigned char unsigned short int unsigned long int float double long double
Analiza pre kodiranja Pre pisanja paralelnog programa potrebno je: • U potpunosti razumeti sekvencijalno rešenje problema • Izvršiti analizu različitih algoritamskih strategija • Uporediti model deljene memorije (npr. pthreads, open-MP, . . . ) ili model distribuirane memorije (MPI) • Uporediti razne tipove komunikacija
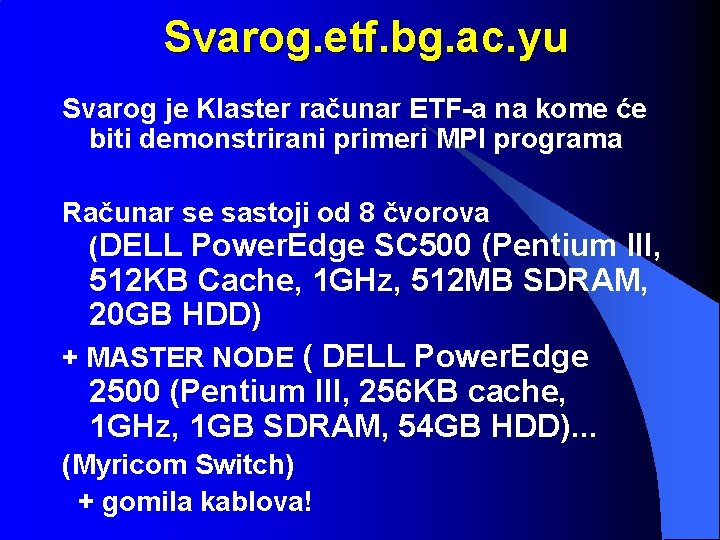
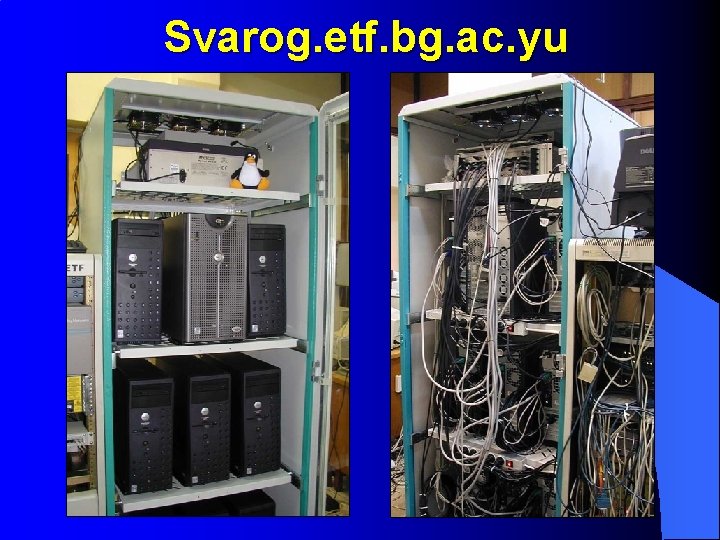
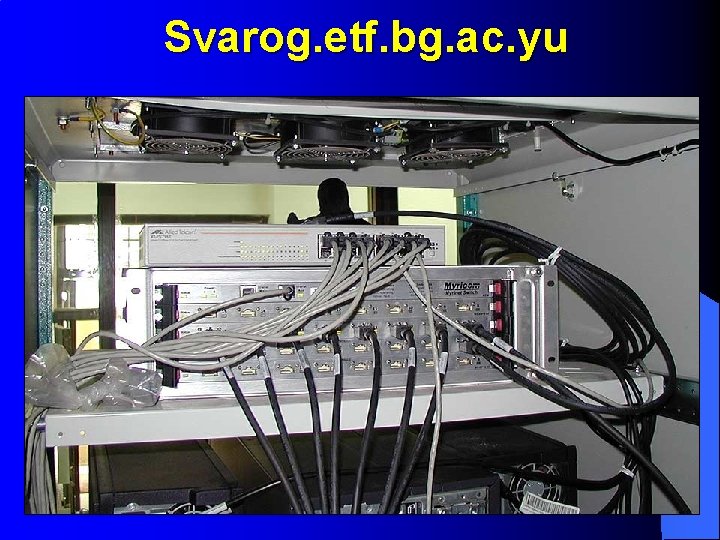
Svarog. etf. bg. ac. yu Svarog je Klaster računar ETF-a na kome će biti demonstrirani primeri MPI programa Računar se sastoji od 8 čvorova (DELL Power. Edge SC 500 (Pentium III, 512 KB Cache, 1 GHz, 512 MB SDRAM, 20 GB HDD) + MASTER NODE ( DELL Power. Edge 2500 (Pentium III, 256 KB cache, 1 GHz, 1 GB SDRAM, 54 GB HDD). . . (Myricom Switch) + gomila kablova!
Svarog. etf. bg. ac. yu
Svarog. etf. bg. ac. yu
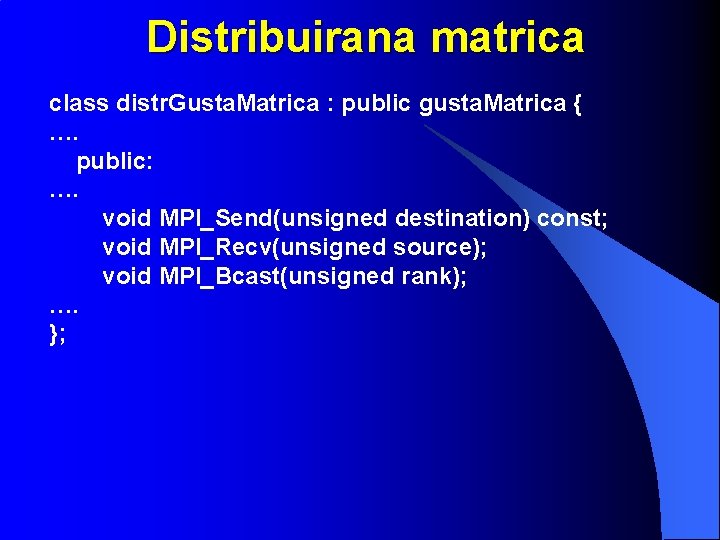
Distribuirana matrica class distr. Gusta. Matrica : public gusta. Matrica { …. public: …. void MPI_Send(unsigned destination) const; void MPI_Recv(unsigned source); void MPI_Bcast(unsigned rank); …. };
Direktna metoda – Kramer • Složenost O(n 3) – primer je nerealan! • Nije primenljiva za velike sisteme • Dobar primer za kolektivnu komunikaciju Ideja algoritma: • Master proces učitava ili generiše sistem jednačina • Broadcast metodom šalje matricu sistema i slobodan vektor svim nodovima • Slave procesi primaju matricu sistema i slobodan vektor i čekaju komande • Master javlja slave procesima koje determinante da računaju • Master i sam računa neke od determinanti • Slave vraćaju izračunate rezultate • Master skuplja rezultate i tumači ih (deli dobijene rezultate sa determinantom sistema)
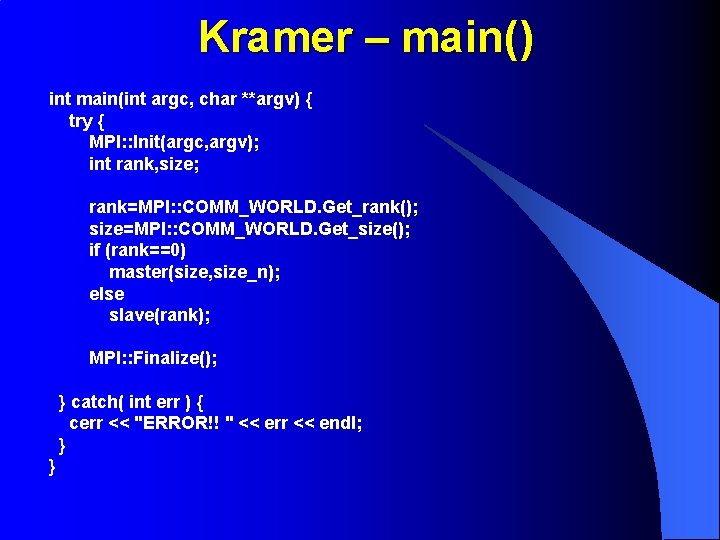
Kramer – main() int main(int argc, char **argv) { try { MPI: : Init(argc, argv); int rank, size; rank=MPI: : COMM_WORLD. Get_rank(); size=MPI: : COMM_WORLD. Get_size(); if (rank==0) master(size, size_n); else slave(rank); MPI: : Finalize(); } catch( int err ) { cerr << "ERROR!! " << err << endl; } }
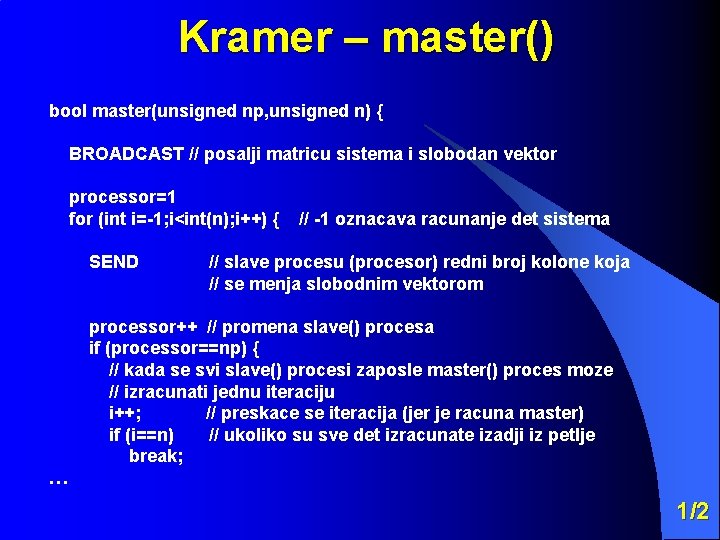
Kramer – master() bool master(unsigned np, unsigned n) { BROADCAST // posalji matricu sistema i slobodan vektor processor=1 for (int i=-1; i<int(n); i++) { SEND // -1 oznacava racunanje det sistema // slave procesu (procesor) redni broj kolone koja // se menja slobodnim vektorom processor++ // promena slave() procesa if (processor==np) { // kada se svi slave() procesi zaposle master() proces moze // izracunati jednu iteraciju i++; // preskace se iteracija (jer je racuna master) if (i==n) // ukoliko su sve det izracunate izadji iz petlje break; … 1/2
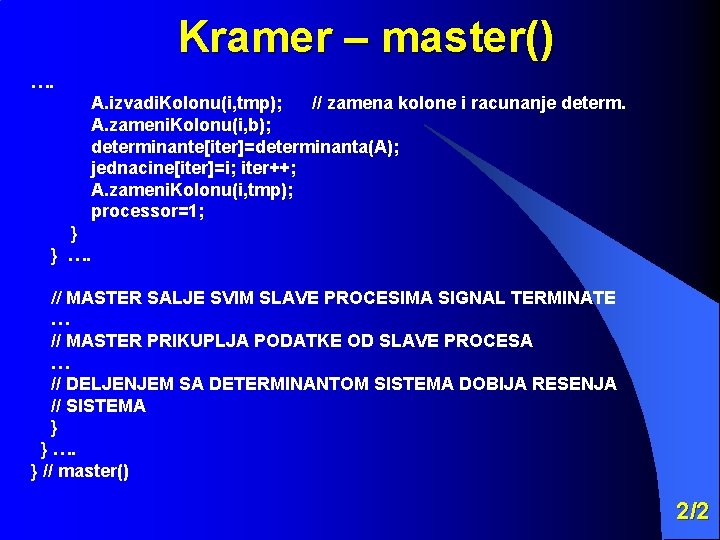
Kramer – master() …. A. izvadi. Kolonu(i, tmp); // zamena kolone i racunanje determ. A. zameni. Kolonu(i, b); determinante[iter]=determinanta(A); jednacine[iter]=i; iter++; A. zameni. Kolonu(i, tmp); processor=1; } } …. // MASTER SALJE SVIM SLAVE PROCESIMA SIGNAL TERMINATE … // MASTER PRIKUPLJA PODATKE OD SLAVE PROCESA … // DELJENJEM SA DETERMINANTOM SISTEMA DOBIJA RESENJA // SISTEMA } } …. } // master() 2/2
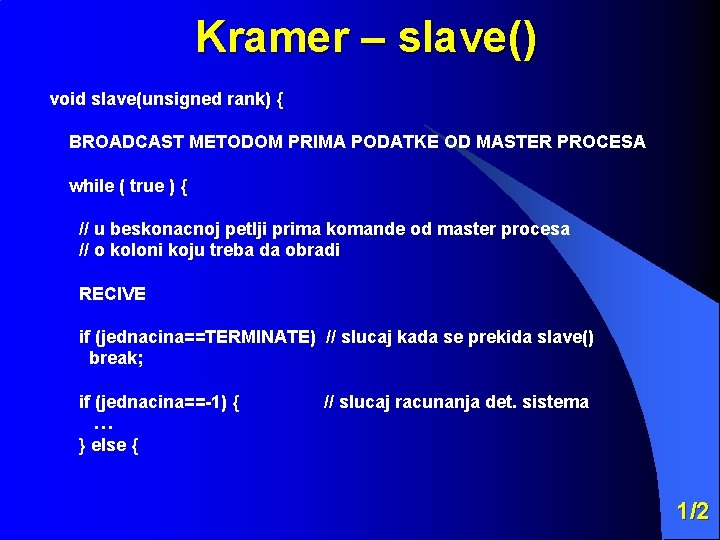
Kramer – slave() void slave(unsigned rank) { BROADCAST METODOM PRIMA PODATKE OD MASTER PROCESA while ( true ) { // u beskonacnoj petlji prima komande od master procesa // o koloni koju treba da obradi RECIVE if (jednacina==TERMINATE) // slucaj kada se prekida slave() break; if (jednacina==-1) { … } else { // slucaj racunanja det. sistema 1/2
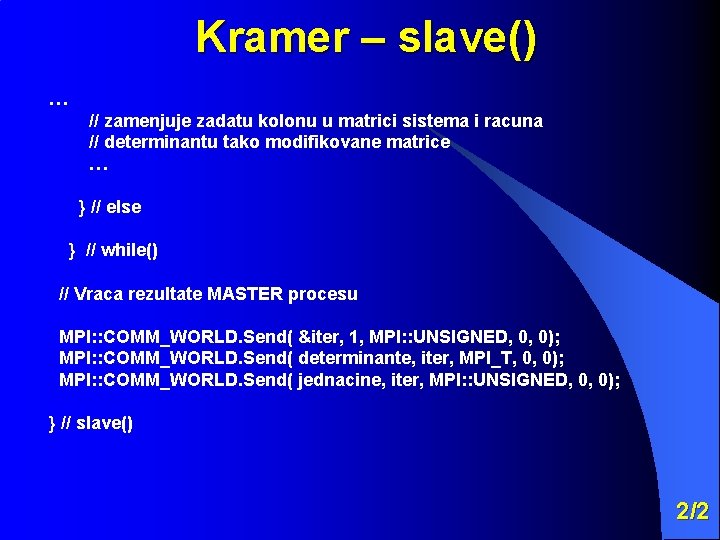
Kramer – slave() … // zamenjuje zadatu kolonu u matrici sistema i racuna // determinantu tako modifikovane matrice … } // else } // while() // Vraca rezultate MASTER procesu MPI: : COMM_WORLD. Send( &iter, 1, MPI: : UNSIGNED, 0, 0); MPI: : COMM_WORLD. Send( determinante, iter, MPI_T, 0, 0); MPI: : COMM_WORLD. Send( jednacine, iter, MPI: : UNSIGNED, 0, 0); } // slave() 2/2
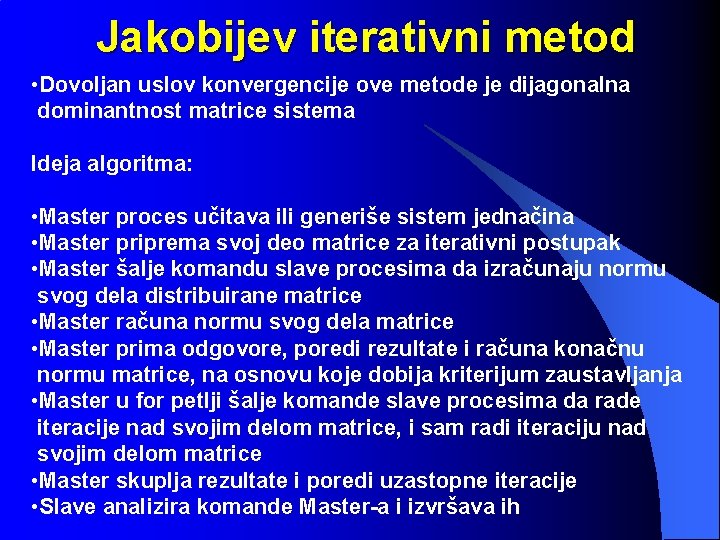
Jakobijev iterativni metod • Dovoljan uslov konvergencije ove metode je dijagonalna dominantnost matrice sistema Ideja algoritma: • Master proces učitava ili generiše sistem jednačina • Master priprema svoj deo matrice za iterativni postupak • Master šalje komandu slave procesima da izračunaju normu svog dela distribuirane matrice • Master računa normu svog dela matrice • Master prima odgovore, poredi rezultate i računa konačnu normu matrice, na osnovu koje dobija kriterijum zaustavljanja • Master u for petlji šalje komande slave procesima da rade iteracije nad svojim delom matrice, i sam radi iteraciju nad svojim delom matrice • Master skuplja rezultate i poredi uzastopne iteracije • Slave analizira komande Master-a i izvršava ih
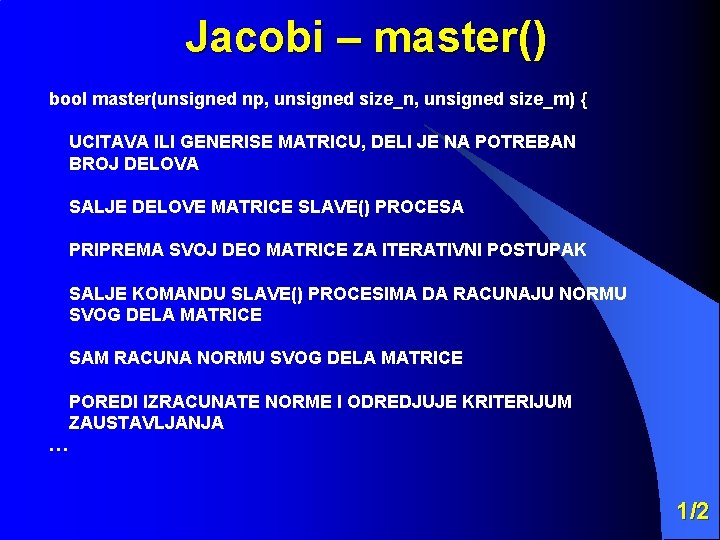
Jacobi – master() bool master(unsigned np, unsigned size_n, unsigned size_m) { UCITAVA ILI GENERISE MATRICU, DELI JE NA POTREBAN BROJ DELOVA SALJE DELOVE MATRICE SLAVE() PROCESA PRIPREMA SVOJ DEO MATRICE ZA ITERATIVNI POSTUPAK SALJE KOMANDU SLAVE() PROCESIMA DA RACUNAJU NORMU SVOG DELA MATRICE SAM RACUNA NORMU SVOG DELA MATRICE POREDI IZRACUNATE NORME I ODREDJUJE KRITERIJUM ZAUSTAVLJANJA … 1/2
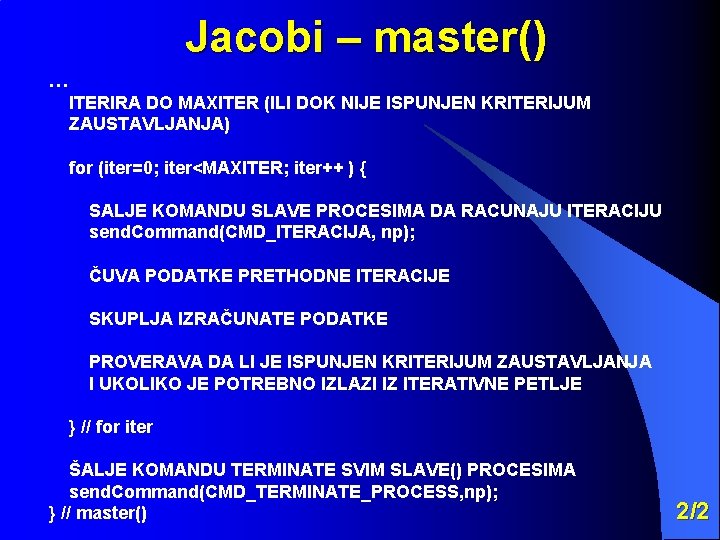
Jacobi – master() … ITERIRA DO MAXITER (ILI DOK NIJE ISPUNJEN KRITERIJUM ZAUSTAVLJANJA) for (iter=0; iter<MAXITER; iter++ ) { SALJE KOMANDU SLAVE PROCESIMA DA RACUNAJU ITERACIJU send. Command(CMD_ITERACIJA, np); ČUVA PODATKE PRETHODNE ITERACIJE SKUPLJA IZRAČUNATE PODATKE PROVERAVA DA LI JE ISPUNJEN KRITERIJUM ZAUSTAVLJANJA I UKOLIKO JE POTREBNO IZLAZI IZ ITERATIVNE PETLJE } // for iter ŠALJE KOMANDU TERMINATE SVIM SLAVE() PROCESIMA send. Command(CMD_TERMINATE_PROCESS, np); } // master() 2/2
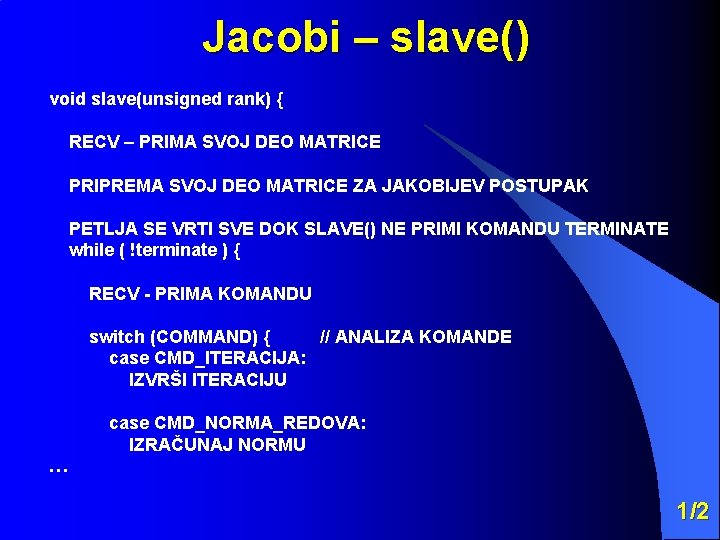
Jacobi – slave() void slave(unsigned rank) { RECV – PRIMA SVOJ DEO MATRICE PRIPREMA SVOJ DEO MATRICE ZA JAKOBIJEV POSTUPAK PETLJA SE VRTI SVE DOK SLAVE() NE PRIMI KOMANDU TERMINATE while ( !terminate ) { RECV - PRIMA KOMANDU switch (COMMAND) { // ANALIZA KOMANDE case CMD_ITERACIJA: IZVRŠI ITERACIJU case CMD_NORMA_REDOVA: IZRAČUNAJ NORMU … 1/2
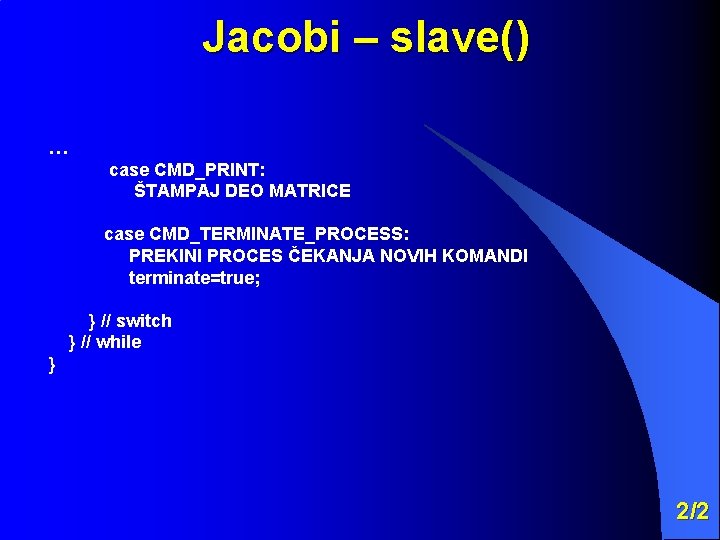
Jacobi – slave() … case CMD_PRINT: ŠTAMPAJ DEO MATRICE case CMD_TERMINATE_PROCESS: PREKINI PROCES ČEKANJA NOVIH KOMANDI terminate=true; } // switch } // while } 2/2
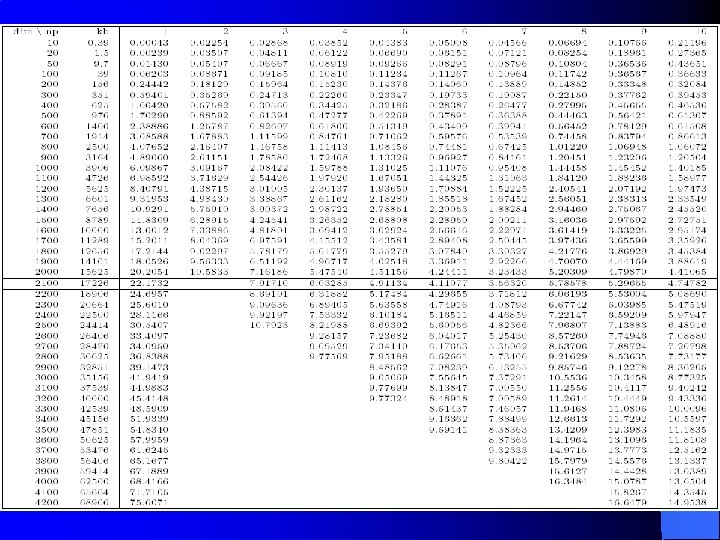
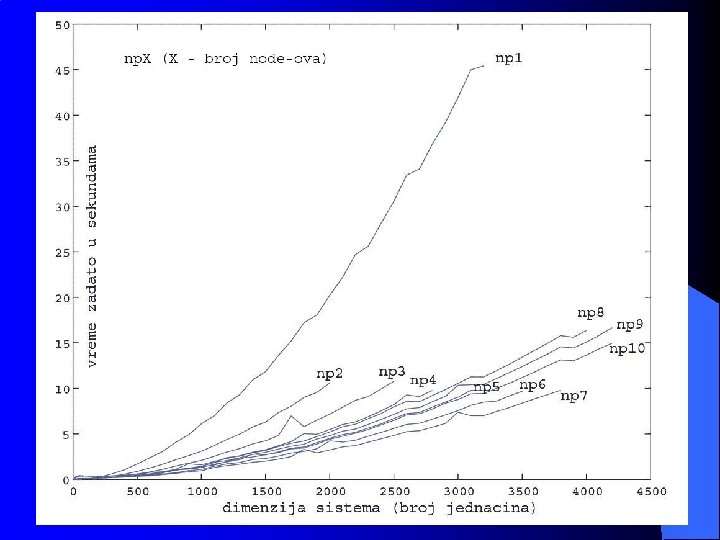
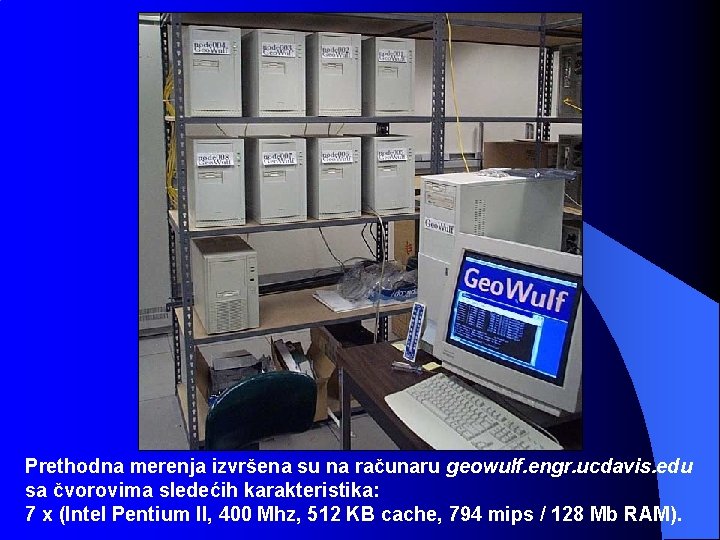
Prethodna merenja izvršena su na računaru geowulf. engr. ucdavis. edu sa čvorovima sledećih karakteristika: 7 x (Intel Pentium II, 400 Mhz, 512 KB cache, 794 mips / 128 Mb RAM).
Jacobi – posix threads Druga implementacija Jacobi-jeve iterativne metode urađena je za paralelne sisteme sa čvrsto vezanim procesorima korišćenjem pthread biblioteke Princip korišćen u ovoj implementaciji je efikasniji ali je ograničen na sisteme sa čvrsto vezanim procesorima, koji podatke razmenjuju putem deljene memorije
Jacobi – pthreads • Program kreira dve vrste niti koje rade po istom principu (prvi set niti priprema sistem jednačina za Jacobi-jev postupak, dok drugi set niti vrši iteracije) • Iteracija se deli na potreban broj niti, ta podela nije stroga niti kontrolisana • Svaka iteracija inicijalizuje potreban broj niti • Svaka od niti obrađuje prvu slobodnu jednačinu iz sistema (prvi slobodan red za obradu) sve dok svi redovi ne budu procesirani, čime se završava iteracija
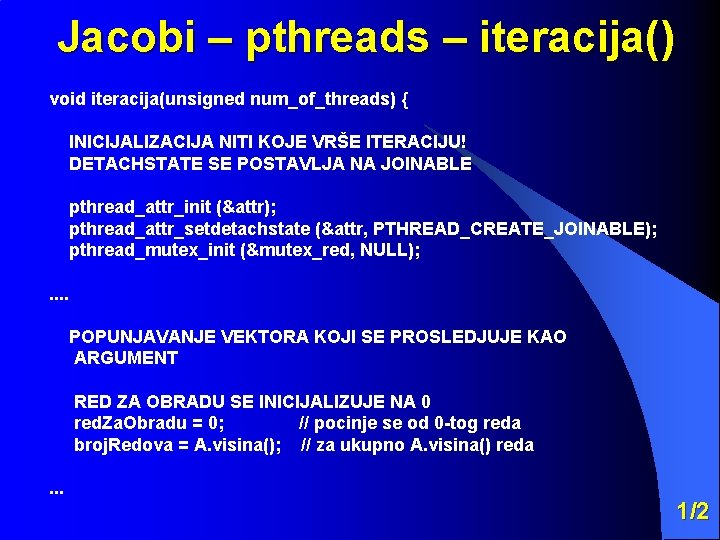
Jacobi – pthreads – iteracija() void iteracija(unsigned num_of_threads) { INICIJALIZACIJA NITI KOJE VRŠE ITERACIJU! DETACHSTATE SE POSTAVLJA NA JOINABLE pthread_attr_init (&attr); pthread_attr_setdetachstate (&attr, PTHREAD_CREATE_JOINABLE); pthread_mutex_init (&mutex_red, NULL); . . POPUNJAVANJE VEKTORA KOJI SE PROSLEDJUJE KAO ARGUMENT RED ZA OBRADU SE INICIJALIZUJE NA 0 red. Za. Obradu = 0; // pocinje se od 0 -tog reda broj. Redova = A. visina(); // za ukupno A. visina() reda. . . 1/2
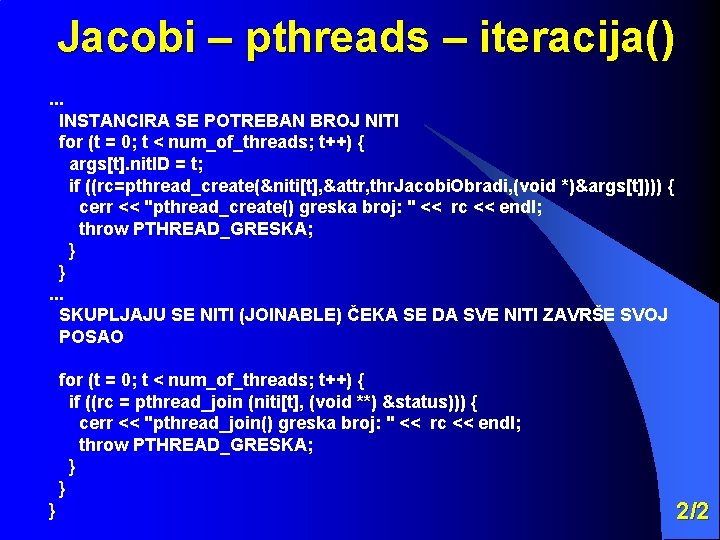
Jacobi – pthreads – iteracija(). . . INSTANCIRA SE POTREBAN BROJ NITI for (t = 0; t < num_of_threads; t++) { args[t]. nit. ID = t; if ((rc=pthread_create(&niti[t], &attr, thr. Jacobi. Obradi, (void *)&args[t]))) { cerr << "pthread_create() greska broj: " << rc << endl; throw PTHREAD_GRESKA; } }. . . SKUPLJAJU SE NITI (JOINABLE) ČEKA SE DA SVE NITI ZAVRŠE SVOJ POSAO for (t = 0; t < num_of_threads; t++) { if ((rc = pthread_join (niti[t], (void **) &status))) { cerr << "pthread_join() greska broj: " << rc << endl; throw PTHREAD_GRESKA; } } } 2/2
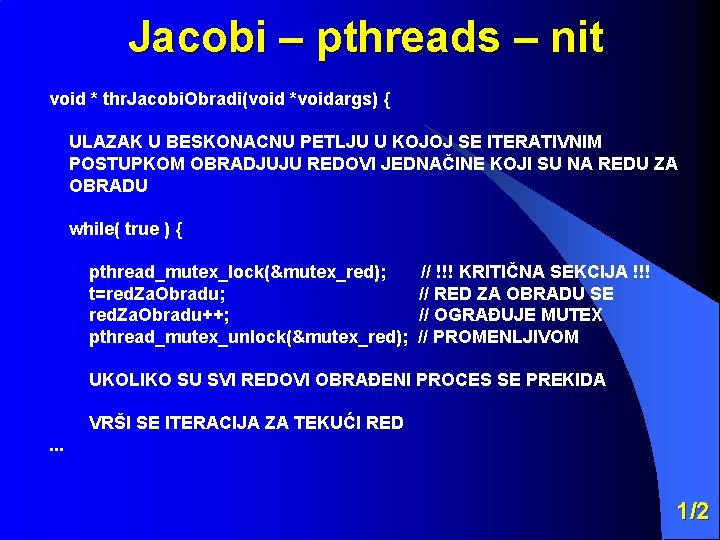
Jacobi – pthreads – nit void * thr. Jacobi. Obradi(void *voidargs) { ULAZAK U BESKONACNU PETLJU U KOJOJ SE ITERATIVNIM POSTUPKOM OBRADJUJU REDOVI JEDNAČINE KOJI SU NA REDU ZA OBRADU while( true ) { pthread_mutex_lock(&mutex_red); t=red. Za. Obradu; red. Za. Obradu++; pthread_mutex_unlock(&mutex_red); // !!! KRITIČNA SEKCIJA !!! // RED ZA OBRADU SE // OGRAĐUJE MUTEX // PROMENLJIVOM UKOLIKO SU SVI REDOVI OBRAĐENI PROCES SE PREKIDA VRŠI SE ITERACIJA ZA TEKUĆI RED. . . 1/2
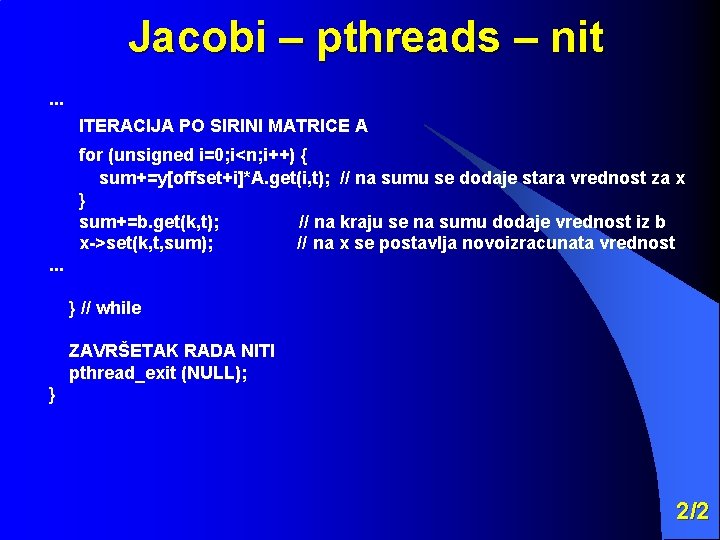
Jacobi – pthreads – nit. . . ITERACIJA PO SIRINI MATRICE A for (unsigned i=0; i<n; i++) { sum+=y[offset+i]*A. get(i, t); // na sumu se dodaje stara vrednost za x } sum+=b. get(k, t); // na kraju se na sumu dodaje vrednost iz b x->set(k, t, sum); // na x se postavlja novoizracunata vrednost. . . } // while ZAVRŠETAK RADA NITI pthread_exit (NULL); } 2/2
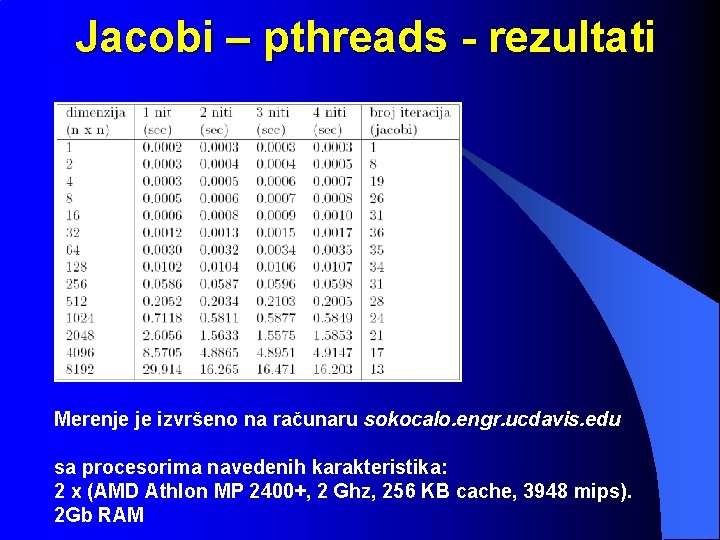
Jacobi – pthreads - rezultati Merenje je izvršeno na računaru sokocalo. engr. ucdavis. edu sa procesorima navedenih karakteristika: 2 x (AMD Athlon MP 2400+, 2 Ghz, 256 KB cache, 3948 mips). 2 Gb RAM
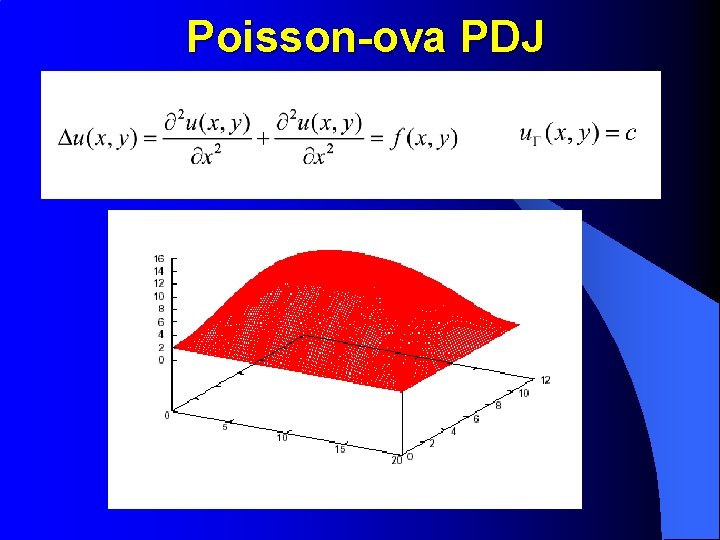
Poisson-ova PDJ
Poisson-ova PDJ Diskretizacija domena metodom konačnih razlika l Sistem linearnih jednačina sa petodijagonalnom matricom l Ne koristi se to što je matrica retka l Rešavanje iterativnim metodama Jacobi, Gauss-Seidel l
Poisson-ova PDJ Paralelizacija rešenja l Dekompozicija domena l Svaki proces rešava poddomen l Komunikacija između susednih procesa l
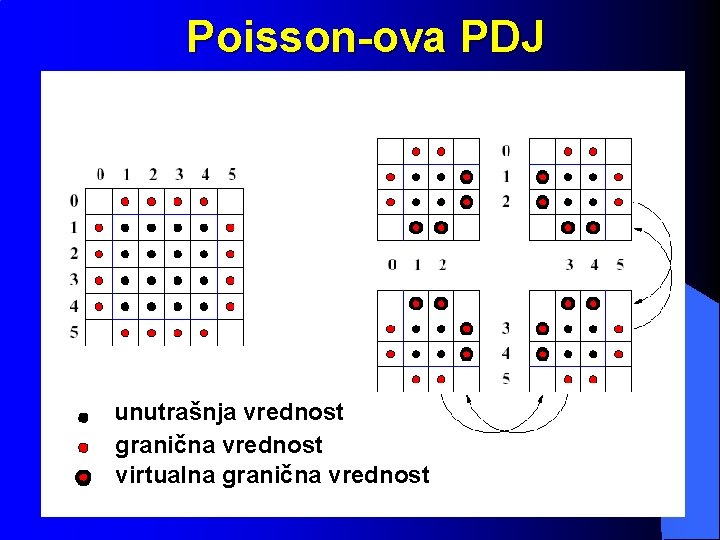
Poisson-ova PDJ unutrašnja vrednost granična vrednost virtualna granična vrednost
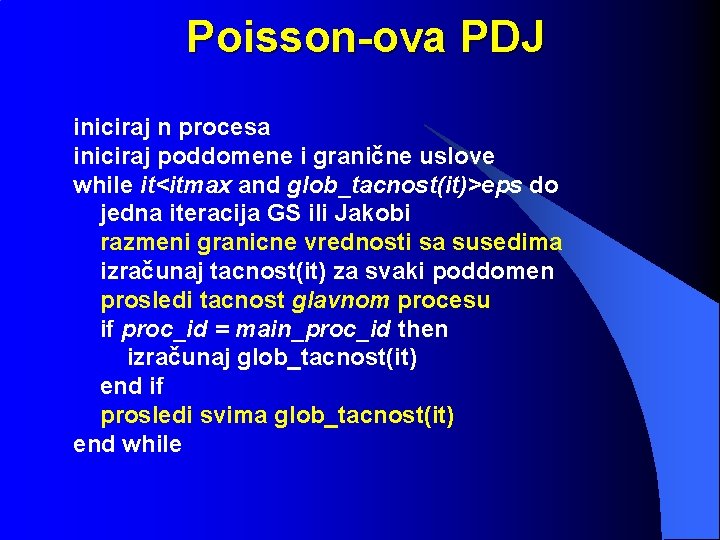
Poisson-ova PDJ iniciraj n procesa iniciraj poddomene i granične uslove while it<itmax and glob_tacnost(it)>eps do jedna iteracija GS ili Jakobi razmeni granicne vrednosti sa susedima izračunaj tacnost(it) za svaki poddomen prosledi tacnost glavnom procesu if proc_id = main_proc_id then izračunaj glob_tacnost(it) end if prosledi svima glob_tacnost(it) end while
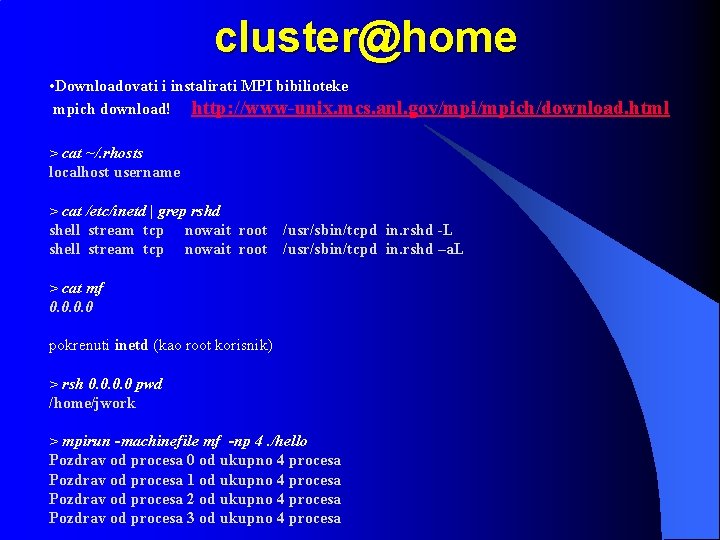
cluster@home • Downloadovati i instalirati MPI bibilioteke mpich download! http: //www-unix. mcs. anl. gov/mpich/download. html > cat ~/. rhosts localhost username > cat /etc/inetd | grep rshd shell stream tcp nowait root /usr/sbin/tcpd in. rshd -L /usr/sbin/tcpd in. rshd –a. L > cat mf 0. 0 pokrenuti inetd (kao root korisnik) > rsh 0. 0 pwd /home/jwork > mpirun -machinefile mf -np 4. /hello Pozdrav od procesa 0 od ukupno 4 procesa Pozdrav od procesa 1 od ukupno 4 procesa Pozdrav od procesa 2 od ukupno 4 procesa Pozdrav od procesa 3 od ukupno 4 procesa
Primene Intenzivna numerička izračunavanja Baze podataka Pretraživanje interneta (npr. google) Računarska grafika renderovanje specijalnih efekata u filmovima Ekonomija: simulacije tržišta kapitala Meterologija Komunikacije: planiranje avio-saobraćaja Tehničke discipline (građevinarstvo, mašinstvo, . . . ) Mehanika Biologija Astronomija, Astrofizika. . .
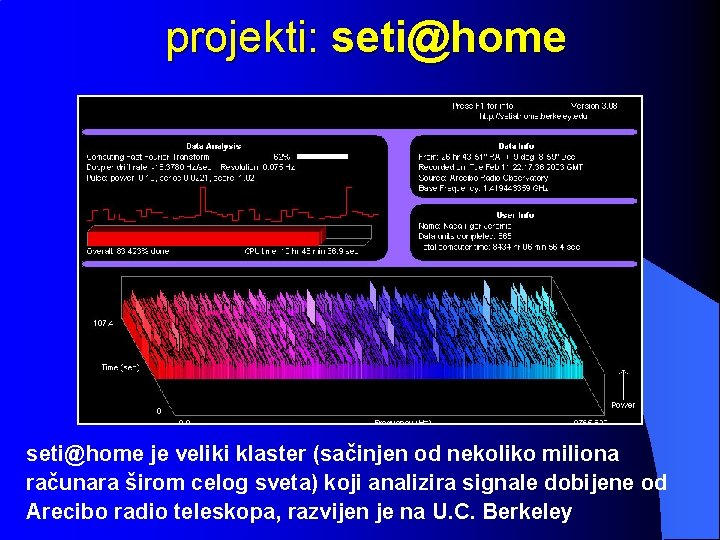
projekti: seti@home je veliki klaster (sačinjen od nekoliko miliona računara širom celog sveta) koji analizira signale dobijene od Arecibo radio teleskopa, razvijen je na U. C. Berkeley
Web l l l l http: //www. mpi-forum. org/ http: //www-unix. mcs. anl. gov/mpich/ http: //setiathome 2. ssl. berkeley. edu/ http: //www. stanford. edu/group/pandegroup/folding/ http: //www. stanford. edu/group/pandegroup/genome/ http: //www. mosix. org/ http: //www. beowulf. org/ l l l http: //www. jwork. net/mpi http: //www. matf. bg. ac. yu/~dradun/mpi http: //www. informatika. com/svarog-beowulf. htm natasa@etf. bg. ac. yu igor@jwork. net
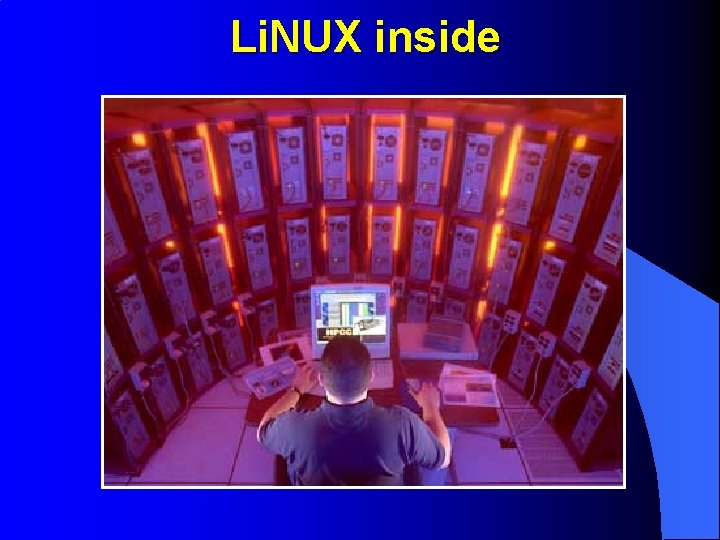
Li. NUX inside
- Slides: 72