
IndexOrganized TableIOT partitioned Table Index 2 nd team
Index-Organized Table(IOT) partitioned Table & Index 2 nd team
IOT Index-organized Table
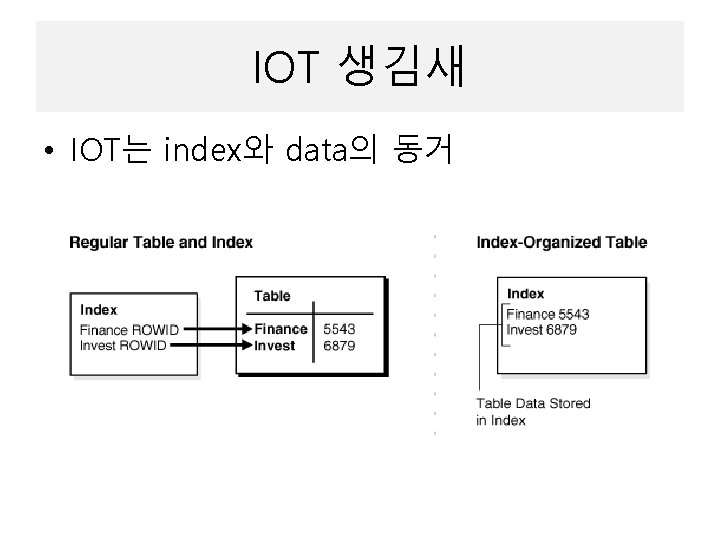
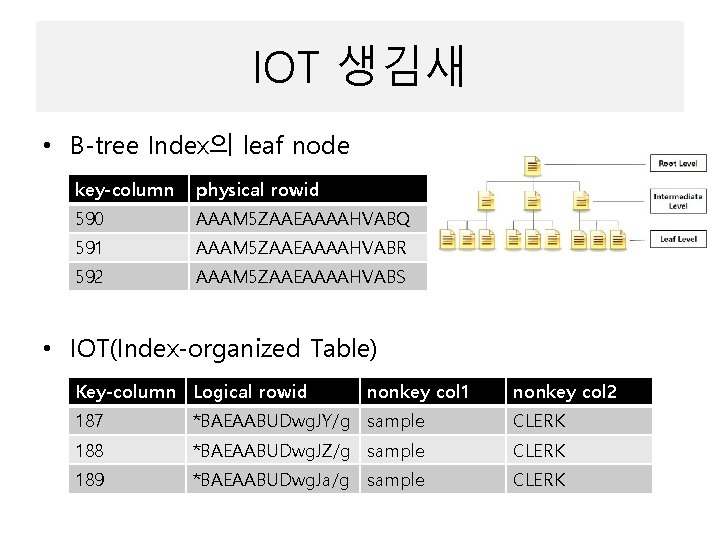
IOT 생김새 • B-tree Index의 leaf node key-column physical rowid 590 AAAM 5 ZAAEAAAAHVABQ 591 AAAM 5 ZAAEAAAAHVABR 592 AAAM 5 ZAAEAAAAHVABS • IOT(Index-organized Table) Key-column Logical rowid nonkey col 1 nonkey col 2 187 *BAEAABUDwg. JY/g sample CLERK 188 *BAEAABUDwg. JZ/g sample CLERK 189 *BAEAABUDwg. Ja/g sample CLERK
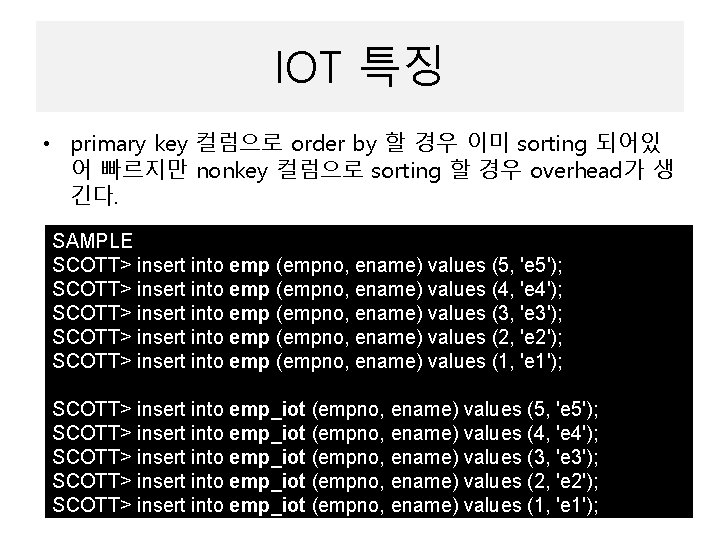
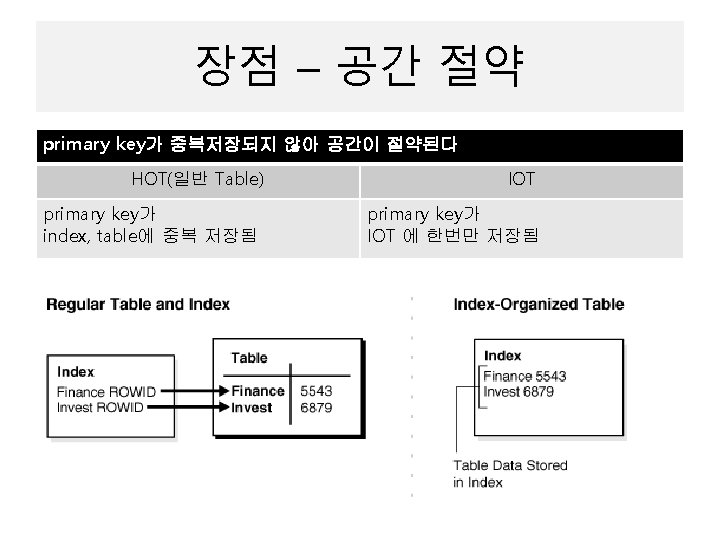
IOT 특징 • primary key 컬럼으로 order by 할 경우 이미 sorting 되어있 어 빠르지만 nonkey 컬럼으로 sorting 할 경우 overhead가 생 긴다. SAMPLE SCOTT> insert into emp (empno, ename) values (5, 'e 5'); SCOTT> insert into emp (empno, ename) values (4, 'e 4'); SCOTT> insert into emp (empno, ename) values (3, 'e 3'); SCOTT> insert into emp (empno, ename) values (2, 'e 2'); SCOTT> insert into emp (empno, ename) values (1, 'e 1'); SCOTT> insert into emp_iot (empno, ename) values (5, 'e 5'); SCOTT> insert into emp_iot (empno, ename) values (4, 'e 4'); SCOTT> insert into emp_iot (empno, ename) values (3, 'e 3'); SCOTT> insert into emp_iot (empno, ename) values (2, 'e 2'); SCOTT> insert into emp_iot (empno, ename) values (1, 'e 1');
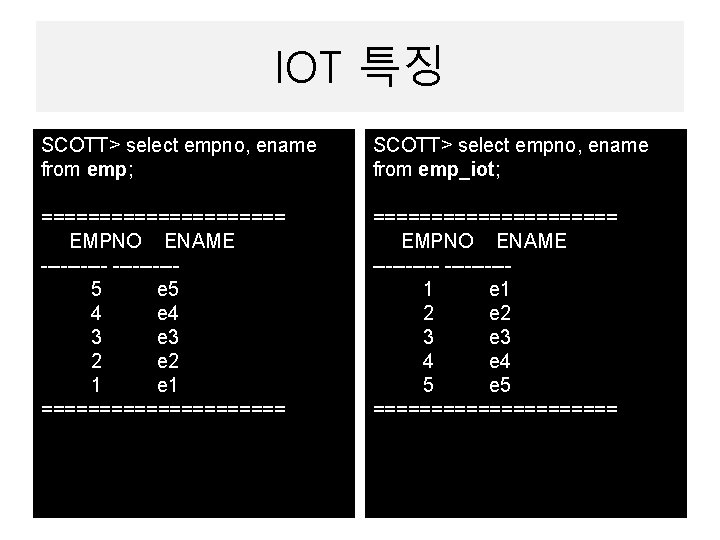
IOT 특징 SCOTT> select empno, ename from emp; SCOTT> select empno, ename from emp_iot; =========== EMPNO ENAME -----5 e 5 4 e 4 3 e 3 2 e 2 1 e 1 ===================== EMPNO ENAME -----1 e 1 2 e 2 3 e 3 4 e 4 5 e 5 ===========
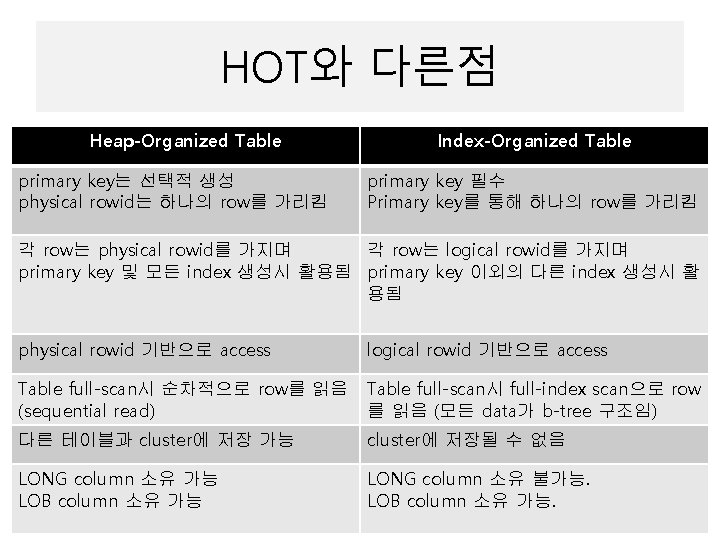
HOT와 다른점 Heap-Organized Table primary key는 선택적 생성 physical rowid는 하나의 row를 가리킴 Index-Organized Table primary key 필수 Primary key를 통해 하나의 row를 가리킴 각 row는 physical rowid를 가지며 각 row는 logical rowid를 가지며 primary key 및 모든 index 생성시 활용됨 primary key 이외의 다른 index 생성시 활 용됨 physical rowid 기반으로 access logical rowid 기반으로 access Table full-scan시 순차적으로 row를 읽음 (sequential read) Table full-scan시 full-index scan으로 row 를 읽음 (모든 data가 b-tree 구조임) 다른 테이블과 cluster에 저장 가능 cluster에 저장될 수 없음 LONG column 소유 가능 LOB column 소유 가능 LONG column 소유 불가능. LOB column 소유 가능.
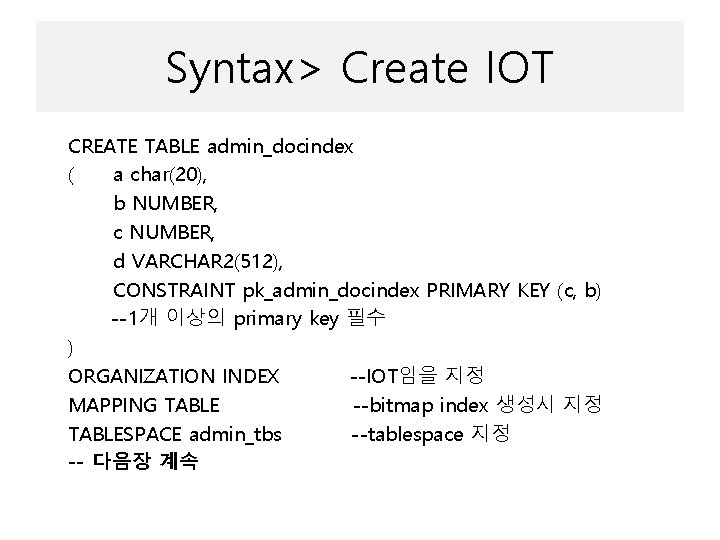
Syntax> Create IOT CREATE TABLE admin_docindex ( a char(20), b NUMBER, c NUMBER, d VARCHAR 2(512), CONSTRAINT pk_admin_docindex PRIMARY KEY (c, b) --1개 이상의 primary key 필수 ) ORGANIZATION INDEX --IOT임을 지정 MAPPING TABLE --bitmap index 생성시 지정 TABLESPACE admin_tbs --tablespace 지정 -- 다음장 계속
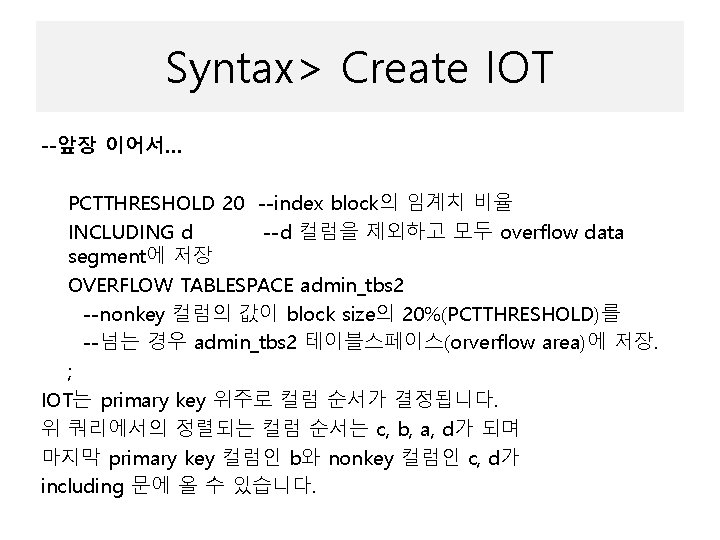
Syntax> Create IOT --앞장 이어서… PCTTHRESHOLD 20 --index block의 임계치 비율 INCLUDING d --d 컬럼을 제외하고 모두 overflow data segment에 저장 OVERFLOW TABLESPACE admin_tbs 2 --nonkey 컬럼의 값이 block size의 20%(PCTTHRESHOLD)를 --넘는 경우 admin_tbs 2 테이블스페이스(orverflow area)에 저장. ; IOT는 primary key 위주로 컬럼 순서가 결정됩니다. 위 쿼리에서의 정렬되는 컬럼 순서는 c, b, a, d가 되며 마지막 primary key 컬럼인 b와 nonkey 컬럼인 c, d가 including 문에 올 수 있습니다.
Syntax> Create IOT • PCTTHRESHOLD (default 50) : 하나의 row가 (PCTTHRESHOLD/100) * DB_BLOCK_SIZE 보다 크다 면 INCLUDING 컬럼 이후의 컬럼 데이터는 OVERFLOW tablespace 에 저장됩니다. (overflow data segment) • INCLUDING : 하나의 row가 PCTTHRESHOLD 에 설정된 값의 조건에 유효한 경 우 INCLUDING으로 지정된 컬럼 이후의 컬럼 데이터들은 OVERFLOW tablespace 에 저장됩니다. (overflow data segment) (INCLUDING 값은 마지막 key컬럼 혹은 nonkey 컬럼이 가능) • OVERFLOW TABLESPACE : PCTTHRESHOLD와 INCLUDING을 만적 할 경우 해당되는 컬럼 데 이터는 지정한 tablespace에 저장되어 고밀도 클러스터링을 유지합 니다.
Create IOT 보너스 • 기존의 table data로 IOT 생성 SCOTT> create table dept_iot_temp (a primary key, b, c) organization index PARALLEL as select * from dept;
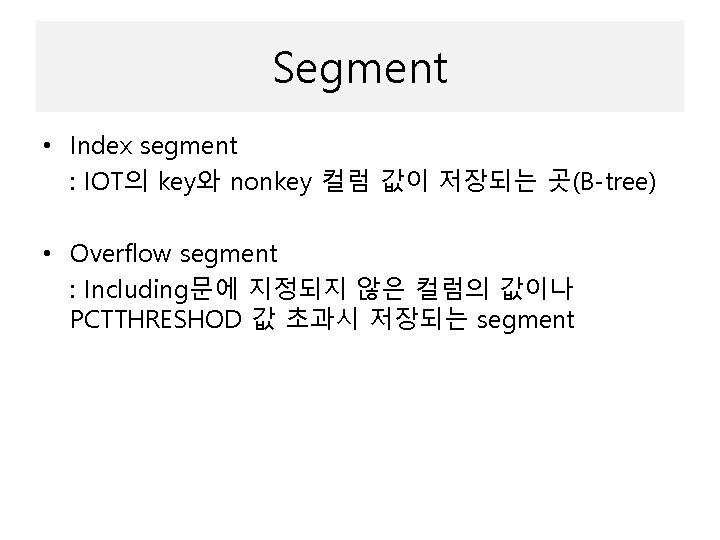
Segment • Index segment : IOT의 key와 nonkey 컬럼 값이 저장되는 곳(B-tree) • Overflow segment : Including문에 지정되지 않은 컬럼의 값이나 PCTTHRESHOD 값 초과시 저장되는 segment
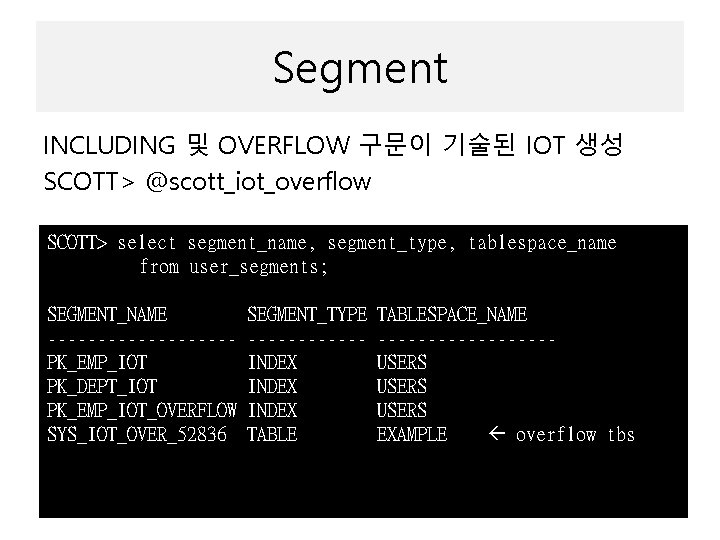
Segment INCLUDING 및 OVERFLOW 구문이 기술된 IOT 생성 SCOTT> @scott_iot_overflow SCOTT> select segment_name, segment_type, tablespace_name from user_segments; SEGMENT_NAME ---------PK_EMP_IOT PK_DEPT_IOT PK_EMP_IOT_OVERFLOW SYS_IOT_OVER_52836 SEGMENT_TYPE ------INDEX TABLESPACE_NAME ---------USERS EXAMPLE overflow tbs
Sample CREATE TABLE EMP_IOT ( EMPNO NUMBER(4) CONSTRAINT PK_EMP_IOT PRIMARY KEY, ENAME VARCHAR 2(10), JOB VARCHAR 2(9), MGR NUMBER(4), HIREDATE, SAL NUMBER(7, 2), COMM NUMBER(7, 2), DEPTNO NUMBER(2) CONSTRAINT FK_DEPTNO_IOT REFERENCES DEPT_IOT ) ORGANIZATION INDEX; … ** 예제 수행용 (슬라이드 노트 참조) SCOTT> @scott. sql SCOTT> @scott_iot. sql
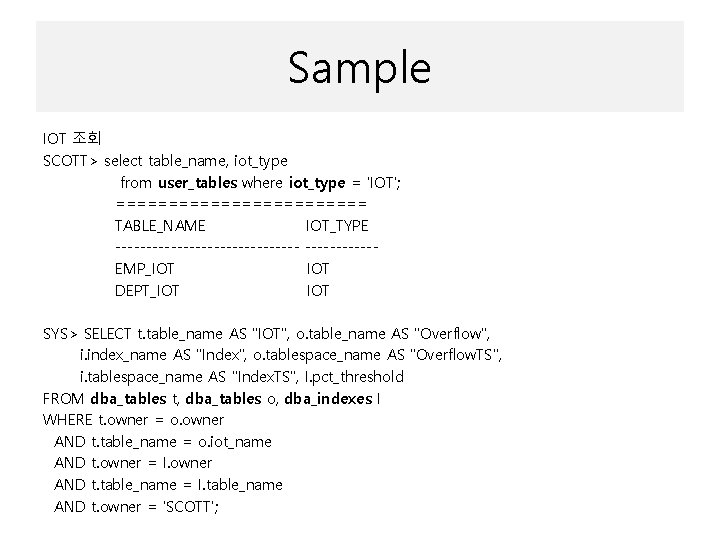
Sample IOT 조회 SCOTT> select table_name, iot_type from user_tables where iot_type = 'IOT'; ============ TABLE_NAME IOT_TYPE ---------------EMP_IOT DEPT_IOT SYS> SELECT t. table_name AS "IOT", o. table_name AS "Overflow", i. index_name AS "Index", o. tablespace_name AS "Overflow. TS", i. tablespace_name AS "Index. TS", I. pct_threshold FROM dba_tables t, dba_tables o, dba_indexes I WHERE t. owner = o. owner AND t. table_name = o. iot_name AND t. owner = I. owner AND t. table_name = I. table_name AND t. owner = 'SCOTT';
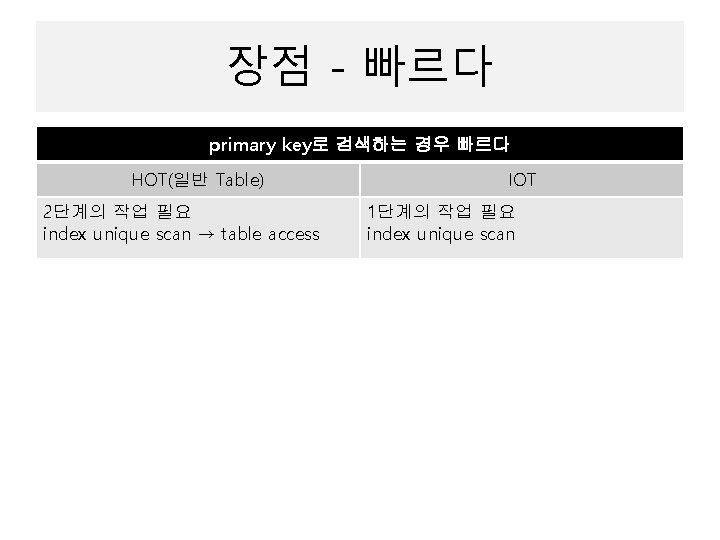
장점 - 빠르다 primary key로 검색하는 경우 빠르다 HOT(일반 Table) 2단계의 작업 필요 index unique scan → table access IOT 1단계의 작업 필요 index unique scan
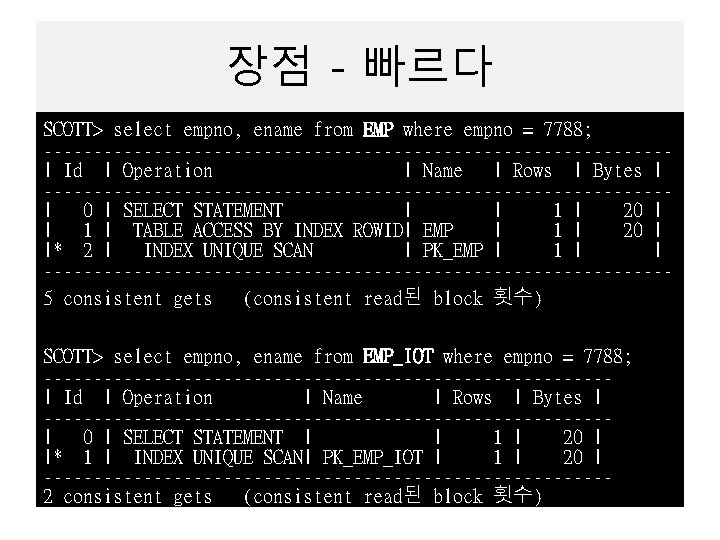
장점 - 빠르다 SCOTT> select empno, ename from EMP where empno = 7788; -------------------------------| Id | Operation | Name | Rows | Bytes | -------------------------------| 0 | SELECT STATEMENT | | 1 | 20 | | 1 | TABLE ACCESS BY INDEX ROWID| EMP | 1 | 20 | |* 2 | INDEX UNIQUE SCAN | PK_EMP | 1 | | -------------------------------5 consistent gets (consistent read된 block 횟수) SCOTT> select empno, ename from EMP_IOT where empno = 7788; ----------------------------| Id | Operation | Name | Rows | Bytes | ----------------------------| 0 | SELECT STATEMENT | | 1 | 20 | |* 1 | INDEX UNIQUE SCAN| PK_EMP_IOT | 1 | 20 | ----------------------------2 consistent gets (consistent read된 block 횟수)
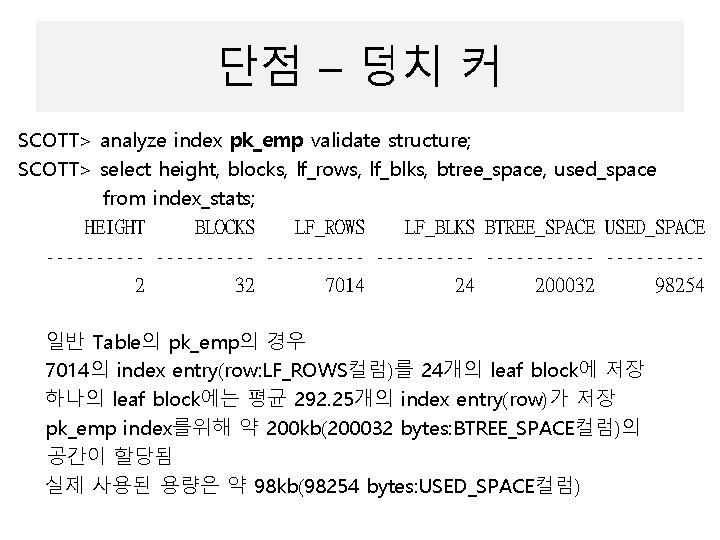
단점 – 덩치 커 SCOTT> analyze index pk_emp validate structure; SCOTT> select height, blocks, lf_rows, lf_blks, btree_space, used_space from index_stats; HEIGHT BLOCKS LF_ROWS LF_BLKS BTREE_SPACE USED_SPACE ---------- ------2 32 7014 24 200032 98254 일반 Table의 pk_emp의 경우 7014의 index entry(row: LF_ROWS컬럼)를 24개의 leaf block에 저장 하나의 leaf block에는 평균 292. 25개의 index entry(row)가 저장 pk_emp index를위해 약 200 kb(200032 bytes: BTREE_SPACE컬럼)의 공간이 할당됨 실제 사용된 용량은 약 98 kb(98254 bytes: USED_SPACE컬럼)
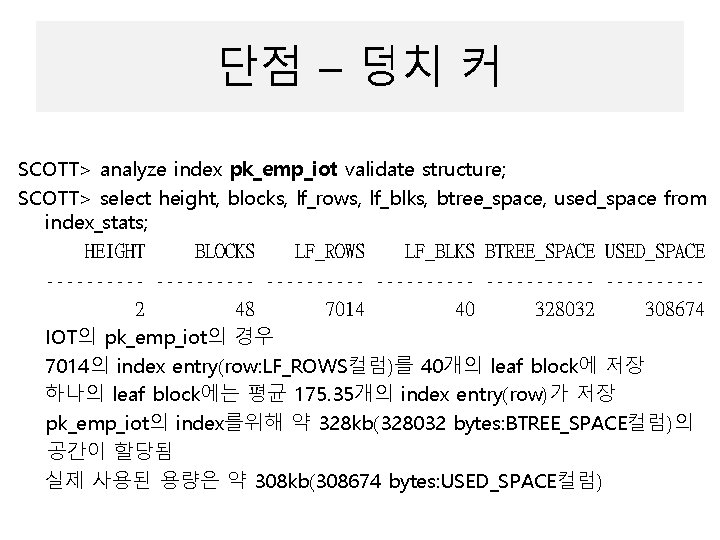
단점 – 덩치 커 SCOTT> analyze index pk_emp_iot validate structure; SCOTT> select height, blocks, lf_rows, lf_blks, btree_space, used_space from index_stats; HEIGHT BLOCKS LF_ROWS LF_BLKS BTREE_SPACE USED_SPACE ---------- ------2 48 7014 40 328032 308674 IOT의 pk_emp_iot의 경우 7014의 index entry(row: LF_ROWS컬럼)를 40개의 leaf block에 저장 하나의 leaf block에는 평균 175. 35개의 index entry(row)가 저장 pk_emp_iot의 index를위해 약 328 kb(328032 bytes: BTREE_SPACE컬럼)의 공간이 할당됨 실제 사용된 용량은 약 308 kb(308674 bytes: USED_SPACE컬럼)
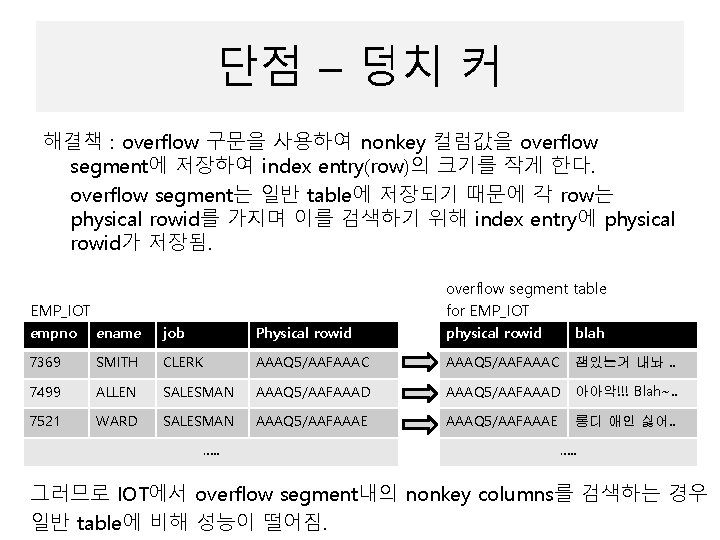
단점 – 덩치 커 해결책 : overflow 구문을 사용하여 nonkey 컬럼값을 overflow segment에 저장하여 index entry(row)의 크기를 작게 한다. overflow segment는 일반 table에 저장되기 때문에 각 row는 physical rowid를 가지며 이를 검색하기 위해 index entry에 physical rowid가 저장됨. overflow segment table for EMP_IOT empno ename job Physical rowid physical rowid blah 7369 SMITH CLERK AAAQ 5/AAFAAAC 잼있는거 내놔. . 7499 ALLEN SALESMAN AAAQ 5/AAFAAAD 아아악!!! Blah~. . 7521 WARD SALESMAN AAAQ 5/AAFAAAE 롱디 애인 싫어. . …. . 그러므로 IOT에서 overflow segment내의 nonkey columns를 검색하는 경우 일반 table에 비해 성능이 떨어짐.
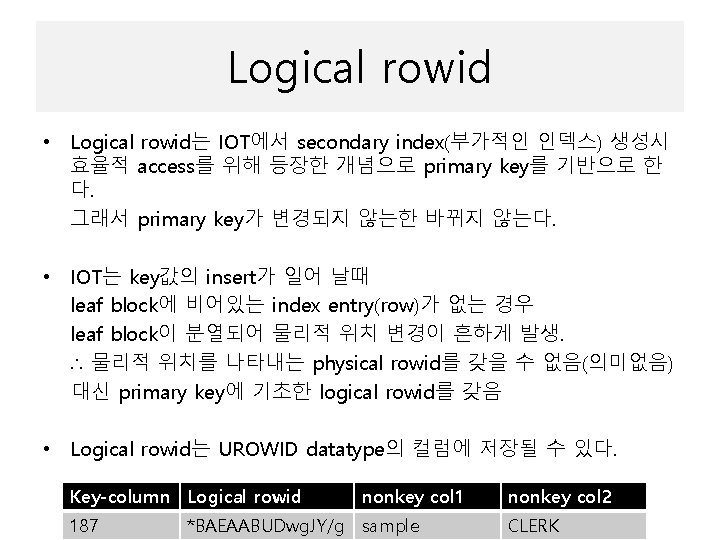
Logical rowid • Logical rowid는 IOT에서 secondary index(부가적인 인덱스) 생성시 효율적 access를 위해 등장한 개념으로 primary key를 기반으로 한 다. 그래서 primary key가 변경되지 않는한 바뀌지 않는다. • IOT는 key값의 insert가 일어 날때 leaf block에 비어있는 index entry(row)가 없는 경우 leaf block이 분열되어 물리적 위치 변경이 흔하게 발생. ∴ 물리적 위치를 나타내는 physical rowid를 갖을 수 없음(의미없음) 대신 primary key에 기초한 logical rowid를 갖음 • Logical rowid는 UROWID datatype의 컬럼에 저장될 수 있다. Key-column Logical rowid 187 nonkey col 1 *BAEAABUDwg. JY/g sample nonkey col 2 CLERK
Logical / Physical rowid • Logical rowid 는 rowid 라는 pseudo-column을 통해 access (physical rowid 도 동일함) SQL> select empno, ROWID from emp_iot where rownum < 10; • Key column의 값이 update 되는 경우 Logical rowid가 변경됨 HOT의 physical rowid는 “alter table … move tablespace …”로 tablespace를 변경하지 않는 이상 변하지 않음 • Physical rowid는 바로 하나의 block만 읽어들여 row를 access 할 수 있다. • IOT의 Logical rowid는 root block에서 leaf block까지 b-tree 구조를 타야하기 때문에 root node와 leaf node가 동일하지 않는 이상 하나 의 block 이상을 access 해야 한다. • 어쨌든 IOT에서는 Logical rowid가 가장 빠른 data access 방법이다.
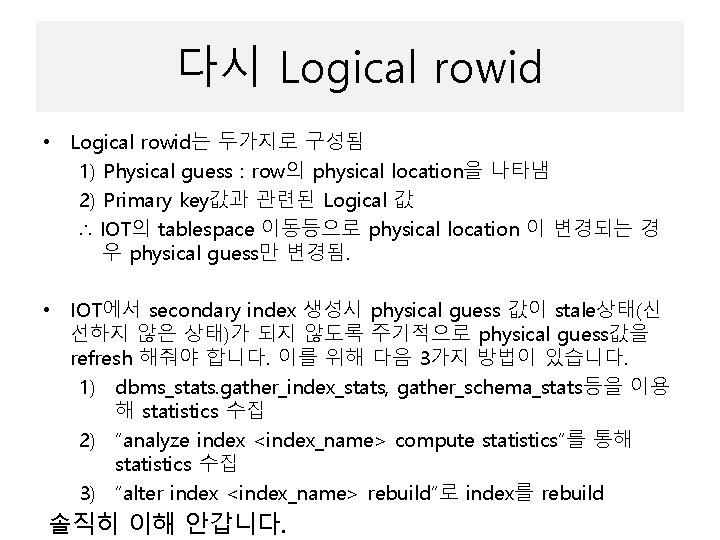
다시 Logical rowid • Logical rowid는 두가지로 구성됨 1) Physical guess : row의 physical location을 나타냄 2) Primary key값과 관련된 Logical 값 ∴ IOT의 tablespace 이동등으로 physical location 이 변경되는 경 우 physical guess만 변경됨. • IOT에서 secondary index 생성시 physical guess 값이 stale상태(신 선하지 않은 상태)가 되지 않도록 주기적으로 physical guess값을 refresh 해줘야 합니다. 이를 위해 다음 3가지 방법이 있습니다. 1) dbms_stats. gather_index_stats, gather_schema_stats등을 이용 해 statistics 수집 2) “analyze index <index_name> compute statistics”를 통해 statistics 수집 3) “alter index <index_name> rebuild”로 index를 rebuild 솔직히 이해 안갑니다.
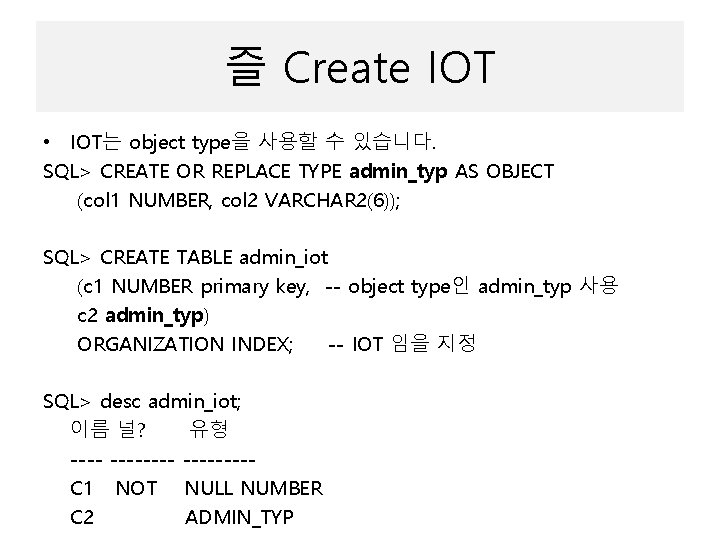
즐 Create IOT • IOT는 object type을 사용할 수 있습니다. SQL> CREATE OR REPLACE TYPE admin_typ AS OBJECT (col 1 NUMBER, col 2 VARCHAR 2(6)); SQL> CREATE TABLE admin_iot (c 1 NUMBER primary key, -- object type인 admin_typ 사용 c 2 admin_typ) ORGANIZATION INDEX; -- IOT 임을 지정 SQL> desc admin_iot; 이름 널? 유형 --------C 1 NOT NULL NUMBER C 2 ADMIN_TYP
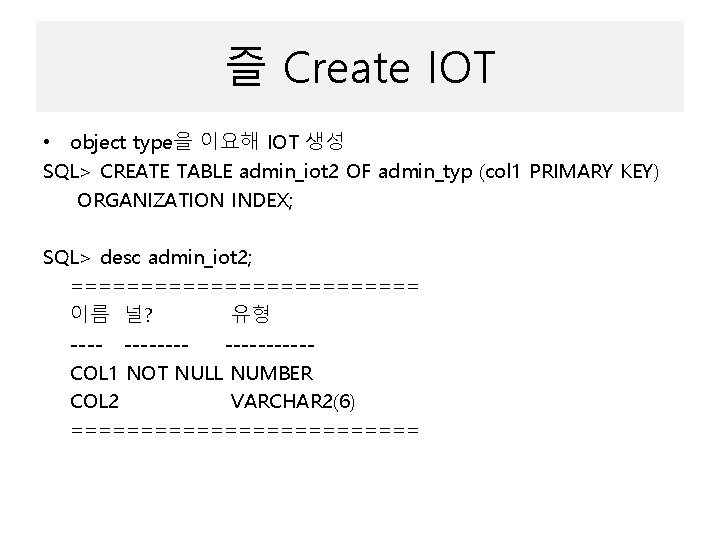
즐 Create IOT • object type을 이요해 IOT 생성 SQL> CREATE TABLE admin_iot 2 OF admin_typ (col 1 PRIMARY KEY) ORGANIZATION INDEX; SQL> desc admin_iot 2; ============= 이름 널? 유형 -----------COL 1 NOT NULL NUMBER COL 2 VARCHAR 2(6) =============
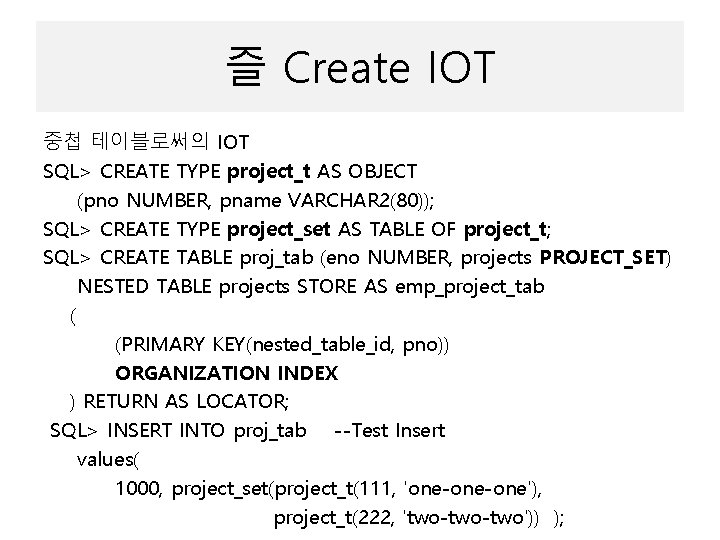
즐 Create IOT 중첩 테이블로써의 IOT SQL> CREATE TYPE project_t AS OBJECT (pno NUMBER, pname VARCHAR 2(80)); SQL> CREATE TYPE project_set AS TABLE OF project_t; SQL> CREATE TABLE proj_tab (eno NUMBER, projects PROJECT_SET) NESTED TABLE projects STORE AS emp_project_tab ( (PRIMARY KEY(nested_table_id, pno)) ORGANIZATION INDEX ) RETURN AS LOCATOR; SQL> INSERT INTO proj_tab --Test Insert values( 1000, project_set(project_t(111, 'one-one'), project_t(222, 'two-two')) );
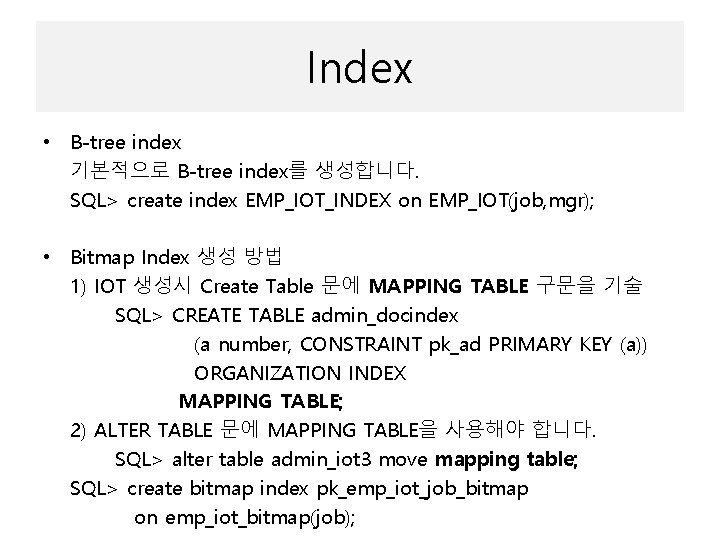
Index • B-tree index 기본적으로 B-tree index를 생성합니다. SQL> create index EMP_IOT_INDEX on EMP_IOT(job, mgr); • Bitmap Index 생성 방법 1) IOT 생성시 Create Table 문에 MAPPING TABLE 구문을 기술 SQL> CREATE TABLE admin_docindex (a number, CONSTRAINT pk_ad PRIMARY KEY (a)) ORGANIZATION INDEX MAPPING TABLE; 2) ALTER TABLE 문에 MAPPING TABLE을 사용해야 합니다. SQL> alter table admin_iot 3 move mapping table; SQL> create bitmap index pk_emp_iot_job_bitmap on emp_iot_bitmap(job);
Alter IOT • IOT는 모든 alter option 사용 가능. • 하지만 primary key constraint 는 drop, defer(deferrable), disable 는 불가
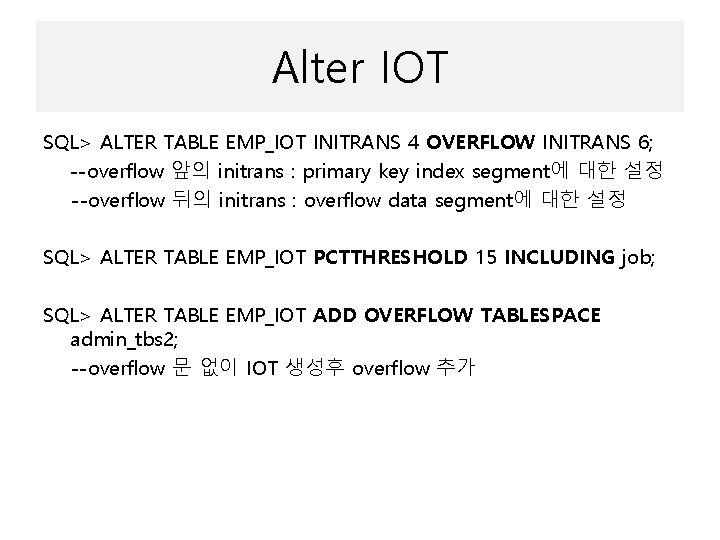
Alter IOT SQL> ALTER TABLE EMP_IOT INITRANS 4 OVERFLOW INITRANS 6; --overflow 앞의 initrans : primary key index segment에 대한 설정 --overflow 뒤의 initrans : overflow data segment에 대한 설정 SQL> ALTER TABLE EMP_IOT PCTTHRESHOLD 15 INCLUDING job; SQL> ALTER TABLE EMP_IOT ADD OVERFLOW TABLESPACE admin_tbs 2; --overflow 문 없이 IOT 생성후 overflow 추가
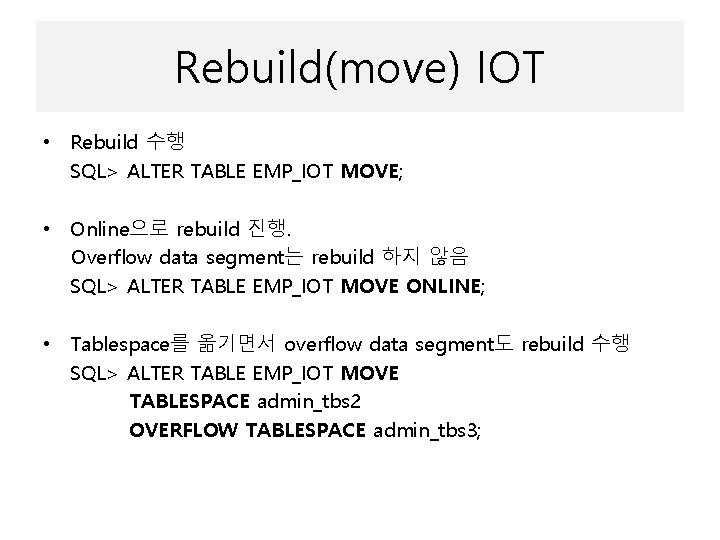
Rebuild(move) IOT • Rebuild 수행 SQL> ALTER TABLE EMP_IOT MOVE; • Online으로 rebuild 진행. Overflow data segment는 rebuild 하지 않음 SQL> ALTER TABLE EMP_IOT MOVE ONLINE; • Tablespace를 옮기면서 overflow data segment도 rebuild 수행 SQL> ALTER TABLE EMP_IOT MOVE TABLESPACE admin_tbs 2 OVERFLOW TABLESPACE admin_tbs 3;

Rebuild(move) IOT • LOB 컬럼이 있는 IOT 에서 rebuild 및 tablespace 이동 SQL> CREATE TABLE admin_iot_lob (c 1 number (6) primary key, admin_lob CLOB) ORGANIZATION INDEX LOB (admin_lob) STORE AS (TABLESPACE admin_tbs 2); SQL> ALTER TABLE admin_iot_lob MOVE LOB (admin_lob) STORE AS (TABLESPACE admin_tbs 3);
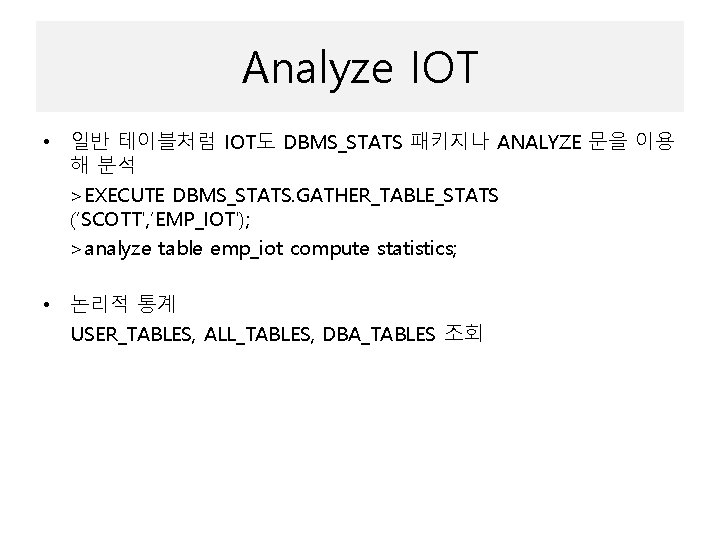
Analyze IOT • 일반 테이블처럼 IOT도 DBMS_STATS 패키지나 ANALYZE 문을 이용 해 분석 >EXECUTE DBMS_STATS. GATHER_TABLE_STATS (‘SCOTT', ’EMP_IOT'); >analyze table emp_iot compute statistics; • 논리적 통계 USER_TABLES, ALL_TABLES, DBA_TABLES 조회
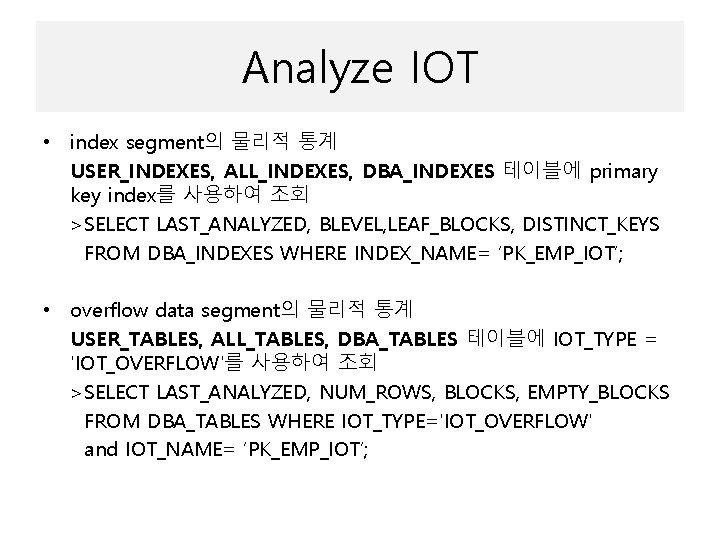
Analyze IOT • index segment의 물리적 통계 USER_INDEXES, ALL_INDEXES, DBA_INDEXES 테이블에 primary key index를 사용하여 조회 >SELECT LAST_ANALYZED, BLEVEL, LEAF_BLOCKS, DISTINCT_KEYS FROM DBA_INDEXES WHERE INDEX_NAME= ‘PK_EMP_IOT’; • overflow data segment의 물리적 통계 USER_TABLES, ALL_TABLES, DBA_TABLES 테이블에 IOT_TYPE = 'IOT_OVERFLOW'를 사용하여 조회 >SELECT LAST_ANALYZED, NUM_ROWS, BLOCKS, EMPTY_BLOCKS FROM DBA_TABLES WHERE IOT_TYPE='IOT_OVERFLOW' and IOT_NAME= ‘PK_EMP_IOT’;
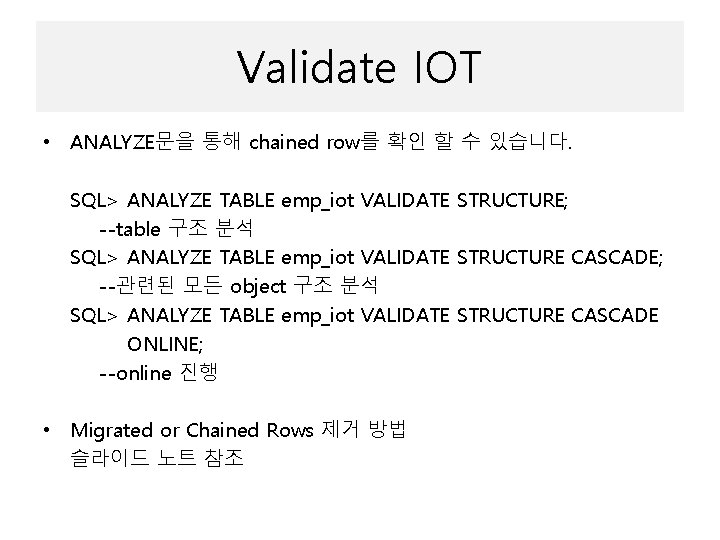
Validate IOT • ANALYZE문을 통해 chained row를 확인 할 수 있습니다. SQL> ANALYZE TABLE emp_iot VALIDATE STRUCTURE; --table 구조 분석 SQL> ANALYZE TABLE emp_iot VALIDATE STRUCTURE CASCADE; --관련된 모든 object 구조 분석 SQL> ANALYZE TABLE emp_iot VALIDATE STRUCTURE CASCADE ONLINE; --online 진행 • Migrated or Chained Rows 제거 방법 슬라이드 노트 참조
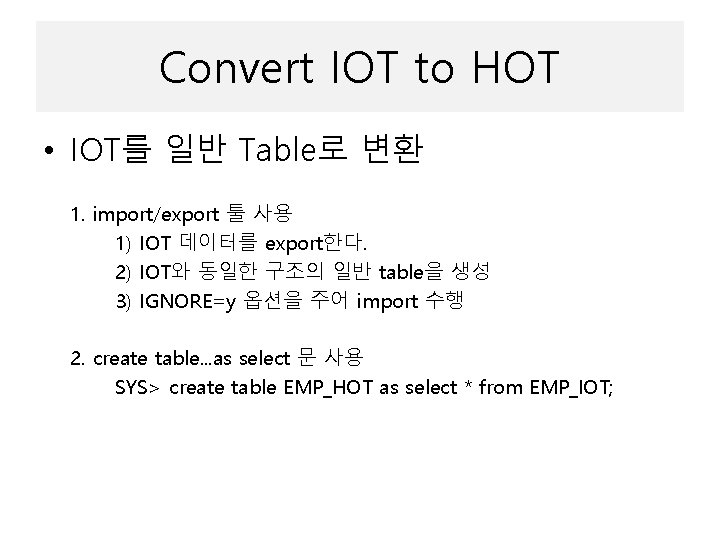
Convert IOT to HOT • IOT를 일반 Table로 변환 1. import/export 툴 사용 1) IOT 데이터를 export한다. 2) IOT와 동일한 구조의 일반 table을 생성 3) IGNORE=y 옵션을 주어 import 수행 2. create table. . . as select 문 사용 SYS> create table EMP_HOT as select * from EMP_IOT;
IOT applications • Online transaction processing (OLTP) • Internet (for example, search engines and portals) • E-commerce (for example, electronic stores and catalogs) • Data warehousing • Analytic functions
참조 ** Index Organized Table (IOT)에 대한 이야기. . . (1) http: //blog. naver. com/jinh 2004? Redirect=Log&log. No=80105323112 ** Index Organized Table (IOT)에 대한 이야기. . . (2) http: //blog. naver. com/jinh 2004? Redirect=Log&log. No=80105899312 ** Overview of Index-Organized Tables http: //download. oracle. com/docs/cd/B 19306_01/server. 102/b 14220/schema. htm#i 23877 ** What Are Index-Organized Tables? http: //download. oracle. com/docs/cd/B 19306_01/server. 102/b 14231/tables. htm#sthref 2402 ** Logical rowids http: //download. oracle. com/docs/cd/B 19306_01/server. 102/b 14220/datatype. htm#i 7207
END IOT
Partitioned Table & Index
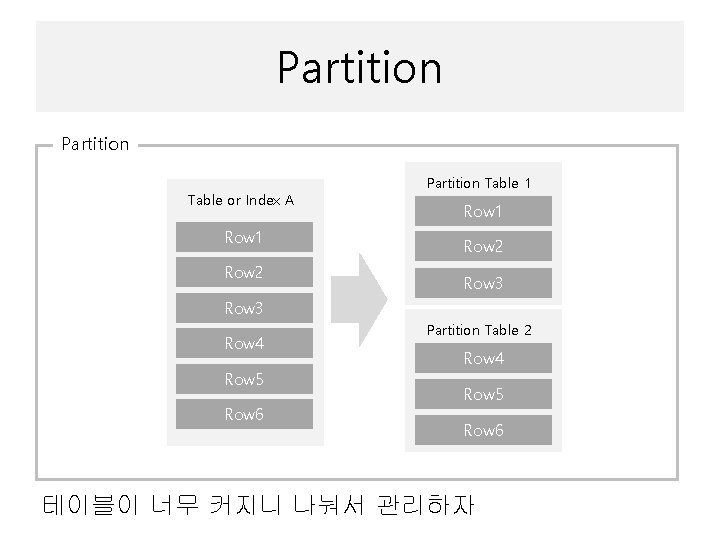
Partition Table or Index A Row 1 Row 2 Partition Table 1 Row 2 Row 3 Row 4 Row 5 Row 6 Partition Table 2 Row 4 Row 5 Row 6 테이블이 너무 커지니 나눠서 관리하자
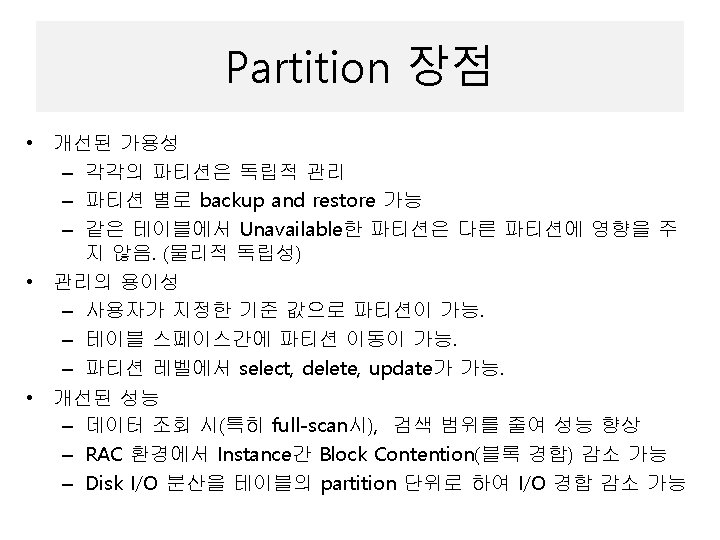
특징 • 모든 파티션 Table 또는 Index는 같은 logical attribute를 가져야 함 ex) columns, data types, constraints. . . • 모든 파티션 Table 또는 Index는 다른 physical attribute를 가져야 함 ex) pctfree, pctused, inittrans, maxtrans, tablespace, sotrage. . . • 파티션 테이블은 'KEY', 'VALUES LESS THAN Literal', 'physical attribute'로 구성 • 'VALUES LESS THAN Literal' 절에서 'Literal' 값에는 SQL Function을 지원 • Composite Column 구성은 16개까지 가능
Dictionary • USER_TAB_PARTITIONS – user소유 table partition에 대한 partition 레벨의 분할정보, partition의 storage매개변수, Analyze 에 의해 집계된 여러통계정보 • USER_PART_TABLES – user소유의 partition table에 대한 object 레벨의 partition정보 • USER_TAB_SUBPARTITIONS – partition 객체에 대한 subpartition 정보
Partitioned Table
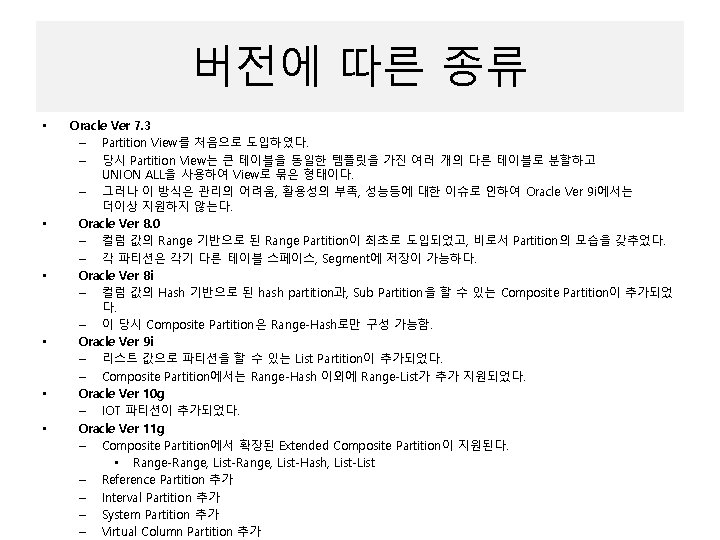
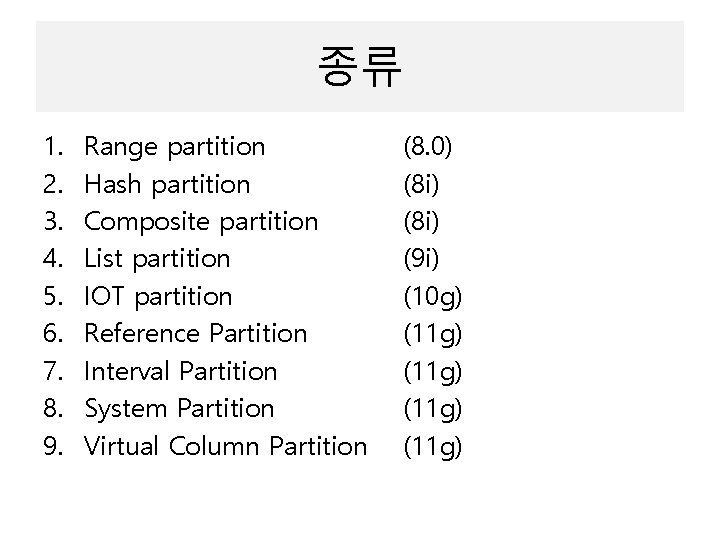
종류 1. 2. 3. 4. 5. 6. 7. 8. 9. Range partition Hash partition Composite partition List partition IOT partition Reference Partition Interval Partition System Partition Virtual Column Partition (8. 0) (8 i) (9 i) (10 g) (11 g)
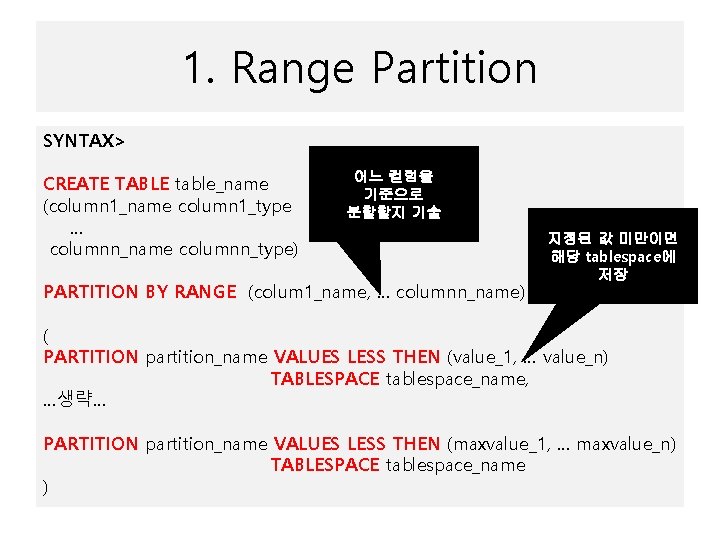
1. Range Partition SYNTAX> CREATE TABLE table_name (column 1_name column 1_type … columnn_name columnn_type) 어느 컬럼을 기준으로 분할할지 기술 PARTITION BY RANGE (colum 1_name, … columnn_name) 지정된 값 미만이면 해당 tablespace에 저장 ( PARTITION partition_name VALUES LESS THEN (value_1, … value_n) TABLESPACE tablespace_name, …생략… PARTITION partition_name VALUES LESS THEN (maxvalue_1, … maxvalue_n) TABLESPACE tablespace_name )
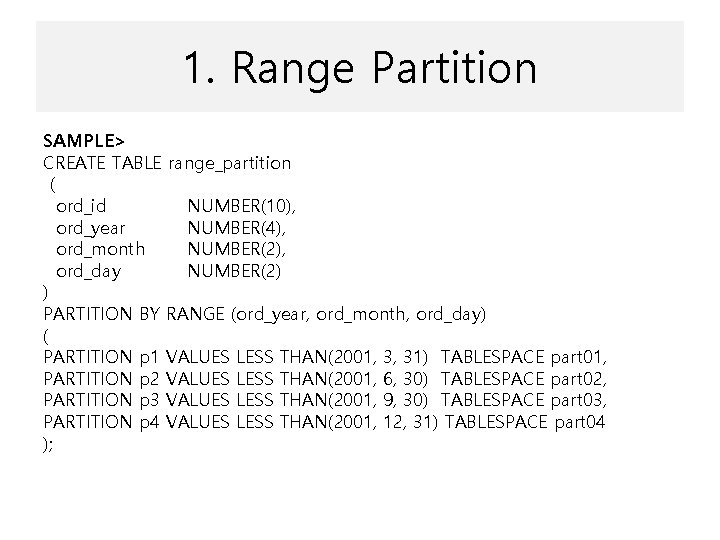
1. Range Partition SAMPLE> CREATE TABLE range_partition ( ord_id NUMBER(10), ord_year NUMBER(4), ord_month NUMBER(2), ord_day NUMBER(2) ) PARTITION BY RANGE (ord_year, ord_month, ord_day) ( PARTITION p 1 VALUES LESS THAN(2001, 3, 31) TABLESPACE part 01, PARTITION p 2 VALUES LESS THAN(2001, 6, 30) TABLESPACE part 02, PARTITION p 3 VALUES LESS THAN(2001, 9, 30) TABLESPACE part 03, PARTITION p 4 VALUES LESS THAN(2001, 12, 31) TABLESPACE part 04 );
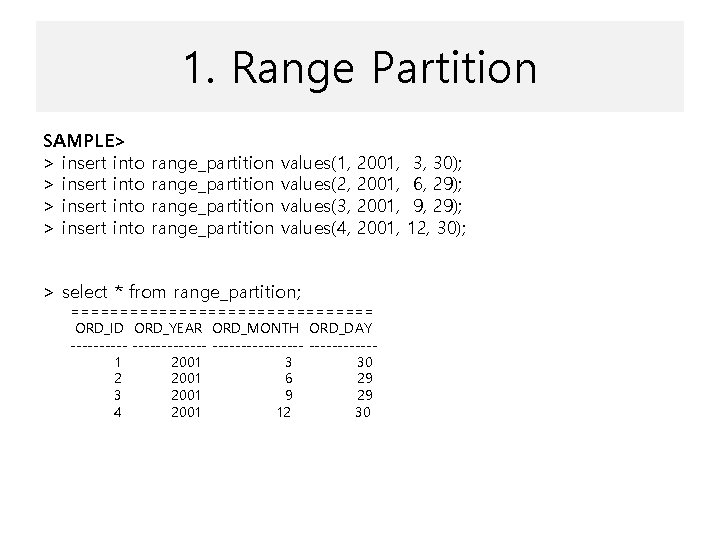
1. Range Partition SAMPLE> > insert into range_partition values(1, values(2, values(3, values(4, > select * from range_partition; 2001, ================ ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------1 2001 3 30 2 2001 6 29 3 2001 9 29 4 2001 12 30 3, 30); 6, 29); 9, 29); 12, 30);
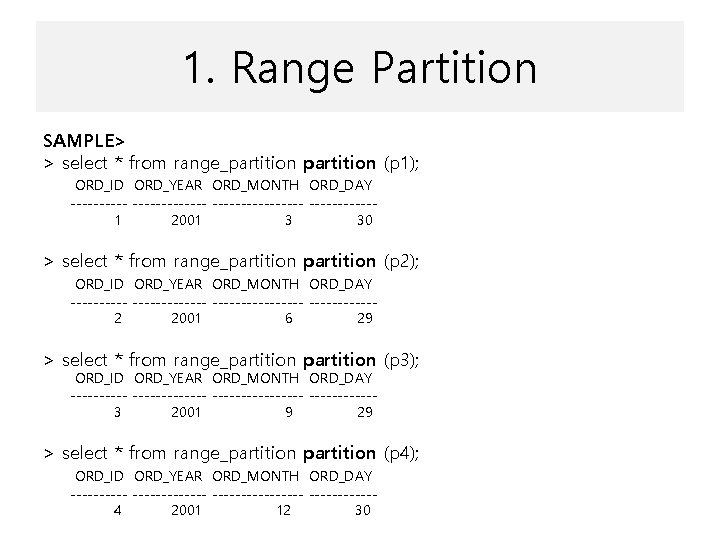
1. Range Partition SAMPLE> > select * from range_partition (p 1); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------1 2001 3 30 > select * from range_partition (p 2); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------2 2001 6 29 > select * from range_partition (p 3); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------3 2001 9 29 > select * from range_partition (p 4); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------4 2001 12 30
1. Range Partition SAMPLE> --Partition 제거 >alter table RANGE_PARTITION drop partition p 4; --Partition 추가 > alter table RANGE_PARTITION add partition p 5 values less than(2001, 12, 31) tablespace part 05; --Partition Table 정보 > select * from user_tab_partitions where table_name = 'RANGE_PARTITION';
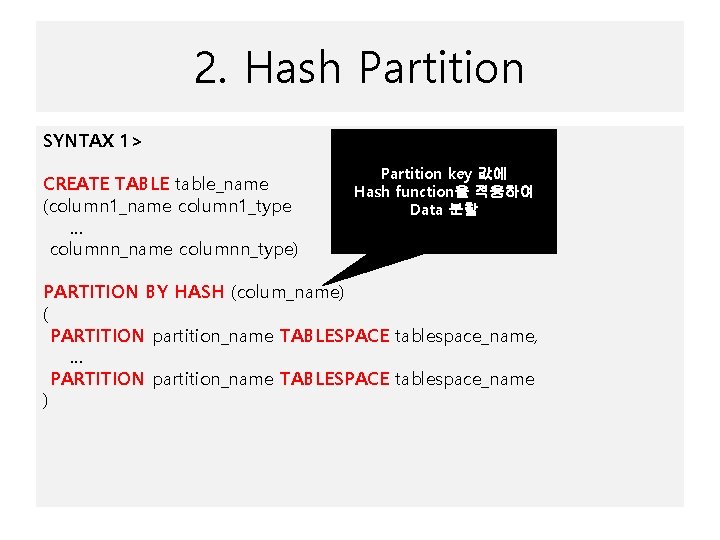
2. Hash Partition SYNTAX 1> CREATE TABLE table_name (column 1_name column 1_type … columnn_name columnn_type) Partition key 값에 Hash function을 적용하여 Data 분할 PARTITION BY HASH (colum_name) ( PARTITION partition_name TABLESPACE tablespace_name, … PARTITION partition_name TABLESPACE tablespace_name )
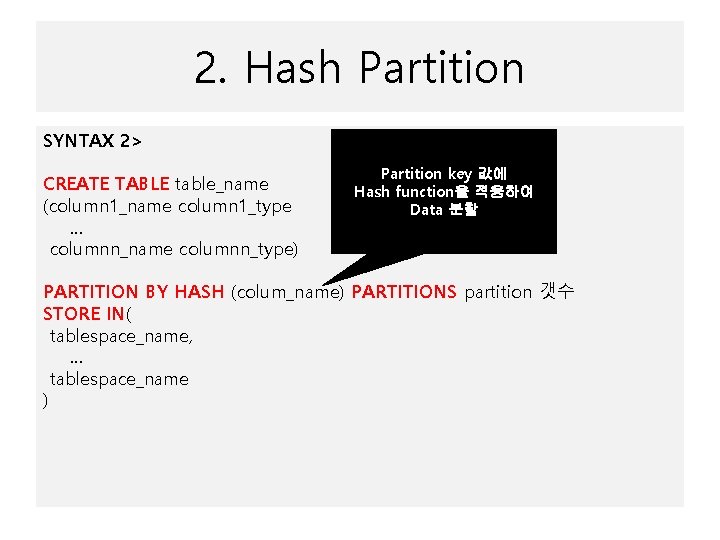
2. Hash Partition SYNTAX 2> CREATE TABLE table_name (column 1_name column 1_type … columnn_name columnn_type) Partition key 값에 Hash function을 적용하여 Data 분할 PARTITION BY HASH (colum_name) PARTITIONS partition 갯수 STORE IN( tablespace_name, … tablespace_name )
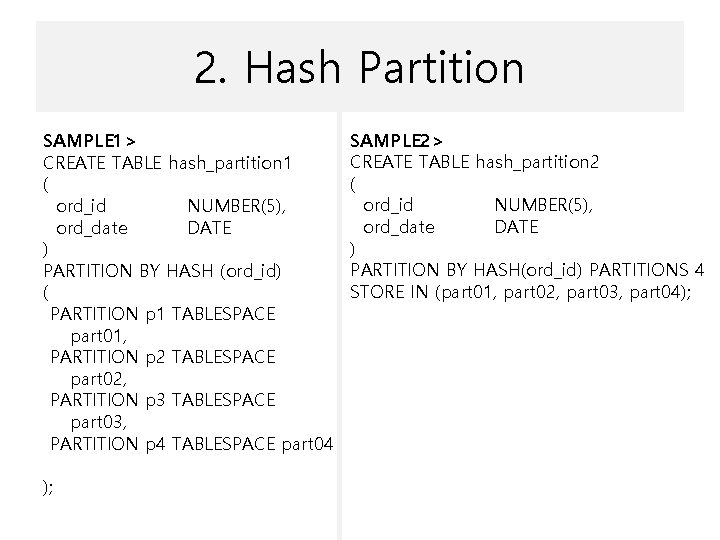
2. Hash Partition SAMPLE 1> CREATE TABLE hash_partition 1 ( ord_id NUMBER(5), ord_date DATE ) PARTITION BY HASH (ord_id) ( PARTITION p 1 TABLESPACE part 01, PARTITION p 2 TABLESPACE part 02, PARTITION p 3 TABLESPACE part 03, PARTITION p 4 TABLESPACE part 04 ); SAMPLE 2> CREATE TABLE hash_partition 2 ( ord_id NUMBER(5), ord_date DATE ) PARTITION BY HASH(ord_id) PARTITIONS 4 STORE IN (part 01, part 02, part 03, part 04);
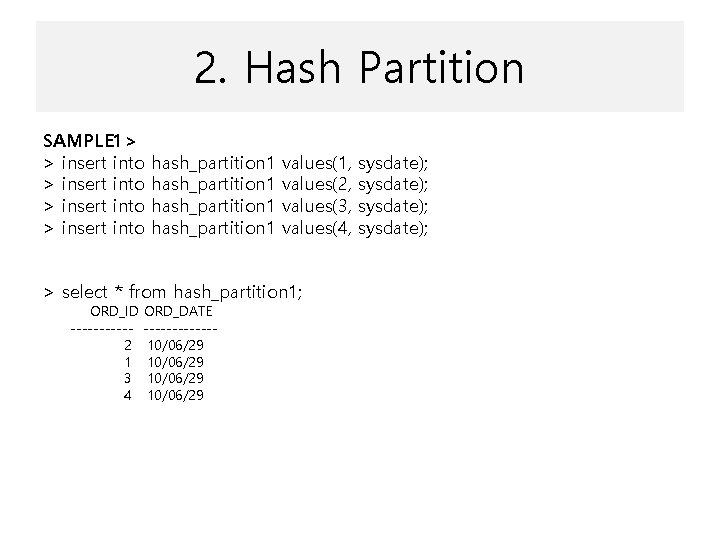
2. Hash Partition SAMPLE 1> > insert into hash_partition 1 values(1, values(2, values(3, values(4, > select * from hash_partition 1; ORD_ID ORD_DATE ------------2 10/06/29 1 10/06/29 3 10/06/29 4 10/06/29 sysdate);
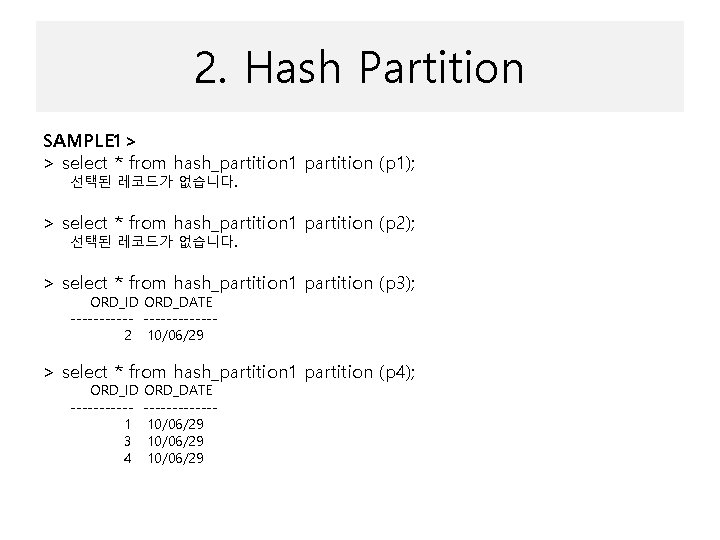
2. Hash Partition SAMPLE 1> > select * from hash_partition 1 partition (p 1); 선택된 레코드가 없습니다. > select * from hash_partition 1 partition (p 2); 선택된 레코드가 없습니다. > select * from hash_partition 1 partition (p 3); ORD_ID ORD_DATE ------------2 10/06/29 > select * from hash_partition 1 partition (p 4); ORD_ID ORD_DATE ------------1 10/06/29 3 10/06/29 4 10/06/29
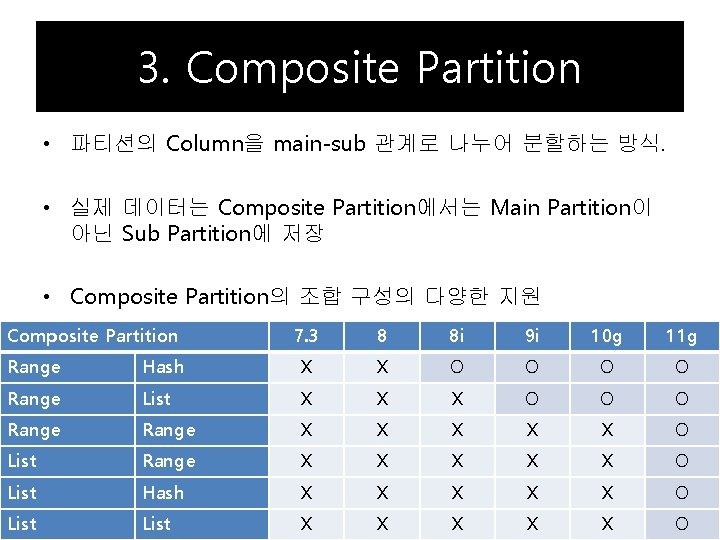
3. Composite Partition • 파티션의 Column을 main-sub 관계로 나누어 분할하는 방식. • 실제 데이터는 Composite Partition에서는 Main Partition이 아닌 Sub Partition에 저장 • Composite Partition의 조합 구성의 다양한 지원 Composite Partition 7. 3 8 8 i 9 i 10 g 11 g Range Hash X X O O Range List X X X O O O Range X X X O List Hash X X X O List X X X O
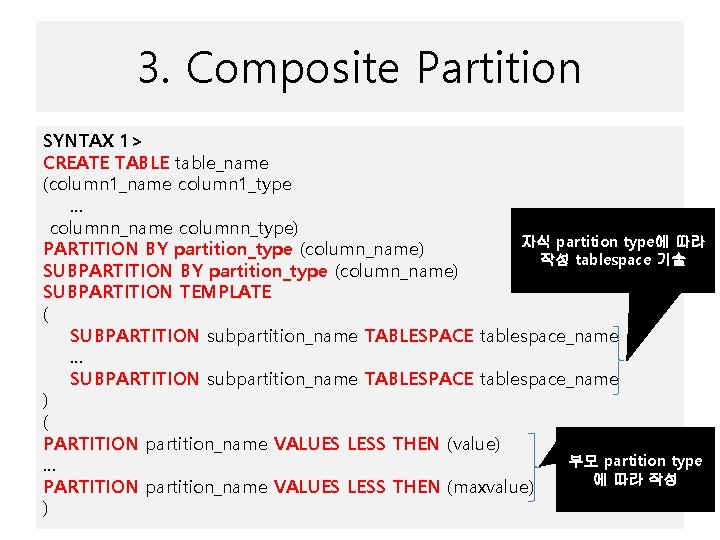
3. Composite Partition SYNTAX 1> CREATE TABLE table_name (column 1_name column 1_type … columnn_name columnn_type) 자식 partition type에 따라 PARTITION BY partition_type (column_name) 작성 tablespace 기술 SUBPARTITION BY partition_type (column_name) SUBPARTITION TEMPLATE ( SUBPARTITION subpartition_name TABLESPACE tablespace_name … SUBPARTITION subpartition_name TABLESPACE tablespace_name ) ( PARTITION partition_name VALUES LESS THEN (value) 부모 partition type … 에 따라 작성 PARTITION partition_name VALUES LESS THEN (maxvalue) )
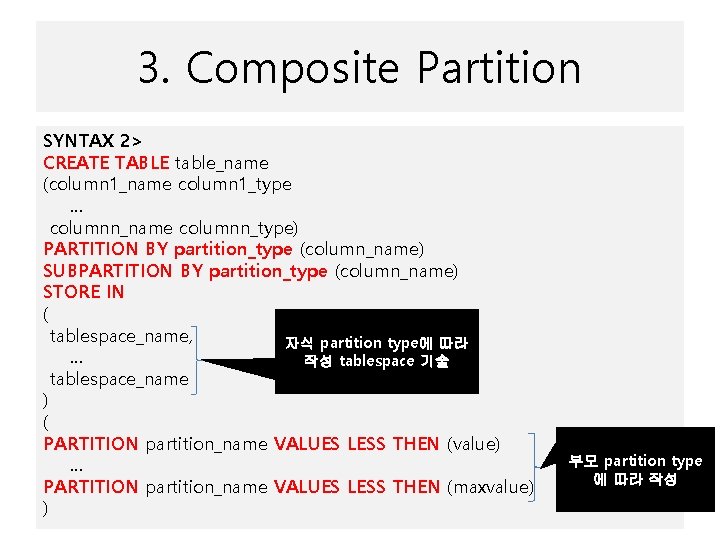
3. Composite Partition SYNTAX 2> CREATE TABLE table_name (column 1_name column 1_type … columnn_name columnn_type) PARTITION BY partition_type (column_name) SUBPARTITION BY partition_type (column_name) STORE IN ( tablespace_name, 자식 partition type에 따라 … 작성 tablespace 기술 tablespace_name ) ( PARTITION partition_name VALUES LESS THEN (value) … PARTITION partition_name VALUES LESS THEN (maxvalue) ) 부모 partition type 에 따라 작성
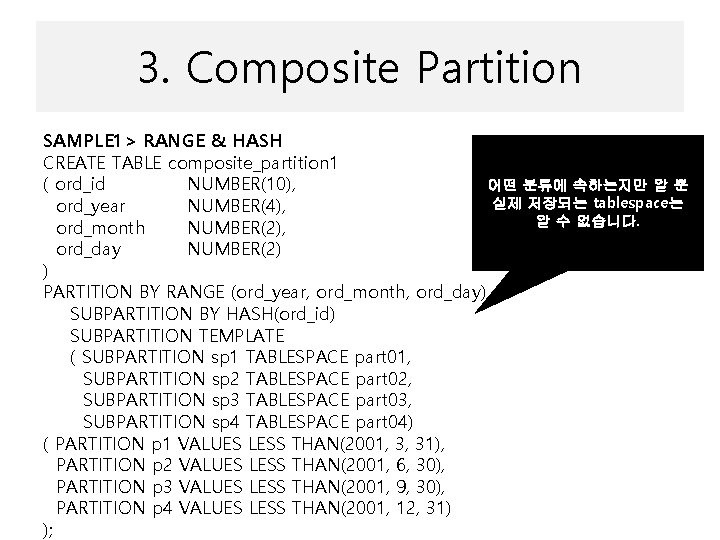
3. Composite Partition SAMPLE 1> RANGE & HASH CREATE TABLE composite_partition 1 어떤 분류에 속하는지만 알 뿐 ( ord_id NUMBER(10), 실제 저장되는 tablespace는 ord_year NUMBER(4), 알 수 없습니다. ord_month NUMBER(2), ord_day NUMBER(2) ) PARTITION BY RANGE (ord_year, ord_month, ord_day) SUBPARTITION BY HASH(ord_id) SUBPARTITION TEMPLATE ( SUBPARTITION sp 1 TABLESPACE part 01, SUBPARTITION sp 2 TABLESPACE part 02, SUBPARTITION sp 3 TABLESPACE part 03, SUBPARTITION sp 4 TABLESPACE part 04) ( PARTITION p 1 VALUES LESS THAN(2001, 3, 31), PARTITION p 2 VALUES LESS THAN(2001, 6, 30), PARTITION p 3 VALUES LESS THAN(2001, 9, 30), PARTITION p 4 VALUES LESS THAN(2001, 12, 31) );
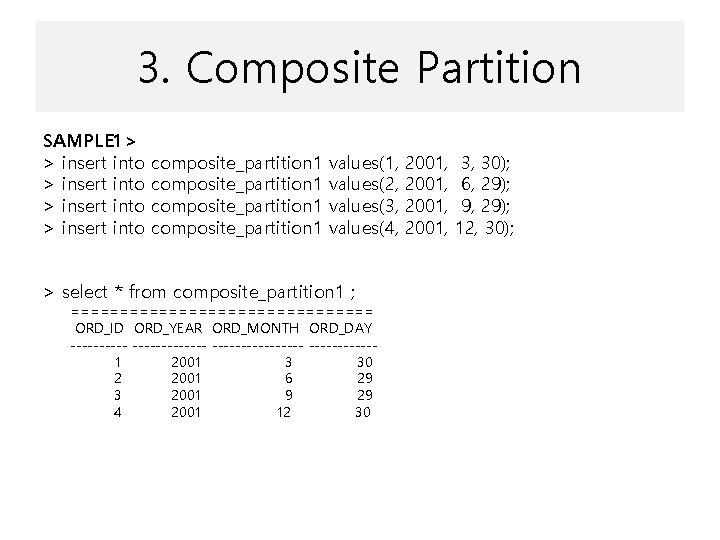
3. Composite Partition SAMPLE 1> > insert into composite_partition 1 values(1, values(2, values(3, values(4, > select * from composite_partition 1 ; ================ ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------1 2001 3 30 2 2001 6 29 3 2001 9 29 4 2001 12 30 2001, 3, 30); 6, 29); 9, 29); 12, 30);
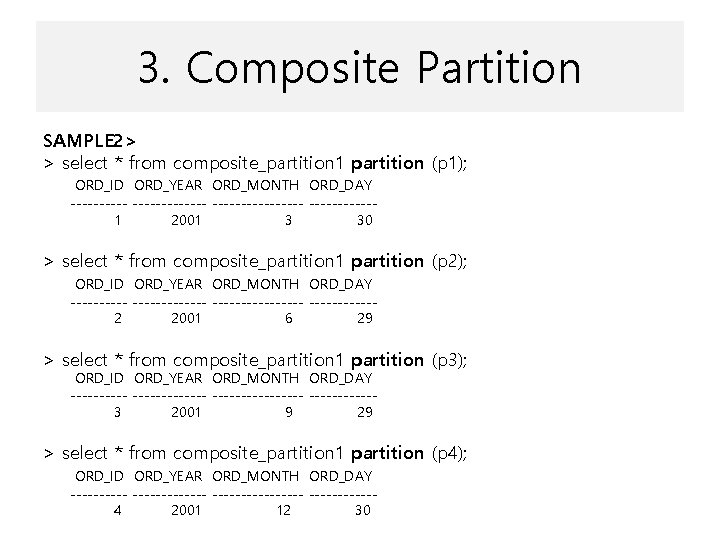
3. Composite Partition SAMPLE 2> > select * from composite_partition 1 partition (p 1); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------1 2001 3 30 > select * from composite_partition 1 partition (p 2); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------2 2001 6 29 > select * from composite_partition 1 partition (p 3); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------3 2001 9 29 > select * from composite_partition 1 partition (p 4); ORD_ID ORD_YEAR ORD_MONTH ORD_DAY ------------- ------4 2001 12 30
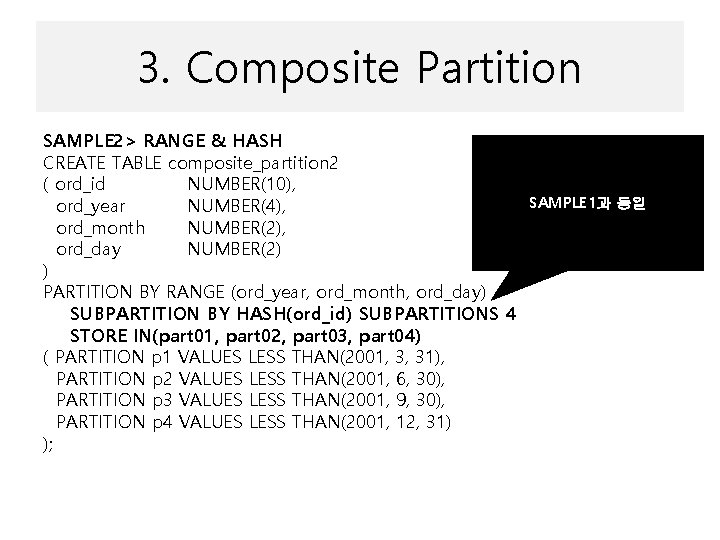
3. Composite Partition SAMPLE 2> RANGE & HASH CREATE TABLE composite_partition 2 ( ord_id NUMBER(10), SAMPLE 1과 동일 ord_year NUMBER(4), ord_month NUMBER(2), ord_day NUMBER(2) ) PARTITION BY RANGE (ord_year, ord_month, ord_day) SUBPARTITION BY HASH(ord_id) SUBPARTITIONS 4 STORE IN(part 01, part 02, part 03, part 04) ( PARTITION p 1 VALUES LESS THAN(2001, 3, 31), PARTITION p 2 VALUES LESS THAN(2001, 6, 30), PARTITION p 3 VALUES LESS THAN(2001, 9, 30), PARTITION p 4 VALUES LESS THAN(2001, 12, 31) );
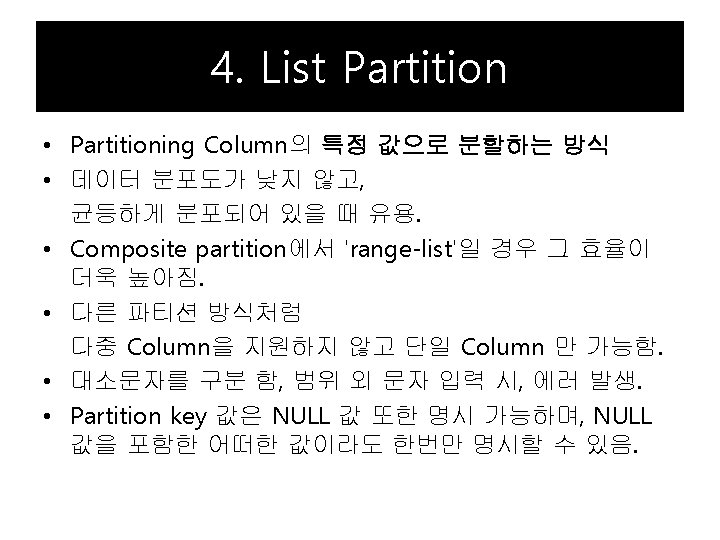
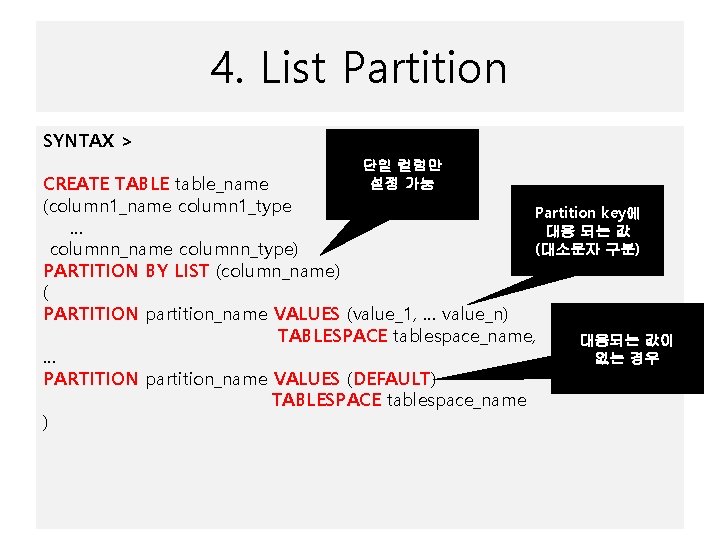
4. List Partition SYNTAX > 단일 컬럼만 설정 가능 CREATE TABLE table_name (column 1_name column 1_type Partition key에 … 대응 되는 값 (대소문자 구분) columnn_name columnn_type) PARTITION BY LIST (column_name) ( PARTITION partition_name VALUES (value_1, … value_n) TABLESPACE tablespace_name, 대응되는 값이 … 없는 경우 PARTITION partition_name VALUES (DEFAULT) TABLESPACE tablespace_name )
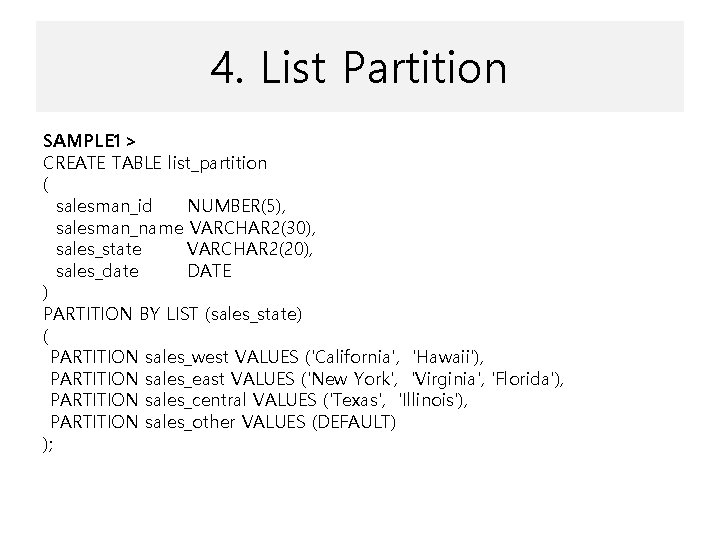
4. List Partition SAMPLE 1> CREATE TABLE list_partition ( salesman_id NUMBER(5), salesman_name VARCHAR 2(30), sales_state VARCHAR 2(20), sales_date DATE ) PARTITION BY LIST (sales_state) ( PARTITION sales_west VALUES ('California', 'Hawaii'), PARTITION sales_east VALUES ('New York', 'Virginia', 'Florida'), PARTITION sales_central VALUES ('Texas', 'Illinois'), PARTITION sales_other VALUES (DEFAULT) );
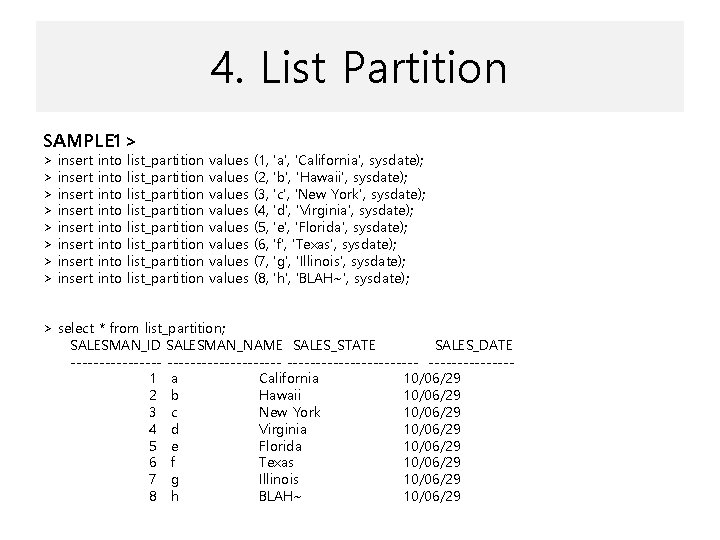
4. List Partition SAMPLE 1> > > > > insert insert into into list_partition list_partition values values (1, (2, (3, (4, (5, (6, (7, (8, 'a', 'California', sysdate); 'b', 'Hawaii', sysdate); 'c', 'New York', sysdate); 'd', 'Virginia', sysdate); 'e', 'Florida', sysdate); 'f', 'Texas', sysdate); 'g', 'Illinois', sysdate); 'h', 'BLAH~', sysdate); > select * from list_partition; SALESMAN_ID SALESMAN_NAME SALES_STATE SALES_DATE -------------------- -------1 a California 10/06/29 2 b Hawaii 10/06/29 3 c New York 10/06/29 4 d Virginia 10/06/29 5 e Florida 10/06/29 6 f Texas 10/06/29 7 g Illinois 10/06/29 8 h BLAH~ 10/06/29
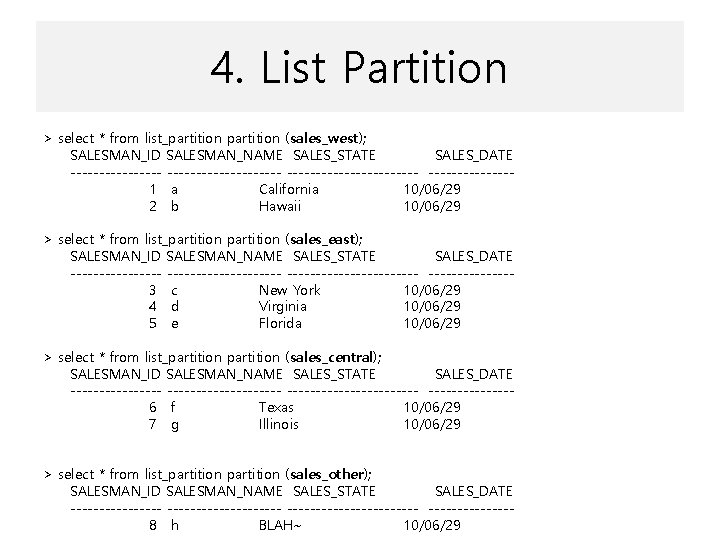
4. List Partition > select * from list_partition (sales_west); SALESMAN_ID SALESMAN_NAME SALES_STATE SALES_DATE -------------------- -------1 a California 10/06/29 2 b Hawaii 10/06/29 > select * from list_partition (sales_east); SALESMAN_ID SALESMAN_NAME SALES_STATE SALES_DATE -------------------- -------3 c New York 10/06/29 4 d Virginia 10/06/29 5 e Florida 10/06/29 > select * from list_partition (sales_central); SALESMAN_ID SALESMAN_NAME SALES_STATE SALES_DATE -------------------- -------6 f Texas 10/06/29 7 g Illinois 10/06/29 > select * from list_partition (sales_other); SALESMAN_ID SALESMAN_NAME SALES_STATE SALES_DATE -------------------- -------8 h BLAH~ 10/06/29
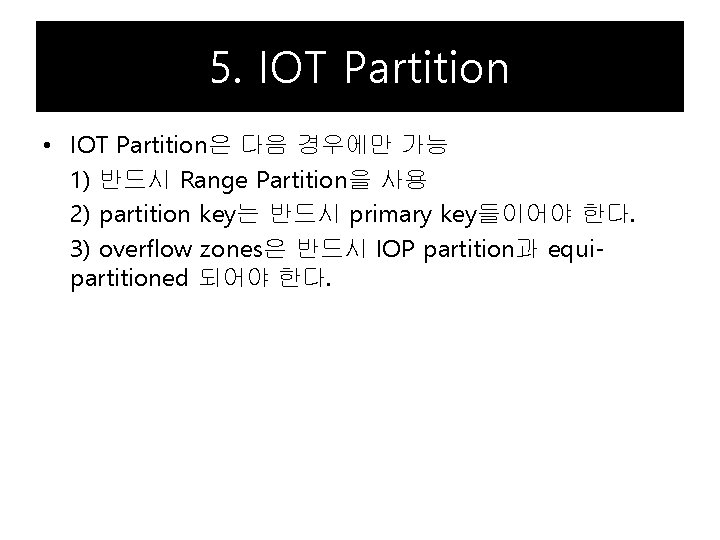
5. IOT Partition • IOT Partition은 다음 경우에만 가능 1) 반드시 Range Partition을 사용 2) partition key는 반드시 primary key들이어야 한다. 3) overflow zones은 반드시 IOP partition과 equipartitioned 되어야 한다.
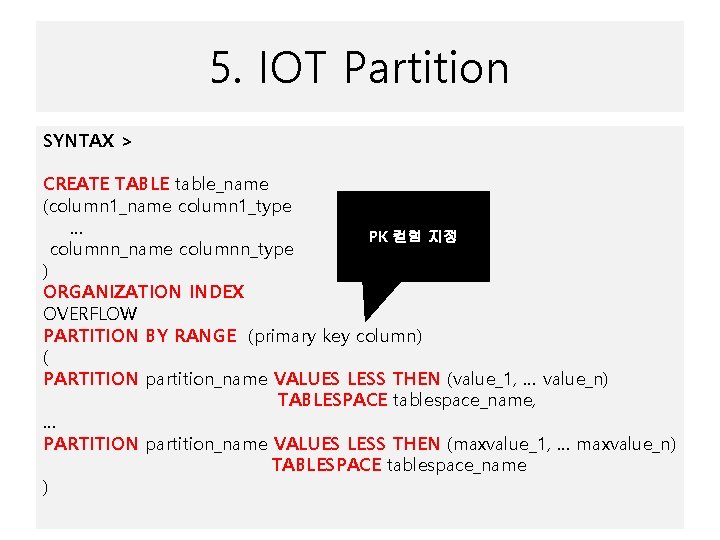
5. IOT Partition SYNTAX > CREATE TABLE table_name (column 1_name column 1_type … PK 컬럼 지정 columnn_name columnn_type ) ORGANIZATION INDEX OVERFLOW PARTITION BY RANGE (primary key column) ( PARTITION partition_name VALUES LESS THEN (value_1, … value_n) TABLESPACE tablespace_name, … PARTITION partition_name VALUES LESS THEN (maxvalue_1, … maxvalue_n) TABLESPACE tablespace_name )
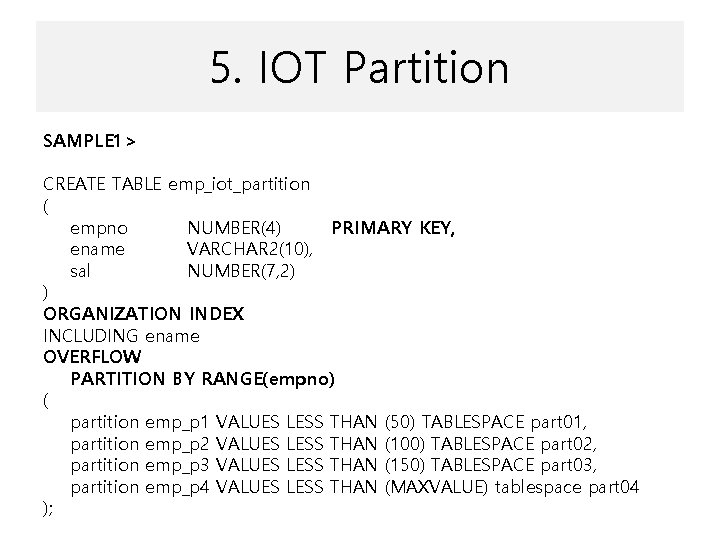
5. IOT Partition SAMPLE 1> CREATE TABLE emp_iot_partition ( empno NUMBER(4) PRIMARY KEY, ename VARCHAR 2(10), sal NUMBER(7, 2) ) ORGANIZATION INDEX INCLUDING ename OVERFLOW PARTITION BY RANGE(empno) ( partition emp_p 1 VALUES LESS THAN (50) TABLESPACE part 01, partition emp_p 2 VALUES LESS THAN (100) TABLESPACE part 02, partition emp_p 3 VALUES LESS THAN (150) TABLESPACE part 03, partition emp_p 4 VALUES LESS THAN (MAXVALUE) tablespace part 04 );
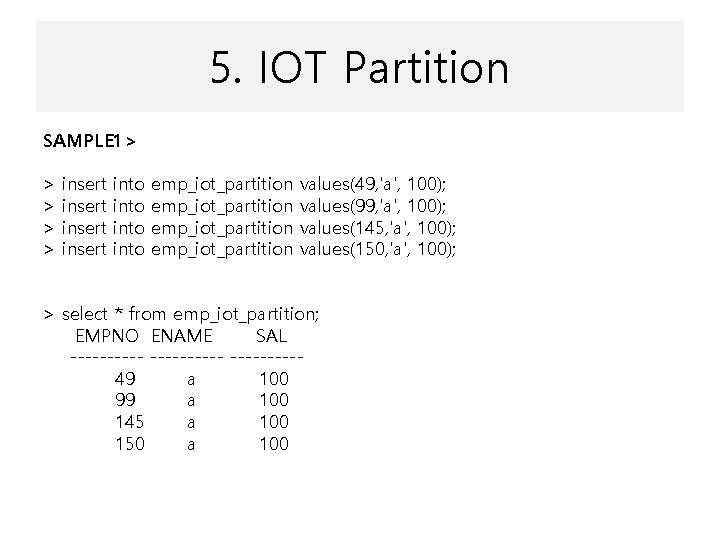
5. IOT Partition SAMPLE 1> > > insert into emp_iot_partition values(49, 'a', 100); values(99, 'a', 100); values(145, 'a', 100); values(150, 'a', 100); > select * from emp_iot_partition; EMPNO ENAME SAL ----------49 a 100 99 a 100 145 a 100 150 a 100
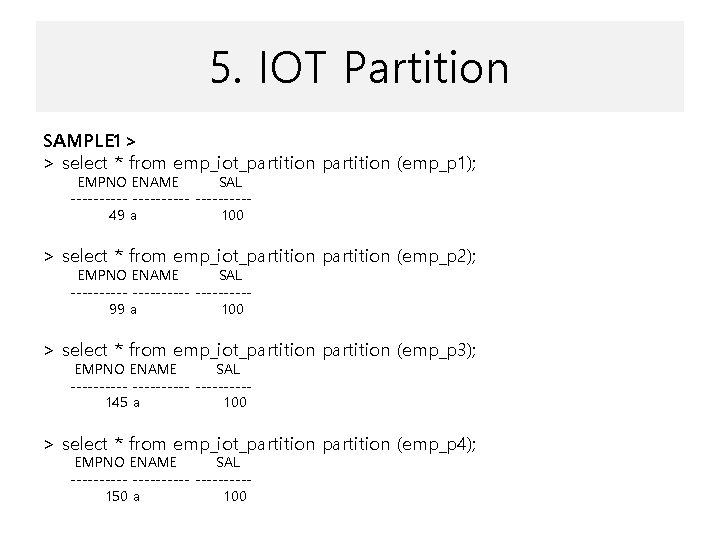
5. IOT Partition SAMPLE 1> > select * from emp_iot_partition (emp_p 1); EMPNO ENAME SAL ----------49 a 100 > select * from emp_iot_partition (emp_p 2); EMPNO ENAME SAL ----------99 a 100 > select * from emp_iot_partition (emp_p 3); EMPNO ENAME SAL ----------145 a 100 > select * from emp_iot_partition (emp_p 4); EMPNO ENAME SAL ----------150 a 100
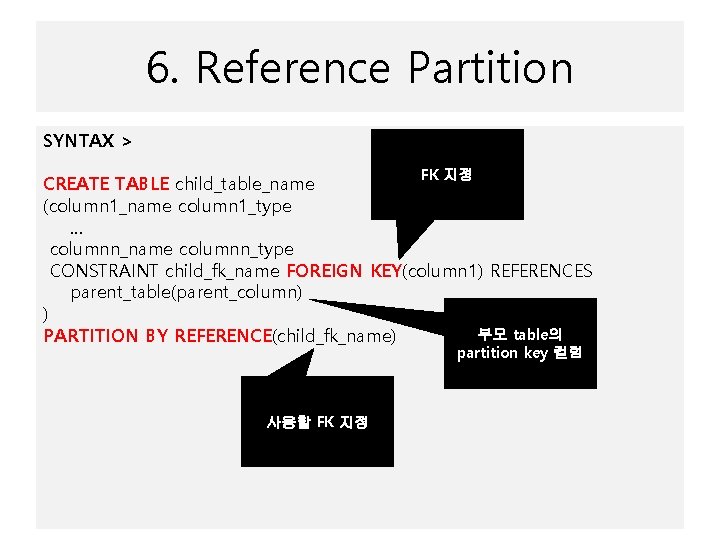
6. Reference Partition SYNTAX > FK 지정 CREATE TABLE child_table_name (column 1_name column 1_type … columnn_name columnn_type CONSTRAINT child_fk_name FOREIGN KEY(column 1) REFERENCES parent_table(parent_column) ) 부모 table의 PARTITION BY REFERENCE(child_fk_name) partition key 컬럼 사용할 FK 지정
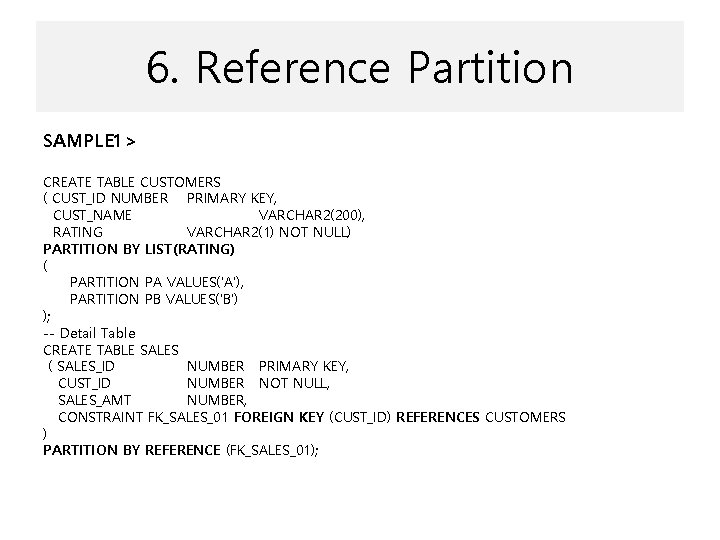
6. Reference Partition SAMPLE 1> CREATE TABLE CUSTOMERS ( CUST_ID NUMBER PRIMARY KEY, CUST_NAME VARCHAR 2(200), RATING VARCHAR 2(1) NOT NULL) PARTITION BY LIST(RATING) ( PARTITION PA VALUES('A'), PARTITION PB VALUES('B') ); -- Detail Table CREATE TABLE SALES ( SALES_ID NUMBER PRIMARY KEY, CUST_ID NUMBER NOT NULL, SALES_AMT NUMBER, CONSTRAINT FK_SALES_01 FOREIGN KEY (CUST_ID) REFERENCES CUSTOMERS ) PARTITION BY REFERENCE (FK_SALES_01);
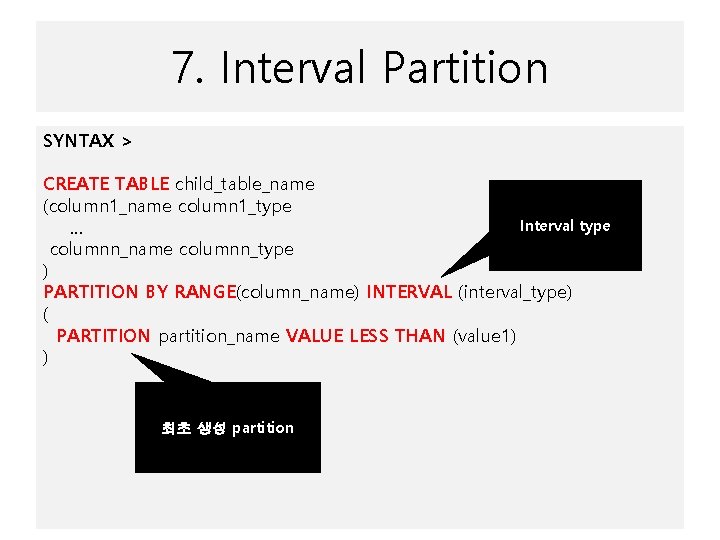
7. Interval Partition SYNTAX > CREATE TABLE child_table_name (column 1_name column 1_type Interval type … columnn_name columnn_type ) PARTITION BY RANGE(column_name) INTERVAL (interval_type) ( PARTITION partition_name VALUE LESS THAN (value 1) ) 최초 생성 partition
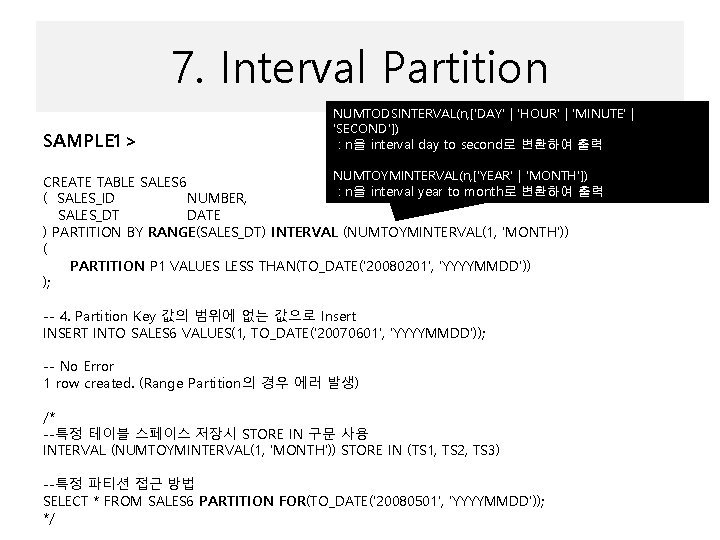
7. Interval Partition SAMPLE 1> NUMTODSINTERVAL(n, ['DAY' | 'HOUR' | 'MINUTE' | 'SECOND']) : n을 interval day to second로 변환하여 출력 NUMTOYMINTERVAL(n, ['YEAR' | 'MONTH']) CREATE TABLE SALES 6 : n을 interval year to month로 변환하여 출력 ( SALES_ID NUMBER, SALES_DT DATE ) PARTITION BY RANGE(SALES_DT) INTERVAL (NUMTOYMINTERVAL(1, 'MONTH')) ( PARTITION P 1 VALUES LESS THAN(TO_DATE('20080201', 'YYYYMMDD')) ); -- 4. Partition Key 값의 범위에 없는 값으로 Insert INSERT INTO SALES 6 VALUES(1, TO_DATE('20070601', 'YYYYMMDD')); -- No Error 1 row created. (Range Partition의 경우 에러 발생) /* --특정 테이블 스페이스 저장시 STORE IN 구문 사용 INTERVAL (NUMTOYMINTERVAL(1, 'MONTH')) STORE IN (TS 1, TS 2, TS 3) --특정 파티션 접근 방법 SELECT * FROM SALES 6 PARTITION FOR(TO_DATE('20080501', 'YYYYMMDD')); */
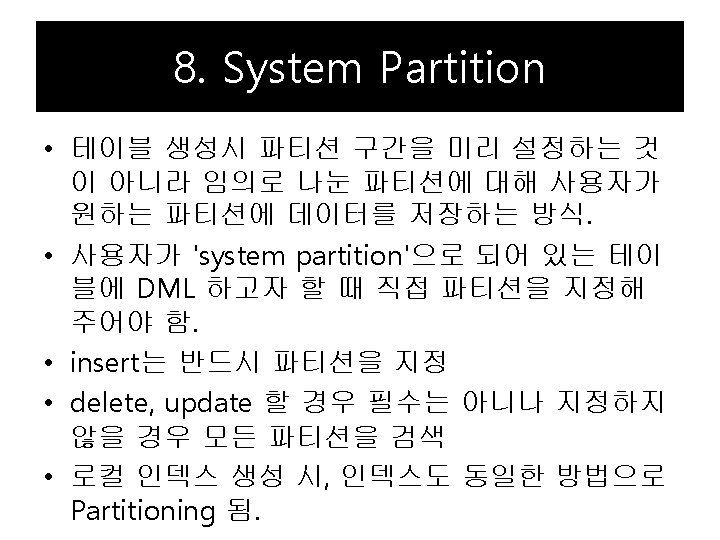
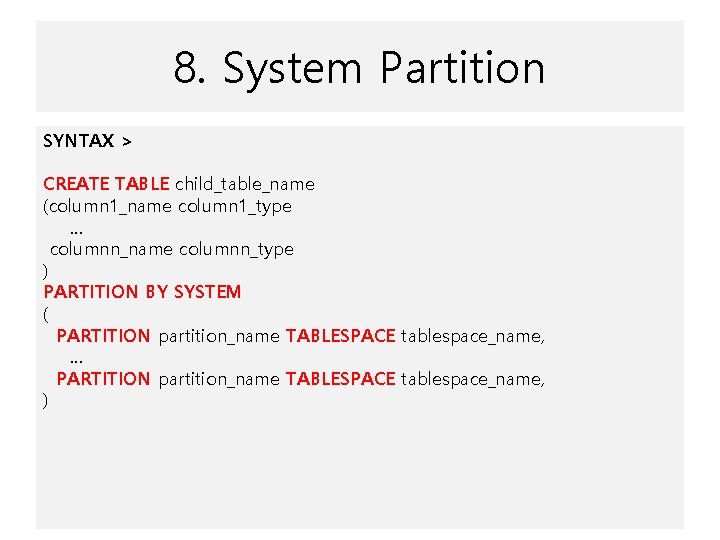
8. System Partition SYNTAX > CREATE TABLE child_table_name (column 1_name column 1_type … columnn_name columnn_type ) PARTITION BY SYSTEM ( PARTITION partition_name TABLESPACE tablespace_name, … PARTITION partition_name TABLESPACE tablespace_name, )
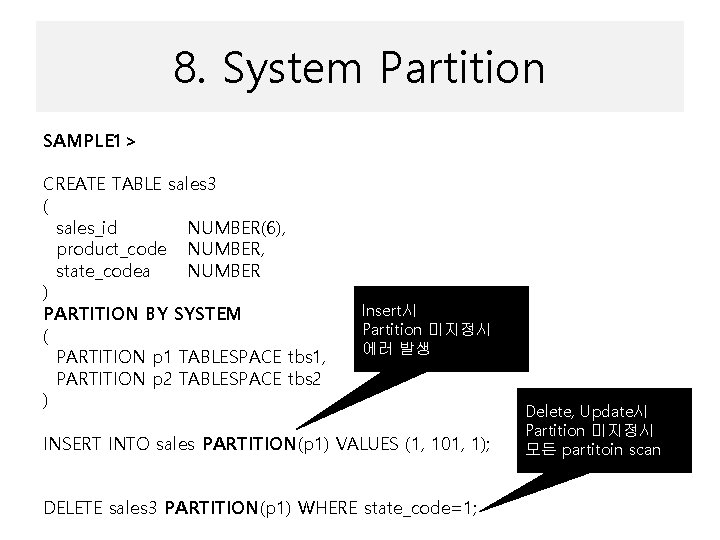
8. System Partition SAMPLE 1> CREATE TABLE sales 3 ( sales_id NUMBER(6), product_code NUMBER, state_codea NUMBER ) PARTITION BY SYSTEM ( PARTITION p 1 TABLESPACE tbs 1, PARTITION p 2 TABLESPACE tbs 2 ) Insert시 Partition 미지정시 에러 발생 INSERT INTO sales PARTITION(p 1) VALUES (1, 101, 1); DELETE sales 3 PARTITION(p 1) WHERE state_code=1; Delete, Update시 Partition 미지정시 모든 partitoin scan
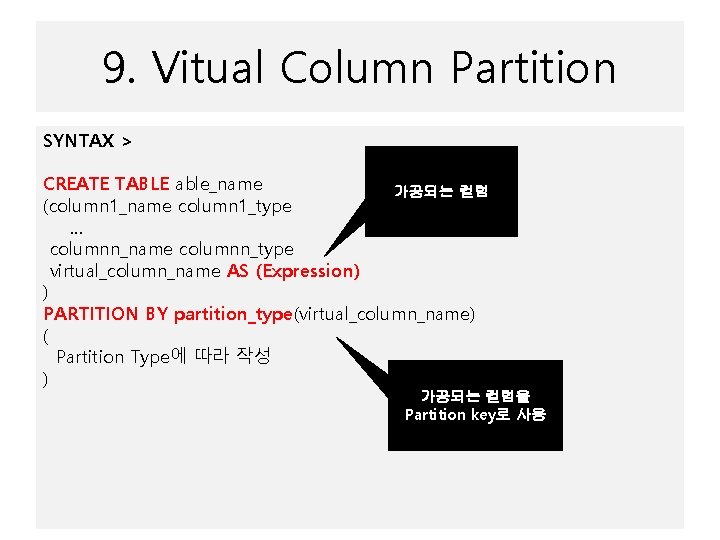
9. Vitual Column Partition SYNTAX > CREATE TABLE able_name 가공되는 컬럼 (column 1_name column 1_type … columnn_name columnn_type virtual_column_name AS (Expression) ) PARTITION BY partition_type(virtual_column_name) ( Partition Type에 따라 작성 ) 가공되는 컬럼을 Partition key로 사용
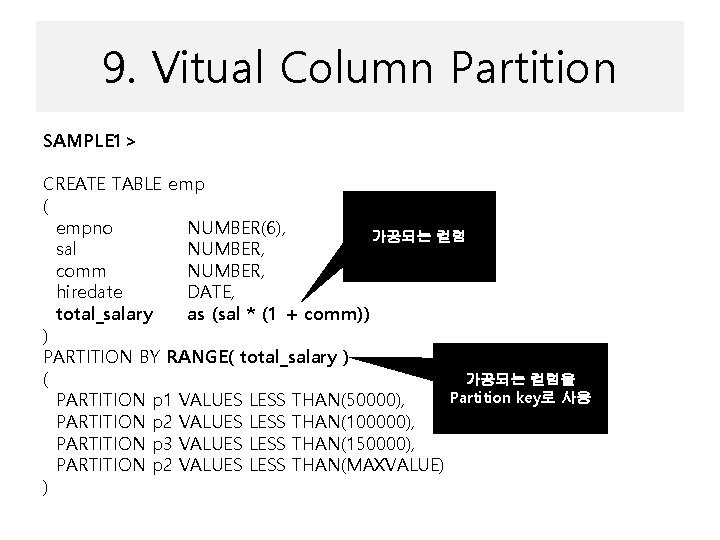
9. Vitual Column Partition SAMPLE 1> CREATE TABLE emp ( empno NUMBER(6), 가공되는 컬럼 sal NUMBER, comm NUMBER, hiredate DATE, total_salary as (sal * (1 + comm)) ) PARTITION BY RANGE( total_salary ) 가공되는 컬럼을 ( Partition key로 사용 PARTITION p 1 VALUES LESS THAN(50000), PARTITION p 2 VALUES LESS THAN(100000), PARTITION p 3 VALUES LESS THAN(150000), PARTITION p 2 VALUES LESS THAN(MAXVALUE) )
Partitioned Index
Local Partition Index • Index를 생성한 Table과 Partitioned Index가 Equi-partition 된 형태 • Index와 Table은 같은 컬럼에 의해 파티션 되며, 하나의 Index Partition이 Table Partition 하나와 대응 • 대응되는 Index Partition과 Table Partition은 각 각 같은 범위를 갖게 됨. • 결국 특정한 하나의 index에 포함된 모든 key들 은 하나의 table partition 내의 data만을 가리킴. • Local Prefixed Index와 Local Non-Prefixed Index로 구분
Local Prefixed Index • Index에서 맨 앞에 위치한 column에 의해 partition되는 방식 – Index Partition Key가 (Col_A + Col_B)인 Index의 구성컬럼이 (Col_A + Col_B + Col_C) 로 결합되어져 있다면 Prefixed index가 된다 • Local Prefixed index에서 컬럼은 Unique/Non. Unique를 모두 허용. • Base table의 파티션이 변경되면 local index의 관련 파티션만 변경.
Local Prefixed Index SYNTAX> CREATE INDEX index_nameb ON PARTITIONED_TABLE (index_column) LOCAL; EXAMPLE> CREATE TABLE local_index_test ( deptno NUMBER NOT NULL, loc VARCHAR 2(10) ) PARTITION BY RANGE (deptno) ( PARTITION part 1 VALUES LESS THAN(30), PARTITION part 2 values less than (MAXVALUE) ); CREATE INDEX dept_idx ON local_index_test(deptno) LOCAL;
Local Non-Prefixed Index • Index의 첫번째 column이 partition key가 아닌 형태로 base table과 동일한 partition구조를 가 진 index. (equi-partitioned) • 빠른 access가 요구 될 때 유용. (base table의 partition key는 제외. ) • partition 단위로 관리 할 수 있으므로 global index에 비해 운영상 편리. • OLAP 측면에서 global index보다 조회 속도가 저하.
Local Non-Prefixed Index SYNTAX> CREATE INDEX index_nameb ON PARTITIONED_TABLE (index_column) LOCAL; EXAMPLE> CREATE TABLE local_index_test ( deptno NUMBER NOT NULL, loc VARCHAR 2(10) ) PARTITION BY RANGE (deptno) ( PARTITION part 1 VALUES LESS THAN(30), PARTITION part 2 values less than (MAXVALUE) ); CREATE INDEX dept_idx ON local_index_test(loc, deptno) LOCAL;
Partition index - Global • global prefixed index – – – base table과 비교하여 not equi-partitioned 상태임. oracle은 only index structure만 관리. (partition은 관리안함) 최종 partition에는 maxvalue값이 반드시 기술되어야 함. local index보다 관리하기가 힘듦 기준 table의 partition이 변경되면 global index의 모든 partition에 영향을 미침. (global index의 재생성을 해야함) • Global non-partitioned index 생성 불가 – Index가 Partitioned 되어 있지 않은 형태(ORACLE 미지원)
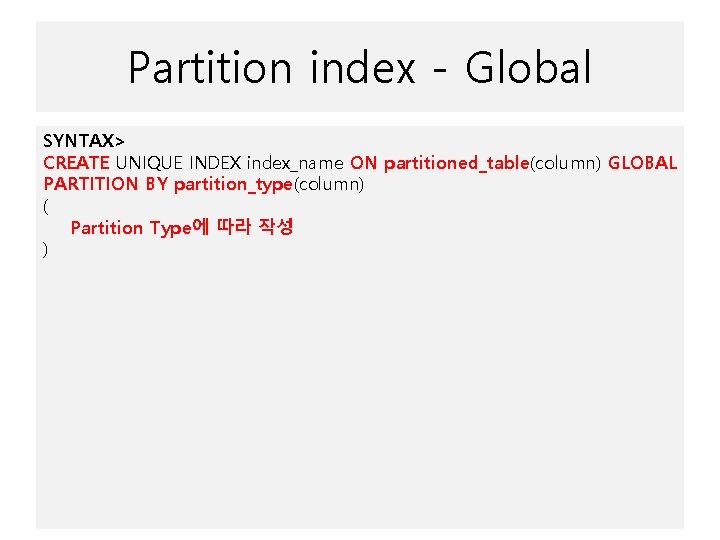
Partition index - Global SYNTAX> CREATE UNIQUE INDEX index_name ON partitioned_table(column) GLOBAL PARTITION BY partition_type(column) ( Partition Type에 따라 작성 )
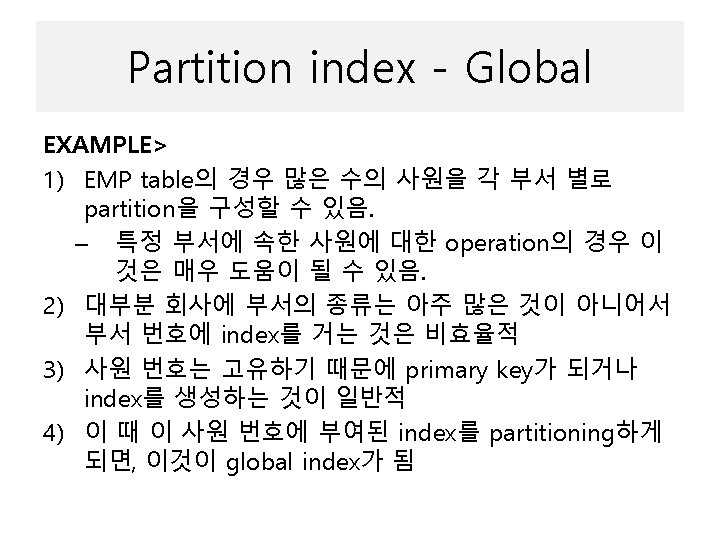
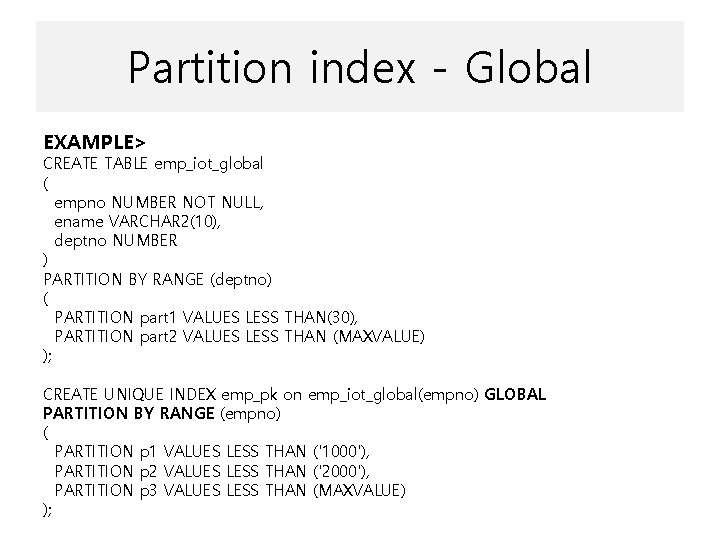
Partition index - Global EXAMPLE> CREATE TABLE emp_iot_global ( empno NUMBER NOT NULL, ename VARCHAR 2(10), deptno NUMBER ) PARTITION BY RANGE (deptno) ( PARTITION part 1 VALUES LESS THAN(30), PARTITION part 2 VALUES LESS THAN (MAXVALUE) ); CREATE UNIQUE INDEX emp_pk on emp_iot_global(empno) GLOBAL PARTITION BY RANGE (empno) ( PARTITION p 1 VALUES LESS THAN ('1000'), PARTITION p 2 VALUES LESS THAN ('2000'), PARTITION p 3 VALUES LESS THAN (MAXVALUE) );
참조 ** 파티셔닝 이용 시기 http: //wiki. oracleclub. com/pages/viewpage. action? page. Id=1507516 ** CREATE TABLE. . . PARTITION. . . 문 http: //radiocom. kunsan. ac. kr/lecture/oracle/statement_create/create_table_partition. html ** IOT PARTITIONING http: //kr. forums. oracle. com/forums/thread. jspa? thread. ID=468631&tstart=571 **오라클 파티션 기법-1 http: //blog. naver. com/imbyuri? Redirect=Log&log. No=110074188888 ** Oracle의 대표적인 DW를 위한 기능, Partition Table의 종류 http: //energ. tistory. com/273 ** 17 Managing Partitioned Tables and Indexes http: //download. oracle. com/docs/cd/B 19306_01/server. 102/b 14231/partiti. htm ** 18 Partitioned Tables and Indexes http: //download. oracle. com/docs/cd/B 19306_01/server. 102/b 14220/partconc. htm
END
- Slides: 110