
INDEX 1 Big Data 2 1 2 3
INDEX 1. Big. Data 실제 적용 사례 2. 빅데이터란 1)빅데이터 부각 배경 2)빅데이터 정의 3)빅데이터 활용 3. 빅데이터 관련 기술(Hadoop) 1)Hadoop Distributed File System(HDFS) 2)Map. Reduce 3)하둡 설정 4)File I/O Example 5)Map. Reduce Example 4. 빅데이터 시장 현황 5. 빅데이터 시사점 http: //insahara. tistory. com 2 /60
1. Big. Data 실제 적용 사례 http: //insahara. tistory. com
2. Big. Data 정의 http: //insahara. tistory. com
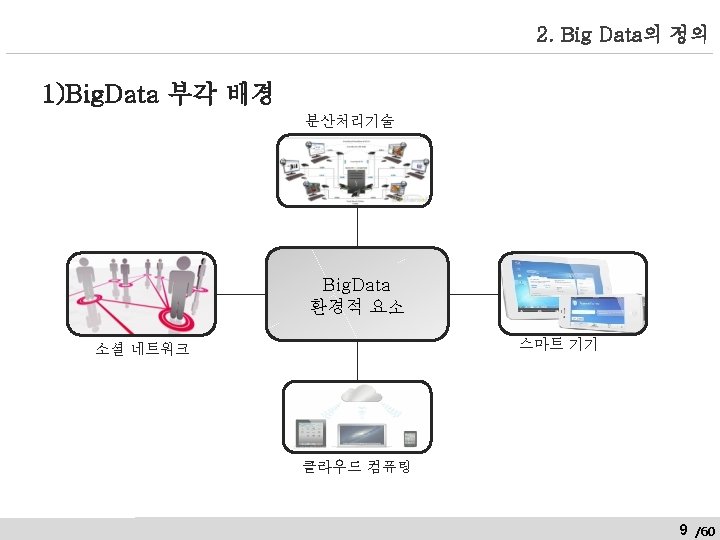
3. Big. Data 기술(Hadoop) 1)Hadoop Distributed File System(HDFS) 2)Map. Reduce 3)Hadoop File I/O & Map. Reduce Sample http: //insahara. tistory. com
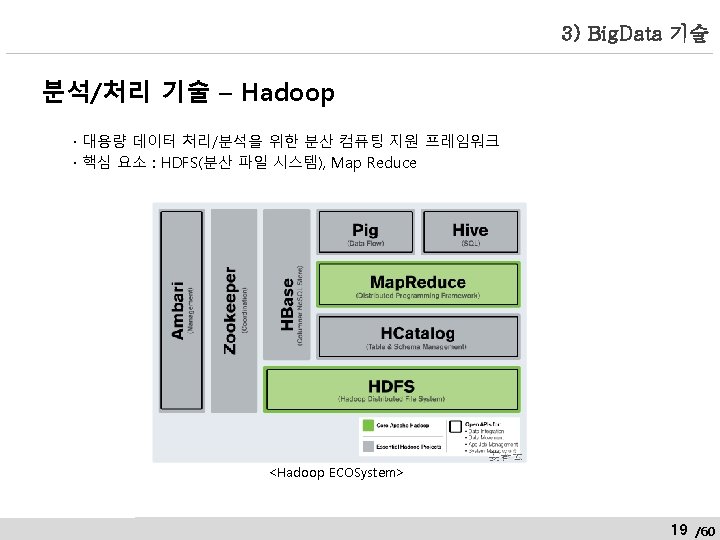
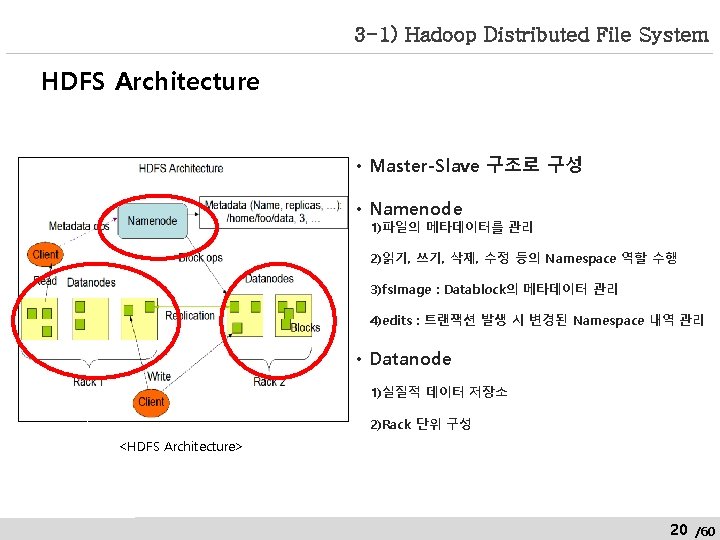
3 -1) Hadoop Distributed File System HDFS Architecture • Master-Slave 구조로 구성 • Namenode 1)파일의 메타데이터를 관리 2)읽기, 쓰기, 삭제, 수정 등의 Namespace 역할 수행 3)fs. Image : Datablock의 메타데이터 관리 4)edits : 트랜잭션 발생 시 변경된 Namespace 내역 관리 • Datanode 1)실질적 데이터 저장소 2)Rack 단위 구성 <HDFS Architecture> http: //insahara. tistory. com 20 /60
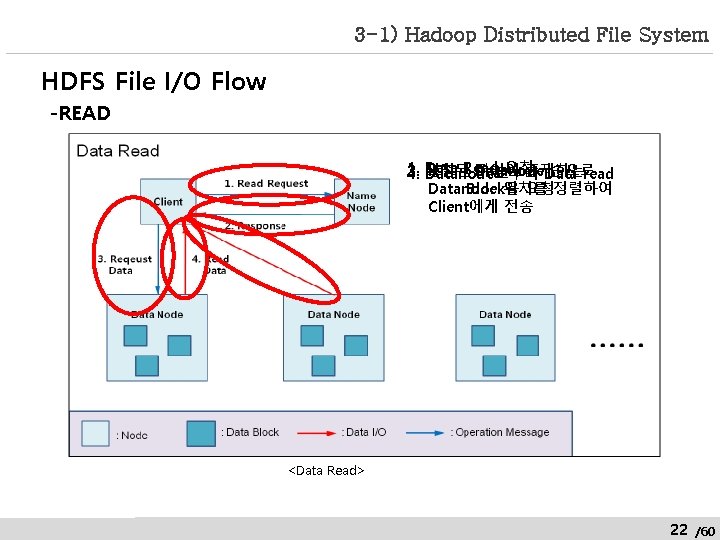
3 -1) Hadoop Distributed File System HDFS File I/O Flow -READ 1. 요청 3. 정렬된 Datanode 순으로 2. Data 요청된Read 파일이 존재하는 4. Datanode로부터 Data read Data Block을 요청정렬하여 Datanode 위치를 Client에게 전송 <Data Read> http: //insahara. tistory. com 22 /60
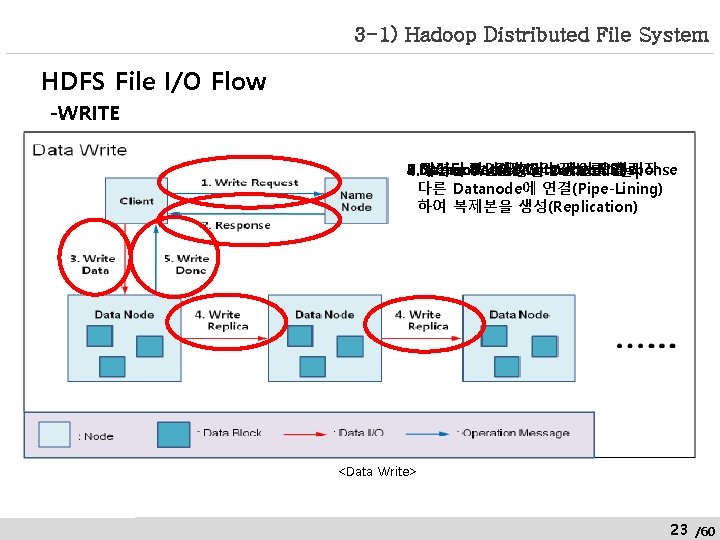
3 -1) Hadoop Distributed File System HDFS File I/O Flow -WRITE 5. 1. Namenode에 2. 정렬된 3. Datanode Write 작업 Datanode의 연결 및중인 Write Connection 및 Datanode는 Write 정보를 작업 작업 요청 Response 종료 시작 4. 데이터 Write 다른 Datanode에 연결(Pipe-Lining) 하여 복제본을 생성(Replication) <Data Write> http: //insahara. tistory. com 23 /60
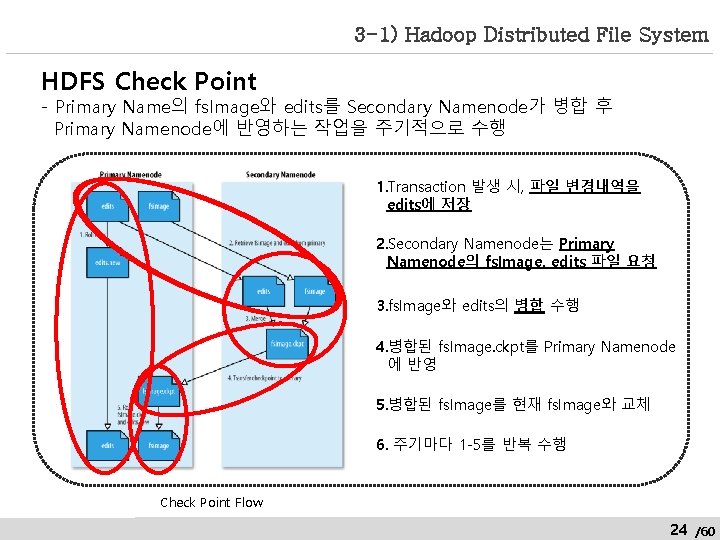
3 -1) Hadoop Distributed File System HDFS Check Point - Primary Name의 fs. Image와 edits를 Secondary Namenode가 병합 후 Primary Namenode에 반영하는 작업을 주기적으로 수행 1. Transaction 발생 시, 파일 변경내역을 edits에 저장 2. Secondary Namenode는 Primary Namenode의 fs. Image, edits 파일 요청 3. fs. Image와 edits의 병합 수행 4. 병합된 fs. Image. ckpt를 Primary Namenode 에 반영 5. 병합된 fs. Image를 현재 fs. Image와 교체 6. 주기마다 1 -5를 반복 수행 Check Point Flow http: //insahara. tistory. com 24 /60
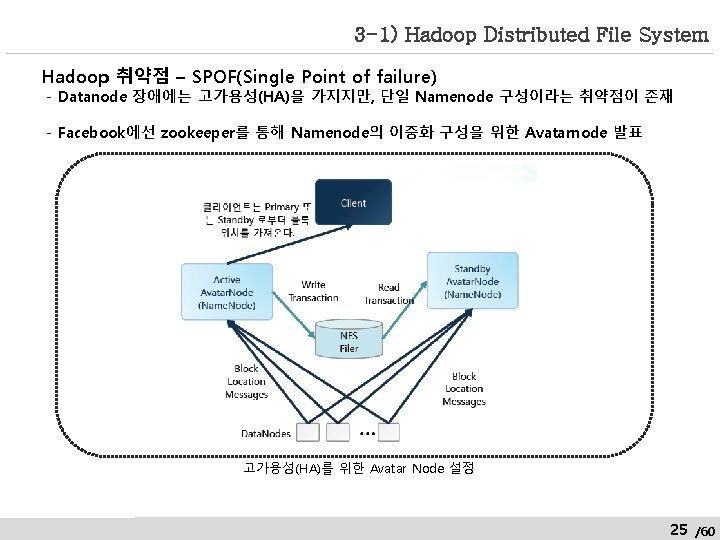
3 -1) Hadoop Distributed File System Hadoop 취약점 – SPOF(Single Point of failure) - Datanode 장애에는 고가용성(HA)을 가지지만, 단일 Namenode 구성이라는 취약점이 존재 - Facebook에선 zookeeper를 통해 Namenode의 이중화 구성을 위한 Avatarnode 발표 고가용성(HA)를 위한 Avatar Node 설정 http: //insahara. tistory. com 25 /60
Hadoop-Map. Reduce http: //insahara. tistory. com
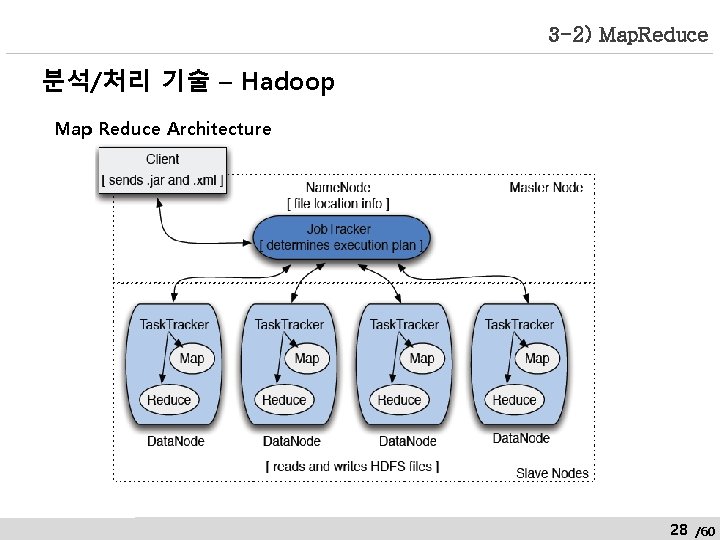
3 -2) Map. Reduce 분석/처리 기술 – Hadoop Map Reduce Architecture http: //insahara. tistory. com 28 /60
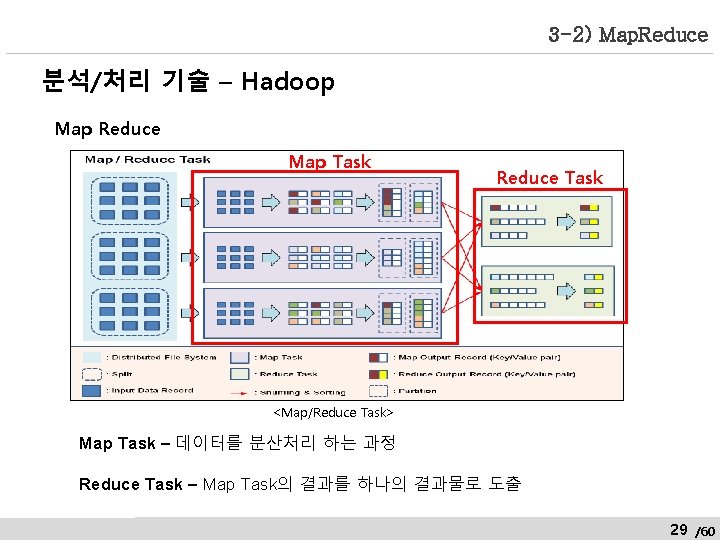
3 -2) Map. Reduce 분석/처리 기술 – Hadoop Map Reduce Map Task Reduce Task <Map/Reduce Task> Map Task – 데이터를 분산처리 하는 과정 Reduce Task – Map Task의 결과를 하나의 결과물로 도출 http: //insahara. tistory. com 29 /60
3 -3)Hadoop 설정 http: //insahara. tistory. com
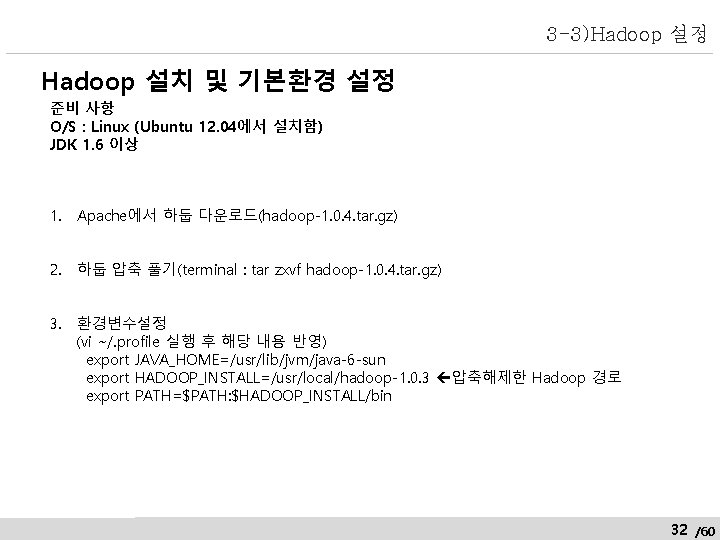
3 -3)Hadoop 설정 Hadoop 설치 및 기본환경 설정 준비 사항 O/S : Linux (Ubuntu 12. 04에서 설치함) JDK 1. 6 이상 1. Apache에서 하둡 다운로드(hadoop-1. 0. 4. tar. gz) 2. 하둡 압축 풀기(terminal : tar zxvf hadoop-1. 0. 4. tar. gz) 3. 환경변수설정 (vi ~/. profile 실행 후 해당 내용 반영) export JAVA_HOME=/usr/lib/jvm/java-6 -sun export HADOOP_INSTALL=/usr/local/hadoop-1. 0. 3 압축해제한 Hadoop 경로 export PATH=$PATH: $HADOOP_INSTALL/bin http: //insahara. tistory. com 32 /60
3 -3)Hadoop 설정 Hadoop 설치 및 기본환경 설정 준비 사항 O/S : Linux (Ubuntu 12. 04에서 설치함) JDK 1. 6 이상 4. {Hadoop-PATH} /conf/hadoop-env. sh 설정 4 -1)vi hadoop-env. sh 실행 4 -2)export JAVA_HOME=/usr/lib/jvm/java-6 -sun export HADOOP_HOME=하둡 패스 입력(ex: /usr/local/hadoop-1. 0. 4) 내용 반영 5. Profile 반영 (source. profile 실행 후 hadoop version 입력하여 하둡 버전이 나오는지 확인) 6. {Hadoop-PATH} /conf/ 내에 hdfs-site. xml, core-site. xml, mapred-site. xml 설정 후 hadoop namenode –format 실행 7. start-all. sh 실행(HDFS & Map Reduce 모두 실행) http: //insahara. tistory. com 33 /60
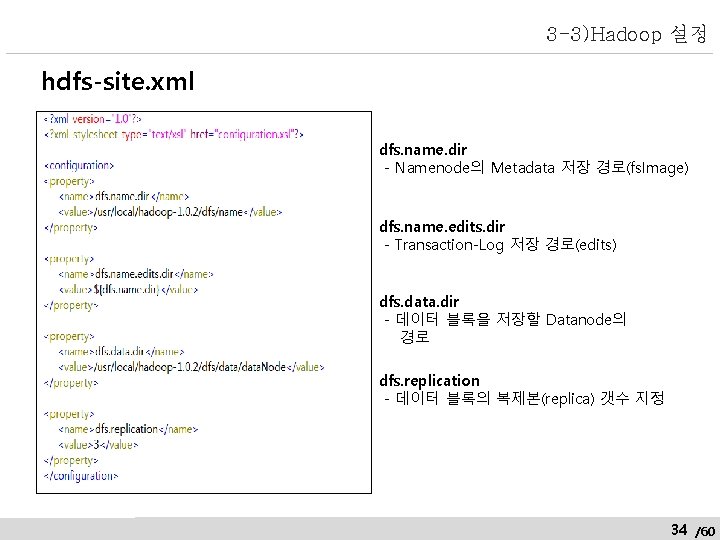
3 -3)Hadoop 설정 hdfs-site. xml dfs. name. dir - Namenode의 Metadata 저장 경로(fs. Image) dfs. name. edits. dir - Transaction-Log 저장 경로(edits) dfs. data. dir - 데이터 블록을 저장할 Datanode의 경로 dfs. replication - 데이터 블록의 복제본(replica) 갯수 지정 http: //insahara. tistory. com 34 /60
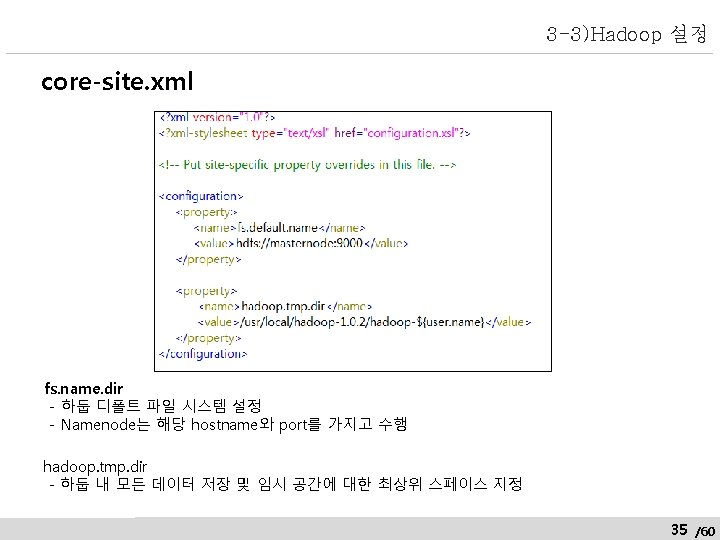
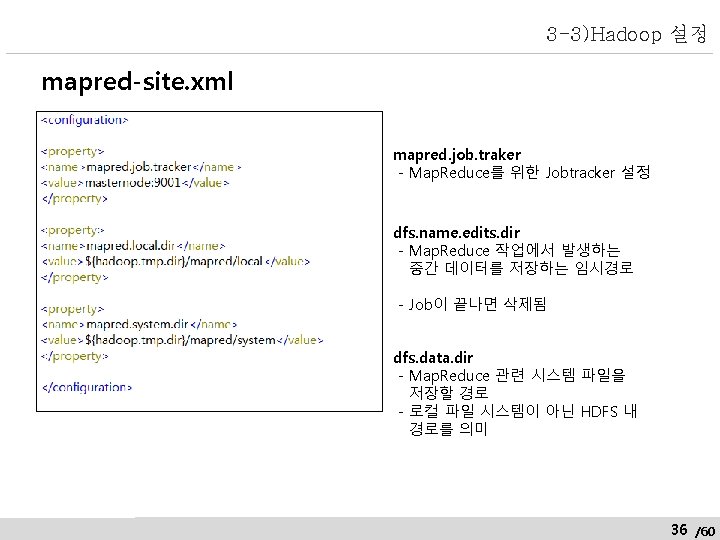
3 -3)Hadoop 설정 mapred-site. xml mapred. job. traker - Map. Reduce를 위한 Jobtracker 설정 dfs. name. edits. dir - Map. Reduce 작업에서 발생하는 중간 데이터를 저장하는 임시경로 - Job이 끝나면 삭제됨 dfs. data. dir - Map. Reduce 관련 시스템 파일을 저장할 경로 - 로컬 파일 시스템이 아닌 HDFS 내 경로를 의미 http: //insahara. tistory. com 36 /60
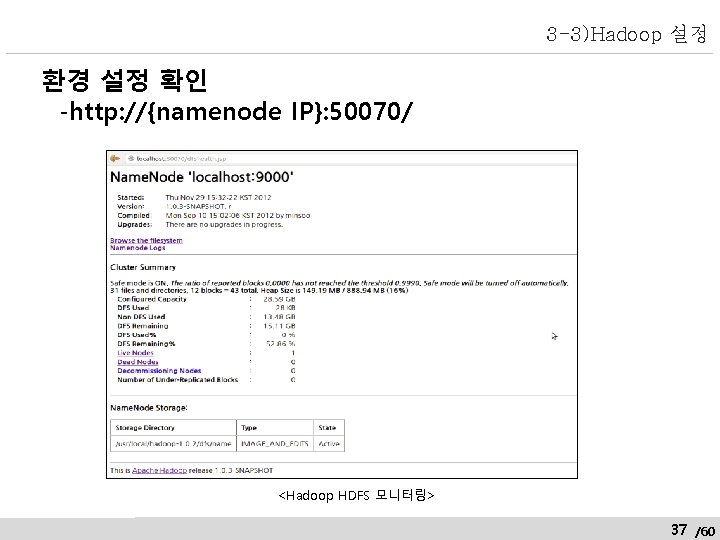
3 -3)Hadoop 설정 환경 설정 확인 -http: //{namenode IP}: 50070/ <Hadoop HDFS 모니터링> http: //insahara. tistory. com 37 /60
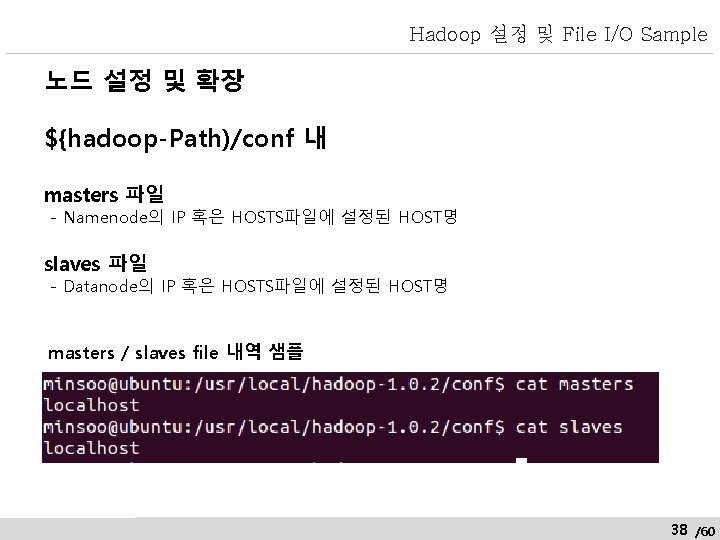
Hadoop 설정 및 File I/O Sample 노드 설정 및 확장 ${hadoop-Path)/conf 내 masters 파일 - Namenode의 IP 혹은 HOSTS파일에 설정된 HOST명 slaves 파일 - Datanode의 IP 혹은 HOSTS파일에 설정된 HOST명 masters / slaves file 내역 샘플 http: //insahara. tistory. com 38 /60
3 -4)HDFS File I/O Example http: //insahara. tistory. com
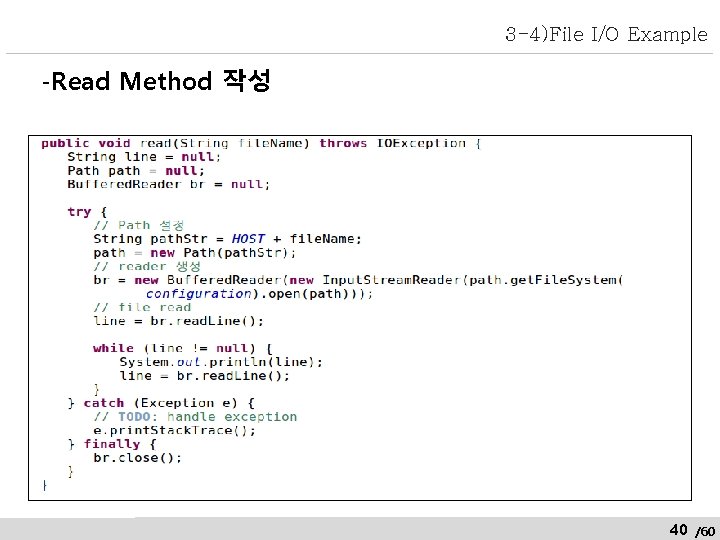
3 -4)File I/O Example -Read Method 작성 http: //insahara. tistory. com 40 /60
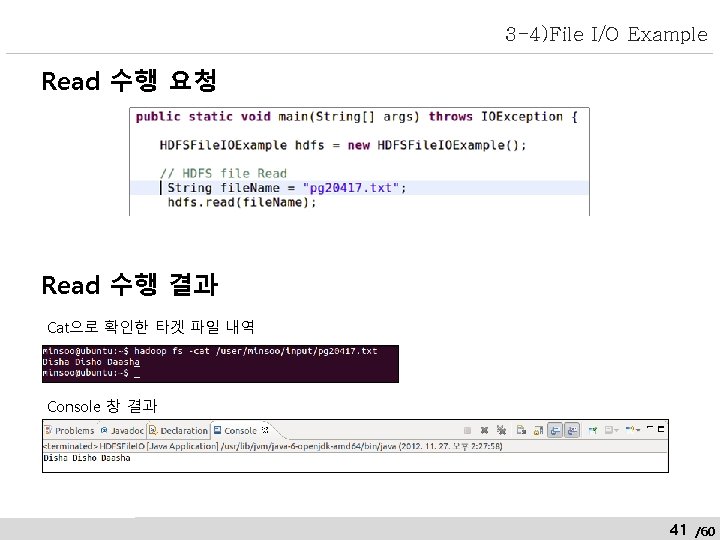
3 -4)File I/O Example Read 수행 요청 Read 수행 결과 Cat으로 확인한 타겟 파일 내역 Console 창 결과 http: //insahara. tistory. com 41 /60
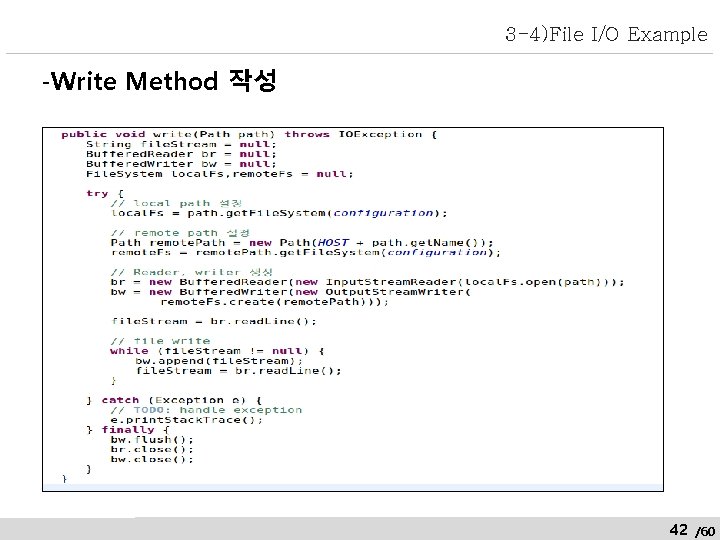
3 -4)File I/O Example -Write Method 작성 http: //insahara. tistory. com 42 /60
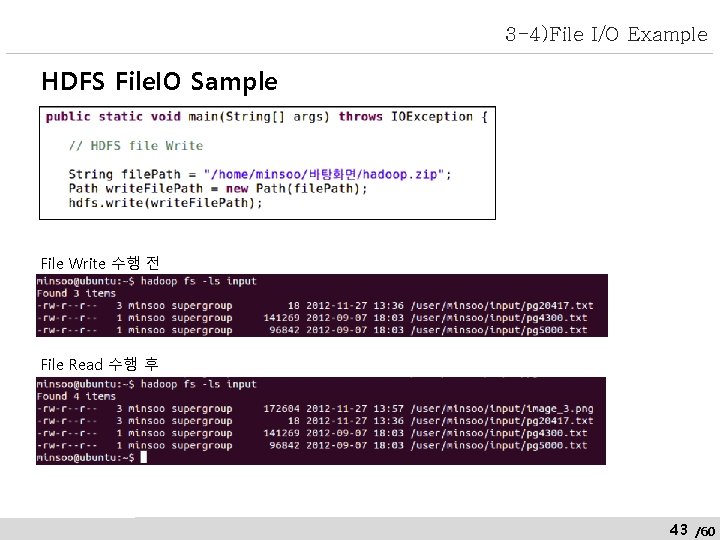
3 -4)File I/O Example HDFS File. IO Sample File Write 수행 전 File Read 수행 후 http: //insahara. tistory. com 43 /60
3 -5)Map. Reduce Example http: //insahara. tistory. com
3 -5) Map. Reduce Example 분석/처리 기술 – Hadoop Map Reduce Example - (Word. Count - Map) 1 ) JAVA 프로젝트 생성 2) 프로젝트 내 conf 폴더 생성 후 Hadoop/lib 내 Library 파일 copy 3) 소스 작성 http: //insahara. tistory. com 45 /60
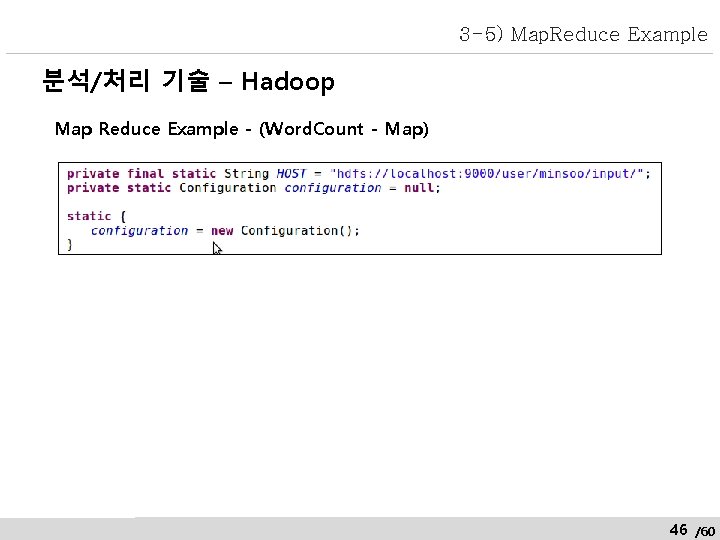
3 -5) Map. Reduce Example 분석/처리 기술 – Hadoop Map Reduce Example - (Word. Count - Map) http: //insahara. tistory. com 46 /60
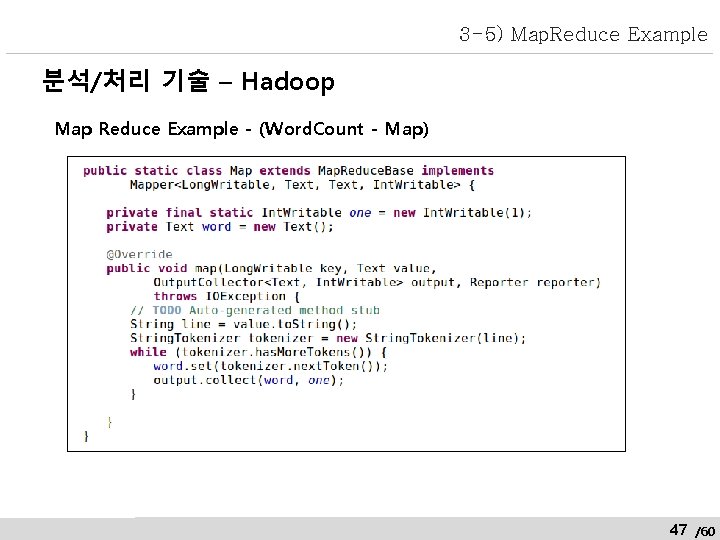
3 -5) Map. Reduce Example 분석/처리 기술 – Hadoop Map Reduce Example - (Word. Count - Map) http: //insahara. tistory. com 47 /60
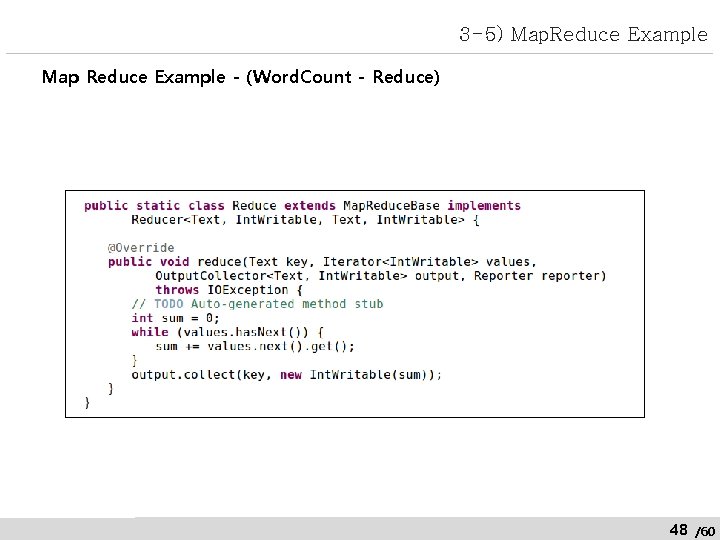
3 -5) Map. Reduce Example Map Reduce Example - (Word. Count - Reduce) http: //insahara. tistory. com 48 /60
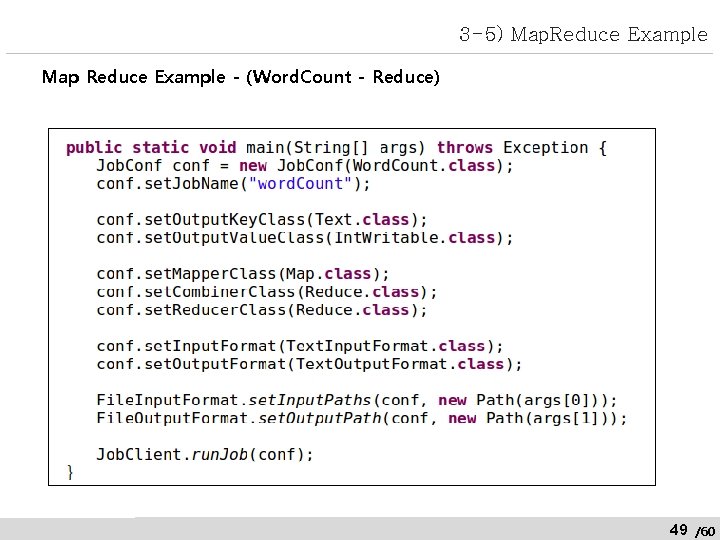
3 -5) Map. Reduce Example Map Reduce Example - (Word. Count - Reduce) http: //insahara. tistory. com 49 /60
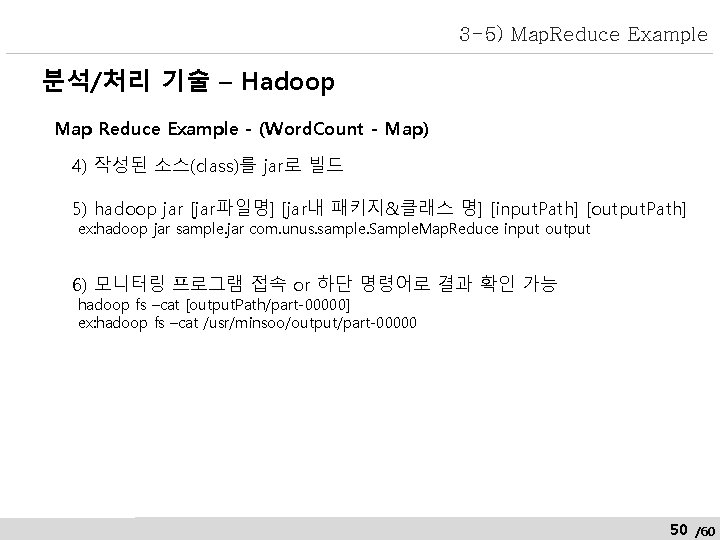
3 -5) Map. Reduce Example 분석/처리 기술 – Hadoop Map Reduce Example - (Word. Count - Map) 4) 작성된 소스(class)를 jar로 빌드 5) hadoop jar [jar파일명] [jar내 패키지&클래스 명] [input. Path] [output. Path] ex: hadoop jar sample. jar com. unus. sample. Sample. Map. Reduce input output 6) 모니터링 프로그램 접속 or 하단 명령어로 결과 확인 가능 hadoop fs –cat [output. Path/part-00000] ex: hadoop fs –cat /usr/minsoo/output/part-00000 http: //insahara. tistory. com 50 /60
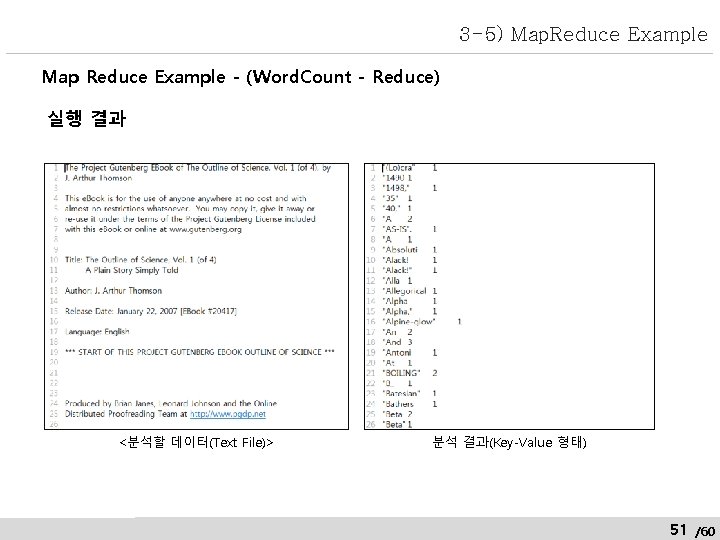
3 -5) Map. Reduce Example Map Reduce Example - (Word. Count - Reduce) 실행 결과 <분석할 데이터(Text File)> http: //insahara. tistory. com 분석 결과(Key-Value 형태) 51 /60
4. Big. Data 시장 현황 http: //insahara. tistory. com
5. Big. Data의 시사점 http: //insahara. tistory. com
감사합니다. http: //insahara. tistory. com
- Slides: 60