
IFT66975 Complexit despace L NL PSPACE Pcompltude et
- Slides: 66
IFT-66975 Complexité d’espace L, NL, PSPACE P-complétude et NC
Complexité d’espace n n n Le temps de calcul est la ressource la plus naturelle à considérer pour mesurer la complexité d’un problème. L’espace (quantité de mémoire) est clairement la seconde ressource dont on se soucie le plus en pratique. On veut développer pour cette mesure une taxonomie de complexité aussi riche que celle existant pour le temps.
n n On mesure la mémoire utilisée par une machine de Turing en comptant le nombre de cellules du ruban utilisées lors d’un calcul. On veut éviter de compter les cellules utilisées pour décrire le mot d’entrée x. Ainsi il est possible de dire d’un calcul qu’il utilise moins de |x| cellules de mémoire.
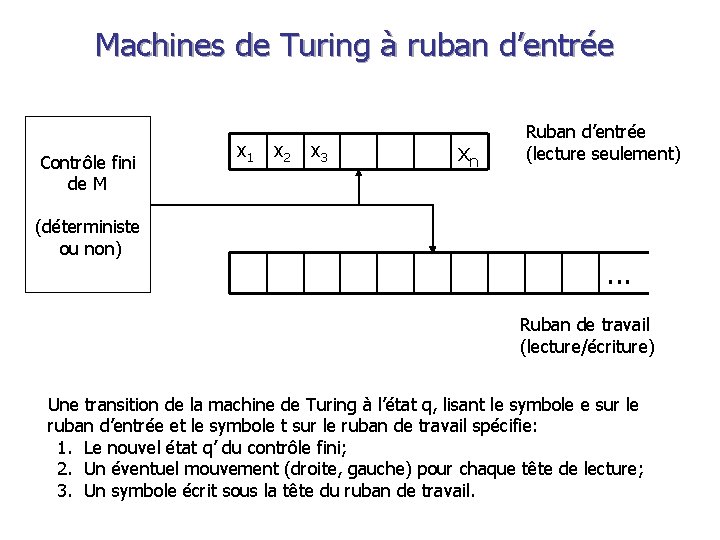
Machines de Turing à ruban d’entrée Contrôle fini de M (déterministe ou non) x 1 x 2 x 3 xn Ruban d’entrée (lecture seulement) . . . Ruban de travail (lecture/écriture) Une transition de la machine de Turing à l’état q, lisant le symbole e sur le ruban d’entrée et le symbole t sur le ruban de travail spécifie: 1. Le nouvel état q’ du contrôle fini; 2. Un éventuel mouvement (droite, gauche) pour chaque tête de lecture; 3. Un symbole écrit sous la tête du ruban de travail.
n n n Une telle machine de Turing peut être nondéterministe. La complexité d’espace d’une m. t. est la fonction s: N N telle que s(n) est le plus grand nombre de cases du ruban de travail utilisées sur une entrée de longueur n. Dans le cas d’une machine nondéterministe, s(n) = plus grand nombre de cases du ruban de travail utilisées sur une entrée de longueur n pour une certaine suite de choix non-déterministes.
Définitions: Pour f: N N, on définit n DTAPE(f) = classe des langages reconnus par une machine déterministe en espace O(f). NTAPE(f) = classe des langages reconnus par une machine non-déterministe en espace O(f). Note: la notation DSPACE et NSPACE est parfois utilisée.
Exemples n n n Les langages réguliers peuvent être reconnus en espace 0. On peut montrer que DTAPE(1) est exactement la classe des langages réguliers. (pas facile) En fait, même DSPACE(o(log n)) ne contient que les langages réguliers. (démonstration ++ difficile)
n s-t-connexité est dans NTAPE(log n). Entrée: graphe dirigé G = (V, E), et s, t V. Question: existe-t-il un chemin de s à t? n Idée: choisir non-déterministement une suite de sommets et vérifier qu’ils relient s à t. Mais attention: on ne peut pas écrire notre choix sur le ruban!
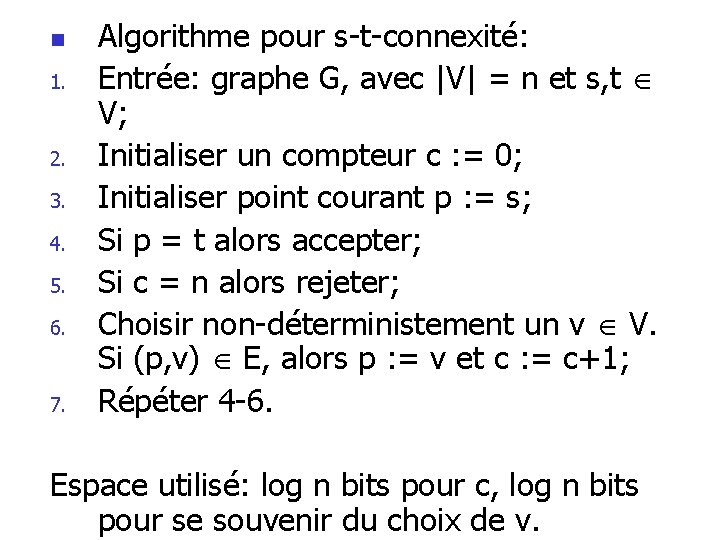
n 1. 2. 3. 4. 5. 6. 7. Algorithme pour s-t-connexité: Entrée: graphe G, avec |V| = n et s, t V; Initialiser un compteur c : = 0; Initialiser point courant p : = s; Si p = t alors accepter; Si c = n alors rejeter; Choisir non-déterministement un v V. Si (p, v) E, alors p : = v et c : = c+1; Répéter 4 -6. Espace utilisé: log n bits pour c, log n bits pour se souvenir du choix de v.
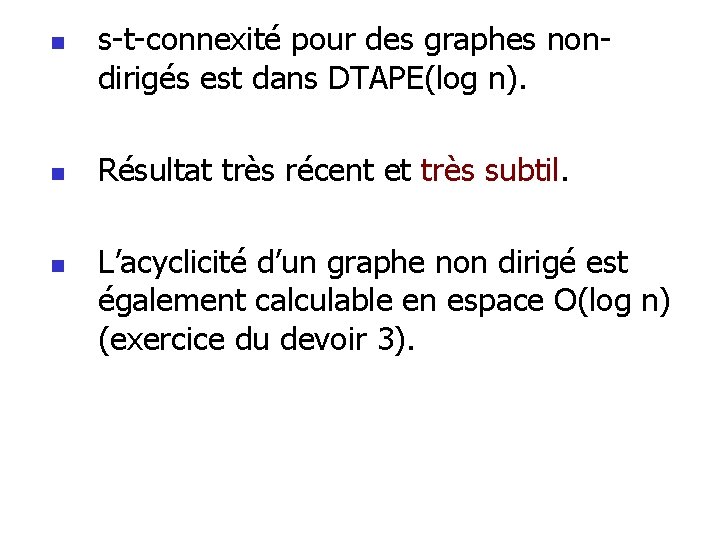
n n n s-t-connexité pour des graphes nondirigés est dans DTAPE(log n). Résultat très récent et très subtil. L’acyclicité d’un graphe non dirigé est également calculable en espace O(log n) (exercice du devoir 3).
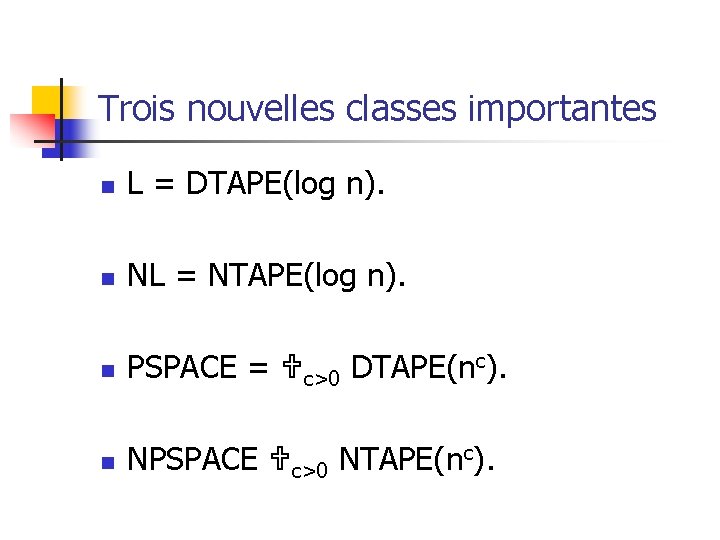
Trois nouvelles classes importantes n L = DTAPE(log n). n NL = NTAPE(log n). n PSPACE = c>0 DTAPE(nc). n NPSPACE c>0 NTAPE(nc).
n Définition: La fonction s: N N est espace-constructible s’il existe une m. t. déterministe utilisant un espace s(n) qui étant donné x écrit sur son ruban de travail la représentation binaire de s(|x|). En particulier, si s est espace-constructible on peut en espace s(|x|) délimiter une région de s(|x|) cellules du ruban de travail. (Note: toute fonction “raisonnable” est espaceconstructible. )
n n n Théorème: [Savitch] Si s: N N est espace-constructible et si s(n) log n, alors NTAPE(s(n)) DTAPE(s 2(n)). Corollaire: PSPACE = NSPACE Contraste important avec la complexité de temps où on pense que la simulation d’une machine non-déterministe ne peut se faire qu’à un coût exponentiel.
n Démonstration: Supposons que L est reconnu par une m. t. à ruban d’entrée non-déterministe M qui utilise un espace s(n). On veut construire une m. t. déterministe M’ qui reconnaît L avec espace s 2(n). Idée maîtresse: analyser le graphe de configurations de M.
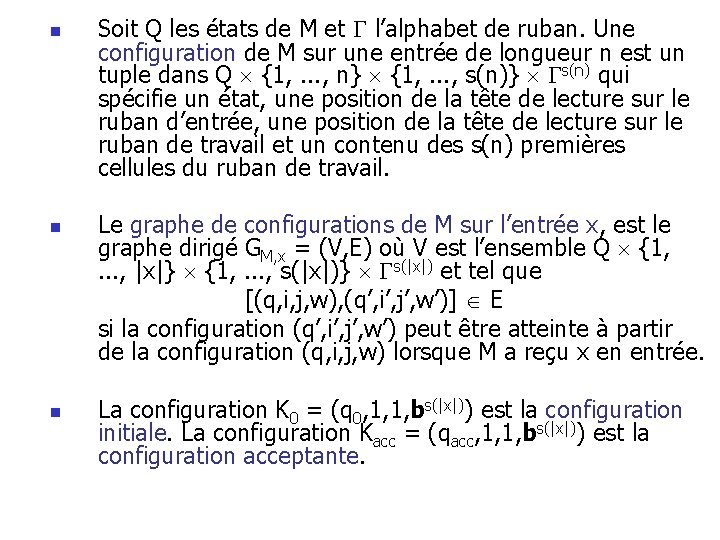
n n n Soit Q les états de M et l’alphabet de ruban. Une configuration de M sur une entrée de longueur n est un tuple dans Q {1, . . . , n} {1, . . . , s(n)} s(n) qui spécifie un état, une position de la tête de lecture sur le ruban d’entrée, une position de la tête de lecture sur le ruban de travail et un contenu des s(n) premières cellules du ruban de travail. Le graphe de configurations de M sur l’entrée x, est le graphe dirigé GM, x = (V, E) où V est l’ensemble Q {1, . . . , |x|} {1, . . . , s(|x|)} s(|x|) et tel que [(q, i, j, w), (q’, i’, j’, w’)] E si la configuration (q’, i’, j’, w’) peut être atteinte à partir de la configuration (q, i, j, w) lorsque M a reçu x en entrée. La configuration K 0 = (q 0, 1, 1, bs(|x|)) est la configuration initiale. La configuration Kacc = (qacc, 1, 1, bs(|x|)) est la configuration acceptante.
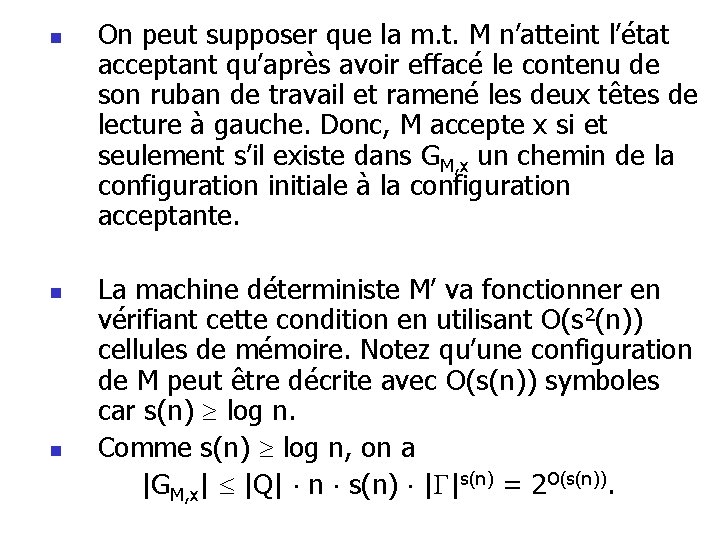
n n n On peut supposer que la m. t. M n’atteint l’état acceptant qu’après avoir effacé le contenu de son ruban de travail et ramené les deux têtes de lecture à gauche. Donc, M accepte x si et seulement s’il existe dans GM, x un chemin de la configuration initiale à la configuration acceptante. La machine déterministe M’ va fonctionner en vérifiant cette condition en utilisant O(s 2(n)) cellules de mémoire. Notez qu’une configuration de M peut être décrite avec O(s(n)) symboles car s(n) log n. Comme s(n) log n, on a |GM, x| |Q| n s(n) | |s(n) = 2 O(s(n)).
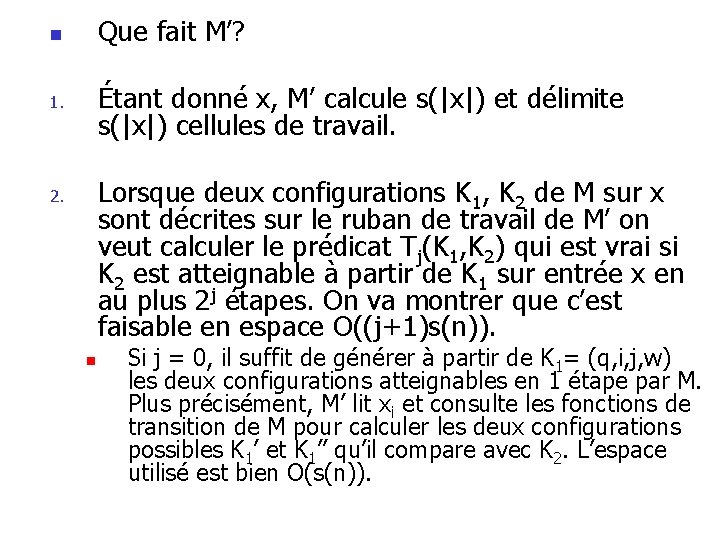
Que fait M’? n Étant donné x, M’ calcule s(|x|) et délimite s(|x|) cellules de travail. 1. Lorsque deux configurations K 1, K 2 de M sur x sont décrites sur le ruban de travail de M’ on veut calculer le prédicat Tj(K 1, K 2) qui est vrai si K 2 est atteignable à partir de K 1 sur entrée x en au plus 2 j étapes. On va montrer que c’est faisable en espace O((j+1)s(n)). 2. n Si j = 0, il suffit de générer à partir de K 1= (q, i, j, w) les deux configurations atteignables en 1 étape par M. Plus précisément, M’ lit xi et consulte les fonctions de transition de M pour calculer les deux configurations possibles K 1’ et K 1’’ qu’il compare avec K 2. L’espace utilisé est bien O(s(n)).
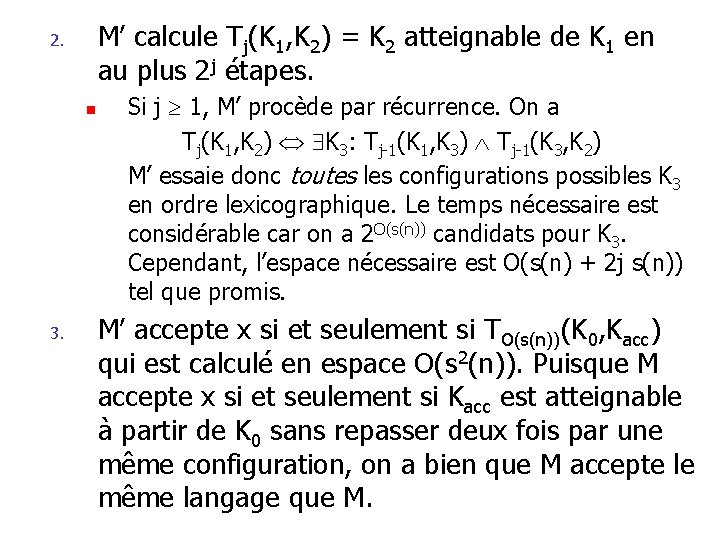
M’ calcule Tj(K 1, K 2) = K 2 atteignable de K 1 en au plus 2 j étapes. 2. n 3. Si j 1, M’ procède par récurrence. On a Tj(K 1, K 2) K 3: Tj-1(K 1, K 3) Tj-1(K 3, K 2) M’ essaie donc toutes les configurations possibles K 3 en ordre lexicographique. Le temps nécessaire est considérable car on a 2 O(s(n)) candidats pour K 3. Cependant, l’espace nécessaire est O(s(n) + 2 j s(n)) tel que promis. M’ accepte x si et seulement si TO(s(n))(K 0, Kacc) qui est calculé en espace O(s 2(n)). Puisque M accepte x si et seulement si Kacc est atteignable à partir de K 0 sans repasser deux fois par une même configuration, on a bien que M accepte le même langage que M.
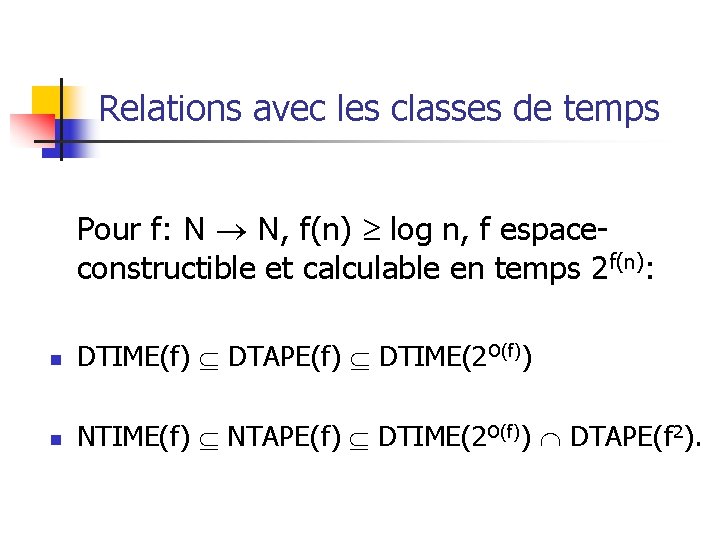
Relations avec les classes de temps Pour f: N N, f(n) log n, f espaceconstructible et calculable en temps 2 f(n): n DTIME(f) DTAPE(f) DTIME(2 O(f)) n NTIME(f) NTAPE(f) DTIME(2 O(f)) DTAPE(f 2).
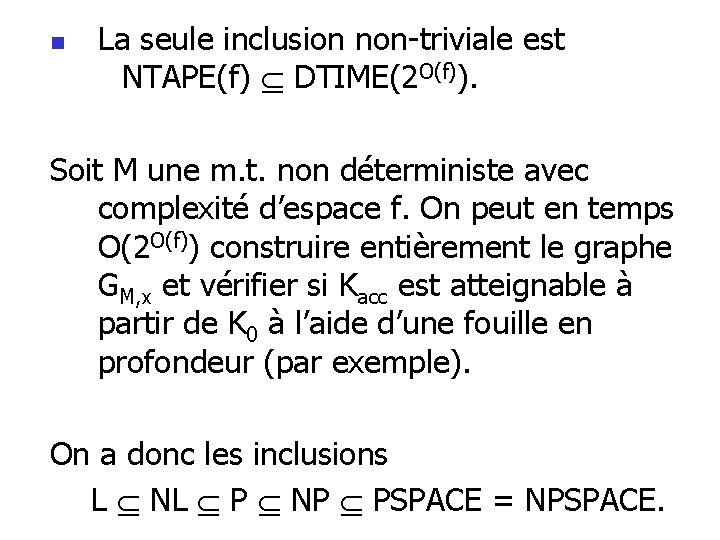
n La seule inclusion non-triviale est NTAPE(f) DTIME(2 O(f)). Soit M une m. t. non déterministe avec complexité d’espace f. On peut en temps O(2 O(f)) construire entièrement le graphe GM, x et vérifier si Kacc est atteignable à partir de K 0 à l’aide d’une fouille en profondeur (par exemple). On a donc les inclusions L NL P NP PSPACE = NPSPACE.
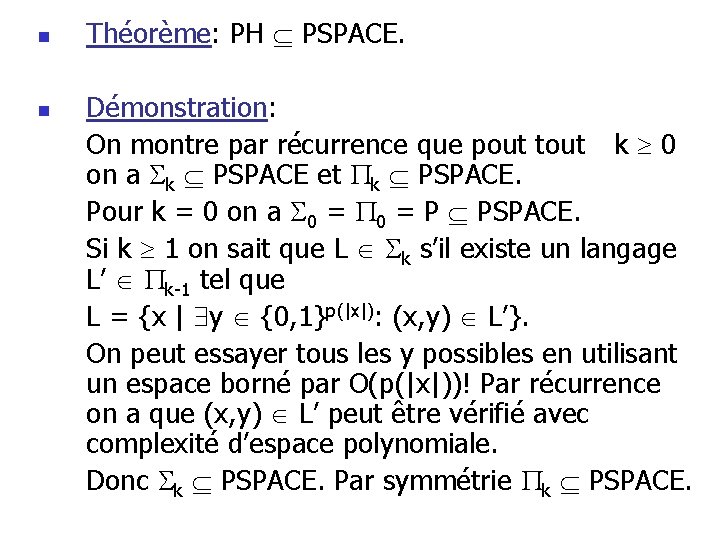
n n Théorème: PH PSPACE. Démonstration: On montre par récurrence que pout tout k 0 on a k PSPACE et k PSPACE. Pour k = 0 on a 0 = P PSPACE. Si k 1 on sait que L k s’il existe un langage L’ k-1 tel que L = {x | y {0, 1}p(|x|): (x, y) L’}. On peut essayer tous les y possibles en utilisant un espace borné par O(p(|x|))! Par récurrence on a que (x, y) L’ peut être vérifié avec complexité d’espace polynomiale. Donc k PSPACE. Par symmétrie k PSPACE.
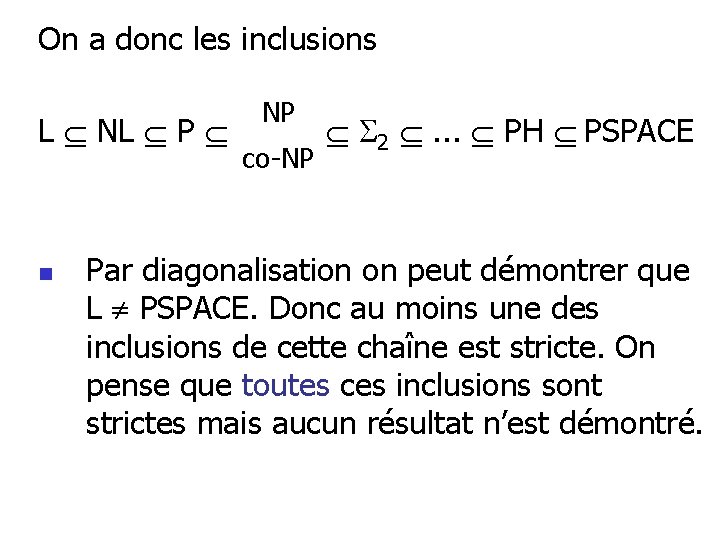
On a donc les inclusions L NL P n NP co-NP 2 . . . PH PSPACE Par diagonalisation on peut démontrer que L PSPACE. Donc au moins une des inclusions de cette chaîne est stricte. On pense que toutes ces inclusions sont strictes mais aucun résultat n’est démontré.
PSPACE-complétude n n Un problème K de PSPACE est PSPACEcomplet si pour tout L PSPACE on a L p K. La PSPACE-complétude est une très forte indication qu’un problème n’admet pas d’algorithme efficace. De nombreux problèmes naissant de la théorie des jeux sont PSPACE-complets.
n Formule Booléenne quantifiée (QBF) Entrée: une formule booléenne quantifiée : Q 1 x 1 Q 2 x 2. . . Qnxn: (x 1, . . . , xn) où Qi { , } et est une formule booléenne avec variables xi. Question: La formule est-elle vraie? À noter que le nombre d’alternations entre les quantificateurs existentiels et universels n’est pas borné, contrairement aux problèmes SATkcir.
n n Théorème: QBF est PSPACE-complet. Démonstration: On veut d’abord montrer QBF PSPACE. Supposons Q 1 = . Alors est vraie si une des deux formules Q 2 x 2. . . Qnxn: E(1, x 2, . . . , xn) ou Q 2 x 2. . . Qnxn: E(0, x 2, . . . , xn) est vraie. On peut ainsi bâtir un algorithme récursif. La base de la récursion est l’évaluation d’une formule sans variable, ce qui se fait en temps polynomial. La gestion de la récurrence nécessite que l’on conserve en mémoire au plus n bits.
n Soit L PSPACE, reconnu par la machine M utilisant un espace p(n). On veut montrer L p QBF. Considérons encore le graphe de configurations de M sur l’entrée x. Cette fois M est déterministe donc il existe au plus une arête sortante de chaque configuration. On a toujours que x L si et seulement si M accepte x s’il existe un chemin de longueur 2 O(p(|x|)) de K 0 à Kacc dans le graphe de configurations. On va montrer comment construire en temps polynomial une formule booléenne quantifiée S(x) qui est vraie si et seulement s’il existe un tel chemin.
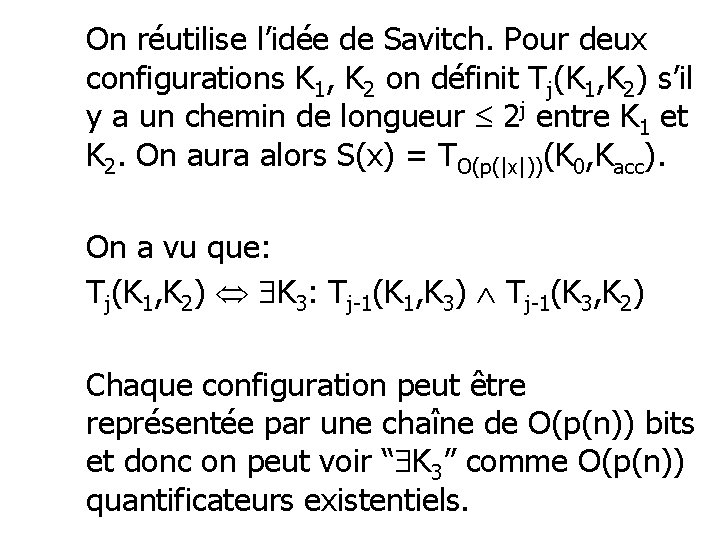
On réutilise l’idée de Savitch. Pour deux configurations K 1, K 2 on définit Tj(K 1, K 2) s’il y a un chemin de longueur 2 j entre K 1 et K 2. On aura alors S(x) = TO(p(|x|))(K 0, Kacc). On a vu que: Tj(K 1, K 2) K 3: Tj-1(K 1, K 3) Tj-1(K 3, K 2) Chaque configuration peut être représentée par une chaîne de O(p(n)) bits et donc on peut voir “ K 3” comme O(p(n)) quantificateurs existentiels.
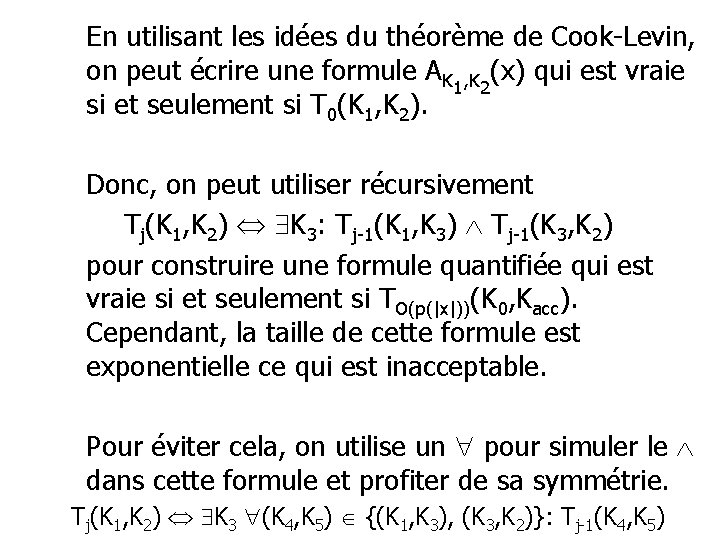
En utilisant les idées du théorème de Cook-Levin, on peut écrire une formule AK 1, K 2(x) qui est vraie si et seulement si T 0(K 1, K 2). Donc, on peut utiliser récursivement Tj(K 1, K 2) K 3: Tj-1(K 1, K 3) Tj-1(K 3, K 2) pour construire une formule quantifiée qui est vraie si et seulement si TO(p(|x|))(K 0, Kacc). Cependant, la taille de cette formule est exponentielle ce qui est inacceptable. Pour éviter cela, on utilise un pour simuler le dans cette formule et profiter de sa symmétrie. Tj(K 1, K 2) K 3 (K 4, K 5) {(K 1, K 3), (K 3, K 2)}: Tj-1(K 4, K 5)
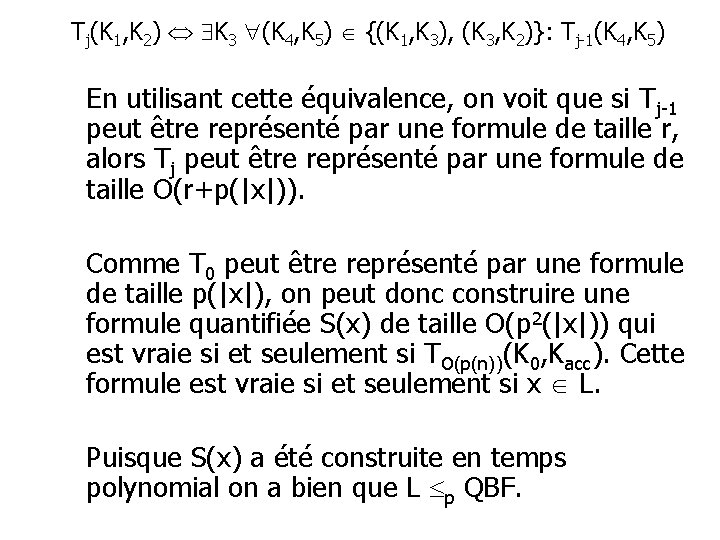
Tj(K 1, K 2) K 3 (K 4, K 5) {(K 1, K 3), (K 3, K 2)}: Tj-1(K 4, K 5) En utilisant cette équivalence, on voit que si Tj-1 peut être représenté par une formule de taille r, alors Tj peut être représenté par une formule de taille O(r+p(|x|)). Comme T 0 peut être représenté par une formule de taille p(|x|), on peut donc construire une formule quantifiée S(x) de taille O(p 2(|x|)) qui est vraie si et seulement si TO(p(n))(K 0, Kacc). Cette formule est vraie si et seulement si x L. Puisque S(x) a été construite en temps polynomial on a bien que L p QBF.
Stratégies de jeux gagnantes n De façon abstraite, un jeu entre Alice et Bob est une compétition se déroulant en n rondes de coups. Pour chaque ronde, Alice joue un coup et Bob joue un coup (selon des règles spécifiées). Après n rondes, l’un des deux joueurs est déclaré gagnant, selon une règle préétablie. L’identité du gagnant dépend de la suite de coups joués.
n n On dit qu’Alice a une stratégie gagnante pour le jeu J si elle peut toujours gagner lorsque les deux joueurs jouent de façon optimale. En d’autres mots, Alice peut jouer un coup à la première ronde tel que peu importe le coup joué par Bob elle peut jouer un second coup tel que peu importe le second coup joué par Bob. . . Alice peut jouer un dernier coup tel que peu importe le dernier coup de Bob, Alice est gagnante. On retrouve des exemples de jeu un peu partout en IA mais aussi en économie, en sociologie, en sciences stratégiques etc. La question fondamentale à propos de tout jeu est: Alice a-t-elle une stratégie gagnante?
n n n Exemple: le jeu Géographie. À la ronde 1, Alice choisit un nom de ville du monde qui commence par “A”. Bob doit répondre par un nom de ville du monde qui commence par la dernière lettre de la ville choisie par Alice. On alterne ainsi sans réutiliser la même ville. Le premier qui ne peut nommer une ville a perdu. Il se peut qu’Alice est une stratégie gagnante aujourd’hui mais pas demain!
n On définit Géographie Généralisée (GG): Entrée: une liste de villes représenté comme un graphe dirigé G avec un point de départ distingué s V. Question: Existe-t-il une stratégie gagnante pour Alice dans le jeu suivant? On part du point s. Chaque coup à partir du point v correspond au choix d’un point v’ non visité et tel que (v, v’) E. Le premier joueur qui n’a pas de coup possible a perdu. n GG est PSPACE-complet.
On a tout d’abord GG PSPACE. n On construit un algorithme récursif qui détermine si Alice peut gagner sur le graphe G à partir du point s. n Algorithme A n 1. 2. 3. n Entrée: G, s. Si s a degré sortant 0, alors G, s est perdant. Sinon, pour chaque si tel que (s, si) E faire appel récursif A( G’, si ) où G’ est G – {s}. Si tous ces appels acceptent alors Bob aura une stratégie gagnante peut importe le coup de Alice donc G, s est perdant. Sinon, G, s est gagnant. A peut être implémenté en espace O(|G|).
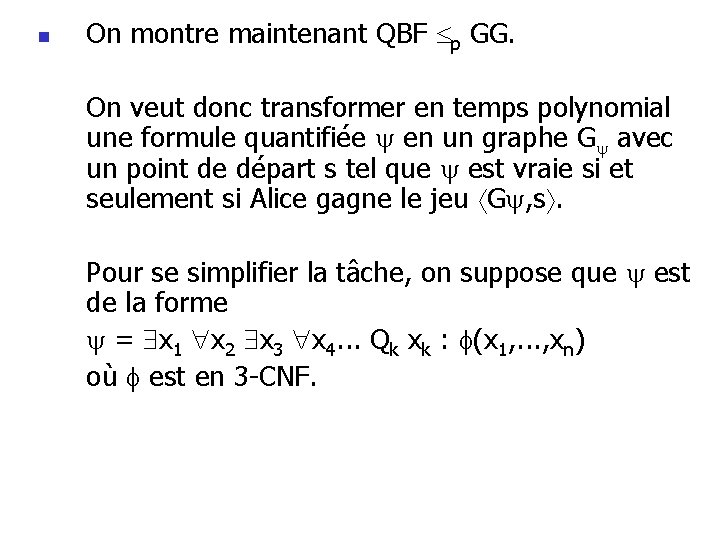
n On montre maintenant QBF p GG. On veut donc transformer en temps polynomial une formule quantifiée en un graphe G avec un point de départ s tel que est vraie si et seulement si Alice gagne le jeu G , s. Pour se simplifier la tâche, on suppose que est de la forme = x 1 x 2 x 3 x 4. . . Qk xk : (x 1, . . . , xn) où est en 3 -CNF.
n n La plupart des jeux de stratégie (go, échecs, dames, tic-tac-toe, othello) sont des jeux se jouant sur une grille fixe. Donc, selon nos définitions, on peut déterminer si Alice a une stratégie gagnante en temps constant! La plupart de ces jeux (pas les échecs) se généralisent naturellement à des grilles n n arbitrairement grandes. On peut montrer que des versions généralisées du go, des dames, d’othello, etc. donnent naissance à des problèmes PSPACE-complets.
Problèmes NL-complets n n Puisque NL P, tous les problèmes non -triviaux de NL sont NL-complets sous les transformations polynomiales. On a donc besoin d’utiliser une notion de réduction beaucoup plus restrictive afin d’obtenir une notion intéressante de NL-complétude.
Fonctions calculables en espace log n Une fonction f: * * est calculable en espace logarithmique s’il existe une machine avec un ruban d’entrée (lecture seulement), un ruban de travail (lecture/écriture) et un ruban de sortie (écriture seule) qui en entrée x produit f(x) sur le ruban de sortie et utilise O(log n) cellules du ruban de travail.
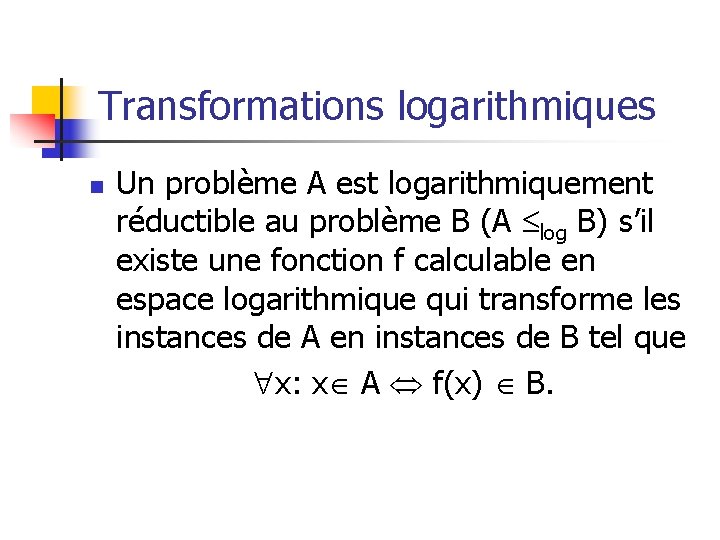
Transformations logarithmiques n Un problème A est logarithmiquement réductible au problème B (A log B) s’il existe une fonction f calculable en espace logarithmique qui transforme les instances de A en instances de B tel que x: x A f(x) B.
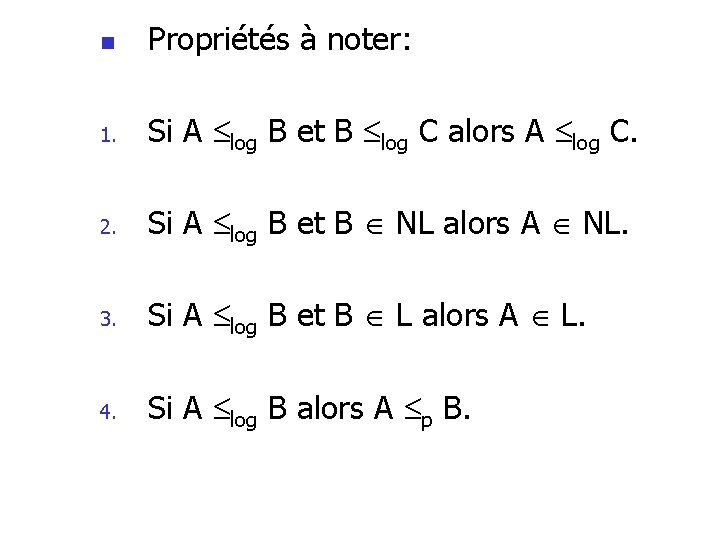
n Propriétés à noter: 1. Si A log B et B log C alors A log C. 2. Si A log B et B NL alors A NL. 3. Si A log B et B L alors A L. 4. Si A log B alors A p B.
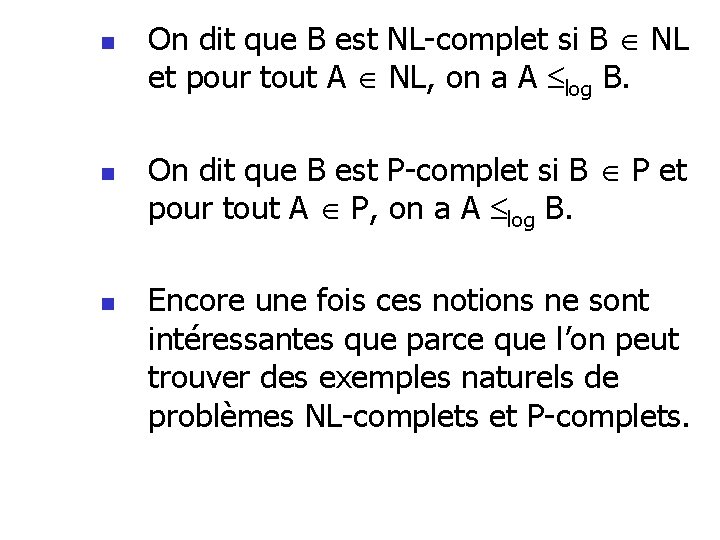
n n n On dit que B est NL-complet si B NL et pour tout A NL, on a A log B. On dit que B est P-complet si B P et pour tout A P, on a A log B. Encore une fois ces notions ne sont intéressantes que parce que l’on peut trouver des exemples naturels de problèmes NL-complets et P-complets.
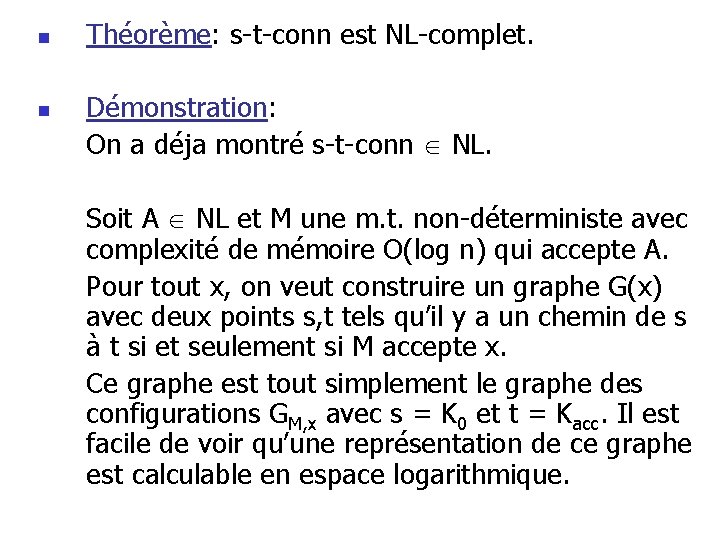
n n Théorème: s-t-conn est NL-complet. Démonstration: On a déja montré s-t-conn NL. Soit A NL et M une m. t. non-déterministe avec complexité de mémoire O(log n) qui accepte A. Pour tout x, on veut construire un graphe G(x) avec deux points s, t tels qu’il y a un chemin de s à t si et seulement si M accepte x. Ce graphe est tout simplement le graphe des configurations GM, x avec s = K 0 et t = Kacc. Il est facile de voir qu’une représentation de ce graphe est calculable en espace logarithmique.
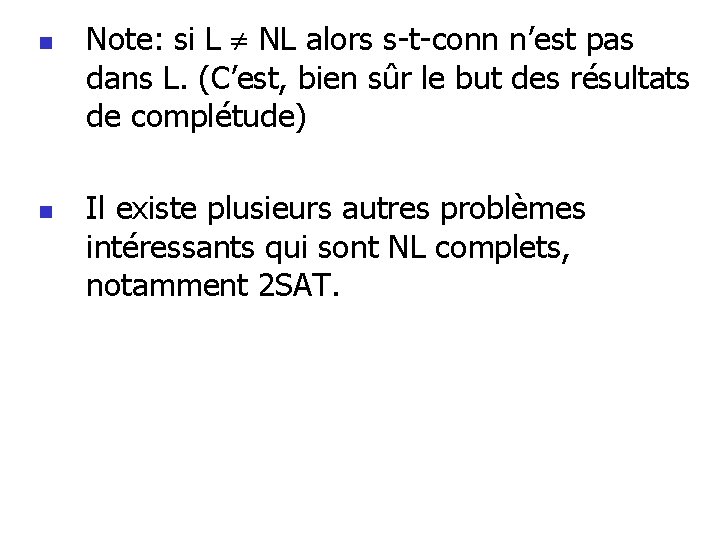
n n Note: si L NL alors s-t-conn n’est pas dans L. (C’est, bien sûr le but des résultats de complétude) Il existe plusieurs autres problèmes intéressants qui sont NL complets, notamment 2 SAT.
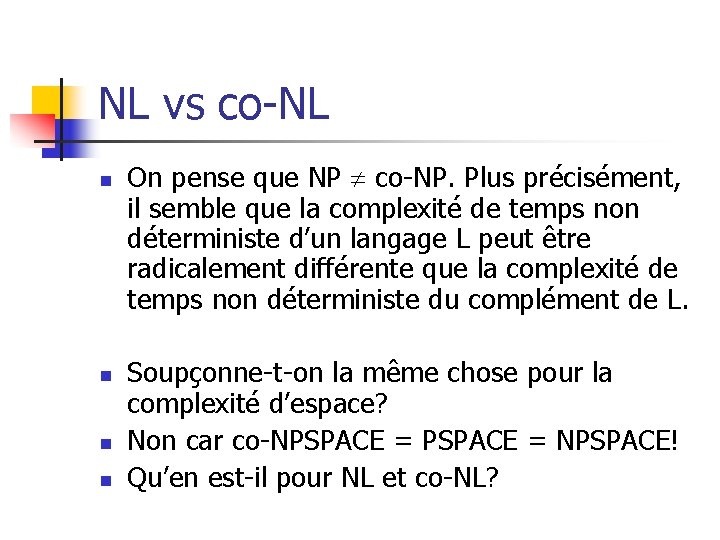
NL vs co-NL n n On pense que NP co-NP. Plus précisément, il semble que la complexité de temps non déterministe d’un langage L peut être radicalement différente que la complexité de temps non déterministe du complément de L. Soupçonne-t-on la même chose pour la complexité d’espace? Non car co-NPSPACE = NPSPACE! Qu’en est-il pour NL et co-NL?
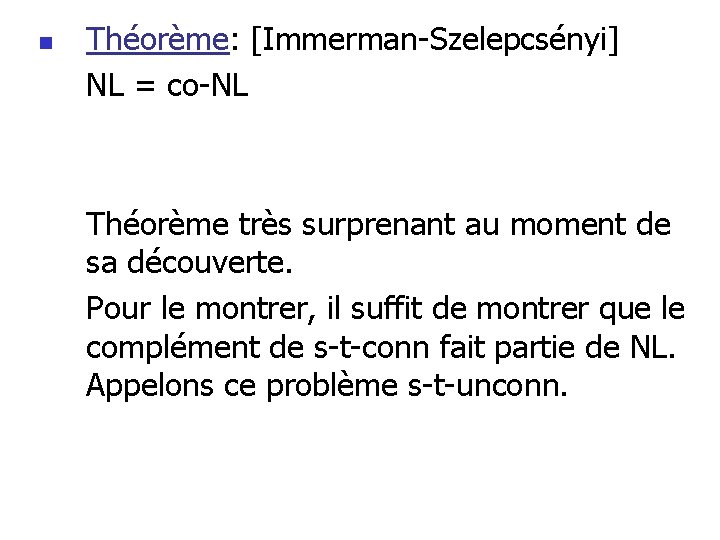
n Théorème: [Immerman-Szelepcsényi] NL = co-NL Théorème très surprenant au moment de sa découverte. Pour le montrer, il suffit de montrer que le complément de s-t-conn fait partie de NL. Appelons ce problème s-t-unconn.
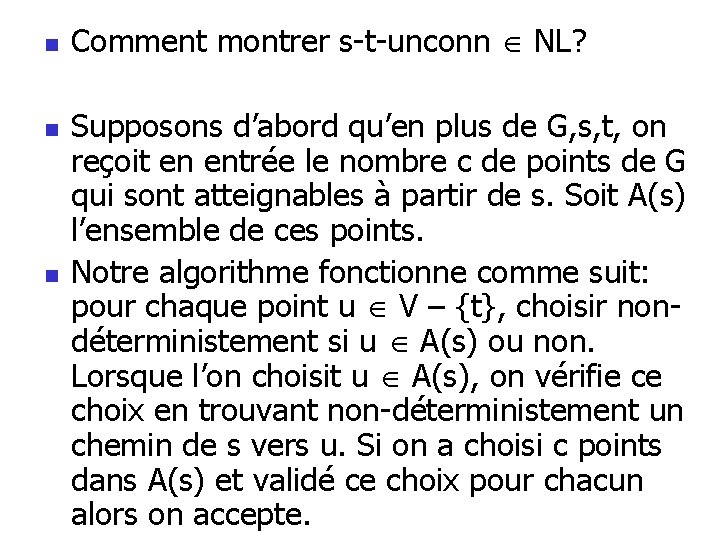
n n n Comment montrer s-t-unconn NL? Supposons d’abord qu’en plus de G, s, t, on reçoit en entrée le nombre c de points de G qui sont atteignables à partir de s. Soit A(s) l’ensemble de ces points. Notre algorithme fonctionne comme suit: pour chaque point u V – {t}, choisir nondéterministement si u A(s) ou non. Lorsque l’on choisit u A(s), on vérifie ce choix en trouvant non-déterministement un chemin de s vers u. Si on a choisi c points dans A(s) et validé ce choix pour chacun alors on accepte.
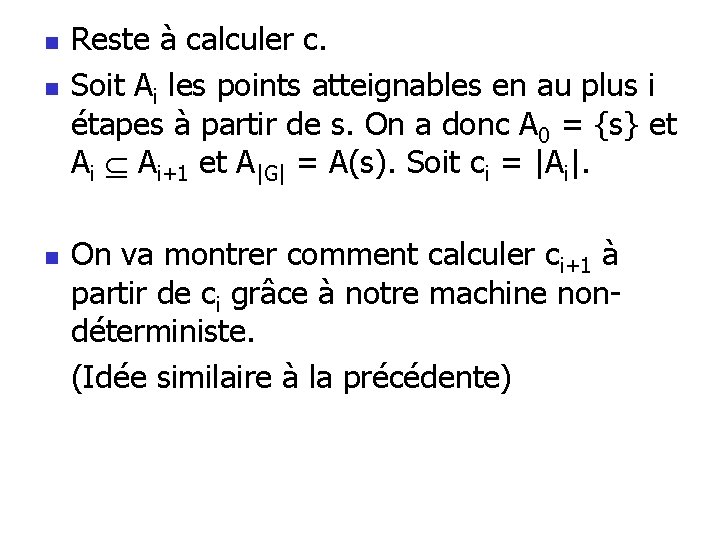
n n n Reste à calculer c. Soit Ai les points atteignables en au plus i étapes à partir de s. On a donc A 0 = {s} et Ai Ai+1 et A|G| = A(s). Soit ci = |Ai|. On va montrer comment calculer ci+1 à partir de ci grâce à notre machine nondéterministe. (Idée similaire à la précédente)
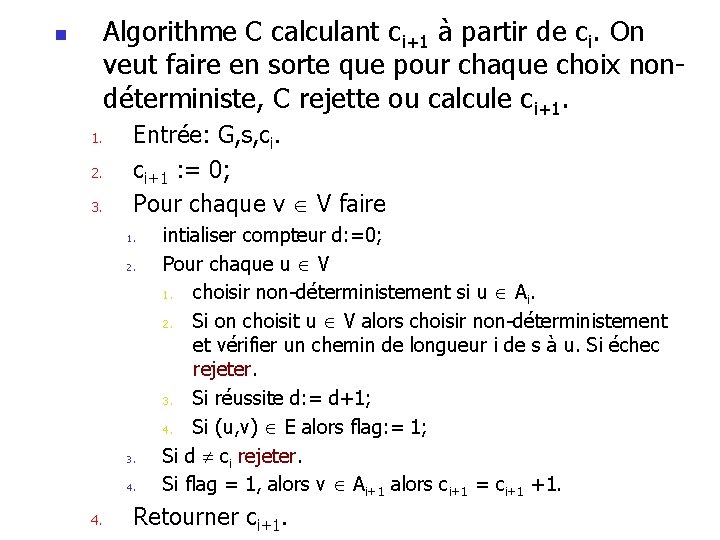
Algorithme C calculant ci+1 à partir de ci. On veut faire en sorte que pour chaque choix nondéterministe, C rejette ou calcule ci+1. n 1. 2. 3. Entrée: G, s, ci. ci+1 : = 0; Pour chaque v V faire 1. 2. 3. 4. intialiser compteur d: =0; Pour chaque u V 1. choisir non-déterministement si u Ai. 2. Si on choisit u V alors choisir non-déterministement et vérifier un chemin de longueur i de s à u. Si échec rejeter. 3. Si réussite d: = d+1; 4. Si (u, v) E alors flag: = 1; Si d ci rejeter. Si flag = 1, alors v Ai+1 alors ci+1 = ci+1 +1. Retourner ci+1.
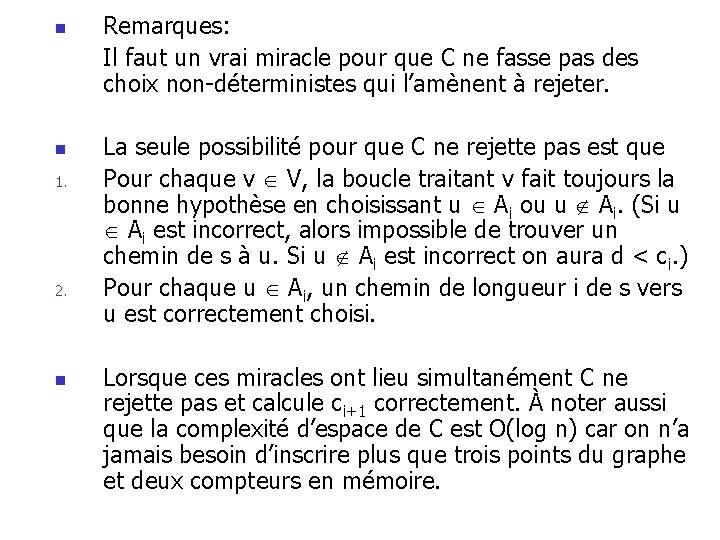
n n 1. 2. n Remarques: Il faut un vrai miracle pour que C ne fasse pas des choix non-déterministes qui l’amènent à rejeter. La seule possibilité pour que C ne rejette pas est que Pour chaque v V, la boucle traitant v fait toujours la bonne hypothèse en choisissant u Ai ou u Ai. (Si u Ai est incorrect, alors impossible de trouver un chemin de s à u. Si u Ai est incorrect on aura d < ci. ) Pour chaque u Ai, un chemin de longueur i de s vers u est correctement choisi. Lorsque ces miracles ont lieu simultanément C ne rejette pas et calcule ci+1 correctement. À noter aussi que la complexité d’espace de C est O(log n) car on n’a jamais besoin d’inscrire plus que trois points du graphe et deux compteurs en mémoire.
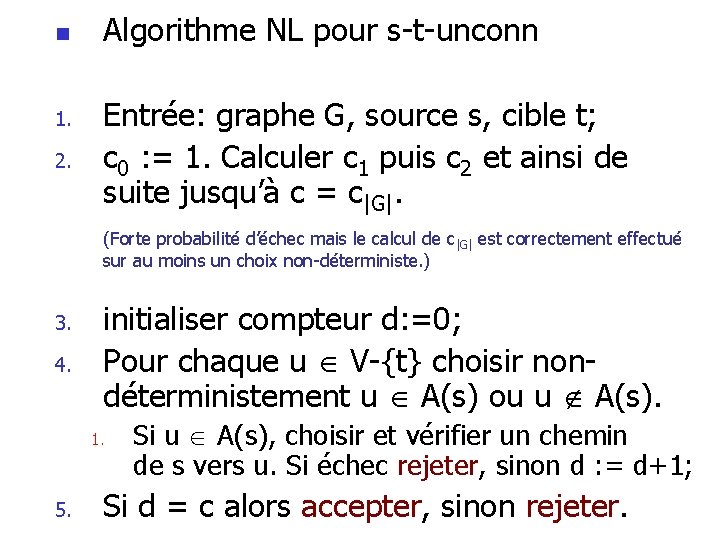
n 1. 2. Algorithme NL pour s-t-unconn Entrée: graphe G, source s, cible t; c 0 : = 1. Calculer c 1 puis c 2 et ainsi de suite jusqu’à c = c|G|. (Forte probabilité d’échec mais le calcul de c|G| est correctement effectué sur au moins un choix non-déterministe. ) 3. 4. initialiser compteur d: =0; Pour chaque u V-{t} choisir nondéterministement u A(s) ou u A(s). 1. 5. Si u A(s), choisir et vérifier un chemin de s vers u. Si échec rejeter, sinon d : = d+1; Si d = c alors accepter, sinon rejeter.
Autres classes d’espace logarithmique n n n On peut également définir des classes probabilistes telles que RL, BPL, PL. On a presque réussi à démontrer que RL = L. De façon générale, on croit que ces classes ne sont pas beaucoup plus grandes que L.
Algorithmes parallèles n n n Le problème s-t-conn peut-être calculé rapidement par un algorithme massivement parallèle. Supposons |G| = n et utilisons n 2 log n processeurs. On peut imaginer les n 2 premiers processeurs sont responsables chacun de calculer T 0(u, v) pour une paire (u, v). Les n 2 suivants calculent chacun un T 1(u, v) grâce à la relation T 1(u, v) m: T 0(u, m) T 0(m, v). Avec log n niveaux on peut donc calculer Tlog n(s, t). Le temps à chaque niveau est linéaire donc le gain n’est pas appréciable.
Pourquoi s’arrêter en si bon chemin? n n n Considèrons le processeur qui calcule Tj(u, v) m: Tj-1(u, m) Tj-1(m, v). Remplaçons le par n processeurs, chacun calculant Tj-1(u, m) Tj-1(m, v) pour un m! Ces réponses sont ensuite combinées par un OU d’arité n. (ce qui demande à nouveau n processeurs). Il existe donc un algorithme massivement parallèle qui calcule s-tconn en temps O(log 2 n).
La classe NC n n Grossièrement la classe de complexité NC est l’ensemble des langages calculables par O(nc) processeurs en temps O(logd n). Puisque le nombre de processeurs est polynomial, on a NC P. Là encore, on croit que l’inclusion est stricte.
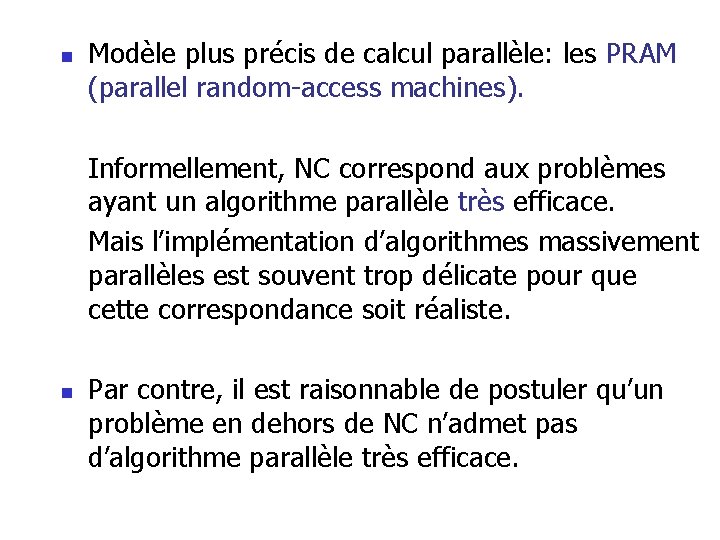
n Modèle plus précis de calcul parallèle: les PRAM (parallel random-access machines). Informellement, NC correspond aux problèmes ayant un algorithme parallèle très efficace. Mais l’implémentation d’algorithmes massivement parallèles est souvent trop délicate pour que cette correspondance soit réaliste. n Par contre, il est raisonnable de postuler qu’un problème en dehors de NC n’admet pas d’algorithme parallèle très efficace.
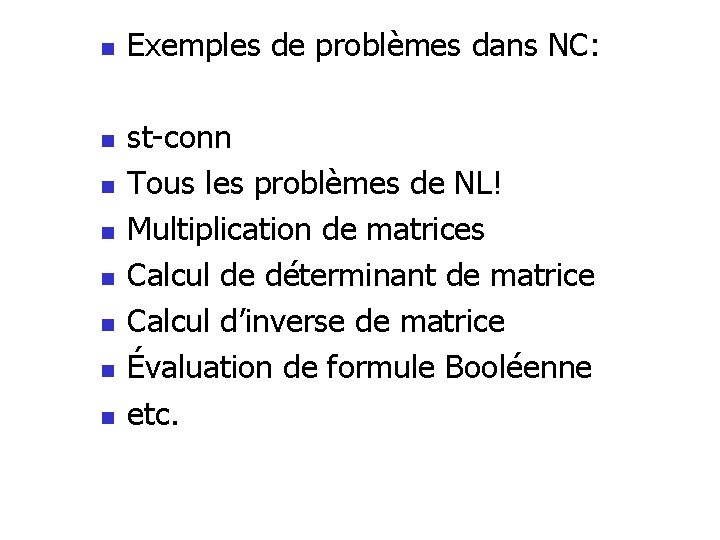
n n n n Exemples de problèmes dans NC: st-conn Tous les problèmes de NL! Multiplication de matrices Calcul de déterminant de matrice Calcul d’inverse de matrice Évaluation de formule Booléenne etc.
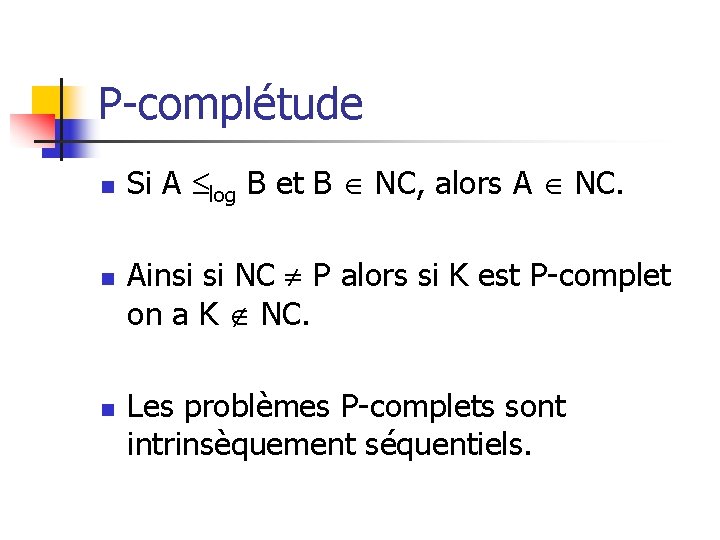
P-complétude n n n Si A log B et B NC, alors A NC. Ainsi si NC P alors si K est P-complet on a K NC. Les problèmes P-complets sont intrinsèquement séquentiels.
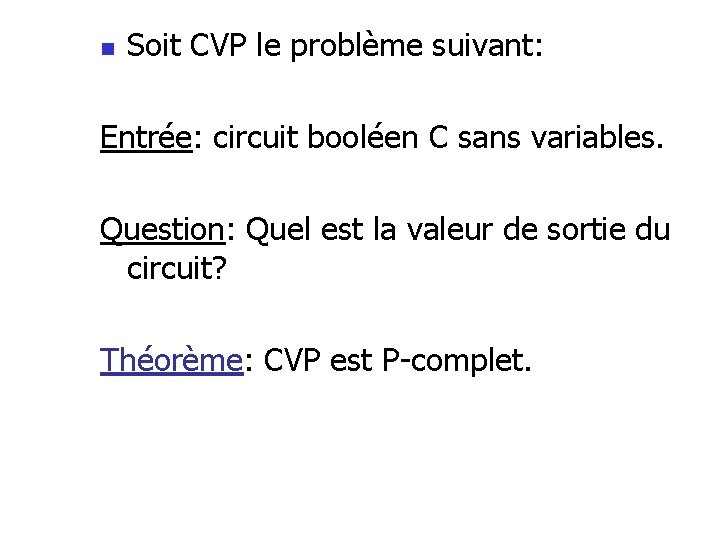
n Soit CVP le problème suivant: Entrée: circuit booléen C sans variables. Question: Quel est la valeur de sortie du circuit? Théorème: CVP est P-complet.
n n n Clairement, on a CVP P: on peut calculer la valeur de chaque porte du circuit niveau par niveau. Soit maintenant A un problème de P et M la m. t. déterministe qui reconnaît A en temps polynomial. Pour chaque x, on peut réutiliser notre construction pour Cook-Levin pour obtenir en espace logarithmique un circuit C(x) dont la valeur de sortie est 1 si et seulement si M accepte x.
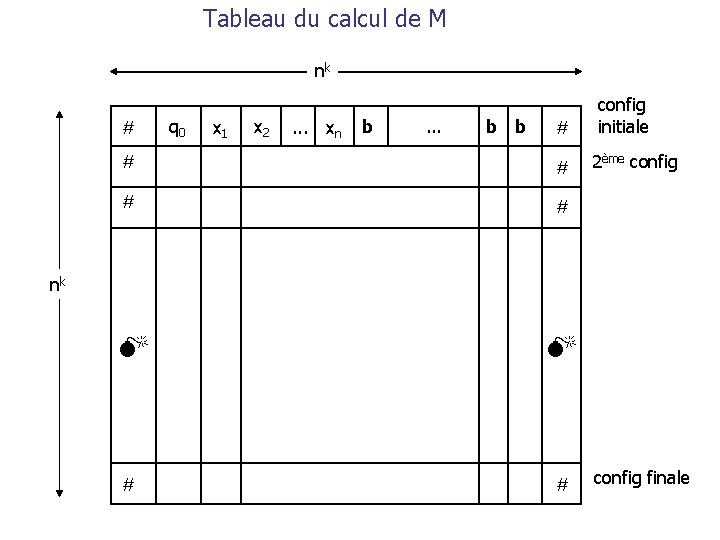
Tableau du calcul de M nk # q 0 x 1 x 2 . . . xn b . . . b b # # # config initiale 2ème config nk config finale
n n n Chaque cellule [i, j] contient un symbole de l’alphabet ou un état q Q. On veut construire à partir d’une entrée x à M un circuit C qui évalue à 1 si et seulement si M accepte x, donc si et seulement si le tableau aboutit dans une configuration acceptante. Chaque cellule va être transformée en un ensemble | | + |Q| portes dans le circuit. La structure du circuit est donc très régulière, ce qui facilite sa construction en espace logarithmique. Le reste n’est qu’une question de détails. (!) (voir 14. 2 de Wegener)
Il existe de très nombreux exemples de problèmes P-complets: n n n Horn-SAT programmation linéaire ordre DFS Max-flow etc.
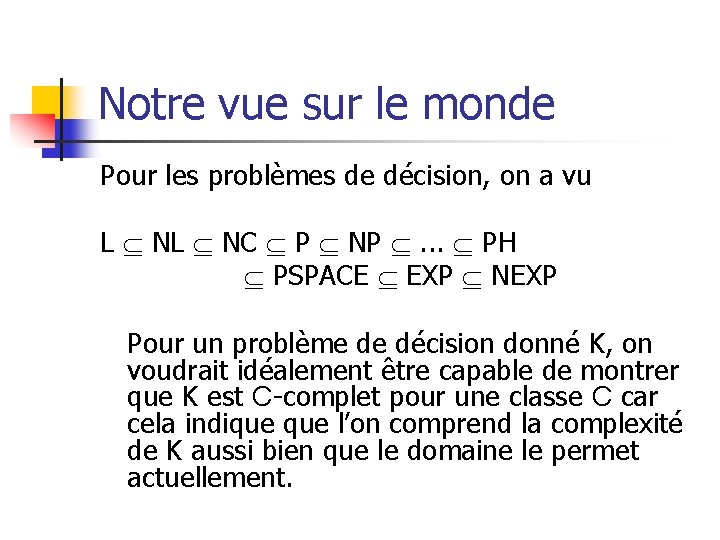
Notre vue sur le monde Pour les problèmes de décision, on a vu L NC P NP . . . PH PSPACE EXP NEXP Pour un problème de décision donné K, on voudrait idéalement être capable de montrer que K est C-complet pour une classe C car cela indique l’on comprend la complexité de K aussi bien que le domaine le permet actuellement.
n n Seul problème: il existe beaucoup de classes de complexité, dont plusieurs qui sont probablement égales et plusieurs qui ne contiennent que très peu de problèmes dignes d’intérêt. cf Complexity Zoo